シミュレーション:モンテカルロ法は遅いのではなく次元に鈍感【第34回】
はじめに
第32章はシミュレーションです。そして連載本編の最終回になります。
この連載では最初の回から、ほとんど毎回シミュレーションを使ってきました。「理論値と実測値を並べて確かめる」というやり方です。ところがその中身は、毎回こう書いていただけでした。
rng = np.random.default_rng(42)
x = rng.exponential(1.0, 100000)
rng.exponential の中で何が起きているのかを、私は一度も考えたことがありませんでした。 一様乱数しかない状態から、どうやって指数分布や正規分布が出てくるのか。第32章はその中身です。連載でずっと使ってきた道具の裏側を、最後に回収する回になります。
学び始める前の私は、この章を「テクニックの詰め合わせ」だと思っていました。逆関数法、棄却法、ボックス=ミュラー法、ブートストラップ法、並べ替え検定、分散減少法。名前が10個くらい並んでいて、それぞれ別に覚えるものだと。
ところが手を動かしてみて、いちばん効いたのは個々の手法ではなく章の構造でした。この章に出てくる技術は2種類しかありません。乱数を「作る」技術と、乱数を「使う」技術です。この2つを分けた瞬間に、10個の名前がきれいに2列に並びました。
そしてもう1つ、思い込みが崩れました。モンテカルロ法は速くも正確でもありません。 1変数の期待値を求めるだけなら、等間隔グリッドの数値積分に1億倍の精度差で負けます。実測しました。それでも使われるのは、精度で勝つからではなく「他の方法が全滅する場所でも生き残る」からでした。よく言われる「精度は でしか上がらない」は、遅いという欠点ではなく「次元に鈍感」という長所だったのです。
この回で扱う用語
| 用語 | 意味 |
|---|---|
| 一様乱数 | 0 と 1 のあいだを平らに埋める乱数。すべての出発点 |
| 逆関数法(inverse transform method) | 累積分布関数の逆関数に一様乱数を通して任意の分布を作る |
| 棄却法(accept-reject method) | 密度を覆う図形に点をばらまき、密度の下に落ちた点だけ採る |
| 採択率 | 棄却法で採用される割合。覆いの中に入っている密度の面積 ÷ 覆いの面積 |
| ボックス=ミュラー法(Box-Muller transform) | 一様乱数2個から正規乱数2個を無駄なく作る |
| 擬似乱数 | 決定的な漸化式で作る「乱数のように見える列」 |
| 周期 | 擬似乱数列が一周して繰り返しはじめるまでの長さ |
| シード(種) | 擬似乱数列の出発点。同じシードなら同じ列が出る |
| モンテカルロ法 | 乱数を使って数値(積分・確率・期待値)を推定する方法の総称 |
| モンテカルロ積分 | 積分を「ランダムに置いた点での平均」で近似する |
| 次元の呪い | 次元が上がると必要な計算量が指数関数的に増える現象 |
| 分散減少法 | 同じ回数でも誤差を小さくする一群の技術 |
| 対照変量法(antithetic variates) | と をペアで使って打ち消し合わせる |
| 層別サンプリング(stratified sampling) | 区間を分割し、各区画から1点ずつ引く。多次元では座標ごとに分割してシャッフルする(ラテン超方格法) |
| 制御変量法(control variates) | 期待値が既知で相関の高い量を引き算する |
| 重点サンプリング(importance sampling) | わざと起きやすい分布から引き、重みで割り戻す |
| 提案分布 | 重点サンプリングや棄却法で、実際に乱数を引く分布 |
| 重み | 提案分布で歪めた分を割り戻す係数。 |
| ESS(Effective Sample Size=有効サンプルサイズ) | 個引いたうち実質いくつが効いているか |
| 指数傾斜(exponential tilting) | 密度に を掛けて正規化し、分布の中心をずらす操作 |
| ブートストラップ法(bootstrap) | 手元のデータから復元抽出して推定値のばらつきを測る |
| 並べ替え検定(permutation test) | 群のラベルを入れ替えて帰無仮説のもとでの分布を作る |
| ジャックナイフ法(jackknife) | 1個ずつ抜いて推定値のばらつきを測る。乱数を使わない |
この章の地図:乱数を「作る」技術と「使う」技術
先に地図を出します。この章の理解はここで8割決まりました。
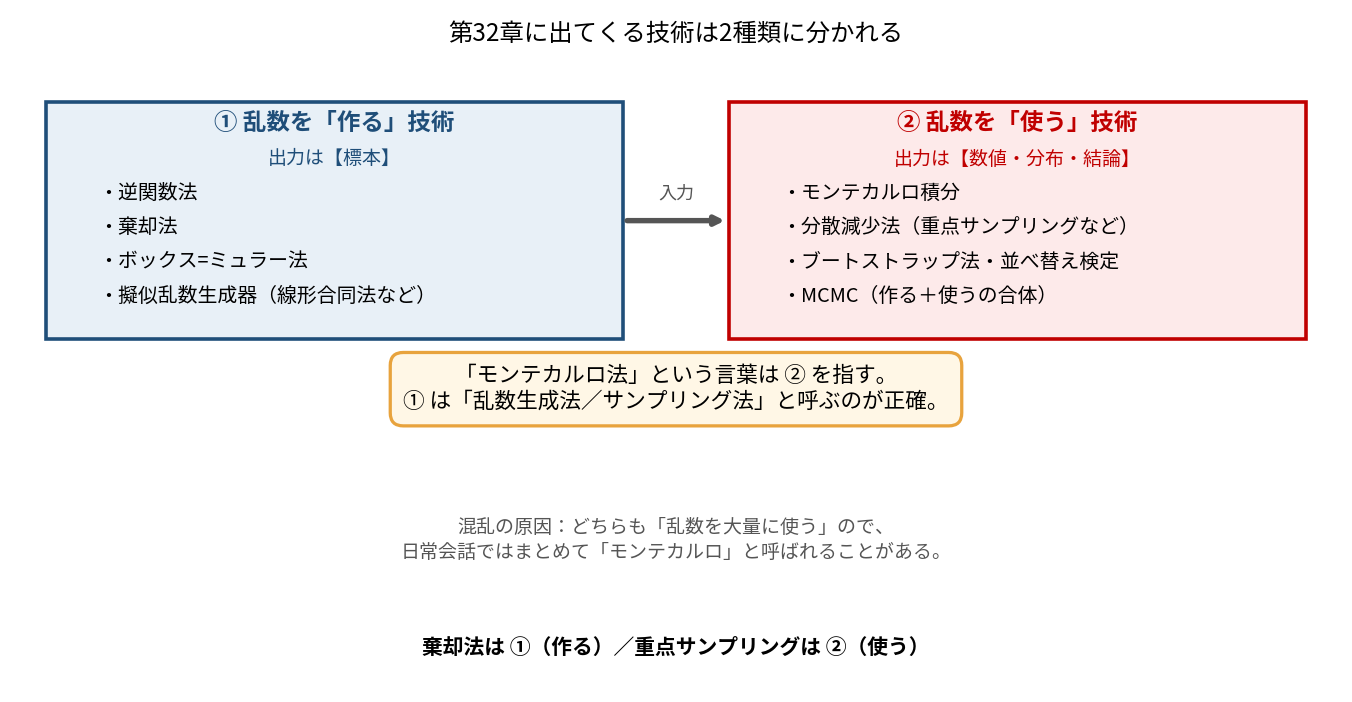
| ① 乱数を「作る」技術 | ② 乱数を「使う」技術 | |
|---|---|---|
| 正式な呼び方 | 乱数生成法・サンプリング法 | モンテカルロ法 |
| 入力 | 一様乱数 | 目的の分布の標本 |
| 出力 | 標本(数値の列) | 数値・分布・結論 |
| この章での例 | 逆関数法、棄却法、ボックス=ミュラー法、擬似乱数生成器 | モンテカルロ積分、分散減少法、ブートストラップ法、並べ替え検定 |
| 成功の基準 | 作った標本が正しい分布に従うか | 推定値が真値に近いか |
| 失敗の症状 | 別の分布になっている | 値が真値からずれる/収束しない |
①の出力が②の入力になります。 そして「モンテカルロ法」という言葉は、本来②だけを指します。①は「乱数生成法」または「サンプリング法」です。
私はこの区別が付いておらず、棄却法とモンテカルロ法を同じものだと思っていました。混乱するのは自然で、というのも実際にまったく同じデータから両方が作れるからです。
正方形にダーツを400万本投げて、円の中に入ったかどうかを記録します。
- 緑の点の「個数」だけを使う → 円の面積比 の推定値が出る → (真値 3.141593)。これがモンテカルロ法です。座標はもう捨ててよい
- 緑の点の「座標」を使う → 円内の一様分布に従う標本が手に入る。これが棄却法です。個数はどうでもよい
投げたダーツは1組しかありません。個数を使うか座標を使うかだけが違います。 そして欲しいものが「数値」か「標本」かで、呼び名が変わる。
以下、第1部で①を、第2部で②を扱います。
第1部 乱数を「作る」技術
逆関数法:累積分布関数を横向きに読む
手元にある道具は rng.random() ひとつ、つまり 0 と 1 のあいだを平らに埋める一様乱数だけ、という状況から出発します。ここから指数分布の乱数を作りたい。
累積分布関数 は、いつもは横軸から縦軸に読みます。「 のとき、それ以下になる確率は 0.632」。逆関数法がやるのは、この読み方をひっくり返すことだけです。縦軸に一様乱数 を置いて、曲線にぶつけて、横軸に落とす。
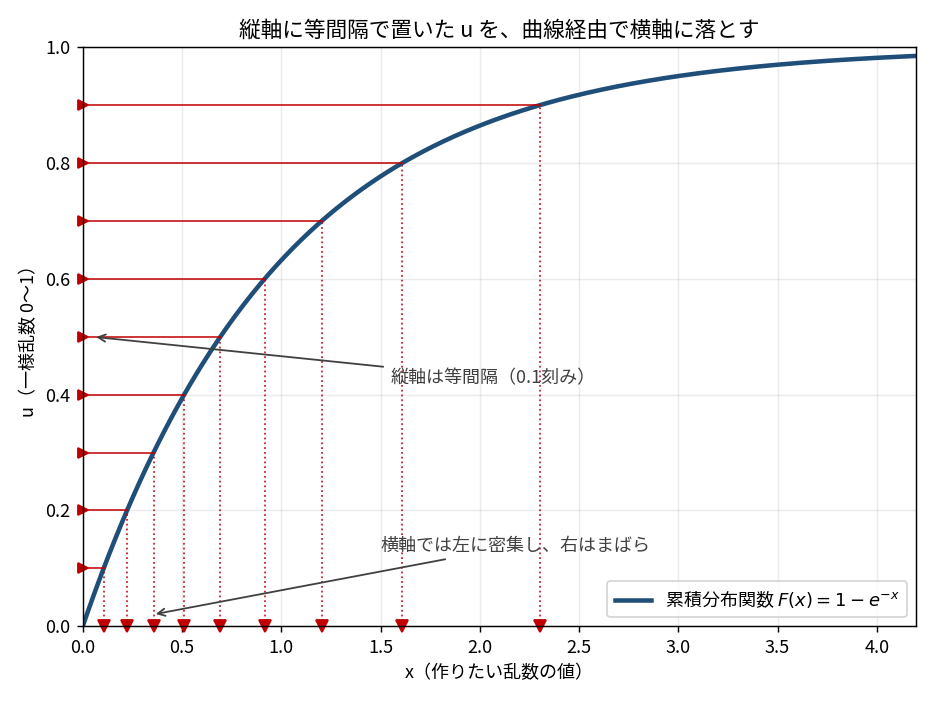
縦軸には 0.1 刻みで等間隔に を置いています。一様乱数なので、どの高さも等確率で出ます。ところが曲線を経由して横軸に落とすと、着地点は左に密集し右はまばらになります。 9本の矢印の間隔が、左では狭く右では広い。
この偏りが、そのまま指数分布のかたちです。
なぜ偏るのか:傾きが密度だから
左側で矢印が密集しているのは、そこで曲線の傾きが急だからです。傾きが急な区間では、狭い 幅のあいだに縦軸の広い範囲が対応します。縦軸の範囲が広い、つまりそこに落ちる が多い、つまりその の近くに乱数が多く生まれる。
そして累積分布関数の傾きは、微分すれば確率密度関数そのものです。
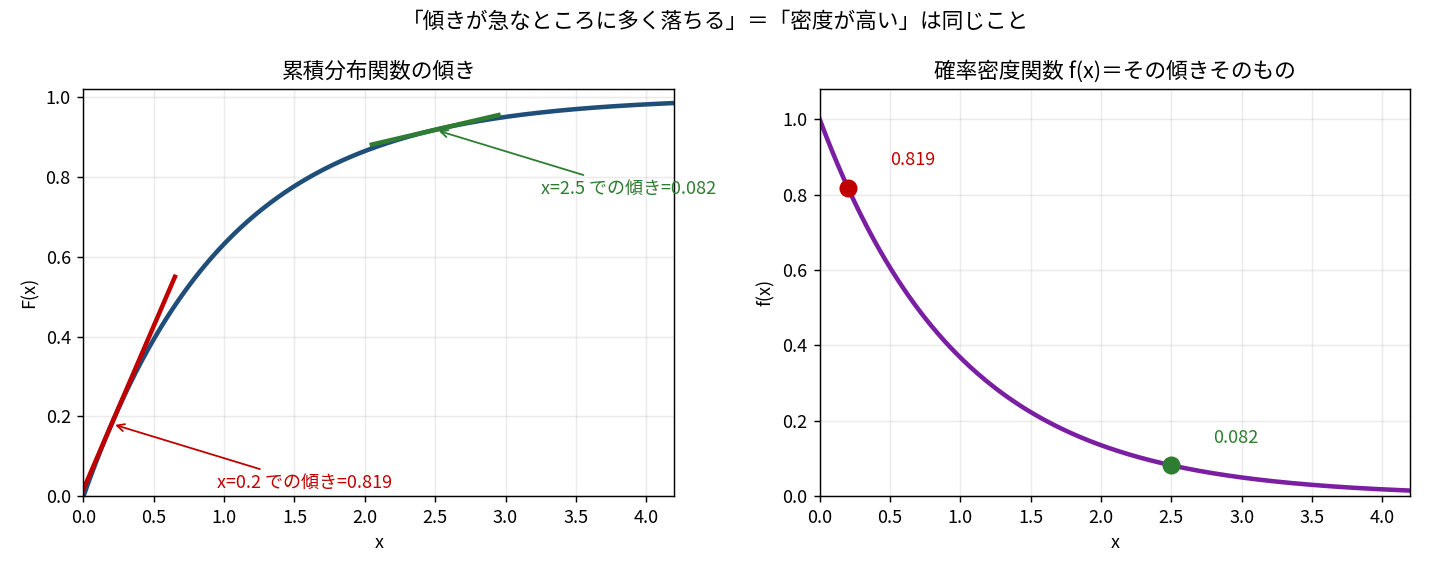
の での傾きは 0.819、 では 0.082。約10倍違います。右のパネルの の値を見ると、まさに同じ 0.819 と 0.082。「傾き」と「密度」は別の話ではなく、同じ数字の別名でした。
ここが原理のすべてです。「傾きが急なところに多く落ちる」という図の見た目が、そのまま「密度が高いところに多く落ちる」という確率の主張になっている。逆関数法は、密度の情報を累積分布関数の傾きという形で借りてきて、それを一様乱数の落下先の混み具合に翻訳する装置でした。
手続きは2行
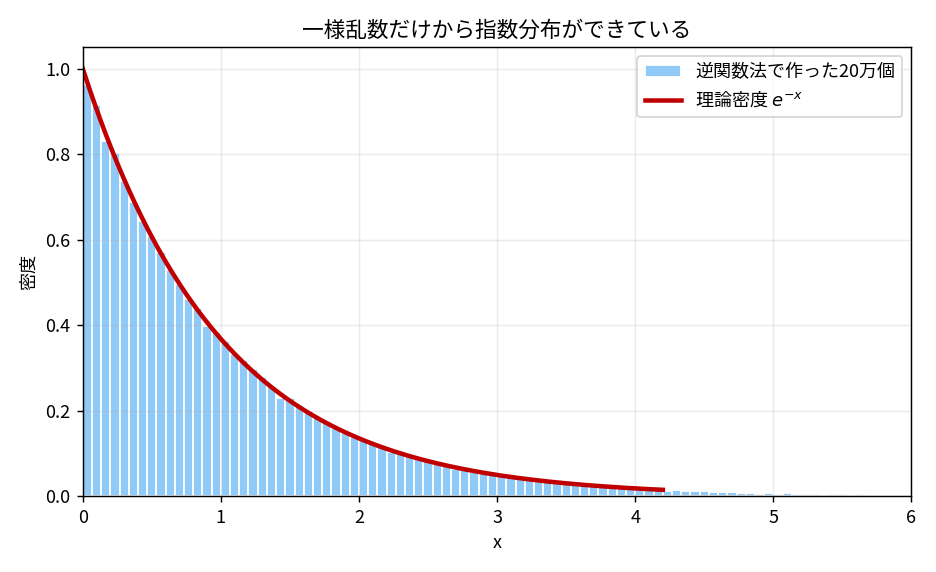
指数分布なら を について解いて、 です。実際にやってみます。
| 確かめた量 | 実測(20万個) | 理論値 |
|---|---|---|
| 平均 | 1.00234 | 1 |
| 分散 | 0.99975 | 1 |
| 中央値 | 0.69699 | 0.69315() |
| 0.62979 | 0.63212 | |
| 0.91797 | 0.91792 |
乱数生成器の側は、指数分布のことを何も知りません。 rng.random() を呼んで に通しただけです。
なぜ正しいのか:区間が1対1に対応している
「傾きが密度」という説明は直感的ですが、もう一段だけ厳密にしておきます。ここが分かると逆関数法は完全に手の内に入ります。
準備は2つだけです。
準備1。累積分布関数の縦軸は確率です。 だから縦軸上のある区間の「長さ」は、そのまま確率の値になっています。累積分布関数は「確率を長さに変換する装置」だと言えます。
準備2。一様乱数は「長さがそのまま確率になる」乱数です。 区間 に入る確率は 。定義から。
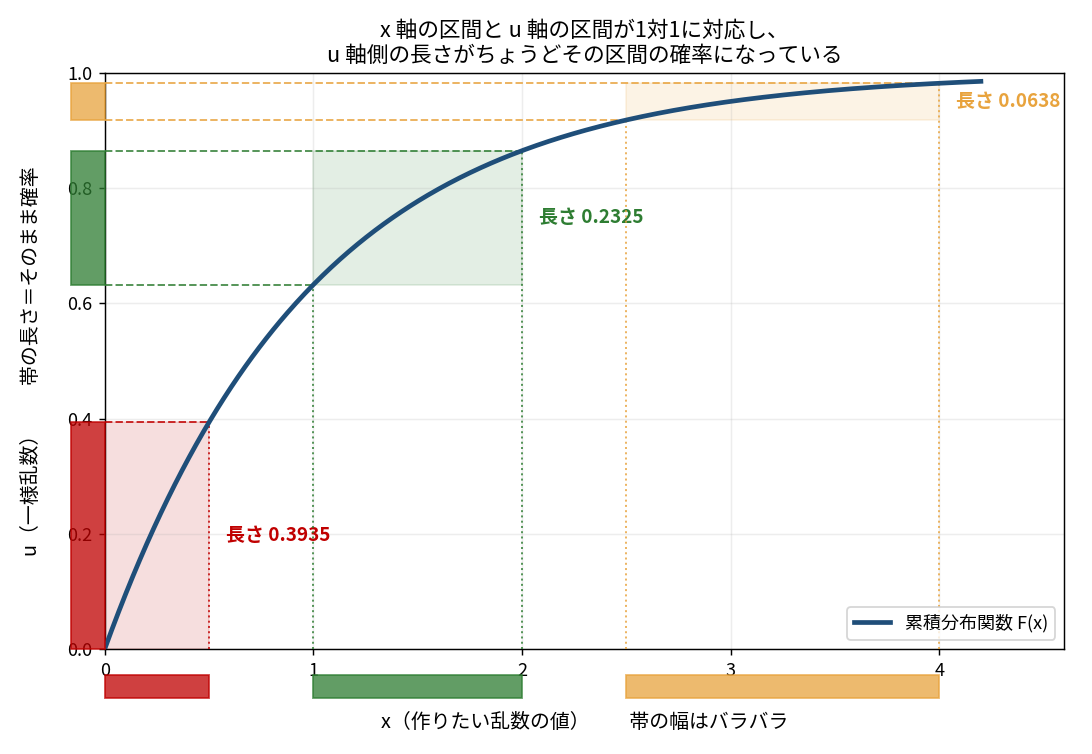
軸側の帯は幅がバラバラ(0.5 / 1.0 / 1.5)ですが、 軸側の帯の長さはそれぞれの区間の確率そのものになっています。
| の区間 | 対応する の区間 | 側の長さ | その区間の確率 |
|---|---|---|---|
| 0.3935 | 0.3935 | ||
| 0.2325 | 0.2325 | ||
| 0.0638 | 0.0638 |
あとは3段です。
- が帯 に落ちる確率は、その長さ = 0.2325(一様乱数の定義から)
- 帯に落ちたら、 は増加関数なので は に入る。この例(連続で狭義に増加)では1対1に対応しているので、取りこぼしも重複もない
- よって が に入る確率も 0.2325。そしてこれが、もともと欲しかった分布での と同じ数字
式にすると1行です。
2番目の等号が「 が単調非減少なので不等号の向きが保たれる」(厳密には次の節で述べる一般化逆関数の性質 )、3番目が「一様乱数が に入る確率は長さ 」。そして最後の が、まさに目標の分布の累積分布関数です。到達しました。
実測で確認しました。 一様乱数200万個について「 が帯に入ったか」と「 が区間に入ったか」を1個ずつ比べたところ、200万個すべてで判定が一致(不一致 0 件)でした。
| 区間 | が帯に入った割合 | が区間に入った割合 | 理論値 |
|---|---|---|---|
| 0.39339 | 0.39339 | 0.39347 | |
| 0.23268 | 0.23268 | 0.23254 | |
| 0.06364 | 0.06364 | 0.06377 |
左2列が小数第5位まで完全一致しているのがポイントです。確率が近いのではなく、同じ事象を2つの軸から見ているだけでした。
だから「どんな分布でも」作れる
いま使った性質は「 が単調非減少で右連続である」ことだけです。だから分布ごとに新しい理屈は要りません。
ただし1つだけ条件を正確にしておきます。累積分布関数が必ず満たすのは「単調非減少」と「右連続」で、狭義の単調増加ではありません。 離散分布や、密度が0の区間がある分布では、 に水平な部分があって1対1になりません。そのときは逆関数を
と定義し直します(一般化逆関数)。こう定義すると が一般に成り立つので、上の1行の証明はそのまま通ります。 狭義増加を仮定しなくてよいのが、この定義の効き目です。
実演します。同じ10個の一様乱数(0.07, 0.15, 0.28, … 0.95)を、4つの違う に通しました。
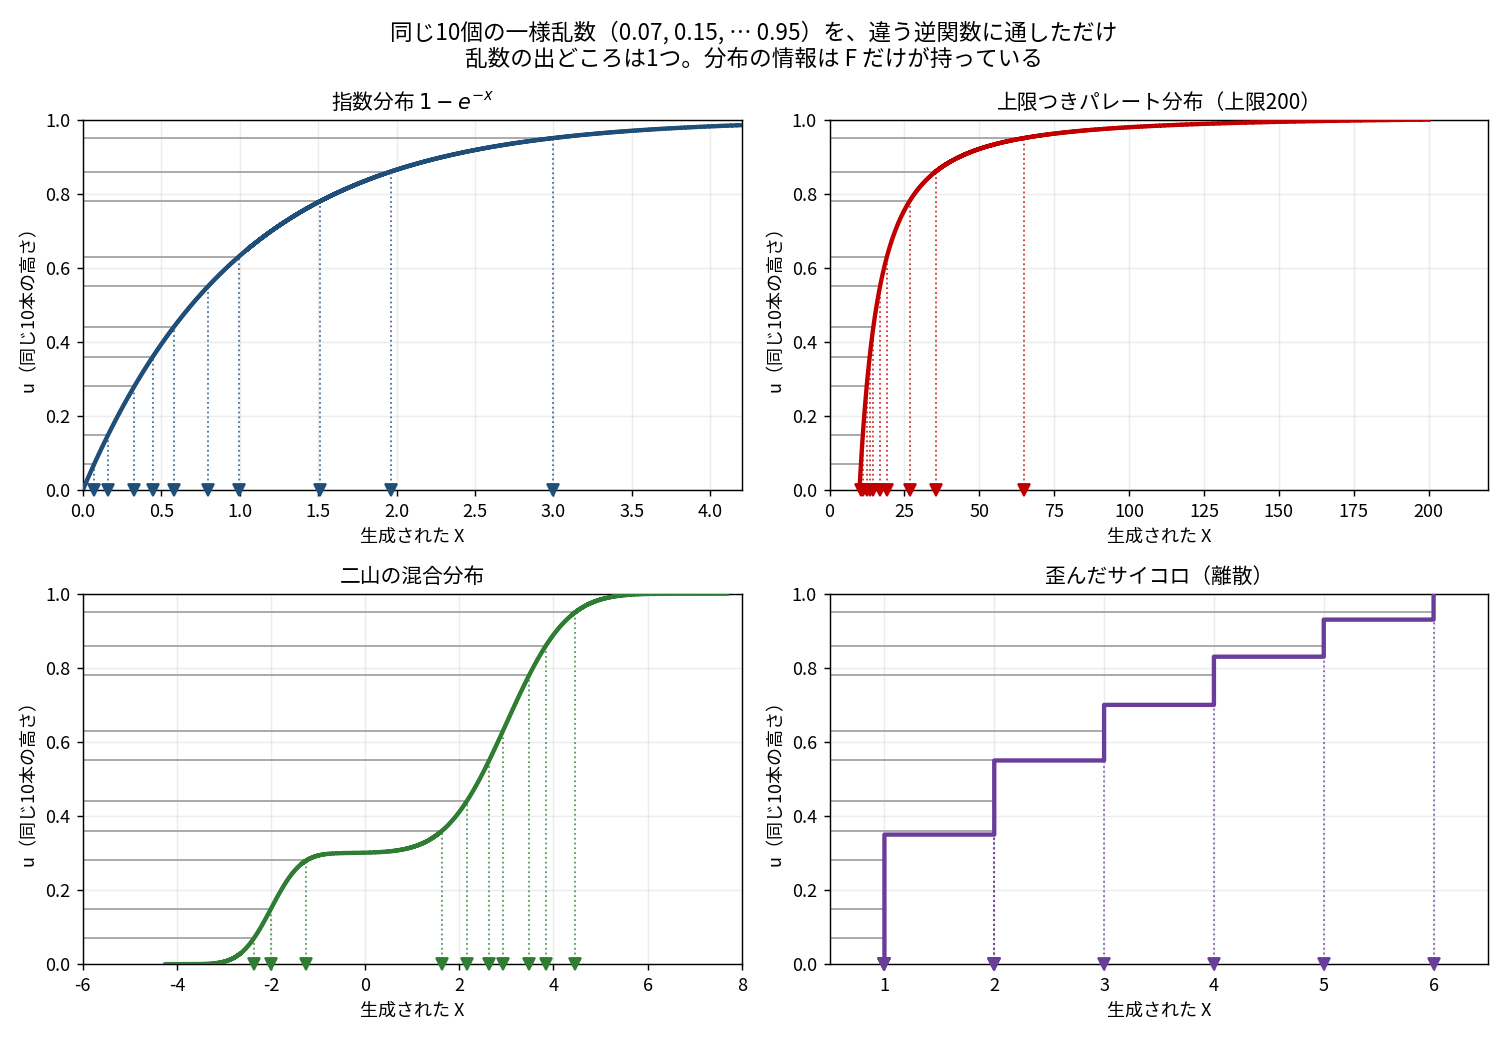
4枚とも、灰色の水平線( の高さ)は同一です。違うのは曲線の形だけ。
| 指数分布 | 上限つきパレート分布 | 二山の混合分布 | 歪んだサイコロ | |
|---|---|---|---|---|
| 0.07 | 0.0726 | 10.490 | −2.364 | 1 |
| 0.15 | 0.1625 | 11.130 | −2.000 | 1 |
| 0.28 | 0.3285 | 12.412 | −1.250 | 1 |
| 0.36 | 0.4463 | 13.409 | 1.632 | 2 |
| 0.44 | 0.5798 | 14.633 | 2.158 | 2 |
| 0.55 | 0.7985 | 16.876 | 2.634 | 2 |
| 0.63 | 0.9943 | 19.160 | 2.928 | 3 |
| 0.78 | 1.5141 | 26.738 | 3.484 | 4 |
| 0.86 | 1.9661 | 35.483 | 3.842 | 5 |
| 0.95 | 2.9957 | 64.801 | 4.465 | 6 |
読み取れることが3つあります。
- 曲線が立っている(密度が高い)ところでは着地点が密集し、寝ているところでは散らばる
- 離散分布(右下)は、累積分布関数が確率 の分だけ垂直に跳ぶので、その跳びの高さに落ちた (幅 の区間)がすべて同じ値に写ることで実現される。連続分布と同じ手続きで離散分布も作れる
- 二山の混合分布では、 で だったのが で に飛んでいます。 付近が2つの山の谷間(曲線がほぼ水平)だからです。 は等間隔なのに飛び地ができる
4つとも理論値と照合しました(各200万個)。
| 分布 | 確かめた量 | 実測 | 理論値 |
|---|---|---|---|
| 指数分布 | 平均 | 0.99892 | 1 |
| 指数分布 | 0.63257 | 0.63212 | |
| 上限つきパレート分布 | 平均 | 23.53156 | 23.55515 |
| 上限つきパレート分布 | 最大値 | 199.999 | 200(上限) |
| 二山の混合分布 | 平均 | 1.49823 | 1.50000 |
| 二山の混合分布 | 0.30118 | 0.30094 | |
| 歪んだサイコロ | 平均 | 2.63880 | 2.64000 |
歪んだサイコロの各面の割合は 0.3502 / 0.1999 / 0.1507 / 0.1295 / 0.1000 / 0.0698 で、設定した 0.35 / 0.20 / 0.15 / 0.13 / 0.10 / 0.07 と一致しました。
結論。乱数生成器は rng.random() ひとつしかありません。4つの分布に共通の乱数源です。分布の情報は、乱数の側ではなく の形だけが持っています。 だから を書き下せる分布なら何でも作れる。「ライブラリに無い分布でも分析できる」という利点は、この一点に由来していました。
コラム:逆関数法と第4回の変数変換は同じ話なのか
第4回で変数変換とヤコビアンを扱いました。逆関数法もまた「一様乱数を別の値に変換する」操作です。同じ話なのか、ヤコビアンは出てくるのか。
同じ話です。逆関数法は変数変換の1次元・単調な場合の特殊ケースでした。そしてヤコビアンは出てきます。というより、ずっと使っていました。
第4回の公式は でした。逆関数法では なので、
ヤコビアン が、密度 そのものです。 数値微分で確かめました。
| 数値微分 | 密度 | 差 | ||
|---|---|---|---|---|
| 0.2 | 0.181269 | 0.8187307530 | 0.8187307531 | 5.1e−11 |
| 0.5 | 0.393469 | 0.6065306598 | 0.6065306597 | 4.0e−11 |
| 1.0 | 0.632121 | 0.3678794412 | 0.3678794412 | 1.6e−11 |
| 2.5 | 0.917915 | 0.0820849986 | 0.0820849986 | 7.7e−12 |
さきほどの図で見た「累積分布関数の傾きが密度である」が、ヤコビアンでした。 1次元だと「傾き」と「密度」が同じものなので区別する必要がなく、ヤコビアンという言葉を持ち出さずに済んでいたわけです。2次元以上になると2つは別物になり、行列式を計算する必要が出てきます。それがこのあと出てくるボックス=ミュラー法の です。
棄却法:逆関数が書けないとき
指数分布は を について解けたので、1行で書けました。正規分布ではこれができません。
この積分は初等関数で書けず、誤差関数 が必要です。当然その逆関数 も、 のような閉じた式にはなりません。
正直に書くと、正規分布は例外的に恵まれています。 数値ライブラリには erfinv があるので、実務では逆関数法も使えます。棄却法が本当に必要になるのは、自分で作った密度や正規化定数が分からない密度のときです。ベイズの事後分布がまさにそれで、第33回の MCMC(Markov Chain Monte Carlo=マルコフ連鎖モンテカルロ法)につながります。ここでは仕組みが見やすいので正規分布を題材にします。
発想:密度を面積として見る
逆関数法は密度の情報を「累積分布関数の傾き」経由で使いました。棄却法はもっと素朴です。
- 密度の曲線を、すっぽり覆う図形(まずは長方形)を用意する
- その図形の中に一様にランダムな点をばらまく
- 曲線より下に落ちた点だけ残し、その 座標を採用する
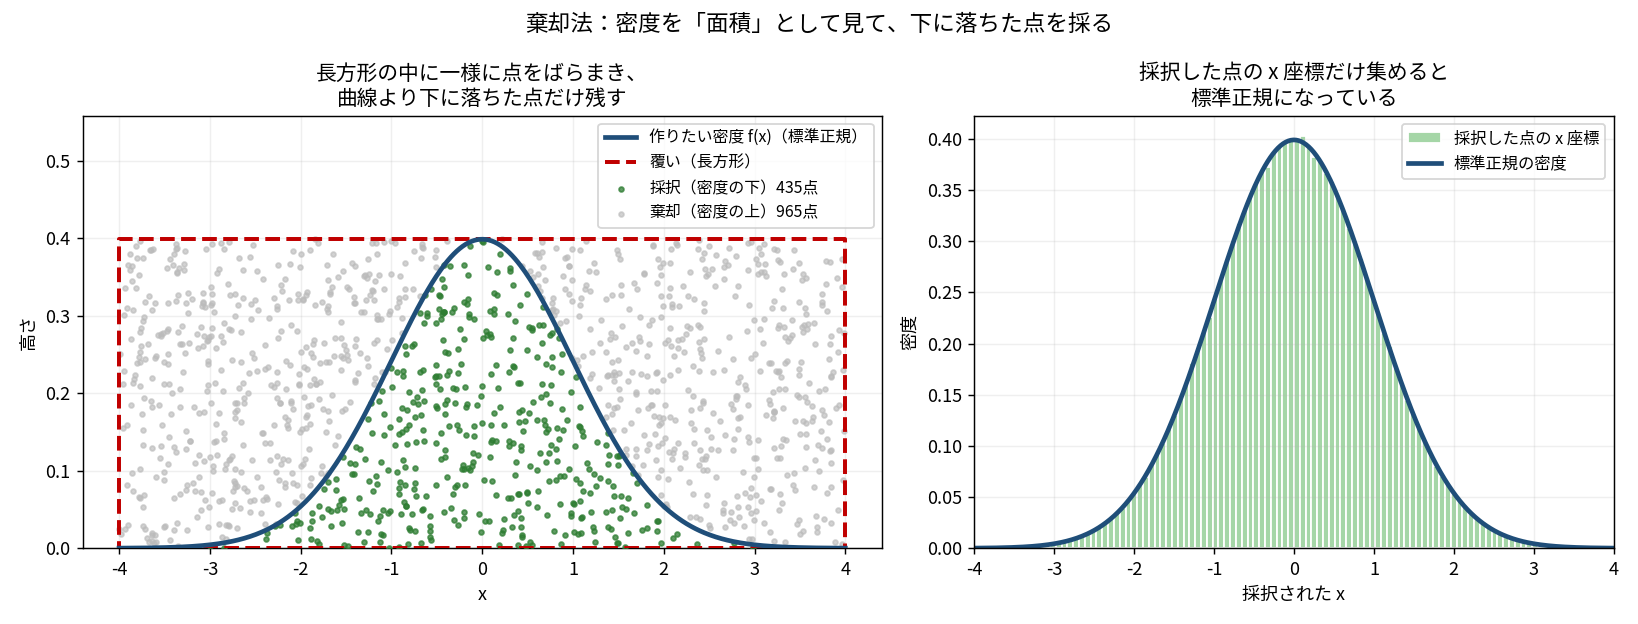
左は1400点をばらまいた例で、緑が採択435点、灰色が棄却965点です。採択された緑の点は、曲線が高いところに密集しています。 右は300万点でやって、採択した点の 座標だけのヒストグラムを描いたものです。
なぜ正しいのか。長方形の中に一様に点を打つと、どの領域に落ちる確率もその領域の面積に比例します。 だから の周りの細い縦の帯に落ちる確率は、その帯の中の「曲線の下の面積」に比例する。それはまさに 帯の幅、つまり密度です。
| 確かめた量 | 実測(300万点から採択) | 理論値 |
|---|---|---|
| 採択率 | 0.313379 | 0.313309 |
| 平均 | 0.00077 | 0 |
| 分散 | 0.99710 | 1 |
| 歪度 | −0.00400 | 0 |
| 0.97512 | 0.97500 |
採択率は「面積の比」そのもの
覆いが密度を完全に含んでいれば分子は 1 になるので、覆いの面積が小さいほど効率が良いことになります。
長方形 なら面積は です。ただしこの場合、分子はぴったり1ではありません。 の外に より遠い裾がわずかに残っているからです。その分の質量を除くと 0.99993666 なので、
分子を 1 と置いて としてはいけません。 差は小数第5位ですが、この差の正体は「切り落とした裾」で、作られる分布が標準正規分布ではなくなっていることの現れです。次の表とジレンマの話に直結します。
長方形の幅を変えてみます。
| 覆いの範囲 | 採択率 | 1個作るのに平均何回引くか |
|---|---|---|
| 0.855624 | 1.17 回 | |
| 0.598144 | 1.67 回 | |
| 0.416643 | 2.40 回 | |
| 0.313309 | 3.19 回 | |
| 0.125331 | 7.98 回 | |
| 0.062666 | 15.96 回 |
ここにジレンマがあります。 広く取ると無駄が増えて採択率が落ちる。狭く取ると採択率は上がりますが、裾が切れて別の分布になってしまいます。 の採択率 0.856 は魅力的ですが、それで作られるのは「 で打ち切られた正規分布」です。
正規分布の裾は無限に続くので、長方形では原理的に完全に覆えません。 どこかで切るしかない。
覆いを「密度に似た形」にする
長方形にこだわる必要はありません。覆いも確率分布でよいのです。ある定数 を使って
を満たす を用意します。すると採択率 ( が の全域を覆う確率分布である場合)。 が 1 に近いほど良いということになります。
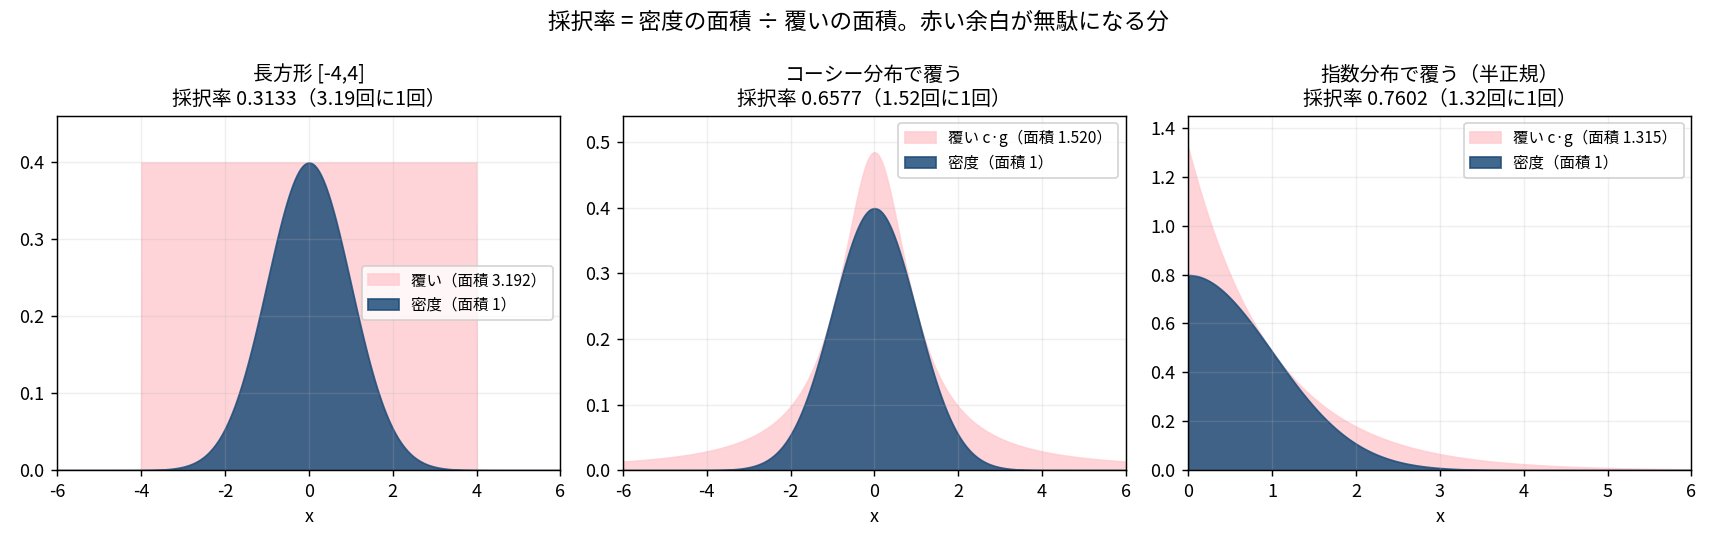
赤い余白がそのまま無駄になる分です。
| 覆い方 | 実際の採択率 | 1個作るのに引く回数 | ||
|---|---|---|---|---|
| 長方形 | 7.9788 | 0.125331 | 0.125331 | 7.98 回 |
| 長方形 | 3.1915 | 0.313329 | 0.313309 | 3.19 回 |
| コーシー分布で覆う | 1.5203 | 0.657745 | 0.657745(実測 0.657786) | 1.52 回 |
| 指数分布で覆う(半正規) | 1.3155 | 0.760173 | 0.760173(実測 0.760255) | 1.32 回 |
長方形 の行だけ と実際の採択率が食い違っています(0.313329 対 0.313309)。長方形は裾を覆いきれていないので が使えず、この差が切り落とした分です。 以降は裾の質量が丸めの範囲で1になるため一致します。覆いが分布(コーシー・指数)なら全域を覆うので、採択率は厳密に です。
コーシー分布が使えるのは、裾が正規分布より厚いからです。 裾で追い越されないので全域を覆えます。「重い裾の分布で軽い裾の分布を覆う」は棄却法の定石で、逆はできません。
指数分布版(半正規分布を作って符号をランダムに付ける)で作った標準正規の検算は、平均 −0.00130、分散 0.99971、(理論 0.95000)でした。コーシー版は平均 0.00027、分散 0.99920、 です。
の求め方
は「 の上限(sup)」です。厳密には最大値が達成されない場合もありますが、今回は で達成されます。
なお条件の本体は「 の台が の台を含む」ことと「」であり、「重い裾で覆う」はそのための言い換えです(厳密には「 の裾が より軽くないこと」で、同程度の減衰でも構いません)。そして から必ず 、つまり採択率は必ず1以下になります。
半正規分布を指数分布で覆う場合を実際にやってみます。
指数部 を微分して 0 にすると 、つまり で最大です。
実測 0.760255 と一致しました。第1回から使っている「微分してゼロ」がここでも出てきます。
棄却法の限界:高次元で崩壊する
棄却法にも弱点があります。しかも、すでに何度も見た弱点です。
次元の立方体 に一様に点を打ち、単位球の中に入ったものだけ採択する(=球内の一様分布を作る)という問題を考えます。
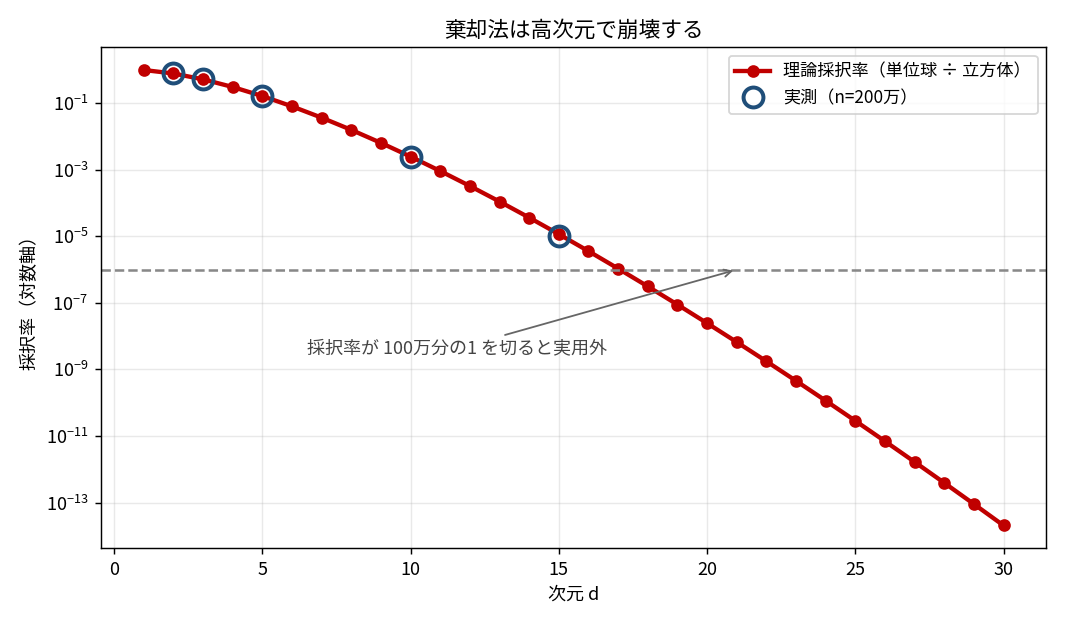
| 理論採択率 | 実測( 万) | 1個作るのに引く回数 | |
|---|---|---|---|
| 2 | 0.785398 | 0.785234(157万個) | 1.27 回 |
| 3 | 0.523599 | 0.523546(105万個) | 1.91 回 |
| 5 | 0.164493 | 0.164746(329,493個) | 6.08 回 |
| 10 | 0.002490 | 0.002447(4894個) | 402 回 |
| 15 | 1.16e−05 | 9.50e−06(19個) | 8.6万 回 |
| 20 | 2.46e−08 | — | 4063万 回 |
| 30 | 2.04e−14 | — | 回 |
| 50 | 1.54e−28 | — | 回 |
で200万点から19個しか採択されませんでした。
高次元では立方体のほとんどが「角」で、球はその中心のごく一部にしかありません。 覆いと密度の面積比が指数的に開くので、採択率が消えていきます。
これが第33回で MCMC が必要になった理由です。 高次元の分布から標本を得るのに、棄却法は使えません。MCMC は「棄却しても前の点に留まる」ことで、この崩壊を回避しています。逆に言えば、低次元では棄却法は今でも現役です。 なら1.91回に1回採択されるので、MCMC のような収束の心配がある道具を持ち出す理由がありません。適材適所でした。
ボックス=ミュラー法:無駄ゼロで正規乱数を2個作る
棄却法は無駄が出ます(長方形なら3.19回に1回)。逆関数法は書けません。そこで発想を変えます。1個ずつ作るのをやめて、2個セットで作る。
2次元標準正規分布( と が独立)の同時密度を書いてみます。
しか出てきません。 これは「原点からの距離だけが効いていて、方向はまったく効いていない」という意味です。だから角度は完全に一様になります。
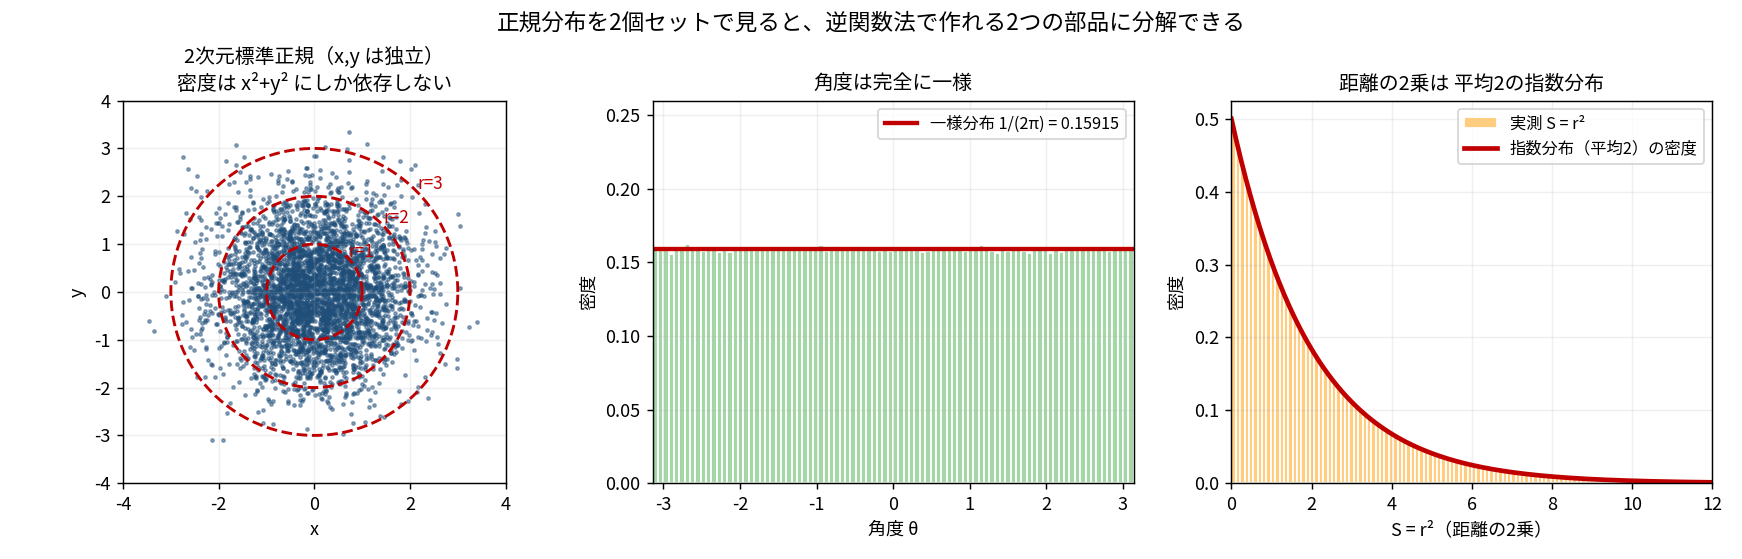
| 確かめた量 | 実測(150万点) | 理論値 |
|---|---|---|
| の平均 | 2.00161 | 2 |
| の分散 | 4.01504 | 4 |
| 0.39325 | 0.39347 | |
| 0.63179 | 0.63212 | |
| 角度の平均 | −0.00098 | 0 |
| 角度の標準偏差 | 1.81375 | 1.81380() |
上の表の角度は arctan2 の で測っているので平均が 0 になります。あとで出てくる手続きの は で平均は ですが、幅が の一様分布なら向きの取り方が違うだけで、標準偏差は同じ です。
ここで話が終わっています。 分解して出てきた2つの部品は、どちらも簡単に作れるものでした。
- 角度 → 一様分布。 をそのまま 倍するだけ
- 距離の2乗 → 平均2の指数分布。逆関数法が使える()
正規分布そのものには逆関数法が使えないのに、2個セットにして極座標で見ると、逆関数法が使える部品に分解できたわけです。
なぜ極座標にすると指数分布が出るのか — ここがヤコビアン
第4回の変数変換では、変数を取り替えるときに「面積の伸び縮み」を補正する必要がありました。極座標では
この がヤコビアンです。ヤコビアン行列の行列式を数値で確認しておきます。
| 行列式(数値計算) | 理論値 | ||
|---|---|---|---|
| 0.5 | +0.3 | 0.5000000000 | 0.5 |
| 1.0 | +1.0 | 1.0000000000 | 1.0 |
| 2.0 | +2.5 | 2.0000000000 | 2.0 |
| 3.0 | −1.2 | 3.0000000000 | 3.0 |
これを密度に掛けると、こうなります。
さらに と置くと なので、
平均2の指数分布です。ヤコビアンの が、 と置いたときの にちょうど吸収されました。 これが「距離の2乗が指数分布になる」理由です。
なお は定義から自由度2のカイ二乗分布です。つまり 平均2の指数分布。第7回で扱ったカイ二乗分布と、ここで出てきた指数分布が同じものだった、という同一視です。準1級では問われやすい形なので押さえておきます。
手続き
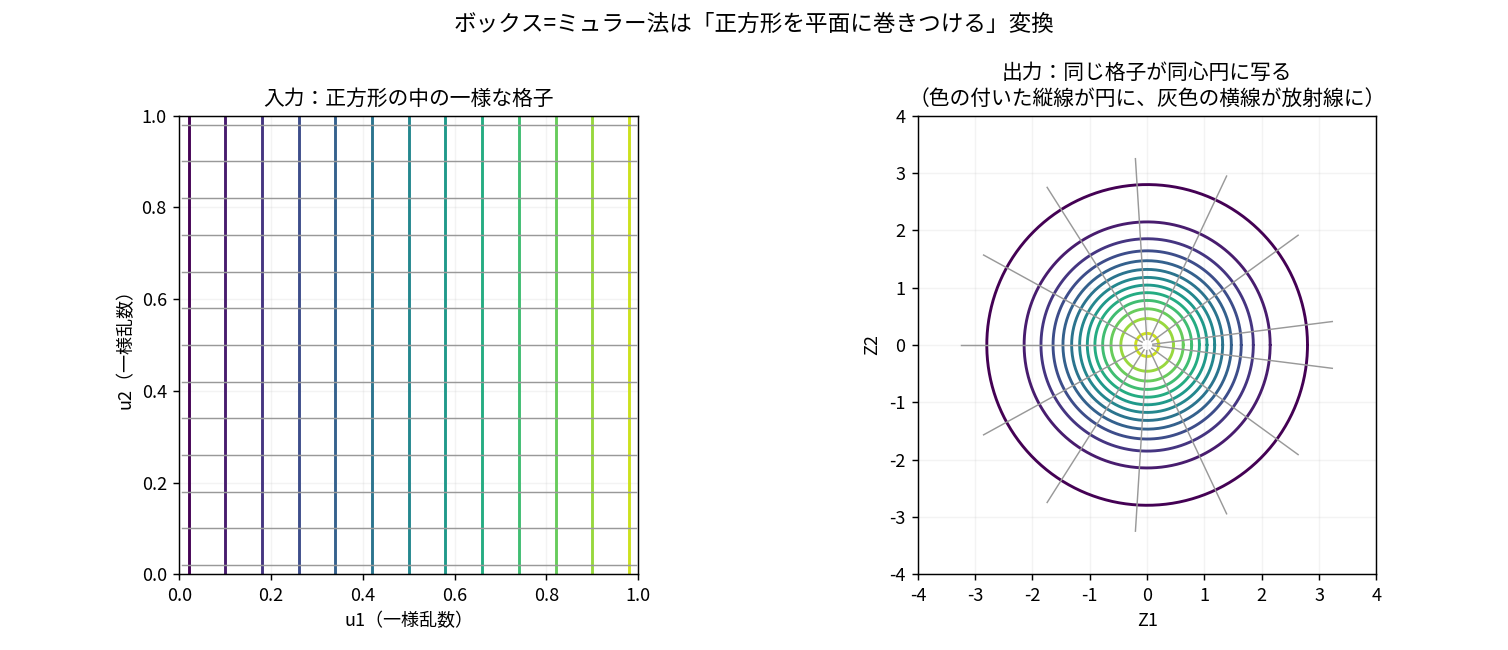
色つきの縦線が同心円に、灰色の横線が放射線に写ります。 が小さいほど大きな円になる( で反転するため)。「正方形を平面に巻きつける」変換だと見ると直感的です。
| 確かめた量 | 実測(150万個) | 理論値 |
|---|---|---|
| 平均 | −0.000641 | 0 |
| 分散 | 1.000397 | 1 |
| 歪度 | −0.002613 | 0 |
| 尖度 | 2.998226 | 3 |
| 0.682525 | 0.682689 | |
| 0.950043 | 0.950004 | |
| 0.989980 | 0.989999 | |
| と の相関 | 0.000459 | 0(独立) |
効率を比べます。
| 方法 | 正規乱数1個あたりに必要な一様乱数 |
|---|---|
| 棄却法(長方形 ) | 6.383 個 |
| 棄却法(コーシー分布で覆う) | 3.041 個(うち1個はコーシー乱数の生成に使う) |
| ボックス=ミュラー法 | 1.000 個(無駄ゼロ) |
ヤコビアンの を落とすと壊れる
「 を指数分布にする」を間違えて「 自体を指数分布にする」とどうなるか、実演しました。
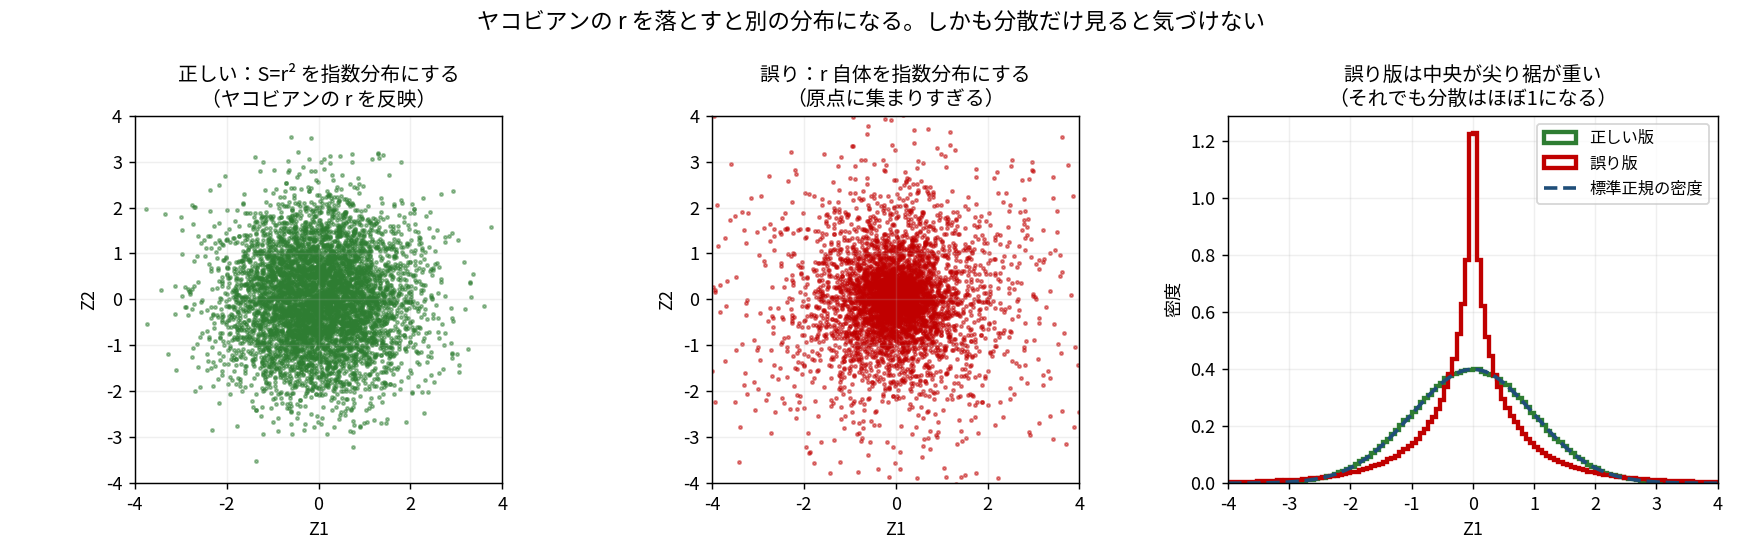
| 量( 万) | 正しい版 | 誤り版( を落とした) | 標準正規の理論値 |
|---|---|---|---|
| 平均 | −0.00069 | −0.00149 | 0 |
| 分散 | 0.99914 | 1.00147 | 1 |
| 尖度 | 3.0090 | 9.1698 | 3 |
| 0.95025 | 0.93538 | 0.95000 | |
| 0.07969 | 0.21826 | 0.07966 |
注目してほしいのは分散の行です。誤り版でも分散 1.00147 で、ほぼ 1 になっています。 偶然ではなく、平均1の指数分布の2次モーメントが 2 なので になるためです。
この「分散だけ合う」現象は (平均1)にした場合に限ります。 をそのまま にすると で分散4になり、すぐに気づけます。
なお尖度も理論値が出ます。、 なので 、つまり尖度は9。実測 9.1698 と整合しています。だから間違い方によって発見しやすさが変わるのが厄介なところです。
「平均と分散を確認したから合っている」では、この誤りを検出できません。 尖度(3 vs 9.17)と原点付近の割合(7.97% vs 21.83%)を見て初めて分かります。この連載で何度も踏んだ罠、理論値と一部が一致するとバグが隠れるが、ここにも出ていました。
擬似乱数は本当にランダムなのか
答えはまったくランダムではありません。 完全に決定的な漸化式です。線形合同法なら
同じ種(シード)を入れれば必ず同じ列が出ます。有限個の状態しかないので、いつか必ず一周します。
周期を実際に数えた
| 周期 | に対する割合 | |||
|---|---|---|---|---|
| 5 | 3 | 16 | 16 | 100% |
| 3 | 1 | 16 | 8 | 50% |
| 9 | 0 | 16 | 2 | 12.5% |
| 65539 | 0 | 256 | 64 | 25% |
| 65539 | 0 | 65536 | 16384 | 25% |
パラメータ次第で周期が よりずっと短くなります。 は周期 2、つまり2つの値を往復するだけです。
| 生成器 | 周期 | 実用上 |
|---|---|---|
| RANDU(1960〜70年代の IBM で標準) | 毎秒10億個なら1秒足らずで一周する。現代では足りない | |
| 線形合同法 (glibc の簡易版) | 同様に不足。なお glibc の rand() は既定では加算的フィードバック方式で周期は約 | |
| メルセンヌツイスタ | 尽きない | |
| numpy の既定(PCG64) | 毎秒10億個で 年 |
結論として、現代の生成器では周期は問題になりません。 問題になるのは別の2つです。
本当の問題①:規則性は次元を上げると見える
RANDU の有名な欠陥を再現しました。この生成器は次の関係を厳密に満たしてしまいます。
実際に計算すると ()でした。つまり3つ連続で取ると、必ず平面上に乗ります。
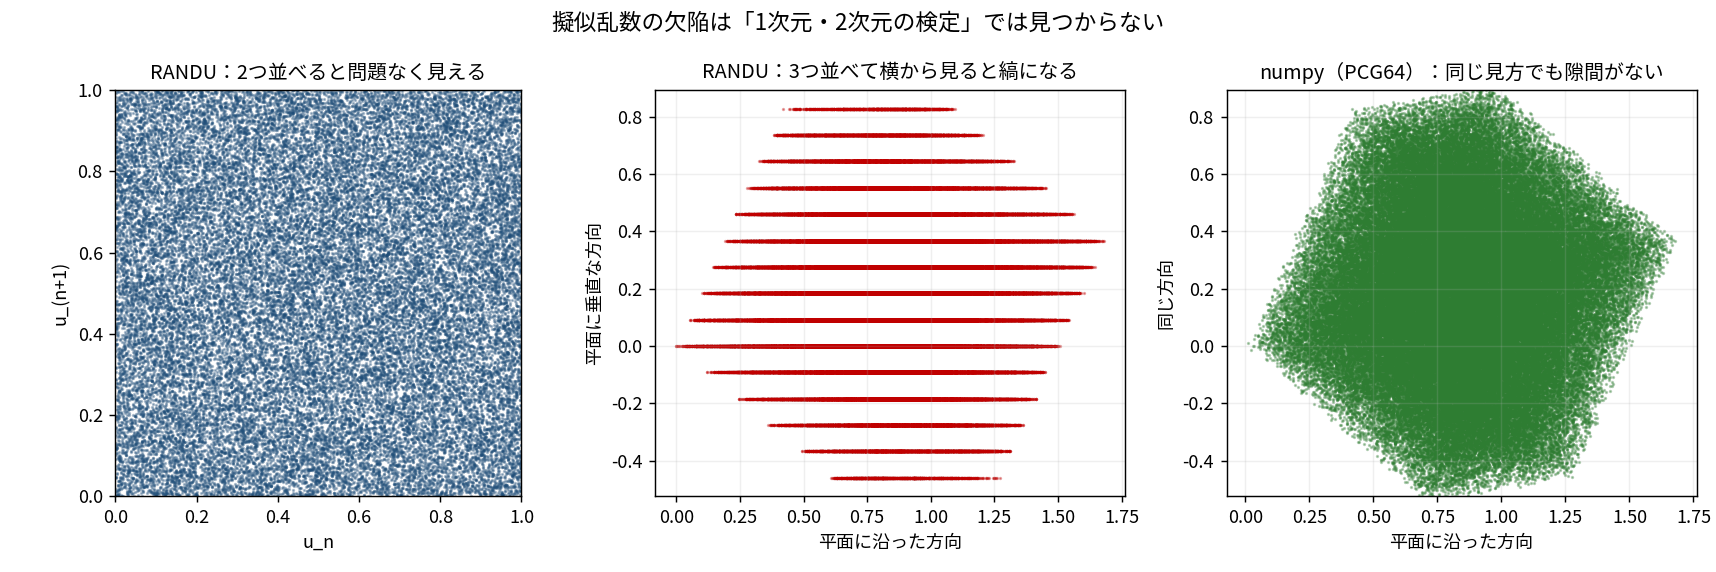
| 検査 | RANDU | 判定 |
|---|---|---|
| 平均 | 0.501851(理論 0.5) | 合格 |
| 分散 | 0.083438(理論 0.083333) | 合格 |
| 10区間の適合度 | 10.338(自由度9の5%点 16.92) | 合格 |
| 3次元での平面の枚数 | 15 枚のみ | 不合格 |
| (PCG64 の同じ量の種類) | 119,375 通り | 合格 |
1次元の検定は全部通ります。 平均・分散・度数分布はどれも問題なし。欠陥は3次元にして初めて見えます。
これは連載で繰り返し出てきた構造と同じです。低次元の要約統計量が合っていても、高次元の構造は壊れていることがある。 そして今回のボックス=ミュラー法でも、 を落とした版が「分散 1.00147」で合格してしまいました。同じ罠です。
本当の問題②:シードと再現性
| シードを固定する理由 | この連載での実例 |
|---|---|
| 検証・査読ができる | 記事の数値を再実行して照合する(毎回やっている) |
| デバッグできる | おかしな結果が出た回を再現して調べる |
| 結果の安定性を確認できる | シードを変えて標準偏差が 655 → 2814 に暴れたのを発見(後述) |
落とし穴が2つあります。
「シードを固定したから再現できる」は、同じライブラリの同じバージョンでしか成り立ちません。 numpy も 1.17 で新しい API(default_rng = PCG64)が入り、推奨が RandomState(メルセンヌツイスタ)から切り替わりました。後方互換のため np.random.rand などのトップレベル関数は今もメルセンヌツイスタなので、古いコードの出力が変わったわけではありません。数値を公開するときは生成器の名前も書くのが安全です。
もう1つは並行実行です。同じシードで複数プロセスを走らせると全部が同じ列を使い、実質的なサンプル数が増えません。numpy では SeedSequence や rng.spawn() で分岐させます。
第2部 乱数を「使う」技術
そもそも何のために乱数を使うのか
第1部で「任意の分布から乱数を作れる」ことが分かりました。しかしそれだけでは変な数字の列が手に入るだけです。そこから結論を出すには、もう1本の柱が必要でした。
| 柱 | やること | 根拠 |
|---|---|---|
| ① 任意の分布から乱数を作れる | 一様乱数 → 好きな分布 | 逆関数法・棄却法・ボックス=ミュラー法(第1部) |
| ② 作った乱数の平均が真の値に近づく | 20万個の平均 ≒ 期待値 | 大数の法則(第8回) |
この連載でずっとシミュレーションで検証してきた正当性は、②の大数の法則です。 ①だけでは入力が作れるだけ、②だけでは入力がない。両方が揃って初めて「シミュレーションで確かめた」と言えます。
そして①が必要になるのは、ライブラリに無い分布を扱うときです。実例で見ます。
題材:ブログ記事のPV
このブログの記事ごとのPVを題材にします。1記事あたりのPVはパレート分布(べき乗則)で表せることが多く知られています。最低10PV、形状パラメータ としました。
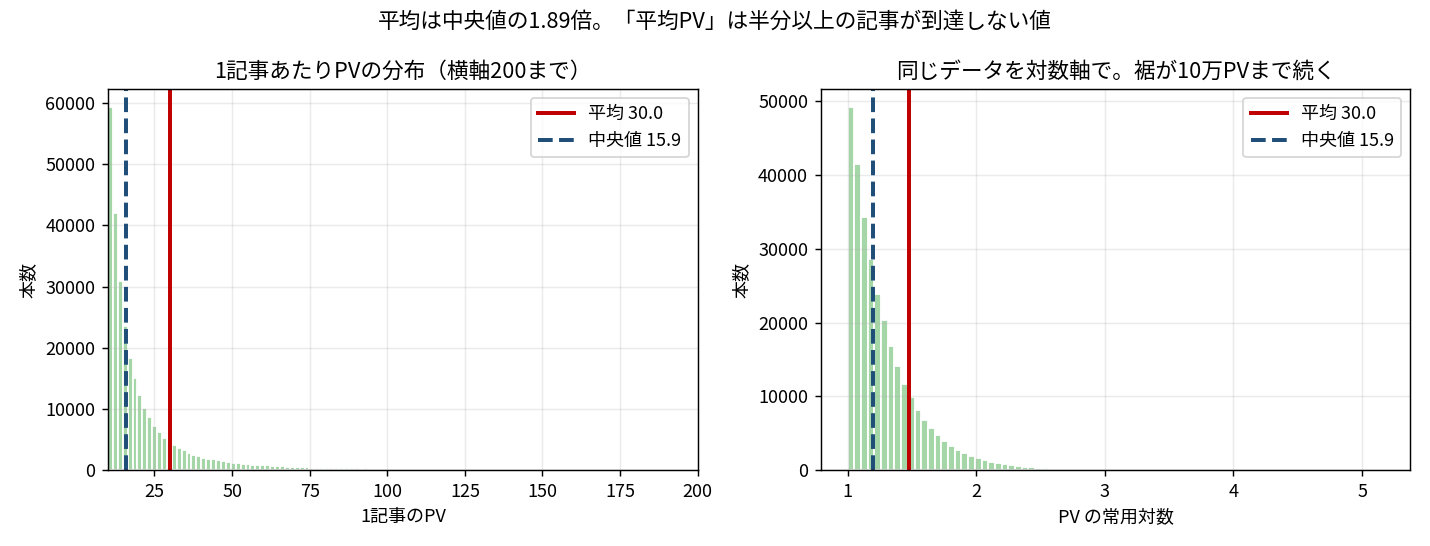
| 量 | 実測(30万本) | 理論値 |
|---|---|---|
| 平均 | 29.8734 | 30.0000 |
| 中央値 | 15.9024 | 15.8740 |
| 平均 ÷ 中央値 | — | 1.890 倍 |
平均は中央値の1.89倍で、平均PVは半分以上の記事が到達しない値です。
見つかったこと1:標準偏差を報告してはいけない
「20本書いたら合計PVはいくらか」を平均 ± 標準偏差で出そうとしました。シードだけ変えて3回。
| 試行 | 合計PVの平均 | 標準偏差 | 中央値 |
|---|---|---|---|
| 1(seed 500) | 602.5 | 2813.7 | 488.8 |
| 2(seed 501) | 597.3 | 655.3 | 491.8 |
| 3(seed 502) | 596.2 | 794.2 | 489.8 |
平均(596〜603)と中央値(489〜492)は安定しているのに、標準偏差だけが4倍以上ばらつきます。 のパレート分布は なので母分散が無限です。存在しない量を測ろうとしているので、値が落ち着きようがありません。
1回だけ回して「合計PVは約600、標準偏差は約2800」と書いていたら、次に測ったとき655になって説明できなくなります。シミュレーションを2回以上回すと、この種の事故が見つかります。
見つかったこと2:精度が で上がらない
連載でずっと「精度はルートでしか上がらない」と扱ってきましたが、この分布では成り立ちません。標準偏差そのものが不安定なので、ばらつきは四分位範囲で測っています。
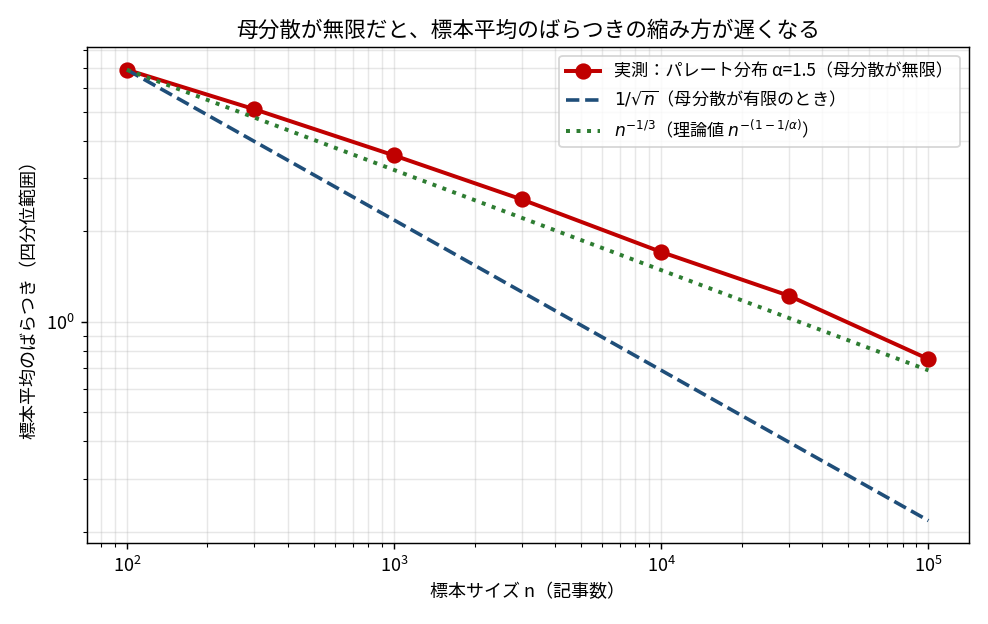
| (記事数) | 標本平均の四分位範囲 | 前の からの縮み |
|---|---|---|
| 100 | 6.8988 | — |
| 300 | 5.0968 | 1.354 倍 |
| 1,000 | 3.5784 | 1.424 倍 |
| 3,000 | 2.5562 | 1.400 倍 |
| 10,000 | 1.7080 | 1.497 倍 |
| 30,000 | 1.2224 | 1.397 倍 |
| 100,000 | 0.7521 | 1.625 倍 |
両対数での傾きは −0.318。 なら −0.5、 なら −0.3333 です。実測は後者に沿っています。
理屈はこうです。 で母分散が無限なので、中心極限定理の前提(分散が有限)が崩れています。 のとき、 の大きさは ではなく で伸びます( 安定分布への収束。パレート分布では形状パラメータがそのまま裾指数になります)。だから標本平均のばらつきは 。 なら です。
なら分散が有限なので通常の に戻り、 では平均そのものが存在しません( はちょうど が発散する境界で、分散は無限のままです。sympy で確認しました)。 この式が意味を持つのは のときだけです。
を10倍にしても、ばらつきは 3.16 分の1ではなく 2.15 分の1にしかなりません。 理論値は( のもとで) です。
この結論を理論だけで出すには安定分布と裾指数の理論が必要ですが、シミュレーションなら10行で出ます。そして実務上の意味は明確です。PVのような裾の重いデータでは、記事数を増やしても平均の精度が想定ほど上がりません。
見つかったこと3:ここで逆関数法が必須になる
上の分析には非現実的な前提があります。1記事が100万PVになる可能性を許していること。現実にはそんな記事は出ません。
そこで「上限 で切ったパレート分布」が必要になります。これは numpy に存在しない分布です。 逆関数法なら累積分布関数を で正規化して解き直すだけです。
上限を 1万 / 5万 / 100万 PV の3通りで比べます。(なおこのあとの節では、第1部の実演でも使った上限200PV版に戻します。 このブログの実測レンジに寄せた設定で、厳密値が手計算できるので検算に向いているためです。以降「上限200PV」と書いてある数値はすべてそちらです。)
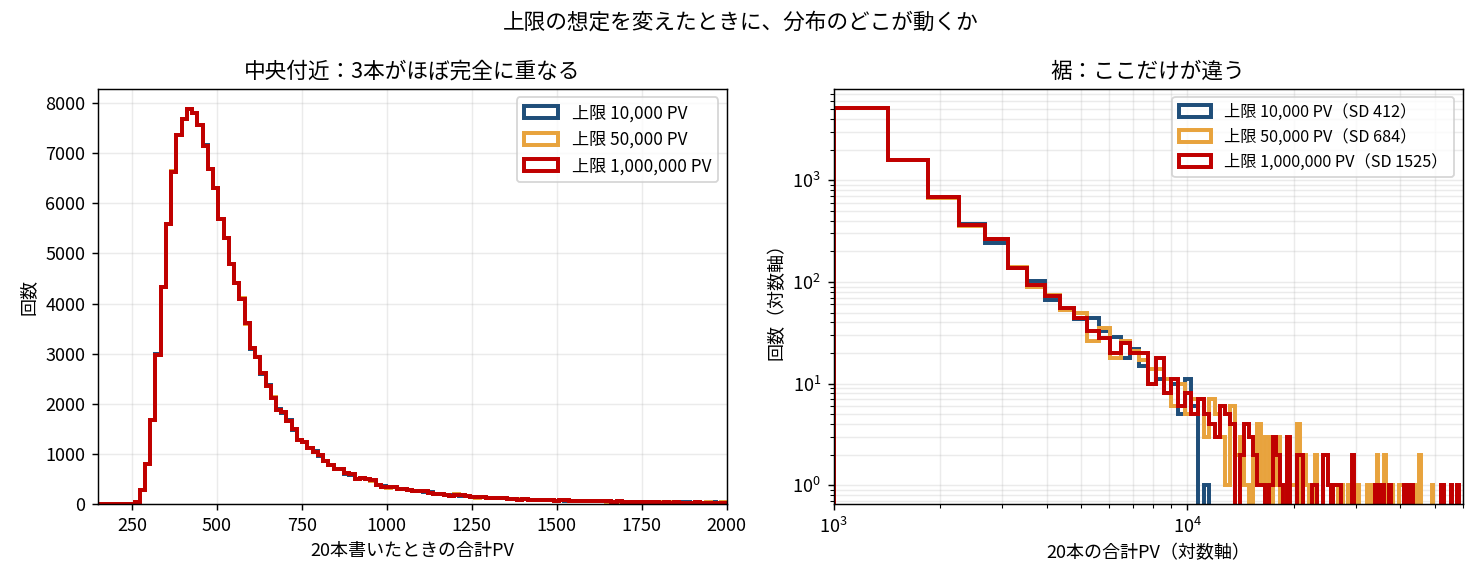
| 上限の想定 | 平均 | 中央値 | 90%点 | 99%点 | 99.9%点 | 標準偏差 |
|---|---|---|---|---|---|---|
| 10,000 PV | 581.7 | 490.5 | 825 | 2079 | 6011 | 412 |
| 50,000 PV | 593.4 | 490.6 | 827 | 2130 | 7952 | 684 |
| 1,000,000 PV | 602.8 | 490.6 | 827 | 2136 | 8253 | 1525 |
中央値は 490.5 / 490.6 / 490.6 でほぼ完全に一致し、90%点も 825 / 827 / 827。ところが標準偏差は 412 → 684 → 1525 と3.7倍動きます。
上限をどこに置くかという検証しにくい仮定が、中央値には影響しないのに標準偏差にはまるごと乗ってしまう。だから中央値と90%点で語れば、仮定が結論に入りません。
これは「どの要約統計量を報告するか」という実務判断です。シミュレーションが答えを出したのではなく、仮定を1つ動かして、結論のどこが動くかを見せたわけです。
1変数なら数値積分に完敗する
ここで、私が最も思い違いをしていたことを書きます。モンテカルロ法は速くも正確でもありません。
「1記事の期待PV」を求めます。逆関数法で乱数を作って平均する方法と、同じ積分を等間隔グリッドで計算する方法を、同じ計算回数で比べます。
実は両者はまったく同じ積分を計算しています。
モンテカルロ法は を乱数で置き、グリッドは等間隔に置く。点の置き場所が違うだけです。 厳密値は 23.5551506580(上限200PVのパレート分布)。
| グリッド推定 | 誤差 | モンテカルロ推定 | 誤差 | |
|---|---|---|---|---|
| 100 | 23.509923 | 4.52e−02 | 22.209464 | 1.35e+00 |
| 1,000 | 23.554660 | 4.91e−04 | 23.995552 | 4.40e−01 |
| 10,000 | 23.555146 | 4.91e−06 | 23.751254 | 1.96e−01 |
| 100,000 | 23.555151 | 4.91e−08 | 23.644453 | 8.93e−02 |
| 1,000,000 | 23.555151 | 4.91e−10 | 23.623753 | 6.86e−02 |
100万回使って、グリッドは誤差 、モンテカルロは 。1億倍以上の差でモンテカルロの負けです。
1つ補足します。上の表のモンテカルロ列は単一のシードでの実現値なので、たまたま大きく振れている可能性があります。この分布の標準偏差は厳密に ( から)なので、 での典型的な誤差は 。表の 0.0686 は3σ程度の外れです。典型値で比べても 倍で、桁の主張は変わりません。
つまり1変数なら、乱数を使うのは点の置き場所をわざわざ雑にしているだけでした。等間隔に置いたほうがムラがなく、はるかに速く収束します。
逆転するのは次元
ではなぜモンテカルロ法が使われるのか。誤差の減り方の法則が違うからです。滑らかな被積分関数で、次元だけを変えて実測しました。
先に前提を書いておきます。ここでのグリッドは中点則(2次精度)のテンソル積で、 という指数はそのことと被積分関数が2階微分可能であることから出ます。指示関数のような不連続な量(確率の推定)では に落ちるので、後で出てくる交差点の位置も変わります。
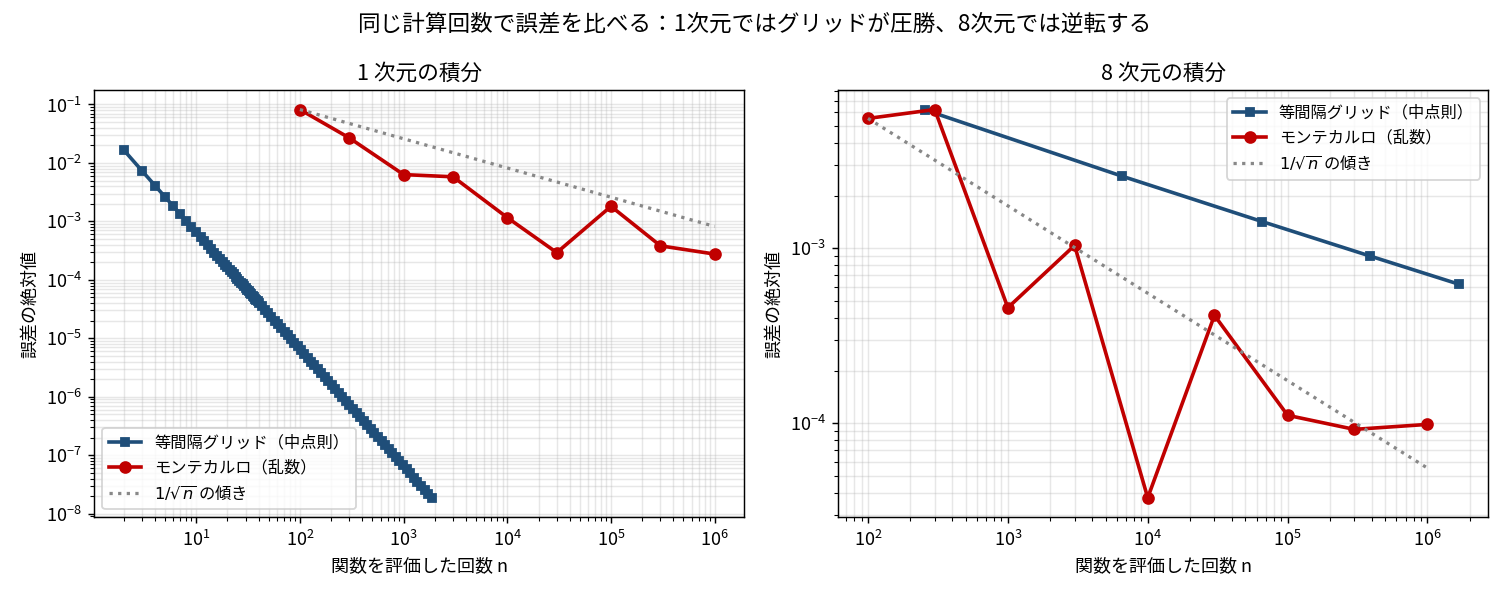
左(1次元)では青のグリッドが赤を圧倒し、右(8次元)では入れ替わっています。 要点は、赤の傾きが左右で変わっていないことです。
| 次元 | グリッドの傾き(実測) | 理論値 | モンテカルロの傾き(実測) | 理論値 |
|---|---|---|---|---|
| 1 | −2.001 | −2.000 | −0.593 | −0.500 |
| 2 | −1.001 | −1.000 | −0.434 | −0.500 |
| 4 | −0.503 | −0.500 | −0.574 | −0.500 |
| 8 | −0.261 | −0.250 | −0.472 | −0.500 |
グリッドの指数は理論どおり で、次元が上がるとどんどん 0 に近づきます(=収束しなくなる)。モンテカルロは のまま動きません。
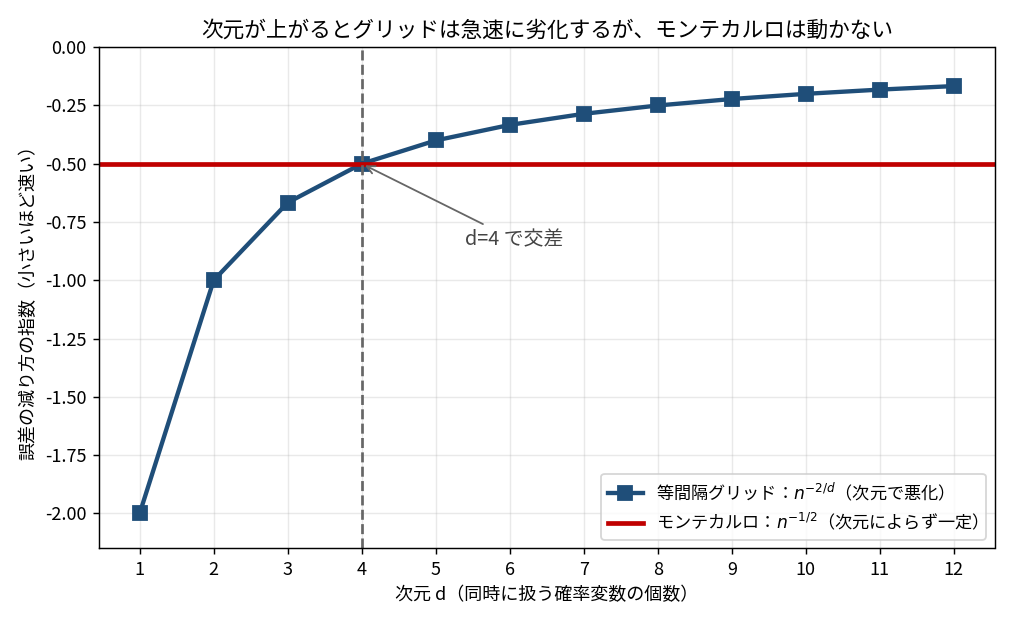
同じ計算回数(おおむね )での誤差を並べます。グリッドは軸あたりの点数 に対して しか取れないので、 をぴったり揃えられません。 は (1次元では点を増やすと誤差が浮動小数の下限に達するので打ち切り)、 は 1,144,900、 は 1,185,921、 は 390,625()です。
| 次元 | グリッドの誤差 | モンテカルロの誤差 | 勝者 |
|---|---|---|---|
| 1 | 1.87e−08() | 2.76e−04 | グリッド(約1.5万倍) |
| 2 | 7.28e−08 | 4.61e−04 | グリッド |
| 4 | 6.20e−05 | 5.84e−05 | ほぼ互角 |
| 8 | 9.03e−04() | 9.85e−05 | モンテカルロ(約9.2倍。 を に揃えても約7.3倍) |
この滑らかな例で交差するのは です。 不連続な量(確率)ならグリッドは なので、交差点は まで下がります。
次元が上がるとグリッドは軸ごとに点を掛け算しなければならず、点が指数関数的に必要になります。 で軸10点なら 回の評価で、1秒に10億回計算しても3175年かかります。同じ問いにモンテカルロは200万回・数秒で答えます。
これが「 が高次元で有利になる」の中身でした。 は「遅い」のではなく「次元に鈍感」という長所だったのです。
モンテカルロ法も次元の呪いを受ける(ただし別の場所で)
では、モンテカルロ法は次元の呪いから自由なのか。自由ではありません。ただし呪いが出る場所が違います。
モンテカルロ法の誤差はこう分解できます。
グリッドと比べたのは の部分で、これは次元に対して不変でした。呪いは のほうに出ます。 そして が次元とともにどう動くかは、何を推定しようとしているかで正反対になります。
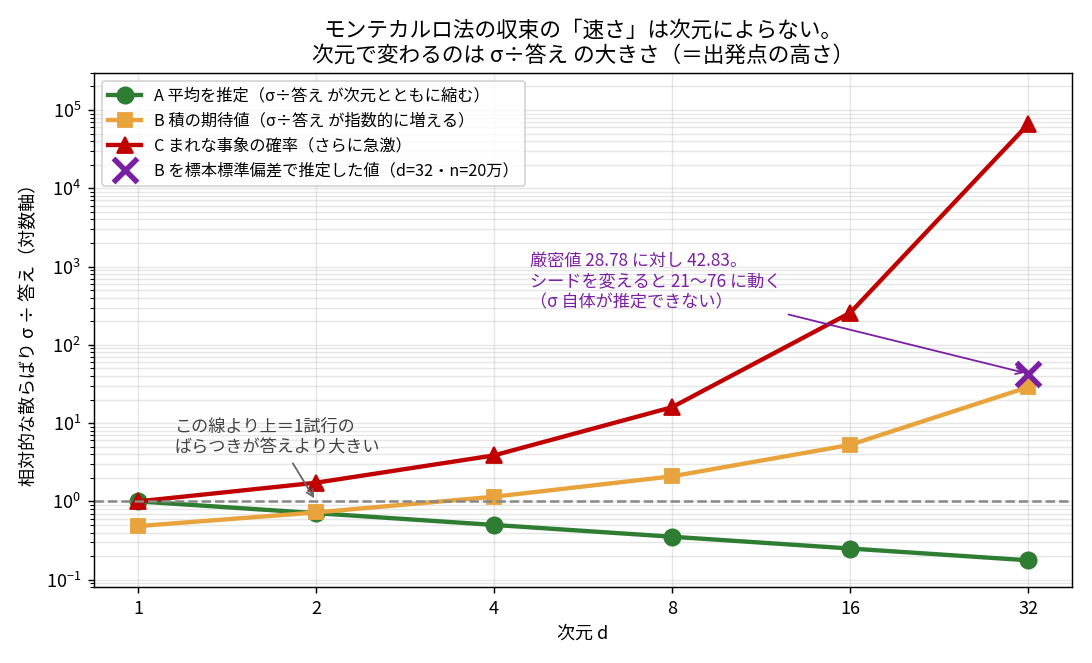
3つとも閉じた式が出るので、厳密値を並べます。A は 、B は 、C は です。
| 次元 | A 平均を推定() | B 積の期待値() | C まれな事象の確率() |
|---|---|---|---|
| 1 | 1.0000 | 0.4834 | 1.00 |
| 2 | 0.7071 | 0.7225 | 1.73 |
| 4 | 0.5000 | 1.1474 | 3.87 |
| 8 | 0.3536 | 2.0896 | 15.97 |
| 16 | 0.2500 | 5.2723 | 256.00 |
| 32 | 0.1768 | 28.7802 | 65536.00 |
A の実測値( 万)は 0.9987 / 0.7109 / 0.5031 / 0.3553 / 0.2506 / 0.1769 で厳密値と一致しました。ところが B を標本標準偏差で推定すると、 だけ 42.83 という値が出ます。厳密値 28.78 の1.5倍です。
シードを変えて8回測り直したら 42.83 / 22.41 / 21.19 / 28.64 / 76.24 / 26.34 / 22.33 / 33.18 と3倍以上ばらけました( では 5.19〜5.33 で安定していて、厳密値 5.272 の近傍にいます)。原因は の での尖度が もあることで、 そのものが推定できない領域に入っています。
この表を作るとき、私自身がこの章の主題を踏みました。 「 が指数的に増える」という定性的な主張は正しいのですが、その を標本標準偏差で1回測って表に載せていました。母分散が無限のときに標準偏差が暴れる話(さきほどのパレート分布)と、まったく同じ構造です。閉じた式があるなら使うべきでした。
A:次元が上がるほど良くなるケース
「 個の値の平均」を推定する問いです(ここでは1個を平均1の指数分布としたモデル例で測っています)。1回の試行で 個の平均を取るので、試行の中身自体が 個の平均化になっており(独立なら) が で縮みます。 実測でも で に対して 0.1769 でした。
ただし正確に言うと、A は「同じ積分の次元だけを変えた」のではなく、 が上がると推定したい量そのものが安定する型です。「高次元の積分が楽になる」のではありません。
ここまで見てきた20本の記事の問い(合計・分位点・シェア)は、すべてこのA型でした。 だから20次元でも40万回で安定した答えが出ていたわけです。
B:積の形はまずい
個の量の積の期待値 を推定する型です。ここでは (真値 )を使いました。
積は1つでも小さい値を引くと全体が小さくなるので、1試行の値が桁で暴れます。 そのうえ答え 自体が とともに指数的に小さくなるため、 が指数的に増えていきます( なので、 が1増えるごとに約1.11倍)。
実務でこの形が出るのは尤度の積や経路の確率です。対策は「対数を取って和に直す」か「逐次モンテカルロ法(粒子フィルタ)で途中でリサンプリングする」です。
C:次元が上がるほど悪くなるケース
「 次元の一様乱数がすべて 0.5 未満」という確率 を素朴に数えます。
| 真値 | での命中数 | 推定値 | 相対誤差 | |
|---|---|---|---|---|
| 4 | 6.250e−02 | 62,728 | 6.273e−02 | 0.36% |
| 8 | 3.906e−03 | 3,844 | 3.844e−03 | 1.59% |
| 12 | 2.441e−04 | 258 | 2.580e−04 | 5.68% |
| 16 | 1.526e−05 | 15 | 1.500e−05 | 1.70%(後述) |
| 20 | 9.537e−07 | 0 | 0 | 100% |
| 24 | 5.960e−08 | 0 | 0 | 100% |
で命中が1件も出ず、推定値が 0 になります。
の相対誤差 1.70% が の 5.68% より良く見えますが、これは偶然です。期待される命中数が 15.26 件のところ実際に 15 件出ただけで、次に回せば 8 件や 22 件になります。命中数が2桁を切ったら、相対誤差の数値は運です。
相対誤差10%に必要な で計算すると、
| 必要な | ||
|---|---|---|
| 10 | 9.77e−04 | 1.02e+05 |
| 20 | 9.54e−07 | 1.05e+08 |
| 50 | 8.88e−16 | 1.13e+17 |
| 100 | 7.89e−31 | 1.27e+32 |
指数関数的な悪化、つまりまさに次元の呪いです。
それでも「傾き」は3つとも
ここが精密にしておきたい点です。A も B も C も、 を増やしたときの減り方の法則は同じでした。250回反復して二乗平均平方根誤差(RMSE = Root Mean Squared Error)を測りました。
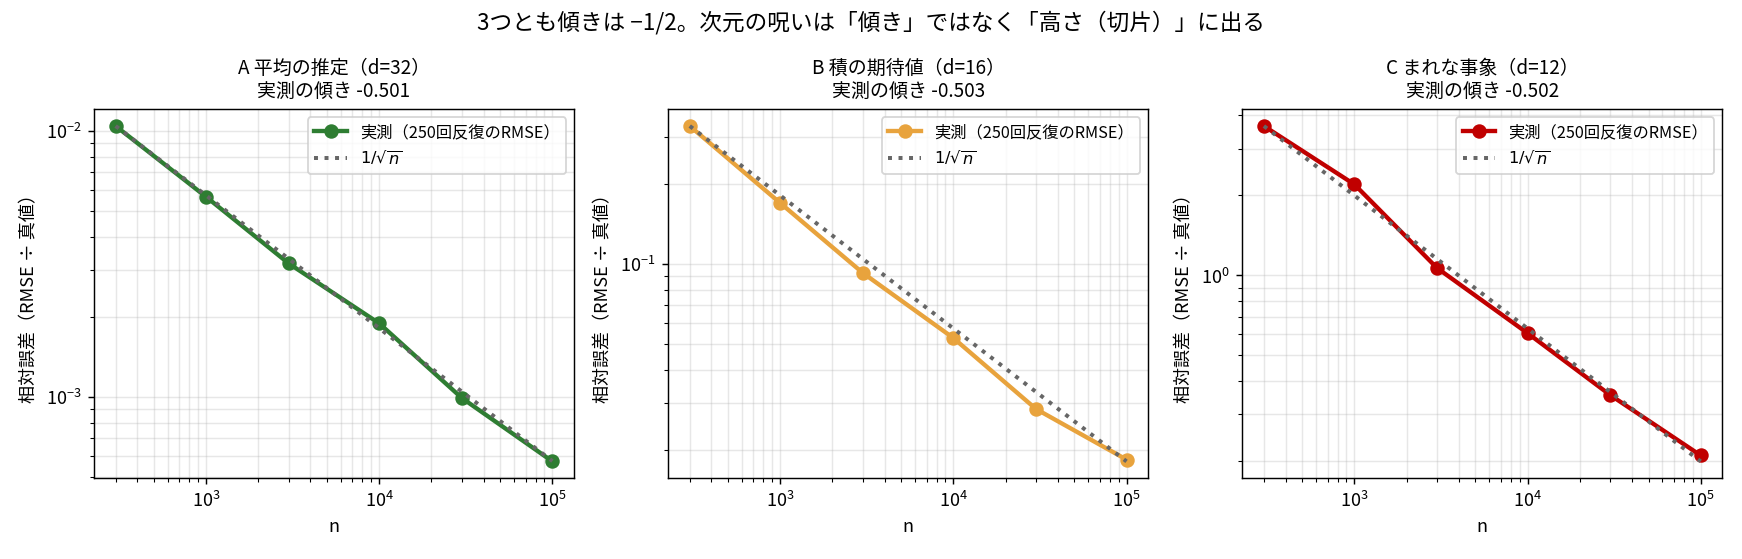
| ケース | 実測の傾き | での相対誤差 | での相対誤差 |
|---|---|---|---|
| A 平均の推定() | −0.5014 | 1.047e−02 | 5.718e−04 |
| B 積の期待値() | −0.5031 | 3.297e−01 | 1.834e−02 |
| C まれな事象() | −0.5015 | 3.648e+00 | 2.105e−01 |
3つとも傾きは で、灰色の の線と平行です。違うのは線の高さ(出発点)だけでした。
言い換えるとこうなります。
| 呪いの現れ方 | 意味 | |
|---|---|---|
| グリッド | グラフの傾きが寝る | を増やしても改善しない体質になる |
| モンテカルロ | グラフが上に平行移動する | 傾きは同じだが出発点が絶望的に高い |
モンテカルロ法の呪いは「 を増やせば必ず解決する。ただし必要な が天文学的」という形をとります。 体質は健全なのに要求量が非現実的。グリッドは を増やしても体質自体が治りません。
20次元の問いに、何が答えられるか
「 が計算できるなら、わざわざ乱数を使う必要はないのでは」という疑問が自然に出ます。半分は正しく、上で見たとおり1変数なら乱数は不要です。
分かれ目は「 が計算できるか」ではなく「知りたい量が何変数の積分か」でした。
同じ設定(上限200PVのパレート分布・20本)で、式で書ける問いと書けない問いを並べます。1記事の期待PVは (厳密)です。
式で書ける問い(乱数は不要)
| 問い | シミュレーション | 厳密な式 |
|---|---|---|
| 20本で1本でも150PVを超える確率 | 0.11499 | |
| 20本の合計PVの期待値 | 471.162 |
期待値は線形なので次元が実質1に落ちます。最大値も「全部が150以下」に分解できて積になります。
が完全に分かっていても式が書けない問い
| 問い | 答え(40万回) | なぜ式にならないか |
|---|---|---|
| 合計PVの分位点 | 中央値 456.4 / 90%点 606.2 / 99%点 758.4 | 20回の畳み込み。パレート分布の和は閉じた式にならない |
| 最大の1本が合計の何%を占めるか | 中央値 17.1% / 平均 18.2% / 95%点 30.1% | 最大値と合計の比の分布。同時分布が必要 |
| 上位3本を除いた17本が全体の何%か | 中央値 62.6% / 平均 62.0% | 順序統計量の部分和の比 |
この2つの表の対比が答えです。 合計PVの期待値は1行の式で出ます(471.103)。しかし合計PVの中央値(456.4)は出ません。期待値は足し算に分解できるが、分位点は分布の形そのものを要求するからです。
そして実務で使うのは分位点のほうでした。期待値 471.103 は中央値 456.4 より大きく、半分以上の「20本セット」が到達しない値だからです。
本数を変えたときの見通し(上限200PVのパレート分布・20万回。すべて20〜80次元の積分で、1つも式では出ません。20本の行が上の表と 456.4 対 456.2 でわずかに違うのは、反復回数とシードが違うためです)
| 本数 | 合計の中央値 | 90%点 | 変動係数 | 最大1本のシェア中央値 |
|---|---|---|---|---|
| 10本 | 219.7 | 334.1 | 0.301 | 24.7% |
| 20本 | 456.2 | 605.9 | 0.212 | 17.1% |
| 40本 | 927.3 | 1129.8 | 0.150 | 11.4% |
| 80本 | 1869.5 | 2146.3 | 0.106 | 7.2% |
本数を8倍にすると合計の中央値は 8.5 倍(ほぼ比例)ですが、変動係数は 0.301 → 0.106 と3分の1に落ち、1本の当たり記事への依存度も 24.7% → 7.2% に下がります。 「本数を増やすと当たり待ちのギャンブル性が薄まる」という定量的な結論です。
| 知りたい量 | 実質の次元 | 使うべき道具 |
|---|---|---|
| 1変数の期待値・確率・分位点 | 1 | 数値積分(グリッド) |
| 和の期待値、最大値の確率 | 1に分解できる | 閉じた式 |
| 和の分位点、比の分布、順序統計量の部分和 | (20など) | 逆関数法+モンテカルロ法 |
が計算できることは、逆関数法を使わない理由ではなく逆関数法を使える前提のほうでした。 が書けないと逆関数法自体が動きません。
分散減少法:乱数の置き方を変える
は、母分散が有限で、点を独立に 個引くかぎり変えられません。この2つの条件が破れると話が変わります。母分散が無限なら遅くなる(さきほどのパレート分布の )。そして点を独立に引くのをやめれば速くなります。
つまり分散減少法には2つの型があります。
| 型 | 手法 | 効果 |
|---|---|---|
| 定数倍しか改善しない | 対照変量法・制御変量法・重点サンプリング | の傾きは変わらず、(=線の高さ)が下がる |
| 収束の次数が変わりうる | 層別サンプリング・準モンテカルロ法 | 傾きそのものが変わる(後で実測します) |
それが分散減少法という一群の技術でした。
素朴なモンテカルロ法の弱点は、乱数がムラを作ることです。24個の点を置いた図を並べます。
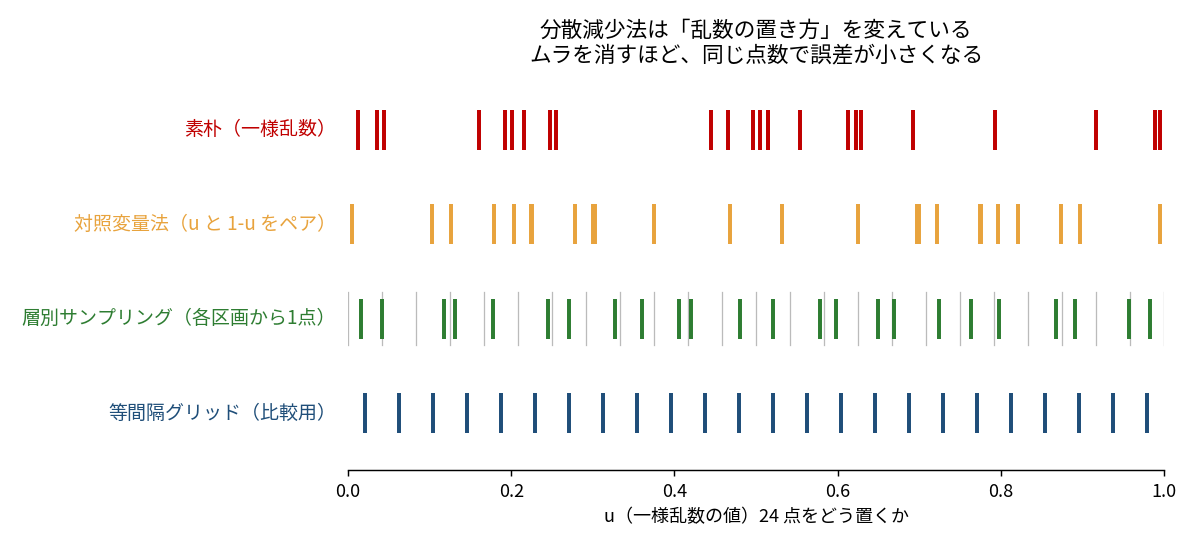
素朴(赤)は目で見て分かるほどムラがあります。 0.05〜0.15 が空白なのに 0.2 付近と 0.6 付近に固まっている。下に行くほどムラが消え、最下段のグリッドは完全に均等です。分散減少法はこの赤を青に近づける工夫だと考えると全体が見通せます。
| 手法 | 何をするか | 効く理屈 |
|---|---|---|
| 対照変量法 | を引いたら もペアで使う | 片方が上振れたら相方が下振れる。負の相関で打ち消す。ただし について単調な量に限る( のような対称な量では相関が になり、同じ評価回数なら分散が2倍に悪化します。実測 2.001 倍) |
| 層別サンプリング | を 個の区画に割り、各区画から1点だけ引く | 空白区画が生まれない。第21回の層別抽出と同じ発想 |
| 制御変量法 | 期待値が既知で相関の高い量 を用意し を測る | ズレの共通成分を引き算する。回帰の残差と同じ構造 |
| 重点サンプリング | わざと起きやすい分布から引き、重みで割り戻す | 命中率を上げる。この4つの中ではまれな事象に効く唯一の手段 |
期待値を推定するかぎり、4つとも推定値に偏りを作りません(重点サンプリングも重みで正確に補正します)。ばらつきだけを削るので、「タダで精度が上がる」ように見えます。
ただし条件が3つ付きます。重点サンプリングは提案分布の台が元の分布の台を覆うこと(後述の「6だけ出るサイコロ」は目標が だから救われているだけです)。制御変量法は係数 を別の標本で決めること(同じ標本から推定すると小さな偏りが出ます)。そして中央値や分位点の推定は、素朴法を含めてどの方法でも有限標本では厳密に無偏ではありません。
実測:効くが、問いによって桁が違う
同じ問い(20本の記事の合計PV、上限200PVのパレート分布)で、目標だけを変えて比べました。 を120回反復し、推定値の標準偏差を測っています。
目標が「和の期待値」のとき(線形)——厳密値は 471.1030 です。
| 手法 | 推定の平均 | 推定の標準偏差 | 改善倍率 |
|---|---|---|---|
| 素朴 | 471.0975 | 0.336567 | 1.00 倍 |
| 対照変量法 | 471.0717 | 0.245433 | 1.37 倍 |
| 層別サンプリング | 471.1030 | 0.000035 | 9707 倍 |
層別サンプリングが9707倍。 ただしこれは という一点での倍率です。ここでの層別サンプリングは、20次元それぞれを独立に 分割してシャッフルするラテン超方格法として実装しています。 を変えて測ると倍率自体が動きます。
| 素朴の標準偏差 | 層別の標準偏差 | 改善倍率 | |
|---|---|---|---|
| 3.6305 | 0.0326094 | 111 倍 | |
| 1.1075 | 0.00115162 | 962 倍 | |
| 0.3141 | 3.62794e−05 | 8658 倍 |
(この表は40反復での測定です。上の表は120反復なので の値がわずかに違います。)
倍率が にほぼ比例して開いていきます。 両対数の傾きを測ると素朴が −0.531(=)に対して層別は −1.477(=)でした。これは定数倍の改善ではなく収束の次数そのものが変わっているということです。
なぜこの目標でだけ桁違いに効くのか。推定している量 が完全に加法的(各座標の寄与を足しただけ)だからです。ラテン超方格法は座標ごとのムラを消すので、加法的な成分の分散をほぼ丸ごと落とせます。
目標が「和の中央値」のとき(非線形)
| 手法 | 推定の平均 | 推定の標準偏差 | 改善倍率 |
|---|---|---|---|
| 素朴 | 456.3642 | 0.400845 | 1.00 倍 |
| 対照変量法 | 456.3231 | 0.326056 | 1.23 倍 |
| 層別サンプリング | 456.3545 | 0.229640 | 1.75 倍 |
目標が「90%点」「600超の確率」のとき
| 目標 | 素朴の標準偏差 | 層別の標準偏差 | 改善倍率 |
|---|---|---|---|
| 90%点 | 0.733974 | 0.512994 | 1.43 倍 |
| 合計 > 600 の確率 | 0.000985 | 0.000672 | 1.47 倍 |
同じ手法・同じデータなのに、改善倍率が 9707 倍から 1.75 倍へ落ちました。
層別サンプリングが劇的に効いたのは、目標が期待値(=足し算)だったからです。各区画の寄与を足すという構造が層別と完全に噛み合う。ところが中央値や分位点は「並べ替えて真ん中を取る」操作で、区画ごとに分解できません。分散減少法の効果は、推定したい量の構造に依存します。
そして実務で使うのは中央値や90%点のほうでした。つまり「1.75倍のために実装を複雑にするか」という判断になります。
重点サンプリング:わざと歪めて重みで割り戻す
分散減少法の中で、重点サンプリングだけは別格です。上の4つの中では、まれな事象に効く唯一の手段だからです(ほかに分割法や交差エントロピー法がありますが、いずれも「事象の近くを重点的に引く」という同じ発想です)。ただし理屈が入りにくいので、サイコロ1個から始めます。
重みとは何か
歪んだサイコロがあって、6が出る確率を推定したいとします。素朴にやると100回振って平均2回しか6が出ないので精度が出ません。そこで6が出やすいサイコロに作り替えて振ります。
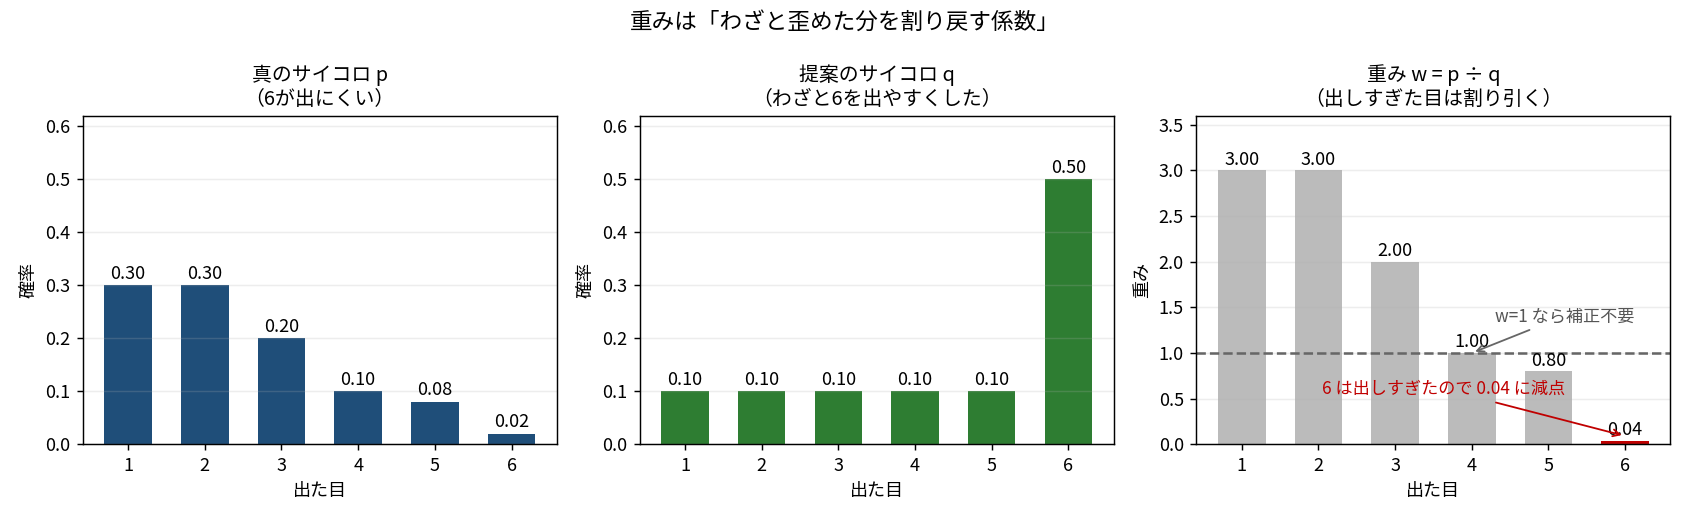
| 出た目 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 真の確率 | 0.30 | 0.30 | 0.20 | 0.10 | 0.08 | 0.02 |
| 提案の確率 | 0.10 | 0.10 | 0.10 | 0.10 | 0.10 | 0.50 |
| 重み | 3.00 | 3.00 | 2.00 | 1.00 | 0.80 | 0.04 |
重みの意味はこれだけです。
本来 0.02 しか出ないはずの目を 0.50 で出させたので、25倍ズルをした。だから1回を 回分として数える。
選挙の出口調査で、ある投票所だけ意図的に多めに調査したら、集計のときに人数比で割り戻すのと同じです。第21回の「抽出確率が違うサンプルは重みをつけて集計する」がそのまま出てきています。
提案のサイコロを10回振って、「6が出たときだけ 0.04 を記録、それ以外は 0」を記録します。
| 回 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| 出た目 | 2 | 6 | 6 | 6 | 6 | 5 | 4 | 5 | 5 | 6 |
| 記録 | 0 | 0.04 | 0.04 | 0.04 | 0.04 | 0 | 0 | 0 | 0 | 0.04 |
平均 。真値 0.02 と一致しました(この10回はちょうど6が5回出た当たり回です)。
なぜ合うのか。提案では6が10回中およそ5回()出ます。その5回に 0.04 を掛けると 。 と を掛けると が約分されて だけが残る。 これが「重みで補正する」の中身です。
| 方法 | での推定 | 標準誤差 |
|---|---|---|
| 素朴(真のサイコロを振る) | 0.020005 | 4.43e−05 |
| 重点サンプリング | 0.020003 | 6.32e−06 |
どちらも 0.02 に収束し(偏りなし)、標準誤差は7倍改善しています。
理想の提案分布は作れない
「6を出やすく」がうまくいったなら、もっと極端にしたらどうなるか。6しか出ないサイコロまで行ってみます。
| 提案 | 重み | 10回振ったときの記録 | 厳密な分散 | |
|---|---|---|---|---|
| 素朴(真のサイコロ) | 0.02 | 1.00 | たいてい全部 0 | 1.9600e−02 |
| 6を50%に | 0.50 | 0.04 | 0.04 が5個くらい | 4.0000e−04 |
| 6を75%に | 0.75 | 0.0267 | 0.0267 が7〜8個 | 1.3333e−04 |
| 6を90%に | 0.90 | 0.0222 | 0.0222 が9個 | 4.4444e−05 |
| 6だけ出るサイコロ | 1.00 | 0.02 | 0.02 が10個。全部同じ | 0(厳密に) |
| 6を1%に(逆方向) | 0.01 | 2.00 | ほぼ全部 0 | 3.9600e−02 |
6しか出ないサイコロを使うと、毎回必ず 0.02 が記録されます。全部同じ値なのでばらつきがゼロ。1回振るだけで厳密に答えが出ます。
ところがこれは使えません。重み を計算するには を知っている必要があり、そして こそが求めたい答えでした。
理想の提案分布は「答えを知っていれば、答えがそのまま重みとして毎回出てくる」というものです。すでに知っている数字を読み上げているだけなので、実際には作れません。
事象が複数の目にまたがる場合で書くと構造が見えます。「5か6が出る確率」(真値 0.10)なら、理想の提案分布は次の3ステップで作れます。
- 元の分布から事象の外(1〜4)を捨てる → 残るのは 0.08 と 0.02。合計 0.10 しかないので確率分布になっていない
- 0.10 で割って合計1に直す → 0.8 と 0.2。これが「 に条件づけた分布」
- この分布を提案に使うと、重みは 、。どちらも 0.10 で一定
②で割った数がそのまま重みとして戻ってくるだけなので、どの目でも同じ値になります。教科書の はこれを1行で書いたもので、 は「割るときに使った 0.10」つまり求めたい答えそのものです。分散は素朴法の 9.0000e−02 から 0 になります。
重みは答えを知らなくても計算できる
ここで混乱しやすい点を1つ潰しておきます。「 が分からないなら重みも決められないのでは」という疑問です。
上のサイコロの例が悪かったので補足します。あの例では「求めたい答え 」と「重みの計算に必要な個々の確率 」が同じ数字でした。だから循環しているように見える。しかも答えが仕様表に書いてあるので、そもそもシミュレーションする必要がありませんでした。
サイコロを3個に増やすと分離します。
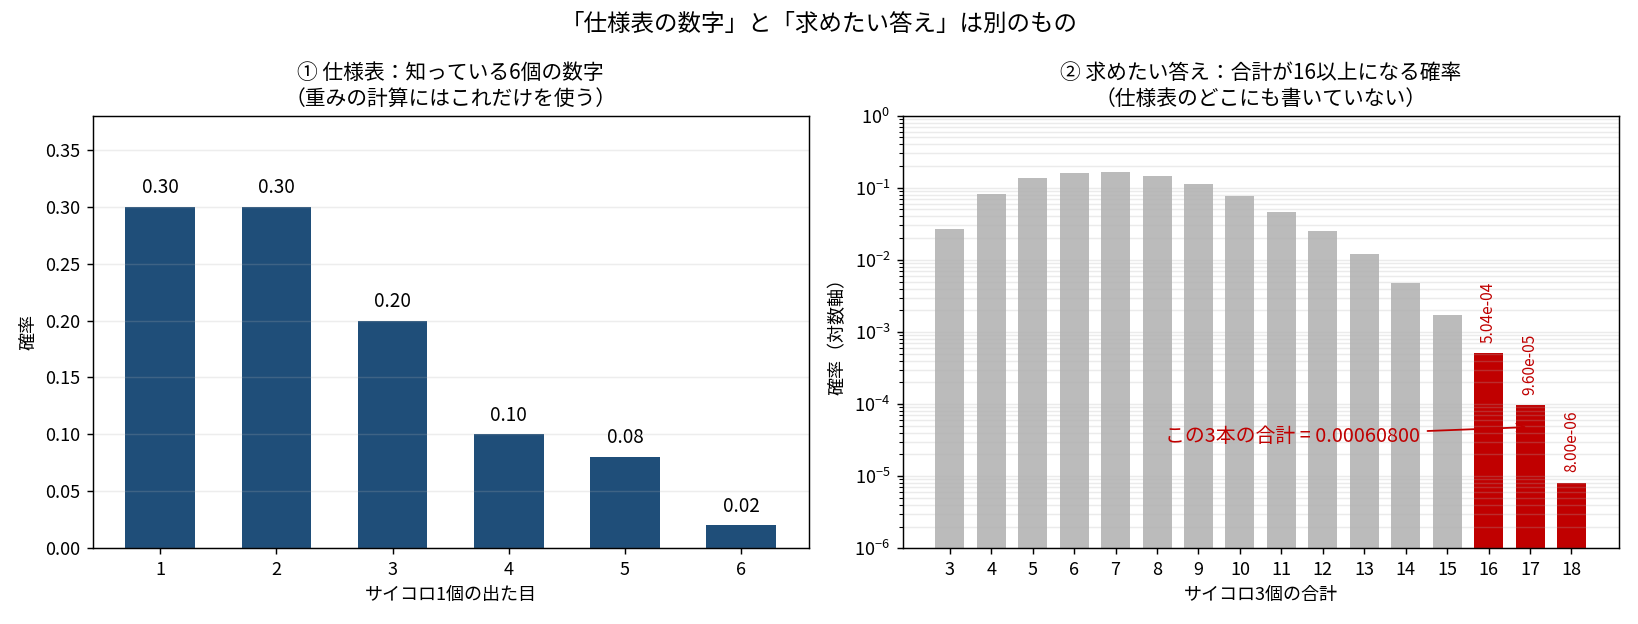
問いは「このサイコロを3個振って、合計が16以上になる確率」。216通りを全列挙した厳密値は 0.00060800 で、これは仕様表のどこにも書いてありません。提案は大きい目が出やすいサイコロ にします。
| 試行 | 出た目 | の積 | の積 | 重み | 合計 | 16以上? | 記録 |
|---|---|---|---|---|---|---|---|
| 1 | (3,6,5) | 0.20×0.02×0.08 = 0.000320 | 0.10×0.40×0.25 = 0.010000 | 0.032000 | 14 | いいえ | 0 |
| 2 | (6,5,5) | 0.02×0.08×0.08 = 0.000128 | 0.40×0.25×0.25 = 0.025000 | 0.005120 | 16 | はい | 0.005120 |
| 3 | (5,5,5) | 0.08×0.08×0.08 = 0.000512 | 0.25×0.25×0.25 = 0.015625 | 0.032768 | 15 | いいえ | 0 |
| 4 | (6,6,2) | 0.02×0.02×0.30 = 0.000120 | 0.40×0.40×0.05 = 0.008000 | 0.015000 | 14 | いいえ | 0 |
| 5 | (6,5,5) | 0.02×0.08×0.08 = 0.000128 | 0.40×0.25×0.25 = 0.025000 | 0.005120 | 16 | はい | 0.005120 |
| 6 | (6,6,5) | 0.02×0.02×0.08 = 0.000032 | 0.40×0.40×0.25 = 0.040000 | 0.000800 | 17 | はい | 0.000800 |
| 7 | (4,5,4) | 0.10×0.08×0.10 = 0.000800 | 0.15×0.25×0.15 = 0.005625 | 0.142222 | 13 | いいえ | 0 |
| 8 | (4,6,4) | 0.10×0.02×0.10 = 0.000200 | 0.15×0.40×0.15 = 0.009000 | 0.022222 | 14 | いいえ | 0 |
この表の全部の数字は、仕様表の12個( の6個 + の6個)から作られています。0.000608 という答えは1度も使っていません。
| 方法 | 推定値 | 標準誤差 | 命中率 | |
|---|---|---|---|---|
| 重点サンプリング | 10,000 | 0.00060435 | 1.36e−05 | 33.03% |
| 重点サンプリング | 20,000,000 | 0.00060867 | 3.06e−07 | 33.11% |
| 素朴 | 10,000 | 0.00030000 | 1.73e−04 | 0.03% |
| 素朴 | 20,000,000 | 0.00060350 | 5.49e−06 | 0.06% |
素朴法は で命中3回しかなく、推定値が真値の半分になっています。
一般的な構図はこうです。重点サンプリングが要求するのは「観測した1点に元の分布が割り当てる確率(密度)を計算できること」だけ。要求しないのは「その分布から導かれる複雑な量(裾確率・分位点・和の分布)を知っていること」。 式に代入できる量と、式から導かねばならない量の差でした。
| 仕様表にあるもの | 仕様表から導かねばならないもの | |
|---|---|---|
| サイコロ3個 | 1個の各目の確率(6個) | 合計が16以上になる確率 |
| コイン10回 | 1回の表の確率 0.5 | 9回以上表になる確率 |
| 指数分布20個 | 密度の式 | 20個の和が40を超える確率 |
| 記事20本のPV | パレート分布の式 | 合計PVの中央値・90%点 |
そして循環が起きる設定は、シミュレーションが不要な設定と同じでした。
重みが元の世界を厳密に復元することの確認
コイン10回で「表が9回以上出る確率」(真値 )を題材にすると、重みの働きが厳密に確認できます。表の確率 0.8 のイカサマコインを提案に使い、表が 回出た列に対して
| 公平での確率 | イカサマでの確率 | 重み | |
|---|---|---|---|
| 0 | 0.0009765625 | 0.0000001024 | 9536.743164 |
| 5 | 0.0009765625 | 0.0001048576 | 9.313226 |
| 8 | 0.0009765625 | 0.0067108864 | 0.145519 |
| 9 | 0.0009765625 | 0.0268435456 | 0.036380 |
| 10 | 0.0009765625 | 0.1073741824 | 0.009095 |
各 について「イカサマでの確率 × 重み」を計算すると、公平コインでの確率にぴったり戻ります。
| (公平コインでの真の確率) | 差 | ||
|---|---|---|---|
| 0 | 0.0009765625 | 0.0009765625 | 1.1e−19 |
| 2 | 0.0439453125 | 0.0439453125 | 0.0e+00 |
| 5 | 0.2460937500 | 0.2460937500 | 2.8e−17 |
| 7 | 0.1171875000 | 0.1171875000 | 1.4e−17 |
| 9 | 0.0097656250 | 0.0097656250 | 1.7e−18 |
| 10 | 0.0009765625 | 0.0009765625 | 0.0e+00 |
11個すべてで一致しました(差はすべて浮動小数の丸め誤差)。重みを掛ける操作は、イカサマコインの世界を公平コインの世界に厳密に戻す変換になっています。 だから足し合わせれば答えが出る。 での推定は重点 0.01074752(標準誤差 4.99e−06・命中率 37.6%)、素朴 0.01070720(標準誤差 3.25e−05・命中率 1.1%)でした。
まれな事象での威力
いよいよ本題です。「Exp(1) を20個足した合計が 100 を超える確率」を推定します。ガンマ分布の上側確率なので厳密値が出ます:3.764894e−23。
| 方法 | 推定値 | 相対誤差 | |
|---|---|---|---|
| 素朴なモンテカルロ法 | 0(命中0件) | 測定不能 | |
| 素朴なモンテカルロ法 | 0(命中0件) | 測定不能 | |
| 素朴なモンテカルロ法 | 0(命中0件) | 測定不能 | |
| 重点サンプリング() | 5.2751e−23 | 40.11% | |
| 重点サンプリング() | 4.0641e−23 | 7.95% | |
| 重点サンプリング() | 3.7262e−23 | 1.03% | |
| 重点サンプリング() | 3.7446e−23 | 0.54% |
素朴法は1000万回で命中0件。重点サンプリングは1000回で桁が合い、10万回で誤差1%。 という確率を10万回のシミュレーションで測っています。 命中率は 0% から 47% に上がりました。
目安 しきい値 はどこから来るのか
上の は当てずっぽうではありません。 です。この目安の出どころを確認します。しきい値 、変数の個数 とすると になります。
まず理想の分布の姿を測る
理想の提案分布(事象に条件づけた分布)は作れませんが、どんな形をしているかは測れます。 の場合で、棄却法を使って条件を満たす標本だけを4億回引いて集めました。
| 量 | 実測(条件付き標本 70,827 本) | 予測 |
|---|---|---|
| 1本あたりの平均 | 2.0888 | |
| 合計 の平均 | 41.7761 | しきい値 |
「合計が40を超えた世界」では、1本あたりの平均が 1 ではなく 2 前後になっています。 しきい値をちょうど超えるあたりに集まるので 。つまり は「理想の分布の平均を真似た設定」でした。形まで一致させることはできませんが、中心は合わせられます。
母関数が出てくる
なぜ「平均 の指数分布」で真似られるのか。ここで第9回の母関数が効きます。元の密度に を掛けて正規化する操作を指数傾斜といいます。
これは平均 の指数分布です。つまり「平均 の指数分布から引く」という操作は、実は で傾斜させたことと同じでした。指数分布は傾斜させても指数分布のまま(指数型分布族の性質)なので、族の中で閉じています。
そして重みを書き直すと、モーメント母関数 がそのまま現れます。
密度比を素直に計算した値とこの式の値を比べたところ、最大の差 8.327e−16(浮動小数の丸め誤差)で一致しました。
最適な は、傾斜した世界での の期待値をしきい値に等しくする条件で決まります。
日本語に直すと「まれな事象を、ふつうの出来事に変える」です。元の世界では合計40は平均20から遠い外れ値ですが、 の世界では合計40が平均そのものになります。
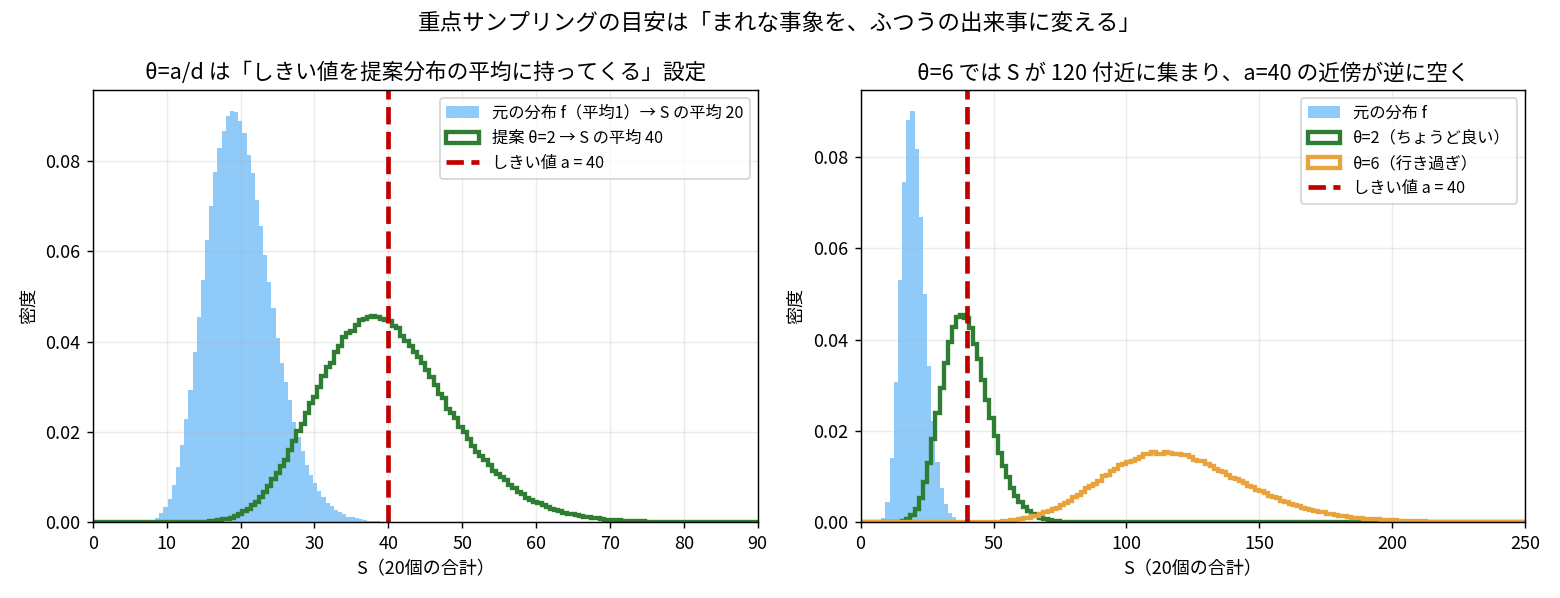
実測した の平均は、元の分布で 20.01、 で 40.00、 で 119.99 でした。 まで行き過ぎると、しきい値40の近傍が逆に空きます。 行き過ぎが悪いのは「まれな事象を今度は反対側からまれにしてしまう」ためです。
おまけ:チェルノフ上界と同じ が出る
同じ は、確率の上界を求める古典的な計算からも出てきます。
| 量 | 数値 |
|---|---|
| 数値的に最小化した | 0.5000 |
| 理論値 | 0.5000 |
| 対応する | 2.000 |
| 上界の値 | 2.1613e−03(真値 1.7630e−04 の 12.3 倍) |
「確率の上界を一番きつくする傾け方」と「重点サンプリングの最適な提案分布」が同じ になります。 どちらも「その事象がいちばん起こりやすくなるパラメータ」を探しているからです。第12回の尤度比検定で見た「対立仮説側に最も有利なパラメータを探す」構造と同じ形でした。
なぜ分散減少法を常用しないのか
はこの問題(独立な和の裾)に固有の公式で、一般には書けません。そして外すと素朴法より悪くなります。 (真値 1.763029e−04)で を動かしました。
| 推定値 | 相対誤差 | 1試行の分散 | 素朴法比 | |
|---|---|---|---|---|
| 1.0(素朴) | 1.80000e−04 | 2.10% | 1.7997e−04 | 1.0000 倍 |
| 1.2 | 1.72415e−04 | 2.21% | 6.4256e−06 | 0.0357 倍 |
| 1.5 | 1.75532e−04 | 0.44% | 5.5975e−07 | 0.0031 倍 |
| 2.0 | 1.76481e−04 | 0.10% | 1.6905e−07 | 0.0009 倍 |
| 2.5 | 1.75394e−04 | 0.52% | 2.5748e−07 | 0.0014 倍 |
| 3.0 | 1.75366e−04 | 0.53% | 6.9552e−07 | 0.0039 倍 |
| 4.0 | 1.76441e−04 | 0.08% | 7.7282e−06 | 0.0429 倍 |
| 6.0 | 1.36611e−04 | 22.51% | 5.9183e−04 | 3.2886 倍 |
| 8.0 | 3.83484e−05 | 78.25% | 4.2867e−04 | 2.3819 倍 |
| 10.0 | 7.99491e−06 | 95.47% | 2.5287e−05 | 0.1405 倍 |
で分散が素朴法の 0.0009 倍(約1100倍の改善)ですが、〜 では素朴法より2〜3倍悪化します。
そして の行が最も危険です。分散は素朴法の 0.1405 倍と「小さく」見えるのに、推定値は真値の 4.5%(相対誤差 95%)。 同じ を40回繰り返して確かめました。
| 推定値の平均 | 実際の標準偏差 | 報告される標準誤差 | 実際 ÷ 報告 | 真値から10%以上外れた回数 | |
|---|---|---|---|---|---|
| 1.0 | 1.7138e−04 | 2.981e−05 | 2.916e−05 | 1.02 倍 | 17 / 40 |
| 2.0 | 1.7630e−04 | 9.151e−07 | 9.197e−07 | 1.00 倍 | 0 / 40 |
| 6.0 | 2.0001e−04 | 7.112e−05 | 6.882e−05 | 1.03 倍 | 37 / 40 |
| 10.0 | 1.6052e−06 | 6.950e−06 | 1.602e−06 | 4.34 倍 | 40 / 40 |
では標準誤差が実際のばらつきの4分の1しか報告されません。 重みが極端に偏り、「たまに出る巨大な重み」を引き当てないと正しい値にならないためです。引き当てなかった回は、小さくまとまった嘘の答えと小さな標準誤差が並んで出てきます。
つまり自分が間違っていることに気づけません。 素朴法()は不正確ですが、標準誤差は正直です(1.02倍)。
答えを知らずに を選ぶ方法
そこで実務では真値を使わずに計算できる診断指標を使います。有効サンプルサイズです。
意味は「 個引いたが、実質いくつが効いているか」。寄与が均等なら に近く、命中が少ないか1個の巨大な重みに支配されていると小さくなります。真値 はどこにも入っていません。
なお教科書の ESS は重み だけで と定義しますが、まれな事象では上のように推定量への寄与 (命中しなかった試行は 0)を使います。こうすると「命中したうえで重みが均等か」を1つの数で見られます。素朴法()で ESS が 0.000167 と極端に小さいのは、重みが完全に均等でも命中率が しかないためです。
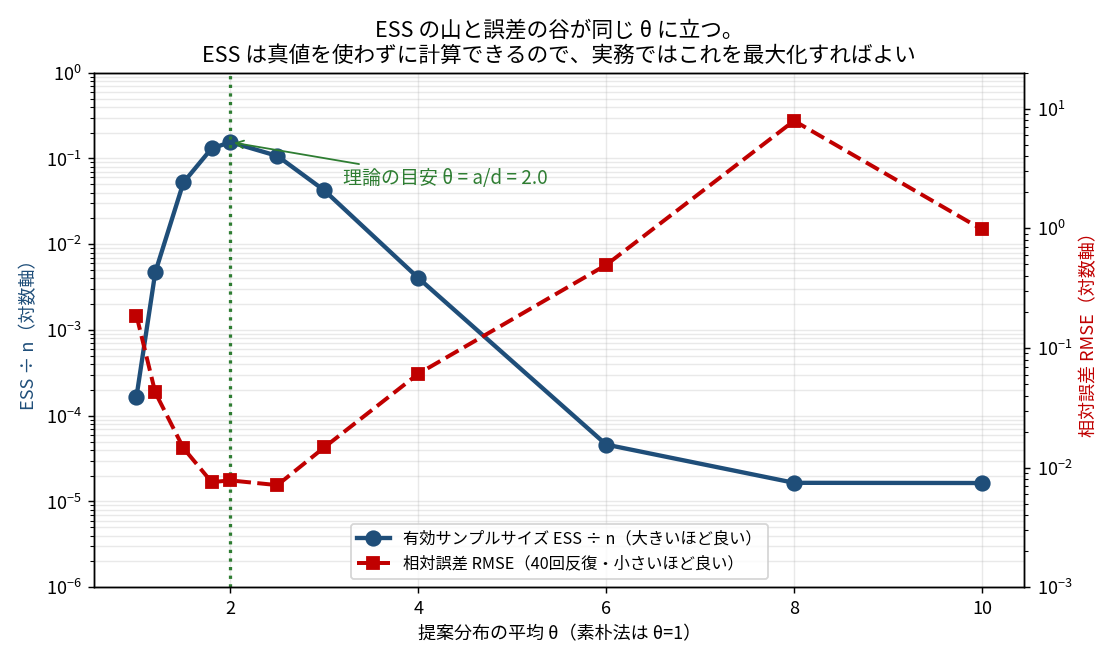
| ESS ÷ | 相対誤差(40回反復の RMSE) | |
|---|---|---|
| 1.0(素朴) | 0.000167 | 18.67% |
| 1.2 | 0.004701 | 4.25% |
| 1.5 | 0.052489 | 1.46% |
| 1.8 | 0.130992 | 0.76% |
| 2.0 | 0.154949 | 0.78% |
| 2.5 | 0.106970 | 0.71% |
| 3.0 | 0.042382 | 1.48% |
| 4.0 | 0.004039 | 6.09% |
| 6.0 | 0.000046 | 49.46% |
| 8.0 | 0.000017 | 793.03% |
| 10.0 | 0.000016 | 97.92% |
ESS の山と誤差の谷は、ほぼ同じ位置に立ちます。 厳密には ESS の最大が 、相対誤差の最小が で1目盛りずれていますが、40反復のばらつきの範囲です。そして緑の点線(理論の目安 2.0)が ESS の頂点と一致しています。真値を使わずに最適な設定の近傍を特定できる、というのが要点です。
注意点が1つあります。 の相対誤差 793% に対して は 97.92% と、数字だけ見ると改善しています。これは改善ではありません。 では推定値がほぼ 0 に潰れ、「常に 0 と答える」状態に近づいたために相対誤差が 100% で飽和しているだけです。ESS はどちらも 0.00002 前後で、正しく破綻を示しています。相対誤差だけを見ると誤読します。
常用しない4つの理由
| 理由 | 根拠になった数値 |
|---|---|
| ① 問いによって効果が桁で違う | 層別が期待値で9707倍、中央値で1.75倍(いずれも 。倍率は にほぼ比例して開く) |
| ② 外すと素朴法より悪化する | 重点サンプリングの で分散 3.29 倍 |
| ③ 標準誤差が過小評価され、失敗を検知できない | で実際が報告の 4.34 倍、40/40 回外れた |
| ④ 良い設計には「答えの居場所」の事前知識が必要 | 最適 しきい値 |
実務での判断はこうなります。まず素朴なモンテカルロ法で回す。 を増やして間に合うならそれで終わり(③の危険を負う必要がない)。 をいくら増やしても届かないときだけ、分散減少法を持ち出す。そのときは必ず複数の設定で回して答えが一致するか確認する( と が一致し、 だけ外れることが検知の手がかりになります)。
ブートストラップ法・並べ替え検定・ジャックナイフ法
最後に、データを使い回す3つの手法を整理します。3つとも「手元のデータから作り直す」ので混ざりやすいのですが、作っている分布が違います。 これが1点の要約です。
| ブートストラップ法 (第11回) | 並べ替え検定 (第15回) | ジャックナイフ法 (第10回) | |
|---|---|---|---|
| 作る分布 | 推定値のばらつき | 帰無仮説のもとでの分布 | 推定値のばらつき |
| 答える問い | この推定値はどれくらいブレるか | 2群が同じ分布から来ているとしたら、これほどの差が出るか | この推定値はどれくらいブレるか |
| 出力 | 標準誤差・信頼区間 | p値 | 標準誤差・偏りの補正 |
| やること | 復元抽出(同じ人が2回出る) | 群のラベルをシャッフル(非復元) | 1個ずつ抜く |
| 分布の中心 | 観測値のまま | 0(帰無仮説の値)。ただし差の形の統計量に限る | 観測値のまま |
| 乱数 | 必要 | 必要(全列挙できれば不要) | 不要(決定的) |
| 計算回数 | 1万〜10万(任意) | (全列挙可) | 通りだけ |
| 根拠となる仮定 | 手元の標本を母集団の代わりに使う | 帰無仮説のもとでラベルが交換可能 | 統計量が滑らか(1次近似) |
同じデータで3つ回した
A群 10人(平均 66.00)、B群 10人(平均 56.30)、差 9.700 です。
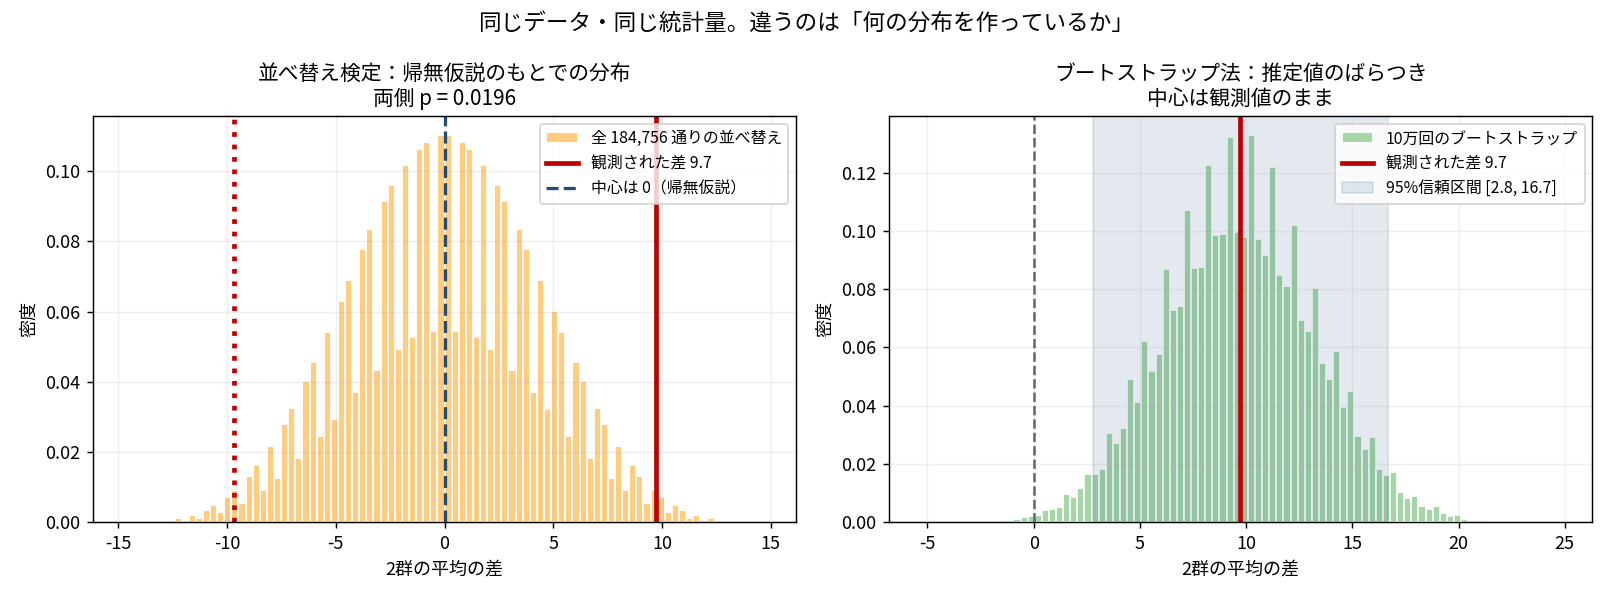
左は分布の中心が 0 です。 「差がない世界」を作っているので当然そうなります。観測値 9.7 がどれくらい端にあるかを見て p 値を出します。右は分布の中心が観測値 9.7 のまま。 「同じ調査をやり直したら差はどれくらい動くか」を見ています。この2枚の中心の違いが、両者の違いのすべてでした。
| 方法 | 結果 | 参考値 |
|---|---|---|
| 並べ替え検定(全 184,756 通りを列挙) | 両側 p = 0.019637(3,628 通りが観測以上に極端) | 帰無分布の中心 −0.000000・標準偏差 4.2681 |
| ブートストラップ法(10万回) | 標準誤差 3.5547/95%信頼区間 [2.800, 16.700] | 分布の中心 9.6871 |
| ジャックナイフ法(A群10通り+B群10通りを群別に計算して合成) | 標準誤差 3.7418 | ウェルチの標準誤差 3.7418 と一致 |
ジャックナイフ法の検算が面白いところです。 A群の平均のジャックナイフ標準誤差は 3.1972 で、 と小数第4位まで完全に一致しました(B群も 1.9439 と 1.9439)。
これは偶然ではなく、平均に対してはジャックナイフ法が を厳密に再現するためです。 を代入すると、ジャックナイフ分散が にぴったりなります。
そして上の表で「差の標準誤差 3.7418 がウェルチと一致」と書きましたが、これも検算ではなく恒等式の確認です。群ごとの標準誤差を で合成する式が、ウェルチの標準誤差の定義そのものだからです。なおこれは群別に計算して合成した場合の話で、20点をプールして1個ずつ抜くと係数が変わり 3.8443 になって一致しません。
だから「平均の標準誤差」を出したいだけならジャックナイフ法は不要(公式がある)。公式がない統計量(中央値・相関係数・分位点)のときに意味が出ます。 その場合は偏りの補正 も併せて使います。
もう1点。ブートストラップ法の標準誤差 3.5547 がジャックナイフ・ウェルチの 3.7418 より小さいのは、乱数のゆらぎではなく系統的な差です。群内の復元抽出は分母 の分散に対応するので、 とほぼ一致します( を直接計算しても 3.5498)。 が小さいときは の補正を入れるか、この差を過度に解釈しないのが安全です。
使い分けの覚え方はこうです。
- p値が欲しい → 並べ替え検定(帰無仮説の世界を作る)
- 信頼区間・標準誤差が欲しい → ブートストラップ法
- 乱数を使いたくない・軽くしたい → ジャックナイフ法(ただし中央値のようなガタつく統計量には弱い)
試験では「復元か非復元か」「分布の中心が観測値か 0 か」で判別できます。
1点だけ注意です。並べ替え検定が厳密に検定しているのは「平均に差がない」ではなく「2群の分布が同一」という強い帰無仮説です。平均だけ等しく分散が違う場合には、厳密な有意水準は保証されません。また「帰無分布の中心が 0」は平均差のような差の形の統計量に限った性質で(左右対称になるのは のとき)、順位和のような統計量では中心は 0 になりません。
自分が間違えていたこと
この章を学ぶ前、次のように思っていました。全部違いました。
① モンテカルロ法は速くて正確な計算法だと思っていた。
逆です。遅くて不正確です。 1変数の期待値では等間隔グリッドに1億倍以上の精度差で負けました(誤差 4.91e−10 対 6.86e−02。典型誤差 0.0223 で比べても約 倍)。長所は精度でも速度でもなく次元に鈍感なことだけ。「精度で勝つ」のではなく「他の方法が全滅する場所でも生き残る」という勝ち方でした。
② は「収束が遅い」という欠点だと思っていた。
次元に鈍感という長所でした。 グリッドの誤差指数は で、 では (実測)と圧倒的に速いのに、 では まで劣化します。モンテカルロ法は のまま。交差点は でした。
③ モンテカルロ法は次元の呪いを受けないと思っていた。
受けます。ただし「傾き」ではなく「高さ」に出ます。 答え が次元とともに、平均の推定では縮み( で 0.1768)、積の期待値では増え(28.78)、まれな事象では暴走します(65536)。3ケースすべて傾きは のままで、違うのは出発点の高さだけでした。
④ 棄却法をモンテカルロ法の一種だと思っていた。
別カテゴリです。棄却法は「乱数を作る」技術で出力は標本、モンテカルロ法は「乱数を使う」技術で出力は数値。同じダーツから両方が出るので混同しやすいのですが、個数を使うか座標を使うかで別れます。
⑤ 逆関数法にヤコビアンは出てこないと思っていた。
出ていました。ヤコビアン で、密度そのものだったのです。「累積分布関数の傾きが密度」という最初の観察が、そのままヤコビアンでした。1次元では両者が同じものなので気づかなかっただけです。
⑥ 分散減少法は「使えるなら常に使うべき技術」だと思っていた。
外すと素朴法より悪化します。重点サンプリングの で分散が 3.29 倍。さらに悪いことに、 では標準誤差が実際のばらつきの4分の1しか報告されず、40回中40回が真値から10%以上外れました。 失敗を検知できないのが最大の問題でした。
⑦ 相対誤差が小さくなれば改善だと思っていた。
の 793% から の 97.92% への「改善」は改善ではありません。推定値が 0 に潰れて相対誤差が 100% で飽和しただけでした。値域に上限がある指標では、良くなったのか壊れたのかが区別できません。
⑧ 「平均と分散が理論値と合ったから正しい」と考えていた。
ボックス=ミュラー法でヤコビアンの を落とした誤り版は、分散 1.00147(理論 1)で合格します。尖度が 9.1698(理論 3)、原点付近の割合が 21.83%(理論 7.97%)でようやく破綻が見えました。同じ構造は RANDU でも起きており、平均・分散・適合度 はすべて合格するのに3次元では15枚の平面しかありません。低次元の要約統計量は、高次元の破綻を隠します。
⑨ 擬似乱数の最大の弱点は周期だと思っていた。
現代の生成器では周期は問題になりません(PCG64 なら毎秒10億個で 年)。問題は規則性と、同じシードでの並行実行でした。
⑩ 「 が計算できるならシミュレーションは不要」と考えていた。
半分正しく、半分間違いでした。分かれ目は「 が計算できるか」ではなく「知りたい量が何変数の積分か」。20本の合計PVの期待値は式で出ますが(471.103)、中央値(456.4)は出ません。そして実務で使うのは後者でした。 ⑪ この記事を書いている最中にも、同じ罠を踏みました。
答え の表(ケースB)で、 の値を標本標準偏差で1回測って 42.83 と書いていました。 厳密値は 28.78 です。シードを変えると 21〜76 に動きます。 の は尖度が で、 そのものが推定できない領域でした。
指摘を受けて閉じた式 に置き換えました。「母分散が無限だと標準偏差が暴れる」という、この記事で自分が書いた話をそのまま踏んだわけです。定性的な主張( が指数的に増える)は正しかったので、余計に気づきにくかった。
要点まとめ
| 論点 | 結論 |
|---|---|
| 章の構造 | 乱数を「作る」技術(出力=標本)と「使う」技術(出力=数値)の2つ。モンテカルロ法は後者を指す |
| 逆関数法の原理 | 累積分布関数の縦軸に一様乱数を置いて横軸に落とす。傾きが急なところに多く落ちる=密度が高い |
| なぜ正しいか | 軸の区間と 軸の区間が対応し、 軸側の長さがその区間の確率になる(連続で狭義増加なら1対1)。200万個で判定が全件一致 |
| 1行の証明 | 。使うのは「 が単調非減少かつ右連続」だけ |
| どんな分布でも作れる理由 | 累積分布関数は単調非減少・右連続。水平部分があっても一般化逆関数 で通る。分布の情報は の形だけが持っている |
| 離散分布 | 累積分布関数が確率 の分だけ垂直に跳ぶので、幅 の が同じ値に写る |
| 変数変換との関係 | 逆関数法は1次元・単調な場合の特殊ケース。ヤコビアン |
| 棄却法の原理 | 密度を面積として見て、覆いの中に一様に点を打ち、下に落ちた点の を採る |
| 採択率 | 覆いの中に入っている密度の面積 ÷ 覆いの面積。覆いが分布なら (、必ず ) |
| 覆いの選び方 | 長方形 0.3133 → コーシー分布 0.6577 → 指数分布 0.7602。重い裾で軽い裾を覆う(逆は不可) |
| 長方形のジレンマ | 狭くすると採択率は上がるが裾が切れて別の分布になる |
| 棄却法の限界 | で200万点から19個。 で 4063万回に1回。だから高次元では MCMC |
| ボックス=ミュラー法 | 2次元正規を極座標で見ると角度は一様・距離の2乗は平均2の指数分布。両方とも簡単に作れる |
| その効率 | 一様乱数2個で正規乱数2個。無駄ゼロ(棄却法は 6.383 個必要) |
| ヤコビアンの役割 | の が の に吸収される。落とすと尖度 9.17(理論 9)になるが分散は 1.00 で合格してしまう( とした場合) |
| 擬似乱数 | 完全に決定的。周期はパラメータ次第で より短くなる( で周期2) |
| 周期は問題か | 現代の生成器では問題にならない。問題は規則性(RANDU は3次元で15枚の平面) |
| 欠陥の見つけ方 | 1次元の検定(平均・分散・)は全部通る。次元を上げないと見えない |
| シードと再現性 | 同じライブラリの同じバージョンでのみ再現。並行実行で同じシードは実質サンプル数が増えない |
| シミュレーションの正当性 | ①任意の分布を作れる(第32章)+②大数の法則(第7章)の2本柱 |
| 1変数での優劣 | 等間隔グリッドが1億倍以上勝つ(単一実現値。典型誤差で比べても約4500万倍)。モンテカルロ法は点の置き場所を雑にしているだけ |
| 誤差の法則 | グリッド(中点則・被積分関数が2階微分可能)は 、モンテカルロは 。交差は (不連続な量なら で交差は ) |
| 高次元でのグリッド | で軸10点なら 回。毎秒10億回でも 3175 年 |
| モンテカルロと次元の呪い | 傾きではなく高さに出る。 を増やせば必ず解決するが、必要な が天文学的 |
| 母分散が無限のとき | 標準偏差の推定値がシードごとに 655〜2814 と暴れる。存在しない量を測っている |
| パレート分布 の精度 | 標本平均のばらつきは (実測 −0.318)。 10倍で 2.15 分の1しか縮まない |
| 仮定の感度 | 上限の想定を100倍動かすと中央値 490.5→490.6(不動)、標準偏差 412→1525(3.7倍)。分位点で語れば仮定が入らない |
| 分散減少法の4手法 | 対照変量法・層別サンプリング・制御変量法・重点サンプリング。期待値の推定なら4つとも無偏(重点は台の被覆、制御変量は を別標本で決めることが条件。分位点は素朴法を含めどれも有限標本では無偏でない) |
| 効果の目標依存 | 層別サンプリングは期待値で 9707 倍、中央値で 1.75 倍()。加法的な目標に強く、倍率は に比例して開く |
| 重みの意味 | 。歪めた分を割り戻す係数(第21回の不均等抽出と同じ) |
| 重みが復元すること | が全 で一致(差 台) |
| 理想の提案分布 | 事象に条件づけた分布。分散ちょうど 0。ただし正規化定数が答えそのもので作れない |
| 重みに必要な情報 | 観測点の密度だけ。答え(裾確率・分位点)は不要。循環する設定はシミュレーション不要な設定 |
| まれな事象での威力 | を素朴法は 回で命中0。重点サンプリングは 回で誤差 1.03% |
| 目安 | 条件付き分布の1本あたりの平均が (実測 2.0888)。指数傾斜+母関数で導出。チェルノフ上界と同じ |
| 常用しない理由 | 外すと悪化( で 3.29 倍)/標準誤差が 4.34 倍過小になり失敗を検知できない |
| 実務での診断 | ESS 。真値を使わずに最適 の近傍を特定できる(ESS の山は 、誤差の谷は ) |
| 3つの再標本化法 | ブートストラップ=復元・中心は観測値・信頼区間/並べ替え=シャッフル・中心は0(差の形の統計量のとき)・p値/ジャックナイフ=1個抜き・乱数不要 |
| ジャックナイフの検算 | 平均に対しては を厳密に再現(3.1972 と 3.1972)。公式がない統計量で意味が出る |
試験対策としての優先順位
| 優先度 | 項目 |
|---|---|
| 最優先 | 逆関数法( を具体的な分布で書けること。指数分布 、ワイブル分布、幾何分布 、一般の離散分布は累積確率と比べる) |
| 優先 | 棄却法の採択率 と の求め方/モンテカルロ積分の誤差が であること/ブートストラップ法と並べ替え検定の違い |
| 普通 | ボックス=ミュラー法の式/ 平均2の指数分布/擬似乱数の周期とシード/ジャックナイフ法(標準誤差と偏りの補正 ) |
| 軽く | 分散減少法(4つの名前と「何をしているか」だけ。導出は不要) |
準1級で手を動かす計算問題は逆関数法に集中しています。 を書いて について解く、という操作を分布ごとに確実にやれるようにするのが最短です。分散減少法は用語と使いどころを答えられれば十分でした。
連載を振り返る(全34回)
これで公式ワークブックの全32章を一周しました。回番号と章番号がずれているのは、第2章(母関数)を後回しにして第9回に置き、第6章を第6回・第7回の2回に分けたためです(第30章のモデル選択は第32回、第32章のシミュレーションが今回)。本編としては最終回なので、最初の状態から何が変わったのかを書き残しておきます。
出発点:「結局これ何に使うんだっけ」が答えられなかった
第1回にこう書きました。
公式テキストは一通り目を通しました。それなのに、いま範囲を見返しても後半はほとんど頭に残っていません。数式が難しかったという話ではなく、「この手法、結局何に使うんだっけ?」 が答えられない状態です。
一度通読して挫折した状態からの再挑戦でした。方針は3つだけ決めました。定義ではなく「何に使う道具か」から入る。生成AIに説明させる。その説明を自分で計算・シミュレーションして検証する。
何が効いたのか
振り返って、明確に効いたやり方が4つあります。
① 数式より先に「定義そのものの図」を出す。
抽象的なイメージ図ではなく、定義を絵にすると何が見えるかを描く。イェンセンの不等式は という式ではピンと来ませんでしたが、「 は曲線上の点、 は弦の中点、凸なら弦は曲線の上」という3点の図を見た瞬間に「そらそうだろ」という気持ちになりました。決定係数も「3本の縦線を測るだけ」に分解したら通りました。今回の逆関数法も、累積分布関数を横から読む図が入口でした。
② 用語を後回しにして、先に「測るもの」を見せる。
用語を定義してから中身に入ると詰まります。逆にしました。 なら「①実測値から平均までの距離、②予測値から平均まで、③実測値から予測値まで」を図で測ってから、最後に「①②③に名前を付けただけ」として平方和という言葉を出す。今回も、重みを「」と定義する前に「25倍ズルしたから1回を 1/25 回分として数える」を先に置きました。
③ 自分の間違いが最良の教材だった。
各回で査読を入れて、自分の誤りを数えました。第16回で5件、第17回で8件、第21回で9件、第24回で12件、第29回で7件、第31回で11件……。この誤りのリストが、記事の中でいちばん価値のある部分になりました。 読者も同じ場所で間違えるからです。そして自分にとっても、間違えた箇所は二度と忘れません。
今回も⑧「平均と分散が合ったから正しい」の思い込みが2か所(ボックス=ミュラー法の と RANDU)で同時に露出しました。同じ形の罠を2回踏んだので、これはもう習性です。
④ 同じ道具が章をまたいで何度も出てくる。
これが最大の発見でした。32章はバラバラな手法の集まりではなく、少数の道具の使い回しでした。とくに繰り返し出てきたのは次の5つです。
| 道具 | どこで再登場したか |
|---|---|
| と精度の限界 | 第8回(中心極限定理)→ 第11回(区間の幅)→ 第21回(標本設計)→ 今回(モンテカルロ誤差) |
| 固有値・固有ベクトル | 第22回(定常分布)→ 第24回(主成分)→ 第25回(判別)→ 第27回(因子) |
| 母関数 | 第9回(畳み込みを掛け算に)→ 今回(指数傾斜と重点サンプリングの最適設計) |
| 残差に落として考える | 第16回(偏回帰係数)→ 第17回(てこ比)→ 第27回(偏相関)→ 今回(制御変量法) |
| 変数変換とヤコビアン | 第4回(定義)→ 今回(逆関数法とボックス=ミュラー法) |
とくに今回は回収の回でした。 逆関数法のヤコビアンが第4回、重点サンプリングの最適設計が第9回の母関数、シミュレーションの正当性が第8回の大数の法則、棄却法の高次元崩壊が第33回の MCMC の動機、そして重みが第21回の不均等抽出。5つの章とつながりました。
まだ弱いところ
正直に書いておきます。
- 多次元正規分布は過去問(2019年6月)で手が止まった箇所で、第24回・第27回で扱いましたが手計算の速度はまだ足りません
- 線形代数(固有値の手計算)は 2×2 なら追えますが、3×3 以上は時間がかかります
- 章別の演習量が足りていません。ここからは過去問中心に切り替えます
数字で見た連載
| 項目 | 数 |
|---|---|
| 本編 | 34回(第1回は方針。第2〜34回の33本で全32章。第6章だけ2回に分けたので 33 本 = 32 章 + 1) |
| 番外編 | 統計の記号の基本・期待値の定義・MCMCを自作した記録 |
| 要点まとめノート | 確率の土台編・推測統計編・線形モデル編・確率過程編・多変量解析編・発展編 |
| 全体のまとめ | 統計検定準1級・独学連載のまとめ |
最初に「後半はほとんど頭に残っていない」と書いた状態から、少なくとも「どの章の道具が何のためにあるか」は答えられるようになりました。 一度通読しただけでは埋まらなかった穴が、自分で数字を出して理論値と突き合わせるという作業で埋まったのだと思います。
シミュレーションの章を最後に置いたのは結果的に正解でした。連載でずっと使ってきた検証手段そのものを検証する回になったからです。「 でしか精度が上がらない」という制約のもとで34回分の数値検証をしてきたわけで、その制約が「遅さ」ではなく「次元への鈍感さ」だったと分かったのは、最後に来る発見としてちょうど良い形でした。
次回
本編はここで完結です。次回からは試験対策編に入ります。
残っている穴は演習量です。
ここからは過去問を解いて、間違えた箇所を章に戻って埋める作業に切り替えます。連載としては「どこで詰まったか」と「その原因がどの章の穴だったか」を記録していく形になります。過去問を解いてみると、詰まる箇所はほぼ例外なく既習の章の穴でした。範囲の判別自体はできるようになっているので、あとは穴を1つずつ塞ぐ段階です。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。