区間推定:信頼区間は「作り方」に付いている数字だった【第11回】
はじめに
第9章の区間推定です。前回(第10回・点推定)の最後で、フィッシャー情報量から という形が出てくるところまで来ました。今回はその「」の側を正面から扱います。
学習を始める前は、この章を軽く見ていました。 という式は連載の第8回から何度も出てきていて、新しく覚えることは母分散の区間の公式くらいだろうと思っていたのです。
実際に手を動かしてみると、覚えることは公式ではなく手順が1つだけでした。 そして自分が誤解していたことが2つ見つかりました。
1つは 「95%」がどこに付いている数字なのかです。「真の値が95%の確率でこの区間に入る」という言い方が誤りだというのは知っていましたが、なぜ区別が実質的に重要なのかは分かっていませんでした。区別しないと実際に間違える例を作ってみたら、はっきりしました。
もう1つは標本サイズ設計です。「必要な精度から を逆算する」だけの話だと思っていたら、素朴に逆算した では差を見つけられる確率が50%しかないことが実測で出ました。そして自分のブログの実測PVを入れてみたら、A/Bテストに5.8年かかるという答えが返ってきました。これは今回いちばん実用的だった計算です。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 記号( と 、 と など)で迷ったら 統計の記号がややこしいのは軸が2本あるからだった を先に読んでください。
TL;DR
- 区間の公式は4つあるように見えて、手順は1つしかない。ピボット量に挟んでパラメータについて解く(反転)だけ
- 信頼係数は作り方に付いている数字で、手元の1本の区間に付いている数字ではない。一様分布で作った反例では、同じ「50%の手続き」から必ず当たる区間と33%しか当たらない区間の両方が出てくる
- 「母分散が既知」は非現実的な仮定に見えるが、比率や件数では分散が平均で決まるのでごく普通の状況。だから母比率の区間では 分布の出番がない(ただし「厳密に95%」にはならない)
- 2本の区間の重なりで差を判断してはいけない。足せるのは分散だけで、差の区間の半幅は2本の半幅を素朴に足した値の (個別の半幅そのものと比べれば 倍)
- 平均の差はウェルチを既定にする。等分散が真のときの損は幅で0.2%、外れたときの事故は被覆率
- 精度設計(半幅を にする)の検出力はちょうど50%。 検出力80%にするには常に2.04倍の が必要
- 月31PVのブログでA/Bテストをやると、いちばん条件のいい場合でも70ヶ月かかる。閾値は月5,000PV
- 比率の は が小さいと壊れる(被覆率0.639)。原因はSEに を入れていることで、反転して作り直すと直る(ウィルソン区間)
- 公式がない量にはブートストラップ。ただし小標本では狭すぎ、最大値には原理的に効かない
点推定値が同じでも、結論が正反対になる
なぜ区間で答えるのか。点推定は「どれくらい信じてよいか」の情報を捨てているからです。これは抽象的な言い方に聞こえますが、具体例にすると露骨です。
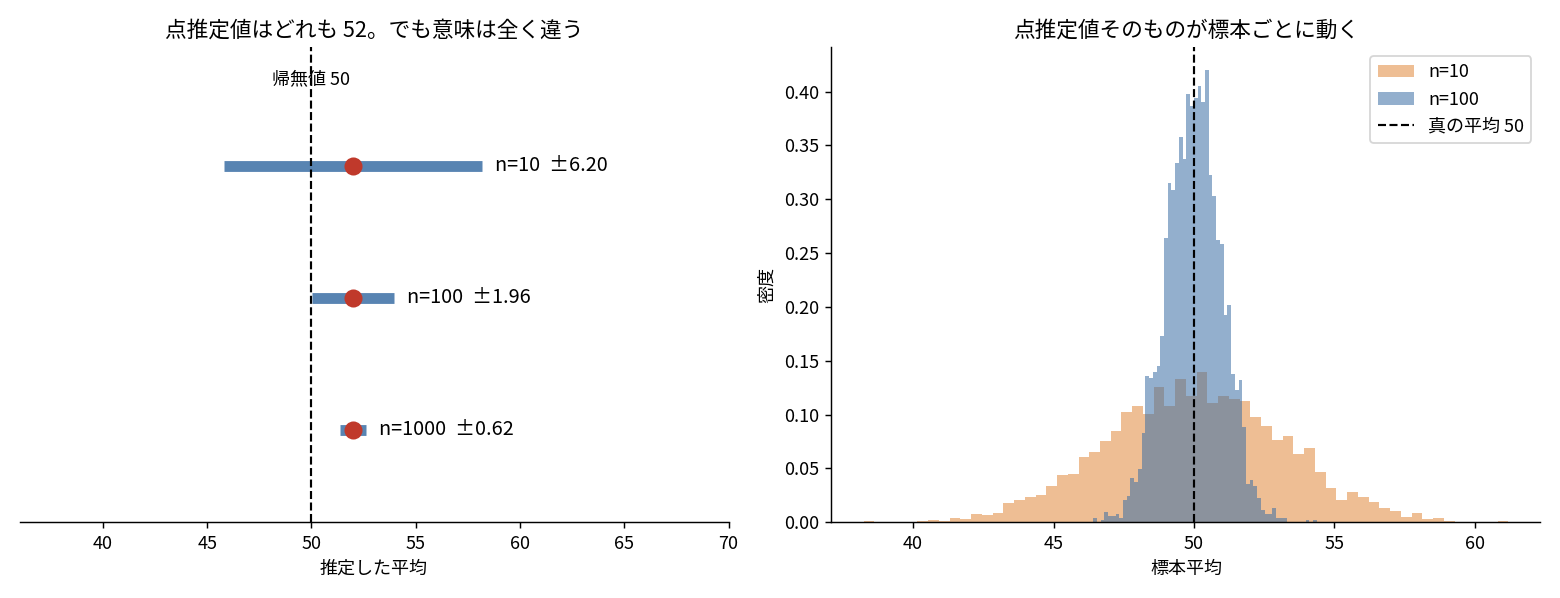
あるテストの平均点を調べて、3回とも 52点 という同じ結果が出たとします。ただし調べた人数だけが違う。合格ラインは50点です。
| 標準誤差 | 95%区間の半幅 | 区間 | 50を含むか | |
|---|---|---|---|---|
| 10 | 3.1623 | 6.1980 | [45.80, 58.20] | 含む |
| 100 | 1.0000 | 1.9600 | [50.04, 53.96] | 含まない |
| 1000 | 0.3162 | 0.6198 | [51.38, 52.62] | 含まない |
過去のデータから 点が既知だとして計算しました。点推定値は3ケースすべて 52.0 に固定しています。
同じ「52点」から、「50点かもしれない」と「50点ではない」という正反対の結論が出ます。 の区間は 50 を含むので合格ラインを割っている可能性を否定できませんが、 以上では否定できる。点推定値だけを報告すると、この違いが完全に消えます。
右の図が示しているのは、そもそも点推定値そのものが標本ごとに動くという事実です(第8回)。1回の調査で出た 52 は、この分布から引いた1個にすぎません。区間推定は、その「引いた1個からどこまで言えるか」を答える道具です。
信頼区間は「1枚の帯を縦に切ったもの」
区間推定は何をしているのか。定義を数式で書く前に、定義そのものを図にすると1枚で終わります。
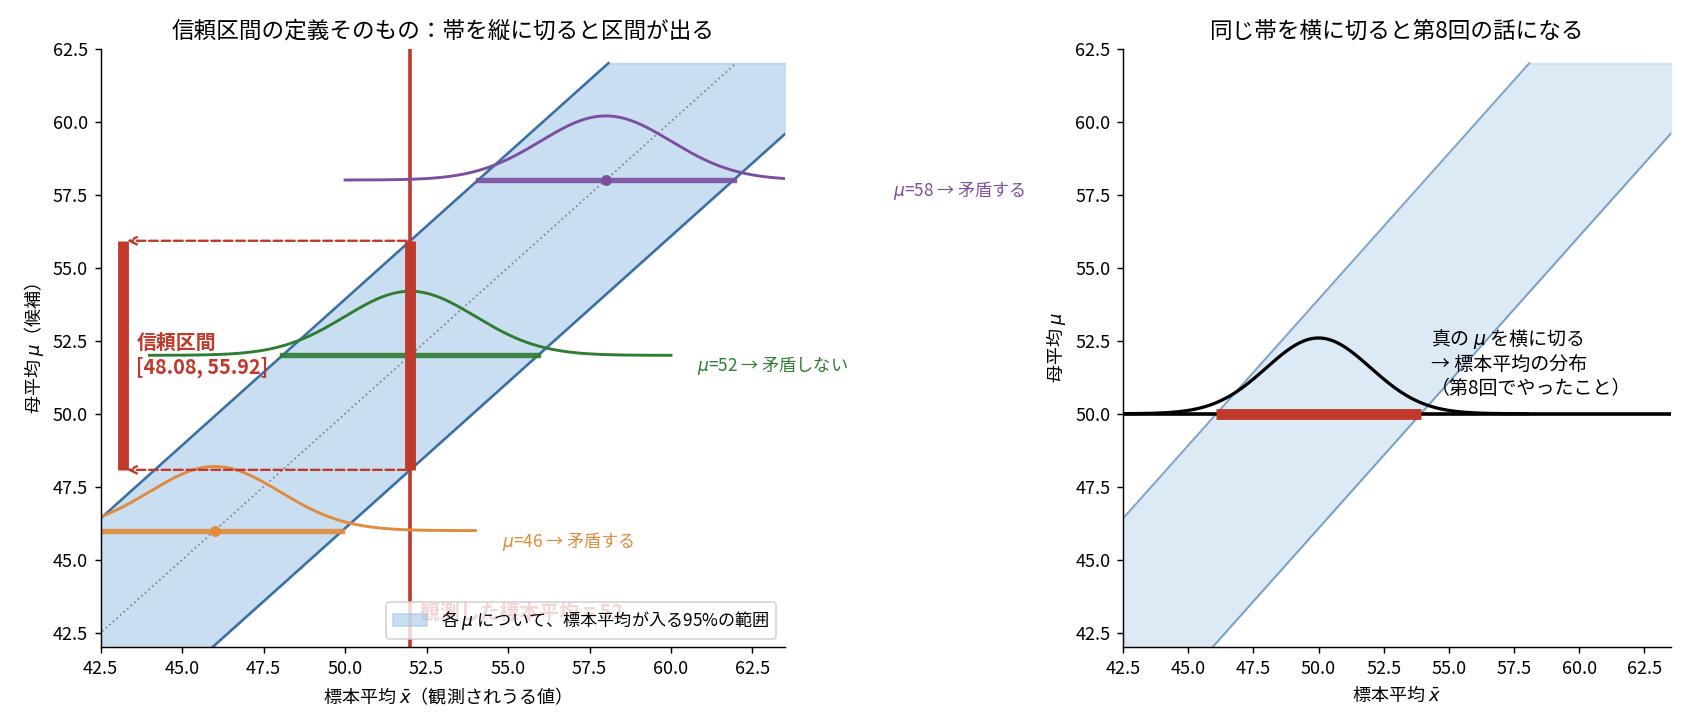
横軸が「観測されうる標本平均」、縦軸が「母平均の候補」です。斜めに走る帯は、各 に対して標本平均が95%の確率で落ちる範囲、つまり を縦に積み上げたものです。
この1枚の帯は、切る向きで2つの話になります。
横に切ると、 を固定して標本平均を見ることになります。これは第8回でやった「標本平均の分布」です。縦に切ると、観測した標本平均を固定して を見ることになります。こちらが信頼区間です。
つまり信頼区間は、観測値と矛盾しない を全部集めた集合です。 なら 52 という値はめったに出ないので候補から外れ、 は矛盾しないので残る。境界がちょうど になります(、 なので 、半幅は )。
この「縦に切る」操作を反転(inversion) と呼びます。そして縦に切った結果が「棄却されない帰無仮説の集合」になっているので、信頼区間と検定は同じ帯の別の切り方だということになります。これが双対性です。次回の検定の章がこの帯の横切りの話になるので、ここで絵を持っておくと得をします。
「真の値が95%の確率で入る」が誤りである、実害のある理由
第8回で被覆率を測って「動いているのは区間の側」と確認しました。ただしそのときは、なぜその区別が実質的に重要なのかまで踏み込んでいませんでした。「言葉づかいの細かい話でしょ」と思えてしまうのが最大の罠なので、区別しないと実際に間違える例を作りました。
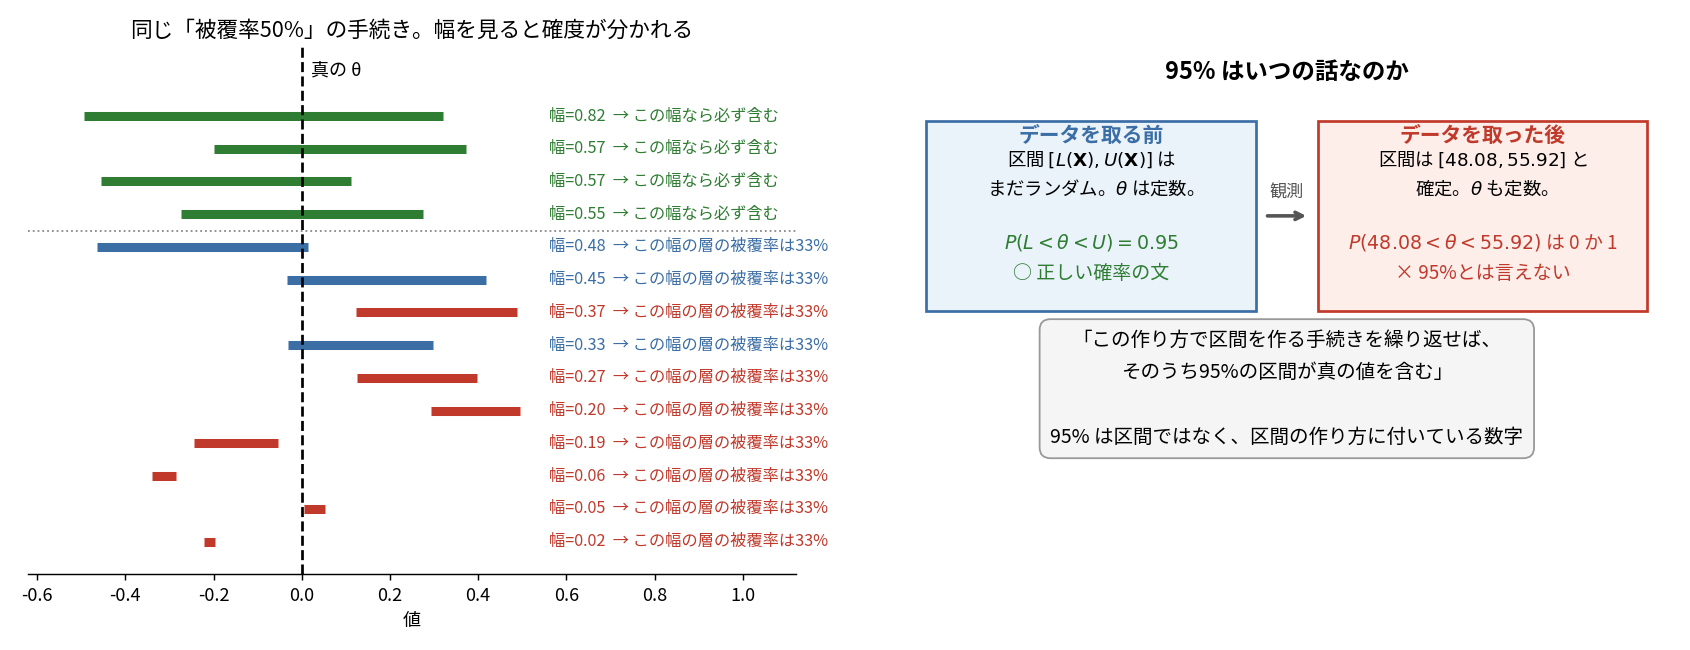
左が決定的な反例です。 一様分布 から2個だけ観測して、区間を(最小値, 最大値)とします。この手続きの被覆率はちょうど50%です。
ところが幅が 0.5 を超えた区間は、100%の確率で必ず を含みます。 2点の間隔が 0.5 を超えているなら、その間に が入らないことは幾何的にありえないからです。一方、幅が 0.5 以下の区間の被覆率は しかありません。
| 条件 | 起こる割合(400万回) | その条件での被覆率 | 理論値 |
|---|---|---|---|
| 全体 | 1.00000 | 0.50065 | |
| 幅 > 0.5 | 0.25023 | 1.00000 | |
| 幅 ≤ 0.5 | 0.74977 | 0.33400 |
「50%」は、手元の1本の区間について何も言っていません。 手元の区間について言えるのは 100% か 33% のどちらかです。
つまり信頼係数は手続きに付いている数字で、目の前の1本の区間に付いている数字ではない。だから次のようになります。
- 誤り:「真の がこの区間 に入る確率は95%」 — は定数、区間も観測後は確定した定数です。この確率は 0 か 1 しかなく、95% になる余地がありません
- 正しい:「この作り方で区間を作ることを繰り返せば、そのうち95%が真の値を含む」
- 正しい:「区間 は、信頼係数95%の手続きで得られた区間である」
では「真の値が入る確率」を言いたいときはどうするのか。 それはベイズの信用区間(credible interval) です。 に事前分布を置いて を確率変数にしてしまえば、 と堂々と言えます。連載第2回で扱った事後分布そのものの区間です。
つまり「真の値が95%の確率で入る」という言い方は、間違った日本語ではなく、別の流派(ベイズ)の正しい言明を頻度論の道具に貼り付けてしまっているのが問題です。だから直感的で、だからみんな間違えるのだと思いました。
ひとつ補足すると、正規分布の場合には、この誤解が実害を出さずに生き延びます。 既知の正規モデルでは区間の幅が常に で固定なので、上の一様分布のように「幅を見れば確度が分かる」という現象が起きません。幅から追加情報が取れないので、「95%」を1本の区間の性質だと思っても事故らない。一様分布の例は、その安心が一般には成り立たないことを示しています。
公式は4つではなく、手順が1つ
ここが今回いちばん報われた部分です。母平均の区間、母分散の区間、母比率の区間は別々の公式ではなく、同じ4ステップの出力でした。
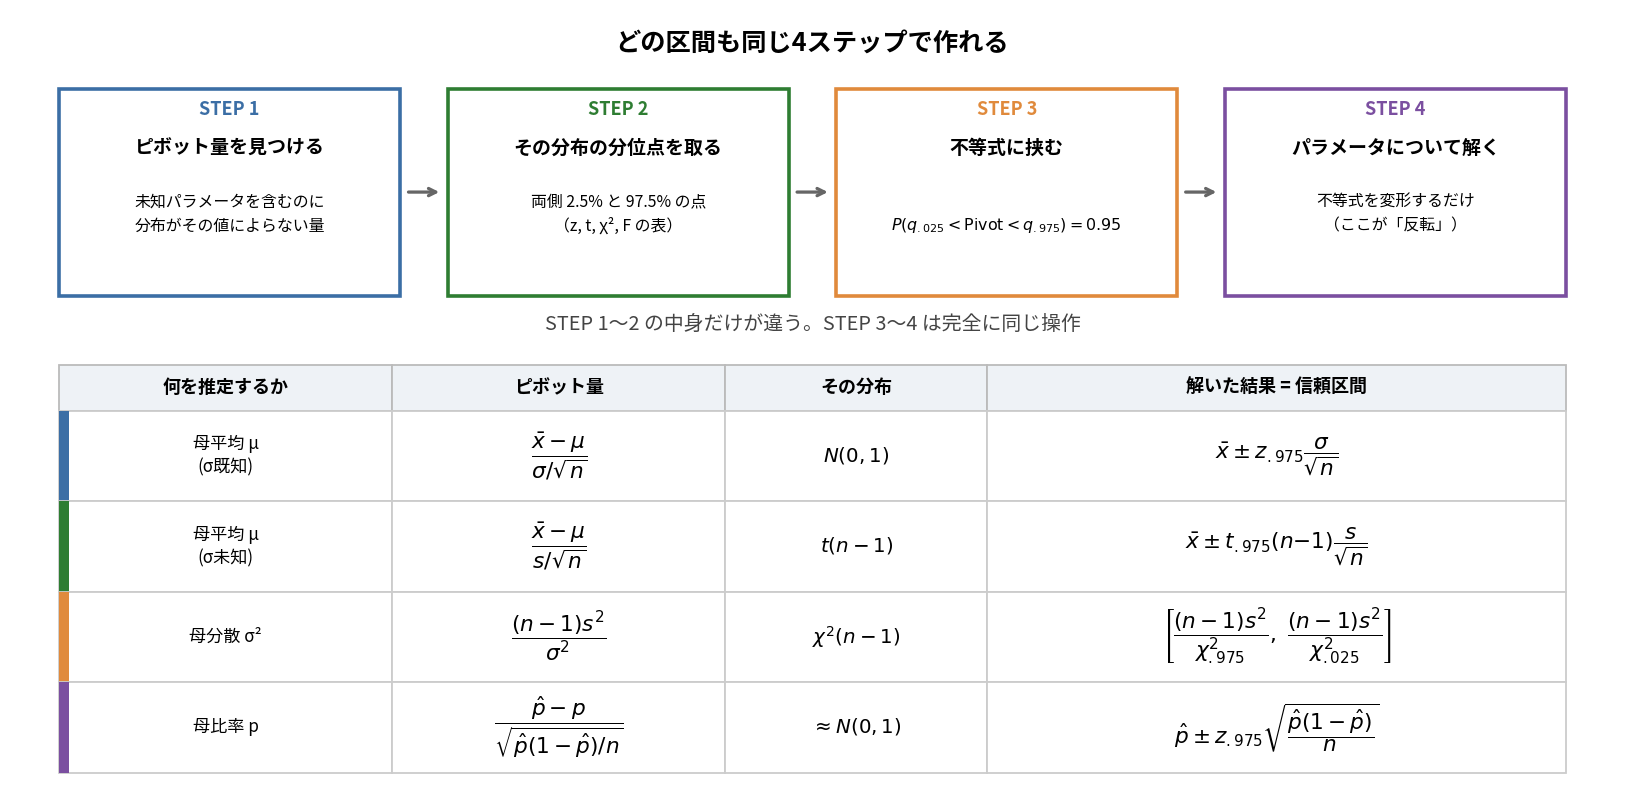
- ピボット量を見つける — パラメータを含むのに、分布がパラメータに依存しない量
- その分布の分位点を取る — 、、、
- 不等式に挟む — 「その量が2つの分位点の間に入る確率が95%」と書く
- パラメータについて解く — 不等式を変形して、パラメータを真ん中に出す
STEP 3〜4 は完全に同じ操作で、違うのは STEP 1〜2 の中身だけです。ピボット量については第7回で扱っていますが、区間推定という手法そのものがピボット量の上に立っているというのが今回はっきりしました。
のデータ(52.1, 48.3, 55.0, 49.8, 51.2, 53.4, 47.6, 50.9, 54.2, 50.5、標本平均 51.3000、不偏分散 5.8778、)で4つ全部やってみます。
| 推定対象 | 使う分位点 | 95%信頼区間 | 幅 |
|---|---|---|---|
| 母平均 ( 既知) | [49.7505, 52.8495] | 3.0990 | |
| 母平均 ( 未知) | [49.5657, 53.0343] | 3.4686 | |
| 母分散 | [2.7809, 19.5898] | 上端は下端の 7.04倍 | |
| 母標準偏差 | 上の平方根 | [1.6676, 4.4260] | 2.65倍 |
母分散の区間で必ずつまずくのは、分位点の大小が入れ替わるところです。 が大きいほど は小さいので、区間の下端に の97.5%点、上端に の2.5%点が来ます。
添字が逆になるのは符号ミスではなく、 が分母にいるためです。これに気づくと、公式を暗記しなくてもその場で導けます。
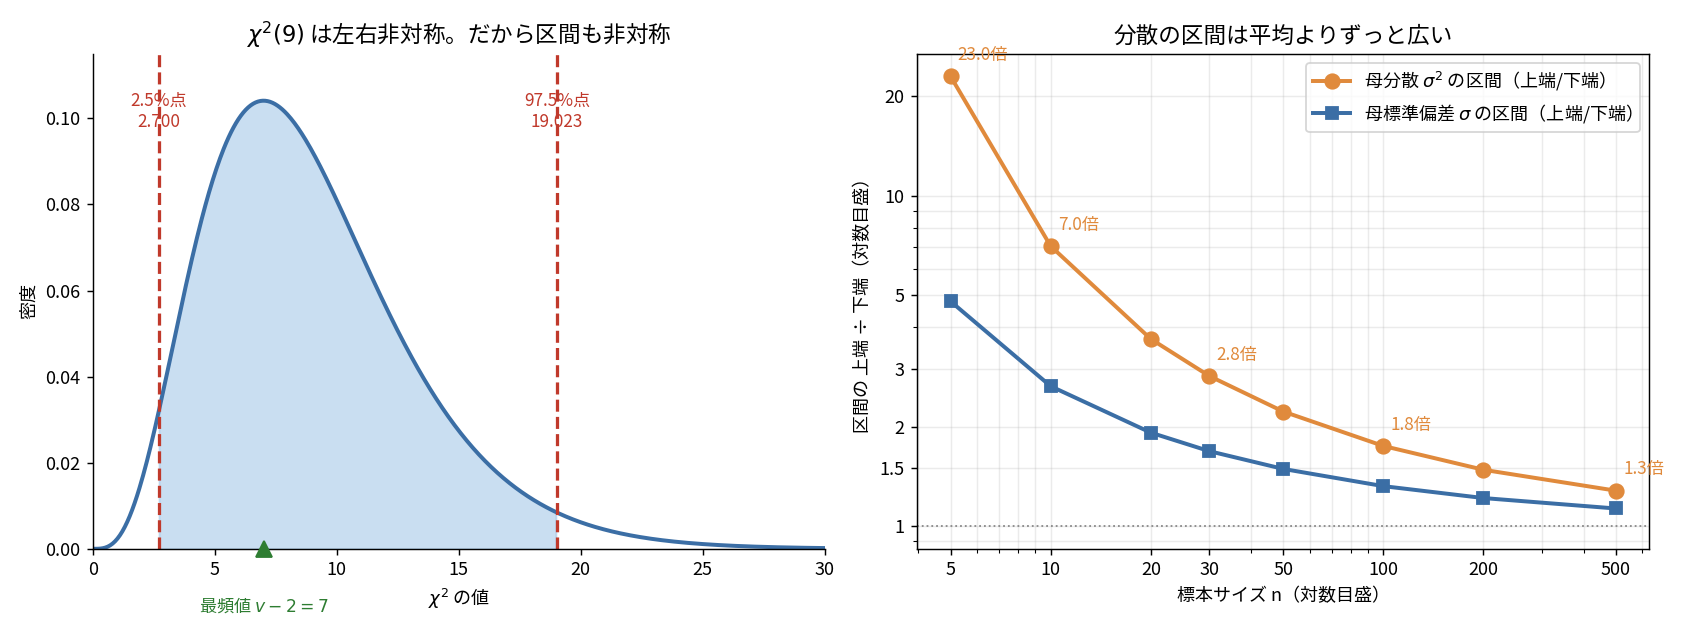
は左右非対称なので、区間も点推定値を中心に対称になりません。平均の区間が の形に書けるのと対照的です。
そして右の図が実務的に効きます。分散の区間はとにかく広いのです。
| 区間の上端/下端 | 区間の上端/下端 | |||
|---|---|---|---|---|
| 5 | 0.4844 | 11.1433 | 23.003 | 4.796 |
| 10 | 2.7004 | 19.0228 | 7.044 | 2.654 |
| 30 | 16.0471 | 45.7223 | 2.849 | 1.688 |
| 100 | 73.3611 | 128.4220 | 1.751 | 1.323 |
| 500 | 438.9980 | 562.7895 | 1.282 | 1.132 |
で母分散の上端が下端の 7.04倍、 でもまだ 1.75倍です。平均の区間が で まで縮むのに比べると、まったく縮んでいません。ばらつきを精度よく推定するのは、平均を推定するよりずっと難しいという教訓になります。
「母分散が既知の場面」は、実は毎日使っている
この章を読んでいて引っかかったのがここでした。母平均を推定したいのに母分散だけ分かっている、という場面が想像できない。 平均が分からないのに分散が分かっているというのは順序が逆に見えます。
調べてみると、この直感は正しくて、そのうえで教科書が 既知を扱う本当の理由は別にあるという結論になりました。理由は3つです。
理由1: 分布の必要性を測る基準線として要る
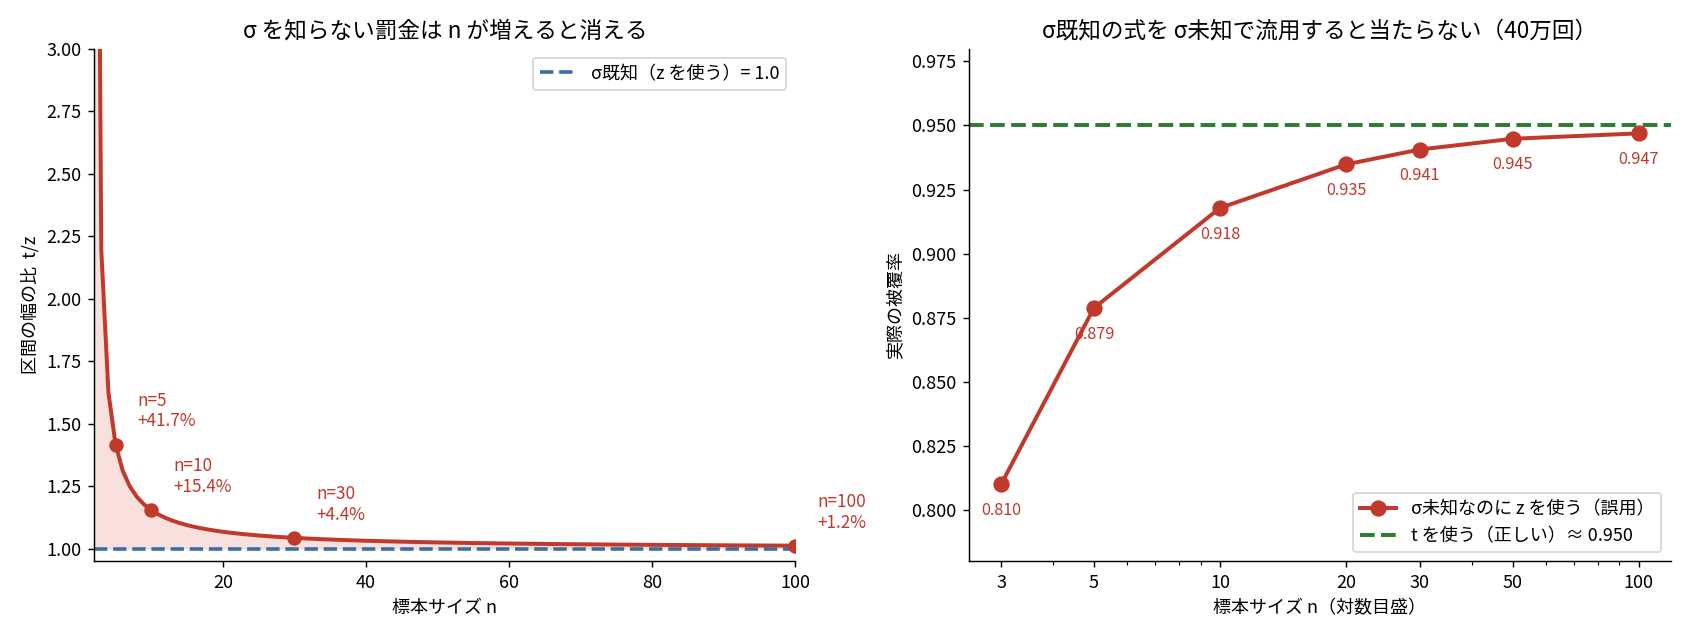
右の図が答えです。 未知なのに 既知の式()を使うと、95%のはずが では 81.0% しか当たりません。 でも 91.8%。
既知の場合を先に立てておかないと、「 分布は何のための補正なのか」が測れないわけです。 既知は理想的な基準線として置かれている。そして左の図が示すのは、この罰金が とともに急速に消えることです( で +4.4%、 で +1.2%)。
理由2:母比率の区間は、構造として「 既知」の場合そのもの
これが一番大事な理由でした。 疑問は「正規分布で 既知」に向いていたのですが、毎日使っている母比率の区間が、構造としては 既知の場合なのです。
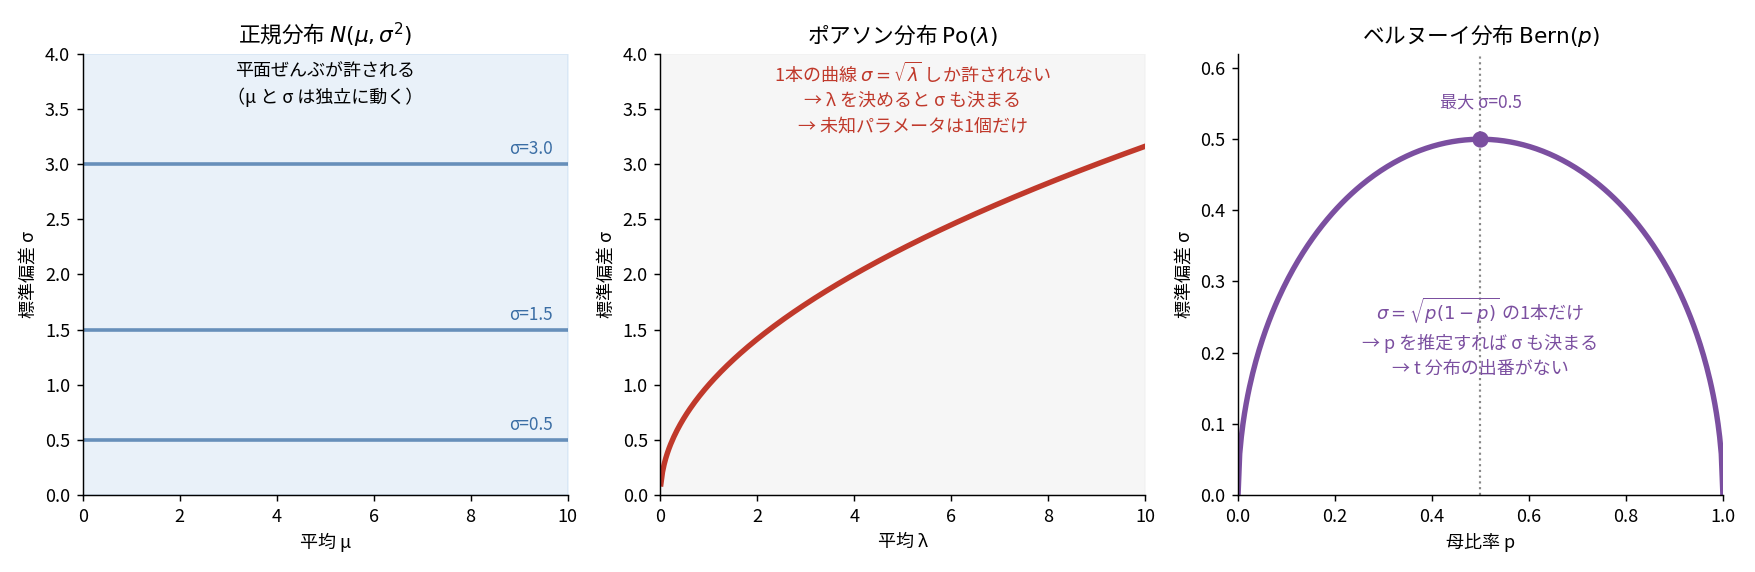
特別なのは正規分布のほうでした。 正規分布 は と が独立に動ける(左の図が平面全体になっている)。だから を推定するときに が「別の未知パラメータ」として邪魔をし、 分布による補正が必要になった。
ところがベルヌーイ分布では です(右の図)。 を決めれば も自動的に決まる。 未知パラメータは の1個だけで、 という独立した未知数は存在しません。
| 分布 | 平均 | 分散 | は独立な未知数か | 使う分布 |
|---|---|---|---|---|
| 正規 | 独立(2パラメータ) | |||
| ベルヌーイ | で決まる | |||
| ポアソン | で決まる | |||
| 指数 | で決まる | (または で厳密に) |
だから母比率の区間推定では 分布による補正の出番がありません。 が要るのは「 が とは独立な第2のパラメータで、その推定の揺れが余分に効いてくる」場合だけだからです。
「 既知」を「 が独立な未知パラメータとして存在しない」と読み替えると、非現実的どころか大半のケースになります。
ただしこれは「 が本当に既知」と同じ強さではありません。 が未知なら も未知で、SE には結局 を代入することになる。正規分布で が既知なら区間は厳密に95%ですが、比率の 区間はそうではありません。この代入のツケが、後半で見るウィルソン区間の話につながります。
理由3:標本サイズ設計では 既知の式しか使えない
これが後半の話につながります。データを取る前に を決めるので、 は存在しません。 に何らかの値を仮定するしかない。つまり 既知の公式は「推定」ではなく 「設計」の場面で本当に使われます。
| 半幅を 以内にしたい | 必要な ( と仮定) | 切り上げ |
|---|---|---|
| 16 | ||
| 97 | ||
| 385 | ||
| 1537 |
精度を2倍にすると は4倍。第8回の の壁がそのまま出ています。
なお が制度的に確立している例も一応あります。校正済み測定器の精度、IQ は定義上 、偏差値は定義上 (設計値なので既知)、臨床検査装置の公称変動係数。ただし本質は理由2と理由3のほうだと思いました。
母比率は新しい概念ではなく、0/1データの平均
理由2に出てきた母比率について、少し戻って整理します。学習中に 「そもそも母比率とは何だっけ」 というところで一度止まったからです。
言葉が硬いだけで、中身はいつも使っている「〜率」でした。母集団の中で、ある性質を持つものの割合のことです。クリック率なら「押した=1 / 押さない=0」の1の割合、内閣支持率なら「支持する=1 / しない=0」の1の割合、不良品率なら「不良=1 / 良品=0」の1の割合。
そして核心は次の1行です。0 と 1 だけのデータの平均を取ると、それは 1 の割合になります。
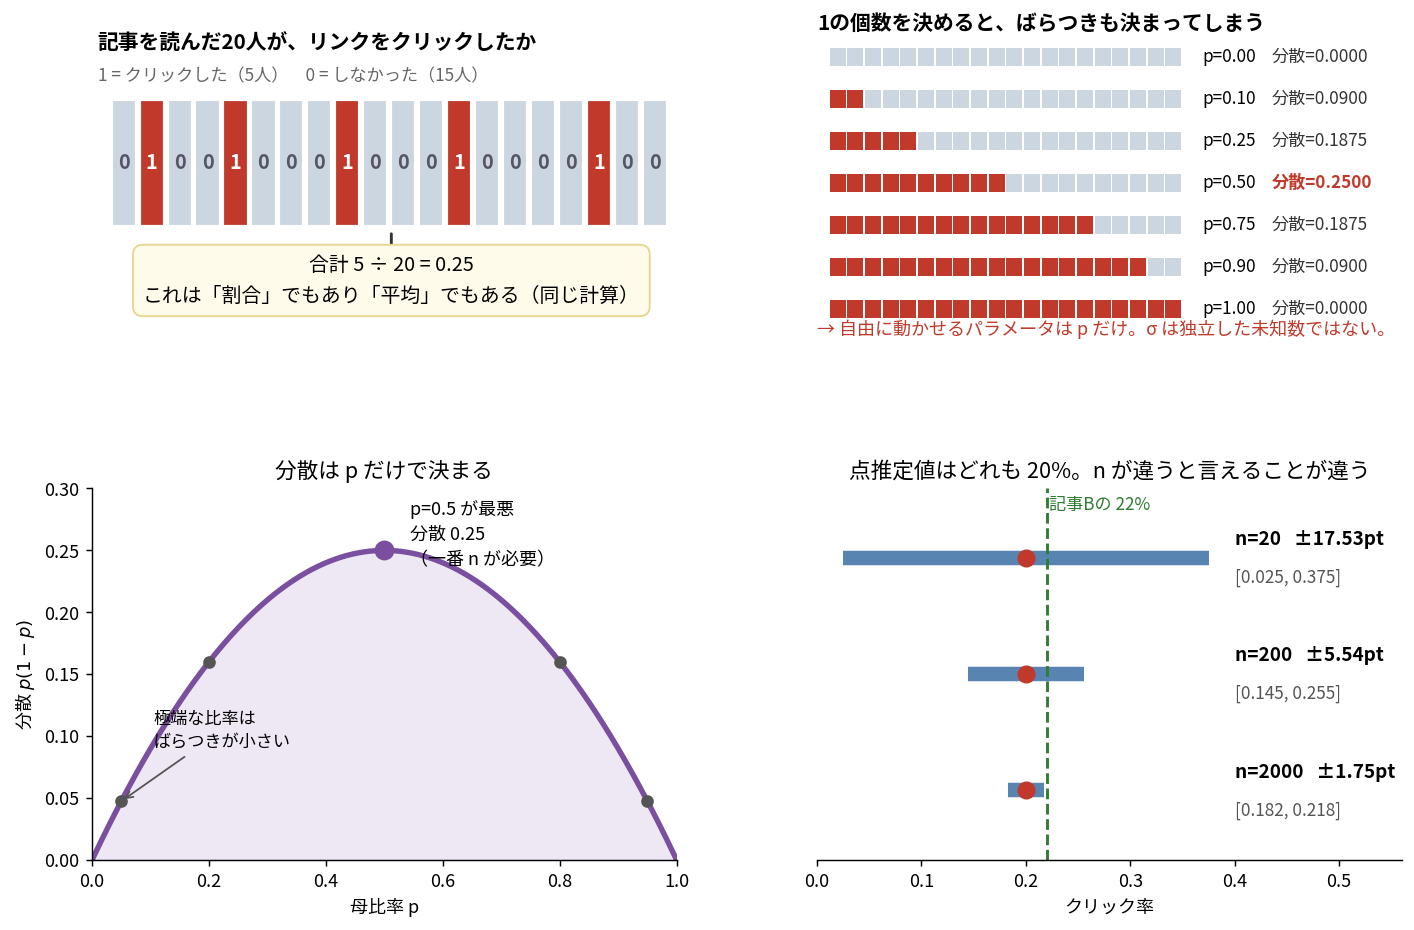
20人のデータ 01001000100010000100 で確かめると、こうなります。
| 計算 | 結果 |
|---|---|
| 1 の個数 ÷ 20(=割合) | |
| データの平均 | 0.2500 ← 同じ |
| データの分散( で割る式) | 0.187500 |
| に を入れる | 0.187500 ← 同じ |
「比率」は新しい概念ではなく、0/1データの平均です。だから第8回でやった平均の道具(標準誤差、1.96、)がそのまま使えます。
そして右上の図が 既知の話に直結します。1 の個数を決めた瞬間に、ばらつきも決まってしまう。 (全員0)と (全員1)は全員同じ答えなのでばらつき 0、 で一番ばらついて分散 0.25。「クリック率が 25% だが、ばらつきはもっと大きい」という状況はありえないわけです。
比率の区間は、二項分布を正規分布で近似したもの
ここで比率と二項分布は同じものを2つの単位で見ているだけという関係も整理できました。二項分布は「何人がクリックしたか」(人数)を見て、比率は「何割がクリックしたか」(割合)を見る。片方を で割ればもう片方になります。
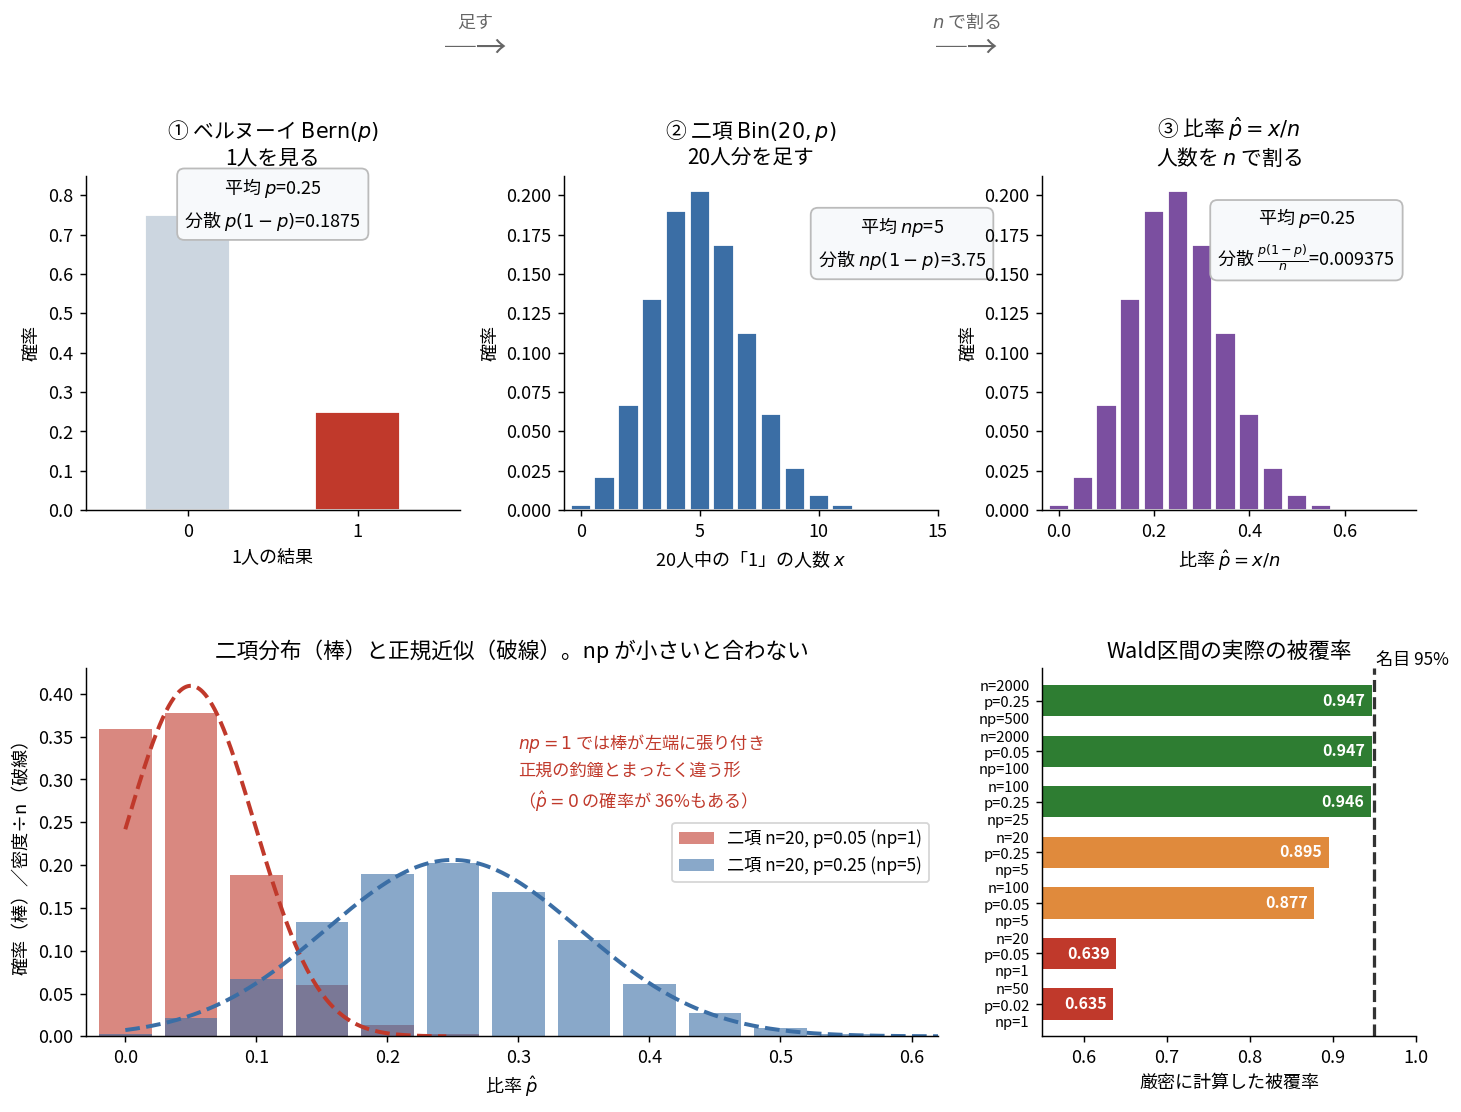
| 段階 | 何を見ているか | 分布 | 平均 | 分散 |
|---|---|---|---|---|
| ① | 1人の結果(0か1) | ベルヌーイ | ||
| ② | 20人中の人数 | 二項 | ||
| ③ | 比率 | ②を で割ったもの |
ここで が出てくる仕組みが見えます。 人数の分散は で に比例して増えるのに、 で割って比率にすると で に反比例して減る。標準誤差はその平方根なので 。第8回の が、 の位置に が入った顔で現れているだけでした。
そして比率の区間推定は、この離散な二項分布を連続な正規分布で近似しているので、条件が悪いと壊れます。
| 厳密に計算した被覆率 | 名目 | 判定 | |||
|---|---|---|---|---|---|
| 50 | 0.02 | 1 | 0.6354 | 0.95 | 破綻 |
| 20 | 0.05 | 1 | 0.6389 | 0.95 | 破綻 |
| 100 | 0.05 | 5 | 0.8775 | 0.95 | 危険 |
| 20 | 0.25 | 5 | 0.8949 | 0.95 | 危険 |
| 100 | 0.25 | 25 | 0.9459 | 0.95 | OK |
| 2000 | 0.05 | 100 | 0.9467 | 0.95 | OK |
| 2000 | 0.25 | 500 | 0.9470 | 0.95 | OK |
被覆率はシミュレーションではなく、二項確率で全ての を重み付けした厳密計算です。
のケースが破滅的です。 「95%信頼区間」と名乗りながら 63.5% しか当たらない。理由は 、 では になる確率が 36% もあることです。そのとき区間は と幅ゼロに潰れます。真の を含むわけがありません。
第7回では「期待度数5以上」、第8回では中心極限定理が破綻する条件として登場した が、ここで3回目の登場です。ただしこの表を見ると でも 88〜89% しかないので、この目安はかなり甘いことも分かりました。 は「使ってよい」ではなく「これ未満は論外」の線と読むべきだと思います。
2本の区間の重なりで差を判断してはいけない
ここから2標本です。実務でほしいのはほぼ「2つを比べる」ほうで、1標本のときには存在しなかった落とし穴が2つ出てきます。
1つめが最頻出の誤りです。グラフに群Aと群Bのエラーバーを2本並べて、「重なっているから差はない」と読む。これは誤りです。
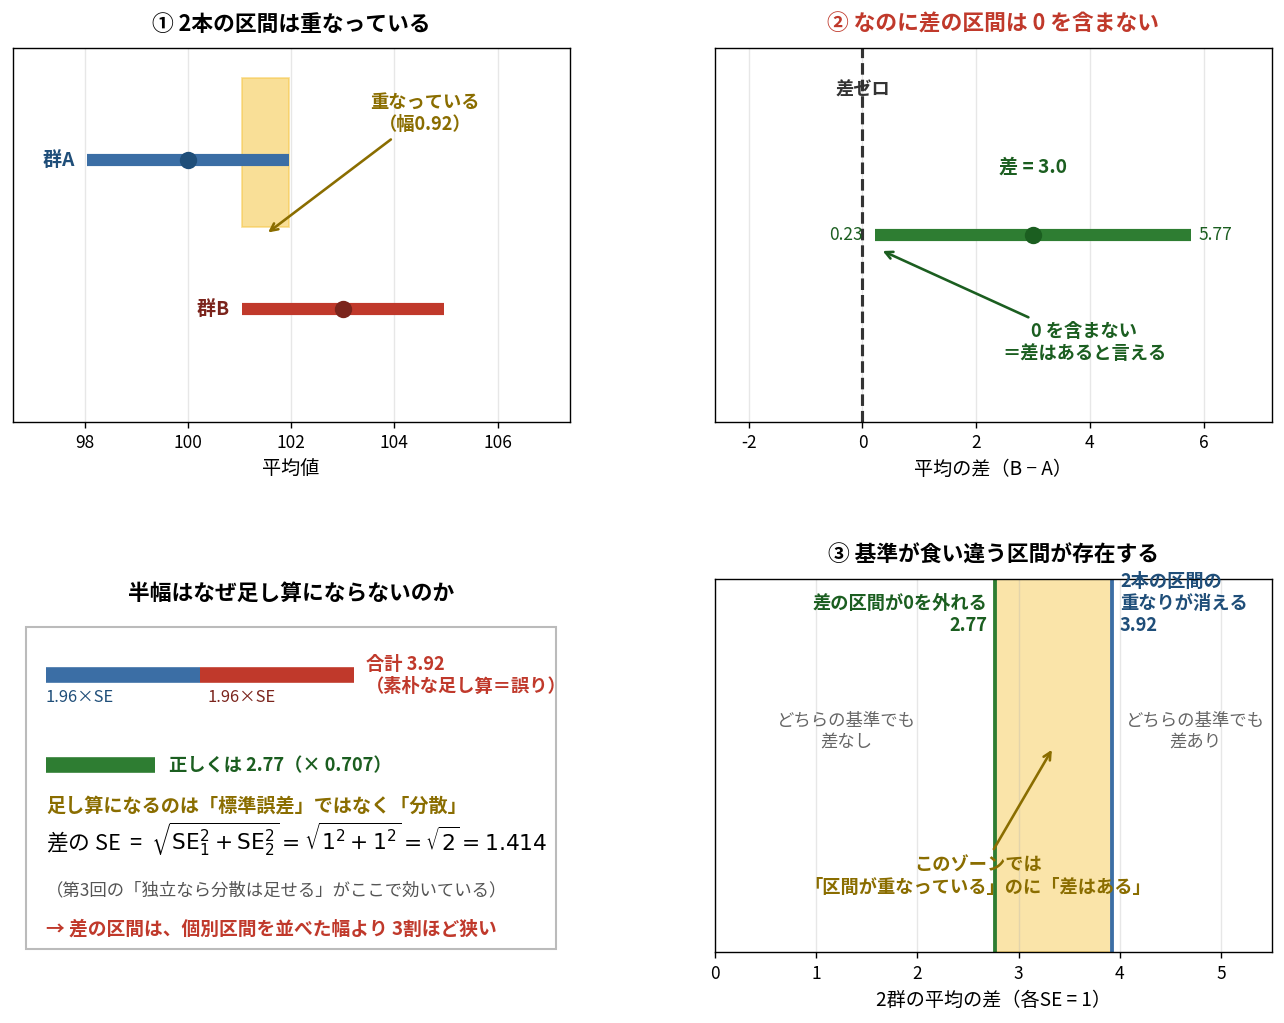
左上と右上は同じデータです。 個別の区間は重なっているのに、差の区間は 0 を含みません。つまり 「差はある」と言える。
理由は半幅が足し算にならないことです。足せるのは分散のほうでした(第3回「独立なら分散は足せる」)。 で、素朴に足した 2.0 より小さい。だから差の区間は個別区間を並べた幅の 0.707 倍にしか広がりません。
右下のとおり、2.77 〜 3.92 のあいだが「重なっているが差はある」ゾーンです。ここに入るデータを重なりで判断すると、実際にある差を見逃します。
「分散だけが足せる」を東に3歩、北に4歩で理解する
「独立なら分散は足せる」は公式として知っていましたが、なぜ半幅ではなく分散なのかが感覚として入っていませんでした。これは直角三角形の話だと思うのが一番効きました。
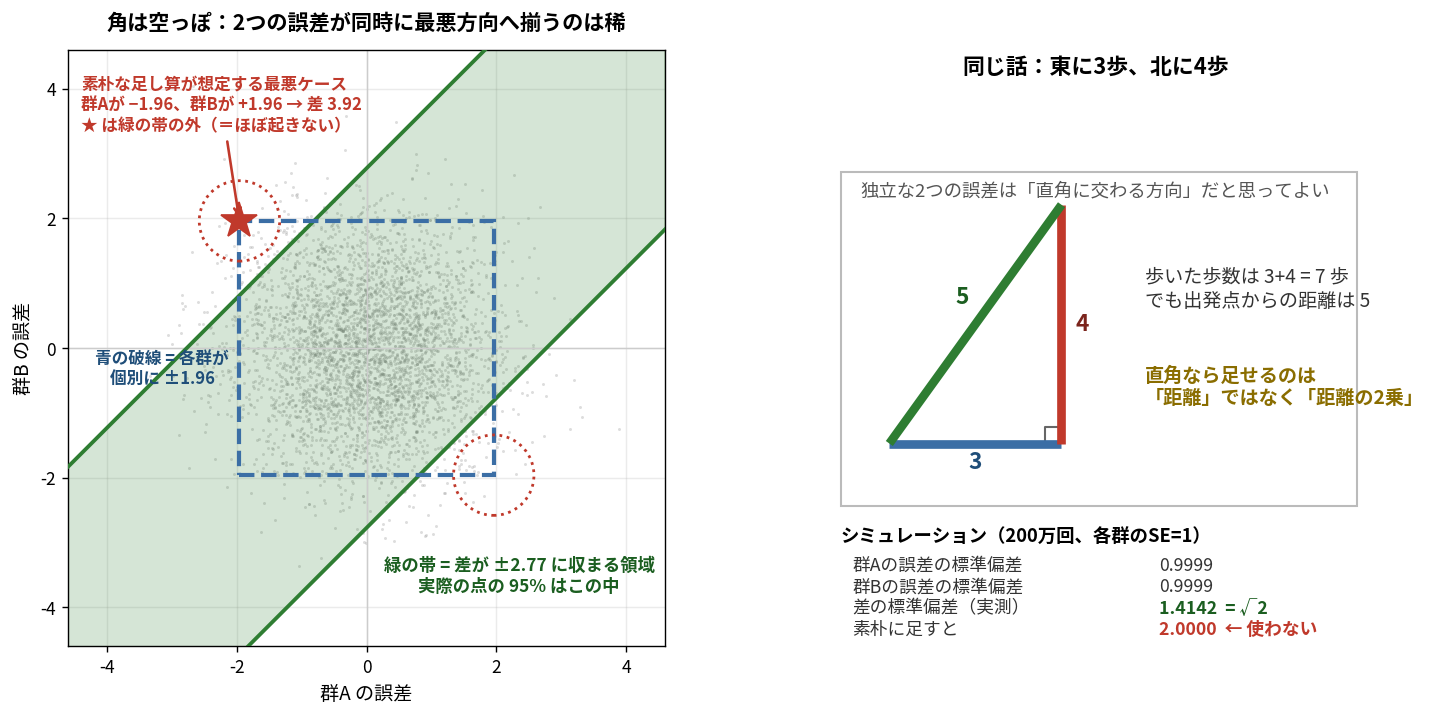
左の図が「なぜ狭くなるか」の答えです。 横軸に群Aの誤差、縦軸に群Bの誤差を取ると、実際のデータは真ん中に丸く集まります。
青い破線の正方形が「各群が個別に の範囲」です。素朴な足し算 3.92 は、この正方形の角(★)を想定しています。 つまり群Aが最大にマイナスへ外れ、同時に群Bが最大にプラスへ外れるという最悪ケース。
でも赤い点線の円の中を見ると、点がほとんどありません。 2つの独立な誤差が同時に大きく、しかも都合よく逆向きに揃うことは、めったに起きない。だから角を切り落とした緑の帯()で十分95%を捕まえられるのです。
右の図が同じことの幾何です。3歩東・4歩北に歩けば、歩数は 7 でも出発点からの距離は 5。2つの誤差は「同じ直線上」ではなく「直角に交わる別の方向」に働くので、合成した長さは足し算にならずピタゴラスの定理になります。
「分散が足せる」というのは、「2乗したものが足せる」=ピタゴラスの定理と言い換えられます。分散はもともと「2乗の平均」なので、最初から2乗の世界の量なのでした。
数字で確認すると、200万回の実測で差の標準偏差が 1.4142(理論値 に一致)、素朴に足した値は 2.0000。区間の被覆率で見ると次のようになります。
| 区間の作り方 | 半幅 | 実際の被覆率 | 評価 |
|---|---|---|---|
| 素朴な足し算 | 3.9199 | 0.9944 | 広すぎる(99.4%になってしまう) |
| 正しい | 2.7718 | 0.9499 | ちょうど95% |
素朴な足し算は「間違って狭い」のではなく「無駄に広い」 のです。だから重なりで判断すると、実際にある差を見逃す方向に間違えます。
逆に、独立でないなら足せません。 同じ人に施策の前後を測った場合(対応のあるデータ)、2つの誤差は同じ方向に動きます=直角ではない。このとき差のばらつきは となり、相関 が正ならもっと小さくなります。これが「対応のあるデータは検出力が高い」の正体で、第3回の「独立なら分散は足せる」の条件節が効いているところです。
半幅という言葉
ここまで断らずに使っていましたが、半幅(half-width)は信頼区間の中心から端までの距離です。区間が なら幅は 23.82、半幅はその半分の 11.91。 と書いたときの のあとの数字が半幅です。
信頼区間はほとんどの場合「点推定値 何か」の形なので、精度を1つの数字で言いたいときに便利で、標本サイズ設計では半幅が主役になります。マージン・オブ・エラーと呼ばれることもあり、世論調査の「誤差 ポイント」がまさにこれです。
なお母分散の区間は「 の形」に書けません( が非対称なので中心が真ん中に来ない)。だから前のセクションでは半幅ではなく「上端 ÷ 下端が何倍」という言い方をしていました。
平均の差:プールとウェルチは「SEの作り方」が違うだけ
平均の差の区間でも4ステップは変わりません。変わるのは SE と自由度だけです。ただしSE の作り方が2通りあるのが2標本の新しい点でした。
記事Aと記事Bの滞在時間(秒)を例にします。群A は 、平均 182.9000、不偏分散 119.2111()。群B は 、平均 210.7500、不偏分散 151.9286()。差(B − A)は 27.8500 秒です。
| 方法 | SE の作り方 | SE | 自由度 | 95%信頼区間 | 半幅 | |
|---|---|---|---|---|---|---|
| プール(等分散を仮定) | 5.4812 | 16 | 2.119905 | [16.2305, 39.4695] | 11.6195 | |
| ウェルチ | 5.5599 | 14.1958 | 2.142015 | [15.9407, 39.7593] | 11.9093 |
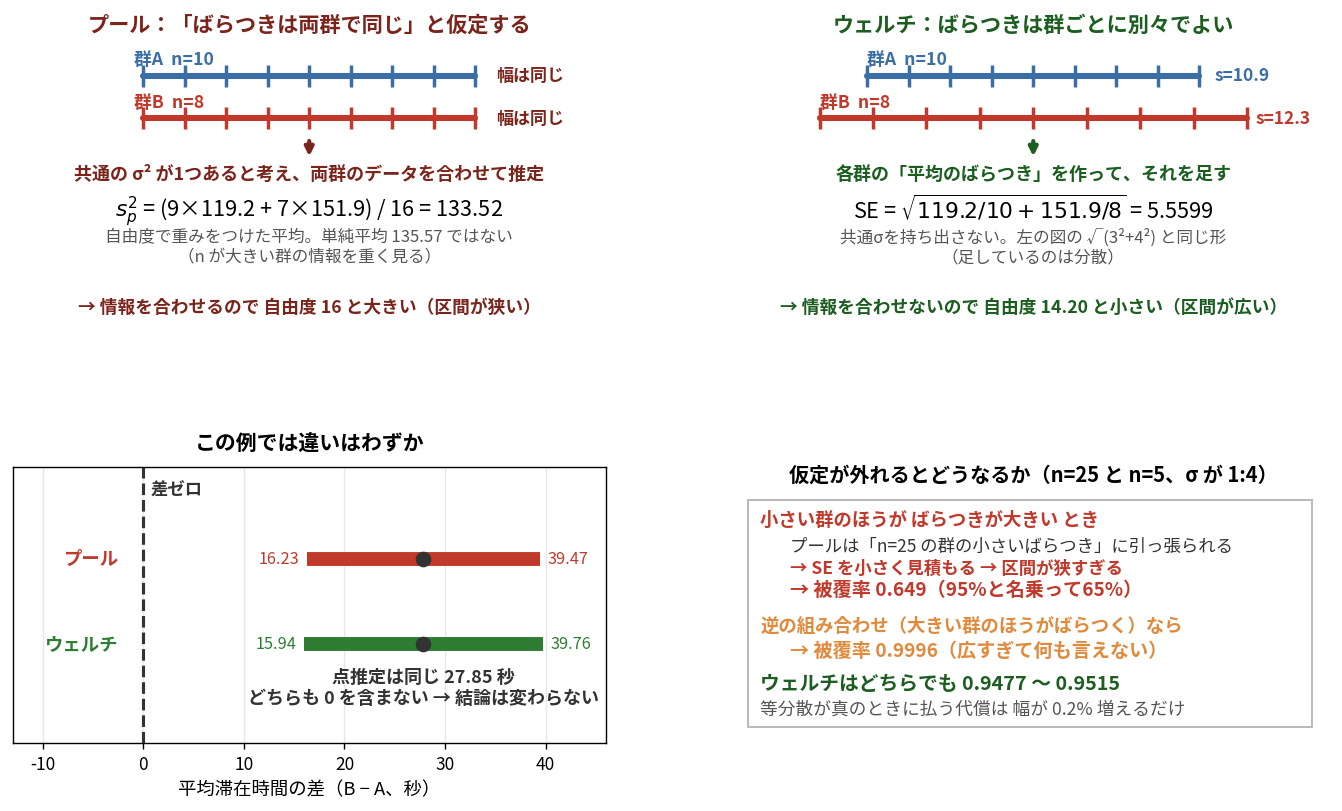
プール(pooled)は「1つにまとめる」 という意味です。「両群のばらつきは同じ だ」と仮定して、その を両群のデータを合わせて推定します。
ここでひとつ引っかかったのが、これが単純平均(135.5698)ではないことです。自由度で重みをつけた平均になっています。 が大きい群のほうが情報が多いので重く見る、ということでした。
得することは自由度です。 2群の情報を合わせるので と大きくなり、 の分位点が小さくなって区間が狭くなる。つまり 「両群のばらつきは同じ」という仮定を持ち込むことで、情報を得ているわけです。
ウェルチ(Welch)は共通の という仮定を置きません。 各群の「平均のばらつき」を作って足すだけです。
これがまさに上のピタゴラスの形です(分散を足して平方根)。ただし代償があって、この量は厳密には 分布に従いません。そこで「 分布で近似したときにいちばん合う自由度」を計算します。それが 14.1958 という半端な数字の正体でした。動く範囲は決まっていて、上限が 、下限が です。
なお、ここでやっているのは平均の差の区間推定だけで、等分散の検定の話ではありません。 自分はここを一度混同しました。「等分散かどうかを検定してから方法を選ぶ」という手順が実務でよく見られるので、区間推定の話と検定の話が地続きに見えてしまうのです。やっていることは「SE の作り方を2通りのどちらにするか」の選択だけです。
どちらを使うべきか:被覆率を測ると答えが出た
この選択に迷う必要はありませんでした。 被覆率を測ったら一方的な結果になりました。
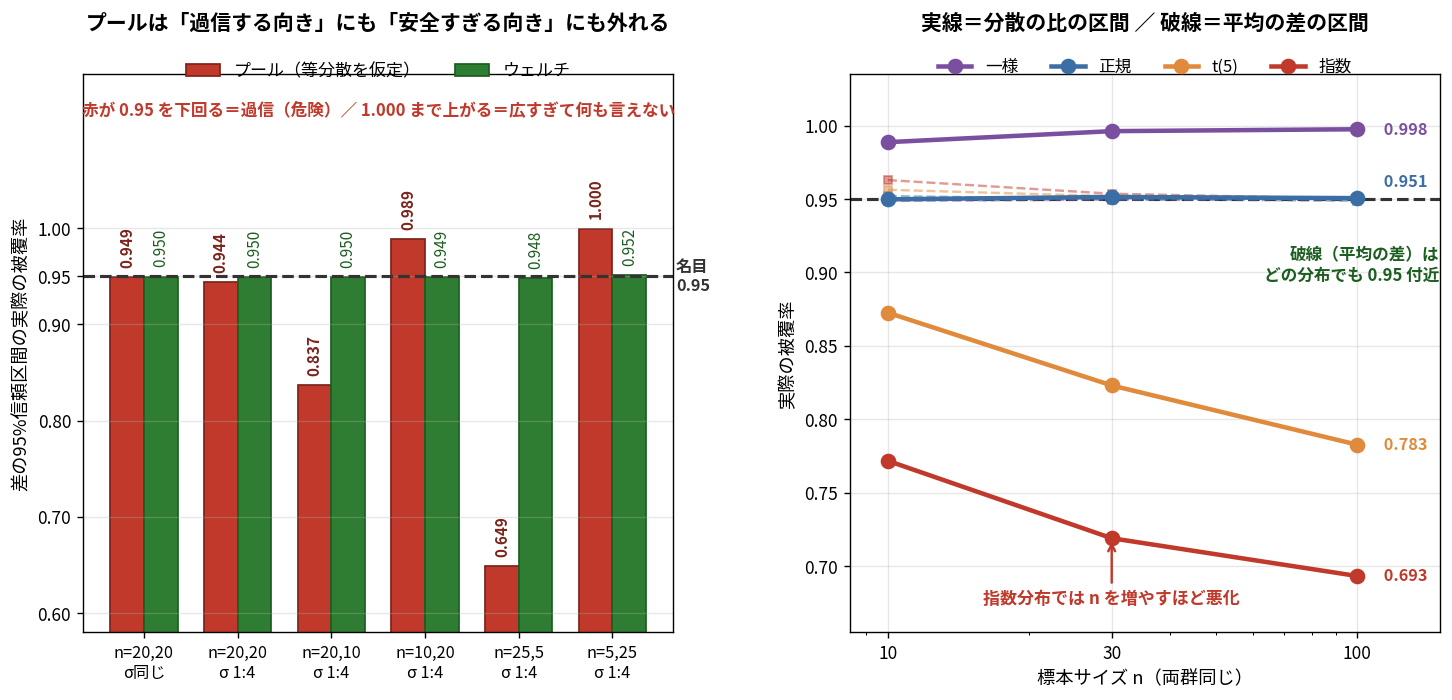
| プールの被覆率 | ウェルチの被覆率 | プールの平均幅 | ウェルチの平均幅 | |||
|---|---|---|---|---|---|---|
| 20 | 20 | 1 : 1 | 0.9493 | 0.9497 | 1.2721 | 1.2741 |
| 20 | 20 | 1 : 4 | 0.9443 | 0.9496 | 3.6894 | 3.7853 |
| 20 | 10 | 1 : 4 | 0.8374 | 0.9495 | 3.7477 | 5.6081 |
| 10 | 20 | 1 : 4 | 0.9889 | 0.9492 | 5.2378 | 3.8811 |
| 25 | 5 | 1 : 4 | 0.6489 | 0.9477 | 3.4486 | 9.2956 |
| 5 | 25 | 1 : 4 | 0.9996 | 0.9515 | 7.4017 | 3.7575 |
各20万回、真の平均差はゼロ、名目 0.95 です。
ウェルチは6条件すべてで 0.948〜0.952。プールは が違うと大きく振れます。 しかも振れる向きが の組み合わせで逆転するのが厄介でした。「小さい の群のほうが が大きい」ときに過信側(0.649)へ、逆なら安全側(0.9996)へ。0.9996 は一見よさそうですが、区間が広すぎて何も言えない状態です。
結論はシンプルで、迷ったらウェルチです。等分散が真のときの損は被覆率 0.9497 対 0.9493 でほぼゼロ、幅も 1.2741 対 1.2721 で 0.2% 増えるだけ。払うコストがこれだけで、避けられる事故が です。 比較になりません。実際 R の t.test() はウェルチが既定値です。Python の scipy.stats.ttest_ind は既定が equal_var=True(プール)なので、明示的に equal_var=False を指定するのが実務的な作法になります。
それなら、なぜ教科書はプールを先に教えるのか。 理由は3つありました。①正規・等分散のもとでは厳密に に従う(ウェルチは近似)ので理論として気持ちがよく、試験で手計算できる。②分散分析の土台で、3群以上に拡張すると「群内のばらつきをプールする」がそのまま分散分析になる。③等分散に物理的な根拠がある場合は効率的。
ただし③の根拠は事前知識から来るべきで、同じデータの等分散検定から来てはいけません。 データを見て手法を選ぶと、名目の信頼係数が保証されなくなります。この点は次のセクションで数字が出ます。
比率の差:A/Bテストで一番使う形
比率でも構造は同じで、SE の中身が変わるだけです。
ルートの中が2つの足し算になっているのが「分散は足せる」の現れです。 分布ではなく なのは、前に見たとおり比率では が独立な未知数ではないからです。
| ケース | 差 | 95%信頼区間 | 半幅 | 0 を | ||||||
|---|---|---|---|---|---|---|---|---|---|---|
| 記事A vs 記事B | 2000 | 400 | 2000 | 440 | 0.2000 | 0.2200 | 0.0200 | [−0.0052, 0.0452] | ±2.52pt | 含む |
| 1桁小さいサンプル | 200 | 40 | 200 | 44 | 0.2000 | 0.2200 | 0.0200 | [−0.0598, 0.0998] | ±7.98pt | 含む |
| 極端に小さい | 20 | 4 | 20 | 5 | 0.2000 | 0.2500 | 0.0500 | [−0.2084, 0.3084] | ±25.84pt | 含む |
| 片方だけ大きい | 5000 | 1000 | 300 | 72 | 0.2000 | 0.2400 | 0.0400 | [−0.0096, 0.0896] | ±4.96pt | 含む |
この表が実務的に一番効きました。 1行目、各群 2000PV ずつ集めても、20% と 22% の差(2pt)は区間が 0 を含みます。 半幅が pt なので、2pt の差では届かない。
そして4行目が重要です。片方を 5000 に増やしても、もう片方が 300 なら半幅は pt。 SE は小さいほうの に支配されます。 片側だけサンプルを積んでも精度は上がりません。A/Bテストで両群を同じ大きさにするのは、この理由でした。
分散の比は 分布で作れるが、使わないほうがよい
2つのばらつきを比べるときは、差ではなく比を見ます。第7回で見たとおり が 分布に従うので、それをピボット量にします。
先ほどの滞在時間データでやってみます。
| 値 | |
|---|---|
| 分散比の点推定 | |
| の 2.5% 点 | 0.207330 |
| の 97.5% 点 | 4.197047 |
| の 95%信頼区間 | [0.3037, 6.1469] |
| 上端 ÷ 下端 | 20.24 倍 |
| の区間(平方根) | [0.5510, 2.4793] |
| 1 を含むか | 含む(等分散を否定できない) |
比 のとき の自由度は で、分子と分母が入れ替わります。 そして1標本の分散のときと同じく、区間の下端に 97.5% 点、上端に 2.5% 点が来ます(比が分母にあるため大小が反転)。また の 2.5% 点 の 97.5% 点という関係があるので、片側の表だけで計算できます。試験ではこれを使います。
ここが今回いちばん意外だった発見でした。 この 区間は正規性がないと崩れ、しかも を増やすほど悪化します。
| 母集団の分布 | 区間 | 区間 | 区間 | 差の区間 | 差の区間 | 差の区間 |
|---|---|---|---|---|---|---|
| 正規 | 0.9498 | 0.9514 | 0.9506 | 0.9520 | 0.9500 | 0.9488 |
| 一様(裾が軽い) | 0.9887 | 0.9962 | 0.9975 | 0.9487 | 0.9496 | 0.9503 |
| (裾が重い) | 0.8726 | 0.8231 | 0.7828 | 0.9563 | 0.9519 | 0.9497 |
| 指数(歪んでいる) | 0.7718 | 0.7191 | 0.6934 | 0.9629 | 0.9536 | 0.9502 |
各10万回、真の分散比 、真の平均差 、名目 0.95、両群 は同じです。
指数分布で 。第8回で見た中心極限定理の話と正反対です。
なぜか。平均の区間は中心極限定理に守られています(右半分の列:どの分布でも で 0.95 に収束)。ところが分散の区間を守ってくれる定理はありません。 が 、比が になるのは正規分布であることを直接使った結果で、 を増やしても正規に近づく理屈がない。むしろ が増えると区間が狭くなるので、ずれた中心を捕まえられなくなり悪化します。
平均の区間は正規性が要らない(CLT が守る)。分散・分散比の区間は正規性が必須(守る定理がない)。しかも を増やしても直らない。 この対比は、区間推定の道具を選ぶときの判断基準として一番使えるものだと思いました。
だから実務上は、2群のばらつきを比べたいだけなら 区間・ 検定は避けたほうがよいという結論になります。そして 「等分散かどうか 検定で調べてから 検定の方法を選ぶ」という二段構えは二重に悪い。 ① 検定自体が正規性の崩れで壊れる、②データを見て手法を選ぶので全体の信頼係数が保証されない。
実際に測ってみると、、、 の条件で、二段構えの手続きの被覆率は 0.9332(ウェルチは 0.9475)でした。しかも幅はほぼ同じ(9.22 対 9.32)。幅の得がないのに被覆率だけ落ちるので、選ぶ理由がありません。
「等分散を仮定していいか」はデータに聞く質問ではなく、実験の設計に聞く質問なのだと理解しました。 分布の存在価値は、第7回でも書いたとおり等分散検定ではなく分散分析と回帰分析のほうにあります。
標本サイズ設計:同じ式を逆向きに読むだけ
先に一行で書くと、この節は「必要な精度から、必要なデータ量を計算する」話です。 ここまでは「 が与えられたとき半幅はいくらか」を計算してきました。設計とは、その式の既知と未知を入れ替えるだけです。
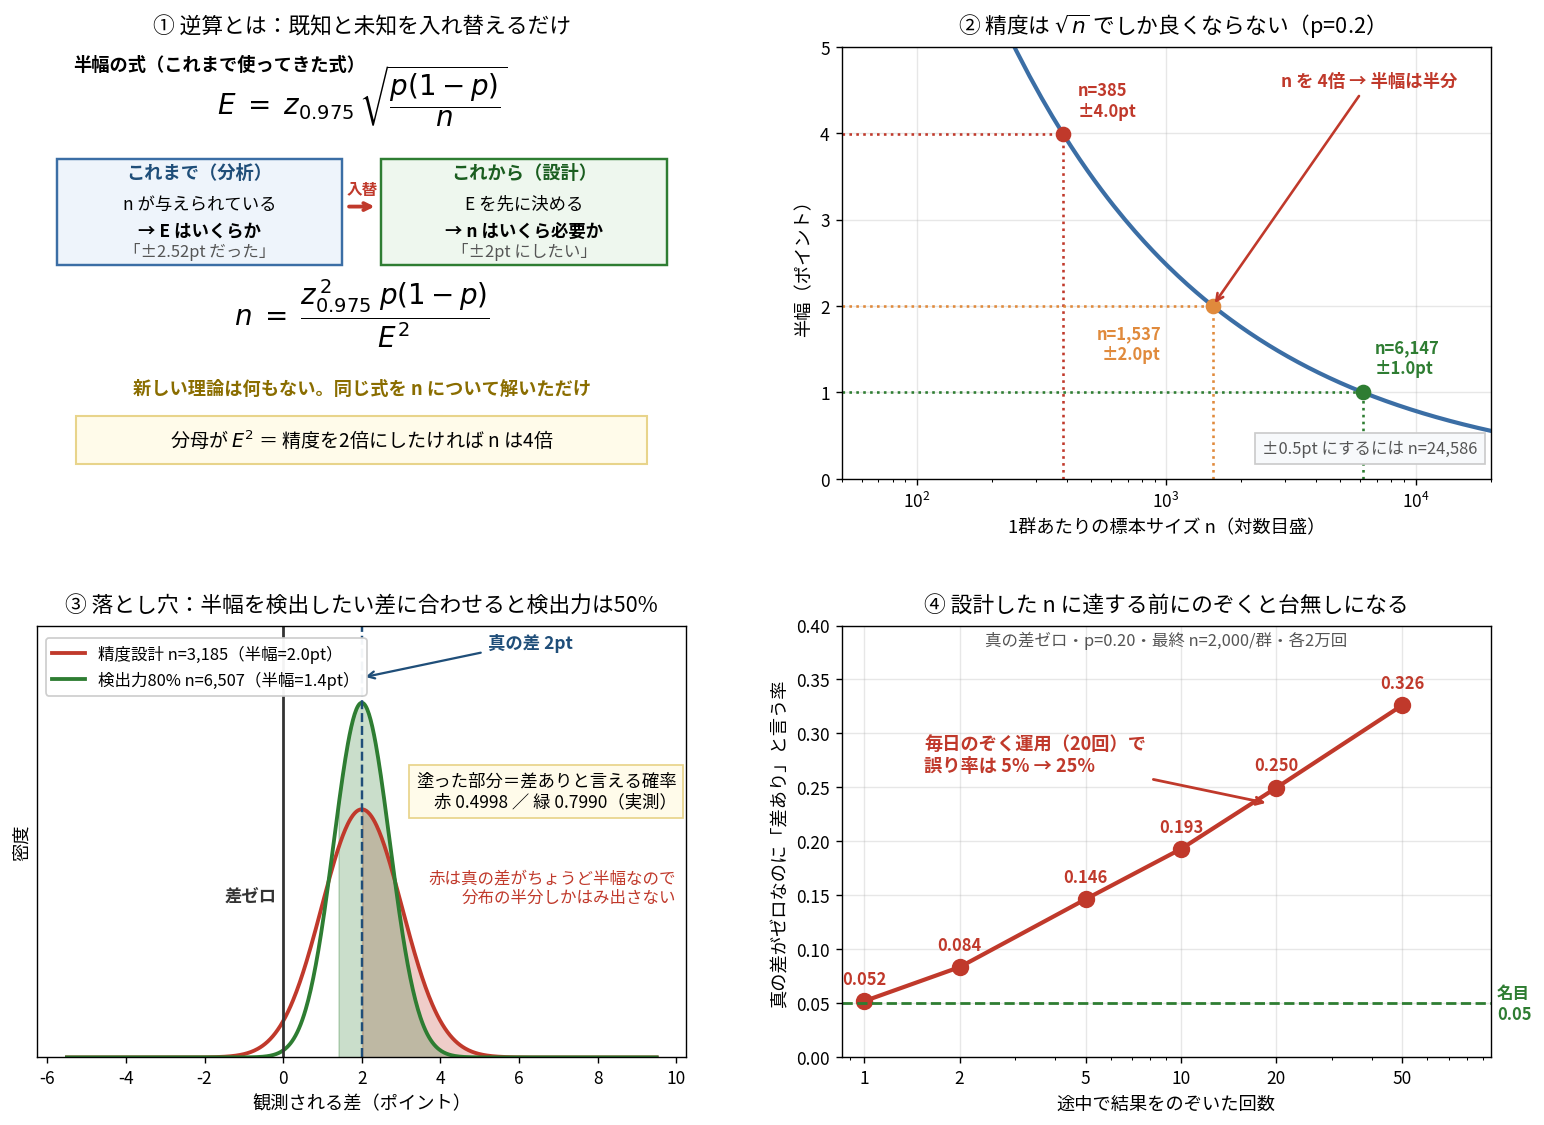
やることは移項だけで、新しい理論は何もありません。 ただし分母が なので、精度を2倍にするには を4倍、10倍にするには100倍必要です。
| ほしい半幅 | (最悪) | |||
|---|---|---|---|---|
| ±10pt | 97 | 62 | 19 | 4 |
| ±5pt | 385 | 246 | 73 | 16 |
| ±3pt | 1,068 | 683 | 203 | 43 |
| ±2pt | 2,401 | 1,537 | 457 | 96 |
| ±1pt | 9,604 | 6,147 | 1,825 | 381 |
| ±0.5pt | 38,415 | 24,586 | 7,299 | 1,522 |
世論調査の「〜1,200」の正体がこの表にありました。 で pt を狙うと 1,068。テレビの世論調査がだいたいこの規模なのは偶然ではなく、「誤差 ポイント」を目標にして逆算した結果です。
が未知のときは を使います。 が最大 0.25 になるので、最悪ケースで見積もれば安全側だからです。これが「 を仮定する」という慣習の理由で、政治的な意味はありません。
落とし穴:素朴に逆算した では、検出力が50%しかない
ここが今回いちばん重要な区別でした。 「2ptの差を見たい」と言われて、素朴に「半幅を2ptにすればいい」と考えると失敗します。半幅をちょうど検出したい差に合わせると、検出力は約50%しかありません。
| 真の差 | 設計 | /群 | 理論半幅 | 実測半幅 | 実測検出率 | ||
|---|---|---|---|---|---|---|---|
| 0.20 | 0.220 | 2.0pt | 精度設計() | 3,185 | 2.000pt | 1.999pt | 0.4998 |
| 0.20 | 0.220 | 2.0pt | 検出力80% | 6,507 | 1.399pt | 1.399pt | 0.7990 |
| 0.20 | 0.240 | 4.0pt | 精度設計() | 823 | 3.998pt | 3.995pt | 0.5030 |
| 0.20 | 0.240 | 4.0pt | 検出力80% | 1,680 | 2.798pt | 2.797pt | 0.8004 |
| 0.05 | 0.060 | 1.0pt | 精度設計() | 3,992 | 1.000pt | 1.000pt | 0.4980 |
| 0.05 | 0.060 | 1.0pt | 検出力80% | 8,155 | 0.700pt | 0.699pt | 0.7993 |
| 0.50 | 0.550 | 5.0pt | 精度設計() | 765 | 4.998pt | 4.995pt | 0.4956 |
| 0.50 | 0.550 | 5.0pt | 検出力80% | 1,562 | 3.498pt | 3.497pt | 0.8027 |
各20万回、検出率は「差の95%信頼区間が 0 を含まない割合」です。
なぜちょうど 0.50 になるのか。 真の差が 2pt で、半幅も 2pt。すると観測される差の分布は 2pt を中心に散らばるので、ちょうど半分が 2pt を超え、半分が下回ります。超えたときだけ区間が 0 を外れる。だから 50%。コインを投げているのと同じです。
だから設計には2種類あることになります。
- 精度設計:区間の幅を保証する。 → 検出力は約50%
- 検出力設計:差を見つける確率を保証する。
違いは が1つ増えるだけです。そして倍率は常に一定でした。
検出力を80%にしたければ精度設計の約2.04倍、90%なら 2.7353倍。 にも にもよらず、常にこの倍率です(上の表で の比が 2.041〜2.043 に揃っているのがその確認になります)。覚えるのは と の2つだけです(厳密には 、 を使った 7.849 と 10.507)。
なぜ が2つ足されるのか。 検出力は2つの分布を同時に相手にしているからです。「差ゼロのときに誤って差ありと言う確率を に抑える」ために ぶんの距離が必要で、さらに「真の差 のときに80%の確率でその線を超える」ために ぶんの距離が必要。2つの分布を引き離す距離なので、両方の分の余裕を足すことになります。第2回で見た と検出力が、ここで という1つの数字に合流しました。
もうひとつの落とし穴:途中で結果をのぞくと台無しになる
設計した に達する前に「もう差が出てるかな」と毎日確認する。これが設計を無意味にします。
| 途中でのぞいた回数 | 真の差がゼロなのに「差あり」と言う率 |
|---|---|
| 1(最後だけ見る=正しい運用) | 0.0521 |
| 2 | 0.0836 |
| 5 | 0.1465 |
| 10 | 0.1930 |
| 20(毎日のぞく運用) | 0.2497 |
| 50 | 0.3262 |
真の差ゼロ、、最終 /群、各2万回、名目の誤り率 0.05 です。
毎日のぞいて「0を含まなくなったら止める」運用は、誤り率5%ではなく25%です。 ノイズがたまたま大きく振れた瞬間を、何度もチャンスを与えて待ち構えているのと同じだからです。
これはさきほど批判した「データを見て手法を選ぶ」とまったく同じ構造の誤りです。95% という数字は「手続きを固定したうえで」の保証なので、データを見て止めるタイミングを決めると保証が消えます。
対策は3つあります。① を先に決めて、そこまで見ない(いちばん簡単で確実)。②どうしても途中で見たいなら群逐次法( を分割する。O'Brien–Fleming 型など)。③ベイズ的な方法を使う。準1級の範囲は①の考え方までですが、実務でA/Bテストを回すなら②を知らないと事故ります。
このブログでA/Bテストをやると5.8年かかる
ここまでの式を、このブログの実測値に入れてみました。GA4 の実測は直近28日でPV 29、月あたり約 31PV です(正確には 29PV/28日 = 31.1PV/月で換算しています)。
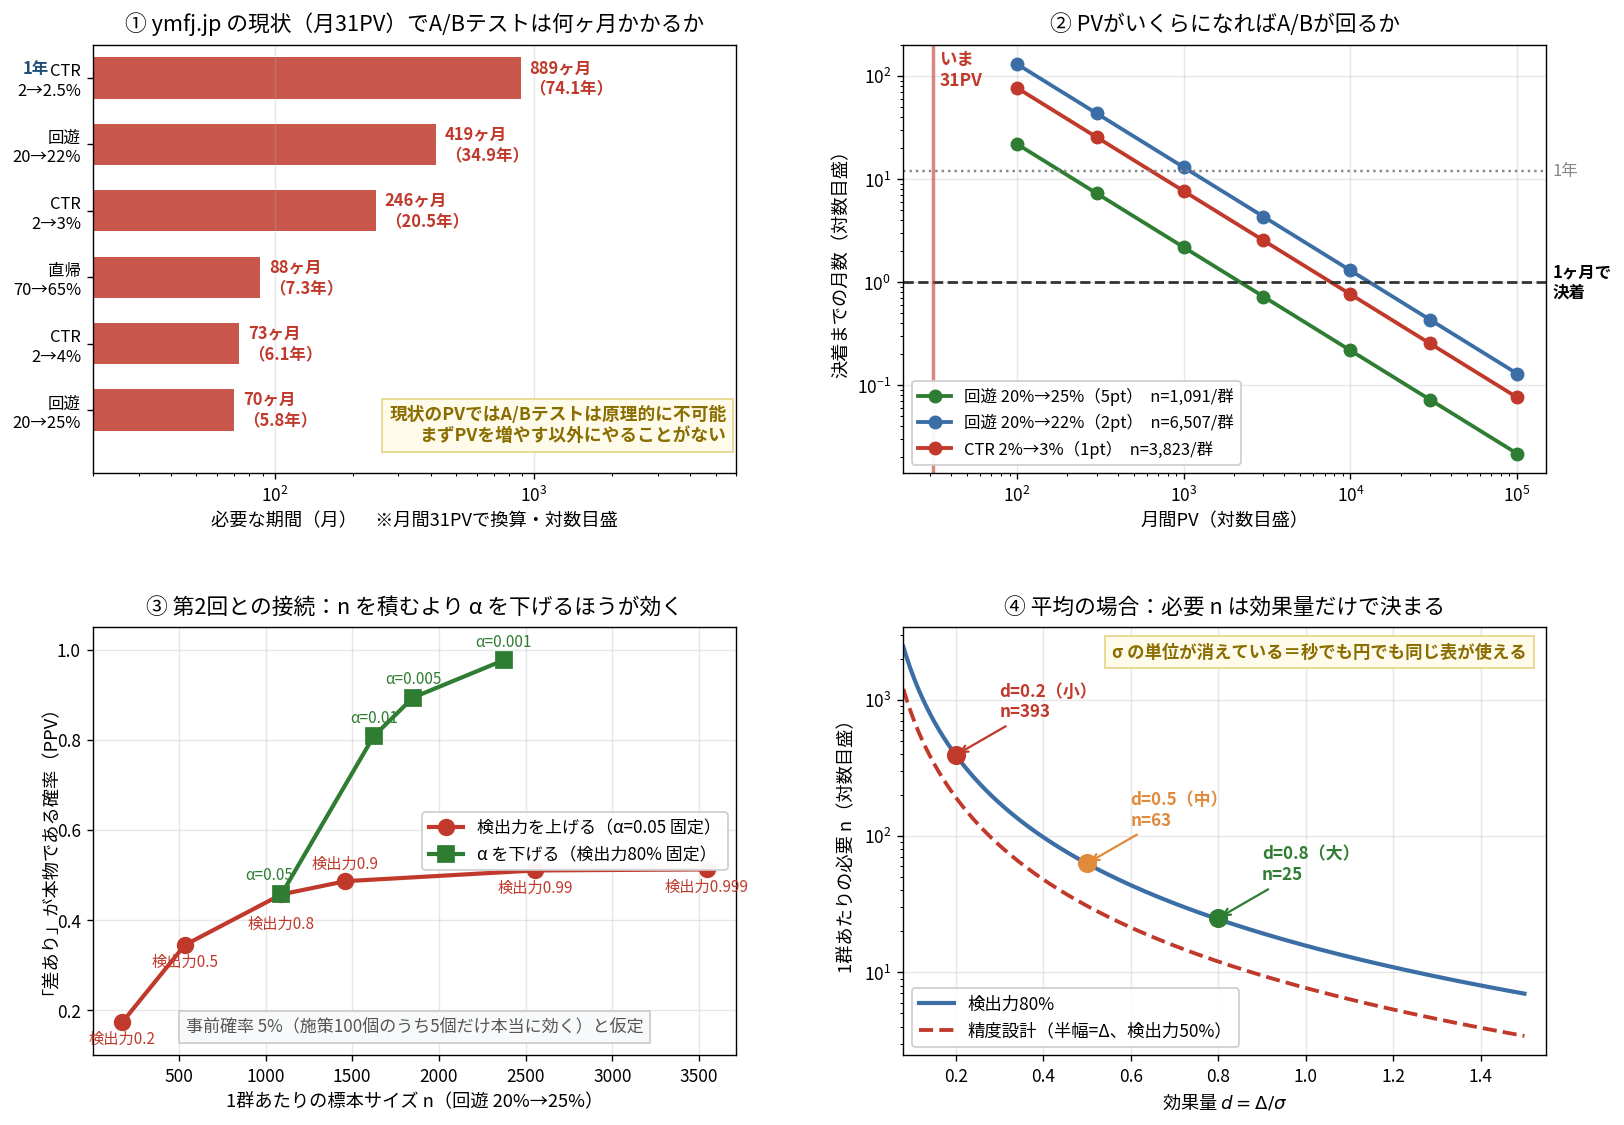
| 施策 | /群(検出力80%) | 必要総PV | 月31PVで | |||
|---|---|---|---|---|---|---|
| 回遊率 20%→25% | 0.20 | 0.250 | 5.0pt | 1,091 | 2,182 | 70ヶ月 |
| CTR 2%→4% | 0.02 | 0.040 | 2.0pt | 1,139 | 2,278 | 73ヶ月 |
| 直帰率 70%→65% | 0.70 | 0.650 | 5.0pt | 1,374 | 2,748 | 88ヶ月 |
| CTR 2%→3% | 0.02 | 0.030 | 1.0pt | 3,823 | 7,646 | 246ヶ月 |
| 回遊率 20%→22% | 0.20 | 0.220 | 2.0pt | 6,507 | 13,014 | 419ヶ月 |
| CTR 2%→2.5% | 0.02 | 0.025 | 0.5pt | 13,807 | 27,614 | 889ヶ月 |
現状の ymfj.jp で A/Bテストは原理的に不可能でした。 いちばん条件のいい「回遊率 20%→25%」でも 70ヶ月(5.8年)、細かい改善だと74年かかります。
これは残念な話ではなく意思決定に使える情報です。「効果測定の仕組みを作る」ことに時間を使うのは、いまは完全に無駄だと言い切れる。PVを増やす以外にやることがないという判断が、推測ではなく計算から出ました。
そして、これが「区間推定を学んで得たもの」の実例だと思います。 点推定なら「回遊率は20%です」で終わりますが、区間まで見ると 「この精度では何も判断できない」ことが分かる。それが分かると、次にやるべきことが変わります。
| 月間PV | 回遊 20%→25%(5pt) | 回遊 20%→22%(2pt) | CTR 2%→3%(1pt) |
|---|---|---|---|
| 100 | 21.8ヶ月 | 130.1ヶ月 | 76.5ヶ月 |
| 1,000 | 2.2ヶ月 | 13.0ヶ月 | 7.6ヶ月 |
| 5,000 | 1ヶ月以内 | 2.6ヶ月 | 1.5ヶ月 |
| 10,000 | 1ヶ月以内 | 1.3ヶ月 | 1ヶ月以内 |
| 30,000 | 1ヶ月以内 | 1ヶ月以内 | 1ヶ月以内 |
この表がロードマップになります。 月間 5,000PV が「大きめの改善(5pt)なら1ヶ月で検証できる」ライン、30,000PV が「細かい改善(1〜2pt)も回せる」ライン。
逆に言うと、月1,000PV 程度までは「A/Bテストで最適化する」フェーズに入っていないわけです。その段階でやるべきは大きく外れた仮説を捨てることで、そこには 5pt どころか 20pt 級の差が必要になります。小さい改善を測れるのは、大きい流入がある人の特権だということになります。
を積むより、基準を厳しくするほうが安い
第2回で 事後オッズ = 事前オッズ × 検出力/ という式を見ました。標本サイズ設計はこの式の 「検出力」だけを動かす操作です。
| 検出力 | 必要 /群 | 「差あり」が本物である確率(PPV) | 見つかる真の数 | 偽陽性の数 |
|---|---|---|---|---|
| 0.20 | 174 | 0.1739 | 1.00 | 4.75 |
| 0.50 | 534 | 0.3448 | 2.50 | 4.75 |
| 0.80 | 1,091 | 0.4571 | 4.00 | 4.75 |
| 0.90 | 1,461 | 0.4865 | 4.50 | 4.75 |
| 0.99 | 2,554 | 0.5103 | 4.95 | 4.75 |
| 0.999 | 3,546 | 0.5126 | 5.00 | 4.75 |
事前確率5%(施策100個のうち5個だけ本当に効く)、 固定、回遊 20%→25% としています。
を 174 → 3,546(20倍)にしても、PPV は 0.174 → 0.513 で止まります。 なぜか。偽陽性の数(4.75)は をいくら増やしても減らないからです。 を 0.05 に固定している限り、効かない95個の施策のうち約4.75個が「有意」になり続ける。 が増やせるのは「真の発見の数」の上限(5個)までです。
一方、 を動かすとこうなります。
| 検出力80%の必要 /群 | PPV | 偽陽性の数 | |
|---|---|---|---|
| 0.05 | 1,091 | 0.4571 | 4.75 |
| 0.01 | 1,624 | 0.8081 | 0.95 |
| 0.005 | 1,851 | 0.8939 | 0.48 |
| 0.001 | 2,374 | 0.9768 | 0.10 |
を20倍にして PPV は 0.17 → 0.51。 を 1/50 にして PPV は 0.46 → 0.98( は 2.2倍で済む)。 サンプルを積むより、基準を厳しくするほうが安いという結論になります。
実務的な処方としては、信頼係数を95%ではなく99%で運用する。必要 は 1,091 → 1,624 で 1.5倍にしかならないのに、PPV は 0.46 → 0.81 になります。そしてこれは複数指標を見るときの多重比較の補正と同じ発想です(第2回で「10指標を同時に見る運用は と同じ」と見た話)。
平均の場合は単位が消えて「効果量」になる
比率ではなく平均を比べるときも同じですが、きれいな性質が出ます。
が消えています。 必要な は 「差が標準偏差の何倍か」だけで決まるのです。この を効果量(effect size、コーエンの ) と呼びます。滞在時間が秒でも、単価が円でも、同じ1枚の表が使えます。
| 効果量 | 慣習的な呼び名 | 精度設計(半幅=) | 検出力80% | 検出力90% |
|---|---|---|---|---|
| 0.1 | 極小 | 769 | 1,570 | 2,102 |
| 0.2 | 小 | 193 | 393 | 526 |
| 0.5 | 中 | 31 | 63 | 85 |
| 0.8 | 大 | 13 | 25 | 33 |
| 1.0 | — | 8 | 16 | 22 |
この表は暗記の価値があります。 心理学や医学の論文で 前後がやたら出てくるのは、・検出力80%・ がテンプレになっているからでした。
さきほどの滞在時間データに当てはめると、 秒だったので、5秒の差を見たいなら で /群、2秒の差なら で /群。実際のデータは と 8 でした。それでも差が見えたのは、差が 27.85秒()と極端に大きかったからです。小さいサンプルで差が出たときは、効果が本当に大きいか、まぐれか、どちらかということになります。
母比率の は、実は壊れている
ここまで「比率の区間は 」と書いてきました。これはWald(ワルド)型と呼ばれる形で、教科書に最初に出てくるものです。ところがこれ、構造的におかしいのです。
(1件も起きなかった)のとき、幅が厳密に0になります。 を代入すると なので、区間は 。「母比率は0で確定」と言い切ってしまう。 でも同じです。
これは極端な例ですが、実害はもっと手前から出ています。厳密計算した被覆率がこちらです。
| Wald の被覆率 | Wilson の被覆率 | ||
|---|---|---|---|
| 20 | 0.01 | 0.1821 | 0.9831 |
| 20 | 0.05 | 0.6389 | 0.9245 |
| 20 | 0.25 | 0.8949 | 0.9348 |
| 20 | 0.50 | 0.9586 | 0.9586 |
| 100 | 0.05 | 0.8775 | 0.9659 |
、 で被覆率 18%。 95%と名乗っているものが18%です。
原因は「SE に を入れていること」でした。 真の ではなく推定値 を使っているので、 が下に外れたときに限って区間が狭くなる。外れているときこそ広くあってほしいのに、逆をやっているわけです。
ウィルソン区間: を「未知のまま」解く
直し方は素直です。SE の中の を、未知の のままにして不等式を解く。
これを について解くと2次方程式になり、答えは
これがウィルソン(Wilson)区間です。 そしてこれはピボット量の反転そのものでした。さきほどの4手順の④「パラメータについて解く」を、サボらずにやっただけ。Wald 型は④で に を代入して1次式に落としてしまった手抜き版だったわけです。
中心が ではなく を 0.5 側に少し引っぱった値になっているのがポイントです。 でも中心が 0 にならないので、幅がゼロに潰れません。
そして驚いたのが、 付近ではウィルソンのほうが狭いことです( での期待幅が 0.3927 対 Wald 0.4268)。この領域では被覆率も守るし幅も狭い、上位互換でした。 が 0 に近いところでは逆にウィルソンのほうが広くなりますが、それは必要な広さです。
ただしウィルソンも万能ではありません。 の最悪ケースは 付近で被覆率 0.839。 が極端に小さいところでは、どの近似も苦しくなります。
| 手法 | の被覆率 | 使いどころ |
|---|---|---|
| Wald | 0.6389 | 使わない |
| ウィルソン | 0.9245 | 既定にする |
| Agresti–Coull | ウィルソンにほぼ同じ | 手計算のとき |
| Clopper–Pearson | 0.95以上を保証(保守的) | 安全側に振りたいとき |
Agresti–Coull の「成功に2、全体に4を足してから Wald 式を使う」という謎の処方は、ウィルソンの近似でした。、。+2/+4 は 1.96 の二乗を丸めた数字だったわけです。これを知って初めて、あの手品めいた式が受け入れられるようになりました。
ブートストラップ:公式がない統計量でも区間が作れる
ここまでは「ピボット量が見つかる」場合の話でした。では中央値や四分位範囲や変動係数の区間はどう作るのか。公式は簡単には出ません。
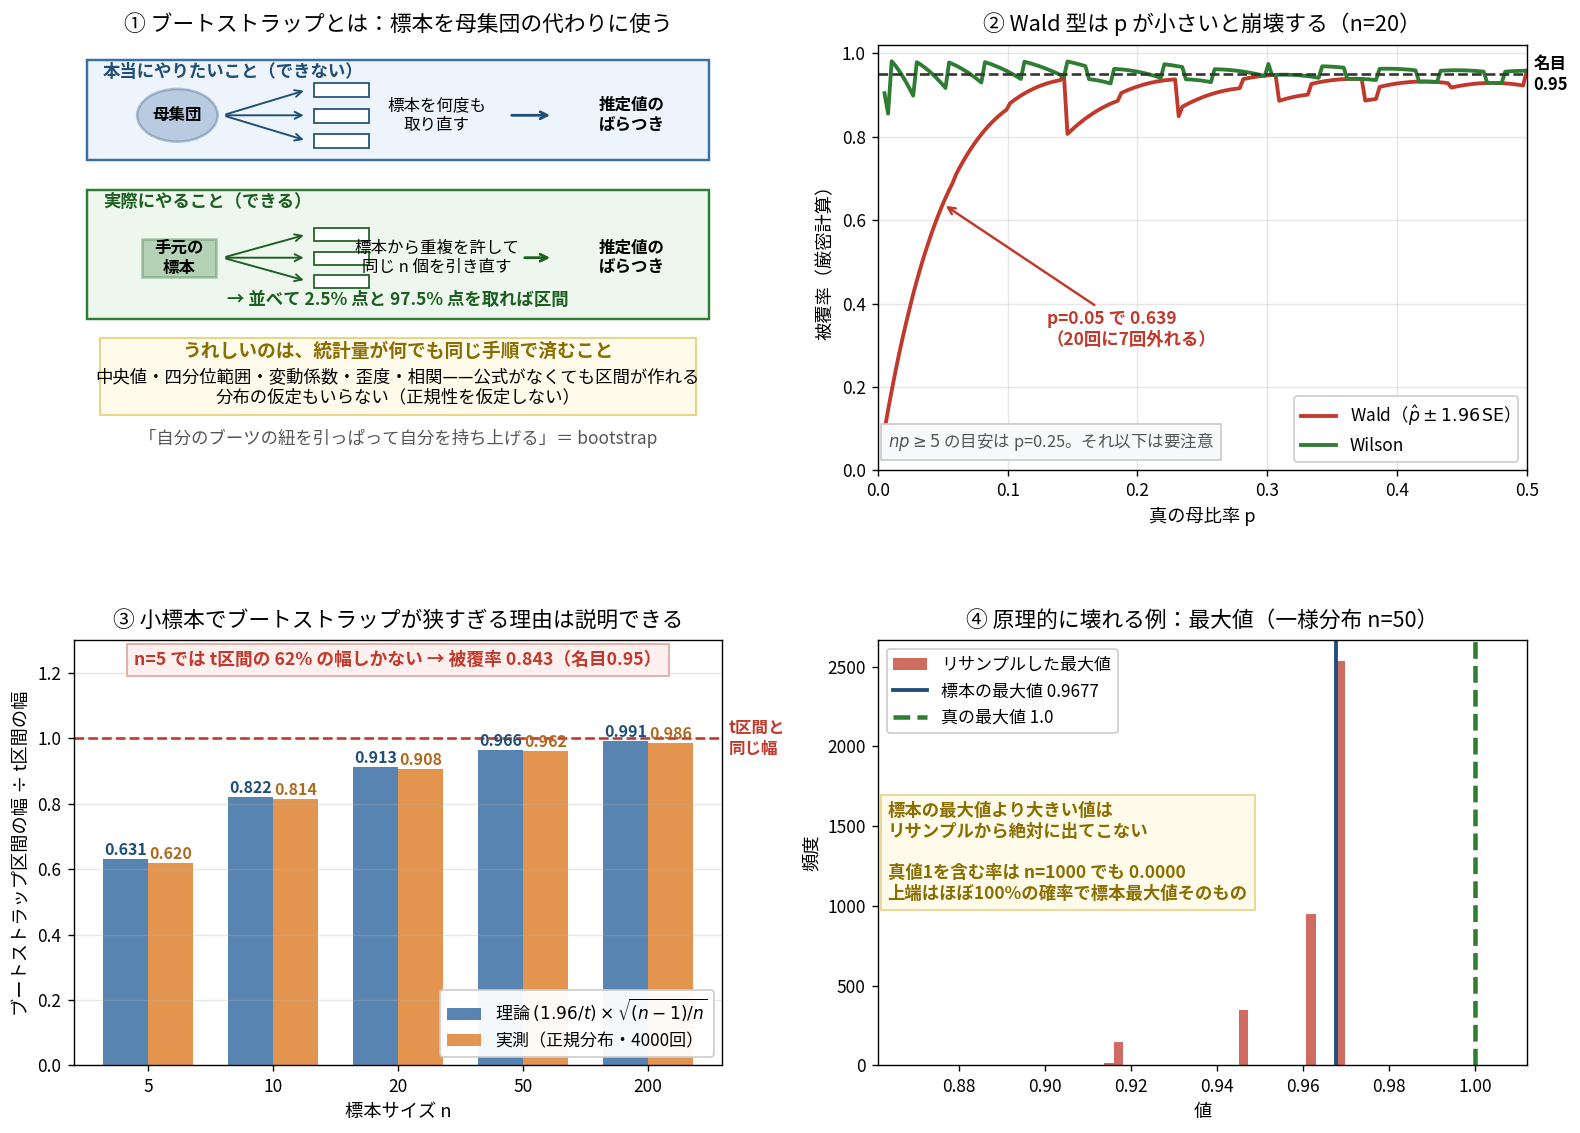
やることは1行です。手元の 個から、重複を許して 個を引き直す。それを何千回もやって、得られた推定値の 2.5% 点と 97.5% 点を区間の端にする。
本当にやりたいのは「母集団から標本を取り直す」ことですが、それはできません。代わりに手元の標本を母集団の代役にするわけです。自分のブーツの紐を引っぱって自分を持ち上げる(bootstrap)という比喩がそのまま名前になっています。
中央値でも歪度でも相関でも、まったく同じ手順で区間が作れます。 分布の仮定も要りません。
弱点1:小標本では狭すぎる(しかも狭さが計算できる)
そのままだと小標本で信頼区間が狭すぎます。
| ブート幅 / t区間幅(理論) | 実測 | 被覆率 | |
|---|---|---|---|
| 5 | 0.6314 | 0.6196 | 0.8430 |
| 10 | 0.8218 | 0.8144 | 0.8974 |
| 20 | 0.9134 | 0.9080 | 0.9276 |
| 50 | 0.9662 | 0.9622 | 0.9394 |
| 200 | 0.9911 | 0.9861 | 0.9469 |
で t区間の62%の幅しかありません。 そしてこの狭さは厳密に計算できました。
理由が2つ入っています。① を使うべきところで (1.96)を使っている( なので 1.96/2.776=0.706)。②リサンプルの分散が 割り( 割りではない)ので 倍。掛けると 0.6314。実測 0.6196 とほぼ一致しました。
対策はブートストラップ(スチューデント化) で、各リサンプルで を作って、その分位点を使う。これで正規 で被覆率 0.9503、指数分布や対数正規分布では通常のt区間にも勝ちます。歪んだ分布のときは 分布が想定する対称性が崩れているので、データから非対称な分位点を作れるブートストラップが有利になるわけです。ほかにBCa(バイアスと歪度を補正する)もあり、実務ではこれが既定です。
弱点2:分布の端では原理的に壊れる
一様分布 の最大値の区間をブートストラップで作ると、被覆率 0.0000。 でも 0 です。
理由は考えれば当たり前でした。リサンプルは手元のデータからしか値を引けないので、標本の最大値より大きい値は絶対に出てこない。 区間の上端は標本最大値以下にしかならず、真の最大値は常にその上にいます。しかもリサンプル1本が標本最大値を含む確率は
つまりリサンプル最大値の6割強が、ぴったり標本最大値に張り付きます。上端に確率質量が集中しているので、上側 97.5% 点はほぼ常に標本最大値そのもの。実測でも 、 の両方で 100% でした。区間の上端が構造的に標本最大値で止まるのが、被覆率が0になる直接の理由です。
目印は「パラメータが分布の端(台の境界)を決めているとき」です。 最大値・最小値・99パーセンタイルはこの仲間。平均や中央値のように「たくさんのデータが寄り集まって決まる量」なら安全です。
弱点3:離散データでは区間が格子状になる
1〜5の5段階評価のような離散データで中央値の区間を作ると、端点が整数(か .5)しか取れないので、区間が のようなカクカクした形になります。95%と言いつつ実際の被覆率は飛び飛びの値しか取れません。
補足:「最尤推定量が正規分布になるのは中心極限定理か」
学習中に自分でつまずいたのでここに残します。第10回で「最尤推定量は が大きいとき近似的に正規分布に従う」と書きましたが、これは中心極限定理そのものではありません。CLT がかかっているのは ではなく「スコア関数の和」 で、そこから に伝わっているという2段構えです。
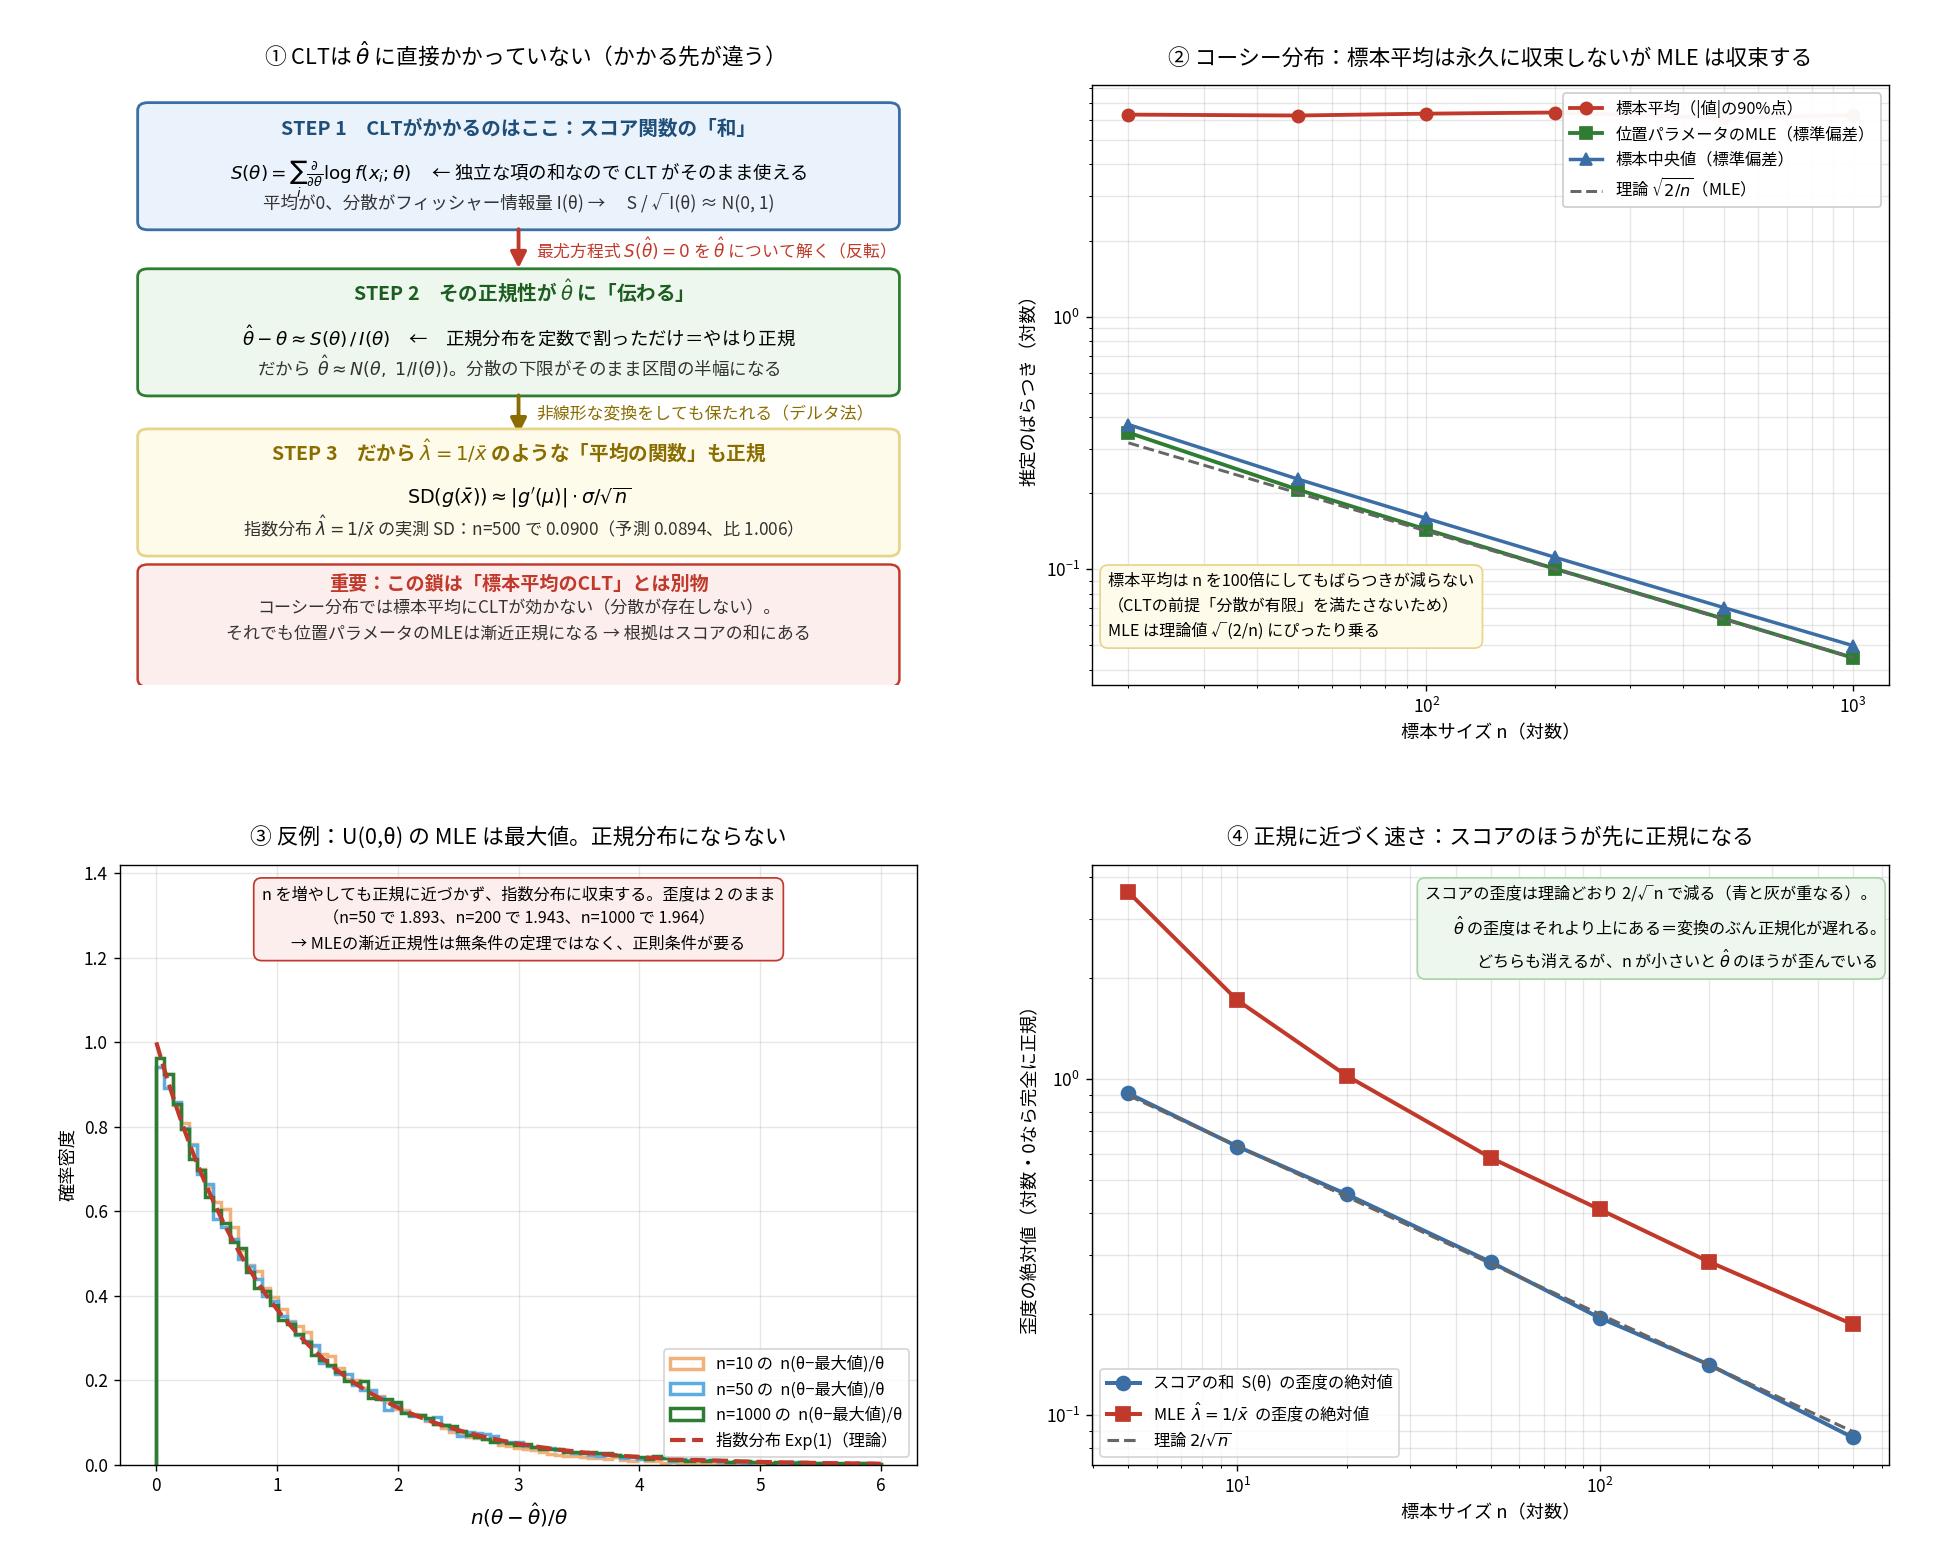
流れはこうです。尤度は掛け算ですが、 をとると和になる。微分したスコア関数 も和のままなので、ここに CLT が素直に効きます。そして は で定義されているので、この式を について解く(=また反転です)と 。分子が正規、分母が定数なので も正規、分散は になります。
第10回のクラメール–ラオの下限の平方根を 1.96 倍したものが、そのまま区間の半幅になっているわけです(下限は分散に対するものなので、平方根を取る一手間が入ります)。点推定と区間推定がここでつながります。
区別にこだわる理由は、壊れる場所が予測できるようになるからです。
証拠①:CLT が効かないのに MLE は正規になる。 コーシー分布は分散が存在しないので CLT の前提を満たさず、標本平均は を50倍にしても改善しません( の99%点が で 64.61、 で 63.48)。ところが同じデータの位置パラメータの MLE は理論値 にぴったり乗ります( で実測 0.1005 対理論 0.1000)。スコア が有界だからです。コーシーはとんでもない外れ値を出しますが、スコアに通すと抑え込まれて和が暴れない。
このとき標本中央値の標準偏差は MLE の約1.11倍(0.1112 対 0.1005)で、漸近相対効率で言えば 、約81%。中央値でもそこそこ戦えるのに、平均は使い物になりません。裾の重いデータで「平均ではなく中央値を見ろ」という実務のセオリーが、ここで数字になりました(ブログの滞在時間や単価も裾が重い側の量です)。
証拠②:CLT がありそうなのに MLE が正規にならない。 の の MLE は標本最大値で、 の歪度は でも 1.9636(正規なら0)。収束先は指数分布で、収束の速さは ではなく とふつうより速い。最大値は和ではないので CLT の管轄外、そして対数尤度が で微分できないのでスコアの話が始まらない。
これが教科書の「正則条件」の正体でした。 目印は 「パラメータが分布の台の端を決めているとき」。ブートストラップが最大値で被覆率 0.0000 だったのと、まったく同じ場所で同じ理由です。
実務的な処方も出ます。 の歪度はスコアの歪度の2〜4倍あります(指数分布の で のとき、スコア 0.0894 に対し は 0.1886)。非線形変換をくぐるぶん正規化が遅れるので、漸近区間は正規に近い尺度の上で作って、あとで戻す。オッズ比を で、相関係数をフィッシャーの 変換で扱うのはすべてこの動機です。そして区間は単調変換で端点をそのまま写せるので、戻すのにコストがかかりません。
詳しくは第10回・統計的推定の基礎に書きました。
つまずいたところ
母比率の区間推定が何の話かピンとこなかった。 平均・分散・平均の差は「測った値のばらつき」として想像できるのに、比率だけ別のジャンルに見えていました。ほどけたのは 「母比率は 0/1 データの平均でしかない」 と分かった瞬間です。クリックしたら1、しなかったら0の数列の平均。だから同じ の形になる。新しい概念を1つ覚えたのではなく、既に知っている式の特殊ケースだったわけです。
2本の区間が重なっているのに差が有意になる、が納得できなかった。 「分散しか足せない」という言葉は知っていても腑に落ちていなかったのですが、東に3歩、北に4歩歩いたら原点からの距離は7ではなく5という図で決着しました。。ばらつきは違う方向を向いた矢印なので、長さを足すのではなく三平方の定理でつなぐ。差の区間の半幅は、2本の半幅を素朴に足した値の 倍まで縮みます(個別の半幅そのものと比べれば 倍で、そこを取り違えると逆の理解になります)。
プール分散とウェルチの区別が曖昧だった。 これは検定の話だと思い込んでいたのですが、区間推定の中の「SE の作り方が2通りある」だけでした。等分散を仮定して2つの を自由度で重みづけして1本にまとめるのがプール、仮定せず で済ませるのがウェルチ。そして被覆率を測ったら答えが出ました。等分散でもウェルチの損は幅 +0.2% しかないのに、条件が崩れるとプールは 0.6489 まで落ちる。ウェルチを無条件で使うのが正解(R の t.test() の既定も var.equal=FALSE)。
標本サイズ設計の説明が自分でも分かっていなかった。 途中で「これは要するに、必要な精度からデータ量を逆算する話だよね」と自分に確認し直したところで見通しがつきました。式は新しくなく、 を について解いただけ。そしてその で検出力はちょうど50%しかない(実測 0.4998)というのが一番の収穫でした。80%欲しいなら 2.0432 倍。
信頼係数を「区間の性質」だと思っていた。 これは反例で潰しました。 から2個取って区間 とすると全体で 50.065% ですが、幅が 0.5 を超えた回に限れば被覆率 100%、超えなかった回は 33.4%。手元の1本を見て「これは95%です」と言うことに意味がないのがはっきりしました。95%は手続きに付いている数字です。
Wald 型の比率区間を疑ったことがなかった。 は教科書の最初に出てくる式なので、正しいものだと思って使っていました。、 で被覆率 18%。 で幅が厳密に0。教科書に載っている順番は、正しさの順番ではないというのが今回いちばん効いた学びかもしれません。
「最尤推定量が漸近正規」を中心極限定理そのものだと思っていた。 半分は当たっていましたが、CLT がかかっているのはスコアの和で、 には反転を通って伝わっている。この区別をしていなかったので、コーシー分布で標本平均が壊れるのに MLE が生きる理由も、 で MLE が正規にならない理由も説明できませんでした。
この記事の要点
- 信頼区間の95%は手続きに付いている数字で、手元の1本には付いていない。「真の値が95%の確率でこの中にある」は誤り
- 区間の公式は4つあるのではなく、手順が1つ。①ピボット量を見つける ②分位点で挟む ③不等式を書く ④パラメータについて解く(反転)
- 既知の式が要るのは、① の必要性を測る基準線 ②比率や件数では が平均で決まるので が正しい ③設計時は が存在しない、の3つの理由から
- 母比率は新しい概念ではなく、0/1 データの平均
- 2本の区間の重なりで差を判断してはいけない。 足せるのは分散だけ(東に3歩・北に4歩=距離5)。差の半幅は2本の半幅を足した値の 0.707 倍
- 平均の差はウェルチを無条件で使う。等分散時の損は幅 +0.2%、外したときの事故は被覆率 0.65
- 分散比の 区間は正規性が崩れると を増やすほど悪化する。 検定で等分散を確かめてから に進む2段階手続きは被覆率 0.9332 で、得るものがない
- 標本サイズは 。このままだと検出力はちょうど50%。80%なら 2.0432 倍、90%なら 2.7353 倍
- 途中で結果をのぞくと誤り率が崩壊する(20回で 0.2497)。 を先に決めて、そこまで見ない
- を積むより を厳しくするほうが安い。 20倍で PPV 0.17→0.51、 を 1/5 にして 1.5倍で 0.46→0.81
- 比率区間の Wald 型は壊れている( で被覆率 0.18)。ウィルソン区間を既定にする
- ブートストラップは小標本で狭すぎ( で t区間の62%)、分布の端では原理的に壊れる(最大値の被覆率 0.0000)
- 月31PV のこのブログでは、A/Bテストは最短でも5.8年かかる。効果測定より流入を増やすフェーズ
次回は第10章 「検定の基礎と検定法の導出」 です。今回の最後に出てきた「信頼区間=棄却されない帰無仮説の集合」という双対性を、検定の側から見直すことになります。区間推定で「反転」を4回やったので、ネイマン・ピアソンの補題や尤度比検定も同じ地図の上に置けるはずです。