モデル選択:AICの「2k」の2はどこから来たのか【第32回】
はじめに
第30章はモデル選択です。第16回の重回帰分析で「説明変数を増やすと決定係数は必ず上がる。無意味な変数を足しても上がる」という現象を見ました。あのとき置いた宿題を、この回で回収します。
学ぶ前の私の理解はこうでした。「AIC という指標があって、小さいほうが良いモデルらしい。パラメータ数に罰則がかかるので、複雑すぎるモデルは選ばれない」。実際に使ったこともあります。ただ、なぜ罰則が「パラメータ数の2倍」なのかは考えたこともありませんでした。 の は、どこから来た数字なのか。
結論から書くと、この は の でした。 の とは無関係です。訓練データでの誤差は のぶんだけ甘く出て、本当に知りたい新データでの誤差は のぶんだけ重く出る。その差が です。20万回のシミュレーションで、小数第2位まで一致することを確かめました。ここが今回いちばんスッキリしたところです。
もう一つの山場は終盤にあります。AIC は尤度比検定と何が違うのかという疑問です。式を並べてみると、AIC でモデルを比べる操作は「第12回の尤度比検定で、棄却限界を の5%点でなく にしたもの」とぴったり一致しました。そこから「AIC に対応する有意水準」を逆算できます。 なら 0.157。よく言われる「AIC は甘い」はここから来ています。ところが を増やすと対応する有意水準は下がり続け、 で 0.042 と 5% を下回ります(厳密な交差点は )。そこから先は AIC のほうが厳しいという逆転がありました。私は「AIC は甘い」を無条件の性質だと思っていたので、これは予想外でした。
そしてこの回には、ずっと後ろに引きずってきた薄気味悪い話があります。ステップワイズ法です。教科書には「批判が多い」と書いてあるのに、理由が列挙されるだけで納得できていませんでした。今回それを5つに分けて全部測りました。純粋なノイズだけのデータでステップワイズを回すと、自由度調整済み決定係数でも 0.145 という値が出ます。調整済みなら安全だと思っていたので、これは効きました。
さらに、5つの罪は同じ種類の問題ではなく、「選んだあとに推論をしたことの罪」「予測にも効く罪」「探索の限界」の3つに分かれると分かったのが、この回の構造的な収穫でした。そして「データを見て 0 か 1 で選ぶ」という操作そのものがコストの発生源だと分かると、ステップワイズ・第19回のラッソ・赤池ウェイトによる平均化が、一本の軸に並びます。
いつものように、出てくる数値はすべて自分で計算しています。 分布の確率とラッソは、この環境に scipy も scikit-learn も無いので自分で実装し、教科書の数値表や最小二乗法の解と突き合わせて検証しました。
この回で扱う用語
略語が多い回なので、先に並べておきます。
| 略語 | 英語 | 日本語 | ひとことで |
|---|---|---|---|
| AIC | Akaike Information Criterion | 赤池情報量規準 | 。新データでの予測誤差の推定量 |
| BIC | Bayesian Information Criterion | ベイズ情報量規準 | 。真のモデルを当てにいく |
| AICc | corrected AIC | 有限修正 AIC | AIC に小標本用の追加罰則を足したもの |
| Mallows' | マローズの | 回帰専用。 を固定した AIC | |
| CV | Cross Validation | 交差検証(交差確認) | データを分けて、選ぶのに使わなかった側で評価する |
| LOO | Leave-One-Out | 一個抜き | 1点だけ抜いて当てはめ、その1点を予測する。 回繰り返す |
| LOOCV | LOO Cross Validation | 一個抜き交差検証 | LOO を使った交差検証。-fold CV と同じもの |
| PRESS | PREdiction Sum of Squares | 予測残差平方和 | LOO の誤差二乗和。再計算せずに閉じた式で出る |
| RSS | Residual Sum of Squares | 残差平方和 | 。当てはまりの悪さ |
| MSE | Mean Squared Error | 平均二乗誤差 | RSS を件数で割ったもの |
| VIF | Variance Inflation Factor | 分散拡大係数 | 第16回の多重共線性の指標 |
はパラメータ数、 はデータの件数、 は尤度です。
の数え方には流儀が2つあるので、先に整理しておきます。AIC の定義に忠実に数えるなら、正規分布の回帰では も推定しているのでこれも1つ数えます。説明変数 本+切片+ で です。いっぽう、このあと出てくる残差平方和を使った導出では「回帰係数の本数」だけを数えます()。
紛らわしいのですが、実害はありません。どちらの流儀でも全モデルに同じ定数が足し引きされるだけなので、AIC の差は変わらないからです。そして後で見るように、AIC は絶対値ではなく差だけが意味を持ちます。以下では、どちらの数え方をしているかを都度明記します。
何に使うのか:決定係数の話の続き
第16回で見た現象をおさらいします。説明変数を増やすと決定係数 は必ず上がります。 とまったく無関係な乱数を足しても上がります。だから「 が大きいモデルを選ぶ」をやると、いつも「全部の変数を入れたモデル」が勝ってしまう。
これは「当てはまりの良さ」を手元のデータで測っているからです。手元のデータへの当てはまりは、変数を増やせばいくらでも良くできます。極端には、 個のデータに 個のパラメータを当てれば残差はゼロになります。
私たちが本当に知りたいのは別のことです。このモデルは、まだ見ていないデータをどれだけ当てるのか。 モデル選択の道具は全部、この一点に向けて作られています。やり方は大きく2つです。
| 考え方 | 具体的な手法 | 何をしているか |
|---|---|---|
| 理論で補正する | AIC・BIC・AICc・ | 手元の当てはまりが甘く出る量を数式で計算して、その分を引く |
| 実際に測る | 交差検証・LOO | データを分けて、当てはめに使わなかった側で本当に測ってみる |
そして道具の外側に、もっと重要な区別があります。第31回の最後に触れた話です。予測が目的なのか、説明が目的なのか。 同じデータでも、この2つで正反対の判断になります。予測が目的なら「効くかもしれない変数は入れておく」が正しく、説明が目的なら「本当に効いている変数だけ残す」が正しい。AIC と BIC は、まさにこの2つに対応しています。
過学習は「二手に分かれる」現象
まず現象を見ます。真の関数を3次式 とし、そこに標準偏差 0.6 の誤差を乗せた15点を用意しました。この15点に 次の多項式を当てはめ、手元の15点での誤差と、同じ仕組みで作った新しい4000点での誤差を両方測ります。
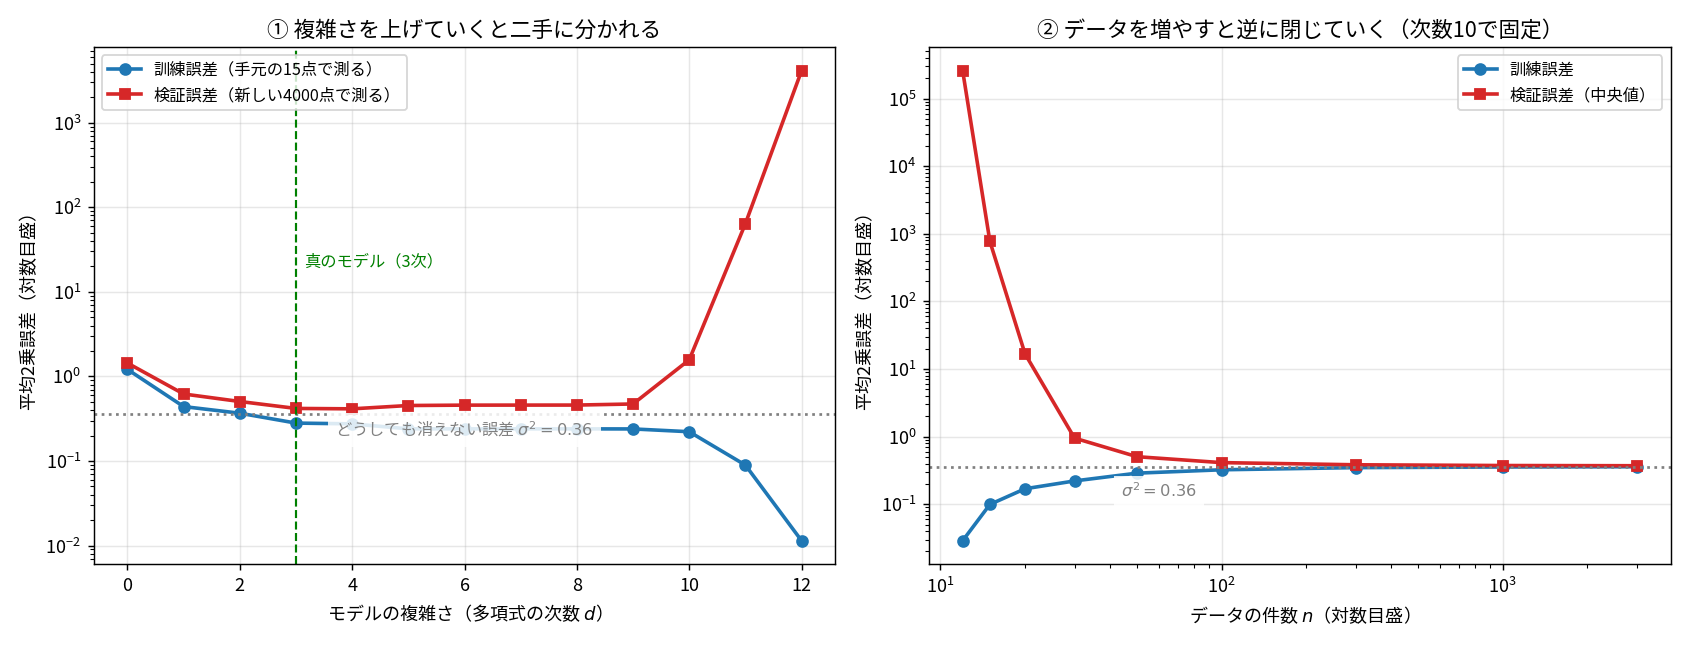
左のグラフが過学習の定義そのものです。訓練誤差(青)は下がり続けるのに、検証誤差(赤)は途中から上がる。 数値で書くとこうなります。
| 次数 | 訓練誤差 | 検証誤差 |
|---|---|---|
| 0(定数のみ) | 1.211 | 1.439 |
| 1 | 0.440 | 0.620 |
| 3(真のモデル) | 0.281 | 0.418 |
| 4 | 0.275 | 0.414 |
| 9 | 0.240 | 0.473 |
| 10 | 0.222 | 1.572 |
| 12 | 0.011 | 4113.978 |
12次では訓練誤差が 0.011 まで落ちています。手元のデータについては、ほぼ完璧に説明できている。ところが新しいデータでの誤差は 4114 です。約37万倍の落差です。
もう一つ、大事な線が引かれています。 の水平な点線です。誤差の標準偏差が 0.6 なので 。これはどんなに良いモデルを持ってきても消せない床です。真の関数を完全に知っていたとしても、 には のばらつきが乗っているので、予測誤差は より下がりません。検証誤差の最小値 0.414 が 0.36 より少し上なのは、この床の上に「モデルを推定したことによる誤差」が乗っているからです。
そして訓練誤差はこの床を下回っています(12次で 0.011)。消せない誤差より小さい誤差が出ているというのは、それ自体が異常のサインです。ノイズを構造として覚え込んでいる証拠です。
右のグラフは同じ現象を別の軸で見たものです。次数を10に固定して、データ件数だけ増やします。 のとき検証誤差は 257915(この列だけは反復の中央値です。 が小さいと検証誤差は極端に裾を引き、平均は数回の外れ値に支配されてしまうので、中央値で見ています。訓練誤差の側は平均です)。 では 0.371 まで落ち、訓練誤差 0.359 とほぼ同じ値になって に収束します。過学習は「モデルが複雑すぎる」のではなく「データの量に対してモデルが複雑すぎる」現象です。 と の比の問題です。
曲線そのものを描くとさらに分かりやすいです。
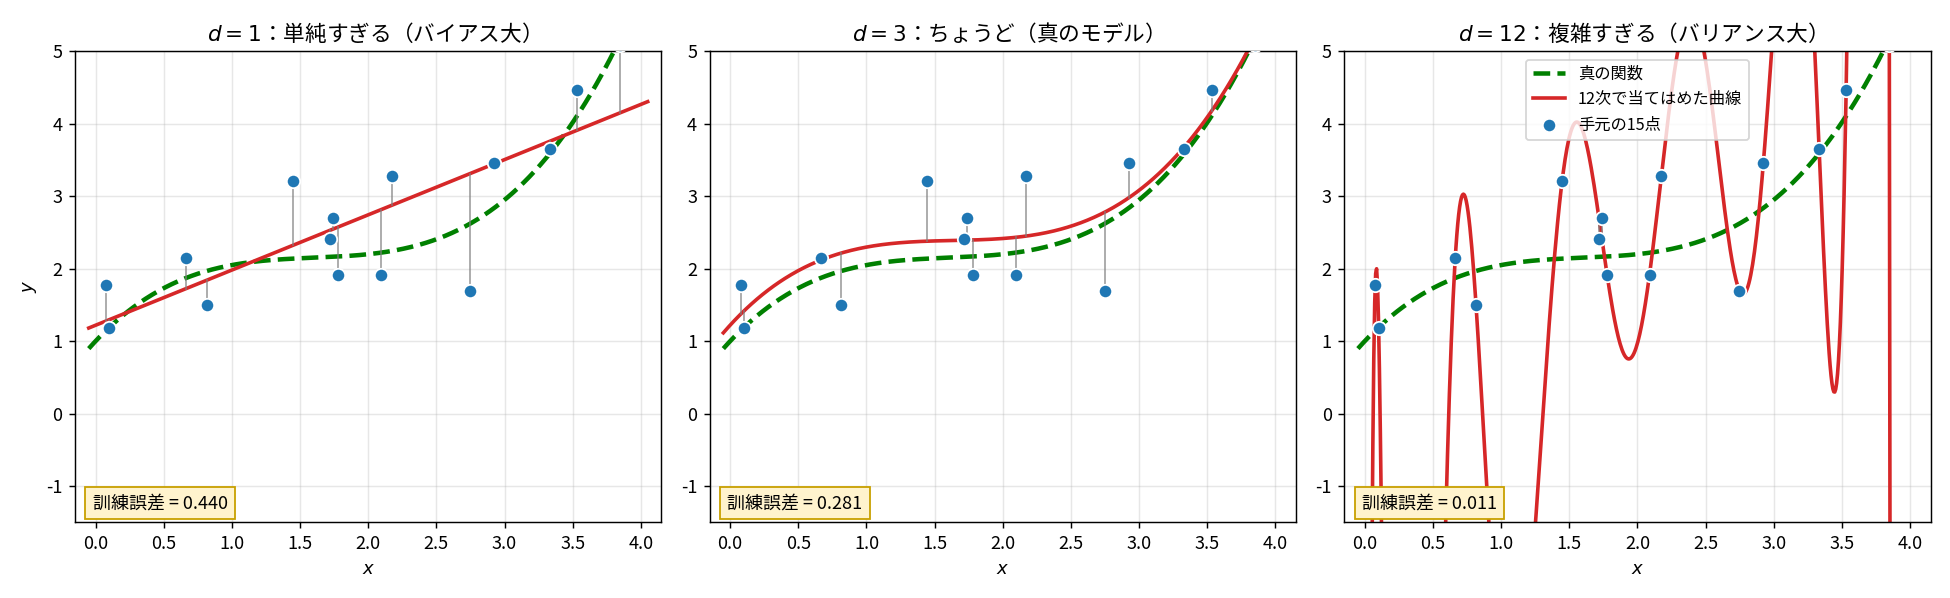
左は単純すぎて構造を捉えきれていない。曲がっているものに直線を当てているので、どんなにデータを増やしても直りません。右は点を通すために暴れている。データが少し変われば、この曲線はまったく別の形になります。この「捉えきれない」と「暴れる」が、次の分解の2つの成分です。
バイアスとバリアンスに分解する
予測誤差は3つに分かれます。
言葉で言えばこうです。バイアスは「何回データを取り直して平均しても残るズレ」。左の図の直線が真の曲線からずれている分です。バリアンスは「データを取り直すたびに答えが変わる幅」。右の図の暴れる曲線が、データごとに別の形になる分です。 は そのものに乗っているノイズです。
複雑さを上げるとバイアスは減り、バリアンスは増えます。逆向きに動くので、合計には最小値があります。これがトレードオフです。
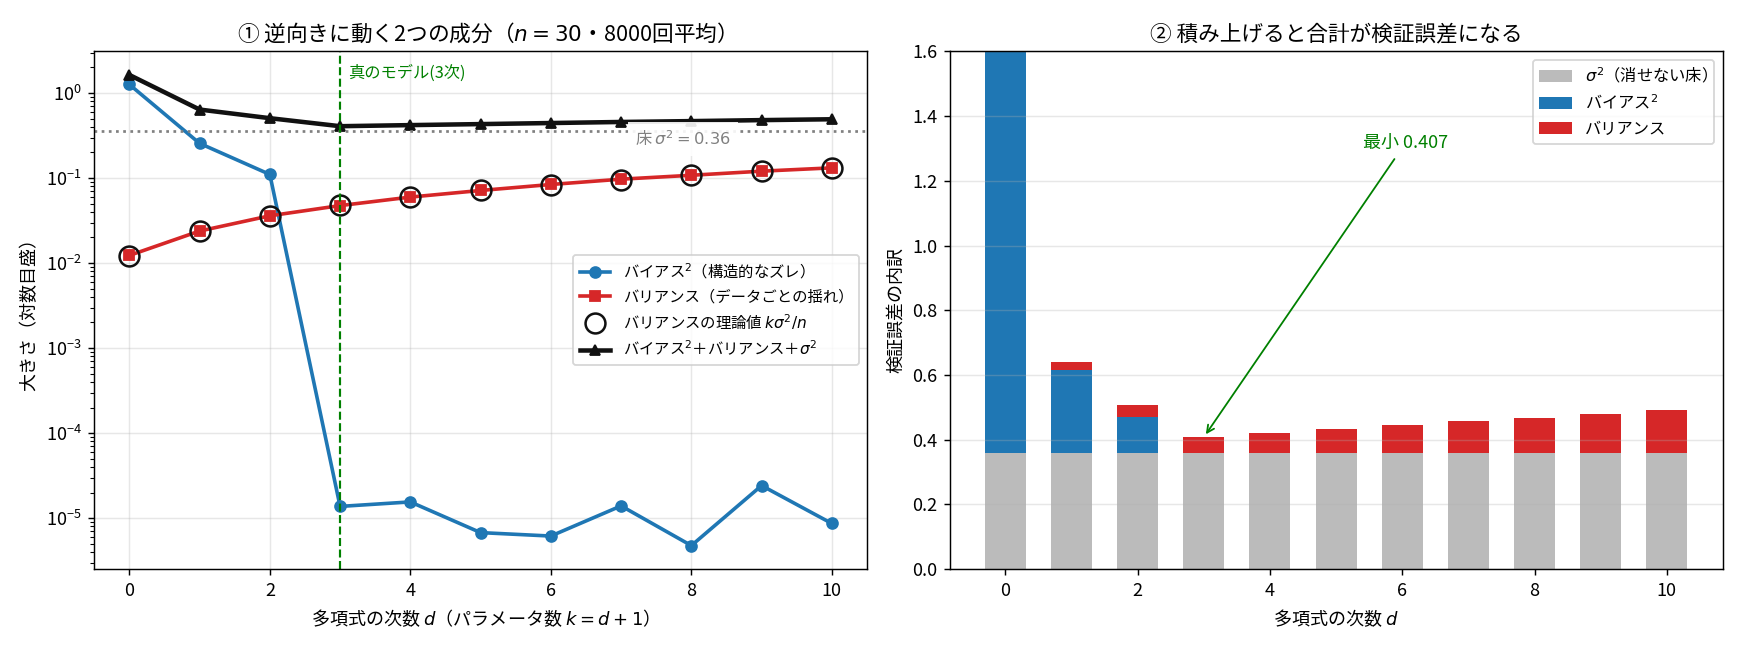
数値で確かめます。 のデータを8000回作り直して、各次数について2つの成分を実測しました。 の位置は 30 点に固定して、毎回ノイズだけを作り直しています(固定設計)。誤差を測るのも同じ 30 点の上です。ひとつ前の実験は新しいランダムな 点で測っていたので、同じ「予測誤差」という語でも中身が違います。 という綺麗な形が出るのは、同じ 点で測っているからです。このあとの の話も、同じ設定の上にあります。
| 次数 | (係数の本数) | バイアス | バリアンス | 理論値 | 合計+ |
|---|---|---|---|---|---|
| 0 | 1 | 1.2628 | 0.0123 | 0.0120 | 1.6351 |
| 1 | 2 | 0.2561 | 0.0238 | 0.0240 | 0.6399 |
| 2 | 3 | 0.1103 | 0.0360 | 0.0360 | 0.5063 |
| 3 | 4 | 0.0000 | 0.0475 | 0.0480 | 0.4075 |
| 4 | 5 | 0.0000 | 0.0598 | 0.0600 | 0.4198 |
| 6 | 7 | 0.0000 | 0.0840 | 0.0840 | 0.4440 |
| 10 | 11 | 0.0000 | 0.1319 | 0.1320 | 0.4919 |
バイアス は3次でほぼ完全にゼロになります( 程度)。真の関数が3次なので、3次以上の多項式は真の関数を含んでいて、構造的なズレが消えるからです。4次以上でもゼロのままです。「余分な項があっても、その係数の期待値がゼロなら、平均的なズレは生じない」ということです。
いっぽうバリアンスは増え続けます。しかもその値が理論値 とぴったり一致しています。 なら で 、実測 0.1319。
この式は覚える価値があります。バリアンスはパラメータ1個あたり ずつ増える。 過学習の「値札」がこれです。パラメータを1個足すたびに、 の税金を払う。データが多ければ税率は下がります。
そしてこの が、次の AIC の の正体に直結します。
なぜ「 個あたり」なのか
回帰の予測値は と書けます。 はハット行列(第17回のてこ比の親玉)です。 の分散の合計は になり、(ここでの は係数の本数)です。1点あたりに直すと 。
になるのは、トレースが順序を入れ替えられる性質から出ます。
5点・2パラメータの小さな例で確かめました。てこ比 は で合計 2.0、パラメータ数と一致します。各点の予測値の分散の実測は 、理論値 。てこ比は「その点が自分の予測値をどれだけ引っ張れるか」であり、引っ張れる点は分散も大きいという関係がここで見えます。
AIC: の はどこから来たのか
AIC の定義はこれです。
第1項は当てはまりの良さ(の逆)、第2項は複雑さへの罰則。小さいほど良い。ここまでは知っていました。分からなかったのはなぜ「」なのかです。 でも でもなく である理由が要ります。
訓練誤差は だけ甘く、真の誤差は だけ重い
答えは、2つの期待値を並べると見えます。 点のデータに 個の回帰係数を最小二乗で当てはめたとき、
これは第16回で出てきた話です。 が不偏推定量になるのは(モデルが真の平均構造を含んでいるとき)、 の期待値が だからでした。パラメータを増やすと分母が減る。つまり手元のデータでの誤差は ぶん甘く出ます。
「甘い」「重い」の基準は です。真の平均を最初から知っていて何も推定しなければ、残差は純粋なノイズなので 。この線を挟んで、訓練誤差が ぶん下、新データの誤差が ぶん上に来ます。
ここで、同じ の位置で だけをもう一度観測しなおしたとします。当てはめた係数はそのままで、新しい に対する誤差を測ると、
符号が反転します。理由は素直です。訓練データでは、当てはめた予測値 が に引っ張られている(残差が小さくなる方向に動いている)。新しい はその引っ張りの外側にあるので、 のばらつき が誤差に足される側に回ります。
差を取ります。
これが です。 は の 。 の とは何の関係もありません。私はここを混同していたので、ずっと「 の意味」が見えていませんでした。
20万回で確かめる
、()、真の関数は3次式。20万回シミュレーションしました。 は回帰係数の本数です。
| 訓練RSS | 理論 | 新RSS | 理論 | 差 | 理論 | |
|---|---|---|---|---|---|---|
| 2 | 95.385 | 85.500 | 104.302 | 94.500 | 8.917 | 9.000 |
| 3 | 87.430 | 83.250 | 100.926 | 96.750 | 13.497 | 13.500 |
| 4 | 80.970 | 81.000 | 99.032 | 99.000 | 18.062 | 18.000 |
| 5 | 78.667 | 78.750 | 101.232 | 101.250 | 22.565 | 22.500 |
| 8 | 72.036 | 72.000 | 107.962 | 108.000 | 35.926 | 36.000 |
| 10 | 67.519 | 67.500 | 112.458 | 112.500 | 44.939 | 45.000 |
の行を見ると、訓練 80.970 対理論 81.000、新データ 99.032 対理論 99.000。ぴったりです。
そして と の行が面白い。 真の関数は3次(係数4本)なので、 や のモデルは間違ったモデルです。実際、訓練RSS の実測 95.385 は理論 85.500 から大きく外れています。この差 9.885 が「捉えきれていない構造」=バイアスです。
ところが差の列を見ると 8.917 で、理論 にちゃんと合っています。 バイアスは訓練側にも新データ側にも同じだけ乗るので、差を取ると消えるのです。式で書くと、バイアス項 が両辺に同一の形で現れて引き算で落ちます。
これは実用上とても重要な性質です。 という補正は、モデルが間違っていても正しく機能する。 AIC が「真のモデルが候補に入っている」を前提としないのは、この性質の帰結です。
ただし、どこまで間違っていていいのかには限度があります。ここで消えたのは平均構造の誤りだけで、 は正しいままでした。分散構造まで間違っている一般の場合、誤特定のもとで正しい罰則は (竹内情報量規準, TIC, Takeuchi Information Criterion)に変わります。ここで は対数尤度のヘッセ行列の期待値(の符号を変えたもの)、 はスコア関数の分散で、モデルが正しければ なので は 次の単位行列のトレース、つまり になります(第10回のフィッシャー情報量の2つの表し方が一致する、という話と同じものです)。つまり が に一致するのは、モデルが正しく特定されているときです。「モデルが間違っていても機能する」は、 を固定した正規線形モデルという今の枠の中での話です。
図にすると2つの曲線の関係が見えます。
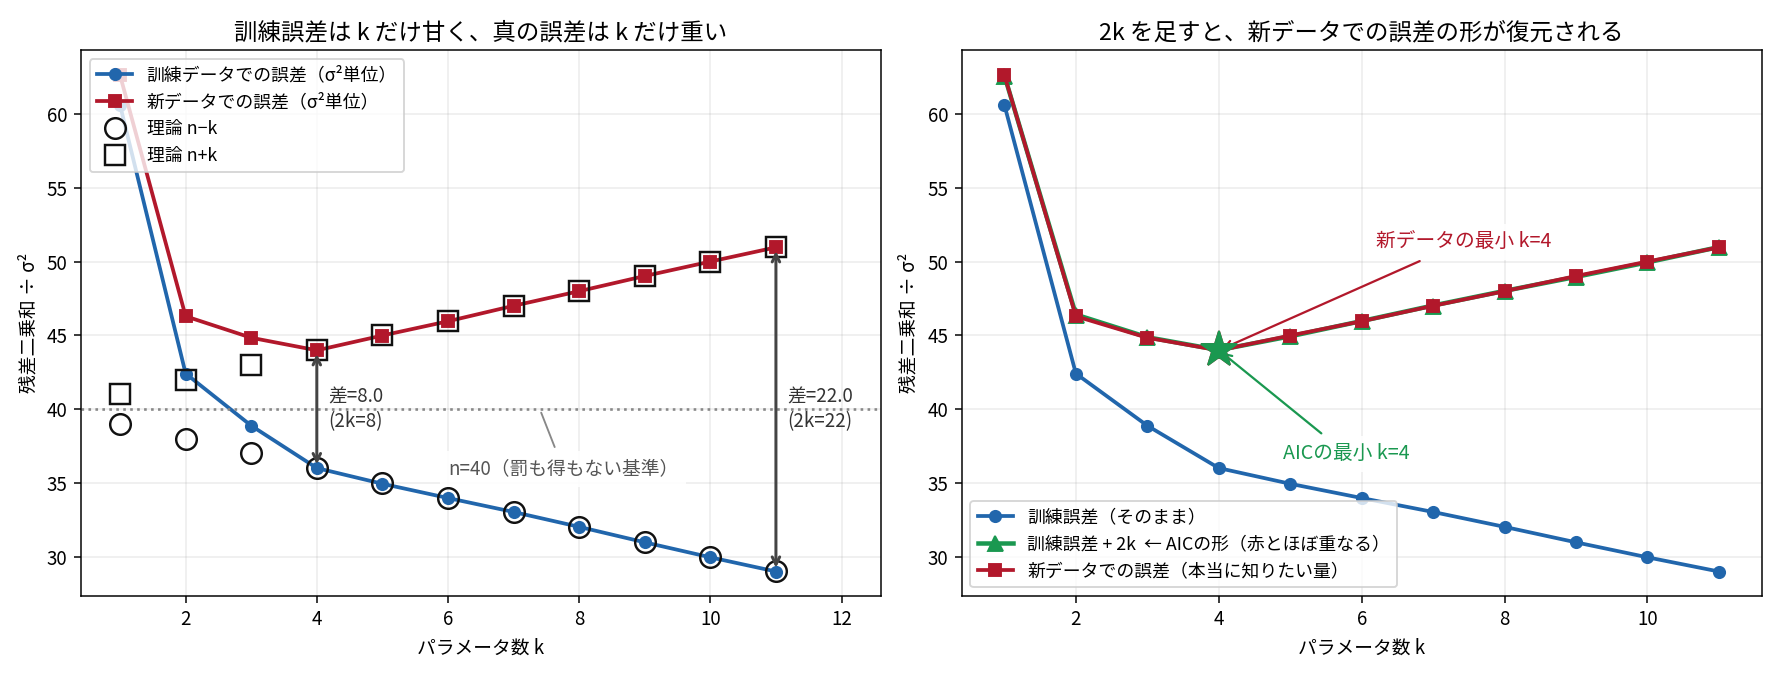
左が2つの期待値、右が補正の結果です。訓練誤差に を足すと、本当に知りたかった新データでの誤差の曲線が復元されます。 これが AIC の全部です。AIC は「新データでの予測誤差の推定量」であり、 の部分が甘く出るぶんを で埋め戻しているだけです。
と残差平方和のつながりも確認しておきます。正規分布を仮定すると対数尤度は
なので、 です。残差平方和が小さいほど尤度が高い。第31回の EM アルゴリズムで最大化していた対数尤度が、そのまま AIC の材料になります。
AIC はパラメータ数の最適値を求める道具ではない
ここで私は勘違いをしていました。「AIC はパラメータ数として幾つが最適かを求める指標」だと思っていたのです。上の図がまさに「 を横軸にした曲線」なので、そう見えます。
違います。AIC が順位づけるのはモデルであって、パラメータ数ではありません。
実演します。8本の候補変数(真に効くのは )から3本を選ぶ組み合わせは56通りあります。56通りすべてがパラメータ数 です(3変数+切片+)。罰則項 は全部同じ。それでも AIC の値は大きく散らばります。
| 順位 | 選んだ変数 | RSS | AIC | |
|---|---|---|---|---|
| 1 | 58.47 | 5 | 8.45 | |
| 2 | 116.03 | 5 | 49.57 | |
| 3 | 123.27 | 5 | 53.20 | |
| … | ||||
| 56 | 436.12 | 5 | 129.01 |
同じ なのに、AIC の幅は 120.6 あります。 罰則が同じなら、あとは当てはまりの勝負です。だから AIC は「3本使うモデルの中でどの3本か」を選べます。パラメータ数だけの関数なら、こんなことは起きません。
そのうえで、パラメータ数をまたいだ比較もできます。同じデータで全256通り(8変数の全部分集合)を計算しました。
| 変数の本数 | その本数での最良の組み合わせ | AIC |
|---|---|---|
| 0 | 定数のみ | 123.46 |
| 1 | 92.17 | |
| 2 | 51.81 | |
| 3 | (真のモデル) | 8.45 |
| 4 | 8.04 | |
| 5 | 8.13 | |
| 8 | 全部 | 13.81 |
AIC 最小は変数4個の (8.04)で、真のモデル(8.45)ではありません。 余分な が1本入っています。差は 0.41 なので実質同点ですが、AIC はこういう「少し入れすぎ」を系統的にやります。この性質は後で正面から扱います。ちなみに同じデータで BIC を計算すると、最小は変数3個の真のモデル(18.92)でした。
絶対値は無意味、差だけが意味を持つ
上の表の「8.04」という数字そのものには意味がありません。 には のようなデータに依らない定数が入っていますし、 の単位を 倍すれば全モデルに が共通に乗ります。データを別のものに変えれば AIC は簡単に数百も動きます。
AIC は同じデータに対する複数モデルの間で、差を見るためだけの量です。 「AIC が 8.04 だから良いモデル」という言い方は成立しません。「AIC がこちらのほうが 41 小さいから、こちらを選ぶ」が正しい使い方です。
AICc:小標本では罰則が足りない
という補正は が大きいときの近似です。 が に比べて小さいと補正が足りず、AIC は複雑なモデルを選びすぎます。修正版が AICc です。
追加項の大きさを表にしました。
| 追加項 | 罰則の合計 | 倍率 | |||
|---|---|---|---|---|---|
| 20 | 3 | 6 | 1.50 | 7.50 | 1.25 |
| 20 | 8 | 16 | 13.09 | 29.09 | 1.82 |
| 20 | 15 | 30 | 120.00 | 150.00 | 5.00 |
| 40 | 8 | 16 | 4.65 | 20.65 | 1.29 |
| 150 | 8 | 16 | 1.02 | 17.02 | 1.06 |
| 150 | 15 | 30 | 3.58 | 33.58 | 1.12 |
、 では罰則が5倍に膨れます。分母 がゼロに近づくからです。逆に 、()なら 1.06 倍で、無視して構いません。よく言われる目安は なら AICc は要らないですが、これは安全側に寄せた慣行で、両者が分かれる境目ではありません。実際に差が出るのは が 10 を切る辺りからです( で 1.06 倍、 で 5 倍)。 が 40 を下回ったら AICc も計算して、差が出るかどうかを自分で見るのが正しい使い方だと思います。
なお、この式が厳密に成り立つのは正規線形回帰(かつ )のときです。一般の尤度モデルに使う場合は近似です。
効果も測りました。真の次数が3の多項式回帰で、真の次数を当てられる割合です。、、候補は0次から9次まで( が小さいときは 次まで)、反復は が小さい順に 3000・3000・2000・1500 回です。
| AIC 平均次数 | AIC 的中 | AICc 平均次数 | AICc 的中 | BIC 平均次数 | BIC 的中 | |
|---|---|---|---|---|---|---|
| 15 | 5.21 | 0.132 | 1.62 | 0.152 | 3.90 | 0.158 |
| 25 | 4.01 | 0.322 | 2.43 | 0.405 | 2.58 | 0.365 |
| 60 | 3.79 | 0.609 | 3.32 | 0.692 | 2.82 | 0.702 |
| 200 | 3.67 | 0.727 | 3.56 | 0.753 | 3.03 | 0.971 |
では AIC の平均次数が 5.21 と暴走しています。AICc は 1.62 に抑えますが、こちらは抑えすぎで的中率は 0.152 と大差ありません。 ではどの規準も的中率が15%程度で、そもそも選べていない。 この「小標本では選べない」は最後の実務の節でもう一度出てきます。
Mallows の
回帰専用の規準として があります。
を全変数モデルから取って固定した AIC の回帰版です。いま評価しているそのモデル自身が真の平均構造を含んでいれば(バイアスがなければ)、含んでいなければ より大きくなります。だから「 が に近く、 を大きく超えていないモデル」を選びます。 が の不偏推定であること、つまり全変数モデルが正しいことも前提です。 の に AIC と同じ が居ることに注目してください。出どころは同じ です。
試験対策としては存在と式の形を知っていれば十分だと思っています。AIC を理解していれば導ける関係です。
BIC:変化点がいくつあるかを決める
BIC の定義は、罰則の係数だけが違います。
が に変わっただけ。 なら なので、実質どんなデータでも BIC のほうが厳しい。 なら で、罰則は AIC の 2.51 倍です。
由来はまったく違います。AIC は予測誤差の推定量でしたが、BIC はモデルの事後確率から出ます。データ が与えられたときのモデル の周辺尤度 をラプラス近似すると、 になります。第33回のベイズ法で扱う周辺尤度がそのまま出てきます。
つまり AIC と BIC は「どちらが正しいか」という関係ではなく、質問が違います。
- AIC:このモデルは新しいデータをどれだけ当てるか
- BIC:このモデルが真のモデルである確率はどれだけか
変化点の個数を決めてみる
差が最も見やすい例を作りました。時系列に段差(変化点)がいくつあるかを決める問題です。 点、真の変化点は 40 と 90 の2か所、区間ごとの平均は 、。変化点の個数 を 0 から 15 まで動かし、各 について位置の最適な組み合わせを動的計画法で厳密に求めました(総当たりだと組み合わせ数が爆発します)。
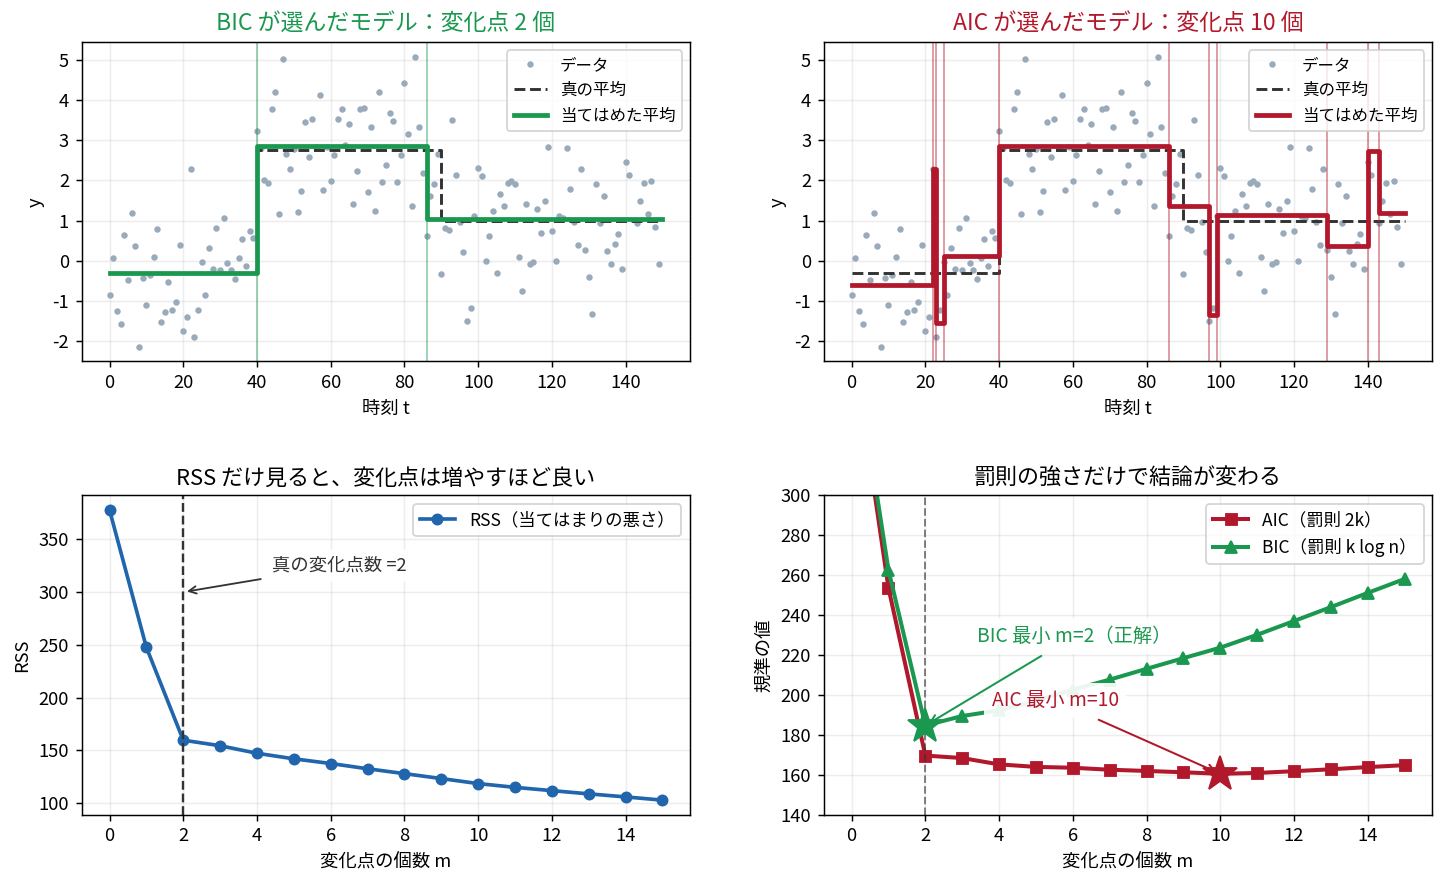
は既知としたので、 は に定数を足したものになり、AIC は と書けます。パラメータ数は「区間ごとの平均 個+変化点の位置 個」で と数えました。位置もデータから決めているので、パラメータとして数えないと不公平になります。
まず下段左のグラフを見てください。RSS は変化点を増やすほど下がり続けます。 決定係数と同じ現象で、これだけ見ていると「変化点は多いほど良い」になってしまいます。個数を決めるには罰則が必要です。
結果です。
| 選んだ個数 | 選んだ位置 | |
|---|---|---|
| 真実 | 2 | 40, 90 |
| BIC | 2 | 40, 86 |
| AIC | 10 | 22, 23, 25, 40, 86, 97, 99, 129, 140, 143 |
BIC は真の構造をほぼ正確に取り出しました。位置も 40 は完全一致、90 に対して 86 です。AIC は 10 個の変化点を置き、うち 40 と 86 は当てていますが、残り8個はノイズに階段を合わせているだけです。
上段右のグラフを見ると、AIC の階段が細かく刻まれているのが分かります。予測の観点では、この細かい刻みは(少なくとも害にならない程度には)情報を持っています。しかし「この時系列に何が起きたのか」を人に説明したいなら、10 個の変化点は使えません。BIC が選んだ2個のほうが、明らかに「答え」です。
これが AIC と BIC を使い分ける理由です。構造を取り出したいなら BIC、予測したいなら AIC。
一つ注意を書いておきます。 と はどちらも正則条件(パラメータが定義域の内点にあり、尤度が滑らか)のもとでの漸近論から出た罰則です。変化点の「位置」は正則なパラメータではありません(整数値で、尤度が滑らかにつながらない)。変化点問題では位置1個あたりの実効的な罰則はもっと大きいことが知られていて、 型の罰則が使われます。ですからここで AIC が 10 個も置いたのは、AIC の一般的な甘さだけでなく非正則性による罰則の過小も混ざった結果です。性格の対比としては分かりやすい例ですが、罰則の理論的な正当化はこの設定では成り立っていません。
AIC と BIC はどちらが「良い」のか
「BIC のほうが真のモデルを当てる」なら、常に BIC を使えばいいのでは、と思いました。そうならない理由が2つあります。
一貫性:BIC が勝つ状況
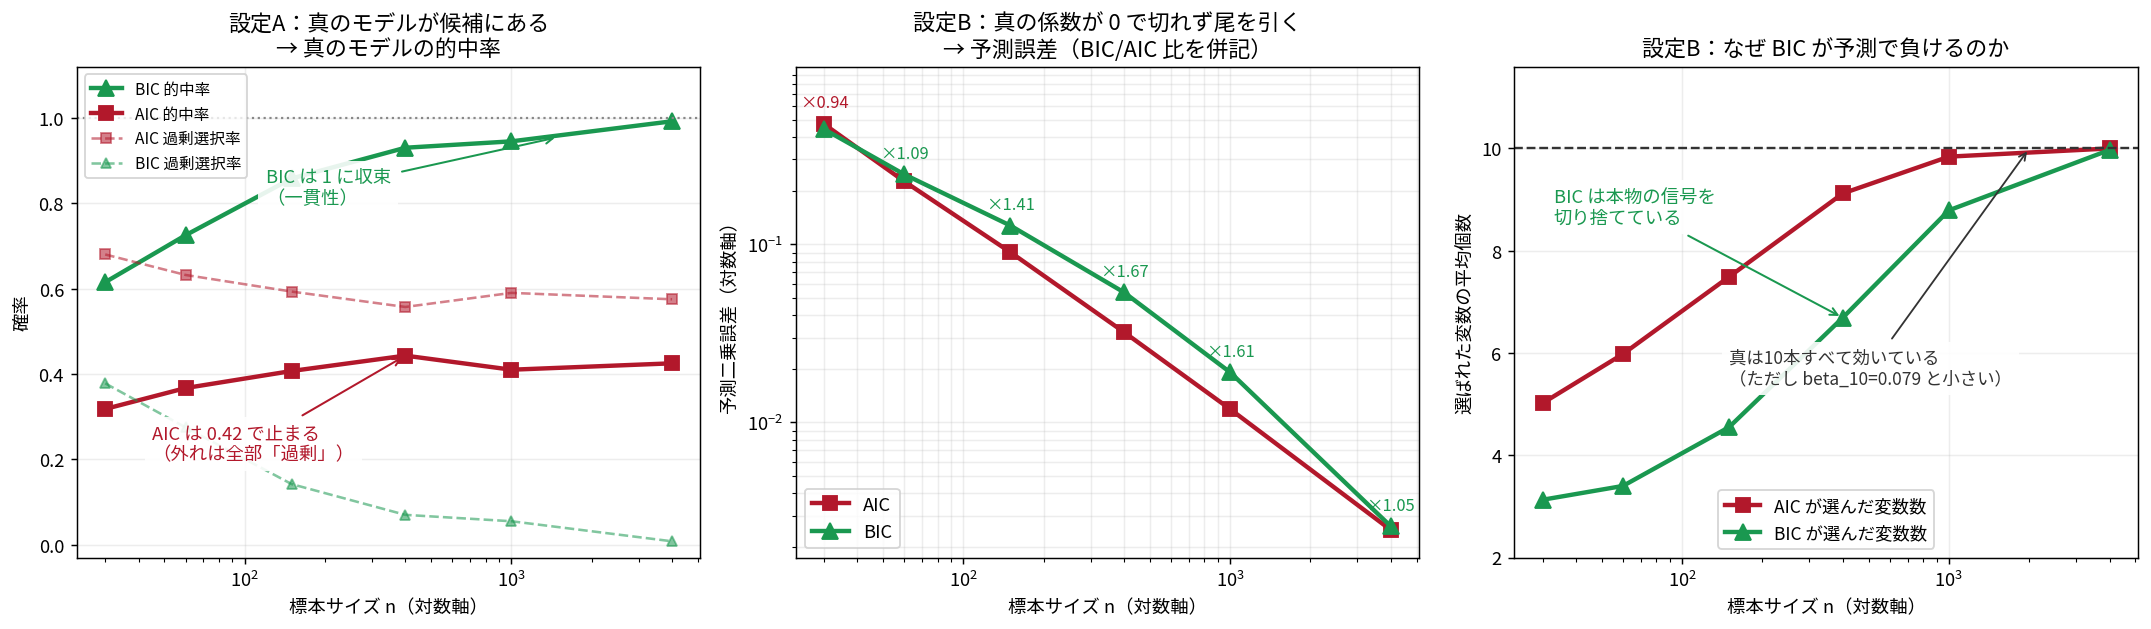
まず BIC が勝つ状況を確認します。候補は8変数の全部分集合256通り、真のモデルは (残り5本の係数は厳密にゼロ)。真のモデルを正確に選べた割合です。
| AIC 的中 | BIC 的中 | AIC が選びすぎた割合 | BIC が選びすぎた割合 | |
|---|---|---|---|---|
| 30 | 0.318 | 0.615 | 0.680 | 0.378 |
| 60 | 0.367 | 0.725 | 0.632 | 0.275 |
| 150 | 0.407 | 0.858 | 0.593 | 0.142 |
| 400 | 0.443 | 0.930 | 0.557 | 0.070 |
| 1000 | 0.410 | 0.945 | 0.590 | 0.055 |
| 4000 | 0.425 | 0.992 | 0.575 | 0.008 |
BIC は を増やすと 1 に近づき、AIC は 0.42 付近で止まります。 この「 で真のモデルを選ぶ確率が 1 に収束する」性質を一貫性(consistency)と呼びます。BIC は一貫、AIC は非一貫です。
用語で一つ注意です。この一貫性と、次に出てくる効率性は、第10回の推定量の一致性(consistency)・効率性(efficiency)とは別の概念です。英語は同じでも、あちらは「推定値が真の値に近づくか」「分散が下限に達するか」という1つのモデルの中でのパラメータの話、こちらは「 を増やすとモデルの選択が真のモデルに収束するか」「選んだモデルの予測誤差が最小に近づくか」という話です。同じ語で違うものを指す典型なので、混ぜないようにしてください。
AIC が止まる理由は右の2列を比べると見えます。AIC の選びすぎは 0.68 から 0.56 へわずかに下がったあと 0.57 前後で止まるのに、BIC の選びすぎは 0.378 から 0.008 まで消えていきます。 が増えても、AIC で余分な変数1本を入れるかどうかの判断は「 が 2 を超えるか」という固定の勝負のままなので、確率 0.157 で入ってしまいます。この確率は に依存しません。BIC は罰則が で伸びるので、対応する確率が とともに縮みます。
この 0.157 から、AIC が止まる高さを計算できます。偽の候補が 本あって、それぞれ独立に確率 0.157 で入るなら、1本も入らない確率は です。この設定は偽の候補が5本なので 、実測 0.425()とぴったり合います。選びすぎのほうも で実測 0.575 です。
つまり「0.42 で止まる」は普遍的な定数ではありません。 止まる高さは候補の作り方で決まります。偽の候補が20本なら まで落ちます。 をいくら増やしても改善しないという性質だけが、 に依らない部分です。
なお「不足」(真の変数を落とす)は 以降どちらも 0.000 でした。外れる原因は、ほぼすべて選びすぎのほうです。
効率:AIC が勝つ状況
では BIC が常に良いのか。上の設定には「真のモデルが候補に入っていて、しかも余分な係数が厳密にゼロ」という強い仮定があります。これを崩します。
候補変数を10本にして、係数を ()、つまり
と、小さくなっていくがゼロにはならない形にしました。現実のデータはたいていこちらです。候補は から順に入れていくネストした11通り()で、真のモデルは全部入りです。ただし10本目の係数は 0.079 しかないので、これを推定するコストが情報の利得を上回るなら、入れないほうが予測は良くなります。
| AIC 予測MSE | AIC の平均変数数 | BIC 予測MSE | BIC の平均変数数 | BIC ÷ AIC | |
|---|---|---|---|---|---|
| 30 | 0.47457 | 5.02 | 0.44416 | 3.13 | 0.936(BIC が勝ち) |
| 60 | 0.22609 | 5.98 | 0.24736 | 3.40 | 1.094 |
| 150 | 0.09040 | 7.49 | 0.12759 | 4.55 | 1.411 |
| 400 | 0.03215 | 9.12 | 0.05377 | 6.69 | 1.673 |
| 1000 | 0.01188 | 9.84 | 0.01912 | 8.79 | 1.610 |
| 4000 | 0.00249 | 10.00 | 0.00261 | 9.97 | 1.050 |
で BIC の予測誤差は AIC の 1.67 倍です。変数数の列に原因が出ています。真は10本なのに、 で BIC は平均 6.69 本しか使っていません。小さい係数を「ゼロだ」と切り捨てて、その情報を捨てています。AIC は 9.12 本まで拾います。この「予測誤差を(達成可能な最小に対して)最小化する」性質を効率性と呼びます。AIC は効率的、BIC は非効率です。
で差が 1.05 に縮むのは、 が十分に大きいと BIC でも全部入れるようになるからです(9.97 本)。 で BIC が勝つのは、データが少なすぎて、小さい係数を推定するコストのほうが情報の利得を上回るためです。「小さい係数を入れるべきか」は、 次第で答えが変わる。 どちらの規準が良いかという話ではなく、 と係数の大きさの兼ね合いです。
一貫性と効率性は両立しません。 これは選び方の工夫の問題ではなく、原理的な二者択一だと知られています(Yang 2005。損失の測り方や漸近の枠組みを固定したうえでの結果です)。真のモデルを当てたいなら小さい係数を切る覚悟が要り、予測を良くしたいなら偽の変数が混ざる覚悟が要ります。
図にまとめました。
使い分けはこうなります。
| AIC | BIC | |
|---|---|---|
| 何を最小化するか | 新データでの予測誤差 | 真のモデルを外す確率 |
| 罰則 | ( で AIC より厳しい) | |
| の性質 | 効率的・非一貫 | 一貫・非効率 |
| 得意な状況 | 係数がゼロにならず裾を引く | 真のモデルが候補にあり係数が厳密にゼロ |
| 目的 | 予測 | 構造の同定・説明 |
両方を計算して、一致すれば安心、割れたら「予測なら AIC、説明なら BIC」で決めるのが実際的だと思います。上の変化点の例では、まさに割れたことが判断の材料になりました。
交差検証:理論で補正せずに実測する
もう一つの流派です。AIC は「甘く出る量」を数式で計算しましたが、交差検証(CV, Cross Validation)は実際に測ります。データを分けて、当てはめに使わなかった側で誤差を測る。第25回の判別分析で見かけの誤判別率と対比して出てきた方法です。
一個抜き(LOO, Leave-One-Out)は、 番目の1点だけを抜いて残り 点で当てはめ、抜いた点を予測し、それを 回繰り返します。誤差の二乗和が PRESS(予測残差平方和)です。
PRESS は再計算せずに出る
回当てはめ直すのは重い。ところが線形回帰では閉じた式があります。
は普通の残差、 はてこ比です。当てはめは1回だけで、LOO の答えが完全に一致します。 確かめました。
| 値 | |
|---|---|
| 総当たりで 回当てはめた LOO の誤差二乗和 | 62.8039145111 |
| PRESS の式 | 62.8039145111 |
| 各点での差の最大絶対値 |
一致は浮動小数の精度いっぱいです。参考に、通常の残差平方和は 46.2818 で、PRESS はその 1.357 倍でした(下の図では 1.36 と丸めています)。この 1.357 倍が「手元のデータで測ると甘く出る」の実測値です。
分母の の意味も見えます。てこ比が大きい点は自分の予測値を強く引っ張っているので、抜いたときのズレも大きくなる。だから残差を で割り戻して膨らませます。第17回で出てきた標準化残差と同じ発想で、割る量が違うだけです。
AIC ≒ LOO は偶然ではない
理論から補正する AIC と、実測する LOO が、しばしば同じモデルを選びます。理由は式の出どころが同じだからです。
どちらもハット行列 から出ています。
| から取るもの | 使い方 | |
|---|---|---|
| AIC | (対角の和) | 全体でまとめて 補正する |
| LOO(PRESS) | (対角成分そのもの) | 点ごとに で補正する |
AIC は「点ごとの補正を平均で代表させたもの」、LOO は「点ごとに個別にやったもの」。 がどの点でも に近い(てこ比が均等な)設計では、両者は一致に近づきます。実際、 なので平均は必ず です。この対応が見えたのが、この節でいちばんスッキリしたところでした。
一致率を測りました。8変数256通りの候補から選ばせ、AIC と各方法が同じモデルを選んだ割合です。
| AIC = LOO | AIC = 10-fold | AIC = 5-fold | |
|---|---|---|---|
| 30 | 0.593 | 0.507 | 0.387 |
| 60 | 0.873 | 0.627 | 0.493 |
| 150 | 0.850 | 0.650 | 0.600 |
| 400 | 0.950 | 0.783 | 0.483 |
で AIC と LOO は 95% 一致します(60回中57回。反復が少ないので標準誤差は 2.8% あります)。いっぽう -fold は が小さいほど AIC から離れます。-fold は 点で当てはめているので、5-fold は 点のモデルを評価していることになり、 点のモデルを評価する AIC とはそもそも別のものを測っています。
-fold は分け方で答えが変わる
-fold のもう一つの弱点は再現性です。同じデータを 200 通りの分け方で 5-fold にかけたら、選ばれるモデルが 17 種類に分かれました。
| 方法 | 選ばれたモデルの種類数 | 最頻モデルの割合 |
|---|---|---|
| 5-fold CV | 17 種類 | 21.0% |
| 10-fold CV | 11 種類 | 38.0% |
| LOO | 1 種類(決定的) | 100% |
| AIC | 1 種類(決定的) | 100% |
最頻モデル()が選ばれるのは 5-fold では5回に1回しかありません。AIC と LOO は分け方の乱数を使わないので、常に同じ答えを返します(そして両者はこの例では一致していました)。
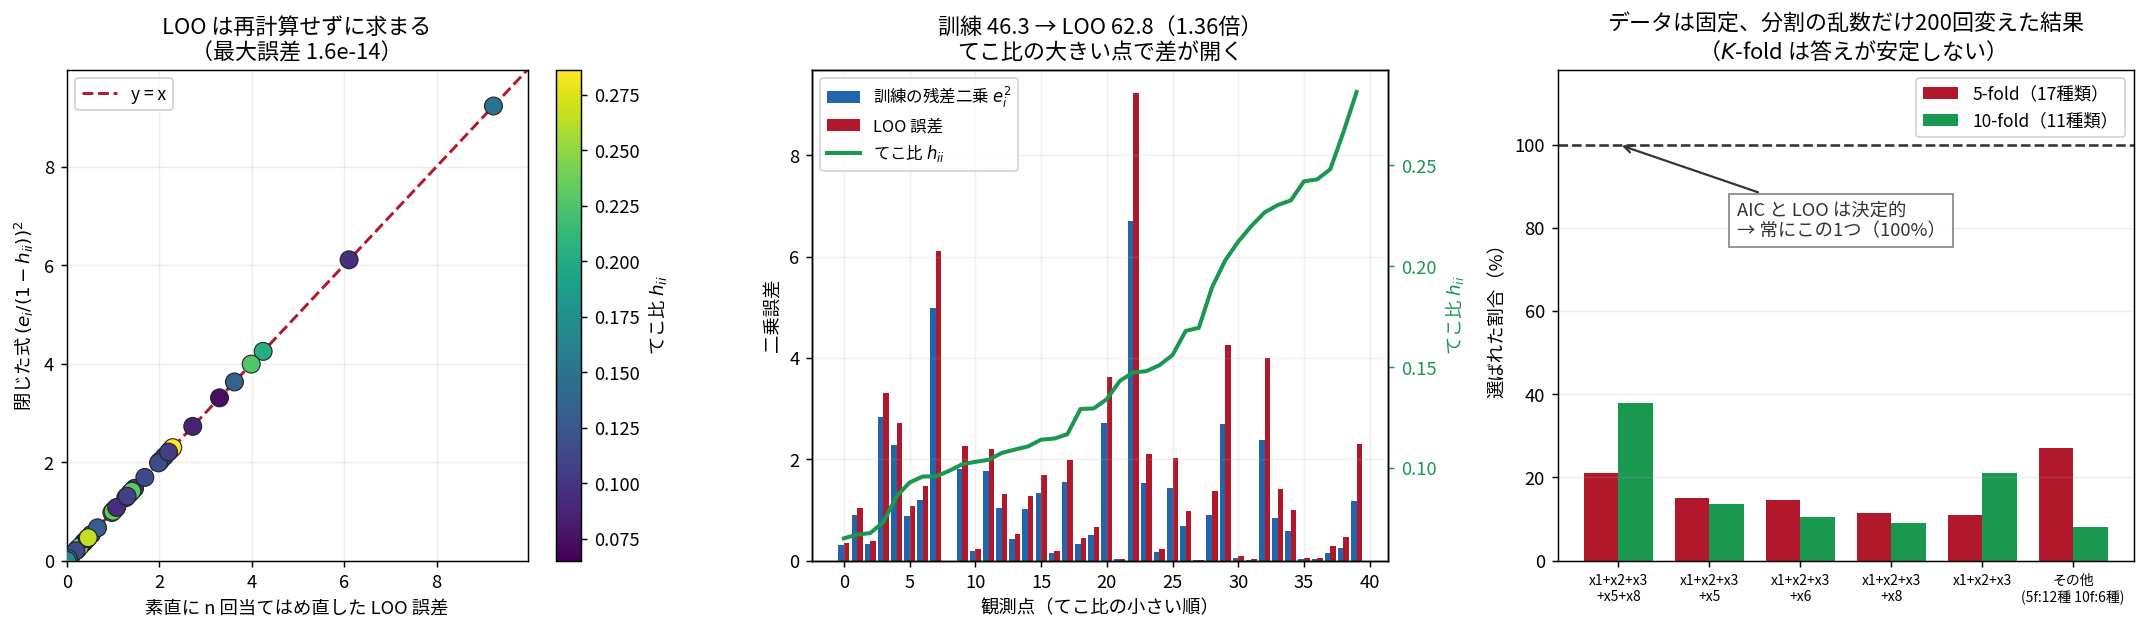
中央のグラフが「甘く出る」の正体を点ごとに見せています。てこ比の小さい点では訓練の残差と LOO 誤差がほとんど同じですが、てこ比の大きい点では LOO 誤差が大きく跳ねます。 モデルが自分に引っ張られている点ほど、抜いたときのペナルティが大きい。
まとめるとこうです。
| 計算量 | 再現性 | 何を評価しているか | |
|---|---|---|---|
| AIC | 当てはめ1回 | 決定的 | 点で当てはめたモデル |
| LOO(PRESS) | 線形回帰なら1回 | 決定的 | ほぼ 点のモデル |
| 10-fold | 10 回 | 分け方に依存 | 点のモデル |
| 5-fold | 5 回 | 分け方に強く依存 | 点のモデル |
線形回帰なら PRESS があるので、LOO を既定値にできます。 決定的で、当てはめも1回で済む。ただし PRESS の閉じた形が使えるのは二乗誤差でハット行列が固定される線形の場合に限られますし、モデル選択の道具としての LOO は AIC と 95% 一致する、つまりAIC と同じ甘さも共有していることを忘れないほうがよいです。-fold の出番は、当てはめが重くて 回回せない場合か、PRESS のような閉じた式が無いモデル(一般化線形モデルや機械学習)です。そして -fold を使うなら、分け方の乱数を変えて何回か回して、答えが安定しているかを見るべきです。1回の結果だけを見て「CV で選んだ」と言うのは危ういと分かりました。
ステップワイズ法の5つの罪
ここが今回いちばん腹に落ちた節です。
ステップワイズ法は、変数を1本ずつ入れたり抜いたりして良いモデルを探す手続きです。前向き(何も入っていない状態から、最も改善する変数を1本ずつ足す)、後ろ向き(全部入れた状態から、最も要らない変数を1本ずつ抜く)、その混合があります。 本の変数の全部分集合は 通りあり、 なら10億通りを超えて総当たりできません。ステップワイズはこれを 回程度の当てはめで済ませます。
教科書には「批判が多い」と書いてあります。ただ理由が並べられるだけで、私はどれも「なんとなく危なそう」の域を出ませんでした。全部測ってみます。
罪1:ノイズだけのデータでも「発見」が出る
いちばん効いた実験です。 を説明変数と完全に無関係な乱数にします。真の関係は何もありません。そこにステップワイズを回して、有意()という入り口を1本でも通った割合を測りました。
| 設定 | 「有意」な変数が1本以上入った割合 | 選ばれた変数の平均本数 | 自由度調整済み | |
|---|---|---|---|---|
| ・候補10本 | 0.389 | 0.65 | 0.053 | 0.044 |
| ・候補30本 | 0.779 | 1.65 | 0.171 | 0.145 |
| ・候補30本 | 0.784 | 1.61 | 0.083 | 0.069 |
| ・候補50本 | 0.911 | 2.02 | 0.071 | 0.059 |
真の関係がゼロのデータで、・候補50本なら10回に9回、「有意な変数」が見つかります。
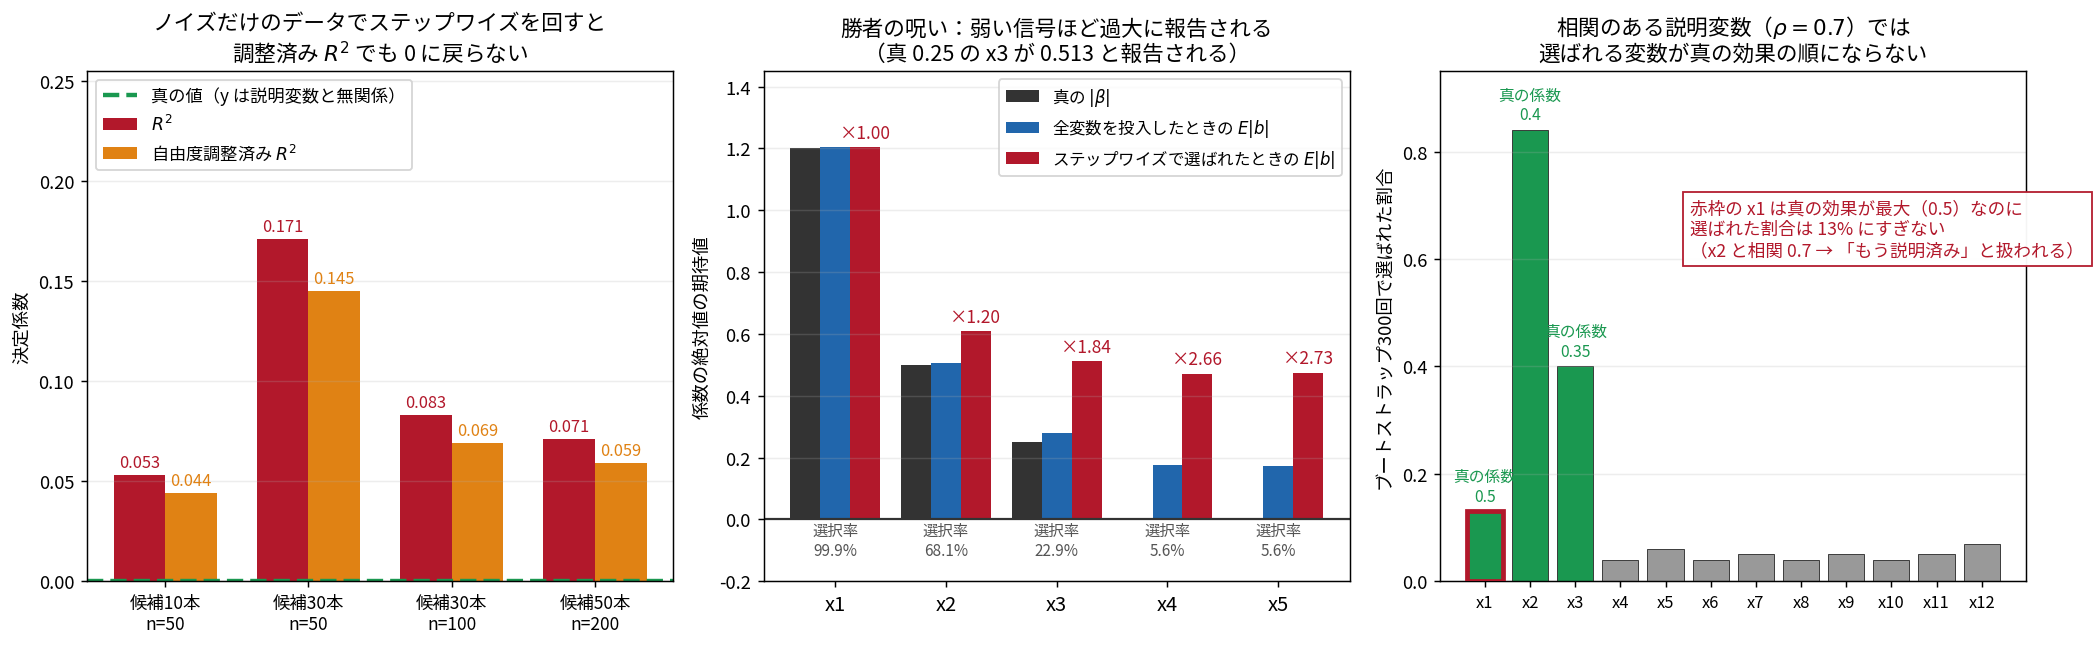
私がいちばん驚いたのは自由度調整済み の列です。0.145 という値が出ています。 第16回で「調整済み は無意味な変数を入れると下がる」と学んだので、調整済みなら安全だと思っていました。違いました。
理由はこうです。調整済み が正しく罰するのは、変数を「あらかじめ決めて」入れた場合です。ステップワイズは が最も上がる変数をデータを見てから選んでいます。 本入れたぶんの補正はしますが、「 本の中から最も良い 本を選んだ」ことは補正していません。払っている税金が、実際に使った自由度に見合っていない。
さらに悪いのは、モデル全体の 検定です。この設定では、1本以上選ばれた回(全体の 77.9%)に限ると、 検定が になる割合は 1.000 でした。最小 値の平均は 0.0136。真の関係がゼロなのに、変数が1本でも残ればモデル全体は必ず「有意」と判定されます。
ただしこの 1.000 は、半分は作りから出てくる数字です。入り口が「 検定で 」なので、残った変数が1本なら で 検定の 値は入り口の 値と同じものになります(平均本数 1.65 なので、そういう回が多い)。驚くべきなのは値そのものではなく、 検定が「選択のあとでは有意水準の意味を失う」という事実のほうです。全試行に対する偽陽性率で言えば 0.779 で、これは上の表の第2列と同じ数字です。
罪2:選ばれた変数の係数が過大になる(勝者の呪い)
真の係数を とし、・候補12本(残り9本は無関係)・・4000回でステップワイズを回します。選ばれたときの係数の絶対値の平均と、選抜せず全変数を投入したときの平均を比べます。この表の倍率の分母は、真の係数ではなく「全変数投入時の 」です。 真の係数がゼロの行でも定義できる基準がこれしかないからです(真の でも はゼロにならず、 倍の標準誤差ぶんは必ず出ます)。ただしこの記事全体で分母を統一しているわけではありません。後の比較表では真の係数を分母にした倍率も使います。倍率の数字を拾うときは、そのつど分母がどちらかを確認してください。
| 変数 | 真の | 全変数投入時の | 選ばれたときの | 倍率 | 選択率 |
|---|---|---|---|---|---|
| 1.20 | 1.204 | 1.204 | 1.00 | 99.9% | |
| 0.50 | 0.506 | 0.608 | 1.20 | 68.1% | |
| 0.25 | 0.279 | 0.513 | 1.84 | 22.9% | |
| 0 | 0.177 | 0.471 | 2.66 | 5.6% | |
| 0 | 0.174 | 0.475 | 2.73 | 5.6% |
真の効果が 0.25 の が、選ばれたときには 0.513 と報告されます。 真の値と比べれば 倍、表の分母(全変数投入時の 0.279)と比べれば 1.84 倍です。同じ現象を2つの基準で測っているだけで、どちらも「大きく出た回だけが生き残る」ことの現れです。
仕組みは単純です。 は22.9%しか選ばれません。では、どういうときに選ばれるのか。推定値が偶然大きく出たときです。 小さく出た回は選ばれずに消えるので、生き残った標本だけを平均すると当然大きくなります。これが勝者の呪いです。
は 1.00 で無傷です。ほぼ必ず選ばれる(99.9%)ので選抜のふるいがかかりません。選択率が低い変数ほど呪いが強い。 そして選択率が低いのは弱い信号の変数なので、弱い効果ほど過大に報告されるという、いちばん困る方向に歪みます。
真の効果がゼロの でも 0.47 という値が報告されています。ゼロのものに 0.47 の効果があると書いてしまう。
罪3: 値と信頼区間が壊れる
罪1と罪2から自動的に出てきます。 値は「この変数を1つ選んで検定した」前提で計算されますが、実際には30本の中で最良だったから選ばれています。 信頼区間も、係数自体が過大なので、真の値を含む確率が名目の95%を大きく下回ります。
罪4:わずかなデータの変化で結果が激変する
、候補12本、説明変数間の相関は AR 型(隣り合うペアが 0.7 で、。 と は 0.49)、真の係数 の設定です。まず1点だけ差し替える( 点のうち1点を新しい観測に置き換える)と何が起きるか。
| 撹乱の方法 | 選ばれたモデルの種類数 | 最頻モデルの割合 |
|---|---|---|
| 1点だけ差し替え | 2 種類 | が 96.7% |
| ブートストラップ再標本 | 65 種類 | が 37.7% |
1点の差し替えなら 96.7% 安定しています。ところがブートストラップ(同じ大きさの再標本)にすると 65 種類のモデルが出てきます。 元のデータで選ばれたのは の1本だけでしたが、その答えは37.7%しか再現しません。「このデータからはこの変数が選ばれた」という結論が、データの取り方の偶然にほとんど支配されています。
しかもここには罪4より深刻な問題が混ざっています。変数ごとの選択率を見てください。
| 変数 | 真の係数 | ブートストラップでの選択率 |
|---|---|---|
| 0.50(最大) | 0.13 | |
| 0.40 | 0.84 | |
| 0.35 | 0.40 | |
| 0 | 0.04〜0.07 |
真の効果が最も大きい が、13%しか選ばれていません。 (真 0.40)が 84% です。順序が逆転しています。
原因は と の相関 0.7 です。 が先に入ると、 の情報の大半は「もう説明済み」になり、追加の改善が小さくなって入らない。
ここで「たまたま が先に入ったから」と書きかけて、確かめてやめました。偶然ではありません。 前向き選択の第1段が見ているのは との周辺相関で、この設定では が 0.514、 が 0.537 です。 は自分の 0.40 に加えて、隣の (0.50)と (0.35)の両方から相関を通じて貸しを受けているので、周辺では を上回ります。だから 84% という高い率で先に入る。真の係数の順序と周辺相関の順序は、説明変数が相関していれば平気で入れ替わります。 ステップワイズが返すのは「効いている変数」ではなく「周辺相関がいちばん大きい変数」です。第16回の VIF(分散拡大係数)で見た多重共線性が、ここで別の顔を出します。
罪5:貪欲な探索なので最良を見逃す
これは他の4つとは種類が違う、素直な計算上の限界です。候補10本(全部分集合 1024 通り)で、ステップワイズの答えと総当たりの AIC 最小モデルを比べました。、真は 、400回。
| 値 | |
|---|---|
| 総当たりの AIC 最小モデルと一致した割合 | 0.365 |
| ステップワイズの AIC - 最良の AIC(平均) | 1.02 |
| 同(最悪の回) | 9.16 |
一致は3回に1回強です。「貪欲だから最良を外す」の証拠だ、と書きかけました。ここで実験の作りに問題があることに気づきました。 この比較では2つのものが同時に変わっています。探索の仕方(貪欲な前向き選択か総当たりか)と、入り口の基準( か AIC か)です。 は 、AIC は 相当()なので、そもそも別の門を通しています。
そこで、探索の仕方だけを変えて測り直しました。貪欲な前向き選択のまま、入り口の判定を「」から「AIC が下がるなら追加」に差し替えます。
| 前向きステップワイズの入り口 | 総当たりとの一致 | AIC の超過(平均) | 最悪 |
|---|---|---|---|
| (上の実験) | 0.345 | 1.088 | 11.76 |
| AIC(同じ貪欲探索) | 0.950 | 0.020 | 0.98 |
(上の表と数字が少し違うのは、乱数の系列が別だからです。設計は同じで、一致率は 0.365 と 0.345、超過の平均は 1.02 と 1.088、最悪は 9.16 と 11.76。走りごとにこの程度は動くので、下の比較は小数第2位まで読まないでください。)
貪欲であること自体のコストは、ほとんどゼロでした。 一致 95%、AIC の超過は平均 0.020。つまり 0.365 という数字が示していたのは「貪欲さの害」ではなく、「 という門は AIC の門と違う」という罪1・罪2と同じ話でした。
罪5として残るのは、正しくは「貪欲探索は 5% 前後の回で総当たりの最良を外す。ただし超過は で 1 未満で、実害はほぼない」という控えめな主張です。最悪の回でも 0.98 で、 の「区別できない」範囲に収まっています。
ボンフェローニで直るのか
罪1(ノイズから発見が出る)は多重比較の問題に見えます。なら第20回のボンフェローニ法で、有意水準を候補数で割ればいいのでは。 でやってみました。・候補30本・3000回の別の実験です。真の係数は で、罪1の実験( が完全な乱数)とは違い、ここには本物の信号が3本あります。 そのうえで「真の係数がゼロの27本のうち1本以上を選んでしまった割合」を測ります。罪1の表の 0.779 とは測っている量が別なので、直接は比べられません。
| 素の | ボンフェローニ | |
|---|---|---|
| 真の係数が 0 の変数を1本以上選んだ割合(罪1) | 0.750 | 0.047 |
| 選ばれた変数の平均本数 | 3.40 | 1.28 |
| (真 0.50)の選択率 | 0.649 | 0.223 |
| の誇張倍率(罪2) | 1.22 | 1.49 |
| (真 0.25)の選択率 | 0.223 | 0.019 |
| の誇張倍率(罪2) | 2.09 | 2.84 |
(この表の誇張倍率だけは、分母が真の です。罪2の表は分母が全変数投入時の 。しかも候補が 30 本と 12 本で別の実験です。そのため同じ の誇張倍率が記事の中で3つの値を持ちます。候補30本・÷真の が 2.09()、候補12本・÷真の が 2.05(、あとの手法比較で使う値)、候補12本・÷全変数投入時が 1.84()。分母か実験のどちらかが違うので、この3つの大小は比べないでください。なお表の中に 0.223 が2回出ますが転記ミスではなく、 の素の選択率と のボンフェローニ下の選択率が偶然一致しています。)
罪1はきれいに直りました。 0.750 が 0.047 で、狙いどおり5%です。
そして罪2は悪化しました。 の誇張が 2.09 倍から 2.84 倍へ。しかも の選択率が 0.223 から 0.019 に落ちています。真に効いている変数を、50回に1回しか見つけられない。検出力を捨てて偽陽性を買い戻したことになります。
理由は罪2の仕組みそのものです。縮小をしない手法のあいだでは、呪いの強さは門の狭さで決まります(縮小を入れると話が変わることは、あとの節で見ます)。門を狭くすれば、通れるのは「よほど大きく出た回」だけになり、生き残った推定値はますます過大になる。罪1と罪2は同じつまみの両端で、片方を締めるともう片方が緩みます。
これは私にとって予想外でした。多重比較の補正は「正しい対処」だと思っていたので、それが別の歪みを増やすというのは考えていませんでした。
5つの罪の構造:3つの種類に分かれる
全部測ってみて、構造が見えました。5つは同じ種類の問題ではありません。 ここは最初「4つは選択後推論の問題、1つは探索の問題」と2分類で書いたのですが、それだと自分の実測と合わないことに気づいて3分類に直しました。
| 罪 | 何の問題か | 予測にも効くか |
|---|---|---|
| 1. ノイズから発見が出る | 選んだあとに検定した | 効かない |
| 3. 値・信頼区間が壊れる | 選んだあとに推論した | 効かない |
| 2. 係数が過大になる | 選抜によるバイアス | 効く(膨らんだ係数がそのまま予測式に入る) |
| 4. データが少し変わると激変する | 選択のバリアンス | 効く |
| 5. 貪欲探索で最良を見逃す | 探索アルゴリズムの限界 | ほぼ効かない(超過は平均 0.02) |
罪1と罪3は「選択後推論(post-selection inference)」の問題で、同じデータで「選ぶ」と「推論する」の両方をやったことが原因です。予測に使うだけなら害になりません。
罪2と罪4はそうではありません。 選抜で膨らんだ係数はそのまま予測式に入るので予測を上に外し、選択の不安定さは予測誤差のバリアンス成分そのものです。これが「予測にも効く」と分かる根拠は、この記事の後半にあります。そもそも 0/1 で選ぶのをやめて赤池ウェイトで平均化するだけで、予測誤差が 6.7〜23% 改善します。 これは「0/1 で選ぶこと自体に予測上の値段がある」ことの直接の証拠です(ステップワイズ固有の罪2・罪4がそれぞれどれだけ効いているかを分離したわけではありません。平均化は縮小とバリアンス低減を同時にやるので、内訳はこの実験からは出ません)。罪2に効く対処が「縮小」(ラッソが呪いを打ち消す)、罪4に効く対処が「平均化」という対応も、ここから素直に出てきます。
この整理ができると、対処法も決まります。
- 予測が目的なら、罪1と罪3は無視してよい。 報告した数値の解釈の話なので、予測誤差には効きません。ただし罪2・罪4は残るので、縮小(ラッソ)か平均化(赤池ウェイト)を検討する価値があります。罪5(貪欲さ)は実質ほぼ効きません。
- 推論したいなら、データを分ける。 選ぶのに使ったデータと、係数や 値を出すデータを別にする。これが唯一素直な解です。
- 選ばれた変数リストを「発見」として報告するのは避ける。 どうしても報告するなら、ブートストラップでの選択率を併記する。上の表で が 13% と分かれば、「 が選ばれた」を結論にはできません。
ここで AIC と検定の共通の限界も見えます。選択と推論を同じデータで両方やることはできない。 これは AIC の欠陥でもステップワイズの欠陥でもなく、データを二重に使うことの帰結です。
正則化を変数選択として見る
第19回でラッソとリッジを扱いました。あのときは「係数を縮める方法」として見ていましたが、変数選択の道具としても見られます。ここで両者の違いが決定的になります。
| 罰則 | 係数がちょうど 0 になるか | 変数選択に使えるか | |
|---|---|---|---|
| リッジ回帰() | ならない(限りなく近づくだけ) | 使えない | |
| ラッソ回帰() | なる | 使える |
覚え方はこうです。絶対値は原点で折れている。その折れがゼロを作る。 二乗は原点で微分がゼロになるので、解をゼロに留める力がありません。第19回で見た の菱形の角が座標軸に触れる図が、そのままこの表の内容です。
リッジ回帰は変数選択の手法ではありません。 私はここを曖昧にしていました。「正則化=変数を減らす」と一括りにしていたのですが、減らせるのはラッソだけです。
ステップワイズとラッソは「逆向きに」失敗する
同じデータでステップワイズとラッソを比べます。、候補12本、、ブートストラップ300回。
| ステップワイズ | ラッソ( は交差検証で決定) | |
|---|---|---|
| 元データでの答え | のみ | () |
| 選んだ変数の平均本数 | 1.92 | 5.87 |
| (真 0.50)の選択率 | 0.11 | 0.68 |
| (真 0.40)の選択率 | 0.84 | 0.97 |
| (真 0.35)の選択率 | 0.40 | 0.87 |
| 偽の変数(真 0)の選択率 | 0.01〜0.12 | 0.28〜0.54 |
元データではラッソが真の3本をちゃんと当てています。 ステップワイズは の1本だけでした。ブートストラップでも、ラッソは真の変数の選択率が 0.68〜0.97 と高い。 の 0.11 対 0.68 は決定的な差です。
理由を「ラッソは相関のある変数の両方に係数を分けて持たせるから」と書きかけて、調べ直してやめました。係数を分け合うのはリッジ()の性質で、ラッソは相関ペアの一方だけを選ぶ傾向があると知られています。 ここで が拾えている主因は次に書く の緩さです。平均 5.87 本も入れているので、真の変数も一緒に入ってくる。門が緩いから拾えているのであって、相関の扱いが賢いからではありません。
そのかわりラッソは偽の変数も 0.28〜0.54 で入れてきます。 ステップワイズは 0.01〜0.12 でした。平均本数 5.87 対 1.92 という差がそれです。
原因は の決め方です。交差検証は予測誤差が最小になる を選びます。予測に良い は、正しい変数集合を選ぶ より小さい(罰則が弱い)ことが知られています。予測のために選んだ で変数リストを作れば、余分が混ざるのは当然です。
失敗の方向が正反対です。 ステップワイズは本物を落とし、ラッソは偽物を混ぜる。どちらが良いかは目的次第で、「効いている変数のリストが欲しい」という目的にはどちらも向いていません。
(この節の選択率とひとつ前の節のブートストラップの数値は、独立に走らせた別のシード・別の300回の結果です。 の選択率が 0.13 と 0.11、ステップワイズのモデル種類数が 65 と 64 で少し違うのはそのためで、設計は同じです。)
呪いの強さを決めるのは「門の狭さ」と「縮小の有無」
勝者の呪いを、ステップワイズ・リラックス・ラッソ(ラッソで選んだ集合を最小二乗で再当てはめ)・ラッソの3つで比べました。・候補12本・400回です。報告される を基準値で割った比です。真の の行は分母が真の で、1.00 が正しい大きさ。真の の行は分母が全変数投入時の で、こちらの 1.00 は「正しい大きさ」ではなく「選抜しなかった場合と同じ」という意味です(ゼロで割れないため)。
| 変数 | 真の | ステップワイズ | リラックス・ラッソ | ラッソ |
|---|---|---|---|---|
| 1.20 | 1.01 | 1.00 | 0.83 | |
| 0.50 | 1.22 | 1.07 | 0.71 | |
| 0.25 | 2.05 | 1.52 | 0.84 | |
| 0 | 2.67 | 1.65 | 0.76 | |
| 0 | 2.98 | 1.68 | 0.81 |
の行で並べると、ボンフェローニ付きステップワイズ 2.84 > 素のステップワイズ 2.05 > リラックス・ラッソ 1.52 > ラッソ 0.84 です(ボンフェローニの 2.84 は候補30本の別実験なので、傾向の比較として見てください)。
これを最初「門の狭さの順序と一致する」と1本の軸で説明しようとして、失敗しました。リラックス・ラッソとラッソは、同じ で選んだ同じ変数集合を使っています。門はまったく同じです。 それでも 1.52 と 0.84 に分かれる。門では説明できません。
軸は2本あります。
| 軸 | 効き方 | 証拠 |
|---|---|---|
| 門の狭さ | 狭いほど呪いが強い | ボンフェローニ 2.84 > 素のステップワイズ 2.05 > ラッソの門 1.52(いずれも縮小なし。ただし 2.84 は候補30本の別実験で、あとの2つが候補12本) |
| 縮小の有無 | 縮小すると打ち消される | 同じ門で 1.52(再当てはめ)→ 0.84(縮小あり) |
1本目はボンフェローニの節で見たとおりです。2本目が新しく、選抜のあとで全員を縮めれば膨らんだぶんが差し引かれる、という話です。
ラッソだけが 1 を下回っています(0.71〜0.84)。 過大でなく過小です。過大に報告するより過小に報告するほうが安全側なので、これは望ましい性質ですが、その理由は門ではなく縮小です。
ただし「安全側」と言えるのは真の効果がある3本の行に限った話です。・ は真の が 0 なので、この行の 1.00 は「正しい大きさ」ではなく「選抜しなかった場合の基準」でしかありません。ラッソの 0.76 も、ゼロであるべきものに値を付けていることは変わりません(選択率 0.32)。比が小さいことは、その意味では慰めになりません。
ここで軸が一本通ります。問題の発生源は「データを見て 0 か 1 で選ぶ」という操作そのものです。
- ステップワイズは 0/1 で選んで、そのまま報告する → 呪いが最大
- ラッソは 0/1 で選ぶが、全員を縮める → 呪いが打ち消される
- 最後の節に出てくる赤池ウェイトによる平均化は、そもそも 0/1 で選ばない → 呪いが起きない
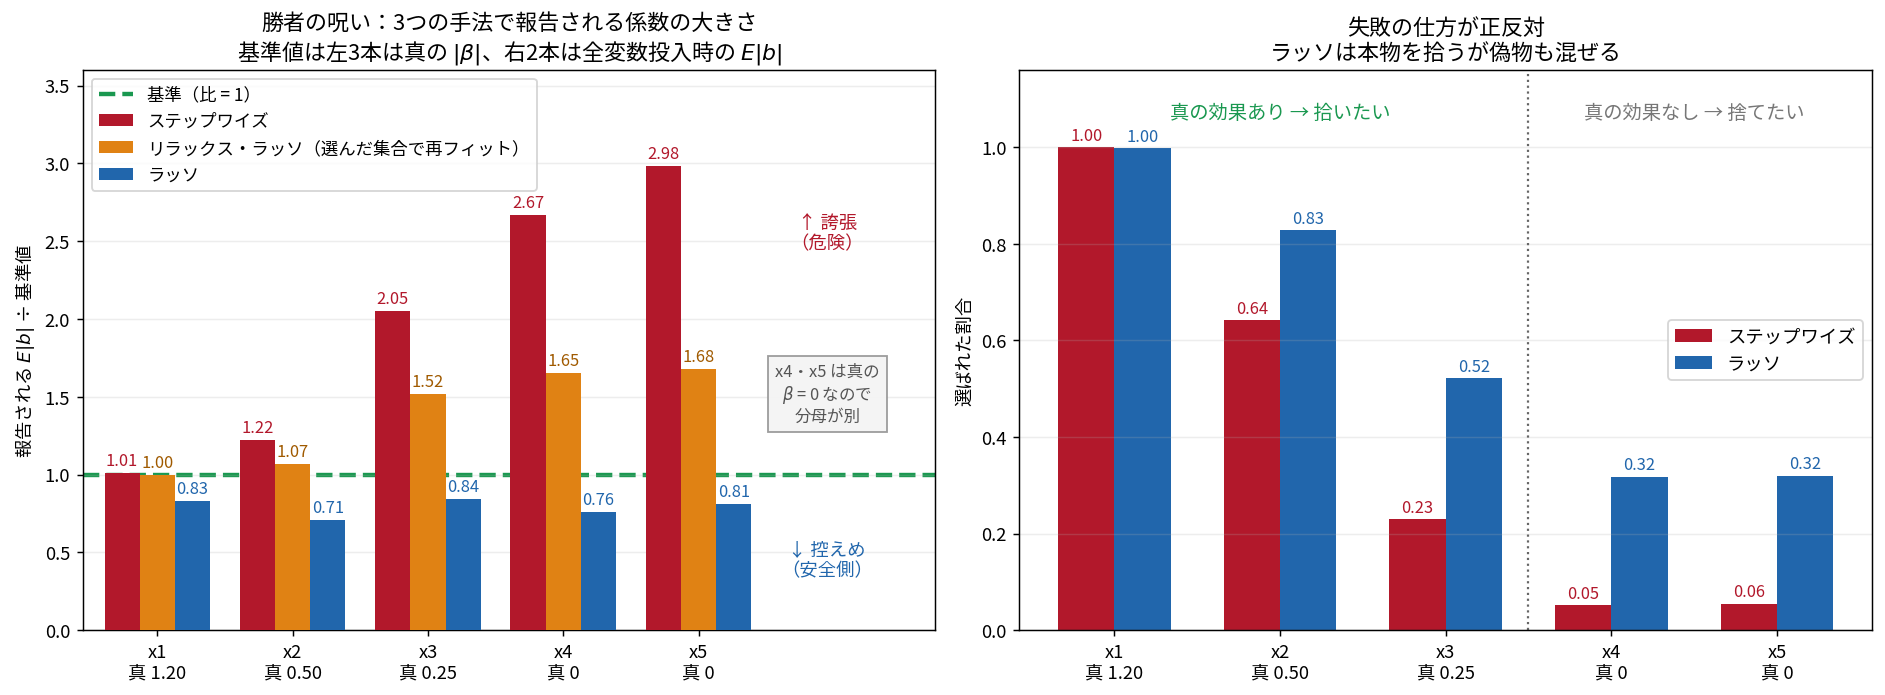
この図の3手法の比較は同じ設定(・候補12本・)を 400 回、罪2の節の表(誇張倍率と選択率の表)は 4000 回で、別の走りです。 の選択率が 0.23 と 22.9% のようにわずかにずれているのは、真の値が違うからではなく、別の乱数で走らせた誤差です(400回のほうが誤差は大きい)。
AIC は検定ではない
最後の山場です。AIC でモデルを比べるのと、尤度比検定でモデルを比べるのは何が違うのか。 私はこの2つが頭の中で分離できていませんでした。
式を並べると同じものだった
モデル (パラメータ )に変数を足したモデル ()を考えます。ネストしています。
AIC で を選ぶ条件は 、つまり
尤度比検定で を棄却する条件は第12回より
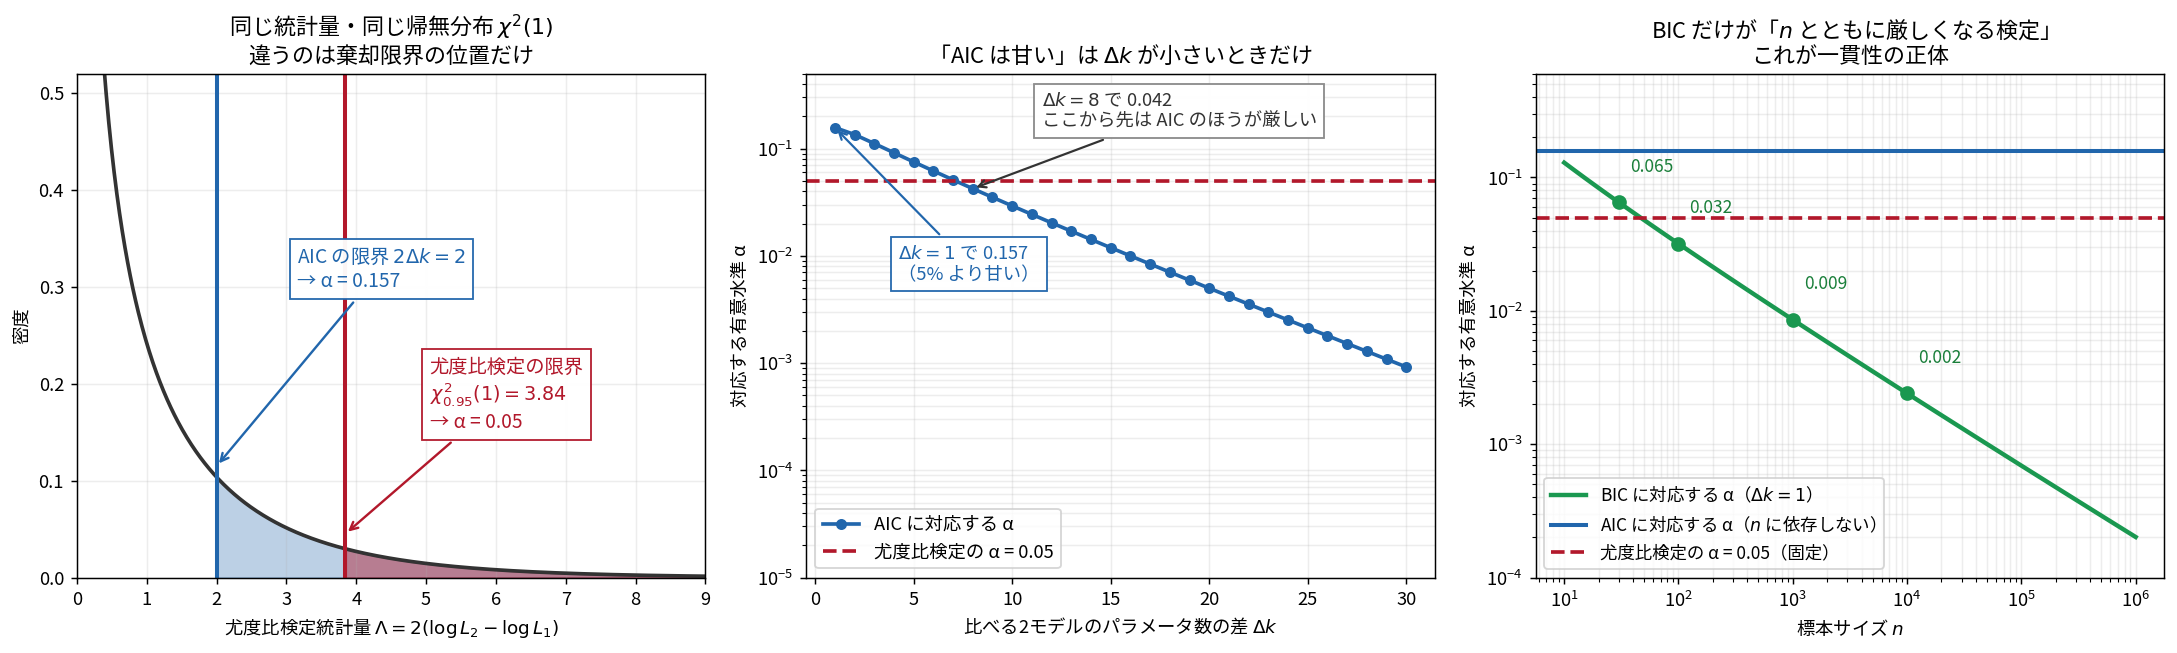
統計量はまったく同じ 、帰無分布も同じ 。違うのは棄却限界の位置だけです。 AIC は 、尤度比検定は 。
これが見えたときは驚きました。AIC は、棄却限界を に取り替えた尤度比検定です。
AIC に対応する有意水準を逆算する
限界が決まれば、有意水準が逆算できます。 です。
| AIC の限界 | AIC に対応する | どちらが厳しいか | ||
|---|---|---|---|---|
| 1 | 2 | 3.841 | 0.1573 | AIC が甘い |
| 2 | 4 | 5.991 | 0.1353 | AIC が甘い |
| 3 | 6 | 7.815 | 0.1116 | AIC が甘い |
| 5 | 10 | 11.070 | 0.0752 | AIC が甘い |
| 7 | 14 | 14.067 | 0.0512 | ほぼ一致(まだわずかに甘い) |
| 8 | 16 | 15.507 | 0.0424 | AIC が厳しい(逆転) |
| 10 | 20 | 18.307 | 0.0293 | AIC が厳しい |
| 20 | 40 | 31.410 | 0.0050 | AIC が厳しい |
「AIC は甘い」という定説は、 の 0.157 から来ています。5%より3倍甘い。だから AIC は変数を入れすぎる。ここまでは知っていた話です。
ところが を増やしていくと甘さは消え、 から先は AIC のほうが厳しくなります。 厳密に を解くと なので、 ではまだ 0.0512 でわずかに甘く、逆転する最初の整数は (0.0424)です。 なら AIC は 0.5% 水準の検定に相当します。
理由は 分布の形から出ます。 の平均は 、標準偏差は です。AIC の限界 は平均から
だけ離れています。 が増えるとこの距離が で広がっていきます。 いっぽう5%点は、 をどう変えても平均からほぼ一定の距離にとどまります。
| AIC の限界の位置 | 5%点の位置(標準偏差の単位) | |
|---|---|---|
| 1 | 0.707 | 2.009 |
| 3 | 1.225 | 1.966 |
| 5 | 1.581 | 1.920 |
| 7 | 1.871 | 1.889 |
| 8 | 2.000 | 1.877 |
| 10 | 2.236 | 1.858 |
| 20 | 3.162 | 1.804 |
と のあいだでこの2つがすれ違います。 左の列は で伸びていくのに、右の列は 2.0 から 1.8 へゆっくり下がるだけ。動くものと動かないものが交差する地点が です。 交点の位置は、この2列を見れば 分布の形だけから決まっていると分かります。
「AIC は甘い」は、1変数ずつ比べるときの話です。 変数を8本まとめて足すかどうかを AIC で判断すると、5%検定より厳しい判断になります。
BIC は「 とともに厳しくなる検定」
同じ計算を BIC でやると、一貫性の正体が見えます。BIC の限界は なので、 なら です。
| BIC に対応する | ||
|---|---|---|
| 10 | 2.303 | 0.12916 |
| 30 | 3.401 | 0.06515 |
| 100 | 4.605 | 0.03188 |
| 1000 | 6.908 | 0.00858 |
| 9.210 | 0.00241 | |
| 13.816 | 0.00020 |
BIC は有意水準が とともにゼロへ縮む検定です。 なら 0.02% 水準。これが「 で偽の変数を入れる確率がゼロになる」=一貫性の正体でした。AIC は 0.157 で固定なので、いくら を増やしても 0.157 で偽の変数を入れ続ける。前に見た「AIC の過剰選択率が減らない」の理由がこれです。
それでも「同じもの」ではない:3つの本質的な違い
限界の位置しか違わないなら、AIC は検定の言い換えなのか。違います。3つの本質的な差があります。
① 尤度比検定は非対称、AIC は対称。
検定は を特別扱いします。 が真のとき誤って棄却する確率だけを に抑え、 が真のときに見逃す確率(第2種の誤り)は制御しません。だから結論は「棄却する/できない」で、「 を採択した」とは言いません。
AIC は2つのモデルを対等に扱います。値が小さいほうを選ぶ。「 側を特別扱いしない」という点が決定的に違います。ここで「AIC には保守性がない」と書きかけたのですが、それは行き過ぎでした。罰則 は正の閾値なので、当てはまりが同じなら AIC は必ず単純なほうを選びます。 単純側への寄りはある。それが5%検定より弱い( が小さいうちは 相当)だけです。
② 検定は入れ子の2モデルしか比べられない、AIC は制限がない。
尤度比検定は という入れ子関係を要求します。 の帰無分布が になる根拠がそこにあるからです。3つ以上のモデルを一度に順位づけることもできません(やれば多重比較になります)。
AIC は差を取るだけなので、入れ子でないモデルも比べられ、いくつでも順位づけられます。 「対数正規分布とガンマ分布のどちらが当てはまるか」のような比較は検定ではやりにくく、AIC なら普通にできます。ただし条件が1つあります。同じ観測値 に対して、同じ測度の上の密度で尤度を計算すること。 の正規密度と のガンマ密度を比べると、変数変換のヤコビアンのぶんだけずれて無意味な比較になります。前に見た256通りの部分集合の順位づけも、検定ではできません。
③ 答えている質問が違う。
| 尤度比検定 | AIC | |
|---|---|---|
| 質問 | この差は偶然で説明できるか | 新しいデータをどれだけ外すか |
| 基準の由来 | 第1種の誤りを に抑える | 予測誤差の(漸近的に)不偏な推定 |
| 出力 | 棄却する/できない(2値) | 各モデルのスコア(順位と差の大きさ) |
| モデルの扱い | を特別扱い | 対等 |
| 比較対象 | 入れ子の2つ | 制限なし・何個でも |
| を増やすと | 値が 0 に張り付き情報量が消える | 差の大きさ(AIC)を返し続ける |
最後の行は、書き直した行です。最初は「検定は を増やせばどんなに小さな効果でも有意になるが、AIC の判定基準は変わらない」と書きました。間違いです。 上の式のとおり統計量は同じ で、 なら は に比例して増えます。棄却限界 は に依らない固定値なので、AIC も を大きくすればどんなに小さい効果でも必ず採用します。
実際、この記事の効率性の実験で という極小の係数を、AIC は で平均 10.00 本、つまり毎回採用していました。自分が載せた表が、自分の主張を否定していました。
正しい差はこうです。 を増やすと検定の 値は 0 に張り付いて、有意かどうかという出力から情報が消えます。AIC は「予測がどれだけ改善するか」を AIC という量で返し続けるので、「効果はあるが は 3 しかない」という判断ができます。 採用するかどうかの境目が動かない点は同じで、違うのは出力が2値かスコアかです。
そして共通の限界も明確です。どちらも、候補に無いモデルは選べません。 AIC は「与えられた候補の中でいちばんマシなもの」を返すだけで、全部が的外れでも何も教えてくれません。AIC が小さいことは、そのモデルが正しいことの証明ではありません。
実務での使いどころ
道具は揃いました。では実際にデータを前にしたとき、何をどう使うのか。ここも測って決めます。
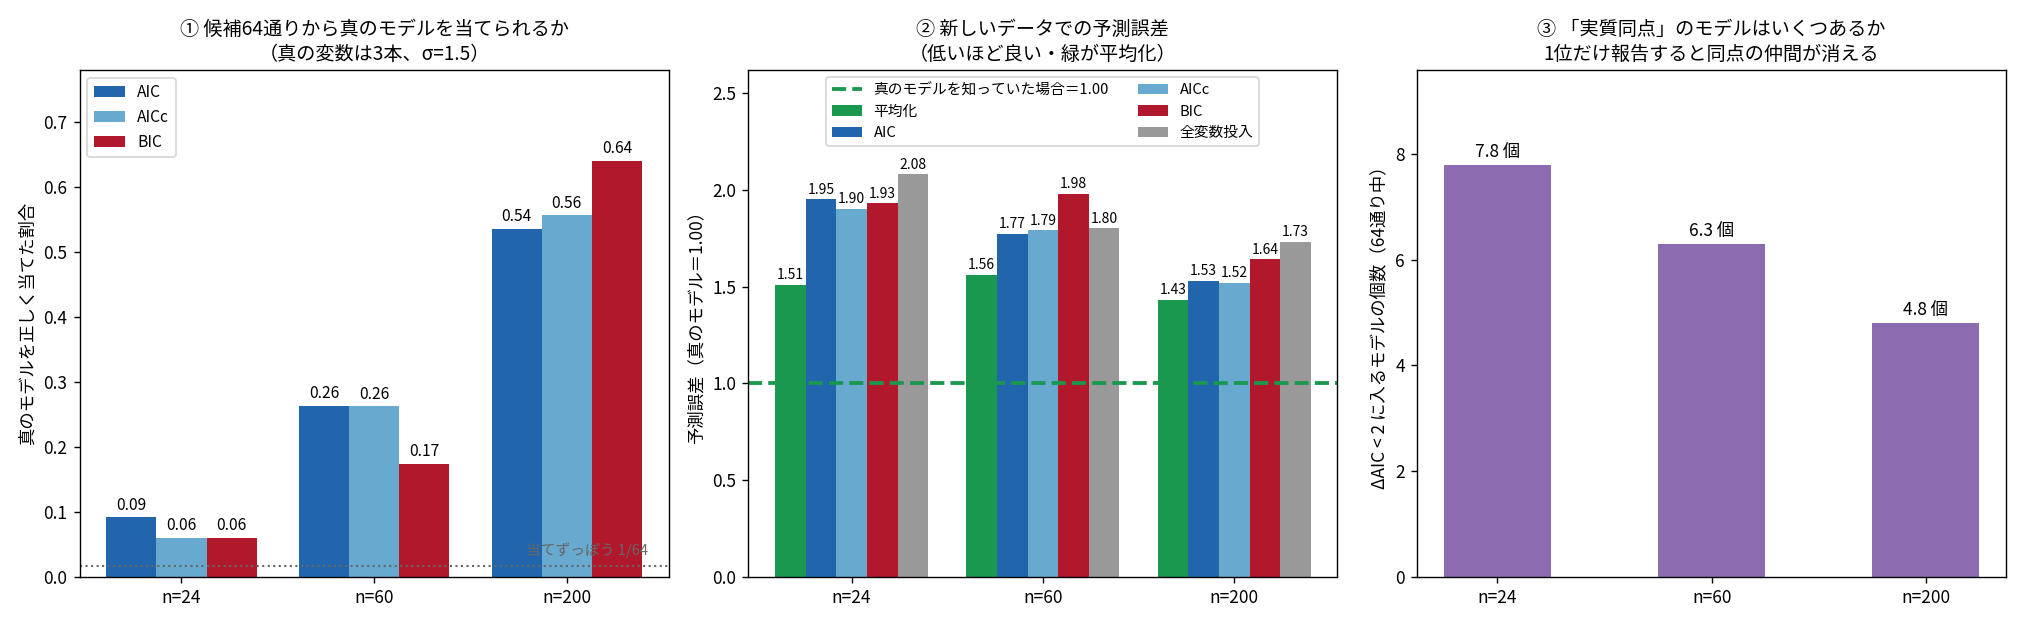
真の係数を 、、候補6本の全64部分集合という設定で、 を 24 / 60 / 200 と変えました。比較対象には「真のモデルを知っていた場合」(達成可能な下限)と、「何も選ばず全部入れた場合」「切片だけの場合」(何もしない場合)を入れます。
まず、小さいデータでは選べない
| AIC 的中 | AICc 的中 | BIC 的中 | 当てずっぽう | |
|---|---|---|---|---|
| 24 | 0.091 | 0.060 | 0.059 | 1/64 = 0.016 |
| 60 | 0.263 | 0.262 | 0.174 | 0.016 |
| 200 | 0.535 | 0.556 | 0.640 | 0.016 |
での的中率は 6〜9%。当てずっぽう(1.6%)よりは高いですが、10回に9回は外します。 この規模のデータで「AIC でこのモデルを選びました」と言っても、それは実質的に何も選んでいません。
予測誤差で見ると、もっとはっきりします。
| 真のモデル | AIC | BIC | 全変数投入 | 切片のみ | |
|---|---|---|---|---|---|
| 24 | 1.00 | 1.95 | 1.93 | 2.08 | 2.29 |
| 60 | 1.00 | 1.77 | 1.98 | 1.80 | 5.96 |
| 200 | 1.00 | 1.53 | 1.64 | 1.73 | 20.59 |
で、AIC で選んだモデル(1.95)は、何も考えず全変数を突っ込んだモデル(2.08)より 6% しか良くありません。 選ぶ苦労の見返りがこれです。 では BIC(1.98)が全変数投入(1.80)に負けています。
AIC が全変数投入をどれだけ上回るかを並べると、 で 6.3%、 で 1.7%、 で 11.6% です。ここで「 が増えるほど選ぶ価値が出る」と書きたくなったのですが、3点のうち真ん中でいちばん小さくなっているので、そう言えません。 表から言えるのは「小標本では選択の見返りが小さい」までです。 でも AIC は全変数投入に勝っているので、「小さいデータでは全部入れたほうが安全」とも言えません。
もう一つ。どの でも「真のモデルを知っていた場合」の 1.5〜2.1 倍の誤差が残っています。 候補の中に正解が入っていて、64通り全部を調べても、真のモデルの2倍の誤差です。「どのモデルか分からない」というだけで、これだけのコストがかかる。 これは選び方が悪いのではなく、選ぶという行為の値段です。あとで出てくる平均化(1.43〜1.56)でも、この値段は 1.4 倍ぶんは残ります。
は「区別できない」
同点がどれだけ出るかも測りました。AIC 最小のモデルから に入るモデルの個数です。
| のモデル数(64通り中) | |
|---|---|
| 24 | 7.8 |
| 60 | 6.3 |
| 200 | 4.8 |
では平均 7.8 個が同点です。「AIC 最小のモデル」は、8個の候補の中から偶然1位になったものにすぎません。
なぜ境目が 2 なのか。慣行の由来は、次に出てくる赤池ウェイトの比です。 は 、つまり相対的な重みが約 0.37 以上あるなら(証拠比が 2.7 倍以内なら)区別しないという線引きです。
そのうえで、覚えやすい読み方もできます。パラメータ1個の罰則がちょうど 2 なので、 は「当てはまりがまったく同じで、パラメータが1個違う」場合の差です。それより小さい差は、パラメータ1個ぶんの重みにも届いていない。 という数字を覚えるのではなく、罰則 の と同じ 2 だと思えば忘れません(由来は上の証拠比のほうで、こちらは結果的に整合する解釈です)。
選ばない選択肢:赤池ウェイト
「同点が8個ある」なら、1個選ぶのをやめて全部使えばよい。赤池ウェイトです。
の は、 の を打ち消して尤度のスケールに戻す操作です。 は「このモデルが最良である相対的な重み」として読めます。予測は と重みつき平均にします。
結果です。予測誤差は上の表と同じ基準(真のモデルを知っていた場合を 1.00)で測っています。
| 平均化 | AIC で1個選ぶ | 差 | |
|---|---|---|---|
| 24 | 1.51 | 1.95 | 23% 改善 |
| 60 | 1.56 | 1.77 | 12% 改善 |
| 200 | 1.43 | 1.53 | 6.7% 改善 |
3つの すべてで、平均化が「1個選ぶ」に勝ちました。 しかも が小さいほど差が大きい。同点が多いときこそ、1個に絞るのが損だということです。
これで軸が完成します。「データを見て 0 か 1 で選ぶ」という操作がコストの発生源でした。この節の平均化は、その操作をやめた3番目の例です。
| 手法 | 0/1 で選ぶか | 結果 |
|---|---|---|
| ステップワイズ | 選んで、そのまま報告する | 勝者の呪いが最大(真 0.25 の変数で 2.05 倍) |
| ラッソ | 選ぶが、全員を縮める | 呪いが打ち消される(同じ変数で 0.84 倍) |
| 赤池ウェイト平均化 | 選ばない | 予測誤差が改善(6.7〜23%) |
目的で道具が決まる
以上を踏まえた使い分けです。
| 目的 | 使う道具 | 注意 |
|---|---|---|
| 予測したい | AIC、または交差検証 | 選んだ変数リストを「発見」として語らない。 が小さいときは AICc も併記する(効き方は小さい。予測誤差の比は で AIC 1.95・AICc 1.90、 では 1.77・1.79 と逆転する。的中率では で AICc 0.060 < AIC 0.091) |
| 構造を同定したい | BIC | 予測は AIC より劣る。真のモデルが候補にある前提 |
| 効いている変数を列挙したい | どれも向かない | ステップワイズもラッソも失敗する。事前知識と実験で決める |
| 係数や 値を報告したい | 選択に使っていない別データで推定する | 同じデータで選択と推論はできない |
最後に、実際に手を動かすときのチェックリストにします。
- 目的を先に決める。 予測か説明か。ここが決まらないと AIC と BIC のどちらを見るかも決まらない。
- AIC と BIC の両方を出す。 一致すれば安心。割れたら、割れたこと自体が「小さい効果の変数がある」という情報。
- を確認する。 40 を下回るなら AICc も計算して差を見る(実際に効いてくるのは 10 を切る辺りから)。
- のモデルを数える。 何個も同点なら「1つ選んだ」と言わない。
- 予測が目的なら、赤池ウェイトで平均化を検討する。 1個選ぶより良くなることが多い。
- 選んだ変数を報告するなら、ブートストラップでの選択率を併記する。 13% しか選ばれない変数を「発見」と呼ばないために。
- 値や信頼区間を出すなら、選択に使ったデータとは別のデータで出す。
そして、この道具立てでできないことをはっきり書いておきます。
- 候補に無いモデルは選べない。 全部が的外れでも AIC は何も警告しません。良い候補を作るのは統計ではなく、対象についての知識の仕事です。
- AIC が小さいことは正しさの証明ではない。 「相対的にマシ」しか言っていません。残差の診断(第17回)は別途必要です。
- 因果関係は出ません。 予測が良いモデルと、介入の効果を表すモデルは別物です。
- 選択と推論を同じデータで両方やることはできない。 これが最も重要な制約だと思います。
自分が間違えていたこと
1. の を の と結びつけていた
「 に を足す。どちらも 2 だから、同じ 2 なのだろう」と漠然と思っていました。無関係です。 の は「尤度比が になるための係数」、 の は「」です。この2つを切り離した瞬間に、AIC の全体像が見えました。 今回いちばん大きい収穫です。
2. AIC を「最適なパラメータ数を求める指標」だと思っていた
を横軸にした U 字の図で AIC を覚えていたので、そういう理解になっていました。AIC はモデルを順位づけます。同じ の56通りで AIC の幅が 120.6 もあるのを見て、ようやく直りました。罰則が同じなら、あとは当てはまりの勝負です。
3. 自由度調整済み なら選択バイアスに強いと思っていた
第16回で「調整済み は無意味な変数で下がる」と学んだので、これで守られていると思っていました。ノイズだけのデータでステップワイズを回すと 0.145 が出ます。 調整済み が罰しているのは「使った変数の本数」だけで、「候補30本の中から選んだ」ことは罰していません。
4. 「AIC は甘い」を無条件の性質だと思っていた
で という話だけを覚えていました。 を増やすと対応する は下がり続け、 で 0.042 と 5% を下回ります(厳密な交差点は )。そこから先は AIC のほうが厳しい。「甘い/厳しい」は に依存します。 なお「 が逆転点」と最初は書きました。 は 0.0512 でまだ 5% より甘く、逆転する最初の整数は 8 です。境目を整数で丸めると向きを間違えます。
5. リッジ回帰も変数選択に使えると思っていた
「正則化で不要な変数が落ちる」と一括りにしていました。リッジはゼロにしません。ゼロを作るのは絶対値の折れだけです。第19回で の菱形の角を見ていたのに、変数選択と結びつけていませんでした。
6. 多重比較の補正がステップワイズを救うと思っていた
ボンフェローニで罪1は直ります(0.750 → 0.047)。そして罪2が悪化します( の誇張 2.09 → 2.84 倍)。しかも検出力が壊滅します(0.223 → 0.019)。門を狭くすると、通り抜けた推定値はますます過大になる。罪1と罪2は同じつまみの両端です。
7. ステップワイズの罪を「推論だけの問題」に切り分けようとした
最初は「5つの罪のうち4つは選択後推論の問題で、予測に使うだけなら害にならない」と書きました。これも間違いです。 膨らんだ係数(罪2)はそのまま予測式に入りますし、選択の不安定さ(罪4)は予測のバリアンスです。実際、赤池ウェイトで平均化すると予測誤差が 6.7〜23% 改善します。1個選ぶことに値段があるなら、選び方の欠点が予測に効いていない、ということはありえません。正しくは「罪1と罪3が選択後推論だけの問題、罪2と罪4は予測にも効く、罪5は探索の限界」の3分類でした。
8. 交差検証は AIC より「実測だから信頼できる」と思っていた
-fold は分け方の乱数で答えが変わります。同じデータで 5-fold を200通りの分割にかけたら17種類のモデルが選ばれ、最頻でも 21% でした。AIC と LOO は決定的です。そして線形回帰なら PRESS があるので、LOO を当てはめ1回で計算できます。実測のほうが偉いわけではありません。
9. 「多重共線性があると係数が不安定」の意味を狭く捉えていた
VIF の話として、係数の標準誤差が膨らむことだと理解していました。選ばれる変数まで入れ替わります。 真の係数が最大(0.50)の が 13% しか選ばれず、0.40 の が 84% 選ばれる。しかもこれを「たまたま先に入った変数が勝つ」と書きかけました。偶然ではなく、周辺相関の順序(0.514 対 0.537)が真の係数の順序と入れ替わっているだけでした。再現性のある構造的な失敗を「偶然」で片づけるところでした。
10. AIC と検定を「別の世界の道具」として分けていた
情報量規準と仮説検定は別の章の話だと思っていました。式を並べると、統計量も帰無分布も同じで、棄却限界の位置だけが違いました。AIC は棄却限界を にした尤度比検定です。 そのうえで、対称性・入れ子の要否・答えている質問が違うので、同じものではありません。
11. モデル選択の「同点」を軽く見ていた
「AIC 最小のモデル」を一意の答えだと思っていました。 では平均 7.8 個が に入ります。そして1個選ぶより赤池ウェイトで平均化したほうが予測は良い(23% 改善)。選ばないという選択肢があることを知りませんでした。
12. 検証で使った指標そのものが不適切だった
ステップワイズとラッソの安定性を「ブートストラップで選ばれたモデルの種類数」で比べようとしました。ステップワイズ 64 種類、ラッソ 179 種類なので「ラッソのほうが不安定」と書きかけました。間違いです。 平均モデルサイズが 1.92 対 5.87 なので、そもそも取りうる組み合わせの数が違います。種類数は主にサイズの関数で、安定性の指標になりません。変数ごとの選択率で比べるのが正しいと気づいて書き直しました。
13. 呪いの強さを「門の狭さ」だけで説明しようとした
ボンフェローニで門を狭くすると誇張が増える(2.09 → 2.84)のを見て、「門が狭いほど呪いが強い」という1本の軸で説明できたつもりになりました。自分が載せた表がそれを否定していました。 リラックス・ラッソとラッソは同じ門・同じ変数集合なのに、誇張倍率が 1.52 と 0.84 です。門は効いていません。効いているのは縮小するかどうかでした。1つの軸にまとめたい欲が出たときは、自分の表の中に反例がないか探すべきでした。
14. 「 を増やすと検定は有意になるが AIC の判定は変わらない」と書いた
検定の が固定で に依らないのと同じ調子で、AIC についてもそう書きました。逆です。 棄却限界 は に依らない固定値で、真の係数がゼロでなければ尤度比 は に比例して増えます。だから を増やせば AIC も必ずその変数を採用します。これも自分が載せた効率性の表( で AIC が平均 10.00 本すべて採用、)が否定していました。 変わらないのは「限界の位置」で、判定そのものは変わります。
15. 「貪欲だから最良を外す」を、2つのものを同時に変えた実験で示そうとした
ステップワイズの答えと総当たりの AIC 最小モデルの一致が 0.365 しかないのを見て、「貪欲な探索の限界だ」と結論しました。この比較では探索の仕方と入り口の基準が同時に変わっています。 前者は ()、後者は AIC( 相当)で、別の門を通しています。貪欲な前向き選択のまま入り口だけ AIC に揃えると、一致は 0.950、AIC の超過は平均 0.020 でした。貪欲さ自体のコストはほぼゼロで、0.365 が測っていたのは門の違いでした。比較したい要因だけを動かす、という当たり前のことができていませんでした。
要点まとめ
AIC の
- 、。差が 。 は の で、 の とは無関係。
- バイアス項は両辺に同じだけ乗るので差では消える。だから 補正は平均構造が間違っていても機能する( まで誤っている一般の場合は TIC の が必要)。
- バリアンスはパラメータ1個あたり 。 から出る。
- AIC はモデルを順位づける道具で、パラメータ数の最適値を求める道具ではない。絶対値は無意味、差だけが意味を持つ。
- なら AICc も計算して差を見る(40 は安全側の慣行で、実際に効いてくるのは 10 を切る辺りから)。 は を固定した回帰版。
AIC と BIC
- AIC 、BIC 。(厳密には )で BIC が厳しい。
- BIC は一貫( で真のモデルの的中率 → 1)、AIC は非一貫(0.42 で止まる)。止まる高さは ( は偽の候補の本数)で、偽が5本なら 。候補の作り方で決まる値で、普遍定数ではない。
- AIC は効率的(予測誤差を最小化)、BIC は非効率。係数がゼロで切れず尾を引く設定では、BIC の予測誤差が AIC の 1.67 倍になった。
- 両立しない。予測なら AIC、構造の同定なら BIC。 変化点の個数では BIC が正解(2個)、AIC は 10 個。
交差検証
- が LOO と厳密に一致(誤差 )。当てはめ1回で済む。
- AIC と LOO は同じ から出ている。 AIC は (対角の和)、LOO は (対角成分)。偶然似ているのではない。
- -fold は分け方の乱数で答えが変わる(5-fold で17種類)。AIC と LOO は決定的。
ステップワイズ法
- 5つの罪:①ノイズから発見が出る(調整済み でも 0.145)②係数が過大(真 0.25 が 0.513)③ 値・信頼区間が壊れる ④データが少し変わると激変(ブートストラップで65種類)⑤貪欲探索で最良を見逃す(ただし探索の仕方だけを変えて測ると一致 95%・AIC 超過 0.02 で、実害はほぼない。総当たりとの一致が 36.5% しかないのは、貪欲さのせいではなく入り口が で AIC と別の門だから)。
- 性質は3種類。①③は選択後推論だけの問題(予測には無害)、②④は予測にも効く(膨らんだ係数はそのまま予測式に入り、選択の不安定さはバリアンス)、⑤は探索の限界。
- 勝者の呪いは「門の狭さ」と「縮小の有無」の2軸。 門を狭くすると①は直るが②は悪化する(ボンフェローニで 0.750→0.047、誇張は 2.09→2.84倍、検出力は 0.223→0.019)。いっぽう同じ門でも縮小すれば誇張は 1.52→0.84 に落ちる。
- 多重共線性のもとで返るのは「効いている変数」でなく「周辺相関がいちばん大きい変数」(真 0.50 の が選択率 13%、真 0.40 の が 84%。周辺相関は 0.514 対 0.537 で逆転している)。
正則化とモデル平均化
- ゼロを作るのは絶対値の折れ。 ラッソ()は変数選択に使えるが、リッジ()は使えない。
- ステップワイズとラッソは逆向きに失敗する。ステップワイズは本物を落とし( を 0.11)、ラッソは偽物を混ぜる(0.28〜0.54)。交差検証の は予測用で、変数選択用ではない。
- ラッソの誇張倍率は真の係数がゼロでない行では 0.71〜0.84 で 1 を下回る(過小報告なので安全側)。縮小が呪いを打ち消している。ただし真の の行では話が別で、そこは「正しい大きさ」が存在しないので倍率を安全性の指標として読めない。
- 赤池ウェイト による平均化は、1個選ぶより予測が良い(6.7〜23% 改善)。
AIC と検定
- AIC は棄却限界を にした尤度比検定。 統計量も帰無分布も同じ。
- 対応する : で 0.157、 で 0.0512、 で 0.0424(ここで 5% を下回る。厳密な交差点は )、 で 0.005。「AIC は甘い」は が小さいときだけ。
- BIC は が とともに縮む検定( で 0.0002)。これが一貫性の正体。
- 3つの本質的な違い:①検定は を特別扱い/AIC は対等 ②検定は入れ子の2つだけ/AIC は制限なし ③「偶然か」/「新データを外すか」。
- 共通の限界:候補に無いモデルは選べない。選択と推論を同じデータで両方やることはできない。
実務
- 小さいデータでは選べない。 ・候補64通りで的中率 6〜9%、AIC で選んだモデルは全変数投入より 6% しか良くない。
- は区別できない(由来は赤池ウェイトの比 。「パラメータ1個の罰則そのもの」は結果的に整合する覚え方)。 では平均 7.8 個が同点。
- どの でも「真のモデルを知っていた場合」の 1.5〜2.1 倍の誤差が残る。平均化しても 1.4 倍ぶんは残る。選ぶという行為そのものに値段がある。
次回
第30章はここまでです。次は第31章「ベイズ法」に進みます。
今回、BIC の由来としてモデルの周辺尤度 が出てきました。あれは何を計算していたのか、なぜラプラス近似で が出るのか。BIC の背景がベイズなので、次回はその土台を作ることになります。
そして今回の「 のモデルを重みつきで平均する」という発想も、ベイズの考え方に非常に近いです。1つのモデルに決めず、確率で重みをつけて全部使う。 赤池ウェイトとベイズのモデル平均化がどうつながるのかは、次回の後半で扱えると思います。
過去の回は統計検定準1級の学習記録・目次にまとめています。