最尤法とフィッシャー情報量:精度がルートでしか改善しない【第10回】
はじめに
第8章から推測統計編に入ります。ここまでの確率の土台編(第2〜9回)は「分布が与えられたときに何が言えるか」という向きの話でした。今回からは逆向き、手元のデータから、背後にある分布のパラメータを当てるという話になります。
順番としては、確率の土台編の最後(第9回・積率母関数)から素直に続く章です。ただし今回の学習は、これまでとは違う詰まり方をしました。
計算ができないのではなく、計算した数字が何なのか分からなかったのです。
最尤法の手順は3行で書けます。実際、対数を取って微分して 0 と置く、というだけの作業です。フィッシャー情報量も、2回微分して符号を反転するだけでした。手は動くのに、出てきた という数字が何なのかが分からない。 これが分からないまま先に進むと、区間推定でも検定でも同じ場所で止まると思ったので、今回は「何に使うのか」に時間をかけました。
結論を先に書くと、こうつながっていました。
フィッシャー情報量は、統計ソフトが出力する「Std. Error」の出どころそのものでした。そして同時に、なぜ精度が でしか改善しないのかという以前からの疑問にも答えが出ました。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 記号( と 、 と など)で迷ったら 統計の記号がややこしいのは軸が2本あるからだった を先に読んでください。今回はこの記事の内容を前提にします。
TL;DR
- 不偏性と一致性は独立な性質。「中心が当たるか」と「 で幅が縮むか」は別の話で、4通りすべて実例がある
- 最尤法は「観測されたデータをいちばん出やすくする を選ぶ」。手順は を取る → を含まない項を捨てる → 微分して 0 の3段だけ
- 正規分布を仮定した最尤法=最小二乗法、ラプラス分布を仮定した最尤法=中央値。頑健推定は「別の分布を仮定した最尤法」として導ける
- 正規分布の分散の最尤推定量は で割る版で、不偏ではない。原因は を で置き換えたところ。 で割ることが悪いのではない
- フィッシャー情報量は「対数尤度の山の尖り具合」。尖っているほど を特定しやすい。 と足し算で積み上がる
- が に比例し、分散がその逆数、標準誤差がさらに平方根。この2段があるから精度は でしか改善しない
- 標準偏差(SD)は世界のばらつき、標準誤差(SE)は自分の知識の不確かさ。 を増やして縮むのは後者だけ
推定量は「関数」であって、数値ではない
最初に足場を作ります。推定量(estimator)と推定値(estimate)は別物です。
| 中身 | 例 | |
|---|---|---|
| 推定量 | データを入れると数値を返す関数。確率変数 | |
| 推定値 | 実際のデータを入れて出てきた数値 |
番外編で整理した「大文字 と小文字 」の軸がそのまま効きます。推定量は確率変数なので分布を持ちます。 この分布のことを標本分布と呼びます。
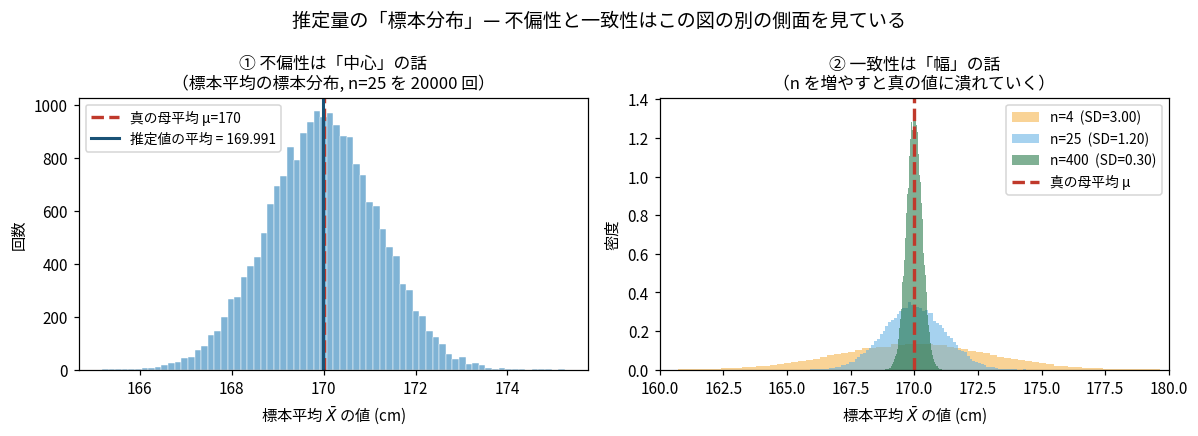
この標本分布という考え方が、この章のすべての土台になります。推定量の良さを議論するというのは、この分布の形を議論することです。
不偏性と一致性は独立な性質だった
推定量の良さを測る性質が2つ出てきます。自分は当初これを「同じことを別の言い方で言っている」と誤解していました。違います。独立です。
不偏性は「標本分布の中心が真の値に乗っているか」。 が小さくても成立し得ます。
一致性は「 を増やすと標本分布が真の値に潰れていくか」。 の話なので、有限の での位置は問いません。
見ている場所が違うので、4通りの組み合わせすべてに実例があります。
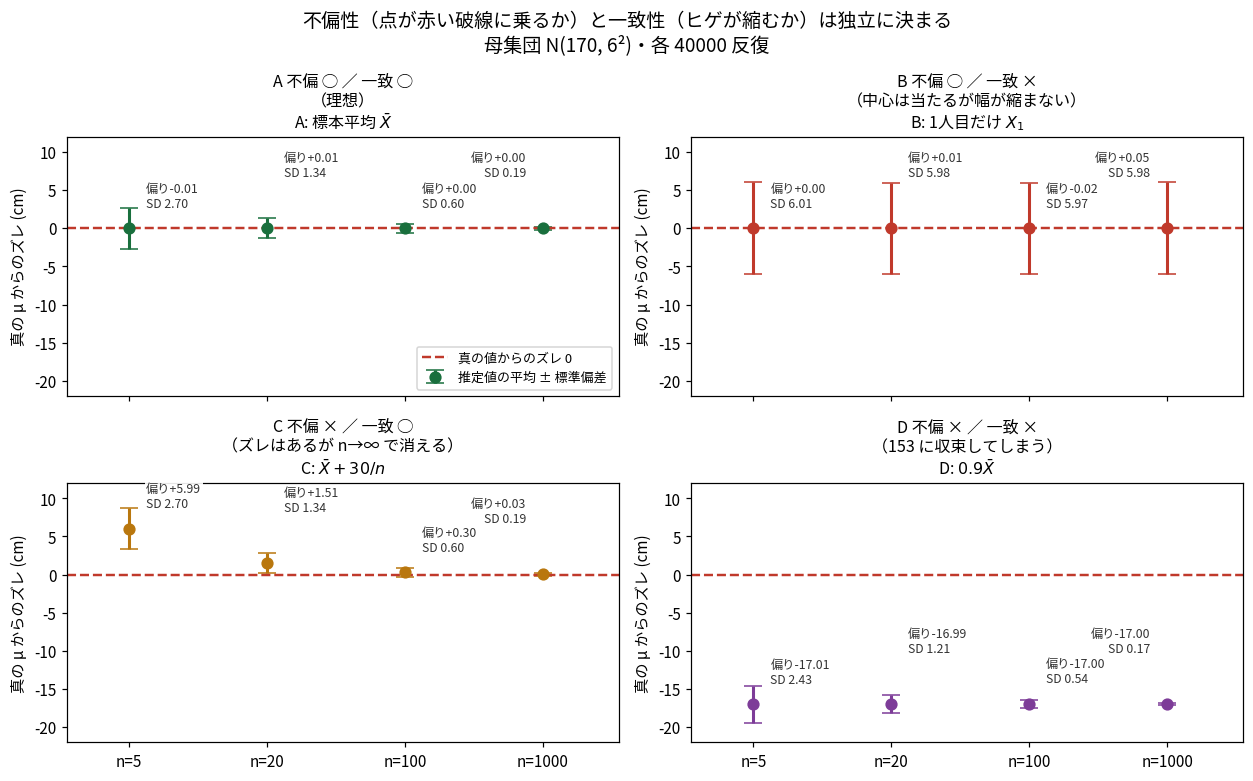
母集団を として、4つの推定量を各4万回ずつ試した結果です。
| 推定量 | の偏り | の SD | 不偏 | 一致 |
|---|---|---|---|---|
| 0.19 | ○ | ○ | ||
| (1人目だけ) | 5.98 | ○ | × | |
| 0.19 | × | ○ | ||
| 0.17 | × | × |
が面白いところです。 1人目のデータだけを使う推定量は、期待値はちゃんと 170 なので不偏です。でも何人集めても1人目しか見ないので、ばらつきは のまま縮みません。不偏だが役に立たない推定量が作れてしまう、という反例になっています。
逆に は で もズレていますが、 で なので一致します。
が「一致 ×」なのは分かりにくいところです。SD は 0.17 といちばん小さいのに、縮んでいく先が で真の値ではないからです。一致性は「幅が縮むか」だけでなく「縮んで寄っていく先が か」まで含みます。
ここでの学び:不偏性だけを追いかけると のような無意味な推定量を排除できません。実務では両方(あるいは後で出てくる MSE のような総合指標)で見る必要があります。
なお一致性の記号 は確率収束です。第8回の大数の法則がまさに「 は に確率収束する」という主張だったので、大数の法則は「標本平均が一致推定量である」ことの宣言だったと読み替えられます。
で割る話は、不偏性そのものだった
第3回で「なぜ で割るのか」を扱いました。あのときは「自由度が1つ減るから」という説明で納得していましたが、あれは不偏性の話だったとここで分かります。
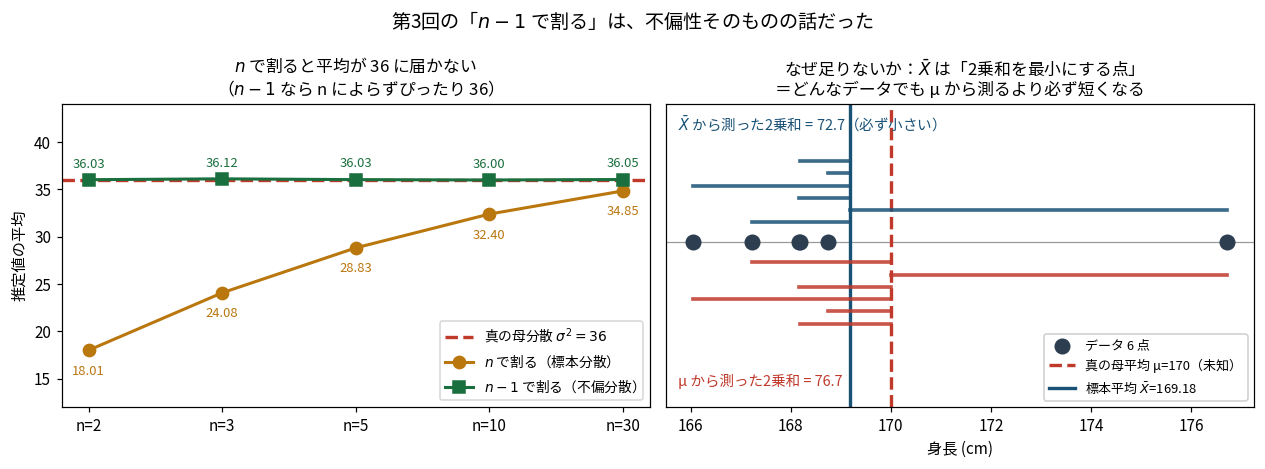
母分散 、 で40万回試した結果です。
| 割り数 | 期待値(実測) | 理論値 |
|---|---|---|
| で割る | 28.82 | |
| で割る | 36.03 | 36 |
| 真の を使い で割る | 36.00 | 36 |
3行目が重要です。 割る数は のままなのに、 ではなく真の を使うと期待値が 36 に戻っています。つまり、 で割ることが悪いのではなく、 を使ったことが原因です。この点は後で最尤法のところに再登場します。
、、 は3つとも別物
ここは自分がいちばん混ざっていたところなので、図で整理しました。「分散」と呼ばれるものが3つあります。
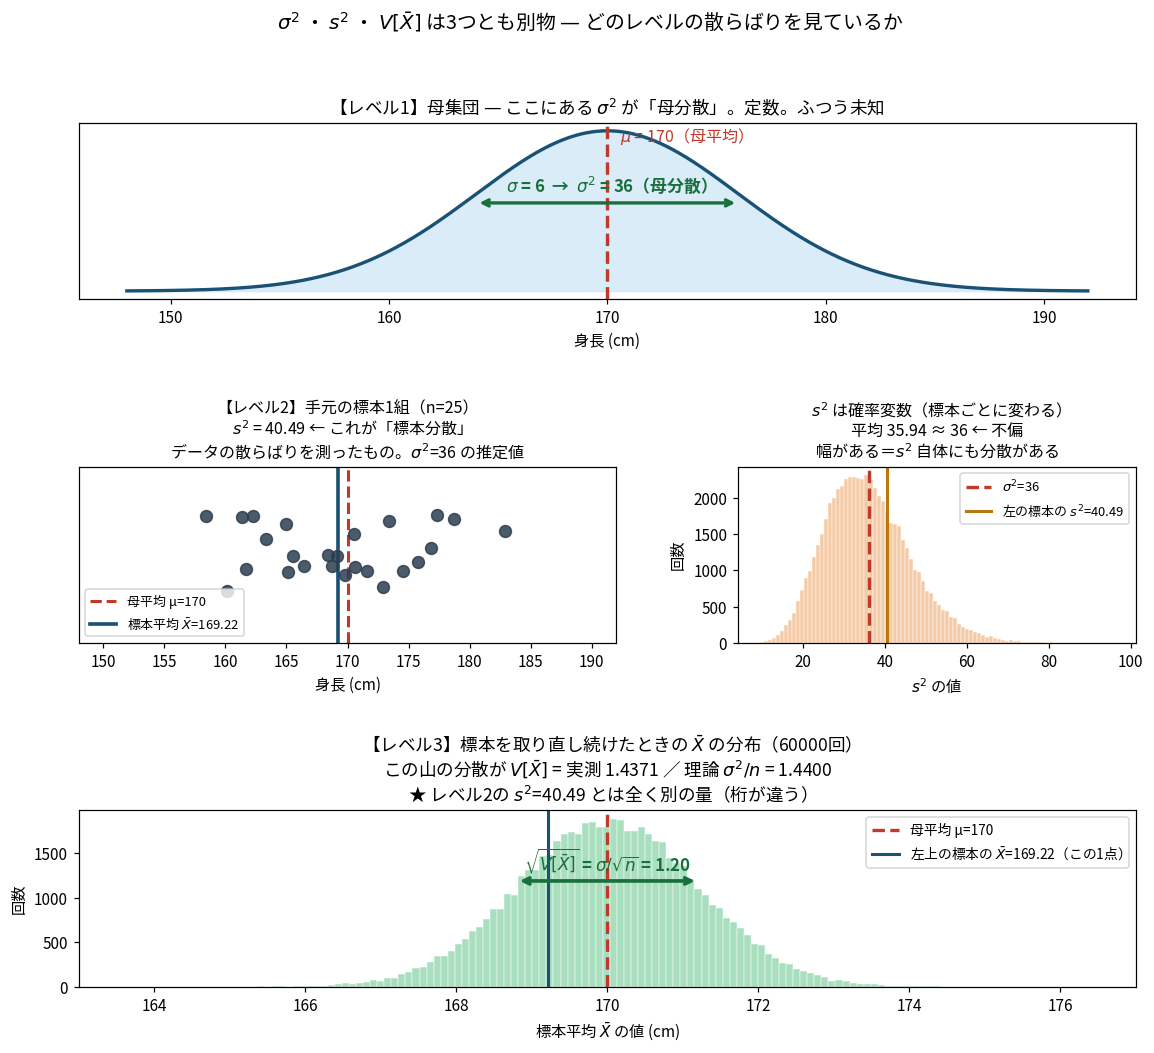
| 記号 | 名前 | 何のばらつきか | 性質 |
|---|---|---|---|
| 母分散 | 母集団の個体 | 定数。ふつう未知 | |
| 標本分散 | 手元の標本の個体 | 確率変数。 の推定値 | |
| 標本平均の分散 | 標本平均という統計量 |
に対して手元の 、そして 。 と は桁が違います。 どちらも「分散」と呼ばれるので混ざりますが、測っているレベルが違うわけです。
この区別は後半の「標準偏差と標準誤差」に直結します。
最尤法:観測されたデータをいちばん出やすくする を選ぶ
ここから本題です。最尤法(maximum likelihood estimation, MLE)の考え方は、実は逆向きに考えると素直でした。
まず順向きに考えます。 (コインの表が出る確率)を仮定すると、「20回投げて7回表が出る確率」が計算できます。 なら 0.0545、 なら 0.0739、 なら 0.0010。
次に逆向きに考えます。 実際に7回表が出たのだから、その結果をいちばん出やすくする を選ぼう。これが最尤法です。
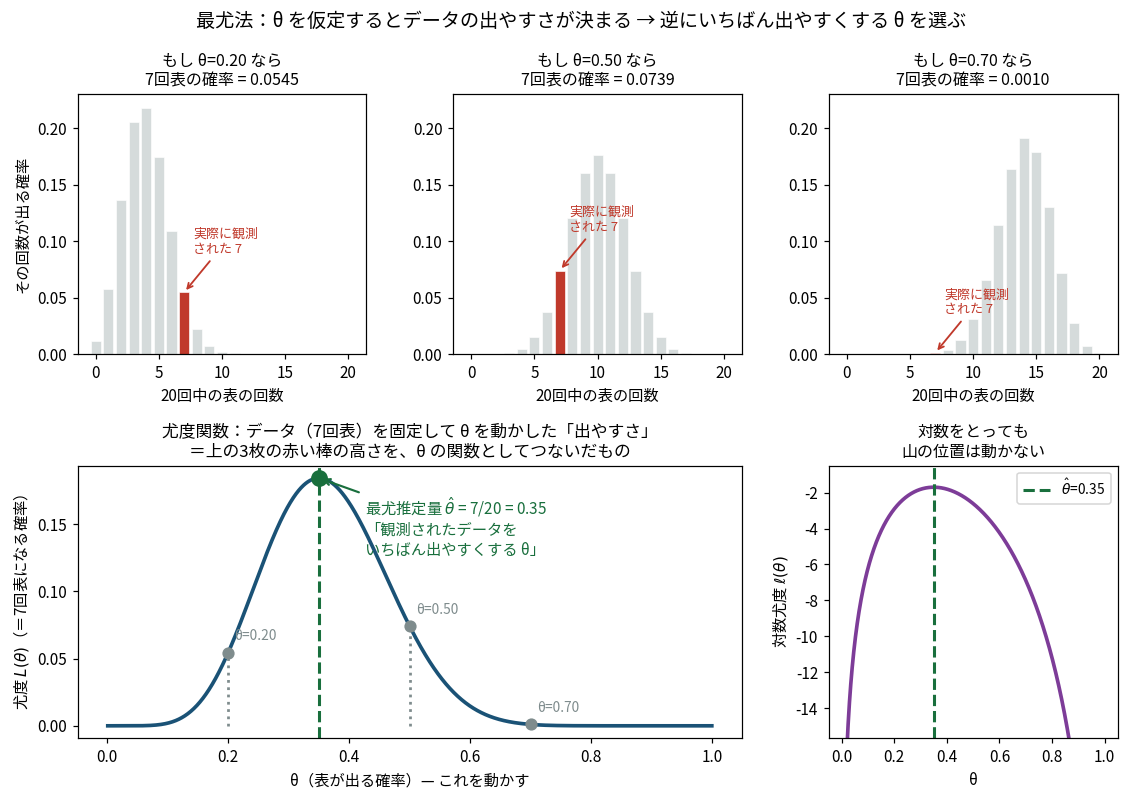
上段の赤い棒の高さを の関数としてつないだものが、下段左の尤度関数 です。最大になるのは
数え上げた比率そのものです。数値でグリッド探索しても 0.3500 が出ました。当たり前の答えですが、「当たり前の答えを、原理から導けた」というのがここでの収穫でした。
手順は3段だけ
一般の分布でも手続きは同じです。
- を書く(分布の密度・確率質量関数)
- 対数を取り、 を含まない項を捨てる
- で微分して 0 と置く
自分が詰まったのは、ほぼ1だけでした。分布の名前から式を書き下せなかったのです。この問題は番外編に切り出して整理したので、そちらを参照してください。
なぜ対数を取るのか
理由は2つあり、どちらもパラメータが何であるかに依りません。
理由①:掛け算を足し算にする。 尤度は という掛け算なので、 で和にすると微分が項別にできます。正規分布や指数分布は の形をしているので、指数が外に出てくれるのも同じ効果です。
理由②:数値計算が破綻しない。 これは実際に確かめると衝撃的でした。
| 式 | 値 | |
|---|---|---|
| 0.0(厳密に) | ||
| 0.0(厳密に) |
では完全に 0 です(潰れ始めるのは )。倍精度浮動小数点の下限(およそ 、非正規化数まで使っても )を割り込むためです。これは丸め誤差ではなくアンダーフローで、値そのものが消えるので、 を変えても尤度は 0 のまま。比較すべき差がすべて失われます。
統計ソフトが尤度そのものではなく log-likelihood しか表示しないのは、表示の都合ではなくそれ以外に計算する方法がないからでした。実データで は小さい方なので、これは理論上の話ではなく日常的な制約です。
対数は に取るのではなく、尤度全体に取る。 であって、 ではありません。 の括弧の は「これは の関数だ」という宣言で、 の対象を指してはいません。自分はここを一度誤解しました。
そして最大値の位置は動きません。
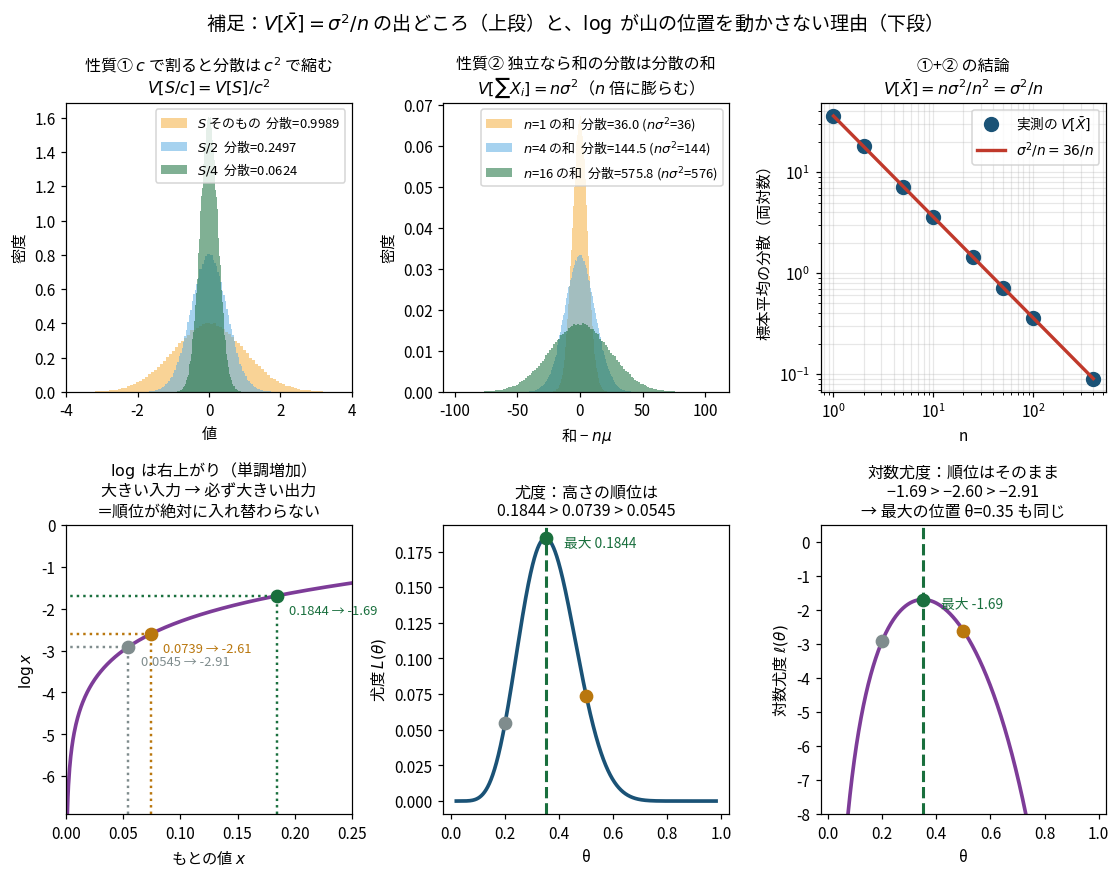
図の下段がそれです。 は単調増加なので、値そのものは変わっても( が になる)、大小関係の順位が保たれるので1位の座は動かないのです。上段はひとつ前の節で出てきた の仕組みで、後半の標準誤差の話に効いてきます。
正規分布でやってみる: が答えに残らない
が未知、 が既知の場合です。データは (、)で確かめます。
第1項に が入っていないので捨てます(手順2の実演)。微分して
この問題の狙いは答えではなく、 が答えに残っていないことです。 は正の定数倍として前に付いているだけなので、どこで最大になるかに影響しません。実際に を変えて数値で最大化すると、
| 既知の | 1 | 4 | 25 | 100 | 10000 |
|---|---|---|---|---|---|
| 170.00 | 170.00 | 170.00 | 170.00 | 170.00 |
を1万にしても は動きません。 ばらつきが分かっていようがいまいが、中心の点推定は標本平均です。ただし区間推定では が効いてきます(幅が変わる)。点推定に効かず区間推定に効く、という切り分けが大事なところでした。
もうひとつ、 を最小にするのが なので、正規分布を仮定した最尤法は最小二乗法と同じものになっています。これは次の節と対になります。
ラプラス分布でやると中央値になる
同じ最尤法で、仮定する分布だけを変えます。ラプラス分布 です。
絶対値なので、微分するには場合分けが必要です。 なら を微分して 、 なら 。これをまとめた記法が (符号関数)です。
マイナスが2つ重なって、スコア(対数尤度の1階微分)は
ここで手が止まりました。この式には が入っていないのです。 の中にはありますが、値としては しか返さないので、 の部分は整数にしかなりません。「 と置いて について解く」という操作がそもそも実行できないのです。
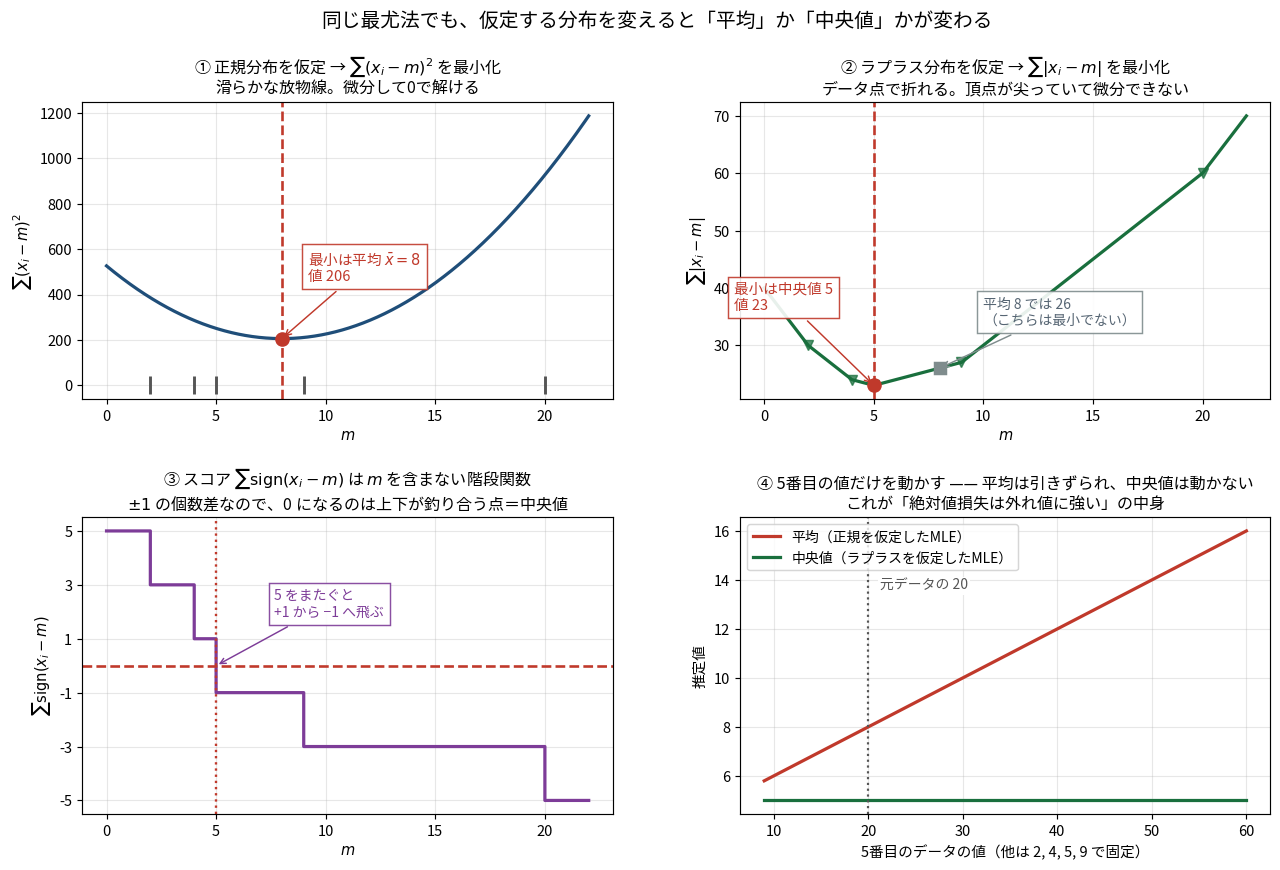
式を解くのではなく、意味を読みます。 スコアは「 より上の個数 − 下の個数」なので、0 になるのは上下が釣り合うとき=中央値です。データ で確かめると、
| 2 | 4 | 5(中央値) | 6 | 8(平均) | 9 | 20 | |
|---|---|---|---|---|---|---|---|
| 30 | 24 | 23 | 24 | 26 | 27 | 60 | |
| スコアの和 | 0 |
中央値 5 で 23、平均 8 で 26。中央値の方が小さく、これが最小です。
| 仮定する分布 | 最小化するもの | 答え |
|---|---|---|
| 正規分布 | 平均 | |
| ラプラス分布 | 中央値 |
この対応が今回いちばん面白かったところです。 20 という外れ値のせいで平均は 8 まで引っ張られていますが、中央値は 5 のまま。図の④は5番目のデータだけを 9 から 60 まで動かしたもので、平均は一直線に引きずられ、中央値は完全に水平です。
つまり頑健推定(robust estimation)は「別の分布を仮定した最尤法」として導けるわけです。回帰でいえば、正規分布を仮定したのが最小二乗法、ラプラス分布を仮定したのが最小絶対偏差(LAD)や分位点回帰。外れ値に強い手法が特別な工夫ではなく、分布の仮定の違いから自然に出てくると分かって、見通しが良くなりました。
偶数個だと答えが一意に決まりません。 データ では が 4 から 5 のどこでも で平坦です。「中央値は真ん中2つの平均」という慣習は、この区間からどれを選ぶかの取り決めに過ぎません。原因は、この区間のどこにいても上側2個・下側2個で釣り合ってしまうことです。 ではスコアが で恒等的に 0 なので、「0 になる点」が1点に定まりません。
最尤法と不偏性が衝突する
と の両方が未知の場合を解くと、最尤法が不偏でない答えを返します。
で割る版です。 第3回でやった不偏分散は で割るのに。データ では なので、
| 値 | |
|---|---|
| 最尤推定量() | 16.0 |
| 不偏分散() | 20.0 |
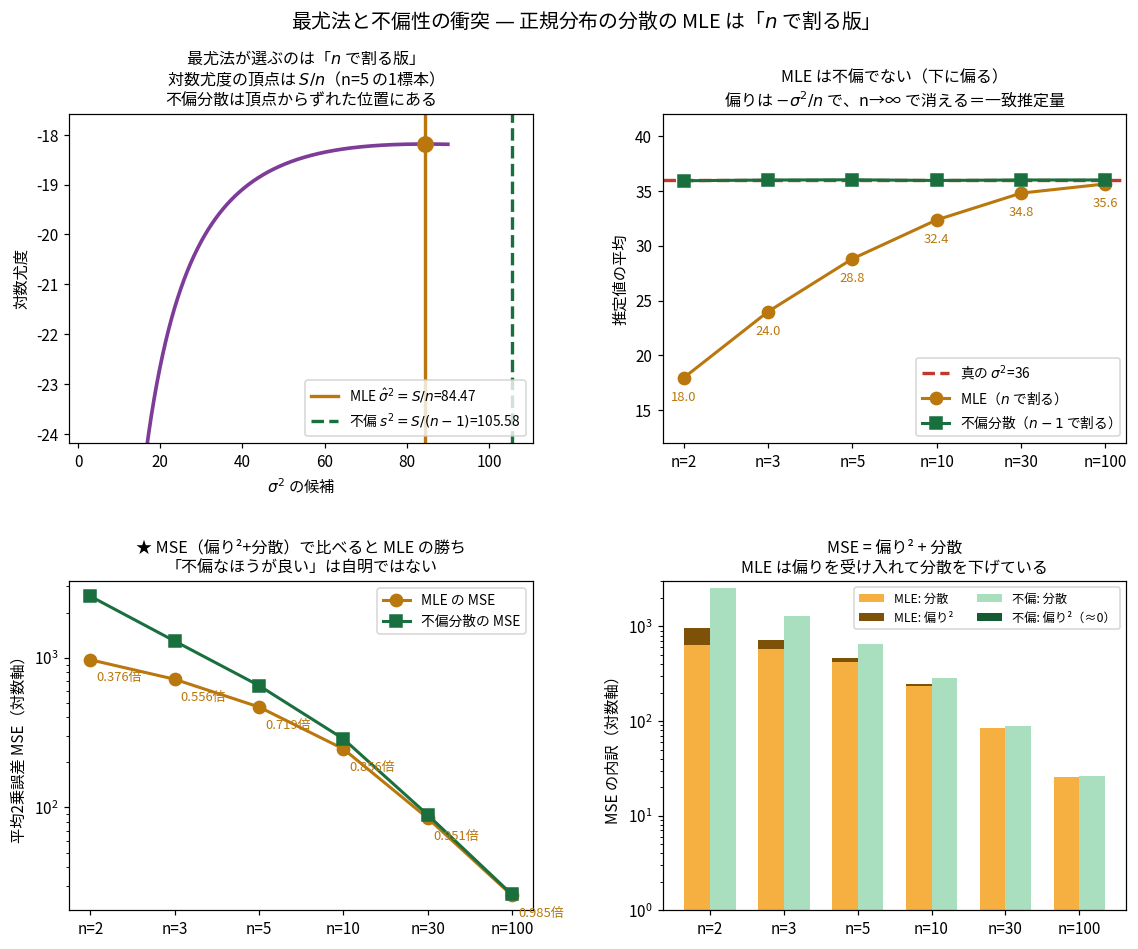
両方正しくて、目的が違います。 どのステップが 割りを生むかというと、 を で置き換えたところです。
は「そのデータの二乗和を最小にする点」なので、真の を使うより が必ず小さくなります。実際、 を 168 に固定して同じ 割りで計算すると 20.0 に増えました( を使ったときは 16.0)。 で最小になっているせいで、 で割った時点ですでに小さめの値が出ている、というわけです。前半の「真の を使えば 割りでも不偏」という結果と、同じことを別の角度から見ています。
MSE で採点すると最尤法の方が勝つ
「不偏でないなら悪い推定量なのか」という疑問には、平均二乗誤差(MSE, mean squared error)が答えを与えます。
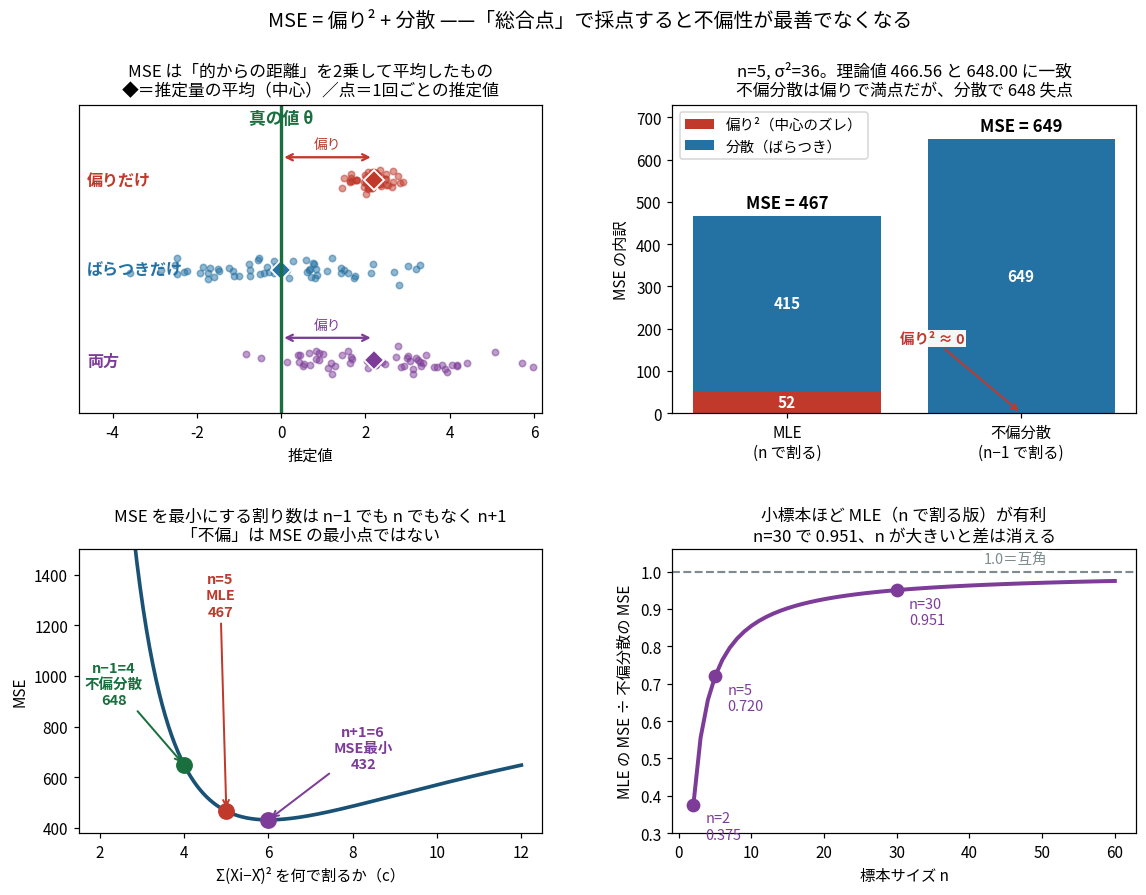
不偏性は「偏り 」しか見ていません。 MSE は偏りと分散の両方を足すので、総合点での比較になります。、 で計算すると、 割りの MSE が 466.56、 割りが 648.00。最尤推定量の方が小さいのです。
最尤法は偏りを受け入れて分散を下げている、という取引をしています。小標本では特にこれが有利になります。
そして MSE を最小にする割り数は、実は です。
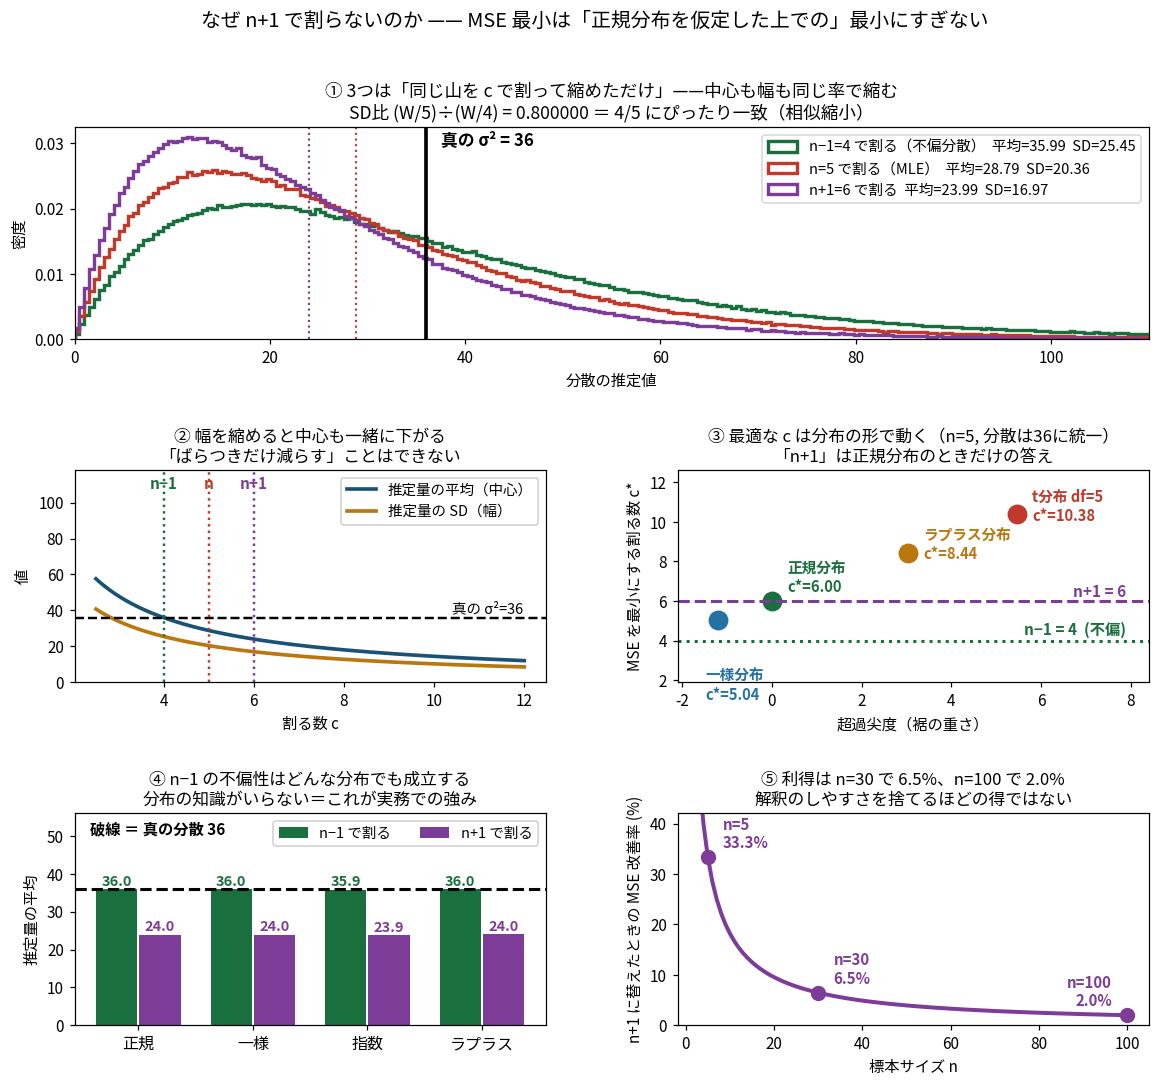
では を使えばいいのか。使いません。 理由は、 が最適なのは正規分布を仮定した上での話だからです。分布の形が変わると最適な割り数も動きます。一方で、 の不偏性は分布の形に依らず成立します。しかも利得は で 6.5%、 で 2.0% と小さい。仮定に依存しない性質を取るという判断です。
モーメント法とジャックナイフ
最尤法以外の推定法も少しだけ触れておきます。
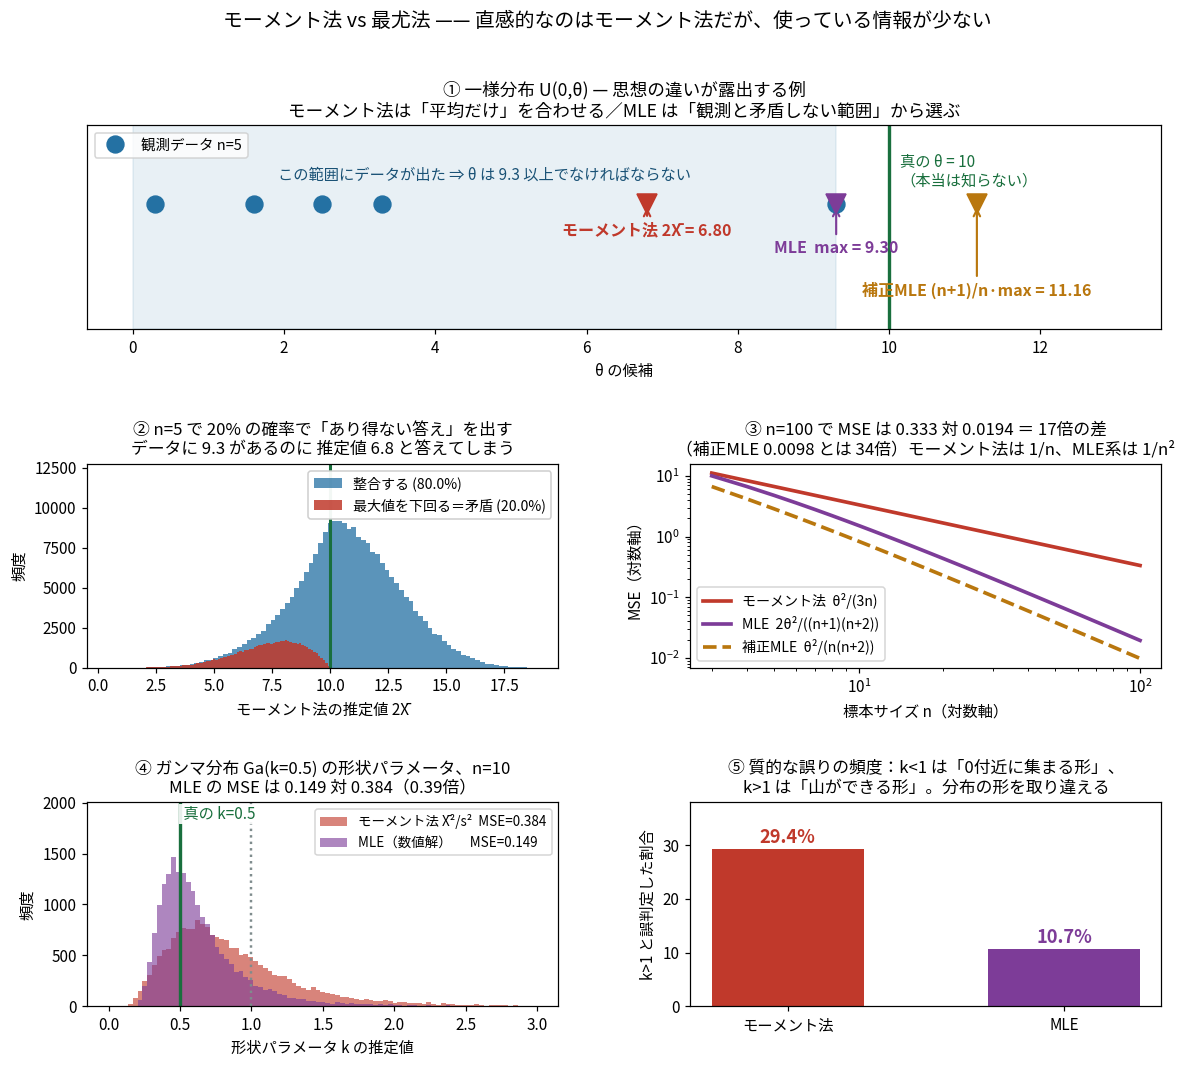
モーメント法は「理論上の平均=標本平均」と置いて解くだけなので直感的ですが、使っている情報が少ないです。 では となり、 で20%の確率で観測された最大値より小さい答えを返します。あり得ない答えです。最尤法の ならそうなりません。 での MSE は 17倍の差(さらに を掛けて偏りを補正すると 34倍)です。
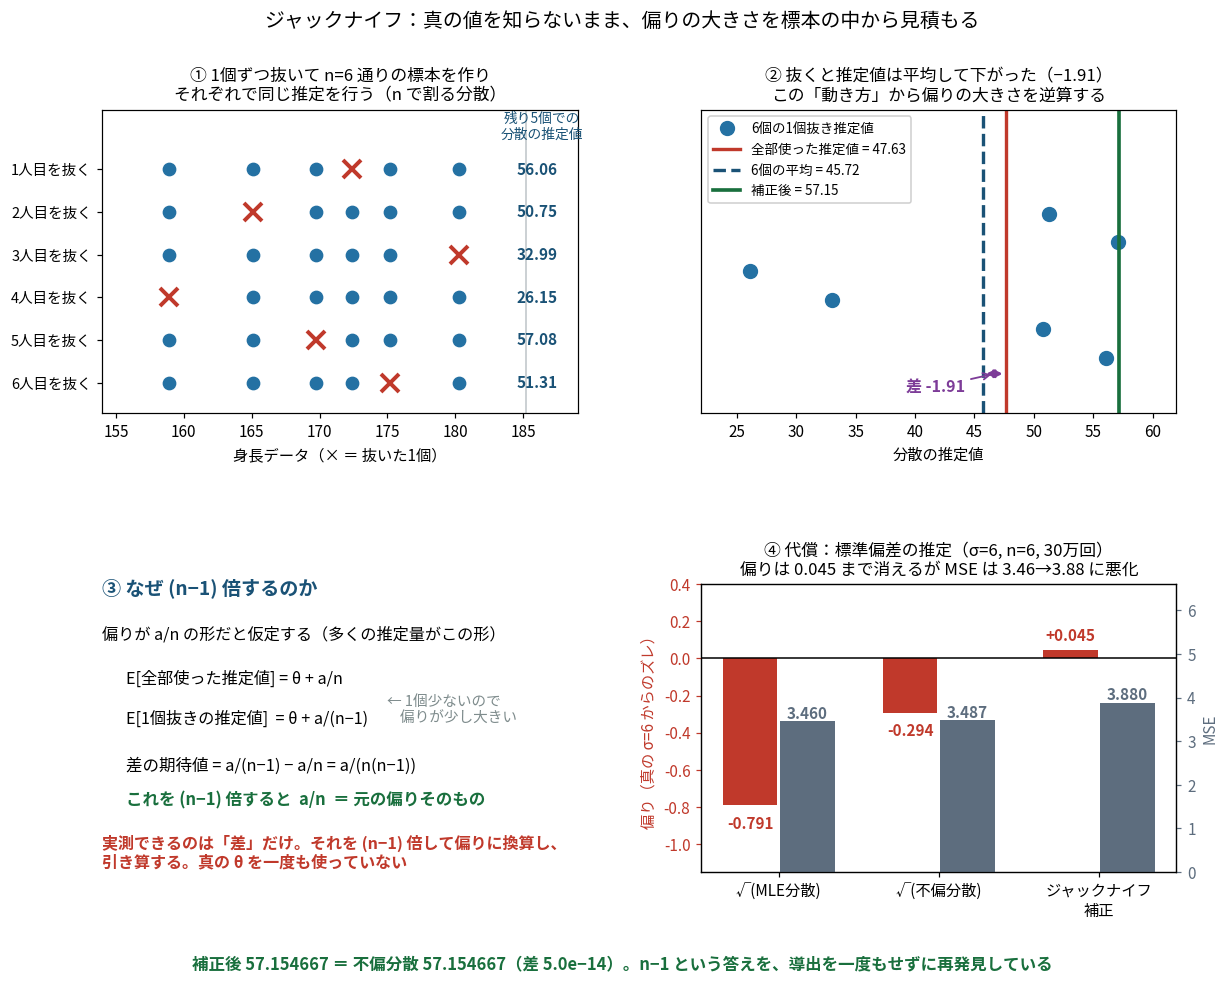
ジャックナイフは、真の値を知らないまま偏りを見積もる手法です。1個ずつ抜いて 通りの推定値を作り、その動き方から偏りの大きさを逆算します。真の値を知らなくても偏りが分かるというのが驚きでした。
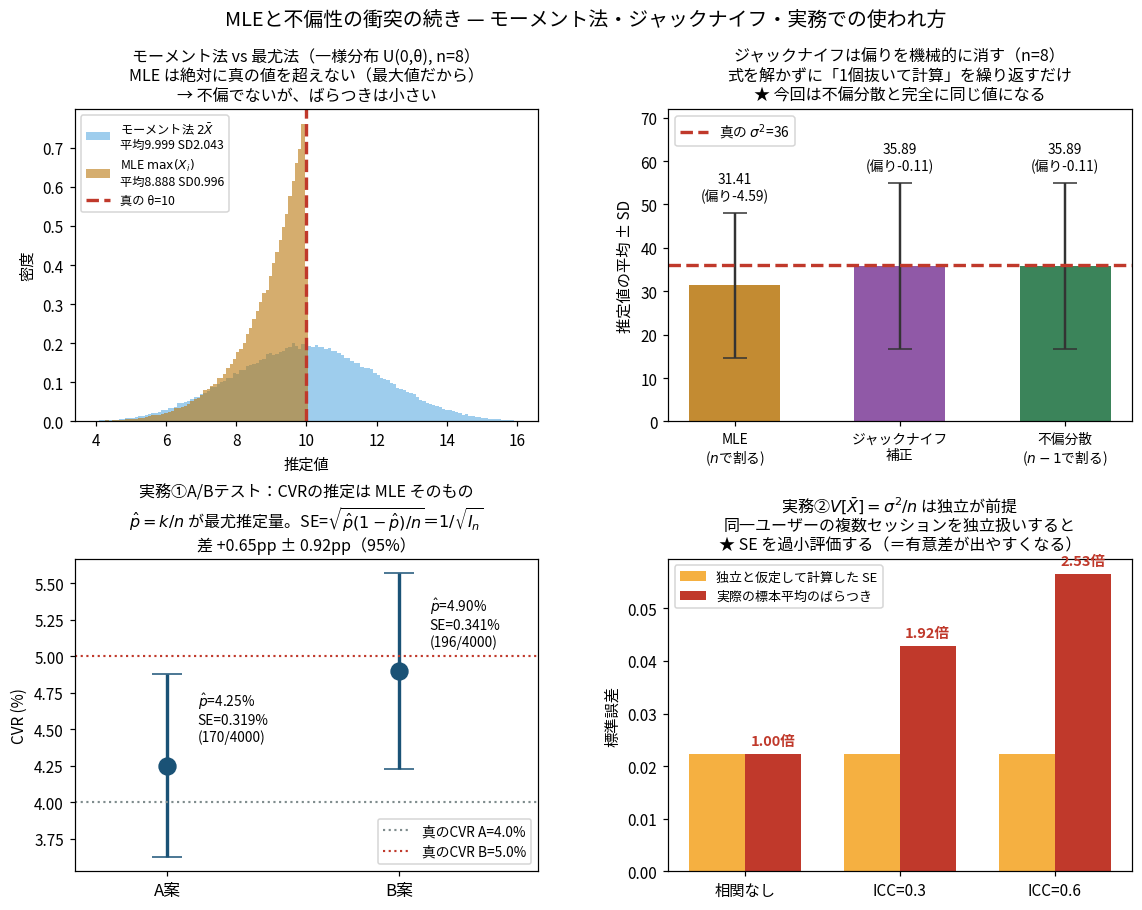
図の右側2つが実務での顔です。A/Bテストのコンバージョン率に付く誤差は で、これは後で出てくるフィッシャー情報量から出る式そのものです。そしてクラスター内相関(ICC, intraclass correlation)があると標準誤差を過小評価するという話は、この記事の最後で扱う「独立性という前提」の実務版です。
十分統計量:情報を落とさない要約
個のデータを少数の統計量に潰しても の推定に必要な情報が失われないとき、その統計量を十分統計量と呼びます。1個で足りるとは限らず、正規分布で と の両方を推定するなら の2個組になります。
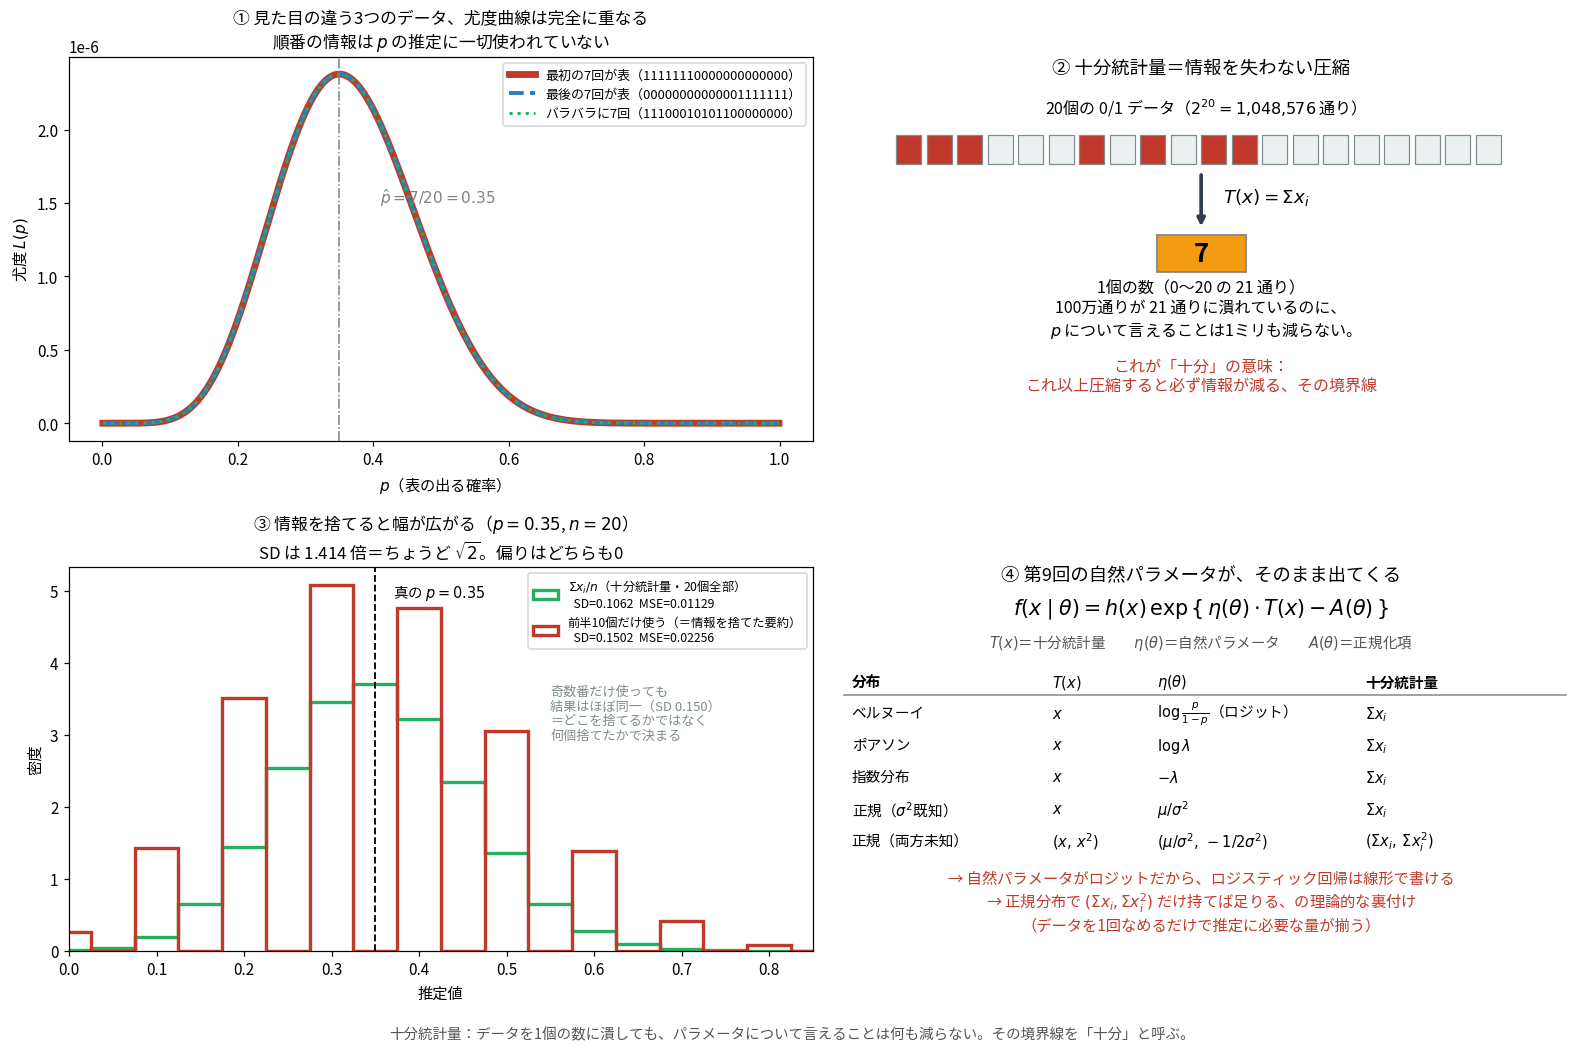
コイン投げなら「表が出た回数」が十分統計量です。見た目の違う3つのデータ列でも、表の回数が同じなら尤度曲線が完全に重なります。 つまり順番の情報は の推定に一切使われていないわけです。
だから安心して要約できます。逆に、十分でない統計量に潰すと(一部を捨てると)推定の幅が広がります。何を捨ててよくて何を捨ててはいけないかの線引きを与えるのが、この概念の役割でした。図の④にあるとおり、二項・ポアソン・正規・指数といった主要な分布はどれも指数型分布族という共通の形に書けて、十分統計量がその形から機械的に読み取れます。
フィッシャー情報量:対数尤度の山の尖り具合
いよいよ本題です。定義は
2階微分の期待値に符号を付けたもの、あるいはスコアの分散です。 のベルヌーイで数値を出すと、両者とも 4.3956 で一致しました(スコアの分散の実測は 4.3936)。
計算は4手
手順①:2回微分する。
手順②:式全体の期待値を取る。 ここが山場でした。2階微分にはまだ が残っているので、データによって値が変わってしまいます。でも情報量はデータを見る前に決まる量でないと困ります(設計段階で を決めたいので)。そこで について期待値を取ります。ベルヌーイでは式が について1次なので を代入するだけで済み、
が消えて だけの式になりました。 定義が期待値になっているのはこのためです。
なお「 に を代入する」と手順を覚えると一般には間違えます。正規分布の では2階微分に が現れるので、必要なのは であって ではありません。あくまで「式全体の期待値」です。
手順③:符号を反転する。
手順④:最後に 倍する。 対数尤度が和なので情報量も足し算です。
、 なら 。 倍を最後に回すのがコツで、最初から を抱えて微分すると式が膨らみます。
符号を忘れると検算で気づけます。 自分はポアソン分布で と出して詰まりました。情報量が負になったらその時点で計算ミスです。「情報が だけある」は意味をなしません。逆数が分散になるので、負だと分散が負になってしまいます。正しくは で、。これはポアソン分布の分散が であることからすぐ確認できる値です。
何を測っているのか
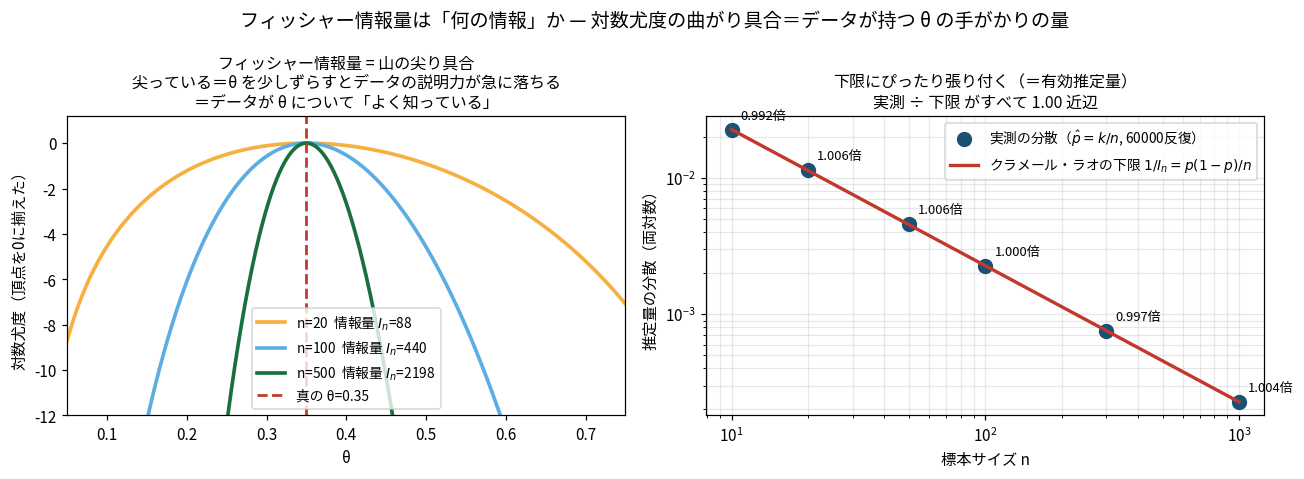
図の左が答えです。 は対数尤度の山の尖り具合です。
- 尖っている → を少しずらすとデータの説明力が急に落ちる → の位置を特定しやすい → 情報が多い
- 平べったい → どの でも大差ない → 特定しにくい → 情報が少ない
2階微分が出てくるのは曲率を測っているからです。尖った山では大きな負の値、平らな山では 0 に近い値。符号を反転すると「尖っているほど大きい」になります。
スコアの分散という定義でも同じことが言えます。スコアは「 を動かしたときの尤度の反応」なので、反応が敏感でデータごとにバラつくほど、 を特定しやすいわけです。
クラメール・ラオの下限
の逆数が、不偏推定量が到達できる分散の限界です。
ベルヌーイ 、 で計算すると
この は、比率のばらつきとして丸暗記していた式そのものです。 導出できたのが収穫でした。標本比率を30万回シミュレートすると分散 0.00056640 で、下限にほぼ張り付いています(図の右)。標本比率は分散が下限に一致する有効推定量なので、これ以上良い不偏推定量は存在しません。
標準偏差と標準誤差:ルートを取る操作は同じ、中身が違う
の逆数の平方根が標準誤差(SE, standard error)です。ここで一度「標準偏差とどう違うのか」を整理しておきます。自分はここが曖昧でした。
ルートを取る操作は同じで、中身が違うだけです。「標準誤差」は、「推定量の標準偏差」の短縮形で、新しい概念ではありません。
| 何のばらつきか | 例 | |
|---|---|---|
| 標準偏差(SD) | 個々のデータが散らばる幅 | |
| 標準誤差(SE) | 推定量が散らばる幅 |
身長 から 人ずつ取る実験です。
| 個人の SD( の平均) | (実測) | ||
|---|---|---|---|
| 5 | 5.64 | 2.690 | 2.683 |
| 25 | 5.94 | 1.199 | 1.200 |
| 100 | 5.98 | 0.601 | 0.600 |
| 400 | 6.00 | 0.300 | 0.300 |
| 1600 | 6.00 | 0.150 | 0.150 |
左の列は を増やしても 6 のままです。 人の身長のばらつきは何人測っても変わりません。右の列は縮みます。
「 を増やして小さくできるのは SE だけ」が両者を分ける決定的な違いです。データを集めても世界のばらつきは減らないが、自分の推定の不確かさは減る。SD は世界のばらつき、SE は自分の知識の不確かさ、と整理すると混ざらなくなりました。
混同すると桁が変わる
の実データ(、)で両方作ると、
| 区間 | 幅 | |
|---|---|---|
| 平均の95%信頼区間() | 4.52 | |
| 個人のばらつきの目安() | 21.49 |
幅が5倍近く違います。( を使っています。 が未知なので正規分布の 1.96 ではなく 分布の値になる、という話は第7回の内容です。下の行は厳密な予測区間ではなく、SD を使うと幅がどれだけ変わるかを見るための目安です。) 論文のグラフのエラーバーが SD か SE かで印象が激変するのはこれが理由で、SE の方が短く見えるので都合よく使われがちという批判もあります。
SE は平均専用ではない
「標準誤差 」と丸暗記していると詰まるところです。どんな統計量にも SE があります()。
| 統計量 | SE(実測) | 理論 |
|---|---|---|
| 1.199 | ||
| 中央値 | 1.490 | |
| 10.37 |
は標本平均に限った場合の式にすぎません。だからこそフィッシャー情報量が要るわけです。 なら公式を覚えていればいいけれど、ロジスティック回帰の係数の SE は暗記できません。情報量から機械的に出します。
漸近正規性:ここで区間推定につながる
最尤推定量は が大きいとき、こう分布します。
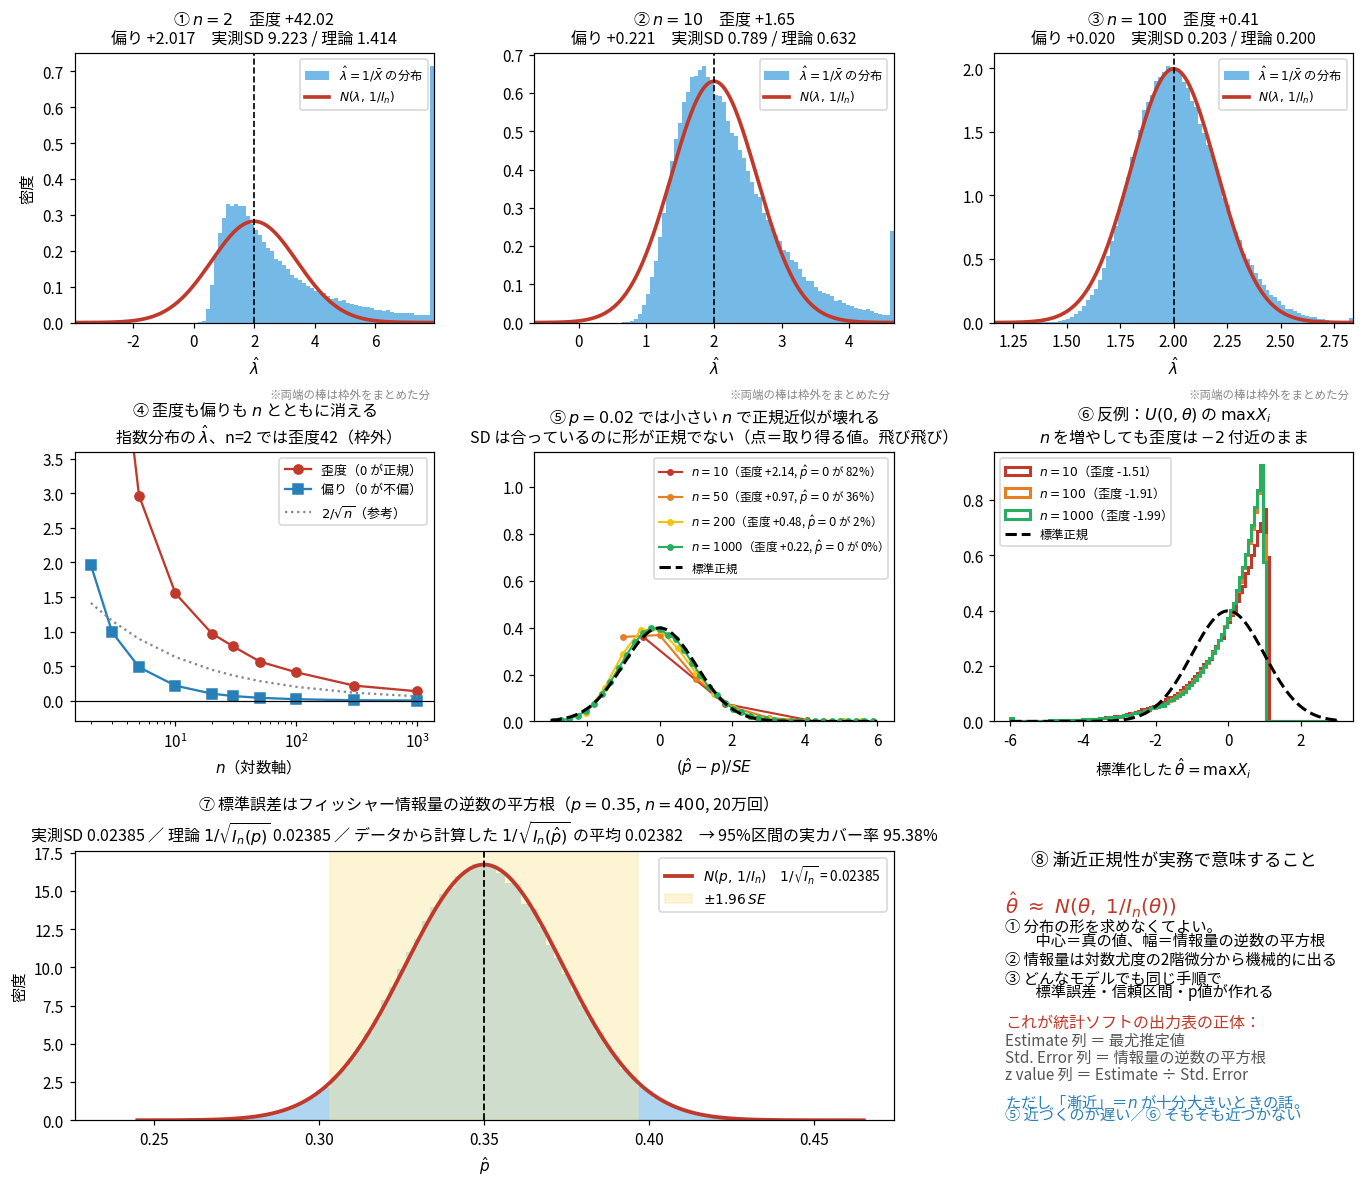
点推定値だけでなく、信頼区間まで出せるようになります。指数分布で を推定した例(真値2、、12万回)です。
| 項目 | 値 |
|---|---|
| (理論) | 0.14142 |
| 実測 | 0.14260 |
| の割合 | 0.9476(理論 0.95) |
信頼区間がちゃんと 95% 当たっています。 1標本での例だと 、、95%信頼区間 。
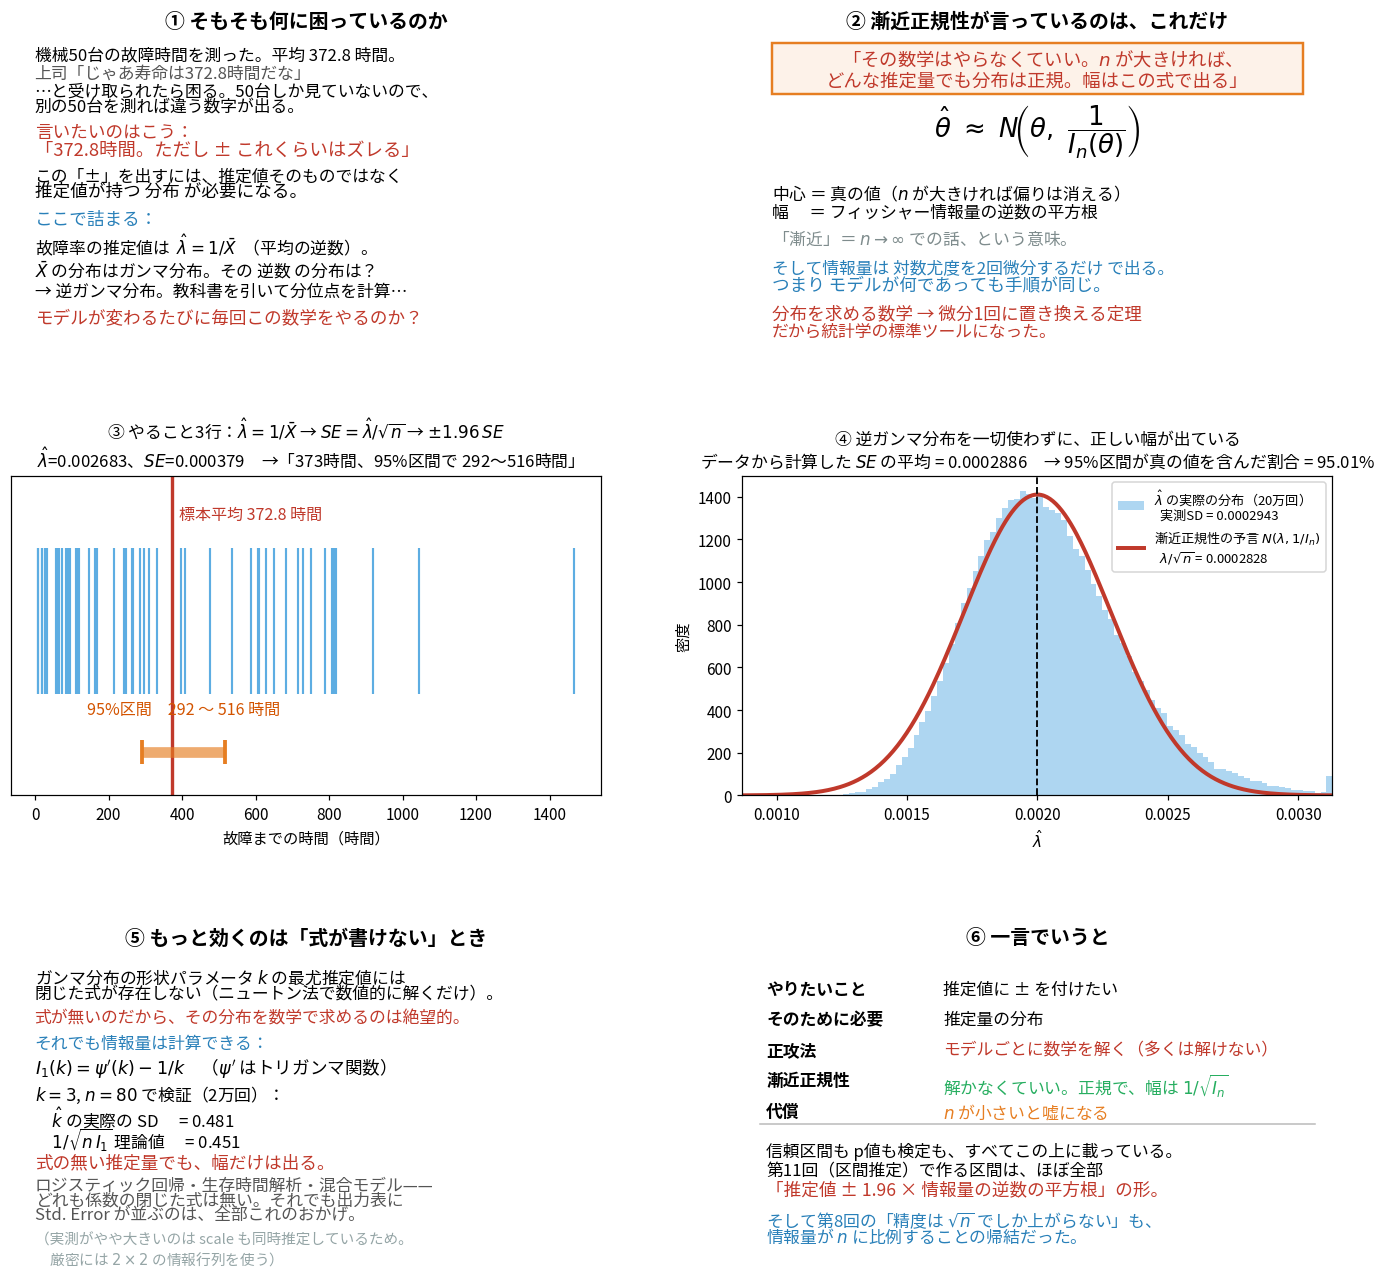
ありがたいのは、 の厳密な分布(逆ガンマ分布)を一切使わずに済むことです。やることは3行だけ。
回帰分析やロジスティック回帰の出力に並ぶ「Std. Error」は、全部これで計算されています。 対数尤度の2階微分の行列(ヘッセ行列)を作り、符号を反転して逆行列を取り、対角成分の平方根を取る。p値も信頼区間もそこから出ます。「フィッシャー情報量は何に使うのか」への最短の答えは「標準誤差を出すために使う」でした。
なお実務では真の が未知なので と推定値を代入するか、データで2階微分をそのまま評価した観測情報量(observed information)を使います。
中心極限定理とは別の定理
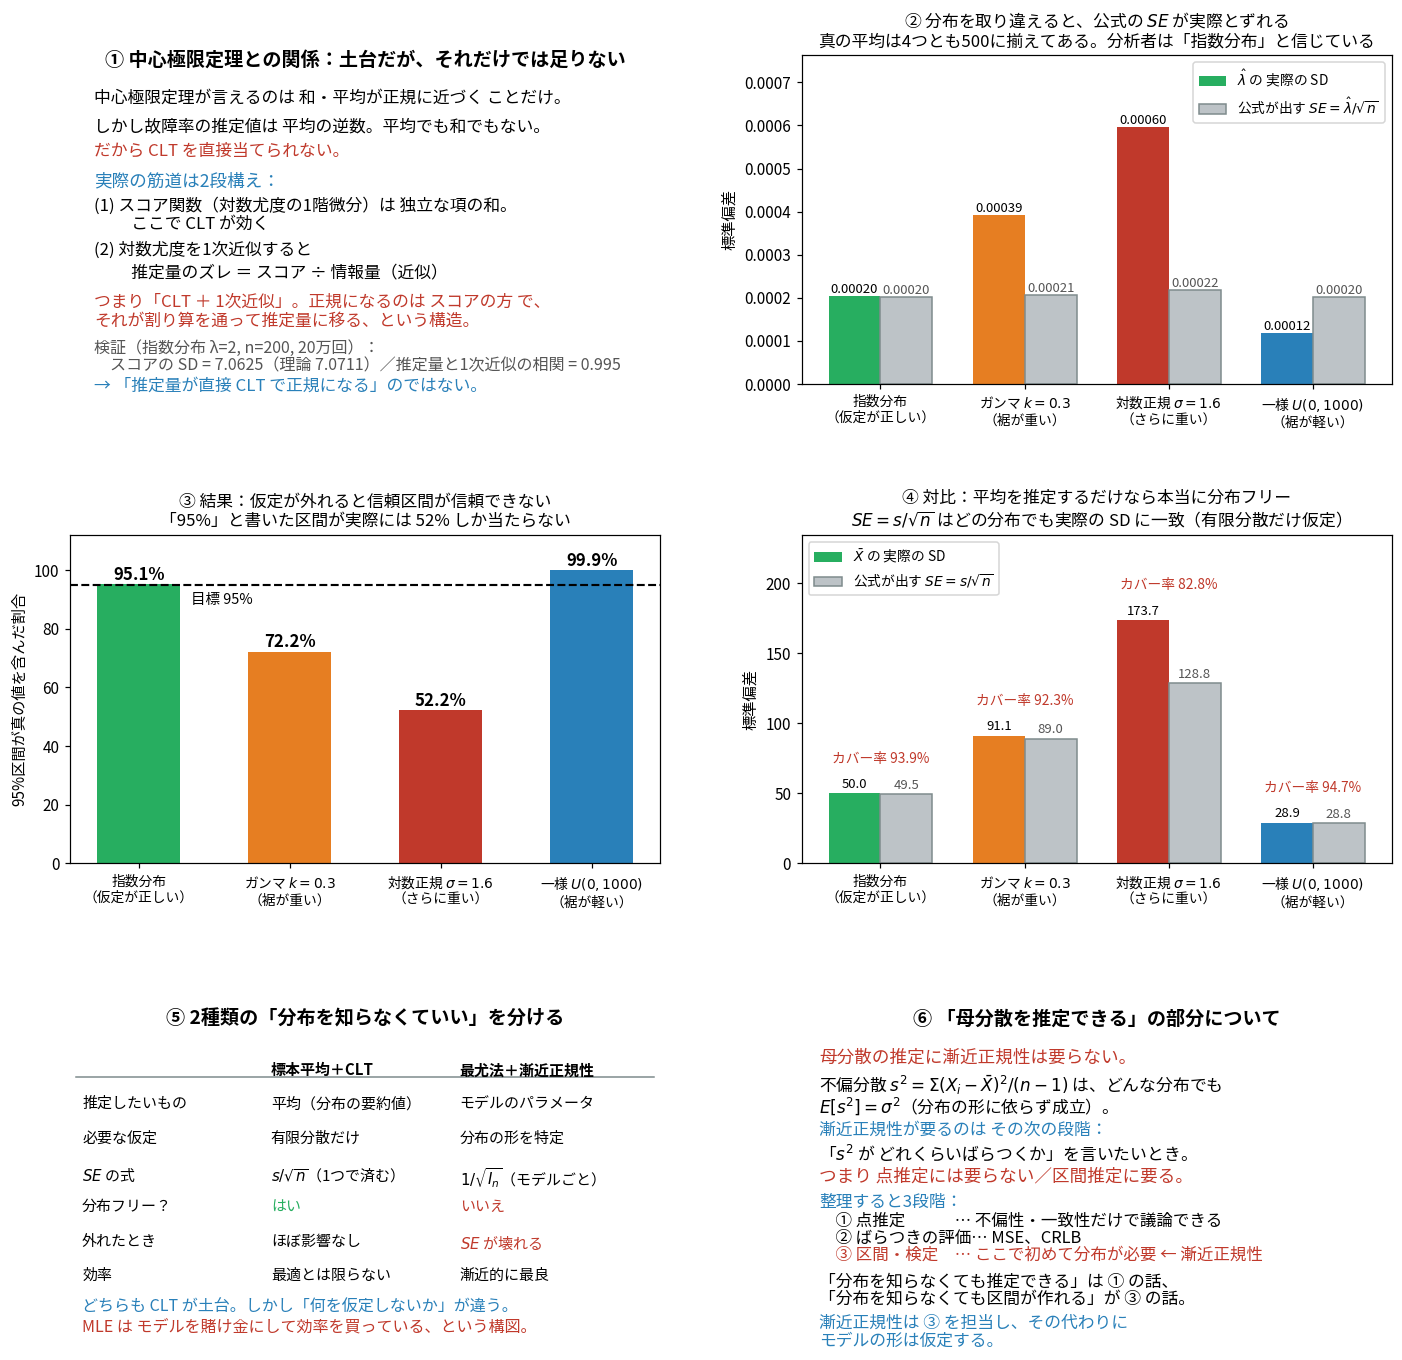
混同しやすいので区別しておきます。第8回の中心極限定理は和や平均についての定理でした。漸近正規性は最尤推定量という、 のような非線形な統計量についての定理です。範囲が広い代わりに、正則条件という前提が付きます。
そして仮定が外れると壊れます。図の②③がその例で、分布を取り違えると公式の SE が実際とずれ、信頼区間が信頼できなくなります。
壊れ方は2種類あります。ひとつ前の図(-15)の⑤⑥に出ていますが、 のような端の値ではSD は合っているのに形が正規でないという状態になります。もうひとつ、 の は を増やしても歪度が 付近のままで、永久に正規分布に近づきません。前者は を増やせば直りますが、後者は直りません。
の壁:情報が足し算だから精度はルート
ここで、以前から気になっていた「なぜ精度は でしか改善しないのか」に答えが出ます。
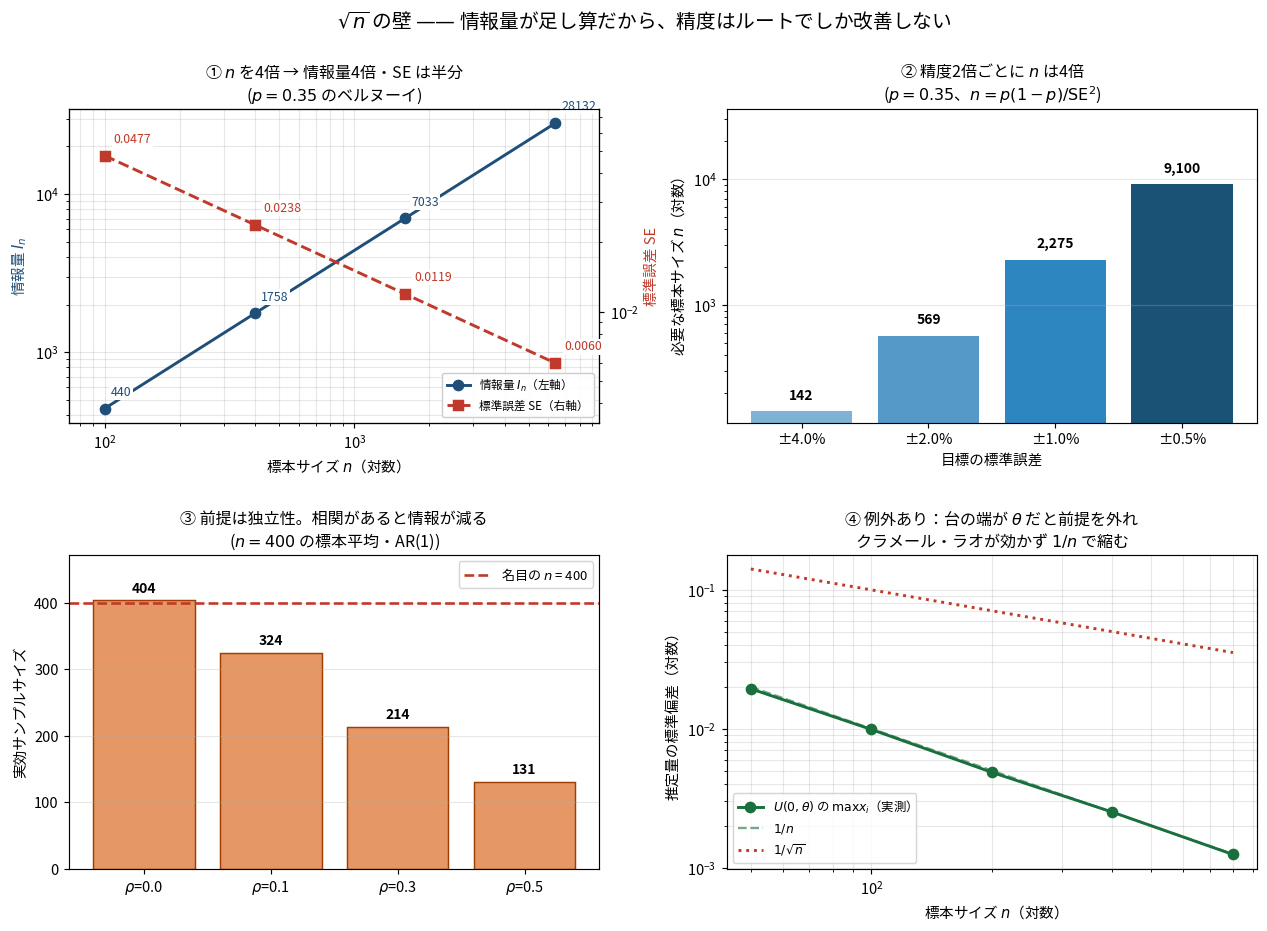
出どころは情報量の加法性1点です。
「情報が1件あたり一定量ずつ足し算で積み上がる」→「精度はルートでしか改善しない」という鎖です。理由は対数を取ったところにあります。尤度は掛け算ですが で和になり、微分しても和のまま。だから 件で 倍の情報。そして分散はその逆数、標準誤差はさらに平方根。この2段を通るので 倍の情報が 倍の精度に薄まります。
| SE | ||
|---|---|---|
| 100 | 440 | 0.0477 |
| 400 | 1758 | 0.0238 |
| 1600 | 7033 | 0.0119 |
| 6400 | 28132 | 0.0060 |
を4倍にすると情報は4倍だが SE は半分。 目標精度から必要な を逆算すると、割の悪さが見えます。
| 目標 SE | 4% | 2% | 1% | 0.5% |
|---|---|---|---|---|
| 必要な | 142 | 569 | 2,275 | 9,100 |
世論調査が2000人前後なのはこの計算です。 SE 1% を狙うと急に高くつくので、そこで打ち止めになる。
なお報道で見る「誤差 ±3%」は SE ではなく許容誤差(margin of error)で です。SE 1% なら許容誤差は約 ±2%。混同すると必要な が4倍ズレます。
傾向ではなく限界である
クラメール・ラオが不等号であることが効きます。「標本平均がたまたま だった」ではなく、どんな不偏推定量を持ってきても より速くはならない。つまり の壁は推定方法の工夫では破れません(改善できるのは定数倍 だけ)。だから精度を上げる手段は本質的に2つです。
- を増やす(コストが2乗で効く)
- を大きくする(測定精度を上げる、良い実験設計にする)
で殴るのは効率が悪いので、1件あたりの情報量を上げる方が筋がいい、という判断がこの不等式から出てきます。用量反応試験でどの用量に何人割り当てるかを の最大化として設計する最適実験計画は、まさにこれを制度化したものです。
効率:他の推定量とどれだけ違うか
CRLB は共通の物差しにもなります。正規分布の中心を推定する場合(、、20万回)。
| 推定量 | 分散(実測) | 理論 |
|---|---|---|
| 標本平均 | 0.03999 | = CRLB |
| 標本中央値 | 0.06194 |
効率は (実測 0.646)。これが意味するのは、中央値で平均と同じ精度を出すには を 倍、つまりデータを57%多く集める必要があるということです。効率という抽象的な数字が「余分に必要な標本数」に翻訳できるのが実用的でした。
前提①:独立性
「情報が に比例する」は無条件ではありません。独立同分布(i.i.d.)が効いています。 相関があると崩れます( の標本平均、隣り合う観測が相関する AR(1) 型で生成)。
| 相関 | SE | 実効的な |
|---|---|---|
| 0.0 | 0.0503 | 395 |
| 0.1 | 0.0552 | 328 |
| 0.3 | 0.0684 | 214 |
| 0.5 | 0.0868 | 133 |
の行が 400 ぴったりでないのはシミュレーションの誤差です(図では別の run で 404 になっています)。 だと 400 件集めても実質 133 件分の情報しかありません。時系列データやクラスター化したデータ(同じ学校の生徒、同じ患者の反復測定)で「実効サンプルサイズ」という言葉が出てくるのはこれです。 を数えて安心すると精度を過大評価します。
前提②:正則条件
CRLB には正則条件があり、外れると より速くなれます。 の を で推定した場合です。
| 50 | 0.01923 | 0.0200 | 0.1414 |
| 200 | 0.00491 | 0.0050 | 0.0707 |
| 800 | 0.00124 | 0.00125 | 0.0354 |
で縮んでいます( より圧倒的に速い)。分布の台の端が そのもので、微分と積分の交換が成立しないため前提を満たしません。「 が普遍法則」ではなく「正則な問題ではそれが限界」だという条件付きの主張です。
つまずいたところ
フィッシャー情報量を計算できても何の数字か分からなかった。 これが今回最大の詰まりでした。 という数字を出しても嬉しくない。逆数を取って平方根を取ると SE になるという接続を知って初めて、標本サイズ設計や信頼区間という「使う場面」に届きました。計算手順より先に用途を知るべきだったという反省です。
を新しい概念だと思った。 自分は絶対値を場合分けして微分していたので、 が出てきた教科書の式と対応が取れませんでした。同じ内容を1行に畳んだだけの記法です。データが 個あると場合分けは 通りに分かれるので、書き並べるのが現実的でないからまとめている、というだけでした。
符号の反転を忘れた。 ポアソン分布で と出しました。定義の外側のマイナスを落としていたのです。上に書いたとおり検算ポイントとして使えます。
「 を に取る」と誤解した。 ここは紛らわしい理由があって、正規分布の を推定すると という項が実際に出てくるのです。「パラメータの を取っている」ように見えます。でもあれは密度の係数 の を取ったら自動的に出てきた結果で、意図ではありません。
SD と SE を同じものだと思っていた。 「分散のルートは標準偏差」という理解自体は正しくて、標準誤差はその一種(推定量に対する標準偏差)だと分かれば済む話でした。3つの分散(、、)を区別する図を描いたのが効きました。
この記事の要点
- 不偏性(中心が当たる)と一致性(幅が縮む)は独立。4通りすべてに実例がある。 は不偏だが一致しない
- 最尤法は観測データをいちばん出やすくする を選ぶ。 を取るのは掛け算を足し算にするためと、アンダーフロー( は厳密に 0)を避けるため
- 正規分布を仮定=最小二乗法=平均、ラプラス分布を仮定=絶対値和=中央値。 頑健推定は分布の仮定の違いから出てくる
- 正規分布の分散の MLE は 割りで不偏でない。原因は、 を で置き換えたこと。MSE で採点すると MLE が勝つ
- フィッシャー情報量は対数尤度の山の尖り具合。期待値を取るのは、データを見る前に計算できる量にするため。符号を忘れて負になったら計算ミス
- 逆数 分散 平方根 SE で信頼区間。 ソフトの「Std. Error」はこれ
- SD は世界のばらつき、SE は自分の知識の不確かさ。 で縮むのは SE だけ
- の加法性が の壁の正体。推定方法の工夫では破れない。ただし独立性と正則条件が前提
次回は第9章の区間推定です。今回出てきた という形を、正面から扱います。点推定で「 は答えに残らない」と書いたところが、区間推定では効いてくるはずです。