回帰診断法:1点で傾きが半分になる仕組みと、てこ比の正体【第17回】
はじめに
第17章は回帰診断法です。前回(第16回・重回帰分析)で「最小二乗法は射影である」「偏回帰係数の正体は残差回帰である」といった話を扱いました。あの回はモデルを作って係数を解釈する話でした。
今回は逆向きです。そのモデルの前提が本当に成り立っているのかを確かめる回です。
前回の最後にガウス・マルコフの定理が出てきました。「誤差が期待値ゼロ・等分散・無相関なら、最小二乗推定量は不偏推定量の中で最も分散が小さい」という定理です。よく考えるとこれは条件付きの保証で、条件が崩れたら何が起きるかは何も言っていません。今回はその「崩れたとき」を全部見ていきます。
そして今回、私の中でいちばん大きかった疑問はこれでした。
最小二乗法は全部の点の残差を2乗して足して最小化するのに、なぜ1点だけが結果を支配できるのか。 平等に扱っているように見えるのに、実際には1点で傾きが半分になる。この矛盾がずっと引っかかっていました。
答えは意外なところにありました。「二乗しているから、まさにそうなる」のです。最小二乗法は平等ではありません。式の上でそれが見えます。
この記事で使う言葉
先に5つ整理します。この記事はこの5語で回ります。
てこ比(leverage): と書きます。ある観測が説明変数の空間で「みんなの中心からどれだけ離れているか」の指標。てこ(レバー)の柄の長さにあたります。重要なのは の値を一切見ずに計算できることです。
外れ値(outlier): の方向にズレている観測。てこ比とは別の概念で、こちらは残差を見て判定します。
影響力(influence):その観測が実際に結果をどれだけ動かしたか。上の2つの掛け算で決まります。代表的な指標が次のクック距離です。
クック距離(Cook's distance): と書きます。「その1点を抜いたら予測値全体がどれだけ動くか」を測った量。影響力の指標です。
不均一分散(heteroscedasticity):誤差の分散が観測ごとに違う状態。反対語は等分散(homoscedasticity)。「hetero=異なる」「skedasis=散らばり」というギリシャ語由来で、字面のまま「散らばりが異なる」です。
略語も先に開いておきます。OLS(Ordinary Least Squares=通常の最小二乗法)、WLS(Weighted Least Squares=加重最小二乗法)、SE(Standard Error=標準誤差)、DW(Durbin-Watson=ダービン・ワトソン比)、BP検定(Breusch-Pagan test=ブロイシュ・ペーガン検定)、RSS(Residual Sum of Squares=残差平方和)、TSS(Total Sum of Squares=全平方和)、RMSE(Root Mean Squared Error=二乗平均平方根誤差)。
なお という記号が2つの意味で使われる問題は前回と同じです。この記事ではパラメータ数を 、有意確率は「p値」と書き分けます。
TL;DR
- 最小二乗法は平等ではない。 傾きは という の加重和で、重みは 。実測で と OLS の傾きが 1.07709520 で一致
- の点は傾きに1票も持っていない(重み )。だから を14動かしても傾きは変化
- 1点が回帰を壊すには「 が遠い」と「 がズレている」の両方が必要。 が掛け算だから、どちらかが0なら積は0
- が遠く もズレた1点で傾きが 1.024 → 0.350 に崩壊(、 は 0.945 → 0.181)
- てこ比は を見ずに計算できる( だけの関数)。 =自分の予測への発言力で、5点すべてで実測の傾きが と 精度で一致
- 重回帰では「単独では平凡なのに組み合わせが異常」な点が生まれる。 相関0.639のとき、重心から同じ距離3.111でも が 0.465 対 0.213 と2.2倍違う
- てこ比が高い点は生の残差が小さく出る()。 の点の残差は 0.030 しかない
- 外れ値は自分でものさしを伸ばして自分を隠す(マスキング)。 が 0.925 → 2.768 と3倍に膨らみ、標準化残差は で飽和して止まる
- だから外れ値判定には外部(スチューデント化残差)を使う。 こちらは 11.79 まで伸び、 に厳密に従う(97.5%点が実測 2.2490 対 理論 2.2622)
- 不均一分散が壊すのは標準誤差だけ。 推定値は不偏のまま(平均 1.500377、真値 1.5)だが、SE は本当のSDの 0.944倍で被覆率 93.74%、偽陽性 6.55%
- ただし「必ず過小評価」は誤り。 分散が中央で大きい形だと比が 2.262 で過大評価になる。鍵はてこ比との相関
- は閾値ではなく目印。 完全に正常なデータで =200 のとき誤検出率 100%( なので は常に上位数%の線。原因は多重比較)
- 削除は区間を 0.721倍に縮めるが被覆率を下げる(95.73% → 91.07%、繰り返すと 80.55%)。一方で点推定のRMSEは改善する(0.102 → 0.084)
- 捨てるより重みを下げるほうが強い。 Huber ロバスト回帰は RMSE 0.080 で削除より良く、標本を1つも捨てない。ただし守るのは 方向だけ(汚染点が =60 なら OLS と同様に壊れる)
- DW が小さい原因は自己相関でないことがある。 誤差が完全に独立な曲線データで DW=0.368、 を入れたら 2.092 に戻った
- 自己相関は不均一分散よりずっと危険。 =0.9 で被覆率 34.03%。ただしこれも向きは の並びで変わる
- アンスコムの4データは係数・・・残差SDが全部一致するのに中身が別物。 うち1つは がちょうど 1.000
- おまけ:残差の平均は常に厳密にゼロなので、診断の材料にならない
なぜ二乗の最小化なのに1点が支配できるのか
順序を変えます。教科書だと診断量の定義から入りますが、最初にこの疑問を片付けたほうが後が全部楽になると気づいたので、ここから始めます。
傾きは の加重和だった
単回帰の傾きの式を変形します。
ここで です。 なので分子の が消えて、この形になります。
つまり傾きは のただの加重和です。重み は だけで決まっていて、 を見る前に確定しています。
実際に確かめました。
| 量 | 値 |
|---|---|
| 1.07709520 | |
| OLS が返す傾き | 1.07709520 |
| 差 | |
| (ゼロ) | |
| 1.00000000 |
下2行は重みが満たす制約です。 かつ で、この2本が「不偏推定量になるための条件」にあたります。
そして重みの中身を見ると、疑問が一気に解けます。
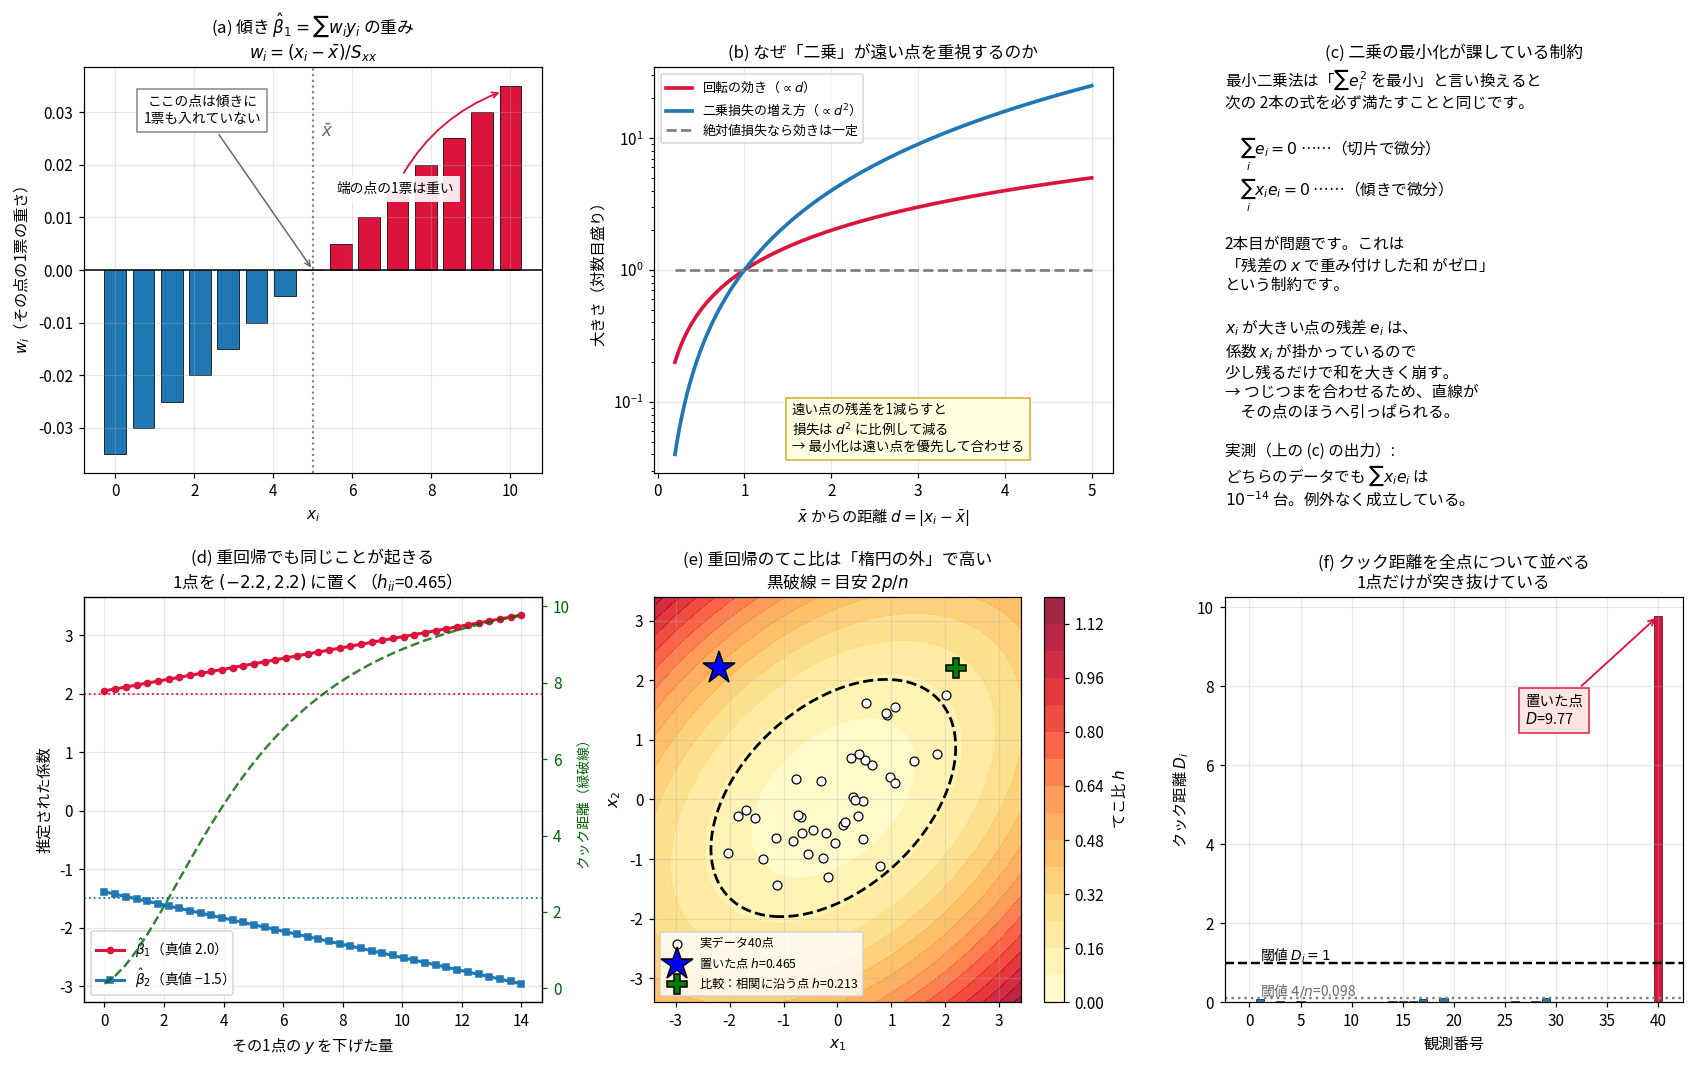
(a) が核心です。 棒グラフは「どの点が傾きに何票入れているか」を表しています。 のところで棒がゼロになっているのが見えるでしょうか。実測値は 、つまり真ん中の点は傾きについて1票も持っていません。端の点の票は重く、 が から離れるほど比例して重くなります(端から2番目 0.03000 対 中央から2番目 0.01000 でちょうど3倍)。
(b) は「なぜ二乗なのか」の答えです。 支点から距離 の点を考えると、回転への効きは に比例する一方、二乗損失の減り方は に比例します。だから最小化アルゴリズムは遠い点を優先して合わせに行く。
もし損失が絶対値()なら、残差の大きさに対する効きは一定になります( が10ズレても100ズレても効きが同じ)。これが後で出てくるロバスト回帰の発想の源です。
ただし注意が必要で、絶対値損失にしても 方向のてこ比は消えません。勾配を書くと明らかです。
どちらにも が残っています。 絶対値損失が一定にするのは「 方向のズレに対する効き」だけで、「 の遠さに対する効き」はそのままです。この事実は後でロバスト回帰の限界として戻ってきます。
(c) は別の角度からの説明です。 最小二乗法は次の2本を必ず満たします。
2本目が問題です。これは「残差を で重み付けした和がゼロ」という制約なので、 が大きい点の残差には係数 が掛かって効きます。少し残るだけで和を崩すため、つじつまを合わせるために直線がその点へ引っぱられる。実データで確認すると、どちらのデータでも は 台、つまり例外なく厳密に成立していました。
ここが今回の土台です。
最小二乗法が平等なのは残差の扱いだけで、係数への寄与は最初から不平等です。 、 という式がそれを示しています。
- が に近い点 … 。 がどれだけ暴れても傾きは動かない
- が遠い点 … が大きい。 が少し動くと傾きが動く
てこ比が高い点とは「 が大きい点」=1票の重みが大きい点のことです。 そして 方向のズレが「その1票の中身」。影響力=票の重み × 票の中身。
「二乗誤差の最小化」という手続きが、勝手にこの重み付けを作り出している。ここが腑に落ちると、以降の診断量が全部「この不平等を測る道具」として読めるようになります。
重回帰でも同じことが起きる
「単回帰の話では?」と思ったので、(切片+説明変数2つ)で実演しました。上の図の (d)(e)(f) です。 と の相関は 0.639 に設定しています。
1点を に置いて、その点の だけを下げていきます。
| を下げた量 | (真値 2.0) | (真値 −1.5) | てこ比 | クック距離 |
|---|---|---|---|---|
| 0 | 2.048 | −1.386 | 0.465 | 0.117 |
| 4.7 | 2.479 | −1.910 | 0.465 | 5.557 |
| 9.3 | 2.910 | −2.434 | 0.465 | 8.647 |
| 14.0 | 3.342 | −2.957 | 0.465 | 9.773 |
が 2.05 から 3.34、 が −1.39 から −2.96(真値はそれぞれ 2.0 と −1.5)。1点で両方の係数が2倍近くまで動きました。 が 0.465 のまま一定なのは、てこ比が だけで決まるので をいくら動かしても変わらないためです。図(f)で全点のクック距離を並べると、この点の 9.77 が他の40点の最大 0.114 の86倍でした。
そして重回帰のほうが厄介です。 (e) を見てください。 と に相関があると、てこ比の等高線は傾いた楕円になります。
| 点の位置 | 重心からの直線距離 | てこ比 |
|---|---|---|
| 3.111 | 0.465 | |
| 3.111(同じ) | 0.213 |
同じ距離なのに が2.2倍違います。 前者は「 が小さいのに が大きい」、つまり相関 0.639 という全体の傾向に逆らっている点だからです。
ここが実務で怖いところでした。 も も単独では という値で、標準偏差1の変数ならよくある値です。単独では平凡なのに、組み合わせとして異常だから高てこ比になる。つまり1変数ずつヒストグラムを描いて外れ値チェックをしても絶対に見つかりません。 を計算して初めて見えます。これが という量をわざわざ使う実用上の理由でした。
なお、てこ比が「重心からの楕円距離」であることは式でも確認できます(後で出てくる図の (d) が等高線の全体像です)。マハラノビス距離 を使うと
で、実測との最大誤差は でした( は共分散行列を で割って測った場合。 で割る流儀なら分母も になります)。楕円が傾く理由は、マハラノビス距離が共分散行列の逆行列で測る距離だからです。
1点を動かすと直線はどう動くか
ここからが今回いちばん見たかったものです。20点を固定して、21番目の点だけを動かします。動かし方を3通り変えると、まったく違う挙動になります。
A: は真ん中のまま、 を大きく動かす
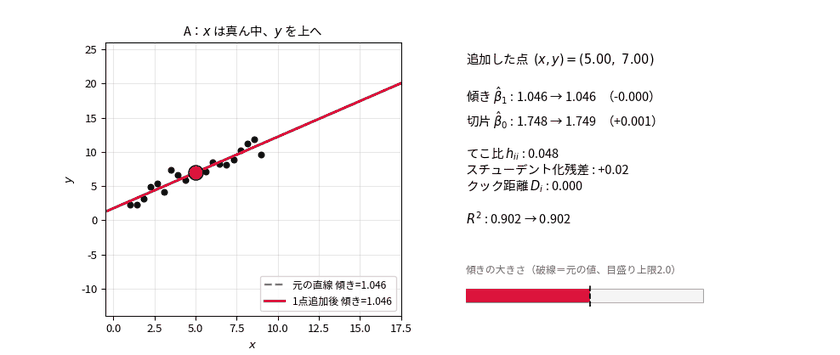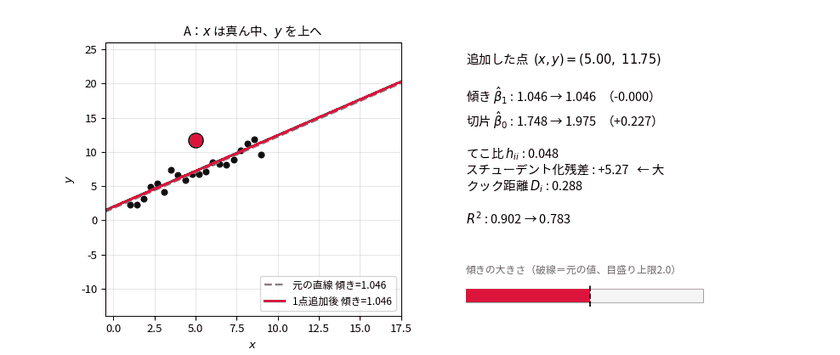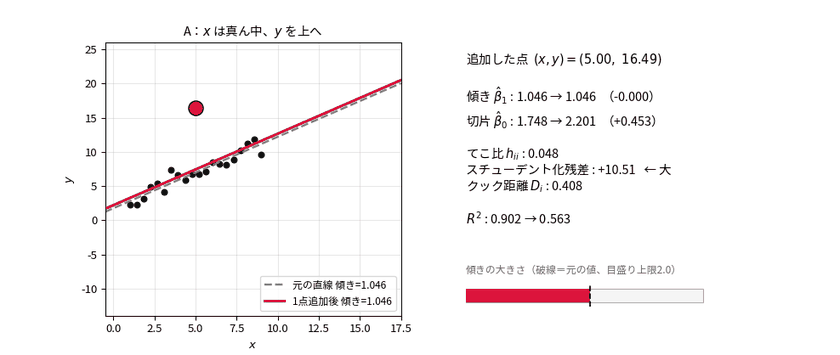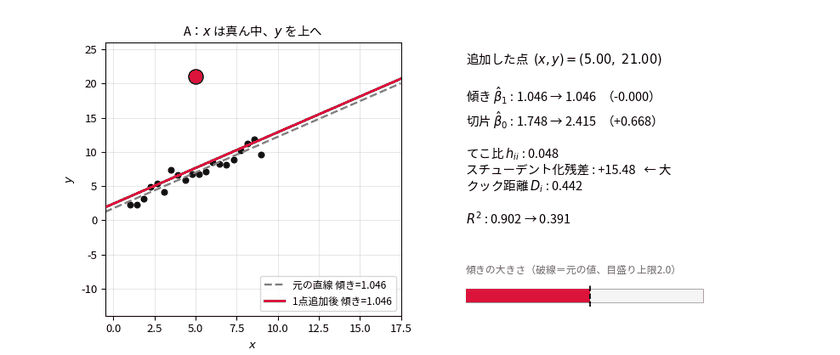
(ちょうど )に置いたまま、 を14上へ動かします。右側の数値に注目してください。
| の位置 | 切片 | 傾き | スチューデント化残差 | |||
|---|---|---|---|---|---|---|
| 7.00 | 1.749 | 1.046 | 0.048 | 0.02 | 0.000 | 0.902 |
| 11.51 | 1.964 | 1.046 | 0.048 | 5.00 | 0.276 | 0.793 |
| 16.25 | 2.190 | 1.046 | 0.048 | 10.24 | 0.405 | 0.573 |
| 21.00 | 2.415 | 1.046 | 0.048 | 15.48 | 0.442 | 0.391 |
を14も動かしたのに、傾きは 1.046 から1ミリも動きません。 動くのは切片だけ(1.749 → 2.415)。スチューデント化残差は +15.48 という異常な値まで行き、 は 0.902 から 0.391 へ落ちるのに、傾きだけが無傷です。
理由はもう分かります。 の点は 、つまり傾きについて1票も持っていない。てこの支点の真上を押しても回転モーメントが生じないのと同じです。
B: は直線上のまま、 を遠ざける
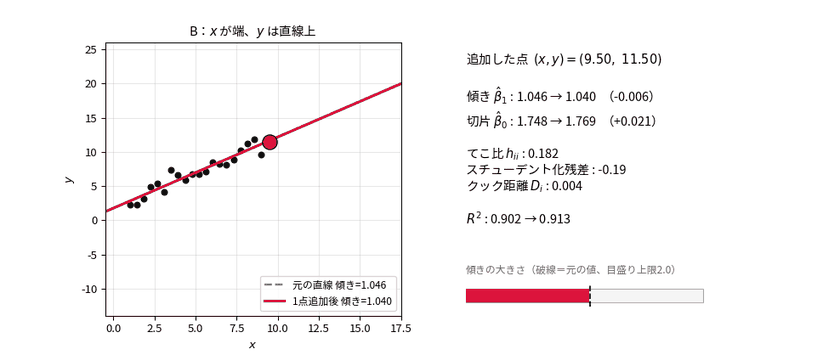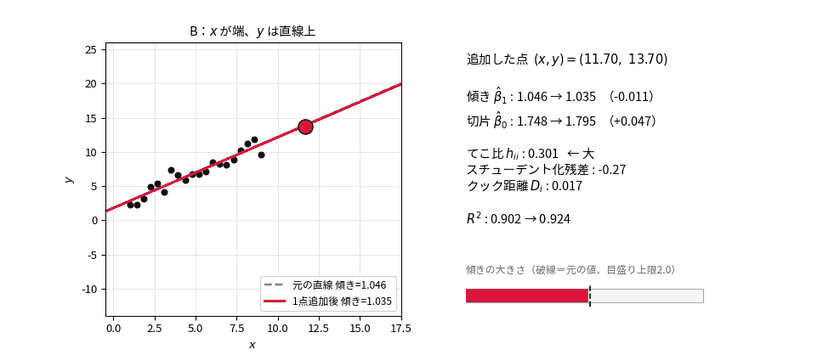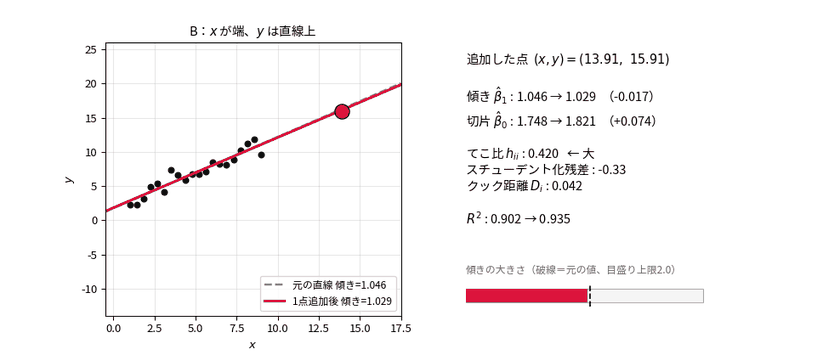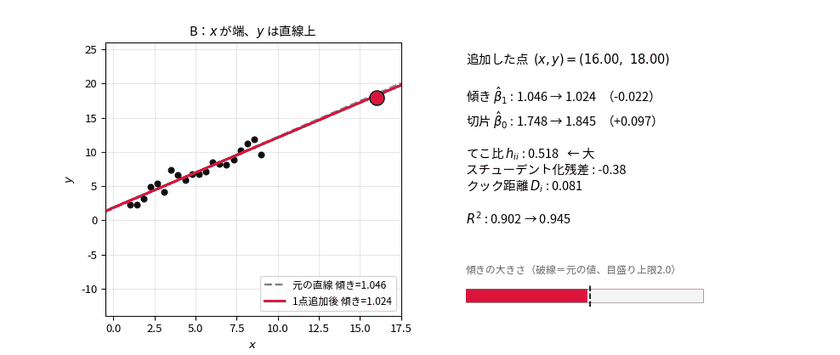
今度は を直線の延長上に置いたまま、 を 9.5 から 16 へ遠ざけます。
| の位置 | 傾き | スチューデント化残差 | |||
|---|---|---|---|---|---|
| 9.50 | 1.040 | 0.182 | −0.19 | 0.004 | 0.913 |
| 11.59 | 1.035 | 0.295 | −0.27 | 0.016 | 0.924 |
| 13.80 | 1.029 | 0.414 | −0.33 | 0.041 | 0.935 |
| 16.00 | 1.024 | 0.518 | −0.38 | 0.081 | 0.945 |
てこ比が 0.182 から 0.518 までぐんぐん上がります。危険な位置に移動しているわけです。ところが傾きの変化はごくわずか(1.040 → 1.024)、クック距離も 0.081 止まり。
しかも は 0.913 から 0.945 に「良くなって」しまいます。 の範囲が広がって が増えたためで、あてはまりの指標としては改善に見える。てこ比が高いだけでは何も起きていないというのがこの図の主張です。
C: が遠く、 もズレる
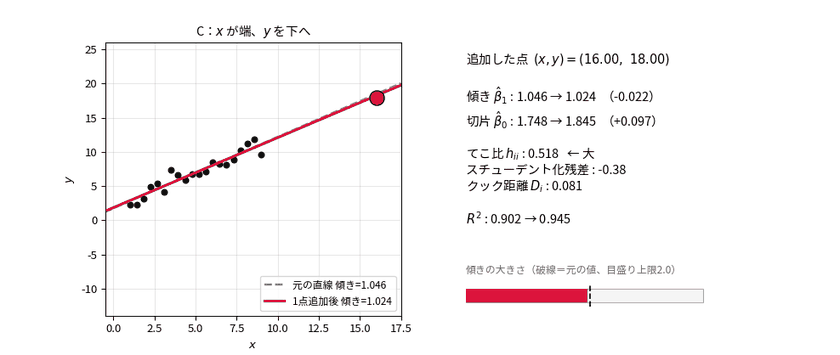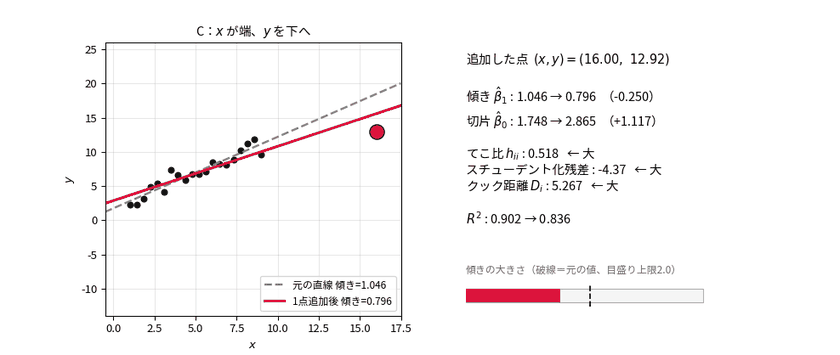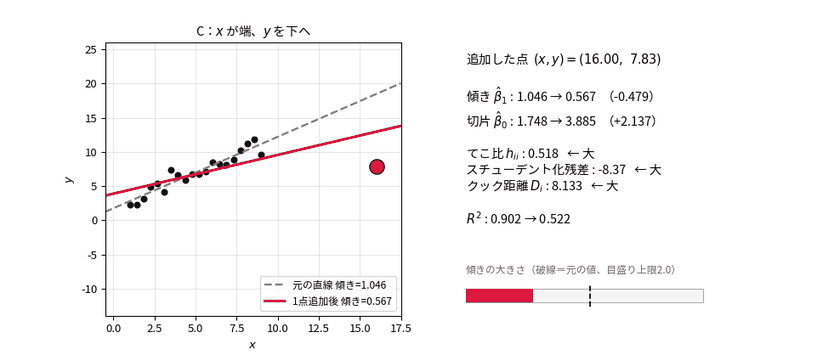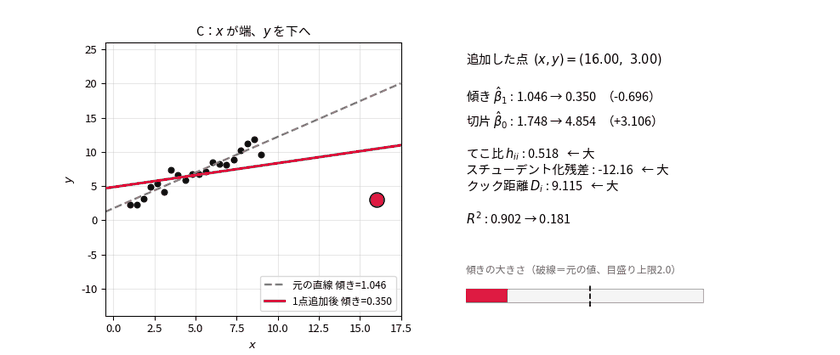
本命です。 に置いたまま( に固定)、 を15下へ動かします。
| の位置 | 切片 | 傾き | スチューデント化残差 | |||
|---|---|---|---|---|---|---|
| 18.00 | 1.845 | 1.024 | 0.518 | −0.38 | 0.081 | 0.945 |
| 13.17 | 2.814 | 0.807 | 0.518 | −4.17 | 5.028 | 0.846 |
| 8.08 | 3.834 | 0.579 | 0.518 | −8.17 | 8.052 | 0.541 |
| 3.00 | 4.854 | 0.350 | 0.518 | −12.16 | 9.115 | 0.181 |
傾きが 1.024 から 0.350 へ崩壊しました(変化 −0.696)。クック距離は 9.115 で、よく使われる閾値1をはるかに超えています。 は 0.945 から 0.181。
Bと違うのは 方向にもズレたことだけ、Aと違うのは が遠いことだけです。
3つのアニメが言っていること。
1点が回帰を壊すには、「 が遠い」と「 がズレている」の両方が必要です。
- A … がズレているだけ → 傾きは無傷
- B … が遠いだけ → 何も起きない(むしろ は改善)
- C … 両方そろって初めて崩壊
式で見ると理由が明快です。
方向のズレ()と 方向の遠さ()の掛け算になっています。 掛け算だから、どちらかが0なら積は0。これがCだけが壊れる理由です。
外れ値・てこ比・影響力を2×2で整理する
この3つが別物だという話を、同じデータで並べます。21番目の点の置き場所を4通り変えただけです( の下限が になっているのがその証拠です)。
大事な工夫が1つあります。 の位置を「その点を除いた直線」からの上下で指定しました。こうしないとてこ比だけを孤立させられません(最初は「真の直線」から指定して失敗しました。それだと③に残差が残ってしまい、影響力がゼロになりません)。
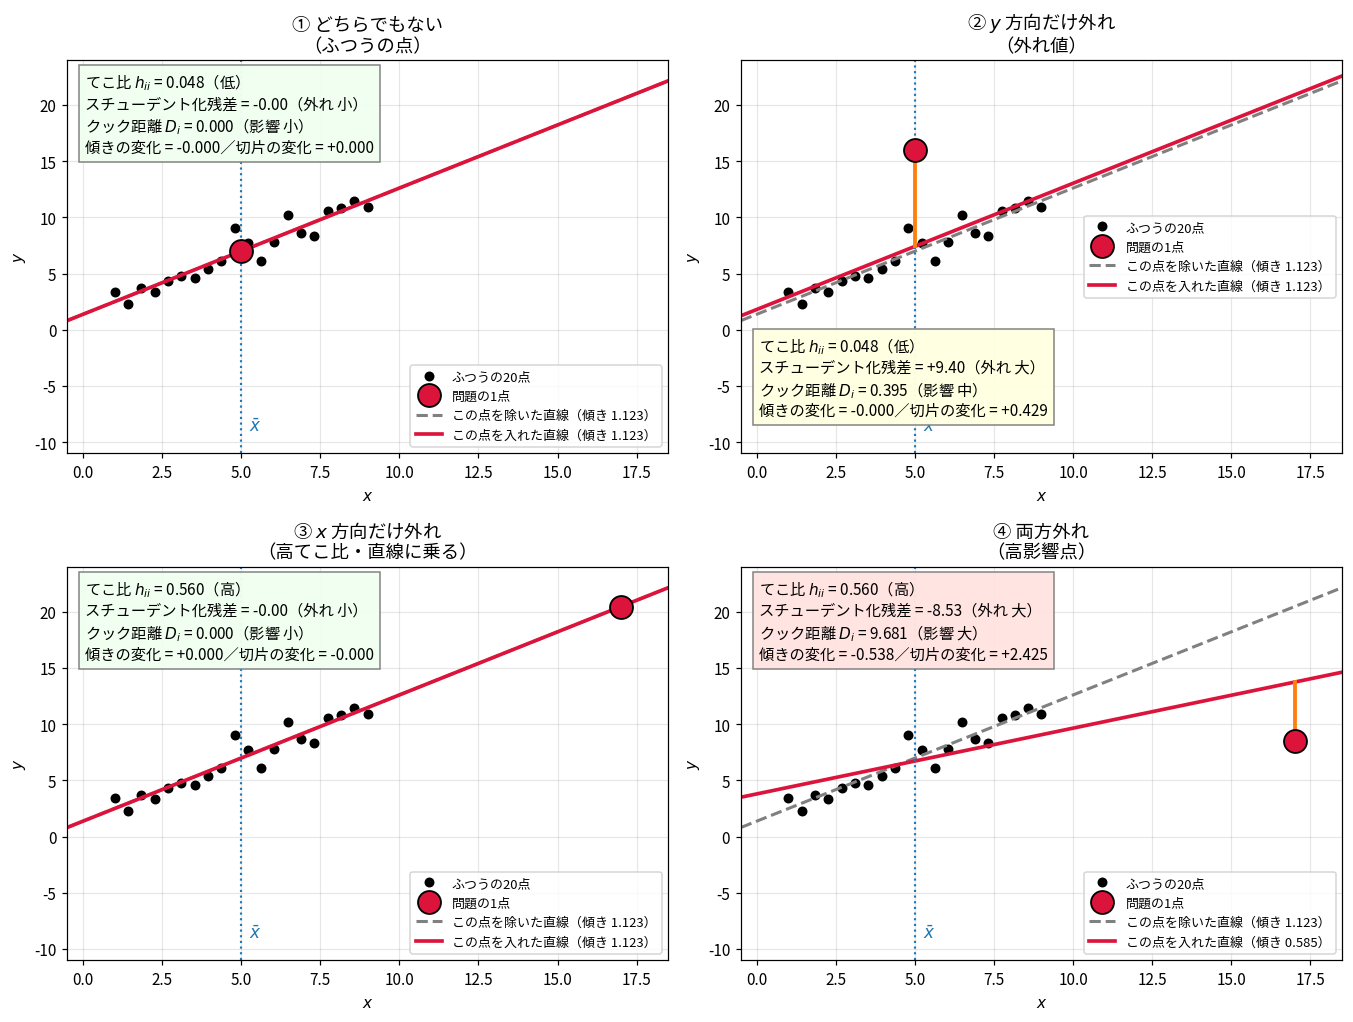
灰色の破線が「問題の点を入れない直線」、赤が「入れた直線」です。2本が重なっていれば影響ゼロと読めます。
| ケース | の位置 | の位置 | てこ比 | スチューデント化残差 | クック距離 | 傾きの変化 | 切片の変化 |
|---|---|---|---|---|---|---|---|
| ① ふつうの点 | の上 | 直線上 | 0.048 | −0.00 | 0.000 | −0.000 | +0.000 |
| ② 外れ値 | の上 | +9 ズレ | 0.048 | +9.40 | 0.395 | −0.000 | +0.429 |
| ③ 高てこ比 | (遠い) | 直線上 | 0.560 | −0.00 | 0.000 | +0.000 | −0.000 |
| ④ 高影響点 | (遠い) | −12 ズレ | 0.560 | −8.53 | 9.681 | −0.538 | +2.425 |
②と③が対比のポイントです。
② は残差が +9.40 という明確な外れ値なのに、傾きの変化は −0.000。動いたのは切片だけ(+0.429)です。クック距離 0.395 は「中くらい」で、閾値1には届きません。
③ はてこ比 0.560 という危険な位置にいるのに、クック距離が 0.000、傾きの変化も +0.000。図でも2本の線が完全に重なっています。
④ は③と同じ位置から を12下げただけで、クック距離が 9.681、傾きが 1.123 から 0.585 へ半減しました。
3つの言葉の定義(これで区別が付きます)。
- 外れ値 … 方向にズレている。残差を見て判定する。データを取ったあとで初めて分かる
- てこ比 … 方向に遠い。 を一切見ずに計算できる( は だけの関数)。つまり「まだ何も起きていないが、起きたら大きい」という潜在的な危険度
- 影響力 … 実際に結果を動かした量。上の2つの掛け算
たとえで言うと、てこ比はハンマーの柄の長さ、外れ値は振り下ろす力、影響力は実際に開いた穴です。 柄が長くても振らなければ穴は開かない(③)。思い切り振っても柄が短ければ穴は小さい(②)。
てこ比が「 を見ずに計算できる」というのは、実験計画の話とも繋がります。どこで観測するかを自分で決められる場合、てこ比はデータを取る前に設計できるのです。前回、説明変数がよく散らばっていると標準誤差が下がるという話をしましたが(単回帰なら で、分母が「てこの長さ」にあたります)、あれは「てこ比の高い点をあえて作ると精度が上がる」という意味でもありました。精度を上げる工夫と、1点に支配されるリスクは同じ源から来ているわけです。
てこ比とハット行列の幾何
てこ比の意味をもう少し掘ります。名前の由来から入ります。
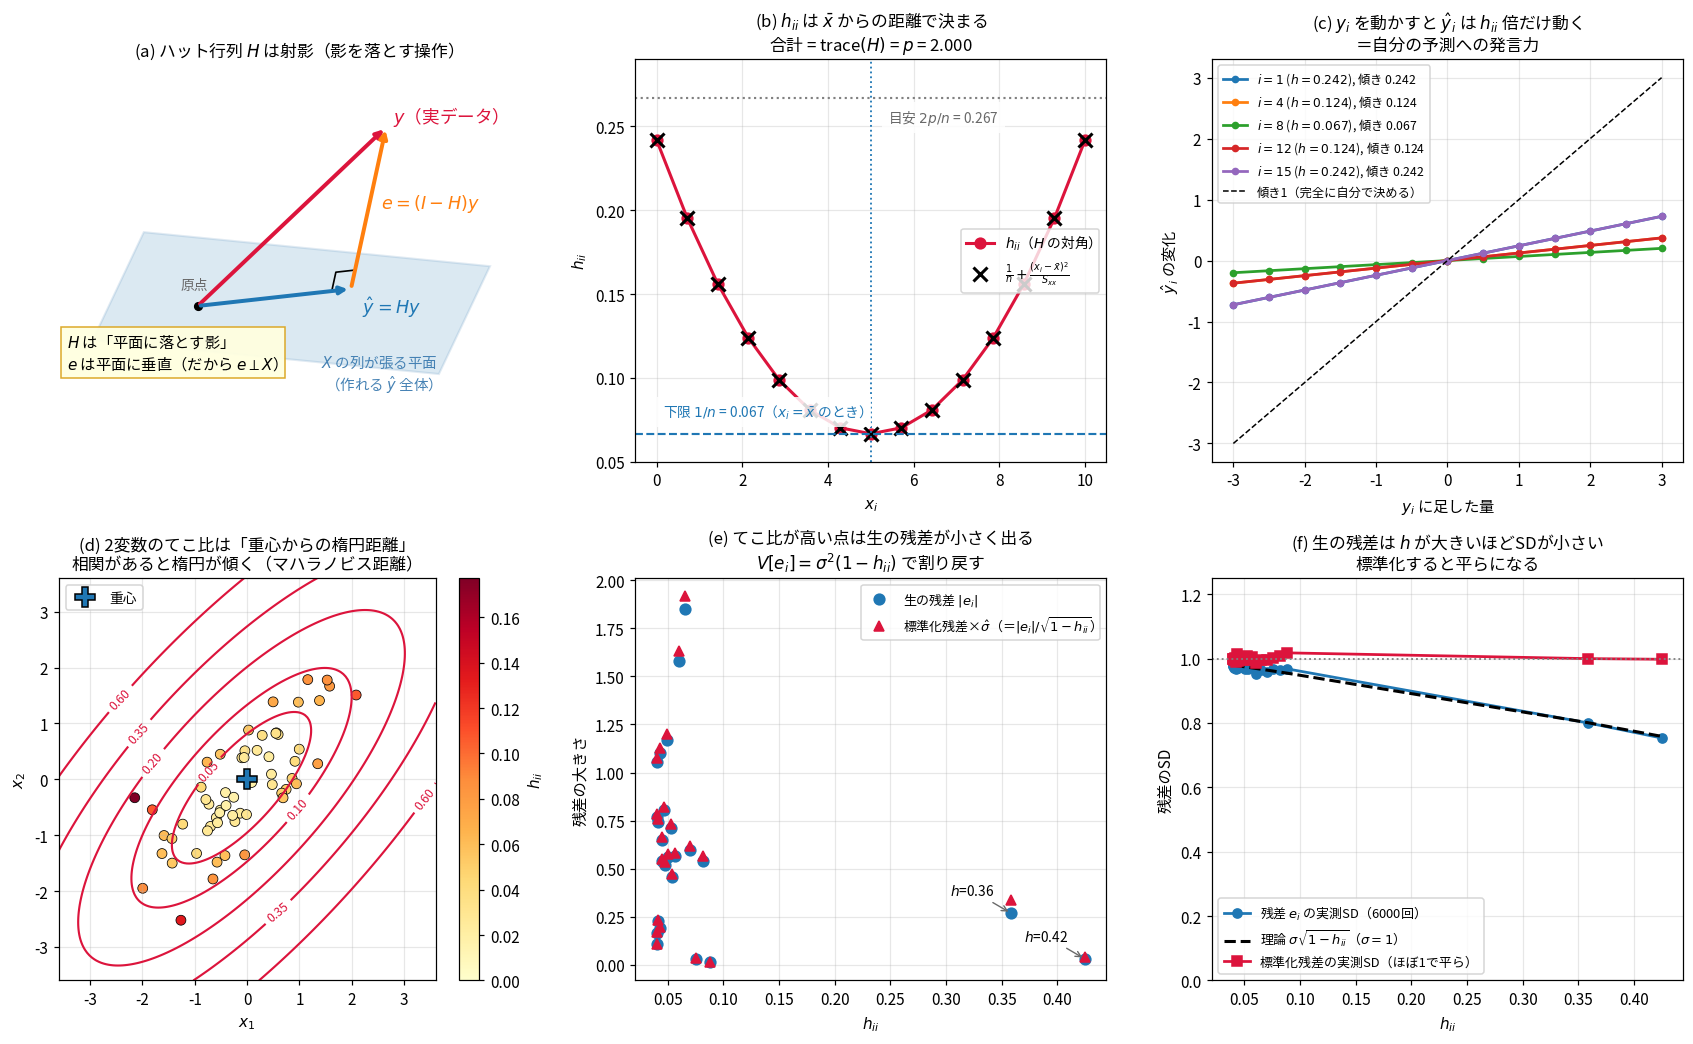
(a) ハット行列という名前の由来。 を使うと と書けます。 に帽子(hat)をかぶせる行列なのでハット行列です。やっていることは射影、つまり影を落とす操作だけです。 の列が張る平面が「作れる予測値の全体」で、 は をそこに垂直に落とす。落とした先が 、落ちた差が残差 です。
の実例で確認しました。 に対して 、残差 。
ピタゴラスの定理が成立しています。残差と列空間の直交も 、 で確認できました。前回の「最小二乗法は射影」がそのまま再登場した形です。
(b) てこ比は からの距離で決まる。 単回帰なら閉じた式が書けます。
図の×印がこの式の値で、実測との最大誤差は でした。ここから3つの性質が読めます。
| 性質 | 内容 | 実測 |
|---|---|---|
| 下限 | のとき最小値 (切片があるとき。なければ下限は0) | 0.0667(=15) |
| 上限 | 後述のアンスコムで 1.000 を実現 | |
| 合計 | 2.000000(=2) |
合計が になるのは前回の と同じ話です。だから平均は で、目安の や は「平均の2〜3倍」という発想から来ています。
(c) ここがてこ比の意味そのものです。 を1だけ動かすと はどれだけ動くか、を実験しました。
| 観測 | 実測の傾き | 差 | |
|---|---|---|---|
| 0.241667 | 0.241667 | ||
| 0.123810 | 0.123810 | ||
| 0.066667 | 0.066667 | ||
| 0.123810 | 0.123810 | ||
| 0.241667 | 0.241667 |
完全に一致しました。つまり
で、自分の予測値を自分でどれだけ決めているかの割合です。 なら回帰線はその点を必ず通る(他の点の意見が一切入らない)。 なら、他の点と平等に しか発言していない。これが「てこ比」という訳語の意味でした。
(e)(f) 実務上の落とし穴。 残差の分散は一定ではありません。
6000回のシミュレーションで、生の残差の実測SDが理論の と一致することを確認しました(最大誤差 0.0166)。標準化すると 0.986〜1.018 で平らになります。
これが意味するのは、てこ比が高い点は生の残差が小さく出るということです。実測では の点の残差が 0.030 しかありませんでした。 倍に補正して初めて他の点と比較できます。
生の残差プロットだけを見ていると、いちばん危険な点が「よくあてはまっている」ように見える。 これがてこ比を別途チェックすべき理由です。
3つの残差と、クック距離の定義
診断量の定義をまとめます。前提として (生の残差)、 はパラメータ数、 です。
① てこ比
を使わないのが特徴です。目安は (甘め)または (厳しめ)。
② 標準化残差(内部スチューデント化残差)
で割って点どうしを比較できるようにしたものです。 分布には従いません。分母の の中に分子の 自身が入っているので、分子と分母が独立でないためです。
では何に従うかというと、 が に従います。ベータ分布は に台を持つので、、つまり という上限がここから出ます。=12、=2 で6万回まわしたときの は 3.0723 で、上限 3.1623 に届きませんでした。
③ スチューデント化残差(外部・削除残差)
はその点 を抜いて計算した誤差の標準偏差です。こうすると分子と分母が独立になり、ちょうど に従います。だから「この点は外れ値か」を検定できます。
右側の等式が実用上ありがたいところで、 回の再フィットをしなくても から変換できることを意味します。
④ クック距離
左が定義( は点 を抜いて再推定した予測値)、右が計算式です。「その1点を抜いたら、全部の予測値がどれだけ動くか」を で割って無次元化したものです。
自作モジュールで両者が一致することを確認しました(最大誤差 )。定義どおり 回再フィットした結果と、右の式が完全に同じ値になります。
4つの関係を1行で。
は だけの量、 は のズレを 分布に載せた量、 はその2つの掛け算。 は を計算する途中に出てくる中間量、という位置づけです。
なぜ「自分を抜く」というひと手間が必要なのか
定義だけ見ると③の は面倒に思えます。実験して理由を確かめました。
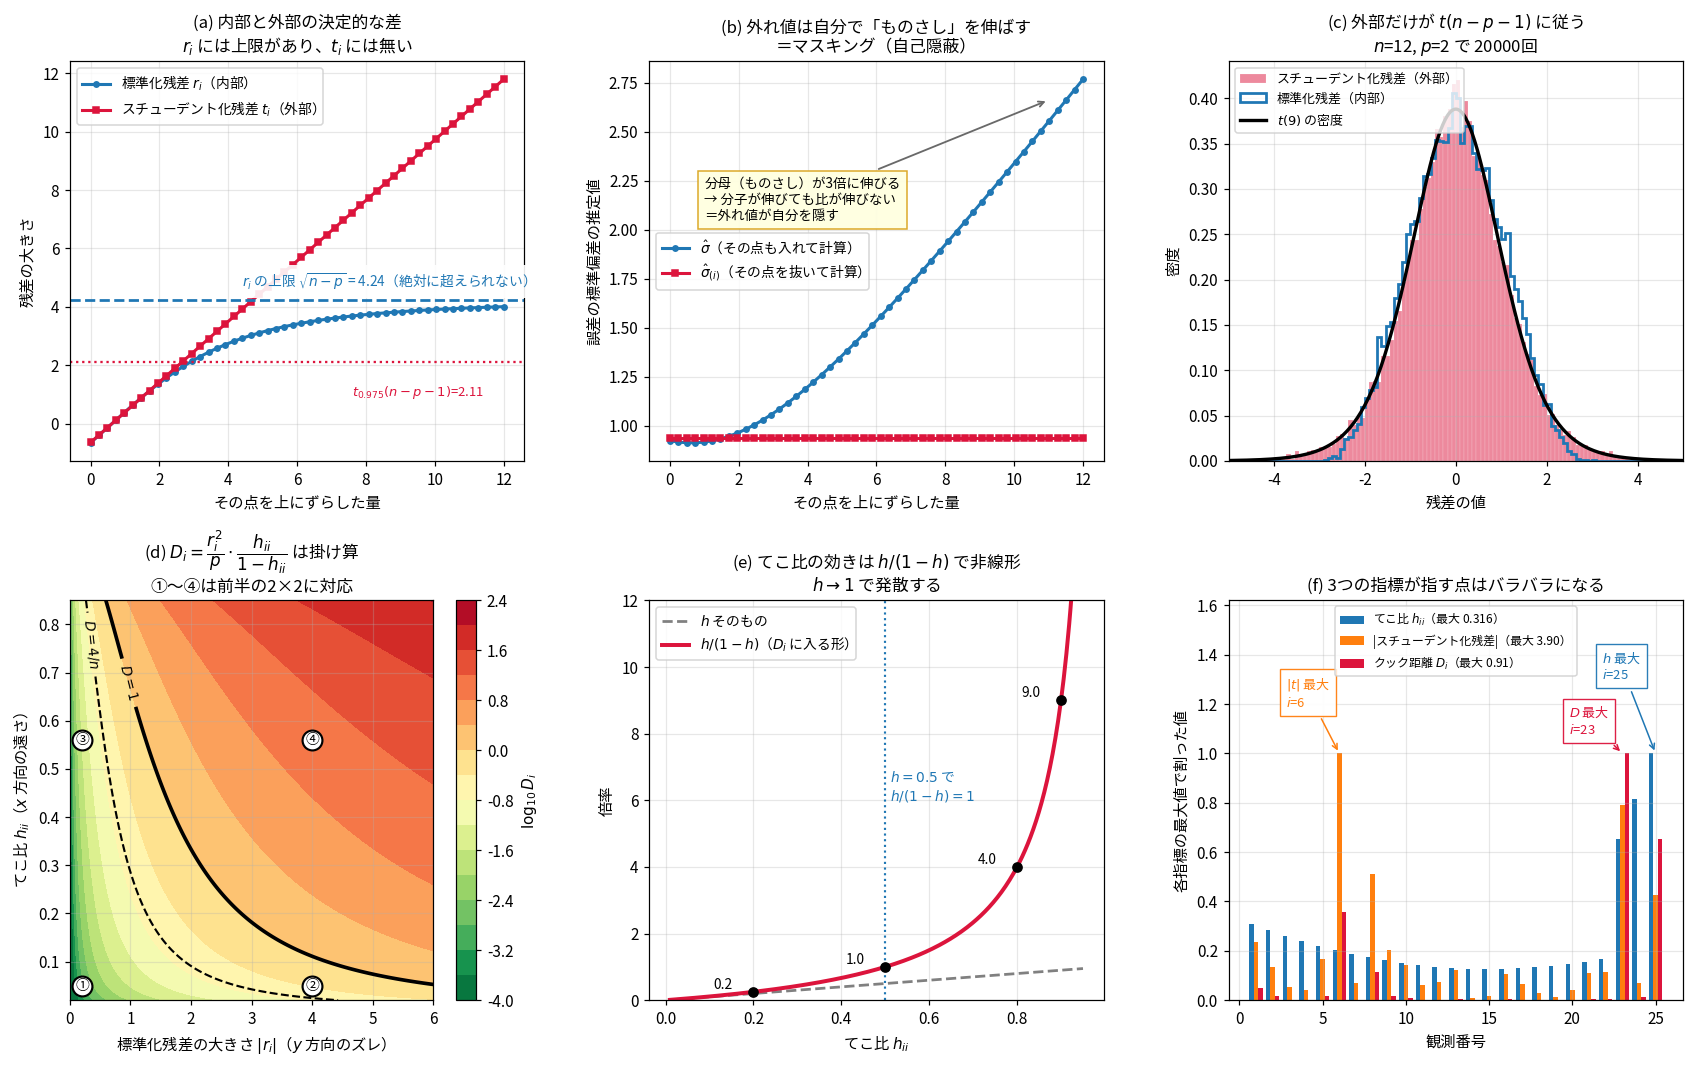
(a) 1点を上へずらしていくと、内部と外部で挙動が正反対になります。
| ずらした量 | 標準化残差 (内部) | スチューデント化残差 (外部) | (全部) | (自分抜き) |
|---|---|---|---|---|
| 0.00 | −0.658 | −0.647 | 0.925 | 0.940 |
| 4.90 | 3.106 | 4.430 | 1.341 | 0.940 |
| 8.57 | 3.794 | 8.238 | 2.041 | 0.940 |
| 12.00 | 4.005 | 11.792 | 2.768 | 0.940 |
青(内部)は 4.005 で飽和して止まります。この実験は =20・=2 なので、理論上限 を超えられないためです(上限は で変わります。次の (c) は =12 なので 3.162 が壁になります)。赤(外部)は 11.79 までまっすぐ伸びます。
(b) 原因はこれです。 が 0.925 から 2.768 へ、つまり3倍に膨らんでいます。一方 は 0.940 のまま不動。
つまり外れ値は自分自身でものさしを伸ばして、自分を平凡に見せてしまう。これをマスキング(自己隠蔽)と呼びます。分子(残差)が伸びても分母(ものさし)が同じ倍率で伸びるので、比が伸びないわけです。
(c) 分布も確認しました。 、 で2万回まわして分位点を照合します。
| 分位点 | 外部の実測 | の理論値 | 差 |
|---|---|---|---|
| 5% | −1.8440 | −1.8331 | −0.0108 |
| 25% | −0.6860 | −0.7027 | +0.0167 |
| 75% | +0.7046 | +0.7027 | +0.0019 |
| 95% | +1.8244 | +1.8331 | −0.0087 |
| 97.5% | +2.2490 | +2.2622 | −0.0131 |
| 99% | +2.8025 | +2.8214 | −0.0190 |
外部は にきれいに従っています。内部の実測範囲は で、 の壁で切られていて裾が足りません。
マスキングが実務で意味すること。
には という上限があるので、 が小さいほど天井が低い。 =12、=2 なら は 3.162 を絶対に超えないので、 「 を外れ値とする」という基準はこのサイズだとほぼ機能しません。
→ 外れ値の判定には必ず外部(スチューデント化残差)を使う。 これが「自分を抜く」ひと手間を払う理由です。
(d)(e) クック距離の2つの因子。 等高線で見ると、①〜④が前半の2×2にそのまま対応します。そして という形が非線形であることが効いてきます。
| てこ比 | |
|---|---|
| 0.10 | 0.111 |
| 0.20 | 0.250 |
| 0.50 | 1.000 |
| 0.80 | 4.000 |
| 0.90 | 9.000 |
| 0.95 | 19.000 |
| 0.99 | 99.000 |
で1倍、0.9 で9倍、0.99 で99倍。 で発散します。だからてこ比が 0.8 を超えたあたりから急に危険になるわけです。
(f) そして3つの指標は別の点を指しました。 これが「3つとも見る必要がある」ことの実演です。
| てこ比 | スチューデント化残差 | クック距離 | この点の正体 | ||
|---|---|---|---|---|---|
| 6 | 1.43 | 0.064 | 3.90 | 0.324 | が中央の外れ値。 は最大だが は中くらい |
| 23 | 11.00 | 0.206 | −3.09 | 0.906 | 高影響点。 も も単独では1位でないのに が最大 |
| 25 | 13.00 | 0.316 | 1.66 | 0.591 | 高てこ比。 は最も遠いが直線に近いので は小さい |
最大は =25、 最大は =6、 最大は =23。3つとも違う点です。 どれか1つだけ見ていると取りこぼします。
回帰の4つの仮定と、確認する方法
ここから後半です。診断の対象になる仮定を先に並べます。
| 仮定 | 式で書くと | 崩れると何が起きるか | 確認方法 |
|---|---|---|---|
| 線形性 | 自体が偏る(バイアス) | 残差 vs 予測値・残差 vs 各説明変数 | |
| 独立性 | は不偏だがSEが壊れる | 残差 vs 観測順・DW | |
| 等分散性 | ( に依らない) | は不偏だがSEが壊れる | 残差 vs 予測値・BP検定 |
| 正規性 | が小さいときだけ区間と検定が歪む(ただし個々の の予測区間は に関係なく歪む) | 正規Q-Qプロット |
この表の3列目が今回の要点です。 崩れ方が2種類に分かれます。線形性の破れは を偏らせるのでモデルを直すしかない。一方、独立性と等分散性の破れは を偏らせずSEだけを壊すので、SEの計算法を替えれば済みます。
正規性だけ性質が違って、 が大きければ中心極限定理で救われます。第13回で検定の頑健性を扱ったときと同じ構図です。「正規性がいちばん重要そう」と思いがちですが、実は4つの中でいちばん優先度が低いというのが今回の学びでした。
残差プロットの判断表
過去問では図の読み取りが問われやすいので、6パターンを同じ形式で並べました。すべて横軸に予測値 、縦軸に標準化残差です。オレンジの線は移動平均で、傾向を見やすくするために引きました。
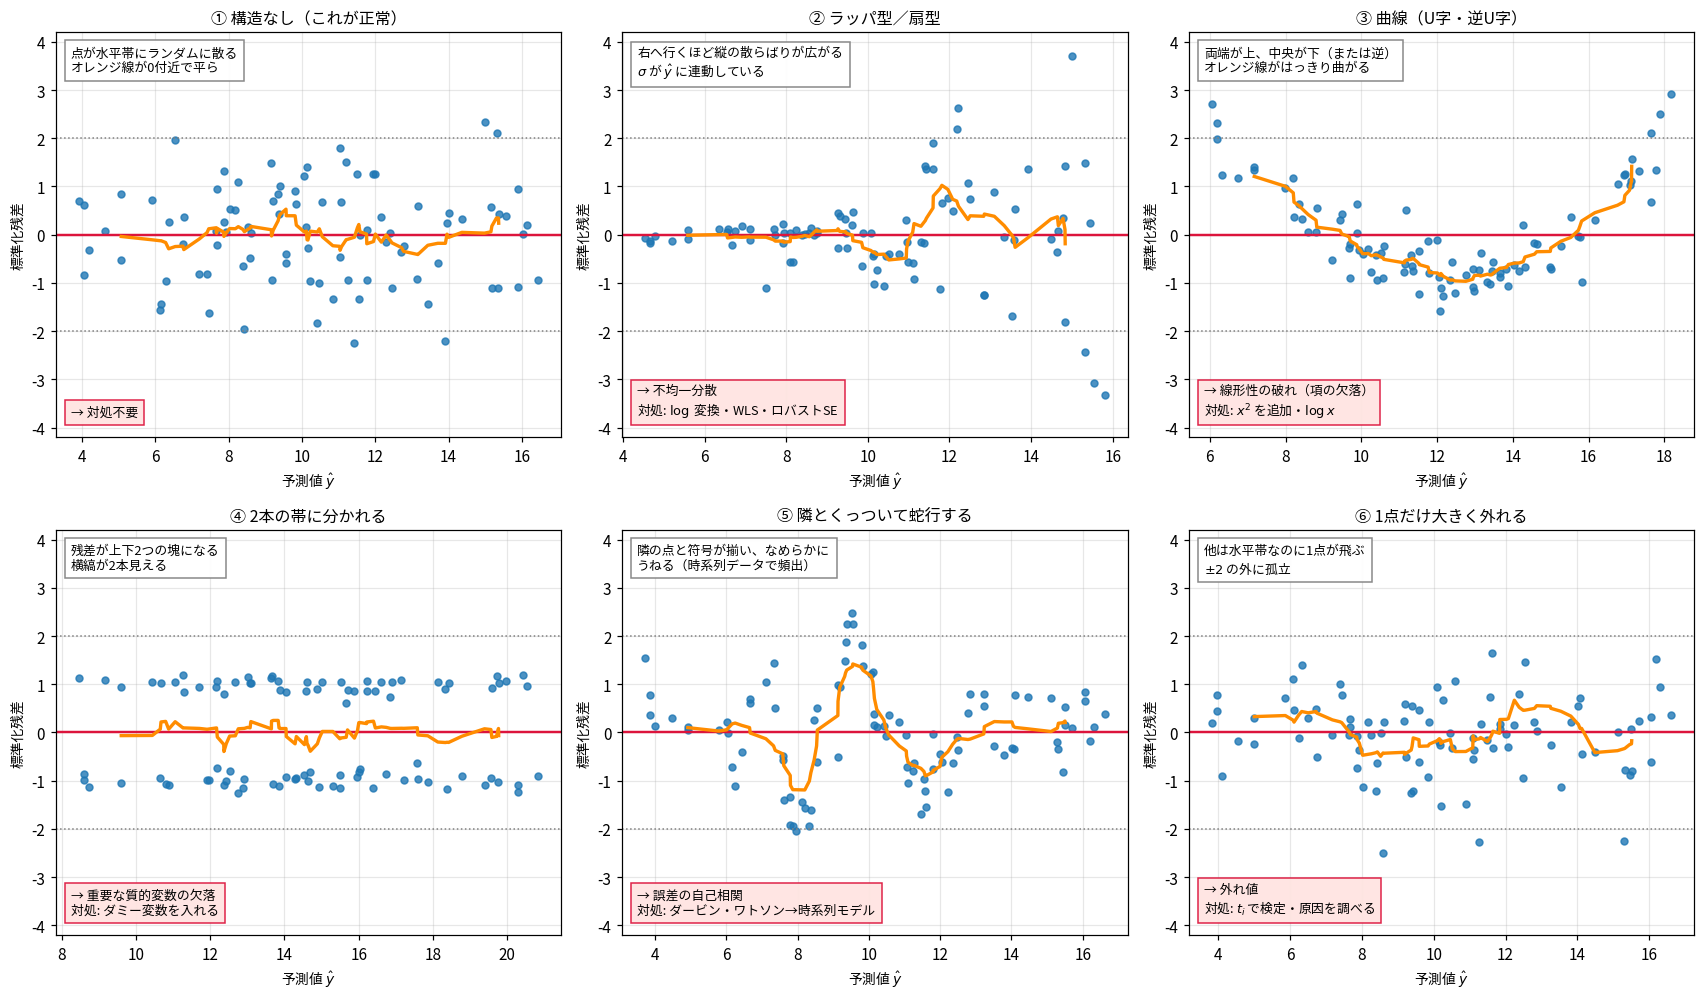
| パターン | 見え方 | 疑うこと | 対処 |
|---|---|---|---|
| ① 構造なし | 水平の帯にランダム | 問題なし | なし |
| ② ラッパ型・扇型 | 右(または左)へ広がる | 不均一分散 | 対数変換・WLS・ロバストSE |
| ③ 曲線(U字・逆U字) | 両端が上、中央が下 | 線形性の破れ(2次項の欠落) | を追加・・スプライン |
| ④ 2本の帯に分かれる | 残差が上下2つの塊 | 質的変数の欠落(群構造) | ダミー変数を入れる・層別 |
| ⑤ なめらかに蛇行 | 隣の点と符号が揃う | 誤差の自己相関 | DW → HAC標準誤差・時系列モデル・一般化最小二乗法 |
| ⑥ 1点だけ飛ぶ | 他は水平帯、1点が孤立 | 外れ値 | で検定・原因を調べる |
同じデータの診断量も出しました。
| パターン | DW | 最大 | 最大 | BP検定のp値 | |
|---|---|---|---|---|---|
| ① 構造なし | 0.893 | 1.93 | 2.41 | 0.097 | 0.242 |
| ② ラッパ型 | 0.461 | 1.19 | 4.00 | 0.294 | 0.0000 |
| ③ 曲線 | 0.641 | 0.31 | 3.05 | 0.228 | 0.469 |
| ④ 2本の帯 | 0.339 | 2.20 | 1.27 | 0.037 | 0.741 |
| ⑤ 蛇行 | 0.930 | 0.34 | 2.55 | 0.067 | 0.050 |
| ⑥ 外れ値1点 | 0.896 | 1.96 | 7.14 | 0.326 | 0.272 |
この表を作っていて2つ気づきました。
1つめ。③の が 0.641 でそれなりに高く、⑥の は 0.896 で①の 0.893 とほぼ同じです。 という数字だけ見ていたら、③も⑥も見逃します。
2つめが自分で驚いたところで、③の DW が 0.31 になっています。③は誤差を完全に独立に生成しているのに、自己相関の指標が「強い正の自己相関」を示しました。
理由を考えると納得できます。 でソートされたデータに曲線があると、直線をあてはめた残差は「左は正、中央は負、右は正」となめらかに変化します。すると隣同士が似るので、自己相関として検出されてしまう。実際に を入れて曲線を吸収したら DW が 2.09 に戻りました(後述)。
DW が小さいときは、まず線形性を疑う。 自己相関と決めつけて時系列モデルに走ると誤診します。手順は 「①残差 vs で曲線がないか確認 → ②なければ自己相関を疑う」。
横軸に何を取るかで見えるものが変わる
| プロット | 何が見えるか |
|---|---|
| 残差 vs 予測値 | 不均一分散・線形性の破れ。まずこれを描く |
| 残差 vs 各説明変数 | どの変数のせいで曲がっているか。原因の特定用 |
| 残差 vs 観測順・時間 | 自己相関。時系列やロット順のデータでは必須 |
| 正規Q-Qプロット | 正規性。直線から外れる=裾が重い・軽い、S字=歪み |
| vs | 不均一分散の専用版。絶対値なので上下の折り返しがなく傾きが見やすい |
| てこ比 vs 標準化残差 | 影響力。クック距離の等高線を重ねると2×2がそのまま読める |
なぜ横軸に を取るのかというと、残差と予測値は直交している(前回の話)ので、仮定が正しければ無相関に見えるはずだからです。構造が見えたらそれは仮定の破れです。 を横軸にすると残差と相関してしまうので間違いです。
不均一分散:壊れるのは推定値か標準誤差か
ここは区別が大事だと思ったので、実測で切り分けました。(0.3 から 3.3 まで11倍の差)というかなり強い不均一分散を作り、8000回まわします。
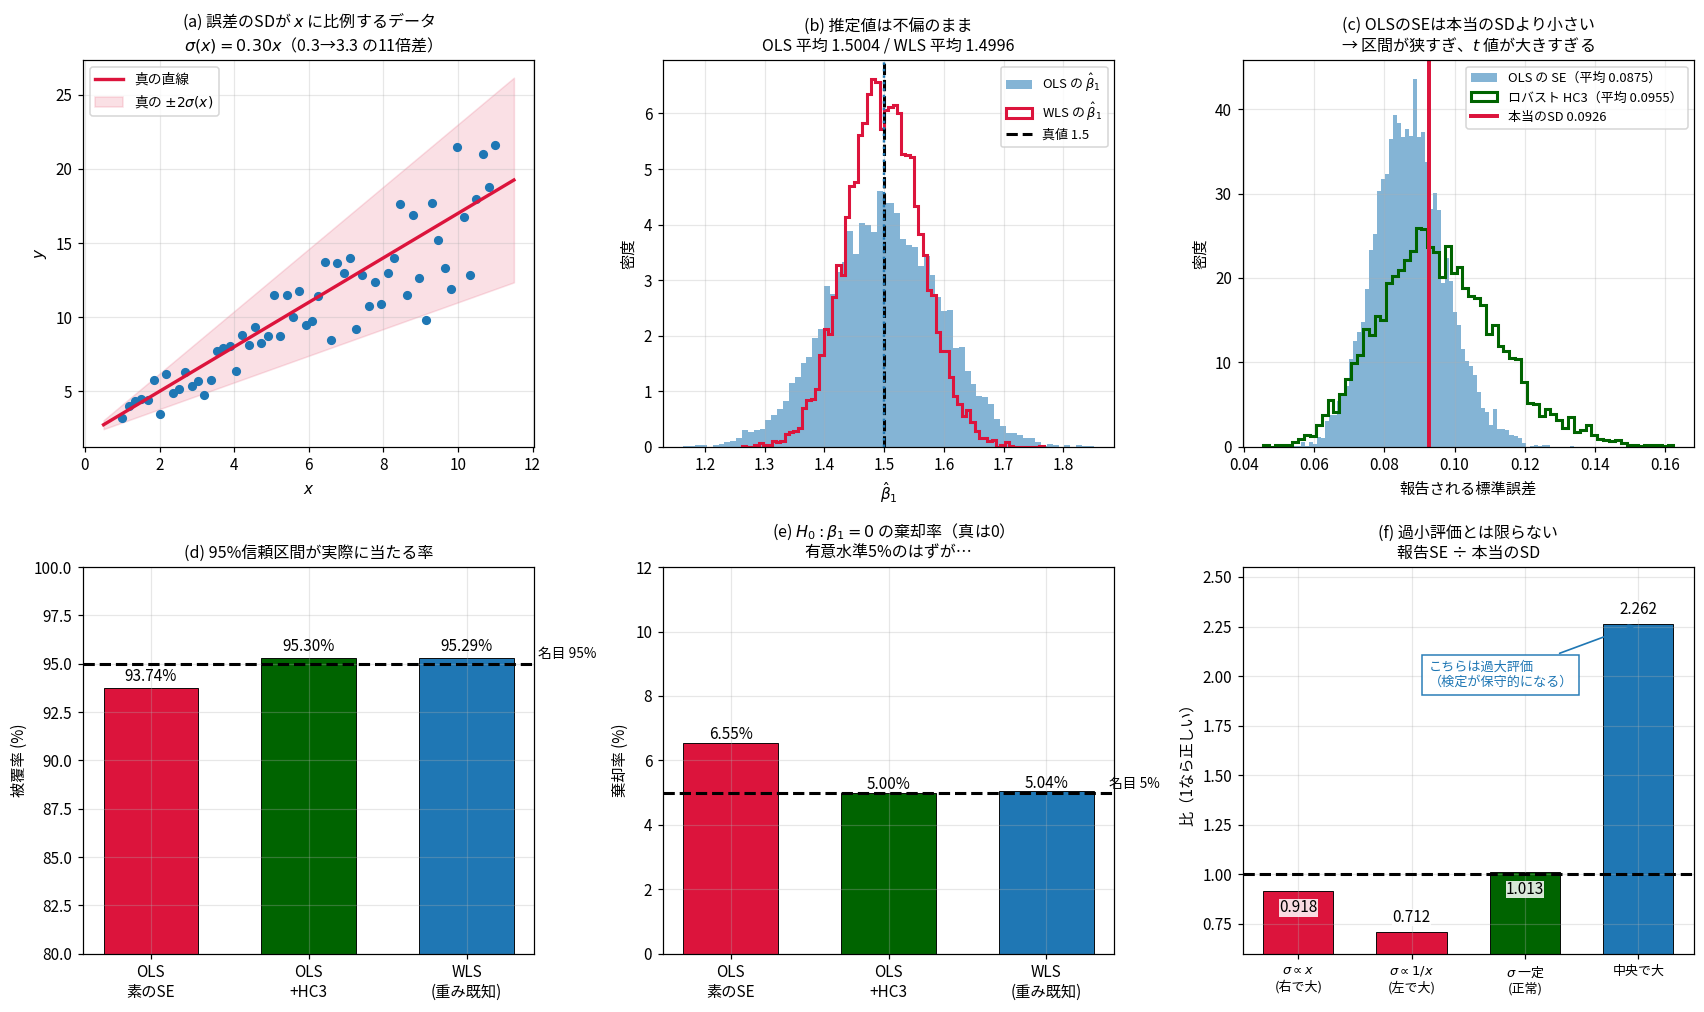
まず結論。推定値はまったく壊れていません。
| 手法 | 傾きの平均(真値 1.5) | 偏り |
|---|---|---|
| OLS | 1.500377 | |
| WLS(重み既知) | 1.499557 |
壊れているのは標準誤差です。
| 量 | 値 | 本当のSDとの比 |
|---|---|---|
| 傾きの本当のSD(8000回の実測) | 0.092602 | 1.000 |
| OLS が報告するSEの平均 | 0.087462 | 0.944(過小評価) |
| ロバスト(HC3)SEの平均 | 0.095465 | 1.031 |
その結果どうなるか。
| 手法 | 95%信頼区間の被覆率 | の棄却率(真は0) |
|---|---|---|
| OLS の素のSE | 93.74% | 6.55%(名目5%の1.31倍) |
| OLS + ロバストSE(HC3) | 95.30% | 5.00% |
| WLS(重み既知) | 95.29% | 5.04% |
答え:壊れるのは標準誤差です。推定値は不偏のまま。
式で追えます。 なので、 でありさえすれば分散がどうなっていようと 。 不偏性は「誤差の平均がゼロ」しか使っていません。
一方 は「全部の点で が同じ」を使って導いた式なので、 そこが崩れると使えません。正しくは
( は誤差の分散共分散行列)。この形をサンドウィッチ型と呼び、 の対角だけを残差の2乗で置き換えたのがロバスト標準誤差です。 逆に言えば、HC系は が対角(=不均一分散だけ)を前提にしているので 自己相関には効きません(後述の自己相関には HAC=Newey-West 標準誤差を使います)。
→ 実務的には「係数の値は信じていい、p値と信頼区間は信じるな」という判断になります。
「必ず過小評価」は間違いだった
教科書でよく「不均一分散はSEを過小評価する」と書かれます。私もそう覚えていたのですが、実測すると向きが変わりました。
| 分散の形 | 報告SE ÷ 本当のSD | 結果 |
|---|---|---|
| (右で大) | 0.918 | 過小評価 → 偽陽性が増える |
| (左で大) | 0.712 | もっと過小評価 |
| 一定(正常) | 1.013 | 正しい |
| 中央で大・端で小 | 2.262 | 過大評価 → 検定が保守的になり見逃しが増える |
鍵はてこ比との相関でした。 てこ比が高い点( が端)の分散が大きいとSEは過小評価になり、逆にてこ比が低い点(中央)の分散が大きいと過大評価になります。
考えてみれば当然で、 は全部の残差を平均した「代表値」です。代表値が、効きの強い点(高てこ比)の実際の分散より小さければSEは小さすぎ、大きければ大きすぎになる。「不均一分散があると危険」は正しいですが、「必ず甘くなる」は誤りでした。
3つの対処法の使い分け
| 対処 | やること | 効果(実測) | いつ使うか |
|---|---|---|---|
| ロバスト標準誤差 | 係数はOLSのまま、SEの計算式だけ差し替える | 被覆率 93.74% → 95.30%/偽陽性 6.55% → 5.00% | 第一選択。 分散の形を知らなくてよい。 が小さいときは HC3 |
| 加重最小二乗法(WLS) | 各点を で重み付けして解く | 被覆率 95.29%/さらに分散が 55.5% 減る(SD 0.0926 → 0.0618) | 分散の形に見当がつくとき。効率が上がる |
| 変数変換 | を にする | BP検定のp値が 0.003 → 0.546(後述) | 誤差が乗法的なとき |
WLSが効率を上げる理由は、ばらつきの小さい点(信頼できる観測)を重く、大きい点を軽く扱うからです。分散が 55.5% 減るというのは、同じ精度を得るのに必要な標本が半分以下になるということです。
ただし WLS が最良になるのは重み が(比だけでも)分かっているときです。分散の形をデータから推定して重みにすると、その推定の不確実性が入るので保証は消えます。だから第一選択がロバスト標準誤差なのでした。
ここで前回のガウス・マルコフの定理と繋がります。あの定理は「等分散のもとでOLSが最良」と言っていました。つまり裏を返せば、等分散でなければOLSより良いものがあるという宣言でもあったわけです。WLSがまさにそれでした。
対数変換すると解釈はどう変わるか
変数変換は不均一分散の対処として出てきますが、係数の意味が変わるのが厄介なところです。ここを数値で確かめました。
真のモデルを 、つまり誤差が掛け算で入る形にします。売上や PV のように「何割増える」という性質の量はこうなりがちです。
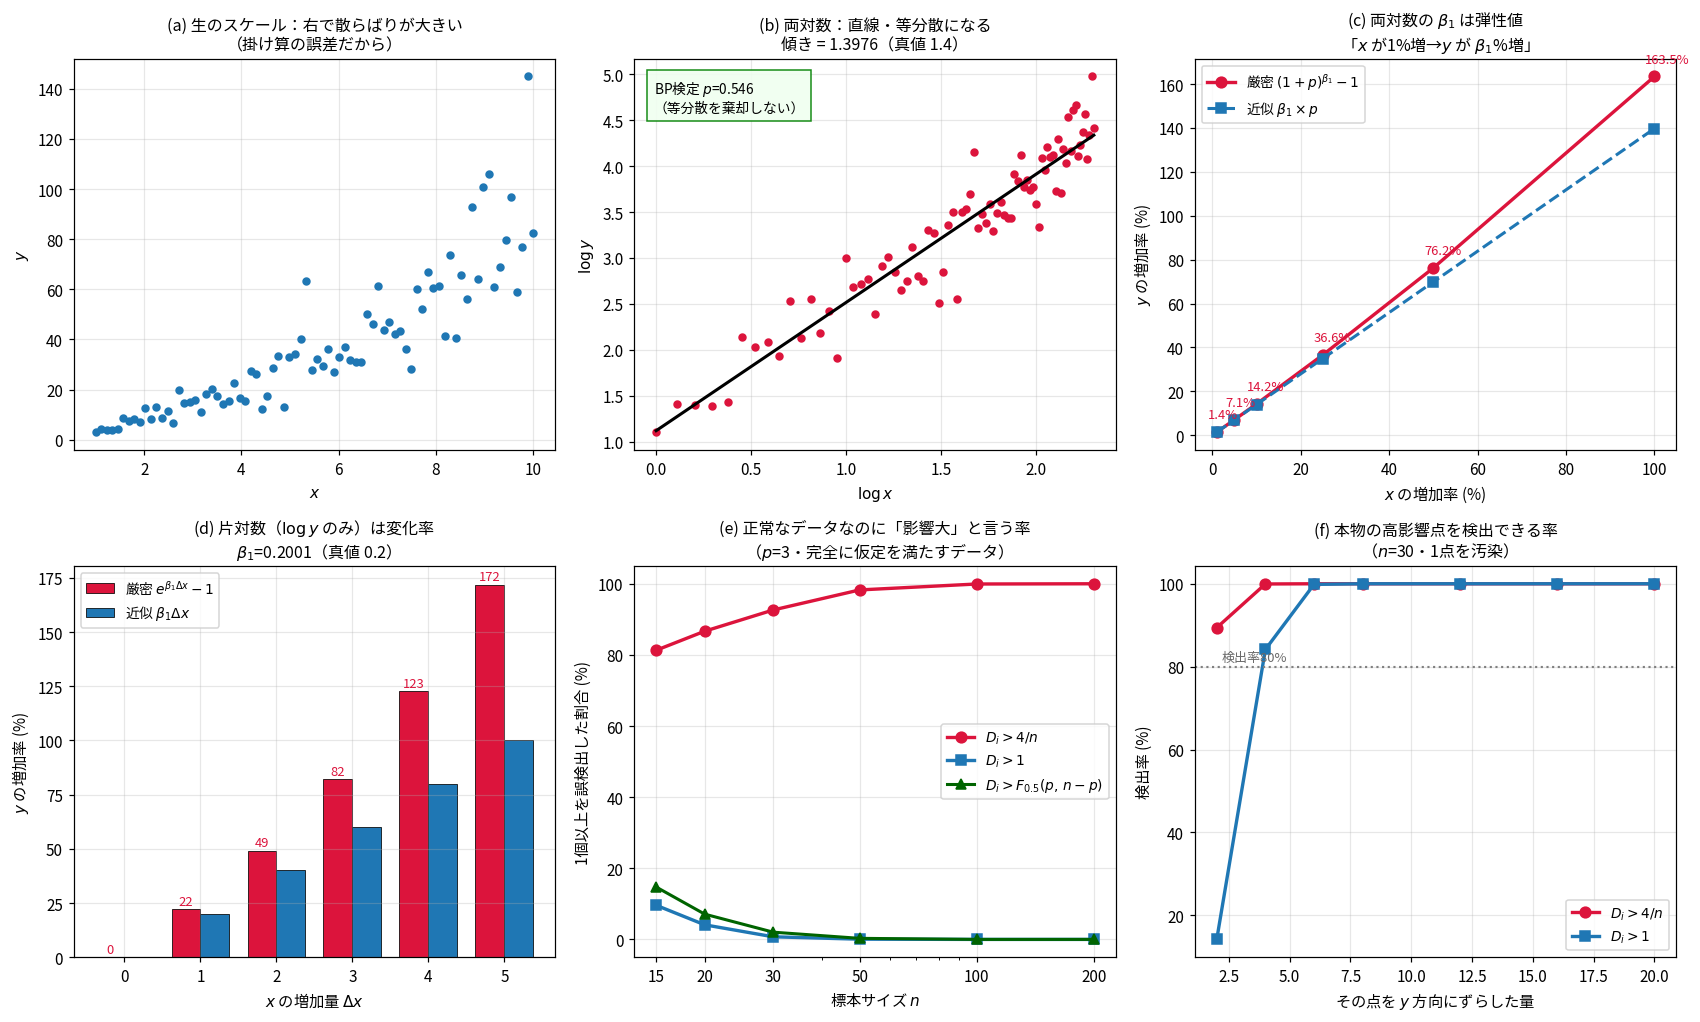
(a)(b) 変換が効く仕組み。 生のスケールだと右へ行くほど散らばりが大きく、そのまま回帰すると BP検定のp値が 0.0029 で不均一分散が検出されます。両辺の対数を取ると
で、直線かつ等分散になります。推定値は傾き 1.3976(真値 1.4)、切片 1.1191(真値 )、BP検定のp値は 0.546 で等分散を棄却しません。
掛け算の誤差は を取ると足し算になる。 これが変換の原理でした。逆に言えば、誤差が最初から足し算で入っているデータに対数変換をしても意味がない(むしろ壊す)ことになります。
(c) 両対数の傾きは弾性値です。
| の増加率 | の増加率(厳密) | 近似 | ズレ |
|---|---|---|---|
| 1% | 1.400% | 1.398% | 0.003% |
| 5% | 7.057% | 6.988% | 0.069% |
| 10% | 14.249% | 13.976% | 0.272% |
| 25% | 36.598% | 34.940% | 1.657% |
| 50% | 76.242% | 69.881% | 6.361% |
| 100% | 163.466% | 139.762% | 23.704% |
1%の変化なら近似がほぼ完璧ですが、100%の変化だと厳密 163.5% 対 近似 139.8% で大きく外れます。「1%増えると % 増える」は小さな変化に限った近似でした。
(d) 片対数( だけ対数)の場合。
| の増加率(厳密) | 近似 | |
|---|---|---|
| 1 | 22.15% | 20.01% |
| 2 | 49.20% | 40.01% |
| 3 | 82.24% | 60.02% |
| 5 | 171.91% | 100.03% |
なので「 が1増えると が約20%増える」と読みますが、 では厳密 171.9% 対 近似 100.0% とまったく合いません。複利で効くので当然です。
4つのモデルを整理します。
| モデル | 式 | の読み方 | 厳密な式 | 呼び名 |
|---|---|---|---|---|
| そのまま | が1単位増えると が 単位増える | — | — | |
| 片対数( のみ) | が1単位増えると が約 % 増える | % | 成長率・半弾性値 | |
| 片対数( のみ) | が1%増えると が約 単位増える | — | ||
| 両対数 | が1%増えると が約 % 増える | % | 弾性値 |
対数変換の副作用(3つとも実務で踏みます)。
① を変換前後で比べてはいけない。 上の例では 0.772 から 0.903 に上がりましたが、 と では被説明変数が別物なので TSS の意味が違います。比較は無意味です。
② 予測値を戻すときに偏りが出る。 は ではなく中央値の推定になります。 理由は2段階です。(1) は単調増加なので分位点をそのまま移すため、 の中央値(正規なら平均と同じ)を戻すと の中央値になる。 (2) 一方 とは一致せず必ず下回る——ここで が凸であることから イェンセンの不等式が効きます。平均が欲しいなら のような補正が必要です。
③ ゼロや負の値には使えない。 で逃げる手はありますが、 係数の解釈が「%」から崩れるので安易に使うと意味を失います。
なお Box-Cox 変換は
という族の中から を最尤法で選ぶ方法です。 なら変換不要、0.5 なら平方根、0 なら対数、 なら逆数。「どの変換がよいか」をデータに決めさせる枠組みで、 の信頼区間が1を含むなら変換しないという判断ができます。
クック距離の閾値は 4/n か 1 か
諸説あって混乱していたので、決着をつけました。完全に仮定を満たす正常なデータを作り、誤検出率を測ります(=3、各条件3000回)。
| の値 | で誤検出 | で誤検出 | で誤検出 | |
|---|---|---|---|---|
| 15 | 0.267 | 81.3% | 9.6% | 14.7% |
| 20 | 0.200 | 86.7% | 4.1% | 7.1% |
| 30 | 0.133 | 92.6% | 0.7% | 2.0% |
| 50 | 0.080 | 98.3% | 0.1% | 0.3% |
| 100 | 0.040 | 99.9% | 0.0% | 0.0% |
| 200 | 0.020 | 100.0% | 0.0% | 0.0% |
=200 の正常なデータで誤検出率100%。 つまり必ず誰かが引っかかります。
理由を最初は「 が増えると は0に近づくのに の分布は縮まないから」だと考えたのですが、これは間違いでした。確かめると の分布も同じ速さで縮んでいます。
| の実測 | 1点あたりの | 引っかかる個数の平均 | |||
|---|---|---|---|---|---|
| 15 | 0.09551 | 0.08333 | 2.79 | 8.7% | 1.30 |
| 30 | 0.03903 | 0.03704 | 3.42 | 6.6% | 1.98 |
| 50 | 0.02201 | 0.02128 | 3.63 | 6.0% | 3.00 |
| 100 | 0.01051 | 0.01031 | 3.81 | 5.7% | 5.71 |
| 200 | 0.00512 | 0.00508 | 3.91 | 5.4% | 10.71 |
なので、 は によらず常に「平均の約4倍」=上位5〜9%あたりの位置に張り付いています。つまり は絶対的な基準ではなく、最初から「上位数%を拾う線」なのです。
なお厳密には で、 に一致するのは全部のてこ比が に揃っているときだけです。 が凸関数なのでイェンセンの不等式により常に 以上になり、 が小さいほど上振れします(=15 で 1.14倍、=200 で 1.007倍)。
そして本当の原因は多重比較でした。1点あたり5〜9%の判定を 個くり返すので、少なくとも1個が引っかかる確率はほぼ で、=200 なら実質1になります。実測でも平均10.71個が引っかかっていました。
第16回で「無意味な変数100本のうち5.55本が偽陽性になる」という話をしましたが、まったく同じ構造です。検定を 回くり返せば、5%水準なら 件は必ず出ます。
逆側(本物を見逃さないか)も測りました。=30 で1点を汚染します。この実験では汚染点を 方向にも遠い位置に置いています(前半のケースCと同じ状況)。
| 汚染の大きさ( をずらした量) | で検出 | で検出 |
|---|---|---|
| 2.0 | 89.4% | 14.2% |
| 4.0 | 100.0% | 84.2% |
| 6.0 | 100.0% | 99.9% |
置く位置を重心に変えると結果が一変します。
| 汚染点の位置 | ずらし量 | で検出 | で検出 |
|---|---|---|---|
| 方向にも遠い位置(上の表と同じ) | 2.0 | 89.4% | 14.2% |
| 方向にも遠い位置 | 6.0 | 100.0% | 99.9% |
| 重心 | 2.0 | 0.0% | 0.0% |
| 重心 | 6.0 | 99.6% | 0.0% |
重心に置いた場合、 を6ずらしても の検出率は0%です。これは欠陥ではなく仕様で、クック距離は影響力の指標なので「影響していない外れ値」は当然拾いません(前半のケースAそのものです)。 なら 99.6% 拾えるので、目印としての が役に立つ場面でもあります。いずれにせよ との併用が必要になります。
結論: は「閾値」ではなく「並べ替えて上位を見るための目印」です。
- … 感度は高い(小さい汚染も89%拾う)が偽陽性だらけ。 「 を降順に並べて上から数点を目で見る」出発点として使う。 「 を超えたら異常」と読んではいけない
- … 超えたらほぼ確実に本物( で誤検出1%未満)。ただし小さい影響は見逃す
- 実務的な答え … 閾値で自動判定しようとしないこと。全点プロットして「他から突き抜けている点があるか」を相対的に見るのが本来の使い方
前半の重回帰の例で、1点だけが他の86倍だったように、 本物の高影響点は相対的に明らかに浮きます。
表の3列目にある について補足します。 は形の上では「 の信頼楕円体の上をどれだけ移動したか」を測っていて、F統計量と同じスケールになります。そこから Cook 自身は「 なら、1点抜くと が50%信頼領域の外に出る」という読み方を提案しました。実測すると は 0.835 から 0.791 と1に近い値で、誤検出率も とほぼ同じでした。よく使われる「」という目安は、この を丸めたものだと理解できます。
が大きいときは より DFBETAS(係数ごとの変化を標準化した量、目安 )や DFFITS(目安 )のほうが「どの係数が動いたか」まで分かって実用的です。
誤差の自己相関とダービン・ワトソン比
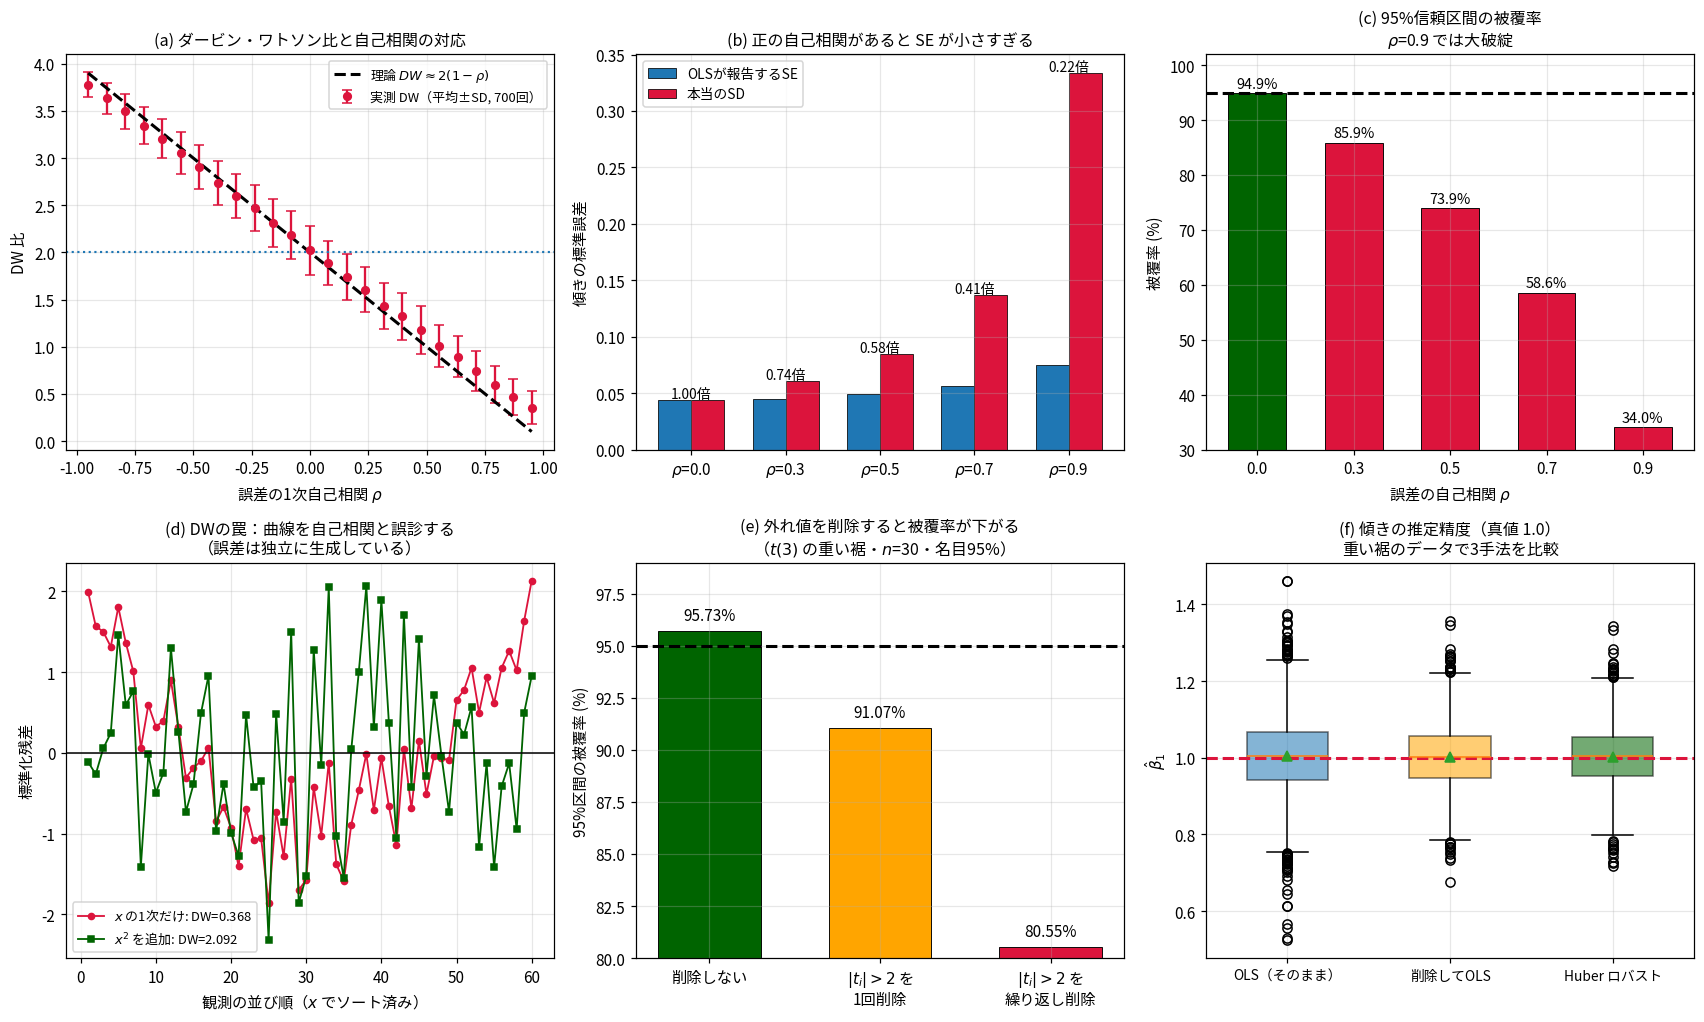
DW比の定義はこれです。
(a) 実測で近似式を確認しました。
| 実測 DW | 理論 | 差 | |
|---|---|---|---|
| −0.950 | 3.7775 | 3.9000 | −0.1225 |
| −0.475 | 2.9064 | 2.9500 | −0.0436 |
| 0.000 | 2.0216 | 2.0000 | +0.0216 |
| +0.475 | 1.1764 | 1.0500 | +0.1264 |
| +0.950 | 0.3540 | 0.1000 | +0.2540 |
範囲は 0〜4 で、2付近なら無相関、0に近ければ正の自己相関、4に近ければ負の自己相関。
が大きいところで理論とズレる(=0.95 で実測 0.354 対 理論 0.100)理由は2つあります。1つは回帰が誤差の滑らかな成分を直線に吸収してしまうので、残差の自己相関が真の誤差より弱まること(=0.95 のとき真の誤差では 0.855 なのに残差では 0.791 でした)。もう1つは近似式が落としている端点項で、厳密には
です( と定義したとき厳密に成立します。実測で差は 台)。
この2つは逆向きに働きます。吸収効果は DW を上へ押し、端点項は必ず正なので下へ引く。=0.95 の系列で内訳を出すと、残差の自己相関 から 、そこから端点項 0.053 を引いて 0.365。上の表の 0.354 は多数回の平均なので完全一致はしませんが、理論値 0.100 との差の大半が吸収効果によるものだと分かります。正味では吸収効果が勝つので、正の自己相関のときは実測が理論値より大きく出ます。
(b)(c) 自己相関の害は不均一分散よりはるかに深刻でした。
| 報告SE | 本当のSD | 比 | 95%区間の被覆率 | |
|---|---|---|---|---|
| 0.0 | 0.0437 | 0.0438 | 0.998 | 94.87% |
| 0.3 | 0.0451 | 0.0607 | 0.743 | 85.90% |
| 0.5 | 0.0489 | 0.0843 | 0.581 | 73.93% |
| 0.7 | 0.0564 | 0.1369 | 0.412 | 58.57% |
| 0.9 | 0.0748 | 0.3336 | 0.224 | 34.03% |
=0.9 では被覆率が 34% まで崩壊します。不均一分散が 93.7% だったのと比べると桁違いです。
理由は直感的に言えて、自己相関があると「実質的な標本サイズ」が減るからです。隣の観測がほぼ同じ情報しか持っていないなら、 個あっても独立な情報は 個ない。それなのに で割ってしまうので過小評価になります。
ただし、ここでも「必ず過小評価」ではありませんでした。 不均一分散のときと同じ罠です。向きは の並び方で決まります(=0.7 で実測)。
| の設計 | 報告SE | 本当のSD | 比 |
|---|---|---|---|
| が単調増加(上の表の =0.7 と同じ) | 0.0564 | 0.1369 | 0.412(過小) |
| が 0,1,0,1,… と交替 | 0.3464 | 0.1563 | 2.216(過大) |
| が符号交替の鋸歯 | 0.0537 | 0.0244 | 2.198(過大) |
「実質的な標本サイズが減る」が効くのは、 自身も滑らかに動いていて、誤差の滑らかさと噛み合うときです。 が1つおきに反転する設計だと、正の自己相関は隣同士の差を安定させるので傾きの分散が下がり、SEは過大評価になります。
不均一分散では「てこ比との相関」で向きが決まりましたが、自己相関では「 の変動と誤差の変動の噛み合わせ」で決まる。同じ構図でした。
(d) 予告した罠の実演です。 誤差を完全に独立に生成した曲線データで DW = 0.368。 を入れて曲線を吸収したら DW = 2.092 に戻りました。DW が小さい原因は自己相関でなく線形性の破れだったわけです。
DW を使うときの注意点。
- 観測に意味のある順序がなければ計算しても無意味。 DW は「隣」を使うので、 並び順を変えると値が変わります。時系列・空間・ロット順など順序が実在するときだけ意味がある
- でソートしたデータでは曲線が自己相関に化ける(上の (d))
- 検定表は と の2つの臨界値を持ち、間に入ると「判定不能」になります。 これは分布が に依存して正確な臨界値が計算できないという事情から来ています
- 1次の自己相関しか見ません。季節性などはブロイシュ・ゴッドフレイ検定や Ljung-Box 検定を使います
- 見つかったときの対処は HAC(Newey-West)標準誤差が手軽です。不均一分散のロバストSEと同じ発想で、 の非対角成分まで拾います。構造をモデル化したいなら時系列モデルや一般化最小二乗法へ
外れ値は削除していいのか
いちばん実務的な問いです。数値で答えを出しました。 という重い裾の誤差(外れ値が自然に発生する)で =30、4000回の実験です。真のモデルは正常で、外れ値は分布の性質として出ているだけという設定です。
| 手続き | 95%区間の被覆率 | 区間幅の平均 |
|---|---|---|
| 削除しない | 95.73% | 0.3972 |
| を1回削除 | 91.07% | 0.2863 |
| を繰り返し削除 | 80.55% | — |
削除すると区間幅は 0.721倍に縮むので「精度が上がった」ように見えます。 ところが実際に当たる率は 95.73% から 91.07% へ下がり、繰り返すと 80.55% まで落ちます。
理由は同じデータで「外れ値を選ぶ」と「推定する」の両方をやっていることです。残差が大きい点を捨てる操作は を人為的に小さくするので、自分で自分のものさしを縮めていることになります。そしてこの選択の不確実性は、最後に報告するSEにまったく反映されません。
第16回で「有意でない変数を消す」という手順が偽陽性を生む話をしましたが、構造が同じです。同じデータで選抜と推定を繰り返すと、報告される不確実性が嘘になります。
ただし点推定の精度は改善する
ここは意外でした。同じ実験で の精度を見ると、削除は有効なのです。
| 手法 | の平均(真値 1.0) | SD | RMSE |
|---|---|---|---|
| OLS(そのまま) | 1.00408 | 0.10184 | 0.10190 |
| 削除して OLS | 1.00248 | 0.08421 | 0.08423 |
| Huber ロバスト回帰 | 1.00302 | 0.07995 | 0.08000 |
つまり「削除すると係数の当たりは良くなるが、その係数に付ける誤差の見積もりが嘘になる」。この2つを分けて理解する必要がありました。
そしてHuber ロバスト回帰は削除よりRMSEが小さく、しかも標本を1つも捨てていません。やることは重み付けで、まず残差を頑健なスケール (、MADは中央絶対偏差)で割って を作り、 なら重み1、超えたら に下げます( は誤差が正規のとき効率95%になる定数)。
これは冒頭の (b) の図に戻る話です。Huber は残差が小さいうちは二乗、大きくなったら絶対値に切り替える損失を使うので、 方向に大きくズレた点の効きが一定で打ち止めになります。
捨てるより重みを下げるほうが強い。 削除は「重み1か0」という極端なロバスト化で、境界のすぐ内外で扱いが不連続に変わります。 Huber はなめらかに下げるので情報を捨てすぎません。
ただし Huber は 方向しか守らない
さきほどの勾配の話がここで効いてきます。絶対値損失でも は残るので、てこ比が高い点に対しては無力です。前半のケースCと同じデータ(20点+汚染1点、真の傾き 1.0、 は15下)で、汚染点の だけを動かしました。
| 汚染点の | OLS | Huber | 絶対値損失(LAD) |
|---|---|---|---|
| 16(ケースCと同じ) | 0.350 | 0.906 | 0.820 |
| 30 | 0.508 | 0.621 | 0.688 |
| 60 | 0.740 | 0.735 | 0.730 |
=16 なら Huber は 0.906 でかなり守り切りますが(OLS は 0.350 まで崩壊)、=60 まで遠ざけると OLS の 0.740 と Huber の 0.735 がほぼ同じになります。 方向の破断点は0、つまり1点でも十分遠ければロバスト回帰も壊れるわけです。
記事の中心命題「壊れるには 遠と ズレの両方が必要」に照らすと、Huber は後者だけを守る道具でした。 方向の外れにも対処するには、てこ比も見る手法(MM推定、最小刈り込み二乗法=LTS)が必要です。
削除を判断する手順
- まず原因を調べる。 入力ミス・単位の誤り・測定機器の故障・対象の取り違えなど、「そのデータが母集団の話ではない」証拠が取れたときだけ削除できます。これはデータ品質の問題で、統計の問題ではありません
- 証拠がなければ削除しない。 「残差が大きい」は削除の理由になりません。重い裾の分布なら、大きい残差は出るべきものが出ているだけです
- 影響力を確認する。 クック距離や DFBETAS で「この点があると結論が変わるか」を見る。変わらないなら悩む必要すらありません
- 結論が変わるなら両方を報告する。 「この1点を含めると 、除くと 0.35」と感度分析として書くのが正しい対処です。隠して一方だけ出すのが最も悪い
- 手法で対応する。 ロバスト回帰、順位に基づく方法(第15回のノンパラメトリック法)、対数変換で裾を圧縮する。削除は最後の手段です
要約統計量が全部一致するのに中身が別物な例
最後に、診断が必要な理由をこれ以上ないほど明確に示す例を置きます。アンスコムの4つ組(Anscombe's quartet)です。
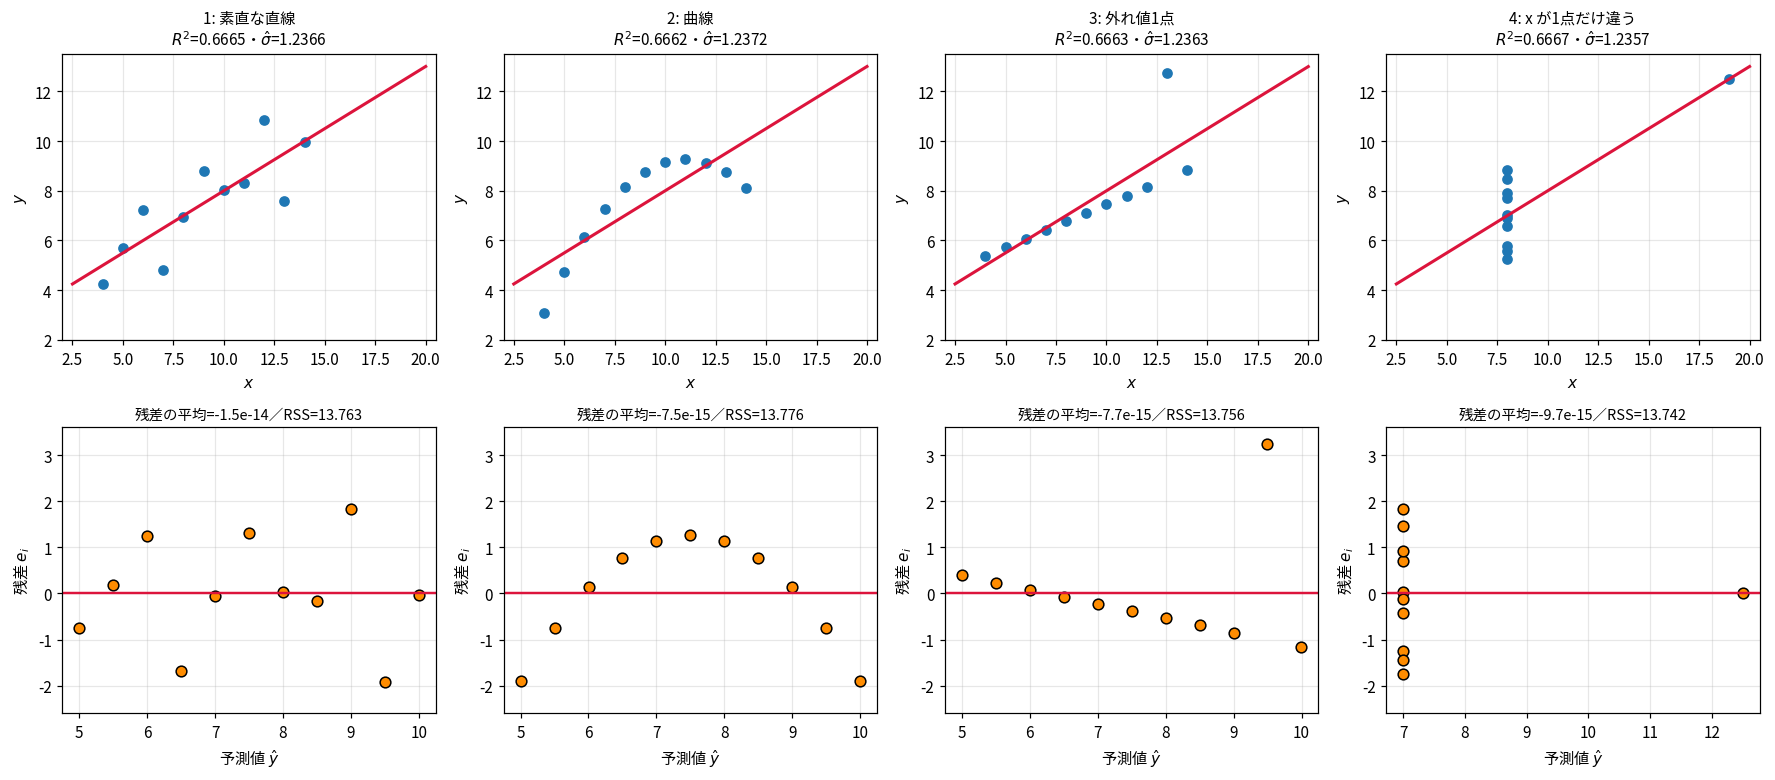
| データ | 切片 | 傾き | 残差の平均 | RSS | 残差のSD | ||
|---|---|---|---|---|---|---|---|
| 1: 素直な直線 | 3.000 | 0.500 | 13.7627 | 1.2366 | 0.6665 | 1.1731 | |
| 2: 曲線 | 3.001 | 0.500 | 13.7763 | 1.2372 | 0.6662 | 1.1737 | |
| 3: 外れ値1点 | 3.002 | 0.500 | 13.7562 | 1.2363 | 0.6663 | 1.1729 | |
| 4: が1点だけ違う | 3.002 | 0.500 | 13.7425 | 1.2357 | 0.6667 | 1.1723 |
回帰の出力表を見るかぎり、この4つは区別が付きません。 係数も も も残差のSDも一致しています。区別が付くのは残差を1点ずつ見たときだけです。
ここで残差の平均について1つ整理しておきます。上の表で4つとも 台になっているのは偶然ではありません。切片がある最小二乗法では
が常に厳密に成立します。でたらめな乱数で試しても 台になりました。切片の役目は「残差の平均をゼロにすること」だと言ってもよく、だから残差の平均を見ても何も分かりません。見るべきは散らばり方と並び方です。
診断量で見ると、ちゃんと差が出ます。
| データ | DW | BP検定のp値 | 最大 | 最大 | 最大 | 読み取れること |
|---|---|---|---|---|---|---|
| 1 | 3.212 | 0.418 | 2.08 | 0.489 | 0.318 | 特に問題なし |
| 2 | 2.188 | 1.000 | 2.24 | 0.808 | 0.318 | 数値には出にくい。図でしか見えない |
| 3 | 2.144 | 0.099 | 1203.54 | 1.393 | 0.318 | 外れ値が明確に検出される |
| 4 | 1.662 | 0.277 | — | 定義できない | 1.000 | てこ比が上限の1 |
極端な2つの数字を確かめました。
データ3の 。 その1点を抜くと残りがほぼ完全な直線になります(抜いた後の RSS が 、)。スチューデント化残差の分母がほぼゼロになるので値が爆発する。「自分を抜いたものさしで測る」ことの威力が極端な形で出た例です。
データ4の 。 これがてこ比の理論上の上限です。 だと回帰直線は必ずその点を通り、実際に残差が でした。理由は明白で、 の観測はこの1点しかないので傾きの情報をこの点が独占しています。実際この点を抜くと の行列式が厳密にゼロになり、傾きが定義できなくなりました。残り10点の はきれいに ずつで、合計すると になります。
ここで表の を「定義できない」と書いた理由も説明しておきます。 に を入れると、 かつ なので0/0 になります。計算機に投げると丸め誤差の比が返るだけで、私の環境では 1574.10 という数字が出ましたが、 に 足すだけで 37.3 に変わるので意味のある値ではありません。
そしてここに重要な含意があります。 の点はクック距離では検出できない( も同様に無意味な値になる)。いちばん危険な点が、影響力の指標に映らないわけです。 を単独で見るべき理由がここにあります。
この1例に「 は自分の予測への発言力」「」「」の3つが全部入っています。
実務でどこまで診断するのが現実的か
最小構成(これだけは毎回やる・3分)
- 残差 vs 予測値の散布図を1枚描く。ラッパ型・曲線・二重帯がないか目で見る
- クック距離を全点プロットして、突き抜けている点がないか見る(閾値ではなく相対で)
- 順序のあるデータなら DW を確認する
あると良い(10分)
- 正規Q-Qプロット。 が小さいときの区間・検定に効きます( が大きければ中心極限定理で救われる)
- 説明変数ごとの残差プロット。曲線が見えたときに原因の変数を特定する
- ロバスト標準誤差を併記。素のSEと大きく違えば不均一分散のサイン。計算コストがほぼゼロなので最初からこれを常用してもよい
やらなくてよいこと
正規性の検定(シャピロ・ウィルクなど)を機械的にやること。 が大きいと些細なズレで有意になり、 が小さいと検出力がありません。しかも が大きいときこそ正規性は要らないという逆転があります。図を見るほうが有益です。
等分散の検定をしてから使う手法を選ぶこと。 第13回で「F検定 → t検定」の多段階手順が有意水準を壊すのを見たのと同じ理屈で、最初からロバストSEを使うほうが素直です。
診断の目的を1行で。
と SE のうちどちらが壊れているかを切り分けること。
- 線形性の破れ・欠落変数 … を壊す(バイアス)→ モデルを直すしかない
- 不均一分散・自己相関 … は無傷でSEだけ壊す → SEの計算法を替えれば済む
- 外れ値・高影響点 … どちらも壊しうる → まず原因を調べる
この3分類ができれば、診断の結果から次の行動が決まります。
自分が間違えていたこと
「最小二乗法は全部の点を平等に扱っている」と思っていた。 残差の扱いは平等ですが、係数への寄与は最初から不平等です。 の重み が全部を決めていて、 の点は1票も持っていません。
「不均一分散はSEを過小評価する」と覚えていた。 分散が中央で大きい形だと過大評価になります(比 2.262)。向きはてこ比との相関で決まります。
「 を超えたら影響が大きい」と読んでいた。 正常なデータで =200 なら100%引っかかります。あれは閾値ではなく、降順に並べる目印でした。
「 なら外れ値」という基準を信じていた。 =12、=2 では が 3.162 を絶対に超えないので、この基準は機能しません。マスキングのせいで、大きい外れ値ほど内部残差では見つけにくくなります。
DW が小さければ自己相関だと思っていた。 誤差が完全に独立でも、 でソートされた曲線データなら DW=0.368 になります。まず線形性を疑うべきでした。
残差の平均に意味があると思っていた。 常に厳密にゼロなので、診断の材料になりません。
削除すれば良くなると思っていた。 点推定のRMSEは改善しますが(0.102 → 0.084)、被覆率が下がります(95.73% → 91.07%、繰り返すと 80.55%)。「係数は良くなるが誤差の見積もりが嘘になる」という分離が必要でした。
が誤検出だらけになる理由を取り違えていた。 最初は「 が増えても の分布は縮まないから」だと思ったのですが、実測すると で同じ速さで縮んでいました。 は常に上位数%の位置にあり、本当の原因はその判定を 回くり返す多重比較でした。
「絶対値損失なら遠い点の特別扱いが起きない」と書きかけた。 勾配を見ると絶対値損失でも は残るので、 方向のてこ比は消えません。実際 Huber は汚染点を =60 に置くと OLS と同じように壊れました(0.735 対 0.740)。ロバスト回帰が守るのは 方向だけです。
「不均一分散では向きが変わる」と書いたのに、自己相関では同じ罠を踏んでいた。 自己相関でも の並びによって過大評価になります(交替する設計で比 2.216)。同じ構図を2回見落としたのが今回いちばん反省した点です。
クック距離が の点を検出できないことに気づいていなかった。 の式が 0/0 になるので、いちばん危険な点が影響力の指標に映りません。
この記事の要点
- 最小二乗法は平等ではない。 、。実測で 1.07709520 が一致し、 の点の重みは
- 二乗損失は遠い点を優遇する。 効きは に比例、損失の減りは に比例。絶対値損失なら 方向の効きは一定(→ ロバスト回帰)。ただし は残るので 方向のてこ比は消えない
- という制約が直線を遠い点へ引っぱる(実測はどちらのデータでも 台)
- 1点が壊すには「 が遠い」と「 がズレ」の両方が必要。 が掛け算だから
- を14動かしても傾きは不動()。 を遠ざけるだけでも何も起きない( は 0.913→0.945 に改善)。両方そろうと 1.024→0.350 に崩壊(=9.115)
- てこ比は を見ずに計算できる( だけの関数)=潜在的な危険度。外れ値は残差で判定=実際に起きたズレ。影響力はその積
- (5点すべて 精度で一致)=自分の予測への発言力
- 、。 単回帰なら (誤差 )
- 重回帰では「単独では平凡なのに組み合わせが異常」な点が生まれる。 同じ距離3.111で が 0.465 対 0.213。1変数ずつのヒストグラムでは見つからない
- なので高てこ比の点は残差が小さく出る(=0.425 で残差 0.030)
- マスキング:外れ値は を3倍に膨らませて自分を隠す。 内部残差は で飽和、外部は に厳密に従う(97.5%点 2.2490 対 2.2622)
- 不均一分散が壊すのはSEだけ。 推定値は不偏(1.500377 対 真値1.5)、SEは 0.944倍、被覆率 93.74%、偽陽性 6.55%
- 不偏性は しか使わない。 は等分散を使って導いた式だから崩れる(正しくはサンドウィッチ型)
- 「必ず過小評価」は誤り。 中央で分散が大きいと比 2.262 で過大評価。鍵はてこ比との相関
- WLS は分散を 55.5% 削る(SD 0.0926→0.0618)。ガウス・マルコフの「等分散のもとで最良」の裏の意味
- 掛け算の誤差は で足し算になる(BP検定 0.0029→0.546、傾き 1.3976 対 真値1.4)
- 弾性値は小さな変化の近似。 1%なら 1.400% 対 1.398% だが、100%なら 163.5% 対 139.8%
- を変換前後で比べてはいけない(被説明変数が別物)。逆変換は中央値の推定になる
- は閾値でなく目印。 正常データで =200 なら誤検出 100%。ただし理由は「 が縮まないから」ではなく多重比較( で は常に上位数%、=200 で平均10.71個)
- は で誤検出1%未満だが小さい影響を見逃し、重心にある外れ値はどれだけ大きくても検出しない(0%)
- は非線形。 0.5で1倍、0.9で9倍、0.99で99倍
- の点はクック距離で検出できない( が 0/0 になる)
- 自己相関は不均一分散よりずっと危険。 =0.9 で被覆率 34.03%。ただしこれも向きが変わる( が交替する設計だと比 2.216 で過大評価)
- HC系のロバストSEは自己相関には効かない( の対角しか置き換えないから)。HAC が必要
- DW が小さい原因は線形性の破れかもしれない。 独立な誤差でも 0.368、 を入れたら 2.092。厳密には
- 削除は区間を縮めるが当たらなくする(0.721倍・95.73%→91.07%→80.55%)。選択の不確実性がSEに入らない
- 点推定のRMSEは削除で改善する(0.102→0.084)が、Huber は 0.080 でさらに良く標本を捨てない
- ただし Huber が守るのは 方向だけ。 汚染点を =60 に置くと OLS と同じく壊れる(0.735 対 0.740)
- アンスコムの4データは係数・・・残差SDが全部一致。うち1つは が 1.000(抜くと の行列式が0)
- 残差の平均は常に厳密にゼロ(切片があるから)。診断の材料にならない
- 診断の目的は「 と SE のどちらが壊れているか」の切り分け
次回は第18章の質的回帰です。ここまでの回帰は が連続量でしたが、 が「買った・買わなかった」のような 0/1 のとき何が起きるか。0/1 を普通に線形回帰すると予測値が1を超えたりマイナスになったりしますが、困るのはそれだけではありません。今回見た不均一分散が、実は 0/1 データでは構造的に必ず発生します( が に依存するため)。その解決としてロジスティック回帰が出てきます。