ベイズ統計:MCMCは「歩き方」と「数え方」の合成語だった【第33回】
はじめに
第31章はベイズ法です。前回のモデル選択で「予測が目的か説明が目的か」という区別を扱いましたが、今回はもっと手前の、確率という言葉の使い方そのものが変わる回になります。
正直に書くと、私はベイズ統計を何度も学ぼうとして、何度も同じ場所で止まっていました。ベイズの定理は分かる。事後分布を計算する手順も追える。それでも「結局ベイズ統計って何なのか」が最後まで言われないまま終わる、という感覚がずっとありました。
今回それが解けたのは、計算の話を後回しにして、絵を2枚並べたからです。頻度論とベイズで「何が固定されていて何が動くのか」を描いただけで、話が通りました。難しい数学は1つも出てきません。
そしてこの記事の中盤で、私は一度完全に詰まりました。 MCMC(マルコフ連鎖モンテカルロ法)です。メトロポリス法のアルゴリズムを順番に追うことはできたのに、それが何をしている道具なのか分からない。原因は名前を分解していなかったことでした。MCMC は独立に発明された2つの技術がくっついた言葉で、片方だけ先に理解すれば済む話でした。その回り道もそのまま記録します。
いちばん驚いたのは終盤です。t分布が正規分布の混合分布だったという事実に行き当たりました。第7回で「分散を知らない罰金」として学んだあの分布が、今回の階層ベイズとまったく同じ構造をしていました。第5回の負の二項分布も同じでした。「消すべきパラメータを最尤推定値のような1点に決め打つと、たいてい自信過剰になる」という筋が、連載で別々に学んだ回をまとめて回収してくれました。
いつものように、出てくる数値はすべて自分で計算し、答えが分かっている問題と突き合わせています。MCMC は自分で実装し、2次元グリッドによる数値積分を「答え」として用意してからその結果を検証しました。
この回で扱う用語
| 用語 | 英語 | ひとことで |
|---|---|---|
| 事前分布 | prior distribution | データを見る前の考え |
| 事後分布 | posterior distribution | データを見た後の考え |
| 共役事前分布 | conjugate prior | 事後分布が同じ族に戻る事前分布 |
| 信用区間 | credible interval | そのものの確率で語る区間 |
| MAP | maximum a posteriori(事後確率最大) | 事後分布の山の頂点 |
| MCMC | Markov chain Monte Carlo(マルコフ連鎖モンテカルロ法) | 歩いた足跡を数えて積分の代わりにする |
| 提案分布 | proposal distribution | 次の候補をどう出すか |
| 詳細釣り合い | detailed balance | 2点間の流れが釣り合う条件 |
| バーンイン | burn-in | 初期値の影響が残る期間。捨てる |
| ESS | effective sample size(有効サンプル数) | 独立サンプルなら何個分か |
| ジェフリーズ事前分布 | Jeffreys prior | 尺度を変えても答えが変わらない事前分布 |
| ベイズファクター | Bayes factor | 2つの仮説の予測力の比 |
| 局外パラメータ | nuisance parameter | 必要だが興味のないパラメータ |
| 周辺化 | marginalization | 局外パラメータを積分で消す操作 |
| Gelman-Rubin 統計量(潜在尺度縮小係数) | 鎖間と鎖内のばらつきの比。1に近ければ収束 | |
| 階層ベイズ | hierarchical Bayes | パラメータの分布のパラメータも推定する |
| 経験ベイズ | empirical Bayes | 上位のパラメータをデータから点推定する |
| 縮小推定 | shrinkage estimation | 個別の推定値を全体平均へ引き寄せる |
ベイズが変えたのは「何が動くか」だけだった
困りごとから始める
第11回の区間推定で、私はひとつ気持ち悪さを抱えたまま先に進んでいました。
95%信頼区間を計算して [0.14, 0.52] という答えが出たとき、「クリック率が 0.14 から 0.52 の間にある確率は 95%」と言ってはいけないと学びました。95% という数字は区間についているのではなく、区間の作り方についている成績だったからです。真のクリック率 は定数なので、確率を持てない。
理屈は分かりました。でも、じゃあ目の前のこの1本の区間について何が言えるのかが分からない。実務で「で、結局クリック率はどのくらいなんですか」と聞かれたときに、「この区間は、同じ手続きを無限回繰り返せば95%の割合で真の値を含むような区間です」と答えるのは、明らかに何かがおかしい。
ベイズ統計はこの気持ち悪さに正面から答えます。
図で見る:同じ問題を見る2つの絵
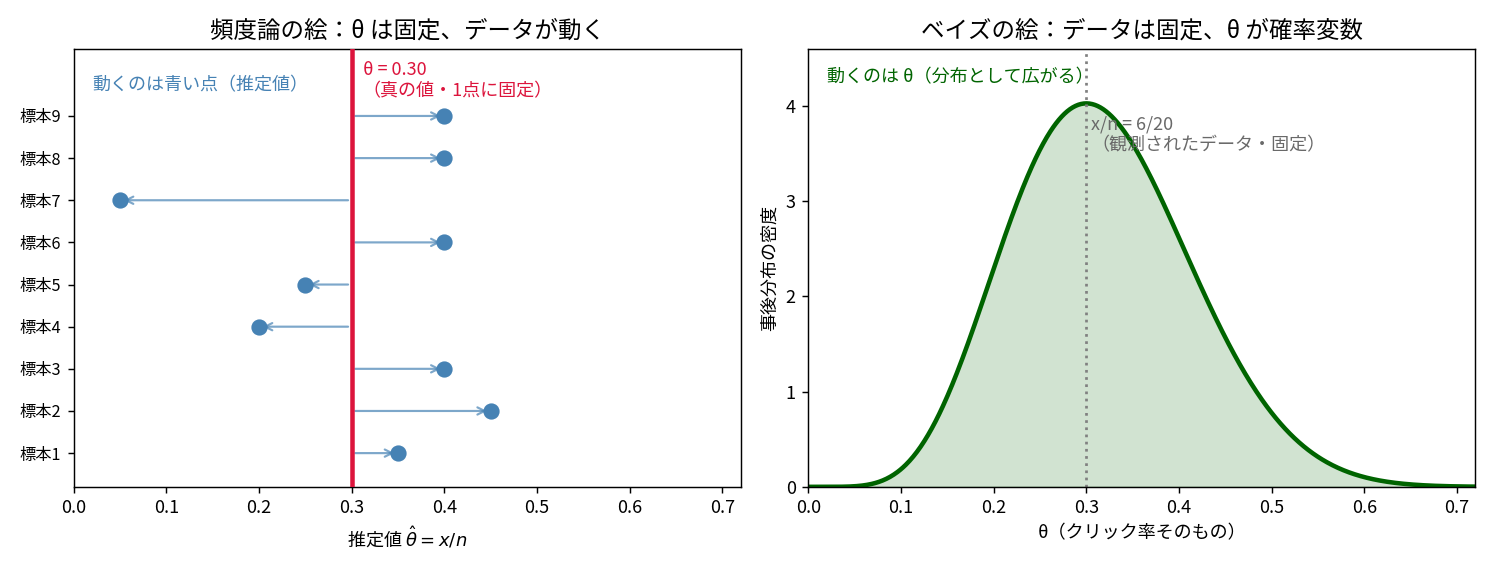
同じ問題(広告のクリック率)を扱っているのに、動いているものが逆です。
左(頻度論) では、真のクリック率 は1点に固定された定数です。神様だけが知っている値で、確率変数ではありません。動くのは標本のほうで、20回試すたびに 7/20、9/20、5/20 と推定値がばらつきます。
右(ベイズ) では、観測した 6/20 はもう見てしまったので固定です。動くのは 。「今のところ 0.3 あたりが一番ありそうだが、0.2 や 0.45 でもおかしくない」という自分の知識の状態を分布で書く。
これが唯一の本質的な差です。そして が確率変数になった瞬間に、さっき禁じられていた文が書けるようになります。
が 0.146 と 0.522 の間にある確率は 95%
よくある引っかかり:クリック率は1つの値でしょう
ここで多くの人が引っかかります(私も引っかかりました)。「現実のクリック率は1つの値として存在するはずで、それが分布するのはおかしいのでは」という疑問です。
これは正しい疑問で、答えはベイズの分布は の物理的なばらつきではないということです。表しているのは自分の知識の不確かさです。
サイコロの例で言うと、振ってしまって伏せた手のひらの下にある目は、物理的にはもう1つに決まっています。それでも「6である確率は 1/6」と言えます。確率が対象の性質ではなく、自分の情報状態を表しているからです。ベイズの の分布はこれと同じ種類のものです。
この立場の違いには名前があって、確率を「長期的な頻度」と読むのが頻度論、「知識の度合い」と読むのがベイズです。
事後分布は「かけ算して面積を1にした」だけ
計算はこれで全部です。
分母は を含まないただの定数なので、実質はかけ算だけです。だから実務では比例だけ書きます。
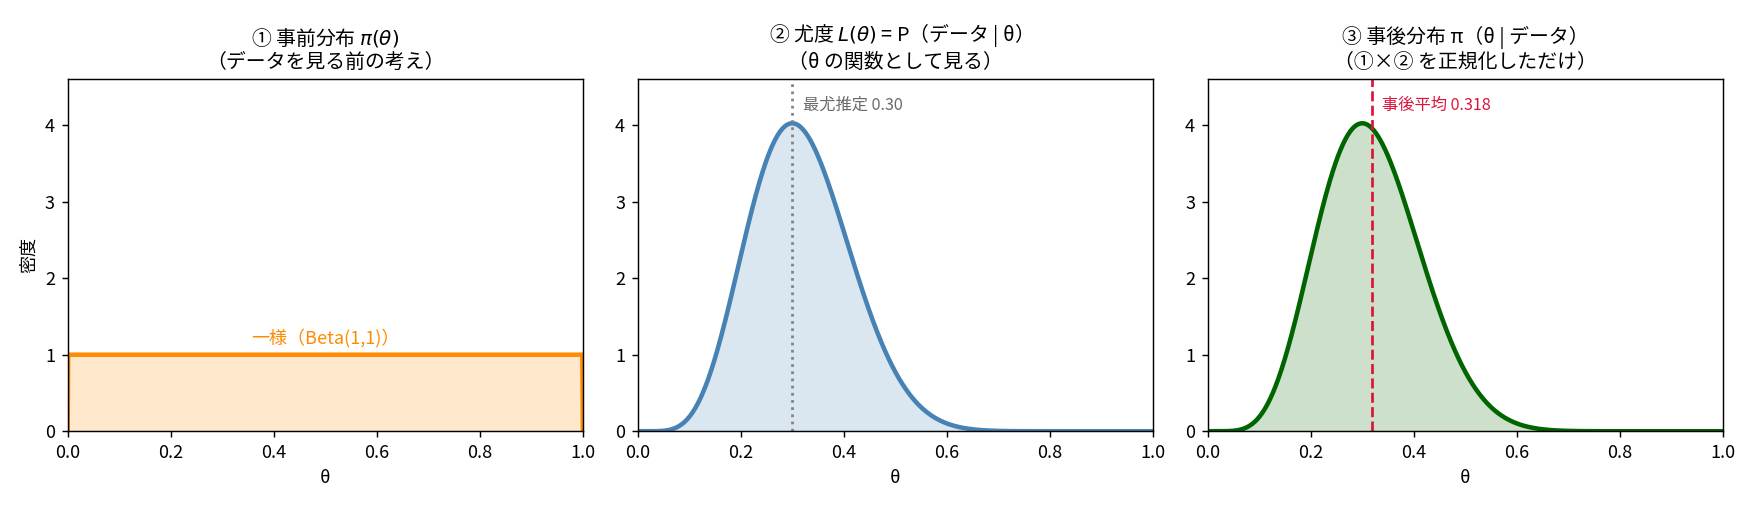
①データを見る前の考えに、②実際に見たデータの尤度をかけて、③面積が1になるよう割る。
第10回でやった最尤法は、②のピークを探すだけの作業でした。ベイズは②を捨てずに全体を持ち歩きます。 この差が後で効いてきます。
3つの代表値が出てくる
事前・尤度・事後を並べた図の右端で気づいてほしいのは、ピークは 0.300 なのに平均は 0.318 とズレていることです。分布が右に裾を引いているためです。
| 要約 | 値 | 意味 |
|---|---|---|
| MAP(事後最大値) | 0.3000 | 山の頂点。事前が平らなので最尤推定 6/20 とぴったり一致する |
| 事後中央値 | 0.3126 | 面積を半分に割る点 |
| 事後平均 | 0.3182 | 重心。 ときれいな形になる |
MAP が最尤推定と一致するのは重要な接続点です。事前分布を平らにしたベイズの MAP は最尤推定と一致するので、最尤法はベイズの特殊ケースとして読めます。
ただし一致するのは MAP だけです。事後平均 0.3182 と事後中央値 0.3126 は最尤推定 0.3000 と一致しません。さらに「平ら」という性質はパラメータの取り方に依存する(後述)ので、 について平らな事前分布を置くと MAP も 0.30 にはなりません。
そして事後平均が になるのも偶然ではありません。「分子に1、分母に2を足す」というあの謎の操作(機械学習のラプラススムージング)の出どころがこれです。 のときに 1/2 を返すので、「何も見ていないなら半々」という自然な振る舞いになります。
なお似た形の Agresti-Coull 法は を使って成功2・失敗2を足す で、こちらは の事前分布に相当します。 とは別物なので混同しないよう注意が必要です(自分は一度混同しました)。
共役とは何か:形が掛け算で壊れないこと
ここで用語をひとつ固めます。私はこの回の準備で「共役事前分布は予習済み」と思っていたのですが、記事を書く段階で「二項分布と共役ってどういう意味だっけ」と自分で分からなくなりました。 定義から確認します。
尤度の族を決めたとき、事後分布が事前分布と同じ族に戻ってくるような事前分布の族を、その尤度に対する共役事前分布という。
用語の注意が1つあります。 「二項分布と共役」は言葉を省略した言い方で、正確には「ベータ分布は二項尤度に対する共役事前分布である」。共役は「分布と分布」の関係ではなく、「尤度の族」と「事前分布の族」の関係です。
「ベータと二項が似ている」という話ではありません。掛け算しても形が壊れない相性の話です。
なぜベータ×二項がベータに戻るのか
式を3行並べるだけで分かります。正規化定数は を含まないので無視します。
掛けると指数が足されるだけです。
最後の形は そのものです。
核心はこれです。 事前分布と尤度がどちらも「 の何乗 × の何乗」という同じ骨格をしている。だから掛け算すると指数が足されるだけで、骨格が変わりません。
共役の正体は「関数の形が掛け算で保たれること」であって、それ以上の意味はない。
共役でないと本当に戻らないのか
言葉だけだと納得しづらいので、共役でない事前分布と並べました。ロジット正規分布( が正規分布に従う)を使います。ベータとよく似た形ですが、二項尤度に共役ではありません。
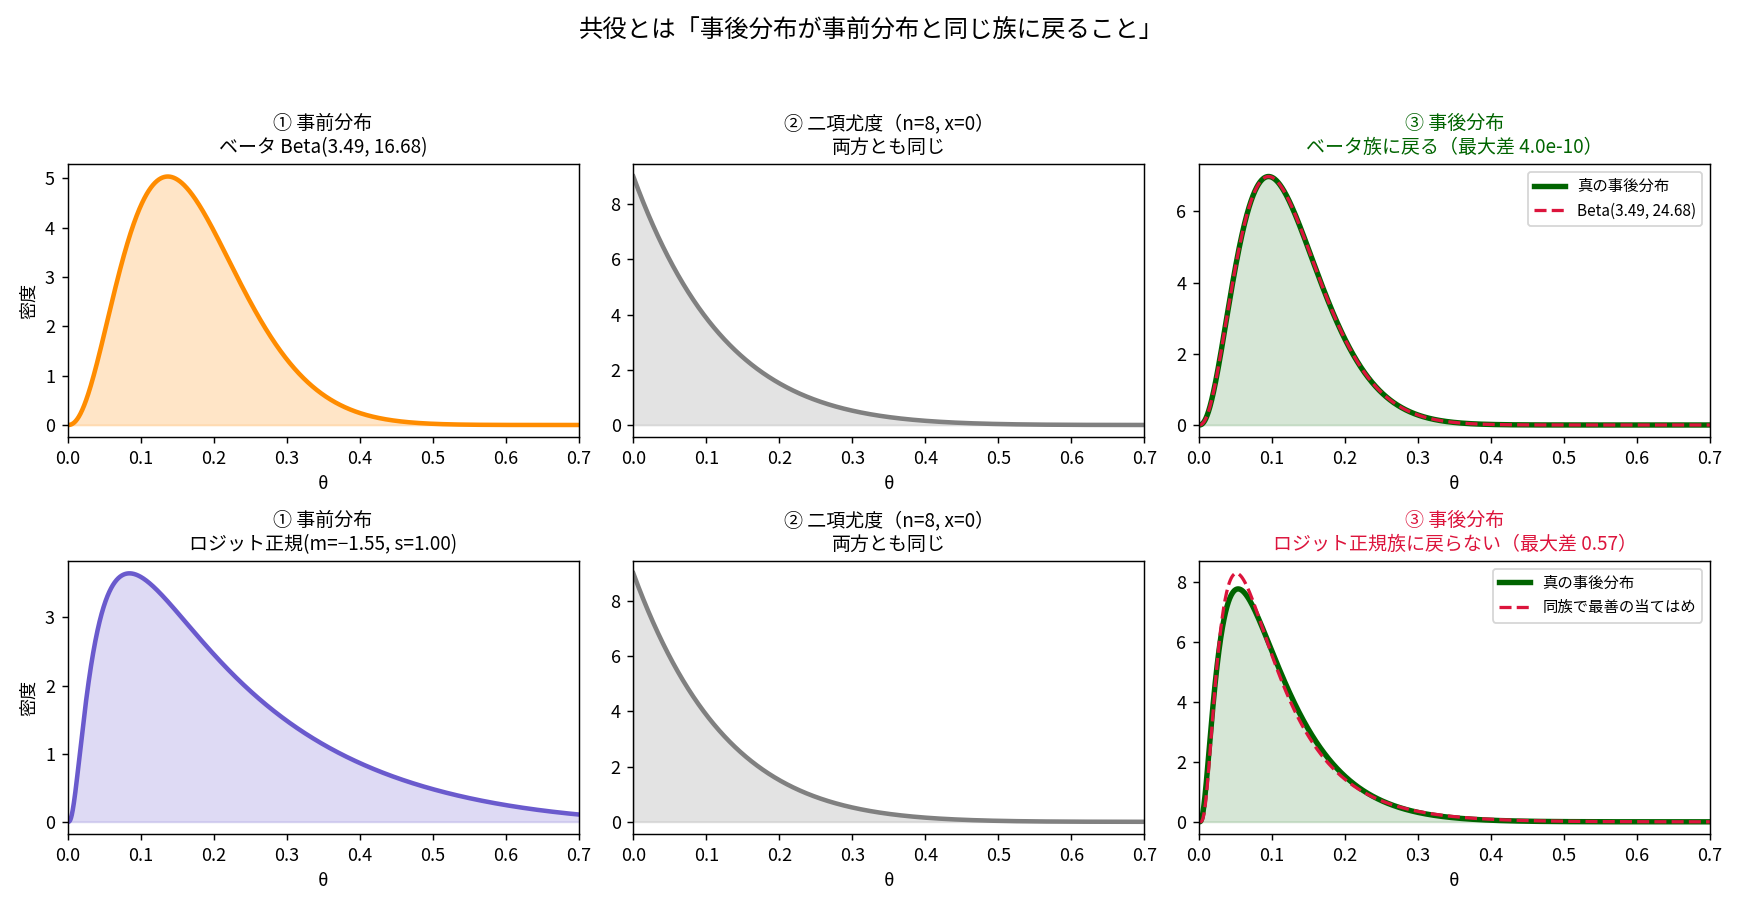
上段(ベータ) は、掛けた結果がぴったりベータ分布に戻ります。真の事後分布(緑)と (赤破線)が重なって区別できません。密度の最大差は で、数値積分の誤差だけです。
下段(ロジット正規) は、②の尤度が上段とまったく同じなのに、③では同じ族で最善の当てはめをしても最大差 0.57 のズレが残ります(ピークの高さが合っていません)。これが「族に戻らない」ということです。
共役な組み合わせの一覧
試験で計算問題として出るのはこの表です。
| 尤度 | パラメータ | 共役事前分布 | 事後分布 | 更新の中身 |
|---|---|---|---|---|
| 二項・ベルヌーイ | 成功確率 | ベータ | と を足す | |
| ポアソン | 強度 | ガンマ | と を足す | |
| 正規(分散既知) | 平均 | 正規 | 正規 | 精度の加重平均 |
| 正規(平均既知) | 精度 | ガンマ | と平方和/2 を足す | |
| 指数 | 率 | ガンマ | と を足す | |
| 多項 | 確率ベクトル | ディリクレ | 各カテゴリの度数を足す | |
| 幾何・負の二項 | 成功確率 | ベータ | ベータ | 同上 |
この表の は を率として書いています。後で出てくる逆ガンマは を尺度として使うので、教科書ごとの流儀の違いに注意してください。
共通の型は1つだけです。
事前分布のパラメータに、データの十分統計量を足す。
理由は第9回の指数型分布族です。指数型分布族の尤度は「 自然パラメータ 十分統計量 正規化項 」の形をしているので、同じ形の事前分布を掛けると指数の中で足し算になる。だから族が保たれます。
ここで注意点が2つあります。私は最初、「共役事前分布が存在するのは指数型分布族のときだけ」と書いたのですが、「だけ」という限定も、そこから引いた理由づけも誤りでした。
まず逆は成り立ちません。 は台が母数に依存するので指数型分布族ではありませんが、パレート分布が共役です(尤度 にパレートを掛けるとパレートに戻る)。
そしてロジスティック回帰の尤度は、実は について指数型分布族です。 対数尤度を書き直すと
で、「自然パラメータ ・十分統計量 」の形をしています。実際 という共役族(Diaconis-Ylvisaker 事前分布)は存在し、更新も閉じます。
後でロジスティック回帰で共役が使えない本当の理由は、その族の正規化定数が閉じた形で書けず、名前のついた分布にならないことです。「共役族が存在しない」のではなく「あっても手で扱えない」が正確でした。
正しい整理はこうです。尤度が指数型分布族なら、自然共役族を必ず構成できる(超パラメータは十分統計量の次元に「見かけの標本サイズ」を1つ足した分)。ただし逆は成り立たず、また構成できても実用的な形になるとは限りません。
信頼区間と信用区間:解釈は違うが数字はほぼ同じ
第11回から引きずっていた気持ち悪さに戻ります。同じデータ( で6クリック)で両方計算して並べました。
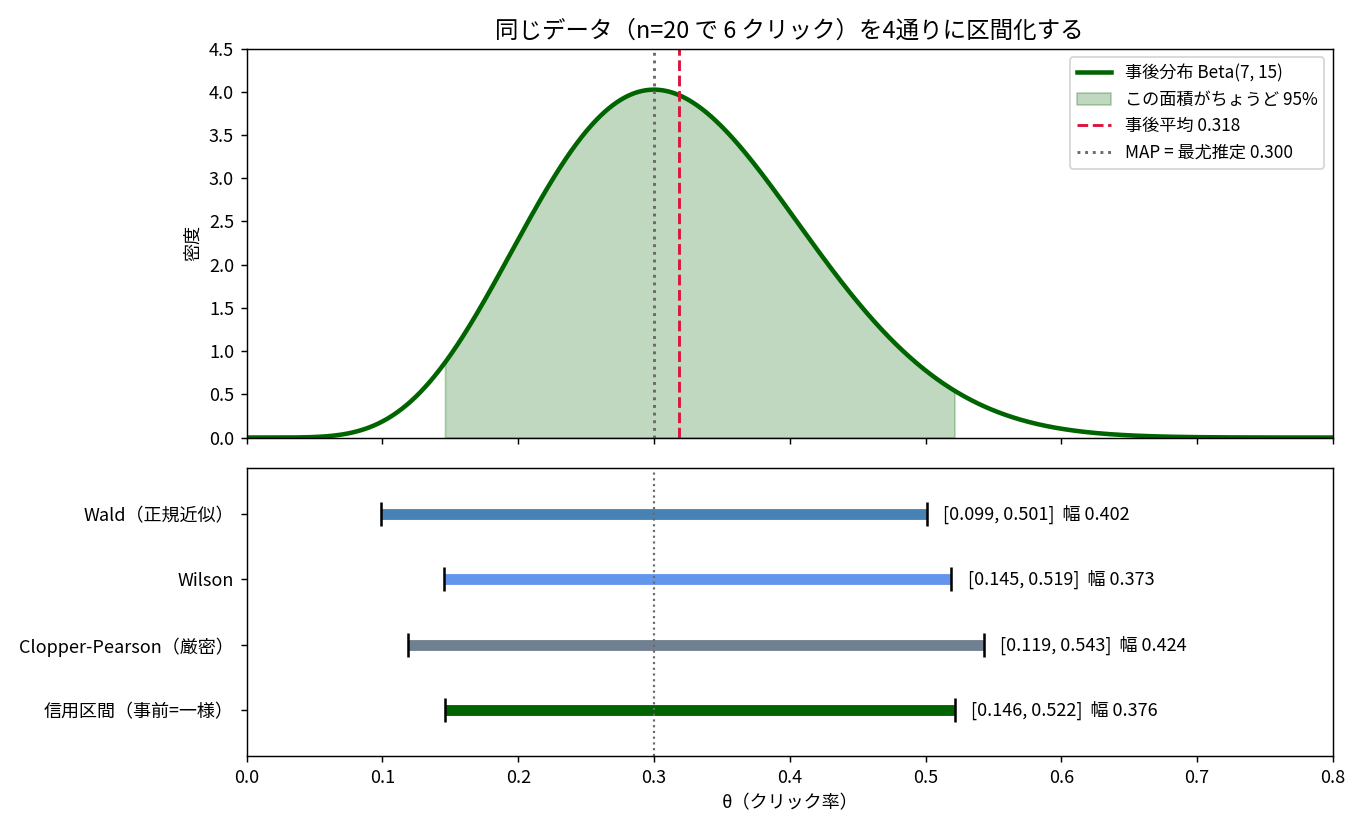
| 方法 | 区間 | 幅 |
|---|---|---|
| Wald(教科書の正規近似) | [0.0992, 0.5008] | 0.4017 |
| Wilson | [0.1455, 0.5190] | 0.3735 |
| Clopper-Pearson(厳密) | [0.1189, 0.5428] | 0.4239 |
| 信用区間(事前=一様) | [0.1459, 0.5218] | 0.3759 |
Wilson の信頼区間と信用区間が、小数第2位までほぼ一致します。 哲学がまるで違うのに、出てくる数字はほぼ同じです。
なぜ一致するのか
偶然ではありません。事前・尤度・事後を並べた図で見たとおり、事前分布が平らなら事後分布の形は尤度そのものです。そして尤度のピーク周りの形は、頻度論が正規近似で使っているものと同じです。同じ関数を、一方は「 の確率分布」と読み、他方は「推定値のばらつき」と読んでいるという状況になります。
を大きくすると一致はさらに良くなります。ここから実務上の含意が出ます。
通常の条件下でデータが十分あるとき、ベイズにするかどうかで結論の数字はほぼ変わらない。 変わるのは「その数字を何と言い表せるか」だけ。
「通常の条件下で」と付けたのは、これがベルンシュタイン=フォン・ミーゼスの定理という漸近論に頼っているからです。真の値がパラメータ空間の内部にあり、事前分布がその近傍で正の密度を持ち、次元が固定されている必要があります。この記事の後半で見る のケースや不適切事前分布では実際に崩れます。
裏を返すと、 が小さいとき・事前情報が本当にあるときにだけ、ベイズは違う答えを出します。
では信用区間の何が嬉しいのか
解釈です。信用区間なら
が 0.146 と 0.522 の間にある確率は 95%
でこの文が終わります。区間の作り方に言及する必要がありません。
もっとはっきりした差が、任意の質問に答えられることです。ベイズなら
と、聞かれた質問に対して数字が1つ返ります。 頻度論では「 である確率」という文自体が定義できません( は定数なので、この確率は 0 か 1 のどちらかで、どちらかは分からない、という答えになってしまう)。
用語の整理
日本語が1文字違いなので、試験では英語で覚えたほうが安全です。
| 用語 | 英語 | 何の確率か | 固定されているもの |
|---|---|---|---|
| 信頼区間 | confidence interval | 区間の作り方の成績 | |
| 信用区間 | credible interval | そのものの確率 | データ |
そして信用区間には作り方が2種類あります。
| 作り方 | 英語 | 中身 |
|---|---|---|
| 等裾区間 | equal-tailed interval | 左右の裾を 2.5% ずつ切る。計算が楽。今回使ったのはこれ |
| HPD区間 | highest posterior density(最高事後密度) | 密度が高い点から順に 95% 集める。幅が最小になる |
単峰かつ対称な事後分布なら両者は一致します(対称でも二峰なら HPD は2つの区間に分かれるので一致しません)。歪んでいるとズレて、HPD のほうが狭くなります。
頻度論の基準で採点したらどうなるか
「ベイズの信用区間は頻度論の基準で見ると成績が悪いのでは」という疑問が湧きます。確かめました。横軸に真の を全部並べ、その区間が を含む確率を厳密に計算します。
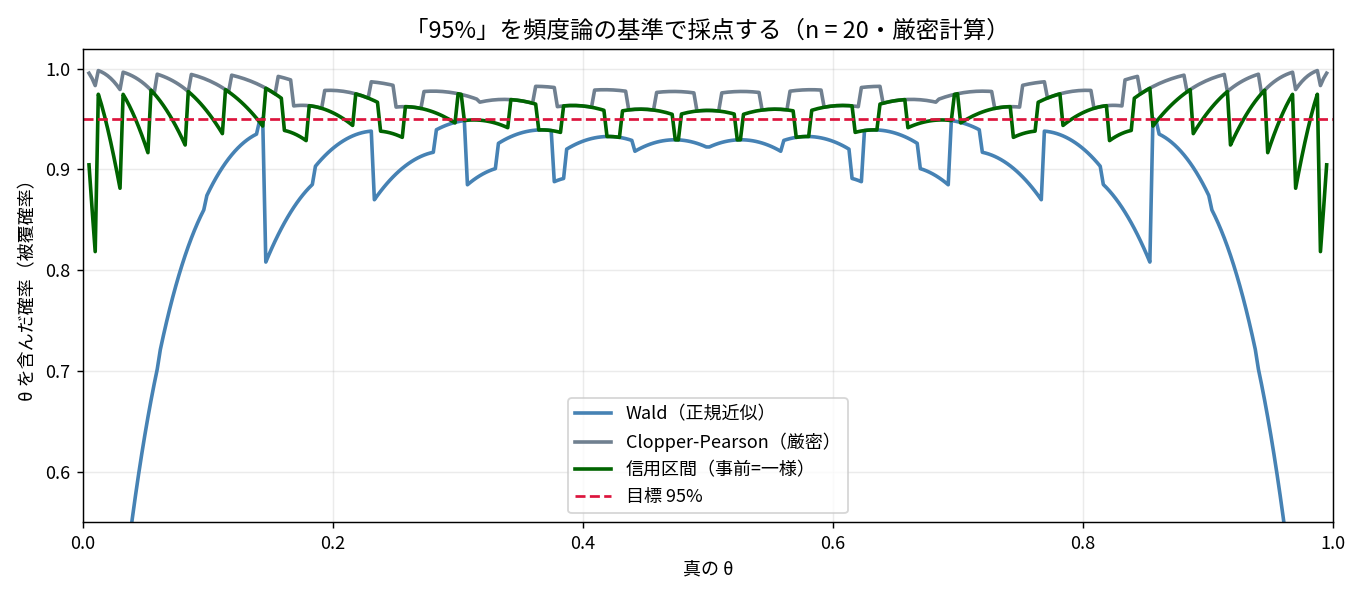
| 真の | Wald | Wilson | Clopper-Pearson | 信用区間 |
|---|---|---|---|---|
| 0.30 | 94.74% | 97.52% | 97.52% | 97.52% |
| 0.05 | 63.89% | 92.45% | 98.41% | 92.45% |
| 0.50 | 95.86% | 95.86% | 95.86% | 95.86% |
の行が要点です。教科書に最初に載っている Wald は、95% と名乗りながら実際は 63.89% しか当てていません。 3回に1回以上外している。一方 Clopper-Pearson は 98.41% で、外さないけれど広すぎます。
信用区間は頻度論の被覆率を目標に作っていないのに、頻度論の基準で採点しても Wald よりずっとまともです。 ギザギザしているのは二項分布が離散だからで、これは頻度論側の区間にも同じように出ます。
0クリックだったときが象徴的
で1件もクリックされなかった場合を計算しました。
| 方法 | 区間 | 問題 |
|---|---|---|
| Wald | [0.000, 0.000] | 幅ゼロに潰れる。「クリック率は0%と断定」という無意味な答え |
| Wilson | [0.000, 0.1611] | 使える |
| Clopper-Pearson | [0.000, 0.1684] | 使える(やや広い) |
| 信用区間(事前=一様) | [0.0012, 0.1611] | 使える。下端が厳密に0にならない |
Wald が潰れる理由は式を見れば明らかで、 なので になるからです。
このとき事後平均は 、そして
と直接言えます。「クリック率が10%未満である確率は89%」という、そのまま意思決定に使える形です。
なお HPD 区間で計算すると、事後分布 は単調減少なのでピークが端()にあり、下端が 0 になります。上端は で、等裾の上端 0.1611 より狭い。片側だけの区間になるという、等裾との違いがはっきり出る例です。
無情報事前分布は本当に「無情報」なのか
事前分布を置くと決めたとき、次に来る疑問はこれです。「何も情報がないときは一様分布を置けばいいのでは」。
私はこれに引っかかりました。一様分布を置くのも、1つの積極的な主張に見えるからです。結論から言うと、その直感が正しいです。
一様分布は尺度を変えると偏った主張になる
に一様分布を置いた後で、同じものを別の尺度で見てみます。
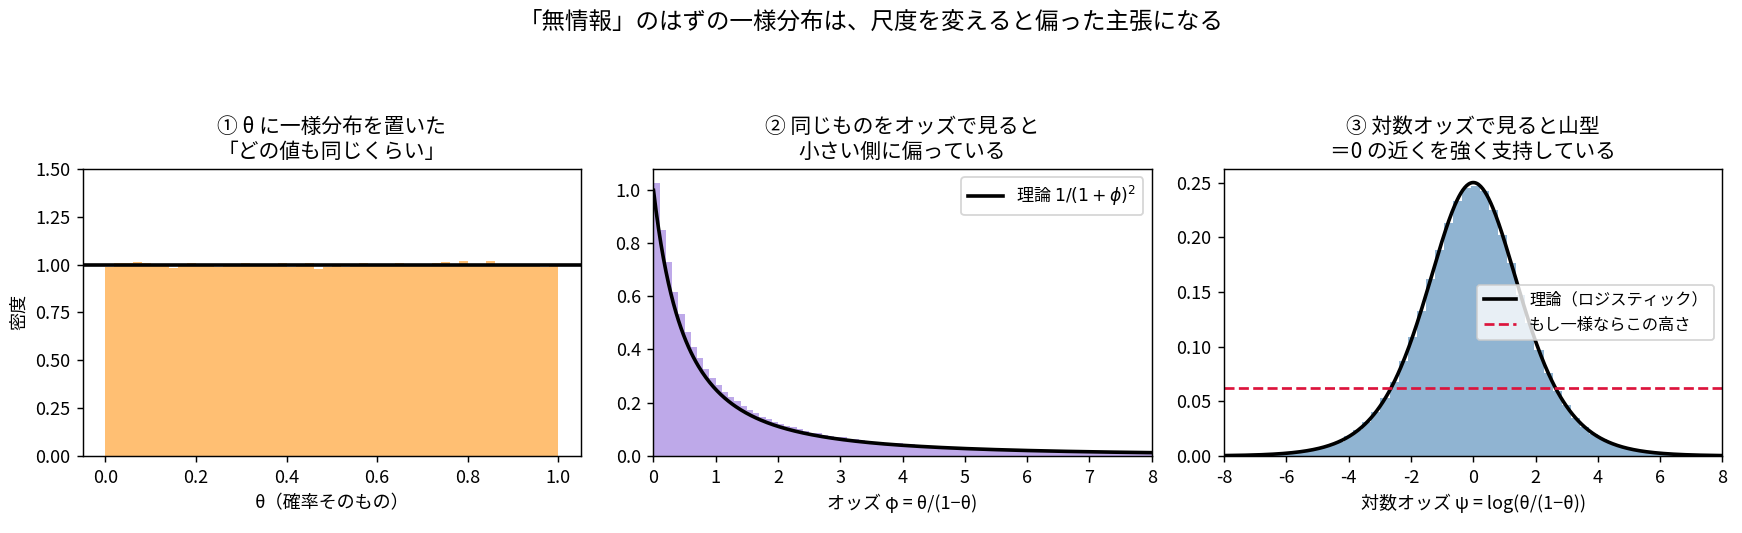
- オッズ で見ると、小さい側に強く偏っています
- 対数オッズ で見ると、0 の近くに集まった山型(ロジスティック分布)になります
数値でも確認しました。 一様 から生成した は、標準偏差 1.81402(理論値 )。そして
は全実数を動くので「 について一様」は不適切事前分布になってしまいますが、図の範囲 に切って比べると一様なら 。実際は3.7倍になっています。
つまり「 について無情報」は「 について無情報」ではありません。 そしてこれは机上の話ではなく、ロジスティック回帰の係数は の側です。第18回で扱った がまさにこれで、「 に一様を置く」と決めた瞬間に、係数については「0 に近い」という主張をしていることになります。
第4回の変数変換(ヤコビアン)が効いているだけの話です。密度は変換で形が変わるので、「平ら」という性質は尺度に依存するのです。
ジェフリーズ事前分布:どの尺度でも同じ答えになるように作る
この問題を解決するために提案されたのがジェフリーズ事前分布です。
二項分布なら なので
なぜ を掛けると解決するのか。 変換不変性を数値で確認しました。
| ルートA: で作って に変換 | ルートB:最初から で作る | 比 | |
|---|---|---|---|
| 0.21254802 | 0.21254802 | 1.000000 | |
| 0.38619484 | 0.38619484 | 1.000000 | |
| 0.0 | 0.50000000 | 0.50000000 | 1.000000 |
| 0.7 | 0.47086396 | 0.47086396 | 1.000000 |
| 2.0 | 0.32402714 | 0.32402714 | 1.000000 |
比が全て 1.000000。 「 で無情報事前分布を作ってから変換する」と「最初から で無情報事前分布を作る」が、比例定数まで完全に一致します。どの尺度で考えても同じ結論になる――これがジェフリーズ事前分布の設計目標です。一様分布ではこれが成り立ちません。
直感的な読み方はこうです。フィッシャー情報量が大きい領域=データが敏感に効く領域なので、そこに事前分布の重みを厚く置くと、尺度の取り方に左右されなくなります。
なおパラメータが複数あるときは になりますが、多母数のジェフリーズ事前分布は必ずしも良い無情報事前分布になりません(そのため参照事前分布などの改良版が提案されています)。この記事では1母数の場合だけを扱います。
事前分布の形と、それが結論をどれだけ動かすか
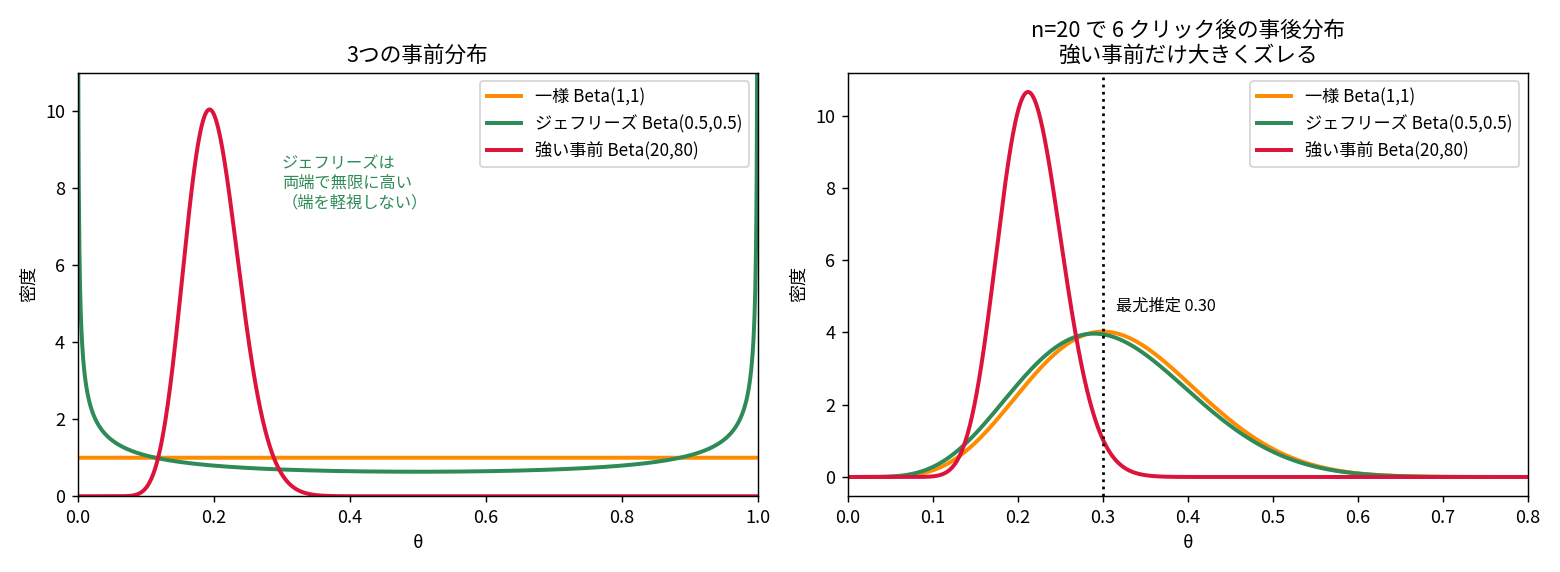
ジェフリーズ は両端で無限に高くなる U 字型です。「0 や 1 に近い可能性を軽視しない」形になっています。
| 事前分布 | 事後平均 | MAP | 95%信用区間 |
|---|---|---|---|
| 一様 (ラプラス) | 0.3182 | 0.3000 | [0.1459, 0.5218] |
| ジェフリーズ | 0.3095 | 0.2895 | [0.1361, 0.5172] |
| ハルデーン (極限) | 0.3000 | 0.2778 | [0.1258, 0.5120] |
| 強い事前 (率2割と思っている) | 0.2167 | 0.2119 | [0.1480, 0.2943] |
| (参考)最尤推定 6/20 | 0.3000 | 0.3000 | — |
一様とジェフリーズはほぼ同じで、強い事前分布だけが大きくズレます。
を増やせば事前分布の影響は消えるか
消えます。率を 30% に固定したまま を増やしました。
| 一様 | ジェフリーズ | 強い事前 | 最大の差 | |
|---|---|---|---|---|
| 20 | 0.31818 | 0.30952 | 0.21667 | 0.10152 |
| 50 | 0.30769 | 0.30392 | 0.23333 | 0.07436 |
| 200 | 0.30198 | 0.30100 | 0.26667 | 0.03531 |
| 1,000 | 0.30040 | 0.30020 | 0.29091 | 0.00949 |
| 10,000 | 0.30004 | 0.30002 | 0.29901 | 0.00103 |
が数百を超えると、事前分布を何にしても結論は実質同じになります。 事前分布の選択に神経を使う必要があるのは小標本のときだけです。
逆に言えば、小標本では事前分布が結論を左右するので、選んだ理由を説明できなければならない。 ここが「ベイズは恣意的だ」という批判の当たっている部分でもあります。
罠:不適切事前分布
上の表のハルデーン事前分布 には注意が必要です。これは積分が発散するので、そもそも確率分布ではありません。こういうものを不適切事前分布(improper prior) と呼びます。
不適切でも事後分布がまともになるなら実用上は使えるのですが、壊れる場合があります。 のデータで計算すると、
| 事前分布 | 事後平均 | 95%上限 |
|---|---|---|
| 一様 | 0.04545 | 0.16110 |
| ジェフリーズ | 0.02381 | 0.11664 |
| ハルデーン | 定義できない | 定義できない |
では事後分布 自体が正規化できず、事後分布そのものが不適切になります(数値的には に退化します)。「無情報を極限まで追求する」と使えなくなる、という教訓です。ジェフリーズが という「ほどよく弱い」ところに落ち着いているのは、この意味でも合理的です。
ここで一度詰まった:MCMC が何なのか分からない
ここまでは共役事前分布のおかげで、事後分布が式で書けました。 二項 で、足すだけでした。
問題は共役でないときです。 そこで MCMC という道具が出てきます。
正直に書くと、私はここで完全に止まりました。教科書のメトロポリス法のアルゴリズムを読んで、手順を追うことはできました。「提案して、比を計算して、確率で受容する」。動きも分かる。でもそれが何をしている道具なのか分からない。
原因は後から分かりました。名前を分解していなかったのです。
MCMC は独立に発明された2つの技術がくっついた名前で、それぞれ別々に理解できます。そして先に理解すべきなのは後ろの「モンテカルロ法」のほうでした。こちらにはマルコフ連鎖が一切出てきません。
順番に積み上げます。
Step 1:モンテカルロ法は「計算する代わりに数える」
まず円周率です。統計は一切出てきません。
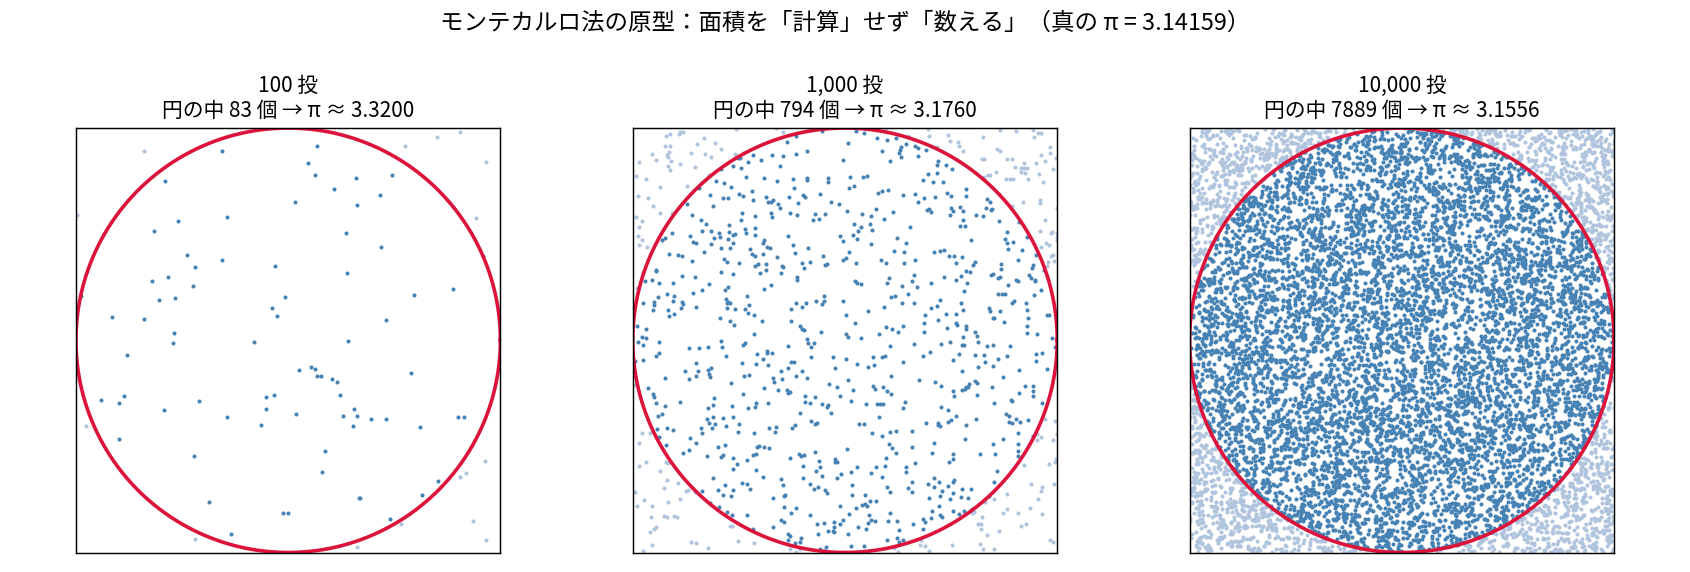
正方形にダーツをランダムに投げて、円に入った割合を数える。面積比が なので、 が になります。1億投で 3.141591(真値との差 )まで出ました。
積分も公式も使っていません。投げて数えただけです。 これがモンテカルロ法の全部で、それ以上の中身はありません。名前の由来もモナコの Monte Carlo(カジノの街)で、要はサイコロを振って答えを出す方法の総称です。
発想の転換はここです。
難しい「計算」を、たくさんの「数え上げ」に置き換える。
Step 2:統計に持ち込む
いま仮に、事後分布 から出た点が2万個手元にあるとします。
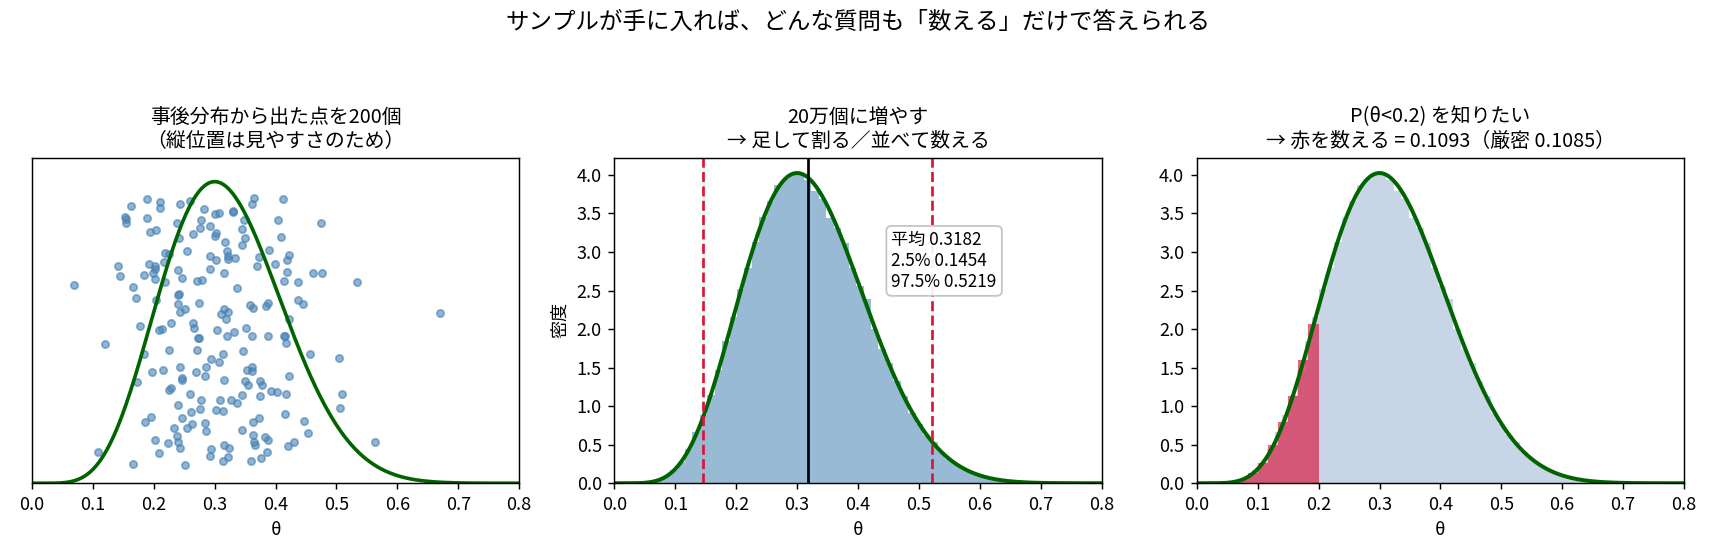
- 事後平均を知りたい → 足して割る
- 95%区間を知りたい → 並べて 2.5% と 97.5% の位置を見る
- を知りたい → 0.2 未満を数える
全部「数える」で済み、積分は一度も出てきません。個数を増やすと厳密解に収束します。
| サンプル個数 | 平均 | 2.5%点 | 97.5%点 | |
|---|---|---|---|---|
| 10 | 0.2811 | 0.1000 | 0.1406 | 0.4380 |
| 100 | 0.3151 | 0.1000 | 0.1778 | 0.5203 |
| 1,000 | 0.3133 | 0.1060 | 0.1472 | 0.5106 |
| 10,000 | 0.3174 | 0.1110 | 0.1450 | 0.5200 |
| 200,000 | 0.3182 | 0.1093 | 0.1454 | 0.5219 |
| 厳密解 | 0.3182 | 0.1085 | 0.1459 | 0.5218 |
さらに強いのが変換してから数えられることです。
| 知りたい量 | やること | モンテカルロ | 厳密解 |
|---|---|---|---|
| の事後平均 | そのまま平均 | 0.3184 | |
| オッズ の事後平均 | 全部変換して平均 | 0.5007 | |
| の事後平均 | 全部変換して平均 | 0.5575 | 0.5573 |
| の事後平均 | 全部変換して平均 | 3.4987 |
「オッズの分布が欲しい」「2群の差が欲しい」と言われても、サンプルを変換して数え直すだけです。積分をやり直す必要がありません。
ちなみに と が別物なのは第4回のイェンセンの不等式です。サンプルで扱うとこの区別が自動的に正しく処理されます。
Step 3:でも、そのサンプルはどうやって作るのか
ここが本題でした。 Step 2 では「事後分布からサンプルが出せる」ことを前提にしていました。
なら有名な分布なのでライブラリで一発です。しかしベイズで出てくる事後分布は「事前 × 尤度」というその場で作られた変な形の関数で、名前も付いていません。
素朴な方法が棄却法です。分布を囲む箱にダーツを投げ、曲線の下に入ったものだけ採用する(円周率と同じ発想)。
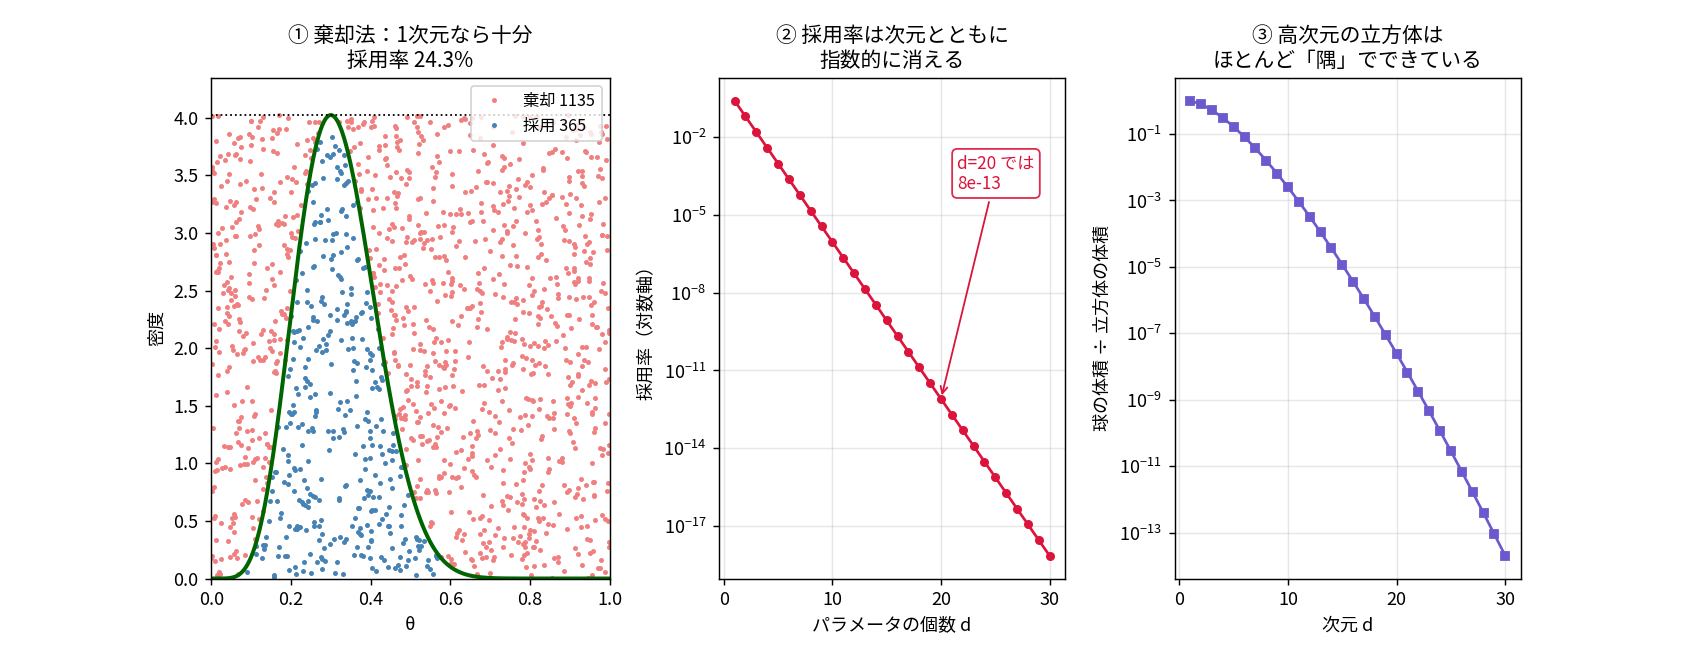
1次元なら採用率 24.3%(図に描いた1500投の試行)で十分実用的です。理論値は 24.8% で、下の表の の行がそれに当たります。ところが次元が上がると壊れます。
| パラメータ数 | 採用率 | 1個採るのに必要な投数 |
|---|---|---|
| 1 | 24.8% | 4 |
| 5 | 0.095% | 1,056 |
| 10 | 0.00009% | 111万 |
| 20 | % | 1.2兆 |
| 50 | % |
理由は棄却法の図の右パネルです。高次元の立方体はほとんど「隅」でできています。 では、立方体に投げたダーツが内接球に入る確率は しかありません。これが次元の呪い(curse of dimensionality) です。
参考に、真面目にグリッドで数値積分する道も潰れています。各軸100点で刻むと、
| パラメータ数 | 評価回数 | 1回1マイクロ秒として |
|---|---|---|
| 3 | 1秒 | |
| 5 | 0.116日 | |
| 10 | 317万年 | |
| 20 | 宇宙年齢の 倍 |
階層モデルではパラメータが数十から数千個になります。この道は原理的に閉じています。
棄却法の敗因は「毎回ゼロから独立に候補を出す」ことです。 良い場所を見つけても、その情報を捨てて、また当てもなく投げる。
ならば「今いる良い場所の隣」を次の候補にすればいい。
これがマルコフ連鎖の出番です。
Step 4:マルコフ連鎖の滞在時間は定常分布になる
第22回の内容ですが、必要な部分だけ確認します。
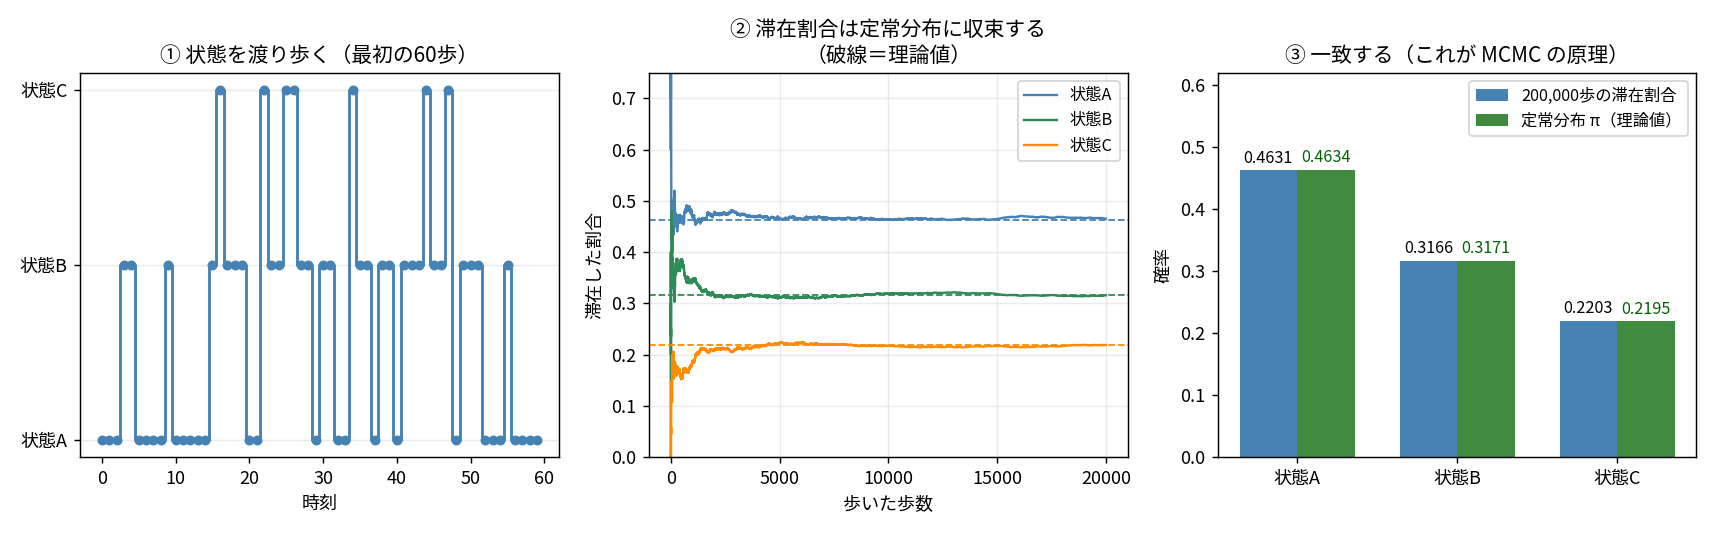
マルコフ連鎖とは「次の状態が今の状態だけで決まる」確率的な移動です。3状態 A・B・C を推移確率に従って渡り歩かせると、歩数を増やすにつれ「各状態にいた時間の割合」が理論値に収束します。
| 状態A | 状態B | 状態C | |
|---|---|---|---|
| 20万歩の滞在割合 | 0.4631 | 0.3166 | 0.2203 |
| 定常分布 (理論値) | 0.4634 | 0.3171 | 0.2195 |
一致します。この一致が MCMC の原理そのものです。
だから話を逆から組み立てられます。
定常分布が「事後分布」になるような歩き方を設計すれば、その足跡が事後分布からのサンプルになる。
全体の組み立て
ここまでを1本に繋げるとこうなります。これが最初から分かっていれば詰まらなかった部分です。
- 事後平均や区間が知りたい → 積分が必要 → 高次元では不可能
- でもサンプルがあれば数えるだけで済む(=モンテカルロ法)
- じゃあサンプルをどう作るか → 棄却法は高次元で死ぬ
- 今いる場所の隣を歩くようにすれば高次元でも動ける(=マルコフ連鎖)
- 足跡の分布は定常分布になるので、定常分布=事後分布になるよう歩き方を設計する
- その足跡を数える(2に戻る)
| Monte Carlo(モンテカルロ) | Markov chain(マルコフ連鎖) | |
|---|---|---|
| 担当 | サンプルを使う側 | サンプルを作る側 |
| やること | 足して割る・並べて数える | 今いる場所の隣へ移動を繰り返す |
| 解決する問題 | 積分が計算できない | 高次元でサンプルが引けない |
| 代償 | 誤差が でしか縮まない | サンプルが独立でなくなる |
最後の代償は実測しました。同じ「20000個」でも、独立サンプルなら事後平均のばらつきは 0.000729、MCMC では 0.001395(1.91倍)。逆算すると MCMC の20000個は独立換算で約5458個分です。
つまり MCMC は「独立性を犠牲にして、高次元でもサンプルが引ける」という取引をしています。
メトロポリス法:比を取ると分母が消える
歩き方の設計に入ります。アルゴリズムはこれで全部です。
def log_target(th):
    if th <= 0 or th >= 1: return -inf
    return 6*log(th) + 14*log(1-th)      # 事後 ∝ θ^6 (1-θ)^14

cur = 0.5
for i in range(n_iter):
    prop = cur + normal(0, step)               # ① 隣を提案する
    logr = log_target(prop) - log_target(cur)  # ② 比を取る → 正規化定数が消える
    if log(uniform()) < logr:                  # ③ 確率 min(1, r) で受容
        cur = prop
    chain[i] = cur                             # ④ 棄却でも今の値を記録する
②が全ての仕掛けです。 比を取ると
計算できない分母が約分で消えます。 分子(事前×尤度)は手で書けるので、これは計算できる。つまり正規化定数を知らないまま、その分布からサンプルできてしまう。 ここがベイズ計算の歴史を変えた一点です。
歩き方を言葉にするとこうです。
登るときは必ず行く。下るときはときどき行く。
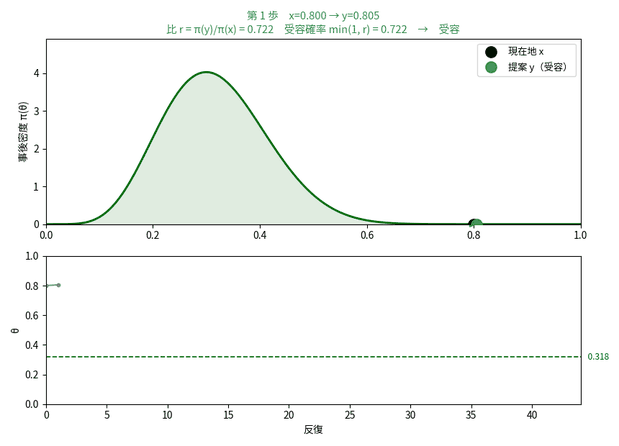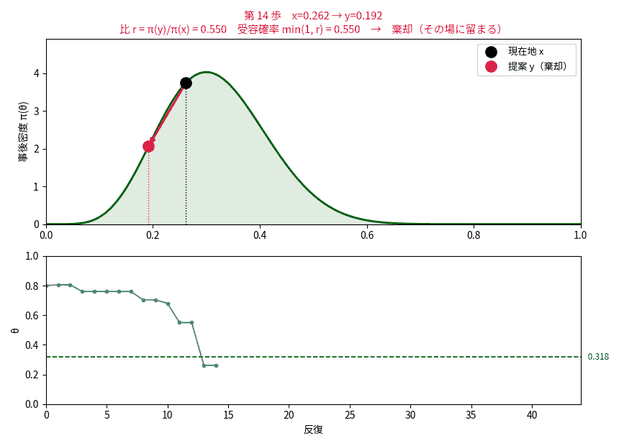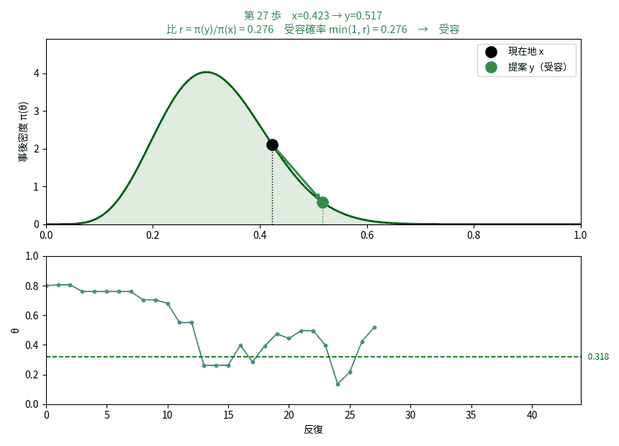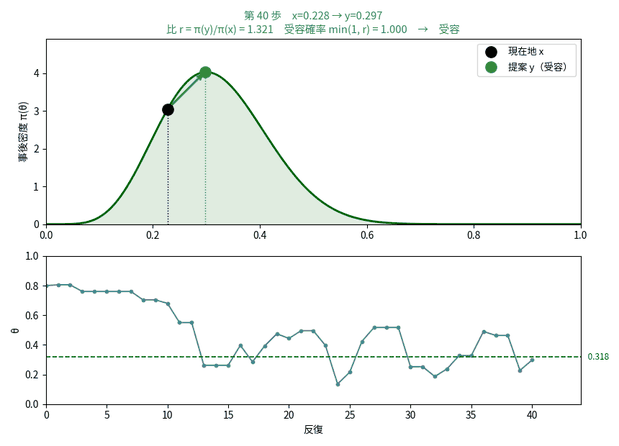
(提案先の密度が高い)なら必ず受容(緑)、 なら確率 で受容し、残りは棄却(赤)。アニメには比 と受容確率 を並べて表示してあるので、 が 1 を超えた歩がすべて受容されていることを確認できます。棄却されるとトレースプロットが横に平らになります。
初期値 0.80 は事後分布の端(密度がほぼ0の場所)なので、中央へ向かう提案は密度が上がる=坂を登る方向になります。だから最初はほぼすべて受容されて、山の中心へ吸い込まれていきます。実際、最初の40歩のうち15歩が で、そのすべてが受容されました。
④の「棄却でも記録する」を落とすとバグります。 棄却は「動かない」だけで、その場にもう1回滞在したことになる。記録しないと密度の高い場所の重みが失われます。
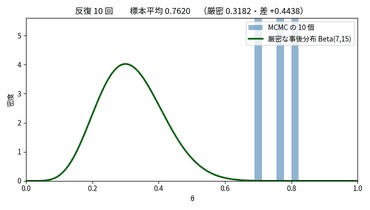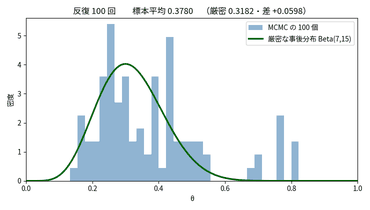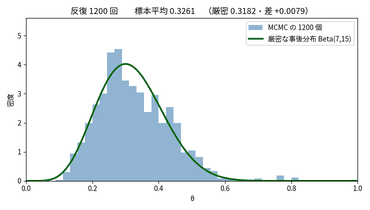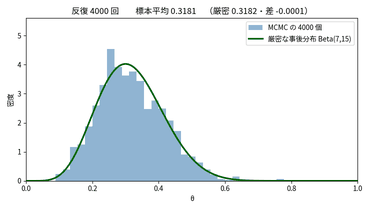
足跡を数えるだけで厳密な に一致していきます。標本平均は10回で 0.762(大外れ)→ 200回で 0.344 → 4000回で 0.31807(厳密値 0.31818 との差 )。
なぜ定常分布が事後分布になるのか:詳細釣り合い
「事後分布が定常分布になるような連鎖」をどう作るのか。詳細釣り合い(detailed balance) という条件を使います。
読み方は単純で、左辺が「 にいて へ移る量」、右辺が「 にいて へ移る量」。2点間の行き来が釣り合っているという意味です。全ての点対で流れが釣り合っていれば分布は変化しないので、 が定常分布になります。
メトロポリスの受容確率 は、この等式が成り立つように逆算して作られたものです。天から降ってきた式ではありません。確かめました。
| 左辺 | 右辺 | 差 | ||
|---|---|---|---|---|
| 0.25 | 0.40 | 2.6126456835 | 2.6126456835 | |
| 0.10 | 0.55 | 0.1862079399 | 0.1862079399 | |
| 0.32 | 0.33 | 3.8613035134 | 3.8613035134 |
差は倍精度の丸め誤差だけです。ぴったり釣り合っています。
が両辺に出てくることに注意してください。 今回は提案が正規分布で対称 なので が約分で消え、比が だけで書けました。対称でない提案を使う場合は の比も残ります。それが「メトロポリス法」と「メトロポリス・ヘイスティングス法」の違いです。
ここで条件の向きを正確にしておきます。 詳細釣り合いは が定常分布であるための十分条件であって、必要条件ではありません。 実際この記事の後半で使うギブスサンプリングは、 という決まった順番で更新する(決定的スキャン)ので詳細釣り合いを満たしませんが、 を不変に保ちます。「MCMC は必ず可逆」と覚えると間違えます。
もうひとつ、詳細釣り合いだけでは収束は保証されません。 第22回でやった既約性(どこからどこへでも行ける)と非周期性が別途必要です。後で出てくる二峰性の失敗例()は、まさに実質的に既約でなくなった状態です。
なお第23回のランダムウォークとの関係も見えます。提案 はただのランダムウォークで、それに受容判定という重み付けを加えると、目標分布に沿って歩くようになる。だからこの方式はランダムウォーク・メトロポリスと呼ばれます。
バーンイン:最初のほうは捨てる
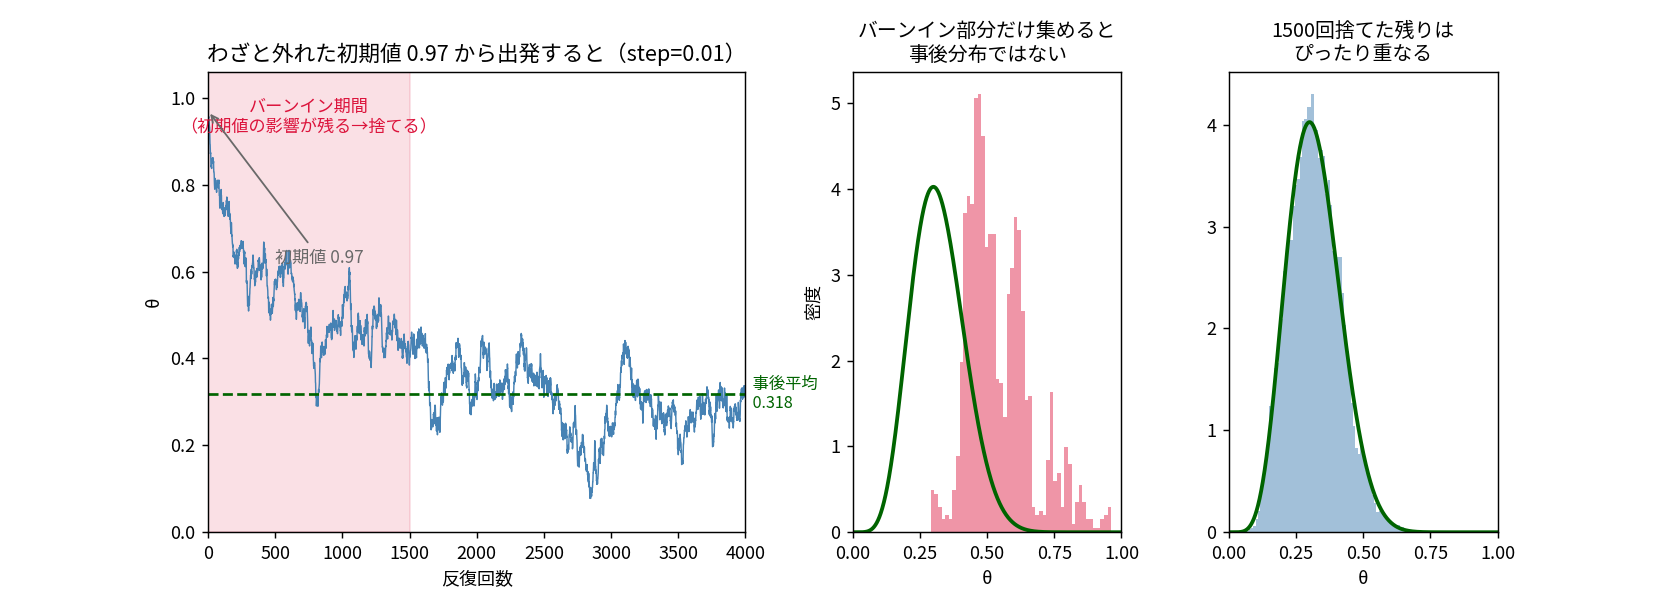
わざと外した初期値 0.97 から、しかも小さすぎる歩幅 0.01 で出発した例です。745 反復目でようやく 0.45 を下回ります。 この期間のサンプルは事後分布ではないので捨てます。
1500 回捨てると平均 0.31860 で厳密値 0.31818 と一致します。捨てないと 0.32423 とズレたままです。
歩幅のチューニング:受容率は高いほど良いのではない
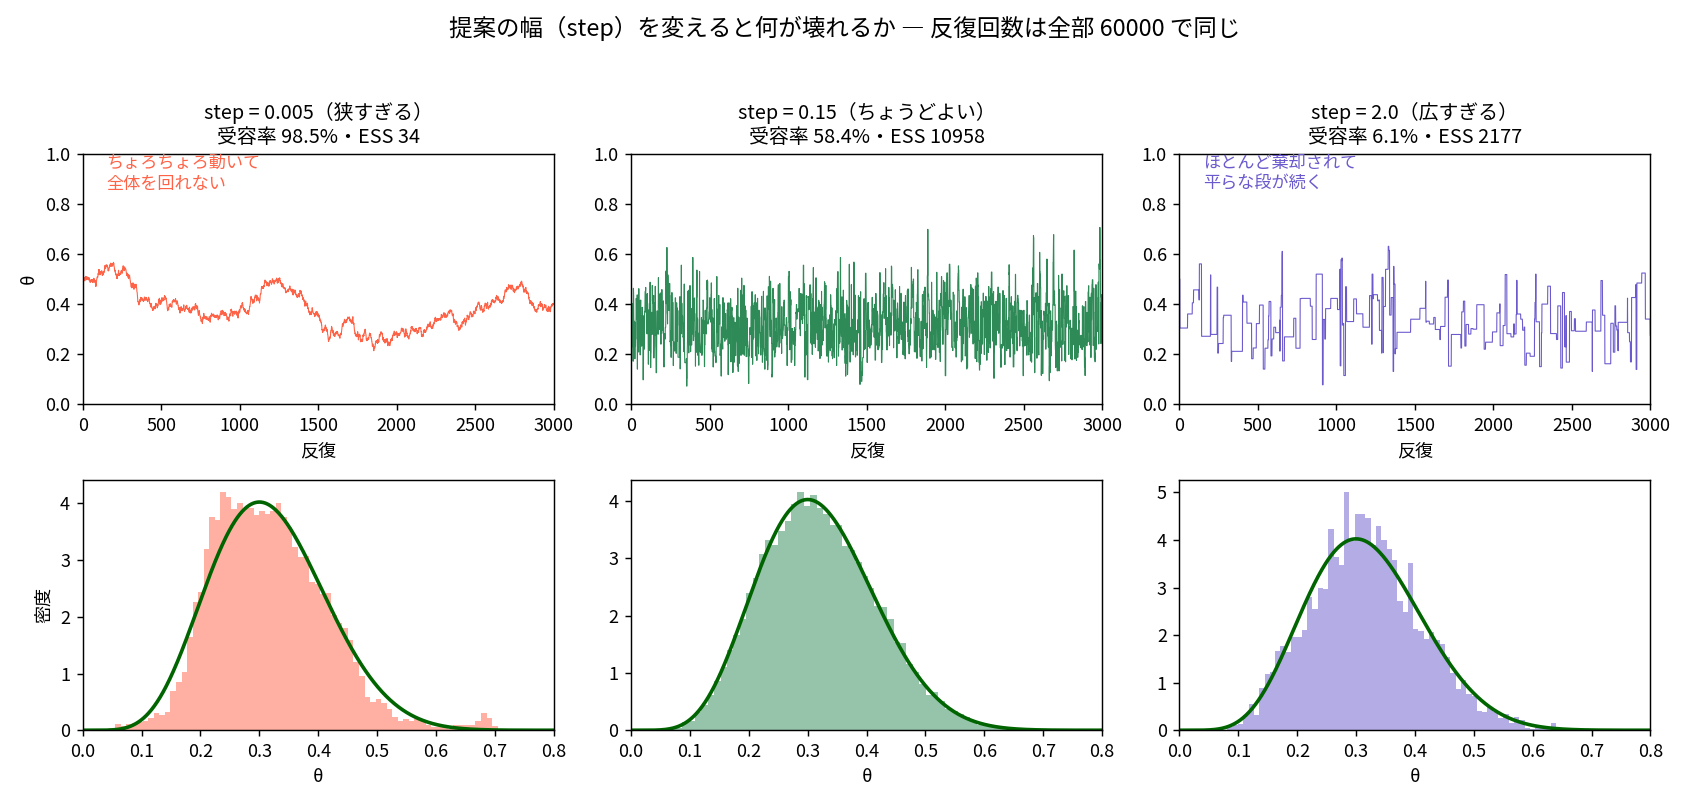
反復回数は3つとも 60000 で同じなのに、質が全く違います。
| 歩幅 step | 受容率 | ESS(有効サンプル数) | 事後平均 | 厳密値との差 |
|---|---|---|---|---|
| 0.005 | 98.5% | 34 | 0.31722 | |
| 0.03 | 90.4% | 1,160 | 0.31839 | |
| 0.15 | 58.4% | 10,958 | 0.31946 | |
| 0.5 | 23.7% | 8,853 | 0.31802 | |
| 2.0 | 6.1% | 2,177 | 0.31783 |
歩幅 0.005 は受容率 98.5% でほぼ全部通りますが、一歩が小さすぎて全体を回れません。58000 個記録しているのに、独立サンプル換算では 34 個分しかない。
逆に歩幅 2.0 は提案が遠すぎてほぼ棄却され、トレースが階段状に固まります。
受容率 20〜50% あたりが目安です(1次元の理論的最適は約 44%、高次元では約 23.4% という結果が知られています)。「受容率が高いほど効率がいい」は直感的ですが逆で、ここは引っかかりやすい点です。
なお表を見ると、ESS が小さくても事後平均自体はそれなりに当たっています(歩幅0.005 で誤差 )。ESS が効くのは「その推定値がどれくらい信用できるか」の側です。
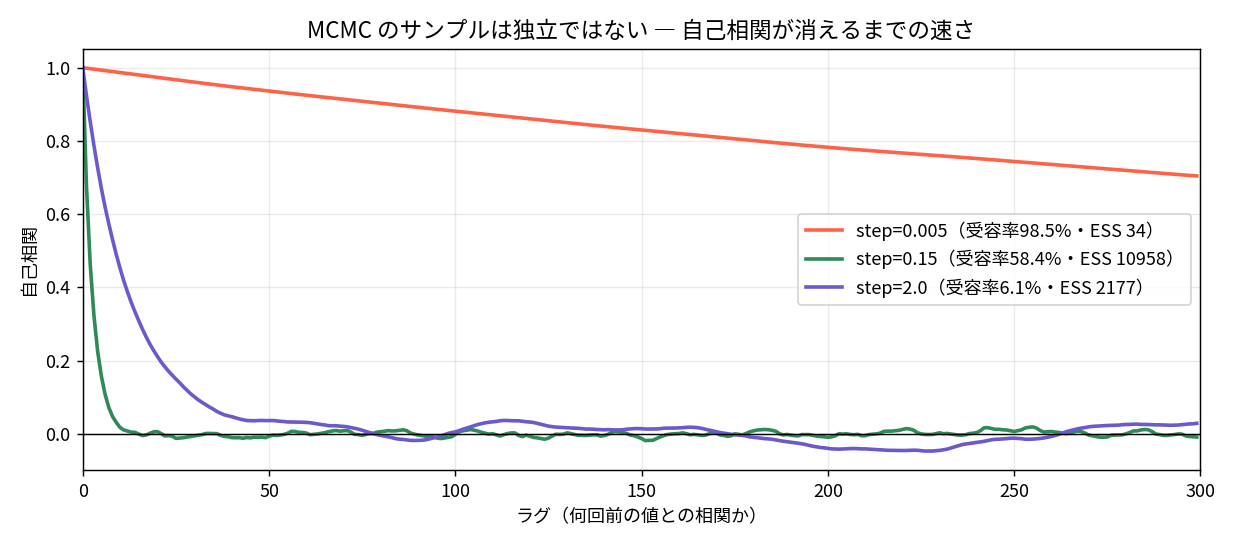
マルコフ連鎖なので隣り合うサンプルは似ています。赤(歩幅が狭い)はラグ 300 でも相関 0.70 が残っている――300回前の値をまだ引きずっています。この「相関が消えるまでの長さ」が ESS を決めます。
まとめて検証する
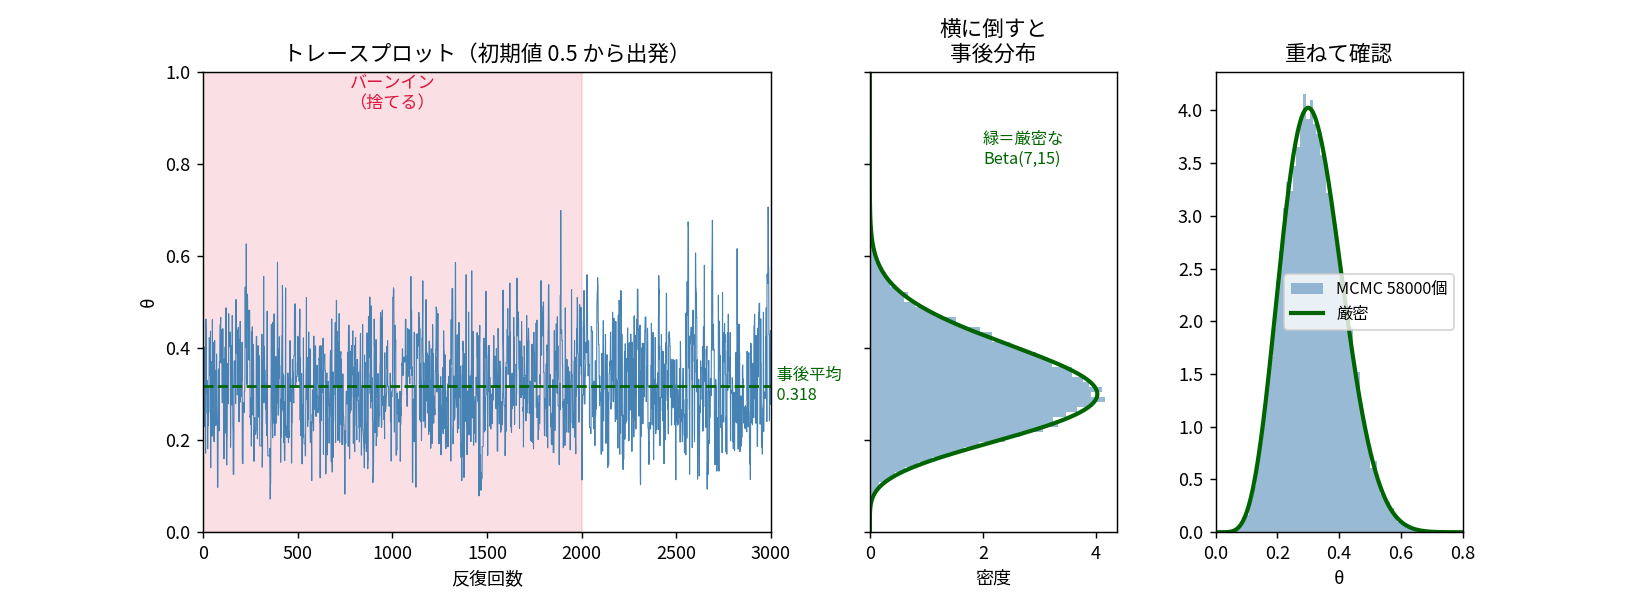
| 量 | MCMC(58000サンプル) | 厳密() | 差 |
|---|---|---|---|
| 事後平均 | 0.31946 | 0.31818 | |
| 事後標準偏差 | 0.09739 | 0.09712 | |
| 事後中央値 | 0.31316 | 0.31258 | |
| 2.5%点 | 0.14844 | 0.14588 | |
| 97.5%点 | 0.52266 | 0.52175 | |
| 0.10507 | 0.10851 | ||
| 0.96021 | 0.96082 |
サンプルの集まりが手に入ると、任意の質問が全部「数えるだけ」で答えられます。 積分をやり直す必要がありません。
共役でない実例に適用する
道具が揃ったので、手では絶対に解けない問題を解きます。ここで大事なのは、変えるのが2箇所だけだという点です。
prop = cur + rng.normal(0, 1, 2) * step        # ← 提案を2次元にした
if log(rng.random()) < log_post(*prop) - log_post(*cur):
    cur = prop
chain[i] = cur
アルゴリズム本体は1文字も変わりません。 差し替えるのは log_post の中身だけです。ここが MCMC が「あらゆるベイズモデルの標準解法」になった理由で、モデルごとに解法を考える必要がなくなりました。
例1:ロジスティック回帰をベイズでやる
第18回のロジスティック回帰を題材にします。記事の長さ (千字)とクリックの有無 (0/1)、。
この尤度には、手で扱える(名前のついた)共役事前分布がありません(さきほど見たとおり、共役族そのものは存在しても正規化定数が閉じた形で書けません)。だから事後分布は手では出ません。パラメータは の2個です。
書くのは事後分布の分子だけです。
def log_post(b0, b1):
    eta = b0 + b1*x
    log_lik = np.sum(y*eta - np.logaddexp(0.0, eta))   # ロジスティックの対数尤度
    log_pri = -(b0**2 + b1**2)/(2*5.0**2)              # 事前 N(0, 5²)
    return log_lik + log_pri
これだけで動きます。
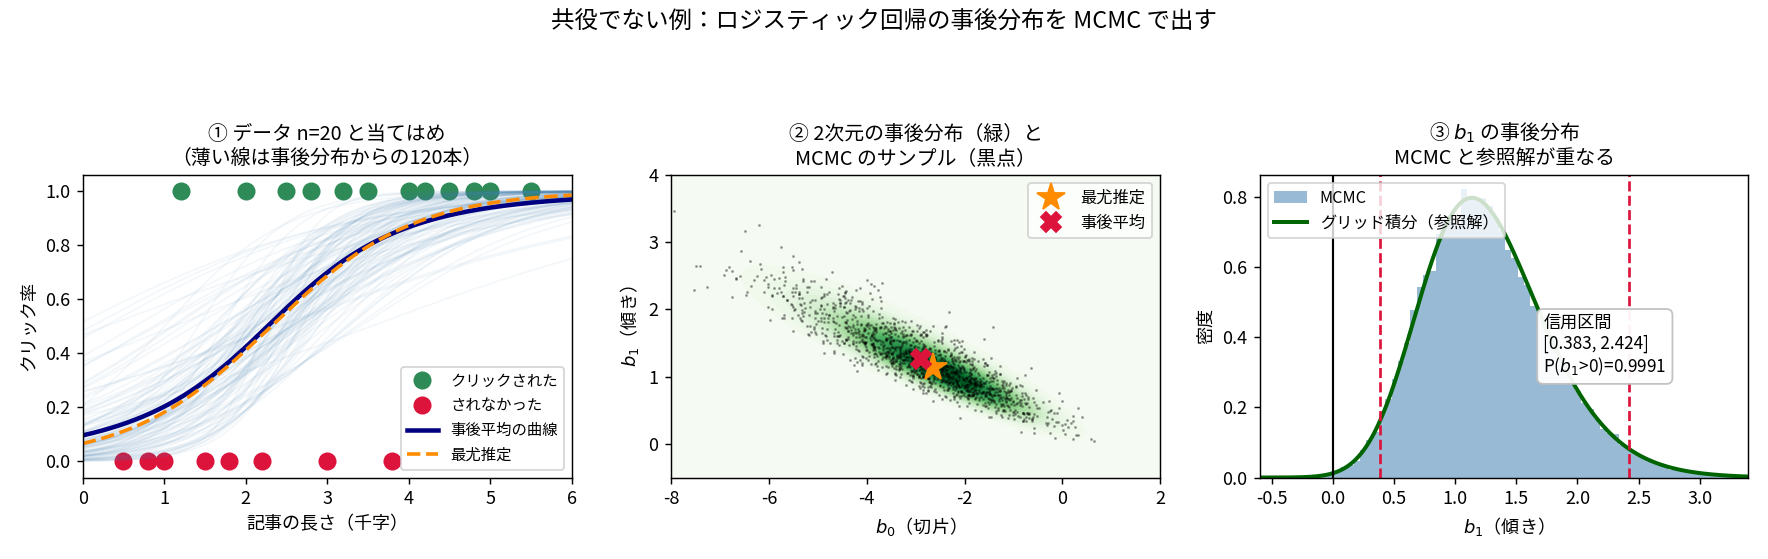
①データと当てはめ。 薄い青の線は事後分布から引いた120本の曲線で、これ自体が不確実性の可視化になっています。
②2次元の事後分布。 と は強く負に相関しています(相関 )。細長い斜めの形です。直感的には、切片を下げても傾きを上げれば同じデータを説明できるからです。この「斜めさ」は後でギブスの弱点として効いてきます。
③ の周辺事後分布。 MCMC のヒストグラムとグリッド積分が完全に重なっています。
なお今回はパラメータが2個なので、グリッド数値積分で答えを別途計算できます。 これを参照解にして MCMC を検証しました。
| 量 | MCMC(18万サンプル) | グリッド積分(参照解) | 差 |
|---|---|---|---|
| 事後平均 | |||
| 事後標準偏差 | 1.40441 | 1.40344 | |
| 事後平均 | 1.26964 | 1.27172 | |
| 事後標準偏差 | 0.52238 | 0.52264 | |
| 2.5%点 | 0.38321 | 0.37364 | |
| 97.5%点 | 2.42356 | 2.42260 | |
| 0.99912 | 0.99866 |
最後の行がベイズにしか書けない文です。「記事の長さの効果が正である確率は 99.9%」と直接言える。頻度論では p 値(データの珍しさ)しか出てきません。
最尤推定との比較: では結論がズレる
| の95%区間 | ||
|---|---|---|
| 最尤推定(第18回の方法) | 1.145 | [0.152, 2.138](ワルド) |
| ベイズ(事後平均) | 1.270 | [0.383, 2.424](信用区間) |
と小さいので一致しません。 の弱い事前分布が極端な値を抑える方向に効き、区間の下限が 0.152 → 0.383 と 0 から遠ざかっています。
さきほど「 が大きければ一致する」と書きましたが、その裏返しがこれです。小標本でこそ差が出ます。
予測:サンプルを変換して数えるだけ
ここが実務で一番効く部分です。
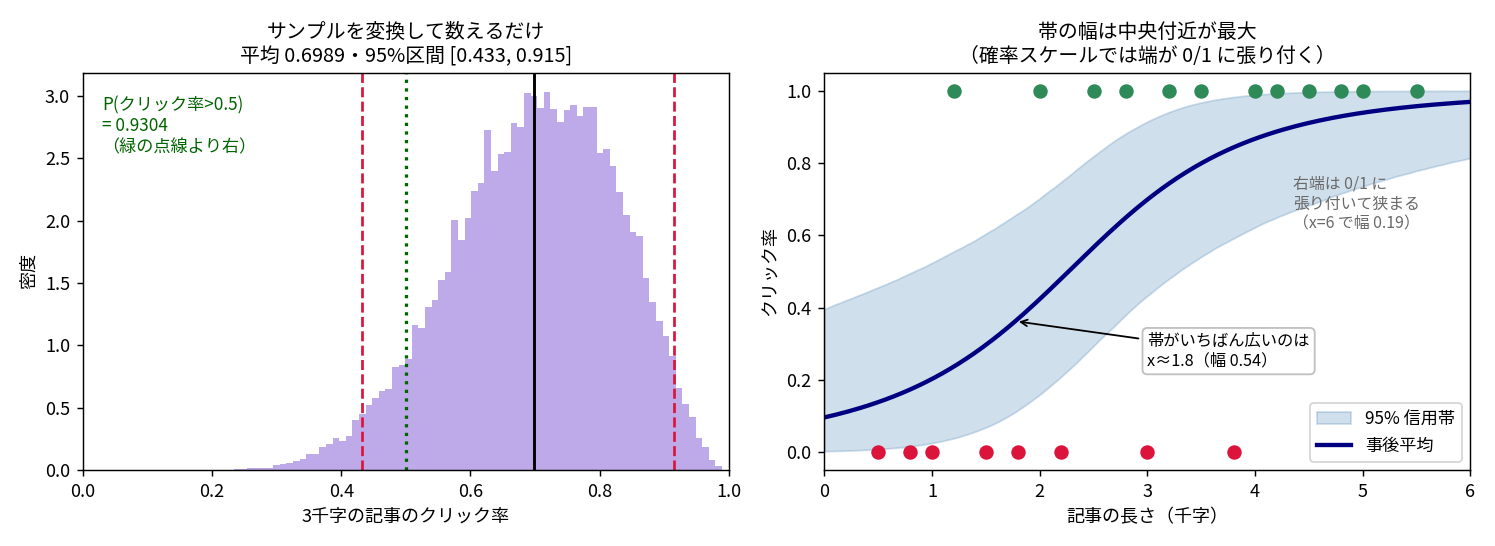
「3千字の記事のクリック率は?」に答えるには、18万個のサンプルそれぞれを変換して数えるだけです。
pr3 = 1/(1+np.exp(-(s[:,0] + s[:,1]*3.0)))   # 全サンプルを変換
pr3.mean()                                    # 0.6989
np.percentile(pr3, [2.5, 97.5])               # [0.4325, 0.9148]
(pr3 > 0.5).mean()                            # 0.9304
参照解(グリッド積分)の事後平均 0.6993 と一致します。
予測の図の右がこれを全ての でやったものです。頻度論なら誤差伝播の公式(デルタ法)を導出する必要がありますが、サンプルがあると変換して数えるだけです。
この図で自分の思い込みが崩れました。 最初は「データが薄い両端で帯が広がる」と書いたのですが、実測すると逆でした。
| (千字) | 0.0 | 1.0 | 2.0 | 3.0 | 5.0 | 6.0 |
|---|---|---|---|---|---|---|
| 帯の幅 | 0.393 | 0.498 | 0.543 | 0.482 | 0.263 | 0.186 |
計算した から 6 の範囲では、最大は中央付近()で、データが薄い右端がいちばん狭い。 理由は確率スケールだからです。 が大きいと予測が 1 に張り付くので、上にも下にも動く余地がなくなります。
線形予測子(対数オッズ)のスケールで測ると期待通りの形になり、同じ範囲で幅は 付近が最小の 2.52、 が最大の 7.68 と端で広がります。つまり「端で広がる」は対数オッズのスケールでの話で、確率に変換すると天井と床に潰されて逆転する、というのが正しい理解でした。
例2:ギブスサンプリング
もう1つの主要な MCMC 手法です。題材を変えます。身長データ で、平均 と標準偏差 の両方が未知。
ギブスが使える条件はこれです。
片方を固定すると、もう片方が共役になる。
ここでは を固定すれば は正規の共役、 を固定すれば精度 はガンマの共役になります。さきほどの共役の表がそのまま部品として使われます。
for i in range(n_iter):
    # ① σ を固定して μ を引く(正規の共役)
    prec = 1/s0**2 + n*tau
    mu  = rng.normal((m0/s0**2 + tau*data.sum())/prec, sqrt(1/prec))
    # ② μ を固定して τ=1/σ² を引く(ガンマの共役)
    tau = rng.gamma(a0 + n/2, 1/(b0 + ((data-mu)**2).sum()/2))
受容判定がありません。 棄却が0回、受容率 100% です。「提案して受け入れるか決める」のではなく、正しい分布から直接引いているので捨てる必要がありません。
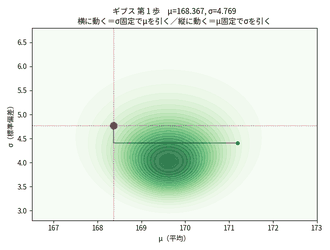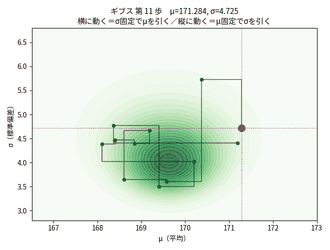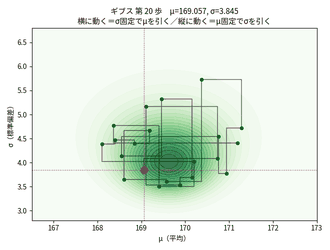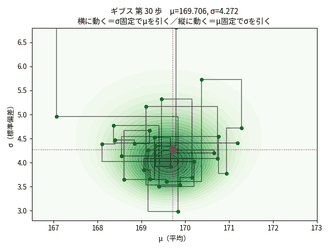
ギブスは「横→縦」の2段階でしか動きません。 斜めには決して動かない――一度に1つのパラメータしか更新しないからです。
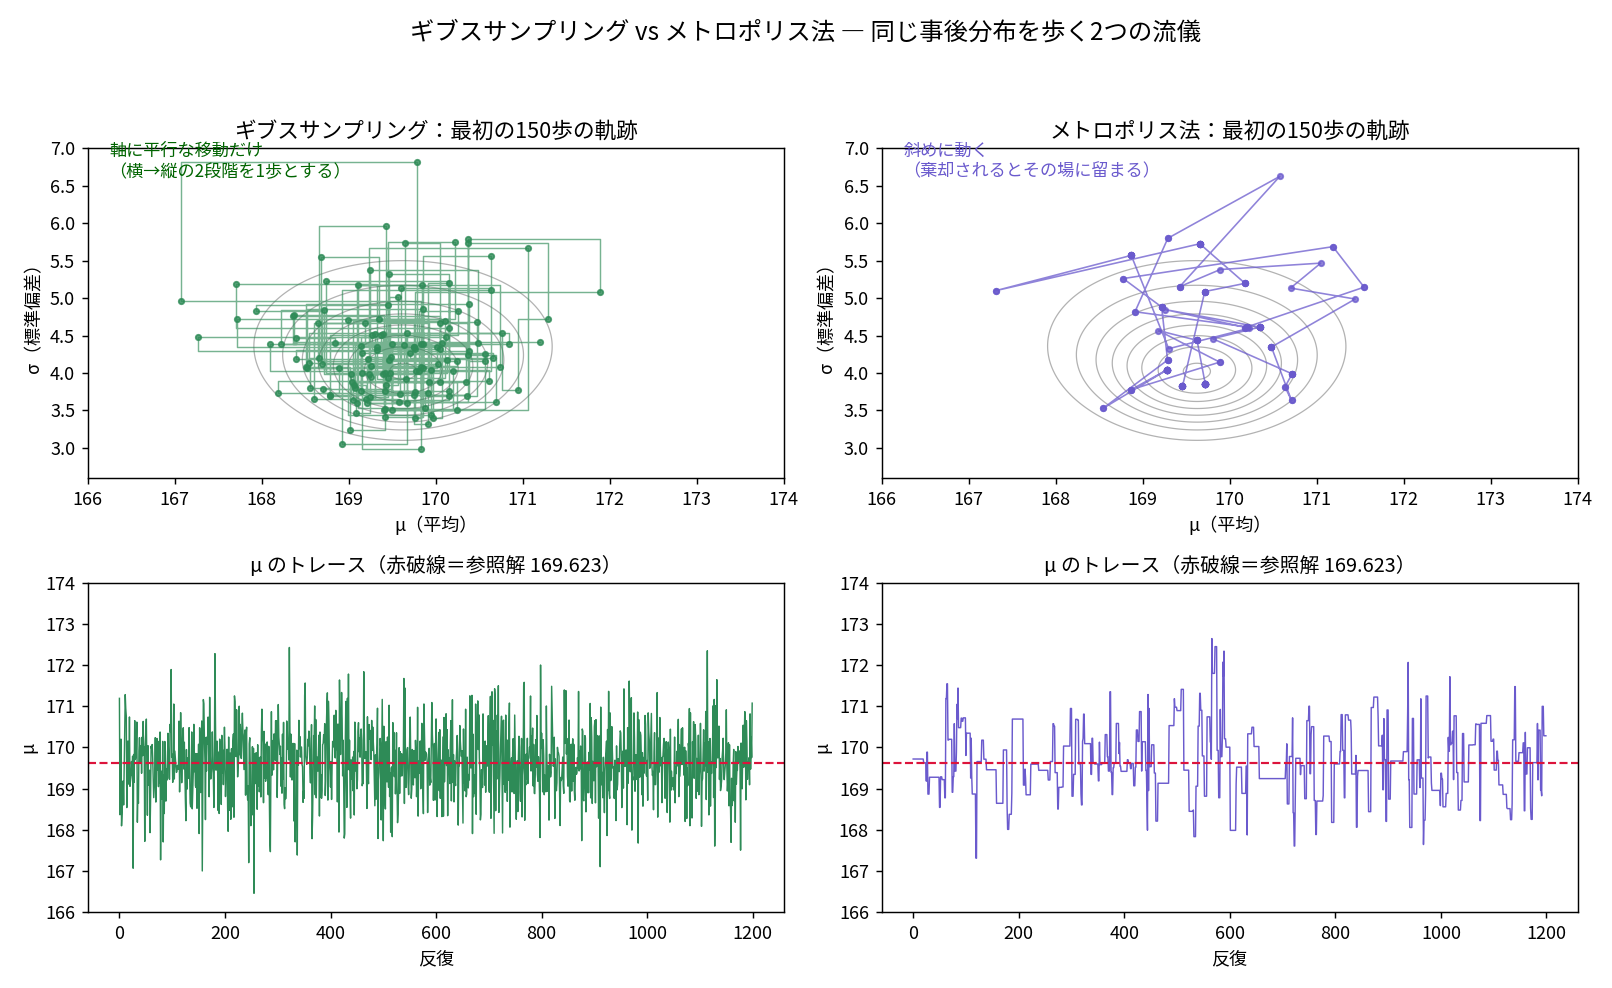
軌跡を並べた図の下段のトレースで差がはっきりします。メトロポリス(右)は平らな段が目立ちます(棄却されて動けなかった時間)。ギブスは(連続パラメータなので)毎回必ず動きます。
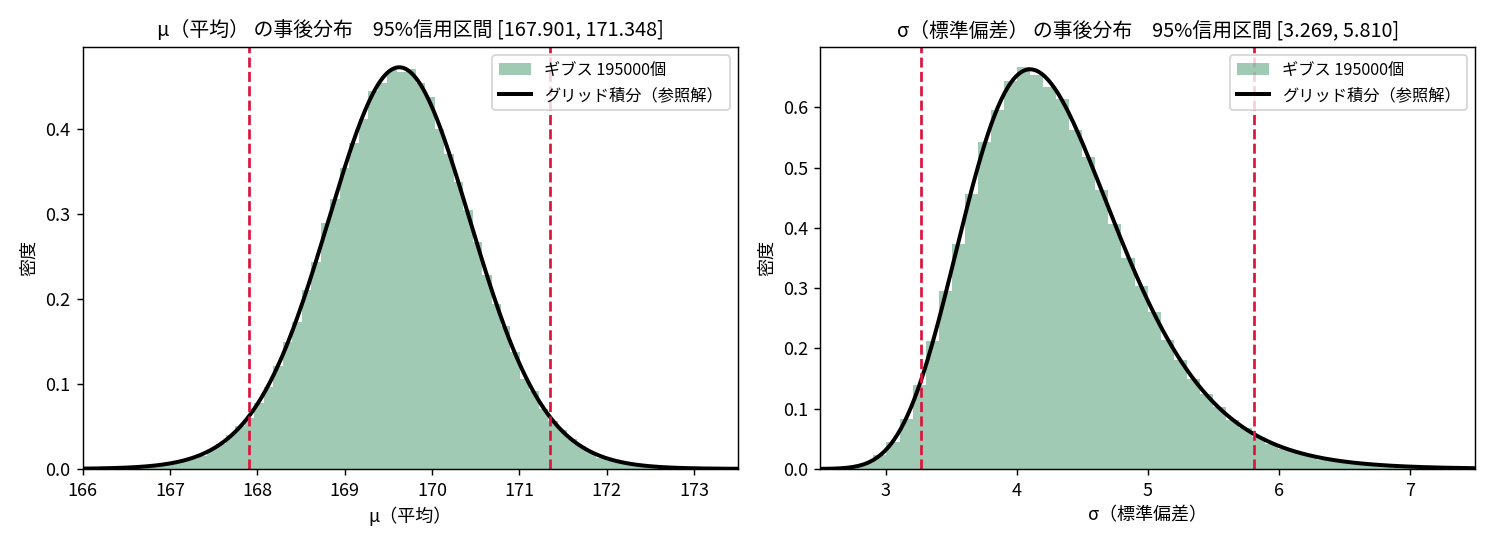
参照解と一致しています。 の事後分布が右に裾を引いて非対称なのが見どころで、「標準偏差の不確実性は上側に大きい」という、当然だが式では見えにくい事実が図に出ます。
| 量 | ギブス | グリッド積分(参照解) | 差 |
|---|---|---|---|
| 事後平均 | 169.62515 | 169.62317 | |
| 事後標準偏差 | 0.87154 | 0.87307 | |
| 事後平均 | 4.31886 | 4.32061 | |
| 2.5%点 | 3.26879 | 3.26095 | |
| 97.5%点 | 5.80961 | 5.81312 |
効率の比較:同じ問題・同じ反復数
| 受容率 | ESS() | ESS() | 事後平均 | 事後平均 | |
|---|---|---|---|---|---|
| ギブス | 100% | 193,434 | 172,421 | 169.6251 | 4.3189 |
| メトロポリス | 23.8% | 24,800 | 17,060 | 169.6265 | 4.3259 |
| 参照解 | — | — | — | 169.6232 | 4.3206 |
反復数は両方 195,000 で同じなのに、ギブスの有効サンプル数は 7.8〜10.1倍。しかも ESS が反復数にほぼ等しい=ほとんど独立なサンプルが得られているということです。
ただし、どちらも正しい答えに収束しています。 差は「正しさ」ではなく「効率」です。ここは混同しやすい点なので強調しておきます。
使い分け
| メトロポリス・ヘイスティングス(本記事の実装は対称提案) | ギブスサンプリング | |
|---|---|---|
| 必要な準備 | 事後分布の分子が計算できればよい | 各パラメータの条件付き分布が既知の分布である必要 |
| 適用範囲 | ほぼ何でも | 条件付きが共役になるモデルだけ |
| 棄却 | ある(受容率の調整が必要) | ない(100%) |
| 調整すべき値 | 提案の幅 | なし |
| 動き方 | 斜めに動ける | 軸に平行のみ |
| 効率 | 低い(この例で ESS 24,800) | 高い(193,434) |
| 弱点 | 高次元だと歩幅の調整が難しい | パラメータ間の相関が強いと極端に遅い |
条件付き分布が書けるならギブス、書けないならメトロポリス。 これが判断基準です。
なお両者は別系統の手法ではありません。ギブスは受容確率が恒等的に 1 になるメトロポリス・ヘイスティングス法の特別な場合として導けます。だから「棄却がない」のも偶然ではなく、条件付き分布から直接引いている以上、必ず受け入れられるということです。
さきほど「決定的スキャンのギブスは詳細釣り合いを満たさない」と書いたことと矛盾するように見えますが、両方正しいです。各成分の更新それぞれは詳細釣り合いを満たす(だから MH の特別な場合と言える)のですが、決まった順番に合成したスイープ全体としては満たさない( の逆順にはならないため)。それでも各ステップが を不変に保つので、合成も を不変にします。
ギブスの弱点は、さきほどのロジスティック回帰の2次元事後分布に繋がります。パラメータ間の相関が強い(細長い斜めの分布)とギブスは極端に遅くなります。 軸に平行にしか動けないので、斜めの谷を進むのに小刻みなジグザグを繰り返すしかありません。例1のロジスティック回帰(相関 )でギブスを使わなかったのは、条件付きが共役でないことに加えてこの理由もあります。
なお両者は排他ではなく、一部のパラメータだけメトロポリスで更新する「メトロポリス内ギブス」が実務では多用されます。実際の統計ソフトでは、JAGS や PyMC が変数ごとにサンプラーを割り当てる一方、Stan は一律にハミルトニアン・モンテカルロ法(HMC)とその発展版 NUTS を使います(そのため離散パラメータを直接は扱えません)。
収束判定は主観的なのか
トレースプロットを目で見るだけでは不十分です。なぜ不十分なのかが今回いちばん納得できた部分でした。
二峰性の分布(山が2つ)で、4本の鎖を別々の初期値から走らせました。
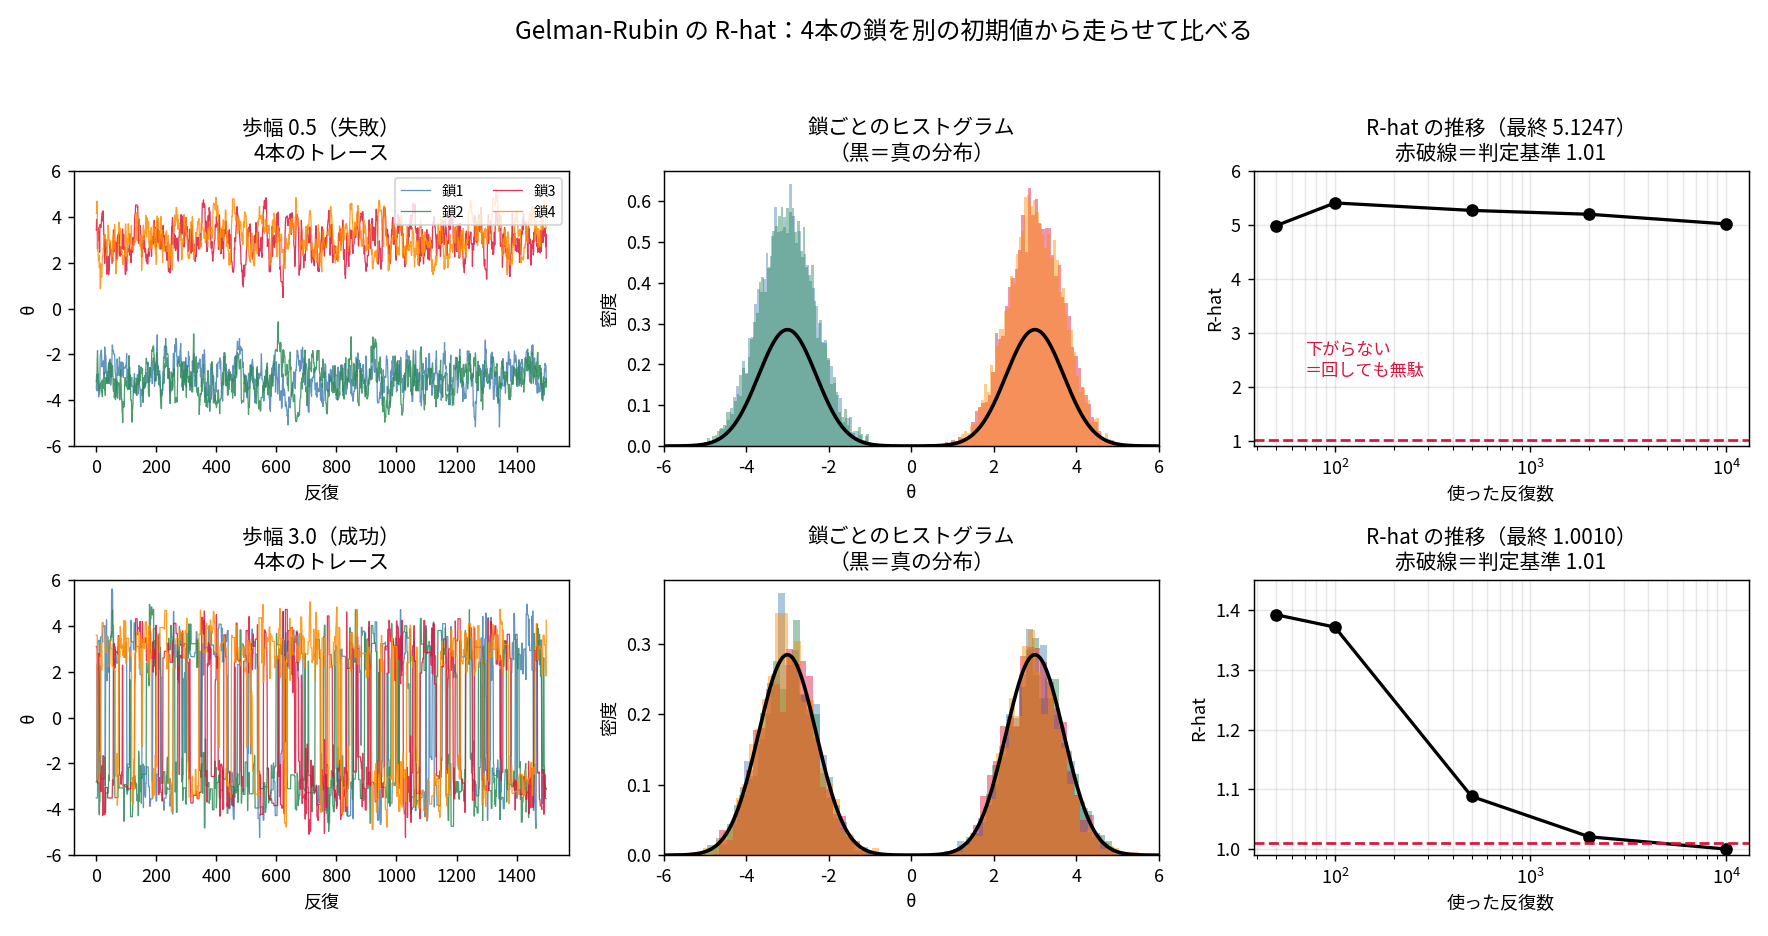
上段が失敗例(歩幅 0.5)。4本が2つの山に分断され、互いに行き来できていません。鎖ごとのヒストグラムを見ると、各鎖は片方の山しか見ていない。。
下段が成功例(歩幅 3.0)。山を越えられるので4本とも同じ分布に到達。。
は何を測っているのか
鎖と鎖の間のばらつき と 1本の鎖の中のばらつき を比べています。
- 収束していれば、どの鎖も同じ分布を見ている → →
- 収束していなければ、鎖が別々の場所に閉じ込められている → →
実測では失敗例で に対して (25万倍)。「トレースプロットを目で見る」を数値化したものが です。判定基準は慣習的に 1.01 未満(昔は 1.1 でしたが、近年は厳しめが推奨されます)。
なぜ複数の鎖が必要か
ここが最重要です。 失敗例の第1鎖だけを見ると、
- 平均 、標準偏差 0.6949
- 前半と後半の平均差 0.0204
完璧に安定して見えます。 ところが第3鎖は平均 で真逆の場所にいます。
この例では1本のトレースプロットからは気づけません。 だから「目で見る」だけでは不十分で、複数鎖+ が必要になります。
そして の図の右列の通り、失敗例では反復を増やしても が下がりません(5.0 のまま)。
| 使った反復数 | (成功例) | (失敗例) |
|---|---|---|
| 50 | 1.3921 | 4.9858 |
| 100 | 1.3714 | 5.4077 |
| 500 | 1.0883 | 5.2691 |
| 2,000 | 1.0207 | 5.1973 |
| 10,000 | 1.0002 | 5.0187 |
これが「いくら回しても無駄」のサインです。 収束していない鎖は、時間をかけても収束しません。
さらに厄介な罠
この失敗例、4本まとめた平均は で真の値 0 とほぼ一致してしまいます。 山が対称なので偶然打ち消し合ったのです。
しかし分布は完全に間違っており、 は実測 0.00160 対 真値 0.00213 でズレています。
「平均が合っているから大丈夫」は収束の証拠にならない。
これは自分でやってみないと気づけない類の罠でした。 を見ていれば 5.12 で即座に分かります。
階層ベイズ:他の記事の情報を借りる
ここからはブログのアクセス解析に直接使える話です。試験では用語レベルの扱いですが、実務でベイズを選ぶ理由がここに集中しているので数値で追いました。
困りごきから
記事30本のクリック率を知りたい。ただし表示回数がバラバラです(5回のものから2000回のものまで)。総表示 8,749回・総クリック 1,618回・全体率 0.1849。
表示8回でクリック0回の記事は「クリック率0%」なのか。 明らかに違うのに、その記事のデータだけを見ると しか出てきません。
やり方は3つあります。
| 方法 | 考え方 | 問題 |
|---|---|---|
| ① 記事ごとに独立に推定 | 各記事の標本比率 | 表示が少ない記事の推定が暴れる |
| ② 全記事をまとめて1つの率にする | 総クリック ÷ 総表示 | 記事ごとの違いを全部捨てる |
| ③ 階層ベイズ・経験ベイズ | ①と②の間を に応じて自動で取る | — |
「階層」とは何が階層なのか
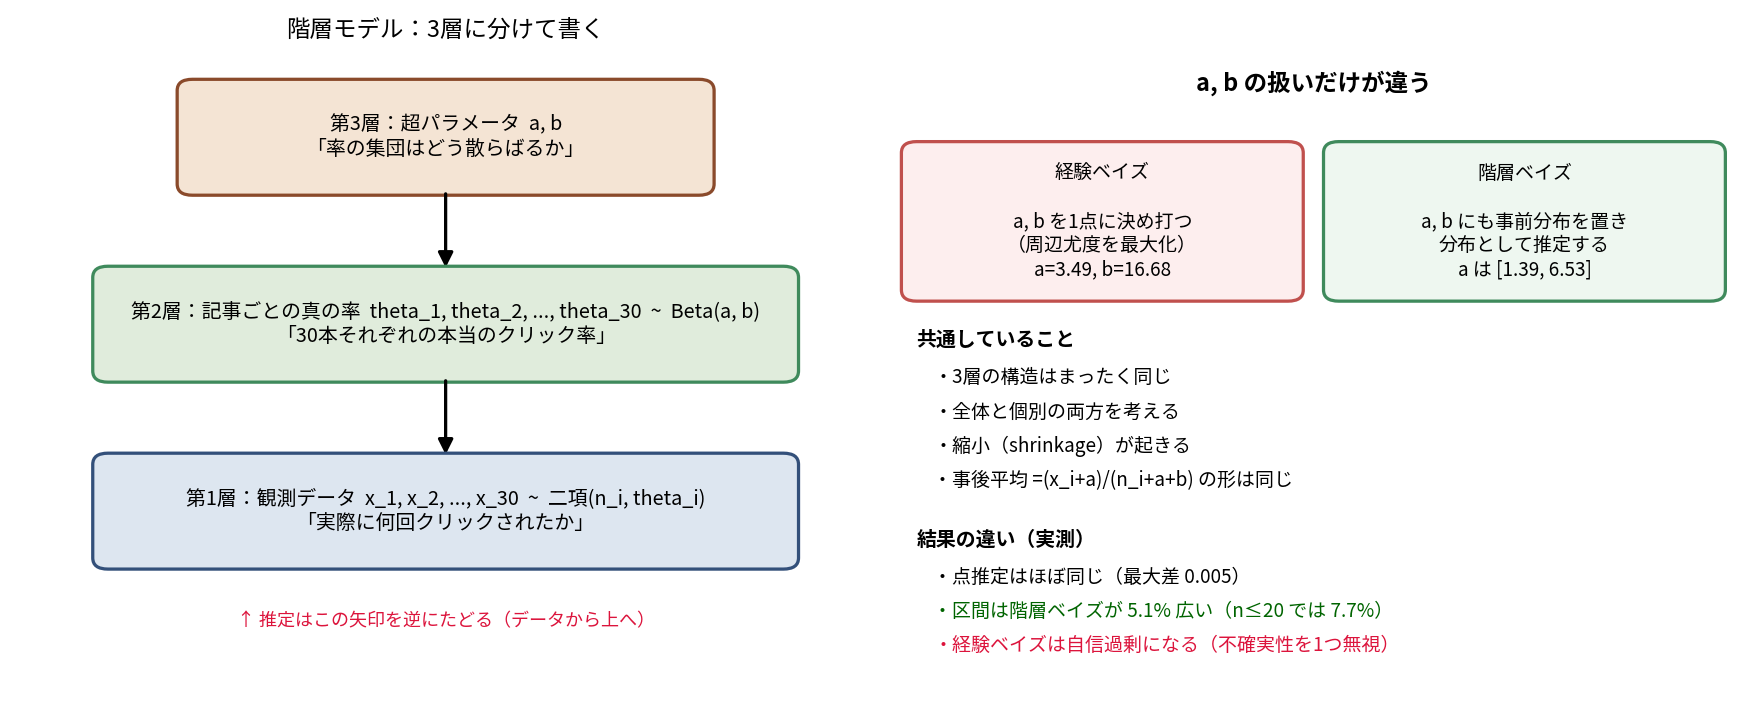
確率の指定が3段重なっていることを「階層」と呼びます。
| 内容 | 意味 | |
|---|---|---|
| 第3層 | 超パラメータ | 率の集団はどう散らばるか |
| 第2層 | 30本それぞれの本当のクリック率 | |
| 第1層 | 実際に何回クリックされたか |
下から読むと「データは で決まる」「その は から来ている」「その は…」と積み上がります。推定はこの矢印を逆にたどる作業です。
「記事ごとに違うが、無関係でもない」を階層で書いたのがこのモデルです。①は「全部無関係」、②は「全部同じ」と言っていたので、その中間を表現できるようになったことになります。
は何を表しているのか
ここが私がいちばん詰まった箇所でした。
は「30本の記事の真のクリック率がどう散らばっているか」を表す分布。
記事1本の率ではなく、率の集団を表しています。第2層に置かれているのが目印です。読み方は2通りあります。
読み方A:中心と集中度に分ける(意味を掴むならこちら)
| 量 | 計算 | 値 | 意味 |
|---|---|---|---|
| 中心 | 0.1732 | 記事全体の平均的なクリック率 | |
| 集中度 | 20.1706 | 大きいほど記事間の差が小さい | |
| 標準偏差 | 0.0822 | 記事間のばらつき |
つまり は「記事のクリック率は 0.173 ± 0.082 くらいに散らばっている」という主張です。実際の30本の真の率は平均 0.1808・標準偏差 0.0750 なので、データから正しく読み取れています。
読み方B:疑似データとして読む(計算に直結するのはこちら)
| 記号 | 値 | 読み方 |
|---|---|---|
| 3.4933 | 「あらかじめ 3.49 回クリックされていた」ことにする | |
| 16.6773 | 「あらかじめ 16.68 回クリックされなかった」ことにする | |
| 20.1706 | 合計 20.2 回分の疑似的な表示を全記事に足す |
この記事の前半で出てきたラプラススムージング(分子に1、分母に2を足す)は の場合でした。経験ベイズは「その足す数をデータから決める」版です。
実際の計算を1本の記事で追う
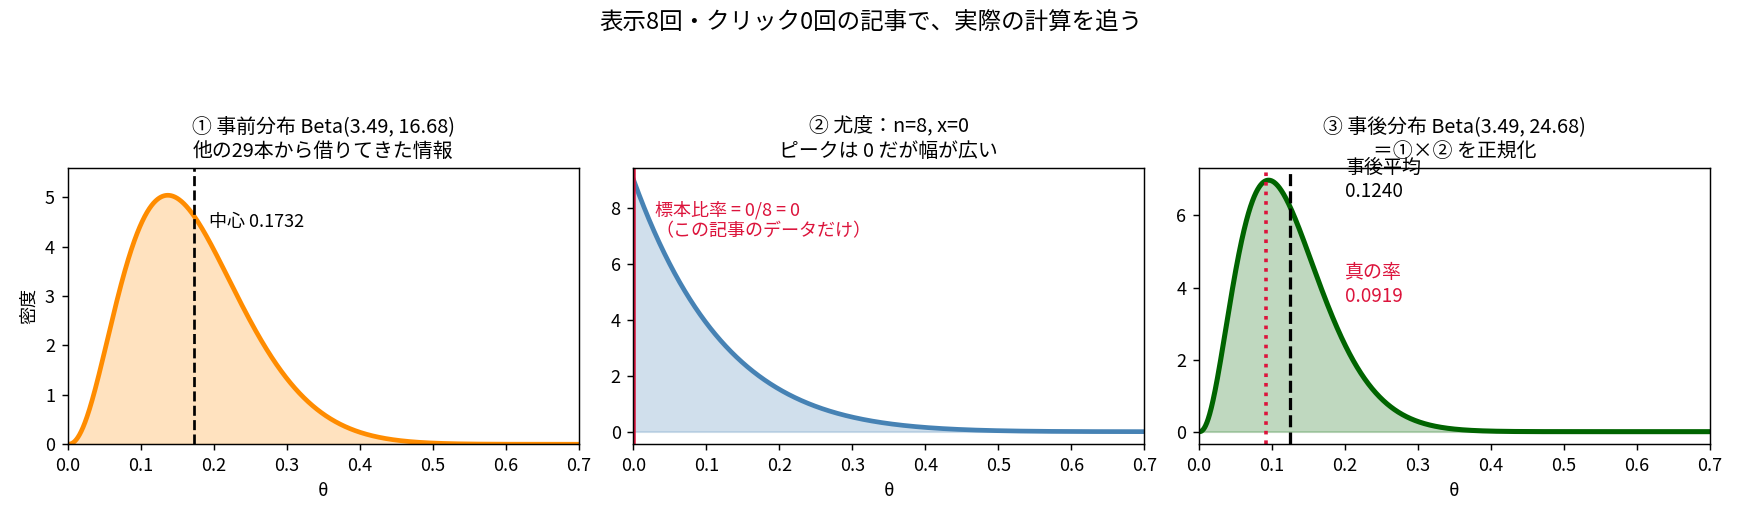
対象: 表示 回、クリック 回(真の率は 0.0919)
ステップ1:標本比率
これが「クリック率0%」という無意味な答えになる原因です。
ステップ2:事前分布を掛けて事後分布を作る
ベータ分布と二項分布は共役なので、足すだけです。
ステップ3:その平均を取る
真の率 0.0919 にかなり近い値です。
図の中央パネルが要点です。 が小さいと尤度自身の幅が非常に広く、「0 だと断定できない」と言っているので、事前分布に引かれる余地が生まれます。
ステップ4:重み付き平均に書き換える
ステップ3と一致します。自分のデータの重みは 28.4% しかなく、71.6% は全体平均から借りている。 これが「他の記事の情報を借りる」の具体的な意味です。
なぜ2つの式が同じなのかは、分数を書き換えるだけです。
1行目から2行目は分子を分けただけ、2行目から3行目は各項に と を掛けただけです。「縮小」という高級そうな話が、ただの分数の書き換えだったのがこの単元の気持ちよいところでした。
ステップ4は必要なのか(自分が引っかかった点)
ここで私はひとつ勘違いをしました。「ステップ4は本来必要な計算だが、今回はベータだから省略できるのだろう」と思ったのです。逆でした。
ステップ4はどんな場合でも計算には不要。ただし共役のときだけ、それが厳密な等式として書ける。
ステップ3で答えはもう出ています。ステップ4は同じ数を別表記にしただけで、新しい情報を1つも生みません。「 だけデータを信じ、残りは全体平均から借りている」という意味を見えるようにするための書き換えです。
つまり共役だと得なことが2つあります。
| 得られるもの | 共役でないと | |
|---|---|---|
| (A) | ステップ2〜3が「足すだけ」で終わる | 数値積分か MCMC が必要 |
| (B) | ステップ4の厳密な重み付き平均の形が存在する | そもそも書き換えられない |
(B) を実験しました。
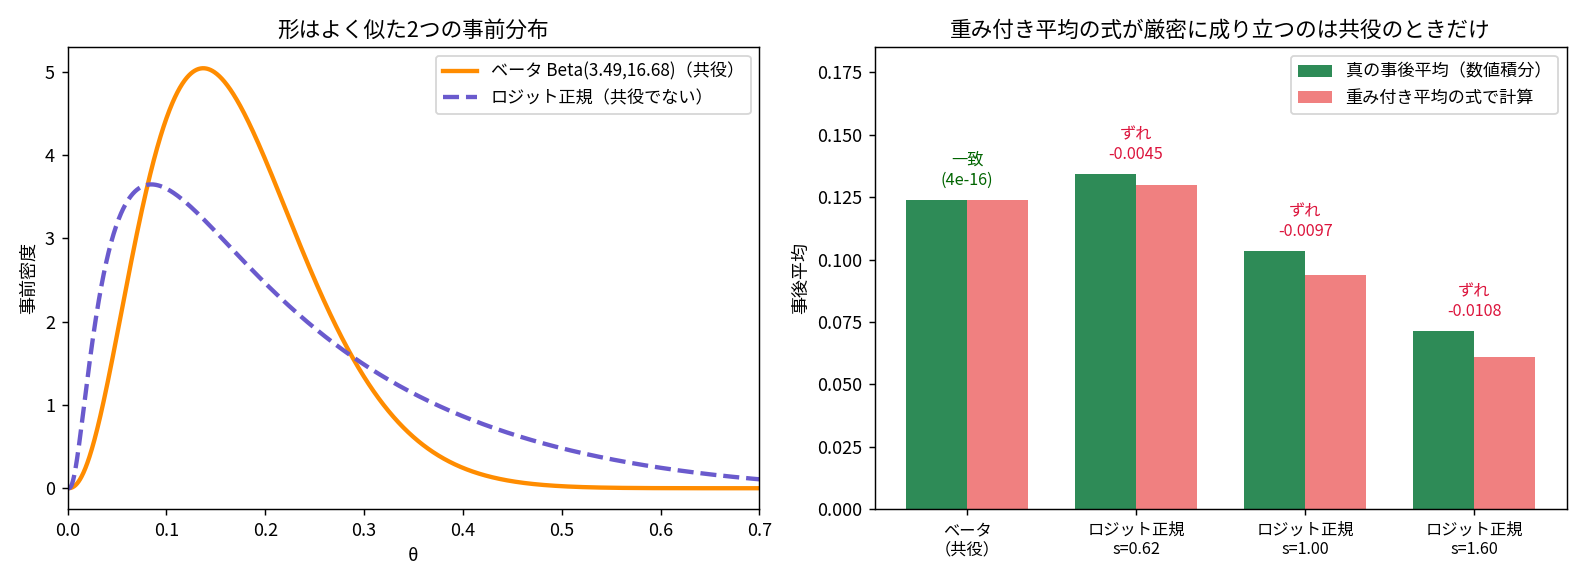
| 事前分布 | 真の事後平均 | 重み付き平均の式 | ずれ |
|---|---|---|---|
| ベータ (共役) | 0.124005 | 0.124005 | |
| ロジット正規 | 0.134419 | 0.129929 | |
| ロジット正規 | 0.103568 | 0.093872 | |
| ロジット正規 | 0.071530 | 0.060775 |
ベータでは倍精度の限界で完全一致、ロジット正規では オーダーのずれが残ります。
このきれいな直線の形は共役の副産物です。共役でないと、事後平均は標本比率と事前平均の線形結合では書けません(尤度と事前分布の形が非線形に絡むため)。
これは第19回のリッジ回帰との類似にも前提が付くことを意味します。 「縮小=重み付き平均」が厳密に成り立つのは、共役や正規モデルの場合だけです。
縮小の効果を測る
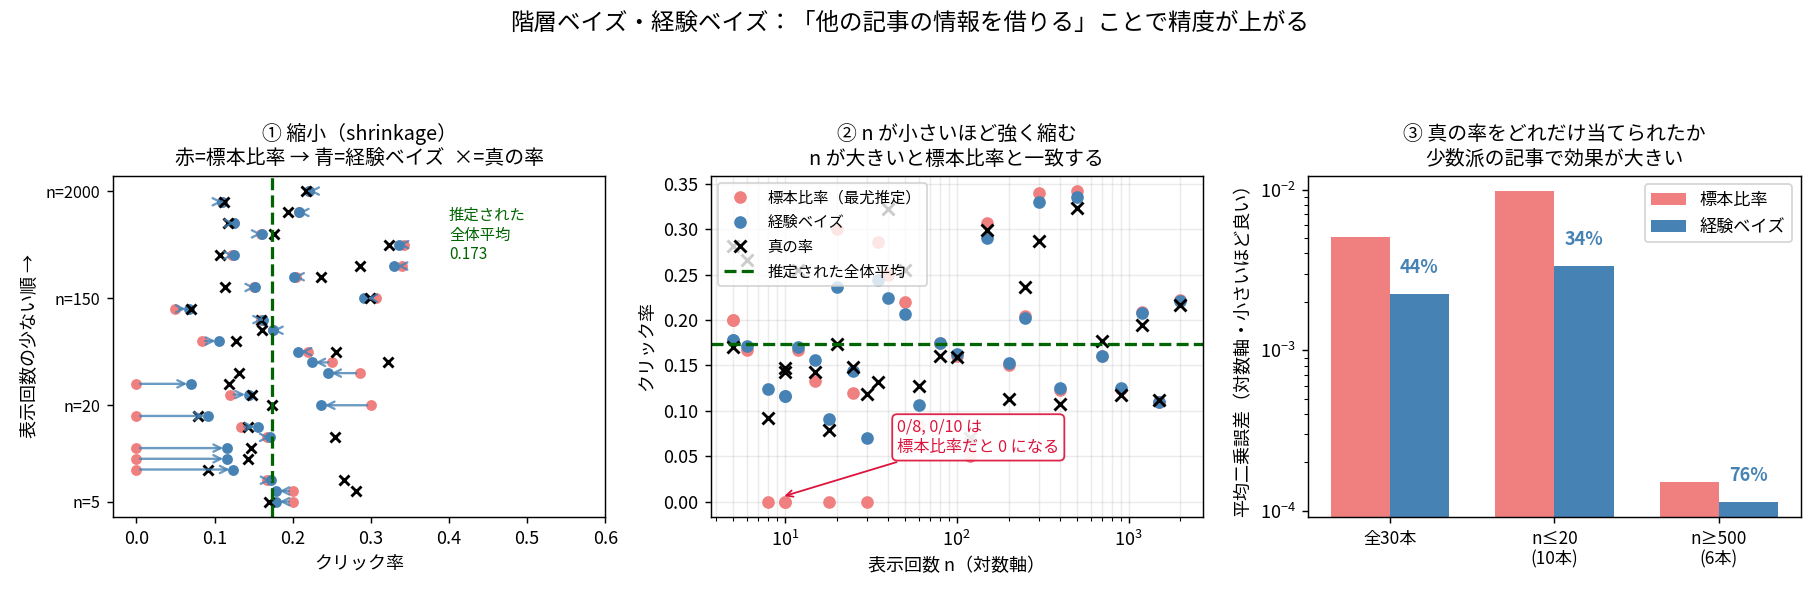
| 方法 | 平均二乗誤差 | 標本比率との比 |
|---|---|---|
| ① 記事ごとに独立に最尤推定 | 0.005064 | 1.000 |
| ② 全記事まとめて1つの率にする | 0.005457 | 1.078(悪化) |
| ③ 経験ベイズ(縮小推定) | 0.002233 | 0.441 |
①も②も負けて、その中間の③が勝ちます。 精度は 2.27 倍。表示20回以下の記事に絞ると 34.3%(約3倍)まで改善します。逆に表示500回以上では 75.8% で差が小さくなります。
と の記事は標本比率だと 0 になりますが、経験ベイズでは 0.124・0.116 に持ち上げられます(真の率は 0.092・0.143)。
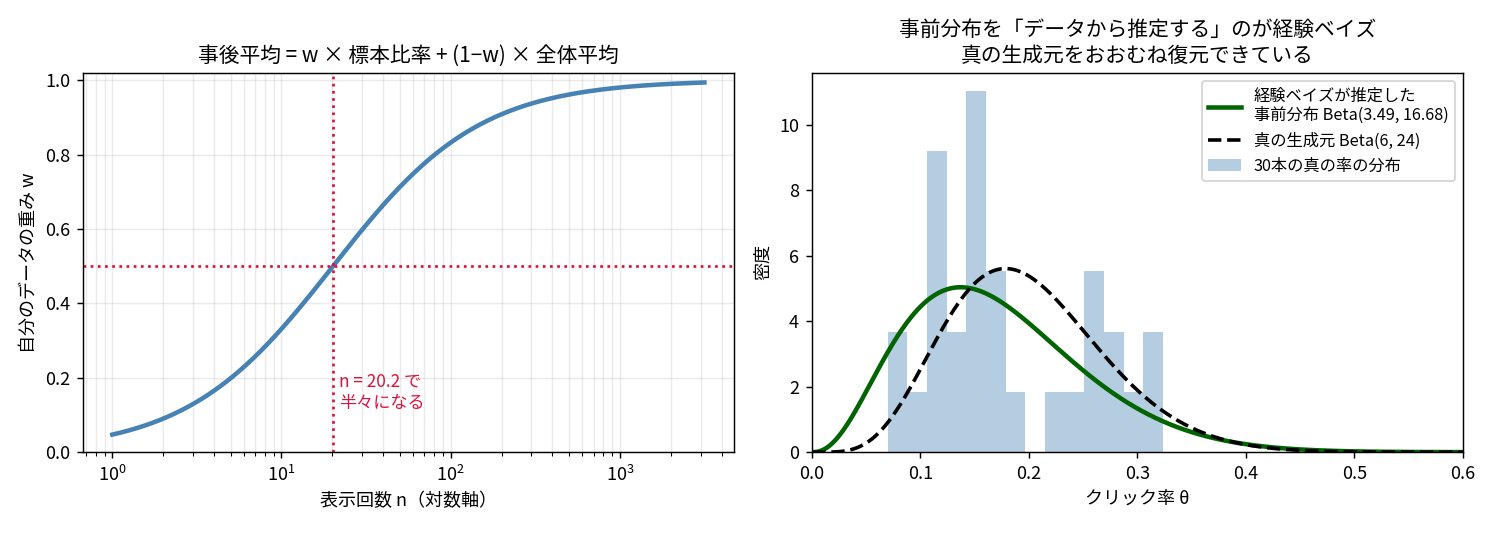
| 表示回数 | 自分のデータの重み |
|---|---|
| 5 | 0.1986 |
| 20 | 0.4979 |
| 50 | 0.7125 |
| 200 | 0.9084 |
| 2,000 | 0.9900 |
推定された事前分布が「20.2回分の疑似データ」に相当するので、 でちょうど半々になります。
同じ式・同じ を使っているのに、 が大きい記事はほとんど動きません。
| 項目 | の記事 | の記事 |
|---|---|---|
| データ | ||
| 標本比率 | 0.00000 | 0.22150 |
| 事後分布 | ||
| 事後平均 | 0.12400 | 0.22102 |
| 重み | 28.4% | 99.0% |
| 動いた量 |
「 に応じて自動で調整」の中身はこれだけです。足している疑似データが 20.2 回分なので、2000 回の実データの前では無視できる量になります。
これは第19回のリッジ回帰・Lasso と同じ話です。 あれも係数を 0 のほうへ縮めて精度を上げていました。「少し偏らせる代わりに分散を大きく減らす」というバイアス・バリアンストレードオフが、ベイズでは事前分布という形で自然に出てきます。
階層ベイズと経験ベイズは何が違うのか
ここまでの計算は経験ベイズでした。階層ベイズとの関係を整理します。
階層モデルの立場からは、経験ベイズは第3層を1点で近似したものと読める。
ただし「経験ベイズは階層ベイズの劣った版」という意味ではありません。経験ベイズは Robbins や James-Stein の流れで、頻度論的なリスク(平均二乗誤差)の観点から独立に正当化される手法です。事前分布の形を仮定しないノンパラメトリック経験ベイズもあります。
違いは第3層の扱いだけです。
| 経験ベイズ | 階層ベイズ | |
|---|---|---|
| の扱い | 周辺尤度を最大化して1点に固定 | 超事前分布を置いて分布として推定 |
| 計算 | 2変数の最適化(軽い) | MCMC(重い・収束判定が必要) |
の決め方(経験ベイズ) は、各記事の を積分で消してしまい、 だけの関数を最大化します。
が消えているので2変数の最適化で済みます。これが経験ベイズが軽い理由です。
ただしここに弱点があります。
| 周辺対数尤度 | |
|---|---|
| (3.493, 16.677) | ← 最大 |
| (3.993, 16.677) | |
| (2.993, 16.677) | |
| (3.493, 18.677) | |
| (3.493, 14.677) |
を 3.0 や 4.0 にしても周辺尤度は 0.7 しか下がりません。 つまり はあまり精度よく決まっていないのに、経験ベイズは 3.493 という1点に決め打ってしまう。この決め打ちの不確実性が結果に反映されません。
階層ベイズを実際に計算する
に超事前分布 を置き、MCMC で推定しました。 は共役なので解析的に積分でき、 の2次元だけメトロポリス法で動かせば済みます。 受容率 32.6%、4本の鎖で ()・1.0011()で収束を確認しました。
アルゴリズムは2段構えです。
for t in range(n_iter):
    # 【前半】a, b をメトロポリス法で1歩動かす(受容/棄却あり)
    prop = (a, b) + 提案のノイズ
    if log(uniform()) < log_marg(prop) - log_marg(cur):
        a, b = prop

    # 【後半】今の a, b で θ_i を1個引く ← これが「ステップ2」の分布
    for i in range(30):
        theta[t, i] = rng.beta(x[i] + a,  n[i] - x[i] + b)
後半の Beta(x+a, n−x+b) が、手計算のステップ2で作った分布そのものです。 共役なので「足すだけ」で書けるため1行で済んでいます。そして前半で が毎回変わるので、後半で使う分布も毎回変わります。
実際の反復を並べるとこうなります(, の記事について)。
| 反復 | 使う分布(ステップ2の計算) | 引いた | ||
|---|---|---|---|---|
| 1 | 3.7872 | 17.2891 | 0.2701 | |
| 2 | 2.9679 | 14.3536 | 0.0470 | |
| 3 | 6.4970 | 31.7293 | 0.1898 | |
| 4 | 2.4481 | 13.1810 | 0.0442 | |
| 5 | 3.3081 | 14.7154 | 0.1136 | |
| 12 | 2.0770 | 9.4009 | 0.3349 |
経験ベイズなら , 固定なので、右列が全部 の同じ分布になります。
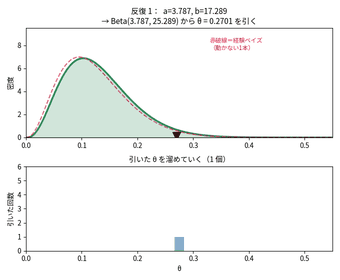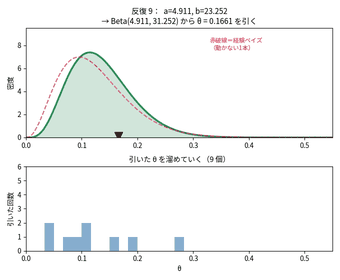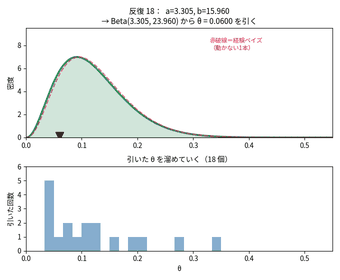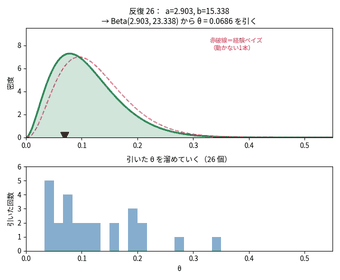
「毎回違う分布から1個ずつ引いて溜める」――これが階層ベイズの MCMC がやっていることの全部です。
結果として事後分布は「ベータ分布の混合」になる
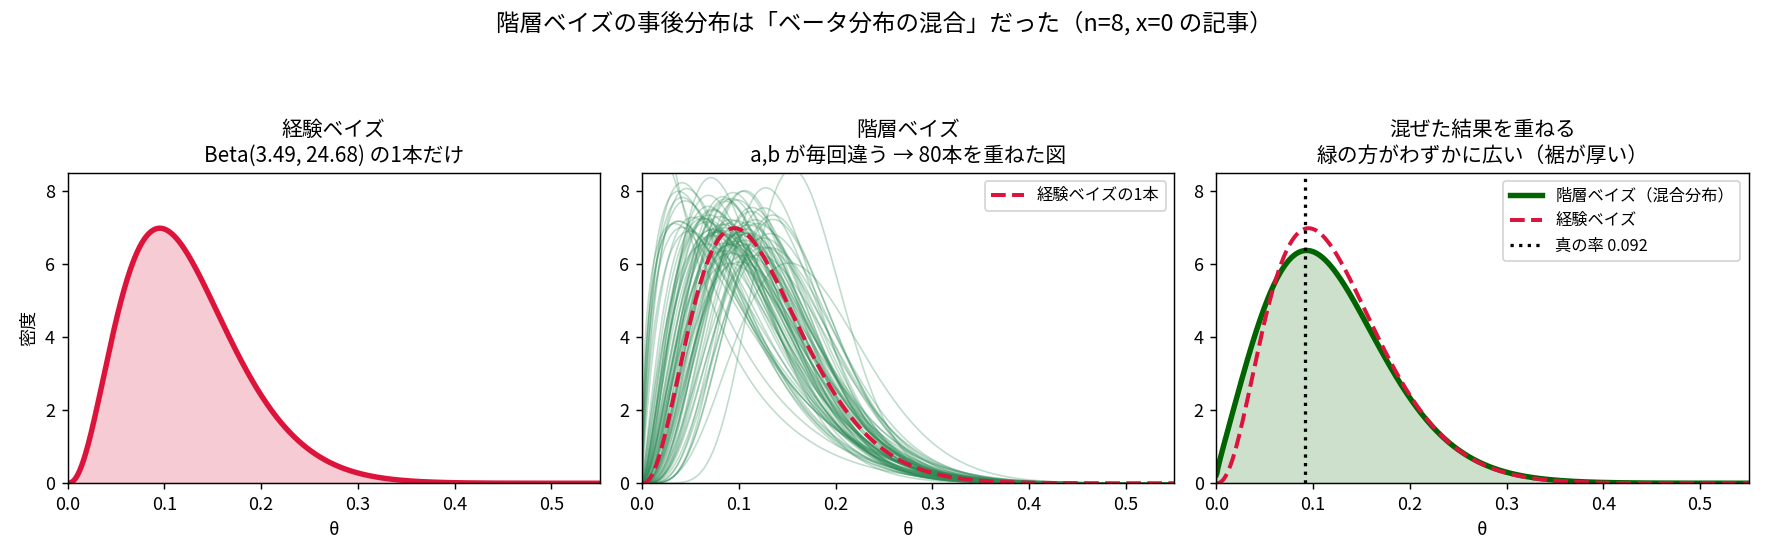
- 経験ベイズの事後分布 = 1つのベータ分布
- 階層ベイズの事後分布 = ベータ分布の混合分布
「混合」なので、成分の平均的な分散よりは必ず広くなります(全分散の公式で )。ただし比較相手である経験ベイズの1本は で とは別物なので、「必ず広い」が自動的に言えるわけではありません。この例では実測で広くなっていることを後で確認します。
差が出るのは点推定ではなく区間幅
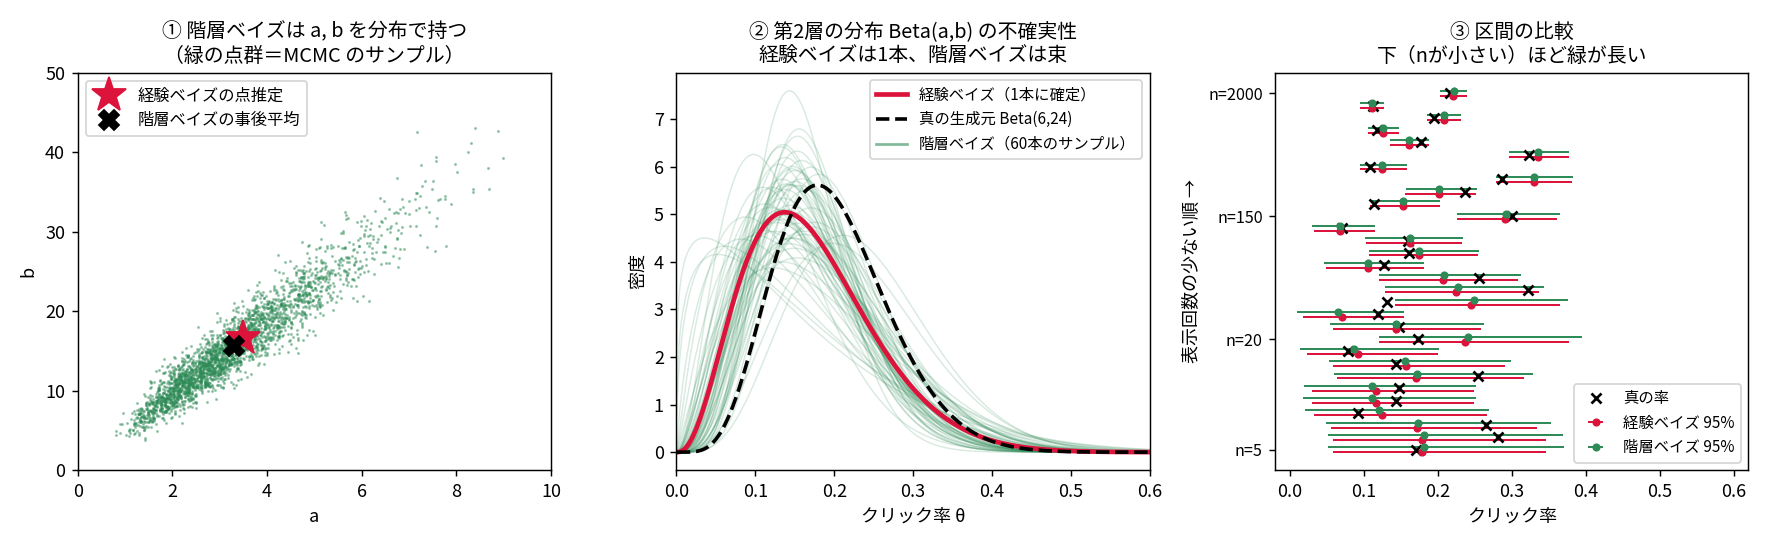
超パラメータの事後分布
| 事後平均 | 事後SD | 95%区間 | 経験ベイズの点推定 | |
|---|---|---|---|---|
| 3.3117 | 1.3376 | [1.389, 6.531] | 3.4933 | |
| 15.6191 | 6.2482 | [6.426, 30.686] | 16.6773 | |
| 中心 | 0.1757 | 0.0194 | [0.1395, 0.2159] | 0.1732 |
| 集中度 | 18.9307 | 7.5292 | [7.917, 37.067] | 20.1706 |
の95%区間が [1.39, 6.53] と非常に広い。 記事30本しかないので は精度よく決まりません。
点推定はほぼ同じ
| 方法 | 平均二乗誤差 | 標本比率との比 |
|---|---|---|
| 標本比率 | 0.005064 | 1.000 |
| 経験ベイズ | 0.002233 | 0.441 |
| 階層ベイズ | 0.002259 | 0.446 |
差は最大 0.00495・平均 0.00164 で、実用上区別がつきません。精度を上げたいだけなら経験ベイズで十分です。
違いが出るのは区間の幅
| 経験ベイズの平均幅 | 階層ベイズの平均幅 | 比 | |
|---|---|---|---|
| 全30本 | 0.15589 | 0.16391 | 1.051 |
| (10本) | 0.24475 | 0.26358 | 1.077 |
| (6本) | 0.04841 | 0.04846 | 1.001 |
階層ベイズの区間のほうが広い。 自体の不確実性を織り込んでいるからです。逆に言えば経験ベイズは自信過剰(不確実性を1段階分数え落としている)。
95%区間が真の率を含んだ割合はどちらも 96.7%(29/30本)でした。この例では実害は出ませんでしたが、 がもっと小さい・グループ数がもっと少ない場合は問題になります。
余分な不確実性を分解する
全分散の公式で2つに分けられます。
すべて「データを与えたもとで」の量です。以下では表記を簡単にするため条件付けを省略します。
| 項 | 値(, ) | 割合 |
|---|---|---|
| 第1項 | 0.00391258 | 92.08% |
| 第2項 | 0.00033663 | 7.92% |
| 合計 | 0.00424921 | 100% |
経験ベイズは第2項を丸ごと落としています。 を1点に決め打った瞬間に になるからです。
検算として、MCMC サンプルでの実測(平均 0.119194・標準偏差 0.064721)と厳密な混合分布の値(平均 0.119450・標準偏差 0.065186)が一致しました。経験ベイズの標準偏差は 0.061024 なので、階層ベイズは 1.068 倍です。
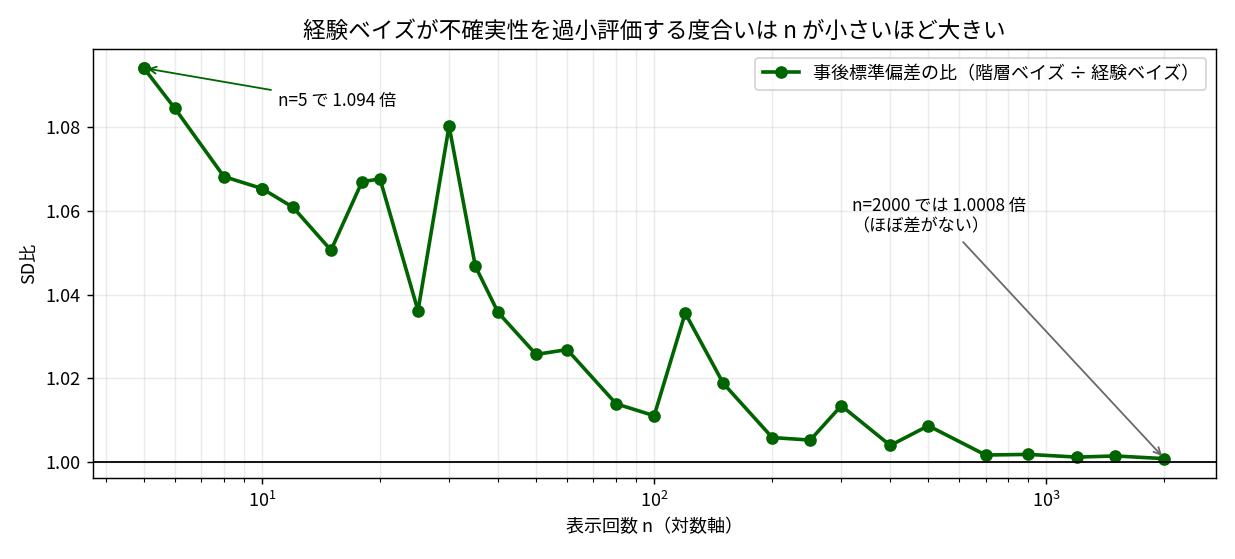
過小評価の度合いは が小さいほど大きくなります( で 1.094 倍、 で 1.0008 倍)。 が大きい記事は にほとんど頼っていない(重み が 99%)ので、 の不確実性も効かないのです。
ただし単調ではありません。 30本を の順に並べると9箇所で増加しており( の 1.0361 から の 1.0803 など)、 の値によっても変わります。 と比の順位相関は で、「おおむね減るが単調ではない」が正確な表現です。
同じ理由で、この比は第2項の割合だけでは決まりません。 なら のはずですが実測は 1.068 です。第1項 も経験ベイズの と等しくない( を平均する操作が条件付き分散そのものも動かす)ためで、この点は最初に書き間違えて検算で気づきました。
この「二段階」の正体は周辺化だった
階層ベイズの MCMC を見ていて、いちばん面白かったのがここです。
最終的に欲しいのは ではありません。 の分布を求めて、それに従って引いた の分布が欲しい。この二段階の構造に、統計学は名前を持っています。
| 用語 | 英語 | 意味 |
|---|---|---|
| 局外パラメータ(迷惑パラメータ) | nuisance parameter | モデルを書くのに必要だが、それ自体には興味がない量。ここでは |
| 周辺化 | marginalization | 局外パラメータを積分で消す操作 |
式で書くとこうです。
MCMC はこの二重積分を「引いて数える」で自動的にやっています。
- アニメの前半(メトロポリス法)= から引く
- アニメの後半(ベータから抽出)= から引く
「二段階」に見えたのは正しく、それが積分の構造をそのまま反映しているからでした。
そして経験ベイズは、この式の後半を1点に集まった分布で近似しています。
デルタ関数で置き換えると積分が消えて、ベータ分布1本だけが残る。 「経験ベイズ=1本、階層ベイズ=混合」の正体はこれでした。
同じ構造を第7回で既に見ていた
ここで伏線が回収されます。t分布がまさにこの構造です。
第7回で t分布を「分散を知らない罰金」として学びました。その中身はこうです。
を周辺化すると、ちょうど自由度 の t分布になります。つまり
t分布 = 正規分布の混合分布
今回の「階層ベイズの事後分布 = ベータ分布の混合」とまったく同じ構造です。
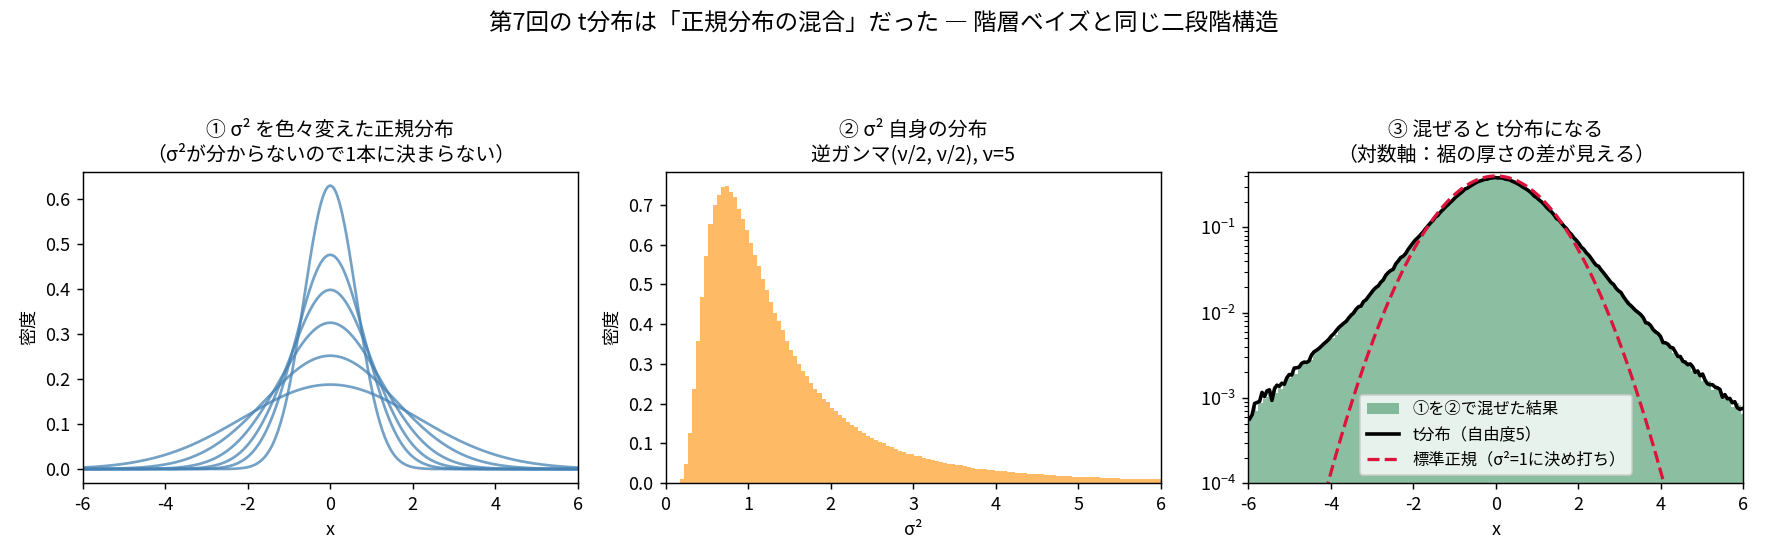
実験で確認しました。
| 自由度 | 95%点(混合をシミュレーションで作った) | 95%点(t分布の厳密値) | 差 |
|---|---|---|---|
| 3 | 2.3525 | 2.3534 | |
| 5 | 2.0158 | 2.0150 | |
| 10 | 1.8157 | 1.8125 | |
| 30 | 1.6972 | 1.6973 |
左の列は400万個の乱数によるシミュレーション値なので、 程度の差は乱数誤差です。
分散も一致します( で混合 1.6641 対 理論値 )。
そして「決め打つと自信過剰になる」のも同じ
| 自由度 | t の 97.5%点 | 正規の 97.5%点 | 区間の過小評価 |
|---|---|---|---|
| 3 | 3.1824 | 1.9600 | 38.4% |
| 5 | 2.5706 | 1.9600 | 23.8% |
| 10 | 2.2281 | 1.9600 | 12.0% |
| 30 | 2.0423 | 1.9600 | 4.0% |
| 100 | 1.9840 | 1.9600 | 1.2% |
(この列は数表と照合できるよう厳密値を載せています。)
「なぜ が小さいと ではなく を使うのか」の答えがこれです。 を1点(最尤推定値)に決め打つと、区間が で 38.4% も短くなります。
そして階層ベイズで見た「経験ベイズは区間が 5% 狭い」とまったく同じ種類の誤りです。一般化するとこうなります。
消すべきパラメータを最尤推定値のような中心的な1点に決め打つと、通常は自信過剰(区間が狭すぎる)になる。 正しく周辺化すると裾が厚くなる。
ただし「必ず」ではありません。代入する点の選び方で向きが変わります。 を最尤推定値ではなく事後平均 で代入すると、 では となり、t の 3.1824 より6.7% 広くなります(自信過小)。 では 2.5303 対 2.5706 で 1.6% 狭いだけです。
理由は階層ベイズのところで自分で見つけた不一致と同じで、 だからです。「1点に潰すと の項が消える」のは常に正しいが、同時に第1項も動くので、差し引きの符号は代入する点に依存します。
この構造が現れる場所の一覧
| 例 | 消したいもの | 結果 | 効果 |
|---|---|---|---|
| t分布(第7回) | が未知 | 正規分布の混合 | 裾が厚くなる |
| 負の二項分布(第5回) | ポアソンの がばらつく | ポアソンの混合 | 過分散になる |
| 階層ベイズ(今回) | が未知 | ベータ分布の混合 | 区間が広くなる |
| 予測分布(今回) | が未知 | 二項分布の混合 | ベータ二項分布になる |
| ランダム効果モデル | 群ごとの効果がばらつく | 正規分布の混合 | 群内相関が生じる |
第5回の負の二項分布がここに入るのが面白いところです。 第18回で「ポアソン回帰で過分散が起きたら負の二項分布にする」という手続きを扱いましたが、その中身は を周辺化した混合分布を使うということでした。
過分散=混合したから分散が増えた。
予測分布でも同じことが起きる
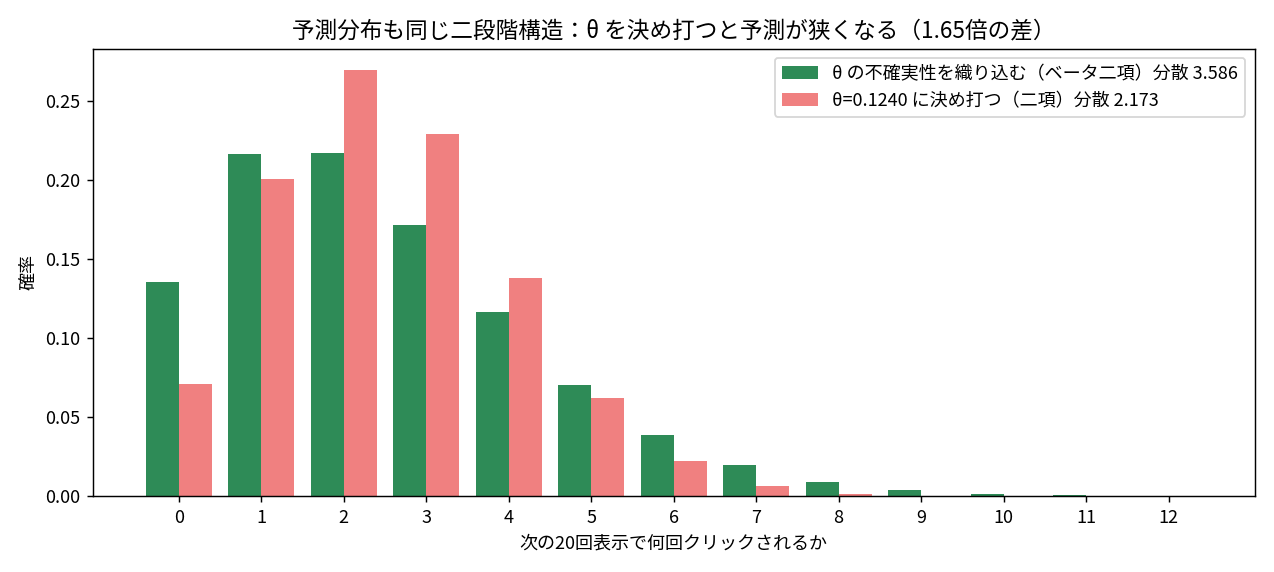
・ の記事を「次に20回表示したら何回クリックされるか」。
| クリック数 | の不確実性を織り込む | を決め打つ |
|---|---|---|
| 0 | 0.13544 | 0.07080 |
| 1 | 0.21666 | 0.20045 |
| 2 | 0.21670 | 0.26956 |
| 3 | 0.17138 | 0.22895 |
| 分散 | 3.586 | 2.173 |
分散が 1.65倍。とくに の確率が約2倍違います。「1回もクリックされない確率」を 決め打ちで見積もると半分に見誤るということです。
シミュレーション(200万回)とベータ二項分布の式が小数第4位まで一致することも確認しました(0.13555 対 0.13544)。
ベイズファクター:p値とは違う問いに答えている
第12回で触れたリンドレーのパラドックスを、ここで数値にします。
まず何が違うかを固定します。
- p値: が正しいと仮定したときの「データの珍しさ」。計算式に は入らない(ただし「何をより極端とみなすか」=片側か両側か・どの検定統計量を使うかは で決まります。第12回のネイマン・ピアソンの補題がまさにこれ)
- ベイズファクター: と の「データを予測できた度合い」の比。両方使う
p値を固定して を動かす
コイン投げ 回で表 回。 対 一様 とします。各 で「両側p値がちょうど 0.01 前後になる」データを選びました。
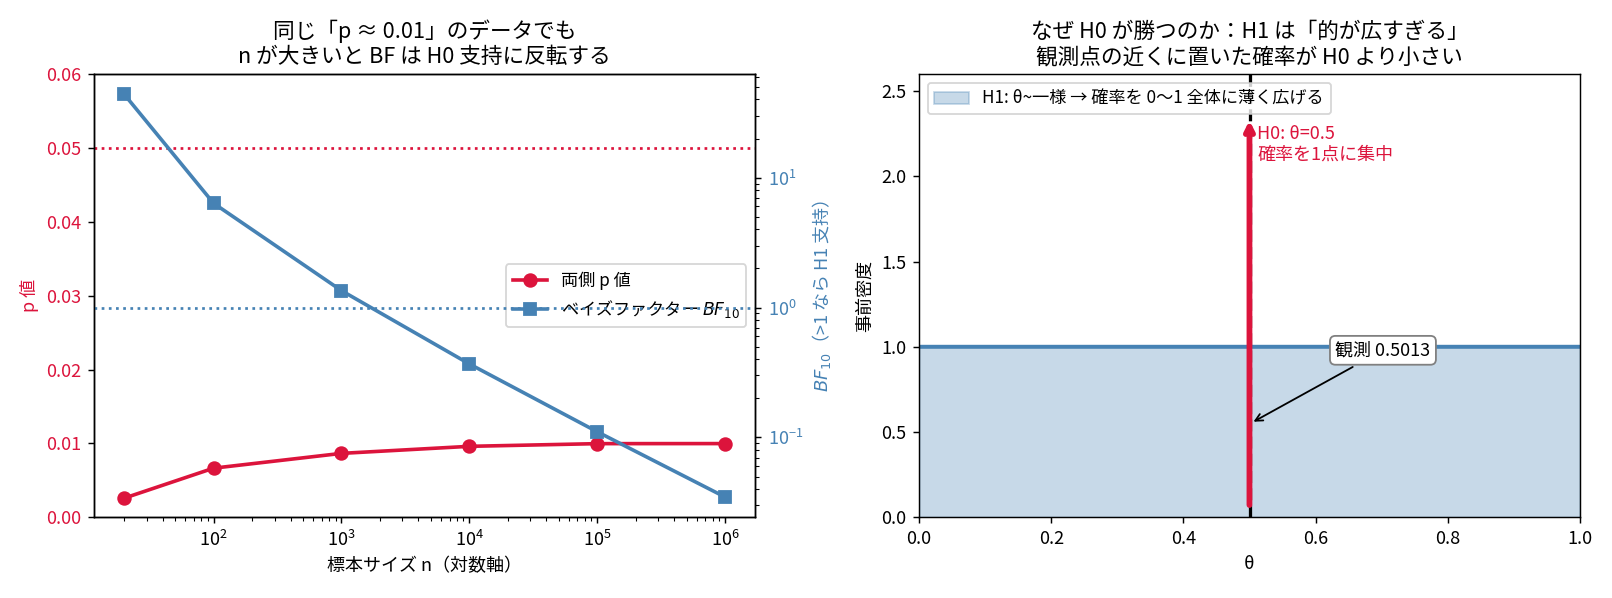
| 標本比率 | 両側p値 | 2つの結論 | |||
|---|---|---|---|---|---|
| 20 | 17 | 0.8500 | 0.00258 | 43.80 | どちらも (一致) |
| 100 | 64 | 0.6400 | 0.00664 | 6.35 | どちらも (一致) |
| 1,000 | 542 | 0.5420 | 0.00864 | 1.35 | p は有意/BF はほぼ中立 |
| 10,000 | 5,130 | 0.5130 | 0.00959 | 0.368 | p は有意/BF は 支持 |
| 100,000 | 50,408 | 0.5041 | 0.00996 | 0.111 | p は有意/BF は 支持 |
| 1,000,000 | 501,289 | 0.5013 | 0.00997 | 0.035 | p は有意/BF は が29倍 |
p値はほぼ水平なのに、BF は 43.8 → 0.035 と3桁下がって 1 を突き抜けます。 同じ「p = 0.01 で有意」なのに結論が反転する。これがリンドレーのパラドックスです。
種明かし
上の図の右パネルです。( 一様)は確率を 0〜1 全体に薄く広げているので、観測点 0.5013 の近くに置いた確率はごくわずかです。一方 は 0.5 の1点に全部を賭けていて、0.5013 は 0.5 のすぐ近くです。
は的が広すぎて、当てても偉くない。
だから が勝ちます。言い換えると、p値は「差があるか」を見ていて、BF は「 と のどちらがマシか」を見ている。 が巨大なら 0.5013 と 0.5 の差は検出できますが、それは「 の方がマシ」を意味しません。
統計的有意性と実質的重要性の区別そのものがここに出ています。
BF の弱点も見ておく
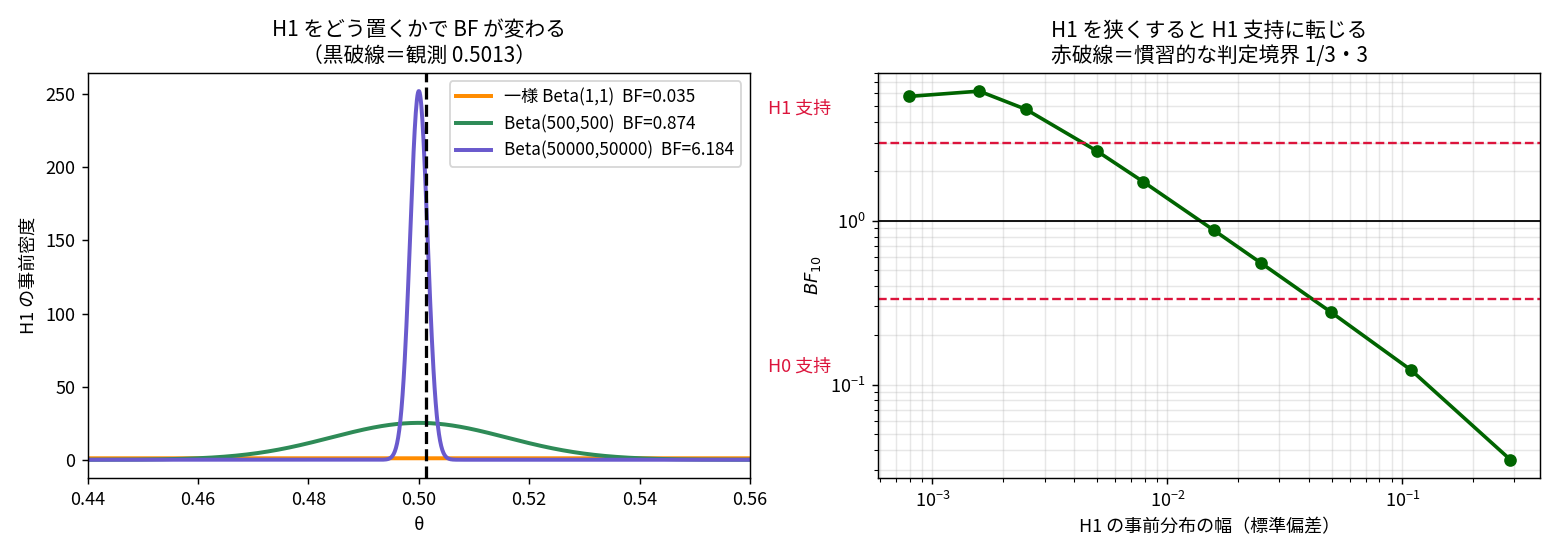
同じデータ(万・)で、 の事前分布の広さだけを変えます。
| の事前分布 | 幅(標準偏差) | 結論 | |
|---|---|---|---|
| 一様 | 0.2887 | 0.0348 | を支持 |
| 0.0498 | 0.277 | を支持 | |
| 0.0158 | 0.874 | どちらとも | |
| 0.0050 | 2.671 | どちらとも | |
| 0.0016 | 6.184 | を支持 |
BF の結論は の設定次第です。 p値には が無いのでこの問題は起きませんが、代わりに「 との比較」という情報も得られません。優劣ではなく、答えている問いが違うというのが正確な整理です。
読み方の慣習と、BF の明確な利点
| 証拠の強さ | |
|---|---|
| 1〜3 | ほとんど言及に値しない |
| 3〜20 | positive(そこそこ) |
| 20〜150 | strong(強い) |
| 150 以上 | very strong(非常に強い) |
なら逆数を見て 側を同じ尺度で読みます。
p値に対する明確な利点が1つあります。 BF は を積極的に支持できる( なら「 側に証拠がある」と言える)。ただしこれは指定した と比べての相対的な主張です(さきほど見た 依存性がそのまま効きます)。
第12回で見たとおり、頻度論では「有意差なし」は「差がないと言えた」ではなく「言えなかっただけ」でした。BF はこの非対称性を解消します。
第2回との接続
・ なら 。オッズは常に の向きで読みます。
| 事前の考え | 事前オッズ | 事後オッズ | |
|---|---|---|---|
| と を五分五分と思っていた | 1 | 6.35 | 0.864 |
| の方が9倍ありそうと思っていた | 1/9 | 0.705 | 0.414 |
第2回の陽性的中率とまったく同じ形です(事前オッズ × 尤度比 = 事後オッズ)。ベイズファクターは尤度比を仮説のレベルに持ち上げたものだと読めます。
なお、この向きは自分で一度間違えました。「 の方が9倍ありそう」に対して事前オッズ 9 を掛けてしまったのですが、オッズは なので正しくは 1/9 です。分母と分子のどちらが かを毎回確認する必要があります。
実務でベイズを使うべき場面
結論から言うと、 が十分にあって「差があるか」だけ知りたいなら頻度論で足ります。 Wilson の信頼区間と信用区間はほぼ一致しました。
手間をかけてベイズにする意味があるのは、次のどれかに当てはまるときです。
| ベイズが効く場面 | なぜ | この回で見た証拠 |
|---|---|---|
| 標本が小さい | 事前情報が精度に効く。頻度論の近似が壊れる領域 | Wald が で被覆率 63.89%/ で区間が [0,0] に潰れる |
| グループが多数あってデータ量が不均衡 | 階層モデルで情報を借りられる | 記事30本で平均二乗誤差が 44%・少数派に絞ると 34% |
| 「確率」として答えたい | のような文が直接書ける | / |
| 予測の不確実性が欲しい | サンプルを変換して数えるだけ。誤差伝播(デルタ法)の導出が不要 | 信用帯がそのまま出る(確率スケールでは中央が最大・対数オッズなら端で広がる) |
| 複雑なモデル・欠測・階層構造 | MCMC なら尤度が書ければ解ける | 共役でないロジスティック回帰も log_post を差し替えるだけ |
| 逐次的に見たい(A/Bテストを途中で覗く) | 事後分布は「今の情報」なので、覗いても事後分布の解釈自体は壊れない | — |
逆に頻度論で十分な場面もはっきりしています。
| 頻度論で十分な場面 | なぜ |
|---|---|
| が十分(数百以上)で「差があるか」だけ知りたい | 結論の数字がほぼ同じ。事前分布の議論が無駄になる |
| 規制・査読・社内合意で「p値」が期待されている | 説明コストが小さい方を選ぶのは合理的 |
| 事前分布の根拠を説明できない | 小標本では結論を左右するので、正当化できないなら使えない |
| 誤り率(第一種の誤りを5%に抑える)を保証したい | それは頻度論が設計目標にしている性質 |
A/Bテストの場合
第6回でベータ分布を使って を計算しましたが、あれはまさにベイズの発想でした。
ベイズが向く理由は3つです。①「B が A より良い確率は 87%」という意思決定に直結する形で出る。②途中で覗いても事後分布の解釈は壊れない(頻度論では覗くたびに多重性が発生し第一種の誤りが膨らむ)。③損失込みで判断できる。
もっとも②には条件が付きます。「 になったら止める」という運用の第一種の誤り率は保証されません。 弱い事前分布のもとで覗き続けると、いずれ閾値を跨いでしまうことがあります(sampling to a foregone conclusion)。頻度論的な誤り率を担保したいなら、別途停止規則を設計する必要があります。
ただし注意が1つあります。 「」は「差が実質的に大きい」を意味しません。ごく小さい差でも が増えれば確率は 1 に近づきます(リンドレーのパラドックスとは現象が逆向きですが、統計的有意性と実質的重要性は別という点で同根です)。差の大きさそのものの事後分布を見るべきで、これはベイズならそのまま出せます。
今回の要点まとめ
頻度論とベイズの2軸
| 頻度論 | ベイズ | |
|---|---|---|
| の扱い | 固定した定数 | 確率変数(知識の不確かさ) |
| データの扱い | 確率変数(取り直せる) | 固定(もう見た) |
| 区間 | 信頼区間(作り方の成績) | 信用区間( の確率) |
| 点推定 | 最尤推定 | MAP(事前が平らなら最尤推定)/事後平均 |
| 仮説の比較 | p値(計算式は だけ) | ベイズファクター(両方を比べる) |
| 「差がない」と言えるか | 言えない(棄却できないだけ) | 言える(。ただし指定した と比べて) |
| 計算の壁 | 分布の導出 | 分母の積分 → MCMC で回避 |
| 小標本 | 近似が壊れる | 事前分布が効いて安定する |
| 大標本 | ほぼ一致する | ほぼ一致する |
引っかかった点と答え
| 引っかかった点 | 答え |
|---|---|
| 結局ベイズ統計とは何か | 何が固定で何が動くかを入れ替えただけ。 が確率変数になるので「 が区間に入る確率」と言える |
| クリック率は1つの値では | ベイズの分布は の物理的ばらつきではなく自分の知識の不確かさ |
| 「二項分布と共役」とは | 正確には「ベータ分布は二項尤度に対する共役事前分布」。尤度の族と事前分布の族の関係 |
| なぜベータ×二項がベータに戻るのか | どちらも の同じ骨格なので掛けても壊れない |
| 共役事前分布はいつ存在するか | 指数型分布族なら必ず構成できるが、逆は成り立たない(一様×パレート)。ロジスティック回帰は指数型だが共役族の正規化定数が書けない |
| 信用区間は素直に解釈できるのか | 本当。 ただし数字は Wilson の信頼区間とほぼ一致する([0.145, 0.519] 対 [0.146, 0.522]) |
| MCMC が何なのか分からない | 名前を分解する。 Monte Carlo(数え方)+ Markov chain(歩き方)で、前者にマルコフ連鎖は出てこない |
| モンテカルロ法とは | 計算する代わりに数える。 長方形で囲むのは棄却法に固有の話で本質ではない |
| なぜマルコフ連鎖で事後分布が出るのか | 足跡の分布=定常分布なので、定常分布が事後分布になる歩き方を設計する |
| なぜ比を取るのか | 計算できない分母が約分で消える。 正規化定数を知らないままサンプルできる |
| 受容確率の式はどこから来たのか | 詳細釣り合いが成り立つように逆算した。 実測で左右が 精度で一致 |
| 受容率は高い方がよいのか | 逆。 20〜50%が目安。98.5%だと58000個が実質34個分 |
| 収束判定は主観的か | で数値化できる。 ただし1本の鎖だけでは気づけない場合がある(安定して見えるのに真逆の場所) |
| 無情報事前分布は無情報か | 違う。 一様を対数オッズで見ると山型( が一様の3.7倍) |
| ジェフリーズの動機は変換不変性か | その通り。 ルートAとBの比が 1.000000 で一致 |
| ステップ4(重み付き平均)は必要か | どんな場合でも計算には不要。共役のときだけ厳密に書けるご褒美 |
| 階層ベイズと経験ベイズの違い | を1点に固定するか分布として扱うか。 階層モデルから見れば経験ベイズは第3層の点近似だが、経験ベイズ自体は頻度論的リスクの側からも正当化される |
| どこに差が出るのか | 点推定はほぼ同じ(0.002233 対 0.002259)。区間幅が 5.1% 違う |
| とは何か | 第2層の分布のパラメータ=率の集団を表す。 中心 と集中度 、または疑似データ |
| 二段階の構造は何なのか | 局外パラメータの周辺化。 t分布・負の二項分布・予測分布もすべて同じ構造 |
| 決め打つと何が起きるか | 最尤推定値のような中心的な点なら通常は自信過剰( を固定して を使うと で 38.4% 過小)。ただし事後平均で代入すると逆に 6.7% 広くなり「必ず」ではない |
| ベイズファクターとp値の違い | p値は「差があるか」、BF は「 と のどちらがマシか」。 巨大な で正反対になる |
自分が間違えた点
記録として残します。
| 間違い | 正しくは |
|---|---|
| 「共役は予習済み」と思っていた | 定義を聞かれて答えられなかった。尤度の族と事前分布の族の関係という点が抜けていた |
| モンテカルロ法=長方形で囲む方法 | 囲むのは棄却法に固有。モンテカルロ法の本質はサンプル平均で期待値を代用すること |
| MCMC は数え方をマルコフ連鎖に適用した | 逆。 数える部分は不変で、変わったのはサンプルの作り方だけ |
| ステップ4は共役なら省略できる | どんな場合でも計算には不要。 共役だと厳密な等式として書けるだけ |
| SD比は第2項の割合で決まる | 第1項も経験ベイズと等しくない。 で予測 1.042 対 実測 1.068 |
| SD比は について単調に減る | 9箇所で増加している。 順位相関 で「おおむね減る」が正確 |
| 事前オッズは が9倍なら9 | オッズは なので 1/9 |
| 共役事前分布は指数型分布族のときだけ存在する | 「だけ」が誤り。 一様分布×パレートが反例。しかもロジスティック回帰は指数型分布族で、共役族自体は存在する(正規化定数が書けないだけ) |
| は Agresti-Coull 法 | 違う。 Agresti-Coull は 。 はラプラス補正 |
| 信用帯はデータが薄い両端で広がる | 確率スケールでは逆。 中央が最大(幅 0.543)で右端が最小(0.186)。端で広がるのは対数オッズのスケール |
| 詳細釣り合いは定常分布であるための必要条件 | 十分条件でしかない。 決定的スキャンのギブスは満たさないのに を不変にする |
| イェンセンの不等式は第8回 | 第4回(変数変換の回) |
試験対策としての優先順位
| 優先度 | 項目 |
|---|---|
| 最優先 | 共役事前分布の組み合わせと事後分布の形(ベータ×二項、ガンマ×ポアソン、正規×正規)/事後平均・MAP・信用区間の計算 |
| 優先 | 信頼区間と信用区間の違い/ジェフリーズ事前分布が になる導出 |
| 普通 | MCMC の考え方(メトロポリスとギブスの違い・収束判定の用語) |
| 軽く | ベイズファクター/階層ベイズ・経験ベイズ(用語と使いどころ) |
準1級では MCMC を実装させる問題は出ません。 用語(バーンイン・提案分布・受容率・)と「なぜ必要か」を答えられれば十分です。手を動かす計算問題は共役事前分布に集中しています。
次回
次回は第32章のシミュレーションです。今回の MCMC で「乱数を使って答えを出す」という発想に踏み込みましたが、次回はその基礎を正面から扱います。
逆関数法・棄却法・ボックス=ミュラー法といった乱数をどう作るかの技術と、ブートストラップ法や並べ替え検定といった乱数で推論する技術です。今回使った棄却法が、そこでは主役として再登場します。
そして接続がひとつあります。今回は「棄却法は高次元で死ぬからマルコフ連鎖が必要だった」という話でしたが、次回は低次元では棄却法が今でも現役である理由を扱います。適材適所の話になります。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。