変数変換とヤコビアン:「面積を1に保つための係数」だった【第4回】
はじめに
第3回では分散を扱いました。今回は第4章「変数変換」から、ヤコビアンを中心に見ていきます。
この章は、過去に一度つまずいた記憶があります。「ヤコビアン」という名前と という見た目に圧倒されて、何のための量なのか分からないまま公式だけ眺めていました。
結論を先に書くと、ヤコビアンは「確率の総量を1に保つための調整係数」でした。それだけです。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
TL;DR
- 身長も体重も正規分布なのに、BMI(体重÷身長²)は歪む。だから「変換後の分布」を求める必要がある
- 分布が変わる理由は、変換で区間の幅が伸び縮みするから
- 密度は「単位幅あたりの確率」なので、幅が変われば高さも変えないと辻褄が合わない
- ヤコビアンが保つのは「全体の面積=1」だけ。平均も標準偏差も変わる
- 一般形は「元の密度を引く」と「幅の伸縮を補正する」を1行で書いたもの
統計の用語が出てくるので、先に用語集を置いておきます。用語を知っている方は「こういう困りごとから始まる」まで飛ばしてください。
用語集
この記事の鍵になる2つだけ挙げておきます。後で具体例つきで説明するので、いま覚える必要はありません。
| 用語 | 記号 | 意味 |
|---|---|---|
| 密度関数 | 変数Xの密度関数に、値xを入れたもの。「x付近の密集度」 | |
| ヤコビアン | 変換による幅の伸縮率。密度を補正する係数 |
の添字 は「どの変数の話か」、括弧の は「代入する値」を表します。変換後の変数Yには という別の関数を使います。
こういう困りごとから始まる
身長の分布はわかっている。体重の分布もわかっている。 ——では、BMI(体重 ÷ 身長²)の分布はどうなるのか?
「元が正規分布なら、BMIも正規分布だろう」と考えたくなります。しかし違います。
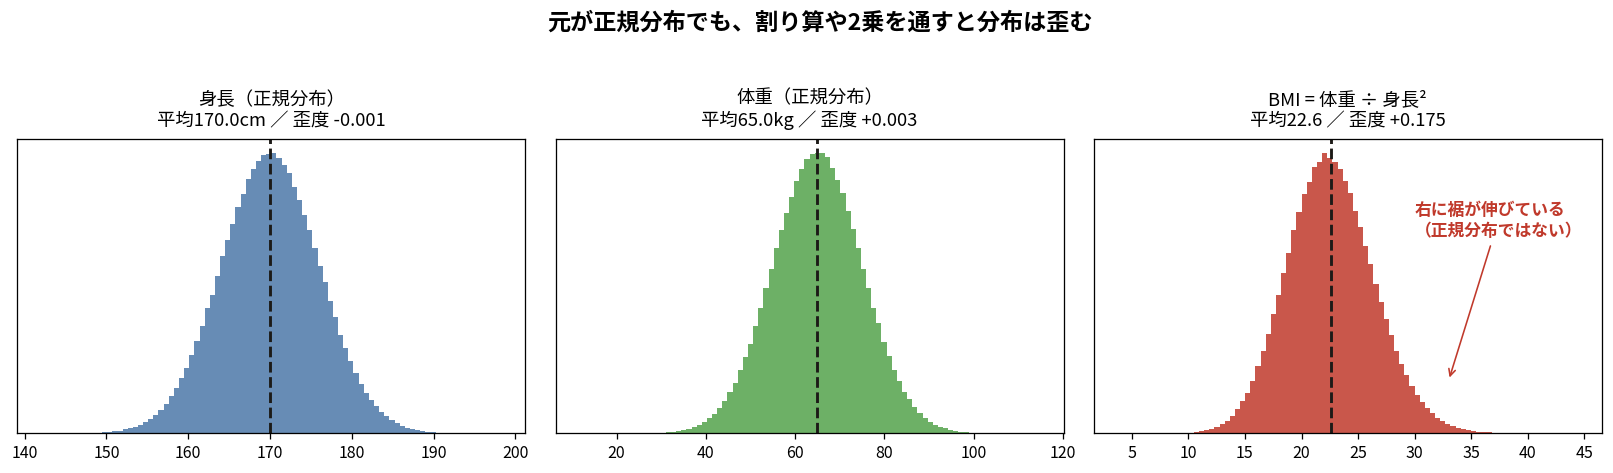
身長と体重はどちらも歪度がほぼ0(左右対称)ですが、BMIは歪度+0.175で右に裾が伸びています。割り算や2乗を通すと形が変わるのです。
だから「変換後の分布を知りたい」という需要が生まれます。これが第4章の存在理由でした。
実務でもよく起きます。単価×個数で売上を出す、対数を取る、比率にする——どれも変換なので、元の分布の性質はそのまま引き継がれません。
まず記号の意味を確認する
本題に入る前に、 という記号を整理しておきます。私はここが曖昧なまま公式を眺めていたので、つまずいたのだと思います。
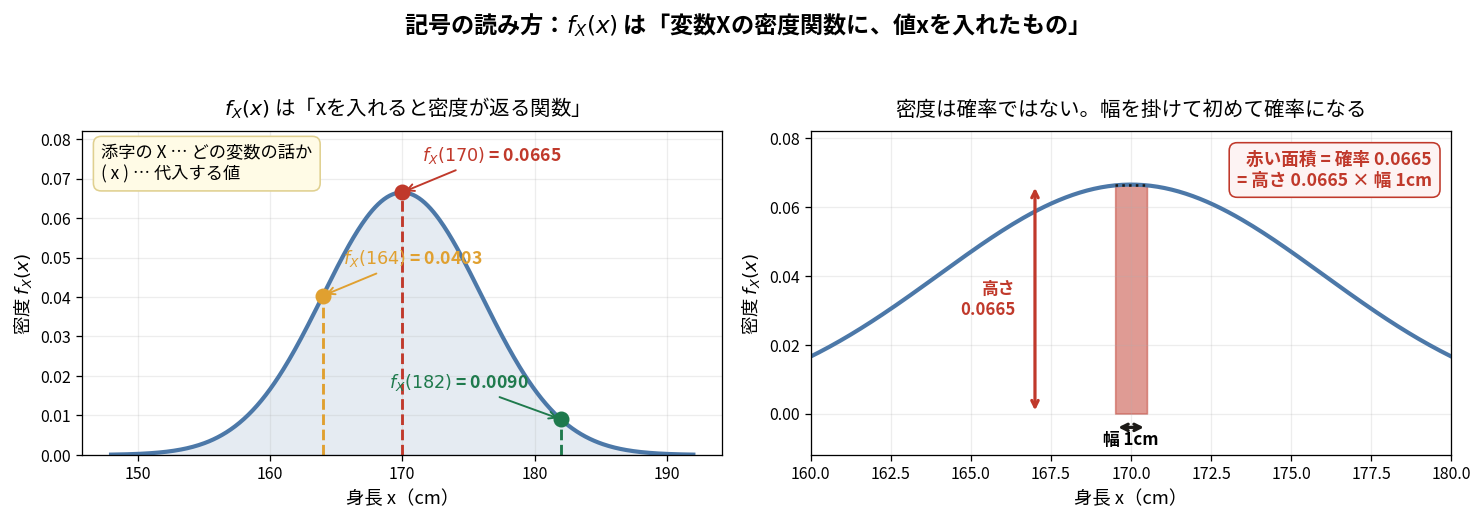
左の図が の意味です。xを入れると密度が返ってくる関数で、 は「170cm付近の密集度が0.0665」を表します。
密度は確率ではない
ここが重要な注意点です。 は「170cmの人が6.65%いる」という意味ではありません。連続的な値では「ちょうど170.000…cm」の確率は0になってしまいます。
密度は「単位幅あたりの確率」で、幅を掛けて初めて確率になります。
実際に確かめました。
| 区間 | 幅 | 実測した確率 | 密度 × 幅 |
|---|---|---|---|
| 169.5〜170.5cm | 1cm | 0.0665 | 0.0665 × 1 = 0.0665 |
| 169.95〜170.05cm | 0.1cm | 0.00665 | 0.0665 × 0.1 = 0.00665 |
一致します。そしてこの性質が、ヤコビアンが必要な理由そのものでした。密度が「単位幅あたりの量」だから、変換で幅が変わったら密度も変わるのです。
核心:変換で「区間の幅」が変わる
なぜ分布の形が変わるのか。もっと単純な例で見ます。0〜1の一様分布を に変換します。
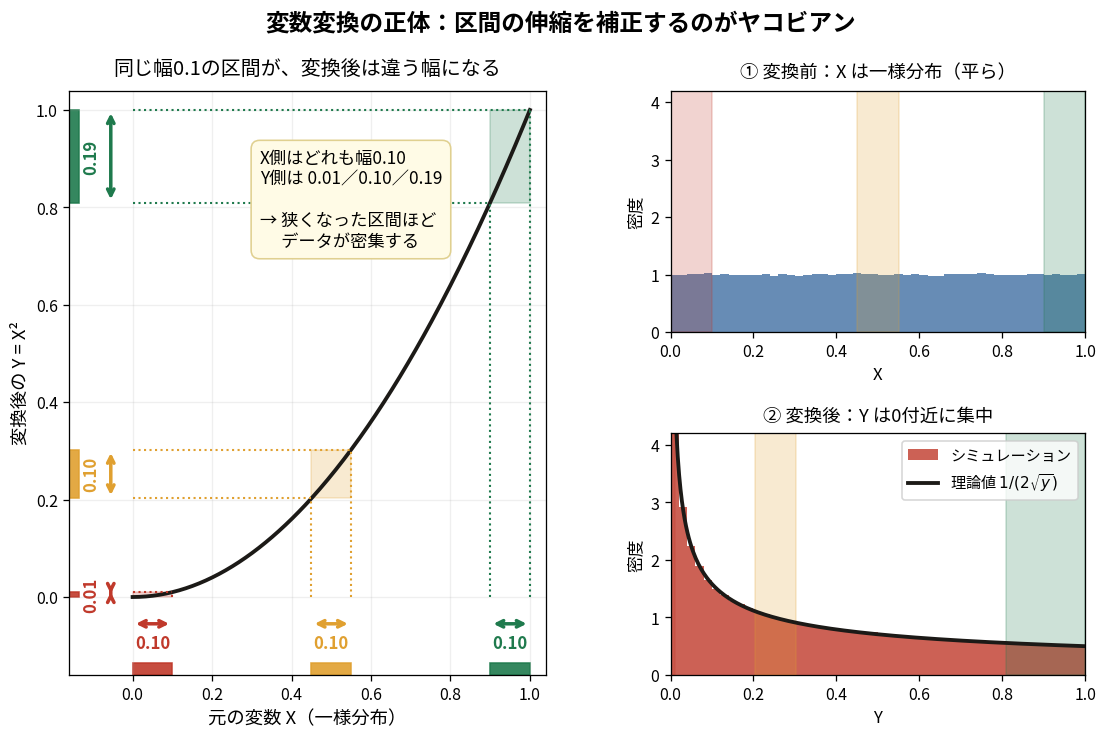
左の図を見てください。X側で同じ幅0.1の区間が、Y側では違う幅になっています。
| X側の区間(幅0.1) | Y側の区間 | Y側の幅 |
|---|---|---|
| 0.0 〜 0.1 | 0.00 〜 0.01 | 0.01(1/10に潰れる) |
| 0.45 〜 0.55 | 0.20 〜 0.30 | 0.10(そのまま) |
| 0.9 〜 1.0 | 0.81 〜 1.00 | 0.19(1.9倍に広がる) |
200万個のデータで、各区間に入る個数を数えました。
| 区間 | X(変換前) | Y(変換後) |
|---|---|---|
| 0.0 〜 0.1 | 200,343個 | 632,920個 |
| 0.4 〜 0.5 | 199,572個 | 149,476個 |
| 0.9 〜 1.0 | 199,874個 | 102,530個 |
理屈はこうです。 という幅0.1の区間は、2乗すると幅0.01に潰れます。データの個数は変わりません。 同じ数のデータが1/10の狭さに押し込まれるので、密度は10倍に濃くなる。
逆に は1.9倍に広がるので、密度は薄くなります。
ヤコビアンは伸縮率の補正にすぎない
この伸縮率は、変換の傾き(微分)そのものです。
密度は「個数 ÷ 幅」なので、幅が 倍になれば密度は 倍になります。つまり、
シミュレーションで検算しました。
| 実測した密度 | 理論値 | |
|---|---|---|
| 0.01 | 5.177 | 5.000 |
| 0.25 | 0.995 | 1.000 |
| 0.81 | 0.564 | 0.556 |
一致しました。上の図の右下でも、ヒストグラムに理論曲線がぴったり重なっています。
f_X と f_Y は別の関数
添字が違うのは、別の関数だからです。同じデータでも「Xの目線」と「Yの目線」で違う形になります。
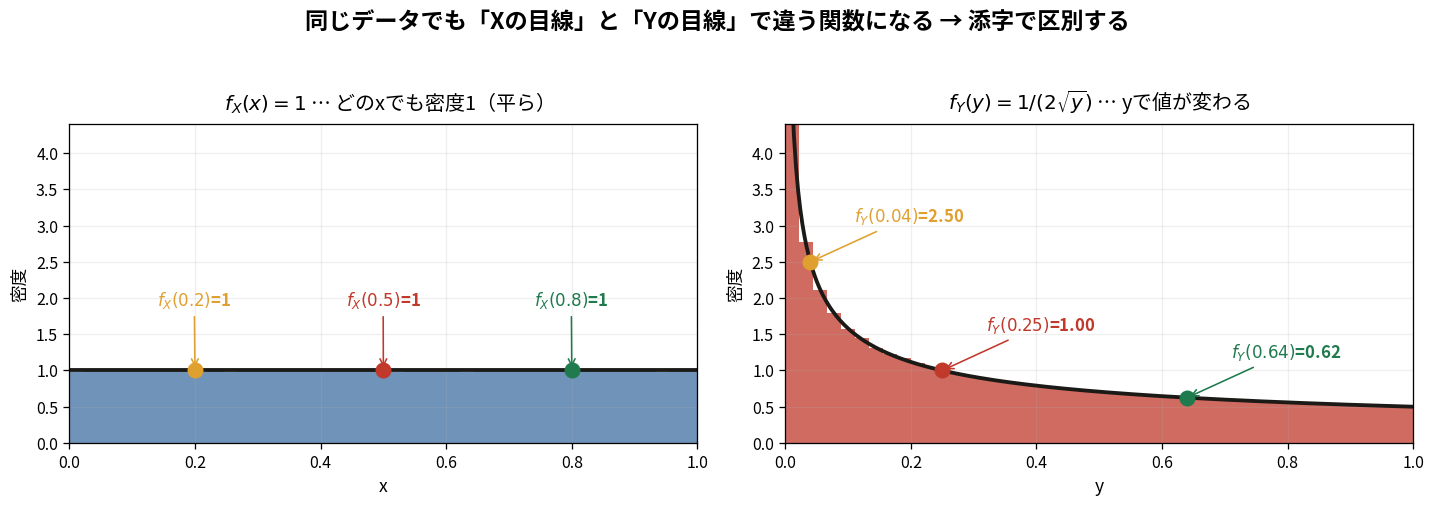
| 変換前 X の目線 | 変換後 Y の目線 | |
|---|---|---|
| 密度関数 | ||
| x=0.5 / y=0.25 | 1.0 | 1.0 |
| x=0.2 / y=0.04 | 1.0 | 2.50 |
| x=0.8 / y=0.64 | 1.0 | 0.62 |
Xの目線ではどこも1で平らですが、Yの目線では場所によって2.50や0.62に変わります。データは同じなのに、見る座標が違うと密度の分布が違って見える——これが変数変換の本質でした。
一般形を分解する
ここまで分かれば、公式も自然に読めます。
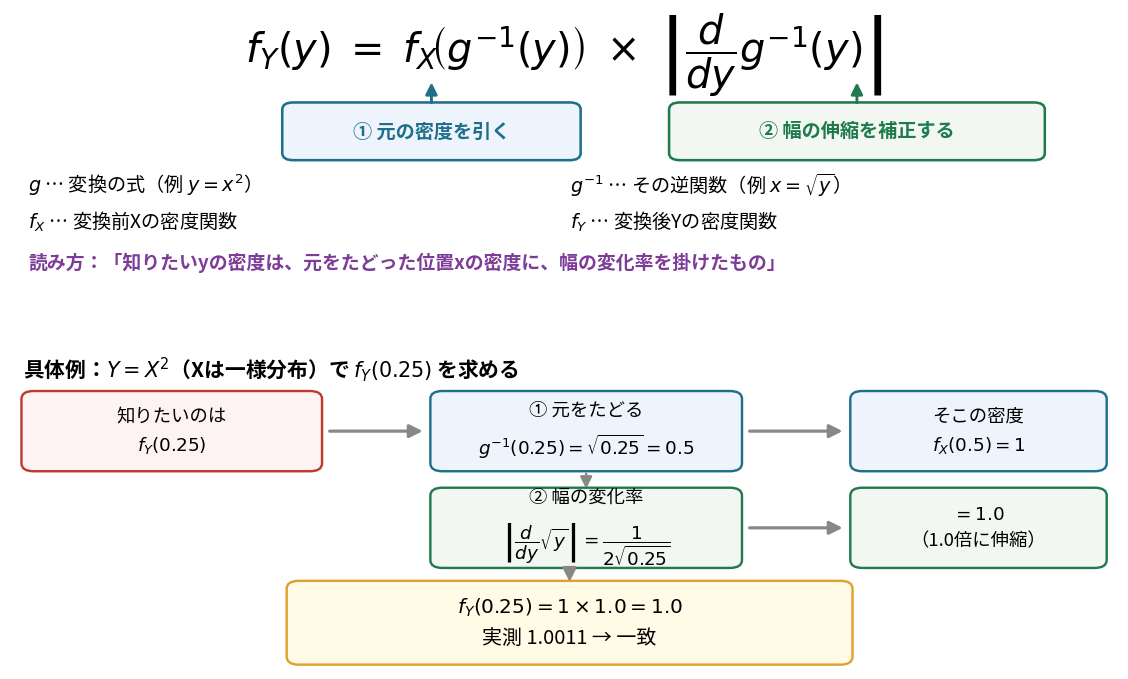
式は2つのパーツの掛け算です。
| パーツ | 役割 |
|---|---|
| ① 元の密度を引いてくる | |
| ② 幅の伸縮を補正する(=ヤコビアン) |
日本語に訳すとこうです。
知りたい y での密度は、元をたどった位置 x での密度に、幅の変化率を掛けたもの
の場合を追います。
- 元をたどる: ←「y=0.25 になったのは、元が x=0.5 だったから」
- そこでの密度を調べる: ←一様分布なのでどこでも1
- 幅の変化率を計算する:
- 掛ける: ←実測値1.0011と一致
なぜ「逆関数」を使うのか
素朴には「xを入れてyを出す」変換 を使いたくなりますが、式には が出てきます。
理由は、求めたいものが「yの関数」だからです。 を求めるとは「yを入れたら密度が返る関数」を作ることなので、右辺もすべてyで書けていなければなりません。しかし元の密度 はxを入れる関数です。だから で「yからxに戻す」必要があります。
ヤコビアンが の形( ではない)なのも同じ理屈でした。
ヤコビアンが保つのは「面積」だけ
ここが今回いちばん腹に落ちた部分です。ヤコビアンは何を守っているのか。
答えは「密度関数の全体の面積が1になること」です。密度関数には、全区間で積分すると必ず1になるという性質があります。
確率の合計は必ず1でなければならない、という当たり前の要求です。ヤコビアンはこの制約を守るための調整でした。
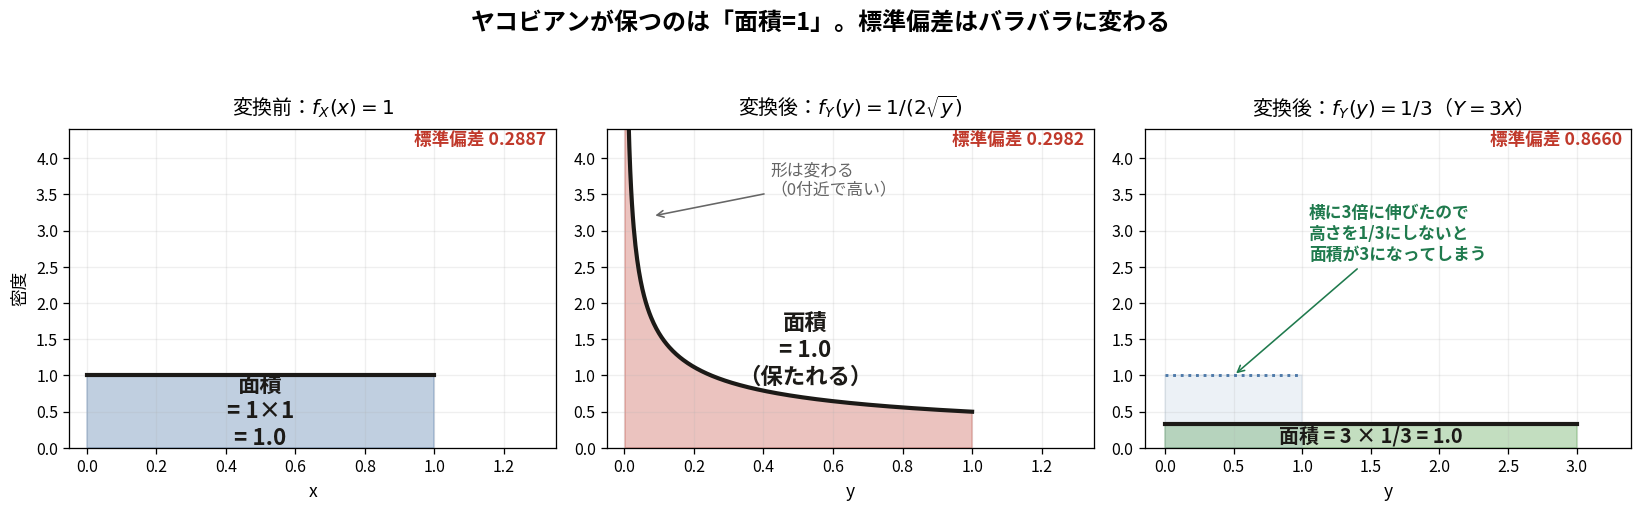
図の右端 の例がいちばん分かりやすいです。Xの範囲が0〜1だったのに、3倍するとYの範囲は0〜3になります。横に3倍伸びたので、高さをそのまま1にしておくと面積が3になってしまう。 だから高さを に下げる。この がヤコビアンです。
標準偏差は保たれない
私は最初「標準偏差を1に保つための係数」だと勘違いしていました。実際に測ると違います。
| 変換 | 変換前の標準偏差 | 変換後の標準偏差 | 密度の面積 |
|---|---|---|---|
| 0.2886 | 0.2981 | 1.000000 | |
| 0.2886 | 0.8658 | 1.000000 | |
| 0.2886 | 0.2356 | 1.000000 | |
| 0.2886 | 0.4919 | 1.000000 |
標準偏差は0.2356から0.8658まで大きく動いていますが、面積は常に1.000000です。保たれているのは面積だけでした。
なお「標準偏差を1にする」のは標準化という別の操作です。 のように意図的に平均0・標準偏差1に揃える変換で、目的が違います(ただし標準化も変数変換の一種なので、その密度を求めるならヤコビアンが必要です)。
面積を保つ要求から、公式が導ける
そしてここが気持ちよかった点です。「面積=1を保つ」という要求から、一般形が自動的に出てきます。
同じデータの塊をXの目線とYの目線で見たとき、含まれる確率は同じでなければなりません。確率 = 密度 × 幅 なので、
これを について解くと、
一般形になりました。公式として暗記するものではなく、制約から導かれる結果だったわけです。
第3回とつながる:E[g(X)] ≠ g(E[X])
もう一つ、前回の内容と直結する発見がありました。「平均身長・平均体重の人のBMI」は、「BMIの平均」と一致しません。
| 計算方法 | 結果 |
|---|---|
| 平均身長1.70m・平均体重65kgから計算したBMI | 22.491 |
| 全員のBMIを計算して平均を取ったもの | 22.570 |
これはJensenの不等式と呼ばれる性質です。
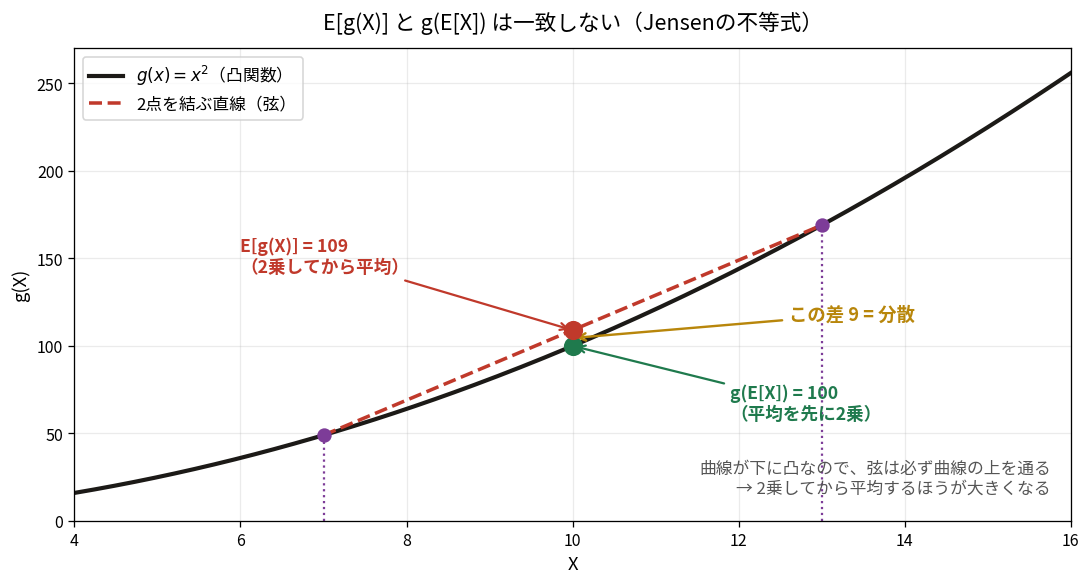
曲線が下に凸なので、2点を結ぶ弦は必ず曲線の上を通ります。だから「2乗してから平均」のほうが「平均してから2乗」より大きくなる。
なお正確に言うと、BMIは身長と体重の2変数の関数なので、上の1変数の図だけで不等号の向きが決まるわけではありません( は2変数関数としては凸ではありません)。上のBMIで差が出たのは、身長の側の が凸であることが効いているためです。「非線形な変換を通すと、平均を入れた結果と結果の平均は一致しない」という事実が本質で、どちら向きにずれるかは変換の形ごとに確かめる必要があります。
そしてこの差が、前回やった分散でした。
第3回で「2乗の平均 − 平均の2乗が分散」と確かめましたが、その正体は、「変換してから平均」と「平均してから変換」のズレだったわけです。図では 、 で差が9。これがそのまま分散になっています。
実務での注意点
平均値を代表値として使い、それを何かの式に入れて計算する——この操作は非線形な式では誤差を生みます。
- 「平均レスポンスタイムから平均スループットを計算する」
- 「平均単価 × 平均個数で売上を見積もる」
こういった計算は、厳密には正しくありません。式が非線形なら、平均を入れた結果と結果の平均は一致しないからです。
AIを使ってみた感想
今回いちばん役に立ったのは、自分の理解を言葉にしてぶつけたことでした。
「ヤコビアンは標準偏差を1に保つための変換」と思っていたのですが、これをAIに確認したところ違いを指摘され、実際に4つの変換で標準偏差を測って「バラバラに変わる」「面積だけが1で不変」と確かめられました。自分で計算するまでは、たぶん勘違いしたまま先に進んでいたと思います。
もう一つは、記号の意味を飛ばさずに聞けたことです。 の添字と括弧が何を指すのか、なぜ と区別するのか。当たり前すぎて教科書には書いていない部分ですが、ここが曖昧だと公式が読めません。分からないところを分からないと言えるのは、AI相手の学習の利点だと思います。
この章で押さえること
| 問い | 答え |
|---|---|
| 何に使うのか | 元の分布から、変換後の分布を求める |
| なぜ分布が変わるのか | 変換で区間の幅が伸縮し、密度が変わるから |
| ヤコビアンとは | 幅の伸縮を打ち消す補正係数 |
| 何を保っているのか | 密度の全体面積=1(確率の合計) |
| なぜ絶対値を付けるのか | 密度が負になってはいけないから |
| 注意点 | 。そのズレが分散だった |
準1級では、この変数変換が第6章で本格的に使われます。t分布やカイ二乗分布は、正規分布を変換した結果として導かれるので、「なぜあの形なのか」を追うにはここの理解が前提になります。
次回
第5回は第5章「離散型分布」を予定しています。
二項分布・ポアソン分布・幾何分布あたりを扱います。「1日に何件クレームが来るか」「何回打ったらヒットが出るか」のような、数えられる現象の型を整理する回です。
この連載は、うまくいった記録だけでなく詰まった箇所も含めて書いています。同じく準1級を目指している方、一度挫折した方の参考になれば嬉しいです。