重回帰分析:「他の変数を固定したとき」の正体は残差だった【第16回】
はじめに
第16章は重回帰分析です。前回(第15回・ノンパラメトリック法)で推測統計編が終わり、ここから線形モデル編に入ります。
この回だけは、私にとって事情が違いました。最小二乗法は手が動く範囲だからです。実務でも過去の勉強でも触ってきたので、 の と を残差の2乗和の最小化で求める、という話は分かっているつもりでした。
ところが「分かっているつもり」の中身が空洞でした。
具体的には、こういう質問に答えられませんでした。係数の標準誤差はどこから来るのか。 という形は何を意味しているのか。決定係数は何を測っているのか。なぜ変数を増やすと必ず上がるのか。そして偏回帰係数の「他の変数を固定したとき」——実際には固定していないのに、なぜそう解釈できるのか。
いちばん大きかった発見を先に書きます。重回帰の係数は、2段階の単回帰と小数10桁まで一致します。 「他の変数を固定する」の正体は「他の変数で説明できる分を引き算しておく」ことでした。そしてこれが分かると、多重共線性・VIF・標準誤差が全部同じ1つのトレードオフの話だと繋がります。
この記事で使う言葉
先に5つだけ整理します。この記事はこの5語で回ります。
偏回帰係数(partial regression coefficient):重回帰の各係数のこと。「偏」は「他の変数の影響を除いた」という意味で、偏微分の「偏」と同じ発想です。単回帰の係数と区別するためにこう呼びます。
多重共線性(multicollinearity):説明変数どうしが強く相関している状態。「共線性」は「同じ線に乗っている」という意味で、複数の変数がほぼ同じ情報を持っていることを指します。
VIF(Variance Inflation Factor=分散拡大係数):字面のまま「分散を膨らませる係数」。ある説明変数が他の説明変数とどれだけ重複しているかを表し、 なら係数の分散が4倍、標準誤差は 倍になります。
列空間(column space):説明変数の列を足したり伸ばしたりして作れるベクトル全体の集まり。この記事では「平面」と呼びます。最小二乗法はこの平面に垂線を下ろす操作です。厳密には列が3本以上なら平面ではなく 次元部分空間で、その次元は列の本数ではなく rank で決まります(後述)。
ハット行列(hat matrix): のこと。 となり、 に帽子(hat)をかぶせるのでこの名前です。
なお略語について1つ注意です。 が2つの意味で使われます。 「パラメータの数( の )」と「p値(有意確率)」はまったく別物で、統計の悪しき慣習です。この記事ではパラメータ数を 、p値は「p値」と書いて区別します。
TL;DR
- 最小二乗法は射影だった。 は「残差が説明変数と直交する」という条件を について解いた結果。 の例で ()を確認
- 単回帰の「共分散÷分散」は射影の言い換え。 の分子分母を同じ で割っただけ。実データで小数10桁まで一致
- 層を無視すると符号が反転する。 文字数とPVの単回帰は だが、ジャンルを入れた重回帰は (真の値 )。3ジャンルすべての内部では右下がり
- ただし「とりあえず全部入れる」は誤り。 交絡因子は入れる( で正解)、媒介変数は問いで決める、合流点は入れると効果ゼロが に化ける
- 標準誤差は「データを取り直したら係数がどれだけ動くか」。 から が1行で出る。4000回の実測sd 4.6353 に対し公式SE 4.6920
- を で割る理由: で割ると (真値1225)と5%過小評価、 なら 1227.4 で当たる
- は変数を増やすと必ず上がる。 前のモデルは新しいモデルの選択肢に含まれるから。乱数113本で 、しかし は 35.6 → 79.5 に悪化
- 乱数だけでも ( がiidなら厳密)。 で乱数100本なら が出る
- 調整済み が上がる境界は ちょうど(600回で反例0件)。有意の境界1.98とズレているので選択基準としては甘い
- 偏回帰係数=残差同士の単回帰の傾き。 全5係数で小数8桁まで一致(フリッシュ=ウォー=ローヴェルの定理)
- 「固定」の代償がVIF。 文字数の独自情報は 15.8% しか残らず、SEが 倍に膨らむ
- VIFが高いから消す、は危険。 ジャンルを消すとSEは改善するのに係数が と符号ごと反転。RMSEで比べると 4.68 対 105.11
- 多重共線性は「情報が消える」のではなく「分解できない」。 相関0.999で個々の係数のsdは5.17まで暴れるが、合計のsdは0.214
- F検定は門番、t検定は内訳。 相関0.99の3変数で (p値は 台)なのに個別tは3本すべて非有意、しかし合計は
- 全変数を交互作用させた重回帰 = 層別に別々の回帰。 傾きもRSS(132731.8685)も完全一致
- おまけ:この記事の部分F検定は偽陽性を引きました(真の構造に交互作用は無いのに )
通し例:架空のブログアクセスデータ
全編を通して1つのデータで説明します。真の構造を私が決めているので、推定値が正解を当てられたかどうかを毎回確認できます。 これが自習でいちばん効きました。
設定は120記事(日記・ガジェット・お金 各40本)で、真の構造はこれです。
誤差は 。文字数は千字単位です。
仕掛けが2つあります。文字数の真の係数は でマイナスにしました。「同じジャンルの中では、長すぎる記事は検索意図がぼやけてPVが落ちる」という想定です。そしてジャンルごとに平均文字数とベースPVを同じ向きに並べました(日記2.2千字/150、ガジェット4.0/380、お金6.2/640)。
ノイズを外して回帰すると係数を の精度で復元できることを確認済みなので、データ生成は意図どおりです。
単回帰では符号を間違える
まず困りごとから入ります。文字数とPVだけで単回帰すると、傾きは (SE 5.656、)。相関係数は です。「長く書けばPVが増える」と読めます。
ところがジャンルで色を塗ると景色が変わります。
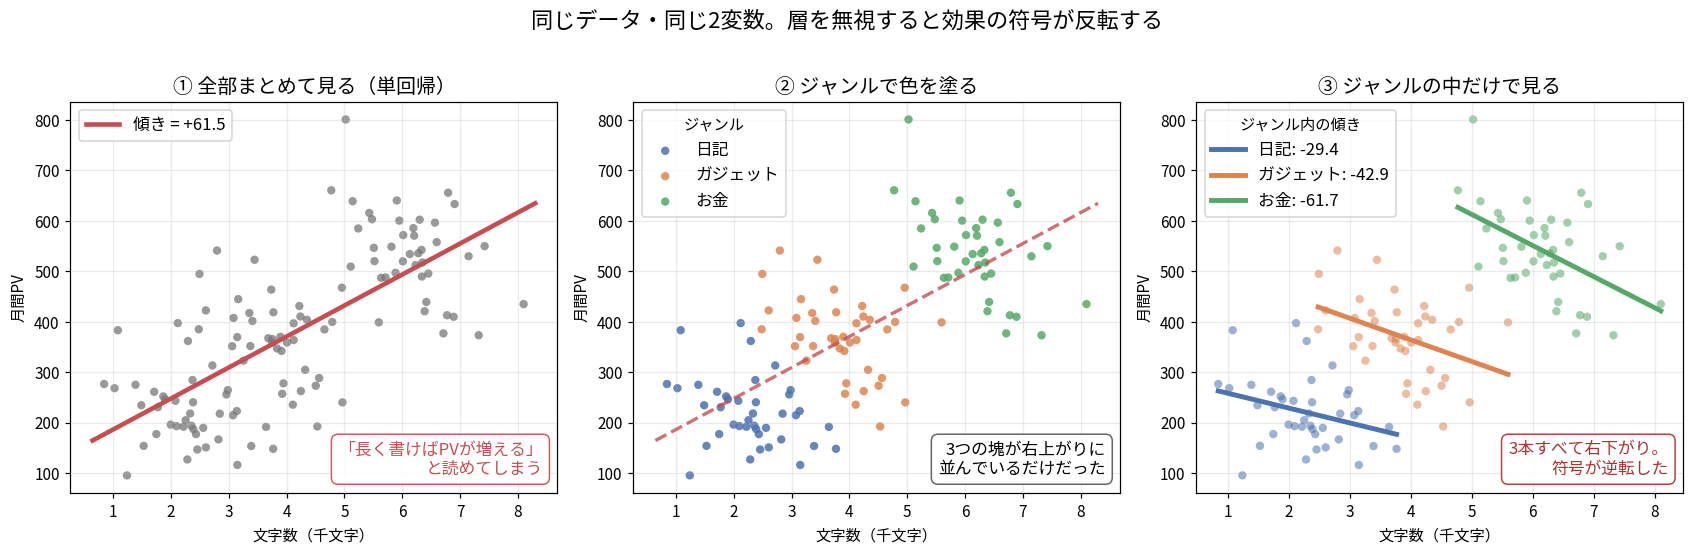
3本すべて右下がりです。日記 、ガジェット 、お金 。同じデータ・同じ2変数で符号が反転しました。
原因は次の図の左側です。
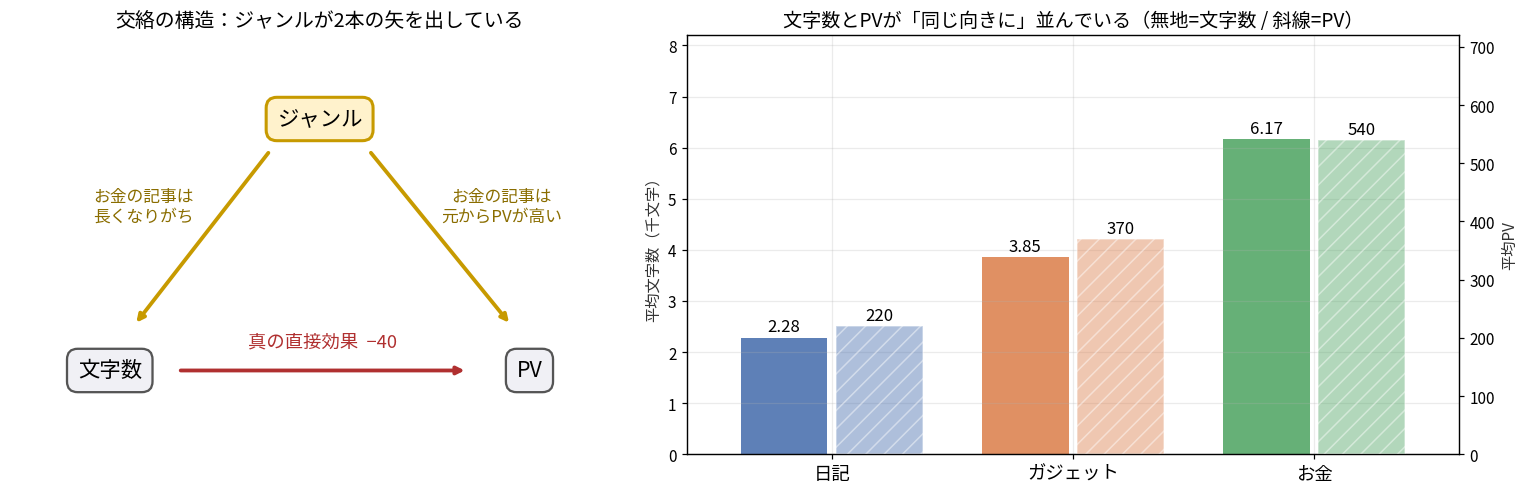
ジャンルが「文字数」と「PV」の両方に矢を出しています。 お金の記事は長くもあり(平均6.17千字)、かつ元からPVも高い(平均540)。この2つが同じ向きに並んでいるので、ジャンルを無視すると「長さのおかげでPVが高い」と誤って帰属されます。これが交絡(confounding)です。
ジャンルをダミー変数として入れて重回帰すると、文字数の係数は (SE 4.692)。真の値 を回収しました。
ここで言い方の区別を押さえておきます。単回帰の も嘘ではありません。 「長い記事のほうがPVが高い」という事実の記述としては正しい。壊れるのは「記事を長くすればPVが増える」という介入の予測に使ったときです。重回帰が答えているのは「文字数とPVは関係あるか」ではなく、「ジャンルを揃えたうえで、文字数はPVに効いているか」です。
「とりあえず全部入れる」は誤り
前節を読むと「関係しそうな変数は全部入れれば安全」と結論しそうになりますが、これは誤りです。 同じ「変数Zを足す」操作を、矢の向きだけ変えた3つの構造で試しました(各4,000回、)。
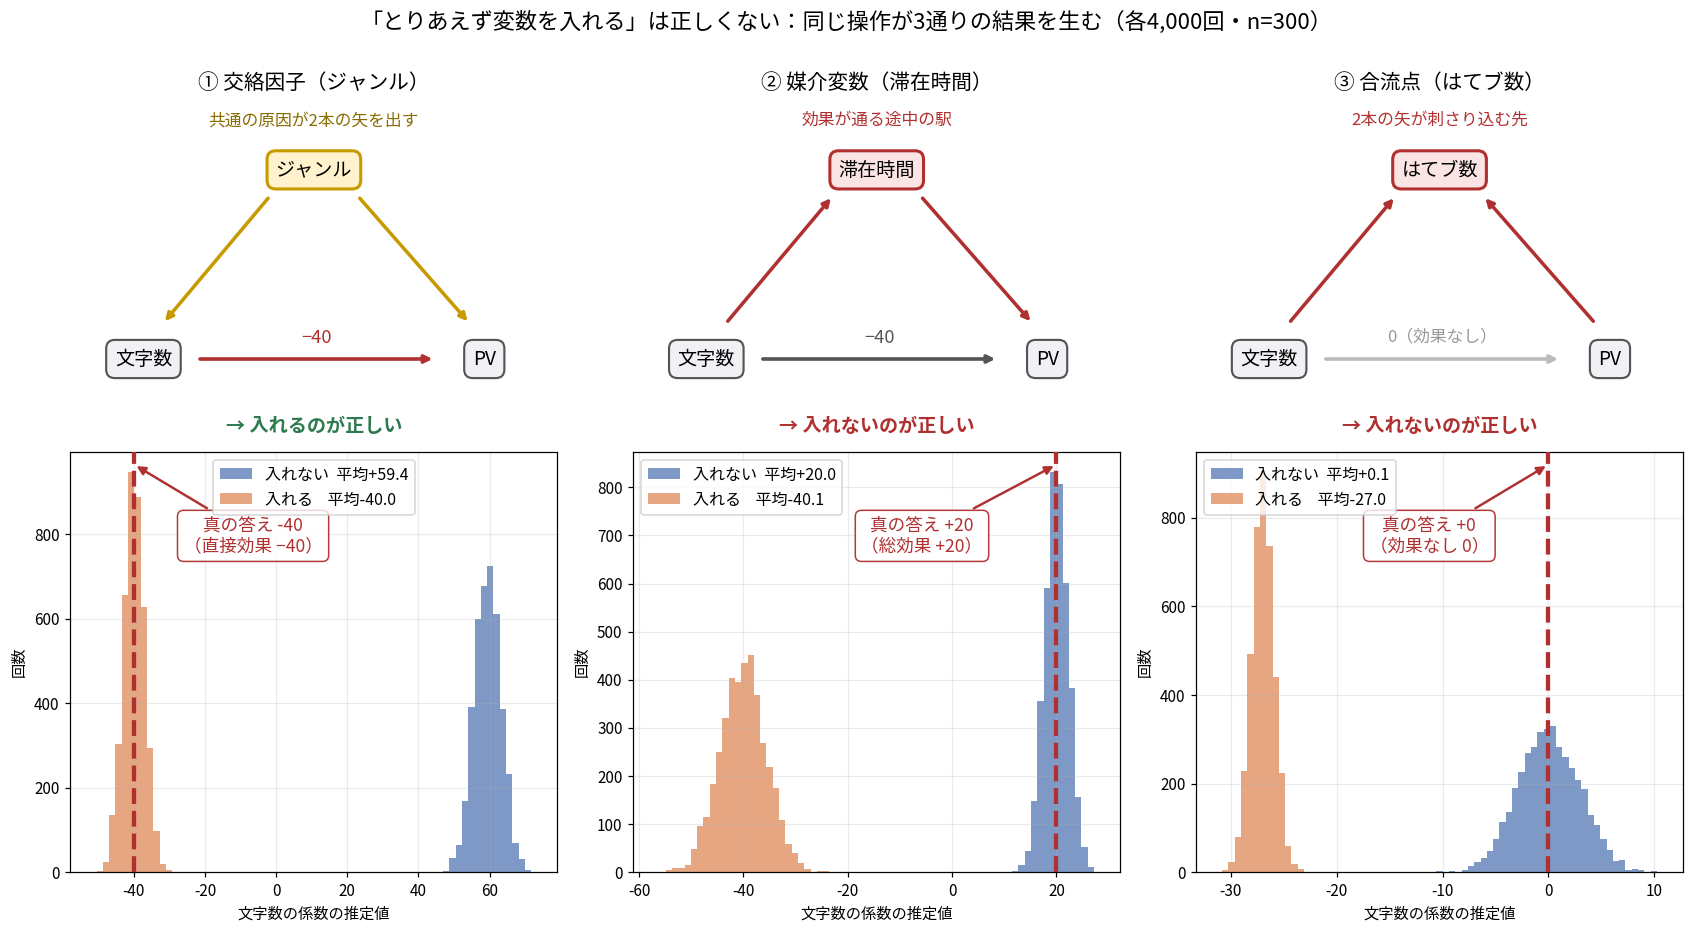
| Zの正体 | 矢の向き | Zを入れない | Zを入れる | 真の答え | 正しい操作 |
|---|---|---|---|---|---|
| 交絡因子(ジャンル) | 文字数 ← Z → PV | 入れる | |||
| 媒介変数(滞在時間) | 文字数 → Z → PV | 入れない | |||
| 合流点(はてブ数) | 文字数 → Z ← PV | 入れない |
媒介変数は「文字数 → 滞在時間 → PV」という経路です。この場合、文字数の総合的な効果は「直接の 」と「滞在時間経由の 」の合計で 、つまりプラスになります。滞在時間を入れずに回帰すると でこれを当てますが、入れると になる。効果が通る途中の駅を塞いでしまったわけです。
そして合流点がいちばん怖いところです。
ここだけ通し例を離れて、矢の向きが誰の目にも明らかな例で確認します。暑い日は熱中症が増え、アイスが売れた日は涼が取れて熱中症が減る。つまり熱中症患者数は、気温とアイス売上の両方から矢が刺さり込む合流点です。上の表の「はてブ数」(長い記事もPVの高い記事もブックマークされやすい)とまったく同じ形ですが、こちらは因果の向きを疑う人がいません。
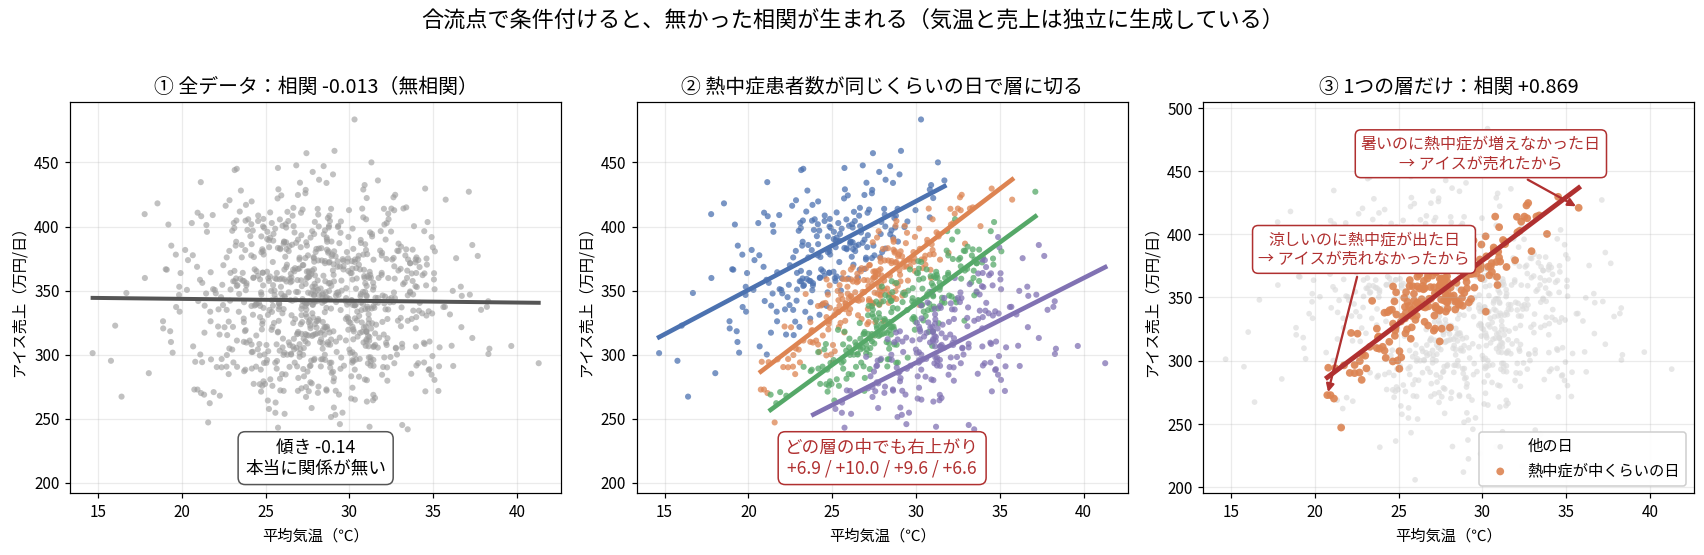
気温とアイス売上をわざと完全に独立に生成しました。全体の相関は 、回帰のp値は 0.695、本当に何の関係もありません。ところが熱中症患者数を説明変数に入れると、気温の係数は (SE 0.141)、p値は計算上ゼロと表示されるほど小さくなります。
理屈はこうです。熱中症の数を揃えて比べるのは、「暑いのに熱中症が増えなかった日」と「涼しいのに熱中症が出た日」を同じグループに入れることです。前者はアイスが売れたから熱中症が抑えられた日、後者は売れなかった日。つまり熱中症を固定した瞬間に、気温の高さがアイス売上の高さの証拠になってしまう。
p値 0.695 が、計算上ゼロと表示される水準まで化けました。有意性は正しさを保証しません。
そして重要なのは、この3変数だけを見ても判別できないという点です。3つとも「Zは文字数ともPVとも相関している」という同じ姿でデータに現れます。 はどの場合も何食わぬ顔で数字を返します。矢の向きはドメイン知識で決めるしかありません(変数がもっと多ければ条件付き独立の構造から部分的に向きを絞る方法もありますが、それは第27回・グラフィカルモデルの話題です)。
なお媒介変数について、私は最初「間違った因果で出てくるやつ」と誤解していました。逆です。媒介変数は本物の因果で、事故は「効果が無いのに有ると誤認した」ではなく「本当にある効果を、通り道を塞いで消してしまった」でした。
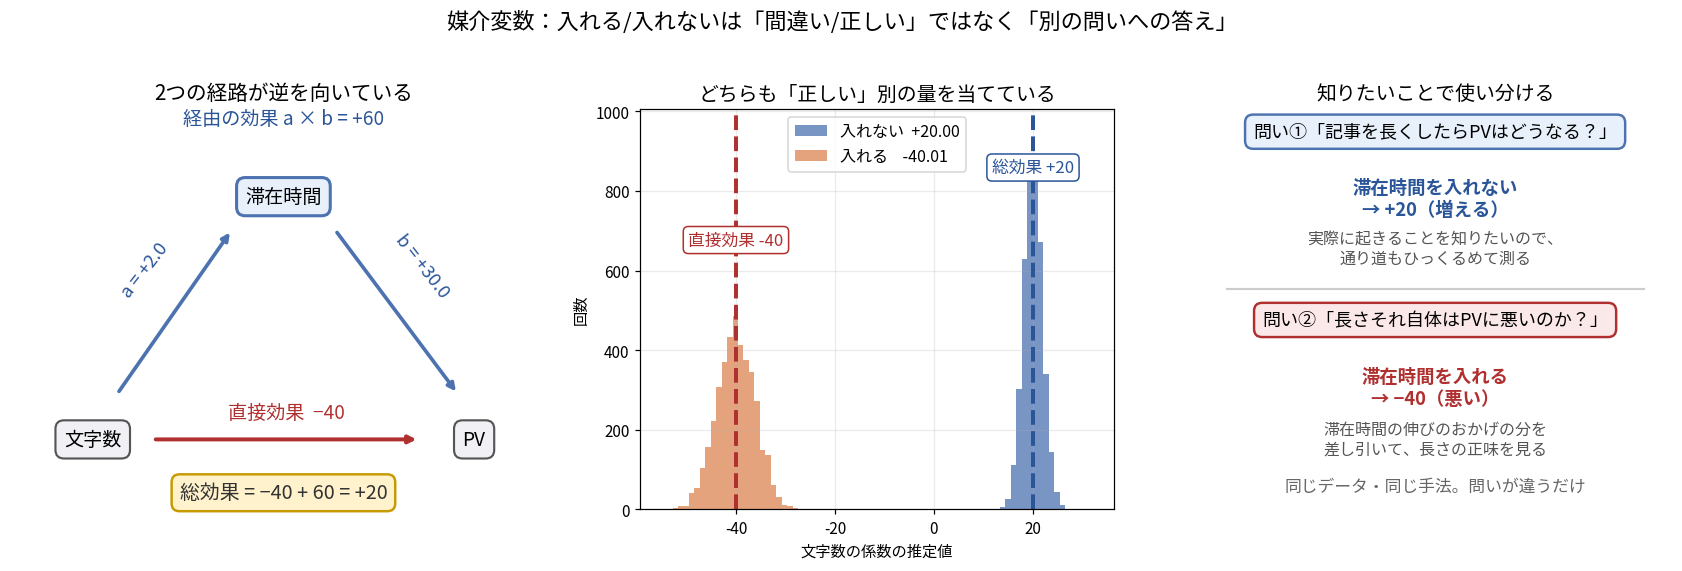
2つは恒等式で結ばれています。
これは平均的に成り立つだけでなく、標本1つごとに厳密に成立する代数的恒等式でした(4000回の各反復での最大誤差 )。
ただし成立条件があります。 これは当てはめる2つのモデルがどちらも線形で、交互作用項を含まない場合の恒等式です(真のデータ生成過程に交互作用や非線形性があっても、この2モデルを当てはめる限り成立します。逆に大きいモデルに交互作用項を入れると崩れます)。ロジスティック回帰のような非線形モデルでも成り立ちません(第18回の話題)。この分解が第27回(第25章)のパス解析・構造方程式モデルの出発点になります。
整理すると、測定できている交絡因子は入れる(原則として選択の余地なし。ただし合流点を兼ねる変数のような例外構造もあります)、媒介変数は問いで決める(総効果なら入れない、直接効果なら入れる)、合流点は入れない(どちらの問いにも答えを壊す)。
はなぜこの形なのか
ここが今回いちばん時間をかけたところです。そして最初に大混乱しました。
原因は私が3次元の絵を2枚見て、それがまったく別の絵だと気づかなかったことです。
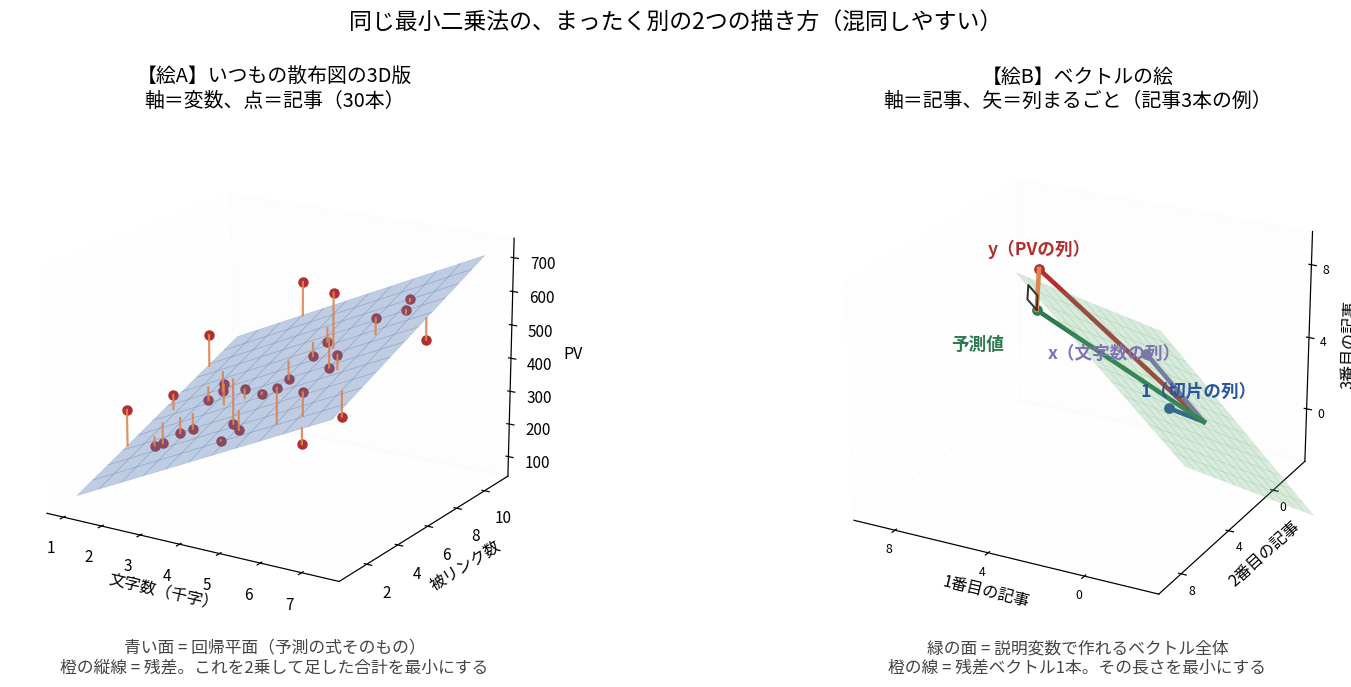
| 絵A(変数の空間) | 絵B(ベクトルの空間) | |
|---|---|---|
| 軸は何か | 文字数・被リンク数・PV(変数) | 1番目の記事・2番目の記事…(データ1件ごと) |
| 次元の数 | 変数の数 | 記事の数(120記事なら120次元) |
| 点/矢は何か | 点=1記事 | 矢=列1本まるごと |
| 平面の意味 | 回帰平面=予測の式 | 列空間=作れるベクトルの範囲 |
| 残差 | 縦線が120本 | 斜めの矢が1本 |
同じ言葉で別のものを指していました。
なおこの先すぐに絵Bが必要になるわけではありません。 次の「まず単回帰から積み上げる」は偏微分して連立方程式を解くだけの代数で、いつもの散布図(絵A)のまま読めます。絵Bが要るのは、そのあとの「幾何で見ると垂線を下ろすだけ」からです。
まず単回帰から積み上げる
行列の前に、偏微分して0に置くという道筋を確認します。残差の2乗和は
これを と で偏微分して0に置くと連立方程式が2本出ます。
2本目で が現れる理由を私は最初つかめませんでした。連鎖律です。 と置くと なので、 で微分すると が落ちてきます。 で微分すると なので何も掛かりません。2本の式の違いはこれだけです。
そしてこの2本は、絵Bで見ると「直交条件」そのものです。 1本目を移項すると 、つまり残差の合計がゼロ——残差が切片の列 と直交しています。2本目は で、残差が の列と直交しています。「縦の距離の2乗和を最小にする」(絵A)と「残差を2本の列それぞれに直交させる」(絵B)は、同じ2本の式の別の読み方でした。 が掛かるのは との内積を取っているから、と読むこともできます。この対応は後半の でそのまま再登場します。
そして変数を増やしても、やることは何も変わりません。 なら未知数が3つになるので式が3本になります。
この係数を表にすると、それがそのまま です(実データで両方を計算して全成分の一致を確認しました)。だから3本の連立方程式は と1行で書けて、両辺に をかければ
行列は連立方程式の書き方であって、新しい概念ではありませんでした。 変数が5本でも50本でも同じ1行で書けるようにしただけです。
そしてこの式を見ると、単回帰で行列が要らなかった理由も分かります。 を決める式に が入っている——つまり説明変数どうしの関係が答えに影響するからです。単回帰では他の変数がいないのでこの項が存在せず、 というきれいな形にまとまっていました。
幾何で見ると「垂線を下ろす」だけ
ここからが絵Bです。 記事3本だけの極小データ(、)で図にしました。
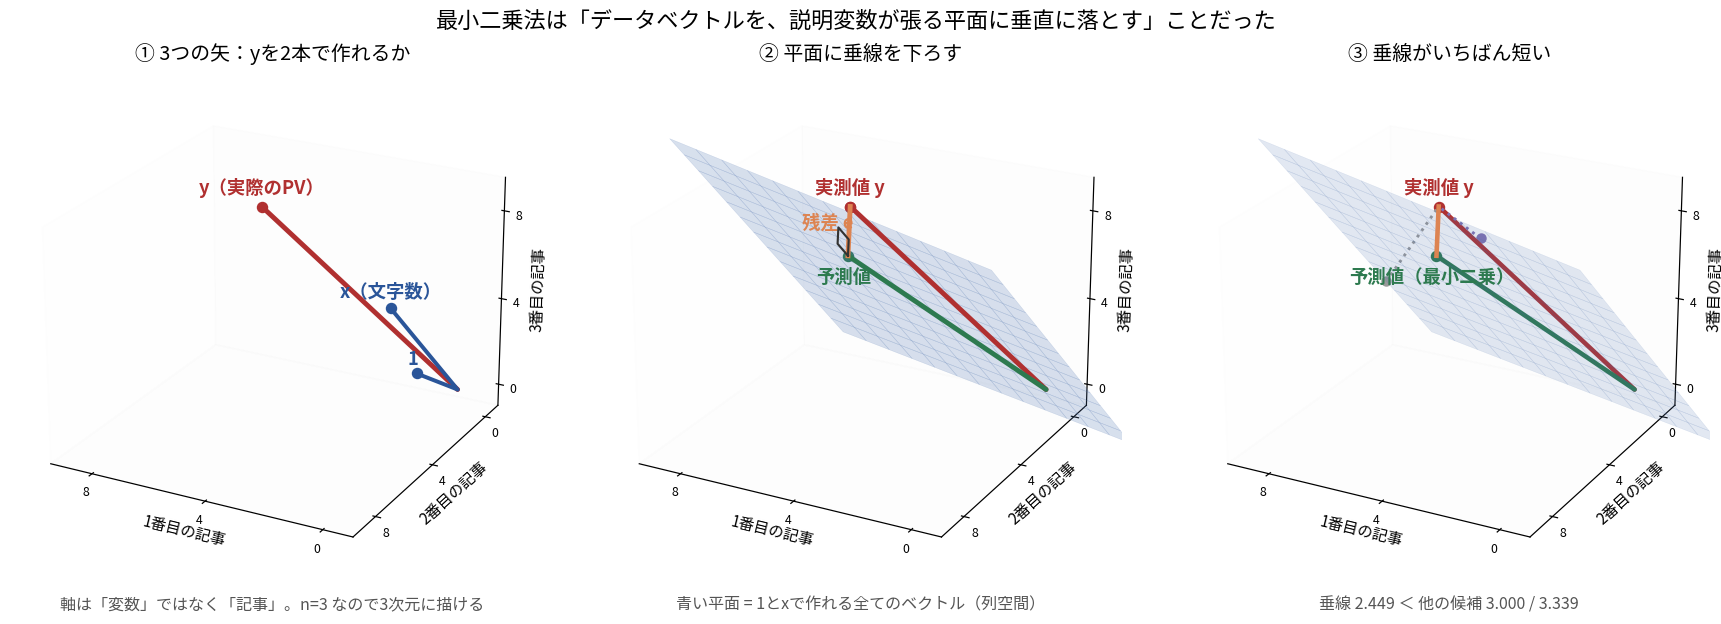
青い2本を伸ばしたり足したりして作れるベクトル全体が平面になります。 が意味するのは「この平面上のどこか」です。ところが はこの平面から外れているので、どう を選んでも届きません。だから平面上でいちばん近い点を選ぶ——それが垂線の足です。
3つの言い方が全部同じだと気づいたのが収穫でした。「残差の2乗和を最小にする」=「距離を最短にする」=「垂直に落とす」。 は矢の長さの2乗そのものなので、最初の2つは同じ。そして平面上で最短距離を与えるのは垂線の足だけです。
そして垂直の条件を式で書くと、答えがそのまま出ます。
ここで私は「 の はどこから来たのか」で詰まりました。この式は1個の内積ではなく、 個の内積を縦に積み上げたものだと分かって解けました。3段階に分けます。
① 平面に垂直とは、平面上のすべてのベクトルに垂直ということ。 ただし無限個を確かめる必要はありません。平面上のベクトルは という形しかないので
となり、張っている列 それぞれに直交していれば右辺は必ず0です。だから確かめるのは列の本数だけで足ります(乱数の で試すと、平面上のどのベクトルとの内積も 以下でした)。
② 列ごとに条件を書き並べる。 、、…、 の 本です。
③ これを1本にまとめると が現れます。 転置するともとの列が行になるからです。 の例なら
で、 の第1行が切片の列、第2行が の列です。行列とベクトルの積は「各行との内積を並べる」操作なので
答えはスカラーではなく 成分の縦ベクトルです( で両成分が を確認)。つまり相手は ではなく「 の各行=もとの各列」で、 という書き方は 本の内積を1行で書くための入れ物にすぎません。
そしてこの2成分は、前の小節で偏微分して出した正規方程式そのものです。 が1本目、 が2本目。絵Aで解いても絵Bで解いても、同じ2本の式に着きます。
は「垂直に落とせ」という条件を について解いた結果でした。 が出るのは内積を取ったから、逆行列が出るのは について解いたから。それだけです。
なお逆行列が存在するには が正則、つまり説明変数の間に完全な重複がないことが必要です(後で出てくるダミー変数の罠がまさにこれに引っかかります)。
平面について3つ補足します。
1つめ。3本以上になると「平面」とは呼べません。 列を足して作れる図形は、1本なら直線、2本なら平面、3本以上なら 次元の「平たいもの」(超平面、正確には 次元部分空間)です。この記事が「平面」と言い続けているのは、図に描けるのが2本までだからにすぎません。
2つめ。その次元は列の本数ではなく rank(階数)で決まります。 列が互いに独立でなければ、本数より低い次元しか張れません。切片+3水準ダミー3本(列4本)で実際に計算すると rank は 3 で止まり、 の行列式は (実質0)で逆行列が存在しません。後で出てくるダミー変数の罠は、「列を増やしたのに図形の次元が増えなかった」状態です。上で書いた「 が正則」という条件は、言い換えれば列の本数ぶんの次元がちゃんと張れているかです。
3つめ。この図形が浮かんでいる空間はデータ件数 次元です。 通し例の120記事・6列なら「120次元空間の中の6次元部分空間」で、絶対に描けません。ただし射影・直交・ピタゴラスはどの次元でも同じ式のまま成り立つので、3次元の絵で見た性質がそのまま通用します。だから絵は で描いています。
そして細かい点を2つ。あの青い2本は単位ベクトルではありません(長さは と )。平面を張る代表として描いただけで、同じ平面を張る別の2本に取り替えても結果は変わりません。そして平面を決めるのは だけで、 は平面上のどこに立つかを指す座標です。平面は を動かす前から決まっています。
直交しているから平方和が足し算になる
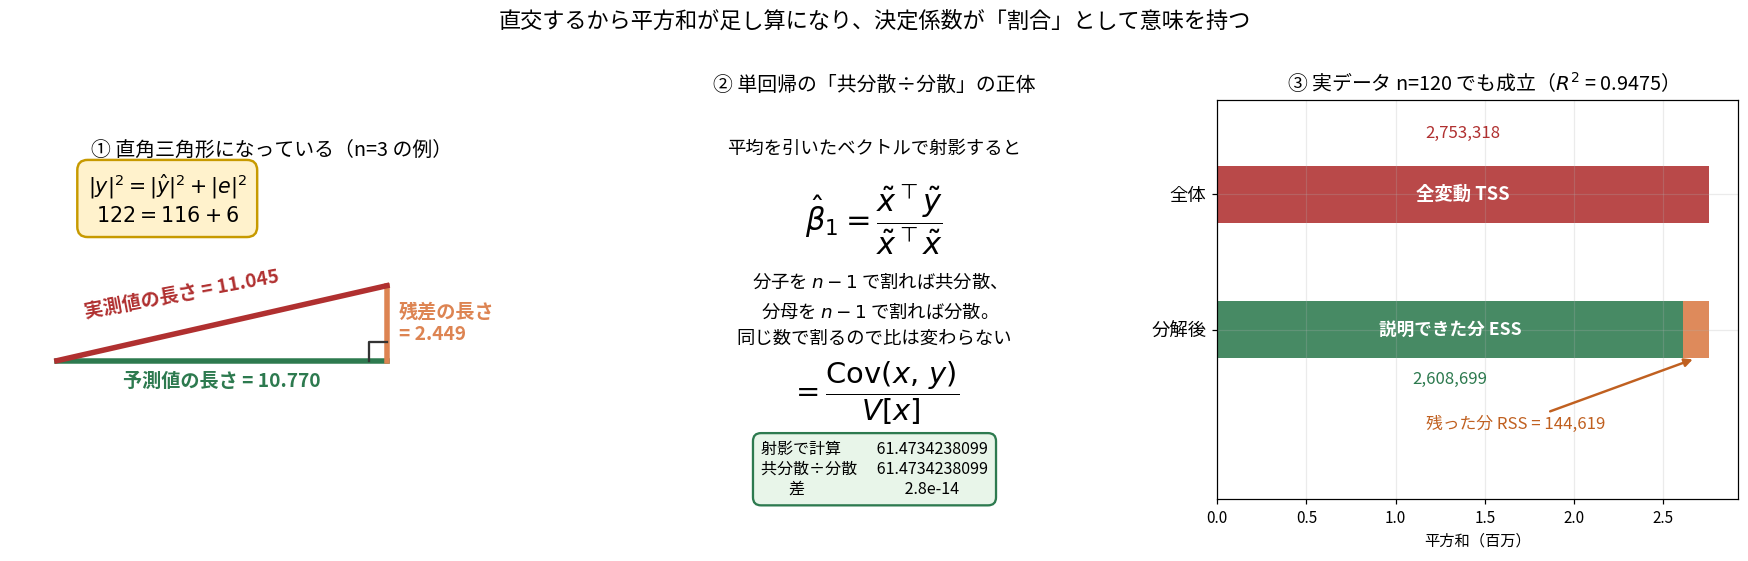
実測値・予測値・残差はぴったり直角三角形をなします()。だから
が成り立ちます。実データでも差は でした。
ただし1つ条件があります。 上の は という「平均を引かない」形の分解です。一方 TSS は下の表のとおり平均からの2乗和で定義されているので、両者が繋がるにはモデルに切片が入っていることが必要です。切片があると残差が とも直交して となり、 の平均が に一致するので、平均を引いた形でも直角三角形が保たれます。実際に切片を外して計算すると とゼロにならず、TSS が 2,753,318 に対して ESS + RSS が 3,408,482 になって分解が崩れました。
この足し算が成り立つのは直角だからです。 斜めに落としていたら平方和は分解せず、「説明できた割合」という言い方自体が意味を失います。 が割合として読めるのは、垂直に落としたことの副産物でした。
3つの平方和は名前が違うだけで作り方は同じです。
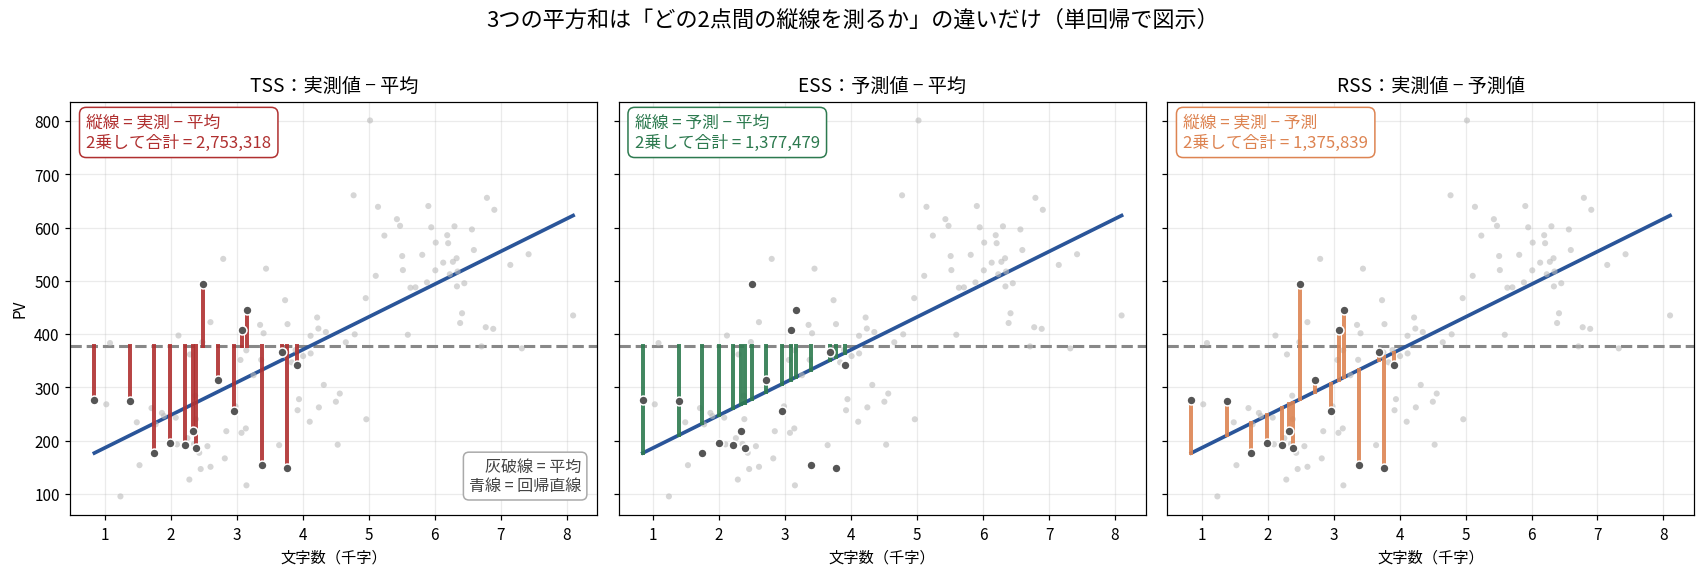
| 記号 | 正式名称 | 式 | 引き算するもの |
|---|---|---|---|
| TSS | Total Sum of Squares(全平方和) | 実測値 − 平均 | |
| ESS | Explained Sum of Squares(回帰平方和) | 予測値 − 平均 | |
| RSS | Residual Sum of Squares(残差平方和) | 実測値 − 予測値 |
ハット行列の性質が自由度の正体だった
なので、 と置けば 。 の例で実際に計算すると、次の性質が確認できます。
| 性質 | 確認 | 幾何的な意味 |
|---|---|---|
| (対称) | 成立 | まっすぐ落としている |
| (冪等) | 成立 | 2回落としても同じ場所 |
| 列数と一致 | 平面の次元=列の本数() | |
| 固有値が 1, 1, 0 | 成立 | 平面内は保たれ、垂直方向は潰される |
| と一致 | これが残差の自由度 |
冪等性 が射影の本質です。影を落とす操作をもう一度やっても影は動かない。そして という等式が、なぜ誤差分散を で割るのかの答えになっています。変数を1本増やすと平面の次元が1つ増え、垂直方向に残る余地が1つ減る。その残った次元の数が自由度です。
単回帰の「共分散÷分散」は射影の言い換え
ここは私が引っかかったところなので丁寧に書きます。「中心化したベクトルで射影すると」と言われて、中心化が何なのか、なぜ出てくるのかが分かりませんでした。
中心化(centering)は「各データから平均を引く」ことだけです。、平均3.5なら 。
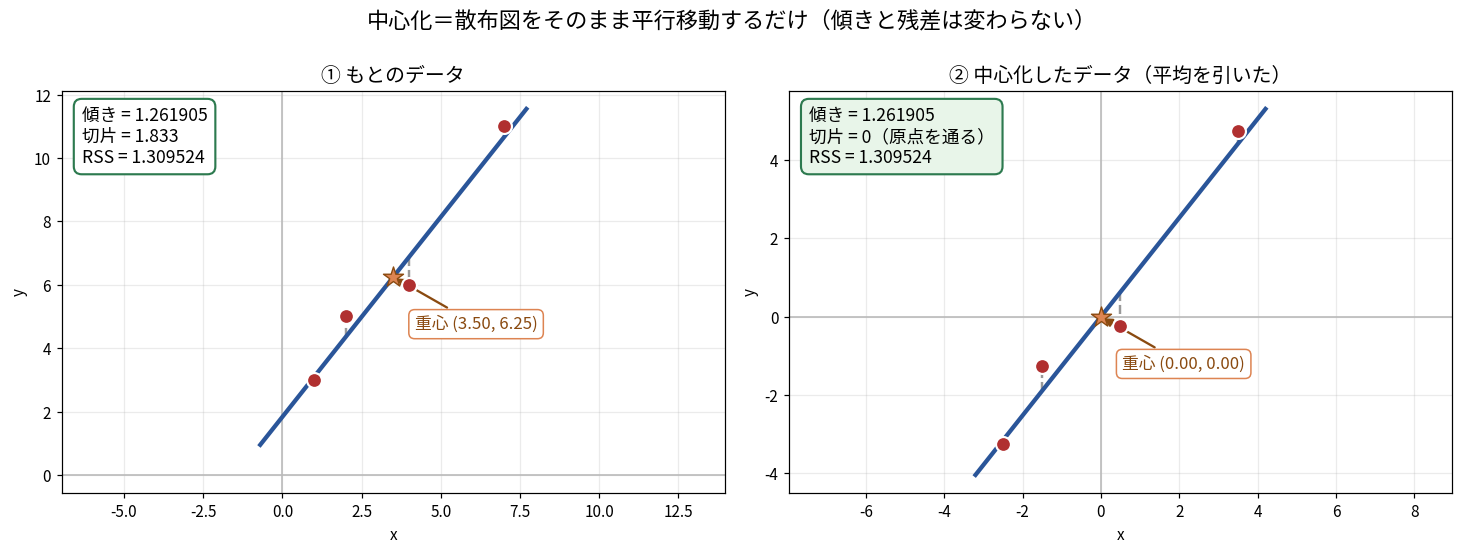
散布図の点の配置をそのまま保って、原点を重心に移すだけです。そして重要なのは、傾きは完全に不変だということ。
| 何を中心化するか | 傾き | 切片 | RSS |
|---|---|---|---|
| しない | 1.2619047619 | 1.833333 | 1.309524 |
| だけ | 1.2619047619 | 6.250000 | 1.309524 |
| と 両方 | 1.2619047619 | 1.309524 |
残差2乗和を最小にするという目的は完全に達成されています。 切片も でいつでも復元できます。中心化は答えを変える操作ではなく、切片を分離して傾きだけを見やすくする座標移動でした。
しかも中心化は既に使っていました。 単回帰の導出で を代入して を消すと、
という変形が出てきます。この右辺が中心化した形で、新しい道具ではなく途中で出てきたものに名前が付いただけでした。
なぜ平均を引くと直交するのか
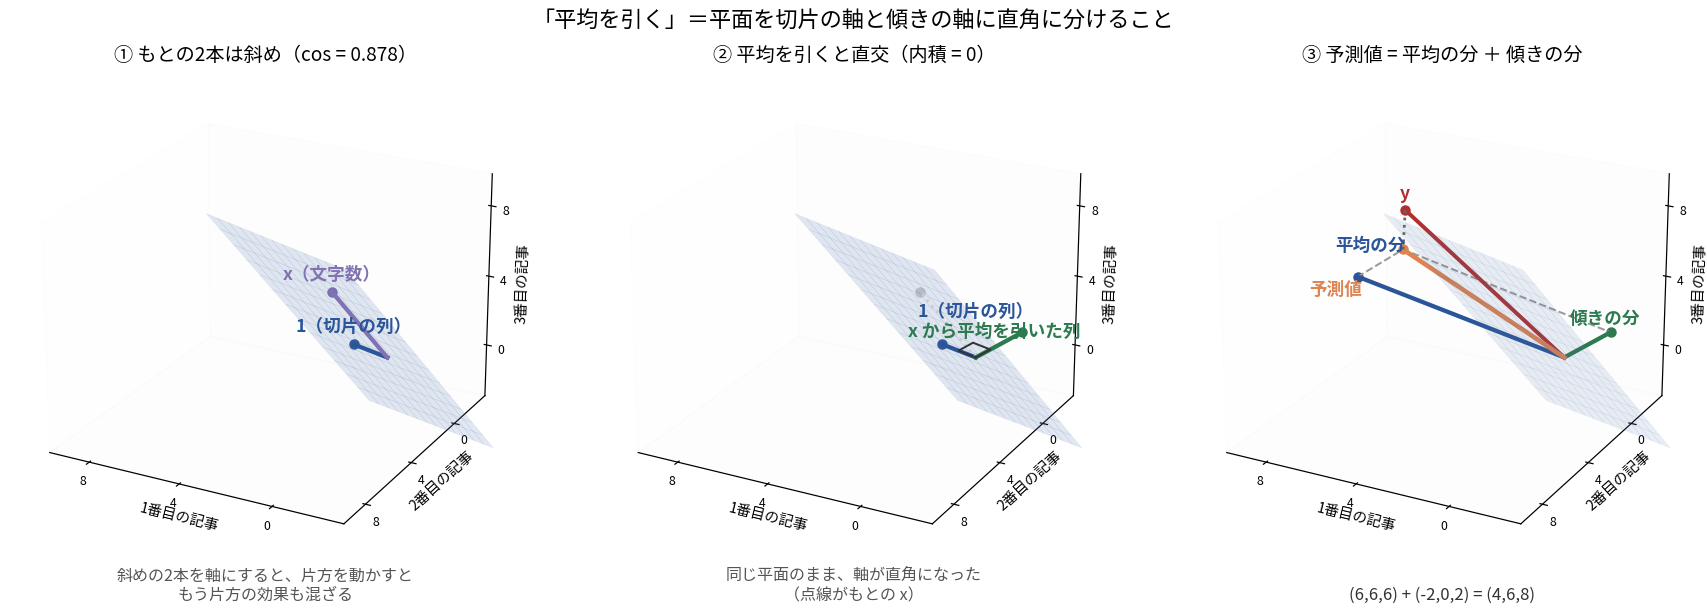
切片の列 と は直交していません(内積は 、)。斜めだと片方の座標を動かすともう片方の意味も変わるので、「傾きだけを取り出す」ことができません。
ところが平均を引くと で直交します。「平均を引いたら合計はゼロ」という定義そのものです。そして平面は変わりません——同じ平面に、直交する新しい目盛りを引き直しただけです。
直交したので傾きは「 という1本の軸だけへの射影」として単独で書けます。1本のベクトルへの射影の係数は内積の比なので
最後の一歩はただの約分です。 分子と分母を同じ で割ると、分子は共分散、分母は分散になります(実データで 22407.7167 ÷ 119 = 188.300140 = 共分散、364.5106 ÷ 119 = 3.063115 = 分散を確認)。分数の分子分母を同じ数で割っても値は変わらないので
「共分散÷分散」は内積の比に を掛けただけでした。行列で解いた値と小数10桁まで一致します。
そして切片は 。回帰直線が必ず点 を通るというよく聞く事実は、この式の言い換えです。
の中身は分散と共分散だった
の正体が気になって調べたら、中心化すれば共分散行列そのもの( 倍だけ違う)でした。
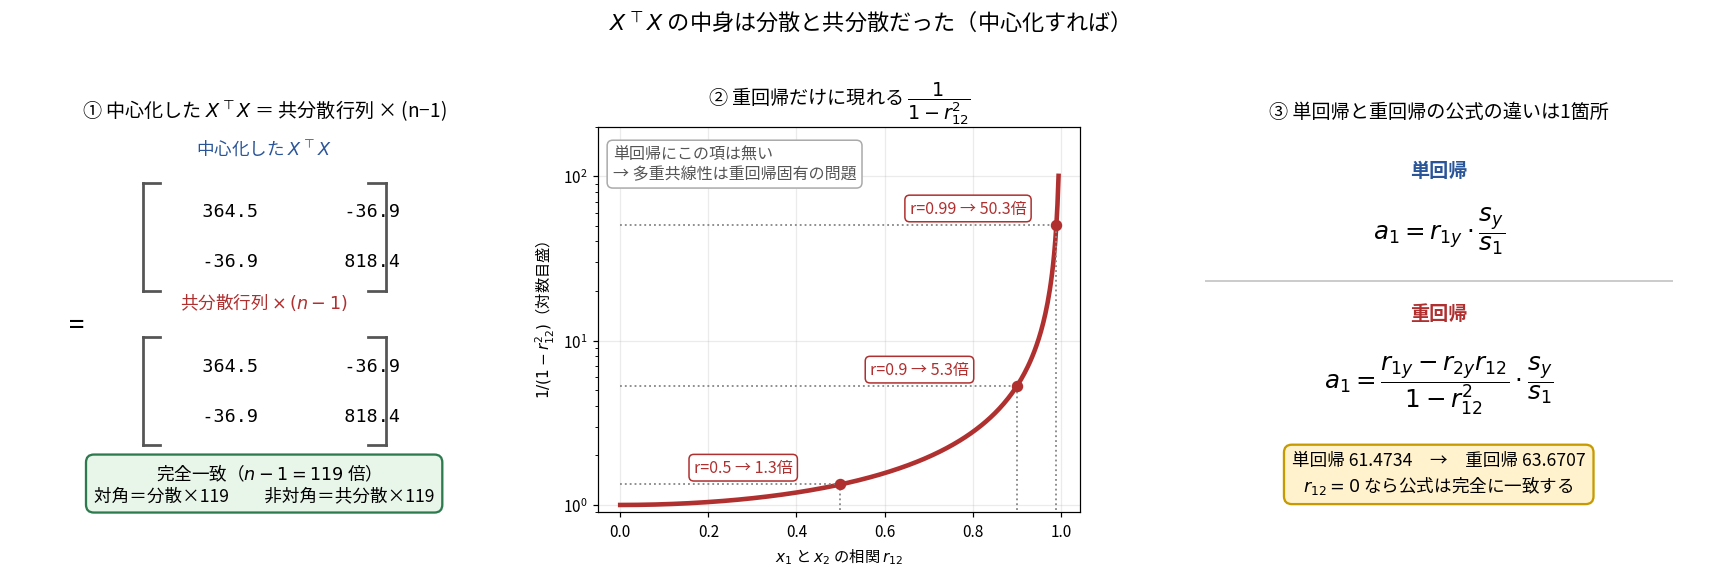
中心化した の対角成分が分散、非対角成分が共分散です(実測で完全一致)。ただし中心化しない生の は、 や 、 が並んだただの2乗和の表で、まだ共分散ではありません。平均を引くという一手間が、2乗和を分散・共分散に変えます。
そして2変数の重回帰は手で解けます。中心化して切片を消し、両辺を で割ると
これが「分散共分散で書いた正規方程式」です。ふつうに解くと
この形に相関は出てきません。 分母 は2×2共分散行列の行列式で、行列で書けば
「共分散行列の逆行列 × との共分散」——これが の中心化版です(実データで小数10桁まで一致)。
ここから相関の形にするのはただの書き換えです。、 を代入すると でくくれて
単回帰は なので、違いは分子で を引き、分母を で割ることだけです。
この1箇所が2つの疑問を同時に説明します。 係数が単回帰と変わるのは を引いているから( と の相関のうち 経由で説明できる分を差し引いている)。そして なら公式は単回帰と完全に一致します。 つまり係数が動く原因は説明変数どうしの相関だけでした。
なぜ相関に直すのか
「計算しやすいから」だと思っていましたが、違いました。計算はむしろ増えます(共分散の形は5つの量、相関の形は6つ。しかも相関を出すには先に共分散が必要)。
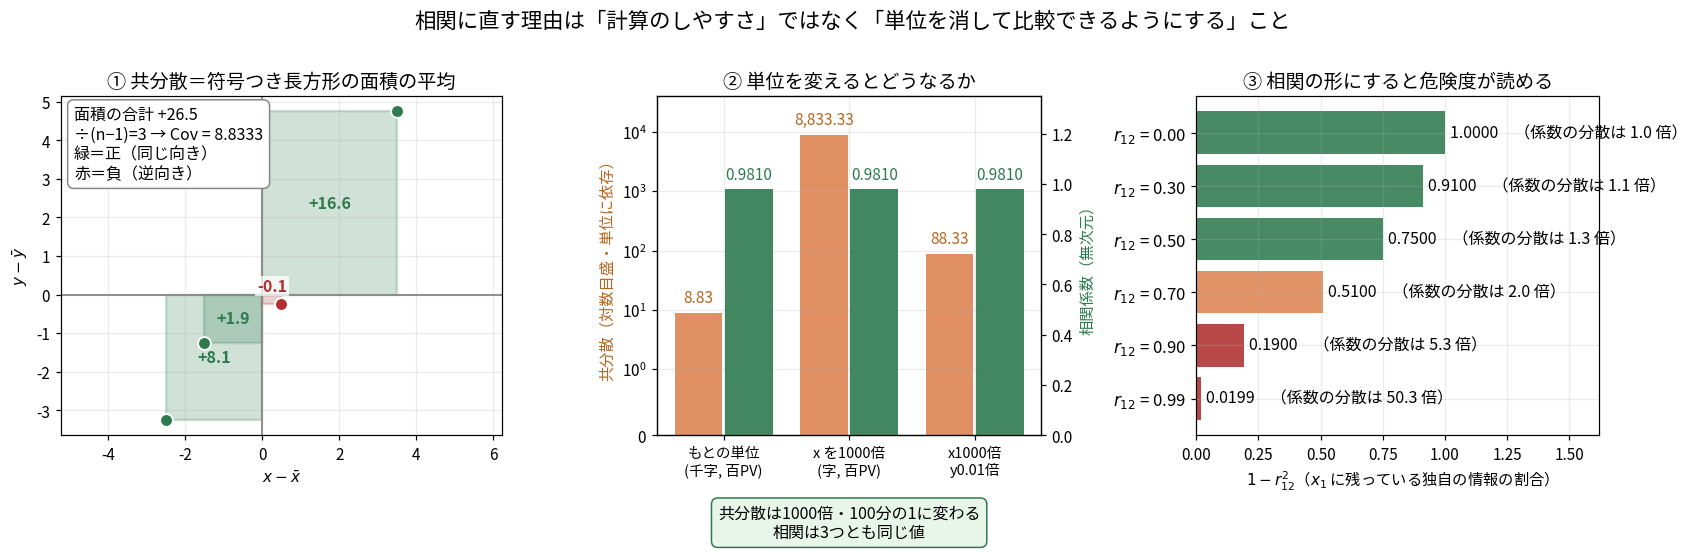
本当の理由は「単位を消して大小を判断できるようにする」ことでした。 共分散の単位は「 の単位 × の単位」なので、 の単位を千字から字に変えるだけで 8.83 が 8833.33 に化けます。数字の大小に意味がないわけです。標準偏差で割ると単位が打ち消えて という固定された物差しに載ります。
今回の文脈での利点も同じです。分母は と の2通りに書けて値は同じ(どちらも 20.968885)ですが、左を見て危険度は判断できません。 右なら が 0〜1 の割合なので一目で分かります。
そして念のため、共分散 は相関の定義の移項です。相関の定義 の両辺に を掛けただけで、覚えるべき新しい事実ではありません。ついでに とすると になり、分散は共分散の特別な場合(相手が自分)だと分かります。
係数の標準誤差はどこから来るのか
は計算すれば1つの数に決まります。では何がばらつくのか。 「もう一度データを取り直したら違う値が出る」という意味です。
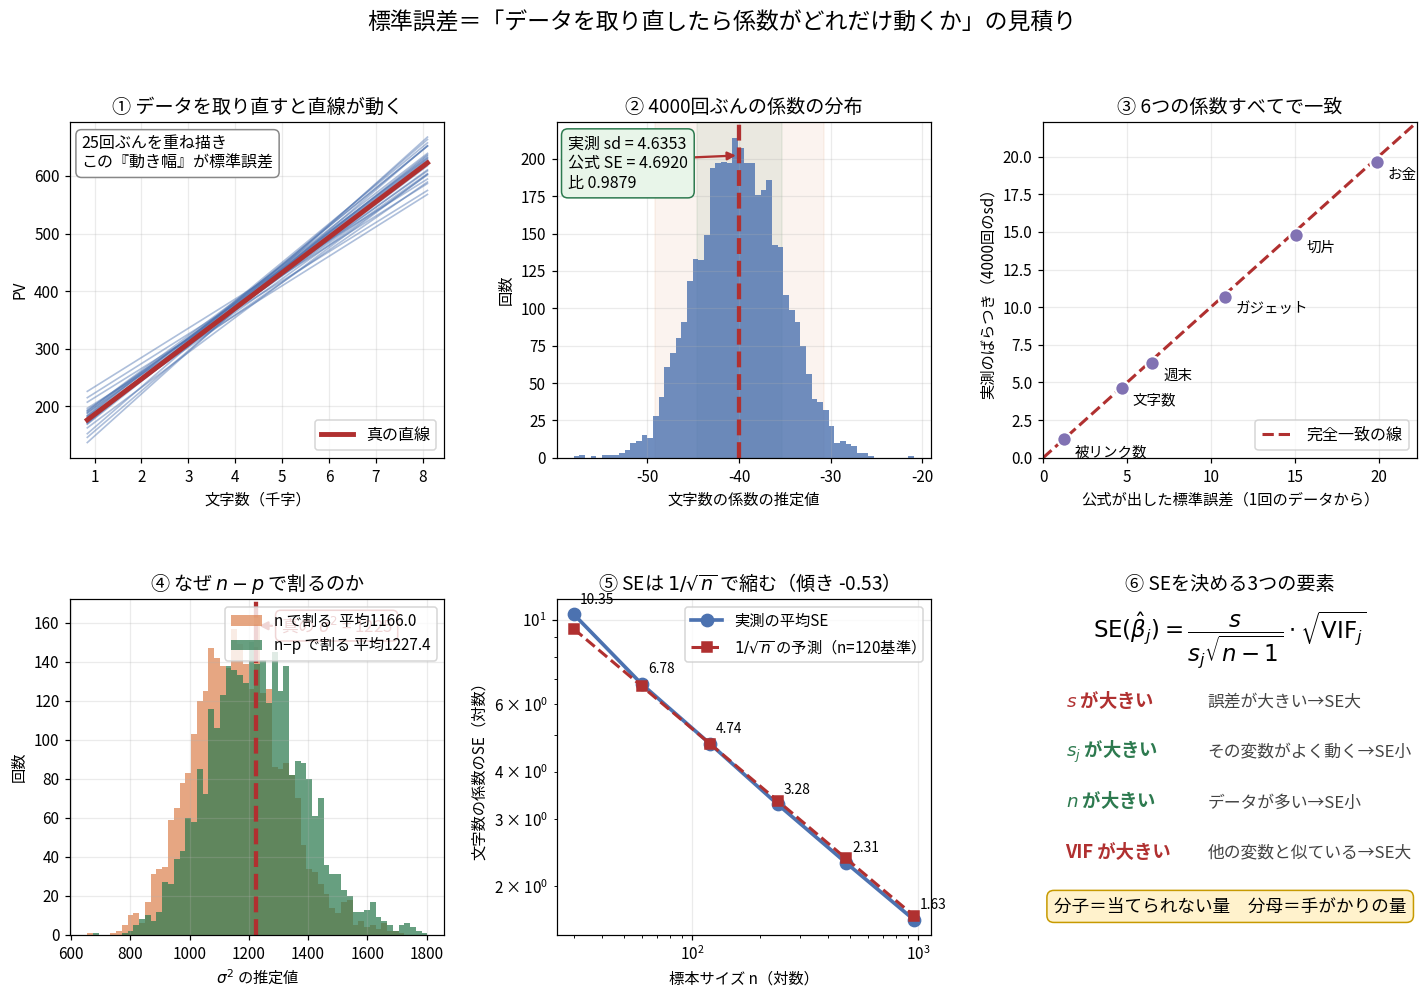
真の構造を固定して誤差だけ振り直すと、回帰直線は扇形に散らばります。この幅が標準誤差です。
そして驚いたのがここでした。文字数の係数を4000回集めた実測のばらつきは 4.6353。一方、1回のデータだけから公式で計算した標準誤差は 4.6920。6つの係数すべてで一致しました。
手元にデータが1組しかないのに「取り直したらどれだけ動くか」を当てられる。 なぜ可能なのかが次の式です。
1行で出ます
出発点は 。これを の式に入れると
第1項で となって が残るので
推定値と真の値のズレは、誤差を行列 で変換したものでした(実データで両辺の差が であることを確認)。 は だけで決まる固定された行列で、ばらつくのは だけです。
あとは分散を取るだけです。ここで という記号には2つの仮定が畳み込まれています。対角がすべて (どの観測も同じ大きさでブレる=等分散)と、非対角がすべて0(ある記事の誤差が別の記事の誤差を予測しない=無相関)。そしてもう1つ、記号の外側に は固定という前提が必要です(だから を定数として外に出せる)。この3つだけで話が進みます。
に を入れると
真ん中で が現れて約分されます( を最大誤差 で確認)。
そしてこの分散には意味があります。 ガウス・マルコフの定理は、誤差が「平均0・等分散・互いに無相関」であれば(正規分布である必要はありません)、最小二乗推定量が線形かつ不偏な推定量の中で分散最小だと言います。BLUE(Best Linear Unbiased Estimator=最良線形不偏推定量)と呼ばれます。
つまり最小二乗法を使う理由は「残差の2乗和が最小だから」という都合ではなく、「不偏推定量として一番精度が高いから」でした。逆に等分散が崩れればBLUEではなくなり、加重最小二乗法などが必要になります。ここが第17回の回帰診断の動機です。
読み方が分かったのが収穫でした。 は「1個1個の観測がどれだけブレるか」、 は「そのブレが係数にどう伝わるか」の増幅率。そして は中心化すれば共分散行列なので、説明変数の散らばり方が係数の精度を決めている。逆行列なので「説明変数がよく散らばっている → SEが小さい」という向きです。 が狭い範囲にしかないと傾きは決めにくい、という直感と合います。
なぜ で割るのか
は普通わからないので と推定します。4000回試すと理由が出ます。
- で割る → (真値 1225)当たり
- で割る → 約5%の過小評価
理由は です。残差は と書けるので
となり、 で割ってはじめて に戻ります。直感で言えば、残差は 個の正規方程式を満たすよう調整されているので、自由に動ける方向が 個しか残っていません。
そして を で置き換えた代償として分布がt分布になります。第7回・第13回でやった「母分散を知らないことへの罰金」と同じ話でした。
ここで仮定が1つ増えることに注意です。 自体に正規性は不要でしたが、t分布・p値・信頼区間には誤差の正規性が必要になります。分散の式までは分布の形を問わない、というのが区切りです。
実データの検定結果はこうなります(自由度114、臨界値 1.9810)。
| 係数 | 推定値 | SE | t値 | 95%信頼区間 | 真の値 |
|---|---|---|---|---|---|
| 切片 | 155.13 | 15.05 | 10.31 | [125.32, 184.95] | 150 |
| 文字数 | 4.69 | [, ] | |||
| 被リンク数 | 21.79 | 1.25 | 17.41 | [19.31, 24.27] | 22 |
| 週末 | 47.73 | 6.52 | 7.33 | [34.83, 60.64] | 45 |
| ガジェット | 226.01 | 10.85 | 20.83 | [204.51, 247.51] | 230 |
| お金 | 483.34 | 19.91 | 24.27 | [443.89, 522.80] | 490 |
6つすべての信頼区間が真の値を含みました(第11回でやったとおり、これは「作り方」の性質で毎回入るわけではありません)。
SEを決めるのは4つ
を成分で書き下すと、SEはこう分解できます。全係数で厳密に成立することを確認しました(差は 以下)。
分母が「手がかりの量」、分子が「当てられない量」です。 が大きいとSEは大きく、(その変数の散らばり)と が大きいとSEは小さくなります。 については両対数の傾きが で、 の法則が確認できました( を8倍にするとSEは 2.90 分の1、)。
そして4つ目がVIFです。
VIF(分散拡大係数)とは何か
VIF = Variance Inflation Factor=分散拡大係数。 字面のまま「分散を膨らませる係数」です。その説明変数が他の説明変数とどれだけ重複しているかを表します。
求め方に発想の面白さがあります。VIFを計算するとき (PV)は一切使いません。
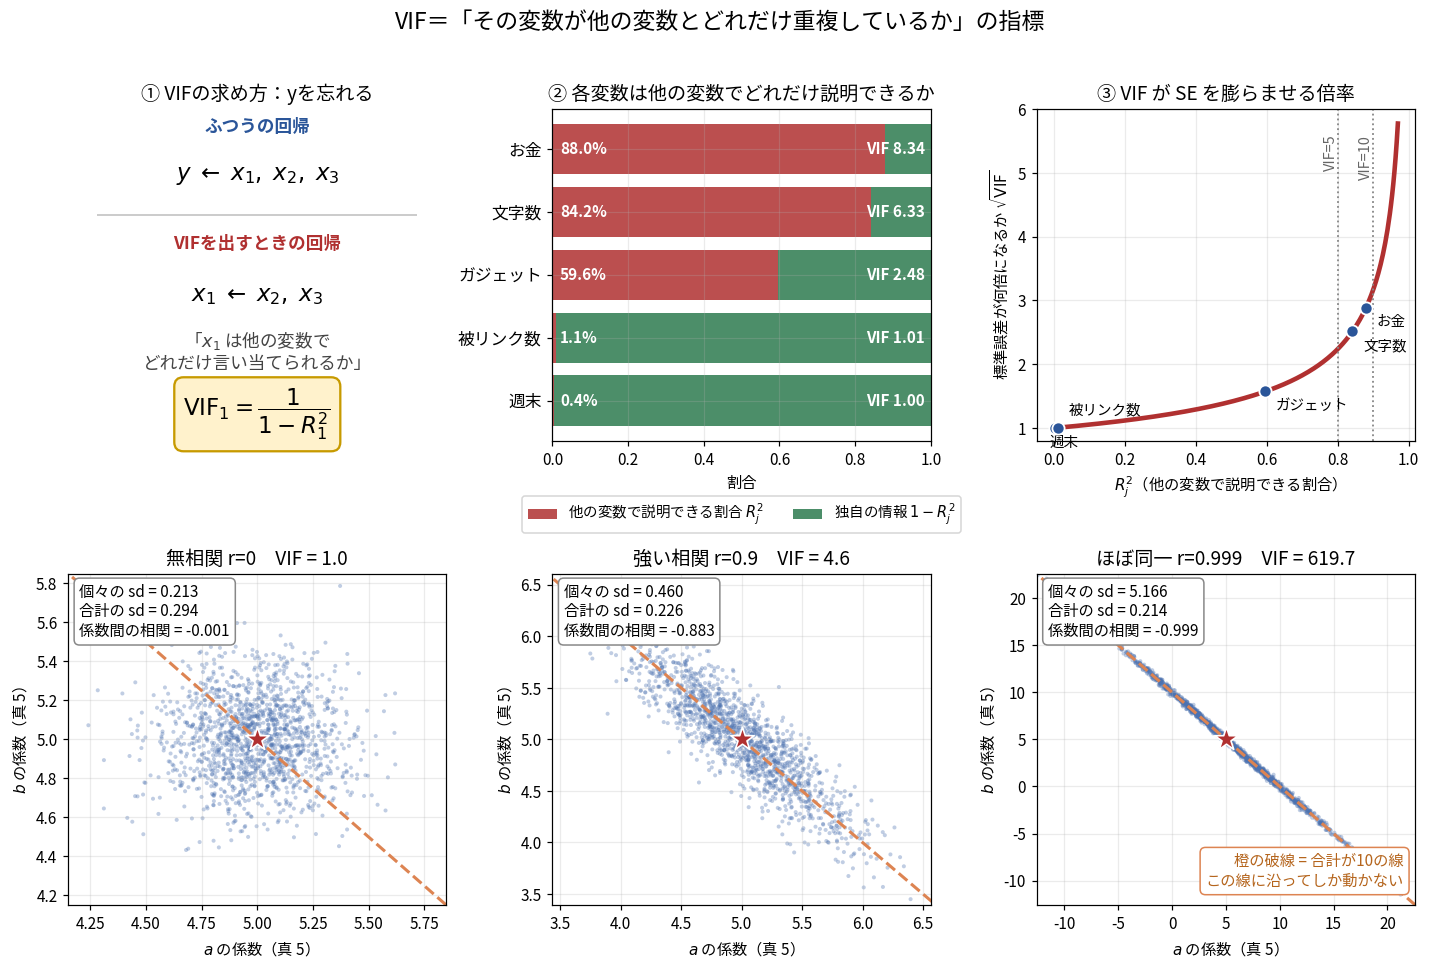
「 を残りの説明変数で回帰する」——この回帰の決定係数を とすると
は「 の分散のうち他の変数で言い当てられる割合」なので、 が「その変数だけが持っている独自の変動の割合」、VIFはその逆数です(以下「独自の情報」と書きますが、正確には分散の割合です)。
| 変数 | 他の変数で説明できる割合 | 独自の情報 | VIF | SEの倍率 |
|---|---|---|---|---|
| お金 | 88.0% | 12.0% | 8.34 | 2.89 倍 |
| 文字数 | 84.2% | 15.8% | 6.33 | 2.52 倍 |
| ガジェット | 59.6% | 40.4% | 2.48 | 1.57 倍 |
| 被リンク数 | 1.1% | 98.9% | 1.01 | 1.01 倍 |
| 週末 | 0.4% | 99.6% | 1.00 | 1.00 倍 |
文字数のVIFが 6.33 なのは、「お金の記事は長い」という設定なのでジャンルが分かれば文字数もだいたい分かってしまうからです。
そして説明変数が2本だけなら相手は1本なので になります(数値でも一致を確認)。前節の はVIFの2変数版でした。3本以上だと1つの相関では表せません(「 は とも とも相関が低いのに で再現できる」ことがある)。相関行列を眺めるだけでは多重共線性を見逃すのはこれが理由です。
多重共線性は「分解できない」問題
図の下段が今回いちばん面白い発見でした。真の係数が両方 5.0 のデータで、相関だけを変えて2000回推定します。
| 2変数の相関 | VIF | 個々の係数のsd | 合計 のsd |
|---|---|---|---|
| 1.0 | 0.213 | 0.294 | |
| 4.6 | 0.460 | 0.226 | |
| 619.7 | 5.166 | 0.214 |
ほぼ同一のとき個々の係数は sd 5.17 で暴れ、真の値が5なのに や が平気で出ます。ところが「2つの係数の合計」は sd 0.214 で、無相関のときより安定しています。
点が「合計が10」の斜線上に完全に潰れるのが図で見えます。係数間の相関は 。合計は正確に分かっているのに、その内訳が決められない状態です。
だから多重共線性は「情報が消える」問題ではなく「情報を分解できない」問題です。 この区別が実務で効きます。訓練データと同じような範囲を予測するだけなら多重共線性は気にしなくてよい(合計=予測値は安定している)。困るのは「どの変数がどれだけ効くか」を言いたいときです。
ただし予測でも1つ条件が付きます。説明変数どうしの関係が崩れた範囲へ外挿すると、内訳が決まっていない代償が予測にも出ます。 「文字数と被リンク数がいつも一緒に増える」データで学習したモデルを、「文字数だけ多い記事」に当てると外れます。
VIFが高い変数は消すべきか
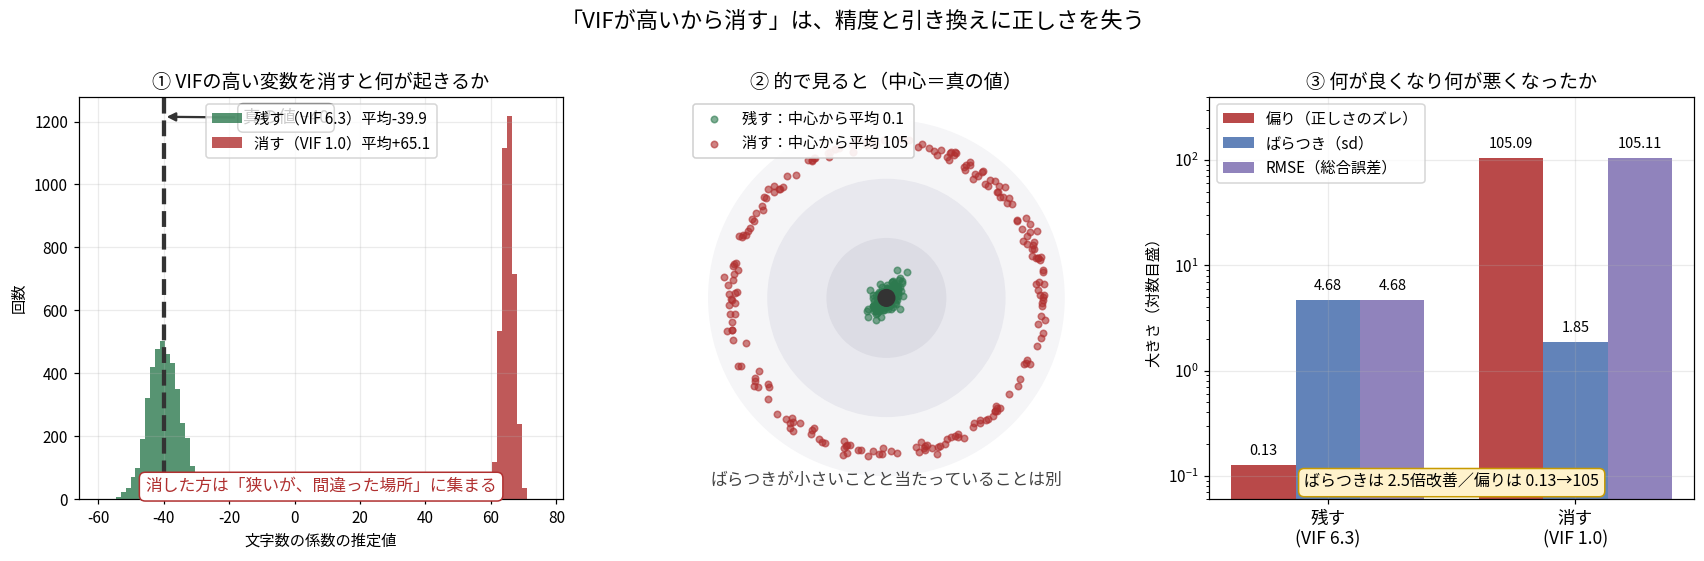
危険です。 実験しました。VIFが高いジャンルダミーを削除すると、残った変数のVIFは全部 1.01 未満、見た目は完璧にきれいになります。ところが。
| 変数 | 全部入れる | ジャンルを消す | 真の値 |
|---|---|---|---|
| 文字数 | (SE 4.69) | (SE 4.64) | |
| (誤差) | 35.62 | 88.41 | 35 |
符号ごと逆転して真の値から104ズレました。 しかも標準誤差は 4.69 → 4.64 とわずかに「改善」して見えるのが厄介です。
4000回で構造が見えます。
| ばらつき sd | 偏り | RMSE(総合誤差) | |
|---|---|---|---|
| ジャンルを残す(VIF 6.3) | 4.678 | 4.680 | |
| ジャンルを消す(VIF 1.0) | 1.849 | 105.110 |
ばらつきだけ見れば消した方が2.5倍「精密」ですが、的の中心から105ズレています。 「精度が良い」と「正しい」は別物で、VIFは前者しか見ていません。
そしてVIFは変数の属性ではなく関係性の指標です。同じ「文字数」の列でも、一緒に入れる変数によってVIFは 1.0046(被リンク数だけ)から 6.3256(ジャンル込み)まで変わります。「この変数はVIFが高い」ではなく「この組み合わせではVIFが高い」が正確な言い方です。
消してよいのは同じ情報の重複(文字数の千字版と字版、合計と内訳の両方)だけです。実際に両方入れるとVIFは無限大になり、係数は 、標準誤差は に暴走しました。これは消しても情報が失われないので副作用がありません。対して交絡因子として必要な変数はVIFが高くても残す(偏りは取り返しがつかないが、ばらつきは を増やせば縮む)。
なおジャンルダミーのVIFが 2.48 と 8.34 と高いのは、ジャンルが文字数と強く相関している(お金の記事は長い)からで、「ダミー変数だから」ではありません。3水準を均等に分けた排他的ダミーどうしは互いに 程度の負の相関を持ちますが、それだけならVIFは 1.33 程度にとどまります(文字数を外してジャンルダミーだけを入れると実測で 1.33 / 1.33)。
「他の変数を固定したとき」の正体
いよいよ本題です。実際に固定していないのに、なぜそう解釈できるのか。
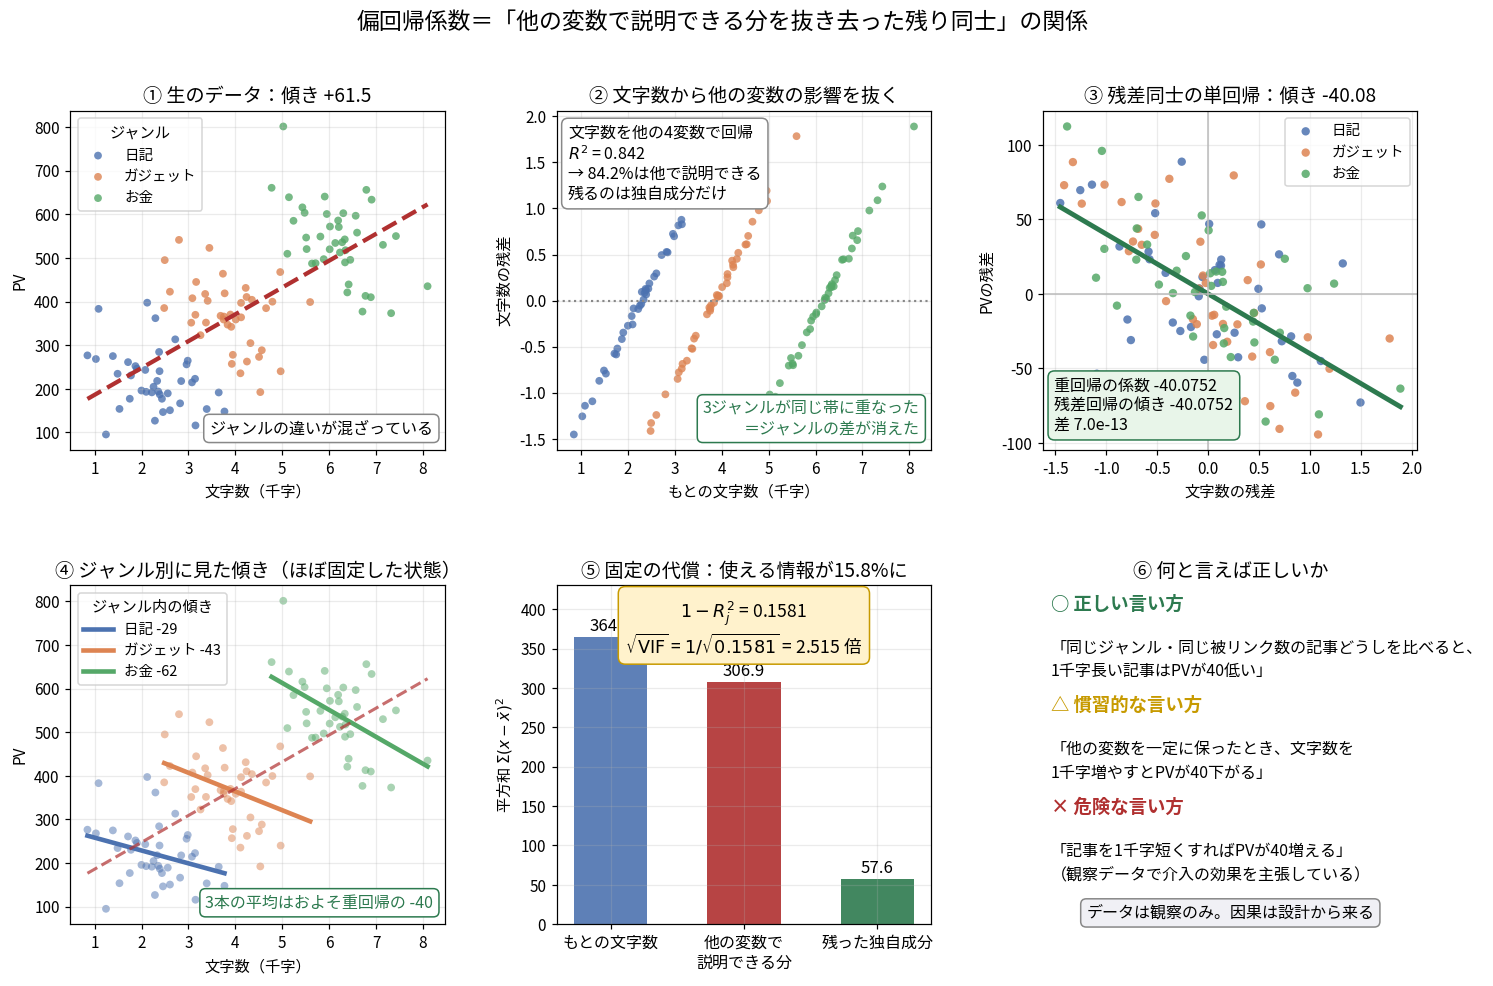
答え:重回帰の係数は、次の3ステップと完全に同じ値になります。
- 文字数から、他の説明変数で説明できる分を抜き去る(残差を取る)
- PVからも同じように抜き去る
- 残った2つの残差だけで単回帰する
| 計算方法 | 文字数の係数 |
|---|---|
| 残差同士の単回帰の傾き | |
| の該当成分 | |
| 差 |
小数10桁まで一致。 全5係数で成立します(フリッシュ=ウォー=ローヴェルの定理)。
2つ補足します。 側は残差化しなくても傾きは同じ値になります( をそのまま使っても 。 の残差が他の変数と直交しているため)。ただし一致するのは係数だけで、標準誤差は一致しません——残差回帰の自由度は になり、重回帰の と違うので、SEは 4.612 対 4.692 とズレます。残差回帰は係数の意味を理解するための道具で、検定にそのまま使うものではありません。
②の図が核心です。 もとの文字数は3ジャンルが階段状に並んでいますが、残差を取ると3つの集団が同じ0の周りに重なります。 残差の意味は「そのジャンルの平均的な長さと比べて何千字長いか」なので、お金の記事の中で長めのものと日記の中で長めのものが同じ「+0.5」として扱われる。ジャンルという情報が消えています。
念のため確認すると、文字数の残差と他の各変数の相関はすべて 程度、計算機の誤差の範囲でゼロでした。「固定した」というより「他の変数の影響を数学的に消去した」と言うのが正確です。
固定の代償がVIFだった
残差回帰の傾きは単回帰と同じ形です。
分母は「その変数に残った独自情報の量」です。実データでは平方和が 364.5106 → 57.6248、比は 0.158088()。使える情報が15.8%に減りました。
標準誤差は分母の平方根に反比例するので
に膨らみます(VIF 6.3256 の平方根 2.5151 と一致)。
これで全部繋がりました。 「他の変数を固定する」とは「他の変数で説明できる分を捨てる」こと。捨てれば使える情報が減るので推定が不安定になる。VIFはその「捨てた量」を測っていたわけです。
交絡を除くために変数を入れる → 情報を捨てる → 精度を失う。 この1本のトレードオフがこの記事全体を貫いています。
何と言えば正しいのか
| 言い方 | 評価 |
|---|---|
| 「同じジャンル・同じ被リンク数の記事どうしを比べると、1千字長い記事はPVが40低い」 | 正しい |
| 「他の変数を一定に保ったとき、文字数を1千字増やすとPVが40下がる」 | 慣習的(教科書もこう書く) |
| 「記事を1千字短くすればPVが40増える」 | 危険 |
3つ目が危険なのは観察データから介入の効果を主張しているからです。実際に記事を短くしたら、「同じジャンルの中で短い記事」になるのではなく内容そのものが変わるかもしれません。係数が答えているのは「比較」であって「介入の結果」ではありません。
決定係数はなぜ変数を増やすと必ず上がるのか
答え:新しい変数の係数を 0 に選べば、前のモデルと完全に同じ予測ができるからです。
変数を1本足すことは平面の次元を1つ増やすことでした。広い空間には元の平面がまるごと含まれるので、前のモデルの答えは新しいモデルでも「選べる候補」の1つです。最小二乗法は候補の中でRSSが最小のものを選ぶので、候補が増えて最小値が悪くなることはありえません。
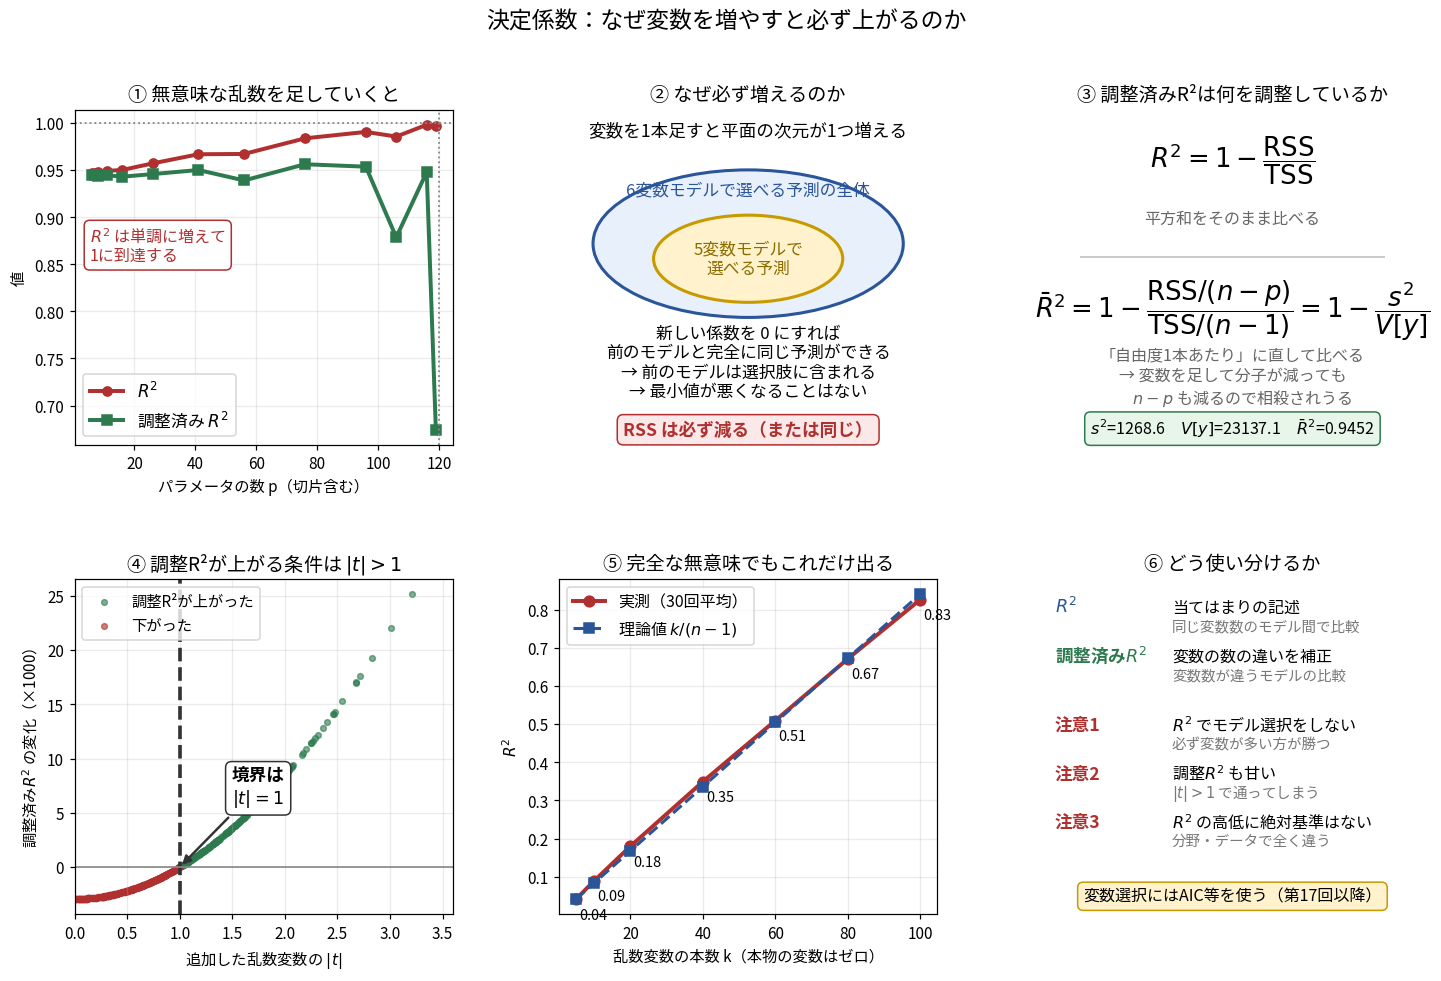
実際に乱数1本を足すと RSS が 144,619.42 → 143,834.41 と785.01 減りました。 乱数はPVと何の関係もないのに、です。
| 足した乱数 | 変数の数 | 調整済み | ||
|---|---|---|---|---|
| 0 | 5 | 0.947474 | 0.945171 | 35.62 |
| 20 | 25 | 0.957257 | 0.945889 | 35.38 |
| 100 | 105 | 0.990567 | 0.919823 | 43.07 |
| 113 | 118 | 0.997704 | 0.726780 | 79.51 |
最後の行が怖いところです。 でほぼ完璧な当てはまりですが、足したのは全部でたらめな乱数。そして は 35.6 → 79.5 に悪化しています。「よく当てはまっている」のに「予測は使い物にならない」——これが過適合(overfitting)です。
ただし正確に言うと、最終行は残差自由度が しかないので、 は極端にばらつく推定値の1標本です(同条件を500回試すと は真値1225付近のまま不偏で、 の中央値は 21.7、79.5を超えるのは4%)。 が確実に悪化するのではなく、当てにならなくなるのが実害だと読んでください。
さらに直接的なのが、本物の変数を1本も使わず乱数だけで回帰した場合です。
は説明変数の本数です。切片があって、 が説明変数と独立かつ同一分布(iid)なら、これは厳密な等式です( が正規分布である必要はありません。対数正規やコーシーでも成立することを確認しました)。逆に の分散が観測ごとに違ったり平均がずれていたりすると崩れます。 で乱数100本なら (30回平均の実測 0.826 は標本誤差の範囲)。 が0.8を超えていても、それ自体は何の証拠にもなりません。
調整済み は「自由度1本あたり」に直している
分子は 、分母は の分散です。つまり調整済み は「 が小さくなったか」を見ています。
変数を足すと分子のRSSは必ず減りますが、同時に も1つ減ります。 割り算なので、分子の減りが「自由度1本を失う代償」に見合わなければ は増えてしまい、 は下がる。「変数1本ぶんの価値があったか」を判定しているわけです。
そして「価値」の正確な条件が分かりました。変数を1本足して調整済み が上がるのは、その変数の のときだけです(600回試して例外0件、図④で境界がぴったり の縦線で分かれます)。
これは経験則ではなく厳密な同値条件で、3行で示せます。 の式で と は変数を足しても変わらないので、 が上がることは が下がることと同じです。 と置くと
左辺は追加した1変数の部分F統計量そのもので、1変数なら 。よって条件は 、つまり です。シミュレーションで反例が出ないのは当然でした。
ここから2つ注意が出ます。調整済み は甘い基準です(有意の境界は約1.98なのに、通す境界は1)。そして「無意味な変数で必ず下がる」わけではありません——乱数でも は約30%起きるので(400回中121回)、その分は上がってしまいます。平均的にはほぼ横ばいで、単調増加する との違いはそこです。
実務では より を見るほうが実用的だと感じました。 なら「予測は±70PVくらいずれる」と分かりますが、 からはこの感覚が得られません。そして は変数を足しても自動的には下がりません(上の表の右端が証拠)。
なおこの例で が高いのは私が真の構造を知っていてそのとおりの変数を入れたからです。現実のアクセス解析でこの数字はまず出ません。
なぜ回帰で検定が必要になるのか
ここまでは「係数を求める」話でした。では求めた は信じてよいのか。 ここで検定が出てきます。
PVとまったく関係のない乱数の列を1本追加してみます。真の効果はゼロです。
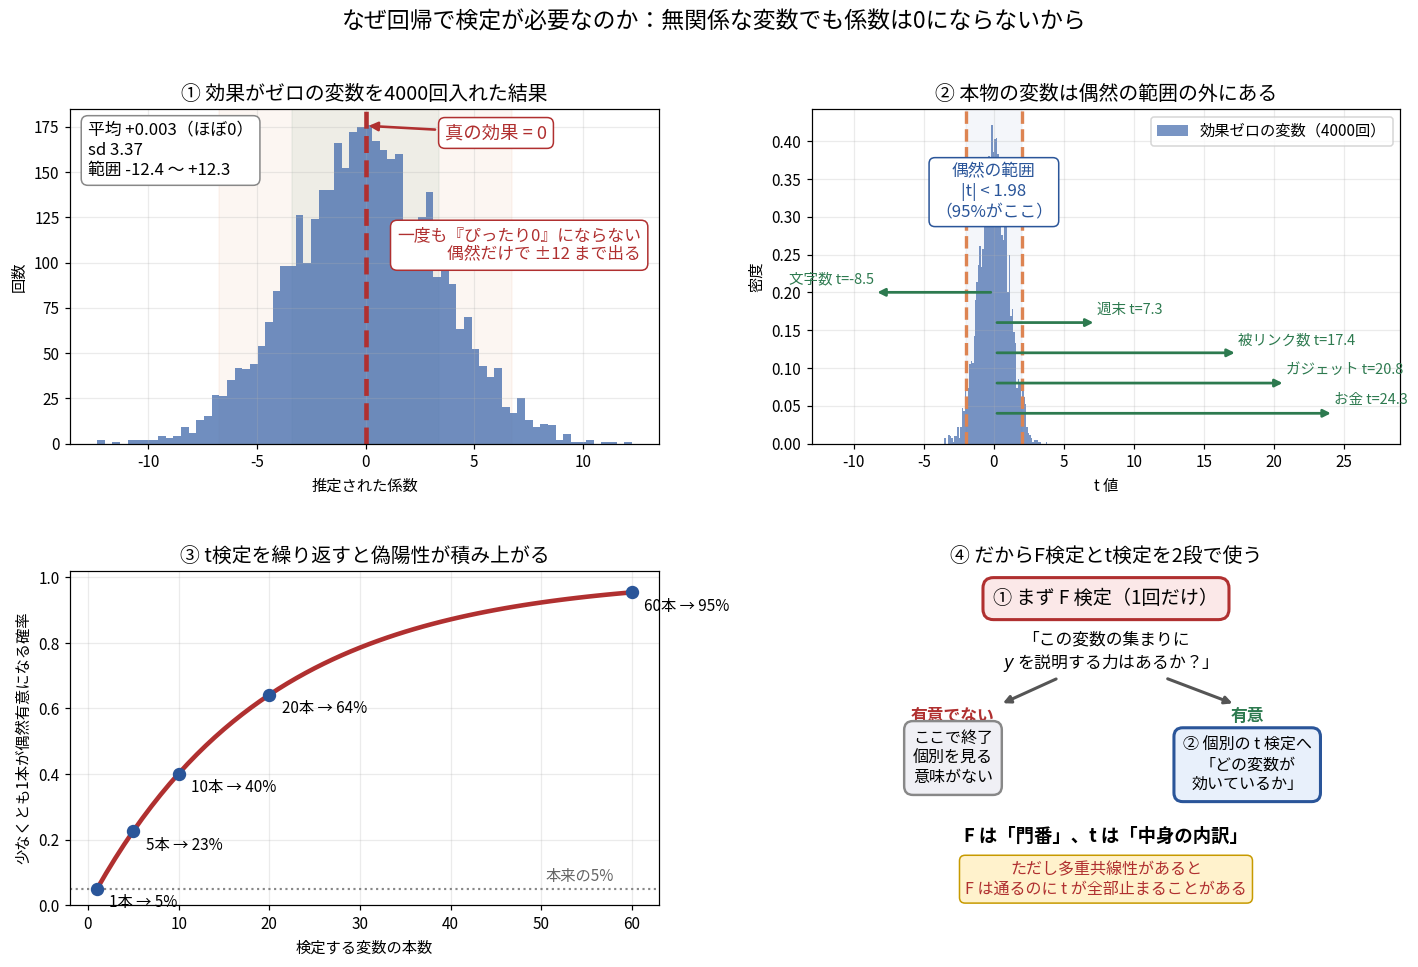
一度も「ぴったり0」になりません。 最小二乗法は「与えられた列でRSSを最小にする」だけの機械なので、無関係な列でも偶然の一致を拾って0でない係数を返します。10回のうち1回は で「有意」にもなりました。中身は完全な乱数なのに。
だから「この係数は本物か、偶然か」を判定する仕組みが必要になります。それが検定です。
4000回集めると、効果ゼロの係数は平均 、標準偏差 3.37、範囲は 〜 。 値に直すと 95%が に収まります(実測で が 0.0583、理論値0.05)。「効果がゼロならこの範囲に散る」と事前に分かるから、超えたら「偶然では説明しにくい」と判断できるわけです。
本物の変数は が 7.33〜24.27。偶然では絶対に届かない距離にあります。
F検定は門番、t検定は内訳
t検定は変数1本ごとに1回行うので、繰り返すと偶然の有意が混ざる確率が上がります。
| 変数の本数 | 少なくとも1本が偶然有意になる確率 |
|---|---|
| 1本 | 5.0% |
| 5本 | 22.6% |
| 20本 | 64.2% |
| 60本 | 95.4% |
第12回でやった多重比較の問題です。そこでF検定を「門番」として先に1回だけ行います。
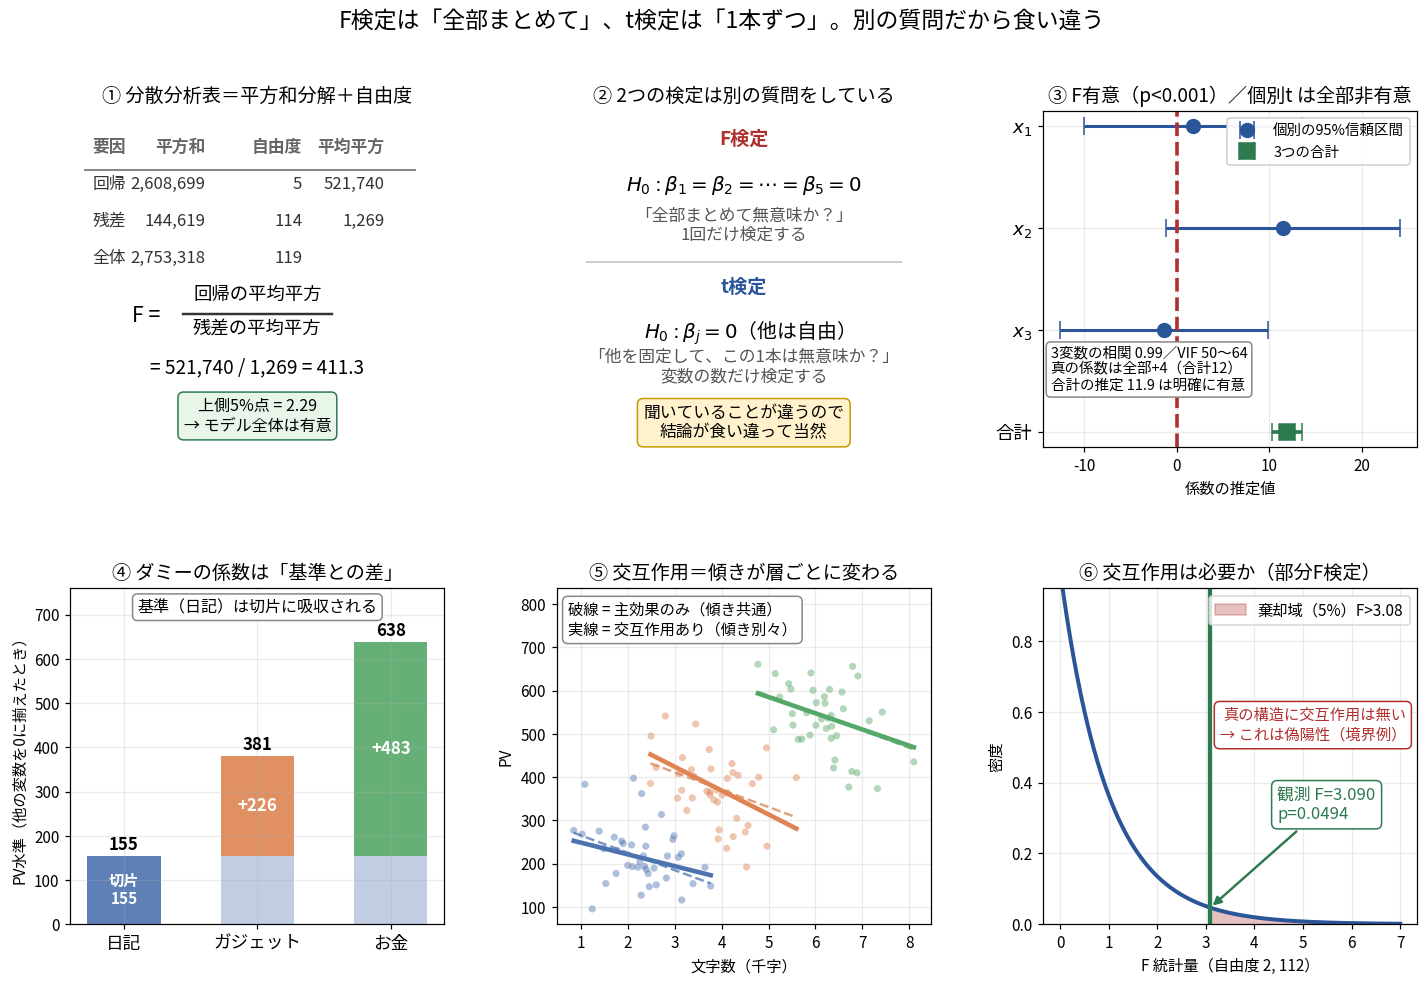
分散分析表はブロック2の平方和分解に自由度を付けただけです。
| 要因 | 平方和 | 自由度 | 平均平方 | F値 |
|---|---|---|---|---|
| 回帰 | 2,608,698.7 | 5 | 521,739.7 | 411.27 |
| 残差 | 144,619.4 | 114 | 1,268.6 | |
| 全体 | 2,753,318.1 | 119 |
分母はブロック3の そのものです。「説明できた量は、説明しきれない量の何倍か」を測っています。第7回でやったとおりF分布は分散の比の分布なので、この形が自然に出てきます。上側5%点は 2.2939 なので、モデル全体は明確に有意です。
とも書けて、実データで 411.274849 と表のF値が完全に一致しました( は切片を含むパラメータ数なので、分子の自由度は説明変数の本数 、分母は です)。 を「有意かどうか」の形に変換したものがF値です。
そして単回帰では になります(、、)。変数が1本なら「全体の検定」と「その係数の検定」は同じ質問だからです。
F有意なのに個別tが全部非有意になる仕組み
これが今回いちばん知りたかった現象です。互いの相関0.99の3変数(真の係数は全部 、合計12)、 で作りました。
| 変数 | 推定値 | SE | t値 | p値 | 判定 | VIF |
|---|---|---|---|---|---|---|
| 5.887 | 0.302 | 0.7636 | 非有意 | 54.9 | ||
| 6.326 | 1.814 | 0.0751 | 非有意 | 63.8 | ||
| 5.612 | 0.8120 | 非有意 | 50.3 | |||
| 合計 | 0.796 | 14.96 | 明確に有意 | — |
モデル全体は 、p値は 台、。 なのに個別は3本とも非有意です。
矛盾していません。2つは違う質問への答えです。
- F検定:「3変数まとめて説明力があるか」→ ある
- t検定:「 を固定して だけの固有の力があるか」→ ない
相関0.99なら、他の2本を固定した後に にはほぼ何も残りません(残差回帰の話)。そして合計を見れば 。 前節の「情報が消えたのではなく分解できないだけ」と完全に同じ現象で、この食い違いは多重共線性のサインとして読むのが正しい対応です。
ダミー変数と交互作用
ここは検定とは別の話題で、モデルの作り方にあたります。
ダミー変数の罠
3水準に3本のダミーを作ると計算できません。 3列の合計が常に1になり、切片の列と同一になるからです。 の行列式は数学的には厳密に0で(計算機では丸め誤差のため と表示されます)、逆行列が存在しません。だから1本落として基準にします。
| ジャンル | 計算 | PV水準 |
|---|---|---|
| 日記(基準) | 切片そのもの | 155.1 |
| ガジェット | 切片 + 226.0 | 381.1 |
| お金 | 切片 + 483.3 | 638.5 |
係数は「基準との差」であって絶対水準ではありません。 基準をお金に変えると切片は 638.48、ダミーは と になりますが、(0.947474)も RSS(144619.42)も予測値も完全に同一です。表現が変わるだけで中身は同じモデルです。
交互作用は層別と同一だった
層ごとに傾きを変えたいときは2つの変数を掛け算した列を足すだけです。ガジェットの記事ではダミーが1なので傾きが に、日記では のままになります。
そして発見がありました。すべての変数を交互作用させた重回帰は、層別に別々に回帰するのと数学的に同一です。
なお下の表の傾きは、記事の冒頭で出した層別の値( / / )とは別の量です。冒頭は「文字数だけ」で層別した傾き、下の表は「文字数・被リンク数・週末」を入れて層別した傾きなので、値が違います。
| 完全交互作用モデル | 層別に別々の回帰(被リンク数・週末も含む) | |
|---|---|---|
| 日記の傾き | ||
| ガジェットの傾き | ||
| お金の傾き | ||
| RSS | 132731.8685 | 132731.8685 |
層別と重回帰は対立する方法ではなく、交互作用の入れ方で連続的に繋がっています。 主効果のみ=傾き完全共通、一部だけ交互作用=部分的に共通、全部交互作用=完全に別々(=層別)。
部分F検定と、私が引いた偽陽性
交互作用の2項をまとめて検定します。入れ子になった2つのモデルの比較で、第12回の尤度比検定と同じ発想です。比べるのは「主効果のみ()」と「文字数×ジャンルの2項だけを追加したモデル()」です(上の完全交互作用モデルではありません)。
自由度 の上側5%点は 3.0773 なので、p値は 0.0494。かろうじて有意です。
ところがこのデータの真の構造に交互作用は入っていません。 つまり第一種の誤り(偽陽性)を引きました。
検定自体は正しく機能しています。同じ設定で4000回試すと p値が0.05を下回る割合は 0.0470(理論値0.05)でした。今回はたまたま5%の偶然を引いただけです。
という 0.05 のすぐ下の値は、そもそも弱い証拠です。 「有意だから真」ではないことを、自分のデータで踏んでしまいました。境界のp値が出たときは追加データで確認するか、ドメイン知識で判断すべきです。
「検定で無意味な変数を炙り出す」の限界
検定は変数選別の道具ですが、2種類の失敗をします。
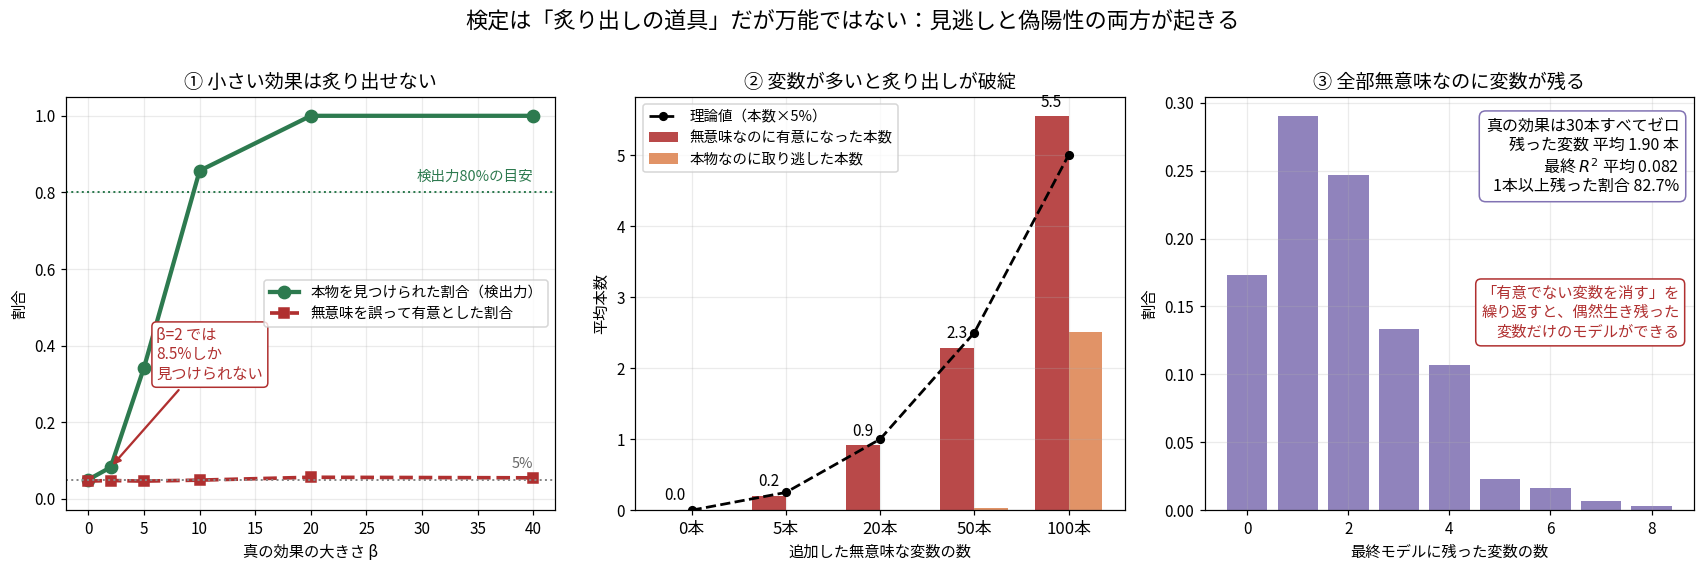
失敗1:見逃し。
| 真の効果 | 本物を有意と判定できた割合 | 無意味を誤って有意とした割合 |
|---|---|---|
| 0 | 0.050 | 0.046 |
| 2 | 0.082 | 0.048 |
| 5 | 0.343 | 0.046 |
| 10 | 0.857 | 0.049 |
| 20 | 1.000 | 0.056 |
偽陽性の率は常に約5%で一定(設計どおり)ですが、本物を見つけられる率は効果の大きさに強く依存します。 なら8%しか見つけられない。「有意でなかった」は「効果がない」を意味しません。
正直に書いておくと、この記事の通し例で が 7〜24 という景気のいい数字が出たのは私が効果の大きい設定でデータを作ったからです。現実のブログ解析では が 1〜3 の微妙な変数がずらりと並びます。
失敗2:偽陽性の積み上がり。 無意味な変数を100本入れると、平均 5.55本が「有意」として残り、さらに本物を2.50本取り逃します。
後者の理由は、追加した列が既存の変数と偶然相関してVIFが上がり、すべての係数のSEが膨らむからです。ここは私も最初「自由度が減って が大きくなるから」と考えて間違えました。 は不偏推定量なので、無意味な変数を何本足しても期待値は のままです。実測すると乱数を1本足したときの 、80本足しても (真の )でほぼ動きません。それでもSEは 4.62 から 8.42 へ1.8倍に膨らみます。 主因は ではなく の対角成分、つまりVIFでした。
ステップワイズ法が推奨されない理由
「有意でない変数を消して、また検定して、また消す」——ステップワイズ法(変数増減法)です。真の効果が全部ゼロのデータ(30本すべて無意味)でやってみました。正解は「1本も残らない」です。
| 結果(200回の平均) | 値 |
|---|---|
| 最終モデルに残った変数の数 | 1.90 本 |
| 最終モデルの | 0.082 |
| 1本以上「有意」が残った割合 | 82.7% |
全部が無意味なのに、82.7%の確率で「有意な変数のあるモデル」が出来上がります。
原因は同じデータを何度も検定していることです。偶然p値が小さかった変数だけが生き残るので、最後に残った変数のp値はもう本来の意味を持ちません。5%の偶然を何十回も引き直して、当たったものだけ採用しているからです。
準1級では手順を知っておく必要がありますが、この欠点も併せて理解すべきところです。
変数選択の他の方法
ステップワイズ以外にも方法はあります(詳細は後の回に譲りますが、地図として置いておきます)。
| 方法 | 考え方 |
|---|---|
| 情報量規準(AIC・BIC) | 検定を繰り返さず、モデル全体の当てはまりと複雑さのバランスを1つの数値で比較する |
| 交差検証(クロスバリデーション) | データを分割し、選ぶのに使わなかったデータで評価する。過適合を直接検出できる |
| リッジ回帰 | 係数を0に近づける罰則を加える。多重共線性に強く、 が壊れるのを防ぐ |
| Lasso | 罰則の形を変えて、係数をちょうど0にする。変数選択と推定を同時に行う |
| 全部の組み合わせを試す(総当たり) | 変数が少ないときのみ。説明変数が 本なら 通り |
ただしどの方法を使っても、ブロック1の3分類(交絡・媒介・合流点)の判断は代替できません。 交絡因子を統計的な基準で落としてしまえば、どんな高級な手法でも偏った答えを返します。変数選択の手法は「入れる候補が決まった後」の道具です。
実務(ブログのアクセス解析)でどう使うか
学んだことを自分のブログ運営に落とすとこうなります。
変数はGA4を見る前に決める。 「ジャンル」「文字数」「公開からの経過日数」のように、PVに効く理屈が言えるものを先に列挙します。データを見て有意なものを拾うと、この記事で見たとおり偶然を拾います。
予測が目的か解釈が目的かを先に決める。 「来月のPVを見積もりたい」なら多重共線性は無視してよく、 を見て精度を判断します。「記事を長くすべきか」なら解釈が目的なので、交絡因子を全部入れてVIFの警告を受け入れます。
が小さいことを自覚する。 私のブログは記事数が2桁なので、変数を5本も入れれば自由度がすぐ尽きます。目安は の1/10。この記事の でも12本が上限です。
係数の大きさを見る。 有意かどうかより「実務的に意味のある大きさか」。PVが0.5増える効果は、有意でも使えません。
A/Bテストができるなら回帰より優先する。 第13回でも書きましたが、介入の効果を知りたいなら実験が正攻法です。重回帰で交絡を除くのは、実験できないときの代替手段にすぎません。
つまずいたところ
2つの3次元の図を同じものだと思っていた。 これが最大の混乱でした。「軸が変数の絵(回帰平面)」と「軸がデータ1件ごとの絵(列空間)」はまったく別で、どちらにも出てくる「平面」の意味も無関係です。絵Bは無くても重回帰は理解できると気づいてから整理できました。
「平面 = 」だと思っていた。 平面を決めるのは だけで、 は平面上のどこに立つかを指す座標です。平面は を動かす前から決まっています。
単位ベクトルだと思っていた。 図の と は長さ1ではありません。ただし「あの2本自体に意味はない」という直感は正しく、同じ平面を張る別の2本でも結果は同じです。
「 が消える」と思った。 は平均の定義なので、 は消えたのではなく という記号の中に入っているだけでした。逆向きに読めば で戻ってきます。
中心化が別の手法だと思った。 導出の途中で を代入した操作が、実質的に中心化そのものでした。新しい道具ではなく、既にやっていたことに名前が付いただけです。
媒介変数を「間違った因果」だと誤解した。 逆でした。媒介変数は本物の因果で、事故は「無い効果を有ると誤認した」ではなく「ある効果を通り道を塞いで消した」です。
合流点を「因果が逆」だと思った。 逆因果は別の罠です。合流点はXとYの両方から矢が刺さり込む先で、条件付けると無かった相関が生まれます(p値 0.695 が 未満に化けた)。
VIFを「その変数の情報量」だと思った。 VIFは他の説明変数との重複度で、関係性の指標です。同じ変数でも一緒に入れる変数の顔ぶれでVIFは変わります(1.0046 → 6.3256)。
「VIFが高いから消す」が正しいと思った。 消すとSEは改善するのに係数が符号ごと反転しました。「精度が良い」と「正しい」は別物で、VIFは前者しか見ていません。
相関に直すのは計算が楽になるからだと思った。 逆で、計算量は増えます。理由は単位を消して大小を判断できるようにすることでした( の単位を変えると共分散は8.83から8833.33に化けるが、相関は0.9810のまま)。
「有意でない変数を消す」を良い手順だと思っていた。 全部無意味なデータで82.7%の確率で「有意な変数」が生き残ります。同じデータで検定を繰り返すとp値が意味を失うからです。
自分の記事で偽陽性を引いた。 部分F検定で が出て「交互作用は必要」と判定しましたが、真の構造には交互作用がありません。0.05のすぐ下は弱い証拠だという教訓を、身をもって得ました。
この記事の要点
- 最小二乗法は射影。 は「残差が説明変数と直交する」条件を について解いた結果。行列は連立方程式の書き方でしかない
- 直交するから が成立し、 が「割合」として読める(、実データの差 )
- が自由度の正体。 これが の分母と調整済み の両方に効く
- 「共分散÷分散」は射影に を掛けただけ(小数10桁一致)。中心化は切片を分離する座標移動で、傾きとRSSは不変
- 中心化した = 共分散行列 × 。 係数は「共分散行列の逆行列 × との共分散」
- 層を無視すると符号が反転する( 対 )。だがとりあえず全部入れるのは誤り——合流点を入れると効果ゼロが に化ける
- 矢の向き(交絡・媒介・合流点)はデータから判別できない。 ドメイン知識だけが決められる
- は から1行。4000回の実測sd 4.6353 対 公式SE 4.6920
- で割らないと を5%過小評価(1166.0 対 真値1225)
- (全係数で 以下の誤差)。 の法則は両対数の傾き で確認
- は必ず上がる(前のモデルが選択肢に含まれるから)。乱数113本で 0.9977、しかし は 35.6→79.5
- 乱数だけでも ( がiidなら厳密)。 の高さは何の証拠にもならない
- 調整済み が上がる境界は ちょうど(600回で反例0件)。有意の境界1.98とズレているので甘い
- 偏回帰係数=残差同士の単回帰の傾き(フリッシュ=ウォー=ローヴェル、小数10桁一致)。「固定」=「他で説明できる分を捨てる」
- 捨てた量がVIF。 文字数の独自情報は15.8%、SEが2.52倍
- 多重共線性は「分解できない」問題。 相関0.999で個々のsdは5.17でも合計のsdは0.214
- VIFが高いから消すと符号が反転する(RMSE 4.68 対 105.11)。消してよいのは同じ情報の重複だけ
- F検定は門番、t検定は内訳。 相関0.99の3変数で なのに個別tは全部非有意、合計は
- 単回帰では (118.140656 で一致)
- 全変数を交互作用させた重回帰 = 層別(傾きもRSSも完全一致)
- 検定は変数選別の道具だが、変数が多いと破綻する。 無意味100本で5.55本が偽陽性+本物2.50本を取り逃す
- ステップワイズは全部無意味でも82.7%で「有意な変数」を残す
次回は第17章の回帰診断法です。この記事では「モデルを作って係数を解釈する」ところまでやりましたが、そのモデルの前提が成り立っているかをまだ確認していません。誤差が等分散なのか、外れ値が1点で結果をひっくり返していないか、残差に構造が残っていないか。 の対角成分が「てこ比」として再登場します。