同じ400社でも分散が86分の1になる:標本調査法と層別抽出【第21回】
はじめに
第21章は標本調査法です。線形モデル編の最後にあたります。
前回(第20回・分散分析と実験計画法)で「データを取る前に設計する」という考え方が出てきました。今回はその続きですが、対象が変わります。実験計画法は自分で条件を割り付けられる場合の話でした。今回はすでにある母集団から抜き出す場合、つまり調査の設計です。
前回の局所管理(ブロック化)が、今回は層別抽出として再登場します。邪魔なばらつきをあらかじめグループに分けて封じ込める、という発想がそのまま効きます。
そして今回いちばんの収穫がこれでした。
同じ400社に聞いても、どの層に何社割り振るかを変えるだけで推定の分散が86分の1になる。
を増やしていません。聞く数は400社のままで、層への配り方を変えただけです(単純無作為との比較で分散が 0.0116 倍、誤差幅でいえば9分の1)。第8回で「 を4倍にしても誤差は半分にしかならない」という の壁を見ましたが、設計を変えれば を触らずにその壁を越えられる。これは知らなかったので驚きました。
なお以下では分散と誤差幅(標準誤差)を行き来します。分散が 倍なら誤差幅は 倍なので、倍率の大きさが場所によって違って見えるのはそのためです。
ただし後半で反対の話が出てきます。設計でどうにもならない誤差です。無回答バイアスは を100万にしても消えず、むしろ信頼区間が縮む分だけ確実に真値から外れていきます。「 を増やすより設計を変えろ、ただし設計にも限界がある」というのが今回の結論です。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 記号で迷ったら 統計の記号がややこしいのは軸が2本あるからだった を先に読んでください。
- 今回の前提になる標準誤差の話は 第8回 で扱っています。
この記事で使う言葉
先に5つだけ。この記事はこの5語で回ります。
標本調査法(survey sampling):母集団から標本を抜き出す「抜き出し方」を設計する分野。推定や検定の手法ではなく、その手前でデータの取り方を決める技術です。
層(stratum, 複数形 strata):母集団を分けた集団のうち、すべてから標本を取るもの。男女、年代、企業規模など。
クラスター(cluster, 集落):母集団を分けた集団のうち、選ばれたものだけから標本を取るもの。市区町村、学校、世帯など。
設計効果(deff, design effect):単純無作為抽出に比べて推定の分散が何倍になるかという倍率。 なら分散が2倍、つまり同じ精度を出すのに2倍の人数が必要という意味です。
有効標本サイズ(effective sample size):。「実際は400人に聞いたが、情報量としては83人分」というときの83にあたる数字。
TL;DR
- 層別抽出とクラスター抽出は抽出の向きが逆。 層別は全部の集団から少しずつ、クラスターは一部の集団を丸ごと。理想の集団の姿も正反対(層別は中が均質、クラスターは中が縮図)
- 層別(比例配分)で消えるのは層間分散だけ。 全体分散の97.9%が層間なら分散比 0.0208(48分の1)、0.0%なら 1.0000(効果ゼロ)
- ネイマン配分は 。 大きさ×ばらつきに比例させる。母集団の2%の層に標本の46.7%を振ると、分散が比例配分のさらに20分の1
- ネイマン配分の正体は「1社追加で減る分散を揃える」操作。 比例配分だと 0.0024/0.0873/14.7162 とバラバラ、ネイマン配分だと 0.02995/0.03009/0.03014 で揃う
- クラスター抽出はほぼ必ず精度が落ちる。 。1集落20人・ICC=0.1 で 400人調査が138人分に
- それでも使う理由はコスト。 予算50万円だと では移動費に食われて90人しか調べられない。 なら有効263人分で約3倍得
- 母集団サイズ が効かないのは「 を固定したとき」の話。 有限母集団修正は抽出率 の関数で、 で効き始める
- 比推定は原点を通る直線を仮定した回帰推定。 切片がある関係に使うと標本平均の7.5倍に悪化する。迷ったら回帰推定(最悪でも1.006)
- 系統抽出は間隔が周期の倍数だと壊れる。 曜日効果のあるデータで にすると開始点次第で推定値が 100.2 と 178.7
- 無回答バイアスは を増やしても消えない。 でも でも偏りは +10.7pt のまま。ウェイト調整で消えるが、それは検証できない仮定に乗っている
- 私が詰まったのは「分散」という語が2つの別物を指していたこと。 データのばらつき と推定値のばらつき は別物
つまずいたところ:「分散」が2つある
本題に入る前に、自分が最初に混乱した点を書いておきます。この章の議論はほぼ全部「分散」の話ですが、その言葉が2つの別物を指していました。
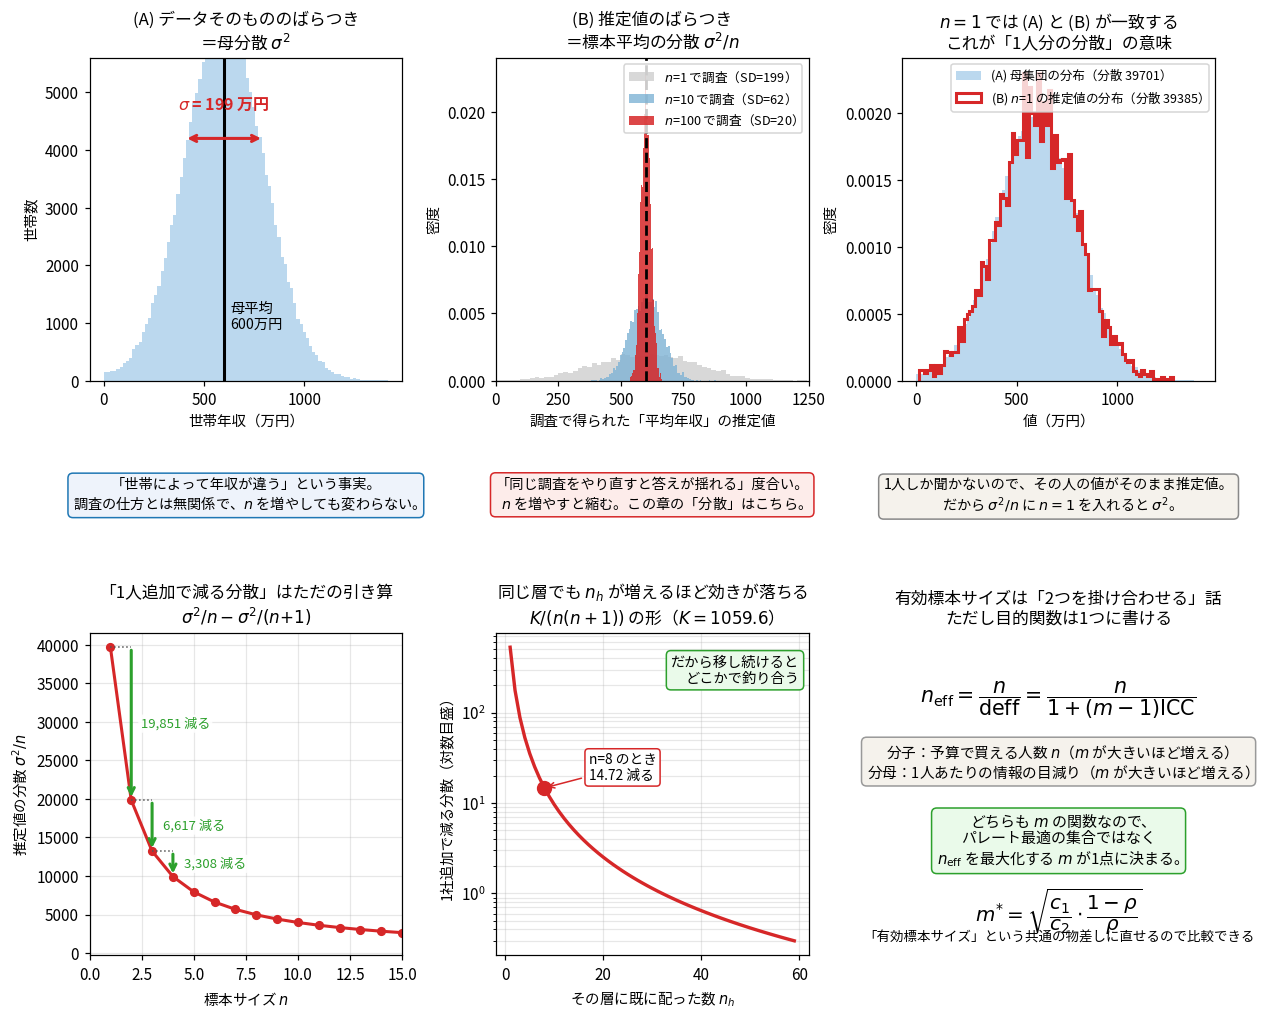
(A) データそのもののばらつき:世帯年収なら「ある人は400万、ある人は800万」という散らばり。母分散 で、標準偏差にすると199万円でした。これは母集団の性質なので、 を10人にしても1000人にしても変わりません。
(B) 推定値のばらつき:「日本の平均年収を推定する」という調査をまるごとやり直すと、1回目は610万、2回目は585万と毎回違う答えが出ます。この揺れ具合が で、実測すると で199万円、 で62万円、 で20万円と縮みました。
この章に出てくる「分散」は、ほぼ全部 (B) です。見分け方は単純で、 で割られていたら (B) です。
そして図の右上が面白いところで、 のとき (A) と (B) は一致します(実測 39701 と 39385)。1人しか聞かないならその人の値がそのまま推定値になるので、当然そうなります。「1人分の分散」という言い方は母分散そのものを指しているわけです。
もうひとつ先に潰しておきます。この章の計算に母平均 は要りません。 標本分散は
と、引いているのが (標本平均)なので、 はどこにも出てきません。上の年収の母集団から を1回だけ抜いてみると、 から標準誤差 が出ます(真の標準誤差は 39.9 なのでやや過大ですが同じ桁)。第10回でやった不偏性のおかげで、 でも は を平均的に当てました(比 1.0010)。
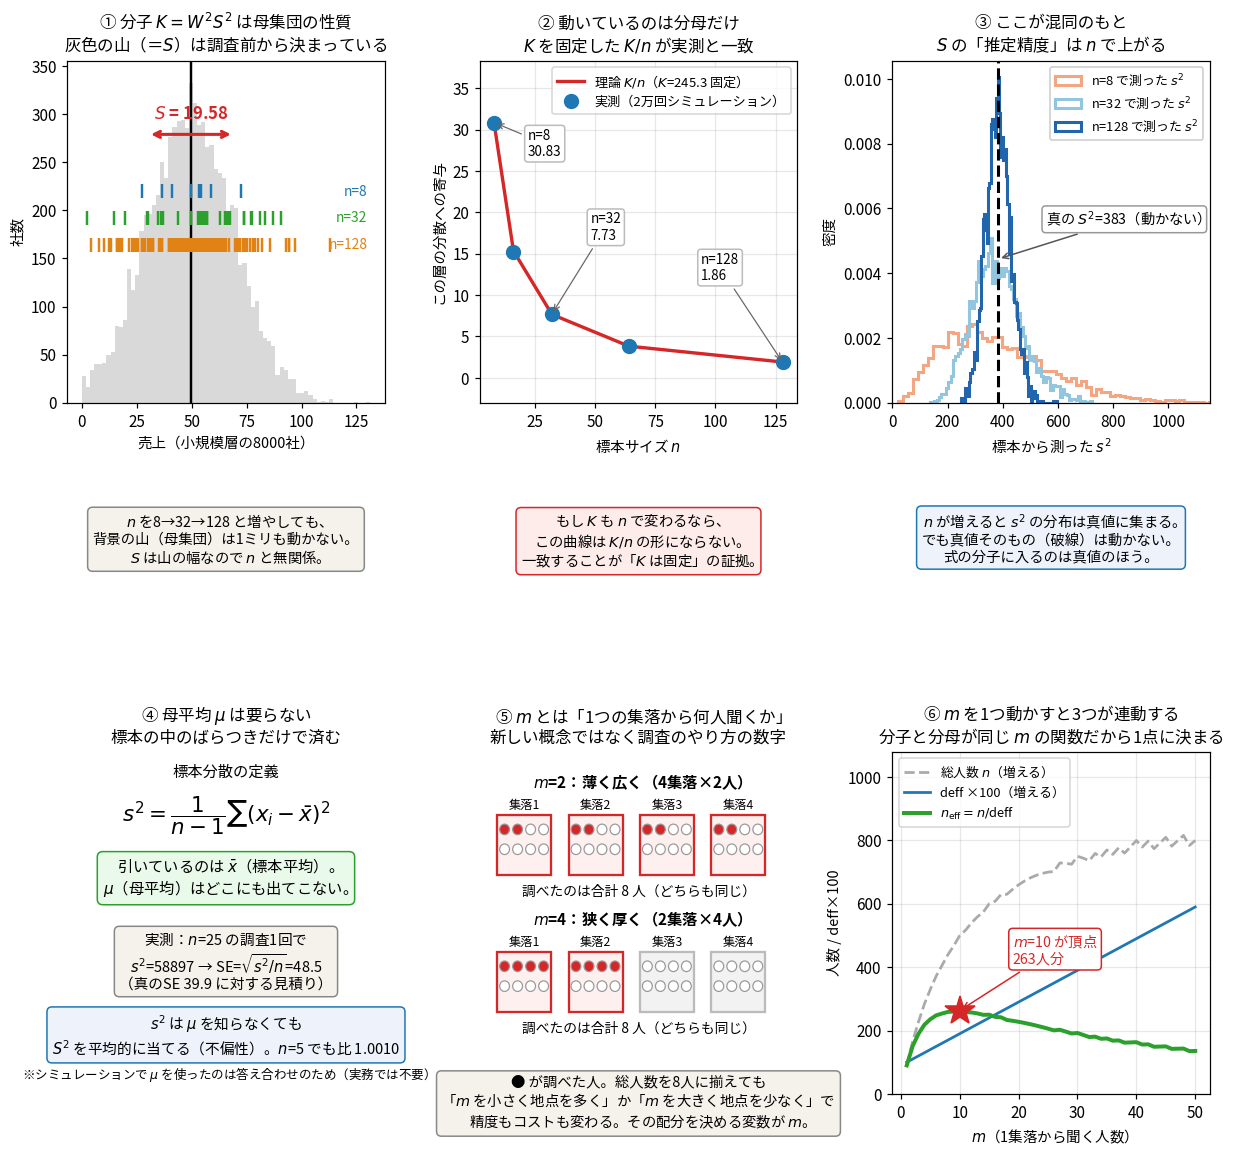
図の左上と中央上が、後で出てくる計算の前提になります(例として小規模層を使っています)。分散の式の分子に入る は母集団の性質なので、調査で を8→32→128 と増やしても背景の山は動きません。だから を固定した が実測に一致します。右上が混同しやすい点で、 の推定精度は で上がりますが、真の は動きません。式の分子に入るのは真値のほうです。
中央下のパネルが の定義で、これは後のクラスター抽出で使います。 は「1つの集落から何人聞くか」という調査計画の数字です。
母集団のサイズは効くのか効かないのか
第8回で「誤差の式に母集団の人数 が出てこない」と書きました。1万人の町でも1億人の国でも、2000人聞けば同じ ±2.19pt という話です。ところが標本調査法には有限母集団修正という係数が出てきます。矛盾していないのか、というのが最初の疑問でした。
先に押さえておくと、この修正が付く理由は「母集団が有限だから」ではなく同じ人を2度選ばない(非復元抽出)からです。1人抜くたびに残りの母集団が減るので、標本が母集団の情報を食い尽くす分だけ推定が安定します。極端に (全数調査)なら係数は0で誤差もゼロ。逆に復元抽出(同じ人を2回選ぶことを許す)なら は一切効かず、 のままです。
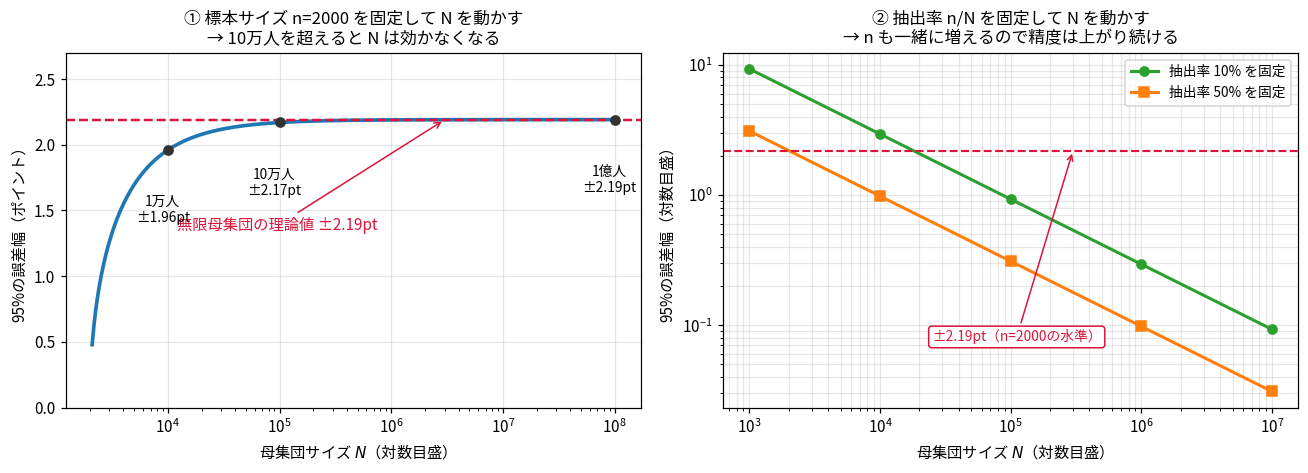
矛盾していませんでした。第8回の主張は「 を固定したまま を動かすと はほとんど効かない」という限定つきの話です。実測(、)だとこうなります。
| 母集団 | 修正係数 | 95%の誤差幅 |
|---|---|---|
| 2500人 | 0.4473 | ±0.98pt |
| 1万人 | 0.8945 | ±1.96pt |
| 10万人 | 0.9900 | ±2.17pt |
| 1億人 | 1.0000 | ±2.19pt |
修正係数は常に1以下なので、有限母集団は精度を良くする方向にしか働きません。そして10万人を超えるとほぼ1に飽和します。
見落としやすいのは、この係数が そのものではなく、ほぼ抽出率 だけで決まることです(厳密には で、 が数百以上なら と読んで差し支えありません)。効くかどうかは「母集団の何割を見たか」で決まります。1億人から2000人は なので効かず、2500人から2000人は なので劇的に効く。実務の目安としては、 が5%を超えたら入れる価値があります。
図の右パネルが対になる話です。抽出率を固定して を動かすと も一緒に増えるので、精度は上がり続けます。同じ「 を動かす」でも、 を固定するか を固定するかで結論が正反対になる。ここが混乱の元でした。
層別とクラスターは何が逆なのか
名前が似ているのに真逆、というのがこの章で最初に整理すべき点でした。1枚の図にしました。
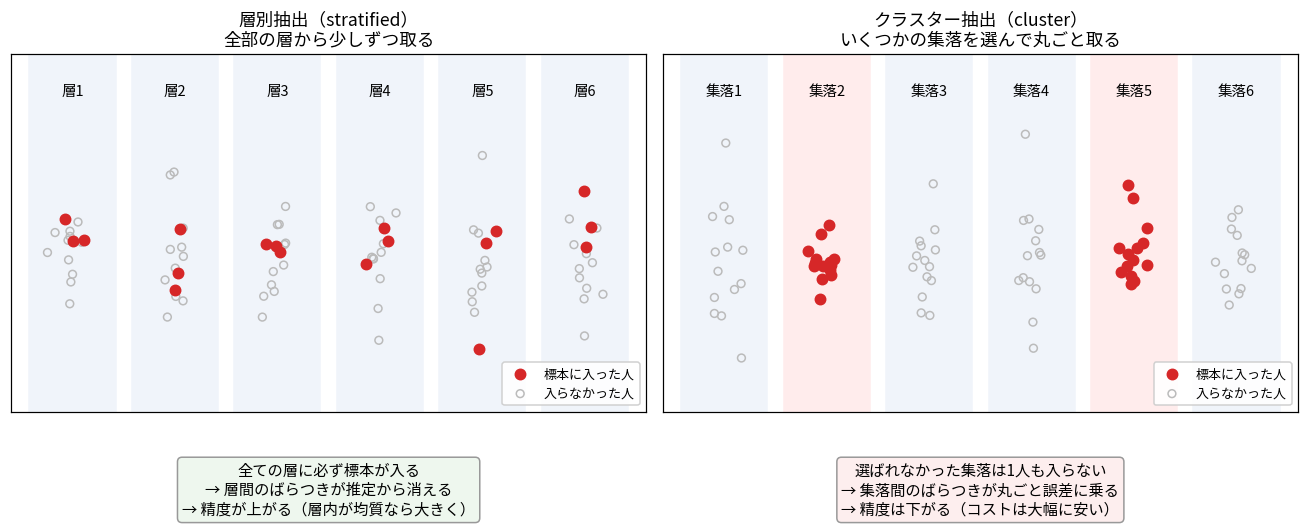
核心は抽出する向きです。層別はすべての集団から少しずつ取り、クラスターはいくつかの集団を選んで中を全員取ります。
| 層別抽出(stratified) | クラスター抽出(cluster) | |
|---|---|---|
| 集団の作り方 | 集団内が似るように分ける | 集団内が母集団の縮図なのが理想 |
| 抽出の対象 | 集団の中の人 | 集団そのもの |
| 標本に入る集団 | 全部 | 選ばれたものだけ |
| 精度 | 単純無作為より上がる | 単純無作為より下がる(ICC>0 なら) |
| 効く条件 | 集団間の差が大きい | 集団間の差が小さい |
| 採用理由 | 精度を上げたい | コスト・名簿の制約 |
| 必要な事前情報 | 全員の層が分かる名簿 | 集落の一覧だけでよい |
| 設計効果 deff | 1以下(比例配分なら) | 1より大きい(ICC>0 なら) |
覚え方としては、理想の集団の姿が正反対だと押さえるのが早いです。層別は「男性の層・女性の層」のように中が均質なのが良い。クラスターは「どの集落を選んでも全国の縮図」なのが良い。だから層別は集団間の差を味方にし、クラスターは集団間の差にやられます。
層別抽出はなぜ精度が上がるのか
全体の分散が2つに分解できます。
(ここでは分散を 、各層は で割った定義にしています。 除で定義すると のずれが出ますが、この記事の議論には影響しません。)
層別抽出を比例配分(層の大きさどおりに配る)でやると、層間の項が推定の分散から消えます。すべての層に母構成どおり標本が入るので「たまたま高所得層ばかり引いた」という事故が起きなくなるからです。残るのは層内分散だけ。
この「層間が消える」は層別の効果の下限にあたる話です。あとで出てくるネイマン配分は層内分散のほうまで圧縮するので、これよりさらに小さくなります。
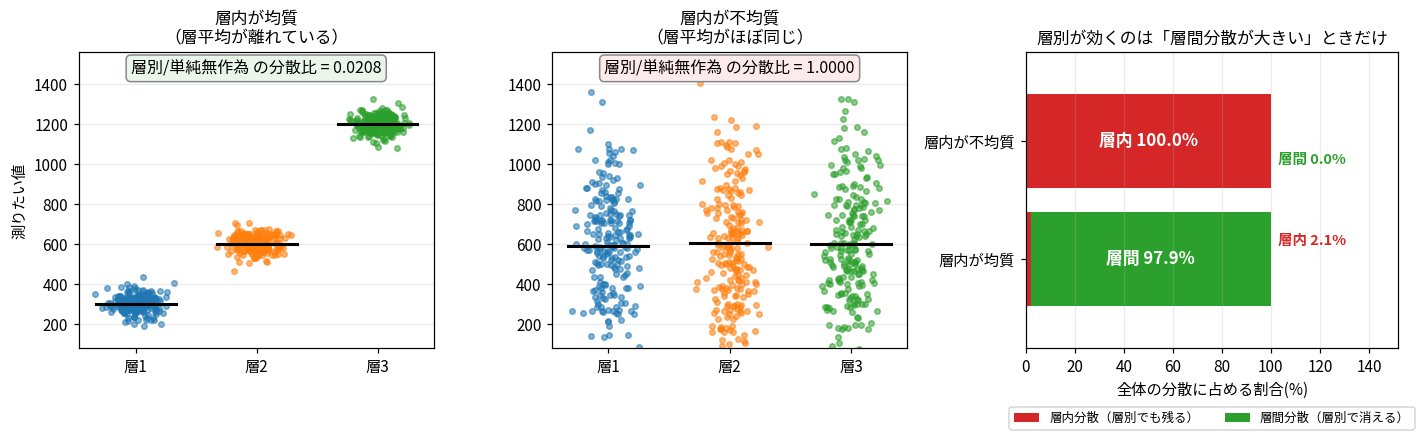
実測で確かめました(いずれも比例配分、 の別のデータです)。層平均が300/600/1200で層内の標準偏差が40のケースでは、全体分散の97.9%が層間なので、層別後の分散は単純無作為の 0.0208倍(約48分の1)になりました。一方、層平均がほぼ同じ(層間0.0%)のケースでは分散比が 1.0000 で効果ゼロです。比例配分では「層内分散の割合」がそのまま分散比になる、という関係が見えます。
「層内が均質なら効く」と「層間が大きいなら効く」は同じことを裏表から言っています(全体の分散は決まっているので、層内が小さければ層間が大きい)。どちらで覚えても構いません。
実務的に大事なのは、比例配分の層別なら損しないという点です。うまく分けられれば大きく得をし、外しても単純無作為と同じ(分散比1.0)で止まります。ただしこの保証は比例配分に付くもので、配り方を大きく誤ると単純無作為より悪くなることもあります(極端に、大規模層に1社だけ配れば で単純無作為の 562.0 を超えます)。迷ったら「層別+比例配分」が安全な既定値です。
ネイマン配分:どこに標本を配るか
層に分けたら、次は400社をどう割り振るかです。素直な案は比例配分で、層の大きさに合わせます。事業所調査の例で見ます。
| 層 | 社数 | 割合 | 層内の標準偏差 | 比例配分 |
|---|---|---|---|---|
| 小規模 | 8000 | 0.80 | 19.58 | 320社 |
| 中規模 | 1800 | 0.18 | 119.0 | 72社 |
| 大規模 | 200 | 0.02 | 1627.5 | 8社 |
母集団の縮図になるので公平に見えます。ところが分散の内訳を見ると問題が分かります。
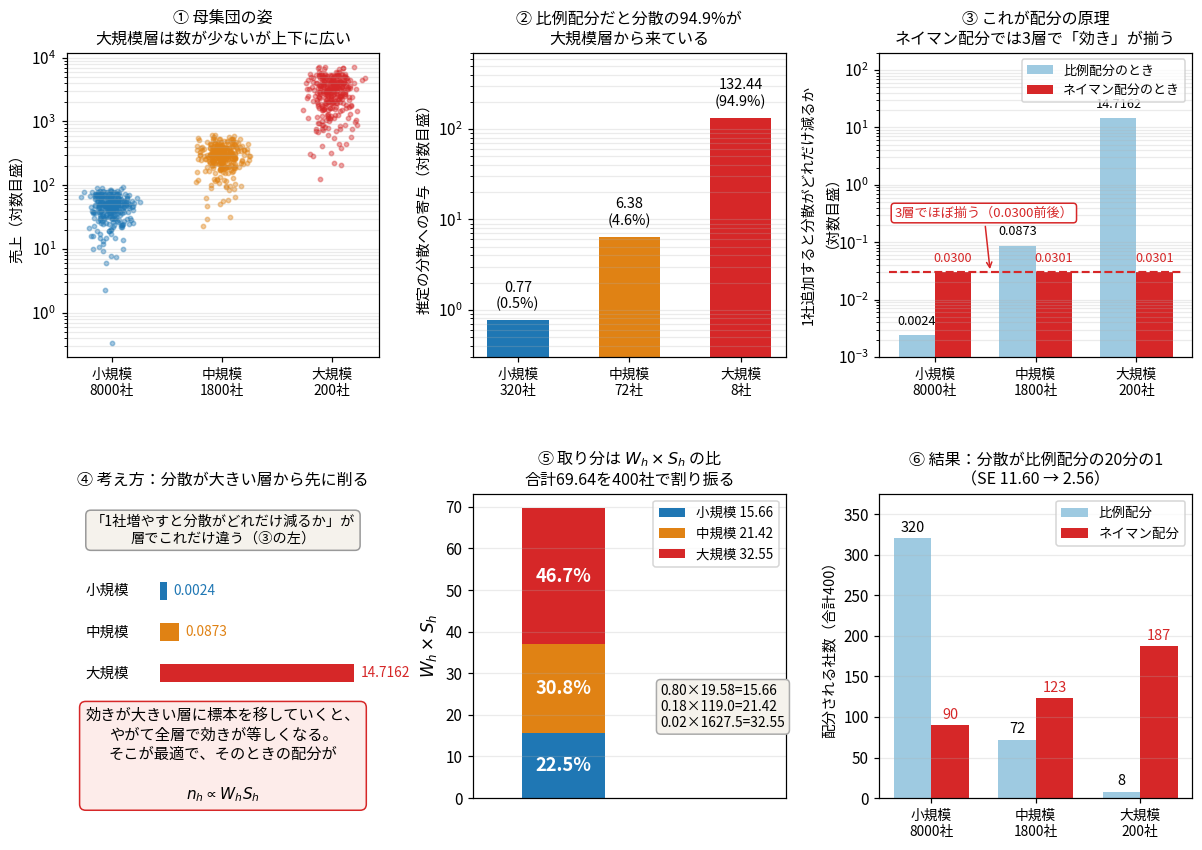
層別抽出での推定の分散は、層ごとの寄与の足し算です。
最後の因子は層ごとの有限母集団修正です(各層で非復元抽出しているため)。以下の数値はこの修正を入れて計算しています。抽出率が小さいうちは修正なしでも足りますが、今回は大規模層で200社中187社も抜くので効きます。
比例配分での実測値がこうなりました(有限母集団修正を除いた の内訳)。
| 層 | 配分 | 分散への寄与 | 割合 |
|---|---|---|---|
| 小規模 | 320社 | 0.767 | 0.5% |
| 中規模 | 72社 | 6.375 | 4.6% |
| 大規模 | 8社 | 132.445 | 94.9% |
分散のほぼ全部が大規模層から来ています。320社も投入した小規模層は0.5%しか貢献していない。比例配分は、すでに十分測れている層に標本を注ぎ込み、荒れている層を放置している状態でした。
配分の原理は「限界的な効きを揃える」
ではどう直すか。考え方は単純で、1社追加したときに分散がどれだけ減るかを層ごとに比べて、いちばん減る層に追加する。
各層の寄与は の形()なので、1社追加したときの減り分はただの引き算です。大規模層で手計算してみます。
(以下の表では の端数まで使った 1059.6・14.7162 を載せています。)
一般式にすると です。3層で計算すると、
| 層 | 配分 | 1社追加で減る量 | |
|---|---|---|---|
| 小規模 | 245.3 | 320社 | 0.0024 |
| 中規模 | 459.0 | 72社 | 0.0873 |
| 大規模 | 1059.6 | 8社 | 14.7162 |
大規模層に1社足すと、小規模層に足すより6000倍以上効きます。だったら小規模層から取り上げて大規模層に回したほうがいい。
移し続けるとどうなるか。大規模層の が増えるとそこの効きは落ちていき(分母の が大きくなる)、小規模層の効きは上がっていく。やがて全層で効きが等しくなり、動かす理由がなくなります。ネイマン配分の 90/123/187 で計算し直すと、
| 層 | 1社追加で減る量 |
|---|---|
| 小規模 | 0.02995 |
| 中規模 | 0.03009 |
| 大規模 | 0.03014 |
3層でほぼ揃いました。これがネイマン配分の正体です。経済学の限界効用の均等化とまったく同じ構造で、式を暗記する話ではありませんでした。
わずかに残る差(0.02995 と 0.03014)はシミュレーション誤差ではありません。配分を連続版の式 で決めたのに対し、ここでは1社刻みの で測っているためのずれです。
そして式が出てくる
効きが揃う条件を解くと が出ます。
| 層 | 割合 | 配分 | |
|---|---|---|---|
| 小規模 | 0.80 × 19.58 = 15.66 | 22.5% | 90社 |
| 中規模 | 0.18 × 119.0 = 21.42 | 30.8% | 123社 |
| 大規模 | 0.02 × 1627.5 = 32.55 | 46.7% | 187社 |
母集団の2%しかない大規模層が、標本の46.7%を取ります。数が少なくてもばらつきが83倍あるので取り分が大きくなる。 が「その層が全体にどれだけ影響するか」、 が「その層がどれだけ荒れているか」で、両方を掛けたものが優先度になっています。
結果は分散が比例配分の20分の1(標準誤差 11.60 → 2.56)でした。単純無作為と比べると 0.0116 倍、つまり86分の1です。前に見た「層間が消える」だけでは 0.24倍(比例配分)までしか説明できないので、残りはネイマン配分が層内分散を圧縮した分になります。
ここで注意が要ります。大規模層は200社しかないのに187社を取る(抽出率93.5%)ことになりました。ネイマン配分は という解を平然と返すので、実務では「ばらつきの大きい層は全数調査にして、残りを他の層に再配分する」という処理をします(take-all層)。事業所統計で大企業が悉皆調査になっているのはこの理屈です。この例は187社 ≤ 200社なので配分自体は成立します(大規模層を200社の全数にして残り200社を再配分しても分散は 6.59 でほぼ同じでした)。以下は 90/123/187 のまま進めます。
なお、有限母集団修正を入れてもネイマン配分の式は変わりません。修正を展開すると となり、引く側が を含まない定数なので、 で微分すると消えるためです。同じ理由で「1社追加で減る量」も修正の有無で変わりません。式に が付くのは層ごとに調査コスト が違う場合で、そのときは になります。
小さい層を多く取ると偏るのではと思いたくなりますが、偏りは出ません。推定量は と母構成 で重み付けして戻しているからです。この構造は後の無回答のウェイト調整と同じです。
を知らないと使えないのか
弱点は を事前に知らないといけないことです。ただし見積りはかなりラフでも構いませんでした。3層の を「3倍・1倍・0.4倍」に間違えた配分で計算すると、
| 配分 | 分散 | 最適に対する悪化 |
|---|---|---|
| 正確な | 6.54 | 1.00倍 |
| ずれた | 16.46 | 2.52倍 |
| 比例配分 | 134.65 | 20.58倍 |
を大きく外しても、比例配分よりはるかに良い(2.52倍の悪化 対 20.58倍で、比例配分のほうが8.2倍悪い)。前回調査や予備調査からの当て推量で十分価値がある、ということになります。
クラスター抽出と設計効果
ここから精度を捨てる側の話です。まず ICC(intraclass correlation coefficient=クラスター内相関係数)を押さえます。意味は文字どおり「同じ集落の2人がどれくらい似ているか」です。
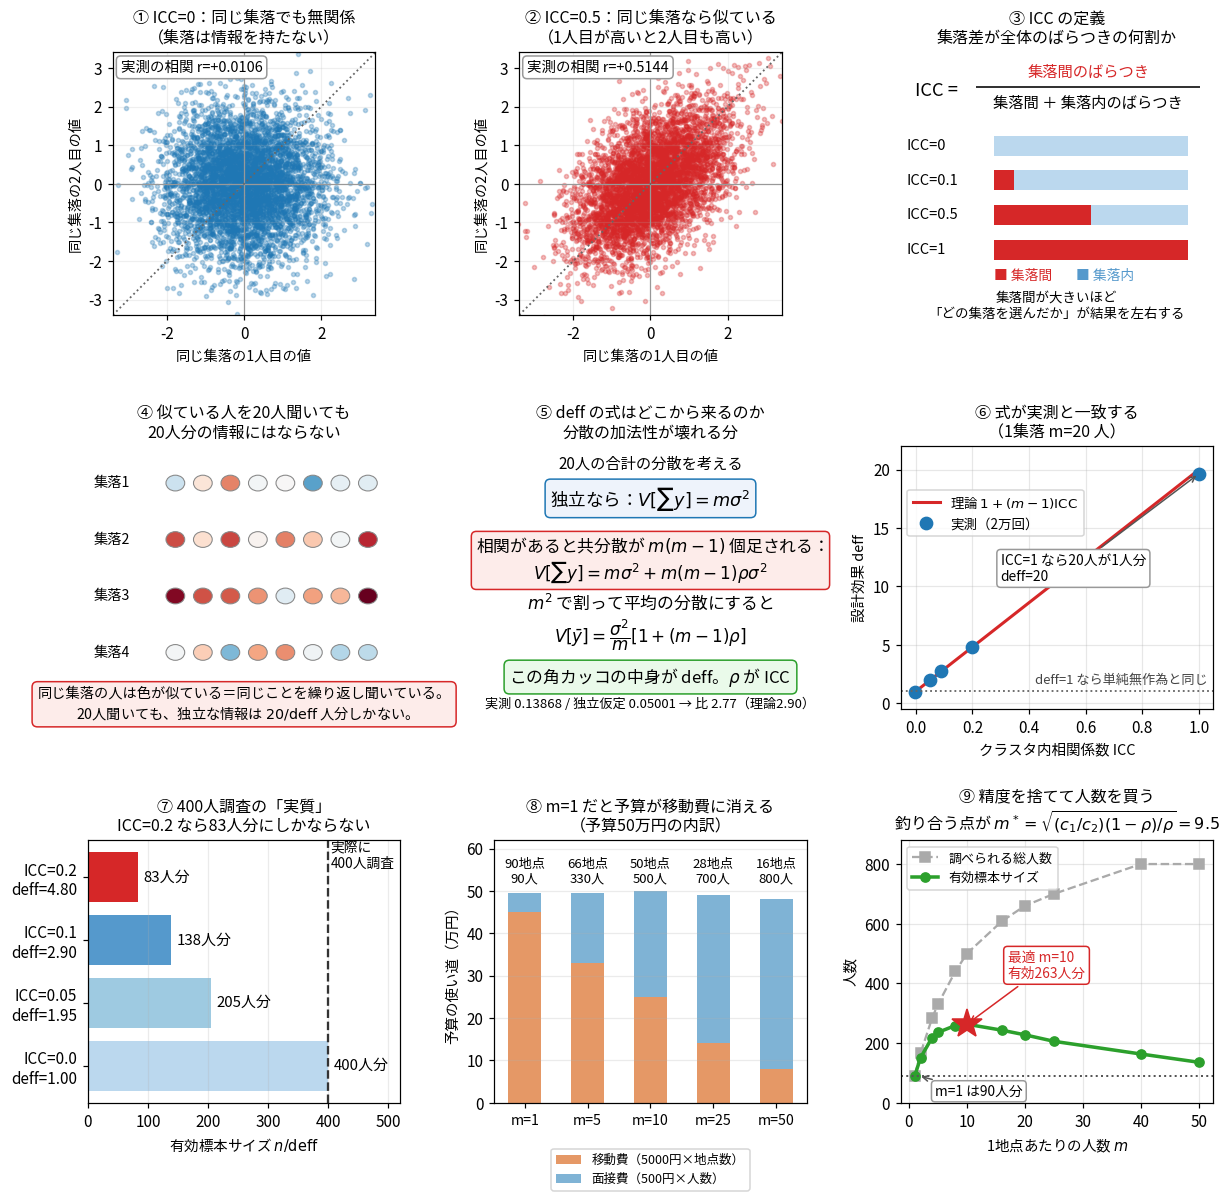
図の左上と中央上が定義そのものです。同じ集落から2人選んで、1人目の値を横軸・2人目の値を縦軸に取った散布図。ICC=0 なら丸い雲(実測 )、ICC=0.5 なら右上がり(実測 )になります。ICC は同じ集落の人どうしの相関係数そのものでした。
定義式は分散の分解で書けます。
現実の値の感覚としては、同じ町内の世帯年収で 0.05〜0.2、同じ学校の生徒の学力で 0.1〜0.3、同じ世帯の政治的意見で 0.5 以上、くらいです。
ひとつ補足すると、この分散の書き方だと ICC は必ず0以上になりますが、「同じ集落の2人の相関」として測ると負にもなりえます(下限は )。世帯内で1人が代表して答えるなど、集落の中で打ち消し合う構造があるとそうなり、そのときは deff が1未満でクラスター抽出のほうが得になります。地理的な集落ではまず起きないので、以下は正の値として話を進めます。以降 ICC を とも書きます。
なぜ精度が落ちるのか
似ている20人に聞くのは、同じことを20回聞いているのに近い。
極端な例で確かめました。集落の中が完全に同一(ICC=1)だとすると、20人の平均の分散は 0.9330、1人だけ聞いた場合の分散も 0.9330。まったく同じです。残りの19人は完全な重複で、聞くだけ無駄でした。
この「調べた人数」と「実質の情報量」のずれの倍率が設計効果です。式は暗記するものではなく、分散の加法性が壊れる分として出てきます。第3回でやった通り独立なら分散は足し算できますが、
人から2人選ぶ順序つきのペアは 個あるので、共分散の項が380個も足されます。式に実測値を入れると で、共分散の項のほうが大きい。1個あたりの相関が0.1でもペアの数で効くわけです。
で割って平均の分散にすると、
は第3回でおなじみの「独立なときの分散」で、角カッコの中身が余分な膨らみ=deff です。シミュレーションで集落平均の分散を直接測ると 0.13868 で、独立と仮定した の 2.77倍。理論値 2.90 との差はシミュレーション誤差です。
(1集落から1人だけ)なら deff = 1 で膨らみません。1人しか取らなければ集落内の重複が起きないからです。
この式が成り立つ前提は3つあります。(1) どの集落も同じ人数 、(2) 集落内のどの2人の相関も同じ 、(3) 集落は互いに独立に選ぶ。現実には集落の大きさがばらつくので、実際の deff はこの式よりさらに大きくなります(ウェイトのばらつきが上乗せされる)。 は楽観側の見積りだと思っておくのが安全です。
実務的な意味
deff で割ったものを有効標本サイズと呼びます。
| ICC | deff | 400人調査の実質 |
|---|---|---|
| 0 | 1.00 | 400人分 |
| 0.05 | 1.95 | 205人分 |
| 0.10 | 2.90 | 138人分 |
| 0.20 | 4.80 | 83人分 |
400人に聞いたのに83人分。標準誤差を と書いたら誤差を半分以下に過小評価することになります。なおこの有効標本サイズは等サイズ集落の前提での値なので、実際はこれより少なく出ます。ここが実務でいちばん事故が起きるポイントだと思います。
なぜあえてクラスター抽出を使うのか
ここまで読むとクラスター抽出は使うべきでないように見えますが、コストを入れると逆転します。
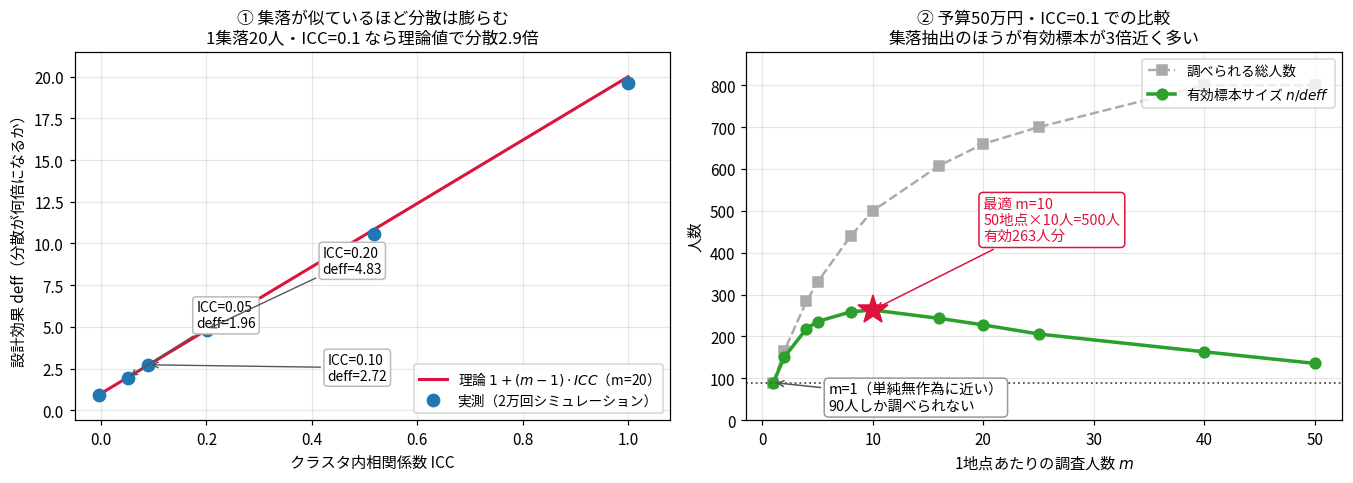
地点あたり移動費5000円、1人あたり面接費500円、予算50万円という設定で計算しました。
| 地点数 | 総人数 | 移動費 | deff | 有効標本 | |
|---|---|---|---|---|---|
| 1 | 90 | 90人 | 45万円 | 1.00 | 90人分 |
| 5 | 66 | 330人 | 33万円 | 1.40 | 236人分 |
| 10 | 50 | 500人 | 25万円 | 1.90 | 263人分 |
| 25 | 28 | 700人 | 14万円 | 3.40 | 206人分 |
| 50 | 16 | 800人 | 8万円 | 5.90 | 136人分 |
(各地点で1人だけ=単純無作為に近い)だと、予算の9割が移動費に消えて90人しか調べられません。1人に会うために毎回5500円かかるからです。 なら移動費を50地点で薄められるので500人調べられ、deff で割っても263人分残る。同じ予算での精度は約3倍勝ちます。
1人あたりの精度では負けるが、1円あたりの精度では勝つ。精度を捨てて人数を買っているわけです。
を上げすぎると deff が効いて落ちるので山型になります。頂点には式があって、
実測の最適 と合いました。式の意味も読めて、移動費が高いほど1地点に多く集め、ICC が高いほど地点を散らすということです。ただし集落サイズがばらつくと deff は式より大きくなるので、真の最適 はこれより小さめに寄ります。
なお、ここで注意したのは「これはパレート最適の集合を探す問題ではない」という点です。分子(総人数)と分母(deff)がどちらも同じ の関数なので、有効標本サイズという共通の物差しに換算できて、最適解が1点に決まります。deff が精度と人数の換算レートの役目をしています。
多段抽出と系統抽出
クラスター抽出を使うもう一つの理由は名簿がないことです。全国民の名簿は手に入りませんが、市区町村の一覧は手に入る。多段抽出(市区町村→投票区→世帯→個人)はこの制約から来ています。段が増えるごとに分散が積み上がるので、実務では2〜3段までが普通です。
系統抽出は名簿から等間隔に抜く方法です(1000人から100人なら10人ごと)。乱数は最初の1個だけで済むので現場で楽なのですが、落とし穴があります。
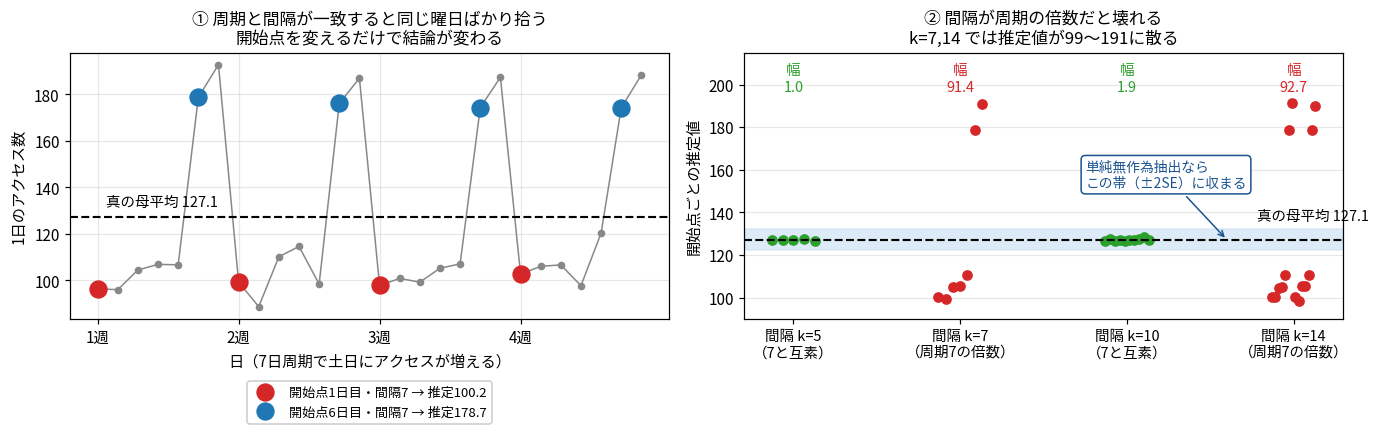
曜日効果のある日次アクセスデータ(土日が多い)で試しました。間隔 にすると同じ曜日ばかり拾います。開始点が月曜なら推定 100.2、土曜なら 178.7。真の母平均は 127.1 です。開始点を選ぶだけで結論が変わる。 も同じく壊れます。 や (7と互素)なら幅は1〜2に収まりました。
逆に、周期がなく単調トレンドがある場合は系統抽出が有利になります。実測では開始点によるばらつきが 0.38 で、単純無作為の 4.70 より小さい。名簿が整列していると系統抽出が自動的に層別の役目を果たすためです(暗黙の層別)。並び順を確認するのが実務の第一歩ということになります。
系統抽出の分散は「開始点が唯一の乱数」なので、実質的に標本サイズ1のクラスター抽出です。だから分散の不偏推定が原理的にできず、普通は単純無作為と仮定して代用します。もう一点、 が ぴったりでないときは母平均に対して厳密には不偏でなくなり、標本サイズも開始点によって と で揺れます。実務では循環系統抽出などで対処します。
比推定と回帰推定:手持ちの情報を精度に変える
ここまでは「誰に聞くか」の話でした。最後は「すでに知っていることをどう使うか」です。
補助変数 について母平均 が既知という状況を使います。全店舗の去年の売上は分かっているが今年の売上は標本しか調べていない、全戸の農地面積は台帳にあるが収穫量は一部しか聞いていない、という場面です。
比推定は「1あたりの量」を掛け戻している
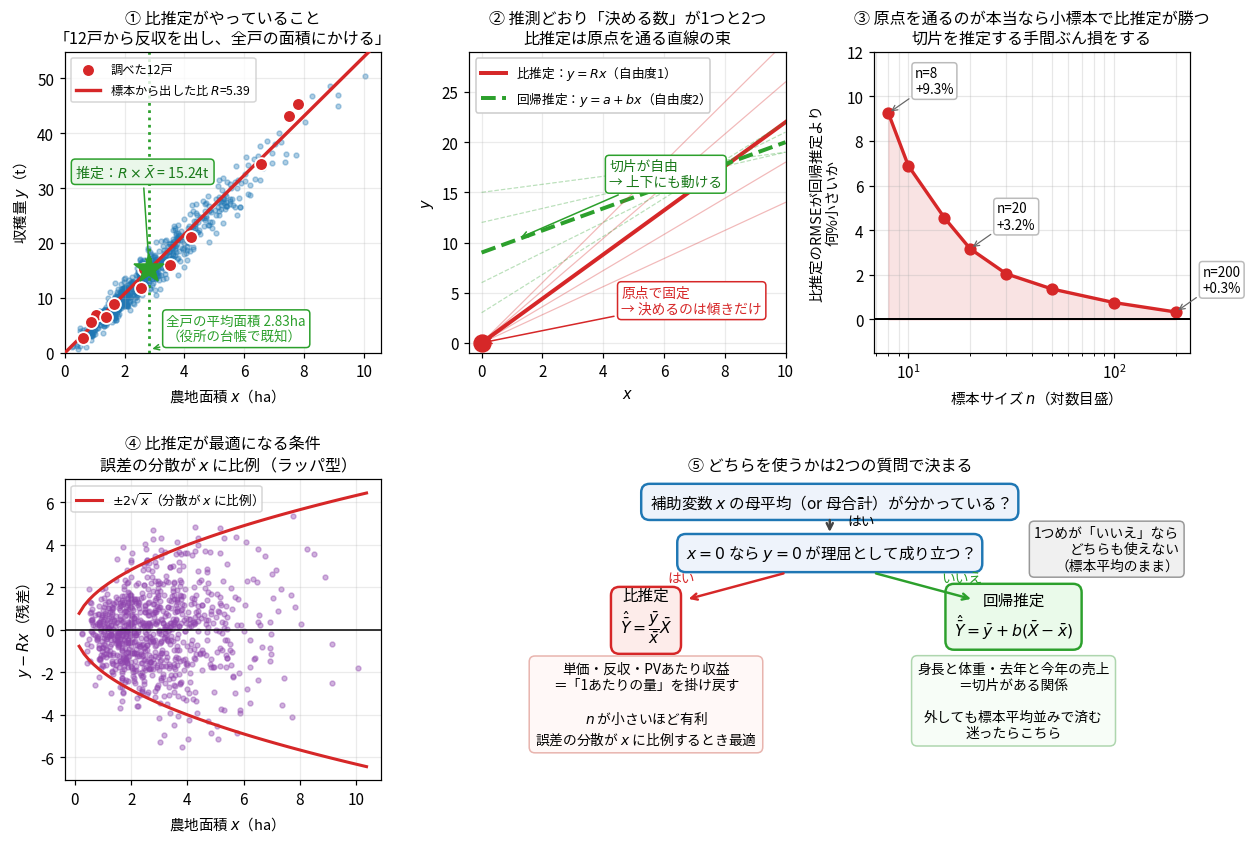
図の左上が比推定の中身です。ある村の米の収穫量を知りたいとき、
- 役所の台帳から全戸の農地面積は分かっている(平均2.83ha)
- 収穫量は全戸に聞けないので12戸だけ調べる
- その12戸から「1haあたり5.39トン」という反収を出す
- 全戸の平均面積に掛ける: トン(丸めていない値で計算すると 15.24)
なぜ効くか。12戸を引いたとき、たまたま大きな農家ばかり当たることがあります。そのとき収穫量の平均も大きく出ますが、面積で割った比(反収)は農家の大小によらずだいたい同じです。だから比のほうが安定していて、それに正しい面積を掛けたほうが精度が良くなる。実測で分散が16分の1になりました。
回帰推定はこうです。
は「標本の が母集団より低めに出た」というズレの情報です。 と が相関しているなら も低めに出ているはずなので、 倍して足し戻す。標本のクセを補助変数で検出して補正しているわけです。分散比はおおよそ になります(実測 0.063、理論 0.064)。
そして図の中央上が2つの関係です。比推定は切片を0に固定した回帰推定で、決めるパラメータが1つ(傾きだけ)か2つ(傾きと切片)かという違いでした。
厳密にはもう一段あります。比推定の傾き は「誤差の分散が に比例する」という重み付けで当てはめた直線で、素朴な最小二乗の とは別物です。あとで出てくる「比推定が最適になる条件」がここに対応します。
使い分け
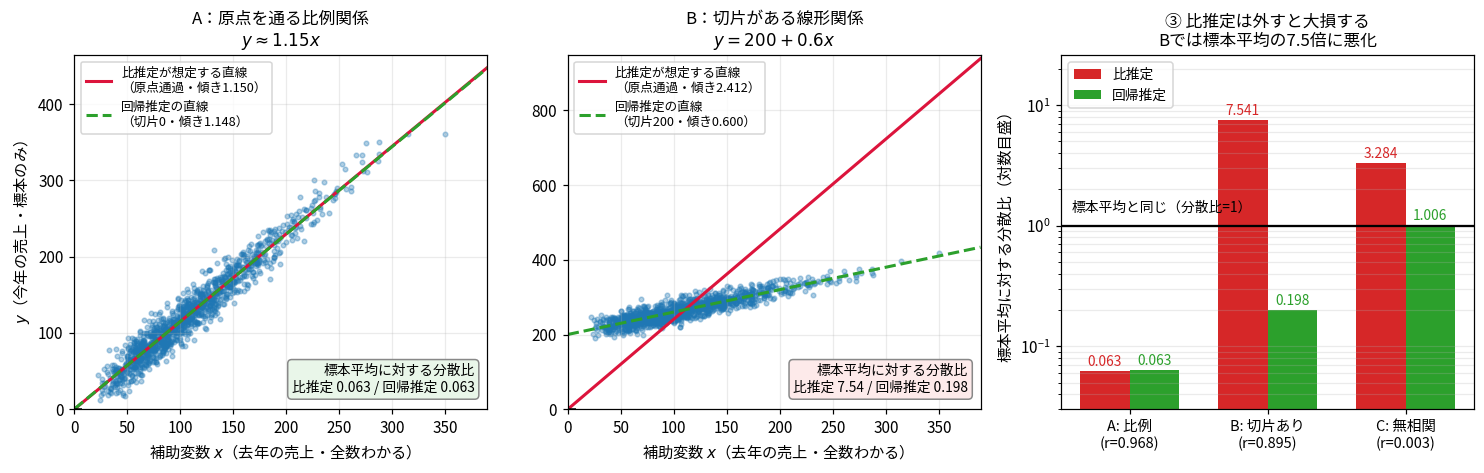
切片がある関係()に比推定を使うと、標本平均の7.5倍に悪化しました。相関が0.895と高いのに損をする。原点を通るという強い仮定を外すと、補助情報が毒になります。
| A:比例 | B:切片あり | C:無相関 | |
|---|---|---|---|
| 比推定 | 0.063 | 7.541 | 3.284 |
| 回帰推定 | 0.063 | 0.198 | 1.006 |
回帰推定は最悪でも標本平均並み(1.006)で止まります。迷ったら回帰推定が実務的な結論です。
では比推定が残っている理由は何か。3つありました。
原点を通るのが本当なら小標本で勝つ。 回帰推定は切片を推定してしまうので、本当は0だと分かっているのにわざわざ測る損があります。 で 9.3%、 で 3.2%、 では 0.3% でした。第10回の「パラメータを増やすと分散が増える」話と同じ構造です。
誤差の分散が に比例するとき最適になる(標準偏差でいえば に比例)。図の左下のラッパ型がその構造で、規模の大きい単位ほど誤差も大きいのは現実のデータでは普通です。回帰推定が最適になるのは分散が一定のときなので、この点では比推定のほうが現実に合う場面が多い。細かい話ですが、分散ではなく標準偏差が に比例する場合は最適推定量が「各単位の比の平均」に変わります。
比そのものが知りたいことがある。 「PVあたり収益はいくらか」を知りたいなら答えが比なので、比推定が直接その答えになります。ここに罠があって、ブログ120記事のうち20記事だけ集計した設定で検証しました。
| 推定の仕方 | 平均 | RMSE |
|---|---|---|
| 比推定() | 2.38923 | 0.0334 |
| 各記事の比の平均 | 2.39516 | 0.0396 |
真の「PVあたり収益」は 2.38956 円/PV です。比の平均と平均の比は違うもので、後者は小さい記事も大きい記事も1票として扱うので別の量を推定しています。サイト全体の RPM(revenue per mille=1000PVあたり収益)を知りたいなら前者が正しい。実務でうっかり後者を計算しがちなところだと思います。
なお比推定・回帰推定はどちらも厳密には不偏ではありません( が分母や の中に入るため)。偏りは で標準誤差の より速く消えるので実用上は無視されます。実測でも偏りは A で −0.004、B で +0.014 と誤差の範囲でした。
使い分けは2つの質問で決まります。
- 補助変数 の母平均(または母合計)が分かっているか → いいえならどちらも使えない
- なら が理屈として成り立つか → はいなら比推定、いいえなら回帰推定
設計でどうにもならない誤差
ここまでは設計で精度を買い叩く話でした。最後に、設計では手が届かない誤差を見ます。
誤差は2種類に分かれます。標本誤差は「全員ではなく一部に聞いたから生じるズレ」で、 を増やせば縮み、これまで扱ってきた がそれです。非標本誤差は「聞き方・答え方・集計から生じるズレ」で、無回答、質問文の誘導、回答者の嘘、入力ミスなどが入ります。
そして非標本誤差は を増やしても縮みません。
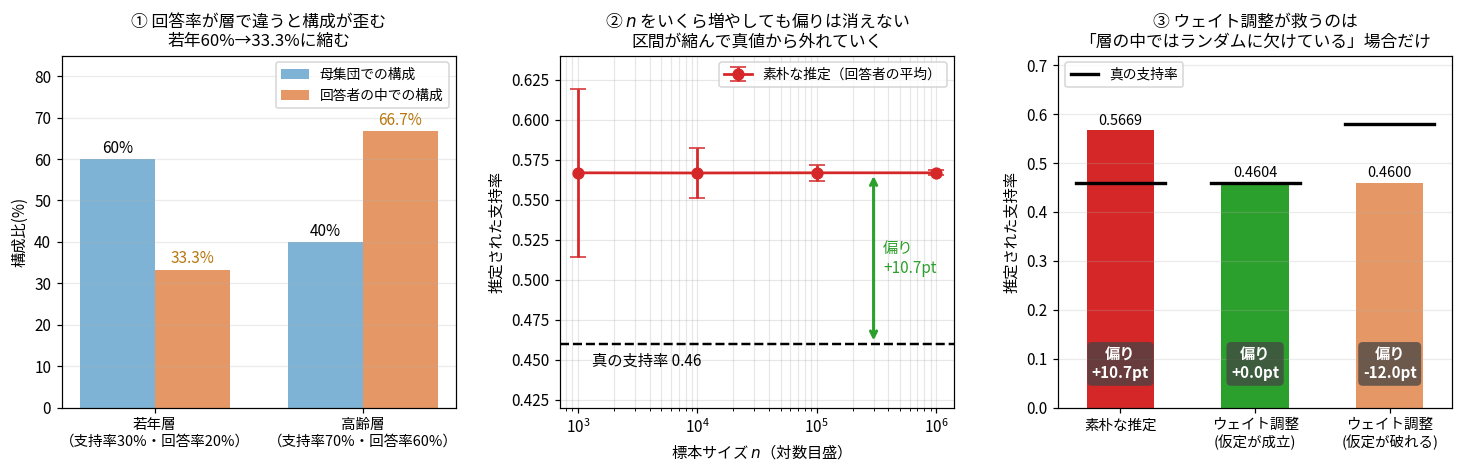
若年層の回答率20%・高齢層60%で、支持率が層で30%/70%という設定を作りました。回答者の中では若年が60%から33.3%に縮みます。素朴に回答者の平均を取ると偏りが +10.7pt。
そして中央のパネルが核心です。
| 依頼数 | 推定値 | 標準偏差 | 偏り |
|---|---|---|---|
| 1000 | 0.5667 | 0.0268 | +10.7pt |
| 1万 | 0.5666 | 0.0080 | +10.7pt |
| 10万 | 0.5667 | 0.0026 | +10.7pt |
| 100万 | 0.5667 | 0.0008 | +10.7pt |
ここでの は依頼した人数です(回答率は全体で36%なので、 なら回答者は360人)。 を1000倍にしても偏りは動きません。標準偏差だけが 0.027 から 0.0008 に縮むので、信頼区間が真値から確実に外れていく。標本を増やすことが状況を悪化させる場面です。
補正は事後層化・ウェイト調整で行います。層ごとの回答者平均を母集団の構成 で重み付けし直す。実測では偏りが +10.7pt から +0.0pt に消え、RMSE(root mean squared error=二乗平均平方根誤差)も 0.107 から 0.0087 になりました(依頼数1万のとき)。ネイマン配分のときと同じ「母構成で戻す」構造です。
ただし仮定しています。MAR(Missing At Random=層の中ではランダムに欠けている) です。回答率が層によって違うこと自体は許され(層ごとに20%と60%で構いません)、層の中で回答者と非回答者の支持率が同じであればよい。全体で回答率が一律という強い状態は MCAR(Missing Completely At Random) で、この設定はそれではありません。そして層内でも差が残る状態が MNAR(Missing Not At Random) で、こうなるとウェイト調整では救えません。層内でも非回答者の支持率が高い設定にすると、ウェイト調整後も −12.0pt の偏りが残りました。
なお MAR で補正できるのは、層を決める変数(ここでは年齢)が母集団側で分かっている場合だけです。
つまりウェイト調整は偏りを消す魔法ではなく、偏りの仮定を層のレベルまで押し下げる道具です。そして仮定が正しいかは、非回答者のデータがないので原理的に検証できません。傍証を取るには追跡調査で非回答者の一部を粘って捕まえる方法があります。
ブログのアンケートに当てはめる
自分の運営に引き寄せて整理しておきます。
いちばん大きいのは自己選択バイアスです。ブログのアンケートに答える人は、記事を最後まで読んだ人、ブログに好意的な人、時間がある人に偏っています。母集団を「読者全体」とすると回答率は数%で、上の設定(20%)よりずっと悪い。GA4 のような行動データが全数に近いのに対し、アンケートは常にこの問題を抱えます。
ウェイト調整をするには母構成が既知でないといけません。ブログの場合、GA4 の年齢・性別・デバイス・流入元の分布が母構成の代わりに使えます。アンケート側で同じ項目を聞いておけば事後層化ができる。これはすぐ仕込める話です。
記事は層になります。 「ふるさと納税の記事の読者」と「統計の記事の読者」を混ぜて平均すると、どちらの実像でもない数字が出ます。記事カテゴリで層別してPVで重み付けするのが筋でしょう。
SNS で拡散されて特定コミュニティから大量に回答が来ると、それはクラスター抽出と同じ構造で deff が効きます。100件集まっても有効30件分ということが起こる。
ただし現状は月31PVという規模なので、標本設計の話をする前段階です。第11回で「月31PVならA/Bテストに5.8年かかる」と出したのと同じ結論で、いまは流入を増やすほうが先になります。
試験対策として押さえるところ
この章は試験での比重が小さいので、深追いはしないことにしました。押さえたのは次だけです。
式は3つ。 有限母集団修正 、ネイマン配分 、設計効果 。
対比表は2つ。 層別 vs クラスター、比推定 vs 回帰推定。この記事の表をそのまま覚えれば足ります。
分散の分解。 比例配分の層別で消えるのは層間分散だけ、という一点。ここが分かっていれば「層別が効く条件」も「クラスターで損する理由」も同じ絵で説明できます。
方向の暗記。 層別(比例配分)は deff ≤ 1、クラスターは deff > 1。比例配分よりネイマン配分のほうが分散が小さい。有限母集団修正は必ず1以下。この3つは符号を間違えやすいので方向だけでも覚えておく価値があります。
自分が間違えていたこと
「分散」を1つの言葉だと思っていた。 データそのもののばらつき と、推定値のばらつき が別物だと区別できていませんでした。この章の議論はほぼ全部が後者の話で、そこを分けたら「1社追加で減る分散」も「1人分の分散」も普通の引き算と代入になりました。 で割られているかどうかが見分け方です。
母平均を知らないと分散が計算できないと思っていた。 標本分散は を引いて作るので は要りません。 の調査1回から標準誤差が出せます。シミュレーションで真値を使っていたのは答え合わせのためで、実務では不要でした。
分子の も で変わると思っていた。 は母集団の性質だけで出来ているので、調査で を増やしても動きません。動くのは「 の推定精度」だけで、式に入るのは真の です。ここを混同すると「1社追加で減る分散」の計算が意味不明になります。
第8回の「母集団サイズ は効かない」を無条件だと思っていた。 あれは を固定したときの話でした。有限母集団修正は抽出率 の関数なので、 が5%を超えれば効きます。抽出率を固定して を動かせば精度は上がり続けます。
クラスター抽出を「劣った方法」だと思っていた。 精度だけ見ればほぼ必ず負けますが、コストを入れると同じ予算で有効標本が3倍になりました。1人あたりの精度ではなく1円あたりの精度で比べるべきでした。
比推定を回帰推定の別物だと思っていた。 切片を0に固定した回帰推定です。そして「原点を通る」という仮定を外すと標本平均より悪化する(7.5倍)ので、柔軟な回帰推定のほうが安全でした。
ウェイト調整で無回答が解決すると思っていた。 解決するのは MAR の仮定が成り立つときだけで、その仮定は原理的に検証できません。仮定を層のレベルまで押し下げているだけでした。
この記事の要点
- 層別とクラスターは抽出の向きが逆。 層別は全集団から少しずつ(中が均質なのが理想)、クラスターは一部の集団を丸ごと(中が縮図なのが理想)
- 層別(比例配分)で消えるのは層間分散だけ。 層間が97.9%なら分散比 0.0208、0.0%なら 1.0000。比例配分なら外しても損しない
- ネイマン配分 の正体は「1社追加で減る分散を揃える」操作。 比例配分の 0.0024/0.0873/14.7162 が、0.02995/0.03009/0.03014 に揃う
- 母集団の2%の層に標本の46.7%を配ると、分散は比例配分の20分の1・単純無作為の86分の1
- の見積りが3倍ずれても比例配分より8倍良い。 使えない理由にはならない
- は共分散が 個足される分。 ICC は「同じ集落の2人の相関係数」そのもの(実測 0.5144)
- ICC=1 なら20人が1人分(分散 0.9330 が一致)。ICC=0.2 で400人調査が83人分
- クラスター抽出を使う理由はコスト。 では予算の9割が移動費で90人分、 なら263人分。
- 有限母集団修正は抽出率 の関数。 で効く。 固定なら は効かない(第8回と矛盾しない)
- 比推定は切片を0に固定した回帰推定。 原点を通るなら小標本で有利( で9.3%)、外すと標本平均の7.5倍に悪化
- 迷ったら回帰推定(最悪でも 1.006)。分散比の目安は
- 比の平均と平均の比は別物(比の平均 2.39516 対 平均の比 2.38923、真値 2.38956)。サイト全体の RPM を知りたいなら
- 系統抽出は間隔が周期の倍数だと壊れる。 で推定値が 100.2 と 178.7。周期がなければ暗黙の層別として有利
- 無回答バイアスは で消えない。 1000人でも100万人でも +10.7pt。区間が縮む分だけ確実に外れる
- ウェイト調整は MAR の仮定に乗っている。 成立すれば +0.0pt、破れれば −12.0pt が残る
これで線形モデル編が終わりました。第16章から第21章まで、回帰・分散分析・標本調査を扱ったことになります。振り返ると、この編はすべて「ばらつきをどう分解するか」の変奏でした。回帰では説明できる分と残差に分け、分散分析では要因ごとに分け、今回は層内と層間に分けた。同じ道具を違う場所に当てていたわけです。
次回からは確率過程編に入ります(第22回・第14章 マルコフ連鎖、第23回・第15章 確率過程の基礎)。ここまでは「手元にある固定したデータ」を扱ってきましたが、次は時間とともに状態が移っていく対象を扱います。今日の状態だけで明日が決まる(過去を忘れる)というマルコフ性が入口で、第5回の無記憶性がそこにつながります。
そのあとが多変量解析編(第24回・第22章 主成分分析から)です。「1つの を説明する」ではなく、 が複数あるとき、あるいは と の区別すらないときにどうするか。今回の「層内と層間に分ける」や第20章の「平方和を直交する方向に分解する」発想が、主成分分析にそのままつながります。