積率母関数:「和を掛け算に変える」ために生まれた形【第9回】
はじめに
前回は大数の法則と中心極限定理を扱いました。ただし証明には触れず、「元の分布が何であれ正規分布に寄る」という事実だけを使って、なぜそうなるのかは棚に上げたまま終えています。
今回はその棚を開けます。第2章に戻って、積率母関数(モーメント母関数)を見ていきます。
この章はロードマップを作った時点で意図的に後ろへ回していました。理由は「数式変形が主役の章だから、具体的な分布と中心極限定理を先に見たほうが何のための道具か分かるはず」というものです。実際そのとおりになりました。ただし、後回しにしたことで別の問題が起きました。
先に「便利さ」を知ってしまったせいで、肝心の定義を分かったつもりで飛ばしていたのです。
今回の学習は、この順番で疑問が出ました。
- 便利なのは分かった。ところで積率母関数とは何なのか
- 定義は分かった。ところでなぜ という形なのか
- 形も分かった。ところで、 には何の意味があるのか
記事はこの逆順、つまり「なぜその形か」から書きます。便利さから入ると、読む側は必ず同じ場所でつまずくと分かったからです。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
TL;DR
- は思いつきではない。「和を積に変える関数」を探すと指数関数しか残らない。 だが は成立する
- 「積率」=モーメント、「母関数」=それを生み出す関数。名前がそのまま中身。定義は の一行だけ
- の正体は「分布を傾けるつまみ」。 だけが傾けない=元の分布。だから、 での傾きが元の平均になる
- サイコロ10個の合計は数え上げると6千万通り。多項式を10乗すれば0.4秒
- 再生性は掛け算1回で証明が終わる。ポアソン+ポアソン、正規+正規、指数を足すとガンマ、すべて同じ手口
- 中心極限定理の正体は 。極限に残るのは平均と分散だけで、歪度は消える
- ただし母関数はいつでも存在するわけではない。コーシー分布や対数正規分布では発散する
- 試験で必要なのは2つだけ。① で微分してモーメントを出す ②掛け算で再生性を示す
統計の用語が出てくるので、先に用語集を置いておきます。用語を知っている方は「なぜ指数関数でなければならないのか」まで飛ばしてください。
用語集
この記事の鍵になる2つだけ挙げておきます。どちらも後で具体例つきで説明するので、いま覚える必要はありません。
| 用語 | 記号 | 意味 |
|---|---|---|
| 積率(モーメント) | 「 の 乗の平均」たち。1次が平均、2次から分散が作れる | |
| 積率母関数 | 積率を生み出す関数。分布の情報を1本の関数に詰め替えたもの |
もう一つ、再生性という言葉も出てきます。「同じ種類の分布どうしを足すと、また同じ種類の分布になる」という性質のことです。
なぜ指数関数でなければならないのか
定義より先に、ここから始めます。私が最初に納得できなかったのは、この妙な形でした。
なぜ が出てくるのか。なぜ が指数の肩に乗るのか。当初は「テイラー展開すると都合よくモーメントが並ぶから、そういう形にしたのだろう」と考えていました。
これは因果が逆でした。
出発点は、母関数の便利さではありません。独立な変数の和 の分布を知りたいという、もっと素朴な困りごとです。
独立性が使える形はひとつしかない
確率変数が独立なとき、何が言えるでしょうか。使える性質はこれです。
平均をバラバラに分解できる。ただし中身が「積」のときだけです。ここが決定的でした。
(和については が独立でなくても常に成り立ちます。分解できるかどうかが問題なのではなく、独立性という強い武器が効くのが積のときだけという話です。)
ところが知りたいのは和 の分布です。ここで独立性を活かしたい。
そこで発想を変えます。和を積に変えてくれる関数があれば、話がつながるはずです。求める条件はこうなります。
「足してから関数に入れた結果」が「別々に入れてから掛けた結果」と一致する関数。これを満たすものを探します。
候補を並べると指数関数だけが残る
実際に試すと、ほとんどの関数が落ちます。
| 候補 | 和を入れると | 判定 |
|---|---|---|
| 成立(積に分かれた) | ||
| 失敗( にならない) | ||
| 失敗( にならない) |
2乗は交差項 が邪魔をします。ただの定数倍は、足し算が足し算のまま残るだけで積になりません。
そして数学的には、この関数方程式の連続な解は だけと決まっています( という中身のないものを除く)。選択肢が他になかったのです。
なお を複素数まで許すと も解になります。これが後で名前だけ出てくる特性関数の正体でした。
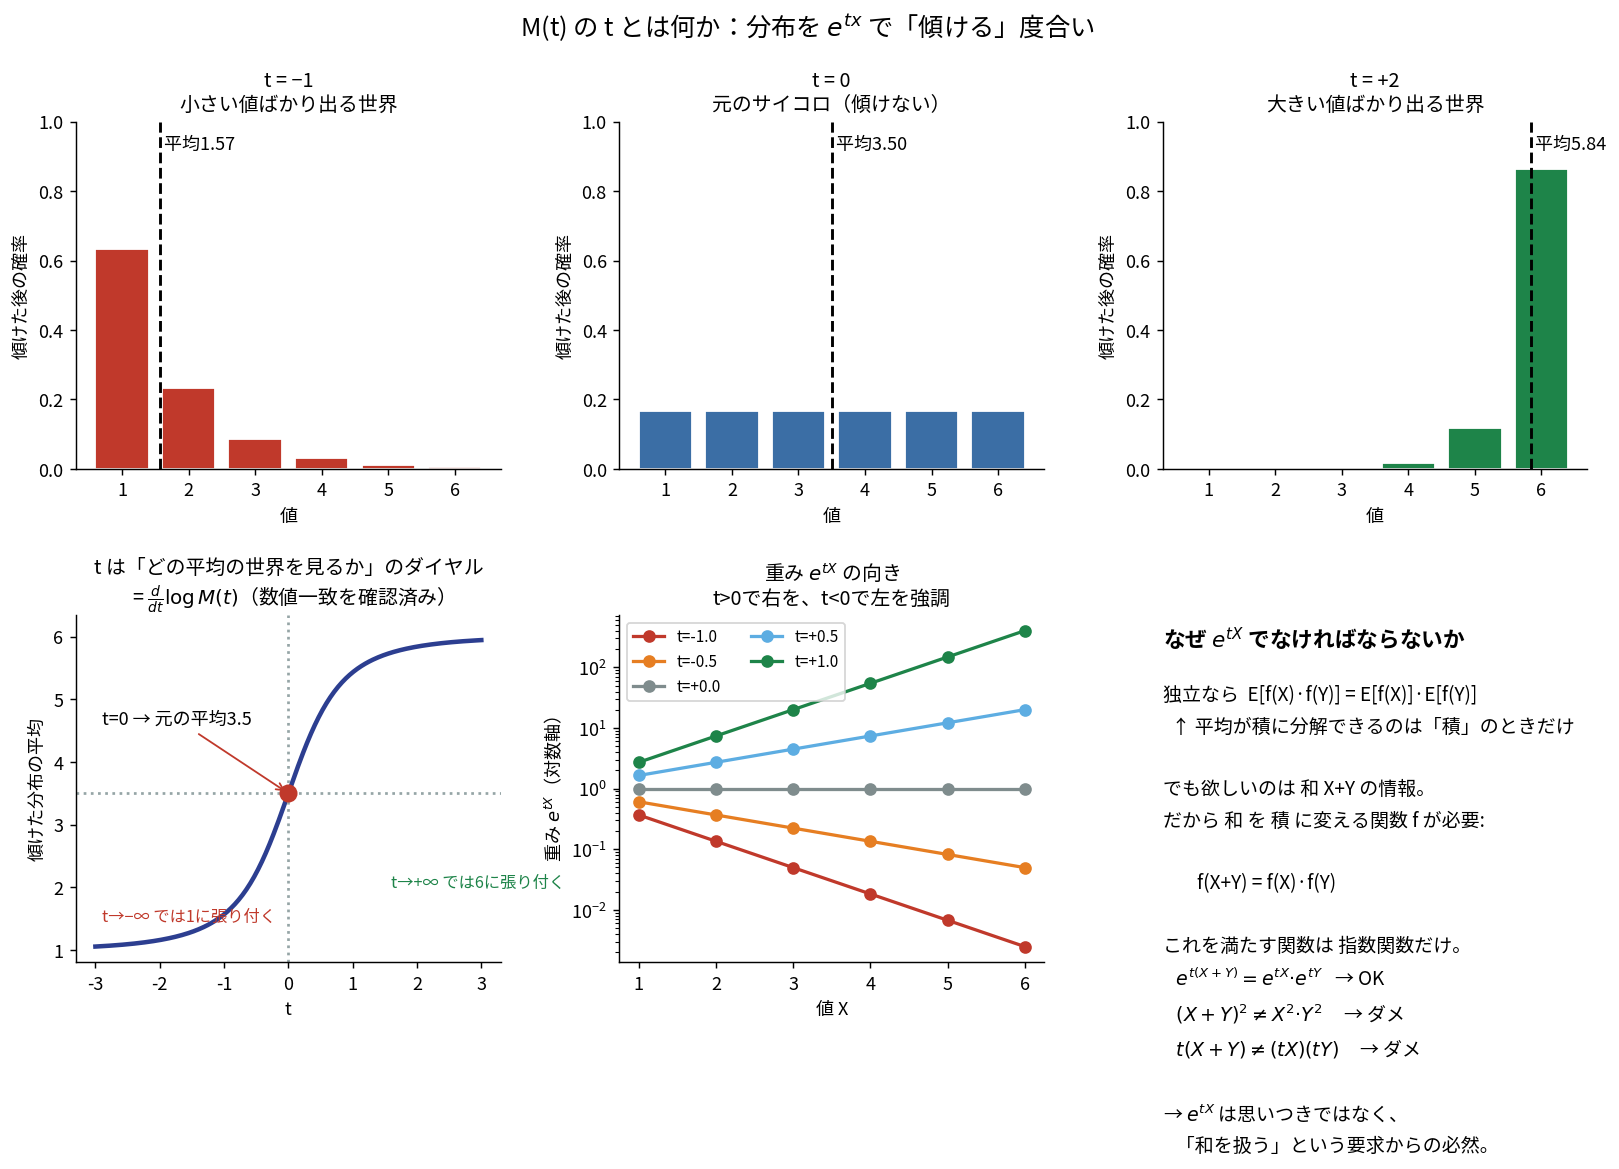
上の図の右下パネルがこの話です(他のパネルは後で使います)。
因果が逆だった
つまり順序はこうでした。
「便利な形を探したら が見つかった」のではない。「和を扱いたい」という要求から、 しか選べなかった。
テイラー展開するとモーメントがきれいに並ぶ、という有名な性質は後から来たおまけです。うれしい偶然のほうが後発だった。
この順番が分かってから、 が急に自然な形に見えるようになりました。指数関数は「足し算を掛け算に翻訳する装置」で、それは高校で習った指数法則 そのものです。新しいものは何もありません。
定義:「積率」はモーメントのこと
形の理由が分かったので、定義に進みます。まず用語をばらします。ここでかなり気が楽になりました。
| 言葉 | 意味 |
|---|---|
| 積率 | モーメント。 という「 の 乗の平均」たち |
| 母関数 | それを生み出す関数。英語では generating function(生成する関数) |
つなげると「モーメントを生み出す関数」。名前がそのまま中身を説明していました。定義は一行です。
は平均を取る記号で、中身の は各値に掛ける重みです。つまりやっていることは重みつき平均にすぎません。 は自分で好きに動かせるダイヤルで、これを変えると重みの付き方が変わります。
サイコロで定義どおり手で組んでみる
抽象的なままだと分からないので、サイコロ1個で作ってみます。値は1から6、確率はどれも 。定義に素直に代入するだけです。
これだけでした。「各値の に、その確率を掛けて全部足す」——定義そのままです。
に数を入れれば、ただの数が返ってきます。
ここで は必ずこうなります。 なら なので、中身は「1の平均」つまり確率の合計です。確率は全部足すと1。だから は分布によらず成立します。
これは計算間違いの検出に使えます。母関数を導出したら を入れてみて、1にならなければどこかで間違えている。試験でも使える検算です。
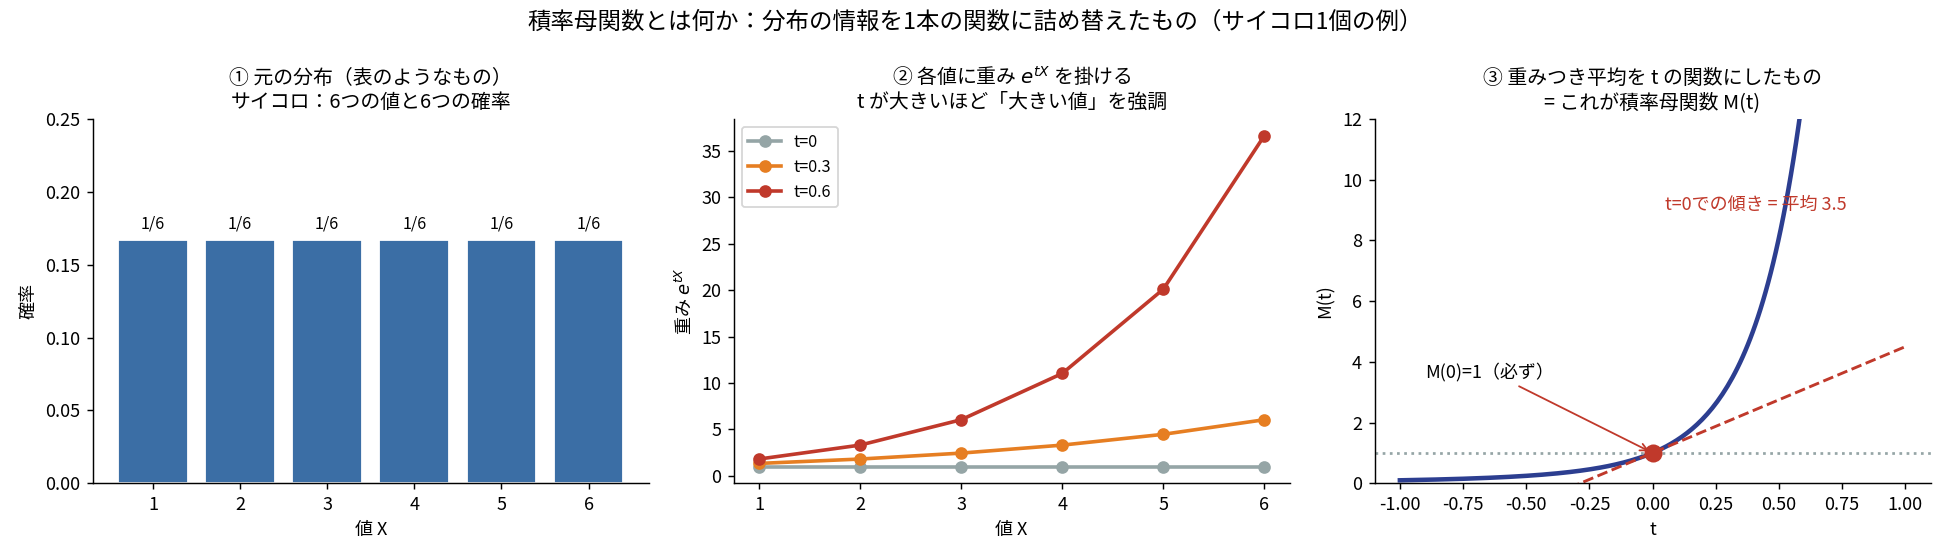
図の①が元の分布、②が重み 、③がそれらを掛けて平均した結果を の関数として描いたものです。③の曲線が そのものです。 で必ず高さ1を通っているのが確認できます。
なぜモーメントを「生む」のか
名前の由来を確かめます。 をテイラー展開すると、
これの平均を取ります。平均は足し算をバラせるので、
モーメントが係数として全部詰まっています。 これが「母関数」と呼ばれる理由でした。
サイコロで実際に展開させてみると、こうなりました。
の係数が 。サイコロの平均そのものです。 の係数に を掛けると で、これは に一致します。
だから微分すれば取り出せる
テイラー展開の係数を取り出す操作が微分でした。 で微分すると、
サイコロで確かめると 、。そして分散は、
サイコロの分散の既知値 と一致しました。
ここで第3回が戻ってきます。あの回で扱った「分散 = 2乗の平均 − 平均の2乗」が、そのまま という形で現れています。母関数は新しい概念を持ち込んでいるのではなく、既知の公式を機械的に実行できる形に整理しただけでした。
とは何か——3つの顔
ここが最後まで残った疑問です。定義も形の理由も分かった。それでも が何なのか掴めませんでした。
は分布のパラメータではありません。データでもない。かといって を代入して消すだけなら、なぜわざわざ変数として置くのか。「計算のための飾り」だと思っていました。
調べると、 には少なくとも3つの役割がありました。
顔①:分布を傾けるつまみ
一番腑に落ちたのがこれです。重み を掛けて、合計が1になるように割り直してみます。すると元の分布を傾けた別の分布が得られます。
サイコロで を動かすと、こうなりました。
| 平均 | |||||||
|---|---|---|---|---|---|---|---|
| 0.634 | 0.233 | 0.086 | 0.032 | 0.012 | 0.004 | 1.567 | |
| 0.414 | 0.251 | 0.152 | 0.092 | 0.056 | 0.034 | 2.227 | |
| 0.167 | 0.167 | 0.167 | 0.167 | 0.167 | 0.167 | ||
| 0.034 | 0.056 | 0.092 | 0.152 | 0.251 | 0.414 | 4.773 | |
| 0.000 | 0.000 | 0.002 | 0.016 | 0.117 | 0.865 | 5.844 |
を上げると大きい目ばかり出る世界、下げると小さい目ばかり出る世界に移ります。 では86.5%が6になり、平均は5.844。 では最大値6・最小値1に張り付きます。
そして重要なのは、 だけが「傾けない」ということです。重みが全部1になるので、元のサイコロがそのまま残ります。
これは気分の話ではなく、等式で裏づけられます。
6つの で数値微分と比べたところ、すべて完全に一致しました( で 1.567067、 で 3.500000、 で 5.843519)。
ここで「微分すると平均が出る」の正体が見えました。 は傾けない世界、つまり元の分布そのものです。だからそこでの傾きが元の平均になる。公式として暗記していた に、はっきりした意味がつきました。
顔②:モーメントを仕分ける棚
もう一つの役割は整理棚です。
の何乗かが、モーメントの住所になっています。 1乗の棚に平均、2乗の棚に2乗平均、3乗の棚に3乗平均。
もし がなく数値ひとつしか持てなければ、取り出せる情報も1個だけでした。 を変数として抱えているから、無限個のモーメントを1本の関数に同時に格納できる。これが「分布の情報を1本の関数に詰め替えた」の意味でした。
顔③:和を積に変えるための係数
3つ目は最初の節で見たとおりです。指数の肩に を乗せるために必要な係数、という役割です。
おまけ: には単位がある
細かい話ですが、これも納得の助けになりました。 は指数の肩に乗るので無次元でなければなりません。ということは、
- が「秒」なら、 は「1/秒」
- が「円」なら、 は「1/円」
は を測る物差しの逆数です。「どのスケールで分布を覗くか」を決めている、と読めます。
用途①:和の分布を数え上げずに求める
の意味が分かったので、実際に何ができるかに移ります。最初の動機だった「和の分布」からです。
問題を立てます。
サイコロを10個振ったとき、合計の分布はどうなるか。
正直に数え上げると 通り。6千万通りを列挙するのは現実的ではありません。
ここで多項式を持ち出します。確率を係数として並べた関数を作ります。
これを10乗して展開すると、 の係数がそのまま「合計35になる確率」になります。実測 0.4 秒で答えが出て、合計35の確率は 0.07269 でした。
なぜこれでうまくいくのか
種明かしは多項式の掛け算の仕組みです。 なので、指数は足され、係数は掛け合わされます。
一方、独立な確率変数の和では、値が足され、確率が掛け合わされます。
構造が完全に同じです。この操作は畳み込みと呼ばれ、まともに計算すると面倒なのですが、母関数の世界では単なる掛け算になる。これが母関数の本質でした。
念のため、 については全数え上げと突き合わせて完全一致を確認しました(確率の総和もぴったり1)。
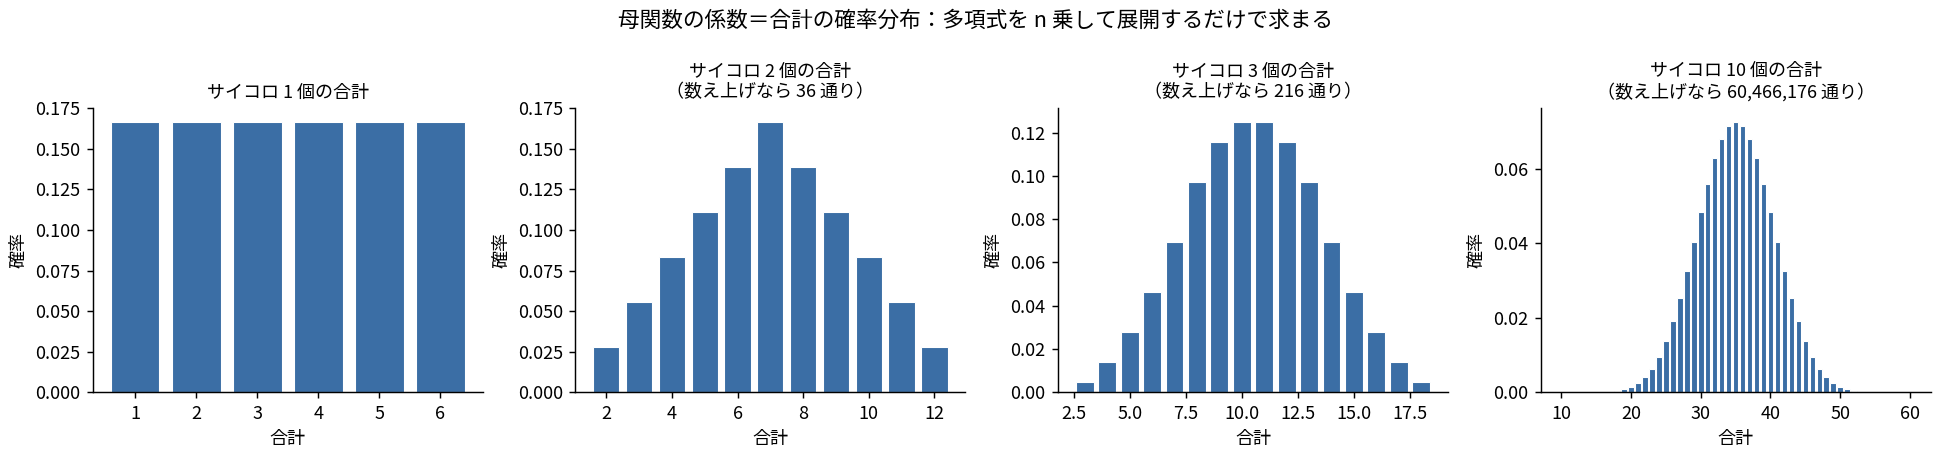
図を見ると、個数を増やすにつれて自然に釣鐘型へ向かっていきます。これは後で中心極限定理として回収されます。
ここで混乱した:母関数は2種類ある
正直に書きます。ここで2つの母関数を混同していました。
| 名前 | 定義 | 係数の中身 |
|---|---|---|
| 確率母関数 | 確率そのもの | |
| 積率母関数 | モーメント |
サイコロの多項式で使ったのは確率母関数のほうです。 の係数が確率だったのはそのためでした。一方、微分してモーメントを出していたのは積率母関数です。別物です。
ただし両者は無関係ではありません。 を代入すると完全に一致します(実際に確認しました)。同じ関数を、変数の取り方を変えて見ているだけでした。
使い分けはこうです。多項式として係数を読みたいときは 、微分してモーメントを出したいときは 。 なお が使えるのは、サイコロのように値が0以上の整数である分布に限られます。連続分布では だけを使います。
この区別を曖昧にしたまま読み進めると、「係数が確率なのかモーメントなのか」で必ず混乱します。私はここで一度つまずきました。
用途②:再生性が掛け算1回で証明できる
母関数が本当に強いのはここからでした。
まず基本の事実です。独立な について、
和の母関数は、各母関数の積。冒頭で「和を積に変える関数」を探した成果がこれです。
ポアソン分布でやってみる
ポアソン分布の母関数は です。 と の2つを掛けます。
指数部が足されただけです。そして右辺は、パラメータ のポアソン分布の母関数そのもの。
これで証明が終わりました。 「ポアソン分布を足すとポアソン分布になり、パラメータは足し算になる」という定理が、指数法則1回で出ました。
畳み込みで直接やろうとすると、無限和の計算に二項定理を持ち込む面倒な作業になります。それが不要になりました。
同じ手口で全部出る
この方法の強さは、使い回しが効くところです。
| 足すもの | 結果 | 母関数での見え方 |
|---|---|---|
| ポアソン(2) + ポアソン(3) | ポアソン(5) | が足される |
| 正規(1, 1) + 正規(3, 4) | 正規(4, 5) | と が足される |
| 指数() を 個 | ガンマ(, ) | 指数が 乗される |
| + | 自由度が足される |
正規分布の場合は母関数が なので、掛けると肩が足されて と が現れます。分散が足されるのは標準偏差ではなく分散のほう、という第3回で確認した事実も、ここに自然に出てきます。
モーメントも機械的に出る
ついでに主要な分布のモーメントを、微分だけで出してみました。すべて教科書の値と一致しました。
| 分布 | 積率母関数 | 分散 | |
|---|---|---|---|
| 二項(, ) | |||
| ポアソン() | |||
| 指数() | () | ||
| 正規(, ) | |||
| ガンマ(, ) | () |
指数分布とガンマ分布に条件が付いています。つまみには回せる範囲がありました。 裾が指数的に減る分布では、重み の増え方が裾の減り方に勝ってしまう があり、そこで母関数は発散します。ただしモーメントを出すのに使うのは の近くだけなので、実用上は困りません。
二項分布の分散 は第3回で手計算で導きました。母関数なら微分2回で同じ答えに着きます。覚える対象が「分布ごとの平均と分散」から「母関数1本」に減るのが実用上のうまみでした。
乱数で検算する
導出が合っていても、思い込みで間違えている可能性があります。それぞれ40万件の乱数で確かめました。
| 検証内容 | 実測(平均・分散) | 理論値 |
|---|---|---|
| ポアソン(2) + ポアソン(3) | 4.9992・5.0057 | 5・5 |
| 正規(1, 1) + 正規(3, 4) | 4.0038・4.9917 | 4・5 |
| 指数(1.5) を3個 | 1.9994・1.3344 | 2・1.3333 |
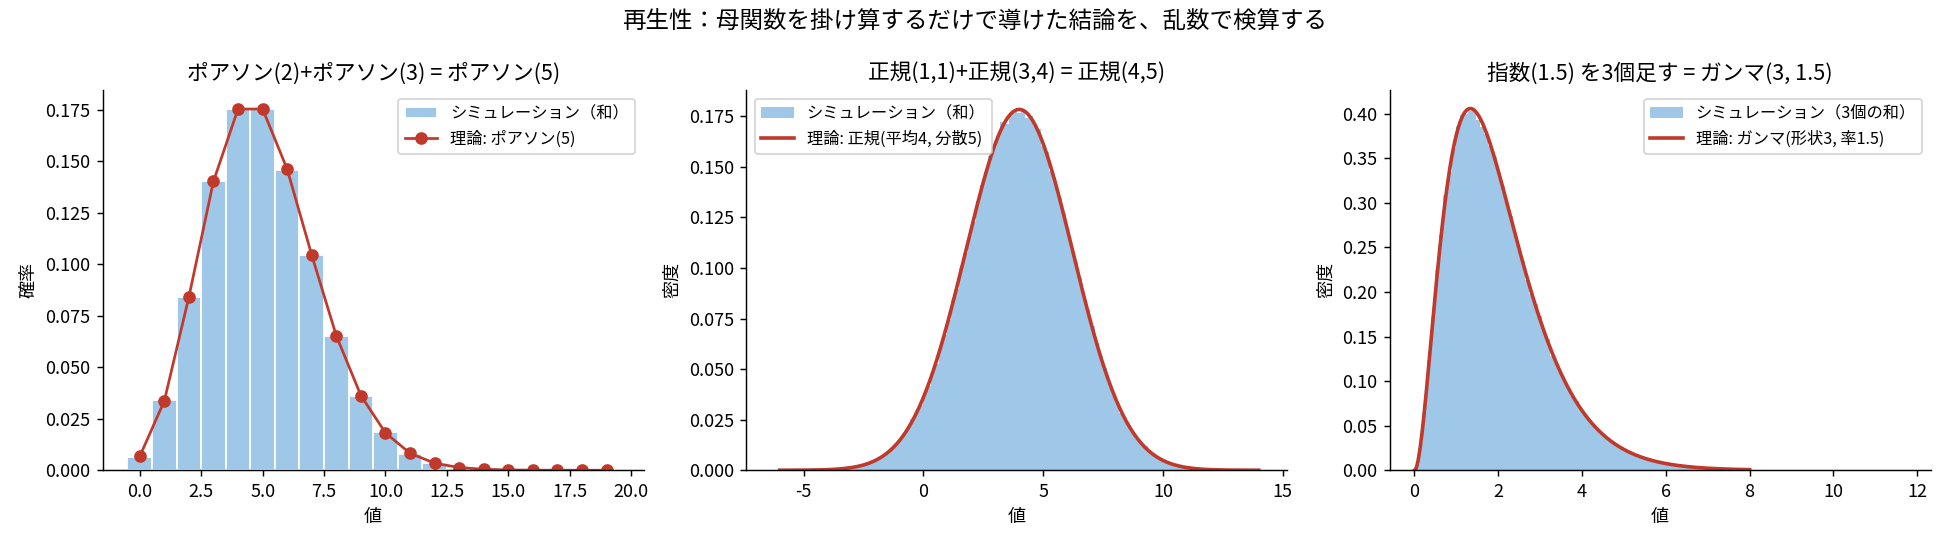
理論曲線とヒストグラムが3つとも重なりました。掛け算1回で出した結論が、乱数でも再現されています。
第6回が回収された
ここで気づいたことがあります。第6回では連続分布を「足したのか、掛けたのか、混ざったのか」という軸で整理しました。あの「足す」系の関係——指数を足すとガンマ、正規を足すと正規——は、すべてこの掛け算1本に集約されます。
個別に覚えていた関係が、1つの原理に落ちました。第6回では「作られ方で分布が決まる」と書きましたが、その作られ方を計算する道具が母関数だったわけです。
一意性:この議論が成立している前提
ここで一度立ち止まる必要がありました。
上の証明では「母関数がポアソンの形になったからポアソン分布だ」と結論しています。これは当たり前でしょうか。
当たり前ではありません。母関数と分布が1対1に対応しているという保証があって初めて許される推論です。これが一意性の定理でした。
原点のまわりで母関数が存在するなら、母関数が一致すれば分布も一致する。
地味な定理ですが、これがなければ再生性の議論は全部崩れます。「形が似ている」だけでは同じ分布だと言えないからです。
条件が付いていることに注意が必要でした。すべての分布に母関数があるわけではありません。 コーシー分布や対数正規分布は で が発散します。その場合は の平均を取る特性関数という兄弟の道具に交代します(こちらは必ず存在する)。母関数は「使えるときは強いが、いつでも使えるわけではない道具」でした。
再生性は当たり前ではない
「和をとっても同じ種類の分布に留まる」のは特別な性質だと分かる例があります。一様分布です。
一様分布 の母関数は です( では になるので、極限として と読みます)。これを2乗しても、 の形にはなりません。
実際に一様分布を2つ足すと、平坦にならず三角分布になります。40万件で確かめると平均1.0007・分散0.1669(三角分布の理論値は1と )。
サイコロ2個の合計が7を頂点とする三角形になるのと同じ現象です。「一様なものを足したら一様」ではありませんでした。
低次のモーメントが一致しても分布は決まらない
もう一つの対比が効きました。平均2・分散1 を共有する2つの分布を並べてみます。正規分布と対数正規分布です。
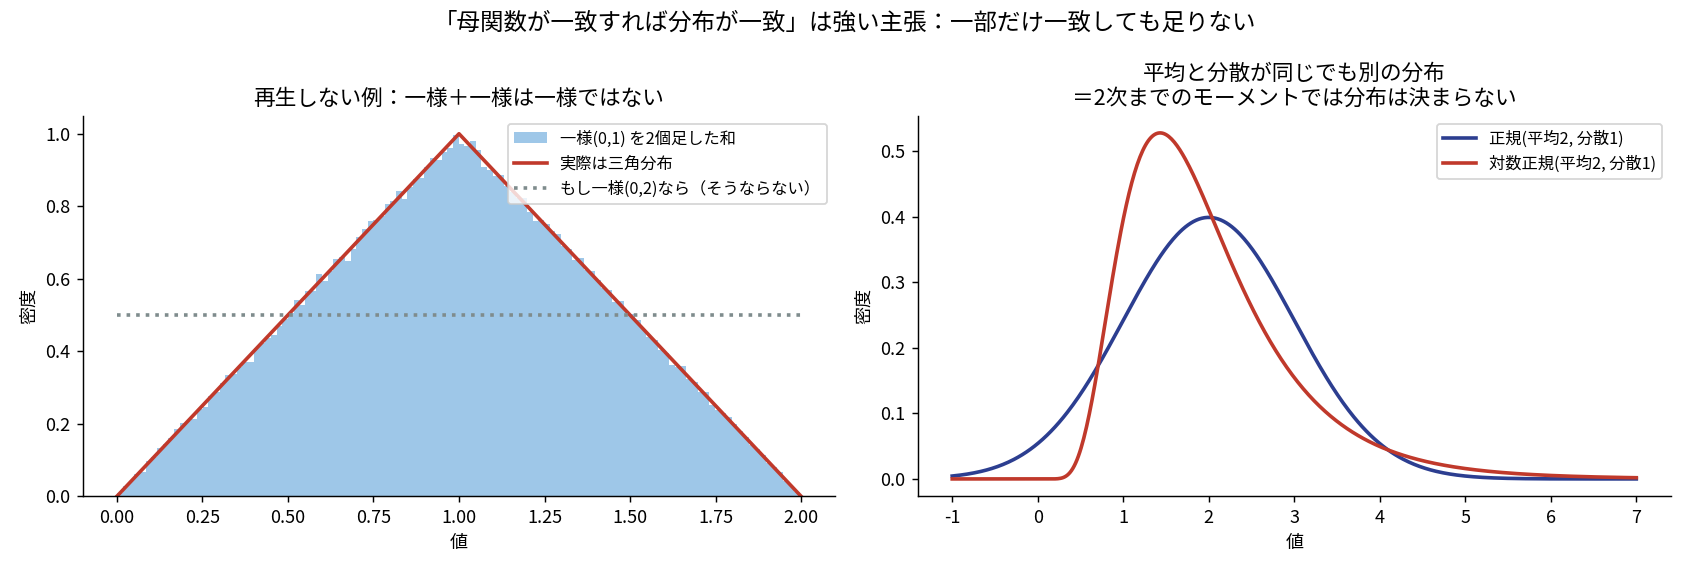
右の図のとおり、まったく別の形をしています。平均と分散が同じでも、分布は決まりません。
だから一意性の主張は「母関数まるごとの一致」という強い条件を要求します。「2次までのモーメントが同じ」では足りない。この対比を見て、一意性が単なる形式的な定理ではないことが分かりました。
中心極限定理の正体
いよいよ最大の応用です。
第1回で、私は中心極限定理をアニメーションと4パネルの図で扱いました。標本サイズを増やすと標本平均の分布が正規分布に近づく様子を見せて、歪度が に従うことまで実測しました。
ただし、あの回でやったのは、「近づく様子を見せた」だけです。なぜ近づくのかには触れていません。前回も「元の分布が何であれ正規に寄る」という事実を使う側に徹して、証明は預けたままにしました。
その預けた「なぜ」に、母関数が答えを持っています。
対数を取ると掛け算が足し算になる
母関数の対数を取ります。これをキュムラント母関数と呼びます。
和の母関数は積だったので、対数を取ると和になります。 個の和なら 倍です。扱いが一気に楽になります。
ここで各項を標準化します。 として、その母関数を と書きます(平均0・分散1に直したもの)。展開すると次の収束が出ます。
そして は標準正規分布の母関数です。一意性の定理があるので、母関数が正規分布の母関数に収束すれば、分布も正規分布に収束すると言えます。
つまり、「正規分布に近づく」の中身は「母関数が正規分布の母関数に近づく」ことだったわけです。
ひとつ注意があります。この筋道が使えるのは母関数が存在する分布に限られます。中心極限定理そのものに必要な条件は「分散が有限」だけで、母関数の存在は要りません。母関数を持たない分布でも定理は成り立ち、そこでは先に触れた特性関数を使って同じ議論をします。母関数版は「見通しのよい特別な場合」だと理解しました。
数値で確かめる
本当に に行くのか、指数分布を出発点にして確かめました。指数分布は強く右に歪んだ分布で、正規分布とは似ても似つかない形です。
の指数分布を平均0・分散1に直すと になります。 における値を並べます。目標は です。
| 5 | 0.72785 |
| 30 | 0.57063 |
| 200 | 0.52490 |
きちんと 0.5 に向かっています。
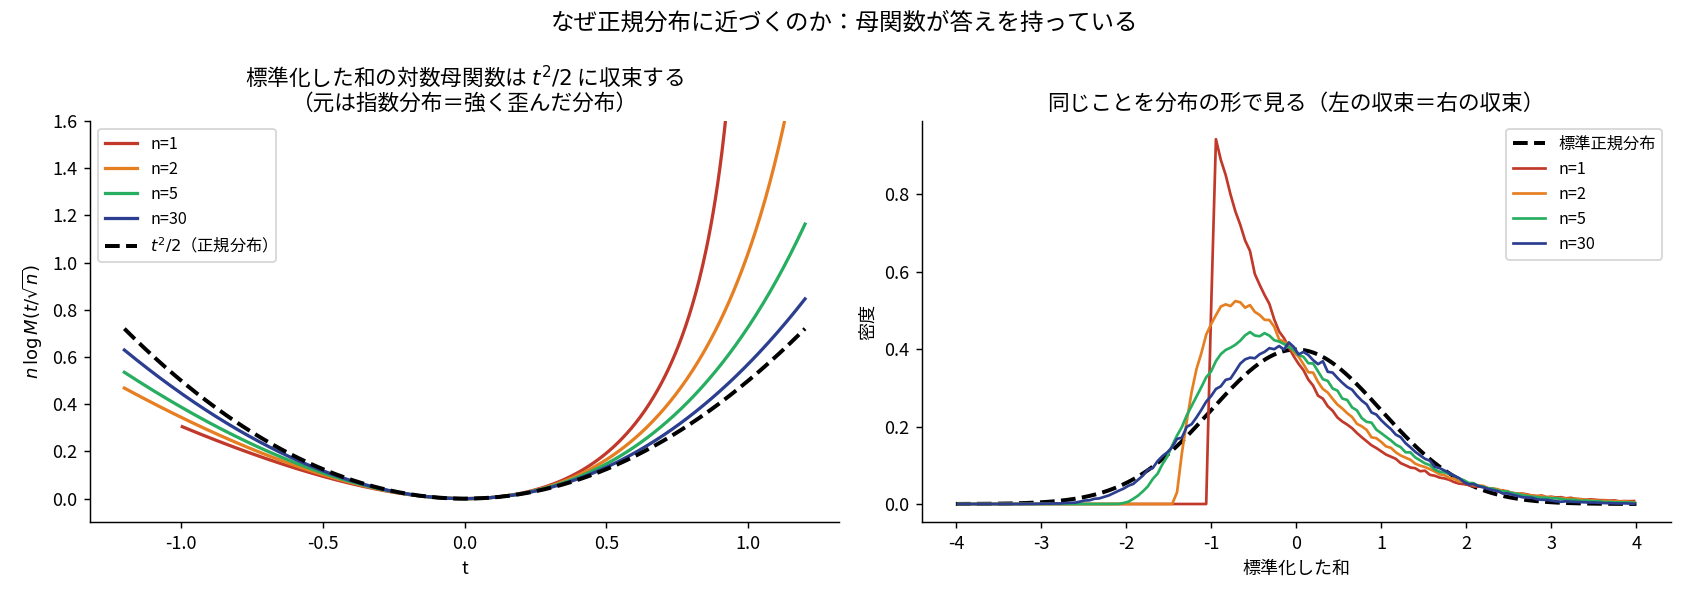
図の左が対数母関数の収束、右が同じことを分布の形で見たものです。左右は同じ現象の別の見方です。左で曲線が黒い破線に貼りつくことと、右で分布が釣鐘型に重なることが、一意性の定理で結ばれています。
歪度が消えるという事実
この見方をすると、中心極限定理のある性質がはっきりします。
展開したときに極限へ残るのは1次(平均)と2次(分散)の項だけです。3次の項には 、4次には と、次数が上がるほど速く小さくなる係数が掛かるため、 を大きくすると消えていきます。
つまり極限では歪度や尖度の情報が消えます。
だから元の分布がどんな形でも、同じ極限に行き着きます。前回の問い——なぜ元の分布の情報が消えて正規分布だけが残るのか——の答えがこれでした。消えているのは3次以上の項、残っているのは平均と分散。第1回で指数分布から始めても正規分布に近づいたのも、このためでした。
ついでに、前回「指数分布は でも近似が不足する」「コーシー分布は何個足しても無駄」という実測が出ていました。ここも説明がつきます。歪んだ分布は3次の項が大きいので、消えるまでに が要る。
コーシー分布はもっと根本的です。 では が無限大になり、そもそも母関数が作れません。平均も分散も存在しないので、残るべき1次・2次の項が最初からない。実際、コーシー分布は 個の平均を取ってもまったく同じコーシー分布のままです。近づくのが遅いのではなく、最初から最後まで動かない。
そしてこの事実が、この後の章を支えています。母集団の分布の形を知らなくても、標本平均の分布は平均と分散だけで扱える。 推定と検定の全体がこの上に立っています。母関数が「後半への土台」である理由がここでした。
コラム:試験の主題ではないが実務で効く使い方
ここからは寄り道です。これから出てくるチェルノフ上限と重点サンプリングは、準1級の出題範囲には入っていません。ただし に具体的な数を入れる場面として面白かったので、読み物として残します(なお節の後半で触れる指数型分布族は、範囲外ではなく後の章で顔を出します)。
実は私は最初、「 に数を入れる場面なんてないのでは」と考えていました。 で微分するだけなら、 は計算のための飾りに見えたからです。これは言い過ぎでした。
めったに起きないことを測る
問題を立てます。
サイコロを100個振る。合計の平均は350。では合計が450以上になる確率は?
正解は です。10億回振って1〜2回という世界です。
まず第3回で扱った分散を使う方法(チェビシェフの不等式)を試すと、上限は でした。真の値の1900万倍です。「3%以下です」と言われても、実際は10億分の1。何も言えていません。
ここで母関数を使うと、次の形の上限が得られます。
この を探す作業が、まさに に数を入れて動かすことです。結果は 、真の値の12倍。桁が合いました。
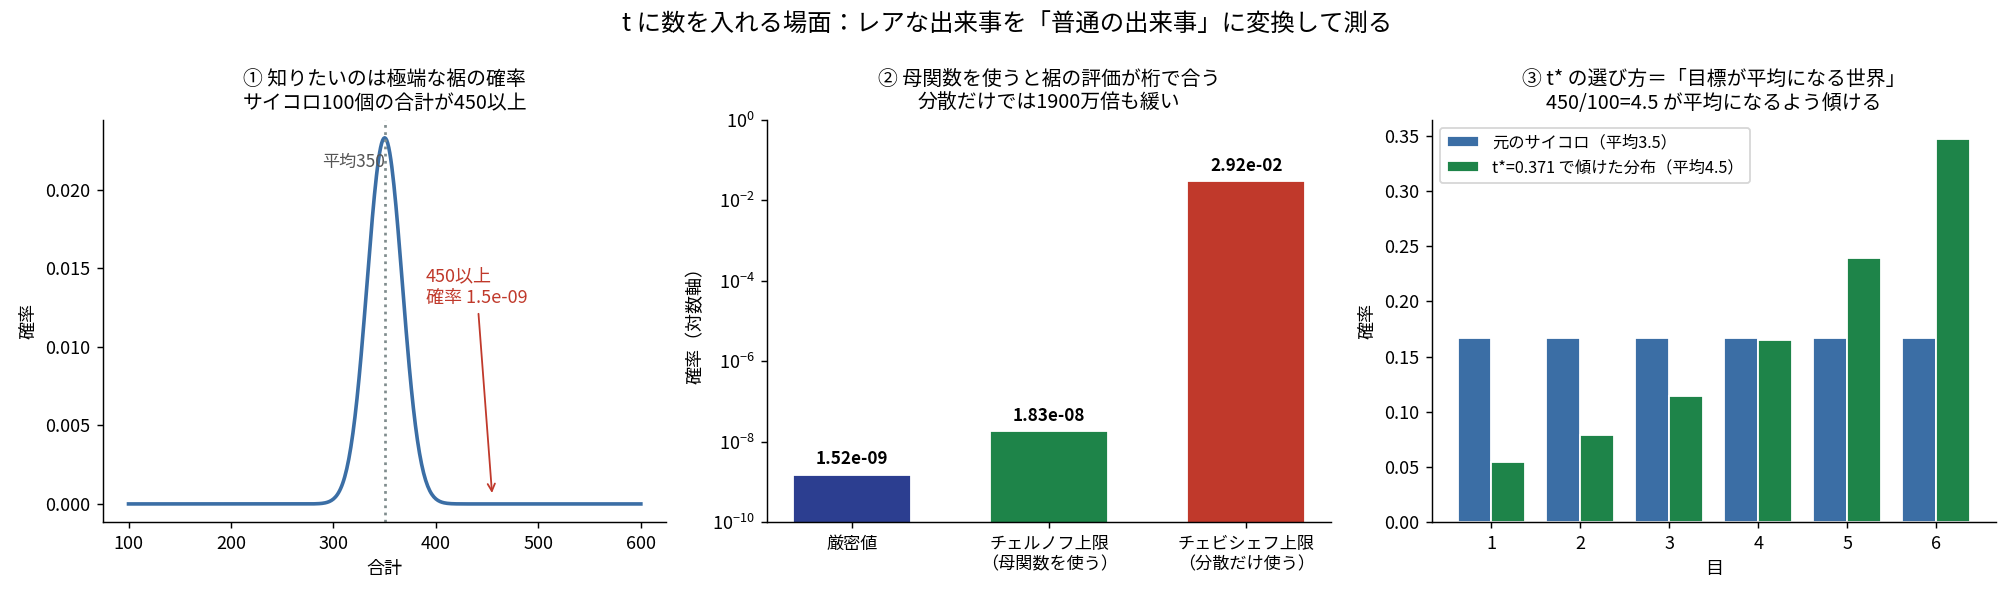
最適な の意味がきれいだった
探索の結果、最適値は でした。この値に意味があります。
この で分布を傾けると、平均がちょうど になります。
つまりやっていることは、「450が"平均"になるような世界に分布を傾けて、そこでの計算を元の世界に換算する」。レアな出来事を、いったんそれが普通に起きる世界へ移して扱うわけです。
さきほどの「 は分布を傾けるつまみ」という解釈が、そのまま手順になっていました。
シミュレーションが成立するようになる
もっと実感が湧いたのはこちらです。同じ確率をモンテカルロで求めようとすると、素朴な方法は破綻します。
| 方法 | 20万回中の当たり | 推定値 | 真値との比 |
|---|---|---|---|
| 素朴なモンテカルロ | 0 回 | 0(推定不能) | — |
| で傾けてから補正 | 103,433 回 | 0.992 |
素朴に振ると20万回で一度も当たらず、推定値は0になります。10億回に1回なので当然です。
そこで で傾けた分布から乱数を出し、後で重みを掛けて元の世界の確率に戻します。すると当たりが10万回を超え、同じ計算量で真値の0.992倍まで当てました。測れなかったものが測れるようになっています。
これは重点サンプリングと呼ばれ、金融のリスク評価(損失が閾値を超える確率)、通信のビット誤り率、保険の破産確率などで標準的に使われる技法です。
IT の文脈だと、テールレイテンシや SLO 違反率の見積もりが同じ構造です。 「p99.99 を超える確率」を素朴な負荷試験で測ろうとしても、めったに起きないので観測できません。傾けて測るという考え方は、そういう場面で効いてきます。
統計理論そのものの土台でもある
もう一つ、これは試験範囲に効いてきます。
傾けた分布は という形をしていました。これは指数型分布族のもっとも素朴な形(自然指数型分布族)そのものです。 このとき は自然パラメータ、 は正規化項にあたります。
一般の指数型分布族は の代わりに十分統計量が入る形に拡張されますが、骨格は同じです。正規・ポアソン・二項・ガンマといった主要な分布を同じ枠組みで統一的に扱えるのは、この構造のおかげです。そして次回扱う最尤法やフィッシャー情報量の一般論も、同じ土台の上に立っています。
での重みづけは、8章以降で出会う道具の下地でした。
試験対策として必要なのは2つだけ
ここまで長く書きましたが、試験のために押さえるべきことは絞れます。
- で微分してモーメントを出す( が平均、 が分散)
- 掛け算で再生性を示す(母関数を掛けて、同じ分布の形になるか見る)
この2つです。チェルノフ上限と重点サンプリングは準1級の範囲を超えています。一方で指数型分布族は範囲外ではありません——第8章の十分統計量や第10章の検定法の導出で顔を出します。ただしこの第2章の段階で一般論まで踏み込む必要はなく、「 で重みづけした形が後で戻ってくる」と覚えておけば十分でした。
検算として を確認する習慣も付けておくと、導出ミスに気づけます。
自分が間違えていたこと
今回は勘違いが多い回でした。正直に残します。
1. 確率母関数と積率母関数を混同していた
と を、どちらも「母関数」と呼んで行き来していました。係数が確率なのかモーメントなのかが曖昧になり、途中で話がつながらなくなりました。 で一致するとはいえ、別物として区別すべきでした。
2. の因果を逆に理解していた
「テイラー展開すると便利だから、この形にしたのだろう」と思っていました。実際は「和を積に変える関数が必要」という要求から、指数関数しか選べなかった。便利さは結果であって理由ではありませんでした。
3. を計算用の飾りだと思っていた
で微分して消すだけの変数に見えていました。実際には「分布を傾けるつまみ」であり、 が傾けた分布の平均になるという明確な意味がありました。この解釈を知ってから、 が公式ではなく当然の事実に見えるようになりました。
4. 母関数はどんな分布にもあると思っていた
「分布の情報を1本の関数に詰め替えたもの」と理解した結果、すべての分布に母関数があるつもりでいました。実際にはコーシー分布のように で発散するものがあり、一意性の定理にも「原点近傍で存在するなら」という条件が付いています。便利な道具ほど、使える範囲を先に確認しておくべきでした。
この回で押さえること
| 問い | 答え |
|---|---|
| なぜ なのか | 和を積に変える関数が必要で、それは指数関数だけ |
| 積率母関数とは | モーメントを生み出す関数。 という重みつき平均 |
| とは | 分布を傾けるつまみ。 が元の分布。だから が平均 |
| 何が楽になるのか | 畳み込みが掛け算になる。モーメントが微分で出る |
| 再生性の証明 | 母関数を掛けて、同じ形になるか見るだけ |
| 一意性が要るのは | 「形が一致したから同じ分布」と言うため。これがないと全部崩れる |
| 母関数の限界 | 原点近傍で存在しない分布がある(コーシー・対数正規)。そこは特性関数の担当 |
| 中心極限定理の正体 | 。平均と分散だけが残り、歪度は消える |
| 試験で必要なのは | での微分と、掛け算による再生性の2つ |
一本の筋にまとめると、こうなります。
母関数は、面倒な畳み込みを掛け算に変える装置。 という形も という変数も、そのために必要だったから存在している。
確率の土台が閉じた
今回で節目を迎えました。
| 章 | 内容 | 状態 |
|---|---|---|
| 1章 | 事象と確率 | 第2回 |
| 3章 | 分布の特性値 | 第3回 |
| 4章 | 変数変換 | 第4回 |
| 5章 | 離散型分布 | 第5回 |
| 6章 | 連続型分布・標本分布 | 第6回・第7回 |
| 7章 | 大数の法則・中心極限定理 | 第8回 |
| 2章 | 確率分布と母関数 | 今回 |
第2章を最後に回したので、これで確率パートが全部埋まりました。
振り返ると、母関数を最後に置いた判断は当たっていました。もし第2回あたりでこの章をやっていたら、「 を微分するとモーメントが出る」という手続きだけを覚えて、何のためかは分からないまま通過していたはずです。分布を5つ以上見て、中心極限定理を現象として眺めた後だからこそ、「その全部を1本の関数で扱える」という話に意味が出ました。
順番を組み替えるという判断そのものが、今回いちばん効いた工夫だったかもしれません。
次回
次回からは推定と検定に入ります。第8章「統計的推定の基礎」です。
手元のデータから母集団の値を推し量るとき、何をもって「良い推定」と言うのか。最尤法・不偏性・フィッシャー情報量が出てくる回です。
今回見た指数型分布族の構造が、そこで効いてきます。 を自然パラメータと呼んだあの形が、最尤推定の一般論にそのまま現れるはずです。土台が埋まった状態で、いよいよ本題に入ります。
この連載は、うまくいった記録だけでなく詰まった箇所も含めて書いています。今回は「なぜこの式なのか」を後回しにしたまま便利さだけ受け取っていたことが分かりました。同じく準1級を目指している方、一度挫折した方の参考になれば嬉しいです。