主成分分析:分散が最大の方向を総当たりで探すと固有ベクトル【第24回】
はじめに
第22章は主成分分析です。多変量解析編の最初の回で、この編の土台になります。
前回の最後に「独立な増分に分解する発想が主成分分析でも形を変えて現れる」と書きました。実際そうなりました。今回やることは、データのばらつきを互いに影響しない方向に分けることです。
この章に入る前、私には具体的な弱点がありました。2019年6月の過去問で多次元正規分布が出て、手が完全に止まったのです。分散共分散行列という言葉は知っていても、それが何をしているのか分かっていませんでした。
そこで今回は1変数の正規分布から出発して、2変数に上げるときに何が追加されるのかを図で確かめ直しました。結論を先に書きます。多次元正規分布は1変数の拡張ではなく、同じ式の書き換えでした。 が になっただけです。
そしてこの回の核心は「なぜ分散を最大にする方向を探すと固有値問題になるのか」です。教科書は「ラグランジュの未定乗数法で解くと固有値問題になる」と書いていますが、それではなぜそうなるのかが分かりません。
そこで固有値を一切使わず、角度を 0.05 度刻みで 3601 通り総当たりしてみました。分散が最大になったのは 29.6 度で、値は 1329.3。いっぽう分散共分散行列の最大固有値は 1329.32。ぴったり一致します。この一致がなぜ起きるのかを図で追いました。
もうひとつ驚いたのが寄与率です。「固有値を合計で割るだけ」という説明を読んで、それがなぜ「説明できた割合」になるのか納得できていませんでした。確かめたら、第16回の決定係数と小数第9位まで一致する同じものでした。類比ではありませんでした。
記事の後半では、検証中に見つけた落とし穴も記録します。マハラノビス距離で外れ値を検出しようとしたら、理論値と合わない。原因は外れ値自身が分散共分散行列を膨らませて、自分の異常度を隠していたことでした。
いつものように、出てくる数値はすべて自分で計算し、理論値と突き合わせています。
この回で扱う用語
先に略語と用語を並べておきます。本文では初出時に改めて説明します。
| 用語 | 読み・スペルアウト | 一言で |
|---|---|---|
| 主成分分析 | PCA(Principal Component Analysis) | 変数を減らして情報の損失を最小にする手法 |
| 分散共分散行列 | (シグマの大文字) | 対角に分散、非対角に共分散を並べた行列 |
| 相関行列 | 全変数を標準化してから作った分散共分散行列 | |
| 固有値 | (ラムダ) | 行列を掛けたときの倍率。主成分分析ではその主成分の分散 |
| 固有ベクトル | 行列を掛けても向きが変わらない方向 | |
| 寄与率 | proportion of variance | 固有値 ÷ 固有値の合計 |
| 主成分得点 | PC score | 個体(データ1件ごと)に付く値 |
| 主成分負荷量 | loading | 変数に付く値。主成分と元の変数の相関係数 |
| マハラノビス距離 | Mahalanobis distance | ばらつきの形をものさしに組み込んだ距離 |
| 主成分回帰 | PCR(Principal Component Regression) | 固有値の小さい主成分を捨ててから回帰する |
| VIF | Variance Inflation Factor=分散拡大要因 | 多重共線性の指標。10 を超えると疑わしい |
| OLS | Ordinary Least Squares=通常の最小二乗法 | 第16回でやった普通の回帰 |
何のための手法なのか
定義から入らず、困りごとから始めます。
このブログのアクセス解析には、記事ごとに複数の指標があります。PV、セッション、平均滞在時間、スクロール率、直帰率、被リンク数。6つの数字を同時に睨んでも、どの記事が良いのか判断がつきません。
「PV は多いが滞在時間が短い記事」と「PV は少ないが最後まで読まれている記事」のどちらを評価すべきか。指標が6つあると、記事どうしを並べて比較することすらできません。
ここで欲しくなるのが「6つの数字を2つにまとめる」操作です。2つなら平面にプロットできるので、記事の位置関係が一目で分かります。
これが次元削減(dimensionality reduction)で、主成分分析はその代表的な手法です。目的は3つあります。
| 目的 | 中身 |
|---|---|
| 次元圧縮 | 変数を減らす。6個 → 2個 |
| 可視化 | 減らした結果、平面に描ける |
| 多重共線性の回避 | 相関のある変数を、相関のない変数に組み替える(第16回の問題への対処) |
ただし減らせば情報は失われます。問題は「どう減らせば損失が最小になるか」です。その答えが固有値分解でした。
多次元正規分布:1変数から積み上げる
主成分分析の道具立ては分散共分散行列です。そしてその意味は、多次元正規分布を通すと一番はっきりします。過去問で詰まった場所なので、ここは丁寧に行きます。
ステップ1:1変数の正規分布を部品に分ける
いきなり2変数に行く前に、1変数の式を分解しておきます。
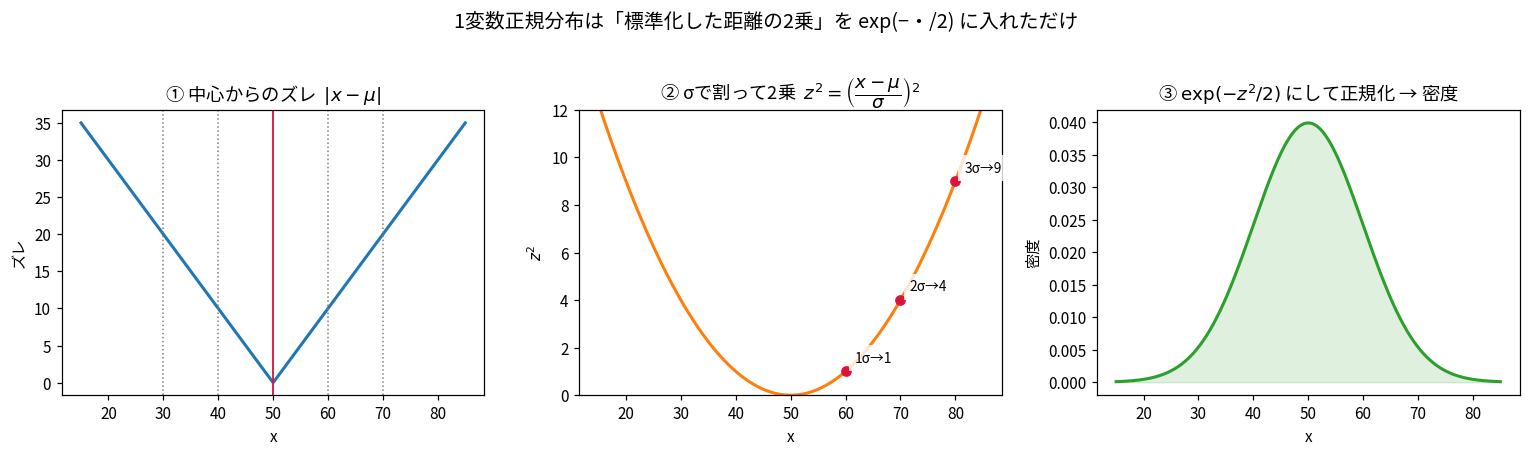
読み方はこうです。正規分布の中身は「中心からどれだけ離れているか」を で割って(ものさしを揃えて)2乗しただけです。中央のパネルを見てください。1σ 離れると 1、2σ で 4、3σ で 9 になります。
1変数の正規分布で本質的なのは という1つの数字だけです。 と前の係数は、その数字を確率の形に整えるための飾りにすぎません。
だから2変数に上げるときの問題は1つに絞られます。2次元での は何か。
ステップ2:2変数だと が作れない
2次元の点 が中心からどれだけ離れているかを測りたい。素朴にやるとこうなります。
と を別々に標準化して足しただけです。両者が独立ならこれで正解ですが、相関があると間違った距離になります。その修正が「非対角成分」の仕事です。
正しい形は、 で割る代わりに行列の逆行列を挟む形になります。
が分散共分散行列です。2次元なら中身はこうなります。
| 場所 | 中身 | 意味 |
|---|---|---|
| 左上(対角) | 方向の広がり | |
| 右下(対角) | 方向の広がり | |
| 右上・左下(非対角) | 2つが連動する度合い。今回の主役 |
ここが私の理解の転換点でした。1変数の が に置き換わっただけなのです。実際、1次元では なので となり、元の式に戻ります。
拡張ではなく、同じ式の書き換えでした。 過去問で手が止まったのは、この対応が見えていなかったからです。
試験で必要になるので、密度の全体も書いておきます。 変数の場合はこうです。
前の係数にある (行列式の平方根)が の多次元版です。1次元なら に戻ります。幾何的には等確率楕円の広さに対応していて、 が「大きい」ほど楕円が広がり、密度は薄くなります。ここも書き換えの対応が付いていました。
なお「 が本質」というのは等高線の形が で決まるという意味に限定しておきます。 の部分を別の関数に替えると、同じ楕円形の等高線を持つ別の分布(楕円分布)になるので、 自体が正規分布を特徴づけています。
ステップ3:非対角成分だけを動かす
対角成分と非対角成分の役割を分離するために、4通りを並べました。①②は非対角が 0、③④で非対角だけを入れています。
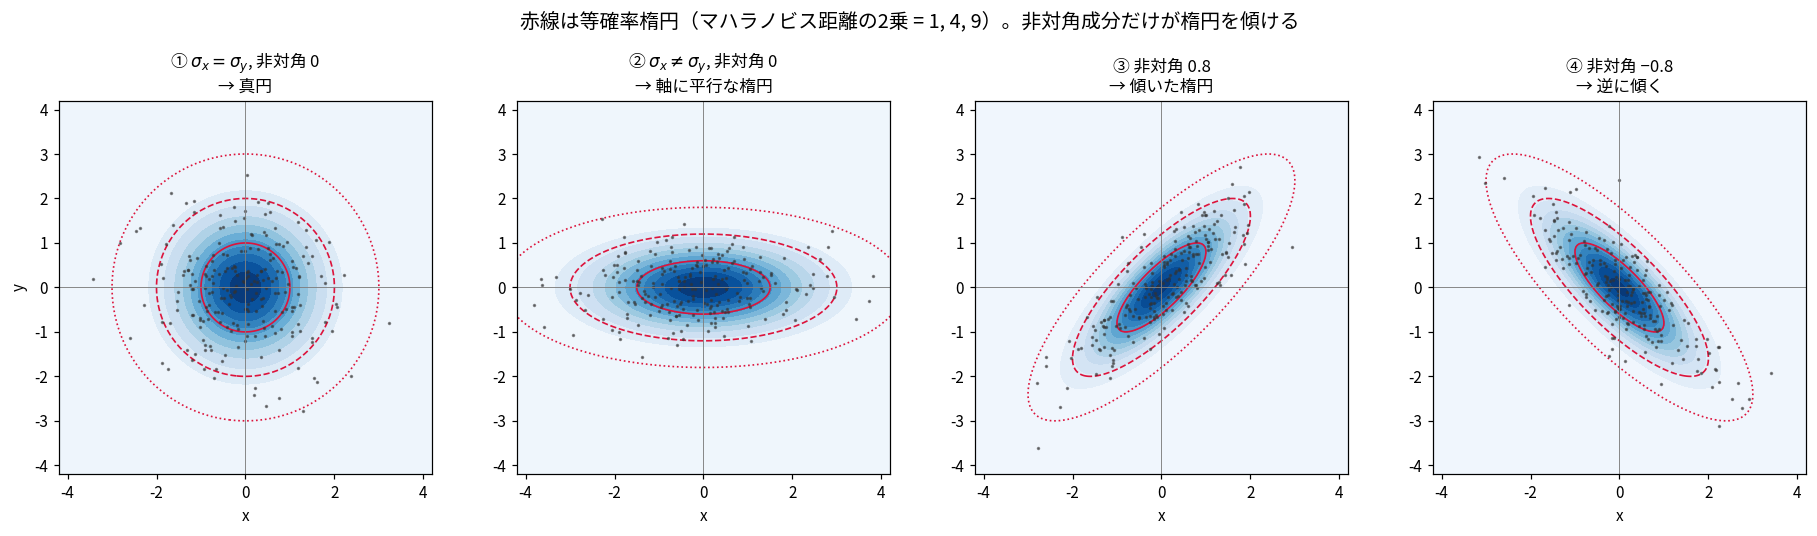
見るべき点は2つあります。
①→②で楕円は伸びるが傾かない。 つまり対角成分は「各軸方向の伸縮」しか担当していません。
②→③で楕円が傾く。 傾きを生むのは非対角成分だけです(非対角が 0 なら絶対に傾きません)。④は符号を反転させた場合で、傾きの向きが逆になります。
ただし傾きの角度そのものは対角成分にも依存します。非対角を 0.8 に固定しても、対角が (1, 1) なら 45.0 度、(2.25, 0.36) なら 20.1 度になります。だから②③は対角を揃えて比べています。また非対角は細長さも変えます(次の節で見ます)。
赤い線が等確率楕円で、内側から に対応します。1変数の 1σ・2σ・3σ の線が、2次元では楕円になったものです。
ただし対応するのは の値だけで、内側に入る確率は一致しません。 ここは混同しやすいので数値を並べます。
| 1次元で内側に入る確率 | 2次元で楕円の内側に入る確率 | |
|---|---|---|
| 1 | 68.3% | 39.3% |
| 4 | 95.4% | 86.5% |
| 9 | 99.7% | 98.9% |
2次元の方が確率が小さくなります(次元が増えると外側に散らばるため)。2次元の確率は で計算できます。これは後半で扱う χ²(2) の性質から出てきます。「2σ の楕円だから95%」とはならないので注意が必要でした。
図が正しいことの確認として、指定した から20万点を発生させ、標本共分散を計算し直しました。
| 指定した (左上, 右上, 左下, 右下) | 標本から計算した共分散 |
|---|---|
| 1, 0, 0, 1 | 1.003, −0.000, −0.000, 1.001 |
| 2.25, 0, 0, 0.36 | 2.247, −0.001, −0.001, 0.359 |
| 1, 0.8, 0.8, 1 | 1.000, 0.797, 0.797, 0.997 |
| 1, −0.8, −0.8, 1 | 0.998, −0.799, −0.799, 1.000 |
非対角成分の正体は「等確率楕円を傾ける唯一の担当」でした。 そしてこれが主成分分析そのものの伏線になります。あとで見るように、主成分分析がやるのは非対角成分を 0 にする座標に移ることだけなので。
共分散と相関係数を分けておく
ここで用語を整理します。私は最初この2つを混同していました。同じものを指しているように見えて、実は別の数字です。
(ロー)が相関係数です。共分散をそれぞれの標準偏差で割っただけ。なぜ割る必要があるのかを数値で見ます。
記事10本について、平均滞在時間とスクロール率を並べたデータを使います。
| 記事 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 平均 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 滞在時間(秒) | 30 | 45 | 50 | 65 | 70 | 85 | 90 | 105 | 110 | 130 | 78.0 |
| スクロール率(%) | 20 | 28 | 25 | 38 | 42 | 45 | 55 | 58 | 62 | 77 | 45.0 |
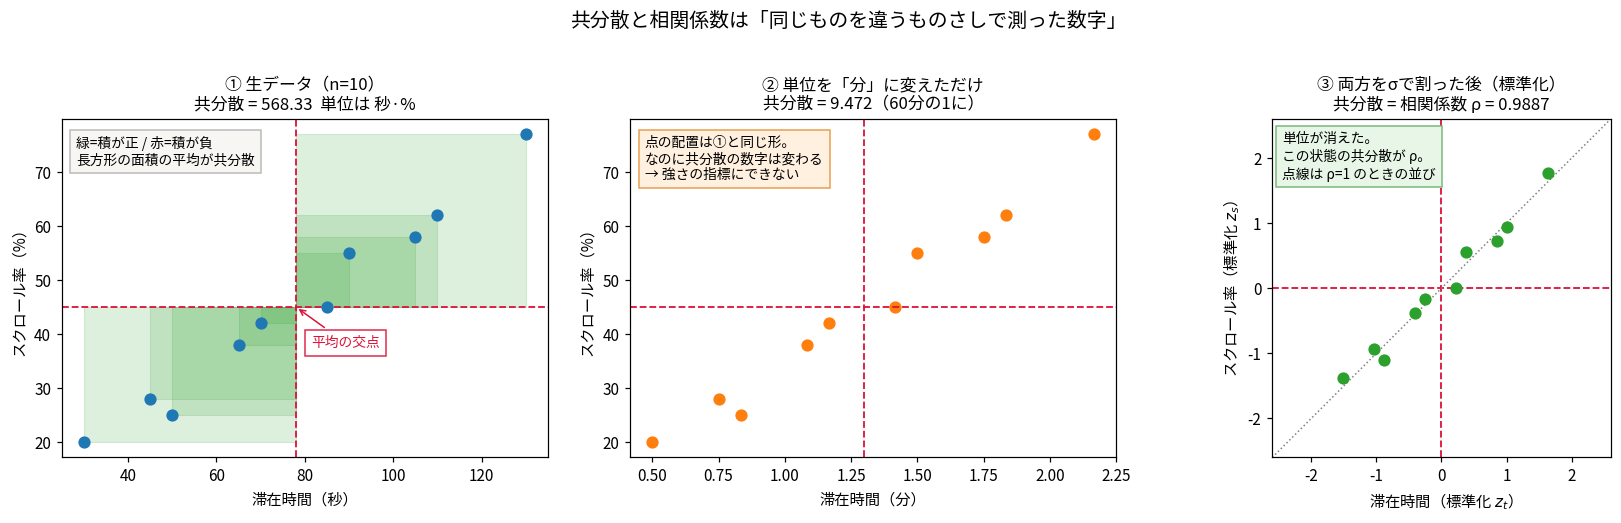
①の長方形が共分散の正体です。各点について「平均からの横のズレ × 縦のズレ」を長方形の面積(符号つき)として描き、その和を で割ったものが共分散です(不偏共分散)。 で割る流儀もありますが、この記事では numpy.cov の既定に合わせて で割っています。
この例では負の点が1つもありません(9点が正、記事6は なので積がちょうど 0)。だから非常に強い正の相関になります。
積 = [1200, 561, 560, 91, 24, 0, 120, 351, 544, 1664]
和 = 5115
和 ÷ (10−1) = 568.3333   ← 図①の数値
(参考:和 ÷ 10 = 511.5。こちらは「平均」だが図の値とは違う)
①と②を見比べてください。 点の並びの形はまったく同じなのに、共分散が 568.33 から 9.472 に変わりました。秒を分にしただけです。
計算を1行ずつ追います。
| 量 | 値 | 単位 |
|---|---|---|
| [滞在時間] | 1006.6667 | 秒² |
| [スクロール率] | 328.2222 | %² |
| 31.7280 | 秒 | |
| 18.1169 | % | |
| [滞在, スクロール] | 568.3333 | 秒·% ← 意味不明な単位 |
| 0.988727 | なし(無次元) |
共分散の単位は「秒·%」のような掛け算した単位になります。これでは大きさを比較できません。「568 は大きいのか」に答えられないのです。単位を変えるだけで数字が60分の1になってしまうので。
は で割ったことで無次元になります。だから大きさを比較できます。検証すると、秒→分に変えたとき共分散は 568.3333 → 9.4722(ちょうど 1/60)、 は 0.988727 のまま不変でした。
そして が必ず −1 以上 +1 以下に収まるのは、無次元だからではなくコーシー・シュワルツの不等式 が成り立つからです。この2つは別の事実なので分けておきます(無次元でも有界でない量はあります。歪度がその例です)。
そしてここが重要です。相関行列 は「標準化してから作った 」です。 別の道具ではありません。上の図③で見た通り、標準化すると分散が 1・共分散が になるので、 を作り直すと自動的に になります。
| (分散共分散行列) | (相関行列) | |
|---|---|---|
| 対角成分 | 1006.667 と 328.222 | 1 と 1(必ず 1) |
| 非対角成分 | 568.333(単位つき) | 0.988727(=) |
| 固有値 | 1329.3164 と 5.5725 | 1.988727 と 0.011273 |
| 固有値の和 | 1334.889 | 2.000(=変数の数) |
相関を強めると楕円が細長くなる
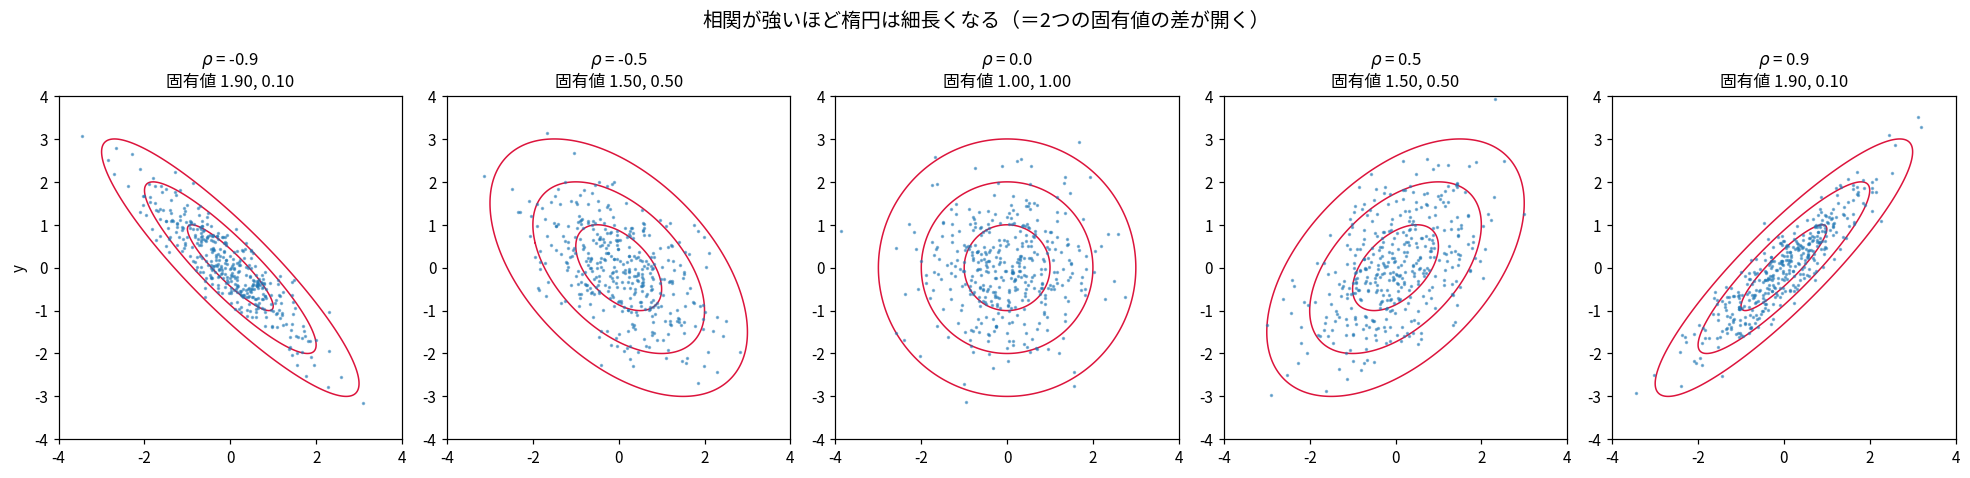
では真円、相関が強まるほど細長くなります。この図は対角成分を 1 に固定して非対角だけを動かしているので、非対角成分が細長さを変えていることが分かります(傾きはどれも45度のまま)。タイトルの固有値に注目してください。楕円の細長さ(アスペクト比)は 、つまり固有値の比の平方根です(差ではありません)。 なら 倍の細長さになります。
| 固有値(大) | 固有値(小) | 理論値 / | 楕円の形 | |
|---|---|---|---|---|
| −0.9 | 1.90 | 0.10 | 1.90 / 0.10 | 非常に細長い(左上向き) |
| −0.5 | 1.50 | 0.50 | 1.50 / 0.50 | やや細長い |
| 0.0 | 1.00 | 1.00 | 1.00 / 1.00 | 真円 |
| +0.5 | 1.50 | 0.50 | 1.50 / 0.50 | やや細長い |
| +0.9 | 1.90 | 0.10 | 1.90 / 0.10 | 非常に細長い(右上向き) |
2変数の相関行列(対角が 1)の場合、固有値は と という手計算できる形になります。上の表は numpy.linalg.eigh の実測値で、理論値と完全に一致しました。
これは2変数限定の話です。 変数で全ペアの相関が等しく の場合(等相関)は が1個と が 個になり、一般の相関行列ではこうした簡単な形にはなりません。実際、あとで扱う6指標の相関行列の固有値は 3.349, 2.560, 0.066, 0.025, 0.0002, 0.00004 で、 の形をしていません。
固有値の和はどの行でも 2.00 で一定です。この「和が保存される」性質が、あとで寄与率の分母になります。
なぜ分散最大化が固有値問題になるのか
ここが今回の核心です。教科書は「ラグランジュの未定乗数法で解く」と書きますが、それではなぜ固有値が出てくるのかが見えません。順序を逆にします。まず総当たりで探して、一致に気づいてから理由を考えます。
やりたいことを図にする
主成分分析の目的を一文で言うと、2つの数字で表されているデータを1つの数字で表したい。情報の損失をできるだけ小さくして。
「1つの数字にする」とは、平面上の点を1本の直線の上に落とすことです(射影)。問題はどの向きの直線を選ぶかです。
選ぶ基準として「落とした後の分散が最大になる向き」を採ります。なぜ分散かというと、分散が大きい=点どうしがよく離れて残っている=元の違いが保たれているということなので。逆に分散が小さい向きに落とすと、全部が団子になって区別がつかなくなります。
先ほどの n=10 のデータ(滞在時間とスクロール率)で、角度を 0 度から 180 度まで 0.05 度刻みで 3601 通り試しました。
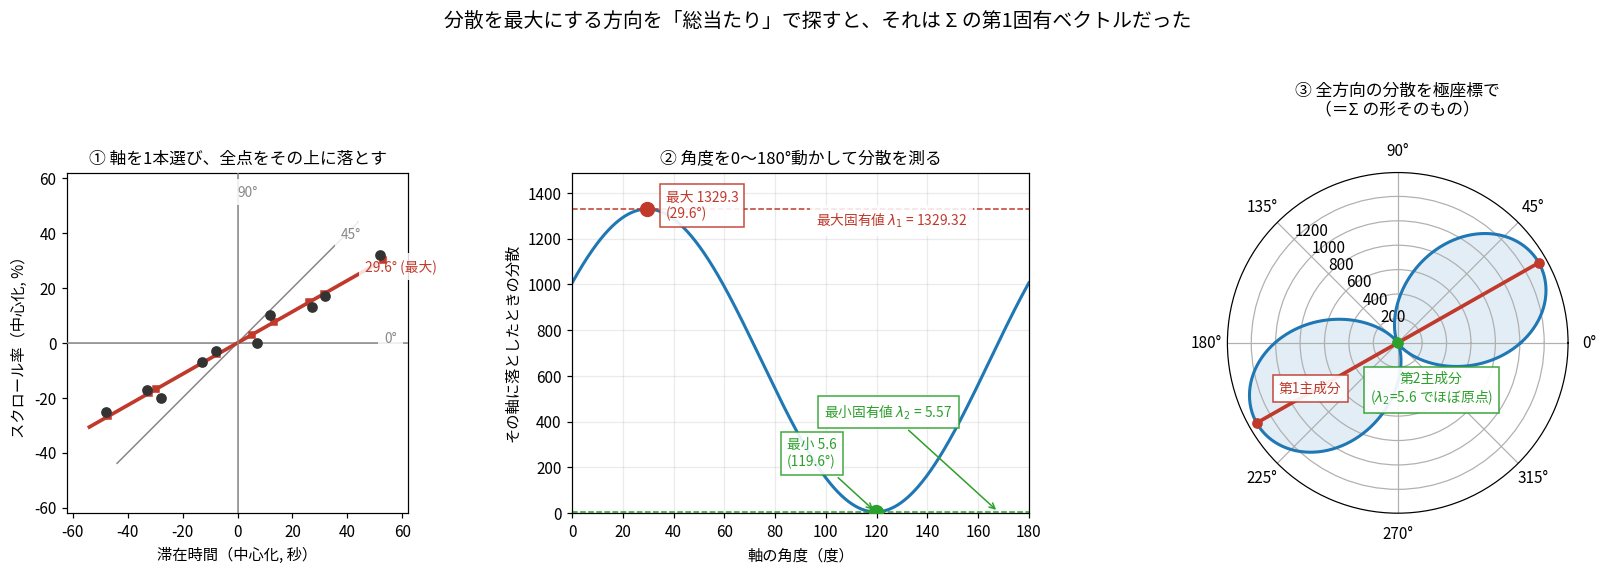
①で赤い線が「選ばれた向き」、赤い四角がそこに落とした点です。②が総当たりの結果で、29.6 度で最大 1329.3、119.6 度で最小 5.6 になりました。
この2つの角度差はちょうど 90.0000 度でした。偶然ではありません(後述します)。
③は同じことを極座標にしたものです。原点からの距離がその向きの分散です。この8の字の形が の形そのものです。
ここまで固有値を一切使っていません。 ただの総当たりです。にもかかわらず、②の破線を見てください。
| 総当たりで見つけた値 | の固有値 | 差 | |
|---|---|---|---|
| 最大 | 1329.316304 | 1329.316406 | 1.02×10⁻⁴ |
| 最小 | 5.572585 | 5.572483 | 1.02×10⁻⁴ |
| 最大の角度 | 29.6000° | 29.5841° | 0.016° |
ぴったり一致します。 差はスキャンの刻み幅 0.05 度による誤差で、刻みを細かくすればいくらでも縮みます。
まず固有ベクトルを定義する
なぜ一致するのかを説明する前に、固有ベクトルを定義します。ここを飛ばすと先に進めません。
第22回で「行列を掛けても向きが変わらない方向」という言い方をしました。それを図にします。行列を「向きを入れると別の向きを返す装置」として見るのが要点です。
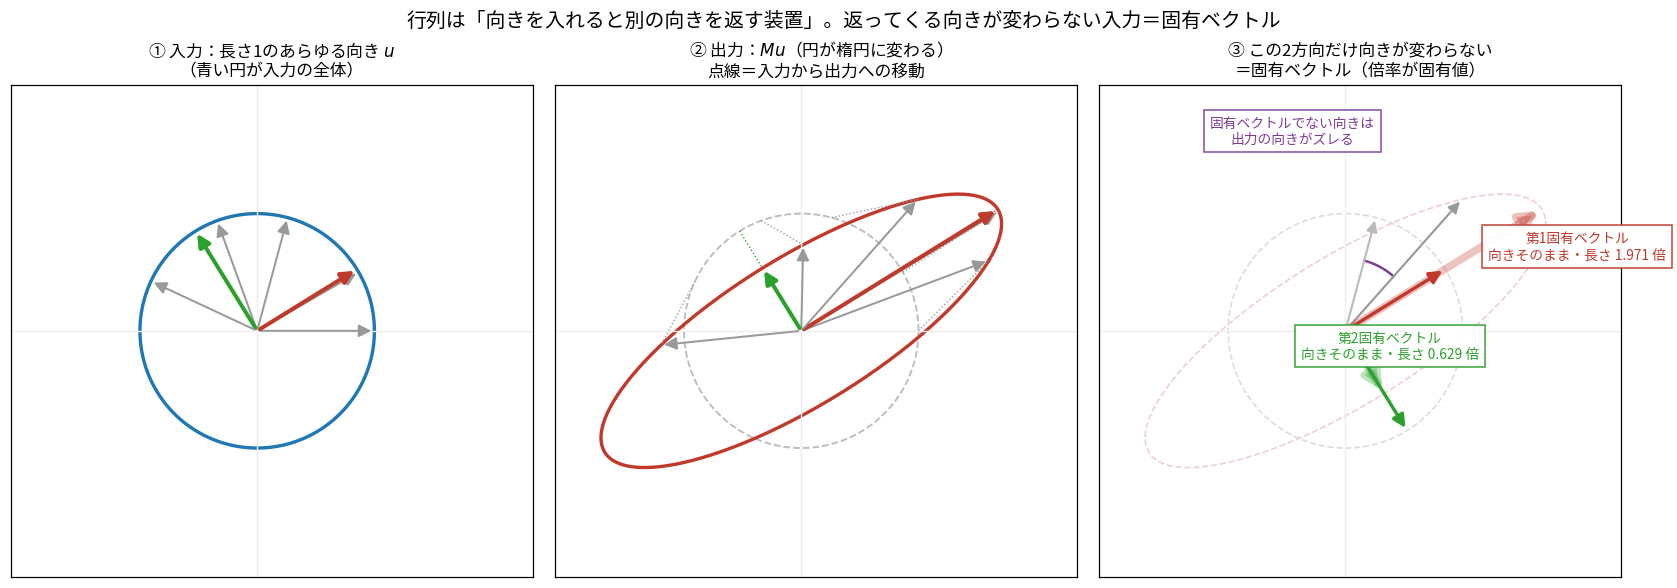
この図だけは、見やすさのため穏やかな行列 を使っています(実データの は相関 0.99 で楕円が潰れてしまうため)。
①→②で、行列を掛けると単位円が楕円に変形します。ほとんどの矢印は向きも長さも変わります。
ところが③を見ると、2本だけ向きが変わらず長さだけ変わる特別な向きがあります。これが固有ベクトル(eigenvector)で、その倍率が固有値(eigenvalue、)です。この例では 1.971 倍と 0.629 倍。
左辺は行列を掛けた結果、右辺はただの定数倍です。実データの で確認しました。
u₁ = [−0.8696, −0.4937]
  Σu₁   = [−1156.016, −656.284]
  λ₁·u₁ = [−1156.016, −656.284]   一致

比較:固有ベクトルでない u = [1, 0] のとき
  Σu = [1006.667, 568.333]  ← [1, 0] の定数倍ではない(第2成分が生えた=向きが変わった)
核心: が とズレている限り、まだ分散を増やせる
分散を式にすると、 という掛け算が現れます。
この式がどこから来るのかは次の節で導出します。いまは形だけ受け取ってください。
内積は「2つのベクトルがどれだけ同じ向きを向いているか × 長さ」です。つまり と の関係が分散を決めている。そこで筋道はこうなります ── まず「向きが完全に揃う方向」を探し、そのうち分散が大きいものを選ぶ。
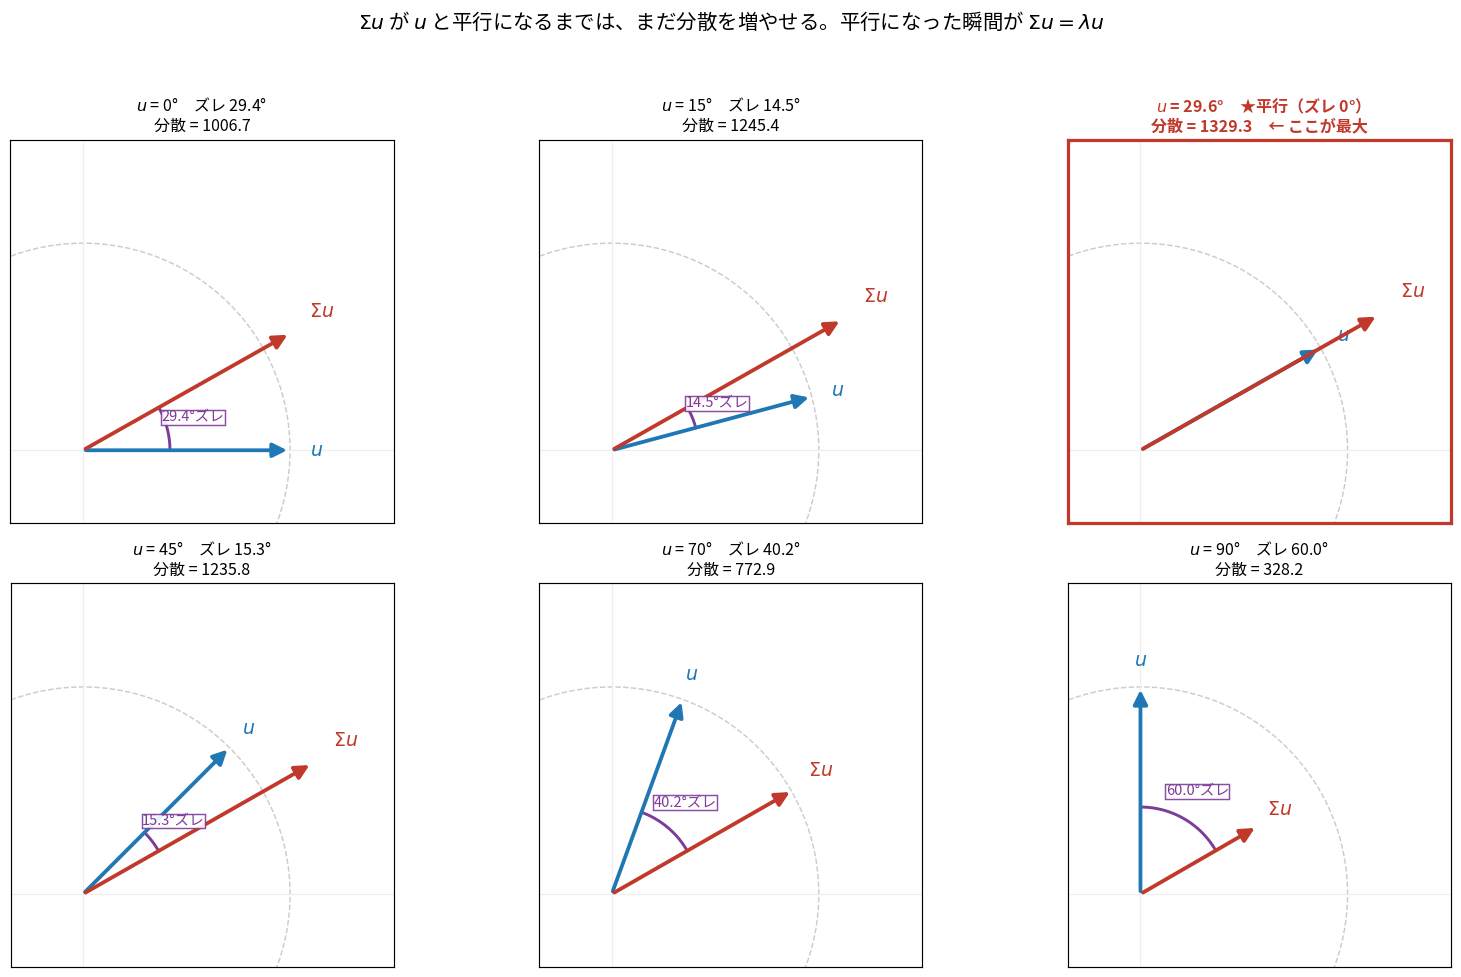
紫の弧が と のズレです。ズレが 0 のところで分散が停留していることを確認してください(この図の範囲では最大になっていますが、範囲を広げると事情が変わります。次の節で扱います)。
| の角度 | と のズレ | 分散 |
|---|---|---|
| 0° | 29.45° | 1006.67 |
| 15° | 14.52° | 1245.39 |
| 29.5841° | 0.00° | 1329.32 ← 最大 |
| 45° | 15.35° | 1235.78 |
| 70° | 40.21° | 772.90 |
| 90° | 59.99° | 328.22 |
答えはこうです。 分散は「 と の内積」なので、 が からズレている限り、 をズレの方向へ少し回せば分散を動かせます。動かせなくなる(=停留する)のは、回す先がなくなったとき、つまり が と完全に平行になったときです。
「平行である」を式で書いたものが ── 固有値問題の定義そのものです。
だから「分散を最大にする方向を探す」問題は、探し方を工夫した結果として固有値問題になるのではなく、停留する条件を書き下すと自動的に固有値問題の形になるのでした。ここが納得できた瞬間、この章の見通しが一気に良くなりました。
ただし「ズレ0=最大」ではない(査読で気づいた誤り)
最初に書いたとき、私は「ズレが小さいほど分散が大きい」と説明していました。これは誤りです。 上の表が 0〜90 度しかサンプルしていないので、たまたま単調に見えていただけでした。範囲を広げて測り直します。
| の角度 | ズレ | 分散 |
|---|---|---|
| 110° | 78.99° | 42.27 |
| 115° | 82.42° | 14.03 |
| 119.5841° | 0.00° | 5.57 ← 最小なのにズレ0 |
| 125° | 82.05° | 17.36 |
| 135° | 73.71° | 99.11 |
最小固有値の方向でも、ズレはちょうど 0 です。 115 度(ズレ 82.42 度)で分散 14.03 なのに、119.58 度(ズレ 0 度)で分散 5.57 まで下がっています。ズレが減る方向に分散も減っている。
は停留点の条件であり、最大・最小の両方(変数が3個以上なら鞍点も)が該当します。固有値問題は「最大の条件」ではなく「停留の条件」を与えているわけです。
そのうえで、どの停留点がどれかは固有値の大小で決まります。
| 方向 | 固有値 | 何か |
|---|---|---|
| 29.5841° | = 1329.32 | 最大(第1主成分) |
| 119.5841° | = 5.57 | 最小(2変数なので第2主成分) |
だから実際に第1主成分を求めるときは、平行になる方向を全部(p 本)見つけて、そのうち固有値が最大のものを選ぶという手順になります。「最大固有値を使う」という言い方の意味がここでようやく分かりました。
が分散そのものになる理由
上の式に を代入するだけです。
は長さ1に決めてあるので 。よって固有値がそのまま「その主成分の分散」です。これが「最大固有値を使う」理由であり、あとで寄与率の話につながります。
はどこから来たのか
ここは飛ばしやすい箇所ですが、飛ばすと納得できません。 は定義ではなく、導ける事実です。
定義なのは内積だけ
まず記号です。 は「向き」を表す2つの数字の組で、(転置)は「縦に並んだものを横に倒す」記号です。そして横ベクトル × 縦ベクトルは「成分ごとに掛けて足す」という約束になっています。
これが内積の定義です。 ここだけが定義で、あとは全部これの組み合わせです。
そして幾何的な意味はこうです。 の長さが1のとき、 は「点 を の直線上に垂直に落としたときの、原点から見た符号つきの座標」になります。これが射影です。
「距離」と書きたくなりますが、距離は負にならないので不正確です。 の向きと逆側に落ちた点は負の値になります(次の表で のように負が並ぶのはこのためです)。
段階1:各点を45度の軸に落とす
の場合を、10点すべてについて計算します。
| i | t−t̄ | s−s̄ | |||
|---|---|---|---|---|---|
| 1 | −48 | −25 | 0.7071×(−48) + 0.7071×(−25) | −51.6188 | 2664.50 |
| 2 | −33 | −17 | 0.7071×(−33) + 0.7071×(−17) | −35.3553 | 1250.00 |
| 3 | −28 | −20 | 0.7071×(−28) + 0.7071×(−20) | −33.9411 | 1152.00 |
| 4 | −13 | −7 | 0.7071×(−13) + 0.7071×(−7) | −14.1421 | 200.00 |
| 5 | −8 | −3 | 0.7071×(−8) + 0.7071×(−3) | −7.7782 | 60.50 |
| 6 | 7 | 0 | 0.7071×7 + 0.7071×0 | 4.9497 | 24.50 |
| 7 | 12 | 10 | 0.7071×12 + 0.7071×10 | 15.5563 | 242.00 |
| 8 | 27 | 13 | 0.7071×27 + 0.7071×13 | 28.2843 | 800.00 |
| 9 | 32 | 17 | 0.7071×32 + 0.7071×17 | 34.6482 | 1200.50 |
| 10 | 52 | 32 | 0.7071×52 + 0.7071×32 | 59.3970 | 3528.00 |
| 合計 | ≈0 | 11122.00 |
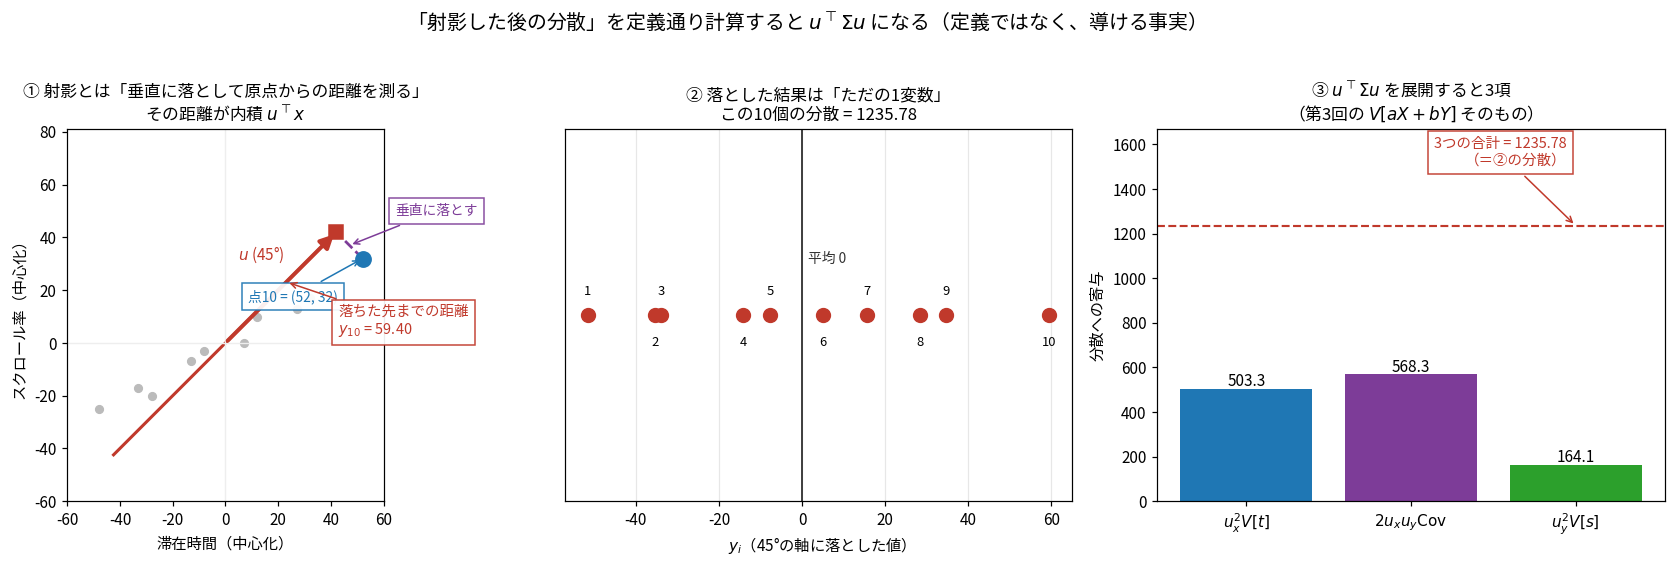
図①が射影の様子です。点10(52, 32)を45度の線に垂直に落とすと、原点からの距離が 59.40 になります。表の と同じ数字です。
図②が結果です。落とした後はただの1変数(10個の数字が数直線上に並んだだけ)。
段階2:定義通りに分散を計算する
特別なことは何もしません。第3回でやった分散の定義そのままです。平均が 0 なので、偏差は値そのものです。
段階3: で計算する
いっぽう、射影を1回もせずに と だけから出します。
Σ = [[1006.6667, 568.3333], [568.3333, 328.2222]]

まず Σu を計算(行列 × 縦ベクトル = 各行と内積を取る)
  1行目: 1006.6667×0.7071 + 568.3333×0.7071 = 1113.6932
  2行目:  568.3333×0.7071 + 328.2222×0.7071 =  633.9605
  → Σu = [1113.6932, 633.9605]

次に u と Σu の内積
  0.7071 × 1113.6932 + 0.7071 × 633.9605 = 1235.777778
段階2 = 1235.777778、段階3 = 1235.777778、差 = 0.00。 同じ数になりました。だから は定義ではなく、計算すると一致するという事実です。
45度だけの偶然ではないことを、10度刻みで確認しました。
| の角度 | 射影して分散を計算 | |
|---|---|---|
| 0° | 1006.666667 | 1006.666667 |
| 30° | 1329.246660 | 1329.246660 |
| 60° | 990.024438 | 990.024438 |
| 90° | 328.222222 | 328.222222 |
| 120° | 5.642229 | 5.642229 |
| 150° | 344.864451 | 344.864451 |
最大の差は 4.55×10⁻¹³(倍精度計算の丸め誤差)。全角度で一致します。
なぜ一致するのか:第3回とつながる
を展開すると、3つの項になります。
| 項 | 計算 | 値 |
|---|---|---|
| 0.7071² × 1006.6667 | 503.333333 | |
| 2 × 0.7071 × 0.7071 × 568.3333 | 568.333333 | |
| 0.7071² × 328.2222 | 164.111111 | |
| 合計 | 1235.777778 |
これは第3回でやった公式そのものです。
射影 は「2つの変数の重み付き足し算」にすぎません。だからその分散は第3回の公式で計算できます。 は、この公式を行列で書き直した略記でした。 新しい概念ではありませんでした。
「内積」と呼ぶと何が便利なのか
を と読むと、内積のもう1つの表し方が使えます。
なので消えます。実データで検証しました。45度のとき 、ズレ角 15.3497 度、。掛けると 1235.777778 で完全一致です。
これで前の節の議論がつながります。 ズレ角が動くと が動くので分散も動く。逆にズレ角 0 度では が停留する( の微分がそこで 0 になる)ので、分散も停留します。厳密には分散は という積なので 側も確認が必要ですが、こちらもその点で停留しています(29.58度の前後で 1329.266 → 1329.316 → 1329.266)。だから停留の条件が「平行」、つまり になるのです。
なお は最大ですが、分散が最大になるとは限りません。分散は という積なので、 の方が小さければ全体は小さくなります。実際、最小固有値の方向では でも しかありません。
第22回の固有ベクトルと同じものか
私が気になっていた点です。同じ道具で、使い方が違うという理解で正しいです。ただし「何を表す行列か」が違うので整理します。
| 第22回:マルコフ連鎖 | 今回:主成分分析 | |
|---|---|---|
| 行列の中身 | 推移確率行列 (状態 i から j へ移る確率) | 分散共分散行列 |
| 行列の性質 | 各行の和が 1。対称でない | 対称()かつ半正定値 |
| 使う固有値 | 最大の (次に2番目…) | |
| なぜその固有値か | 「掛けても変わらない」=分布が動かない状態を探しているから。1 という値に意味がある | がそのまま分散なので、大きいほど情報が多い。値の大小に意味がある |
| 固有ベクトルの意味 | 定常分布(確率の配分) | 主成分の向き(座標軸) |
| 固有値は実数か | 複素数になりうる(非対称だから)。eig が必要 | 必ず実数、しかも 0 以上。異なる固有値の固有ベクトルは必ず直交。eigh が使える |
対称行列であることが決定的です。 は対称なので、固有ベクトルが必ず直交することが数学的に保証されます。だから総当たりのスキャンで、最大 29.6 度と最小 119.6 度の差がちょうど 90.0000 度になったわけです。偶然ではなく対称性の帰結でした。
これが「第2主成分は第1主成分と直交する」という性質の出どころです。
ただし正確に言うと、第2主成分の定義は「第1主成分と直交する方向のうち分散が最大のもの」で、直交は制約として課されています。ポイントは制約付きの解がちょうど第2固有ベクトルになり、それが自動的に第1主成分と直交していることです(制約を外せば第1主成分がもう一度出てくるので、制約自体は効いています)。直交性を人為的に押し付けた結果ではない、という意味で理解しておきます。
なお固有値が重複する場合(真円のように )は固有ベクトルの選び方に自由度が出ますが、その中から直交する組を選べることは保証されています。
2×2 の固有値を手で求める
線形代数の計算に自信がなかったので、実データで型を1回通しました。2×2 なら3ステップです。
- トレース(対角の和)を出す:
- 行列式を出す:
- を解の公式で解く
判別式 = 1334.8889² − 4 × 7407.5926 = 1752297.9753,  √ = 1323.7439
λ = (1334.8889 ± 1323.7439) / 2
  λ₁ = 1329.3164   λ₂ = 5.5725

numpy.linalg.eigh の結果: λ₁ = 1329.316406, λ₂ = 5.572483   一致
検算が2本あります。 試験で計算ミスを見つけるのに使えます。
| 検算 | 左辺 | 右辺 | |
|---|---|---|---|
| 固有値の和 = トレース | 1329.3164 + 5.5725 = 1334.8889 | 1334.8889 | 一致 |
| 固有値の積 = 行列式 | 1329.3164 × 5.5725 = 7407.5926 | 7407.5926 | 一致 |
固有ベクトルは の1行目を書くだけです。
(1006.6667 − 1329.3164)·u_x + 568.3333·u_y = 0
→ u_y / u_x = −(1006.6667 − 1329.3164) / 568.3333 = 0.567712  (=傾き)
→ 角度 = arctan(0.567712) = 29.5841°   ← 総当たりで見つけた 29.6° と一致
→ 長さ1に正規化: [0.869632, 0.493701]

eigh の出力: [−0.869632, −0.493701]   ← 符号が逆だが同じ直線
符号は決まりません。 が固有ベクトルなら も固有ベクトルです()。だから主成分の「向き」は決まりますが「正の側がどちらか」は決まりません。ソフトによって主成分得点の符号が反転することがあるのはこのためで、解釈上の意味はありません。
主成分分析は「非対角成分を 0 にする座標変換」
ここで最初の伏線を回収します。主成分の座標に移ってから分散共分散行列を計算し直すと、こうなります。
元の座標での Σ = [[1006.667, 568.333], [568.333, 328.222]]

主成分得点 Z = X_中心化 · V を計算して、その共分散行列:
[[1329.316406, −0.000000], [−0.000000, 5.572483]]
  非対角成分の実測値 = −8.095 × 10⁻¹⁴(数値誤差。実質 0)
主成分分析の正体は「非対角成分が 0 になる座標系に移ること」でした。 楕円が傾いていた座標から、楕円の軸に沿った座標へ乗り換える。
非対角成分が 0 ということは主成分どうしは無相関です。これが「多重共線性の回避」に使える理由です(相関がある変数を、相関のない変数に組み替えたわけなので)。
なお無相関は独立とは違います。共分散が 0 でも独立とは限りません(元のデータが多変量正規分布に従うなら無相関から独立が導けますが、一般には導けません)。主成分分析が保証するのは無相関までです。
そして分散の総量は保存されます。
元の座標: V[滞在] + V[スクロール] = 1006.666667 + 328.222222 = 1334.888889
主成分の座標: λ₁ + λ₂ = 1329.316406 + 5.572483 = 1334.888889   完全一致
座標を回してもばらつきの総量は変わりません(対角成分の和=トレースが保存される)。変わるのはその総量をどう配分するかだけです。元の座標では 1006.7 と 328.2 に分かれていたものが、主成分の座標では 1329.3 と 5.6 という極端な配分になりました。
寄与率はなぜ「説明できた割合」になるのか
ここから変数を増やします。記事12本について6つの指標を並べたデータを使います(実際のアクセス解析の構造に寄せた架空データ)。
| 記事 | PV | セッション | 平均滞在秒 | スクロール率% | 直帰率% | 被リンク数 |
|---|---|---|---|---|---|---|
| ふるさと納税2025 | 4200 | 3100 | 185 | 72 | 38 | 14 |
| 信用取引リスク | 1850 | 1420 | 210 | 78 | 32 | 9 |
| Jamstack入門 | 980 | 760 | 165 | 65 | 45 | 6 |
| Obsidian運用 | 1200 | 910 | 240 | 82 | 28 | 7 |
| 統計検定準1級① | 620 | 480 | 320 | 88 | 22 | 4 |
| 統計検定準1級② | 540 | 410 | 295 | 85 | 25 | 3 |
| Serafina | 310 | 260 | 95 | 42 | 68 | 1 |
| Ventuno | 280 | 230 | 88 | 38 | 71 | 1 |
| AWS移行記録 | 750 | 580 | 275 | 80 | 30 | 5 |
| ふるさと納税計算 | 2400 | 1800 | 155 | 68 | 41 | 11 |
| KaTeX導入 | 430 | 340 | 230 | 76 | 34 | 2 |
| GA4設定 | 890 | 680 | 198 | 74 | 36 | 4 |
前節で確認した通り、分散の総量は座標を回しても保存されます。ここが割合の分母になります。
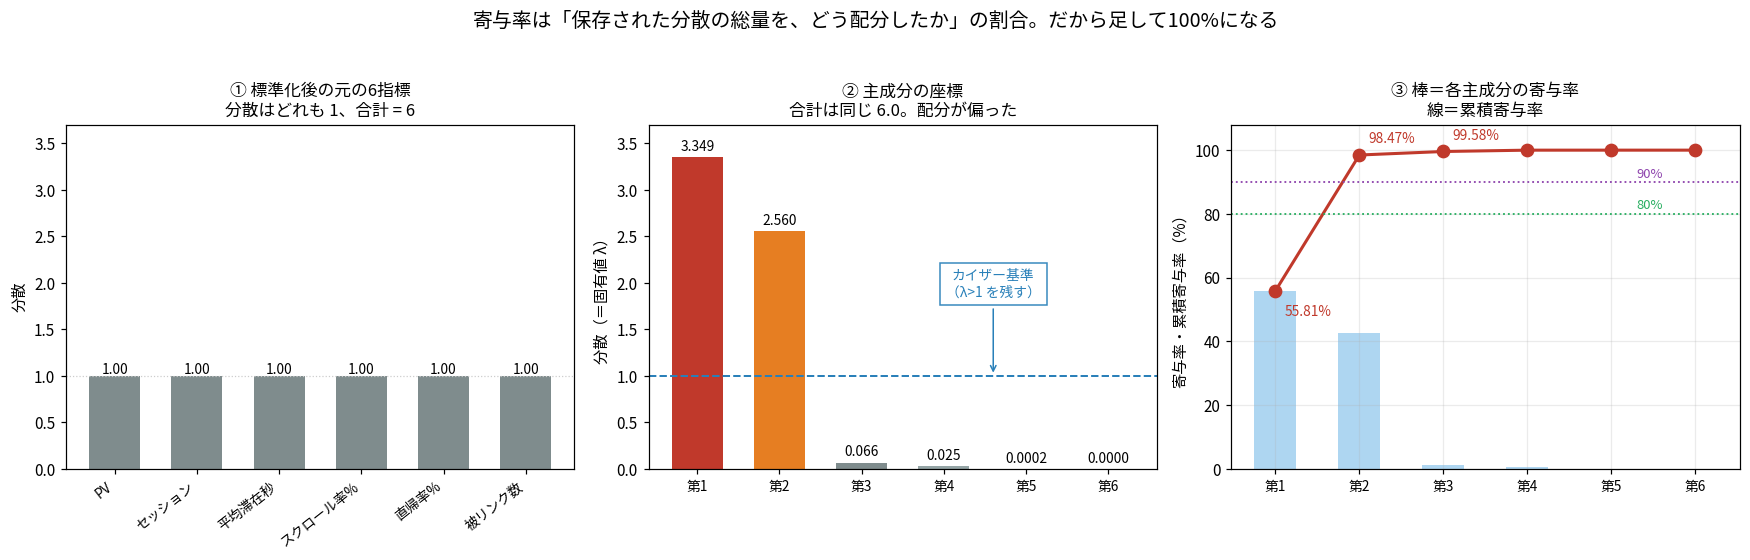
①→②が要点です。標準化すると各指標の分散はどれも 1 になり、合計 6。主成分の座標に移ると 3.349, 2.560, 0.066, 0.025, 0.0002, 0.0000 になりますが、合計は 6.000 のままです。
総量が変わらず配分だけが変わるので、「第1主成分が総量の何割を取ったか」が意味のある割合になります。
決定係数との関係は「類比」ではなく「同じもの」だった
私が確かめたかったのはここです。「第16回の決定係数と似た話なのか」。似ているどころではありませんでした。
k 個の主成分だけで元データを復元して、残差を測りました。
全分散 = 6.000000
k個で復元した予測値 X̂ = Z_1..k · V_1..k^⊤
説明率 = 1 − (残差の分散 ÷ 全分散)   ← 決定係数と同じ形
| k(使う主成分の数) | 復元から計算した説明率 | 累積寄与率 |
|---|---|---|
| 1 | 0.558142887 | 0.558142887 |
| 2 | 0.984726599 | 0.984726599 |
| 3 | 0.995764296 | 0.995764296 |
| 4 | 0.999960274 | 0.999960274 |
| 5 | 0.999993318 | 0.999993318 |
| 6 | 1.000000000 | 1.000000000 |
小数第9位まで一致しました。 決定係数が だったのと同じ構造で、累積寄与率は「主成分で近似したときの決定係数」です。
違いは1点だけです。回帰では という目的変数への当てはまりを測り、主成分分析ではデータ自身への当てはまりを測る。測り方の構造は完全に同じでした。
ただしこの一致には条件が2つあります(自分で試して気づきました)。
(1) 主成分分析と同じ計量で残差を測ること。 「相関行列で主成分分析したのに、残差は生の単位で測る」という取り違えをすると、k=1 で 0.5553 になり累積寄与率 0.5581 とずれます。
(2) 全変数を合計した分散に対する割合であること。 変数ごとの は一致しません。
| 指標 | k=1 での変数別 |
|---|---|
| PV | 0.5561 |
| セッション | 0.5554 |
| 平均滞在秒 | 0.3329 |
| スクロール率% | 0.6088 |
| 直帰率% | 0.6130 |
| 被リンク数 | 0.6826 |
| 平均 | 0.558143 ← 累積寄与率と一致 |
一致するのは平均だけです。 平均滞在秒は 0.333 しか復元できていません。だから「第1主成分で各指標が56%説明できる」と読むのは誤りで、正しくは「全体を平均すると56%」です。この性質はフロベニウスノルムでの最良近似(Eckart-Young の定理)から来ています。
主成分をいくつ残すか
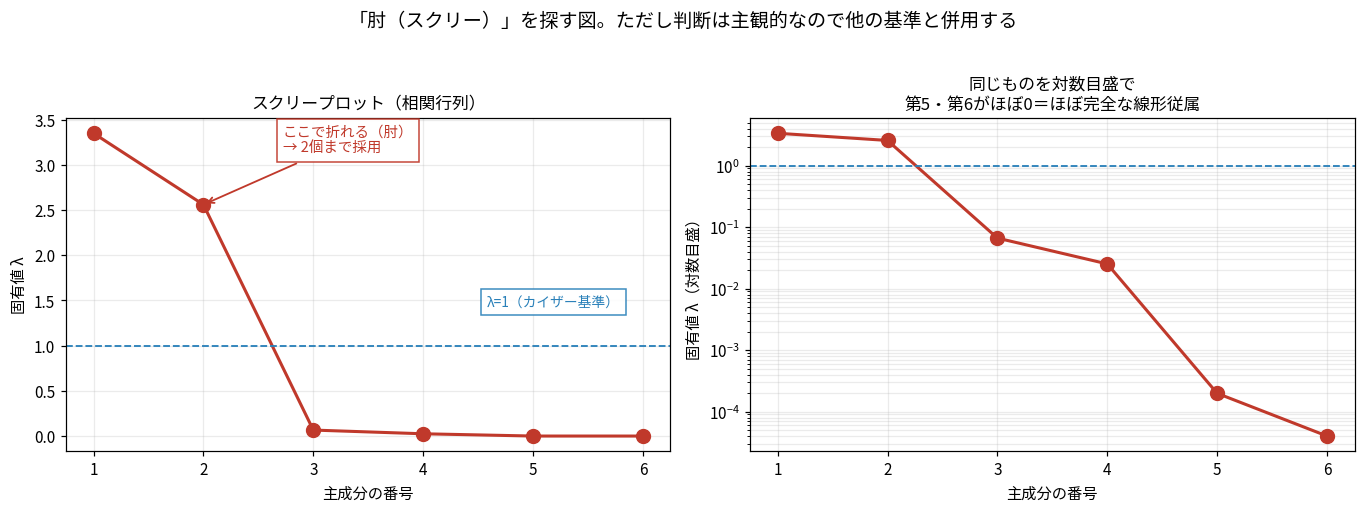
スクリープロットは固有値を大きい順に並べた図です。「急に落ちて平らになる場所(肘)」の手前までを採用します。この例では第2主成分の後で崖のように落ちているので2個。
右の対数目盛版を見ると、第5・第6主成分の固有値が 0.0002 と 0.00004 でほぼ 0 です。これは指標の間にほぼ完全な線形関係があることを意味します。
ほぼ 0 の固有値が2つあるので、ほぼ完全な線形関係が2本あるはずです(必ずしも2変数のペアとは限りません)。固有ベクトルを見ると、この例では2組のペアでした。
| 主成分 | 固有値 | 主に担っている変数 | その相関 |
|---|---|---|---|
| 第6(最小) | 0.00004 | PV(−0.671)とセッション(+0.700) | 0.9999 |
| 第5 | 0.0002 | スクロール率(−0.680)と直帰率(−0.691) | −0.9998 |
最小固有値の固有ベクトルは「ほぼ一定になってしまう線形結合」を表します。 PV とセッション(相関 +0.9999)では符号が逆になって差を取り、スクロール率と直帰率(相関 −0.9998)では同符号になって和を取っています。負の相関なら和がほぼ一定になるので、符号の付き方が逆になります。
どちらもその線形結合がほぼ一定=その方向にばらつきがないという同じ関係です。
| 基準 | 考え方 | この例での答え |
|---|---|---|
| カイザー基準 | 相関行列の固有値が 1 を超えるものを残す。「1つの指標分(=標準化後の分散1)より多くを説明していなければ、まとめる意味がない」という理屈 | 2 個 |
| スクリープロット | 固有値の折れ線の「肘」を目で探す | 2 個 |
| 累積寄与率 80% | 目的に応じた閾値で切る | 2 個 |
| 累積寄与率 90% | 同上 | 2 個 |
カイザー基準には注意点があります。「固有値 > 1」は相関行列を使ったときだけ意味を持ちます。分散共分散行列の固有値は単位に依存するので(この例では 1989946 など)、1 と比べても無意味です。
またスクリープロットの「肘」の判断は主観的です。この例は差が極端なので明快ですが、なだらかに減る場合は人によって答えが変わります。複数の基準を併用し、最後は解釈可能性で決めるのが実務です。
主成分得点と主成分負荷量
混同しやすい2つなので先に分離します。どちらも「主成分と何かの関係」を表す数字ですが、対象が違います。
| 対象 | 個数 | 意味 | |
|---|---|---|---|
| 主成分得点 | 個体(この例では記事) | n 個 | 「この記事は第1主成分の値がいくつか」 |
| 主成分負荷量 | 変数(この例では指標) | p 個 | 「この指標は第1主成分とどれくらい相関しているか」 |
見分け方は簡単です。得点は記事12本ぶん、負荷量は指標6個ぶんあります。
主成分得点(記事ごと・12個)
| 記事 | 第1主成分 | 第2主成分 |
|---|---|---|
| ふるさと納税2025 | +3.0595 | +2.9347 |
| 信用取引リスク | +1.2761 | +0.3730 |
| ふるさと納税計算 | +1.1264 | +1.7696 |
| Obsidian運用 | +0.9193 | −0.6822 |
| 統計検定準1級① | +0.8404 | −2.1958 |
| AWS移行記録 | +0.4170 | −1.3147 |
| 統計検定準1級② | +0.3948 | −2.0233 |
| GA4設定 | −0.2550 | −0.4749 |
| KaTeX導入 | −0.5611 | −1.2924 |
| Jamstack入門 | −0.5937 | +0.4317 |
| Serafina | −3.1888 | +1.1400 |
| Ventuno | −3.4348 | +1.3344 |
第1主成分得点の分散 = 3.348857   ← 固有値 λ₁ と一致
第1と第2の相関 = 9.89×10⁻¹⁷      ← ほぼ0(無相関)
主成分負荷量(指標ごと・6個)
負荷量は「主成分と元の変数の相関係数」です。だから必ず −1 〜 +1 に収まります。
| 指標 | 固有ベクトルの成分 | 第1主成分の負荷量 | 第2主成分の負荷量 |
|---|---|---|---|
| PV | +0.407515 | +0.745748 | +0.658667 |
| セッション | +0.407257 | +0.745276 | +0.660777 |
| 平均滞在秒 | +0.315297 | +0.576990 | −0.798022 |
| スクロール率% | +0.426384 | +0.780278 | −0.619912 |
| 直帰率% | −0.427829 | −0.782922 | +0.616545 |
| 被リンク数 | +0.451464 | +0.826173 | +0.536449 |
負荷量には計算式があります。ただし適用条件があるので一般形から書きます。
は変数 の標準偏差です。相関行列で主成分分析した場合は (標準化済みなので)なので、分母が消えて次の形に簡約されます。
例(相関行列版): PV → 0.407515 × √3.348857 = 0.745748
                   実測の相関係数も 0.745748   全6変数で一致

検算1:第1主成分の負荷量の2乗和 = 3.348857 = λ₁
検算2:各変数について全主成分の負荷量2乗の和 = すべて 1.000000
簡約形を共分散行列版に使うと壊れます。 同じデータを共分散行列で主成分分析して確かめました。
共分散行列版で u_j × √λ₁ を計算すると:
  [1136.67, 835.37, −6.26, 2.67, −2.69, 3.87]   ← ±1 を大きく超える

s_j で割った正しい形なら:
  [0.99999, 0.99995, −0.0859, 0.1692, −0.1725, 0.9536]
  実際の相関係数と一致
上の検算1は標準化した場合限定です(共分散行列版では負荷量2乗和が 2.975 で λ₁=1989946 とまったく合いません)。検算2は一般形を使えばどちらでも成立します(共分散版でも6変数すべて 1.000000 を確認)。
この記事では以降すべて相関行列を使うので簡約形で通しますが、式を持ち出すときは前提を確認する必要があります。
係数と負荷量の使い分けを押さえておきます。固有ベクトルの成分は「主成分を作るときの重み」、負荷量は「主成分と変数の相関」です。解釈には負荷量を使うのが普通です。相関係数なので大きさの比較がしやすく、絶対値が 0.7 を超えれば「その主成分はその変数を強く反映している」と言えます。
バイプロット:得点と負荷量を1枚に重ねる
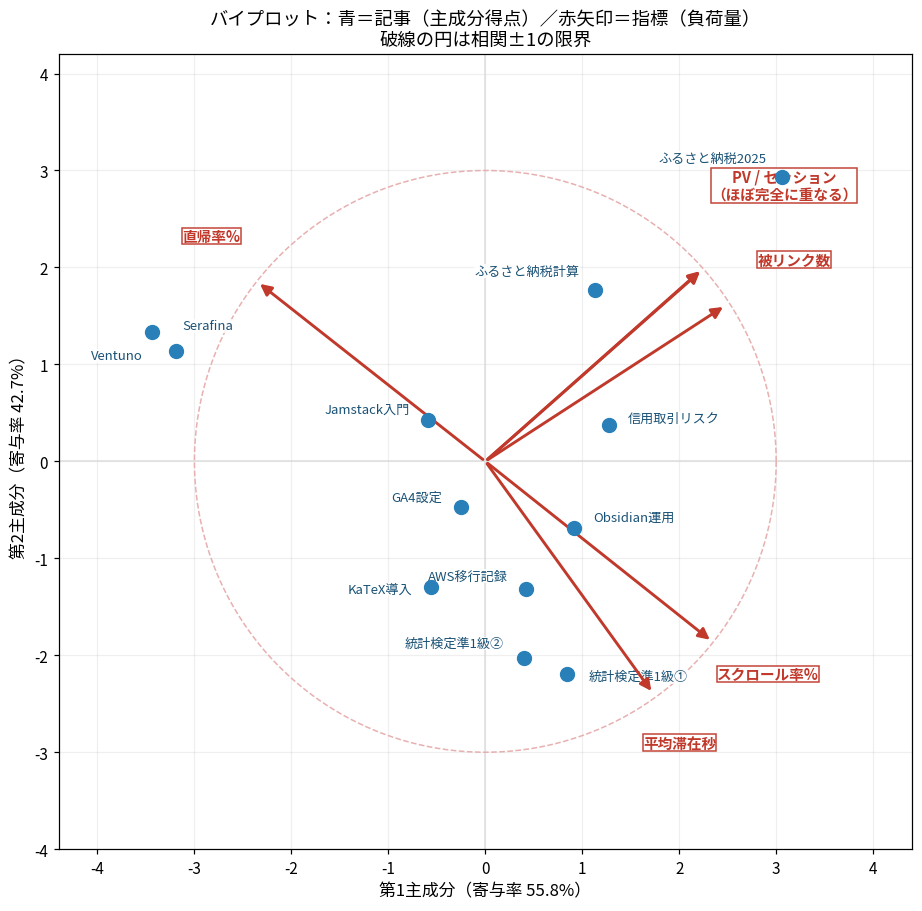
読み方は「矢印の向きに位置する記事は、その指標が高い」です。
PV とセッションの矢印がほぼ完全に重なっていることに注目してください。相関 0.9999 なので当然ですが、この2つは実質的に同じ情報だと図から一目で分かります。「6指標のうち実質何個分の情報があるか」という問いの答えでもあります。
直帰率だけが逆向きなのは、他の指標と負の相関があるからです(直帰率が高い記事は PV も滞在時間も低い)。
主成分に意味付けをしていいのか
ここは私が最も疑っていた点です。「第1主成分は総合力を表す」という説明をよく見かけますが、それは恣意的ではないのか。
結論から言うと恣意的になり得ます。 ただし「だから解釈してはいけない」わけでもないので、線を引きます。
この例で解釈を試みると
| 負荷量のパターン | 解釈の候補 | |
|---|---|---|
| 第1主成分 | 被リンク数 +0.826/スクロール率 +0.780/直帰率 −0.783/PV +0.746/セッション +0.745/滞在秒 +0.577 | 直帰率以外が全部同じ符号で大きさも近い → 「記事の総合的な良さ」のような軸 |
| 第2主成分 | セッション +0.661/PV +0.659 が正、滞在秒 −0.798/スクロール率 −0.620 が負 | 「集客力」と「読まれ方」が逆を向いている → 「広く浅く読まれる ↔ 狭く深く読まれる」の軸 |
第2主成分の解釈はバイプロットで裏が取れます。ふるさと納税系の記事(PV が多く滞在時間が短い)が上、統計検定の記事(PV は少なく滞在時間が長い)が下に来ています。得点表を見ると統計検定準1級① が −2.1958、② が −2.0233 で最も下です。
恣意性の核心(3点)
(1) 主成分は「分散が最大」という数学的基準だけで決まっています。 「総合力」という意味を先に決めて探したのではなく、出てきた軸に後から名前を付けています。名前は解釈者の産物であって、データが主張したものではありません。
(2) 符号に意味はありません。 固有ベクトルの符号は任意なので、ソフトによって第1主成分の正負が反転します。「高いほど良い」は保証されず、負荷量の符号を見て自分で決める必要があります。
(3) 第1主成分が「総合力」に見えるのは、たまたま全変数が同符号だったからです。 指標をすべて「大きいほど良い」向きに揃えて集めれば、相関が全部正になり、第1主成分は自動的に「全体的な大きさ」を拾います。これは発見ではなく、指標の選び方の帰結です。
だから解釈は仮説を立てる道具として有用ですが、検証された事実ではありません。「第1主成分は総合力を表すと解釈できる」までが誠実な言い方で、「総合力である」は踏み越えています。名前を付けたら、その名前が妥当かを別のデータで確認すべきです。
相関行列か分散共分散行列か
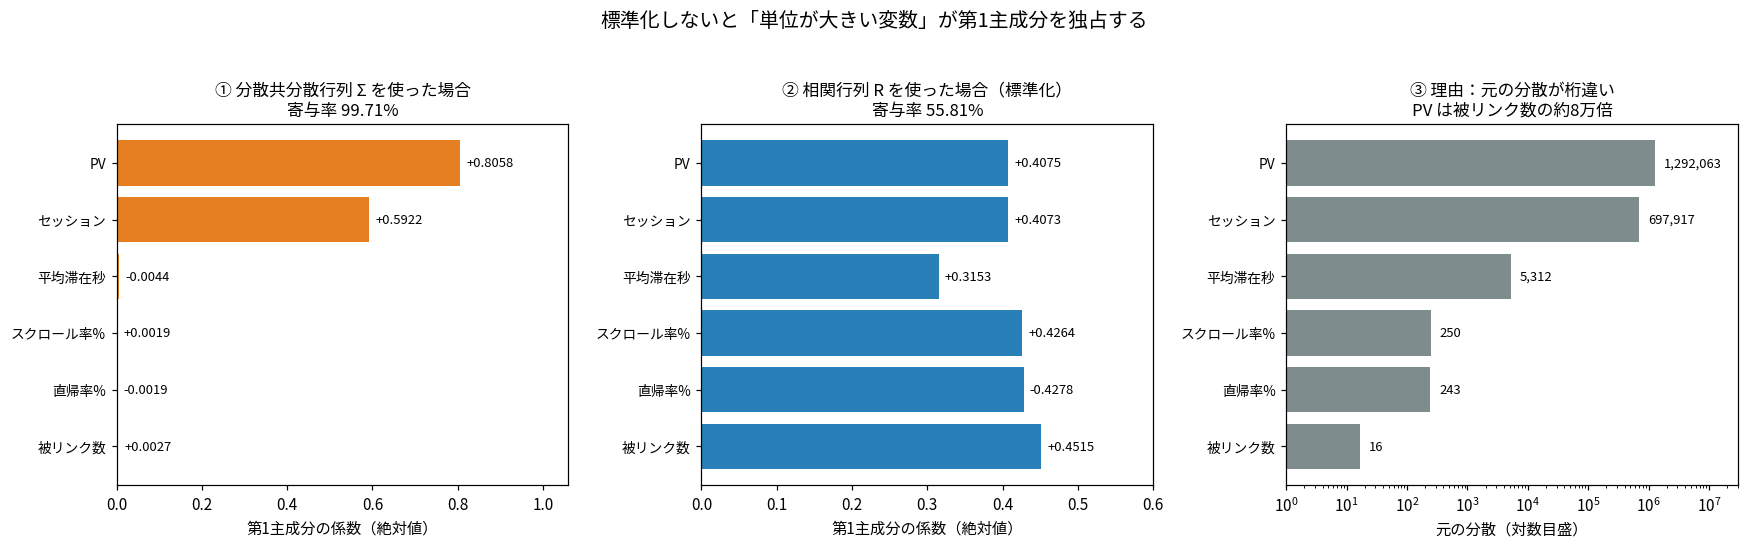
①と②で第1主成分の中身がまったく違います。 ①(分散共分散行列)では PV とセッションだけで決まっており、他の4指標の係数はほぼ 0(平均滞在秒は −0.0044)。②(相関行列)では6指標が 0.32〜0.45 に分散しています。
③が理由です。PV の分散は 1,292,063、被リンク数は 16。約8万倍の差があります。分散を最大にする方向を探しているので、分散が桁違いに大きい変数の方向が自動的に選ばれるわけです。
決定的な違い:単位を変えると結果が変わるか
PV の単位を「PV」から「千PV」に変えただけで再計算:

  Σ版の第1寄与率: 99.7066% → 99.1828%   変わる
  R版の第1寄与率: 55.8143% → 55.8143%   変わらない(固有値が全て一致)
原則として相関行列(=標準化する)を使います。 理由は上の通りで、 版の結果は単位の選び方という恣意的なものに左右されるからです。「結果が変わるのはなぜか」の答えは、 版が「分散の絶対的な大きさ」を、 版が「相関の構造」を見ているからです。
分散共分散行列を使うのは、全変数が同じ単位で、かつ分散の差そのものに意味があるときです。たとえば同一試験の各科目の点数(すべて100点満点)で「ばらつきの大きい科目こそ重要」と考える場合。逆に言えば、単位が混在していたら選択の余地はなく相関行列です。この例の PV(回)と直帰率(%)のように。
| 分散共分散行列 | 相関行列 | |
|---|---|---|
| 固有値の合計 | 元の分散の合計(この例 1,995,802) | 必ず変数の数 p(この例 6) |
| 単位を変えると | 結果が変わる | 変わらない |
| 大きい分散の変数 | 支配してしまう | 対等に扱われる |
| カイザー基準 | 使えない | 使える() |
| 使う場面 | 同一単位+分散差に意味があるとき | 通常はこちら |
マハラノビス距離:ばらつきの形をものさしに組み込む
等確率楕円の話をここで回収します。「この記事は異常だ」と判定したいとき、素朴には中心から遠い点を探せばよさそうです。それがユークリッド距離です。
ところがこれだと困ります。滞在時間とスクロール率のデータ(n=62、相関 0.928)に2点を仕込みました。
| 点 | 滞在秒 | スクロール率% | どういう記事か |
|---|---|---|---|
| A | 320 | 100 | 滞在時間が長くスクロールもされている。相関の傾向に沿ってとても優秀な記事 |
| B | 300 | 55 | 滞在時間は長いのにスクロールされていない。傾向から外れている |
異常として検出したいのは B です。 A はただ優秀なだけで異常ではありません。
実測:順位が逆転する
中心(平均)= (175.790, 65.955)   相関係数 = 0.928300

ユークリッド距離:  点A = 148.17   点B = 124.69   → A の方が遠い
マハラノビス距離:  点A =   2.30   点B =   7.05   → B の方が遠い(逆転)
外れ値トップ5を並べると、順位そのものが入れ替わります。
| 順位 | ユークリッド距離で選ぶと | マハラノビス距離で選ぶと |
|---|---|---|
| 1 | (320, 100.0) d=148.17 ←点A | (300, 55.0) d=7.05 ←点B |
| 2 | (33, 33.6) d=146.41 | (320, 100.0) d=2.30 ←点A |
| 3 | (41, 37.1) d=137.84 | (33, 33.6) d=2.23 |
| 4 | (300, 55.0) d=124.69 ←点B | (41, 37.1) d=2.09 |
| 5 | (61, 40.0) d=117.69 | (246, 90.2) d=1.96 |
ユークリッド距離では B が4位まで落ちます。 本当に見つけたい異常が埋もれてしまう。5%基準で判定すると、マハラノビス距離では点B ただ1点だけが外れ値と判定されました(意図通りです)。
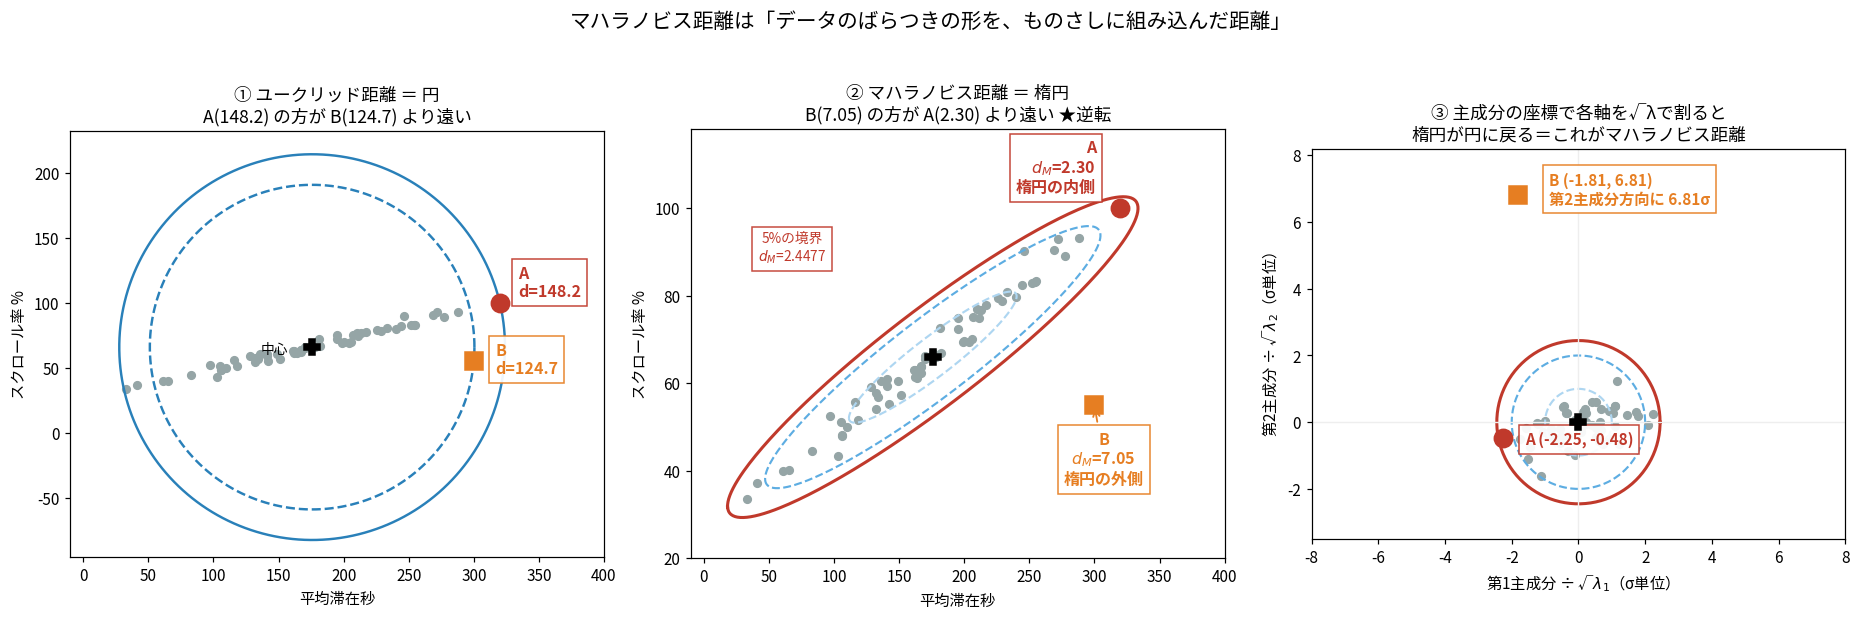
①が問題の可視化です。データは相関 0.928 なので細長い雲になっています。ところがユークリッド距離の等距離線は真円。雲の形と円の形が合っていないので、「雲に沿って遠い点」と「雲から外れた点」を区別できません。
②ではものさしが雲と同じ形の楕円になっています。だから A は楕円の内側(正常)、B は外側(異常)と正しく判定されます。
③が正体です。 主成分の座標に移して各軸を で割ると、楕円が円に戻ります。
マハラノビス距離は「主成分の座標で、各方向を で割ってから測ったユークリッド距離」でした。 実測で確認すると、主成分座標を で割ってからユークリッド距離を計算した値と、マハラノビス距離の最大の差は 2.66×10⁻¹⁵(完全一致)。
これは1変数の の多次元版です。記事の最初で「1変数の正規分布で本質的なのは だけ」と確認しましたが、その がまさにマハラノビス距離の2乗でした。多次元正規分布の指数部に名前が付いただけです。
数字で見る「なぜ B が異常か」
第1主成分の標準偏差 = √4344.57 = 65.91(雲の長い方向)
第2主成分の標準偏差 = √29.62   =  5.44(雲の細い方向)

点A: 第1主成分方向に −2.25σ、第2主成分方向に −0.48σ → どちらも常識的な範囲
点B: 第1主成分方向に −1.81σ、第2主成分方向に +6.81σ → 異常
ここが核心です。点B は生の単位で見ると、第2主成分方向に 37.09 しかズレていません。点A のズレ(148.15)よりずっと小さい。ところが第2主成分方向の標準偏差は 5.44 しかないので、37.09 ÷ 5.44 = 6.81σ という異常な値になります。
「ばらつきが小さい方向でのズレは、生の単位が小さくても異常度が高い」 ── これがマハラノビス距離が測っているものです。
χ²分布との接続(第7回の回収)
「距離 7.05 は大きいのか」に答えるには基準が必要です。データが多次元正規分布に従うなら、マハラノビス距離の2乗は χ²分布に従います(自由度=変数の数)。
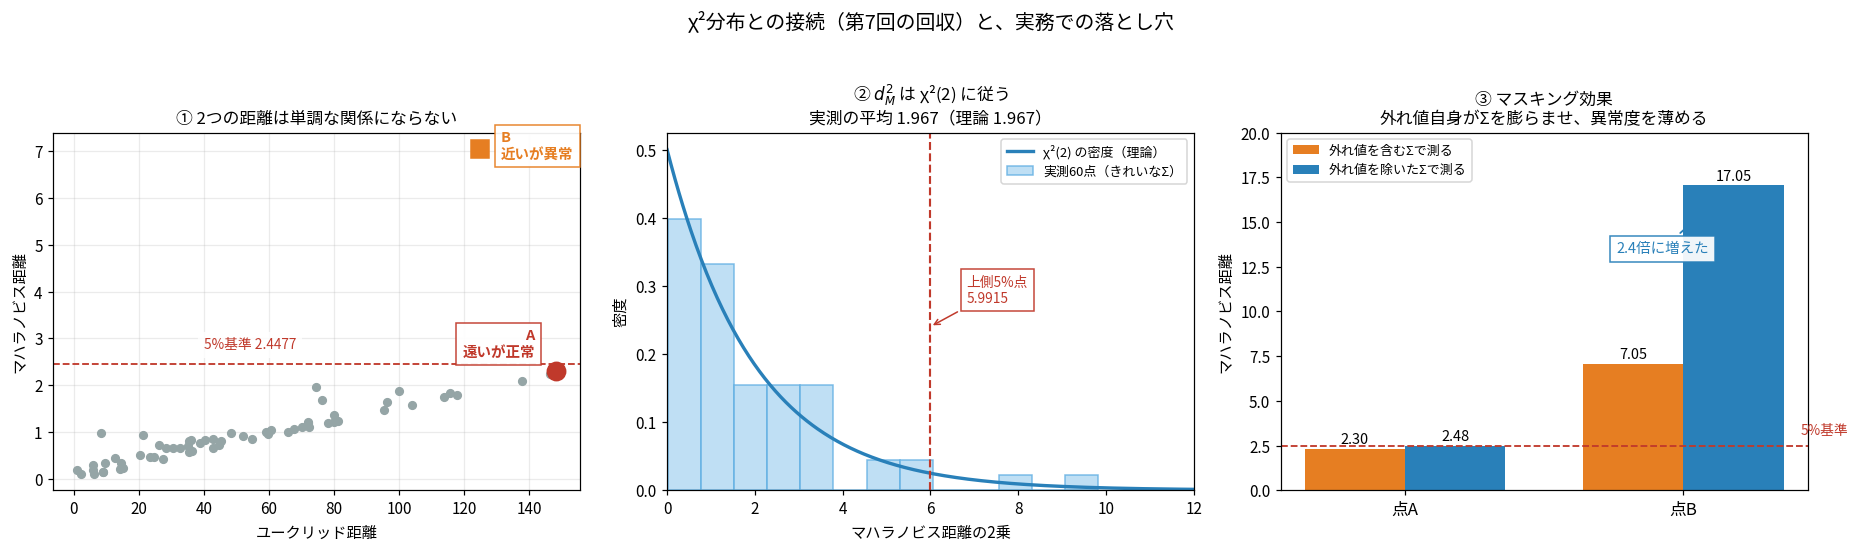
①は2つの距離が単調な関係にならないことの証拠です。右下(ユークリッドでは遠いがマハラノビスでは近い=点A)と左上(逆=点B)が同時に存在するので、片方を計算すればもう片方が分かるという関係ではありません。
②で χ²(2) の密度とヒストグラムを重ねました。おおむね形は合っていますが、62点全体で計算した の平均は 1.9677 で、χ²(2) の平均 2 とは一致しません( 倍だけずれます。理由は後述します)。2変数の場合は自由度2で、χ²(2) は手計算できます(上側確率がちょうど )。
| 上側確率 | χ²(2) の点 | マハラノビス距離の基準 |
|---|---|---|
| 50% | 1.386294 | 1.177410 |
| 10% | 4.605170 | 2.145966 |
| 5% | 5.991465 | 2.447747 |
| 1% | 9.210340 | 3.034854 |
検算: exp(−5.991465/2) = 0.050000  (自由度2なので −2ln(0.05) = 5.9915 と手で出せる)

点A の d_M² = 2.30² = 5.29 → 上側確率 ≈ 0.071(χ²(2) 近似)
                              厳密なベータ分布では 0.066
                              いずれにせよ5%基準では外れ値ではない
点B の d_M² = 7.05² = 49.70 → 基準を大きく超えており異常
χ² 近似には条件がある(査読で判明)
ここは私が雑に扱っていた箇所です。「 が χ²(p) に従う」が成り立つのは と が既知のときです。ところが今回は同じ標本から と を推定しているので、厳密には χ² ではありません。
正確には次のベータ分布に従います。
この違いは細かい話では済みません。ベータ分布は有界なので、 に上限が生まれます。
なら 、つまり 。シミュレーション(正規データで3000回)でも上限を超えないことを確認しました。
点B の は、この上限の 91% に張り付いた値です。 だから最初に書こうとした「上側確率 」のような p 値は原理的に出せません。χ²(2) は 60.02 より大きい値にも確率を置いているので、この領域では近似そのものが破綻しています。点B が異常だという結論は変わりませんが、p 値を書くのは誤りでした。
5%基準の方も厳密に計算すると差が出ます。
| 5%基準の | ||
|---|---|---|
| χ²(2) 近似 | 5.9915 | 2.4477 |
| ベータ分布(厳密) | 5.7954 | 2.4074 |
χ² 近似の方がわずかに甘く、外れ値を見逃す側にずれています。 この例では点A(2.2992)の判定は変わりませんが、境界付近では結論が変わり得ます。
が大きければ χ² 近似で問題ありません(上限 が十分大きくなるため)。 が小さいときと、 が上限に近いときに注意が必要でした。
もう1点。62点それぞれを5%で判定すると多重性の問題が出ます。 正常なデータでも期待 3.1 点が引っかかる計算です(今回は結果的に1点でしたが、それは偶然です)。外れ値検出として使うならボンフェローニ補正などで閾値を調整すべきでした。
χ²になる理由は③の図で見えています。 主成分の座標で各方向を で割ると、互いに無相関で分散1の変数が p 個できます。それを2乗して足したものがマハラノビス距離の2乗 ── これは第7回でやった χ² の定義そのもの(標準正規の2乗和)です。だから自由度が変数の数になります。2乗して足した項の数が自由度なので。
なぜ共分散行列でよいのか(相関行列ではなく)
主成分分析では相関行列を推奨したのに、マハラノビス距離の定義は共分散行列を使う。矛盾しているように見えますが、していません。マハラノビス距離では、どちらを使っても答えが同じになるからです。
(1) 共分散行列 Σ で計算(生データのまま)
    点A = 2.2992282507   点B = 7.0496091167

(2) 標準化してから相関行列 R で計算
    点A = 2.2992282507   点B = 7.0496091167

差 = 4.44×10⁻¹⁶ と 0.00(倍精度の丸め誤差のみ)
単位を変えても不変です。
| 変換 | 点A の | 点B の |
|---|---|---|
| 元(秒, %) | 2.29922825 | 7.04960912 |
| 滞在を「分」に(÷60) | 2.29922825 | 7.04960912 |
| スクロールを小数に(÷100) | 2.29922825 | 7.04960912 |
| 両方変える | 2.29922825 | 7.04960912 |
上の表は単位の変更(各軸を定数で割る)だけですが、マハラノビス距離は可逆な線形変換すべてに対して不変です。回転やせん断でも変わりません。 と変換すると が に変わり、 の側で打ち消し合うためです。
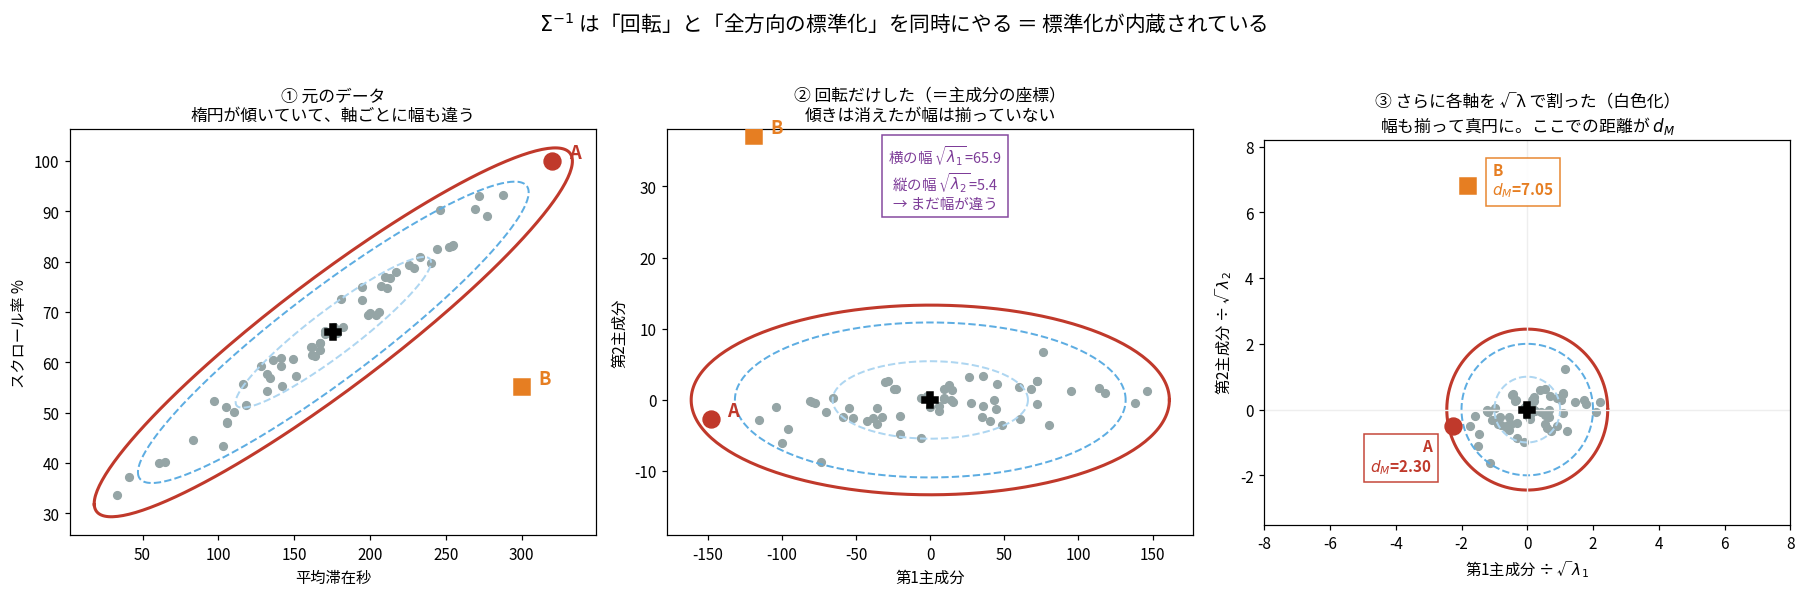
理由は に標準化が内蔵されているからです。3段階に分けると見えます。
①→②:主成分の座標に移る(回転)。傾きが消えますが、横の幅 65.9・縦の幅 5.4 でまだ揃っていません。
②→③:各軸を で割る(全方向の標準化)。ここで真円になります。
を挟むという操作が、この①→③を一気にやっています。 事前に標準化してもしなくても同じ場所に着くので、選択問題が発生しません。この操作を白色化(whitening)と呼びます。どの方向にも同じばらつきになった状態を、あらゆる周波数が均等な白色光にたとえた名前です。
いっぽう主成分分析では、同じ単位変換で結果が変わります。
| 変換 | 第1主成分の角度 | 第1主成分の寄与率 |
|---|---|---|
| 元(秒, %) | 12.2640° | 99.3227% |
| 滞在を「分」に | 86.1901° | 99.9296% |
| スクロールを小数に | 0.1237° | 99.9999% |
| 両方変える | 7.3978° | 99.7405% |
第1主成分の向きが 12.3 度から 86.2 度まで動きます。 ほぼ直角に変わってしまう。
違いはこうです。マハラノビス距離は「全方向を割る」ので方向を選びません。だから最初のスケールが何であれ行き先は同じ。主成分分析は「1つの方向を選ぶ」ので、選ぶ前の時点でどの変数の分散が大きいかが結果を決めてしまいます。
「捨てる(方向を選ぶ)操作が入ると、その前のスケールが効いてくる」と覚えるとよさそうです。
2つの式の関係を整理する
と はよく似ています。並べます。
| 主成分分析の分散 | マハラノビス距離の2乗 | |
|---|---|---|
| 式 | ||
| か か | (そのまま) | (逆行列) |
| 挟まれるもの | 方向 (長さ1) | 点の位置 |
| 答えの意味 | その方向のばらつきの大きさ | その点の異常度(何σ分か) |
| 単位 | 元の単位の2乗(単位あり) | なし(無次元) |
| スケール変更で | 変わる | 変わらない |
をかけると単位が付いたままなので影響を受けます(だから標準化するかを選ぶ必要がある)。 で割ると単位が消えるので受けません(だから選ぶ必要がない)。
ただし無関係な2つの式ではありません。同じ固有値分解でつながっています。
各項が「その主成分の得点を、その主成分の分散で割ったもの」です。主成分分析で求めた がそのまま分母に入っています。
点B の場合(実測):
  第1主成分の項: (−119.048)² / 4344.57 =  3.2621
  第2主成分の項: (37.089)²   /   29.62 = 46.4349  ← こちらが支配的
  合計 = 49.6970 → √49.6970 = 7.0496
分母が小さい(=29.62)ほど、その方向のズレが大きく評価されるのが式から見えます。
主成分回帰:第16回の多重共線性はここで解決する
第16回で多重共線性を扱いました。「相関の高い変数を入れると結果が悪くなる」現象で、当時の私は「なぜと言われると説明できない」状態でした。主成分分析の言葉を使うと、原因が固有値として見えます。
記事40本について、文字数・見出し数・内部リンク数から PV を予測するモデルを作りました。
x1 = 文字数(千字)
x2 = 見出し数   ← 文字数とほぼ比例するように作った
x3 = 内部リンク数 ← 独立

x1 と x2 の相関 = 0.989834  (x1 と x3 の相関 = 0.0687)
真の係数: 切片 2.0、x1 = 0.9、x2 = 0.5、x3 = 0.7
通常の最小二乗法の結果
| 変数 | 推定値 | 標準誤差 | t値 | 真の値 |
|---|---|---|---|---|
| 切片 | 1.6281 | 0.4331 | 3.760 | 2.00 |
| x1 文字数 | 1.0292 | 0.4137 | 2.488 | 0.90 |
| x2 見出し数 | 0.4430 | 0.2462 | 1.800 | 0.50 |
| x3 内部リンク数 | 0.7476 | 0.0782 | 9.559 | 0.70 |
= 0.966616 で当てはまりは良好です。ところがx2 の t値が 1.800 で有意になりません(自由度36の5%基準 2.0281 に届かない。p値 = 0.0803)。真の係数は 0.5 で確実に効いているのに「効いていない」と判定されてしまいます。標準誤差が膨らんでいるのが原因です。膨張の度合いは で測れて、x1 と x2 は共線性がなければ達成できたはずの標準誤差の 7.0 倍になっています(x3 は = 1.005 倍)。
VIF(Variance Inflation Factor=分散拡大要因)
  x1 文字数:      VIF = 49.61
  x2 見出し数:    VIF = 49.67
  x3 内部リンク数: VIF =  1.01
※ 一般に VIF > 10 で多重共線性が疑われる
原因を固有値で見る
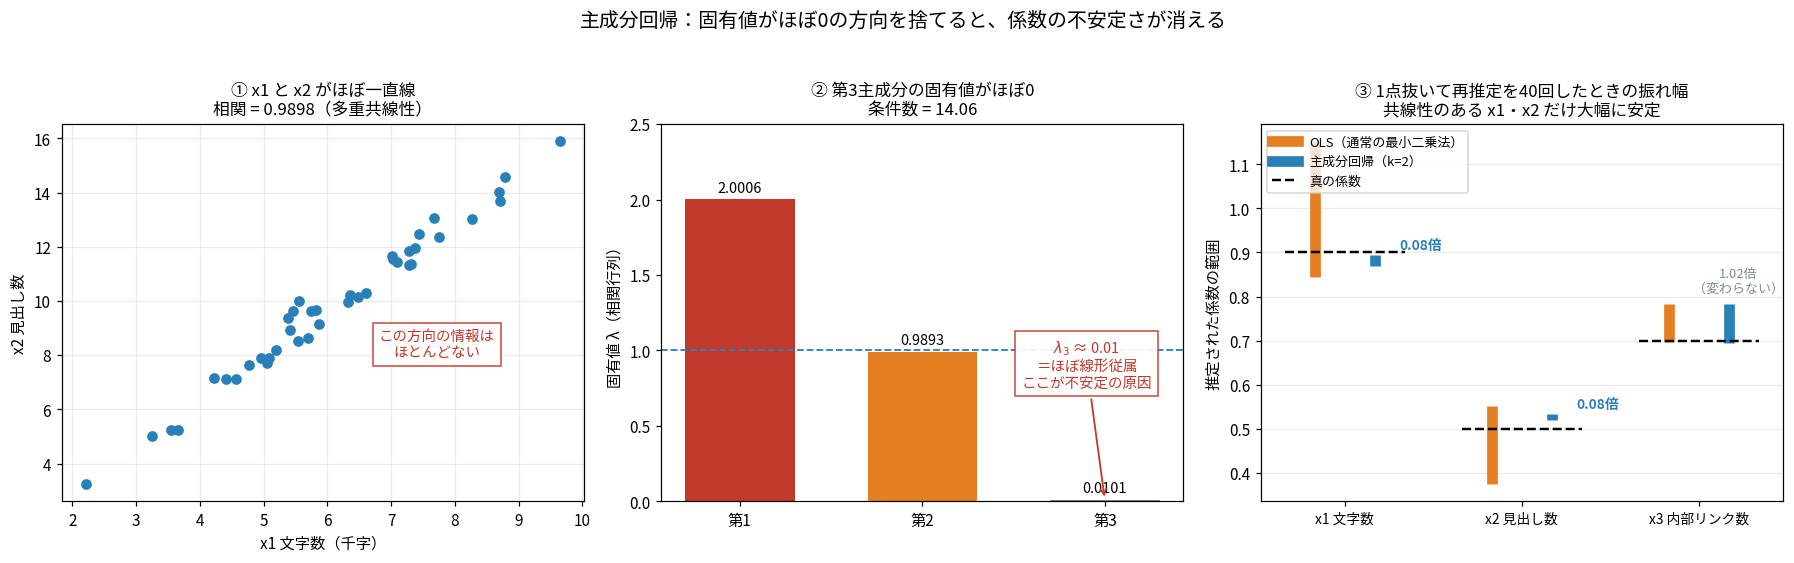
②が原因の正体です。相関行列の固有値は 2.0006、0.9893、0.0101。第3主成分の固有値がほぼ 0 ── つまりその方向にデータのばらつきが実質ないということです。
なぜそれが困るのか。 回帰係数を求めるには という逆行列が必要です(第16回)。ところが逆行列を取ると固有値が逆数になります ── は に化けます。小さい固有値が、逆数になって係数の分散を爆発させるのがメカニズムでした。
「0 で割れない」の一歩手前が「ほぼ 0 で割る」であり、それが標準誤差の膨張として現れます。ここが第16回で分からなかった部分です。
条件数 = √(λ_max / λ_min) = √(2.0006 / 0.010123) = 14.06
※ 10 を超えると多重共線性が疑われ、30 を超えると深刻とされる
   (定義に √ を取らない流儀もあるので注意)
症状:データを少し変えると係数が動く
「不安定」を実測しました。40点から1点だけ抜いて再推定する操作を40回繰り返します(Leave-One-Out)。
| 変数 | 最小 | 最大 | 振れ幅 | 真の値 |
|---|---|---|---|---|
| x1 文字数 | 0.8440 | 1.1521 | 0.3081 | 0.90 |
| x2 見出し数 | 0.3749 | 0.5521 | 0.1773 | 0.50 |
| x3 内部リンク数 | 0.6972 | 0.7832 | 0.0860 | 0.70 |
たった1点抜くだけで x1 の係数が 0.844 〜 1.152 まで動きます。 係数の値そのものを解釈したいのに、これでは「文字数が1千字増えると PV がどれだけ増えるか」を語れません。共線性のない x3 は 0.086 しか動いていないので、これは共線性ペア特有の現象です。
主成分回帰のやり方と結果
手順は単純です。
- 説明変数を標準化する
- 主成分分析して主成分得点を出す(主成分同士は無相関)
- 上位 k 個の主成分得点を説明変数として回帰する
- 必要なら元の変数の係数に戻す
効いているのはステップ3(捨てること)です。 ステップ2で主成分同士は無相関になりますが、それだけでは何も改善しません(後で見るように、全部の主成分を使うと OLS と完全に一致してしまいます)。問題の元凶である の方向を捨てることで、はじめて逆数の爆発が止まります。
| k | 元の変数に戻した係数 | コメント | |
|---|---|---|---|
| 1 | 0.917208 | x1=0.9183, x2=0.5464, x3=0.1783 | x3 が 0.7 → 0.18 に潰れた。捨てすぎ |
| 2 | 0.966503 | x1=0.8849, x2=0.5289, x3=0.7458 | 3つとも真の値に近い |
| 3 | 0.966616 | x1=1.0292, x2=0.4430, x3=0.7476 | OLS(0.966616)と完全一致 |
k=3(全部使う)が OLS と完全に一致するのは重要な確認です。主成分回帰は「座標を回してから回帰する」だけなので、全部の主成分を使えば何も変わりません(回帰は座標の回転で不変)。意味があるのは捨てたときだけです。
そしてk=1 は捨てすぎでした。第2主成分は主に x3 を担っている(固有ベクトルの成分 −0.9946)ので、これを捨てると x3 の情報が失われ、係数が 0.7 → 0.18 に潰れます。累積寄与率も 66.69% しかありません。k=2 で累積 99.66% です。
k=2 での安定性
| 変数 | PCR の振れ幅 | OLS の振れ幅 | 比 | 真の値 |
|---|---|---|---|---|
| x1 文字数 | 0.0257 | 0.3081 | 0.083 倍 | 0.90 |
| x2 見出し数 | 0.0143 | 0.1773 | 0.081 倍 | 0.50 |
| x3 内部リンク数 | 0.0874 | 0.0860 | 1.016 倍 | 0.70 |
共線性のある x1・x2 の振れ幅が約8%(12分の1)に縮みました。 いっぽう共線性のない x3 は 1.02 倍でほぼ変化なし。
これは主成分回帰が「全体をぼかして安定させた」のではなく、問題のある方向だけを狙って直したことの証拠です。副作用が最小限だと確認できました。
代償:バイアスとの引き換え
ただし無料ではありません。主成分を捨てると推定量が「残した主成分の張る空間」に押し込められるので、一般には不偏性を失います(バイアスが入る)。
厳密に言うと、真の が残した主成分の空間に入っていれば PCR も不偏です。この例で k=2 の係数が真の値にほぼ一致したのは偶然ではなく、真の が捨てた第3主成分の方向の成分をほとんど持っていなかったからでした。逆に k=1 で x3 の係数が潰れたのは、真の が捨てた第2主成分の方向に大きな成分を持っていたからです。「捨てた方向に真の係数の成分があるか」が分かれ目です。第16回のガウス・マルコフ定理で「OLS は線形不偏推定量の中で最小分散(BLUE)」と扱いましたが、主成分回帰は不偏性を諦めて分散を下げるという取引をしています。
これは第19回のリッジ回帰・Lasso と同じ発想です。バイアスを少し受け入れて分散を大きく下げ、合計の誤差を小さくする。
| 手法 | やり方 | 不偏性 |
|---|---|---|
| OLS(通常の最小二乗法) | そのまま推定 | 不偏 |
| 主成分回帰(PCR) | 固有値の小さい主成分を完全に捨てる | 一般に偏りあり |
| リッジ回帰(第19回) | 係数を連続的に縮める(捨てない) | 偏りあり |
| Lasso(第19回) | 変数を 0 にする(選択する) | 偏りあり |
PCR とリッジの違いを一言で言うと、PCR は 0 か 1(捨てるか残すか)、リッジは連続的に縮めます。リッジの方が滑らかなので実務ではリッジや Lasso が使われることが多いです。
PCR の弱点はもう1点あります。主成分は を見ずに だけで決めているので、「捨てた主成分が実は をよく説明していた」という事故が起こり得ます。それを避けるために も見て成分を作る手法がPLS 回帰(Partial Least Squares=部分最小二乗回帰)です。
見落としやすい点
多重共線性は予測を壊しません。 この例でも = 0.966616 で、k=3 の PCR と同じです。壊れるのは個々の係数の解釈だけです。
ただし限定が付きます。予測が安定なのは、予測したい点がデータの雲の内側にある場合(内挿)だけです。共線性の方向( の方向)に外挿すると、予測も不安定になります。「文字数は多いが見出しは少ない」という現実のデータには無い組み合わせを予測させると、誤差が増幅されます。
だから「多重共線性があるから対処が必要」ではなく、「個々の係数を解釈したいのに不安定だから対処が必要」が正確な言い方です。目的次第で、何もしないのが正解の場合もあります。
ブログのアクセス解析に使えるか
先ほどの6指標の例が答えになっています。6指標が実質2軸に圧縮できました(累積寄与率 98.47%)。
| 得られたこと | 中身 |
|---|---|
| 指標の重複が見える | PV とセッションの相関 0.9999。両方を見る必要はない。第5・第6固有値がほぼ0なのも同じことの表れ |
| 記事を2次元にプロットできる | バイプロットで12記事の位置関係が一目で分かる。6指標の表を睨むより速い |
| 記事のタイプが分かれる | 「広く浅く」(ふるさと納税系)と「狭く深く」(統計検定系)が第2主成分で分離。6指標を個別に見ていては気づきにくい |
| 外れ値が目立つ | Serafina・Ventuno が左端に離れている(グルメ記事=直帰率が7割) |
ただし実務上の注意があります。この例は n = 12(記事12本)で p = 6。標本サイズが小さすぎます。 主成分分析は目安として n ≥ 5p 〜 10p 程度が望ましいとされます(この例なら30〜60本)。
また解釈が安定するかは確認が必要です。記事を数本入れ替えたら第2主成分の向きが変わるようなら、その解釈は信用できません。これも「解釈は仮説」という前の節の話に戻ります。
自分が間違えていたこと・詰まっていたこと
① 多次元正規分布を「1変数の拡張」だと思っていた
過去問で手が止まった原因がこれでした。新しい分布を新しく覚える気になっていたのですが、 が になっただけの書き換えでした。1次元では なので元の式に戻ることを確認したら、急に見通しが良くなりました。
② と共分散を区別していなかった
記事を書く途中で気づきました。「非対角成分 0.8」と「 = 0.8」を同じものとして扱っていたのですが、それが一致するのは対角成分が両方 1 のとき(=相関行列のとき)だけです。n=10 の例では非対角成分 568.333 と = 0.9887 でまったく違う数字でした。
③ を定義だと思っていた
これは定義ではなく、導ける事実です。射影後の分散を定義通り(偏差の2乗の平均)計算すると、結果的にこの形にまとまる。展開すると第3回の の公式そのものでした。定義なのは内積だけ(成分ごとに掛けて足す)です。
④ 「主成分が直交する」を条件だと思っていた
直交するように選んでいるのだと思っていました。実際には制約として課されていますが、 が対称行列なので固有ベクトルは自動的に直交し、制約が実質的に効きません。 総当たりのスキャンで最大 29.6 度と最小 119.6 度の差がちょうど 90.0000 度になったのは、この帰結でした。
⑤ 「ズレ0なら分散が最大」と書いていた(査読で判明)
これが今回いちばん大きな誤りでした。 と のズレを測る図を作り、「ズレが小さいほど分散が大きい」と説明したのですが、測った範囲が 0〜90 度しかなかったので単調に見えていただけでした。
範囲を広げたら、最小固有値の方向でもズレはちょうど 0 です。115 度(ズレ 82 度)で分散 14.03、119.58 度(ズレ 0 度)で分散 5.57。ズレが減る方向に分散も減っていました。
は停留点の条件であって、最大の条件ではありません。最大・最小の両方が該当します(変数が3個以上なら鞍点も)。自分で「最小固有値 5.57」という数字を記事に書いていたのに、それが反例になっていることに気づいていませんでした。
⑥ 寄与率と決定係数は「似ている」程度だと思っていた
実測したら小数第9位まで一致しました。累積寄与率は「k個の主成分で復元したときの決定係数」そのものです。類比ではありませんでした。
ただし一致するのは全変数の平均に対してだけです。変数ごとに見ると平均滞在秒は 0.333 しか復元できていません(k=1 のとき)。「第1主成分で各指標が56%説明できる」と読むのは誤りでした。
⑦ 負荷量の式を無条件に使っていた(査読で判明)
「負荷量 = 固有ベクトル × √固有値」という式を条件なしに書いていました。これは相関行列で主成分分析した場合限定です。共分散行列版で同じ式を使うと 1136.67 のような値が出て、相関係数のはずなのに ±1 を超えます。正しい一般形は で割る形でした。
⑧ χ² 近似の条件を無視していた(査読で判明)
マハラノビス距離の2乗が χ²(p) に従うのは母数が既知のときです。今回は同じ標本から と を推定しているので、厳密にはベータ分布に関係する量になります。
これは細かい話ではありませんでした。 には という上限がある(=62 なら 60.02)ので、点B の = 49.70 は上限の 82.8% に達しています。当初この点に「上側確率 」と書こうとしていましたが、χ²(2) は 60.02 より大きい値にも確率を置いているので、この領域では近似が破綻していて p 値を出せません。
⑨ マスキング効果(検証中に発見)
これが今回いちばん実務的な発見でした。外れ値2点を除いた60点について、汚染された (=外れ値を含めて計算した )でマハラノビス距離を測ったら、 の平均が 1.117 しかなく、 に届きません。バグを疑って調べたら、バグではありませんでした。
外れ値自身が の計算に入っているので、 が膨らんで、自分の異常度が薄まっていたのです。
| 外れ値2点を含む | 外れ値2点を除いた | |
|---|---|---|
| 分散(滞在秒, スクロール率) | 4149.87, 224.32 | 3656.22, 210.09 |
| 相関係数 | 0.9283 | 0.9859 |
| 60点の の平均 | 1.1169 | 1.9667 |
| 理論値 | ―(恒等式が成り立つのは62点全体で、その平均は 1.9677) | 1.9667(=60) 恒等式なので必ず一致 |
| 点A の | 2.2992 | 2.4763 |
| 点B の | 7.0496 | 17.0492 |
点B の異常度が 7.05 → 17.05 と約2.4倍になりました。 点B を の計算から外すと、データ本来の相関(0.9283 → 0.9859)が見えるようになり、「相関の線から外れている」という点B の異常さが正しく評価されます。
これがマスキング効果(masking effect=覆い隠し効果)です。外れ値が自分の存在によって自分を隠します。 外れ値が複数あるとさらに深刻になります。
対策は、頑健な推定(Minimum Covariance Determinant など、データの一部だけを使って を推定する方法)を使う、または疑わしい点を除いて を再計算することです。試験範囲外ですが、実務では必須の注意点でした。
なお理論値が ではなく になるのは、同じデータから平均と を推定しているためです。 はトレースの代数的な恒等式なので、正規分布かどうかとは無関係に必ず成り立ちます(=40, =3 でも 2.925 と厳密に一致することを確認しました)。
⑩ 主成分回帰の「捨てすぎ」を軽く見ていた
「固有値が小さいものを捨てればよい」と単純に考えていたのですが、k=1 にすると x3 の係数が 0.7 から 0.18 に潰れました。第2主成分が x3 の情報をほぼ全部担っていたためです。寄与率だけでなく、捨てる主成分がどの変数を担っているかを負荷量で確認する必要がありました。
要点まとめ
| 問い | 答え |
|---|---|
| 多次元正規分布は1変数の何を拡張したものか | 拡張ではなく書き換え。 が 、 が になっただけ |
| の対角成分・非対角成分の役割 | 対角は各軸方向の伸縮。傾きを生むのは非対角だけ(ただし非対角は細長さも変え、傾きの角度は対角にも依存する) |
| 等確率楕円とは | (マハラノビス距離の2乗)が一定の点の集合。 の値は 1σ・2σ・3σ に対応するが内側の確率は違う(=4 で 95.4% でなく 86.5%) |
| 共分散と相関係数の違い | 共分散は単位つき(秒·%)で比較不能、 は で割って無次元。秒→分で共分散は1/60、 は不変 |
| 相関行列 とは | 標準化してから作った 。別の道具ではない。固有値の和は必ず p |
| なぜ分散を最大にするのか | 落とした後に点どうしが離れて残る=元の違いが保たれるから |
| は定義か | いいえ。射影後の分散を定義通り計算するとこの形になる。第3回の そのもの |
| なぜ固有値問題になるのか | が とズレていれば分散を動かせる。動かせない条件(停留)=平行= |
| ズレ0なら最大か | いいえ。停留の条件にすぎない。最小固有値の方向(119.58°)でもズレは0で分散5.57 |
| 総当たりと固有値の一致 | 3601通りのスキャンの最大 1329.316304 vs 最大固有値 1329.316406 |
| 固有値 は何か | その主成分の分散そのもの( に を代入すれば ) |
| 第22回と同じ道具か | 同じ。ただし は非対称で に意味があり、 は対称で の大小に意味がある |
| なぜ主成分が直交するのか | 制約としては課すが、 が対称行列なので自動的に成り立ち実質的に効かない(29.6°と119.6°の差が90.0000°) |
| 2×2 の固有値の求め方 | tr と det を出して 。検算は和=tr、積=det |
| 固有ベクトルの符号 | 決まらない。 も も固有ベクトル。ソフトで反転する |
| 主成分分析を一言で | の非対角成分が 0 になる座標に乗り換えること(実測 −8.095×10⁻¹⁴) |
| 分散の総量は | 保存される(1334.889 のまま)。配分だけが 1006.7/328.2 → 1329.3/5.6 に変わる |
| 寄与率が割合になる理由 | 分散の総量が保存されるので、分母が固定されている |
| 決定係数との関係 | 同じもの。累積寄与率=k個で復元したときの (小数第9位まで一致)。ただし一致するのは全変数の平均だけ(平均滞在秒は k=1 で 0.333) |
| 主成分得点と負荷量 | 得点は個体に付く(n個)/負荷量は変数に付く(p個・相関係数) |
| 負荷量の計算 | 一般形は 。相関行列版なら =1 なので固有ベクトル×√固有値に簡約される |
| いくつ残すか | カイザー基準(相関行列で )・スクリープロットの肘・累積寄与率。併用する |
| 意味付けは恣意的か | 恣意的になり得る。名前は解釈者の産物。「解釈できる」までが誠実 |
| 第1主成分が総合力に見える理由 | 全変数を同符号に揃えて集めたから。発見ではなく指標の選び方の帰結 |
| 相関行列か共分散行列か | 通常は相関行列。版は単位を変えると寄与率が 99.71%→99.18% に変わる |
| マハラノビス距離は何を測るか | そのデータのばらつきを基準に、何σ分離れているか |
| その正体 | 主成分の座標で各軸を √λ で割ってからのユークリッド距離(差 2.66×10⁻¹⁵) |
| ユークリッドとの違い | 等距離線が円か楕円か。順位が逆転する(A:148→2.30、B:125→7.05) |
| なぜ χ² になるか | 無相関で分散1の変数を p 個作って2乗和するから。第7回の χ² の定義そのもの |
| χ² 近似の条件 | 母数が既知のときだけ。標本から推定すると (=62 で 60.02)という上限が付く |
| 2変数の5%基準 | ()。自由度2は で手計算できる。ただし標本から推定した場合の厳密値は 5.7954() で χ² は甘い側 |
| マハラノビス距離はなぜ でよいか | でも でも同じ(差 4.44×10⁻¹⁶)。 が白色化を内蔵している |
| なぜ主成分分析では変わるのか | 方向を選ぶから。単位を変えると第1主成分の角度が 12.3°→86.2° に動く |
| 多重共線性の正体 | 固有値がほぼ0の方向があること(=0.0101) |
| なぜ係数が不安定になるか | で固有値が逆数になる。0.0101 → 99 に化けて分散が爆発 |
| 主成分回帰の効果 | 共線性ペアの振れ幅が0.08倍に。共線性のない変数は1.02倍で無影響 |
| k を全部使うと | OLS と完全一致。捨てて初めて意味が出る |
| 主成分回帰の代償 | 一般に不偏性を失う。ただし真の が残した空間に入っていれば不偏。第19回のリッジ・Lasso と同じ取引 |
| 多重共線性で予測は | 内挿では落ちない。壊れるのは係数の解釈だけ(ただし共線性の方向に外挿すると予測も不安定) |
| マスキング効果 | 外れ値込みの で測ると点Bが 7.05、除くと 17.05(2.4倍) |
次回
次回は第23章 判別分析です。今回のマハラノビス距離がそのまま主役として再登場します。「どちらのグループの中心に近いか」を測って分類する ── その距離としてマハラノビス距離を使うのがマハラノビス距離判別で、今回確認した「ばらつきの形をものさしに組み込む」性質がそこで効いてきます。
そして今回の等確率楕円も再登場します。2つのグループの が等しいと仮定すると境界が直線になり(線形判別)、異なると曲線になる(2次判別)── この分かれ目が楕円の形の違いから来ます。
今回「 を挟むと単位が消える」ことを確認しましたが、判別分析ではこれが「変数のスケールに依存しない分類ができる」という利点として現れます。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。