統計の記号がややこしいのは軸が2本あるからだった【番外編】
第8章の統計的推定を読んでいたとき、内容とは別のところで手が止まりました。 と と と と が同じページに並んでいて、どれが何なのか自信を持って言えないのです。
読み進めることはできます。文脈でだいたい分かるからです。でも「だいたい分かる」で通していると、自分で式を書く側に回ったときに必ず止まります。実際、最尤法の問題で「まず を書く」という手順の最初の一歩が出てこなかったのは、微分ができないからではなく、分布の名前から を書き下せなかったからでした。
なので連載の流れからは外れますが、番外編として記号の話だけを1本にまとめておきます。結論から言うと、ややこしく見えるのは軸が2本あって、それが交差しているからです。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 確率の土台(第1〜7章)の要点は 確率の土台 要点まとめノート にまとめています。
軸は2本しかない
記号の種類は多く見えますが、判断すべきことは2つだけです。
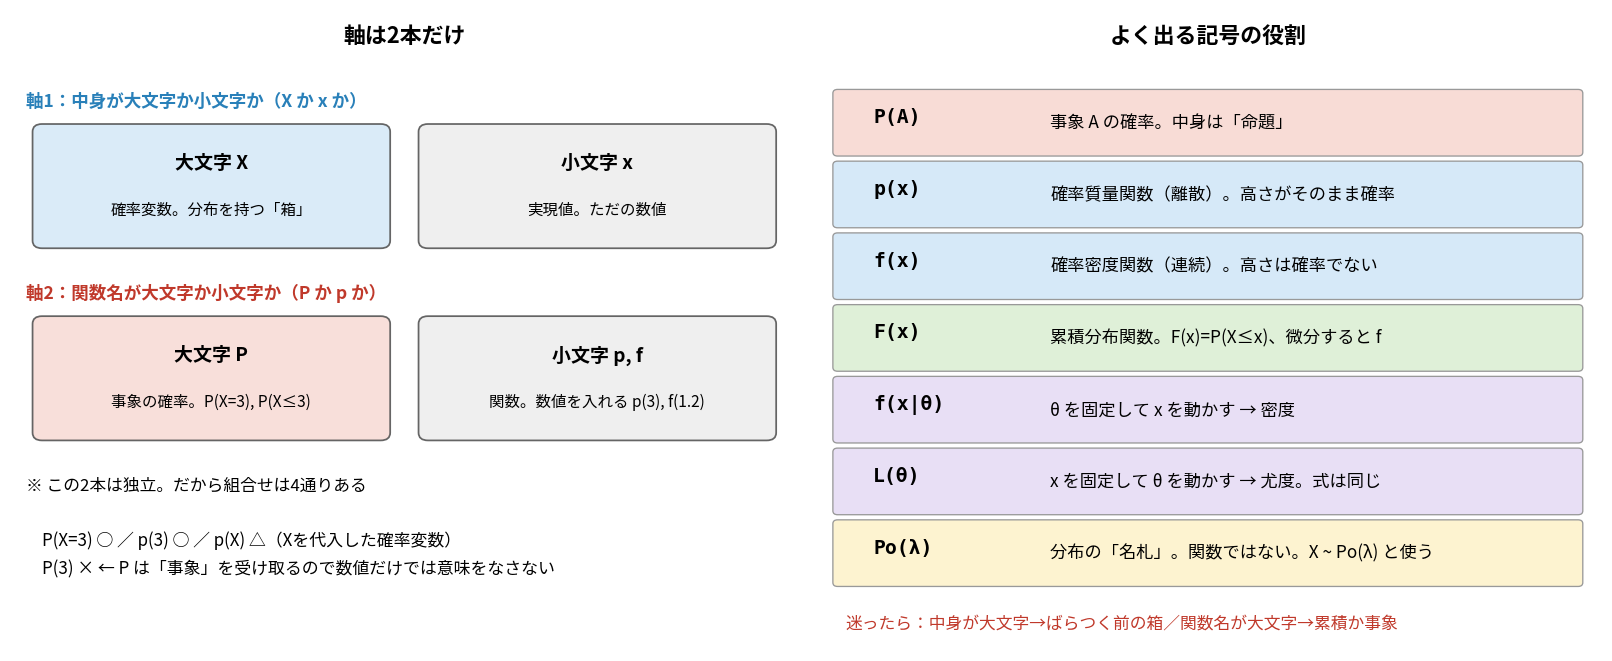
軸1:中身が大文字 か小文字 か。
大文字 は確率変数です。分布を持っている「箱」であって、まだ値が決まっていません。小文字 は実現値、つまり箱から出てきた個々の数値です。
軸2:関数名が大文字 か小文字 か。
大文字 は事象の確率です。受け取るのは「事象」——「 が 3 になる」「 が 3 以下になる」といった出来事——なので、 や のように書きます。小文字の は関数で、受け取るのは数値です。、 のように書きます。
この2本が独立だというのが要点です。だから (両方大文字)も (両方小文字)もあり得ます。逆に とは普通書きません。 が受け取るのは事象——厳密には標本空間の部分集合——なので、数値をひとつ渡されただけでは対象が定まらないからです。書くなら と集合にします。
ただし軸が独立なのは「判断のしかた」の話で、組み合わせ4通りのすべてが実際に流通しているわけではありません。 のような書き方もほぼ見かけません。
大文字 と小文字 :期待値を取れるのはどちらか
軸1の違いは、「その記号に期待値を取れるか」で試すと一気にはっきりします。
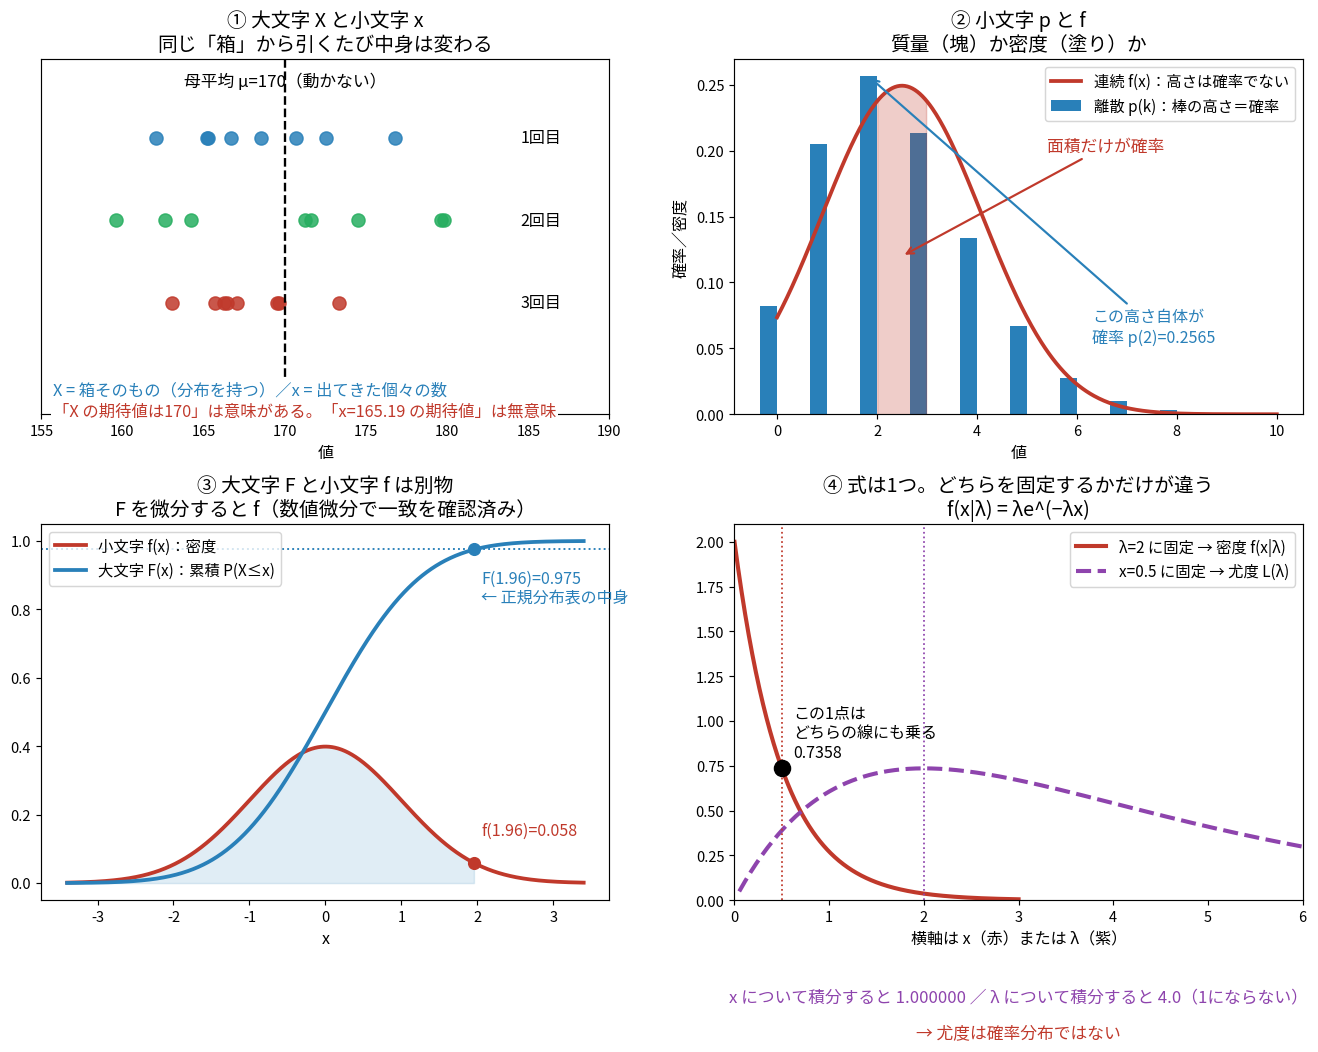
図の左上のパネルは、母平均 、母標準偏差 6 の集団から 8 人ずつ 3 回標本を取った様子です。点線の は動きません。動くのは点の配置だけです。
- 「 の期待値は 170」——これは意味があります。 は確率変数なので、分布があり、その中心を語れます。
- 「 の期待値」——これは意味をなしません。165.19 はただの数字で、分布を持っていないからです。
この区別を飛ばすと、「標本平均は 169.3 だったので、この推定量の期待値は 169.3 だ」という混同が起きます。推定量の期待値は のままです。データを見て動いたのは実現値の側だけです。
なお や のようなギリシャ文字は母集団の側の値(パラメータ)、 や のようなラテン文字は標本から計算した値(統計量)という慣習もあります。これは軸1とは別の話ですが、同じ「動くか動かないか」の対立を表しているので一緒に覚えると楽です。
ただしこの慣習には目立つ例外があります。二項分布の母比率 、標本サイズ 、ガンマ分布の形状 はいずれもラテン文字ですが母集団側の値です。とくに母比率の は、この記事の主題である確率質量関数の と文字が衝突しているので注意が必要です。
小文字 と :質量か密度か
ここが自分がいちばん混ざっていたところです。 と は「小文字だから同じようなもの」ではありません。教科書がきちんと使い分けている場合、両者は離散と連続で役割が違います。
| 記号 | 名前 | 対象 | 高さの意味 |
|---|---|---|---|
| 確率質量関数(PMF, probability mass function) | 離散型 | 高さそのものが確率 | |
| 確率密度関数(PDF, probability density function) | 連続型 | 高さは確率ではない。面積が確率 |
「質量」という訳語が最初は不思議でしたが、意味は素直です。離散型では確率が特定の点に塊(かたまり)として乗っているので質量。連続型では確率が区間に塗り広げられているので密度、というだけの対比です。
図の右上のパネルで、ポアソン分布 の棒の高さは で、これがそのまま「 が 2 になる確率」です。一方、重ねた正規分布の曲線の高さは確率ではありません。
密度が確率でないことは、1 を超えられることで確かめられます。 の原点での密度を計算すると
です。確率が 3.99 になるはずはないので、これは確率ではありません。分布が細く尖るほど密度は高くなります。
では連続型で はどうなるか。理論上は厳密に 0 です。 実験でも、標準正規分布から 1000 万個の乱数を引いてちょうど 0.5 だったものを数えると 0 個でした(もっとも有限精度の計算機では「厳密に 0」を確かめることはできないので、これは裏づけであって証明ではありません)。実数の点をピンポイントで当てることはないので、当然の結果です。
だから連続型では必ず幅を持たせます。 を中心に幅 0.001 の区間を取ると
で、同じ 1000 万個の乱数でこの区間に入った割合は 0.000355 でした。密度 × 幅 = 確率という関係が数値で確認できます。
なお実際の教科書では、離散でも連続でも一律に と書く流儀がかなりあります。「一般論を書くときに場合分けしたくない」という都合です。だから を見たら連続型と決めつけるのは危険で、文脈を見る必要があります。逆方向も同じで、ベイズ統計や機械学習の文献では連続の密度を 、 と書くのがむしろ標準です。つまり「 なら連続」も「 なら離散」もどちらも決めつけられません。 と の使い分けは記号の規則ではなく、文献ごとの流儀だと思っておくのが安全です。
大文字 と小文字 :これは完全に別物
は累積分布関数(CDF, cumulative distribution function)です。定義は
で、名前のとおり「 以下になる確率を積み上げたもの」です。この定義は離散型でも連続型でも同じように使えます。そして連続型に限れば、 と は大文字小文字の違いに見えて微分積分の関係にあります。(離散型の は階段状なので微分できません。)
図の左下のパネルがこの関係です。数値微分で確かめると、標準正規分布で のとき となり、密度 に一致しました。
のありがたみは、正規分布表の中身がこれだと気づいたときに来ます。
「1.96 で 97.5%」という、検定でも区間推定でも出てくる数字は の値です。 の方は表には載りません。表を引くという行為は を評価しているのだと分かると、 と を混ぜなくなります。
軸1と組み合わせると、 の定義に (大文字)と (小文字)が両方出てくる理由も見えます。 は「箱 から出る値が、指定した数値 以下になる確率」なので、箱と基準値の両方が必要なのです。
と :式は同じ、固定するものが違う
最尤法で出てくる縦棒つきの記号です。 は「パラメータが のときの の密度」と読みます。 は条件であって、確率変数ではありません(ベイズ統計では確率変数として扱いますが、それはまた別の話です)。実際、 が確率変数でないことを強調するために とセミコロンで書く流儀もあります。縦棒は条件付き確率の記法を借りているだけです。
そして尤度 は、同じ式のまま、固定する変数を入れ替えたものです。
| 固定するもの | 動かすもの | 名前 | |
|---|---|---|---|
| 密度 | |||
| (観測データ) | 尤度 |
指数分布 で見てみます。図の右下のパネルで、赤い実線は に固定して を動かしたもの(密度)、紫の破線は に固定して を動かしたもの(尤度)です。、 の 1 点(値は 0.7358)は、どちらの線にも乗っています。 式は 1 つだからです。
そして両者の決定的な違いは、積分して 1 になるかどうかです。
方向に積分すると 1 になりません。つまり尤度は確率分布ではありません。 「 がこの値である確率」を表しているわけではないので、 を確率のように扱うと事故ります。
ただしこの「4」という数字自体には意味がありません。 のときに になっただけで、 なら 1、 なら 0.25 です。 大事なのは「値が 1 でない」ことではなく、値がデータ次第で何にでもなる=そもそも正規化されていないことです。分布によっては積分が発散して有限の値にならないこともあります。
尤度が 1 を超えることもあります。指数分布で 、データが 3 点あって が小さいとき、尤度は 30197.38 という値になりました。確率なら絶対に起こらないことです。
離散でも連続でも同じ手続きで尤度が書ける理由も、ここで整理できます。離散なら 、連続なら ですが、連続の場合に厳密な確率を書くと になります。この は を含まないので、 どうしを比べる目的では消えてしまうのです。だから最尤法の手順は離散と連続で変わりません。
は関数ではなく「名札」
の が何なのか、長いあいだ気にしていました。答えは分布の名前を書いた札で、関数ではありません。だから単独では使わず、(従う、distributed as)と組み合わせて使います。
(、 と書く文献もあります。ここは流儀差です。)
これは「 という確率変数は、パラメータ 2.5 のポアソン分布に従う」という宣言です。確率の とは無関係で、フランスの数学者 Siméon Denis Poisson(シメオン・ドニ・ポアソン) の名前の頭 2 文字です。フランス語で魚を意味する poisson と綴りが同じで、これは偶然ではなく姓そのものが「魚」という単語に由来するタイプの名字です。とはいえ分布の中身と魚は何の関係もありません。
分布名の由来は、こう並べると覚えやすくなります。
| 記号 | 分布 | 由来 |
|---|---|---|
| ポアソン分布 | Poisson(人名) | |
| 二項分布 | binomial(二項の) | |
| 幾何分布 | geometric(等比数列の形だから) | |
| 正規分布 | normal(正規の) | |
| 指数分布 | exponential(指数関数の) | |
| ガンマ分布 | ガンマ関数 を使うから | |
| t 分布 | Student(Gosset の筆名)の t | |
| F 分布 | Fisher(人名) | |
| カイ二乗分布 | 二乗和だから |
そのまま人名の記号になっているのはポアソン分布と F 分布で、t 分布も筆名を経由した人名由来です。ちなみに Fisher は F 分布とフィッシャー情報量の両方に登場します。 については、「二乗和の分布」という中身は正しいのですが、 という文字が選ばれた理由は Pearson の従来の記法に由来するもので、二乗和だからという語呂ではありません。
そしてここに記号の衝突があります。 の は F 分布の名札であって、さきほどの累積分布関数の ではありません。 や も名札の側です。同じ文字が別の役割で使われるのは統計では普通に起きるので、その意味でも「文字だけで決めない」のが正解になります。
肝心なのは「名札」と「関数」を混ぜないことです。 は分布そのものを指す名前で、確率を計算したいときは中身の式を書きます。
離散型なので、これを と書くこともできます。 と は同じものを違う流儀で書いているだけで、前者は「事象の確率として」、後者は「関数として」書いています。どちらが正しいというものではありません。
覚えるより、書き分けの練習で身につく
記号の対応表を眺めても定着しませんでした。効いたのは、分布の名前から式を書き下す練習です。最尤法の手順は結局
- を書く(ここが記号の問題)
- 対数を取って を含まない項を捨てる
- で微分して 0 と置く
の 3 段で、詰まるのはほぼ 1 だけでした。式が書ければ後は機械的です。逆に言えば、記号が曖昧なままだと計算力とは無関係なところで止まるということです。
この記事の要点
- 判断すべき軸は2本だけ。中身が か か(確率変数か実現値か)、関数名が か か(事象の確率か関数か)。
- は確率質量関数(離散)で高さが確率。 は確率密度関数(連続)で面積が確率、高さは 1 を超えられる。ただしどちらの文字を使うかは流儀差が大きい。
- は累積分布関数で 。。正規分布表の中身は 。
- と は同じ式で固定する変数が違うだけ。 方向に積分しても 1 にならず、値はデータ次第なので尤度は確率分布ではない。
- などは分布の名札で、 と一緒に使う。確率の とは無関係。
次回からは本編に戻り、第8章の統計的推定の内容そのものを扱います。上で触れた最尤法の 3 段の手順や、フィッシャー情報量の計算はそちらで詳しくやります。