t分布・カイ二乗分布・F分布:母分散を知らないことへの罰金【第7回】
はじめに
前回(第6回)は連続型分布を扱いました。今回は標本分布として、χ²分布・t分布・F分布の3つを見ていきます。
この章は連載の中でも構え方に迷った箇所でした。教科書を開くと「 が従う分布を自由度 のカイ二乗分布と呼ぶ」という定義から始まります。読めば分かるのですが、なぜそんなものを定義したいのかが書かれていません。定義を覚えても、試験で「ここでt分布を使う」と判断する力にはつながりませんでした。
そこで今回は順番を逆にしました。分布の定義を先に置かず、困りごとから並べることにします。
σ を知らない → t分布 ばらつきそのものを知りたい → χ²分布 ばらつきを比べたい → F分布
この順に進めると、3つはバラバラの暗記項目ではなく、1つの土台から生えた3本の枝に見えてきました。とくにt分布は、私の中で「母分散を知らないことへの罰金」という形で腹に落ちました。罰金の額が具体的な数字で出てくるところまで確かめられたので、その過程を書きます。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
TL;DR
- 統計量も確率変数である。標本平均は標本を取り直すたびに動く。その動きの分布が標本分布
- σ の代わりに を使いながら 1.96 を当てると、95%区間が実際にμを捕まえるのは n=10 で91.8%、n=3 で80.9%。この不足を埋める値がt分布から出る
- t分布の裾が重い真因は「 が小さめに出るから」ではない。分解実験で 1.959 → 2.015 → 2.261 と分かれ、偏りの寄与は0.05、ばらつきの寄与が0.25
- 「n−1で割る」が直すのは偏り、t分布が直すのはばらつき。別問題であり、両方セットで初めて正しくなる
- t区間が壊れる条件は「正規でない」ではなく「歪んでいる」。対称なら頑健、対数正規は n=100 でも被覆率85.1%
- χ²の式に σ があるのに σ は未知でよい。分布がσに依存しないから解き直せる(ピボット量)。区間推定という手法自体がこの発想の上にある
- がχ²になるのは偶然ではない。k=2 なら と恒等式(最大差 3.553e-15)で、自由度が なのはずれの合計が0という制約のせい
- 「期待度数5以上」は呪文ではなく中心極限定理がどこから信用できるかの目安。期待度数2で棄却率3.36%、25で4.92%、100で5.03%
- F分布の主役は等分散検定ではなく分散分析。「平均に差があるか」が「群間のばらつき ÷ 群内のばらつき」に翻訳される
統計の用語が出てくるので、先に用語集を置いておきます。用語を知っている方は「標本平均は動く」まで飛ばしてください。
用語集
この記事の鍵になる3つだけ挙げておきます。すべて後で具体例つきで説明するので、いま覚える必要はありません。
| 用語 | 記号 | 意味 |
|---|---|---|
| 標本分布 | — | 統計量そのものが従う分布。データの分布ではない |
| 自由度 | 自由に動ける情報の個数。制約が1つあると1つ減る | |
| ピボット量 | — | 未知のパラメータを含むのに、分布がその値によらない量 |
3つ目のピボット量が今回の隠れた主役でした。名前を知らずに使っている概念で、私はここでいちばん長く引っかかりました。
標本平均は動く
まず土台から始めます。前回まで扱ってきたのは「データ1個がどこに落ちるか」の分布でした。今回はそこから一段上がります。
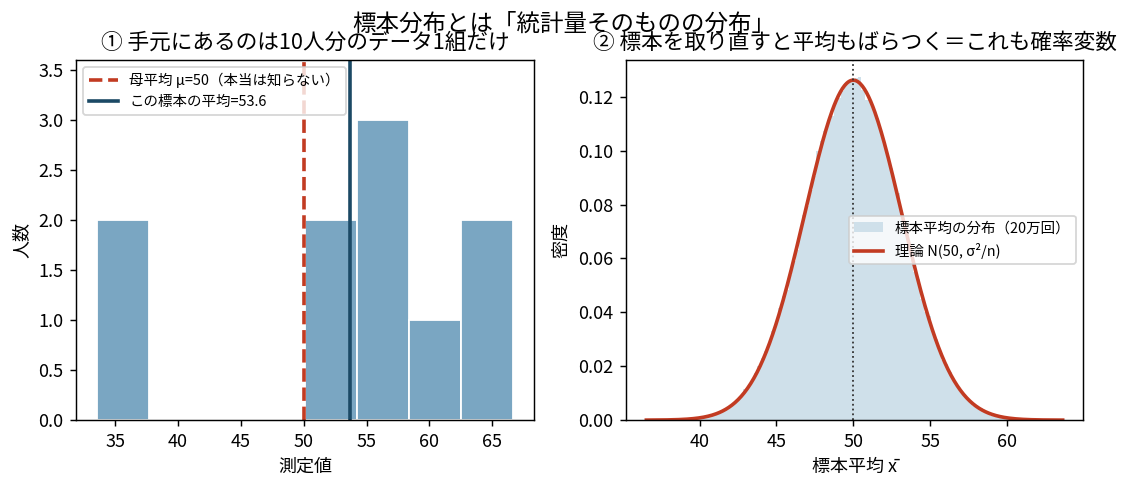
図の左では、同じ母集団から10個ずつ標本を取っています。1回目の平均、2回目の平均、3回目の平均——どれも同じ値にはなりません。当たり前のことですが、この当たり前を明示的に扱うのが今回の章でした。
右のヒストグラムが、その標本平均を大量に集めたものです。母平均のまわりに集まっていて、母集団そのものより幅が狭い。つまり標本平均は確率変数であり、それ自身の分布を持つ。これが標本分布です。
言い換えると、今回は「データの分布」ではなく「計算結果の分布」を扱います。平均を計算したら、その平均という数字がどれくらい信用できるのか。分散を計算したら、その分散はどれくらいブレるのか。ここが分かると、推定や検定という手続きが何をしているのかが見えてきます。
そして標本平均については、答えがすでに前回までの道具で出ています。母集団が なら、標本平均は
に従います。分散が で割られるのは、独立なものを足すと分散が足せるという第3回の性質から出てきます。ここまでは新しい分布が要りません。問題はこの先でした。
困りごと1:σ を知らない
の分布を使えば、母平均の95%信頼区間はこう書けます。
きれいな式ですが、実務でこの式を使おうとすると、いきなり手が止まります。σ を知らないのです。母集団の標準偏差を知っているなら母平均も知っているはずで、そもそも推定する必要がありません。
そこで誰でも思いつく対処をします。σ の代わりに、手元のデータから計算した標本標準偏差 を入れる。
この差し替えがどれくらい罪深いのかを、まず数字で見ました。
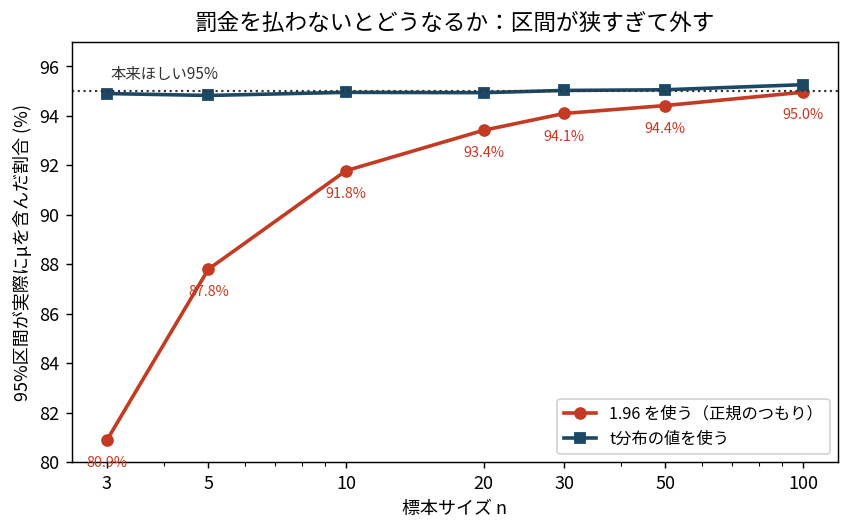
「95%信頼区間」と名乗っているのに、実際にμを捕まえた割合(被覆率)は n=10 で91.8%、n=3 では80.9% でした。名目より1割も低い。 を代入した瞬間に、区間は看板どおりの働きをしなくなっていたわけです。
そして図のもう一本の線が、t分布から取った値を使った場合です。こちらは小さい でも95%の線に乗っています。t分布はこの不足をぴったり埋めるために作られた分布だと分かりました。
罰金としてのt分布
では埋めるために何をしているのか。答えは単純で、1.96 より大きい数を使います。
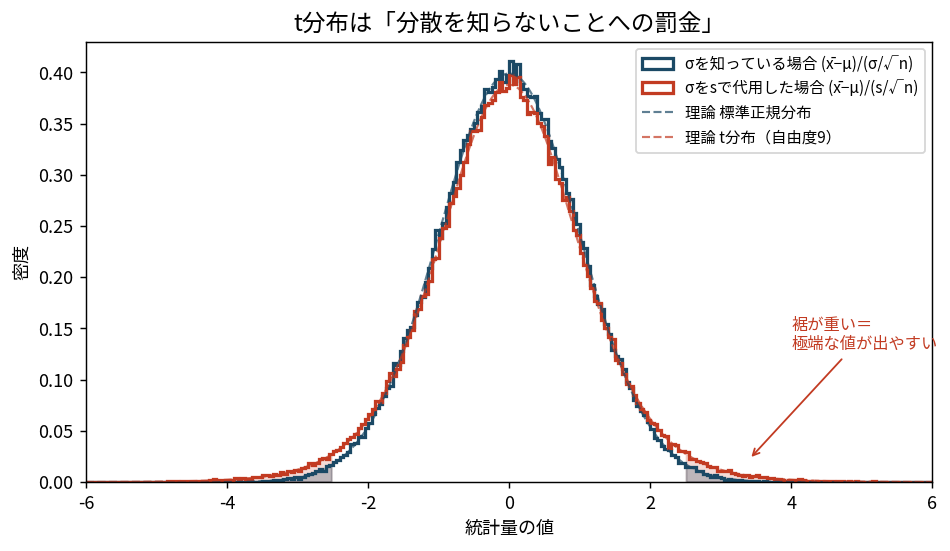
自由度9のt分布は、標準正規分布より中心が低く、裾が重い形をしています。同じ2.5%を切り取るために、より外側まで行かなければならない。実際に上側2.5%点は 2.2622(上側5%点は1.8331)で、1.96 より外にあります。
この「外側に行かされる分」が罰金です。額は分散で見ると分かりやすくて、自由度 のt分布の分散は
です。 なら 1.2857。標準正規の分散1に対して約29%ばらつきが増えている。σ を知らないというだけで、区間を3割ほど広く取らされるわけです。
罰金の額は自由度で変わります。 では分散が定義できず、 のt分布はコーシー分布そのもので分散を持ちません。データが1個ぶんしかないと罰金は無限、という極端な形でこの構造が現れます。
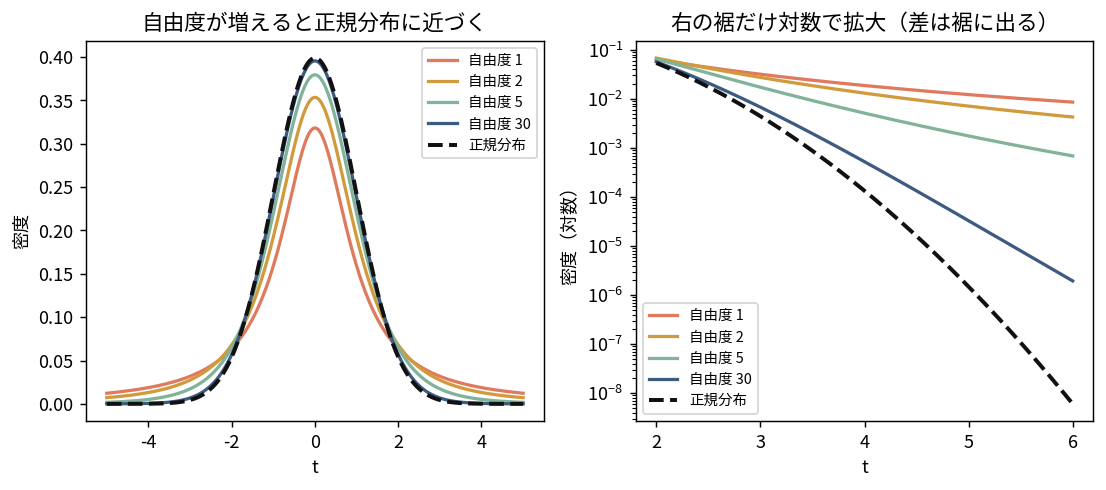
逆に自由度を上げると、t分布は正規分布に近づきます。データが増えれば が σ に近くなり、罰金が要らなくなる。図はその過程です。「 が大きければt分布でも正規分布でも同じ」という実務上の緩さは、この収束から来ていました。
ここで自分が間違えた: は小さめに出るから?
さて、なぜ裾が重くなるのか。私は自信をもって、こう説明していました。
は σ より小さめに出やすい。分母が小さいと は大きくなる。だから裾が重い。
これは間違いでした。しかも自然な誤解だと思うので、丁寧に書きます。同じ場所で詰まる方が多いはずです。
まず、 が小さめに出るという前半は半分だけ正しい。確かめてみると次のようになります。
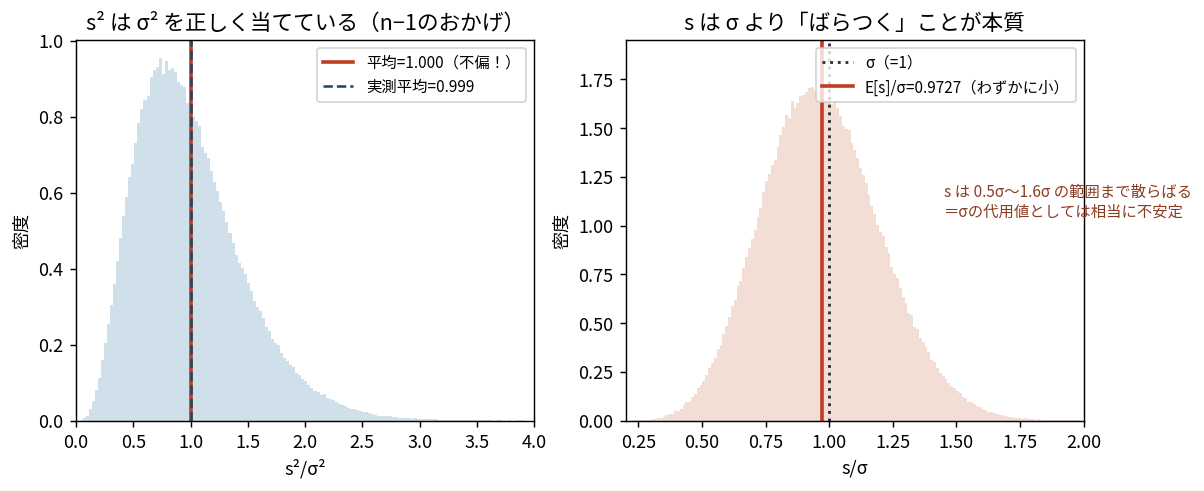
| 量 | n=10 での平均 | 偏りは |
|---|---|---|
| 1.000 | なし(不偏) | |
| 0.9727 | わずかに小さめ |
不偏なのは であって ではないのでした。平方根が非線形なので、期待値を取ると下にずれる。これは第4回で扱ったJensenの不等式とまったく同じ構造です。 なので、 になる。ここは自分の理解が一段深まった箇所でした。
ただし——これで裾の重さが説明できるかというと、できません。0.9727 という数字は σ から2.7%ずれているだけです。1.96 を2.7%膨らませても 2.01 程度で、2.2622 には全然届かない。
そこで実験を分けました。3段階の上側2.5%点を比べます。
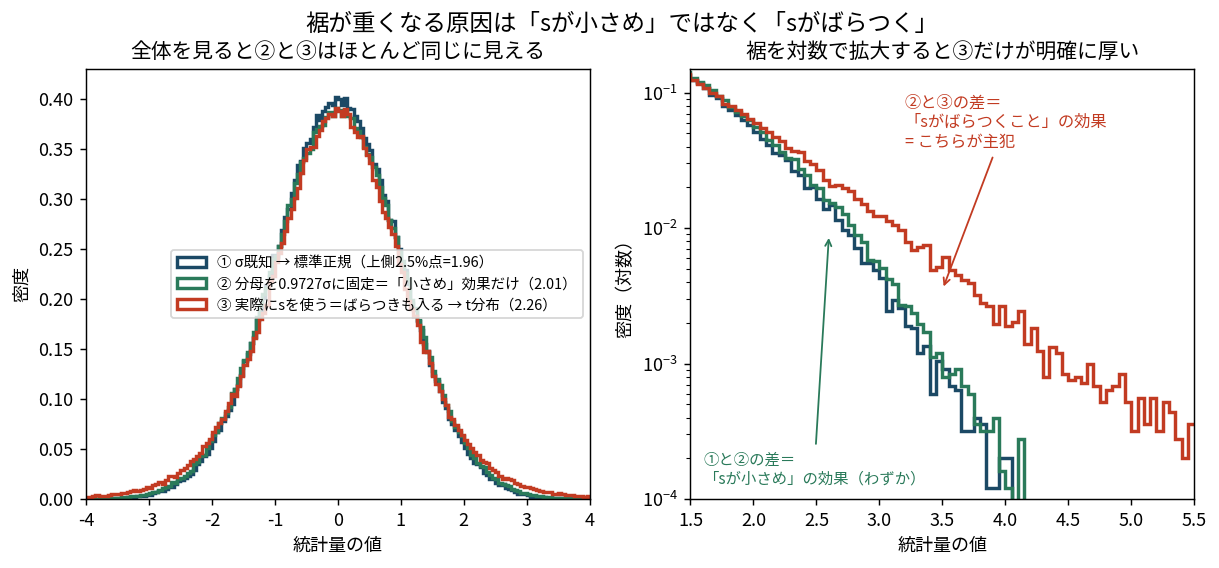
| 設定 | 分母 | 上側2.5%点 |
|---|---|---|
| ① σ 既知 | 1.959 | |
| ② 偏りだけ再現 | 定数 | 2.015 |
| ③ 実際のt統計量 | 2.261 |
1.96 から 2.26 への移動幅のうち、偏りが説明するのは 0.05 だけで、残る 0.25 はばらつきの寄与でした。裾が重い主因は「 が小さめ」ではなく、「 が標本ごとにばらつくこと」だったのです。図の右パネルで裾を対数に拡大すると、②と③の差がはっきり見えます。
橋渡しは の凸性
では「ばらつく」が「裾が重い」に変わるのはなぜか。ここも数字で追えました。効いているのは ではなく のほうです。
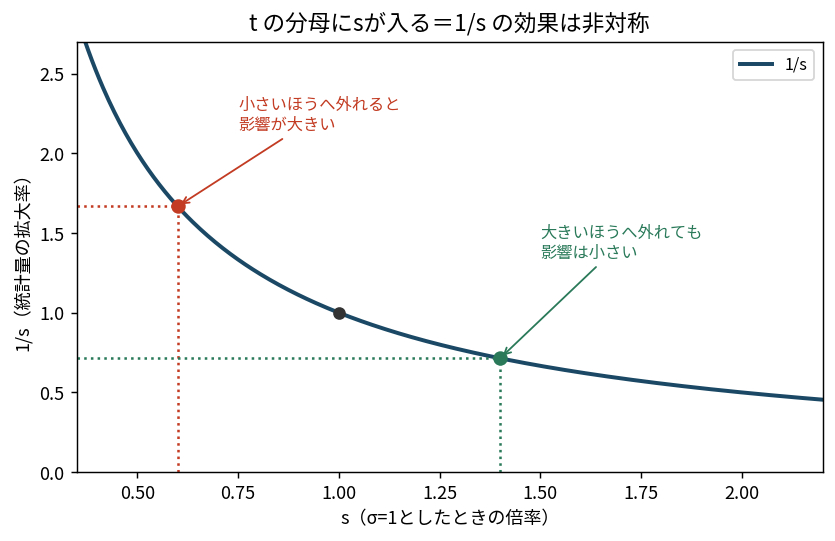
| が | は |
|---|---|
| 0.6倍に外れる | 1.67倍(+67%) |
| 1.4倍に外れる | 0.71倍(−29%) |
は下に凸なので、 が同じだけ上下に外れても、小さい側への外れが不釣り合いに大きく効きます。 が対称にばらついていても、 を通した後は上方向に長い裾ができる。t統計量の重い裾は、この変換の非対称性が作っていたわけです。
図の左パネルで が 0.5σ から 1.6σ まで散らばっていたことを思い出すと、0.6倍あたりへの外れは珍しい事故ではありません。1割程度の頻度で起きる出来事が、統計量を大きく吹き上げている。
n−1 で割ることと t分布を使うことは別問題
もう一つ整理が必要だったのが、第3回で扱った「なぜ n−1 で割るのか」との関係です。私は最初、この2つを同じ話だと思っていました。n−1 で割って補正しているのに、なぜさらにt分布まで必要なのか、と。
答えは、直しているものが違うからでした。
| 手当て | 直すもの | 意味 |
|---|---|---|
| n−1 で割る | 偏り | 平均すれば当たるようにする |
| t分布を使う | ばらつき | 1回1回の区間が当たるようにする |
「平均すれば当たる」と「1回1回当たる」は別の要求です。前者を満たしても後者は満たされません。
試しに n で割る(n−1 を使わない)版で計算し直しました。
| 分母 | 上側2.5%点 | |
|---|---|---|
| n で割る | 0.900 | 2.384 |
| n−1 で割る | 0.9998 | 2.261 |
n で割ると分散が1割小さく見積もられ、必要な臨界値は 2.384 まで悪化します。n−1 で割ったときの 2.261 は理論値 2.2622 に一致しました。
つまり 「n−1 で割る」と「t分布を使う」はセットで初めて正しくなる。片方だけでは足りません。この整理ができてから、両者を混同しなくなりました。
何を仮定していて、何を仮定していないのか
もう一点、前提を精密にしておきます。「σ が未知だから」と繰り返し書いてきましたが、t分布を使うとき何もかもが未知なわけではありません。
未知なのは母分散 です。一方で母集団の形が正規分布であることは既知として仮定しています。形を仮定してパラメータだけを未知とする、この立場がパラメトリック統計でした。あとでノンパラメトリック手法を学ぶときに区別が必要になる境目なので、ここで書き留めておきます。
では正規性はどこまで要るのか
そうなると次の疑問が来ます。母集団が正規でなかったら、t区間はどれくらい壊れるのか。
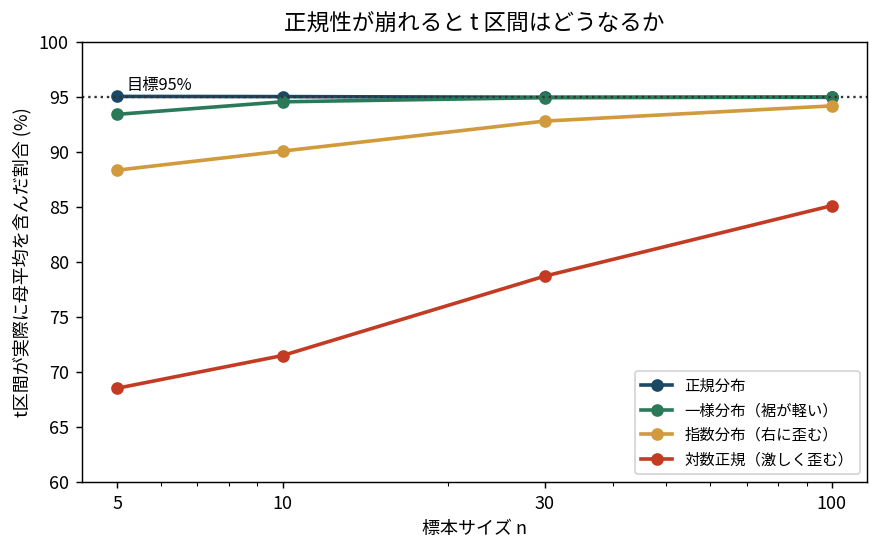
95%区間の被覆率を、母集団の形を変えて測りました。
| 母集団 | n=5 | n=10 | n=30 | n=100 |
|---|---|---|---|---|
| 正規 | 95.0% | 95.0% | 95.0% | 94.9% |
| 一様 | 93.4% | 94.5% | 94.9% | 95.0% |
| 指数 | 88.3% | 90.1% | 92.8% | 94.2% |
| 対数正規 | 68.5% | 71.5% | 78.7% | 85.1% |
一様分布は正規分布とかなり違う形(裾がない、平ら)なのに、n=10 で 94.5% とほぼ問題ありません。一方で対数正規分布は n=100 でも 85.1% で回復していない。
つまり問題は、「正規かどうか」ではなく「歪んでいるかどうか」でした。対称なら形が違っても頑健で、強い右歪みは標本を増やしても効かない。この一文が今回いちばん実務に持ち帰れる収穫でした。
よく言われる「n>30 なら正規近似で大丈夫」という説明は、対称に近い分布に限れば妥当という条件つきの経験則だったわけです。収入・滞在時間・購買金額のような右に歪んだ指標では、対数変換をかけるかブートストラップに切り替えるほうが素直です。前回の対数正規分布の話がそのまま効いてきました。
困りごと2:ばらつきそのものを知りたい
ここまでは平均が主役で、ばらつきは邪魔者でした。次はばらつき自体を推定したい場面に移ります。製品のばらつきを管理したい、収益の変動幅を知りたい、といった問いです。
このとき登場するのがχ²分布で、標本分散との関係はこう書けます。
そして最初に引っかかるのが形でした。
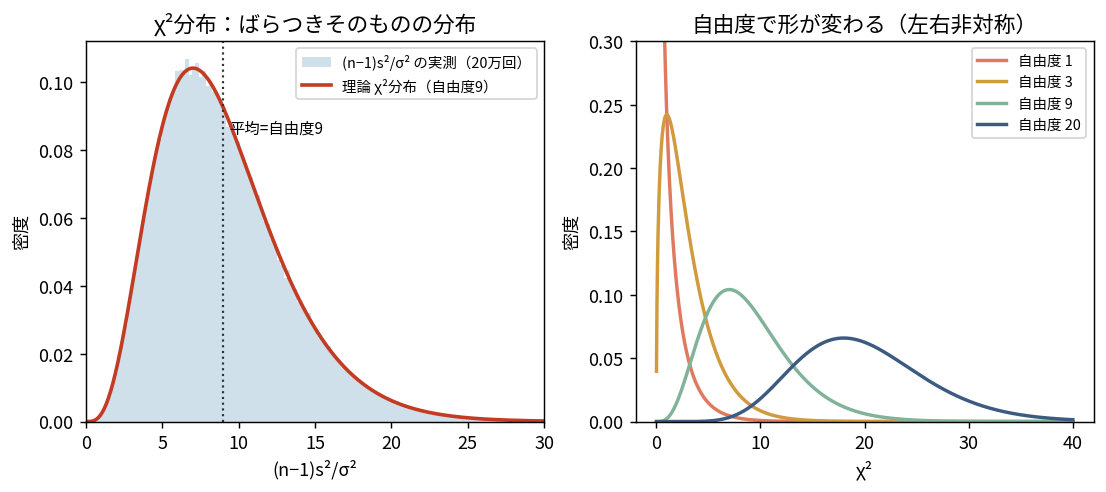
χ²分布は左右非対称です。正規分布やt分布のように「」で済みません。自由度9なら
で、上下でまったく別の値を引くことになります。符号を変えれば済むという癖が抜けていないと必ず間違える箇所で、実際に私も最初は上側だけ引いて済ませようとしました。2乗和なので負にならず、下限が0で押さえられている一方で上には無限に伸びる。その形が非対称を生んでいます。
「σ が式にあるのに未知でよい」のはなぜか
そしてここが今回いちばん時間をかけて考えた点です。上の式には σ が入っています。σ を知らないから推定しているのに、σ を使う式で何ができるのか。
答えは、この式の分布が σ の値に依存しないことにありました。 がどう散らばるかは自由度だけで決まり、σ が3でも300でも同じ χ²(9) になります。
だから不等式を書いて、σ² について解き直せます。
解き直した後には σ が残らず、 と自由度だけが残る。これが σ² の信頼区間でした。σ は「推定するための足場」として一度式に登場し、変形の途中で消えていく役回りだったのです。
この発想には名前がついていて、ピボット量(枢軸量)と呼びます。未知パラメータを含むのに分布がその値によらない量。t統計量 もまったく同じ構造で、μ を含むのに分布は μ によらないので、μ について解き直せば信頼区間が出ます。
ここまで来て気づいたのは、区間推定という手法自体がピボット量の発想の上に立っているということでした。個別のテクニックを2つ覚えていたつもりが、実は1つの原理の2つの適用例でした。
ただし分散の区間は非常に広い
実際に σ² の信頼区間を作って、被覆率を測ってみました。
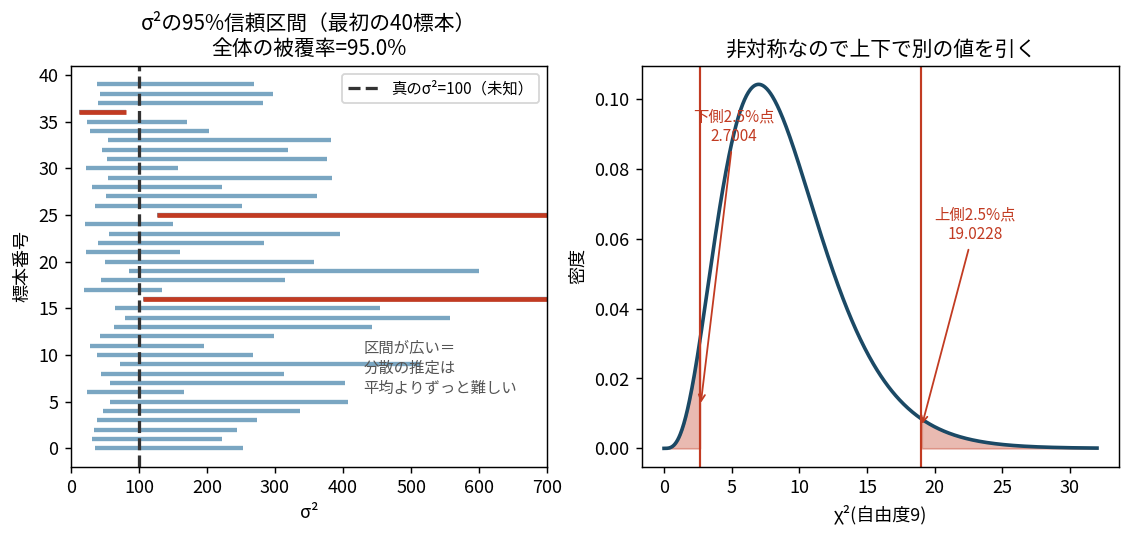
被覆率は 94.99% で理論どおりでした。手続きは正しく動いています。しかし図を見ると、区間が異様に長いのが目につきます。
これが素直な結論につながりました。分散の推定は平均の推定よりずっと難しい。同じデータ数でも、平均については狭い区間が出るのに、分散については「2倍違うかもしれない」程度の幅しか言えない。ばらつきを議論するときは、平均を議論するときより多くのデータが要るということです。
χ²のもう一つの顔:度数のずれ
さてχ²分布には、ここまでとまったく見た目の違う使い方があります。度数のずれの検定です。適合度検定や独立性の検定として出てくるもので、こちらのほうが実務では頻繁に登場します。
具体例で進めます。あるサイトの問い合わせ件数を曜日でまとめたとします。
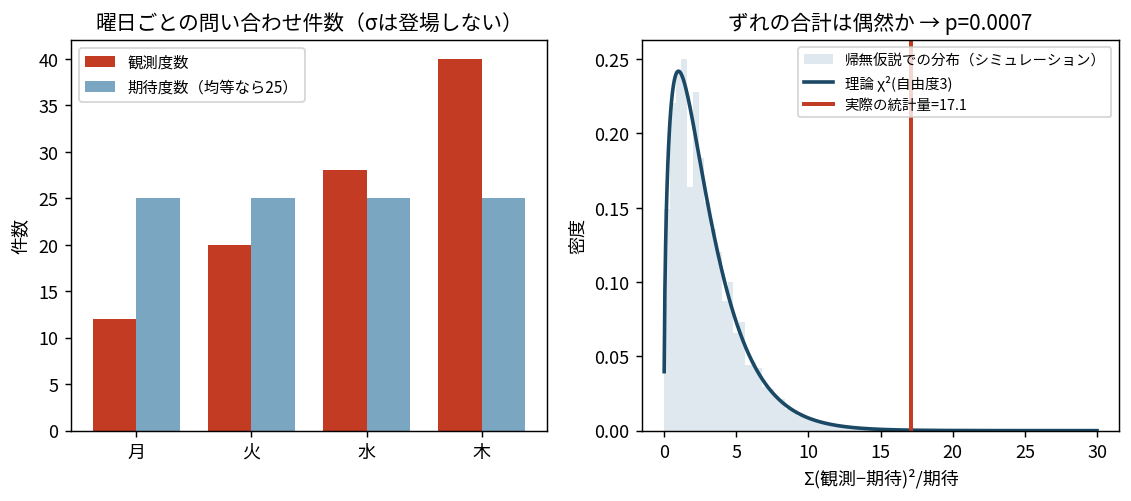
観測が 、どの曜日も同じなら期待は各25。ずれを次の式で測ります。
曜日による偏りは偶然では説明しづらい、という結論になります。
問題はこの式です。σ も も出てきません。 さっきまで標本分散とσ²の比を見ていたのに、こちらは観測度数と期待度数の話をしている。同じχ²という名前がついているのが、私にはずっと納得できませんでした。「χ²検定」と名前だけ与えて、なぜχ²になるのかを説明しない教科書が多いのも、この違和感を放置させている原因だと思います。
そこで5段階に分けて追いました。ここが今回の山場です。
STEP1:1項だけ見ると正規分布に近づく
まず を外して1カテゴリだけを見ます。あるカテゴリに入る件数 は二項分布に従います( 回のうち確率 で当該カテゴリに入る)。
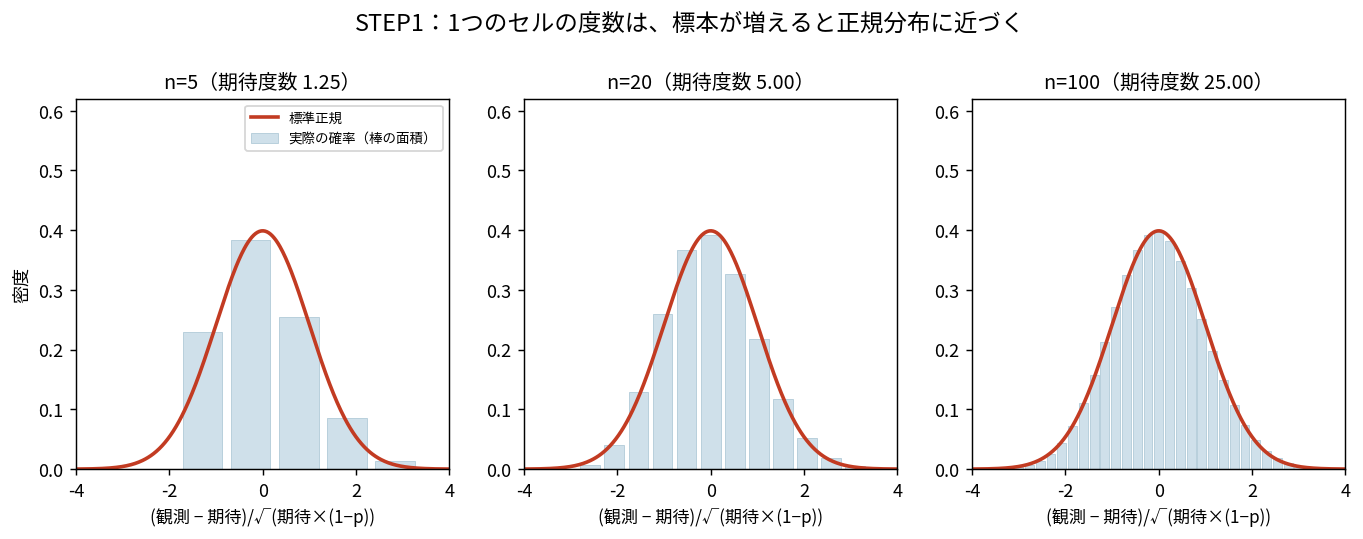
を大きくすると二項分布は正規分布に近づくので、標準化した
は標準正規分布に近づきます。ここまでは前回までの話の延長です。
ただし気になる点が残ります。検定の式の分母は ではなく (=)です。 が抜けている。このズレは STEP4 まで保留にします。
STEP2:2カテゴリなら恒等式になる
次に、カテゴリが2つだけの場合を計算してみました。 という関係が使えるので、素直に代入して整理できます。
近似ではなく恒等式でした。 が抜けていたのは、2項ぶんを足すと分母に が復活する形に約分されていたからです。
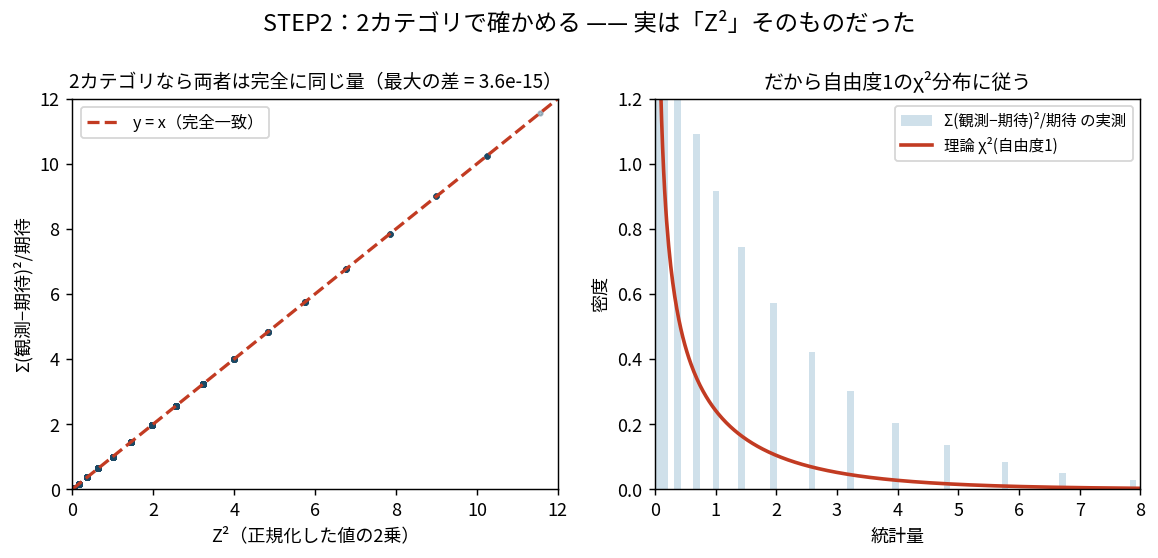
40万回のシミュレーションで両者の差を測ると、最大差 3.553e-15。浮動小数点の丸め誤差だけで、実質完全一致です。
このSTEPの価値は、視点が変わることでした。 はχ²の定義から外れた別物ではなく、 をわざわざ書かずに済むよう約分された形だったのです。名前が同じなのは偶然ではありませんでした。
STEP3:自由度が になる理由
カテゴリが 個あるなら、 を 個足すのだから χ²() では、と思ってしまいます。しかし正しくは χ²() です。
理由は制約でした。合計人数が固定されているので、ずれの合計は必ず0になります。
3つのカテゴリのずれが決まれば4つ目は自動的に決まる。自由に動けるのは 個だけです。
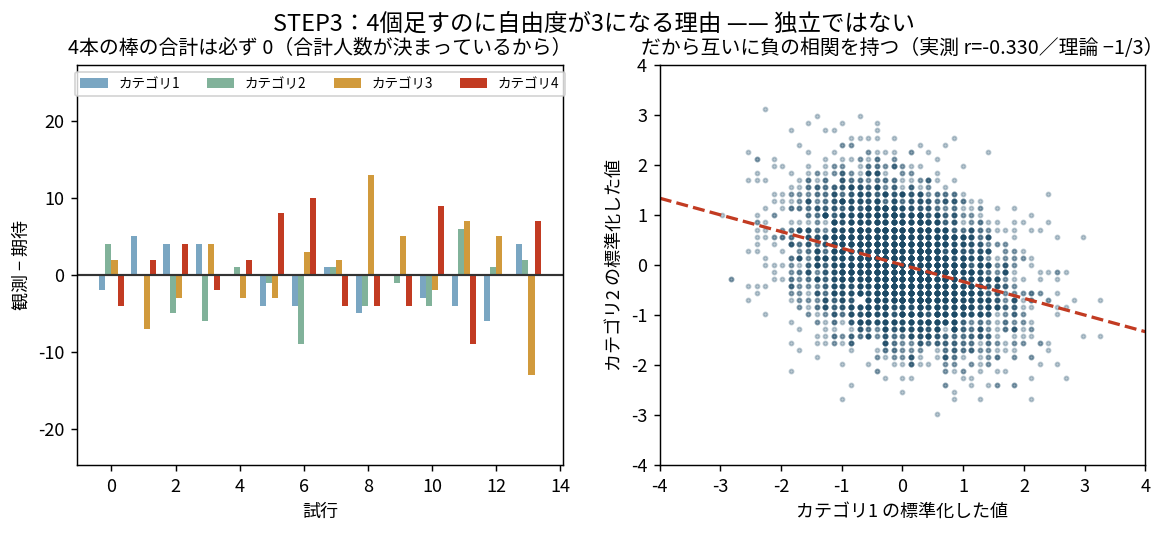
図の右で、2つのセルのずれの相関を取ると −0.330(理論値 −1/3)でした。合計が固定されているので、どこかが多ければどこかが少ない。負の相関はこの制約の現れです。
そしてここで第3回につながりました。標本分散が n−1 になるのも、偏差の和が0だからです。まったく同じ原理が、まったく違う見た目の場所で働いていた。「自由度」という言葉が抽象的に感じられていたのは、この共通の骨格を見ていなかったせいでした。
STEP4:2つのズレが打ち消し合う
ここで STEP1 の保留を回収します。各項の分母が なので、各項の2乗は分散1になりません。実際に測ると 0.748〜0.750、つまり ( なら 0.75)でした。
そして STEP3 で見たとおり、項の間には負の相関があります。
つまり2つの「合計を小さくする方向の効果」があるわけです。各項が1より小さい、項どうしが負に相関している。この2つがちょうど整合して、
という自由度に落ち着きます。 を足し上げると、ぴったり になる。
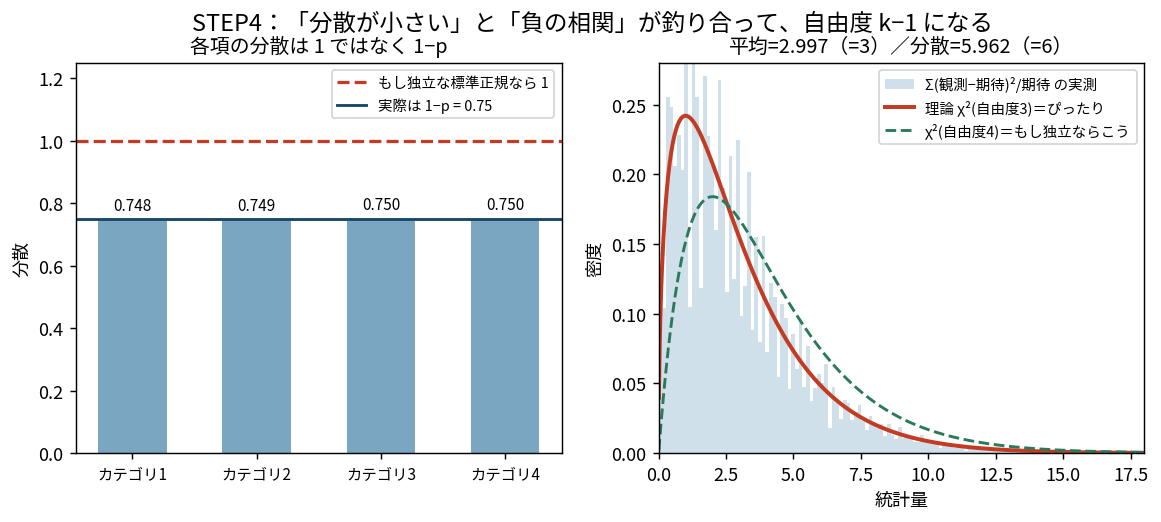
検証すると平均 2.997(理論3)、分散 5.962(理論6)で、χ²(3) と一致しました。χ²(4) の曲線とは明確にずれています。
ここで言い方を正確にしておきます。 は「」という定義をそのまま満たしているわけではありません。正しくは、「定義を満たす量とまったく同じ分布になることが証明されている」です。私は当初これを「定義を満たしている」と雑に理解していて、だからSTEP1の のズレに気づいたとき混乱しました。
STEP5:「期待度数5以上」の正体
最後に成立条件です。STEP2( での一致)は恒等式なので厳密ですが、STEP1(正規近似)は近似でした。 が小さければ近似は崩れます。
崩れ方を測りました。名目5%の検定が実際にどれくらい棄却するか、期待度数を変えて調べたものです。
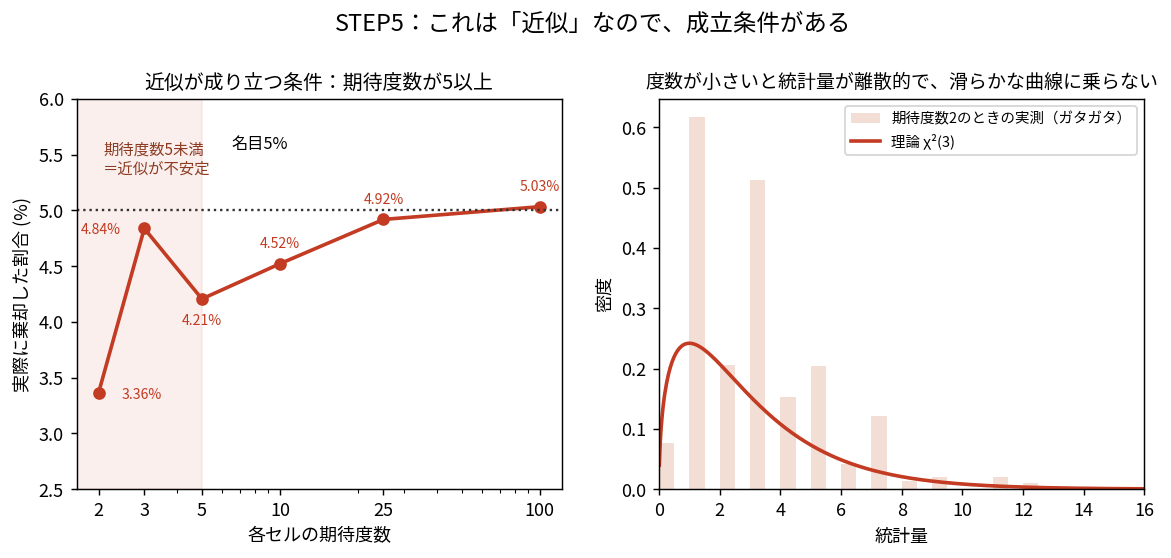
| 期待度数 | 実際の棄却率 |
|---|---|
| 2 | 3.36% |
| 3 | 4.84% |
| 5 | 4.21% |
| 10 | 4.52% |
| 25 | 4.92% |
| 100 | 5.03% |
大まかには、期待度数が小さいと名目より低く、大きくすると 5% に収束します。これが教科書に出てくる、「期待度数は5以上」の正体でした。呪文のような経験則だと思っていたものが、中心極限定理をどこから信用してよいかの目安だと分かった瞬間、覚える対象ではなくなりました。
ただし表をよく見ると、きれいに単調ではありません(期待度数3で4.84%なのに、5で4.21%に下がっている)。度数が離散なので、「棄却域に入る最初の値」がどこに来るかが刻み幅に振り回されるためです。小さい期待度数では棄却率が上下に揺れるので、1点の数字ではなく全体の傾向として読むのが正しい見方でした。
満たせない場合の対処もはっきりします。カテゴリを統合して度数を増やすか、近似を使わないフィッシャーの正確確率検定に切り替える。前回のA/Bテストの回で 検定とフィッシャー検定が食い違った話が、同じ根っこから出ていたことになります。
2つの用途は同じ骨格だった
ここまで見ると、χ²の2つの顔が同じものだと分かります。
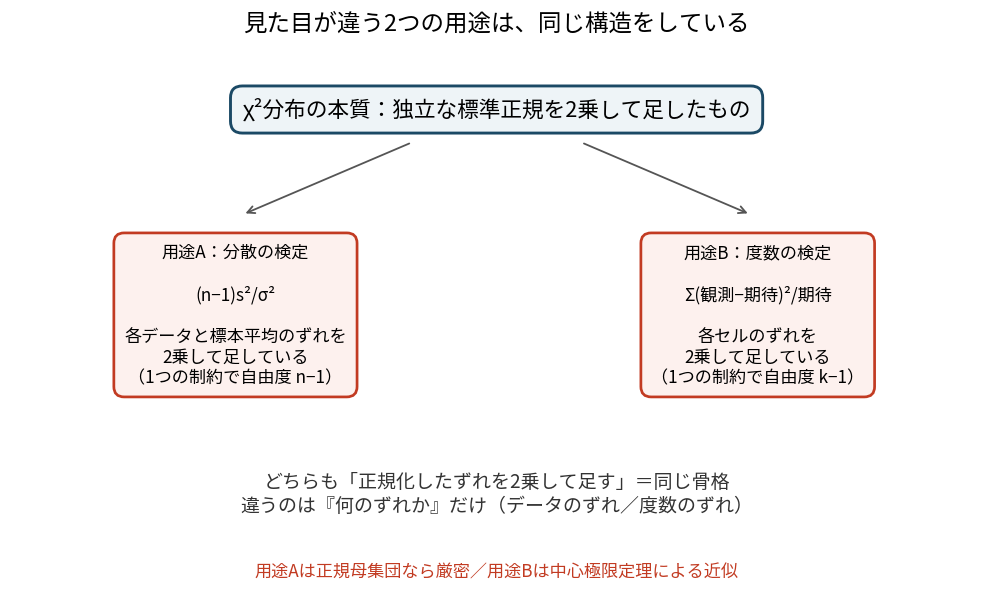
| 用途A:分散 | 用途B:度数 | |
|---|---|---|
| 何のずれか | データと標本平均のずれ | 観測度数と期待度数のずれ |
| 正規化に使うもの | σ | |
| 自由度が減る理由 | 偏差の和が0 | ずれの和が0 |
| 厳密さ | 正規母集団なら厳密 | 中心極限定理による近似 |
| 使う場面 | 品質管理、ボラティリティ、「平均は同じだが安定性が違う」 | 適合度検定、独立性の検定 |
骨格は共通です。正規化したずれを2乗して足す。制約が1つあるので自由度が1減る。 違うのは「何のずれを見るか」と「厳密か近似か」だけでした。
用途Aは「平均は同じだが安定性が違う」を示したい場面で効きます。2つのサーバのレスポンスタイムが平均では同じでも、片方だけ大きく振れているなら運用上の意味は違う。用途Bは度数の話なので、ばらつきの言葉が一切出てきません。見た目が違うので別物として覚えていましたが、1つにまとめられました。
困りごと3:ばらつきを比べたい
最後はF分布です。1つのばらつきではなく、2つのばらつきの比を扱います。
χ²を2つ用意して割ったもの、という構造です。
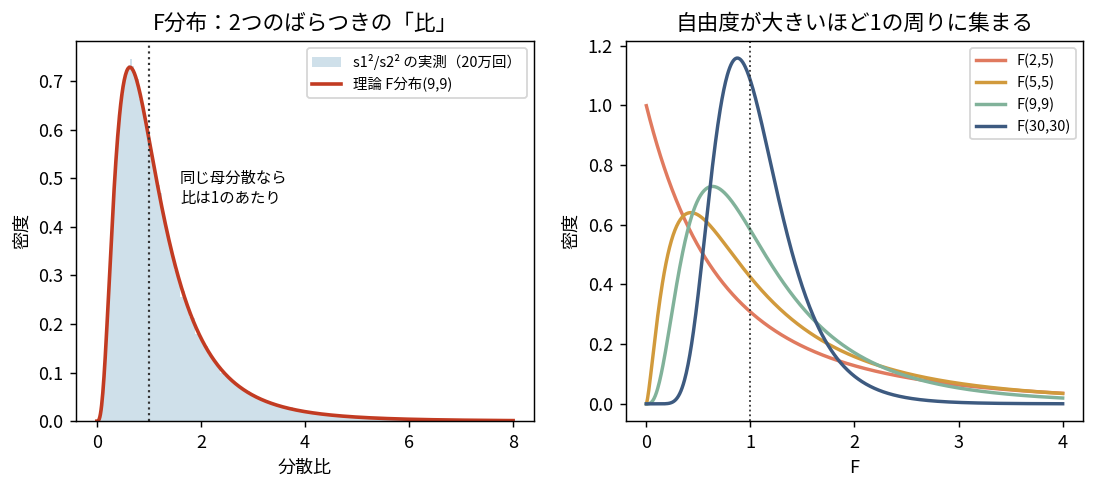
この分布で真っ先に驚いたのが上側5%点の大きさでした。F(9,9) の上側5%点は 3.179。つまり
母分散がまったく同じでも、n=10 なら標本分散の比が3倍を超えることが5%の確率で起きる。
10個ずつのデータで「こっちのほうがばらつきが大きい」と言うのは、想像よりずっと危ういわけです。さっきσ²の信頼区間が広かったことと同じ話を、比の形で見ていることになります。
そしてt分布との関係も確認できました。
に対して F(1,9) の上側5%点は 5.1174。一致します。t分布はF分布の特別な場合だったわけで、2群の比較でt検定と分散分析が同じ結論を出す理由もここにありました。両側2.5%ずつを見ることと、2乗して上側5%を見ることが同じ操作になっている。
主役は等分散検定ではなく分散分析
F分布の説明は「2群の等分散検定」から入ることが多いのですが、実際に使う場面はそちらではありませんでした。主役は分散分析、つまり3群以上の平均の比較です。
例を見ます。
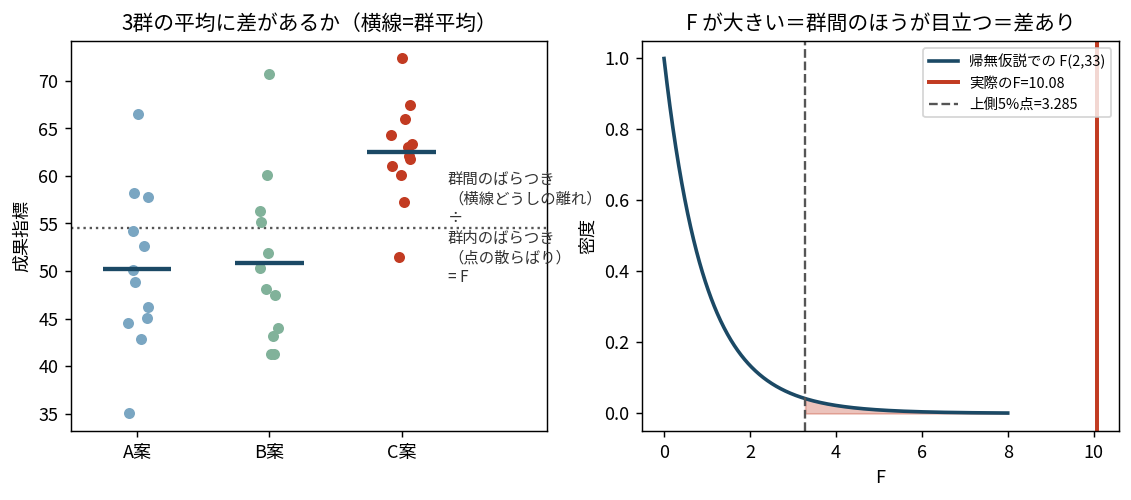
3群それぞれ n=12 のデータで、。F(2,33) の上側5%点 3.2849 を大きく超えているので、群による平均の違いは偶然では説明しづらいという結論になります。
ここで一度立ち止まる価値があります。知りたいのは平均の差なのに、計算しているのはばらつきの比です。この翻訳が分散分析の核心でした。
群の平均が離れていれば分子が大きくなります。しかし「離れている」と言うには基準が必要で、その基準に群内のばらつきをものさしとして使う。群内が大きければ、群間が多少離れていても偶然の範囲です。
比を取るので単位が消え、無次元の量になります。だから 3.2849 のような絶対的な基準値で判定できる。t統計量を標準誤差で割って 1.96 と比べるのと、まったく同じ発想でした。「誤差のものさしで測る」という一手が、統計の検定の共通形だと見えてきます。
なぜ3群をまとめて1回で検定したいのかという動機も、ここに絡みます。t検定を3回繰り返すと、どれか1つが偶然有意になる確率が上がってしまう(多重比較の問題)。一度の検定で済ませたい、という要求に分散分析が応えているわけです。
等分散検定としてのF検定は、いま使わない
一方で、教科書の入口だった等分散検定については、実務上の注意を書いておく必要があります。
F検定による等分散の判定は正規性の崩れに弱いうえに、「等分散を検定してから t検定の手法を選ぶ」という二段構えが検定全体の性質を歪めます。データを見て手続きを決めているので、名目の有意水準が保証されなくなる。このため現在は非推奨とされ、最初からWelchのt検定を使うのが標準になっています。
F分布の存在価値は等分散検定ではなく、分散分析と回帰分析のほうにありました。この整理ができたのは今回の収穫の一つです。
3つは正規分布から作った部品だった
ここまで困りごとから並べてきましたが、最後に構造として見直します。
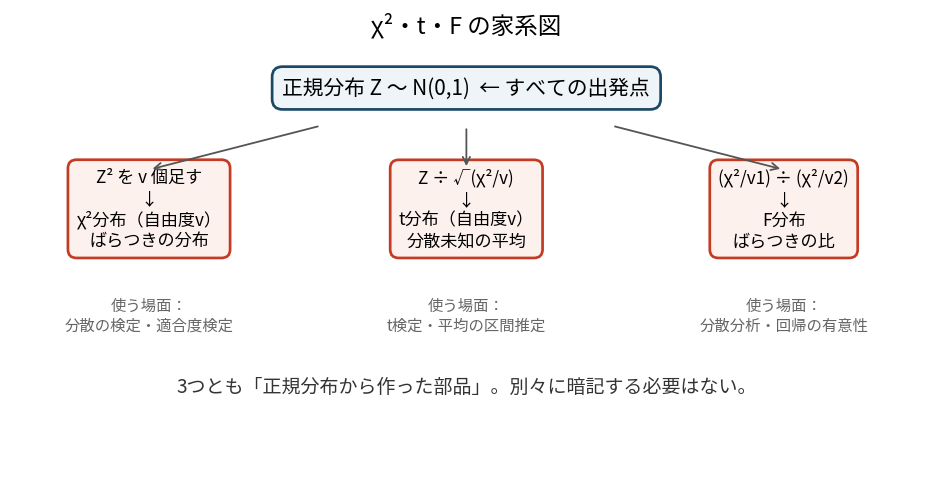
| 分布 | 正規分布からの作り方 | 答える問い |
|---|---|---|
| χ² | 標準正規を2乗して足す | ばらつきはどれくらいか |
| t | 正規 ÷ | σ を知らないとき平均はどこか |
| F | χ² ÷ χ² | 2つのばらつきの比はどうか |
3つとも正規分布から作られています。だから最初に見た定義()は、覚える対象ではなく作り方の記録でした。
そして作り方を見ると、なぜ自由度というパラメータが付いてくるのかも自然です。何個足したか、何個で割ったかが分布の形を決める。分布ごとにパラメータの意味を覚え直す必要はありませんでした。
ブログ運営に使ってみる
この回の道具は、自分のブログ分析にそのまま持ち込めます。
まず独立性の検定です。「流入元(検索/SNS/直接)× アフィリエイトリンクのクリック有無」でクロス集計を作り、χ²検定にかければ、流入元によってクリック率が本当に違うのか、それとも偶然の範囲かを判定できます。管理画面の数字を見て「SNS経由のほうが反応がいいな」と感じることがありますが、件数が少ないうちはそれが偶然の範囲であることが多い。感覚を検定に通すと、施策を打つ前に思い込みを削れます。
ただし今回学んだ注意がそのまま効いてきます。セルを細かく割ると期待度数が小さくなる。 「流入元5種類 × デバイス3種類」で15セルに分けると、1000セッションあっても平均66件で、偏りがあれば数件しか入らないセルが出ます。そうなるとSTEP5で見たとおり、検定の結果が名目どおりに機能しません。期待度数の最小値を必ず確認するのが実務の作法だと分かりました。細かく割りたい気持ちを抑えて、まず2×2で見るほうが確実です。
A/Bテストで平均を比べるときの注意もあります。滞在時間やコンバージョン単価のような右に歪んだ指標にそのままt検定を当てると、対数正規の被覆率(n=100 で85.1%)で見たように区間が看板どおりに働きません。この手の指標では対数変換をかけるか、ブートストラップに切り替える。前回のベータ分布の話と合わせると、指標の性質に応じて手法を選ぶ判断ができるようになってきました。
この回で押さえること
| 問い | 答え |
|---|---|
| 標本分布とは | データの分布ではなく統計量の分布 |
| σ を知らないとき | t分布。罰金の額は分散 で、 なら29%増 |
| t分布の裾が重い真因 | が小さめだからではなく、 がばらつくから。 の凸性が変換する |
| n−1 と t分布の関係 | n−1 は偏りを直し、t分布はばらつきを直す。セットで初めて正しい |
| t区間が壊れる条件 | 正規でないことではなく歪んでいること |
| χ²の式にσがあるのに未知でよい理由 | 分布がσによらない(ピボット量)ので解き直せる |
| がχ²になる理由 | k=2 なら と恒等式。自由度 はずれの和が0だから |
| 「期待度数5以上」の意味 | 中心極限定理を信用してよい目安 |
| F分布の使いどころ | 等分散検定ではなく分散分析・回帰分析 |
そして冒頭に置いた見方に戻ります。
3つの分布は、正規分布から作った部品である。定義を覚えるのではなく、どんな困りごとに答えるために作られたのかを覚える。
定義から入っていたら、たぶん今回も「 の2乗和」という文字列だけが残って数日で消えていました。困りごとの順に並べ直したことで、試験問題を見たときに「これはσが未知だからt」「これはばらつきの比だからF」と入口から選べる状態になりました。
前回・前々回とのつながり
今回は過去の回が何度も戻ってきました。
| つながった先 | どこで |
|---|---|
| 第3回 分散 | n−1 の意味、偏差の和が0だから自由度が1減るという共通原理 |
| 第4回 変数変換 | をJensenの不等式で説明、 の凸性 |
| 第6回 連続分布 | 右に歪んだ分布の扱い、正規近似が効く条件、フィッシャーの正確検定 |
とくに「偏差の和が0だから自由度が減る」が、標本分散と度数の検定という無関係に見える2箇所で同じ働きをしていたのが印象的でした。前回「前の章を飛ばすと後で必ず戻ってくる」と書きましたが、今回はその実例が最も多い回になりました。
次回
次回は大数の法則と中心極限定理を扱う予定です。
今回は「 を大きくすると近似が効く」という言い方を何度も使いました。期待度数5以上の話でも、正規性の頑健性の話でも、t分布が正規分布に近づく話でも。その根拠になっている定理を、まだ正面から扱っていません。なぜ を大きくすれば当たるようになるのか、そしてどれくらい大きければ十分なのかを、次はそこから見ていきます。
この連載は、うまくいった記録だけでなく詰まった箇所も含めて書いています。同じく準1級を目指している方、一度挫折した方の参考になれば嬉しいです。