大数の法則と中心極限定理:世論調査はなぜ2000人で足りるのか【第8回】
はじめに
前回(第7回)は標本分布を扱いました。その中で私は「 を大きくすると近似が効く」という言い方を何度も使っています。期待度数5以上の話でも、t分布が正規分布に近づく話でも、正規性がどこまで要るかという話でも、結論はいつも「 が大きければ大丈夫」でした。
しかし、その根拠になっている定理を正面から扱っていません。前回の末尾で自分にこう宿題を出しました。
なぜ を大きくすれば当たるようになるのか、そしてどれくらい大きければ十分なのか。
今回はここに答えます。扱うのは大数の法則と中心極限定理で、教科書では確率論の締めくくりに置かれている2つです。
ただ、この2つは定義から入ると本当につまらない章でした。「標本平均は母平均に確率収束する」「標準化した和は標準正規分布に分布収束する」——読めば分かるのですが、読み終えても手元に何も残りません。実際、私は第1回で中心極限定理のアニメーションまで作っています。指数分布から標本平均を取り、 を1から50まで動かして形が釣鐘に変わっていく様子を眺めました。歪度が で減っていくことも実測しました。それでも、あのときは「形が正規に近づく」を眺めただけで、それが何の役に立つのかは分かっていませんでした。
今回は入口を変えます。困りごとから始めます。
1億人以上いる国で、たった2000人に聞いて支持率が分かるのはなぜか。
この問いに答えようとすると、2つの定理が必要な理由と、それぞれの役割の違いがはっきり出てきました。そして途中で、自分が数年単位で誤解していた点にぶつかりました。1.96 という数字の意味です。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
TL;DR
- 大数の法則が言うのは「いつか寄る」だけ。「 でどれくらい近いか」には答えない。この空白を埋めるのが中心極限定理
- 誤差は でしか縮まない。誤差を半分にするにはデータを4倍。n=500 で ±4.38pt、2000 で ±2.19pt、8000 で ±1.10pt
- 2000人という数字は理論値ではなく、精度とコストの折り合い点。ここから先は投資に対する見返りが急激に悪くなる
- 誤差の式に母集団の人数 が出てこない。1万人の町でも1億人の国でも、2000人聞けば同じ ±2.19pt
- 中心極限定理の御利益は「形が釣鐘になる」ことではなく、元の分布が何であれ同じ公式が使えること。支持率でもクリック率でも滞在時間でも同じ手順になる
- 私は 1.96 を「95%の外側の部分」だと思っていた。誤りは二重で、内外が逆であり、そもそも 1.96 は確率ではなく横軸上の位置
- 「1.96=場所、95%=面積」。±2.19pt が出てくるのは 1.96個分 × 標準誤差1.118pt という二階建ての翻訳を経ているから
- 被覆率を10万回測ると真の で 94.80%。ただし正しい言い方は「真の値が区間に入る確率が95%」ではなく「この作り方で区間を引くと95%の場合に真の値を捕まえる」
- 条件を外すと本当に壊れる。コーシー分布では を1000倍にしても平均が縮まらず、 では正規近似の上側2.5%点が 1.96 ではなく 3.12 になる
- 覚えるべき目安は ではなく かつ 。ただしこれは最低ラインで、歪んだ分布では満たしてもまだ足りない。CVR 0.5% のA/Bテストで「30件集まったから正規近似」は完全に誤り
統計の用語が出てくるので、先に用語集を置いておきます。用語を知っている方は「大数の法則:たくさん集めれば真の値に寄る」まで飛ばしてください。
用語集
この記事の鍵になる3つだけ挙げておきます。すべて後で具体例つきで説明するので、いま覚える必要はありません。
| 用語 | 記号 | 意味 |
|---|---|---|
| 標本誤差 | — | 全員に聞かず一部だけ聞いたことから生じるずれ。集計ミスや嘘の回答とは別物 |
| 標準誤差 | 標本平均(や標本比率)そのものの標準偏差。データのばらつきではなく推定値のばらつき | |
| 被覆率 | — | 「95%信頼区間」と名乗る区間が、実際に真の値を含んだ割合 |
2つ目の標準誤差が今回の主役です。前回も使った言葉ですが、今回はこれを具体的な数字として計算し、報道で見る「±2ポイント」に翻訳するところまでやります。
大数の法則:たくさん集めれば真の値に寄る
まず大数の法則から始めます。主張自体はごく素朴で、「データをたくさん集めれば、標本平均は母平均に近づく」というものです。式で書けば
となります。コインを投げ続ければ表の割合は 0.5 に近づく。世論調査で聞く人数を増やせば、推定した支持率は本当の支持率に近づく。誰でも直感的に受け入れる話です。
実際にどう寄るのかを見てみました。真の支持率を 50% とした母集団から、標本サイズ を増やしながら調査を繰り返した図です。
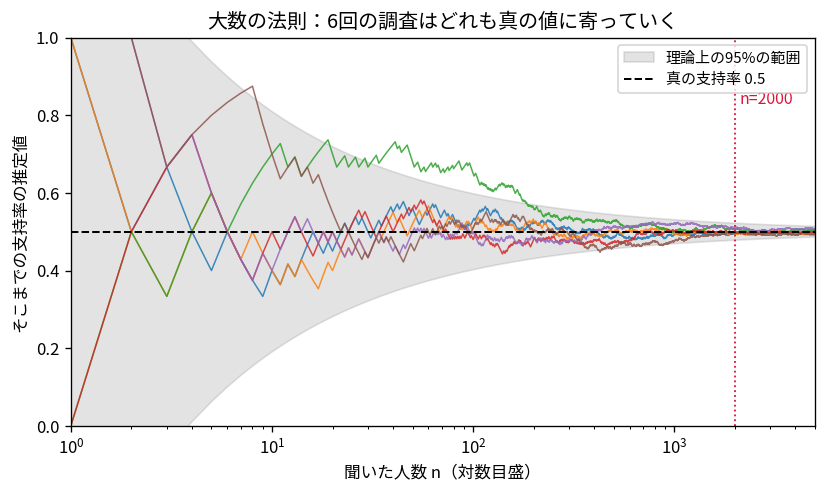
6本の線がそれぞれ独立な調査です。左端では推定値が真の値からかなり外れていて、線ごとにバラバラの位置にあります。右に行くにつれて6本が真ん中の 50% に収束していきます。これが大数の法則の絵です。
ここで注目したいのは折れ線ではなく、背景の灰色の帯です。帯は理論上の95%範囲、つまり「調査を無限回やったら95%はこの中に入る」という幅を表しています。この帯の細り方が思っていたより緩やかでした。横軸が対数目盛なので、目盛1つ進むごとに は10倍になっています。それなのに帯の幅は3倍ちょっとしか細くなりません。
この「10倍集めても3倍しか良くならない」が今回の話の中心になります。先に指摘しておくと、これは大数の法則が保証している範囲の外の話です。
大数の法則は「いつか」しか言わない
そして、ここが私の最大のつまずきでした。大数の法則を初めて習ったとき、率直に「で、それが何なの」と思ったのです。表の割合が 0.5 に近づくことは投げる前から知っている。定理として証明されるほどのことなのか、と。
理由が分かりました。大数の法則は「いつか寄る」しか言っていないからです。
実務で知りたいのは、そこではありません。手元にあるのは 2000人分のデータで、 にはできません。知りたいのは次の問いです。
いま持っている2000人のデータで、真の値からどれくらいずれている可能性があるのか。
大数の法則はこれに答えません。「 を無限に大きくすれば誤差は0に近づく」と言うだけで、 のときの誤差が ±2pt なのか ±20pt なのかは何も教えてくれません。方向を示しているだけで、距離を測ってくれないのです。
この整理ができたとき、2つの定理の分担がやっと見えました。
| 定理 | 答える問い | 答えの形 |
|---|---|---|
| 大数の法則 | 集めれば当たるのか | 当たる(ただし で) |
| 中心極限定理 | いま何ポイントずれているのか | ±2.19pt( を入れると数字が出る) |
大数の法則は「近づく」という保証であり、中心極限定理は「どれくらい」という見積もりです。保証だけでは仕事になりません。逆に、近づく保証がないところで見積もりを出しても意味がありません。両方あって初めて、2000人のデータから支持率を語れるようになります。
教科書がこの2つを並べて置いている理由が、ここでようやく分かりました。似ているから並べているのではなく、片方の欠けているところをもう片方が埋めているから並んでいるのでした。
なぜ2000人なのか:√n の壁
では中心極限定理の側から、具体的な数字を出してみます。支持率のような比率の場合、95%の誤差の幅は次の式で書けます。
は真の比率です。 は第3回で見たベルヌーイ分布の分散で、 のとき最大の 0.25 になります。つまり最も精度が出にくいのが 50% 前後ということで、これは後で被覆率の節でもう一度出てきます。ここでは一番厳しい で計算します。
1.96 という数字については後の節で正面から扱うので、いまは「95%を切り取るための係数」として置いておいてください。実際に を変えて計算した値を並べます。
| 標本サイズ | 95%の誤差 | 前の行からの改善 |
|---|---|---|
| 500 | ±4.38pt | — |
| 1000 | ±3.10pt | 1.41分の1 |
| 2000 | ±2.19pt | 1.41分の1 |
| 4000 | ±1.55pt | 1.41分の1 |
| 8000 | ±1.10pt | 1.41分の1 |
| 16000 | ±0.77pt | 1.41分の1 |
を2倍にするたびに誤差が 分の1になっています。式の分母に がいるので当然ですが、この当然が実務では厳しい制約になります。
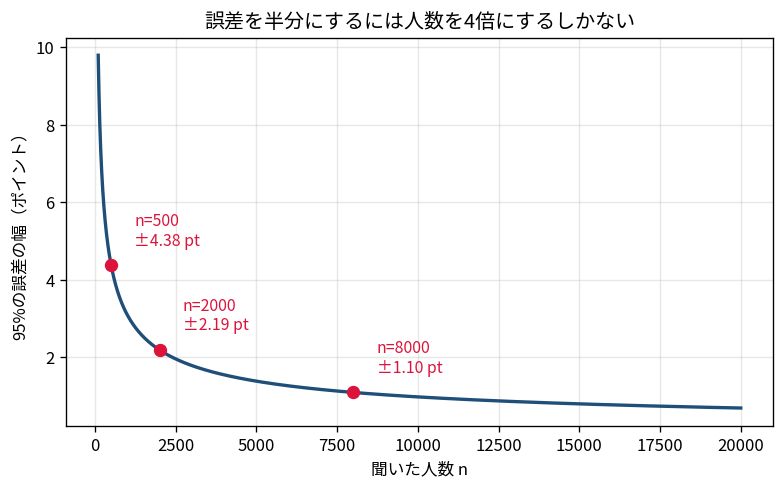
図の形が全部を語っています。左側の急降下と、右側のほぼ水平。500人から2000人へ 1500人追加すると、誤差は 4.38pt から 2.19pt へ 2.19pt ぶん改善します。ところが 2000人から8000人へ 6000人追加しても、2.19pt から 1.10pt へ 1.09pt ぶんしか改善しません。追加した人数は4倍なのに、得られた改善は半分です。
言い換えると次のようになります。
誤差を半分にしたければ、データを4倍集めなければならない。
これが私の中で「√n の壁」として腹に落ちた点でした。誤差は に反比例するのではなく に反比例します。データを増やす努力は線形にしか払えないのに、精度は平方根でしか返ってきません。
2000という数字の正体
ここまで来ると、報道の世論調査がだいたい1000〜2000人で止まっている理由が説明できます。
での誤差は ±2.19pt です。支持率が「43%」と出たとき、実際は 41%〜45% くらいの範囲にある、という精度になります。政権支持率が上がったか下がったかを月単位で追うには、これで足ります。
そして 2000人から先に進むと何が起きるか。誤差を ±1.10pt にするには8000人が必要で、電話をかける手間もコストも4倍になります。得られるのは 1.09pt の改善だけです。さらに ±0.55pt を目指すなら3万2000人ですが、そこまでやっても現実には別の誤差のほうが大きくなります。電話に出てくれない人の偏り、質問の言葉づかいによる回答の変化、回答者が本心を答えないこと——これらは標本誤差ではないので、 をいくら増やしても消えません。
つまり 2000 は、理論から導かれた必要数ではなく、標本誤差が他の誤差と同じくらいの大きさになるあたりで止めた折り合い点でした。 の壁があるからこそ、この折り合いの位置が「もっと増やしても仕方ない」というはっきりした形で決まっているわけです。
この見方は自分のブログの数字にもそのまま効きました。アクセス解析で日別のクリック率を見て一喜一憂していたのですが、1日100セッション程度なら誤差は容易に5ポイントを超えます。週次でまとめて を7倍にしても、誤差は 分の1にしかなりません。「もう少しデータが溜まれば分かる」と思っていた判断の多くは、実は必要な が桁で足りていなかったのだと分かりました。
一番の驚き:母集団の人数は式に出てこない
さて、ここが今回いちばん驚いた箇所です。
さっきの誤差の式をもう一度見てください。
母集団の人数がどこにもありません。
有権者が1億人でも、社員が1万人でも、村人が500人でも、式に入るのは真の比率 と標本サイズ だけです。私はこれを最初、式の書き間違いか、何か省略された前提があるのだと思いました。1億人から2000人を選ぶのは全体の 0.002% です。0.002% しか見ていないのに、20% を見た場合と同じ精度が出るというのは、素朴な感覚に反します。
もちろん厳密には母集団サイズの効果があって、有限母集団修正と呼ばれる係数が付きます。
が母集団サイズ、 が標本サイズです。これを掛けた実際の誤差を計算してみました。 に固定して、 だけを動かします。
| 母集団 | 修正係数 | 95%の誤差 |
|---|---|---|
| 1万 | 0.894 | ±1.96pt(この 1.96 は後述の とは無関係の偶然) |
| 10万 | 0.990 | ±2.17pt |
| 100万 | 0.999 | ±2.19pt |
| 1億 | 0.99999 | ±2.19pt |
10万人を超えたあたりで、修正係数はほぼ1になります。100万人と1億人で誤差が同じです。100倍違う母集団に対して、同じ2000人で同じ精度が出ています。
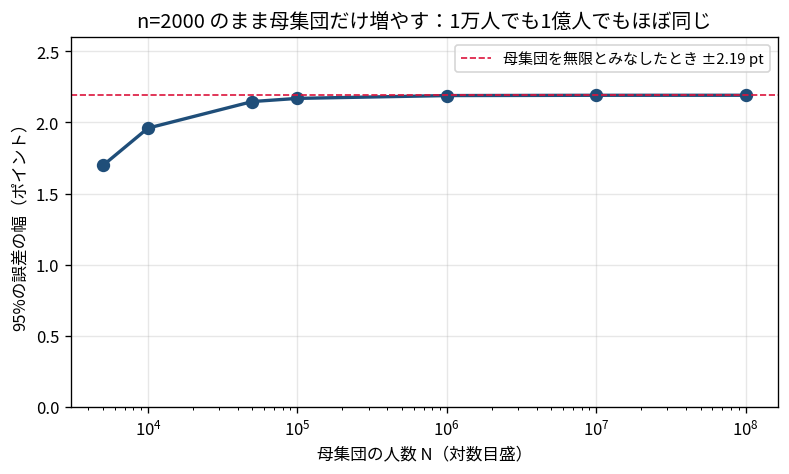
図では 10万人あたりから水平になり、赤い破線に貼り付いています。それ以降は母集団を何倍にしても誤差が動きません。
そして興味深いのは、修正係数が1より小さいということです。つまり母集団が小さいほうが誤差が小さい。1万人の町から2000人聞けば ±1.96pt で、1億人の国から2000人聞くより精度が良いことになります。母集団の 20% を聞いているのだから当然と言えば当然で、極端に まで持っていけば係数は0、つまり全員に聞いたので誤差ゼロです。
本当にそうなのか自分で確かめた
ここは信じきれなかったので、実際に母集団を作って確かめました。 人ぶんの0と1を用意し、そこから2000人を非復元で(同じ人を二度選ばないように)抜き出して比率を計算する。これを2万回繰り返して、推定値のばらつきを測ります。
| 母集団 | 実測の標準偏差 | 理論値 |
|---|---|---|
| 2万 | 0.01068 | 0.01061 |
| 100万 | 0.01109 | 0.01117 |
一致しました。 が2万から100万へ50倍になっても、推定値のばらつきは 0.0107 から 0.0111 へわずかに増えるだけです。有限母集団修正の式が正しく効いていることも確認できました。
なぜ母集団サイズが効かないのか
数字で納得したあと、直感の側でも整理したくなりました。うまくいった説明はスープの味見です。
鍋のスープの味を確かめるとき、スプーン1杯すくって舐めます。このとき鍋が小鍋か大鍋かは関係ありません。必要なのは「よく混ざっていること」と「スプーンの大きさ」だけです。大鍋だからスプーン10杯必要、ということにはなりません。
推定の精度を決めているのも同じで、手元の情報量です。情報量は集めた人数で決まります。2000人に聞けば2000人分の情報が手に入る。その2000人が1億人の中から偏りなく選ばれているなら、背後に何人いようと手元の情報量は変わりません。母集団が大きいことは「まだ聞いていない人が多い」という意味でしかなく、聞いた人の情報を薄めるわけではないのです。
逆にここから、「よく混ざっていること」=無作為抽出が絶対条件だということも分かります。式に が出てこないのは無作為抽出が成り立っている前提の話で、これが崩れると議論全体が土台から崩れます。よくある「1万件の回答を集めたから信頼できる」という主張が危ういのはここで、 が大きくても選び方が偏っていれば、誤差の式そのものが適用できません。 を増やしても偏りは減らないというのは、標本誤差の式に偏りの項が一切入っていないことから見て当たり前でした。
なお、ここは前回の話ともつながります。前回「歪んだ分布では を増やしても被覆率が回復しない」という結果を見ました(対数正規で でも 85.1%)。前提が崩れているときは が助けてくれないという構造が、抽出の偏りという別の形でもう一度出てきたことになります。
中心極限定理:誤差の「形」が決まる
ここまで誤差の大きさの話をしてきました。 という式を当たり前のように使ってきましたが、この式が使える根拠にまだ触れていません。根拠が中心極限定理です。
主張はこうです。
元の分布が何であっても、標本平均を標準化したものは標準正規分布に近づく。冒頭に書いたとおり、第1回でアニメーションまで作った話です。今回はこれを「形が近づく」ではなく「だから何が言えるのか」の側から見ます。
まず図を見てください。
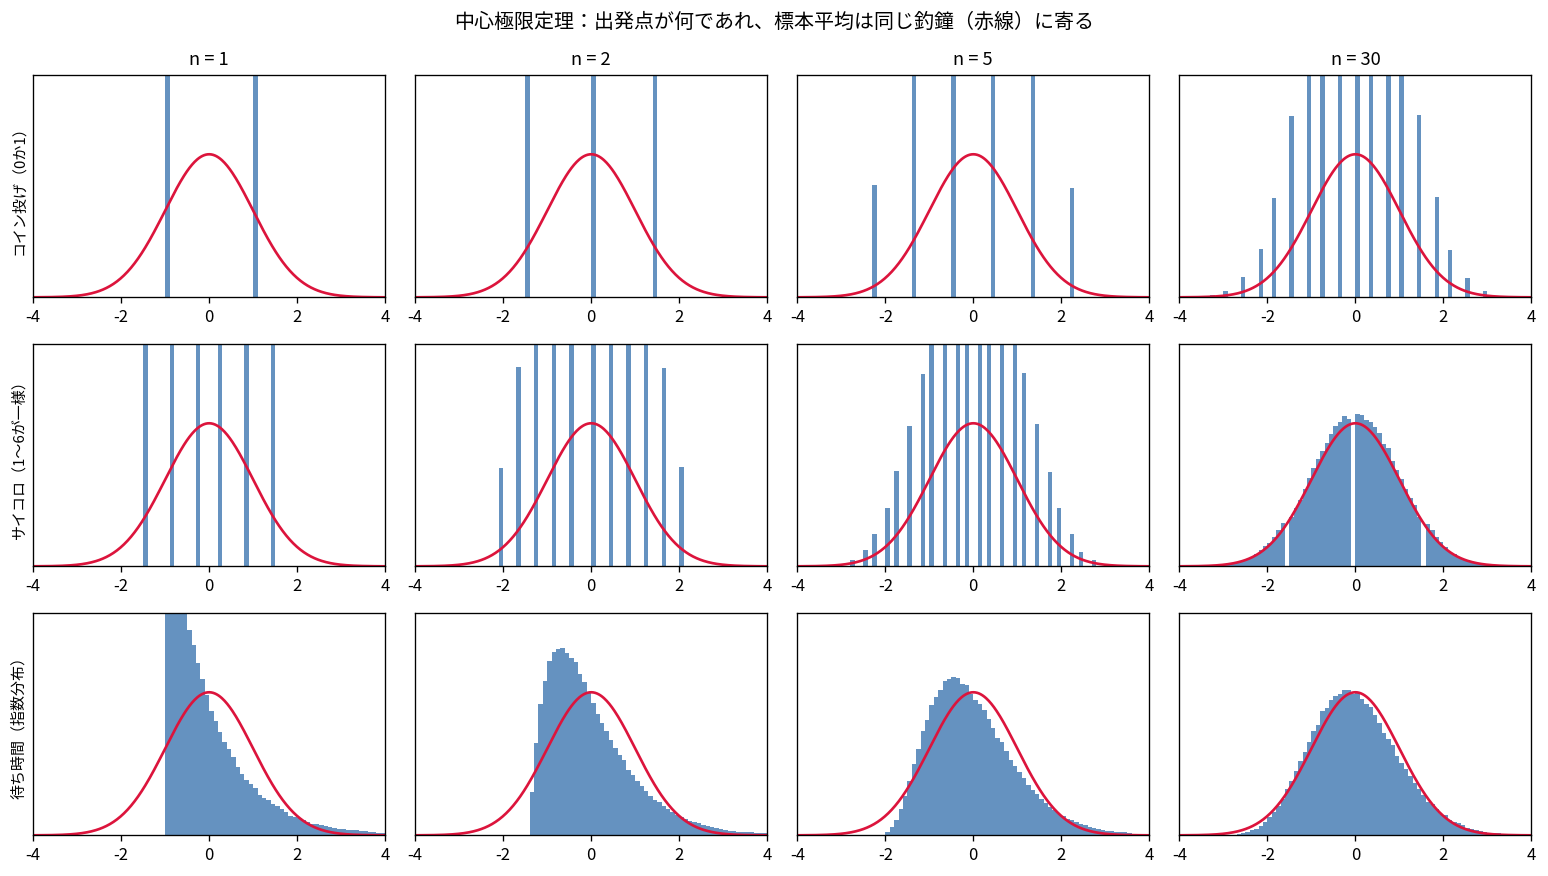
左端の列を見ます。、つまり標本平均を取る前の元の分布です。3つはまったく違う形をしています。
- コイン投げ:0 と 1 の2本の棒しかない
- サイコロ:1から6まで同じ高さの棒が6本
- 待ち時間(指数分布):左端が高くて右に長い裾
これほど違うものが、右端の ではどれも赤い曲線の輪郭に沿っています。とくに1行目が印象的で、0か1しか出ないものを30個平均するだけで釣鐘の形になる。これが起きる理由が私にはずっと不思議でしたが、少なくとも起きることは図が示しています。
ここで一つ、図をよく見ないと気づかない点があります。1行目の のパネルで、棒が櫛のように等間隔で並んでいます。これは元の分布が離散だからです。コイン投げを30個平均した値は、表の枚数が0枚から30枚のいずれかなので、取り得る値は31通りしかありません。連続的に埋まっているわけではないのです。サイコロの行も、 のパネルまでは棒が離れているのが見えます( では刻みが細かくなって塗りつぶしに見えますが、飛び飛びであることは変わりません)。
つまり中心極限定理が言っているのは「形(分布の輪郭)が正規に寄る」であって、「中身が連続になる」ではありませんでした。形は正規に近づくが、中身は飛び飛びのまま。 ここを混同していると、離散データに正規近似を当てたときの微妙なズレ(連続修正が必要になる場面など)が理解できません。
何が嬉しいのか
さて本題です。形が正規分布に近づくと、何が嬉しいのか。第1回のアニメーションを眺めていたときの私は、ここに答えられませんでした。
答えは、元の分布の形を調べる必要がなくなることでした。
支持率を推定したいとき、一人一人の回答は「支持する/しない」の0か1です。この分布は正規分布とはまったく似ていません。それでも標本平均(=支持率の推定値)は正規分布に近づくので、正規分布の性質をそのまま使えます。「中心から標準偏差1.96個分の内側に95%が入る」という正規分布の事実を、支持率の推定値に対して使ってよい。だから
という式が出てきます。元の分布が0と1しかないという事実は、この式のどこにも出てきません。
そして同じことが他の指標にも言えます。
| 測るもの | 一人分のデータの形 | 標本平均の分布 |
|---|---|---|
| 支持率 | 0 または 1 | 正規に近づく |
| クリック率 | 0 または 1 | 正規に近づく |
| サイコロの目 | 1〜6が等確率 | 正規に近づく |
| 滞在時間 | 右に長く歪む | 正規に近づく |
左の列がまったく違うのに、右の列が全部同じです。だから支持率でもクリック率でも滞在時間でも、同じ手順で誤差を計算できます。 指標ごとに専用の理論を作らなくてよい。これが中心極限定理の実務的な御利益でした。
言い換えると、中心極限定理は変換器です。「元の分布が何であれ」という多様な入力を、「正規分布」という一種類の出力に変えてくれる。出口が一種類だから、その先の道具(信頼区間、検定、標本サイズ設計)を一式だけ用意すれば済みます。前回扱ったt分布・χ²分布・F分布が全部正規分布から作られていたことを思い出すと、あの3本の枝が生えている根っこが中心極限定理だったことになります。
第1回で「形が正規に近づく」のアニメーションを作ったとき、私はこの絵を「不思議で面白い現象」として眺めていました。今回、それが「だから誤差の大きさを数字で出せる」という実用に直結していると分かって、ようやく定理として受け取れた感じがあります。
ただし——ここまで「」を係数として使い続けてきました。この 1.96 が何の数字なのかを、私は長いあいだ間違って理解していました。次はそこを扱います。
1.96 とは何の数字なのか
ここが今回いちばん恥ずかしい告白になります。私は 1.96 を、こう理解していました。
1.96 は、95% の外にある部分のことだ。
つまり「95% が中心にあって、残りのはみ出した部分が 1.96 なんだろう」という認識です。試験問題を解くときは表から 1.96 を引いて式に入れれば答えが合うので、これで何年も困りませんでした。困らなかったからこそ、直す機会もありませんでした。
誤りは二重になっていました。順番に潰します。
誤り1:内と外が逆だった
まず単純に、内外が逆でした。1.96 の内側が 95% で、外側が 5% です。しかもその 5% は左右に分かれていて、片側 2.5% ずつになります。
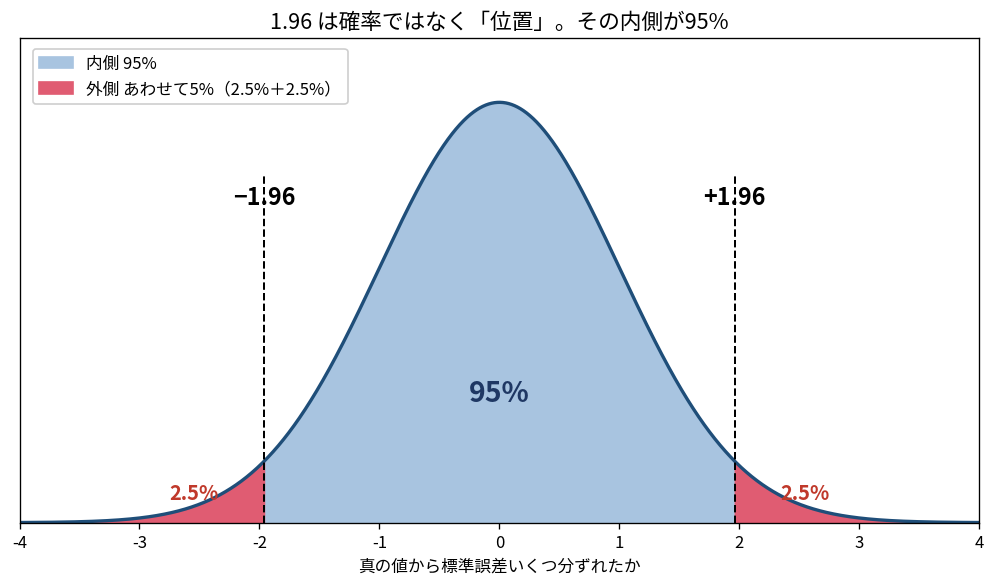
図を見れば一目で分かる話です。青い部分が 95%、両端の赤い部分が 2.5% ずつで合計 5%。
言われれば当たり前ですが、私の頭の中では「95%」と「1.96」という2つの数字が並んでいて、片方が中で片方が外、という誤った対応がついていました。「95%区間」という呼び名のほうを聞き慣れていたので、1.96 は残りの説明だと思い込んでいたのだと思います。
誤り2:もっと根が深かった——1.96 を確率だと思っていた
しかし本当の問題はこちらでした。内外が逆というのは表面的な間違いで、その下にもっと深い誤解がありました。
私は 1.96 を確率だと思っていました。
これは致命的です。1.96 は確率ではありません。確率なら 0 から 1 の間になるはずで、1.96 という値そのものが確率としてありえません。それに気づかずに使えていたのは、公式に当てはめる作業しかしていなかったからです。
正しくは、1.96 は横軸上の位置です。「真の値から標準誤差いくつ分ずれたか」を測る目盛の上の座標です。
役割を分けて書くと、こうなります。
| 数字 | 正体 | 単位 |
|---|---|---|
| 1.96 | 横軸上の場所(境目の位置) | 標準誤差いくつ分 |
| 95% | その場所より内側の面積 | 確率 |
この2行に分けた瞬間、頭の中が整理されました。1.96=場所、95%=面積。 別の種類の量なので、そもそも「どちらが内でどちらが外か」という問いの立て方自体が間違っていたわけです。面積は場所に対して決まる従属的な量で、並列に置けるものではありませんでした。
そして「場所」であることが分かると、場所と面積の対応表が意味を持ちます。
| 境目の位置 | 内側の確率 |
|---|---|
| ±1 | 68.27% |
| ±1.645 | 90.00% |
| ±1.96 | 95.00% |
| ±2.576 | 99.00% |
| ±3 | 99.73% |
1.96 は天から降ってきた定数ではありませんでした。95% と注文したから出てくる数字です。99% が欲しいと注文すれば 2.576 に動き、90% でよいなら 1.645 に縮みます。逆向きに読むこともできて、±3 の内側は 99.73%——製造業の「3シグマ」がこの行です。
私は 1.96 を「正規分布に付いてくる定数」として暗記していました。円周率のような性質の数だと思っていたのです。実際には自分が指定した信頼水準の裏返しでした。表の左列を動かせば右列が動く、その1組を切り取っただけの数字です。
二階建ての翻訳:1.96 から ±2.19pt へ
もう一つ、ここまで飛ばしてきた話があります。 のときの誤差を「±2.19pt」と書いてきましたが、1.96 という数字から 2.19pt がどうやって出てきたのかを明示していません。私が引っかかっていたのはここでもありました。
答えは、目盛が二階建てになっているからです。
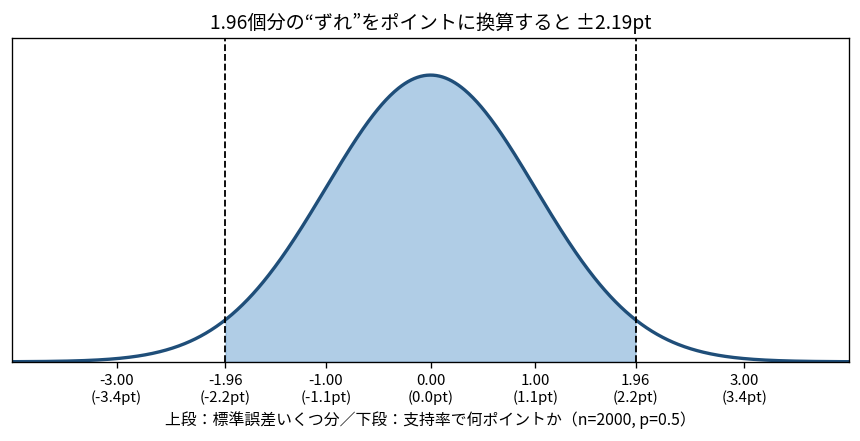
目盛のラベルが2行になっています。上の行は「標準誤差いくつ分」という共通の目盛です。どんな調査でも、どんな指標でも同じ目盛で、単位がありません。下の行は「支持率で何ポイント」という、この調査だけの目盛です。単位はポイントです。
2つをつないでいるのが標準誤差で、、 なら
つまり 1.118pt です。これが「標準誤差1個分は何ポイントか」という換算率になります。あとは掛けるだけです。
手順として書き出すと、次の3段になります。
- 注文する:95% でよいと決める
- 場所を引く:95% に対応する境目は 1.96(標準誤差いくつ分か)
- 翻訳する:1.96 × 標準誤差1.118pt = ±2.19pt(支持率のポイントに変換)
2段目と3段目が別の操作だという点が肝でした。2段目は正規分布の性質だけで決まり、調査の内容に一切依存しません。3段目で初めて や が入ってきて、この調査固有の数字になります。一般的な部分と個別的な部分がここで分かれているわけです。
だから 1.96 は使い回せます。支持率でもクリック率でも滞在時間でも、2段目は同じ 1.96 です。変わるのは3段目の標準誤差だけ。中心極限定理が「元の分布が何であれ正規に寄る」と保証してくれているのは、この2段目を共通化するためでした。前の節で「変換器」と書いたことの中身が、ここでやっと具体的な手順として見えました。
逆に、この二階建てを意識していないと ±2.19pt という数字が空から降ってきたように見えます。私が長く「1.96 は何の数字なのか」を言えなかったのは、2段目と3段目をまとめて1つのブラックボックスとして扱っていたからでした。
本当に95%当たっているのか
さて、理屈は分かりました。では現実に 95% 当たっているのでしょうか。
前回、被覆率という言葉で同じことを測りました。「95%信頼区間」と名乗る区間が、実際に真の値を含んだ割合です。今回も測ります。 で調査を10万回繰り返し、そのたびに区間を作って、真の値を含んだかどうかを数えました。
一点だけ実務に寄せています。標準誤差の計算に使う は、真の値ではなくその回の推定値を使いました。真の を知っていたら推定など要らないので、こうしないと現実の手続きになりません。
| 真の | 被覆率(10万回) | 95%の誤差 |
|---|---|---|
| 0.5 | 94.80% | ±2.19pt |
| 0.4 | 94.96% | ±2.15pt |
| 0.1 | 94.68% | ±1.32pt |
| 0.03 | 94.70% | ±0.75pt |
どれも 95% のすぐ下です。理論どおりに動いていると言っていい範囲でした。前回 t区間で見たような「対数正規で でも 85.1%」という壊れ方は、ここでは起きていません。
右の列も見ておきます。真の が小さいほど誤差が小さくなっています。 が で最大になるので、50% 前後の争いがいちばん精度を出しにくいわけです。支持率 3% の推定は ±0.75pt まで詰められるのに、50% の推定は ±2.19pt で止まる。選挙の接戦がいちばん読みにくいのは、取材の難しさだけでなく、式の形からしてそうなっていました。
動いているのは区間の側だった
そして、ここで言い方を正確にしておく必要があります。私はずっと、こう理解していました。
真の値が区間に入る確率が 95% である。
これも正確ではありませんでした。真の値は動きません。支持率の真の値は、誰も知らないだけで、ある1つの数に決まっています。確率的に揺れているのは調査のほうです。
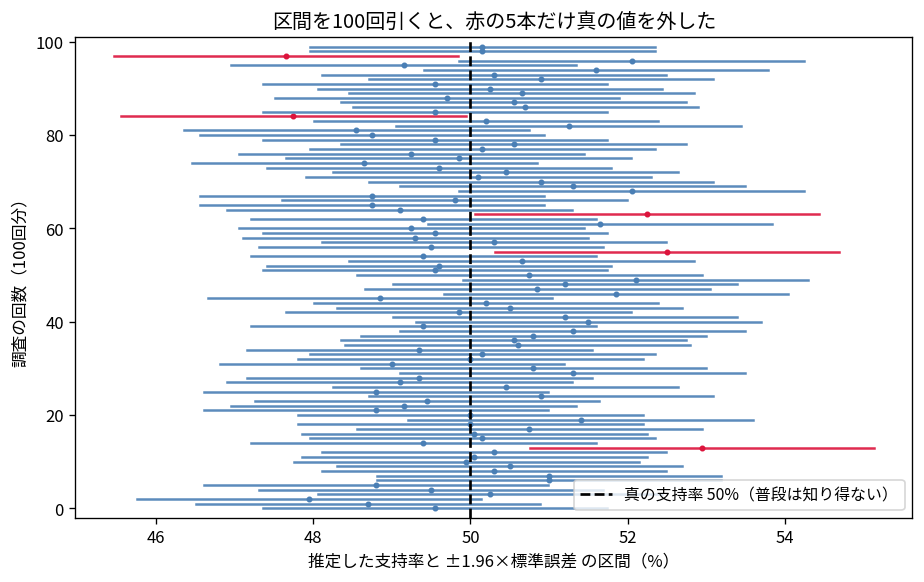
図がこれを一目で示してくれました。100回の調査で区間を100本引いたものです。真の値50%を示す縦の破線は1本で、まったく動いていません。 動いているのは横向きに伸びた線分のほう、つまり区間の側です。調査ごとに中心も幅も違う位置に来ます。
そのうち縦破線をまたげなかったのが5本、赤で示した区間です。95本が的中しました。
だから正確な言い方はこうなります。
この作り方で区間を引くと、95% の場合に真の値を捕まえる。
主語が真の値ではなく区間を引く手続きです。95% は真の値の性質ではなく、手続きの成績でした。
この違いは言葉遊びではありませんでした。手元にある1本の区間について「この区間に真の値が入っている確率は95%」と言うことはできません。その区間はもう引かれてしまっていて、当たっているか外れているかのどちらかに決まっています。図の赤い5本を引いてしまった人にとって、その区間の的中確率は 95% ではなく 0% です。そして自分がどちらを引いたのかは分からない。分かるのは「この手続きは20回に19回当たる」ということだけでした。
「95%信頼区間」という名前が誤解を招きやすいのは、名前が区間の側に付いているのに、95% が指しているのは手続きの側だからだと思います。
3ポイント差は差と言えるのか
この見方が効く場面をひとつ確かめました。報道でよく見る形です。
A候補 48%、B候補 45%。A候補が3ポイントリード。
同数の2000人ずつに聞いたとして、この3ポイントに意味があるのか。真の差がゼロの状況を作ってシミュレーションしました。
差の標準偏差は次の式になります。
つまり 1.58pt です。実測も 1.58pt で一致しました。すると3ポイント差は
つまり 1.90σ 相当にすぎません。境目の 1.96 に届いていません。実際、真の差がゼロでも が起きる割合は 5.8%(正規近似による理論値 5.78%)ありました。20回に1回以上は、まったく互角の2候補が3ポイント差以上に見えるわけです。
ここで見落としやすいのが、個々の推定の誤差より差の誤差のほうが大きいという点でした。候補者それぞれの支持率の誤差は ±2.19pt ですが、差の標準偏差は 1.58pt で、1.96 を掛けると ±3.10pt になります。2つの推定値それぞれに誤差があるので、引き算するとその両方が乗ってきます。誤差が打ち消し合ってくれるわけではありませんでした。
私は「±2.19pt なんだから、3ポイント違えば有意なのでは」と考えていました。比べる相手を間違えていて、差について語るなら差の誤差を使わなければならない。 倍が付くだけの話ですが、この一歩を飛ばすと結論が反対になります。
条件を外すと壊れる
ここまで2つの定理が働く様子を見てきました。最後に、働かない場合を見ます。前回の学びで一番効いたのが「前提が崩れているときは が助けてくれない」でした。今回も同じ構造が出てくるのか確かめたかったからです。
大数の法則が破綻する:コーシー分布
まず大数の法則そのものが成り立たない例です。コーシー分布から標本平均を取ってみます。
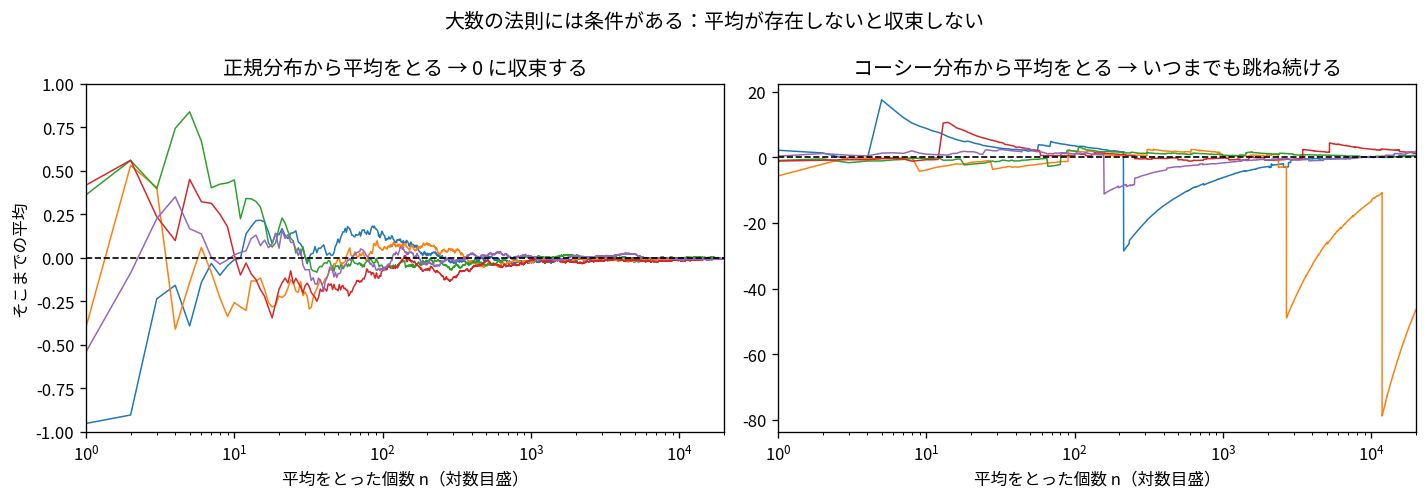
まず左右の縦軸目盛が違うことに注意してください。左は −1 から +1、右は −80 から +20 です。同じ縮尺では並べられませんでした。
左の正規分布は教科書どおりで、 が増えると 0 に集まっていきます。右のコーシー分布は、万を超えても突然 −80 近くまで落ちる系列があります。図の右端でいったん0の近くに戻っている線もありますが、これは収束したのではなく、次の大きな外れ値が来るまでの静かな期間にすぎません。
数字で測りました。標本平均の中央絶対偏差(ばらつきの目安)です。
| 中央絶対偏差 | の割合 | |
|---|---|---|
| 10 | 0.987 | 6.22% |
| 100 | 1.003 | 6.40% |
| 1000 | 0.984 | 6.28% |
| 10000 | 1.007 | 6.28% |
を1000倍にしても、まったく縮まっていません。 0.99 前後のまま動きません。平均が真の中心から10以上離れる割合も 6.2〜6.4% で一定です。
理由は前提でした。コーシー分布は期待値が存在しません(定義の積分が発散します)。大数の法則は「標本平均は母平均に近づく」という定理なので、近づく先の母平均が存在しなければ何も主張できません。実際に起きているのは、コーシー分布の標本平均が1個だけ観測したのと同じ分布に従うということです。1万人分のデータを平均しても、1人分の情報しか得られていない。 を増やす努力が完全に無効化されています。
これは机上の話ではありませんでした。収入、都市の人口、保険の損害額、SNSの拡散数——裾の重いデータで「平均」を語るとき、この構造に触れている可能性があります。コーシー分布ほど極端でなくても、裾が重ければ収束は絶望的に遅くなります。「たくさんデータがあるから平均は信用できる」が成り立たない場合がある、その根拠がここでした。
中心極限定理が破綻する:np < 5
次に、大数の法則は成り立つのに中心極限定理の近似が使えない場合です。前回「期待度数5以上」を扱いましたが、あれと地続きの話でした。
に固定して、 だけを下げていきます。
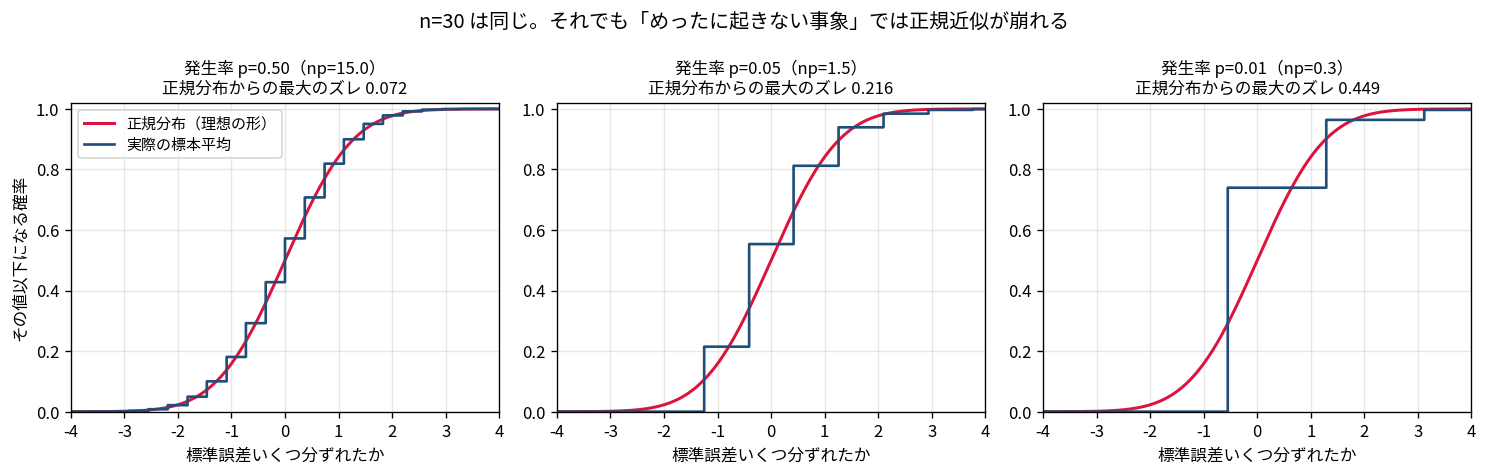
| 正規分布との最大ズレ | 上側2.5%点 | ||
|---|---|---|---|
| 0.50 | 15.0 | 0.072 | 1.83 |
| 0.20 | 6.0 | 0.107 | 2.28 |
| 0.05 | 1.5 | 0.216 | 2.09 |
| 0.01 | 0.3 | 0.449 | 3.12 |
は同じです。それでも では正規近似が完全に壊れていて、本来 1.96 のはずの上側2.5%点が 3.12 になっています。1.96 を使えば、外れる確率を大幅に見誤ります。
なお上側2.5%点の列は を下げるにつれてきれいに増えているわけではありません( で 2.28、 で 2.09)。取り得る値が飛び飛びなので、「累積が0.975を超える最初の値」がどこに来るかが刻み幅に振り回されるからです。単調に悪化するのは左の最大ズレの列で、こちらのほうが崩れ具合の指標としては素直でした。
図の一番右のパネルが分かりやすいです。最初の1段で確率0.74まで一気に上がってしまいます。 30人に聞いて確率1%の事象が起きる回数は、74%の確率で0人、22%の確率で1人です。取り得る値が実質2通りしかないものを、滑らかな釣鐘で近似しようとしている。無理があるのは絵を見れば明らかでした。
では のまま を増やすとどうなるか。
| 正規分布との最大ズレ | ||
|---|---|---|
| 30 | 0.3 | 0.449 |
| 100 | 1.0 | 0.236 |
| 500 | 5.0 | 0.116 |
| 1000 | 10.0 | 0.083 |
を30から500へ約17倍にすると、ズレが 0.449 から 0.116 へと4分の1になります。 が5に達するあたりで、壊れているとは言えない水準まで来ます。ただし後の節で見る「ズレ 0.05 以下」という実用の目安には、 ではまだ届いていません。 は正規近似を検討してよい最低ラインで、安心して使える水準ではないということです。いずれにせよ、効いているのは ではなく でした。
覚えるべき目安は ではなく、 かつ 。
も要るのは、 が1に近い側でも同じことが起きるからです。「まれ」なのは片側だけの話ではありません。
そして、これが前回の「期待度数は5以上」の一般形でした。前回は度数の検定の文脈で「各セルの期待度数が5以上」という条件を見ましたが、期待度数とはまさに です。別々に覚えていた2つの経験則が、同じ条件の別の書き方だったことになります。前回「呪文だと思っていたものが中心極限定理を信用してよい目安だと分かった」と書きましたが、今回はその目安の中身が「 ではなく で測る」という形で確定しました。
収束の速さを決めるのは歪み
最後に、 の条件を満たしていても収束の速さが分布によって違う、という話です。
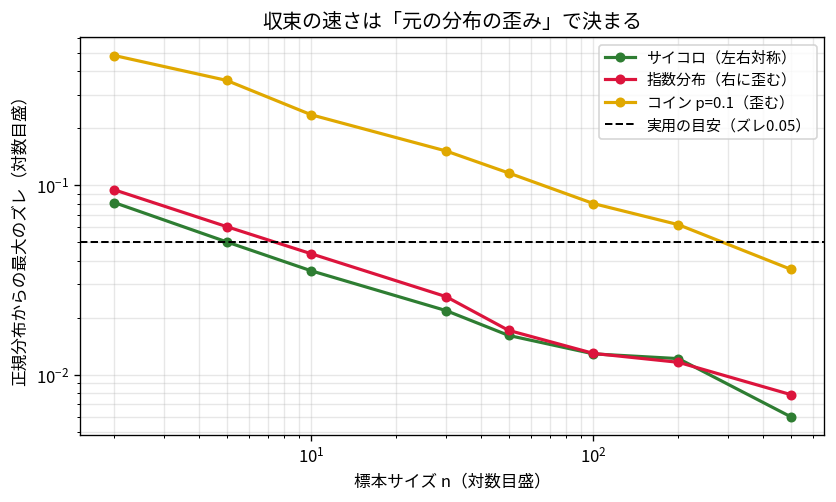
3種類の母集団について、標本平均の分布が正規分布からどれだけずれているかを測りました。
| サイコロ(対称) | 指数分布(右に歪む) | コイン (歪む) | |
|---|---|---|---|
| 2 | 0.081 | 0.095 | 0.484 |
| 5 | 0.050 | 0.061 | 0.358 |
| 10 | 0.035 | 0.043 | 0.235 |
| 30 | 0.022 | 0.026 | 0.152 |
| 100 | 0.013 | 0.013 | 0.080 |
| 500 | 0.006 | 0.008 | 0.036 |
(前節の表は二項分布の厳密計算ですが、指数分布が入るこの表は乱数によるシミュレーション値です。小数第3位はぶれます。)
サイコロは で目安の 0.050 に到達し、 で下回ります。上側2.5%点を見ると で 1.964 で、1.96 とほぼ一致します。5個の平均で足りるわけです。
指数分布は少し遅れます。 で上側2.5%点が 2.117、 でも 2.042 で、1.96 に完全には届きません。前回「 なら正規近似で大丈夫」を条件つきの経験則だと書きましたが、右に歪んだ分布ではまさにこの「条件」に引っかかっています。
そしてコイン が桁違いに遅い。 を超えたあたりでようやく 0.05 を下回り、 で 0.036 です。サイコロが で到達した水準に、100倍のデータを要しています。 の条件だけ見れば で を満たしているのに、実際にはその10倍が必要でした。 は入場券にすぎないということが、ここでもう一度確認できます。
決めているのは元の分布の歪みでした。左右対称なら速く、歪んでいれば遅い。第1回で指数分布の標本平均の歪度が で減っていくことを実測しましたが、この分子の2は指数分布そのものの歪度です。一般には標本平均の歪度は「元の分布の歪度 ÷ 」になるので、出発点の高さがそのまま収束の遅さになるわけです。コイン の歪度は約 2.67 で指数分布より大きく、実際いちばん遅れています。第1回のグラフを眺めていたときは減り方だけを見ていて、分子の値が実務上いちばん重要な情報だとは気づきませんでした。
実務的な含意ははっきりしています。
CVR 0.5% のA/Bテストで「30件集まったから正規近似」は完全に誤り。
CVR 0.5% は です。 を満たすには が必要で、30件では話になりません。件数ではなく転換の起きた回数を見るのが正しい確認手順でした。自分のブログのクリック率で「そろそろ判断できるだろう」と考えていた場面のほとんどが、この条件を満たしていませんでした。
前回・前々回とのつながり
今回も過去の回が何度も戻ってきました。
| つながった先 | どこで |
|---|---|
| 第1回 やり直し | 作ったCLTのアニメが「何の役に立つのか」に今回やっと答えられた。歪度 の分子が収束の速さを決めていた |
| 第3回 分散 | が で最大なので、50%前後の争いが一番精度を出しにくい |
| 第6回 連続分布 | CLTは「混ぜる」ではなく「合計」、裾の重い分布の扱い。コーシーの破綻はその延長 |
| 第7回 標本分布 | 「期待度数5以上」の一般形が だった。被覆率の測り方、前提が崩れると が助けてくれない構造 |
とくに第7回との接続が濃い回になりました。前回は「期待度数5以上」を中心極限定理の信用できる境目として理解したところで止まっていましたが、今回それが という形で一般化され、A/Bテストの件数の話まで一直線につながりました。前回末尾の宿題に答えるつもりで書き始めて、答えたら前回の内容の意味が変わったという感覚があります。
第1回との接続も書き留めておきます。同じ現象を同じ道具で見ているのに、あのときは「不思議な現象」で、今回は「誤差を数字で出すための土台」でした。教材が変わったわけではなく、問いの立て方が変わっただけです。この連載を「やり直し」として始めた意味が、いちばんはっきり出た回だったと思います。
次回
次回は確率分布と母関数を扱う予定です。教科書では2章にあたる部分で、順番としては戻ることになります。
意図的に後回しにしていました。この章は積率母関数や確率母関数の数式変形が主役で、先に読んだときは「何のための変形なのか」がまったく掴めなかったからです。具体的な分布(第6回)と、その分布が近似に寄っていく仕組み(今回)を先に見てから戻れば、母関数が何を代行してくれる道具なのかが見えるはずだと考えています。
とくに今回、中心極限定理の証明には触れませんでした。「元の分布が何であれ正規に寄る」という事実だけを使って、なぜそうなるのかは棚に上げたままです。その棚を開ける鍵が母関数だと聞いているので、次回はそこを確かめます。なぜ元の分布の情報が消えて、正規分布だけが残るのかを、次はそこから見ていきます。
この連載は、うまくいった記録だけでなく詰まった箇所も含めて書いています。今回は 1.96 という、試験なら何度も正解してきた数字を根本から誤解していたことが分かりました。同じく準1級を目指している方、一度挫折した方の参考になれば嬉しいです。