期待値は「gを差し替えられる1つの型」だった【番外編】
過去問を解いていて、指数分布の分散を積率母関数から求める問題で間違えました。原因を追っていくと、計算のミス以前に期待値の定義そのものを理解していなかったことが分かりました。
という式を見て、意味が取れていなかったのです。そして を求めるとき、 に何かを代入するのだと思っていました。
これは土台なので、抜けたままだと推定でも検定でもずっと詰まります。整理しておきます。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
TL;DR
- 期待値は「値 × 確率」を全部足したもの。離散では 、連続では を使う
- 連続では1点の確率が0なので、確率の代わりに「密度 × 幅」を使う。それが
- 離散と連続の違いは、 が に、 が になった2箇所だけ
- は に何かを代入するのではなく、 を積分する
- 平均・分散・積率母関数はすべて「 を差し替えた同じ式」だった
何が分かっていなかったのか
指数分布(率 、平均は )の分散を積率母関数から求めようとして、こう書いてしまいました。
これは間違いです。しかも間違いの種類が2つ重なっていました。
ひとつは微分する変数を取り違えたこと。積率母関数の微分は について行いますが、 で微分していました。もうひとつは期待値を取る順序が逆だったこと。正しくは「先に期待値を取って の関数を作り、それを微分する」のですが、微分してから期待値を取ろうとしていました。
そしてこの2つのミスの根っこにあったのが、 という記号が何を意味するのかを分かっていなかったことです。
離散の期待値:値 × 確率 を足す
出発点は離散です。サイコロの期待値は素直に計算できます。
これを一般化すると、こうなります。
ここで とすれば平均、 とすれば2次モーメント。掛ける中身()を変えるだけで、いろいろな量が計算できます。
サイコロで を求めるなら、 です。
ここで大事なのは、 に何かを代入しているのではないということでした。 の形として が現れているだけです。
連続では「点の確率」が使えない
連続分布では困ったことが起きます。ちょうど になる確率は0なのです。値が連続的に無限にあるので、1点あたりの確率は0になってしまいます。だから「値 × 確率」の形が使えません。
そこで幅を持ち込みます。密度 は「単位幅あたりの確率」なので、幅を掛けて初めて確率になる。幅 の区間に入る確率は で近似できるわけです。
だから離散の を に置き換えればいい。
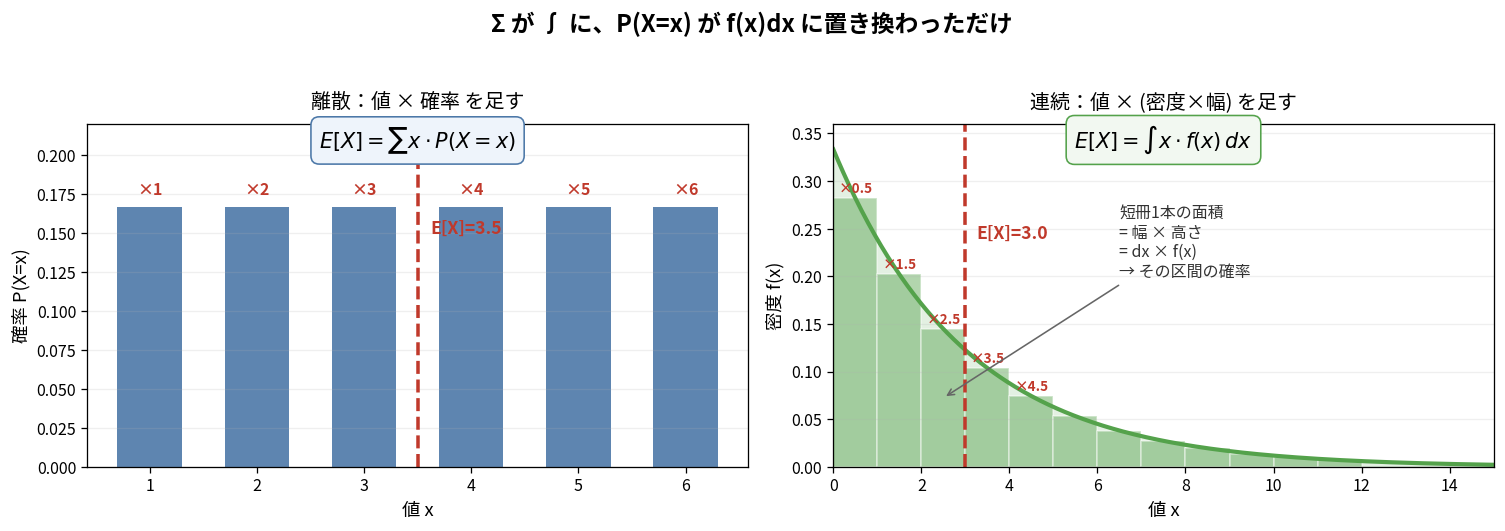
違いは2箇所だけです。 が になり、 が になった。それ以外の構造は同じでした。
密度そのものは確率ではない
ここは第4回(変数変換)でも出てきた話です。平均3の指数分布で ですが、これは「 の確率が0.333」という意味ではありません。
実際に確かめました。
| 区間 | 実測した確率 | 幅 |
|---|---|---|
| 0.28349 | 0.33333 | |
| 0.03278 | 0.03333 | |
| 0.00335 | 0.00333 |
幅を小さくするほど 幅 に近づきます。これが密度の意味です。
本当に足し算なのか確かめる
積分は「無限に細かい足し算」です。それなら有限の足し算でも近い値が出るはずなので、実際に計算してみました。
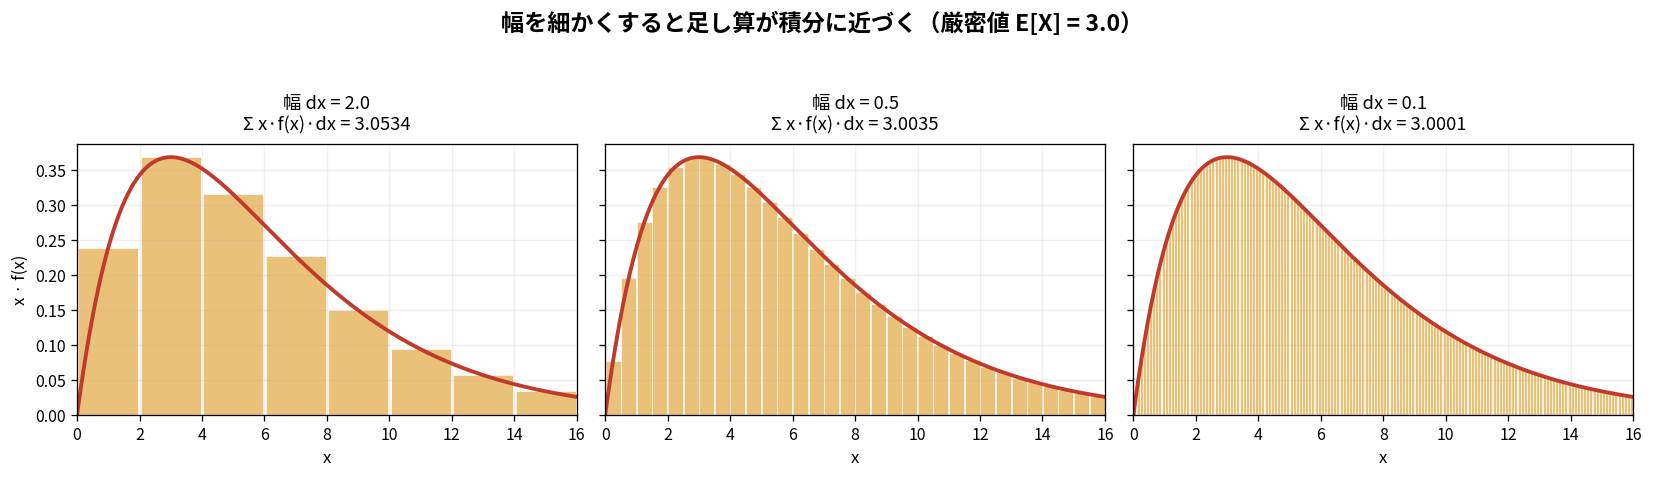
平均3の指数分布で を足し上げていくと、こうなります。
| 区間幅 | ||
|---|---|---|
| 1.0 | 3.013755 | 18.000802 |
| 0.1 | 3.000139 | 18.000000 |
| 0.01 | 3.000001 | 18.000000 |
| 厳密な積分 | 3() | 18() |
細かくするほど厳密値に近づきます。積分は足し算の極限という当たり前のことですが、自分の手で確かめると納得が違いました。
import numpy as np

lam = 1/3                                 # 率λ。平均は 1/λ = 3
f = lambda x: lam * np.exp(-lam * x)

for dx in [1.0, 0.1, 0.01]:
    xs = np.arange(dx/2, 200, dx)      # 区間の中央の値
    print(dx, (xs * f(xs) * dx).sum())  # E[X] = 3 に近づく
    print(dx, (xs**2 * f(xs) * dx).sum())  # E[X²] = 18 に近づく
g を差し替えるだけで、全部同じ式
ここが今回いちばんの発見でした。期待値の枠組みは1つで、変えるのは だけです。
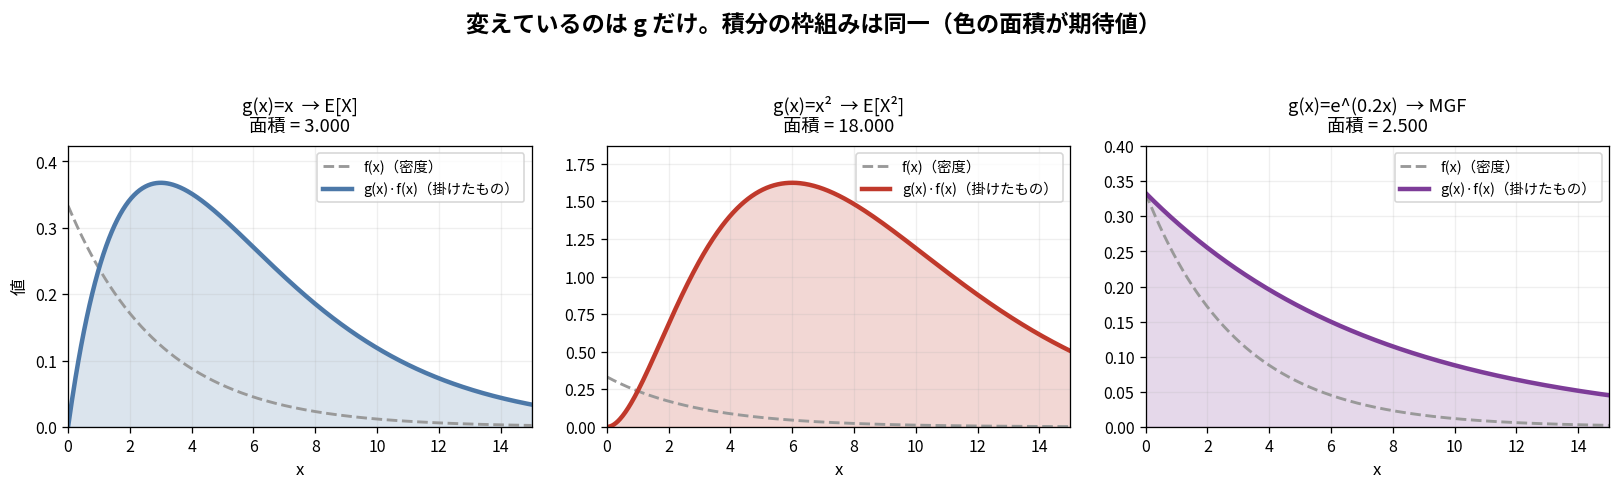
灰色の破線が密度 、色つきの曲線が で、その面積が期待値です。 を変えると曲線の形が変わり、面積も変わります。
率 (平均 )の指数分布で計算すると、こうなります。
| 求めたいもの | 積分の結果 | 意味 | |
|---|---|---|---|
| 平均 | |||
| 2次モーメント | |||
| 3次モーメント | |||
| () | 積率母関数 | ||
| 全確率 |
積率母関数も同じ式だった
に を入れただけです。第9回で「なぜ という形なのか」を扱いましたが、計算の枠組み自体は平均や分散と何も変わりません。特別な操作ではなかったのです。
私が間違えたのは、この を「動かす対象」ではなく分布のパラメータのように扱ってしまったことでした。 はモーメントを取り出すための取っ手で、最後まで文字のまま残して、微分し終わってから を代入します。
表の最後の行が検算に使える
を入れると になります。これは「全確率が1」という当たり前のことですが、密度の式が正しいかの検算として使えます。
同じ発想で、積率母関数を導出したら を入れてみるのが有効です。 になるはずなので、1にならなければ途中で計算を間違えています。30秒で済む検算です。
分散もこの型に収まる
を入れただけです。分散は「平均からのズレの2乗」という量の期待値でした。
離散なら 、連続なら です。
サイコロで確かめます。 なので、
| 1 | 6.25 | 1.04167 |
| 2 | 2.25 | 0.37500 |
| 3 | 0.25 | 0.04167 |
| 4 | 0.25 | 0.04167 |
| 5 | 2.25 | 0.37500 |
| 6 | 6.25 | 1.04167 |
| 合計 | 2.91667 |
第3回で扱った展開形 で計算しても で一致します。
指数分布の E[X²] を定義通り積分する
積率母関数を使わずに直接計算すると、こうなります。
部分積分を2回使えば出ます。これと を組み合わせると です。
両方の手が動くと検算になります。積率母関数で出した答えを定義通りの積分で確かめる、あるいはその逆。今回の私のミスも、定義通りに を積分して を確認できていれば、その場で気づけたはずでした。
シミュレーションでも一致する
800万件の乱数で確認しました。積分で定義した期待値と、実際にたくさん生成して平均を取ったものが一致します。
| 量 | シミュレーション | |
|---|---|---|
| 2.9997 | 3.0000 | |
| 18.0064 | 18.0000 | |
| 162.2279 | 162.0000 | |
| 2.4986 | 2.5000 | |
| 1.5349 | 1.5350 |
最後の行のように でも計算できます。 は何でもよいのです。
これは第8回(大数の法則)とつながります。「たくさん生成して平均を取ると期待値に近づく」——それが大数の法則でした。つまり積分による定義と、シミュレーションによる近似が、大数の法則で結ばれているわけです。
実務的には、積分が解けない場合でもシミュレーションで期待値を求められるということでもあります(モンテカルロ法)。
この先で効いてくる
今後こういう記号が出てきますが、すべて同じ型です。
| 記号 | 積分で書くと | 何を計算しているか |
|---|---|---|
| 平均 | ||
| 2次モーメント | ||
| 分散 | ||
| 積率母関数 | ||
| エントロピー |
第8章(統計的推定の基礎)では、フィッシャー情報量がこういう形で出てきます。
長くて怖い見た目ですが、これはスコア関数の2乗の期待値であって、 に「スコア関数の2乗」を入れただけです。今回の型で読めば「(スコア関数の2乗) か」と分かります。
記号に圧倒されて手が止まる、という状態を避けられそうです。
分かったこと
| 問い | 答え |
|---|---|
| 連続の期待値の定義は | 。「値 × 密度 × 幅」を足す |
| 離散との違いは | 、 の2箇所だけ |
| なぜ確率でなく密度なのか | 連続では1点の確率が0だから。幅を掛けて確率にする |
| の求め方 | に代入するのではなく、 を積分する |
| 積率母関数の求め方 | に を入れて積分する |
| 検算の方法 | で1になるか/ になるか/定義通りの積分と一致するか |
一言でまとめると、期待値は を差し替えられる1つの型でした。平均・モーメント・分散・積率母関数は、その型に何を入れるかの違いしかありません。
過去問で計算を間違えたとき、最初は「計算ミスかな」と思っていました。でも掘っていくと、定義の理解が抜けていたのが原因でした。公式を覚えて手順を追うだけでは、こういう抜けに気づけません。間違えたことで土台の穴が見つかったので、結果的には収穫だったと思います。
この連載は、うまくいった記録だけでなく詰まった箇所も含めて書いています。同じく準1級を目指している方、一度挫折した方の参考になれば嬉しいです。