判別分析:フィッシャーの判別は分散分析のF値の最大化だった【第25回】
はじめに
第23章は判別分析です。前回の主成分分析でマハラノビス距離と多変量正規分布を扱ったので、その道具がそのまま効く回になります。
この章に入る前、私はひとつ引っかかっていることがありました。第18回のロジスティック回帰と、目的が同じに見えるのです。どちらも「この人は継続するか解約するか」という0か1かを予測します。同じ問題に2つの道具があるなら、どちらを使えばいいのか。前提が違うのか、精度が違うのか。
もうひとつ、フィッシャーの線形判別について「群間分散を群内分散で割った値を最大にする」という説明を聞いて、それは第20回の分散分析のF値と同じ形ではないかと思っていました。分子が群間、分母が群内。形がそっくりです。偶然なのか、それとも本当に同じものなのか。
手を動かしてみたら、同じものでした。 しかも定数倍の関係が小数10桁まで一致します。フィッシャーの線形判別は、要するに「射影したあとのF値がいちばん大きくなる向きを探す」手続きでした。第20回で「差があるかを検定する」ために使った量を、今回は「最もよく分かれる方向を探す」目的関数として使い回している。同じ量の別の使い方だったわけです。
そしてこの章でいちばん怖かったのは、誤判別率の話です。2つの群をまったく同じ乱数発生器から作って(つまり原理的に判別が不可能なデータで)判別ルールを組んだところ、変数を18個入れると誤判別率が0.24%と出ました。「99.8%の精度で判別できます」と報告してしまう状態です。真の答えは50%、つまりコイン投げと同じです。
この記事では、通説を検証して自分の実測の読み方を間違えた箇所も記録します。「線形判別分析は外れ値に弱い」という話を確かめたら、ロジスティック回帰も崩れたので「差はない」と結論しかけたのですが、それは両方が壊れきって差を測れない領域の数値でした。もうひとつ「線形判別分析のほうが効率がよい」という話は正しいのですが、差が出る条件がかなり限定的でした。
いつものように、出てくる数値はすべて自分で計算し、理論値と突き合わせています。
この回で扱う用語
| 用語 | 読み・意味 |
|---|---|
| 判別分析 | Discriminant Analysis。既にグループが分かっているデータから、グループ分けのルールを作る手法 |
| 群 | Group / Class。分類したいグループ。この記事では「継続」「解約」の2群 |
| 線形判別関数 | Linear Discriminant Function。 の形の式。符号で群を決める |
| 判別得点 | 線形判別関数に実際の値を入れて出てきた数 |
| LDA | Linear Discriminant Analysis=線形判別分析。境界が直線(超平面)になるもの |
| QDA | Quadratic Discriminant Analysis=2次判別分析。境界が2次曲線になるもの |
| マハラノビス距離 | Mahalanobis Distance。散らばりで割ってから測る距離。 |
| プールした共分散行列 | 群ごとの散らばりをまとめて1つに推定した分散共分散行列。群内共分散行列とも |
| ベイズ判別 | 事前確率と誤判別コストを考慮して、損失が最小になるように割り当てる方式 |
| 事前確率 | Prior Probability。データを見る前の「この群である割合」。有病率などがこれ |
| 見かけの誤判別率 | Apparent Error Rate。ルールを作ったのと同じデータで測った誤判別率。楽観的に偏る |
| ホールドアウト法 | データを学習用と評価用に分け、評価用だけで誤判別率を測る方法 |
| 交差確認法 | Cross Validation。分割と評価を繰り返して平均する方法。交差検証とも |
| LOO | Leave-One-Out=1個抜き。1件だけ抜いて残りで学習し、抜いた1件を当てる交差確認法 |
| Wilks の | ウィルクスのラムダ。。群がどれだけ分かれているかの指標。0に近いほどよい |
| Hotelling の | ホテリングのT2乗。2群の平均が等しいかを多変量で検定する統計量 |
| SVM | Support Vector Machine=サポートベクターマシン。マージンを最大にして境界を引く手法 |
困りごと:グループ分けのルールが欲しい
有料会員が10人います。過去のデータから、5人は継続し、5人は解約したと分かっています。手元にあるのは2つの数字です。
- = その月のログイン日数
- = 使った機能の数
やりたいのは、新しい会員が来たときに「この人は解約しそうか」を判定するルールを作ることです。すでに答えが分かっている10人のデータから、判定式を逆算したい。これが判別分析の目的です。
| 会員 | ログイン日数 | 機能の数 | 結果 |
|---|---|---|---|
| A | 20 | 5 | 継続 |
| B | 22 | 6 | 継続 |
| C | 18 | 4 | 継続 |
| D | 24 | 6 | 継続 |
| E | 16 | 4 | 継続 |
| F | 12 | 4 | 解約 |
| G | 14 | 5 | 解約 |
| H | 10 | 3 | 解約 |
| I | 16 | 5 | 解約 |
| J | 8 | 3 | 解約 |
継続群の平均は 、解約群の平均は です。数字を眺めると「ログイン日数が多ければ継続」で済みそうに見えます。ところが、それではうまくいきません。
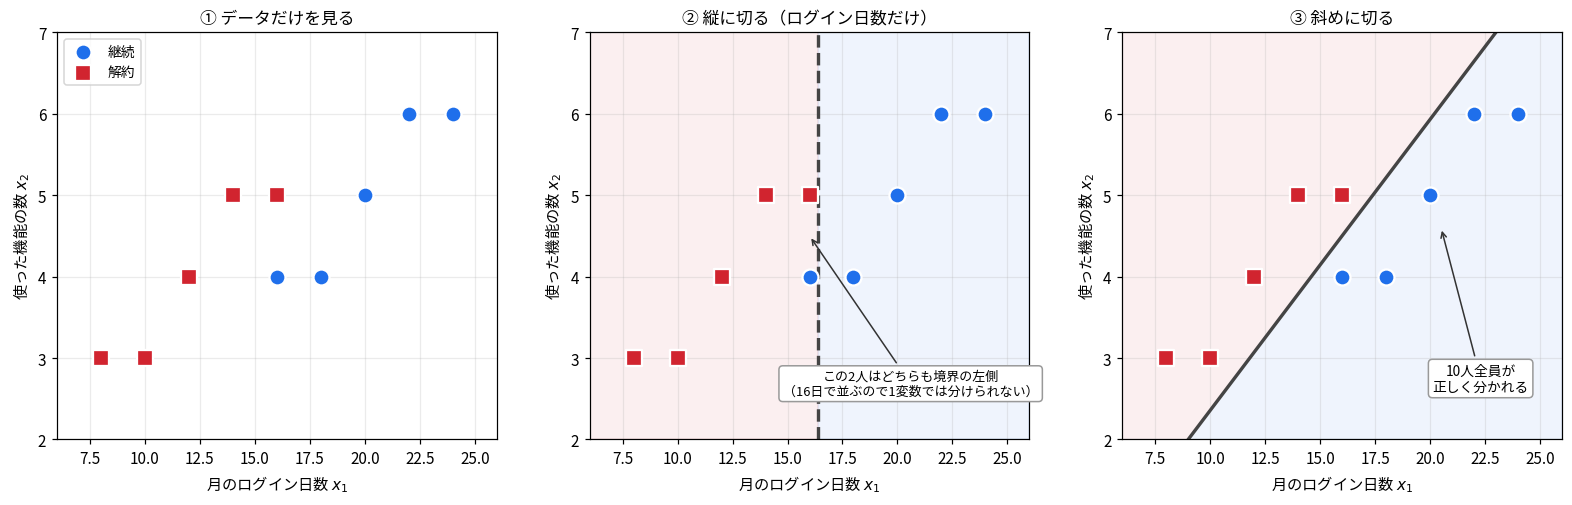
真ん中の図を見てください。ログイン日数だけで縦に切ると、会員E(16日・機能4個・継続)と会員I(16日・機能5個・解約)が必ず同じ側に入ります。 ログイン日数が同じなので、その1変数では区別できません。どこに線を引いても、このどちらかを間違えます。
右の図のように斜めに切ると、10人全員が正しく分かれます。判別分析は、この「斜めの線」をデータから機械的に決める手続きです。
ここで注意しておきたいのは、この問題設定が第18回のロジスティック回帰とまったく同じだということです。0か1かを予測したい。同じ問題に2つの道具が用意されている理由は、この記事の後半で扱います。
線形判別関数を作ってみる
線形判別関数は次の形です。
なら継続、 なら解約と判定します。決めるべきは重み と切片 です。
結論の式を先に出すと、こうなります。
は2群の平均ベクトル、 はプールした共分散行列(群ごとの散らばりをまとめて推定したもの)です。
この式の気持ちは後で説明します。まず数字を入れてみます。この記事の10人のデータは、計算がすべて整数になるように作りました。
プールした共分散行列
群ごとに「平均からのずれ」の積和を計算して足し、(標本数 − 群の数 = )で割ります。
この行列の行列式は です。行列式が1なので、逆行列も整数になります。
重みベクトル
平均の差は です。
切片は2群の平均の中点で になるように決めます。中点は なので、
判別関数が出ました。
10人に当てはめると次のようになります。
| 会員 | 判定 | 実際 | |||
|---|---|---|---|---|---|
| A | 20 | 5 | 継続 | 継続 ○ | |
| B | 22 | 6 | 継続 | 継続 ○ | |
| C | 18 | 4 | 継続 | 継続 ○ | |
| D | 24 | 6 | 継続 | 継続 ○ | |
| E | 16 | 4 | 継続 | 継続 ○ | |
| F | 12 | 4 | 解約 | 解約 ○ | |
| G | 14 | 5 | 解約 | 解約 ○ | |
| H | 10 | 3 | 解約 | 解約 ○ | |
| I | 16 | 5 | 解約 | 解約 ○ | |
| J | 8 | 3 | 解約 | 解約 ○ |
10人全員が正しく分類されました。1変数では区別できなかった会員E()と会員I()も、符号がきれいに分かれています。
係数の符号が「逆」に見える問題
ここで手が止まりました。機能の数 の係数が 、つまりマイナスです。
ところがデータを見ると、機能の数の平均は継続群が5個、解約群が4個。継続群のほうが多いのです。多いほうが継続なのに、係数がマイナスとはどういうことでしょうか。
これは第16回の偏回帰係数とまったく同じ構造です。この係数は「ログイン日数を固定したときの機能の数の効き方」を表しています。
会員EとIで確かめられます。どちらもログイン日数は16日で同じ。違うのは機能の数(4個と5個)だけです。そして機能が多い会員Iのほうが解約している。つまりログイン日数が同じなら、機能を多く触っている人のほうが解約寄り、という関係がデータの中にあります。
解釈をつけるなら「たいして使っていないのにいろいろな機能を触り回っている人は、目的に合わなくて探し回っている状態かもしれない」といった読み方になります。単独で見た平均の大小と、他の変数を固定したときの効き方は別物である、という第16回の教訓がここでも効いています。
フィッシャーの線形判別は何を最大化しているのか
さて、 という式はどこから来たのでしょうか。フィッシャーの考え方から導けます。
発想:2次元を1次元に潰す
2変数のままだと「分かれているか」を判断しづらい。そこで1本の直線に射影して1次元に潰します。 潰したあとで2群がきれいに離れていれば、その方向が良い方向です。
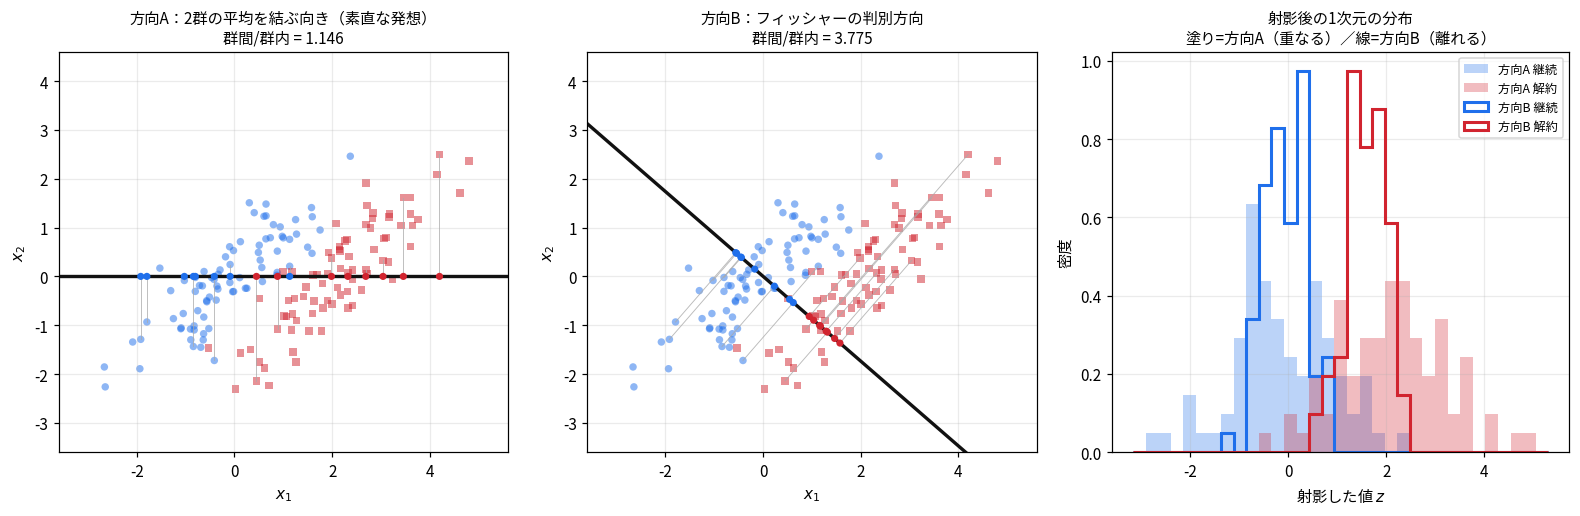
左の図が、素直な発想です。2群の平均を結ぶ向きに射影する。中心が離れている方向なのだから、それが一番よく分かれそうに思えます。
ところが右の図を見ると、この方向(塗りつぶしのヒストグラム)では2群が大きく重なっています。一方、中央の図の方向(線のヒストグラム)ではきれいに離れています。平均を結ぶ向きが最良ではないのです。
何を測って良し悪しを決めるか
良い方向とは何でしょうか。図を見ながら考えると、2つの条件が要ります。
- 2群の中心が離れていること(群間のばらつきが大きい)
- 各群の中でまとまっていること(群内のばらつきが小さい)
中心が離れていても、各群がだらしなく広がっていたら重なってしまいます。逆に各群がぎゅっと固まっていれば、中心が少ししか離れていなくても分かれます。この2つを同時に扱うには、割り算にすればよい。
これがフィッシャーの判別基準です。上の3枚組の図に書いてある数字がこれで、方向Aは 1.146、方向Bは 3.775。方向Bは3.3倍よいという意味です。
方向 に射影したときの値を式で書くと、群間変動 と群内変動 を挟んで次の形になります。
これを最大にする が に比例する、というのがフィッシャーの結果です。 を で割ったものが なので、定数倍の違いを無視すれば冒頭の式と同じになります(判別は符号だけで決まるので、 の定数倍は結果に影響しません)。
そしてこれは分散分析のF値だった
ここが今回いちばん確かめたかった点です。「群間÷群内」という形は、第20回の分散分析のF値とそっくりです。
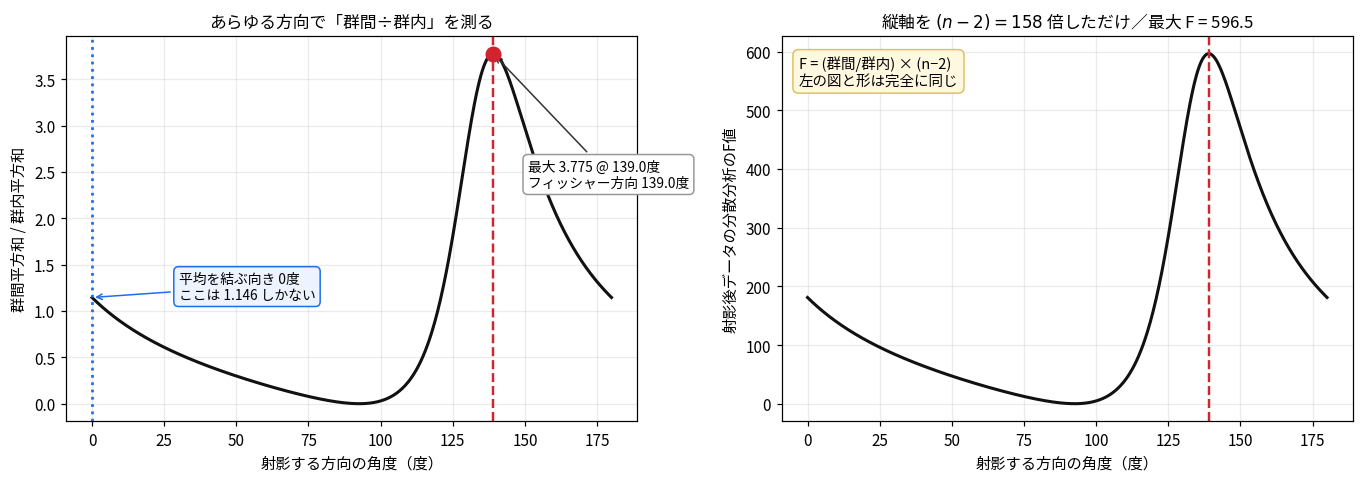
左の図は、あらゆる方向(0度から180度まで)について「群間平方和÷群内平方和」を計算したものです。山のピークは139度で、フィッシャーの判別方向と一致しています。素直な発想だった「平均を結ぶ向き」は0度(この設定では平均差が 方向だけなので)で、ピークから大きく外れています。
右の図は、同じ計算の縦軸を 倍しただけです。すると、射影後のデータを一元配置分散分析にかけたF値になります。2群の一元配置分散分析では自由度が なので、
は方向によらない定数です。だから「群間÷群内を最大にする方向」と「F値を最大にする方向」は完全に同一になります。
実際に数値で確認しました。ここまでの2枚の図と同じデータ(各群80人、合計160人)で、フィッシャー方向の分離比は 3.775252、 を掛けると 596.489833。射影後のデータで一元配置分散分析を計算したF値も 596.489833 で、差は (浮動小数点の丸め誤差の範囲)でした。
任意の方向でも成立します。
| 射影する方向 | 群間÷群内 | 射影後のF値 | 比 × |
|---|---|---|---|
| フィッシャー方向(139度) | 3.775252 | 596.489833 | 596.489833 |
| 軸 | 1.145507 | 180.990040 | 180.990040 |
| 軸 | 0.002473 | 0.390750 | 0.390750 |
| 対角 | 0.351532 | 55.542129 | 55.542129 |
| 逆対角 | 3.568547 | 563.830465 | 563.830465 |
どの方向でも一致します。フィッシャーの線形判別と分散分析は、同じ量を違う目的で使っているだけでした。
- 第20回(分散分析)… 群間÷群内を計算して、F分布と比べて検定する
- 第25回(判別分析)… 群間÷群内が最大になる方向を探す
前者はF値を「読む」、後者はF値を「最大化する」。同じ量に対する2つの態度です。この接続が見えたのが、今回いちばんの収穫でした。
群が3つ以上のとき
補足として、群が3つ以上ある場合は射影する方向が1本では足りません。 の固有値問題を解いて、 本の判別方向を取り出します( は群の数、 は変数の数)。2群なら なので方向は1本で、上の式で終わりです。3群なら2本になり、その2本で張る平面にデータを落として散布図を描く、という使い方をします。前回の主成分分析で固有値分解を扱ったので、道具立ては同じです。
ただし目的が違います。主成分分析は群のラベルを使わず「全体のばらつきが大きい方向」を探しました。判別分析はラベルを使って「群が分かれる方向」を探します。同じ固有値分解でも、 と という2つの行列を持ち込むところが違いです。
判別そのものを多群でどう行うかは、この記事の後半「3群以上に拡張する」の節で扱います。
なぜマハラノビス距離なのか
判別のもうひとつの説明の仕方があります。2つの群の中心のうち、近いほうに割り当てる。 これなら直感的です。
ただし「近い」の測り方が問題になります。素直に定規で測った距離(ユークリッド距離)ではうまくいきません。
まず距離の等距離線を見る
距離の定義そのものを図にすると、違いが一目で分かります。
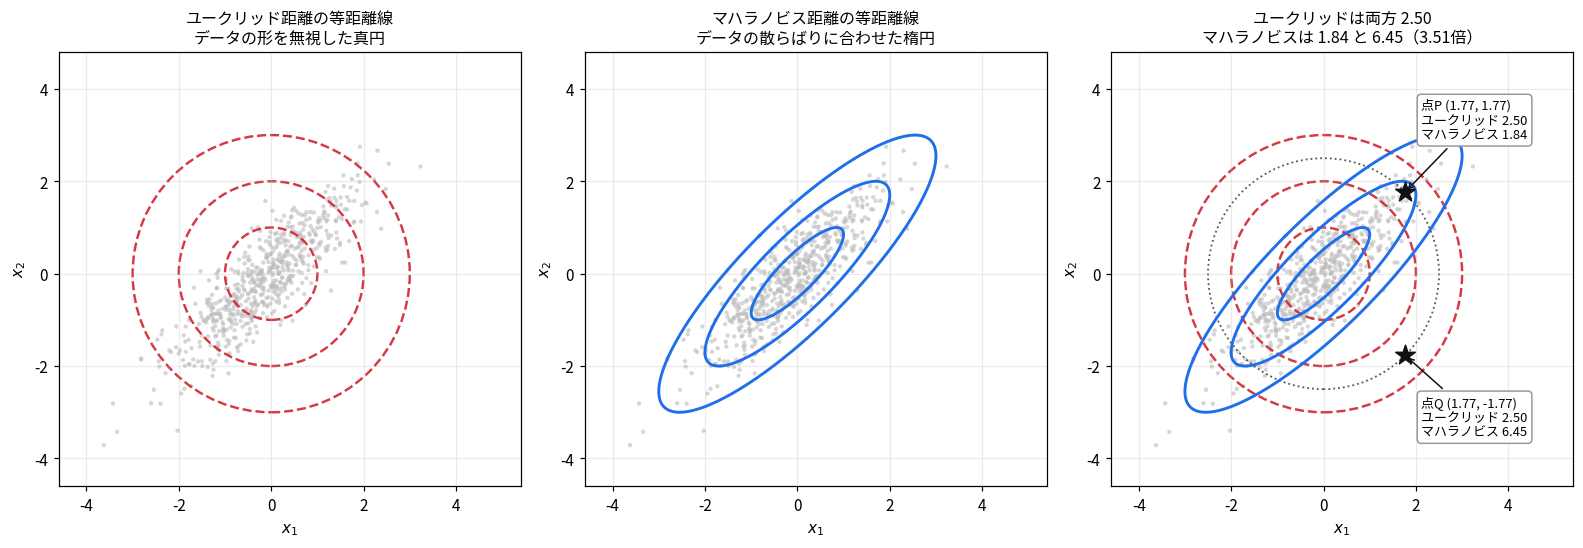
灰色の点がデータの散らばりです。斜めに細長く伸びています(2変数に強い正の相関がある状態)。
左の図がユークリッド距離の等距離線です。真円で、データの形をまったく見ていません。中央がマハラノビス距離の等距離線で、データの散らばりに沿った楕円になっています。
右の図に注目してください。点Pと点Qは、原点からのユークリッド距離がどちらもちょうど 2.50 です。同じ円の上に乗っています。ところがマハラノビス距離は 1.84 と 6.45 で、3.51倍も違います。
3.51倍の出どころ
この数字は手で確かめられます。共分散行列を
とすると、固有値は と です(対称行列の固有値分解。前回の主成分分析で扱った計算です)。
- データが伸びている方向の標準偏差 …
- データがつぶれている方向の標準偏差 …
点Pは伸びている方向(45度)にあり、点Qはつぶれている方向(度)にあります。同じ長さ 2.50 の矢印でも、割る数が違います。
比を取ると 。図の 3.51 と一致します。
主軸(固有ベクトル)方向に限れば、マハラノビス距離は「その方向の標準偏差いくつ分か」を測っていると読めます。つぶれている方向に 2.50 も離れているのは「データが行かない方向にそんなに行った」ということなので、異常さの度合いが大きい。だから遠い、と評価されます。
「主軸方向に限れば」と条件を付けたのは、これが一般の方向では成り立たないからです。上の点P・Qはたまたま主軸上(45度と 度)に取ったので単純な割り算になりましたが、たとえば0度方向では、 に対して「その方向の標準偏差の逆数」は で、約1.9倍ずれます。
一般の方向まで含めて正確に言うなら、 を掛けてデータを等方(真円)に変形してから、ユークリッド距離で測ったものがマハラノビス距離です。楕円を円に引き伸ばす座標変換をしてから普通に測る、という理解が厳密です。
ユークリッド距離だと実際に間違える
抽象的な話ではなく、最初の10人のデータで実害が出ます。
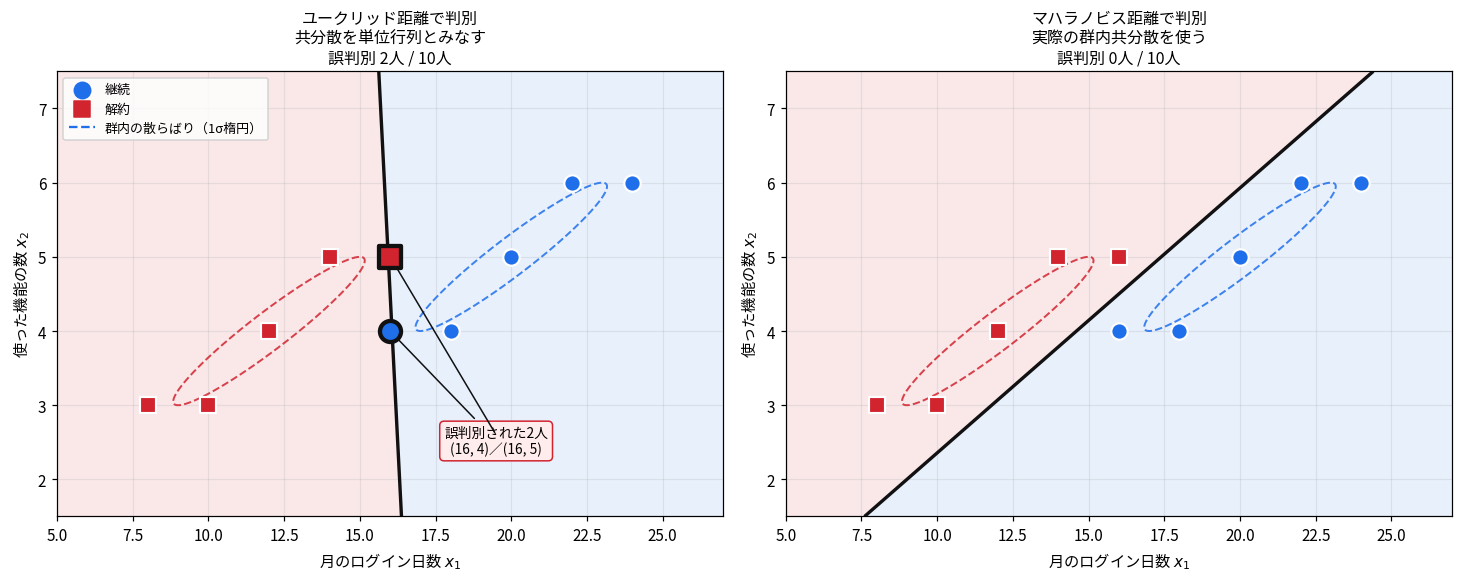
破線の楕円が各群の散らばり(1標準偏差)です。斜めに傾いています。
左はユークリッド距離で「近いほうに割り当てる」を実行した結果です。境界がほぼ垂直になり、会員E(16, 4)と会員I(16, 5)の2人を誤判別しました。ユークリッド距離は各群の楕円の傾きを無視するので、境界が2群の平均を結ぶ線と直交する向きに引かれてしまいます。
右はマハラノビス距離を使った結果です。境界が群内の散らばりの傾きに沿って斜めになり、誤判別0人になりました。
同じデータ、同じ「近いほうに割り当てる」という規則です。違いは距離の定義だけで、結果が変わりました。
線形判別関数との関係
ここで気持ちのよい事実があります。「マハラノビス距離が小さいほうに割り当てる」と「線形判別関数の符号で決める」は同じ判定になります。
2つの群のマハラノビス距離の2乗の差を取ってみます。
展開すると の項が両方に同じ形で現れて消えます。残るのは について1次の項と定数項だけです。
で割って符号を整えると、 という形になります。 を思い出すと、これは そのものです。
共通の共分散行列を使うから2次の項が消えて、境界が直線になる。 これが「線形」判別と呼ばれる理由です。実際に検証コードでも、テスト点500個すべてで両者の判定が一致しました。後で扱う2次判別では、群ごとに共分散行列が違うため2次の項が消えず、境界が曲線になります。
「共分散行列が全群で同じ」とはどういう仮定なのか
ここまで「共通の共分散行列」と繰り返してきましたが、これが実際のデータで何を仮定していることになるのか、私は最初つかめていませんでした。式の上では が1つだけという話ですが、現実の言葉に直すと何を主張しているのでしょうか。
答えは「群によって中心はズレるが、ばらつき方の癖は同じ」です。身長と体重で男女を判別する例で見ます。
| 男性 | 女性 | 同じか | |
|---|---|---|---|
| 平均 | 172cm, 68kg | 159cm, 53kg | 違う |
| 身長の標準偏差 | 約6cm | 約6cm | 同じ |
| 体重の標準偏差 | 約8kg | 約8kg | 同じ |
| 身長と体重の相関 | 約0.6 | 約0.6 | 同じ |
つまり「背が高い人は重い傾向がある」という関係の強さが、男女で同程度だと仮定しています。中心の位置が違うのは構いません(むしろそれが判別の材料です)。ばらつき方だけが共通という主張です。
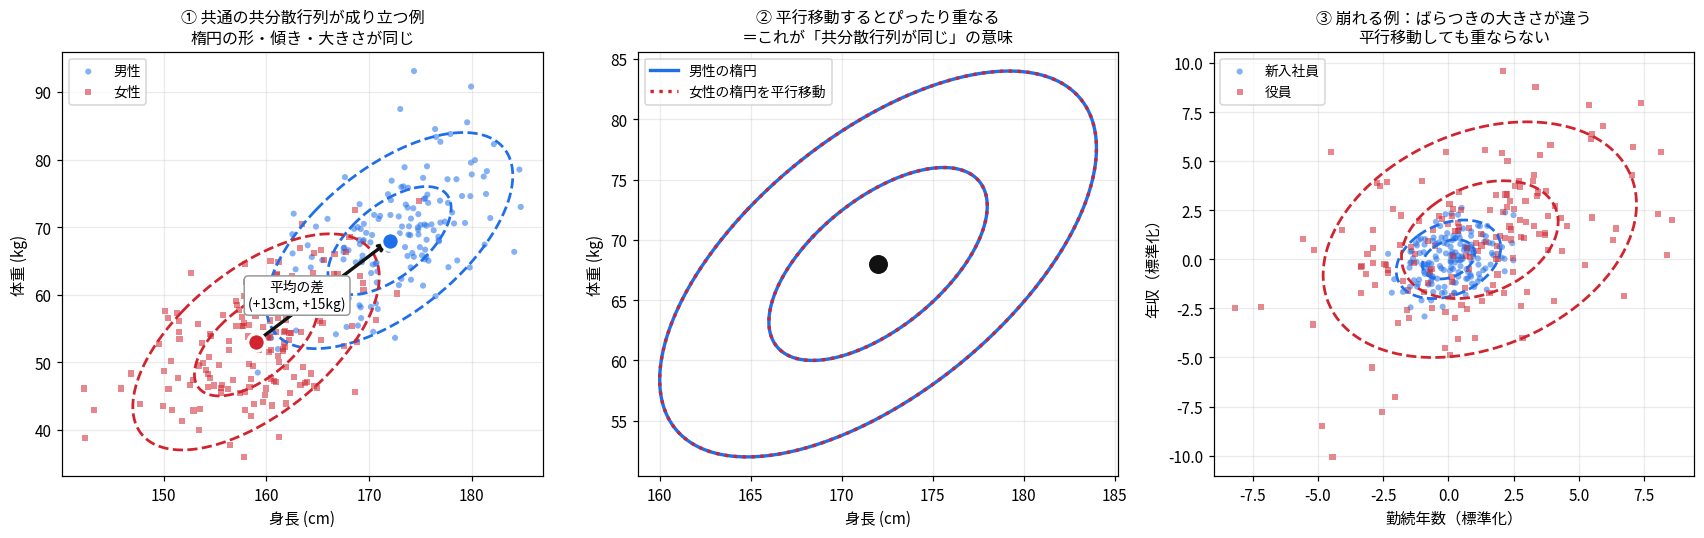
図の見どころは真ん中です。女性の楕円を平均の差の分だけ平行移動すると、男性の楕円にぴったり重なります。 幾何的に言えばこうなります。
共通の共分散行列 = 全群の等確率楕円が「合同」(平行移動だけで重なる)
- 平均が違う … 楕円の位置が違う(仮定違反ではない)
- 共分散行列が違う … 楕円の形・大きさ・傾きが違う(これが仮定違反)
右の図が崩れる例です。新入社員と役員の年収を比べると、役員は個人差が桁違いに大きいので楕円の大きさが違い、平行移動しても重なりません。
崩れる3つの典型パターン
崩れ方には型があり、それぞれ境界の形と対応します。
| 崩れ方 | 実務の例 | 境界の形 |
|---|---|---|
| ばらつきの大きさが違う | 新入社員 vs 役員の年収(役員は個人差が大きい)/既存顧客 vs 新規顧客 | 楕円・円 |
| 相関の符号が違う | 健康な人は「運動量が増えると体重が減る」、回復期の患者は「運動量が増えると体重も増える」 | 双曲線 |
| 片方の群だけ特定の変数が固定的 | 正常な製造ラインは温度が一定、異常ラインは温度が暴れる | 放物線・平行2直線 |
実務で「同じ」と言えるのはどんなときか
目安として、同じ母集団を条件で切り分けた群なら成り立ちやすいです(男女、地域、購入経路など)。測定の仕組みが共通なので、測定誤差の構造も似通ります。
逆に階層や規模が違う群では崩れがちです(新人と役員、中小企業と大企業、健常者と重症患者)。判断のコツは「片方の群だけ極端な人が混じりうるか」を考えることです。混じりうるなら、その群の分散が大きくなって仮定が崩れます。
確認する手順としては、群ごとに標準偏差と相関行列を出して並べるのが手軽です。検定(Box のM検定)もありますが、標本が大きいと些細な違いでも有意になるので機械的な採用は勧められません。後の節で扱うように、交差確認法で線形と2次を両方測って比べるのがいちばん確実です。
境界が「直線」と「2次曲線」に分かれる仕組み
前の節で「2次の項が消えるから直線になる」と書きました。ここは判別分析の構造の核心で、試験でも問われるところなので、1次元の例で丁寧に追ってみます。
出発点は、群 に属する見込み(対数尤度)です。
判別は「 と のどちらが大きいか」で決めます。だから境界は差がゼロになる場所です。この引き算で何が起きるかが全てでした。
分散が同じとき: が打ち消し合う
1次元で書くと、分母が同じ になるのがポイントです。
分子の に注目すると 。消えます。
1次式がゼロになる点は1個だけ。 なら (中点)です。 の項も が共通なので引き算で消えています。
分散が違うとき: が生き残る
分母が揃わないので、係数が打ち消し合いません。
が残るので境界の式は2次方程式になり、解は最大2個。さらに も消えずに残ります(広がった群にペナルティを与える役割です)。
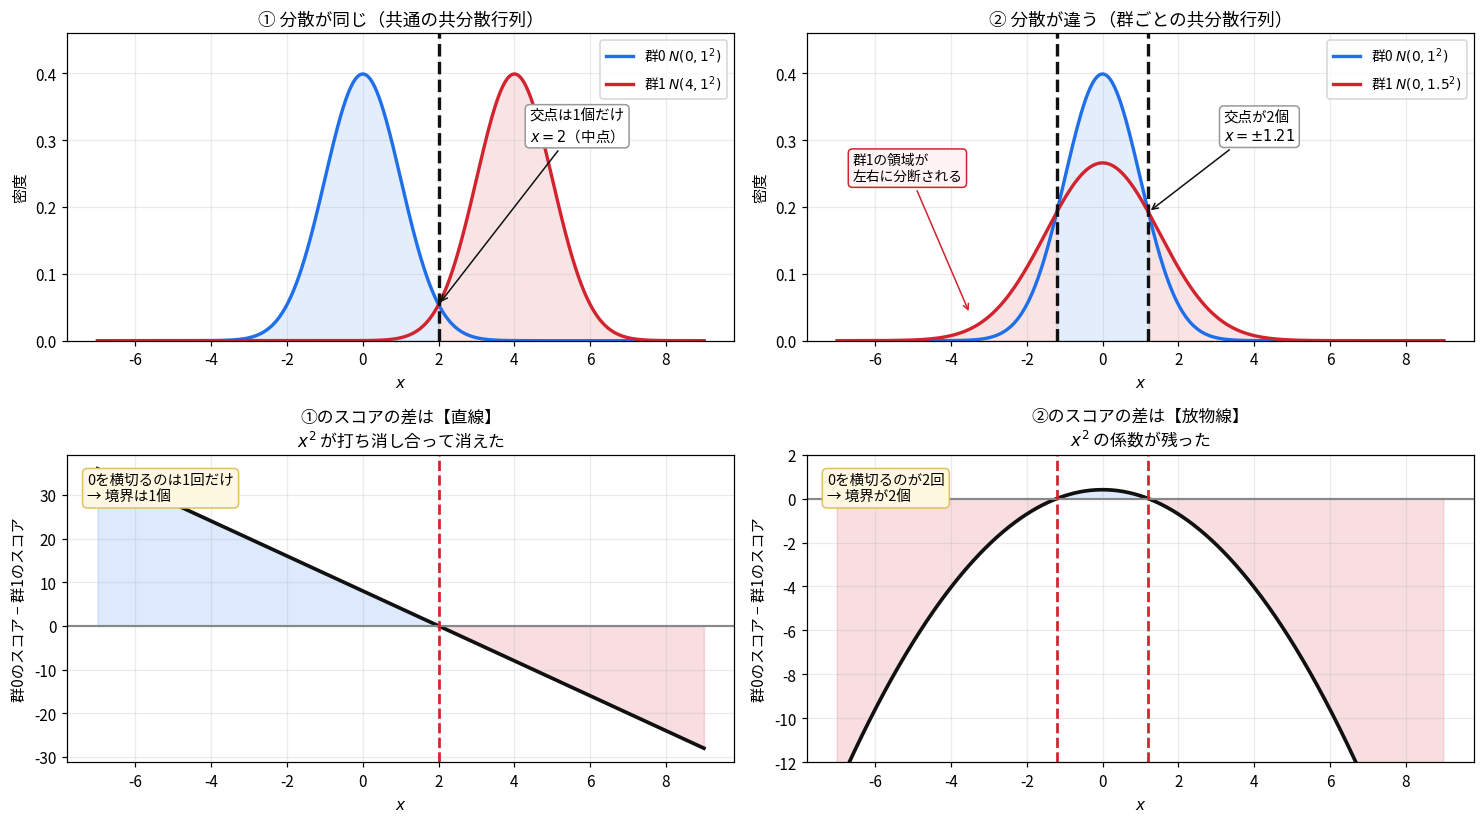
下段を見てください。スコアの差が直線か放物線かという違いが、そのまま境界の個数になっています。
右上の図で起きていることが「2次」の実質です。群0 = 、群1 = という平均が同じで分散だけ違う設定で、判定はこうなります。
| 群0のスコア | 群1のスコア | 判定 | |
|---|---|---|---|
| 群1(外側) | |||
| 群1(外側) | |||
| 群0(内側) | |||
| 群1(外側) | |||
| 群1(外側) |
群0と判定されるのは という「区間」で、群1は左右2つに分断されます。これは1本の線では絶対に表せません。
中央に固まっていたら散らばりの小さい群、外側にあったら散らばりの大きい群、という理にかなった判定です。そして平均が同じでも分散の違いだけで判別できている点にも注目してください。線形判別だと のとき となって判別不能ですが、2次判別なら分けられます。
2次元だと「2次曲線」の種類が見える
多次元では の項が という行列を挟んだ形になります。
なら で2次の項が消えて直線。違えば で、 の固有値の符号が境界の形を決めます。高校で習う2次曲線の分類とまったく同じです。
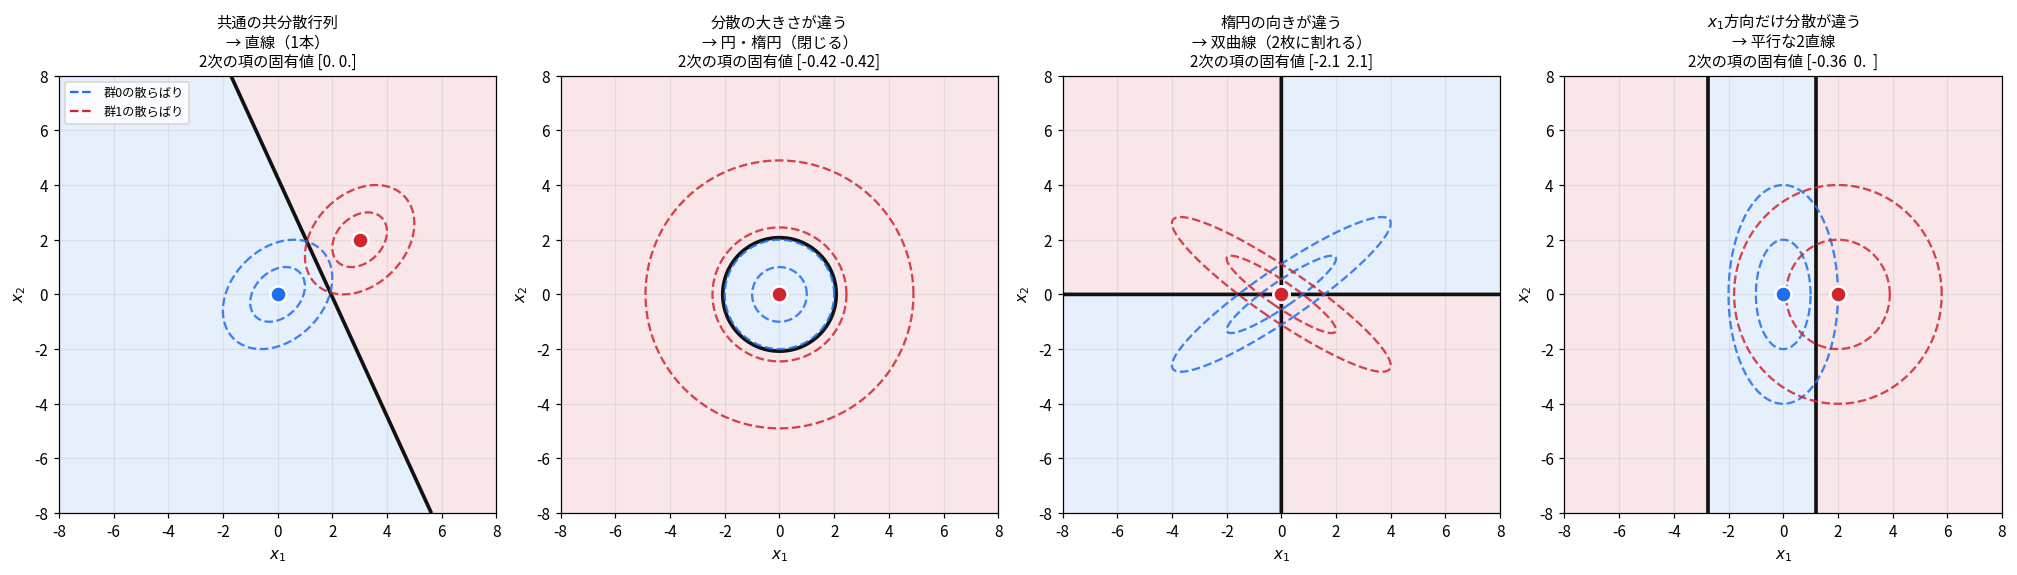
| の固有値 | 境界の形 | 起きている状況 |
|---|---|---|
| 両方 0 | 直線(超平面) | 共分散行列が共通=線形判別 |
| 同符号 | 楕円・円 | 片方の群が全方向に広い(内側と外側で分ける) |
| 異符号 | 双曲線 | 楕円の向きが違う(方向ごとに優劣が逆転) |
| 片方が 0 | 放物線・平行2直線 | ある方向だけ分散が同じ |
4枚目を手で解いて確認しました。群0 = ・、群1 = ・ のとき、 方向は分散も平均も両群で同じなので、 の2次項も1次項も完全に打ち消し合います。すると境界は だけの2次方程式になり、 を含まない ── つまり縦の直線です(分散だけが同じで平均が違うと、 の1次項が残って傾いた放物線になります)。解くと と の2本で、図の縦線の位置と一致しました。
ここから引っかけポイントが出てきます。「2次判別の境界は必ず曲線」ではありません。 固有値に0が混じると平行2直線になります。「2次式で表される図形」であって、必ず曲がるわけではない ── これが正確な理解です。
事前確率を考える:これは第2回のベイズの定理そのもの
ここまでは「2群が同じくらいの割合で存在する」という暗黙の前提で話してきました。しかし現実には偏りがあります。
有病率1%の病気の検査を考えます。検査値 は、健常者なら 、病気の人なら に従うとします。分布の形だけ見れば、中点の 1.5 で切るのが自然に思えます。
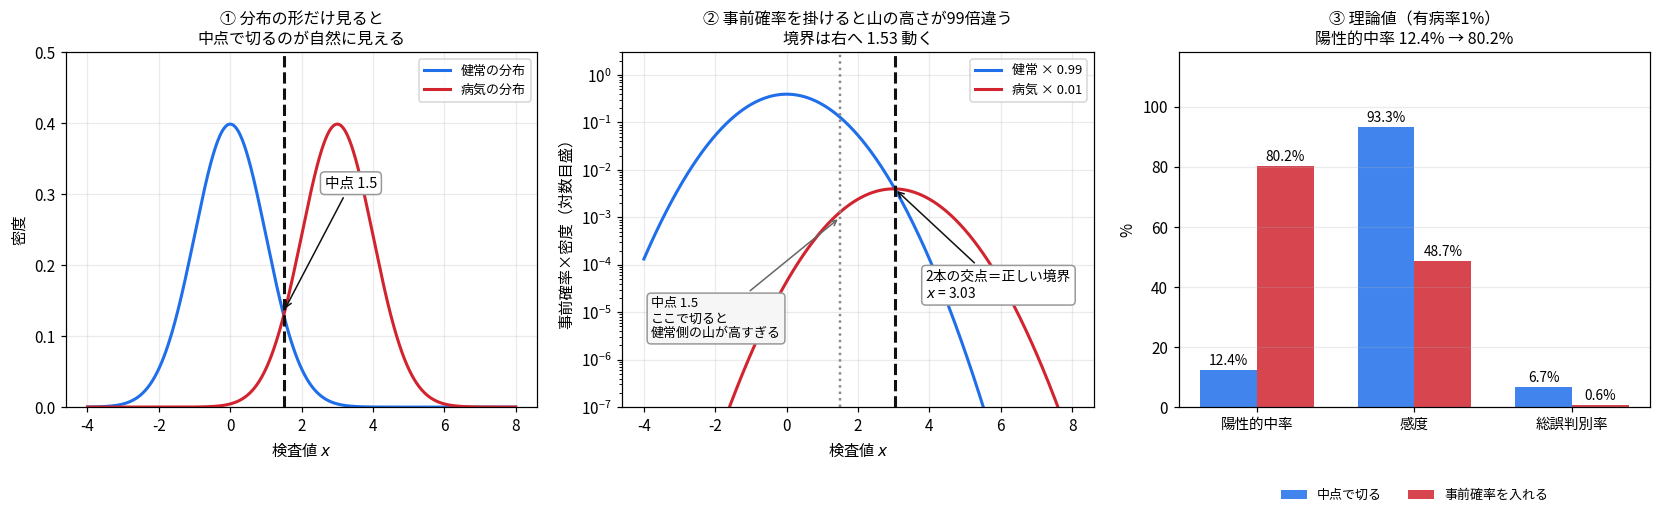
真ん中の図が答えです。事前確率(健常0.99、病気0.01)を掛けると、山の高さが99倍違います。 2本の曲線の交点は中点から大きくずれ、 になります。
式を見ると足し算になっている
なぜ足し算なのかを確認します。第2回のベイズの定理はこうでした。
事後確率は、尤度と事前確率の掛け算に比例します。判別は「事後確率が大きいほうに割り当てる」だけです。両辺の対数を取ると、掛け算が足し算になります。
多変量正規分布の密度を入れると、第1項が 、つまりマハラノビス距離の2乗の 倍になります(正規分布の指数部分がそのままマハラノビス距離だからです。ここは前回の多変量正規分布の話が直接効きます)。
2群の差を取ると、前節と同じように2次の項が消えて、
という形になります。事前確率は の項として切片に足されるだけです。1次元の例で境界を書くと、
図の 3.03 と一致します。
誤判別コストも同じ場所に入る
「病気の人を healthy と判定する損失」と「健常者を病気と判定する損失」は普通は等しくありません。前者のほうがずっと重い。この非対称性も、まったく同じ場所に入ります。
は「本当は群1なのに群2と判定したときの損失」です。事前確率とコストは、どちらも切片への足し算という同じ形で効きます。実務では両者を掛けた をまとめて扱うことも多く、比だけが効くので片方に押し込めます。
この添字はとても間違えやすいので、確認の仕方を決めておきます。この記事では群1が継続、群2が解約です。「解約の見逃し」とは、真は解約(群2)なのに継続(群1)と判定することなので です。これを5倍重く見るなら 、 なので、足す量は
とマイナスになります。
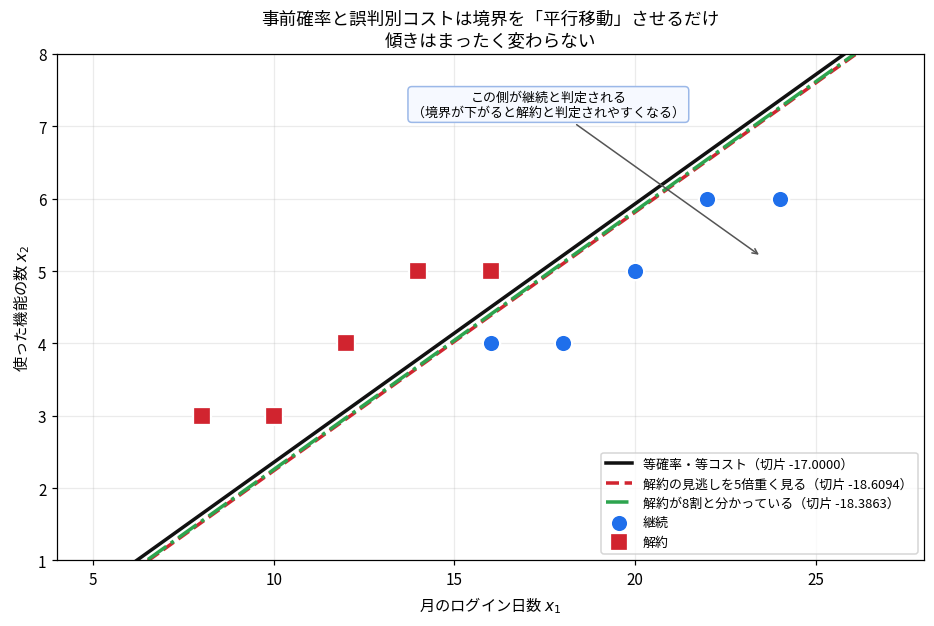
図で確認できます。3本の境界はすべて平行です。10人のデータで実際の数値を出すと、
| 設定 | 切片 | |
|---|---|---|
| 等確率・等コスト | ||
| 解約の見逃しを5倍重く見る | ||
| 解約が8割と分かっている |
はまったく変わっていません。 切片だけが動いています。 なので 、 なので 。手計算と一致します。
符号の向きは意味で検算します。 この判別関数では が継続なので、 より継続領域は境界の下側です。切片を小さくすると境界が下がり、継続領域が狭まって解約と判定されやすくなります。 解約の見逃しを重く見るなら、解約と判定されやすくなるべきなので、切片は小さくなるのが正しい。図でも赤破線と緑の一点鎖線が黒より下にあり、両方とも「解約と判定されやすくする」方向で揃っています。
実際に境界付近の点で判定が変わることを確認しました。 から の5点で、等コストなら解約判定は1点、 を足しても1点ですが(この設定では判定が変わるほどの移動ではない)、符号を逆にして を足すと解約判定が0点になります。逆向きに動かすと見逃しがむしろ増えるわけで、そこで誤りに気づけます。
有病率が低いと陽性的中率が下がる、あの話と同じ
ご質問の「有病率が低いと陽性的中率が下がるという話と同じ構造か」について、正規分布の確率を厳密に計算して確かめました(シミュレーションだと乱数の揺れが入るので、ここは理論値で出しています)。人数は200万人あたりに換算した値です。
| 指標 | 中点 1.5 で切る | 事前確率を入れる(3.03) |
|---|---|---|
| 陽性と判定された人 | 150,942人 | 12,154人 |
| そのうち本当に病気 | 18,664人 | 9,747人 |
| 陽性的中率 | 12.36% | 80.19% |
| 感度(病気を見つける率) | 93.32% | 48.74% |
| 特異度 | 93.32% | 99.88% |
| 総誤判別率 | 6.68% | 0.63% |
同じ構造です。中点で切ると、感度93.32%・特異度93.32%という「そこそこ優秀」な検査に見えるのに、陽性的中率は12.36%しかありません。 陽性と言われた人の9割近くが実は健常者です。健常者が99倍多いので、たった6.7%の偽陽性率でも人数では病気の人を圧倒してしまう。第2回でやったあの計算です。
事前確率を入れた境界にすると陽性的中率は80.19%に上がります。ただし感度が93.32%から48.74%に落ちます。
ここは自分でも引っかかったので書いておきます。総誤判別率は 6.68% → 0.63% と10分の1に改善しているのに、病気の人の半分以上を見逃しているのです。総誤判別率を最小にするというのは、人数の多い群を優先するという意味なので、少数派の見逃しが増えます。
実際の検診でこの境界を使わないのは、まさにこの理由です。見逃しの損失が桁違いに大きいので、誤判別コストを入れて境界を戻すことになります。「総誤判別率の最小化」が実務の目的とは一致しない、という良い例でした。
誤判別率を同じデータで測ってはいけない
判別ルールができたら「どれくらい当たるのか」を知りたくなります。ここに罠があります。
見かけの誤判別率
ルールを作ったのと同じ10人にルールを当てはめると、誤判別0人=誤判別率0%でした。これを見かけの誤判別率と呼びます。この0%を「このルールは完璧です」と読んではいけません。
どれくらい嘘をつくのかを、極端な実験で測りました。2つの群をまったく同じ乱数発生器から発生させます。 群のラベルはコイン投げで割り当てただけで、データには群の情報が一切入っていません。つまり真の誤判別率は50%(コイン投げと同じ)です。
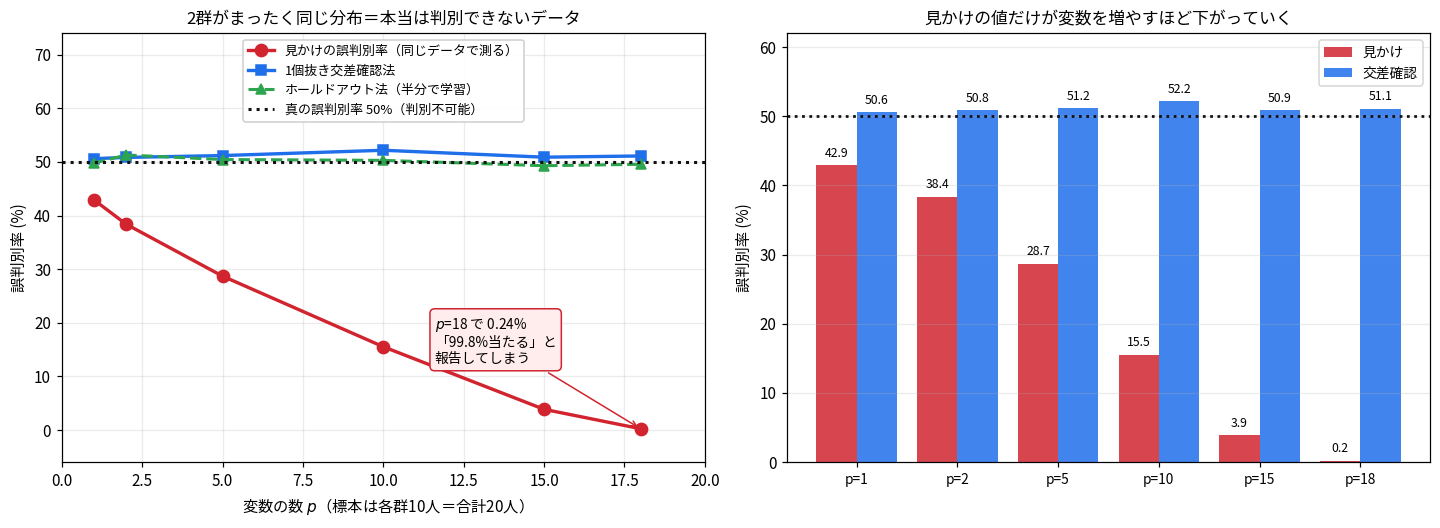
各群10人(合計20人)で、変数の数 を増やしていきます。
| 変数の数 | 見かけの誤判別率 | 1個抜き交差確認 | ホールドアウト法 | 真の値 |
|---|---|---|---|---|
| 1 | 42.92% | 50.60% | 49.77% | 50% |
| 2 | 38.38% | 50.83% | 51.28% | 50% |
| 5 | 28.69% | 51.18% | 50.43% | 50% |
| 10 | 15.53% | 52.17% | 50.28% | 50% |
| 15 | 3.86% | 50.88% | 49.28% | 50% |
| 18 | 0.24% | 51.10% | 49.55% | 50% |
で見かけの誤判別率が 0.24% です。「99.8%の精度で判別できるルールができました」と報告してしまいます。実際にはデータに情報が1ビットも入っていません。
一方、1個抜き交差確認法とホールドアウト法は、どの行でも正しく50%前後を返しています。
細かい点ですが、交差確認法の値が 50.60〜52.17% とすべて50%を上回る側に寄っているのは偶然ではありません。1個抜き交差確認法は 件で学習した規則を評価するので、 件全部で学習する規則より少し不利な条件になります。つまりわずかに悲観側に偏るのが理論通りの振る舞いです。見かけの誤判別率が大きく楽観側に外れるのに比べれば、無視できる大きさです。
なぜこうなるのか
標本20人に対して、 のとき共分散行列だけで 個のパラメータを推定しています。平均も 個。推定すべき量が標本数より桁違いに多い状態です。
こうなると判別ルールは、群の構造ではなくその20人の偶然の凹凸を暗記します。20人の座標を丸暗記して線を引けば、その20人は完璧に分けられます。でも21人目には何の役にも立ちません。
これが第16回で扱った「変数を増やすと決定係数 が下がることはない」現象と同じ構造です。 のときは自由度調整という補正がありました。判別分析では、測る場所を変える(学習に使っていないデータで測る)という解き方をします。
3つの測り方
| 方法 | やり方 | 長所 | 短所 |
|---|---|---|---|
| 見かけの誤判別率 | 学習データで測る | 計算が1回で済む | 楽観的に偏る。標本が小さいと使い物にならない |
| ホールドアウト法 | データを2分割し、片方で学習、片方で測る | 簡単。楽観側には偏らない | 学習に使えるデータが減る。分割の仕方で結果が揺れる |
| 交差確認法 | 分割と評価を繰り返して平均する | データを無駄にせず、揺れも小さい | 計算量が増える( 回学習する) |
1個抜き交差確認法(LOO)は、 件のデータから1件だけ抜いて残り 件で学習し、抜いた1件を当てる。これを 回繰り返して誤りの割合を出します。データが少ないときはこれが定番です。
なお、これらは判別分析に限った話ではありません。第32回のモデル選択(AIC・BIC)は、同じ「当てはめすぎ」の問題に対して「パラメータ数に罰則を科す」という別の解き方をします。交差確認法は罰則を仮定せず実際に測るので、モデルの形を問わず使える一方、計算量を払う。この対比は第32回で改めて扱います。
2次判別:柔軟なら常にそちらでよいのか
ここまでは2群の共分散行列が同じだと仮定していました。この仮定を外すと2次判別になります。
群ごとに共分散行列 を推定して、次のスコアが大きいほうに割り当てます。
第2項がマハラノビス距離の2乗(群ごとの共分散で測ったもの)です。第1項の が新しく登場します。共分散行列が群で違うと、2群の差を取っても の項が消えません。だから境界が2次曲線になります。
の意味は「その群の広がりの大きさによる補正」です。広がった群は密度がどこでも低いので、距離が同じでも所属確率が下がる。行列式は楕円の体積に相当するので、体積が大きいほどペナルティが付きます。
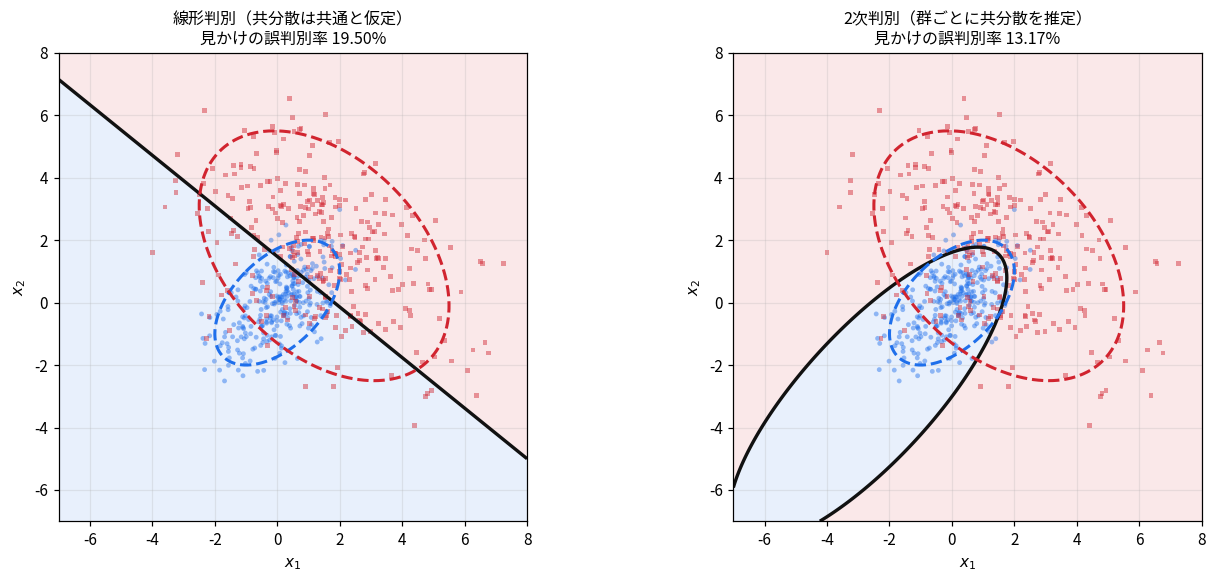
破線の楕円が各群の実際の散らばりです。青い群は小さくまとまり、赤い群は大きく広がっています。左の線形判別は境界が必ず直線なので、内側の小さい群に沿った形にはできません。右の2次判別は曲線なので、青い群の側に張り出した形を描けています(この図では放物線状に開いた曲線になっていて、完全に閉じた楕円で囲んでいるわけではありません)。
「柔軟なら常に2次でよいのでは」への答え
私も同じことを考えたので、2つの設定で誤判別率を実測しました。評価は必ず別に発生させたテストデータ(各群3000件)で行っています(前節の教訓)。
| 各群の | ① 等分散が真:線形 | ① 2次 | ①の差 | ② 分散が違う:線形 | ② 2次 | ②の差 |
|---|---|---|---|---|---|---|
| 10 | 21.46% | 23.73% | +2.27pt | 24.14% | 17.75% | pt |
| 20 | 20.22% | 20.96% | +0.74pt | 23.00% | 15.39% | pt |
| 50 | 19.68% | 19.86% | +0.18pt | 22.39% | 14.58% | pt |
| 200 | 19.44% | 19.49% | +0.05pt | 22.07% | 14.16% | pt |
| 1000 | 19.28% | 19.29% | +0.01pt | 21.97% | 14.08% | pt |
答えは「常に2次でよいわけではない、ただし損は思ったより小さい」でした。そして表の縦の動き方に決定的な非対称性があります。
①の列(等分散が真なのに2次を使った場合)は、 で pt 悪化しますが、 で pt、 では pt。標本を増やせば損失がほぼ消えます。 余分に推定したパラメータの誤差が、標本が増えれば小さくなるからです。
②の列(分散が本当に違うのに線形を使った場合)を見てください。線形判別は で 24.14%、 でも 21.97%。標本を1000倍にしても改善しません。 一方2次は14.08%まで下がります。7.9ptの差が、標本をいくら増やしても埋まらないのです。
ここが本質でした。
- 間違ったモデルを使うと、標本を増やしても直らない(バイアスは消えない)
- 無駄に複雑なモデルを使うと、標本を増やせば直る(バリアンスは消える)
前者は取り返しがつかず、後者は取り返しがつきます。だから「等分散かどうか怪しいなら2次を試す価値がある」という判断になります。
では判断基準は何か
標本サイズが変数の数に対して十分かどうかです。2次判別は群ごとに共分散行列を推定するので、1群あたり 個の成分が必要です。
| 変数の数 | 線形判別(共通1個) | 2次判別(2群なら2個) |
|---|---|---|
| 2 | 3個 | 6個 |
| 5 | 15個 | 30個 |
| 8 | 36個 | 72個 |
| 20 | 210個 | 420個 |
で分散が本当に違う設定を実測すると、標本が足りないときに逆転が起きます。
| 各群の | 線形判別 | 2次判別 |
|---|---|---|
| 12 | 31.29% | 29.33%(差が小さい) |
| 20 | 33.01% | 18.83% |
| 50 | 27.08% | 9.94% |
| 300 | 22.96% | 6.24% |
各群12人(1群あたり36個の共分散成分を12人から推定)では、2次判別の優位がほぼ消えています。 以上では明確に2次が勝つ。共分散行列を推定できるだけの標本があるかが分かれ目です。
なお、等分散かどうかを検定する方法としてBox のM検定があります。ただしこの検定は標本が大きいと些細な違いでも有意になり、正規性からのずれにも敏感なので、検定結果を機械的に採用するのは勧められません。実務では交差確認法で線形と2次を両方測って比べるのがいちばん確実です(測り方の話が、そのままモデル選択の道具になります)。
線形と2次の中間として、共分散行列を「群ごとの推定」と「共通の推定」の重みつき平均にする正則化判別分析もあります。第19回のリッジ回帰と同じ発想で、極端な2択の間を連続的につなぐ考え方です。
3群以上に拡張する
ここまで2群で話してきましたが、実務では3つ以上に分けたい場面が普通にあります。優良顧客・一般顧客・離脱予兆の3段階、といった具合です。
判別分析は元から多群に対応しています。 各群のスコアを計算して、いちばん大きい群に割り当てるだけです。
これを全群について計算して最大のものを選ぶ。群が何個でも同じ手続きで、2群の「符号で決める」はこの特殊ケースでした(2群の差を取ると1本の判別関数になる)。
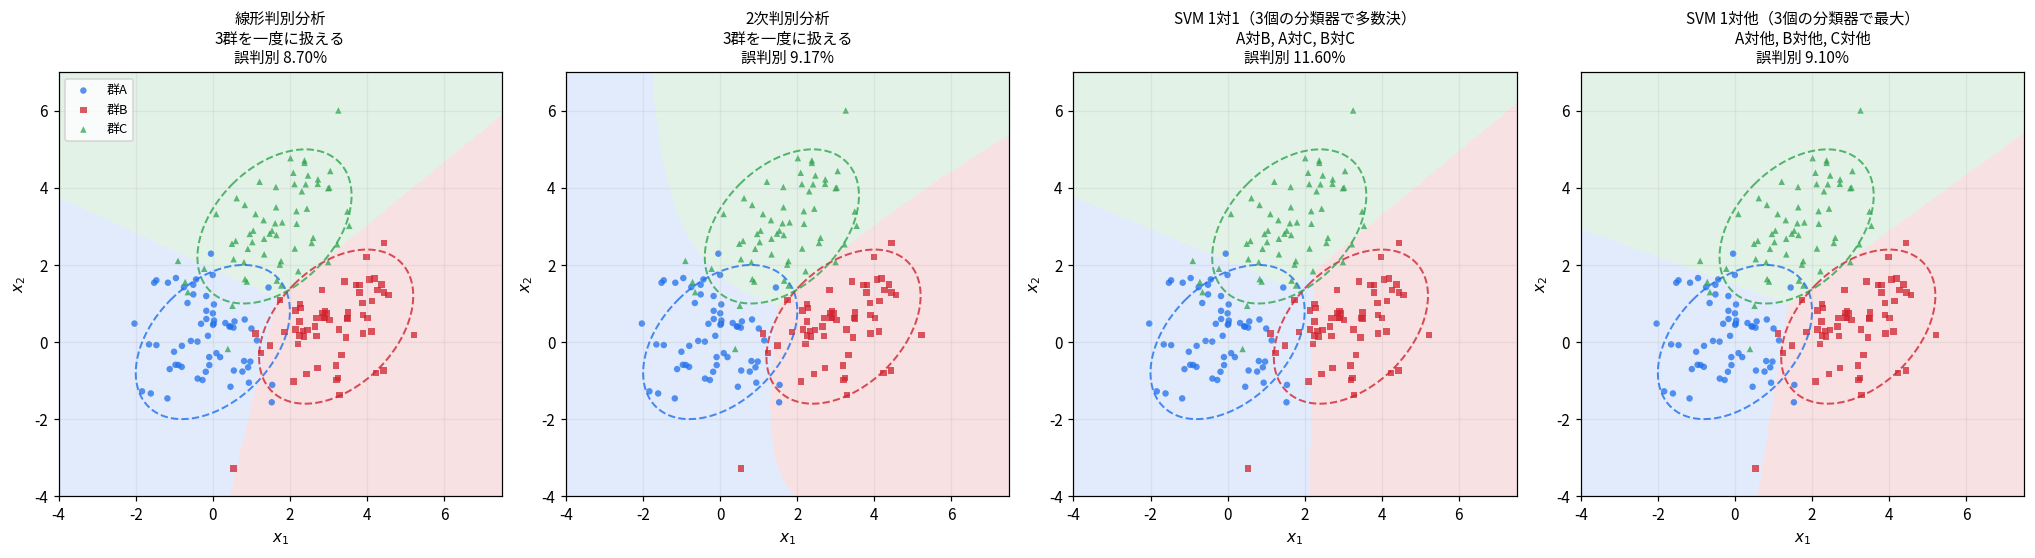
左端の線形判別分析を見ると、境界が3本の直線で1点に集まる形になっています。3群を一度に扱っていることが図から見て取れます。
一方、サポートベクターマシンは2群専用
ここに両者の設計思想の差が出ます。サポートベクターマシンは本質的に2群を分ける道具なので、多群にするには複数の分類器を組み合わせる必要があります。
| 方式 | やり方 | 分類器の数( 群) | 決め方 |
|---|---|---|---|
| 1対1(one-vs-one) | 全ペアで分類器を作る(A対B、A対C、B対C) | 多数決 | |
| 1対他(one-vs-rest) | 「その群 vs 残り全部」の分類器を作る | スコアが最大の群 |
3群で実測すると次のようになりました。
| 手法 | 誤判別率 | 内部の分類器 |
|---|---|---|
| 線形判別分析 | 8.70% | 1回の計算 |
| サポートベクターマシン 1対他 | 9.10% | 3個 |
| 2次判別分析 | 9.17% | 1回の計算 |
| サポートベクターマシン 1対1 | 11.60% | 3個 |
この設定(多変量正規・等分散)では線形判別分析が最良でした。前提が合っているので当然の結果です。
組み合わせ方式には決められない領域ができる
格子4万点で内部の投票状況を調べたら、両方式の弱点が観察できました。
1対1の弱点:じゃんけん状態。 3群の得票は必ず か になります。 は「AはBに勝ち、BはCに勝ち、CはAに勝つ」という三すくみで、多数決では決まりません。実測で0.12%(49点)発生しました。
1対他の弱点:全員が否定する領域。 すべての分類器が「自分の群ではない」と言う点が1.79%(716点)ありました。だから符号ではなくスコアの大小で決める実装にしていますが、スコアの尺度が分類器間で揃っている保証がないという問題が残ります(別々に学習しているため)。
判別分析にはこの種の不整合が起きません。全群のスコアを同じ式・同じ尺度で計算して比べるので、決められない領域も矛盾も生じないからです。
群が増えたときのコストも違います。
| 群数 | 判別分析 | 1対1 | 1対他 |
|---|---|---|---|
| 3 | 1回 | 3個 | 3個 |
| 10 | 1回 | 45個 | 10個 |
| 26(アルファベット認識) | 1回 | 325個 | 26個 |
| 100(画像分類) | 1回 | 4,950個 | 100個 |
1対1は で増えます。ただし1個あたりの学習データは2群分だけなので、計算量が である効果で合計時間は意外に悪化しません。実務では1対1のほうがよく使われます。
試験対策として押さえるのは3点です。①各群のスコアを計算して最大の群に割り当てる、②判別方向は 本取れる、③Wilks の で「 個の平均ベクトルが全て等しいか」を一度に検定できる(これは多変量分散分析、MANOVA=Multivariate Analysis of Variance と同じ枠組みです)。
変数選択とWilksのラムダ
変数が10個も20個もあるとき、全部使うべきでしょうか。前節の通り、変数を増やすと見かけの成績は上がりますが実力は落ちます。効く変数を選ぶ必要があります。
そのための指標が Wilks の (ラムダ)です。
は群内の平方和積和行列、 は全体の平方和積和行列です( は検証コードで数値的に確認済みです。第20回の平方和の分解が多変量に拡張された形です)。
読み方はこうです。全体のばらつきのうち、群内で説明されずに残っている割合。 縦棒は行列式で、多変量の「体積」に相当します。
- が1に近い … 群内変動が全変動とほぼ同じ=群で分かれていない
- が0に近い … 群内変動が小さい=よく分かれている
1変数の場合を書くと なので、 と同じ形です(第16回の決定係数)。決定係数が「説明できた割合」なら、 は「説明できずに残った割合」。向きが逆なので、 は小さいほうが良い、という読み方になります。
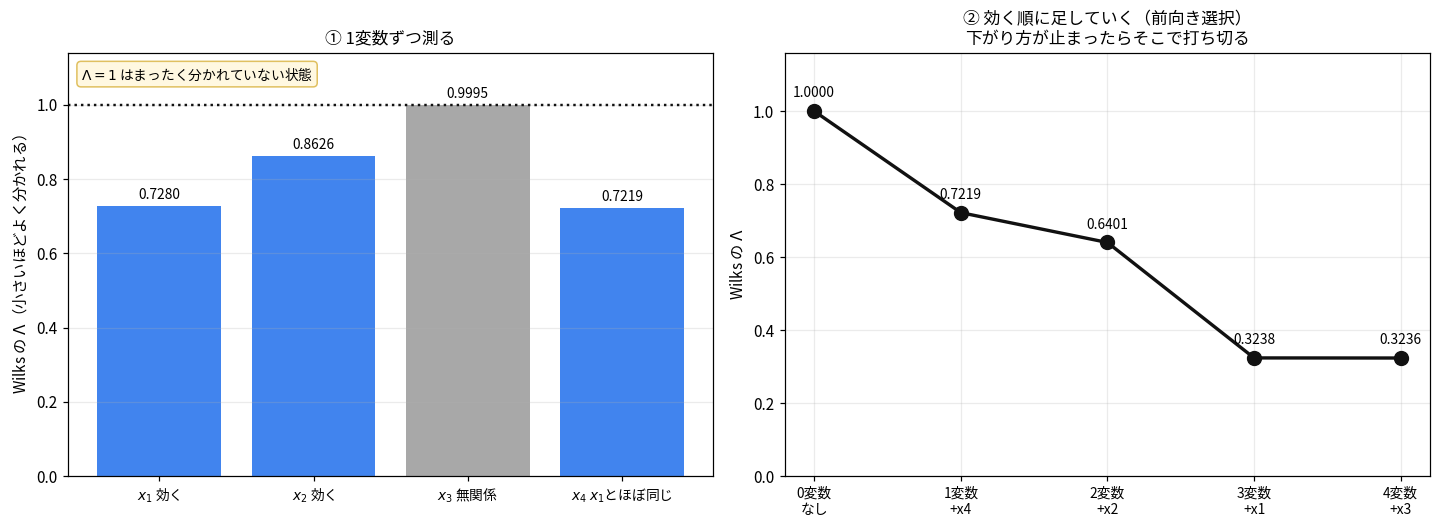
4つの変数を用意しました。 と は本当に効く変数、 は群と無関係なノイズ、 は とほぼ同じ情報を持つ変数(相関0.95)です。
左の図(1変数ずつ測る): 無関係な は で、ほぼ1です。「まったく分かれていない」と正しく判定できています。
右の図(前向き選択): 効く順に変数を足していきます。 は 1.0000 → 0.7219 → 0.6401 → 0.3238 と下がり、最後に を足しても 0.3238 → 0.3236 しか動きません。 ここが打ち切りの目安になります。
はF統計量に変換して検定できます(Rao の近似)。
| 変数 | F値 | 自由度 | p値 | |
|---|---|---|---|---|
| 0.7219 | 45.455 | (1, 118) | ||
| 0.6401 | 32.889 | (2, 117) | ||
| 0.3238 | 80.733 | (3, 116) | ||
| 0.3236 | 60.100 | (4, 115) |
4変数目を足すと はわずかに下がるのに、F値は 80.733 から 60.100 に落ちています。 役に立たない変数を足すと自由度を1つ損するので、検定の切れ味が悪くなる。この動きが「不要な変数を入れるべきでない」ことを数値で示しています。
前向き選択の落とし穴
上の表で1番目に選ばれたのが ( とほぼ同じ情報を持つ変数)だったことに注意してください。単独では が で の 0.7280 より良かったので選ばれています。しかしこの2つは相関0.95なので、両方入れる意味はほとんどありません。
前向き選択は「その時点で最も良い1個」を貪欲に選ぶので、変数の組み合わせとして最良とは限りません。第16回の多重共線性の話が、そのままここでも効いています。
Hotelling の との関係
2群の場合、 は Hotelling の と厳密に対応します。 は2群の平均ベクトルが等しいかを検定する統計量で、t検定の多変量版です。
は2群の平均間のマハラノビス距離の2乗です。この関係を検証したところ、小数10桁まで一致しました(、、両者から計算した値が完全に一致)。 をF分布に直した値 433.4690 と、 から Rao の近似で計算したF値も一致しました(2群のときは近似ではなく厳密になります)。
判別分析の「どれくらい分かれているか」と、検定の「平均に差があるか」は同じ量を見ているわけです。ここもフィッシャーの判別=F値の話と同じ構図でした。
最初の10人のデータでも計算できます。、、(自由度 )、。10人しかいなくても、2群の平均に差があると言えます。
ロジスティック回帰と何が違うのか
いよいよ最初の疑問です。判別分析とロジスティック回帰(第18回)は、どちらも0か1かを予測します。何が違い、どう使い分けるのでしょうか。
違い①:モデル化する対象が違う
これが本質的な差です。
線形判別分析は の分布までモデル化します。 「継続群の は に従い、解約群の は に従う」と仮定して、そこからベイズの定理で を逆算します。データがどう生まれたかを記述するので生成モデルと呼ばれます。
ロジスティック回帰は の形だけを仮定します。 「 オッズが の1次式になる」と決めるだけで、 自体がどんな分布かは問いません。境界だけを直接モデル化するので識別モデルと呼ばれます。
面白いのは、正規・等分散を仮定すると、ロジスティック回帰の形が導出できることです。前の節で見たように、2群の対数尤度の差を取ると について1次式になりました。事後確率はこれをロジスティック関数に通した形になります。
つまり両者は同じ形の関数を使っているのに、係数の推定方法が違うのです。
| 線形判別分析 | ロジスティック回帰 | |
|---|---|---|
| 推定に使うもの | 群ごとの平均と共分散行列 | 尤度の最大化( の条件付き尤度) |
| 計算方法 | 閉じた式で一発(行列の掛け算と逆行列) | 反復計算(ニュートン法・IRLS) |
| の分布 | 多次元正規・等分散を仮定 | 仮定しない |
違い②:前提が正しいときの精度
「前提が正しければ線形判別分析のほうが効率がよい」というのが教科書的な説明です(Efron 1975)。これを実測しました。
正直に書くと、最初の実験では差がまったく出ませんでした。 LDA 20.41% / ロジスティック回帰 20.54% で、0.13ptしか違わない。おかしいと思って条件を振り直したところ、2群の隔たり(マハラノビス距離 )を変えると差が出ることが分かりました。最初の設定は で、あまり分かれていないケースを選んでしまっていたのです。
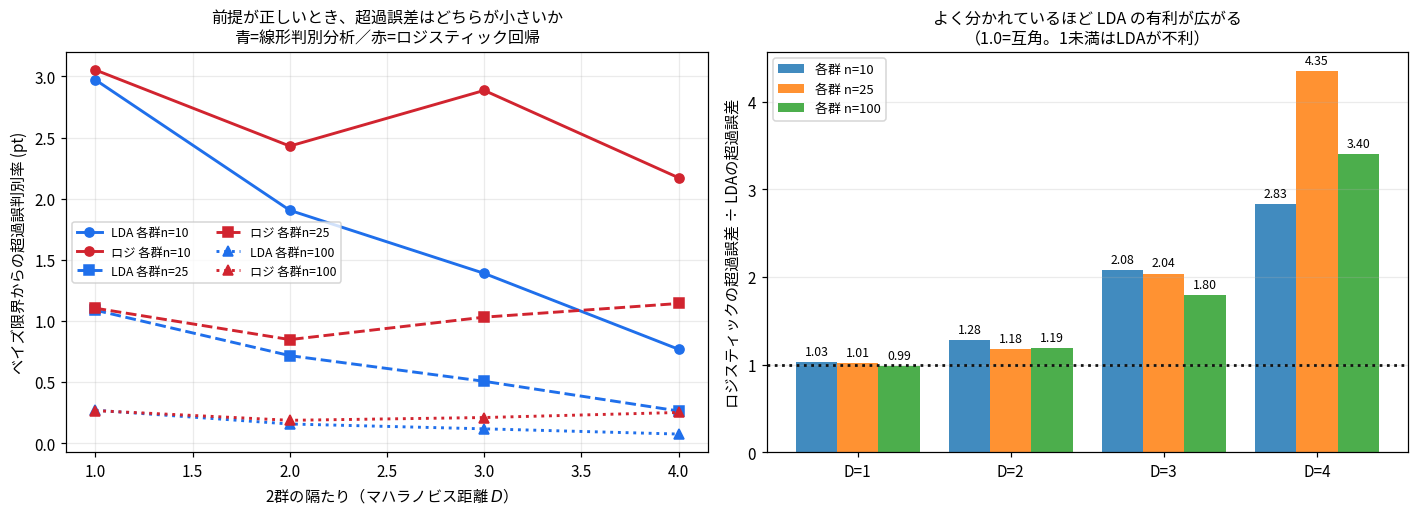
縦軸を「ベイズ限界(理論上の最小誤判別率)からの超過分」にすると、比較が公平になります。 が変わるとベイズ限界そのものが変わるので、絶対値では比べられないからです。
| 隔たり | 各群 | ベイズ限界 | 線形判別分析 | ロジスティック回帰 | 超過誤差の比 |
|---|---|---|---|---|---|
| 1 | 10 | 30.85% | 33.83% | 33.91% | 1.03倍 |
| 1 | 25 | 30.85% | 31.94% | 31.96% | 1.01倍 |
| 1 | 100 | 30.85% | 31.12% | 31.12% | 0.99倍 |
| 2 | 10 | 15.87% | 17.77% | 18.30% | 1.28倍 |
| 2 | 25 | 15.87% | 16.58% | 16.71% | 1.18倍 |
| 2 | 100 | 15.87% | 16.02% | 16.05% | 1.19倍 |
| 3 | 10 | 6.68% | 8.07% | 9.57% | 2.08倍 |
| 3 | 25 | 6.68% | 7.19% | 7.71% | 2.04倍 |
| 3 | 100 | 6.68% | 6.80% | 6.89% | 1.80倍 |
| 4 | 10 | 2.28% | 3.04% | 4.45% | 2.83倍 |
| 4 | 25 | 2.28% | 2.54% | 3.42% | 4.35倍 |
| 4 | 100 | 2.28% | 2.35% | 2.53% | 3.40倍 |
ベイズ限界は で計算できます( なら )。理論値と実測が整合しています。
結論として、教科書の説明は正しいのですが、差が出る条件が限定的でした。
- (あまり分かれていない)… ほぼ互角(0.99〜1.03倍)
- (よく分かれている)… 線形判別分析が2.8〜4.4倍有利
なぜこうなるかというと、超過誤差の絶対値自体が が大きいと小さくなるので、比では大きく見えても実害は小さいという側面もあります(・ で 2.54% vs 3.42%、差は0.88pt)。一方 では両者とも 31% 台で、差が0.02pt。
実務のデータは 側に寄りがちです(きれいに分かれるなら統計を使うまでもない)。精度差を体感する機会は少ない、というのが実感でした。
違い③:壊れ方が違う
精度が互角なら、壊れ方で選ぶことになります。ここで通説の検証を2つやりました。
検証1:「線形判別分析は外れ値に弱い」は本当か
線形判別分析は平均と共分散を使うので、外れ値に引っ張られると言われます。訓練データにだけ極端な1点を混ぜ、テストデータはきれいなままにして測りました(外れ値をテストにも入れると測定が壊れるので、ここは分けています)。
| 訓練データの外れ値 | 線形判別分析 | ロジスティック回帰 |
|---|---|---|
| なし | 20.39% | 20.52% |
| 群0に | 34.66% | 32.81% |
| 群0に | 53.05% | 53.13% |
| 群0に | 52.43% | 53.07% |
(ベイズ限界は 19.32%。 の設定です)
両者とも崩れました。 20.4% から 53% まで、つまりコイン投げ以下になります。
ただしこの表の読み方には注意が必要です。2群の判別で53%は偶然水準(50%)そのものなので、 以降の行は「両方とも完全に壊れきった」状態を見ているだけで、手法の差を測れる領域ではありません(天井に張り付いている)。差が測れるのは の中程度の外れ値の行だけで、そこではロジスティック回帰のほうが良い(32.81% vs 34.66%)という結果でした。
理屈もこの向きを支持します。ロジスティック回帰の尤度方程式に現れる残差は で、 が0か1、 が0から1の間なので必ず から の範囲に収まります。一方、線形判別分析は平均と共分散という有界でない量を通じて影響を受けるので、外れ値が遠ざかるほど際限なく引っ張られます。
ただしロジスティック回帰が無敵というわけではありません。尤度方程式は で、残差が有界でも掛かる は有界でない(第17回のてこ比です)。だから外れ値が十分遠ざかれば、ロジスティック回帰も結局壊れます。上の表で 以降に両者の差が消えたのは、まさにこれが効いた結果です。
というわけで、正確な結論はこうなります。「線形判別分析だけが外れ値に弱い」という言い方は不正確で、極端な外れ値では両者とも偶然水準まで壊れる。差が見えるのは中程度の外れ値のときで、そこではロジスティック回帰がやや強い。 ただし差は2pt程度で、崩れ方の大きさ(20%→33%)に比べれば小さい。どちらを選ぶかで対処するより、データを見て外れ値を見つけるほうが効くというのが実務的な結論です(第17回の回帰診断法がここに繋がります)。
検証2:完全分離のとき
こちらは明確な差が出ました。2群がきれいに分離しているデータ(重なりがゼロ)で両者を当てはめます。
| 手法 | 結果 |
|---|---|
| ロジスティック回帰 | 係数 、標準誤差が 〜 に発散 |
| 線形判別分析 | 、切片 。普通に有限の値 |
ロジスティック回帰は完全分離だと最尤推定量が存在しません(Albert・Anderson 1984)。尤度を大きくしようとすると係数がいくらでも大きくなれるので、反復計算が発散します。その結果として標準誤差が爆発し、係数の検定が意味をなさなくなります。ここは第18回の Hauck-Donner 効果(係数が大きくなるとワルド検定統計量がかえって小さくなる現象)と同じ機構で、分離に近づくほど顕在化します。
この2つは混同しやすいので分けておきます。完全分離は「推定量が存在しない」問題、Hauck-Donner 効果は「検定の切れ味が非単調に落ちる」問題です。前者が原因、後者がその現れ方という関係になっています。
線形判別分析は平均と共分散を計算するだけなので、この状況でも壊れません。分離が良いほど判別としては望ましい状況なのに、ロジスティック回帰はそこで数値的に不安定になる。これは実用上はっきりした差です。
使い分けの表
まとめます。
| 観点 | 線形判別分析が向く | ロジスティック回帰が向く |
|---|---|---|
| 説明変数の型 | すべて連続で正規に近い | 0/1やカテゴリが混ざる |
| 標本サイズ | 小さい( が変数の数に対して少ない) | 中〜大 |
| 2群の分離 | よく分かれている( が大きい) | 分離が悪くても安定 |
| 完全分離のとき | 壊れない | 係数が発散する |
| 欲しい出力 | 群への割り当て・判別得点 | オッズ比による効果の解釈 |
| 群が3つ以上 | 自然に拡張できる(判別方向が複数) | 多項ロジットが必要 |
| 検定・推論 | 平均ベクトルの差の検定() | 係数ごとのワルド検定・信頼区間 |
実務での判断としては、「係数の意味を説明したい」ならロジスティック回帰です。オッズ比は「この変数が1増えると解約オッズが1.4倍」と報告できます。判別分析の係数 は、そういう直接的な解釈が難しい(前に見た通り符号が直感と逆になることもある)。
逆に「とにかく分類したい・群が3つ以上ある・標本が少ない」なら判別分析です。閉じた式で一発で計算できる軽さも利点です。
なお現代的な実務では、この2つより勾配ブースティングやランダムフォレストのほうが精度が出る場面が多いです。ただし判別分析は「なぜその判定になったか」がマハラノビス距離という明確な量で説明でき、計算が軽く、標本が少なくても動く。解釈と軽さで選ばれる道具という位置づけになります。
実務での使いどころ
スパム判定と解約予測について、実際に測ってみました。
スパム判定:説明変数が0/1ばかりのケース
「特定の単語が出たか」という0/1の変数が20個ある設定です。多変量正規分布からは遠い(0か1しか取らない上に、ほとんどの単語は出現率5%で極端に偏っている)ので、判別分析の前提が崩れています。
| 学習データ数 | 線形判別分析 | ロジスティック回帰 |
|---|---|---|
| 60 | 11.94% | 11.22% |
| 200 | 7.62% | 8.57% |
| 1000 | 5.70% | 5.96% |
意外にも線形判別分析が壊滅しませんでした。 以上ではむしろ勝っています。前提が0/1データで明らかに崩れているのに、実用的な精度が出る。
理由を考えると、線形判別分析が実際に使うのは平均ベクトルと共分散行列だけです。正規分布を仮定したのは「その2つだけで話が済む」ことの根拠づけであって、計算に入るのは平均と共分散のみ。データが正規でなくても、群の中心と散らばりに情報があれば機能するわけです。
これは「前提が崩れたら使えない」という素朴な理解を修正する必要があった点です。前提は「最適性の保証」のためにあり、「動作の条件」ではない。 ただし極端な偏りがある場合や、共分散行列が特異になる場合(同じ列が2つある等)は計算自体が破綻するので、注意は必要です。実際のスパムフィルタでは単語数が数千になるので、 になって共分散行列の逆行列が計算できません。そこは正則化や次元削減が必要になります。
解約予測:連続変数で正規に近いケース
利用日数と課金額のような連続変数で、判別分析の前提に近い設定です。
| 学習データ数 | 線形判別分析 | ロジスティック回帰 |
|---|---|---|
| 30 | 32.03% | 32.10% |
| 60 | 31.21% | 31.23% |
| 200 | 30.58% | 30.58% |
| 1000 | 30.34% | 30.34% |
ほぼ完全に同じでした。この設定は 、ベイズ限界が 30.33% なので、 の実測 30.34% はほぼ限界に達しています。前節の表の の行(比 0.99〜1.03倍)と整合する結果です。
実務的な結論としては、こうなります。
- 精度で選ぶ場面はほとんどない。 差が出るのは「よく分かれている×標本が少ない」という狭い条件
- 解約予測では、判定より「誰から順に手を打つか」が重要。 判別得点や事後確率を大きい順に並べて上位から対応する、という使い方になる。この点はロジスティック回帰の予測確率と同じ運用
- 事前確率と誤判別コストの調整が、手法選択よりずっと効く。 解約率が5%なら、事前確率を入れないと全員「継続」と判定するルールができあがる(それで95%的中する)。見逃しコストを入れて境界を動かすことが本質
- どちらを使うにせよ、誤判別率は交差確認法で測る。 ここを外すと何をやっても意味がない
最後の点が今回いちばん実務的な学びでした。手法の選択より、測り方を間違えないことのほうが影響が大きいです。
サポートベクターマシン:同じ問題を別の基準で解く
版によっては第23章にサポートベクターマシン(SVM)が含まれます。準1級では用語と考え方までで十分なので、考え方だけ図で見ます。
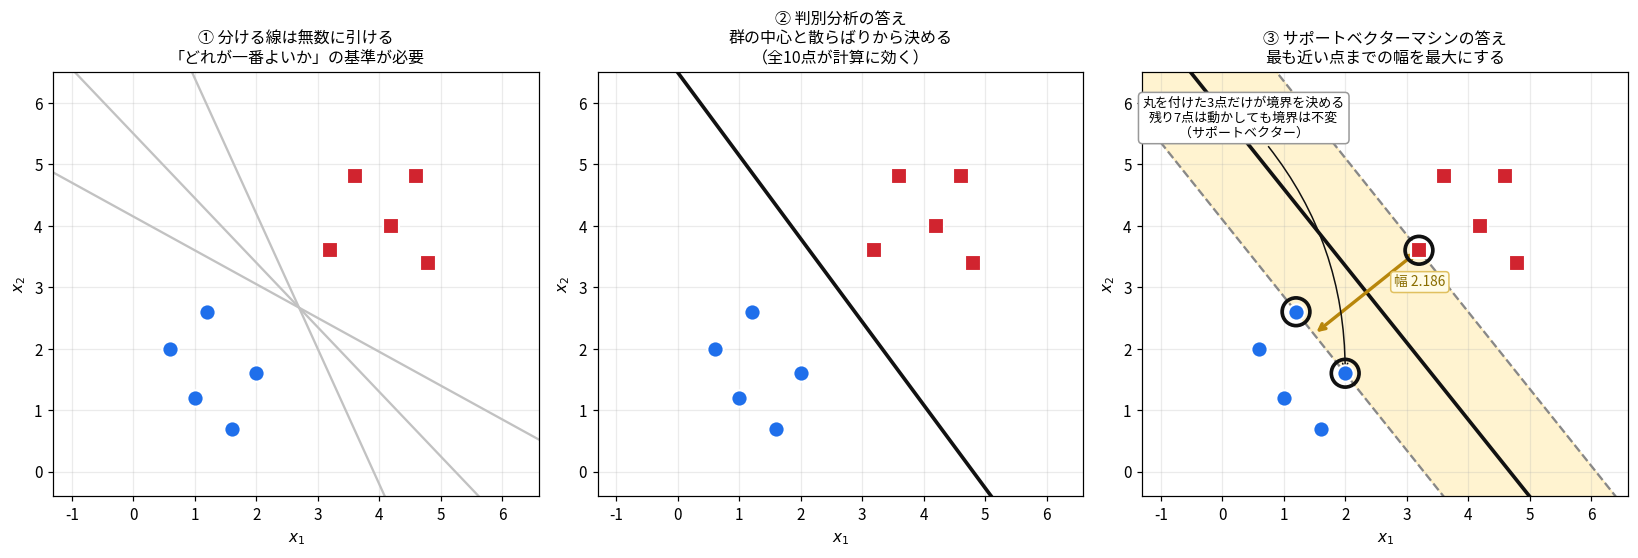
左: 10点を分ける直線は無数に引けます。「どれが一番よいか」の基準が必要です。判別分析は「群間÷群内を最大に」という基準を持ち込みました。SVMは別の基準を持ち込みます。
中央: 判別分析の答え。群の平均と共分散から計算するので、10点すべてが計算に効きます。 境界から遠い点も平均の計算に入ります。
右: SVMの答え。境界から最も近い点までの幅(マージン)を最大にします。 黄色い帯がマージンで、その幅は 2.186。丸を付けた3点がサポートベクターです。
決定的な違いはここです。この3点以外の7点は、どこに動かしても境界が変わりません。 境界の近くにいる少数の点だけで境界が決まります。
| 判別分析 | サポートベクターマシン | |
|---|---|---|
| 何を見るか | 群の中心と散らばり(全点が効く) | 群の境目(サポートベクターだけが効く) |
| 基準 | 群間÷群内の最大化 | マージンの最大化 |
| 確率を出せるか | 出せる(事後確率) | 素では出せない(後処理が必要) |
| 非線形化 | 2次判別・変数変換 | カーネル法(高次元に写して線形に分ける) |
| 外れ値 | 平均に効くので影響する | 境界から遠い外れ値は完全に無視される |
「群の中心を見るか、群の境目を見るか」という対比で覚えられます。外れ値が群の内側の奥にあるとき、SVMはそれを無視しますが判別分析は平均が動きます。逆に外れ値が境界付近にあると、SVMはそれをサポートベクターにしてしまうので、そこはソフトマージン(多少の誤分類を許す)で対処します。
カーネル法は「元の空間では直線で分けられないデータを、高次元に写してから直線で分ける」という発想です。2次判別が「境界を曲げる」のに対し、カーネル法は「空間を曲げて境界は直線のまま」と考えます。目指すものは近いのですが、道具立てが違います。
速度は判別分析が圧勝する
ここは私が誤解していた点です。「サポートベクターマシンは3点だけで境界が決まる」と知っていたので、使う点が少ないから速いのだろうと思っていました。逆でした。
「どの点が効くのか」を突き止めるために最適化問題を解く必要があるのが重さの原因です。結果として少数の点しか残らないだけで、全点を見て探索しています。実測すると差は極端でした。
| 合計 | 判別分析 | サポートベクターマシン | 比 |
|---|---|---|---|
| 100 | 0.066ms | 3.8ms | 57倍 |
| 200 | 0.071ms | 15.9ms | 224倍 |
| 400 | 0.080ms | 42.3ms | 527倍 |
| 800 | 0.106ms | 184.3ms | 1743倍 |
判別分析は を8倍にしてもほぼ横一線です(図の左パネルでは から16倍の800まで伸ばしていますが、0.065ms から 0.102ms しか増えていません)。計算量を分解すると理由が分かります。
については1次、 については3乗( が2倍で逆行列の時間は約8倍。実測でも : 100→200 で 0.101ms→0.841ms でした)。一方サポートベクターマシンは のカーネル行列を作って二次計画問題を解くので 〜 です。
では、なぜ機械学習ではサポートベクターマシンが選ばれたのか
上の表は に固定して だけ動かした、判別分析に最も有利な条件でした。 を動かすと話が変わります。
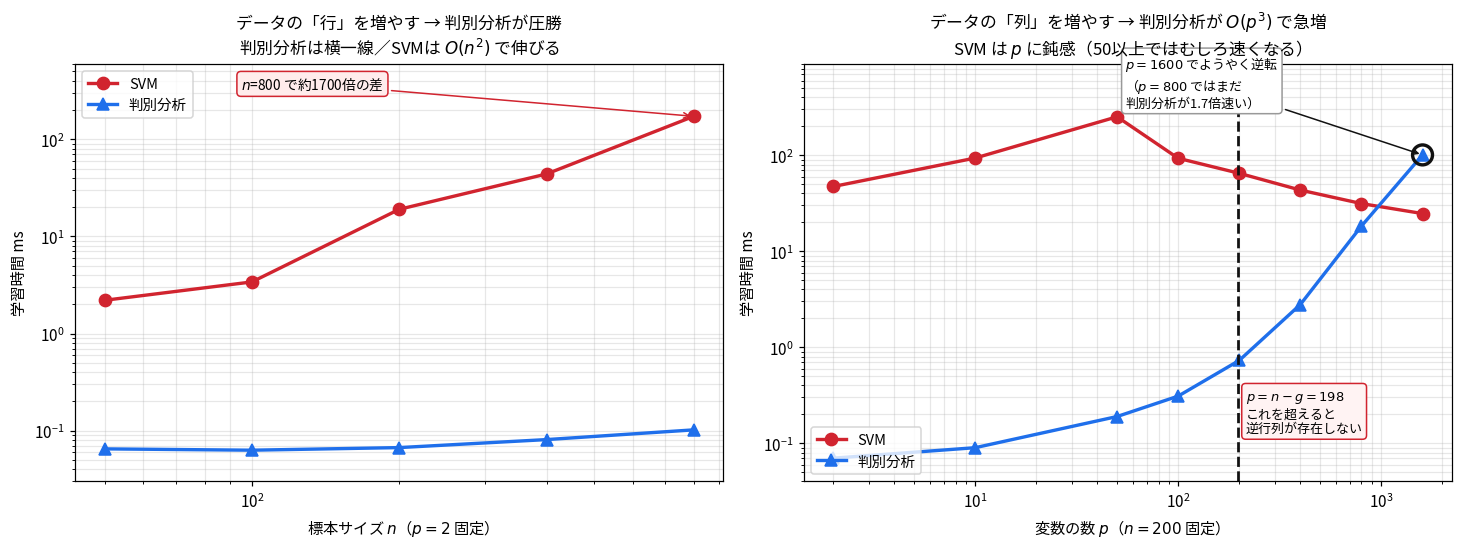
右の図が本題です。 を増やすと判別分析が で立ち上がります。 ではまだ判別分析が1.7倍速いのですが(18.3ms 対 31.4ms)、 で逆転します(100.9ms 対 24.7ms)。しかもサポートベクターマシンは が50を超えるとむしろ速くなっています(高次元だと分離しやすく、最適化の収束が早いため)。
ただし速度は本質ではありませんでした。決定的なのは で計算できなくなることです。
プールした共分散行列 は ですが、そのランクは高々 です( 個の独立な偏差ベクトルから作るため)。 だとランクが足りず 、つまり逆行列が存在しません。 を使う判別分析は、ここで原理的に止まります。0で割るのと同じです。
実測で確認すると、(群内自由度48)のとき では のランクが48しかなく、行列式が 、条件数が で完全に破綻していました。
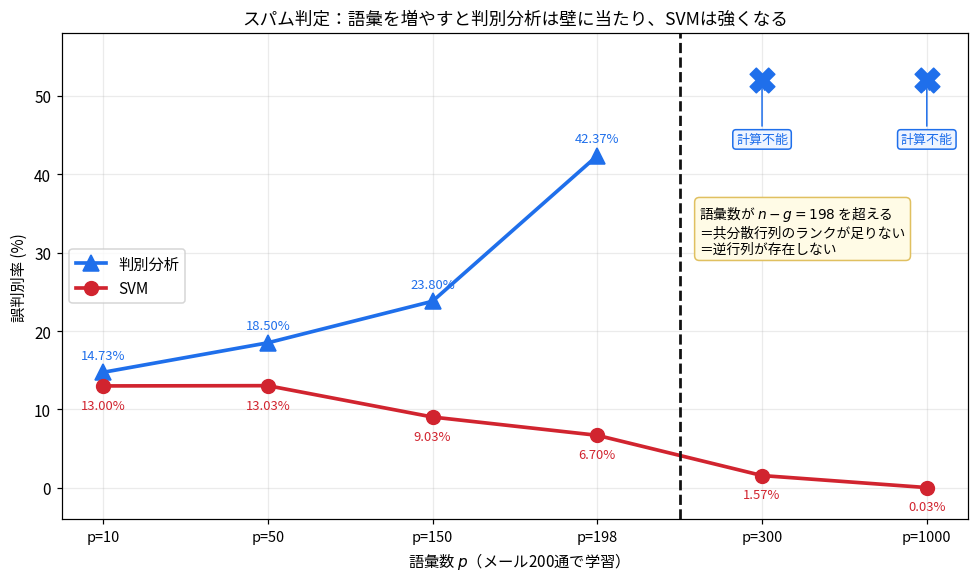
スパム判定で実験すると、この壁が現実の問題として現れます。メール200通()で学習した場合です。
| 語彙数 | 判別分析 | サポートベクターマシン |
|---|---|---|
| 150 | 23.80% | 9.03% |
| 198() | 42.37% | 6.70% |
| 300 | 計算不能 | 1.57% |
| 1000 | 計算不能 | 0.03% |
判別分析は語彙を増やすほど悪化して壁に当たり、サポートベクターマシンは語彙を増やすほど強くなります。 実際のスパムフィルタの語彙は数千〜数万語なので、この壁は必ず来ます。
サポートベクターマシンが に強い理由は、解く問題に という内積の形でしか が現れないことです。だから作る行列は常に で、 が5000になってもサイズが変わりません(実測では を500倍にしても速度が落ちませんでした)。「 を に置き換える」のがカーネル法の効能で、境界を曲げられるのと同じ仕組みの別の側面です。
境界の形の自由度という軸
もうひとつ、精度で決定的に差がつく場面があります。境界が曲がっているときです。
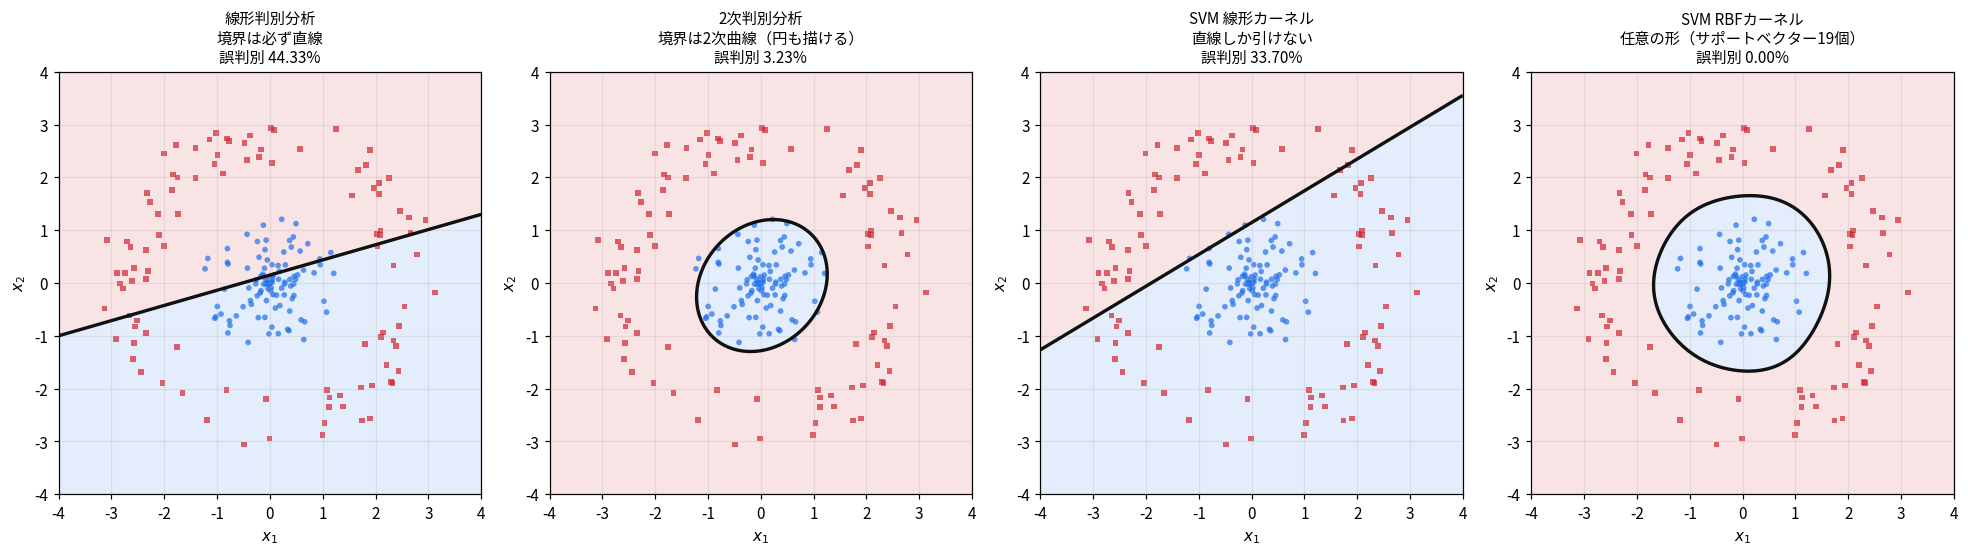
内側の円と外側のリングという、直線では原理的に分けられないデータです。
| 手法 | 誤判別率 | 境界の形 |
|---|---|---|
| 線形判別分析 | 44.33% | 直線のみ |
| サポートベクターマシン(線形カーネル) | 33.70% | 直線のみ |
| 2次判別分析 | 3.23% | 2次曲線 |
| サポートベクターマシン(RBFカーネル) | 0.00% | ほぼ任意の形 |
判別分析の境界は直線か2次曲線までです(正規分布を仮定した結果としてその形にしかならない)。サポートベクターマシンはカーネルを差し替えることで形の制約を事実上外せます。機械学習でサポートベクターマシンが使われたのは、この「データの形を仮定せずに複雑な境界を引ける」点が評価されたからでした。
ただし自由度には代償がある
同じデータ・同じ手法で、(誤分類をどれだけ許すか)と (RBFカーネルの幅)の選び方だけで誤判別率が 0.0% から 50.0%(=偶然水準、完全に無意味) まで動きました。実務では交差確認法で総当たりしてから選ぶので、実質的な計算コストは上の表よりさらに大きくなります。
一方判別分析には調整するパラメータがありません。データを入れれば答えが1つ出ます。融通が利かないとも読めますが、選ぶ人間の判断が入り込まないという利点でもあります。
使い分けの整理
判断の順序としてはこうなります。
- 境界が曲がっているか → 曲がっていればサポートベクターマシン(RBF)か2次判別
- と の比 → が小さければ判別分析、 が に近い/超えるならサポートベクターマシンかリッジ判別分析
- が巨大(数百万) → サポートベクターマシンは で現実的でないので判別分析側に戻る
2番目に補足があります。 でも、 の逆行列をとるリッジ判別分析なら動きます。・ のスパムデータで測ると、リッジ判別分析()が 0.00%、サポートベクターマシンも 0.00% で並びました。「 が大きいと判別分析は使えない」のは素の判別分析の話で、正則化すれば判別分析系のまま戦えます。ただし という調整パラメータが増えるので、上で挙げた「調整不要」という長所は手放すことになります。
最後にひとつ注意点です。どちらの手法も変数を選んではくれません。 効く変数5本に無関係なノイズ列を足していく実験をしたところ、サポートベクターマシンも判別分析と同程度に悪化しました(11.94% → 30.06%)。サポートベクターマシンが得意なのは「意味のある列が大量にある」場合(スパムの語彙のように1本1本は弱いが全部に情報がある)で、「意味のない列が大量にある」場合には強くありません。効く列を選ぶ作業は、手法の選択では代替できないわけです。
なお、サポートベクターマシンは現在では第一選択ではなくなりました。 が現代のデータ量( が数百万)に耐えられないためで、2010年代以降はニューラルネットと勾配ブースティングが主流です。サポートベクターマシンの黄金期は「 は大きいが は数千〜数万」という2000年代のデータ規模とよく噛み合っていた時期でした。
試験対策として
準1級で問われそうな形を整理します。
計算問題の型
① 線形判別関数を作る
と切片を計算し、新しい個体を判定する。手順は決まっています。
- 群ごとの平均ベクトルを出す
- 群ごとの偏差平方和積和行列を足して を作り、 で割って を得る
- を計算する(2×2なら )
- 切片は中点で0になるように
注意点: を作るときの割る数は です( ではありません)。群の数を引きます。10人・2群なら8で割る。
② マハラノビス距離を計算する
を素直に計算する。 なら手で展開したほうが速いこともあります。
ここで です。分母が行列式、 と が入れ替わって掛かる点に注意します(逆行列の形から来ています)。
③ 事前確率つきの境界を出す
を切片に足す。符号を間違えやすいので、「割合の多い群のほうに広く割り当てられる」という向きで検算します。有病率1%なら、健常と判定される領域が広がる(境界が病気側に動く)。
④ 誤判別率を表から読む
分割表(混同行列)から見かけの誤判別率を出す。 です。交差確認法との違いを説明できるようにしておく。
⑤ 2群の判別確率(理論値)
2群が 、 で事前確率が等しいとき、理論上の誤判別率は
です( は2群間のマハラノビス距離)。 なら 、 なら 。この式は出題されやすいので、 の で割る部分を落とさないようにします。
用語の対比で問われそうな組
判別分析と主成分分析(前回との対比)
| 主成分分析 | 判別分析 | |
|---|---|---|
| 群のラベル | 使わない(教師なし) | 使う(教師あり) |
| 探す方向 | 全体のばらつきが最大 | 群間÷群内が最大 |
| 固有値問題 | の固有値分解 | の固有値分解 |
| 目的 | 次元を落として要約する | グループ分けのルールを作る |
どちらも「良い方向を探す」ので混同しやすいのですが、ラベルを使うかどうかで区別できます。
線形判別と2次判別
| 線形判別 | 2次判別 | |
|---|---|---|
| 共分散行列 | 群で共通と仮定 | 群ごとに推定 |
| 境界の形 | 直線(超平面) | 2次曲線(超曲面)。退化して平行2直線になることもある |
| の項 | 消える(共通なので) | 残る |
| 必要な標本 | 少なくて済む | 群ごとに 個の推定が必要 |
| 等確率楕円の関係 | 全群が合同(平行移動で重なる) | 形・大きさ・傾きが違ってよい |
| のとき | 判別不能( になる) | 分散の違いで判別できる |
3つの誤判別率
見かけ(楽観的に偏る)/ホールドアウト(偏らないがデータを使い切れない)/交差確認(偏らずデータを活かすが計算量)。この3つの長短を言えるようにしておきます。
引っかかりやすい点
- の分母は 。 群の数を引く
- マハラノビス距離は「小さいほう」に割り当てる。 大きいほうではない
- ではなく が誤判別率の引数
- 事前確率とコストは切片だけを動かす。 傾きは変わらない
- 見かけの誤判別率は「平均的に」真の値より小さい。 個々の標本で必ずそうなるとは限らない(期待値についての下向きバイアス)
- 判別関数の係数の符号は、単変量の平均の大小と一致しないことがある(偏回帰係数と同じ)
- Wilks の は小さいほうがよい。 決定係数と向きが逆
- 「2次判別の境界は必ず曲線」ではない。 2次の項の固有値に0が混じると平行2直線になる。「2次式で表される図形」であって必ず曲がるわけではない
- 共通の共分散行列は「平均も同じ」という仮定ではない。 平均は違ってよく、ばらつき方だけが共通
- 平均が同じでも分散が違えば2次判別で分けられる。 線形判別だと で判別不能になる
- だと共分散行列の逆行列が存在しない。 ランクが足りないため。正則化すれば回避できる
自分が間違えていたこと
① フィッシャーの判別とF値の関係を「似ている」で止めていた
「群間÷群内という形が分散分析と似ている」とは思っていましたが、定数倍で厳密に一致するとまでは思っていませんでした。 が方向によらない定数だから最大化の答えが変わらない、という一行が理解の核でした。似ているのではなく、同じ量を違う目的で使っていました。
② ユークリッド距離でも「だいたい合う」と思っていた
散らばりを無視しても大きくは外れないだろうと考えていました。実際は10人のうち2人(20%)を誤判別しました。相関が強いほど差が開き、この記事の設定では同じユークリッド距離の2点でマハラノビス距離が3.51倍違いました。相関が強いデータでは、距離の定義の選択が結果を左右します。
③ 「総誤判別率を最小にすれば良い判別」だと思っていた
事前確率を入れると総誤判別率が 6.68% → 0.63% に改善したので、これで良くなったと書きかけました。よく見ると感度が93.32%から48.74%に落ちていました。 病気の人の半分を見逃しています。総誤判別率の最小化は多数派を優先するので、少数派の見逃しが増える。目的関数が実務の目的と一致しているかを毎回確認する必要があるという教訓でした。誤判別コストが教科書に載っている理由がここで分かりました。
④ 「2次のほうが柔軟だから常に良い」と思っていた
実測すると、等分散が真のときは各群 で2.27pt悪化しました。ただしそれ以上に重要だったのは非対称性です。「無駄に複雑」は標本を増やせば直るのに、「間違ったモデル」は標本を1000倍にしても直らない(21.97%のまま)。この非対称性を見るまでは、単に「2次は過学習しやすい」という浅い理解でした。
⑤ 「線形判別分析は外れ値に弱い」を検証せずに書こうとしていた
通説として知っていたので、そのまま書こうとしました。実際に測ったらロジスティック回帰も崩れました(20.4% → 53%)。片方だけが弱いという書き方は不正確でした。
さらに、この実験の読み方でもう一段間違えました。最初は「極端な外れ値でも両者が53%で同じだから差はない」と結論しかけたのですが、2値判別の53%は偶然水準(50%)そのもので、そこは差を測れない領域です。両方が壊れきった天井に張り付いているだけでした。差が測れる中程度の外れ値の行を見ると、ロジスティック回帰のほうが2pt良い。理屈でも、ロジスティック回帰の残差 は に有界なのに対し、線形判別分析は平均と共分散という有界でない量を通すので、通説の向き自体は正しかったわけです。
「測れない領域の数値を根拠に差がないと結論する」のは、⑧で自分が反省したことと同じ型の誤りでした。値が天井や床に張り付いていないかを先に確認する必要があります。
⑥ 誤判別コストの符号を逆に間違えた
これは査読で見つかった、この記事でいちばん恥ずかしい誤りです。「解約の見逃しを5倍重く見る」場合に を足すと書いていました。正しくは です。
原因は の添字の向きを取り違えたことです。「解約の見逃し」は真が解約(群2)なのに継続(群1)と判定することなので 、つまり分母にあたります。分子と分母を逆にしたので、切片が反対方向に動きました。
しかも、その誤った数値で図まで描いていました。図では「解約の見逃しを重く見る」線が「解約が8割」の線と反対側に出ていて、2本が逆方向に開いていました。同じ「解約側に寄せる」意味の2つの調整が反対方向を向いていたら、それは誤りのサインだったのに気づけませんでした。
対策として、記事に検算のルールを書き足しました。符号を計算で決めず、意味で検算する。 「見逃しを重く見る=そちらと判定されやすくする=その領域が広がる」という向きを先に決めて、切片がどちらに動くべきかを確認する。 の中身の順序を暗記するより確実です。
⑦ 前提が崩れたら使えないと思っていた
スパム判定風の0/1データ(多次元正規から明らかに外れている)で線形判別分析が壊滅すると予想したのですが、実用的な精度が出ました。線形判別分析が実際に使うのは平均と共分散だけで、正規分布の仮定は「その2つで最適になる」ことの根拠づけでした。前提は最適性の保証であって動作条件ではない、という区別ができていませんでした。
⑧ 効率性の差が出る条件を確かめずに一般化しかけた
最初の実験で差が0.13ptしか出なかったので「実質的に差はない」と結論しかけました。条件(2群の隔たり )を振ったら、 では2.8〜4.4倍の差が出ました。「差がない」という結論は、差が出る条件を探したうえででないと言えません。 自分が選んだ1つの設定で一般化するところでした。
⑨ サポートベクターマシンのほうが速いと思っていた
「サポートベクターマシンは3点だけで境界が決まる」と知っていたので、使う点が少ないから速いのだろうと考えていました。逆でした。 で判別分析のほうが1743倍速いという結果です。
「どの点が効くのか」を突き止めるための最適化が重さの原因で、少数の点しか残らないのは計算し終わった後の結果でした。「結果として使う量」と「計算に要する量」を混同していたわけです。
さらに、この比較自体が判別分析に有利な条件( 固定)だったことにも後から気づきました。 を動かすと で逆転し、 では判別分析が計算不能になります。「どちらが速いか」は測る軸( か か)で答えが変わるという、比較の設計そのものへの反省でした。
⑩ 前向き選択が最良の変数組を選ぶと思っていた
Wilks の で前向き選択したら、1番目に選ばれたのが ( とほぼ同じ情報を持つ変数)でした。単独の成績が良かったからです。しかし と は相関0.95なので両方入れる意味がありません。貪欲法は組み合わせとしての最良を保証しないという、第16回の多重共線性の話がここでも効いていました。
要点まとめ
| 問い | 答え |
|---|---|
| 判別分析は何のための道具か | 群が分かっているデータからグループ分けのルールを作る。1変数では分けられないものを、変数の組み合わせで分ける |
| 線形判別関数の重み | 。 はプールした共分散行列(分母は ) |
| 係数の符号が直感と逆になる理由 | 他の変数を固定したときの効き方を表すから。第16回の偏回帰係数と同じ構造 |
| フィッシャーが最大化しているもの | 射影後の群間平方和÷群内平方和。 |
| それは分散分析のF値と同じか | 同じ。 で、 は方向によらない定数。最大化の答えが一致(小数10桁で確認) |
| 第20回との関係 | 同じ量を、第20回は検定するために読み、今回は最大化して方向を探す。態度が違う |
| なぜマハラノビス距離か | ユークリッド距離は散らばりの向きを無視する。同じ距離2.50の2点でマハラノビス距離が1.84と6.45(3.51倍)に分かれる |
| 3.51倍の出どころ | 固有値の比 。主軸方向に限れば「その方向の標準偏差いくつ分」。厳密には で等方化してからのユークリッド距離 |
| ユークリッドだと本当に間違えるか | 10人の例で2人を誤判別(マハラノビスは0人)。距離の定義だけで結果が変わる |
| なぜ「線形」判別なのか | 共通の共分散行列を使うと、距離の差の の項が両群で同じ形なので消える。1次式が残るから境界が直線 |
| 共通の共分散行列とは何の仮定か | 群の等確率楕円が合同(平行移動だけで重なる)。平均は違ってよく、ばらつき方だけが共通 |
| 実務で成り立ちやすいのは | 同じ母集団を条件で切った群(男女・地域)。崩れやすいのは階層や規模が違う群(新人と役員) |
| 崩れ方と境界の形 | 2次の項 の固有値の符号で決まる。両方0=直線/同符号=楕円/異符号=双曲線/片方0=放物線・平行2直線 |
| 1次元で「2次」とは何が起きるか | 群0の領域が区間になり群1が左右に分断される()。1本の線では表せない |
| 平均が同じでも判別できるか | 2次判別ならできる(分散の違いで分ける)。線形判別は で判別不能 |
| 多群への拡張 | 判別分析は元から対応(各群のスコアの最大を選ぶ)。判別方向は 本。 の多群検定は多変量分散分析と同じ枠組み |
| SVMの多群化 | 2群専用なので1対1(個・多数決)か1対他(個・スコア最大)。1対1はじゃんけん状態0.12%、1対他は全員否定1.79%が発生 |
| SVMと判別分析の速度 | 判別分析が圧勝( で1743倍)。 対 。「3点だけで決まる」のは計算後の結果で、探索には全点を使う |
| を増やすとどうなるか | 判別分析は で重くなり で逆転( ではまだ1.7倍速い)。 では逆行列が存在せず計算不能(スパム判定で語彙198語が限界) |
| なぜ機械学習でSVMが使われたか | カーネル法は を に置き換える(行列は常に )。加えて境界の形の自由度(同心円で44%対0%) |
| でも判別分析を使うには | リッジ判別分析( の逆行列)。 でSVMと同じ0.00%。ただし の調整が増える |
| 無関係な列を足すとどうなるか | SVMも同程度に悪化(11.94%→30.06%)。効く列を選ぶ作業は手法の選択では代替できない |
| 事前確率はベイズの定理と同じか | 同じ。 対数を取ると が切片への足し算になる |
| 事前確率とコストは何を動かすか | 切片だけ。 傾き は不変( が3設定で完全に同一) |
| 有病率1%での効果 | 境界が 1.5 → 3.03 に動き、陽性的中率 12.36% → 80.19%。ただし感度は93.32%→48.74%に落ちる |
| 総誤判別率の最小化の落とし穴 | 多数派を優先するので少数派の見逃しが増える。だから誤判別コストが必要 |
| 見かけの誤判別率はどれくらい嘘か | 判別不可能なデータ(真の値50%)で、・ のとき0.24%。「99.8%的中」と報告してしまう |
| なぜそうなるか | 20人に対し共分散行列だけで171個のパラメータ。偶然の凹凸を暗記している |
| 交差確認法は正しく測れたか | LOOもホールドアウトも全条件で50%前後を返した(LOOは 50.60〜52.17% とわずかに悲観側) |
| 2次判別は常に良いか | いいえ。等分散が真なら で +2.27pt悪化。ただし では +0.01pt に消える |
| 線形判別の限界 | 分散が本当に違うとき、標本を1000倍にしても改善しない(21.97%のまま。2次は14.08%) |
| 判断基準 | 間違ったモデルは標本で直らない/無駄に複雑なモデルは標本で直る。 2次判別には群ごとに 個の推定ができる標本が必要 |
| Wilks の | 。小さいほうがよい( と同じ形)。1に近いと分かれていない |
| と の関係 | 。2群なら厳密に対応(小数10桁で確認) |
| 不要な変数を足すと | はわずかに下がるがF値は下がる(80.733 → 60.100)。自由度を損する |
| LDAとロジスティック回帰の本質的な違い | の分布までモデル化するか(生成モデル)/境界だけモデル化するか(識別モデル) |
| 正規・等分散を仮定すると | ロジスティック回帰と同じ形の関数が導出される。違うのは係数の推定方法 |
| 精度の差は出るか | ではほぼ互角(0.99〜1.03倍)。 では線形判別分析が2.8〜4.4倍有利。差が出る条件は限定的 |
| 外れ値への強さ | 両者とも崩れた(20.4%→53%)。極端な外れ値では偶然水準(50%)に張り付いて差が測れない。差が見える中程度の外れ値ではロジスティック回帰が2pt良い(残差が有界だから) |
| 完全分離のとき | ロジスティック回帰は最尤推定量が存在せず係数が発散(Albert・Anderson)。標準誤差の爆発を通じてHauck-Donner効果が顕在化。LDAは有限の値を返す |
| 前提が崩れたら使えないか | いいえ。0/1データでも実用精度が出た。LDAが使うのは平均と共分散だけで、正規性は最適性の根拠 |
| 実務での選び方 | 係数を説明したいならロジスティック回帰(オッズ比)。分類したい・群が3つ以上・標本が少ないなら判別分析 |
| 実務で最も効くこと | 手法選択より事前確率とコストの調整、そして誤判別率を交差確認法で測ること |
| サポートベクターマシンとの違い | 判別分析は群の中心(全点が効く)、SVMは群の境目(サポートベクターだけが効く。10点中3点) |
次回
次回は第24章、クラスター分析です。今回との対比がそのまま入り口になります。
今回の判別分析は群のラベルが分かっているデータからルールを作りました。クラスター分析はラベルがないデータから群そのものを見つけます。教師ありと教師なしの違いです。前回の主成分分析(ラベルを使わない)と今回(ラベルを使う)に続いて、この軸がもう一度出てきます。
ただし「ラベルが1列なくなるだけ」ではありません。今回の記事でいちばん怖かったのは、見かけの誤判別率が0.24%まで下がる話でした。あれができたのは、正解ラベルがあったから「間違っている」と分かったからです。ラベルがなくなると、そもそも採点ができなくなります。 交差確認法という命綱が使えない世界に入るわけで、そこがクラスター分析のいちばん厄介なところになります。
そして今回の「距離の測り方で結果が変わる」という話が、さらに大きく効きます。マハラノビス距離とユークリッド距離の選択に加えて、群と群の距離をどう定義するか(最短距離法・ウォード法など)という選択肢が増えるからです。今回2人の誤判別で済んだ距離の定義の問題が、クラスター分析では「まったく違う分類結果が出る」規模で現れます。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。