密度が計算できてもサンプリングできない:MCMCを自作した記録【番外編】
はじめに
第33回でベイズ法を扱ったとき、MCMC(Markov Chain Monte Carlo=マルコフ連鎖モンテカルロ法)の考え方を追いました。ただ、あのときはアルゴリズムを読んだだけでした。
そこで練習用のプロジェクトを作り、メトロポリス法の中核だけを自分で書くという課題をやりました。目標分布・診断図・簡易チェックは用意済みで、自分が書くのは受理判定のループだけ、という形です。
書き終えて分かったのは、自分がいちばん誤解していたのはアルゴリズムではなく「MCMCが何のための道具か」だったということです。とくに次の2つを混同していました。
- 確率密度を点ごとに計算できること
- その分布から標本を生成できること
この2つはまったく別です。そして、この区別が付いていなかったので「解析的に解ける正規分布に、なぜわざわざMCMCを使うのか」がずっと引っかかっていました。
なお用語について1つ。第33回では「受容」「受容率」と書きましたが、この記事では実装のコードに合わせて「受理」「受理率」で統一します。同じものです。
この記事は、その引っかかりを実装と数値で解いた記録です。ベイズの理屈やギブスサンプリング、 による収束判定は第33回、逆関数法・棄却法・重点サンプリングそのものは第34回で扱ったので、ここでは重複を避けて「使い分け」に絞ります。
結論を先に3つ
① MCMCは確率密度関数を発見する方法ではありません。 目標分布に従う、互いに相関のある標本を生成する方法です。密度の式は最初から手元にあります(なければMCMCも動きません)。
② 目標分布から独立な標本を直接生成できるなら、通常は直接モンテカルロのほうが簡単で効率的です。 後で数値を出しますが、同じ標本数でも実質の情報量が20分の1近く違いました。
③ MCMCの利点は、正規化定数が分からなくても、正規化前の密度の相対値を評価できれば使えることです。 ベイズの事後分布がまさにその形をしています。(ただしこの性質自体はMCMC固有ではありません。後で触れます。)
以下、この3点を実装と数値で確かめていきます。
この記事で扱う用語
| 用語 | 意味 |
|---|---|
| 目標分布 | 標本を得たい分布。この記事では正規分布と、ロジスティック回帰の事後分布 |
| 正規化定数 | 密度の積分を1にするための割り算の定数。多次元では多重積分になる |
| 正規化前の密度 | で割る前の値。 に比例する量。相対値だけが分かる |
| エネルギー関数 | と書いたときの 。 |
| 提案分布 | 次の候補をどこから引くかを決める分布。目標分布とは別物 |
| ランダムウォーク・メトロポリス法 | 提案分布に「現在位置を中心とする正規分布」を使う MCMC |
| 受理比 | 候補を採るかどうかを決める比。(対称提案のとき。一般形は本文で述べます) |
| burn-in | チェーンの最初のほうを捨てる区間。初期値の影響を落とすため |
| 自己相関 | 標本が何歩前の自分と似ているか。MCMC標本は独立ではない |
| ESS(Effective Sample Size=有効サンプルサイズ) | 相関を考慮した「実質の標本数」 |
| ランニング平均 | 先頭から 個までの平均を の関数として描いたもの |
| 受理率 | 候補が採用された割合。高ければ良いというものではない |
密度を評価できることと、サンプリングできることは別
まず、この記事の出発点になった混同をはっきりさせます。
「密度を評価できる」とは、 を1つ渡せば (または正規化前の値)を計算して返せる、ということです。 関数に代入するだけなので、式が書けていれば必ずできます。
「サンプリングできる」とは、その分布に従う値を1つ生成できる、ということです。 これは代入では作れません。乱数の生成器が必要です。
| 密度を評価する | サンプリングする | |
|---|---|---|
| 入力 | (知りたい点) | 一様乱数 |
| 出力 | 数値 | 分布に従う値 |
| 難しさ | 式に代入するだけ | 分布ごとに専用の仕掛けが必要 |
| ベイズの事後分布では | できる(尤度 × 事前分布) | 一般にできない |
ベイズの事後分布は、この表の右下に落ちます。 尤度と事前分布を掛ければ任意のパラメータ値での「もっともらしさ」は計算できます。しかし「事後分布から1個引く」ための専用の乱数生成器は、一般には存在しません。
MCMCはこの穴を埋める道具です。評価はできるがサンプリングできない分布から、標本を作る。
通常のモンテカルロ法・重点サンプリング・MCMCの違い
3つを並べて整理します。重点サンプリングはMCMCの一種ではありません。 別系統の手法です。
| ① 通常のモンテカルロ法 | ② 重点サンプリング | ③ MCMC | |
|---|---|---|---|
| 標本をどこから生成するか | 目標分布そのものから | 自分で選んだ提案分布から | 提案分布で候補を作り、受理判定を通したものを鎖としてつなぐ |
| 標本は独立か | 独立 | 独立 | 独立でない(前の値と相関する) |
| 標本ごとの重みがあるか | ない | ある() | ない(重みなしだが相関あり) |
| 必要な情報 | 目標分布からの乱数生成器 | 正規化前の と の値、提案分布からの生成器 | 正規化前の の値、提案分布からの生成器 |
| 正規化定数 | 生成器の中で解決済み | 自己正規化すれば不要 | 不要 |
| 得意な問題 | 直接引ける分布 | 提案分布が目標に近く、まれな事象を狙うとき | 直接引けず、次元が高いとき |
| 主な失敗要因 | 生成器が作れない | 重みが1個のサンプルに集中する(次元が上がると起きる) | 混ざりが遅い、鎖が動かない、収束前に打ち切る |
の行に注意が必要です。「正規化定数が不要」はMCMC固有の性質ではありません。 自己正規化した重点サンプリング(重みを合計1に直す形)も を必要としません。だから両者の本当の分かれ目は ではなく、重みが壊れるかどうかでした。
同じ推定対象を3手法で
目標分布を とし、(真値 2.0)を推定します。標本数はすべて 9000 に揃えました。
| 手法 | 推定値 | 実質の標本数 | 標準誤差 |
|---|---|---|---|
| ① 直接モンテカルロ(目標分布から独立に生成) | 1.9725 | 9000(= ) | 0.0157 |
| ② 自己正規化重点サンプリング(提案 ) | 1.9713 | 4571( の 50.8%) | 0.0222(近似) |
| ③ MCMC(自作のランダムウォーク・メトロポリス法、提案幅 1.0) | 2.0490 | 526( の 5.8%) | 0.0691 |
②の標準誤差は自己正規化のため近似値です。中身は「重み付き分散 ÷ 重みのESS」の平方根で、デルタ法の簡略形にあたります。①③は通常の標準誤差です。
この1次元の問題では ① が圧勝です。 同じ9000標本でも、実質の情報量が 9000 対 4571 対 526。目標分布から直接引けるなら、MCMCを使う理由はありません。
では差はどこで出るのか
同じ形の問題を 次元にします。目標を 、重点サンプリングの提案を とすると、重みは各座標の比の積になります。
| 次元 | 重みのESS ÷ (重点サンプリング) | 最大の重みが占める割合 | MCMCのESS ÷ |
|---|---|---|---|
| 1 | 0.5169 | 0.0001 | 0.1770 |
| 2 | 0.2661 | 0.0004 | 0.1056 |
| 5 | 0.0359 | 0.0065 | 0.0384 |
| 10 | 0.0019 | 0.1016 | 0.0287 |
| 20 | 0.0006 | 0.1838 | 0.0143 |
| 50 | 0.0001 | 0.7337 | 0.0055 |
(重点サンプリング側の分母は2万、MCMC側は burn-in 2000 を落とした1万8000です。)
では、2万個引いた重みのうち1個が全体の73%を占めます。 残りの 19,999 個を全部合わせても 27% ほどで、重みのESSは実質2個分()しかありません。重点サンプリングは次元とともにこう壊れます。一方MCMCのESS比はゆるやかに下がるだけです。
(MCMCの側は提案幅を で調整しています。表の の値 0.1770(17.70%)が、さきほどの3手法比較で出た 5.8% と違うのは提案幅が 2.4 と 1.0 で違うためです。
なお理論的な目安は で、 なら で約 3.6 になります。ここでは を掛けずに使ったので最適よりやや狭く、17.70% は後で出てくる最良の 22.02% に届いていません。なお2つは鎖の長さが違うので、厳密な比較ではなく目安の比較です。)
これが使い分けの分かれ目でした。 重点サンプリングとMCMCの違いは「 が要るかどうか」ではなく、「重みで補正するか、受理判定で補正するか」の違いで、後者のほうが次元に強い。
なぜ既知の正規分布を教材にするのか
練習用プロジェクトの目標分布はこうなっています。
Target: Normal(mean=2.0, std=1.5)
log_target(x) = -0.5 * ((x - 2.0) / 1.5)^2
正規分布なら直接サンプリングできますし、平均も標準偏差も解析的に分かっています。 つまり実用上、この分布にMCMCを使う必要はまったくありません。
それでも教材にする理由は1つです。答えが分かっているので、実装が正しいかを確かめられる。
実際に、用意されていた簡易チェック(check_sampler.py)は次を検査します。
標本平均:   1.9811(理論値 2.0000)
標本標準偏差: 1.5147(理論値 1.5000)
受理率:     79.9%
OK: 平均
OK: 標準偏差
OK: 受理率
OK: チェーンが動いている

すべての簡易チェックを通過しました。
答えの無い分布で書いたら、この4行が出せません。「正しく動いているか分からないアルゴリズム」を書いてしまうのがいちばん怖いので、最初は答えのある分布で書くというのが教材の意図でした。
、、 の対応
ここで用語を1つ整理しておきます。物理由来の書き方で、目標分布を次の形に書くことがあります。
この をエネルギー関数と呼びます。両辺の対数を取ると、
つまり と置いただけで、特別な仮定は入っていません。正規分布なら
です。 が正規化定数で、 にするための割り算の分母です。
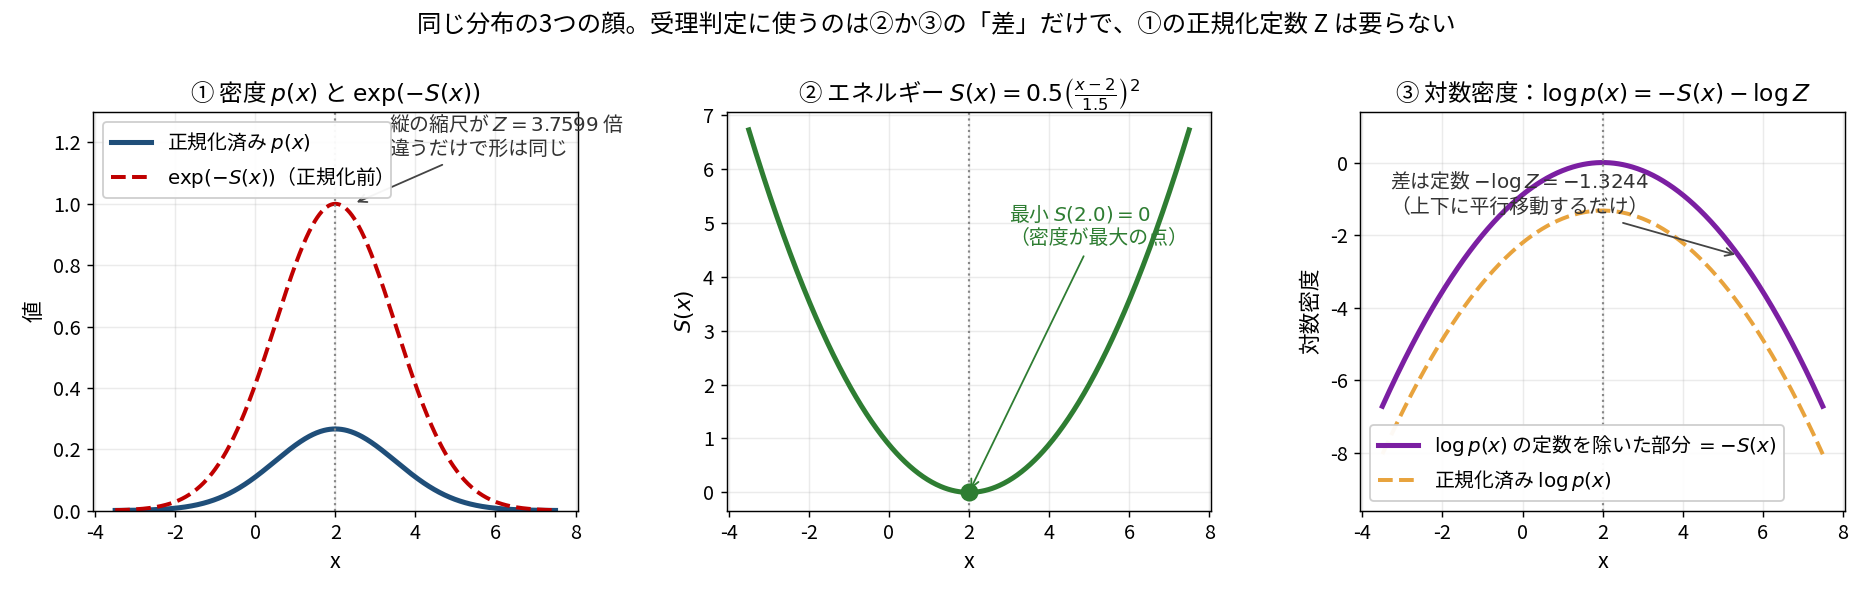
3枚とも同じ分布を描いています。左は縦の縮尺が 倍違うだけ、右は上下に だけ平行移動しているだけです。
数値で確かめます。
log_target(x) | 正規化済み | と一致するか | |||
|---|---|---|---|---|---|
| 2.0 | 0.00000 | −0.00000 | 1.000000 | 0.265962 | 一致 |
| 0.5 | 0.50000 | −0.50000 | 0.606531 | 0.161314 | 一致 |
| −1.0 | 2.00000 | −2.00000 | 0.135335 | 0.035994 | 一致 |
| 3.5 | 0.50000 | −0.50000 | 0.606531 | 0.161314 | 一致 |
| 5.0 | 2.00000 | −2.00000 | 0.135335 | 0.035994 | 一致 |
密度では「比」、エネルギーと対数密度では「差」
ここが実装で間違えやすいところです。受理判定に使うのは比です。
が約分されて消えます。 そして指数の中は の差です。3通りの移動で確かめました。
| 現在 → 候補 | 差 | 受理確率 | 密度の比で検算 | 参考:差 | ||
|---|---|---|---|---|---|---|
| 0.5 → 1.5 | 0.50000 | 0.05556 | 0.44444 | 1.000000 | 1.559623 | 0.090275 |
| 0.5 → −1.0 | 0.50000 | 2.00000 | −1.50000 | 0.223130 | 0.223130 | −0.125320 |
| −1.0 → 2.0 | 2.00000 | 0.00000 | 2.00000 | 1.000000 | 7.389056 | 0.229968 |
読み取れることが3つあります。
- 密度が上がる移動( が下がる移動)は比が1以上になり、必ず受理されます。 1行目と3行目です
- 密度が下がる移動でも、比の分だけの確率で受理されます。2行目は 22.3% で受理
- 右端の「差」の列は受理判定に使いません。 は が約分されないので、正規化定数が必要になってしまいます
確率密度そのものでは「比」を取り、エネルギーまたは対数密度では「差」を取る。 これが対応関係です。実装では対数で持って差を取るので、桁溢れも起きません。
ランダムウォーク・メトロポリス法:自分で書いた部分
私が書いたのは次の5ステップだけです。目標分布・診断図・チェックは用意されていました。
current = initial_state
current_log_density = log_target(current)

for i in range(n_samples):
    dx = rng.normal(loc=0.0, scale=proposal_std)   # 対称な正規ランダムウォーク
    candidate = current + dx
    candidate_log_density = log_target(candidate)

    log_alpha = candidate_log_density - current_log_density   # 対数受理比

    r = rng.random()
    if min(0.0, log_alpha) > np.log(r):             # log(U) < min(0, log_alpha)
        accepted_count += 1
        current = candidate
        current_log_density = candidate_log_density

    samples[i] = current      # 受理・棄却にかかわらず、現在の状態を保存する
書いてみて引っかかった点が3つありました。
① 棄却したときも標本に記録する。 ここを「受理したときだけ記録」にすると別の分布になります。棄却は「同じ場所にもう1歩ぶんの滞在時間を与える」という意味を持っているので、記録しないと滞在時間の情報が消えます。
② 比較は対数で行う。 を計算して と比べても数学的には同じですが、 が大きな負の数のとき が 0 に潰れます。 の形なら潰れません。
③ min(0, ...) は要るのか。 受理確率は なので、対数では です。 は必ず負なので、 のときは を取らなくても常に受理されます。つまり結果は同じですが、式が受理確率の定義と1対1に対応しているので付けたままにしました。
対称な提案分布だから Hastings 補正が消えている
一般のメトロポリス–ヘイスティングス法の受理確率は次の形です。
右側の分数が Hastings 補正です。今回の提案分布は「現在位置を中心とする正規分布」なので対称で、
が成り立ちます。だから補正が1になって消え、古典的なメトロポリス法(Metropolis et al. 1953)の形になります。
非対称な提案を使うときは補正が必要です。 たとえば正の値しか取らないパラメータに対して対数正規の提案を使う場合や、現在位置に応じて提案の幅を変える場合です。補正を忘れると別の分布に収束します。しかも「動いてはいる」ので、気づきにくい。
なお、対称性は必須条件ではありません。目標分布を不変分布にするための十分条件は詳細釣り合いで、「対称な提案+メトロポリスの受理則」はそれを満たす組み合わせの一例にすぎません。 詳細釣り合いを満たすのは提案分布単体ではなく、提案と受理則を合わせた遷移全体です。詳細釣り合いそのものは第33回で扱ったので、ここでは深追いしません。
提案分布を変えても同じ分布に収束するのはなぜか
これも引っかかった点でした。提案分布はまったく違うものを使えるのに、なぜ同じ目標分布に行き着くのか。
理由は、提案分布は「どこを次に見るか」しか決めておらず、「そこに留まる割合」は受理判定が決めているからです。受理確率に の比が入っているので、最終的な滞在時間の比が の比に一致します。提案分布は探索の効率だけを変えます。
ただし無条件ではありません。次の条件が必要です。
| 条件 | 意味 | 破ると何が起きるか |
|---|---|---|
| 正しい受理確率 | 提案が非対称なら Hastings 補正を入れる | 別の分布に収束する |
| 既約性 | 正の確率を持つどの領域へも(有限歩で)到達できる | 分布の一部に到達できず、その領域が欠ける |
| 非周期性 | 決まった周期で同じ場所に戻る構造がない | 歩目の分布が1つに落ち着かない(時間平均は収束するが、任意の時点の分布としては使えない) |
ランダムウォーク・メトロポリス法では、提案が全域に正の密度を持つ正規分布なので既約性と非周期性は自動的に満たされます。だから実務で気をつけるのは1行目、受理確率を正しく書くことだけになります。
診断図の読み方
固定シードで実行した結果を見ます。設定は --samples 10000 --burn-in 1000 --proposal-std 1.0 --seed 42(初期値 0)です。
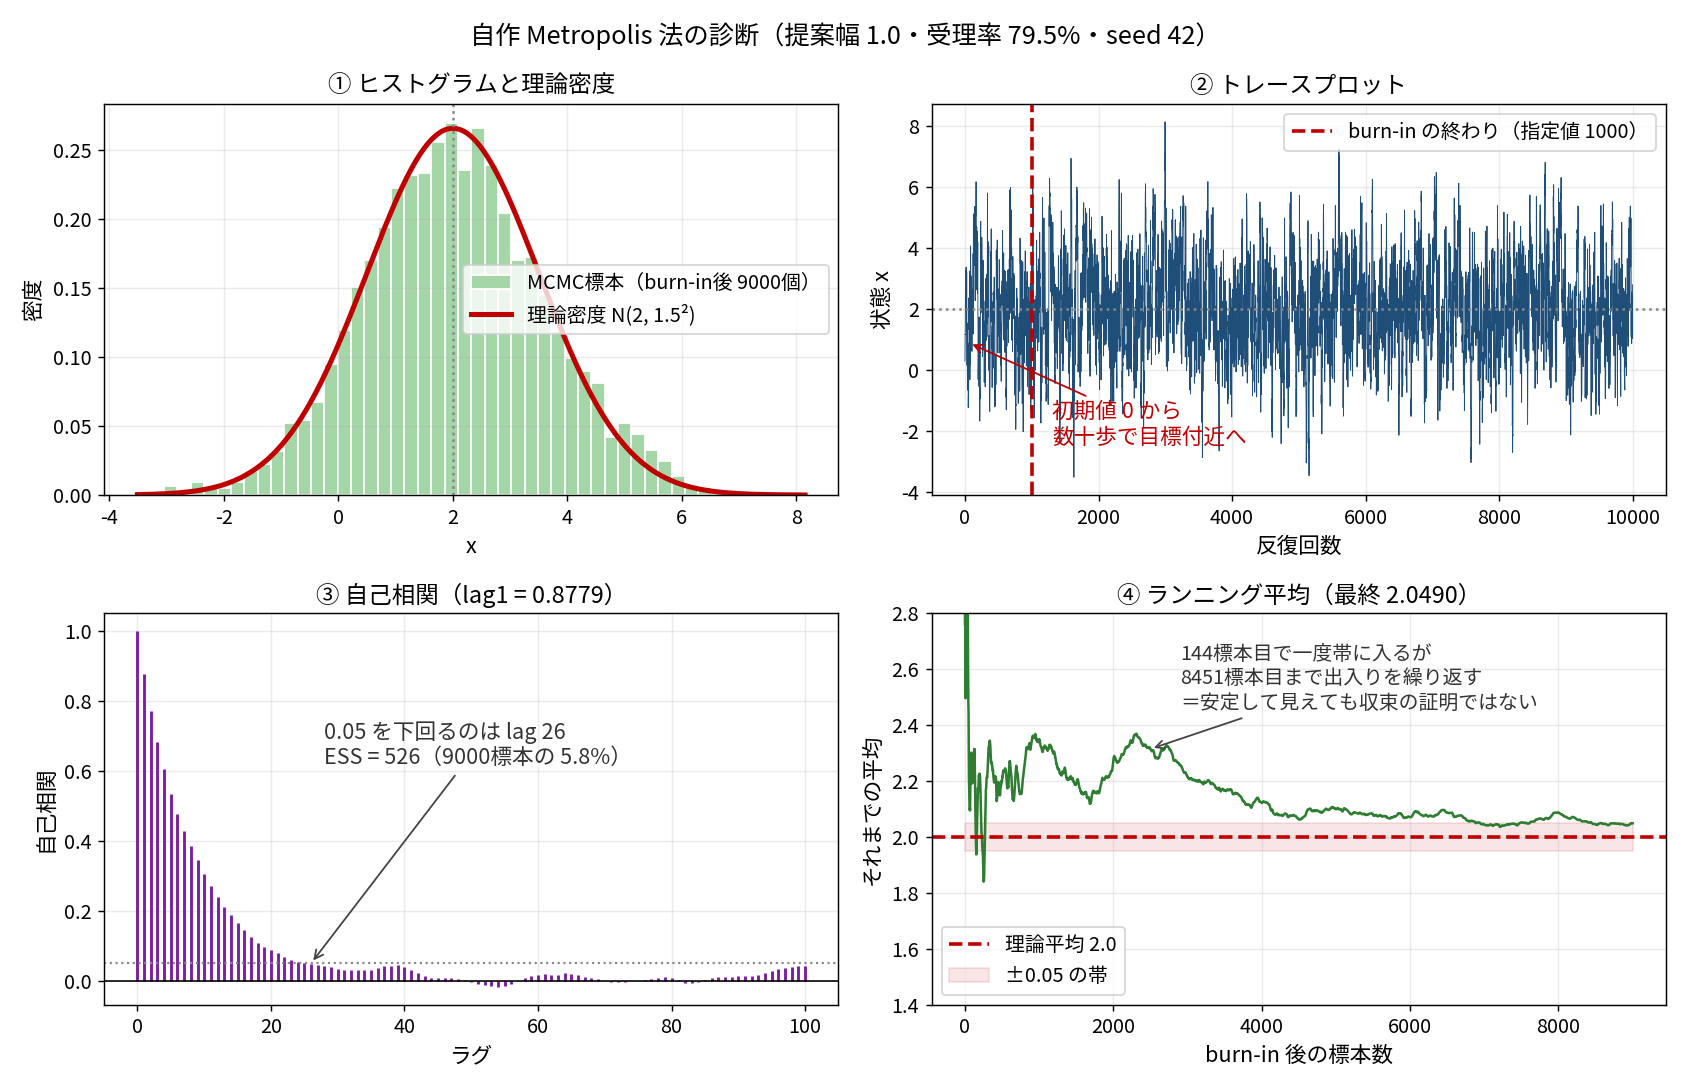
4枚それぞれの読み方を書きます。
① ヒストグラムと理論密度
見るのは「形が合っているか」だけです。 ここが合っていなければ実装が間違っています。合っていても収束の証明にはなりません(後述)。
| 確かめた量 | burn-in後 9000 標本 | 理論値 |
|---|---|---|
| 平均 | 2.0490 | 2.0000 |
| 標準偏差 | 1.5837 | 1.5000 |
② トレースプロット
縦軸が状態、横軸が反復回数です。 見るポイントは3つ。
- 初期値からの立ち上がり:0 から始めて、最初の20歩は 0.305, 1.055, 1.055, 1.183, 1.166, 2.046, … と目標付近へ上がっていきます。同じ値が2回続いているところ(1.055 が2回)は棄却された歩です
- 同じ場所に長く留まっていないか:水平な線が長く続くのは棄却が連続しているサインです
- 帯の太さが一定か:途中で急に幅が変わるなら、分布の別の領域に移った可能性があります
赤い縦破線が burn-in の終わりですが、これはグラフから自動検出した値ではありません。 コマンドラインで --burn-in 1000 と指定した値をそのまま描いているだけです。この実装に自動判定は入っていません。
③ 自己相関
MCMC標本は独立ではありません。 ここが通常のモンテカルロ法との最大の実務的な違いです。
lag 1 の自己相関は 0.8779。1歩前の自分と 88% 相関しています。0.05 を下回るのは lag 26 で、26歩離れてようやく「ほぼ無関係」になります。
これを1つの数にまとめたのがESSです。
が lag の自己相関です。自己相関が全部 0 なら ESS 。相関が強いほど小さくなります。今回は ESS = 526、つまり9000標本が実質526個分の情報しかありませんでした。
(無限和は打ち切る必要があります。この記事では Geyer (1992) の「連続する2つの自己相関の和が負になったら止める」という方式を使っています。)
ESSが分かると平均のズレが解釈できます。 モンテカルロ標準誤差は標準偏差 ÷ なので、。実測の平均 2.0490 は理論値から 0.0490 離れていますが、これは 0.71 標準誤差ぶんです。偏りではなく誤差の範囲でした。
④ ランニング平均
先頭から 個までの平均を の関数として描いたものです。理論平均 2.0 に近づいていく様子が見えます。
ただし、ここが最も誤解しやすい図です。 ランニング平均が横ばいになっても、それは収束の証明になりません。実測すると、 の帯に
- はじめて入るのは 144 標本目
- それ以降ずっと帯の中に留まるのは 8451 標本目
でした。144 標本目のグラフを見て「安定した」と判断すると間違えます。横ばいに見えるのは、単に分母が大きくなって新しい標本の影響が薄まっているからでもあります。
受理率
今回は 79.5% でした。4枚のパネルには出ませんが、図全体の見出しに表示されています。この数字の読み方は次の節でまとめます。
実務での収束判定
この記事の診断(1本の鎖のトレース・自己相関・ランニング平均)は、どれも「明らかに壊れている」ことを見つける道具です。 「収束した」ことの証明にはなりません。
実務では次を併用します。
| 道具 | 何を見るか |
|---|---|
| 複数の鎖を別の初期値から走らせる | 別々の場所に落ち着いていないか(1本では絶対に分からない) |
| (Gelman–Rubin の収束診断とその改良版) | 鎖の間のばらつきと鎖の中のばらつきの比。1に近いか |
| ESS | 推定に使える実質の標本数が足りているか |
は第33回で扱いました。今回のプロジェクトは1本の鎖しか走らせないので、原理的に が計算できません。 そこは教材の範囲外だと理解しておく必要があります。
提案幅を変えると何が変わるのか
同じ目標分布・同じシード・同じ標本数で、提案分布の標準偏差だけを変えます。
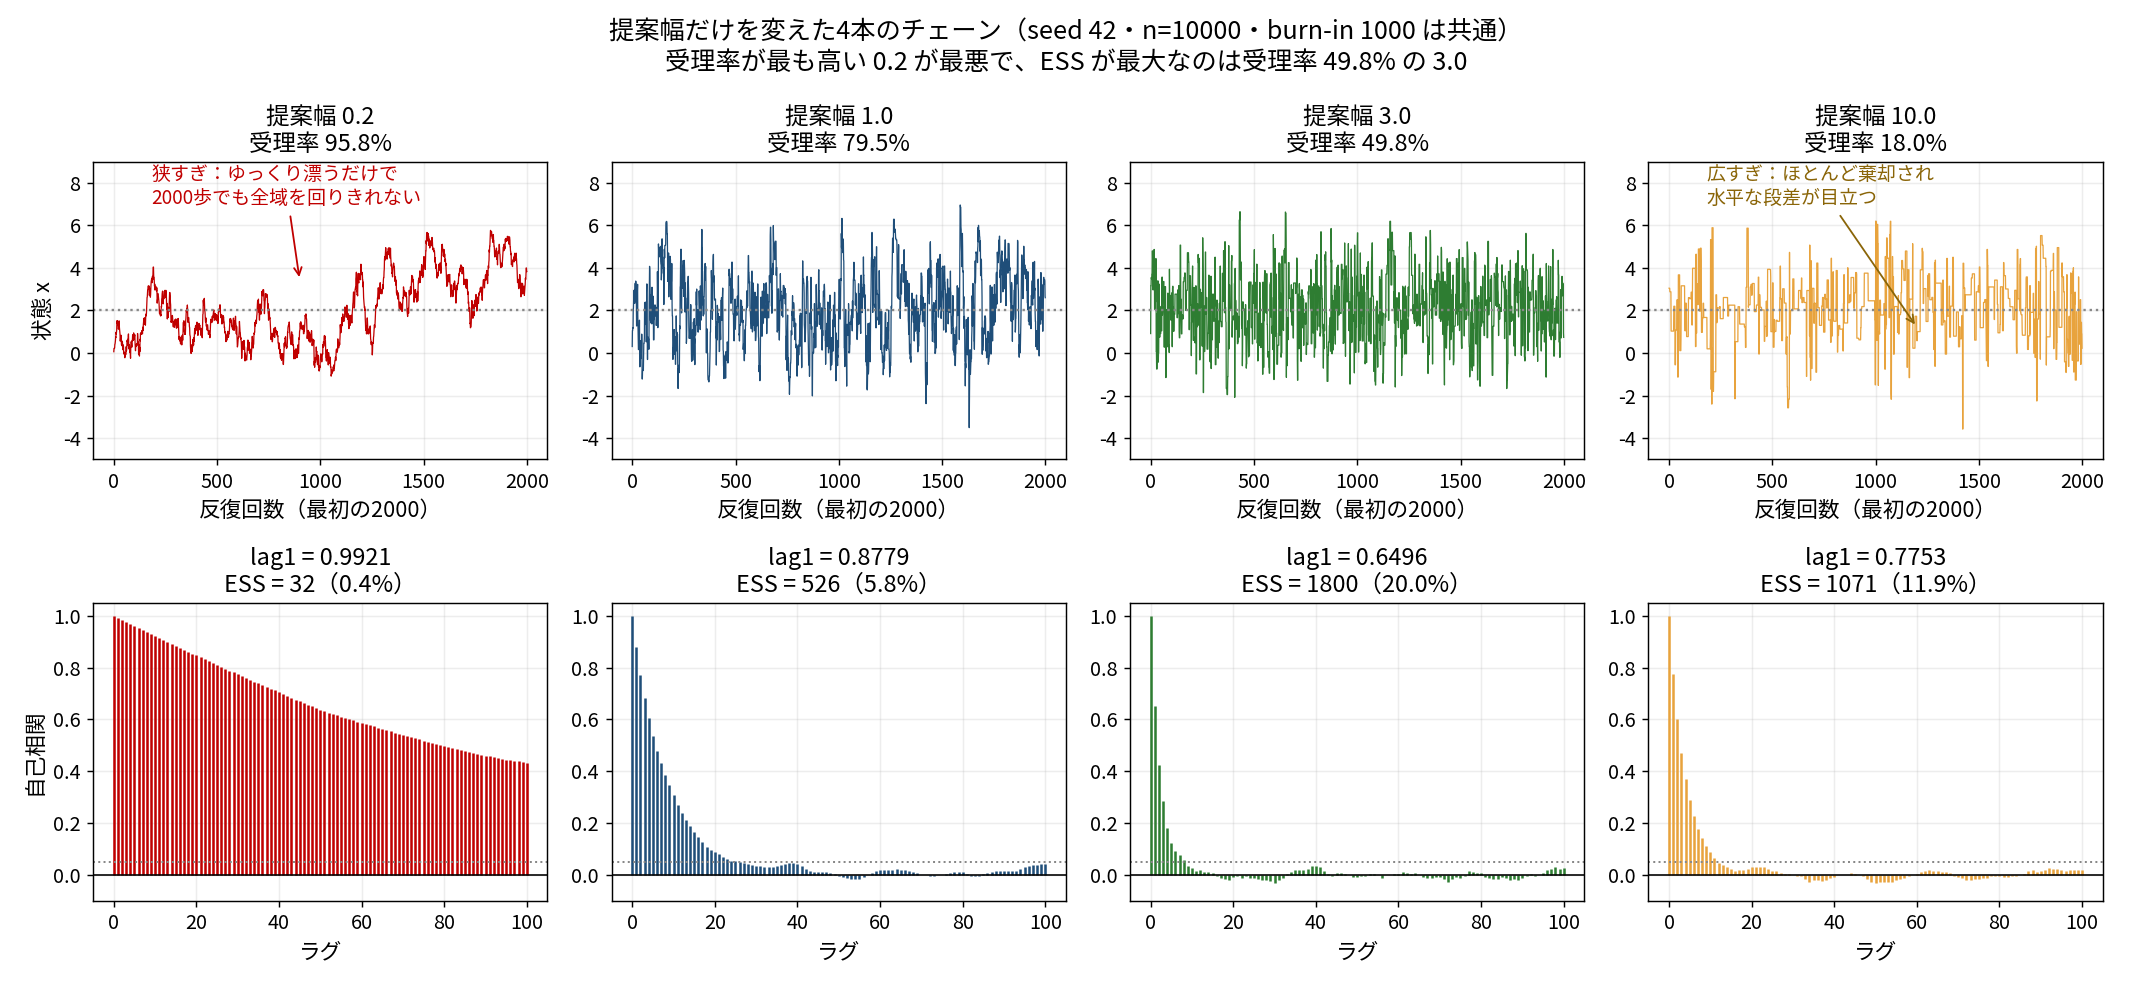
| 提案幅 | 受理率 | burn-in後の平均 | 同 標準偏差 | lag1 の自己相関 | ESS | ESS ÷ 標本数 |
|---|---|---|---|---|---|---|
| 0.2 | 95.8% | 2.2024 | 1.5517 | 0.9921 | 32.1 | 0.4% |
| 1.0 | 79.5% | 2.0490 | 1.5837 | 0.8779 | 525.7 | 5.8% |
| 3.0 | 49.8% | 2.0187 | 1.4944 | 0.6496 | 1800.0 | 20.0% |
| 10.0 | 18.0% | 2.0015 | 1.4324 | 0.7753 | 1071.0 | 11.9% |
| 理論値 | — | 2.0000 | 1.5000 | — | — | — |
(上の図の見出しには「ESSが最大なのは 3.0」と書いてありますが、これは1万標本での比較です。あとでもっと細かく探すと 3.5 が最良になります。)
受理率が最も高い 0.2 が、いちばん効率が悪いです。 ESSが 32 しかありません。9000歩使って実質32個分。
理由はトレースを見れば分かります。提案幅 0.2 では、ほとんどの候補が受理されるかわりに、1歩で 0.2 程度しか動きません。 ゆっくり漂うだけで、2000歩でも分布の全域を回りきれない。「受理された」のと「進んだ」のは別です。
逆に提案幅 10.0 では、82% の反復が棄却されます。棄却は「同じ場所で足踏み」なので、これも効率を落とします。
つまり効率には山があります。 もっと細かく探しました(10万標本)。
| 提案幅 | 受理率 | ESS | ESS ÷ 標本数 |
|---|---|---|---|
| 0.5 | 89.6% | 2168.1 | 2.41% |
| 1.0 | 79.5% | 6194.0 | 6.88% |
| 2.0 | 62.4% | 14115.8 | 15.68% |
| 3.0 | 49.9% | 19428.2 | 21.59% |
| 3.5 | 45.0% | 19819.0 | 22.02% |
| 4.0 | 40.9% | 19694.0 | 21.88% |
| 6.0 | 29.4% | 16729.9 | 18.59% |
| 10.0 | 18.3% | 11398.9 | 12.67% |
| 15.0 | 12.5% | 7889.6 | 8.77% |
この1次元の問題では、提案幅 3.5(受理率 45.0%)が最良でした。 目標分布の標準偏差 1.5 に対して 2.33 倍です。
高次元では漸近的に最適な受理率が 0.234 であることが知られています(Roberts, Gelman & Gilks 1997)。この実測はそれよりずっと高い受理率で最良になりました。 ただしこれは理論と食い違っているわけではありません。1次元での最適な受理率は約 0.44 とされており(Roberts & Rosenthal 2001)、実測の 45.0% はそちらとよく一致しています。
つまり「受理率を 0.234 に合わせる」は高次元での目安で、低次元ではもっと高いほうが良い。 どちらにしても受理率だけを見て調整せず、ESSで比べるのが確実です。
極限の分布は変わらない
「提案幅で結果が変わるなら、正しい分布に収束していないのでは」と思うかもしれません。標本数を10倍にして確かめました。
| 提案幅 | 受理率 | 平均 | 標準偏差 | ESS |
|---|---|---|---|---|
| 0.2 | 96.0% | 1.9903 | 1.4463 | 431.7 |
| 1.0 | 79.5% | 1.9748 | 1.5145 | 6194.0 |
| 3.0 | 49.9% | 1.9895 | 1.5048 | 19428.2 |
| 10.0 | 18.3% | 1.9820 | 1.4951 | 11398.9 |
どの提案幅でも平均が 2.0 に、標準偏差が 1.5 に近づきます。 提案分布は極限の目標分布を変えません。変えるのは有限標本での探索効率だけです。
さらに、1万標本のときの平均のズレも誤差として説明できます。
| 提案幅 | 平均 | 理論との差 | ESS | モンテカルロ標準誤差 | 差 ÷ 標準誤差 |
|---|---|---|---|---|---|
| 0.2 | 2.2024 | 0.2024 | 32.1 | 0.2741 | 0.74 |
| 1.0 | 2.0490 | 0.0490 | 525.7 | 0.0691 | 0.71 |
| 3.0 | 2.0187 | 0.0187 | 1800.0 | 0.0352 | 0.53 |
| 10.0 | 2.0015 | 0.0015 | 1071.0 | 0.0438 | 0.03 |
どれも1標準誤差以内です。 提案幅 0.2 の 2.2024 は偏りではなく、ESSが32しかないための誤差でした。平均のズレはESSを見ないと解釈できません。
密度は評価できるが直接サンプリングできない例
ここまでは正規分布でしたが、そこにMCMCを使う実用上の理由はありませんでした。実際に必要になる形を1つ見ます。ロジスティック回帰のベイズ事後分布です。
設定
説明変数 と二値の応答 を20組用意しました。
x = -2.5 -2.0 -1.5 -1.0 -0.5 0.0 0.0 0.5 1.0 1.5 2.0 2.5 -1.2 0.7 1.8 -0.3 1.1 -2.2 0.2 2.2
y =  0    0    0    0    1   0   1   1   1   1   1   1    0   0   1    1   1    0   0   1
モデルは次の形です。 の2次元です。
事前分布は intercept・slope ともに の独立としました。これは固有な(proper な)事前分布です。
事前分布を固有にしたのには理由があります。ロジスティック回帰では完全分離(ある閾値で が完全に 0 と 1 に分かれる状態)が起きると、平坦な事前分布のもとで事後分布が発散して不適切になります。今回のデータは の順に並べると
0, 0, 0, 0, 0, 0, 1, 1, 0, 1, 0, 1, 0, 1, 1, 1, 1, 1, 1, 1
で、どの閾値でも完全には分かれません。そのうえ固有な事前分布を置いているので、事後分布は二重に安全に proper です。
密度は必ず計算できる
対数事後密度は「対数尤度 + 対数事前」です。 を渡せば必ず値が返ります。
| intercept | slope | 対数尤度 | 対数事前(定数省略) | 対数事後(正規化前) |
|---|---|---|---|---|
| 0.0 | 0.0 | −13.8629 | −0.0000 | −13.8629 |
| 0.3 | 1.5 | −7.2738 | −0.1872 | −7.4610 |
| 1.0 | 3.0 | −8.5311 | −0.8000 | −9.3311 |
| −1.0 | 0.5 | −12.7410 | −0.1000 | −12.8410 |
しかし「この事後分布から を1つ引く」ための専用の乱数生成器は存在しません。 正規分布やベータ分布のようには作れない。ここが表の右下でした。
正規化定数は二重積分になる
正規化定数は
です。2次元なら格子で数値積分できます。ただしここで1つ落とし穴を踏みました。
実装の log_prior は事前分布の正規化定数を省いています(受理判定では消えるので不要だからです)。1成分あたり 、intercept と slope の2成分で です。そのまま格子で積分すると 、値 になりますが、これは上の式の ではありません。この を足すと
で、これが上の式が意味する値(ベイズの周辺尤度)です。2つは 倍違います。
なお厳密には、これも格子の範囲(intercept は 、slope は )で打ち切った数値積分の値です。
受理判定では消える定数が、正規化定数そのものを求めるときには消えない。 この記事の主題(比では が消える)の裏返しで、自分で1回踏みました。
ただしMCMCはこの値を一切使いません。 そしてパラメータが10個あれば10重積分になり、この方法は使えなくなります(第34回で見たグリッド法の次元の壁と同じ話です)。
2次元のランダムウォーク・メトロポリス法
1次元のときと同じ受理判定を、2次元にしただけです。提案は各成分に独立な正規分布(標準偏差 0.55)、6万反復、burn-in 1万、初期値 。
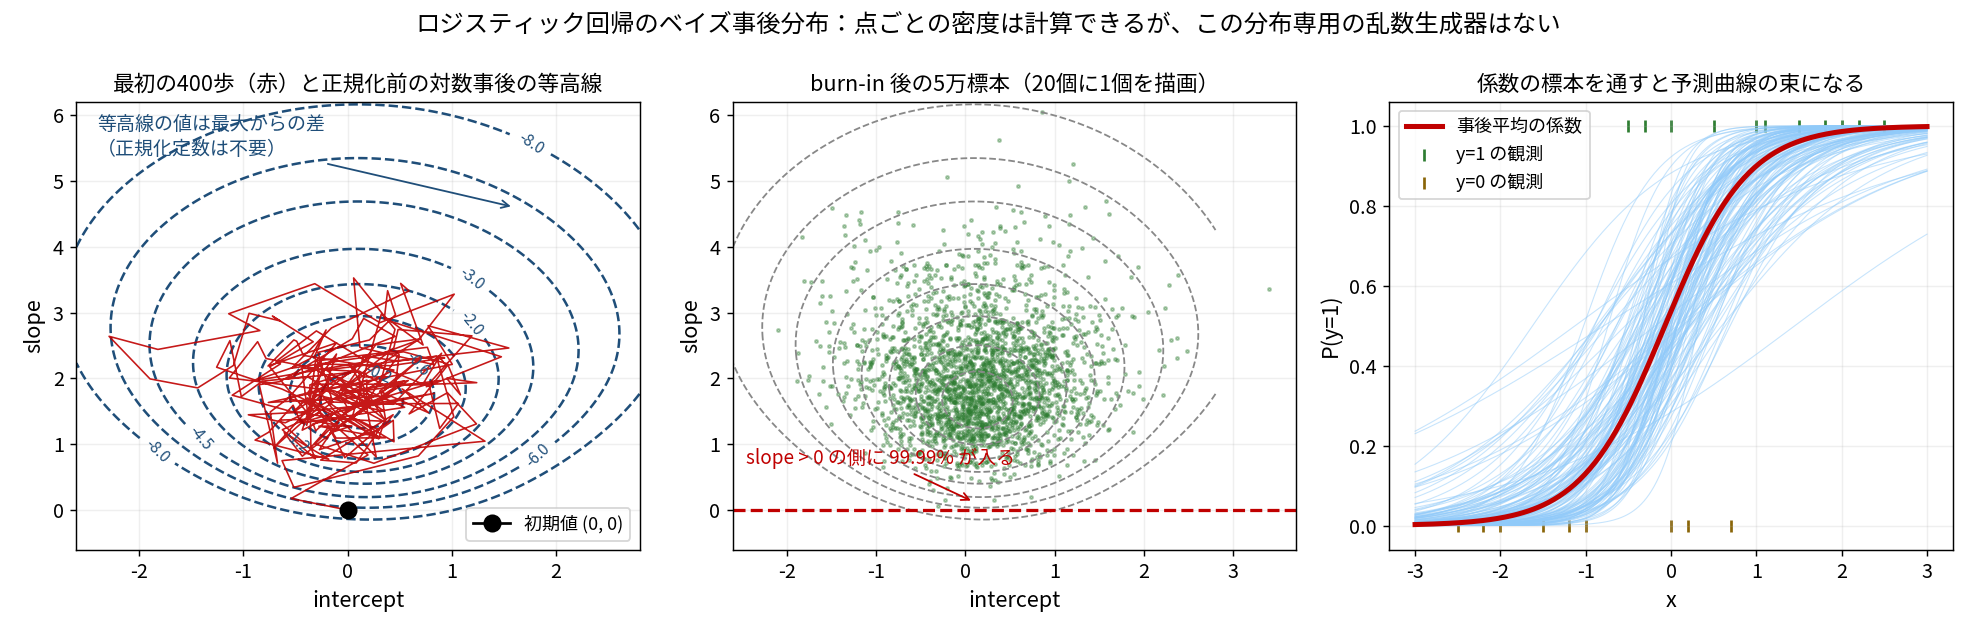
受理率は 62.9% でした。
| パラメータ | 事後平均 | 事後標準偏差 | 95%信用区間 | ESS |
|---|---|---|---|---|
| intercept | 0.1478 | 0.6858 | [−1.1971, 1.5330] | 3909.2 |
| slope | 2.0448 | 0.7952 | [0.7655, 3.8875] | 2662.6 |
格子による数値積分と照合しました。
| 量 | MCMC | 格子(数値積分) |
|---|---|---|
| intercept の事後平均 | 0.1478 | 0.1416 |
| intercept の事後標準偏差 | 0.6858 | 0.6758 |
| slope の事後平均 | 2.0448 | 2.0195 |
| slope の事後標準偏差 | 0.7952 | 0.7830 |
| 0.9999 | 0.9999 |
一致しています。 2次元だから格子と比べられるので、これも「答えのある問題で実装を確かめる」の一例です。
標本があると何ができるか
事後分布の標本が手に入ると、知りたい量を標本に対して計算して数えるだけで済みます。
- 傾きが正である事後確率:。標本のうち slope が正だったものの割合を数えただけ
- での予測確率:各標本の をシグモイド関数に通して平均すると 0.8655、95%区間は [0.6095, 0.9889]
右のパネルの水色の束がこれです。係数の標本1個ごとに予測曲線が1本引けるので、予測の不確実性がそのまま束の太さになります。 点推定1つでは出てこない情報です。
そしてこの計算のどこにも正規化定数 は出てきません。 受理判定が比しか使わないので、 を知らないまま標本が得られ、標本から期待値も確率も出せます。
ただし そのものは出ません。 通常のMCMCは正規化定数を推定しません。(ベイズでは周辺尤度)が欲しい場合は、ブリッジサンプリングや熱力学的積分といった別の工夫が必要です。
通常のモンテカルロ法で十分な例
逆の方向も見ておきます。球の体積を求める問題です。
球の条件は
で、立方体 から一様に点を打って、球の中に入った割合を数えます。
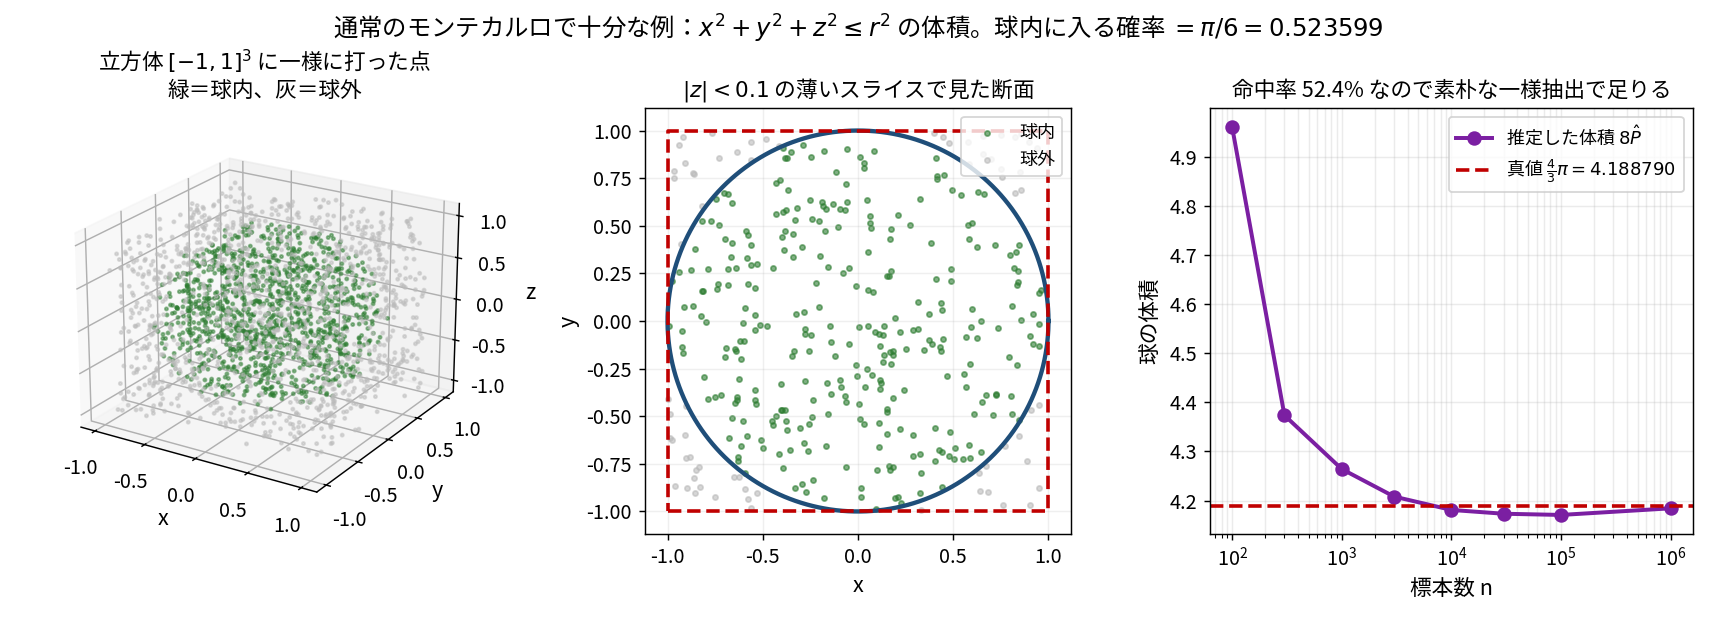
| 標本数 | 命中数 | 推定した | 推定した体積 | 真値 |
|---|---|---|---|---|
| 10,000 | 5,226 | 0.522600 | 4.180800 | 4.188790 |
| 1,000,000 | 523,014 | 0.523014 | 4.184112 | 4.188790 |
| 20,000,000 | 10,473,833 | 0.523692 | 4.189533 | 4.188790 |
3次元ではMCMCを使う必要がありません。 理由を正確に書きます。
「中心に確率が集中していないから」ではありません。 正しい理由は次の2つです。
- 基準となる一様分布から独立標本を直接生成できる(
rng.uniformで済む) - 球内に入る事象が希少ではない(命中率 52.4%)
このどちらかが崩れると話が変わります。
高次元では崩れる
球と超立方体の体積比は次元とともに急減します(第34回でも同じ比率を見ました)。
| 次元 | 球 ÷ 立方体 | 1個採るのに引く回数 |
|---|---|---|
| 3 | 5.235988e−01 | 1.910 回 |
| 5 | 1.644934e−01 | 6.079 回 |
| 10 | 2.490395e−03 | 401.5 回 |
| 20 | 2.461137e−08 | 4.063e+07 回 |
| 30 | 2.041026e−14 | 4.899e+13 回 |
では 4000万回引いて1個です。上の条件2(希少でない)が崩れています。
ただし「単純なMCMCに替えれば自動的に体積が求まる」わけではありません。 ここは私が最初に誤解しかけた点です。通常のMCMCは目標分布の標本を作るだけで、正規化定数を出しません。そして球の体積はまさに正規化定数の側にある量です。高次元の体積を求めるには、重点サンプリング・逐次的に領域を分割する方法・熱力学的積分といった、別の枠組みが必要になります。
使い分けの判断フロー
ここまでを1本の流れにまとめます。
目標分布から独立標本を直接生成できる?
  Yes → 通常のモンテカルロ法
  No  → 良い提案分布と安定した重みを作れる?
           Yes → 重点サンプリング/棄却サンプリングを検討
           No  → 正規化前の目標密度を評価できる?
                    Yes → MCMC を検討
                    No  → 通常の MCMC も困難
別枠の注意が1つあります。 上のフローの1行目が Yes でも、通常のモンテカルロ法が実用にならない場合があります。知りたい事象がまれなときです。
たとえば「確率 の事象の確率を推定したい」なら、直接生成できても素朴に数えるだけでは1億回引いて1回しか当たりません。この場合は重点サンプリングなどで「まれな事象を起きやすくして重みで割り戻す」必要があります。第34回で の確率を10万回で推定した例がこれです。
つまり判断は2軸で見るのが正確です。
| 事象が希少でない | 事象が希少 | |
|---|---|---|
| 直接生成できる | 通常のモンテカルロ法 | 重点サンプリングなど |
| 直接生成できない | MCMC | MCMC + まれな事象向けの工夫 |
技術的に混同しやすい点のまとめ
自分が実際に混同していた点、あるいは書きながら怖くなって確認した点を並べます。
| 混同 | 正しい理解 |
|---|---|
| MCMCと重点サンプリングは似た手法 | 別系統の手法。 MCMCは鎖をつなぐ、重点サンプリングは独立標本に重みを付ける |
| MCMCは確率密度関数を求めてくれる | 求めない。 密度の式は最初から必要。MCMCが出すのは標本 |
| MCMC標本には重みが付いている | 付かない。 重みなしだが相関がある |
| 密度が計算できればサンプリングもできる | 別問題。 事後分布は前者ができて後者ができない典型 |
| メトロポリス法は指数関数の形の分布専用 | 違う。 は と置いた一般的な書き方 |
| 正規化定数が要らないのはMCMCだけの特徴 | 違う。 自己正規化した重点サンプリングも を必要としない |
| MCMCなら正規化定数も分かる | 分からない。 標本と期待値・確率は出るが は別の工夫が必要 |
| 詳細釣り合いのために提案は対称でなければならない | 違う。 非対称でも Hastings 補正を入れれば詳細釣り合いを満たす。さらに詳細釣り合い自体が十分条件にすぎず、満たさなくても不変分布にできる(第33回の決定的スキャンのギブスサンプリング) |
| 非対称な提案でもそのまま使える | 使えない。 Hastings 補正 が必要 |
| 自己相関が0なら独立 | 同義ではない。 無相関は独立より弱い条件 |
| 提案分布を変えても収束するから何でもよい | 条件つき。 正しい受理確率・既約性・非周期性が必要 |
| 受理率は高いほど良い | 違う。 同じ1万反復(burn-in後9000標本)で、受理率 95.8% は ESS 32.1、49.8% は ESS 1800.0(56倍の差) |
| 高次元なら常にMCMCが最適 | 違う。 問題によっては別の手法が要る。体積の計算はMCMC単体では解けない |
| ランニング平均が横ばいなら収束した | 証明にならない。 帯に入り続けるのは 8451 標本目からだった |
| burn-in はグラフから自動で決まる | 今回の実装では指定値。 自動判定は入っていない |
参考文献
一次資料と標準的な教科書を挙げます。
| 内容 | 文献 |
|---|---|
| メトロポリス法の原論文 | Metropolis, N., Rosenbluth, A. W., Rosenbluth, M. N., Teller, A. H., & Teller, E. (1953). Equation of State Calculations by Fast Computing Machines. The Journal of Chemical Physics, 21(6), 1087–1092. |
| 非対称提案への一般化(メトロポリス–ヘイスティングス法) | Hastings, W. K. (1970). Monte Carlo sampling methods using Markov chains and their applications. Biometrika, 57(1), 97–109. |
| 提案幅の最適化と受理率 0.234 | Roberts, G. O., Gelman, A., & Gilks, W. R. (1997). Weak convergence and optimal scaling of random walk Metropolis algorithms. The Annals of Applied Probability, 7(1), 110–120. |
| 1次元を含む各種アルゴリズムの最適な受理率 | Roberts, G. O., & Rosenthal, J. S. (2001). Optimal scaling for various Metropolis-Hastings algorithms. Statistical Science, 16(4), 351–367. |
| 複数の鎖による収束診断 | Gelman, A., & Rubin, D. B. (1992). Inference from Iterative Simulation Using Multiple Sequences. Statistical Science, 7(4), 457–472. |
| 自己相関の打ち切りとESS | Geyer, C. J. (1992). Practical Markov Chain Monte Carlo. Statistical Science, 7(4), 473–511. |
| 改良版の収束診断とESS | Vehtari, A., Gelman, A., Simpson, D., Carpenter, B., & Bürkner, P.-C. (2021). Rank-Normalization, Folding, and Localization: An Improved for Assessing Convergence of MCMC. Bayesian Analysis, 16(2), 667–718. |
| 重点サンプリングとMCMCの位置づけ | Robert, C. P., & Casella, G. (2004). Monte Carlo Statistical Methods (2nd ed.). Springer. |
| ロジスティック回帰のベイズ事後分布・弱情報事前分布 | Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian Data Analysis (3rd ed.). CRC Press. |
再現方法
この記事の数値と図は、すべて固定シードで再現できます。スクリプトは site/scripts/mcmc-column/ に置いてあります。
| ファイル | 内容 |
|---|---|
mcmc_common.py | 練習用プロジェクトの sampler.py を呼び出す共通部分とESSの計算 |
v1_normal.py | エネルギー関数との対応、簡易チェックと同じ設定、診断の数値 |
v2_sweep.py | 提案幅を変えたときの受理率・ESS・平均のズレ |
v3_logit.py | ロジスティック回帰の事後分布と格子による照合 |
v4_three.py | 3手法の比較、次元による重みの崩壊、球の体積 |
v5_optimal.py | 1次元での最適な提案幅の探索 |
f_common.py | 図の共通設定(日本語フォント・文字サイズ) |
f1.py ~ f5.py | 記事の5枚の図 |
mcmc_verify_output.txt | v1 ~ v5 の実行結果。記事の数値はこれと f1.py ~ f5.py の出力に一致します |
mcmc_common.py は練習用プロジェクトのパスを絶対パスで直書きしているので、別の環境で動かすときはそこを書き換えてください。
主な設定は次のとおりです。
- 目標分布:。
target.pyのlog_targetが返すのは (正規化定数を省いた対数密度) - 診断図:
--samples 10000 --burn-in 1000 --proposal-std 1.0 --seed 42(初期値 0) - 簡易チェック:
n_samples=30000, burn_in=3000, proposal_std=1.0, initial_state=-5.0, seed=2026 - ロジスティック回帰:提案の標準偏差 0.55、6万反復、burn-in 1万、seed 20260816、事前分布
この記事の位置づけ
連載の中での位置を書いておきます。
| 記事 | 何を扱っているか |
|---|---|
| 第33回 | ベイズ法の全体。事後分布・共役事前分布・MCMCの導入・ギブスサンプリング・・階層ベイズ |
| 第34回 | 乱数を「作る」技術と「使う」技術の地図。逆関数法・棄却法・モンテカルロ積分・分散減少法 |
| この番外編 | その2つの境目。 密度を評価できることとサンプリングできることの区別、3手法の使い分け、実装して分かったこと |
準1級の試験対策としては、この記事の内容は「用語と使いどころ」のレベルで十分です。 MCMCを実装させる問題は出ません。ただ、自分で書いてみると「棄却したときも記録する」「対数で比較する」「受理率が高いほど良いのではない」といった、読むだけでは通り過ぎる点が体に入りました。
この連載の全体像は統計検定準1級・独学連載のまとめにあります。