仮説検定はなぜ遠回りするのか:ネイマン・ピアソンと尤度比【第12回】
はじめに
第10章は検定の基礎と検定法の導出です。検定そのものは、この連載でもすでに何度か使ってきました。第7回でt分布とχ²分布を扱い、第2回ではp値の誤解とA/Bテストの偽陽性に触れています。手順としての検定は、もう動かせる状態でした。
それでも今回に一番時間がかかりました。理由は、検定の論理が納得できていなかったことです。
なぜ「効果がある」と言いたいときに「効果がないとは言えない、とは言えない」という二重否定の形を取るのか。棄却域はどう決めるのが正しいのか。t検定とχ²検定と尤度比検定は、それぞれ別に覚えるものなのか。回帰分析の出力に並ぶp値と、教科書に出てくるスコア検定は何が違うのか。
手が動くのに、なぜその手順なのかが説明できない。 第10回でフィッシャー情報量に対して感じたのと同じ詰まり方でした。
結論を先に書くと、この章は1本の対数尤度曲線で全部つながっていました。
そしてt検定は尤度比検定そのもの、ピアソンのχ²検定はスコア検定でした。個別に覚えるものではなく、同じ曲線をどこで測るかの違いだったのです。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 記号( と 、 と など)で迷ったら 統計の記号がややこしいのは軸が2本あるからだった を先に読んでください。
- 有意水準・検出力・p値の基本的な誤解については 第2回 で扱いました。今回はその先に進みます。
TL;DR
- 「帰無仮説を棄却する」という遠回りは、 が計算できないことの帰結。 を仮定した世界の珍しさしか測れないので、背理法の形にするしかない
- 棄却域は同じ有意水準でも無数に作れて、検出力は 0.8038 から 0.0000 まで変わる。 「 を守る」だけでは検定は決まらない
- ネイマン・ピアソンの補題は「尤度比の大きい順に棄却域へ詰めろ」と言っている。 64通りの棄却域を総当たりして、これが上限の壁になることを確認した
- t検定は尤度比検定そのもの。 が の単調関数なので、棄却域が完全に一致する
- ウィルクスの定理で、中身の違う4つのモデルがすべて同じ に乗った。 ただし小標本では第一種の誤りが 0.0979 まで膨らむ
- ワルド・スコア・尤度比は1本の対数尤度曲線の「横の距離・接線の傾き・縦の高さの差」。 検出力まで一致するのは局所対立仮説のもとで、効果量を固定すると差が残る
- 小標本でワルドは危険。、 で実際の第一種の誤り率 0.5998(名目の12倍)
- 信頼区間は「棄却されない を全部集めた集合」。 定義の言い換えなので、同じ統計量なら例外なく一致する(199/199で確認)
- ホルム法はボンフェローニの上位互換。 同じFWERを保ったまま検出力が上がるので、ボンフェローニを選ぶ理由がない
- p値は ではなく 。 「以上」が本質
1. なぜ「帰無仮説を棄却する」という遠回りをするのか
最初の疑問はこれでした。「この薬は効く」と示したいのに、統計学は「効かないとは言えない」という否定形から始めます。回りくどい。
直接は計算できないから
理由は単純で、知りたいものが計算できないのです。
本当に知りたいのは です。しかしこれを出すには、データを見る前の「効果がある確率」(事前確率)が必要になります。第2回のベイズの定理がまさにその計算でした。事前確率を決めないと事後確率は出ない。 そして「この薬が効く事前確率」を客観的に決める方法はありません。
そこで発想を裏返します。(効果がない)を仮定すれば、データの分布は計算できる。 仮定した世界の中の話なので、事前確率は要りません。
- 直接測れないもの …
- 測れるもの …
測れる方だけを使って結論を出す形式が、背理法です。 「 が正しいとしたら、こんなデータはめったに出ない。実際に出た。だから を疑う」。
非対称性は設計であって欠陥ではない
ここで大事なのは、この論理は を否定する方向にしか働かないということです。そしてその根っこは、 と がそもそも対等な仮説ではないことにあります。
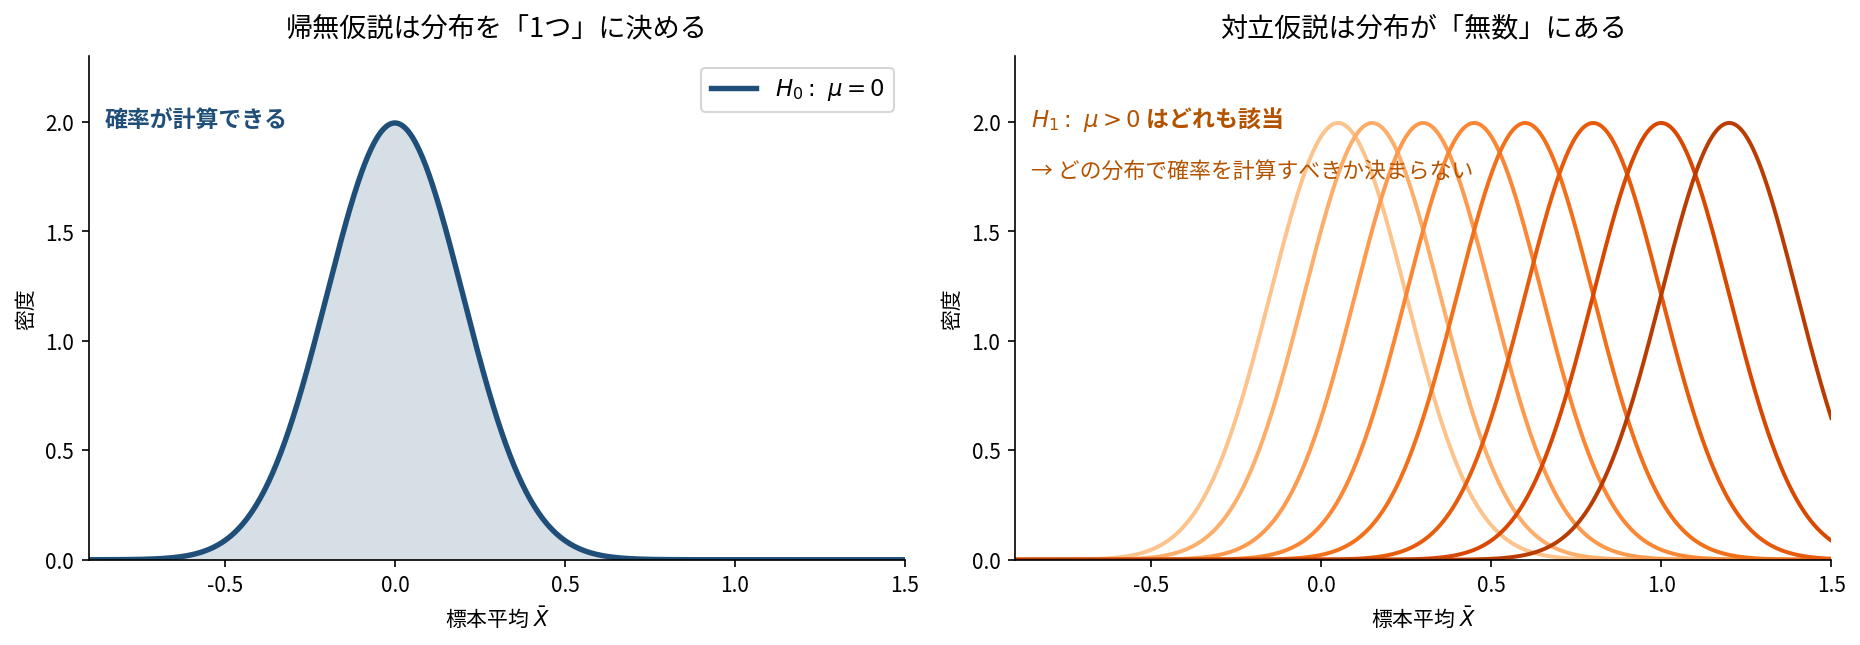
は分布を1つに確定させます( の一点)。だから確率が計算できます。ところが ()は無数の分布の集まりなので、どの分布で確率を計算すべきかが決まりません。 を仮定した世界の珍しさは、原理的に計算できないのです。
だから検定は「 を仮定して珍しさを測る」という一方向にしか働きません。統計量が裾に落ちたときは「 のもとでは珍しい」と言えます。しかし中央に落ちたときに言えるのは「 のもとでは普通」だけで、 が正しい証拠にはなりません。 から少しずれた仮説のもとでも、同じデータは普通に出るからです。
だから結論は「棄却する」か「棄却しない」の2択で、「採択する」は存在しません。 教科書がこの言い方にこだわる理由がここで分かりました。二重否定は言葉の癖ではなく、論理構造がそうなっているのです。
2種類の誤り
が正しいのに棄却してしまうのが第一種の誤り(確率 )、 が正しいのに棄却しないのが第二種の誤り(確率 )です。 が検出力です。
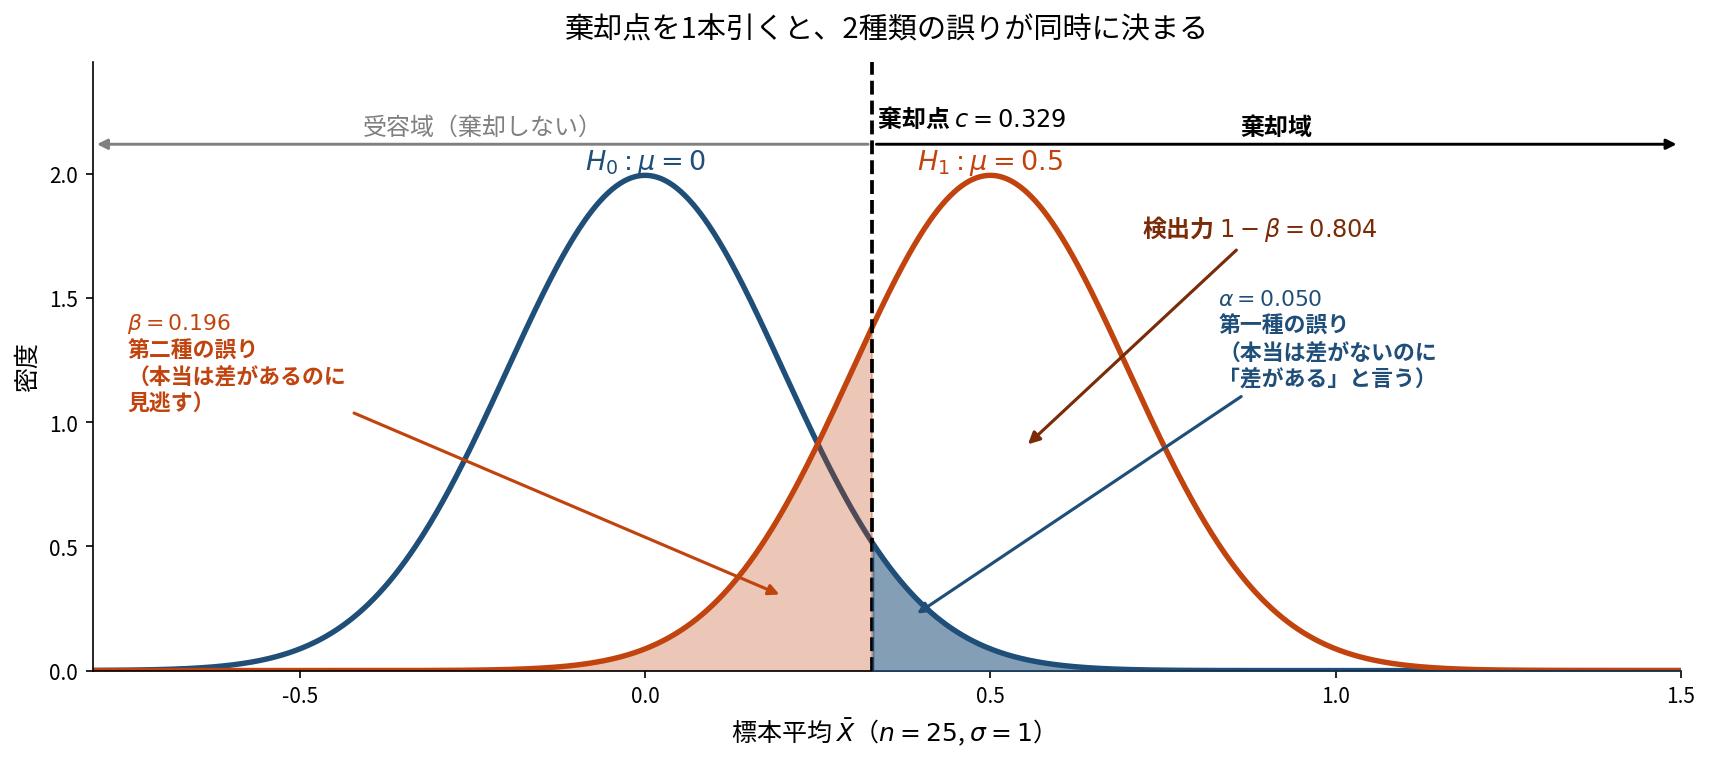
2つの分布の重なりを1本の境界線で切っているので、片方を減らせばもう片方が増えます。 これは技術の問題ではなく幾何の問題です。
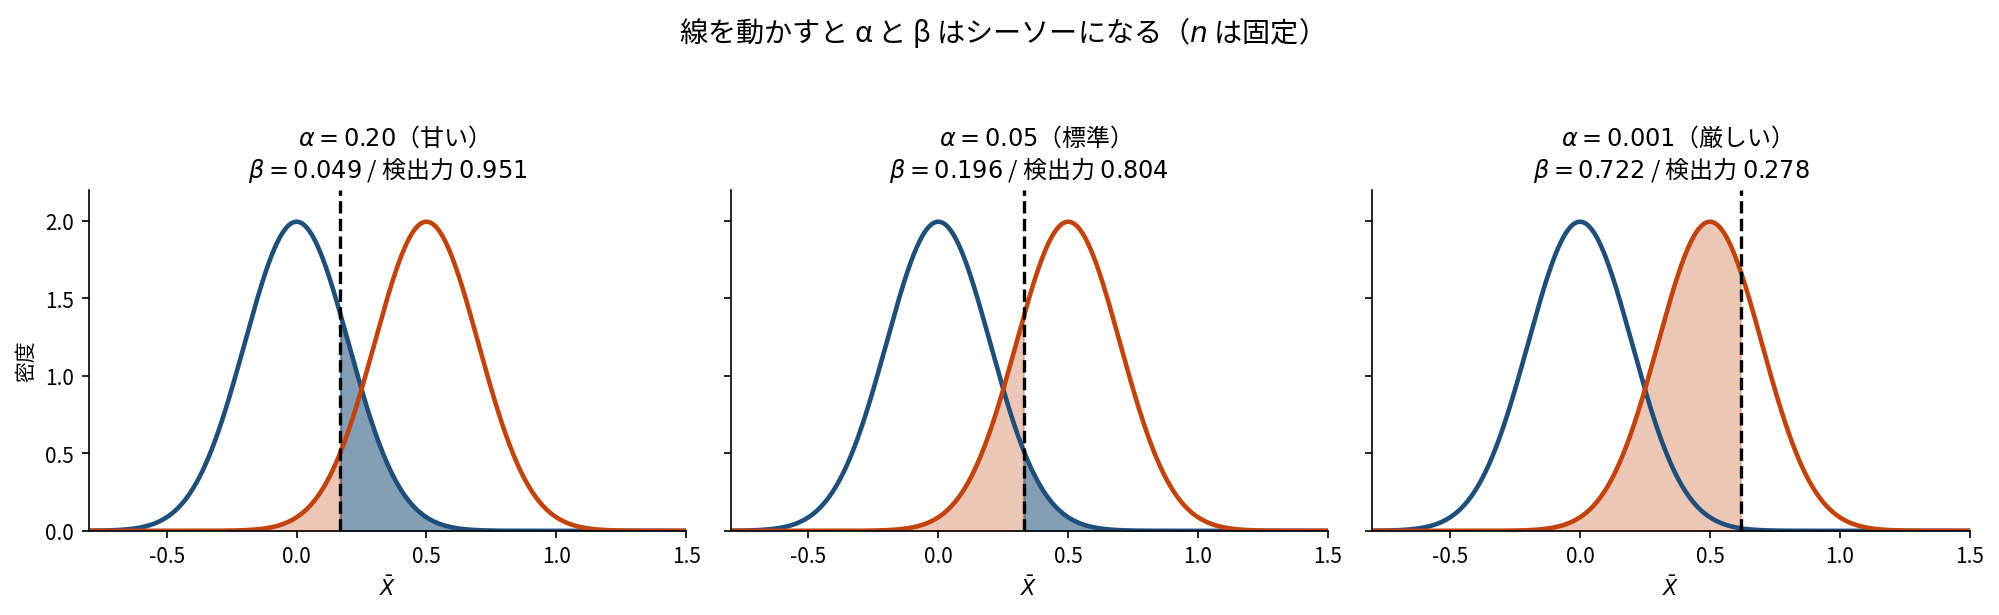
このトレードオフから逃げるには、重なりそのものを小さくするしかありません。一番素直な手が標本サイズを増やすことです。
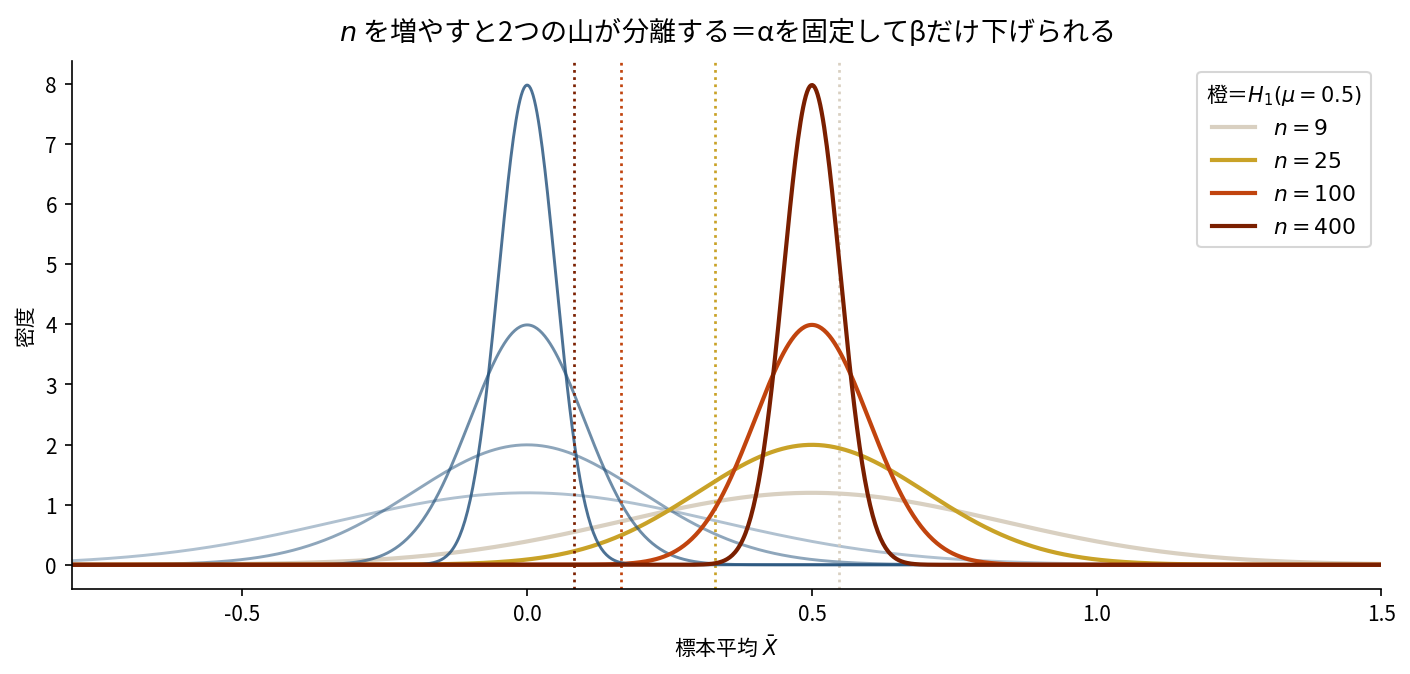
を増やすと分布の幅が で縮み、重なり自体が小さくなる。だから を固定したまま を下げられます。第10回で見た「 の壁」が、ここでは味方に回っています。
検出力を真の効果量の関数として描くと、こうなります。
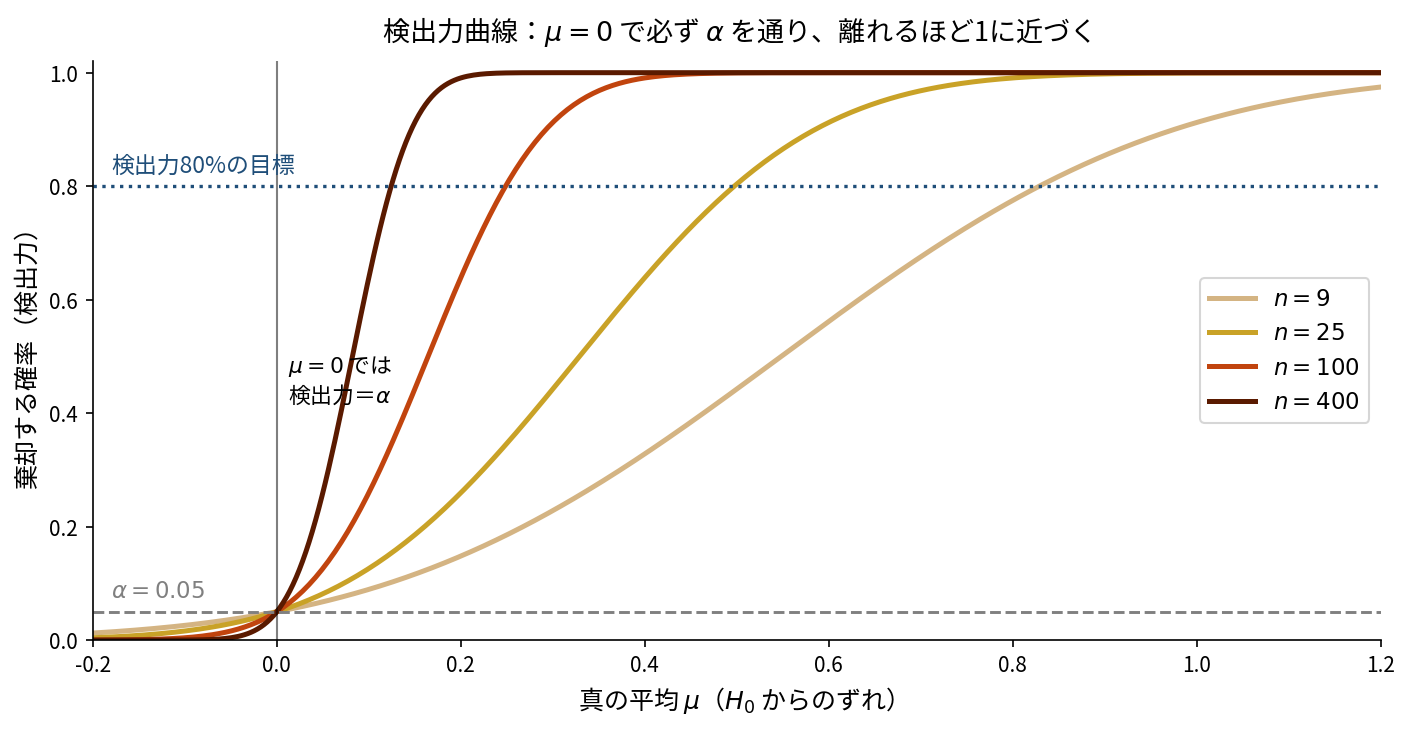
での検出力がちょうど になるのが検算ポイントです( が真のときの棄却率=第一種の誤り率)。
p値の分布
が正しい世界でp値を大量に計算すると、一様分布になります。20万回のシミュレーションで、25%点 0.2485、50%点 0.4981、75%点 0.7500 でした。
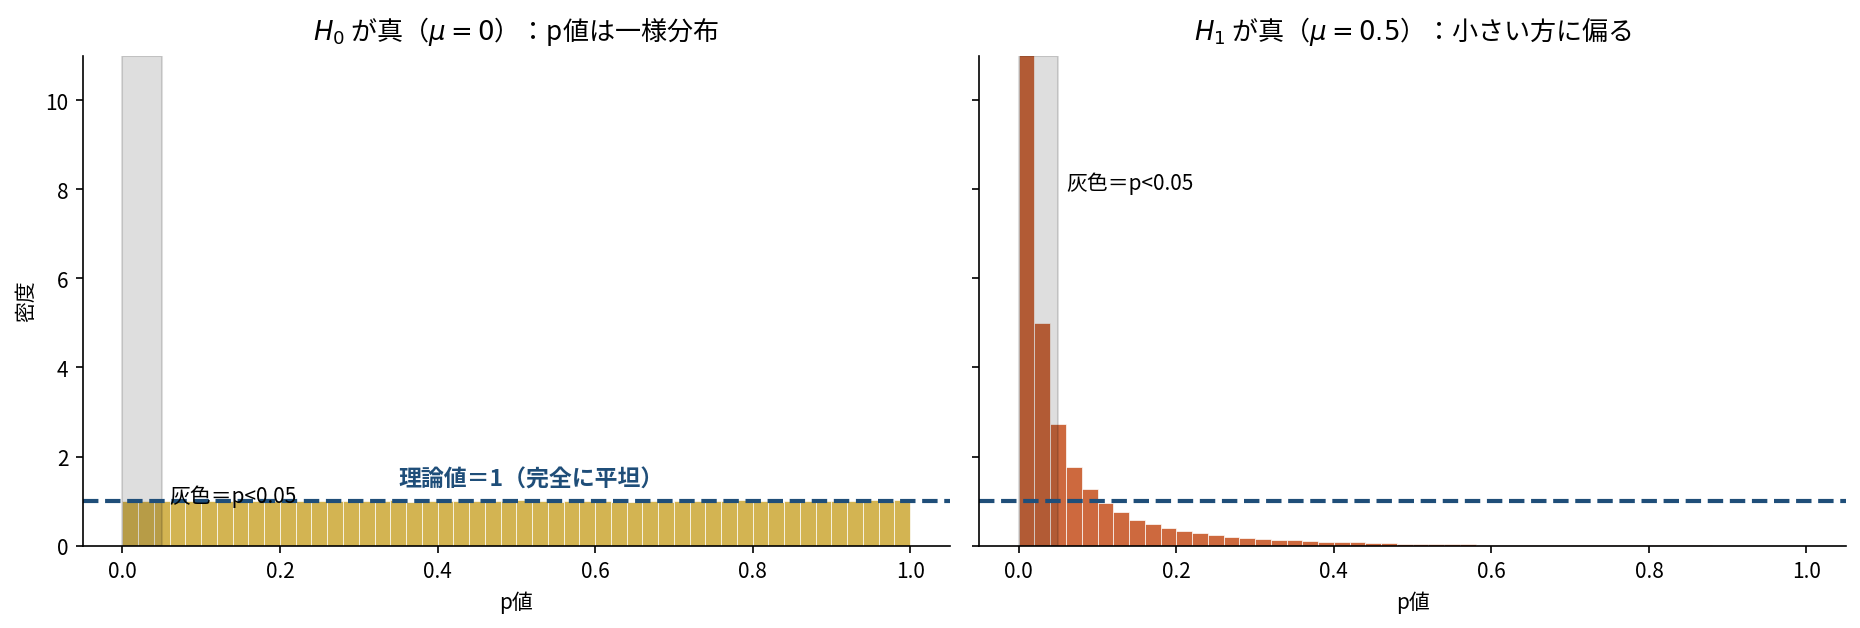
右パネルが対になっています。 が真なら、p値は小さい方に偏る。 つまり検定は「一様分布から小さい方に偏ったかどうか」を見ているだけです。
これが検定の土台です。「 が正しければ、小さいp値は出にくい」という一点だけが根拠になっています。 で運用すれば実際の棄却率は 0.04944、 なら 0.01015 と、設計通りに機能しました。
2. 棄却域は無数にある
「 を守る」という条件だけでは、検定は一つに決まりません。 これは意外でした。
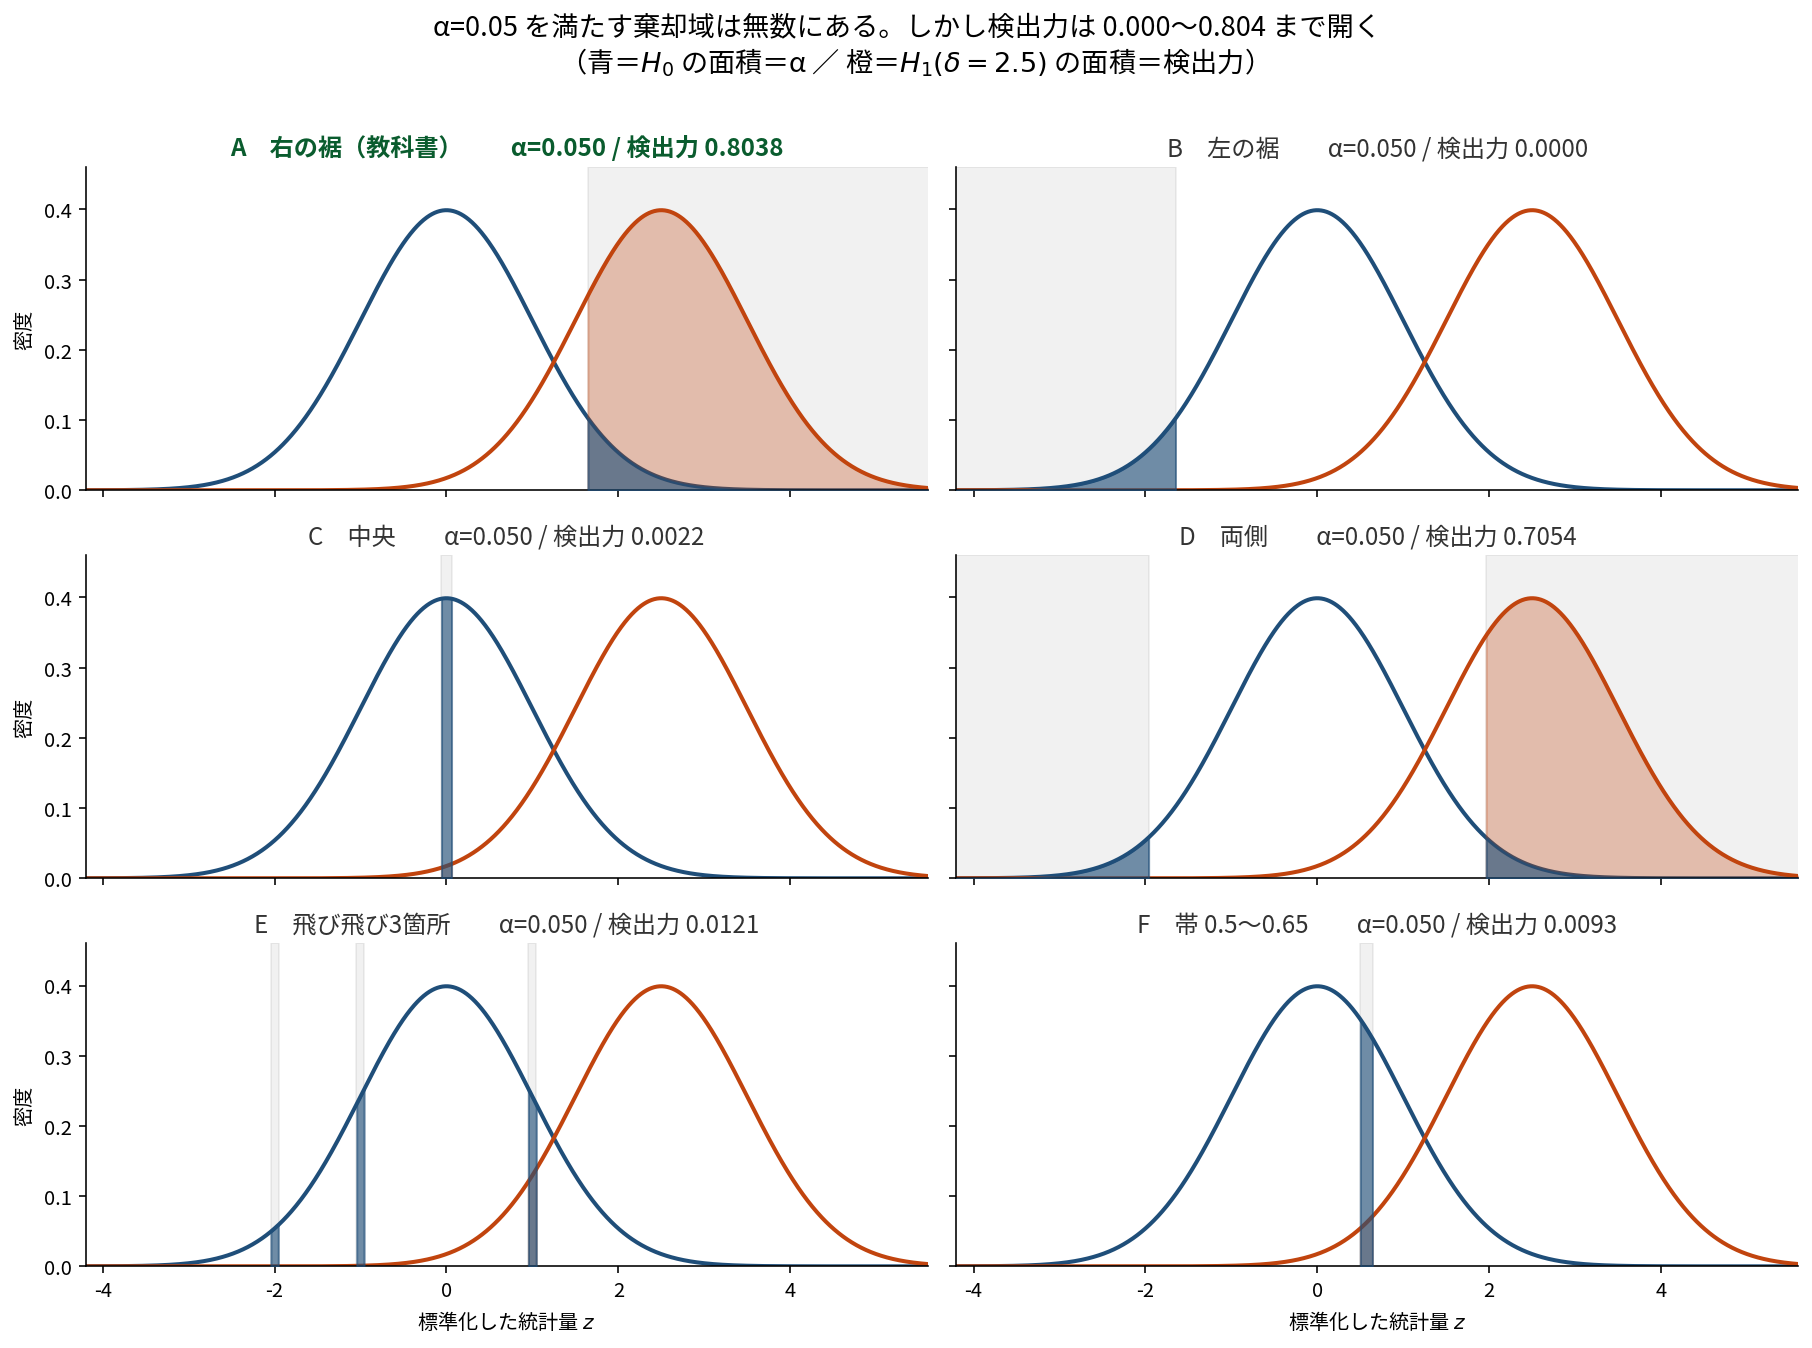
6つの棄却域はすべて を正確に満たしています。それでも検出力は 0.8038 から 0.0000 まで変わりました。 最良のAと最悪のBの間に、検出力が数百倍違う選択肢が並んでいます。
| 棄却域 | 検出力 | |
|---|---|---|
| A. 右の裾 | 0.050 | 0.8038 |
| B. 左の裾 | 0.050 | 0.0000 |
| C. 中央 | 0.050 | 0.0022 |
| D. 両側 | 0.050 | 0.7054 |
| E. 飛び飛びの3箇所 | 0.050 | 0.0121 |
| F. 帯 | 0.050 | 0.0093 |
パネルBは笑ってしまう例です。 が右にあるのに左の裾を棄却域にしているので、検出力がほぼ 0。有意水準は完璧に守っているのに、効果を絶対に見つけられない検定です。
「 を守る」は最低条件にすぎず、その中でどう選ぶかが検定法の設計でした。ここでネイマン・ピアソンの補題が必要になります。
3. ネイマン・ピアソンの補題
何を保証しているのか
質問はこうでした。「最強力」とは何に対して最強なのか。
答えは、「同じ有意水準 を満たすすべての検定の中で、検出力が最大」です。 という予算を固定した上での最適化になっています。
ネイマン・ピアソンの補題
単純仮説 対 において、尤度比 が大きい順に棄却域へ入れていく検定が、水準 の中で検出力最大になる。
総当たりで確かめる
補題を信じる前に、棄却域を全部列挙して総当たりしました。6面のサイコロを1回振る設定なら、棄却域は 通りしかないので全数調査できます。
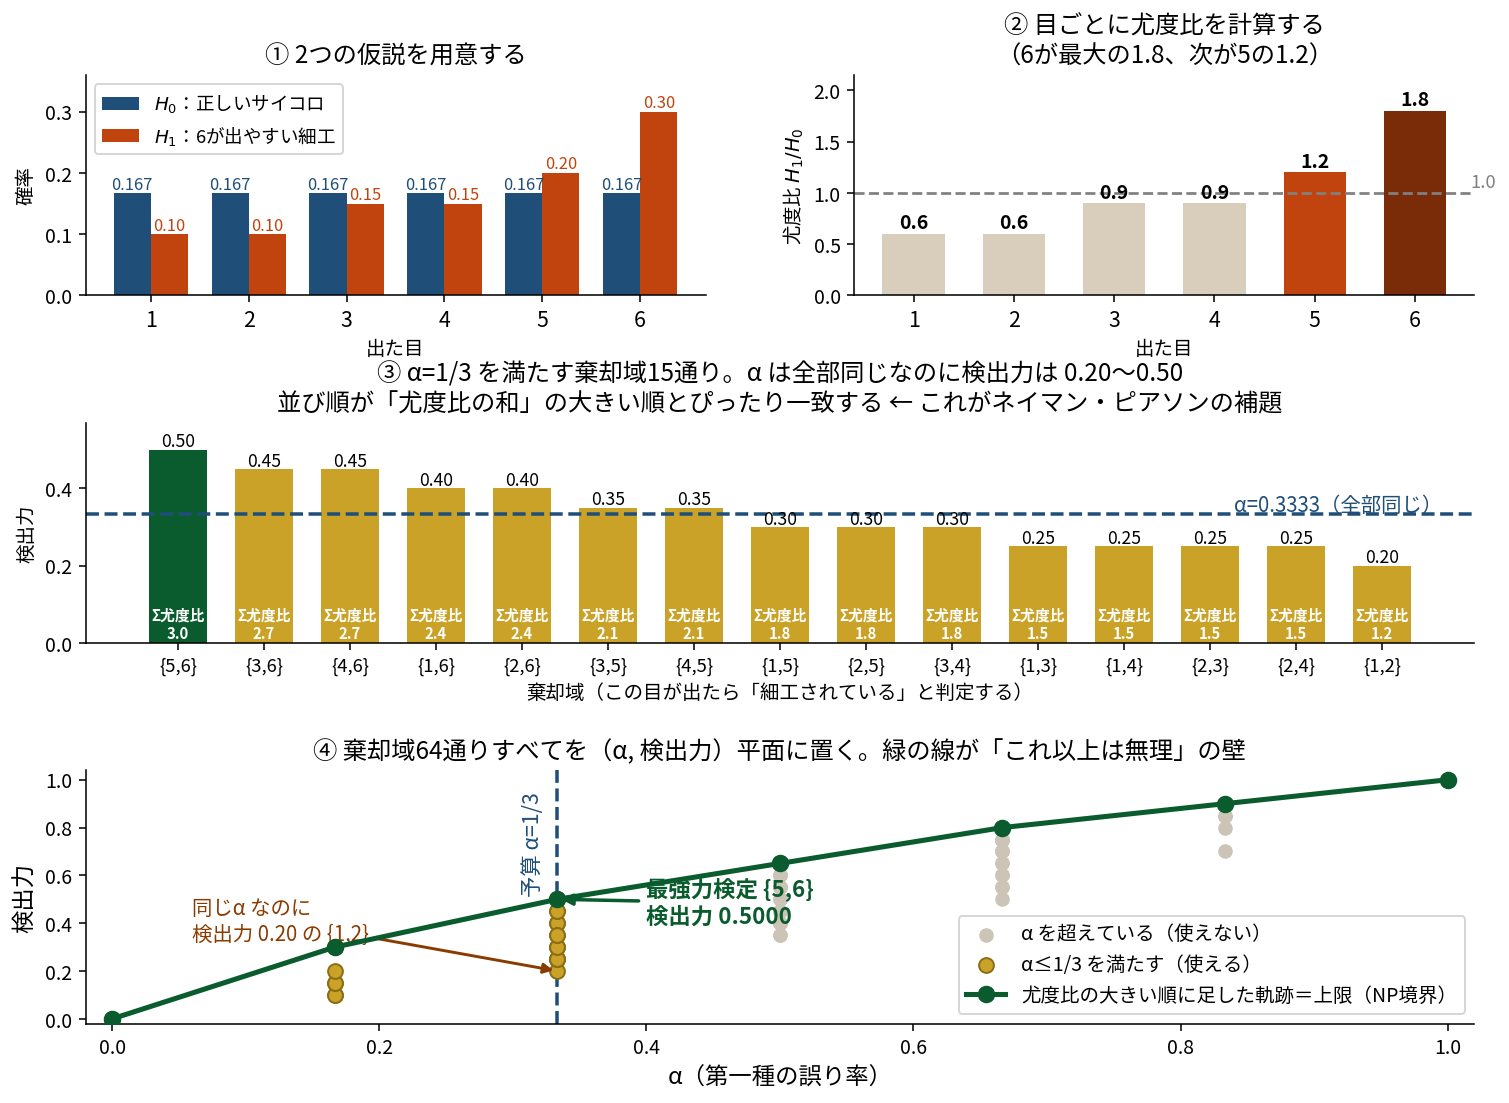
パネル③が核心です。(2つの目を棄却域にする)を満たす15通りを並べると、検出力の順位が尤度比の和の順位と完全に一致しました。最強は で 0.50、最弱は で 0.20。尤度比の大きい目から詰めた組み合わせが勝つという補題の主張そのままです。
パネル④では64通り全部を 平面に置きました。尤度比の大きい順に足していった点列が、他のすべての点の上を通る境界線になっています。 これが「最強力」の意味でした。到達不可能な領域があり、その壁がNP検定です。
尤度比で切ると裾になる
尤度比を閾値で切ると、なぜ「裾」が棄却域になるのか。
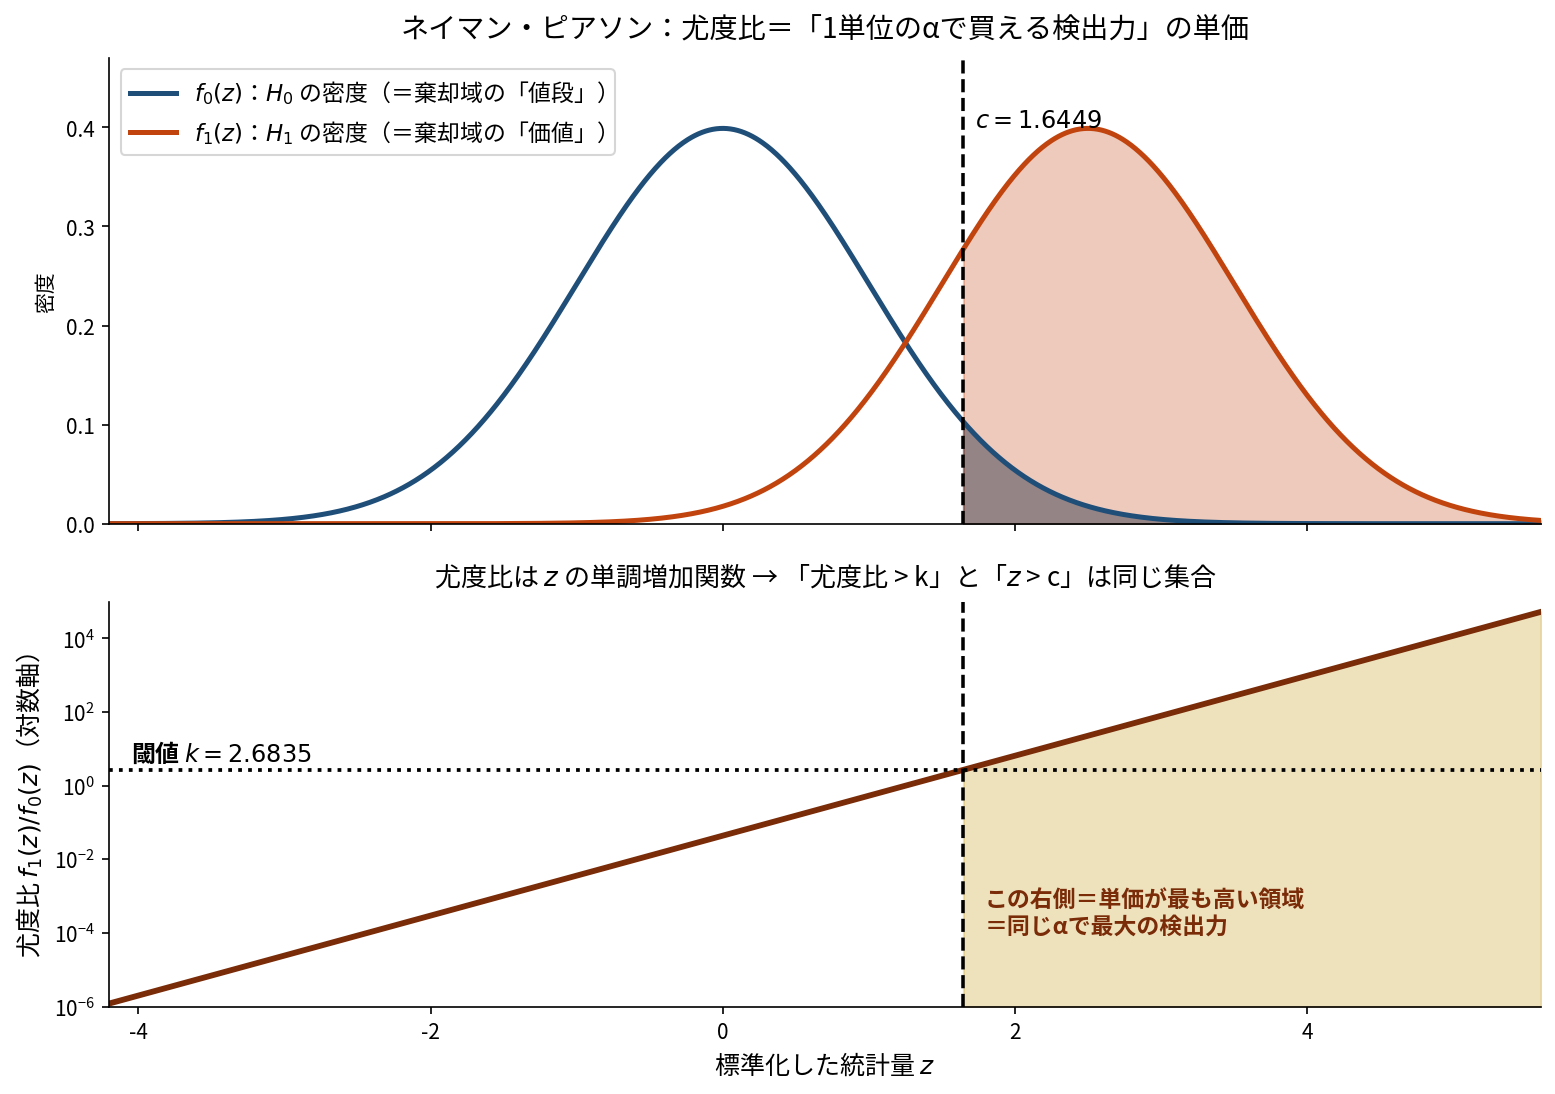
正規分布で平均だけが違う場合、尤度比は の単調増加関数になります。だから「尤度比が より大きい」は「 が より大きい」と同じ条件です。裾を棄却域にするのは慣習ではなく、尤度比を大きい順に取った結果でした。
逆に言えば、尤度比が単調でない問題では裾が最適にならないことになります。ここは重要な条件付きです。
なお補題そのものは単純仮説どうしの話です。 のような片側の複合仮説に橋を架けるのが単調尤度比(monotone likelihood ratio、MLR)とカーリン・ルービンの定理で、「尤度比が の単調関数」という上の性質がまさにその条件でした。だから正規分布の片側検定では、裾を棄却域にする検定が のどの に対しても一斉に最強力になります(一様最強力検定)。
またサイコロ例で をちょうど達成できたのは偶然です。離散分布では任意の をぴたりと満たす棄却域が存在しないので、厳密な最強力性を言うには境界でコインを投げる(ランダム化)操作が必要になります。図④の点列が階段状になっているのは、この到達できない隙間の現れでした。
4. 尤度比検定は個別の検定を含んでいる
t検定は尤度比検定そのもの
「t検定は尤度比検定の特殊ケースなのか」という質問を確かめました。そうでした。
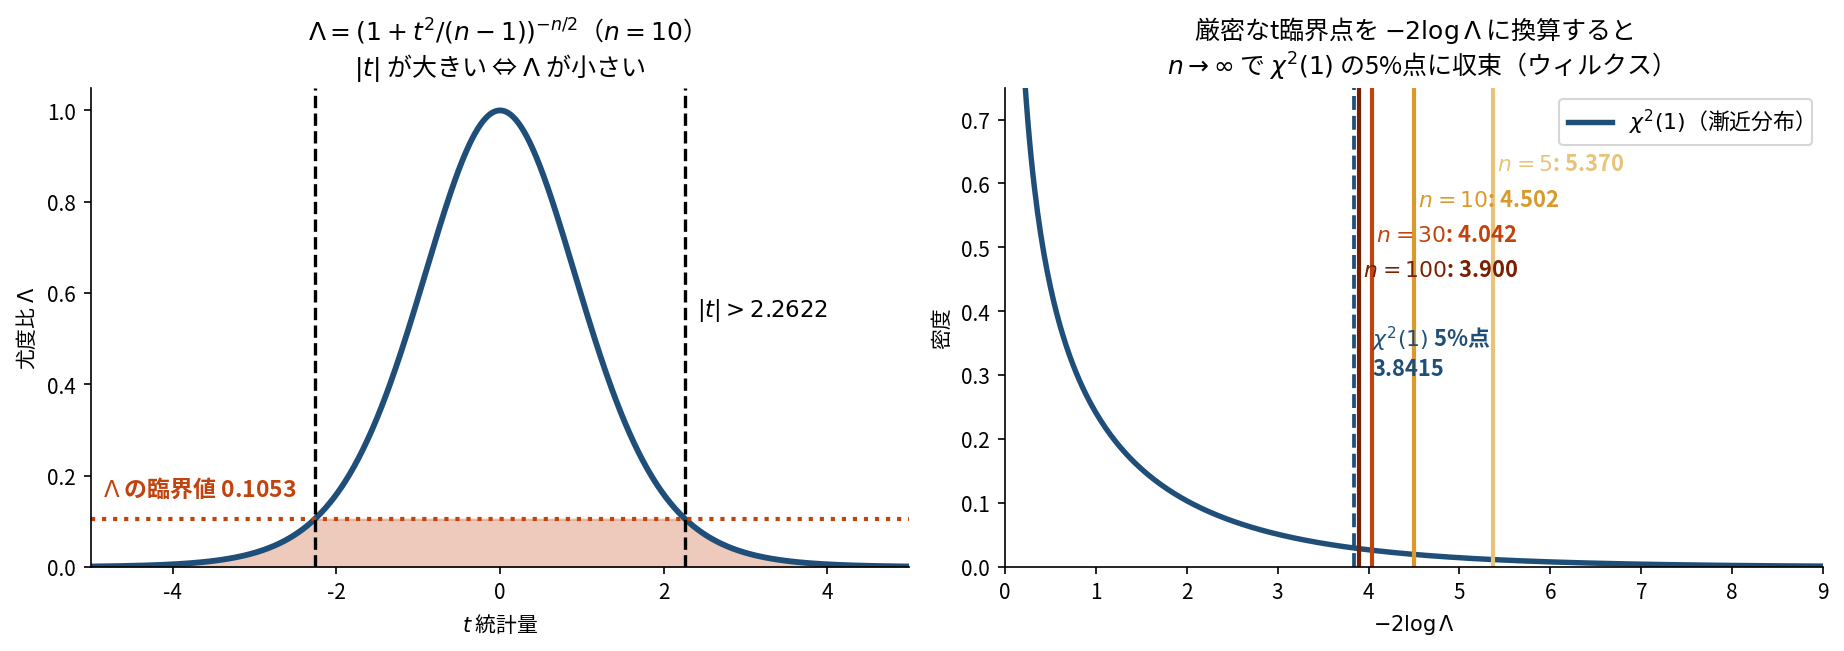
左パネルが決定的です。尤度比 は の単調減少関数なので、「 が小さい」と「 が大きい」は同じ条件になります。棄却域が完全に一致するので、t検定と尤度比検定は同じ検定です。
ただしピアソンのχ²適合度検定は尤度比検定ではありません。 あちらは後述のスコア検定として導かれ、尤度比版は という別の統計量になります。漸近的には同じ に乗りますが、値も棄却域も一致しません。「教科書に並ぶ検定は、少数の型の使い回し」という見立ては正しく、その型が1つではなく3つあったわけです。
一般化尤度比検定
単純仮説どうしでなく、 や に自由なパラメータが残る場合は、それぞれで最尤推定してから比べます。
は「 で縛ったパラメータの本数」です。この漸近分布がウィルクスの定理です。
中身の違う4モデルで検算する
「どんなモデルでも になる」という主張が本当なのか、まったく別のモデル4つで実測しました。
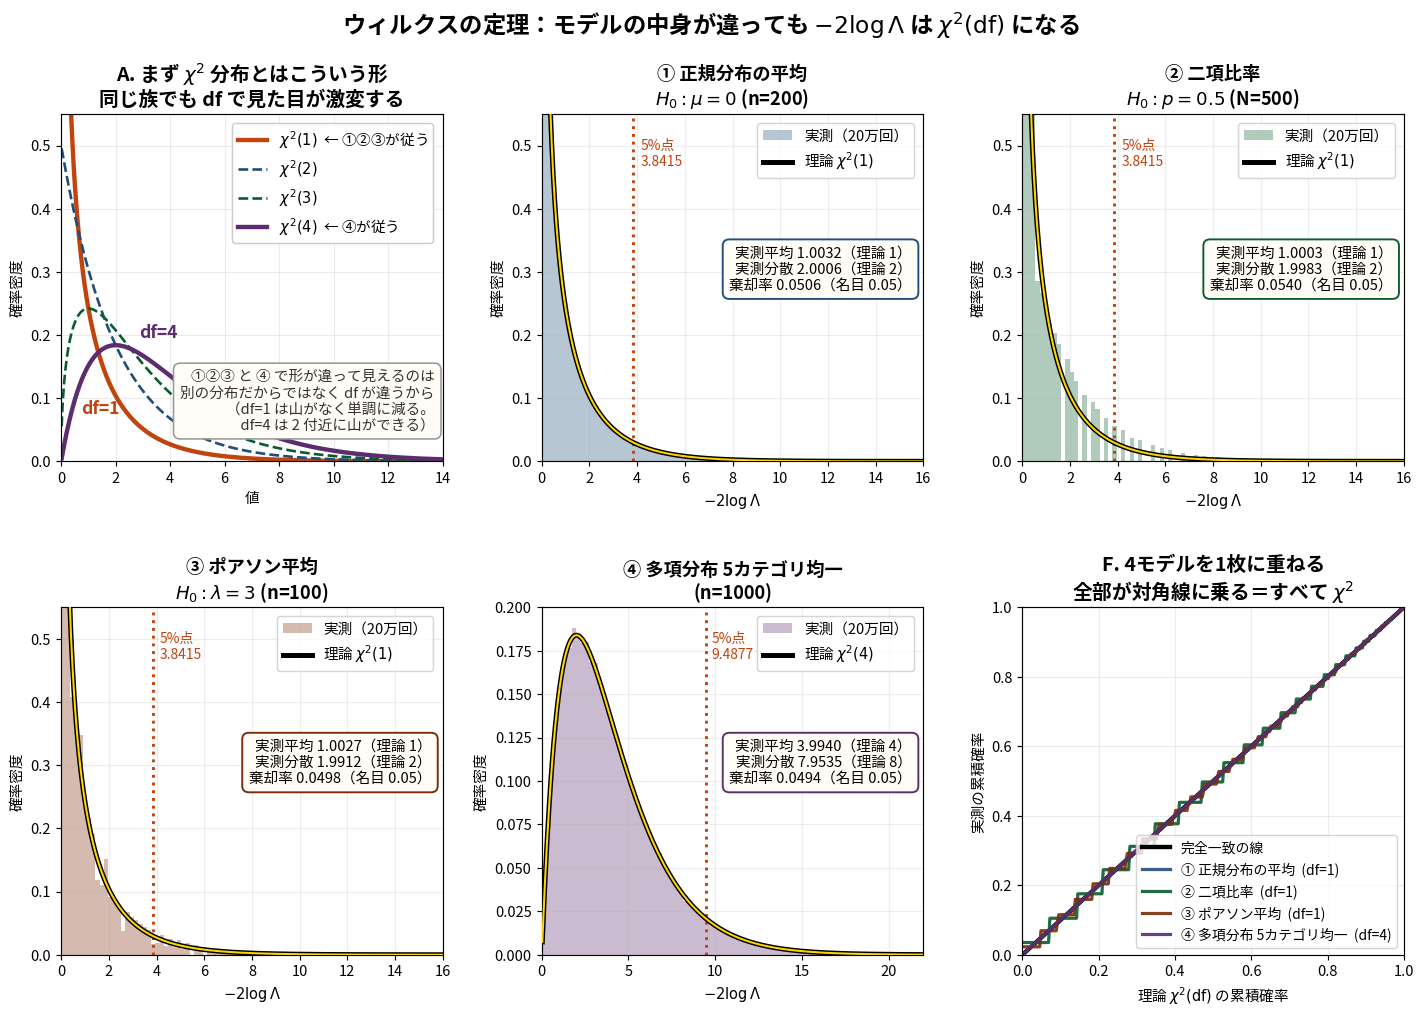
先にパネルAを見てください。 分布は自由度で形が激しく変わります。 は山がなく 0 付近から単調に減り、 は 2 付近に山ができます。この予備知識がないと、①②③と④が「別の分布」に見えてしまいます(筆者は実際にそう見えて混乱しました)。
| モデル | 縛った本数 | 実測平均 | 実測分散 | 棄却率 |
|---|---|---|---|---|
| ① 正規分布の平均(=200) | 1 | 1.0032 | 2.0006 | 0.0506 |
| ② 二項比率 =0.5(=500) | 1 | 1.0003 | 1.9983 | 0.0540 |
| ③ ポアソン平均 =3(=100) | 1 | 1.0027 | 1.9912 | 0.0498 |
| ④ 多項分布5カテゴリ(=1000) | 4 | 3.9940 | 7.9535 | 0.0494 |
の平均は 、分散は です。①②③は 1 と 2、④は 4 と 8 にきれいに乗りました。パネルFのP-Pプロットは形の違いに影響されない確認方法で、4本すべてが対角線に重なっています。
縛った本数だけで自由度が決まり、モデルの中身は関係ない。( が正しいときの話です。また真値がパラメータ空間の内点にある、識別可能、対数尤度が滑らか、といった正則条件が要ります。 のように が境界上にある場合は極限が になりません。) これがウィルクスの定理の威力でした。
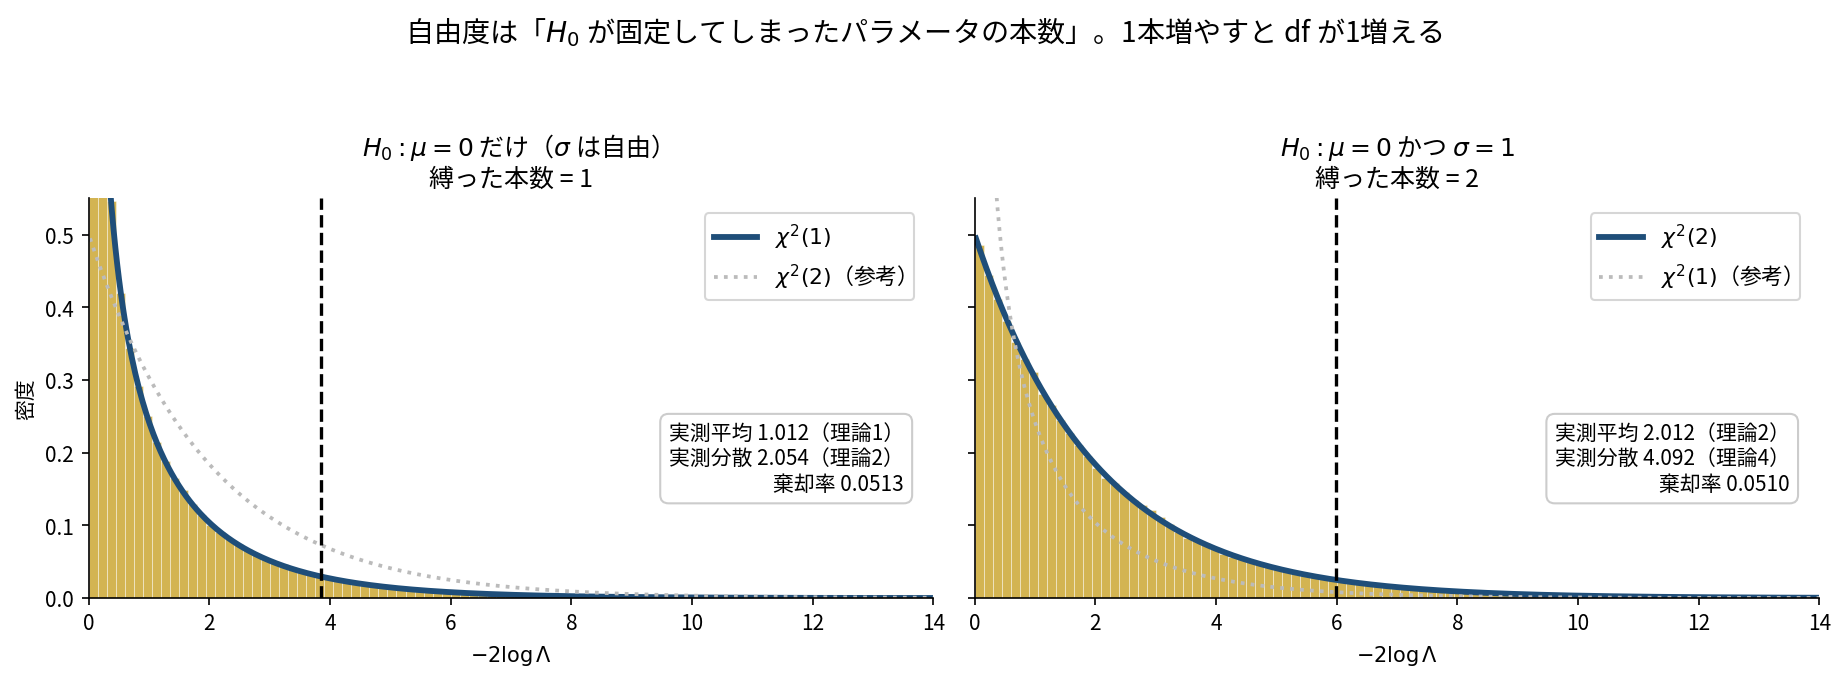
同じ正規分布のモデルでも、 で縛る本数を1本から2本に変えると自由度が1から2に動きます。 自由度は「モデルの複雑さ」ではなく「 が課した制約の本数」でした。
小標本では使えない
ただし漸近の定理なので、小標本では成り立ちません。
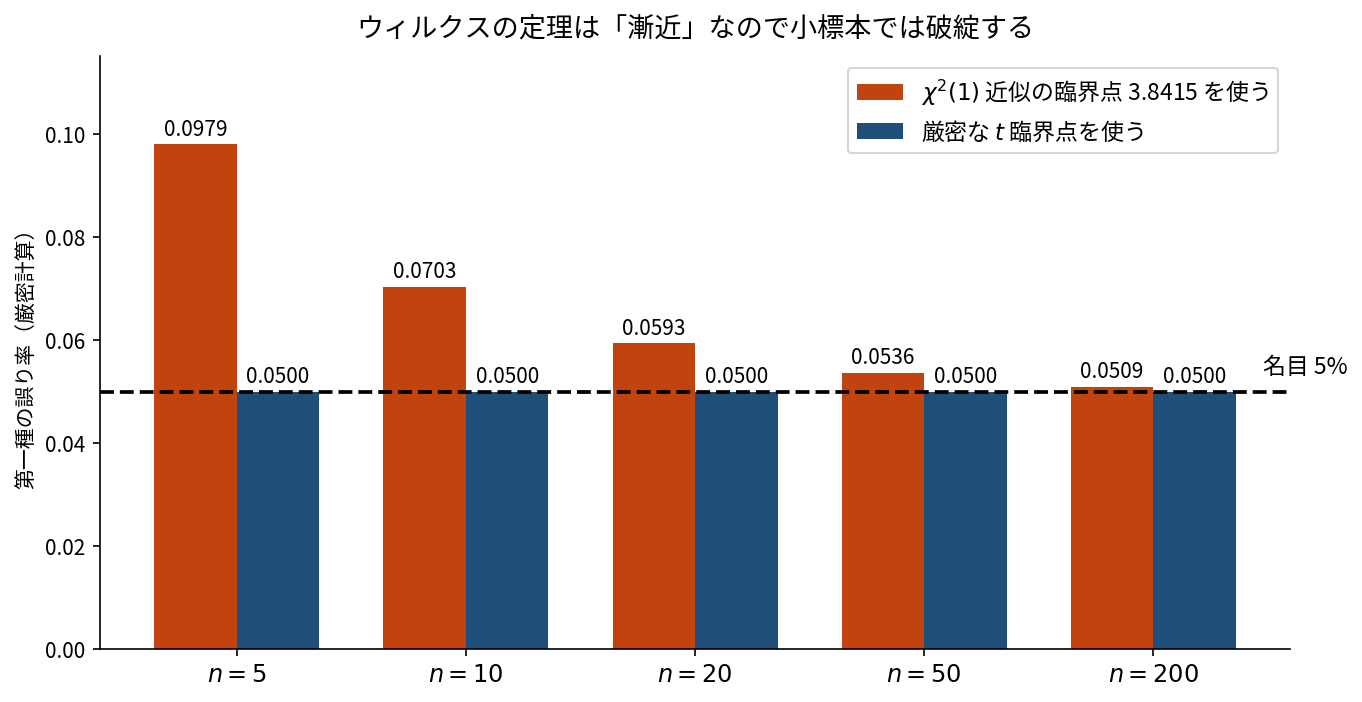
で の臨界点 3.8415 を使うと、実際の第一種の誤り率は 0.0979 ── 名目5%の2倍です。厳密なt臨界点を使えば 0.0500 で正確です。
だから小標本ではt分布を使う。 「t検定は尤度比検定と同じ」と言いながらt分布の表が必要な理由がここでした。棄却域の形は同じでも、臨界値の精度が違うのです。
5. ワルド・スコア・尤度比 ── 同じ曲線の測り方3種
次の疑問はこれでした。答えが同じなら1つでいいのに、なぜ3つあるのか。
1本の曲線を違う場所で測っている
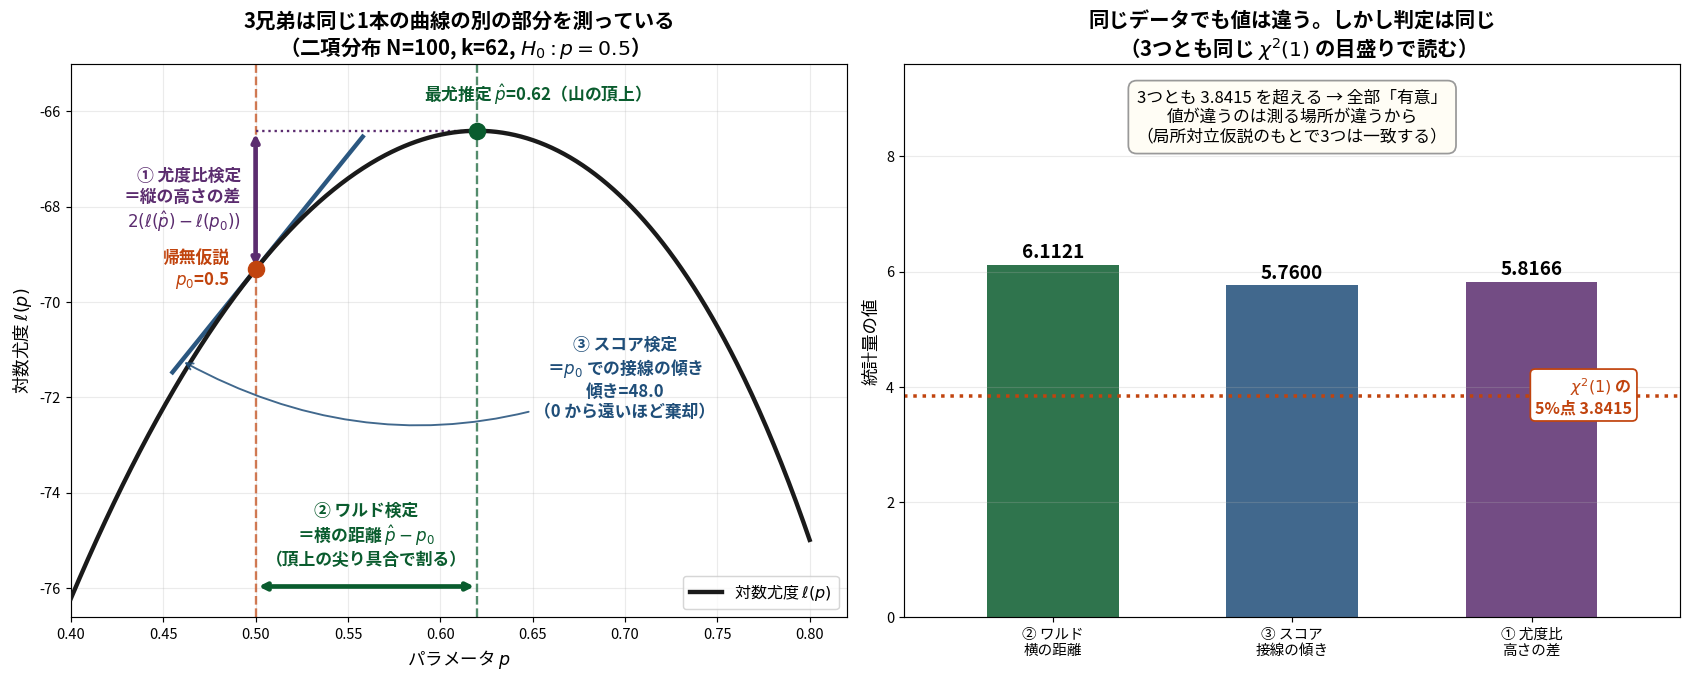
これが3つの定義そのものの図です。題材は二項分布(100回中62回成功、)。曲線は対数尤度 で、山の頂上が最尤推定 です。
- ① 尤度比(縦の矢印) … 頂上の高さ と での高さ の差。「 を信じるとどれだけ尤度を損するか」
- ② ワルド(横の矢印) … と の横方向の隔たり。距離のままでは単位が残るので、頂上の尖り具合(フィッシャー情報量)で割って無次元化します。尖った山なら少しのずれも致命的、平たい山なら同じずれも許容範囲という調整です
- ③ スコア(接線) … における接線の傾き。頂上では傾きが 0 なので、傾きが 0 から遠い= は頂上から外れているという論法。ここでは傾き 48.0 で、これを での情報量 で割って が統計量です
第10回で「フィッシャー情報量は対数尤度の山の尖り具合」と書きました。その尖り具合が、ここでワルド統計量の分母として使われています。 情報量の使い道がもう一つ増えました。
| 検定 | 測るもの | 必要な当てはめ | 統計量 | p値 |
|---|---|---|---|---|
| ① 尤度比 | 縦の高さの差 | と の両方 | 5.8166 | 0.01588 |
| ② ワルド | 横の距離 | だけ | 6.1121 | 0.01343 |
| ③ スコア | 接線の傾き | だけ(最尤推定が不要) | 5.7600 | 0.01640 |
同じデータでも値が違います。測る場所が違うのだから当然です。それでも3つとも の目盛りで読み、全部 3.8415 を超えて同じ結論になりました。
「必要な当てはめ」の列が実務上の分かれ目です。
- スコアは最尤推定が要らない。 だからピアソンの適合度検定はスコア検定として導けます( の期待度数だけで計算が済む)
- ワルドは を変えても再計算が要らない。 回帰分析の出力に各係数のp値が並ぶのはこれが理由です
- 尤度比は2回当てはめるので手間がかかる。 その代わりパラメータの取り方を変えても値が不変という強い性質を持ちます
「漸近同等」は局所対立仮説での話
教科書は「3つは漸近同等」と書きます。ところが効果量を固定したまま を増やしても、差は縮みませんでした。
| ワルド | スコア | 尤度比 | ワルド/尤度比 | |
|---|---|---|---|---|
| 100 | 6.1121 | 5.7600 | 5.8166 | 1.0508 |
| 1600 | 97.7929 | 92.1600 | 93.0658 | 1.0508 |
| 25600 | 1564.6859 | 1474.5600 | 1489.0524 | 1.0508 |
比が 1.0508 のまま収束しません。 ここは筆者が引っかかった点で、原因は設定が悪いことでした。効果量を固定して を増やすのは「 から一定の距離を保ったまま情報を増やす」ことなので、統計量は に発散します。 から遠い領域では対数尤度が放物線から大きく外れるので、3つの測り方の差が残るのです。
漸近同等が主張しているのは「 の近く」の話でした。正確には局所対立仮説 ── 効果量が で縮んでいく設定で成り立ちます。
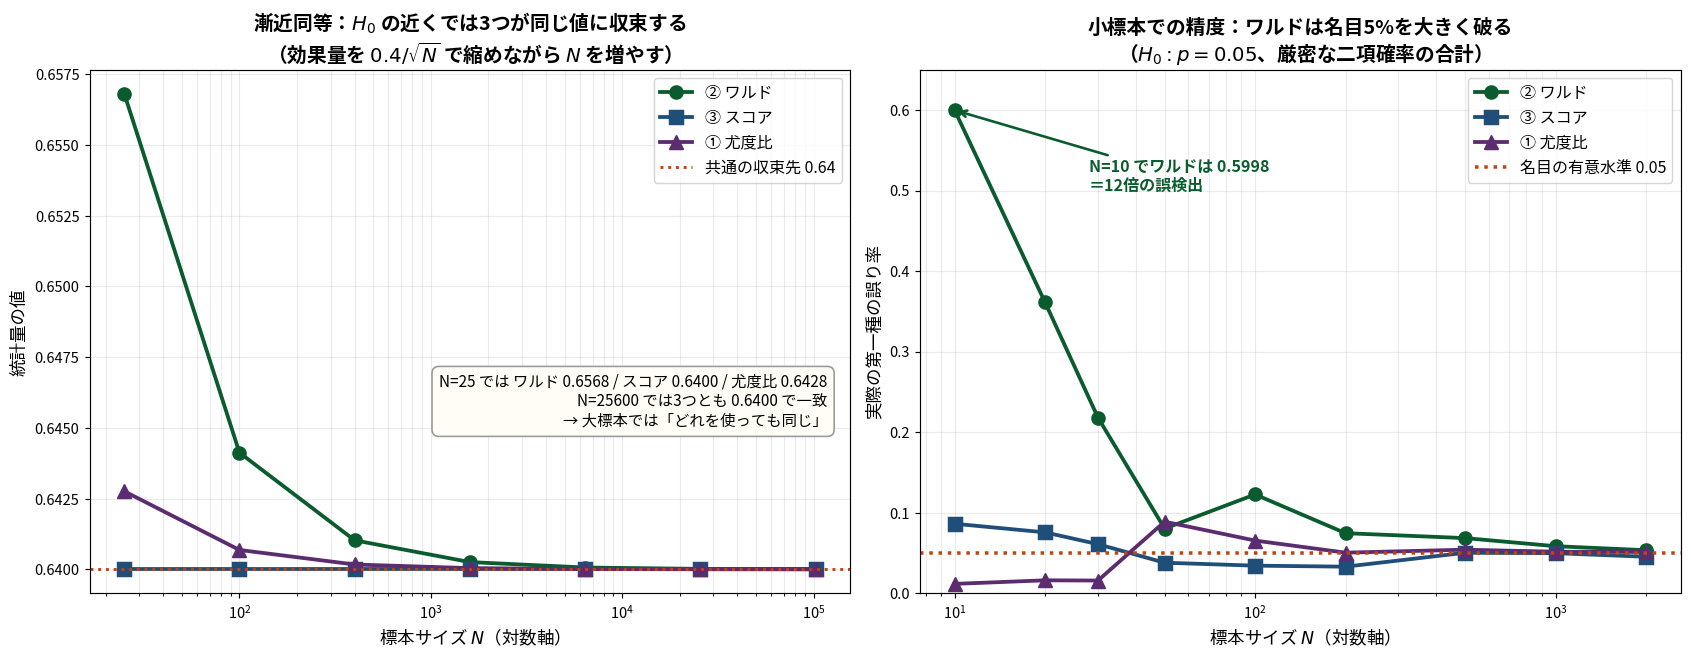
効果量を で縮めながら を増やすと、3本が同じ 0.6400 に収束しました。 では 0.6568 / 0.6400 / 0.6428 と差がありますが、 で完全一致です。
だから大標本では「どれを使っても同じ」で、小標本では差が出る。 ここが選択の分岐点になります。
小標本での精度差
のもとで、実際の第一種の誤り率を厳密な二項確率の合計で計算しました(シミュレーションではありません)。
| =10 | =20 | =50 | =200 | =1000 | |
|---|---|---|---|---|---|
| ② ワルド | 0.5998 | 0.3611 | 0.0801 | 0.0744 | 0.0583 |
| ③ スコア | 0.0861 | 0.0755 | 0.0378 | 0.0328 | 0.0496 |
| ① 尤度比 | 0.0115 | 0.0159 | 0.0887 | 0.0502 | 0.0514 |
でワルドは 0.5998 ── 名目5%の12倍です。逆に尤度比は で 0.0115 と保守的すぎ、 では 0.0887 まで跳ねます。3つの優劣は と で入れ替わるので、「常にこれが正しい」という順位はありません。理由は明快で、分散を で推定しているためです。 が偶然小さく出ると推定分散も小さくなり、統計量が過大になります。スコアは での分散を使うので、 を検定している最中はその値が正しいのです。
なおワルドの 0.5998 の内訳は、(1回も起きない)が 0.5987、 が 0.0011 です。 では で推定分散が 0 になり、統計量が計算できません。ここを「棄却」として数えた結果がこの数字で、破綻の大半は極限ケースそのものです。 を棄却しない扱いにすれば 0.0011 と極端に保守的になり、いずれにしても名目5%からは大きく外れます。
なお では3つの棄却域が整数 のレベルで完全に一致してしまい差が出ません( なら3つとも または で棄却)。比較には をずらす必要がありました。
どの場面でどれを使うのか
「必要な計算が違う」だけでは選べないので、結論が実際に食い違う場面を並べました。
ケース1:大標本のA/Bテスト(CVR 2.00% vs 2.30%、各群2万人)
| 検定 | 統計量 | p値 |
|---|---|---|
| ② ワルド | 4.2785 | 0.03860 |
| ③ スコア | 4.2780 | 0.03861 |
| ① 尤度比 | 4.2814 | 0.03853 |
p値の差は小数第5位。 実務の大半はこれです。だから現場で 検定とχ²検定と尤度比検定が混在していても誰も困りません。
ケース2:抜取検査(30個中1個が不良、)
期待不良数3個に対して観測1個。統計的には「まだ何も言えない」場面です。
| 検定 | 統計量 | p値 | 判定 |
|---|---|---|---|
| ② ワルド | 4.1379 | 0.04193 | 棄却(改善したと結論) |
| ③ スコア | 1.4815 | 0.22354 | 棄却しない |
| ① 尤度比 | 1.9474 | 0.16287 | 棄却しない |
ワルド区間は [−0.0309, 0.0976]。下限が負なのに 0.10 を含まないので「有意に改善」と読めてしまいます。ウィルソン区間は [0.0059, 0.1667] で正しく 0.10 を含みました。
不良率・離脱率・副作用発生率のように が 0 に近く標本も小さい場面が、実務で一番危ない場所です。
ケース3:完全分離(パネルA)
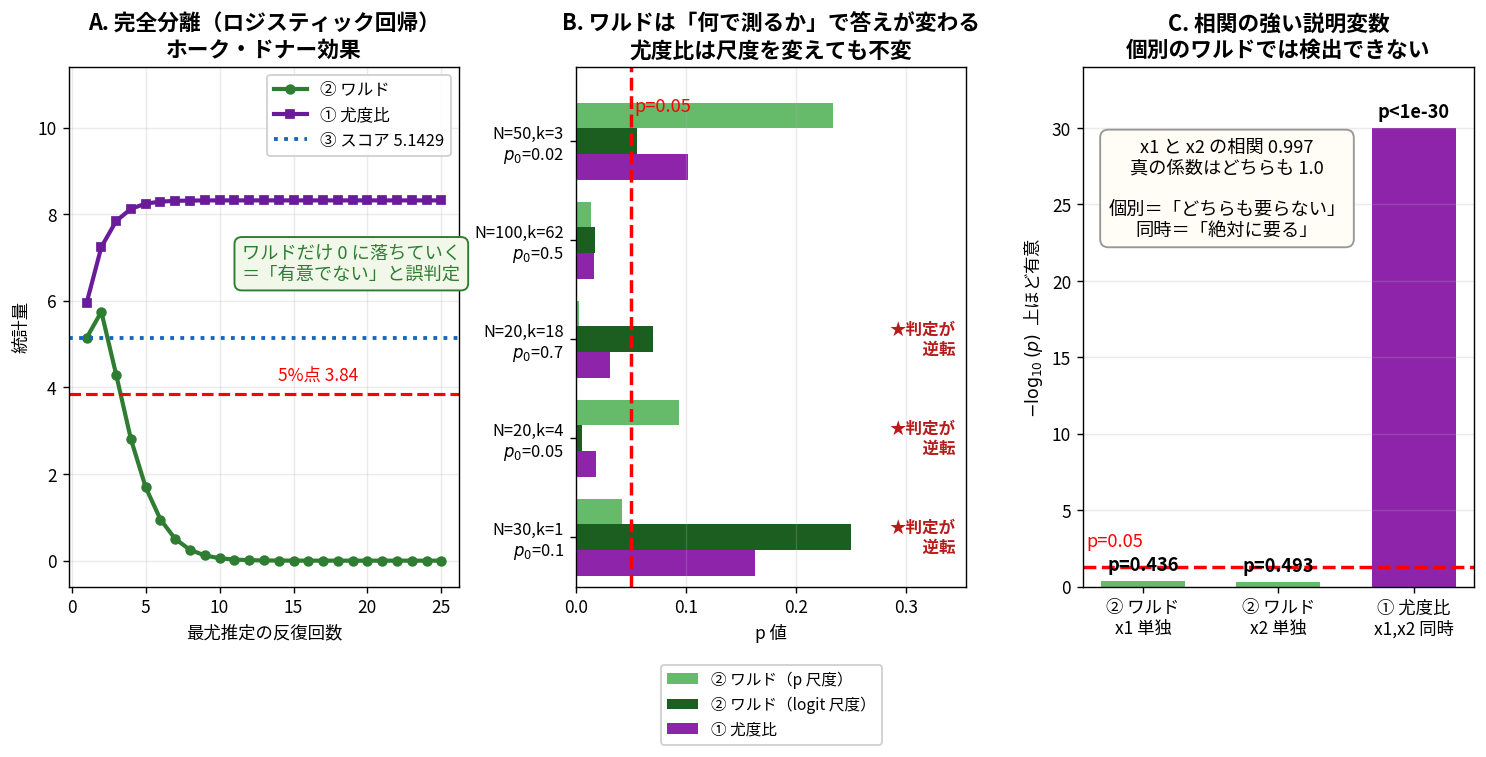
ロジスティック回帰で、説明変数の値だけで結果が完全に予測できてしまう場合です。最尤推定が発散するので反復のたびに傾き が大きくなりますが、標準誤差はもっと速く大きくなるので比 が小さくなっていきます。反復2回目で 5.75 だったワルド統計量が、20回目には 0.0000。
「効果が強すぎると有意でなくなる」という倒錯した挙動で、これがホーク・ドナー効果(Hauck–Donner effect)です。尤度比は 8.3178 で頭打ちながら棄却側を保ち、スコアは で評価するので発散に巻き込まれません。データが少なく群がきれいに分かれる医学研究などで実際に起こります。
この現象は完全分離だけの話ではなく、次のケース4(尺度依存)と根が同じです。オッズ比(logit)の尺度でワルド統計量を計算すると、、 の二項比率でも をピークに で 8.24 へ減少します。 が極端になるほど「横の距離」は伸びるのに、分母の がそれ以上の速さで縮むためです。ワルドが何を「距離」と呼ぶかに依存する現象なのでした。
ケース4:尺度依存(パネルB)
同じデータ・同じ帰無仮説でも、比率 で測るか logit で測るかでワルドのp値が変わります。5例中3例で 0.05 をまたいで判定が逆転しました。、、 では 0.0935(棄却しない)が 0.0053(強く棄却)に化けます。
尤度比はこの問題が原理的に起きません。対数尤度の「高さの差」は座標の取り方に依存しないからです(パラメータ変換不変性)。ワルドは「横の距離」を測るので、横軸の目盛りを取り替えると距離も変わります。オッズ比で報告するか比率で報告するかは本来ただの表記の選択なのに、それが結論を変えてしまうのは深刻です。
ケース5:相関の強い説明変数(パネルC)
と の相関 0.997、真の係数はどちらも 1.0(両方とも本当に効いている)。それでも個別のワルド検定は と で「どちらも要らない」と言います。 を落としても が代役を務められるので、「この変数を1つだけ抜く」という問いへの答えが両方とも「抜いてよい」になるためです。
2変数を同時に検定する尤度比は 。回帰分析の出力に並ぶ個別p値だけを見て変数選択すると、両方消してモデルを壊します。
| 場面 | 推奨 | 理由 |
|---|---|---|
| 大標本・比率が極端でない | どれでもよい | p値が小数第5位まで一致する |
| 回帰係数を一覧で見たい | ② ワルド | 再当てはめが不要。ソフトの標準出力 |
| 小標本/ が 0 付近 | ③ スコア | 分散を で評価するので水準を守る |
| 全敗・全勝/完全分離 | ③ スコア | ワルドは分散0や発散で計算不能・誤判定 |
| オッズ比など尺度を変換して報告 | ① 尤度比 | 変換で値が変わらない |
| 複数の変数をまとめて落とすか判断 | ① 尤度比 | 個別ワルドは相関で共倒れする |
| モデル選択・入れ子モデルの比較 | ① 尤度比 | 逸脱度差がそのまま統計量になる |
迷ったら尤度比、比率の小標本ならスコア、ソフトの出力を読むだけならワルド。 ワルドが実務で最も普及しているのは統計的に優れているからではなく、計算が1回で済むからでした。
6. 信頼区間と検定は同じもの
「信頼区間に 0 が入らなければ有意」という関係が常に成り立つのかを確かめました。答えは条件つきで成り立つです。
双対性
信頼区間とは、その検定で棄却されない を全部集めた集合である。したがって「 が区間の外 その検定で棄却」は定義の言い換えであって、区間と検定が同じ統計量から作られている限り例外なく成立する。
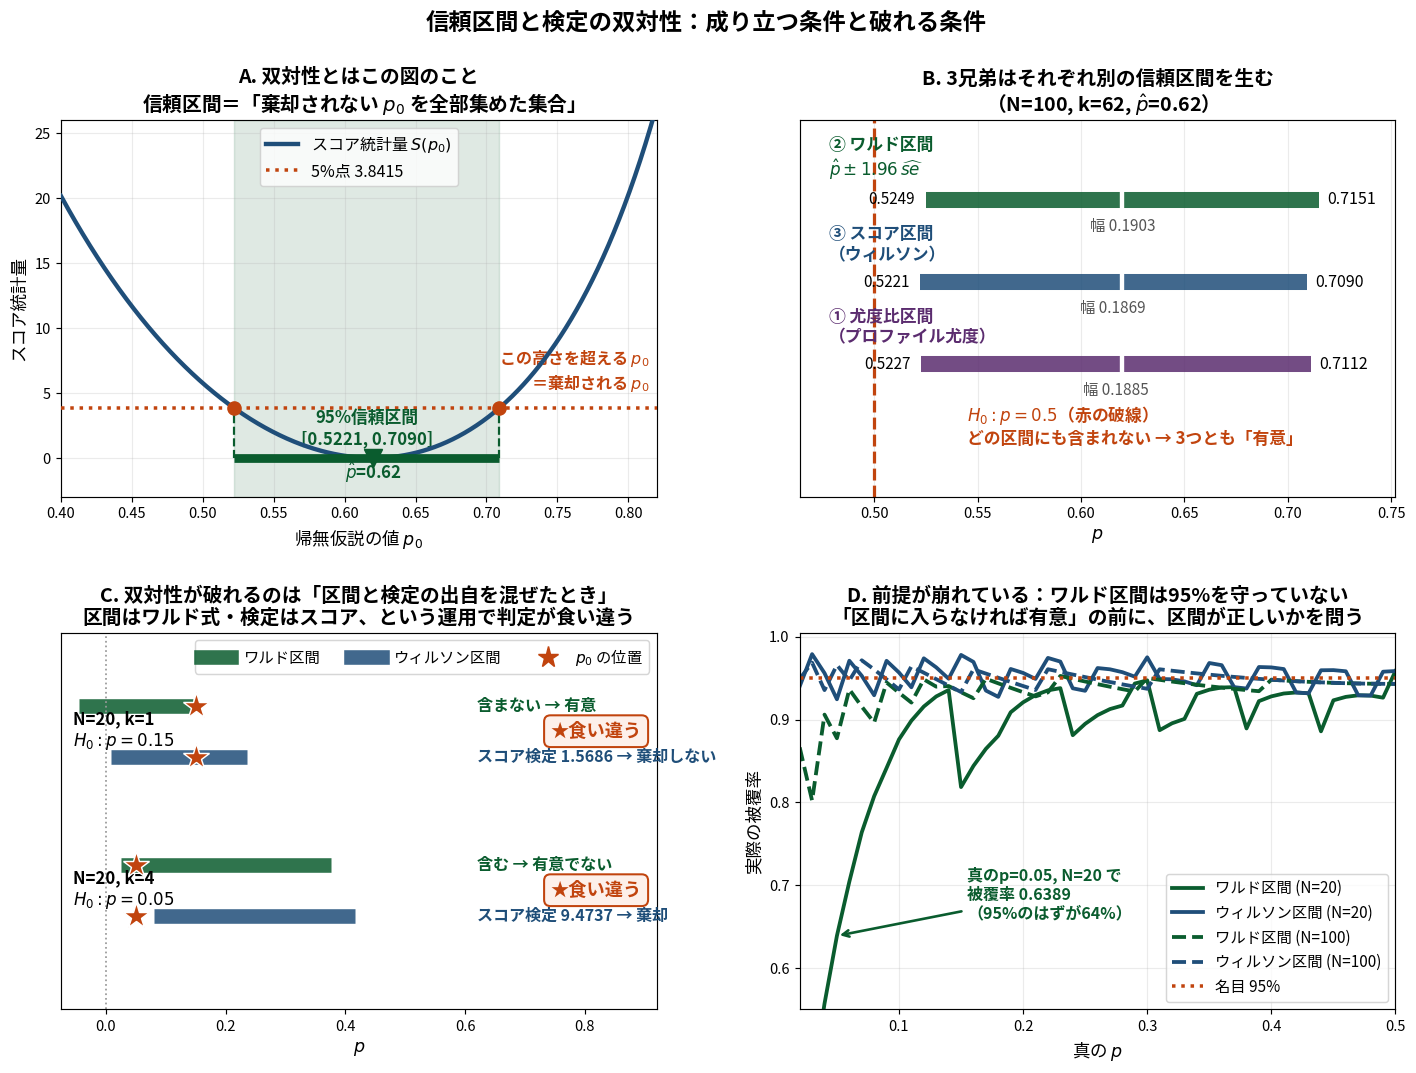
パネルAが双対性の定義そのものの図です。 横軸は「 として何を立てるか」。スコア統計量を の関数として描くと の真下で 0 になる谷型になり、この曲線が 5%点 3.8415 より下にある の範囲=棄却されない の集合=それがそのまま信頼区間です。区間を「作る」というより棄却されない領域を読み取っているだけだと分かります。
3兄弟はそれぞれ別の区間を生みます(パネルB)。
| 区間 | 範囲 | 幅 | 対応する検定 |
|---|---|---|---|
| ワルド | [0.5249, 0.7151] | 0.1903 | ワルド検定 |
| ウィルソン | [0.5221, 0.7090] | 0.1869 | スコア検定 |
| プロファイル尤度 | [0.5227, 0.7112] | 0.1885 | 尤度比検定 |
ウィルソン区間はスコア検定を反転したもの、プロファイル尤度区間は尤度比検定を反転したものでした。名前で暗記していた区間が、検定と一対一で対応していたのです。
を 0.005 刻みで全点走査したところ、同じ統計量から作った区間と検定は 199/199 点すべてで一致しました。例外はありません。
破れるのは方法を混ぜたとき
しかし区間と検定の出自を混ぜると食い違います(パネルC)。「区間は教科書のワルド式、検定は 検定(=スコア)」という現実によくある組み合わせで、両方向の食い違いが実在しました。
| データ | ワルド区間 | 区間の判定 | スコア検定 | 検定の判定 | |
|---|---|---|---|---|---|
| =20, =1 | =0.15 | [−0.0455, 0.1455] | 含まない → 有意 | 1.5686 | 棄却しない |
| =20, =4 | =0.05 | [0.0247, 0.3753] | 含む → 有意でない | 9.4737 | 棄却 |
1件目は区間の下限がマイナスになっている点にも注目してください。確率が負になる区間を出す式を使っているのです。 では のうち6通りで区間が からはみ出しました。
そもそも被覆率が足りていない
さらに手前の問題があります(パネルD)。ワルド区間は 95% を守っていません。
| 真の | ワルド =20 | ウィルソン =20 | ワルド =100 | ウィルソン =100 |
|---|---|---|---|---|
| 0.05 | 0.6389 | 0.9245 | 0.8775 | 0.9659 |
| 0.10 | 0.8760 | 0.9568 | 0.9324 | 0.9364 |
| 0.20 | 0.9208 | 0.9563 | 0.9331 | 0.9405 |
| 0.50 | 0.9586 | 0.9586 | 0.9431 | 0.9431 |
真の 、 で被覆率 0.6389 ── 95%のはずが64%です。
「区間に入らなければ有意」を使う前に、その区間が名目の信頼度を持っているかを問う必要があるのでした。二項比率のワルド区間は「方法を混ぜる」と「被覆率が足りない」の両方に該当する要注意ケースです。
7. 多重比較 ── 何を守りたいのかで手法が決まる
「20個検定すれば3回に2回は何か有意になる」という話は第2回で扱いました。ここではその先、どう補正するのか、手法の違いは何なのかに進みます。
守りたいものが2種類ある
- FWER(family-wise error rate、族全体の誤り率)… 個の検定のうち1つでも偽陽性が出る確率
- FDR(false discovery rate、偽発見率)… 棄却したもののうち偽陽性が占める割合
ボンフェローニとホルムは FWER を守り、BH法(ベンジャミニ・ホッホバーグ法)は FDR を守ります。 目的が違うので優劣ではありません。
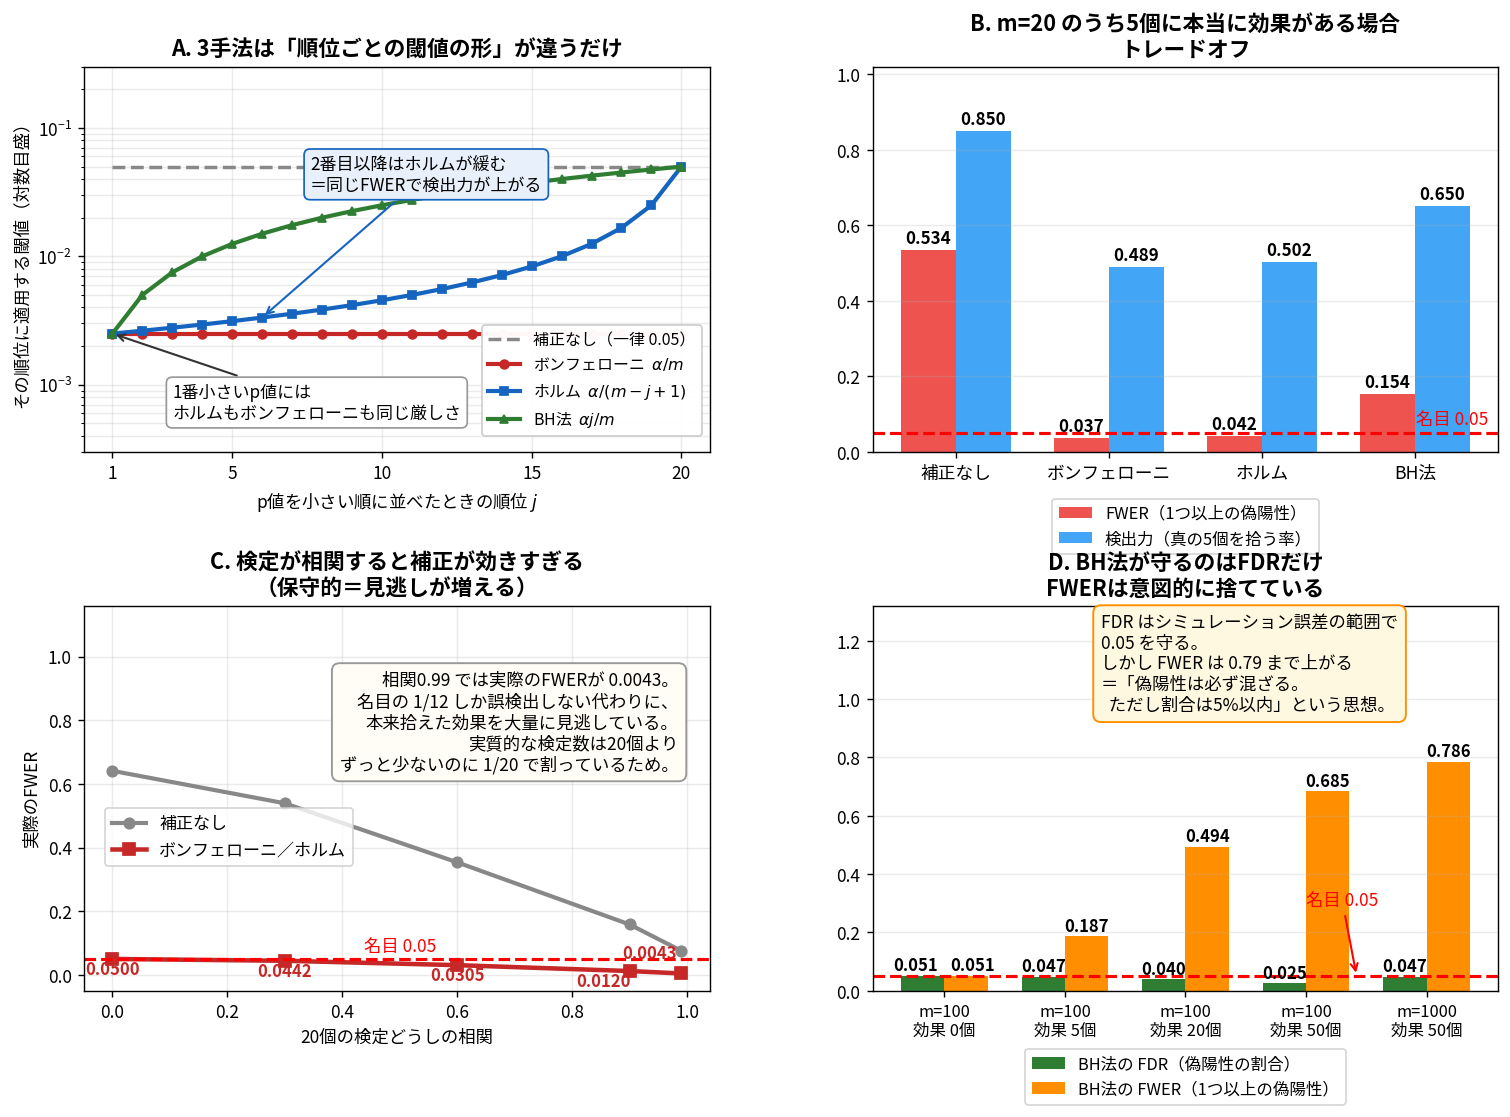
パネルAが3手法の定義そのものの図です。 どの手法も「p値を小さい順に並べ、順位 ごとに違う閾値と比べる」という同じ形で、違うのは閾値の作り方だけでした。
| ボンフェローニ | ホルム | BH法 | |
|---|---|---|---|
| 閾値 | (一律) | ||
| 守る対象 | FWER | FWER | FDR |
| 実測 FWER | 0.037 | 0.042 | 0.154 |
| 実測 検出力 | 0.489 | 0.502 | 0.650 |
ホルムはボンフェローニの上位互換
ここが一番実用的な発見でした。ホルム法は1番小さいp値にはボンフェローニと同じ厳しさを課しますが、2番目以降が緩みます。 それでも FWER は同じく守られます(実測 0.042 vs 0.037)。
つまりホルムはボンフェローニを検出力で上回りながら、同じ保証を与えている(0.489 → 0.502)。検定するだけならボンフェローニを選ぶ理由はほぼありません。
唯一の例外は同時信頼区間です。ボンフェローニなら各項目に幅 の区間を与えるだけで同時被覆 が言えますが、ホルムは順位に応じて閾値が変わる段階的手続きなので、対応する区間が素直に作れません。p値だけを報告するならホルム、区間も並べたいならボンフェローニという分かれ方になります。
手続きの違いも押さえておきます。ホルムは「先頭から順に見て、条件を満たさなくなったら止める」、BHは「条件を満たす最大の順位を探し、そこ以下を全部棄却する」です。BHの方が後戻りを許すぶん緩くなります。
ボンフェローニの弱点は相関
検定どうしが相関していると(同じ被験者に似た項目を20個測る、共発現する遺伝子群など)、実際の FWER が名目を大きく下回ります(パネルC)。
| 相関 | 補正なし | ボンフェローニ/ホルム |
|---|---|---|
| 0.00 | 0.6412 | 0.0500 |
| 0.60 | 0.3536 | 0.0305 |
| 0.99 | 0.0754 | 0.0043 |
相関 0.99 では 0.0043 ── 名目の 1/12 しか誤検出しない代わりに、本来検出できた効果を大量に見逃しています。 実質的な検定数は20個よりずっと少ないのに、律儀に で割っているためです。
BH法が捨てているもの
BH法の FDR は 0.025〜0.051 と、シミュレーション誤差の範囲で 0.05 を守ります。一方 FWER は最大 0.786(パネルD)。
これは失敗ではなく設計です。「偽陽性は必ず混ざる。ただし発見した中の割合は5%以内に抑える」という思想だからです。数千件の検定を回して候補を絞り、後で追試する探索研究ではこちらが合理的です。
なお帰無仮説が全部正しいとき FDR と FWER は一致するので(実測 0.051 / 0.051)、その場合はBH法も FWER を守ります。
ただしBH法の FDR 制御が保証されるのは独立または正の依存のもとです。負の相関が混じる場合は保証が外れるので、より保守的なベンジャミニ・イェクティエリ法を使います。この点でボンフェローニとホルムは強く、依存構造を問わず FWER を守ります。
1件の誤りも許されないならホルム、候補を絞って後で追試するならBH法、という使い分けになります。
8. p値は結局何を測っているのか
最後に、「p値は 」という説明を検証します。惜しいけれど違います。
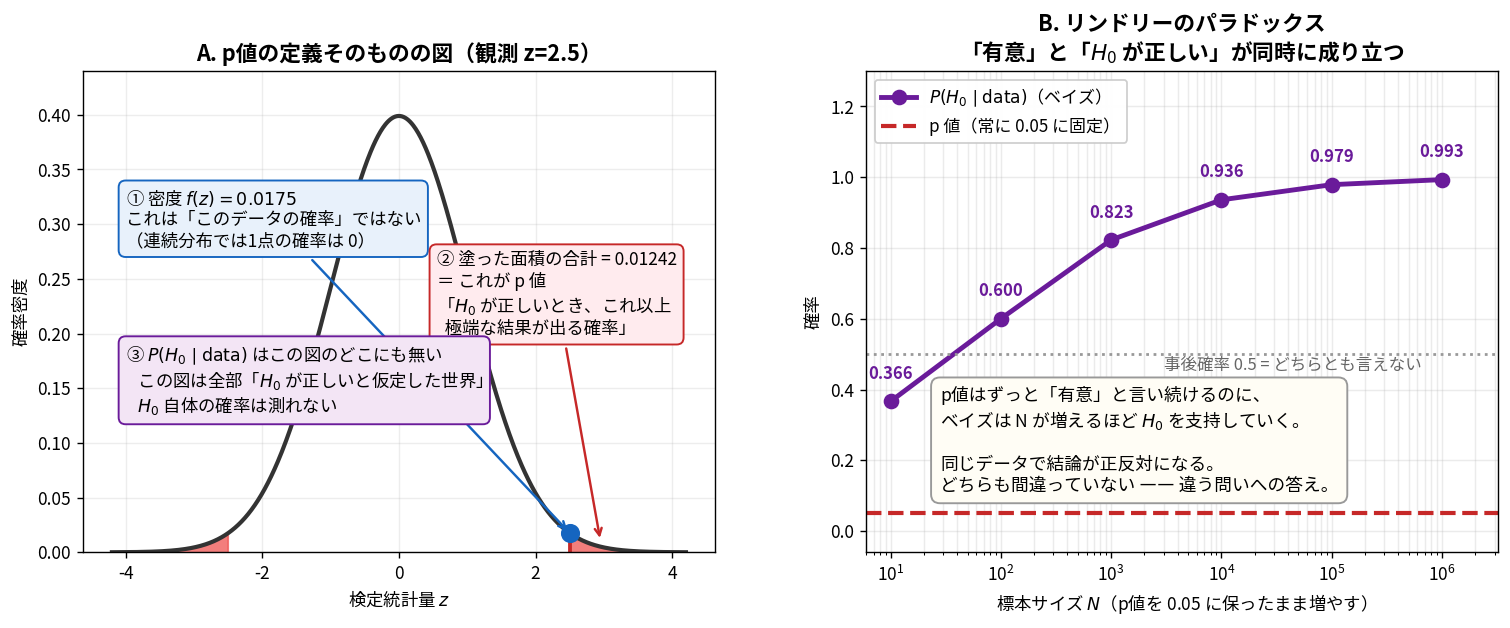
観測 、両側p値 0.01242 として、3つの量を区別します。
| 量 | 記号 | 値 | 誰が答えるか |
|---|---|---|---|
| 密度(尤度) | 0.0175 | どの立場でも計算できる | |
| p値 | 0.01242 | フィッシャー/ネイマン・ピアソン | |
| 帰無仮説の事後確率 | 0.155〜0.849(事前次第) | ベイズのみ |
① 密度 0.0175 は「このデータの確率」ではありません。 連続分布では1点の確率は 0 です。
② p値は で、 ではありません。 「以上」が入るのが決定的で、これがあるから実際には観測していない、もっと極端なデータまで足し合わせることになります。
③ は、この図のどこにも存在しません。 図全体が「 が正しいと仮定した世界」の絵なので、 自体の確率は測る対象になっていないのです。これを出すには事前確率が必要で、それはベイズの仕事でした(第2回)。
表の 0.155〜0.849 は、 の事前確率を 0.5 から 0.95、効果の事前標準偏差 を 1 から 5 まで動かして得た範囲です。同じ が、置いた事前分布次第で「まあ疑わしい」から「ほぼ で説明できる」まで振れるということです。
リンドリーのパラドックス
両者がどれだけ違うかを数値で見ます。p値をちょうど 0.05 に保ったまま標本サイズを増やしてみました(効果量を で縮める)。
| p値 | ||
|---|---|---|
| 10 | 0.0500 | 0.366 |
| 1000 | 0.0500 | 0.823 |
| 10000 | 0.0500 | 0.936 |
| 1000000 | 0.0500 | 0.993 |
p値はずっと「有意」と言い続けるのに、 の事後確率は 0.993 まで上がります。 では「p値は有意」かつ「 が正しい確率 99.3%」が同時に成り立ちます。
矛盾ではありません。p値は「 が正しいならこんなデータは珍しい」と言い、ベイズは「 とわずかな効果を比べれば、これだけの標本で効果がこんなに小さいのは の方が自然だ」と言っている。 違う問いへの答えです。
「p = 0.012 なら が正しい確率は 1.2%」という読み方は、桁が違うレベルで誤りでした(実際は 0.155〜0.849)。
フィッシャー流とネイマン・ピアソン流
| フィッシャー流 | ネイマン・ピアソン流 | |
|---|---|---|
| p値の役割 | に対する証拠の強さの尺度 | 本来は不要。 と棄却域を事前に決めるだけ |
| 対立仮説 | 要らない | 必須(ないと検出力が定義できない) |
| 結論の形 | 「p=0.012 の証拠が得られた」 | 「=0.05 で棄却する」 |
| 繰り返しの意味 | この1回のデータについて語る | 長期的に誤り率を に抑える |
現代の実務はこの2つが混ざった折衷です。「 で有意」(ネイマン・ピアソン)と言いながら「p = 0.012 だった」(フィッシャー)と報告します。厳密には出自の違う2つの流儀を並べて使っているわけで、教科書の書き方に揺れがあるのはこのためでした。
つまずいたところ
「漸近同等」を素朴に検算して混乱した。 効果量を固定したまま を増やして比を取ったら、1.0508 のまま収束しませんでした。設定が間違っていたのです。漸近同等は局所対立仮説(効果量が で縮む)での主張で、 から一定距離を保ったまま情報を増やす設定は対象外でした。「漸近」と書いてあるとき、何を固定して何を動かすのかを確認する必要があるという教訓です。
ホーク・ドナー効果を、1変数の二項比率で起きると誤解した。 「ワルドは効果が大きいほど有意でなくなる」という話を1変数の設定で確かめようとして、統計量が単調増加するだけで再現しませんでした。あれは多変量、特にロジスティック回帰の完全分離で起きる現象で、1変数の二項比率では起きません。ワルドの本当の破綻点は または で推定分散が 0 になり計算不能になることでした。
で3検定を比較して、差が出ないと悩んだ。 3つとも の単調関数になるので、整数 のレベルで棄却域が完全に一致します( なら3つとも または )。比較には をずらす必要がありました。「差がない」という結果が出たら、設定が差を検出できる形になっているかを疑うべきでした。
χ²分布は自由度で形が激変することを軽視していた。 「4つのモデルが全部同じχ²になる」という図を描いたら、自由度1のパネルと自由度4のパネルが別の分布に見えて自分でも混乱しました。 は山がなく単調減少、 は 2 付近に山ができます。形が違うのは別の分布だからではなく自由度が違うからで、比較にはP-Pプロットのような形に依存しない方法が要ります。
信頼区間を「検定とは別に覚えるもの」だと思っていた。 ウィルソン区間もプロファイル尤度区間も、名前だけ暗記していました。それぞれスコア検定と尤度比検定を反転したもので、区間の個数は検定の個数と一致します。覚える量が3分の1になりました。
この記事の要点
- 「棄却する」という遠回りは が出せないことの帰結。 「採択」が存在しないのは論理構造の反映で、言葉の癖ではない
- 同じ でも棄却域は無数にあり、検出力は 0.8038 から 0.0000 まで変わる。 を守るのは最低条件
- NP補題は「尤度比の大きい順に詰めろ」。 64通りの総当たりで上限の壁になることを確認した
- t検定は尤度比検定そのもの。 が の単調関数なので棄却域が一致する
- ウィルクスの定理の自由度は「 が課した制約の本数」で、モデルの中身に依存しない。ただし では第一種の誤りが 0.0979 に膨らむ
- 3検定は1本の対数尤度曲線の横の距離・接線の傾き・縦の高さの差。 検出力の一致は局所対立仮説のもとでの話
- 小標本でワルドは危険( で 0.5998)。尺度を変えると判定が逆転し、相関した変数では個別に共倒れする
- 信頼区間は「棄却されない の集合」。 ウィルソン=スコア反転、プロファイル尤度=尤度比反転
- ホルムはボンフェローニの上位互換。 BH法はFWERを捨ててFDRを守る設計
- p値は 。 事後確率とは桁が違う(0.012 に対し 0.155〜0.849)
次回は第11章の正規分布に関する検定です。今回は論理構造だけを扱ったので、次回は実務側 ── t検定の使い分け、ウェルチの検定、分散の検定、そしてどの検定をいつ選ぶかのフローチャートに進みます。今回「小標本ではワルドを避ける」と書いた話が、正規分布の枠組みでどう現れるかを見るつもりです。