因子分析が再現するのは相関だけ:主成分分析との違いは対角【第27回】
はじめに
第25章は因子分析とグラフィカルモデルです。
正直に書くと、この章に入る前の私は因子分析に対してかなり疑いを持っていました。「観測できない共通要因を取り出す」と説明されるのですが、観測できないものをどうやって推定するのかが分かりません。データに無いものを取り出したと言われても、それは分析者が勝手に決めた話ではないのか。しかも「因子軸は回転できて、回転しても当てはまりは同じ」と聞きます。だとしたら結論はいくらでも動かせるのではないか。
もうひとつの引っかかりは前回の主成分分析との区別です。どちらも「たくさんの変数をまとめる」道具に見えます。「矢印の向きが逆」という説明を何度か目にしましたが、それが何を意味するのかが分かっていませんでした。
手を動かしてみて、疑いはだいぶ解けました。いちばん効いたのは同じ相関行列に両方を当てて、どちらが相関行列を再現できるかを測るという実験でした。結果はこうです。
因子分析は相関の部分を誤差 0.000000 で再現しました。主成分分析(上位2成分)は最大 0.144371 ずれました。しかも主成分分析は対角成分が 0.70〜0.83 にしか届かず、1 になりません。
この1つの数値で、教科書に並んでいた違い(独自因子を持つか・対角を共通性に置き換えるか・回転の不定性があるか)が全部つながりました。因子分析の目的は分散を最大化することではなく、相関行列の非対角を再現することでした。
回転の不定性についても、実際に軸を回して測ってみたら納得できました。当てはまりは本当に変わりません。それでも結論が恣意的にならない理由があって、それは回転で変わるものと変わらないものがはっきり分かれていることでした。
グラフィカルモデルは唐突に見えますが、こちらも「見かけの相関を背後の構造で説明する」という点で因子分析と同じ話をしています。偏相関がちょうどゼロになる例を作って、それが「グラフに辺を引かない」判断に対応することを確かめました。
いつものように、出てくる数値はすべて自分で計算し、理論値と突き合わせています。
この回で扱う用語
| 用語 | 読み・意味 |
|---|---|
| 因子分析 | Factor Analysis。観測変数の背後に少数の共通因子を仮定するモデル |
| 共通因子 | Common Factor。複数の観測変数に共通して影響する見えない変数 |
| 独自因子 | Unique Factor。その変数だけに影響する要因(固有の性質+測定誤差) |
| 因子負荷量 | Factor Loading。因子が観測変数に与える影響の大きさ |
| 共通性 | Communality。その変数の分散のうち共通因子で説明できた分 (標準化していれば「割合」) |
| 独自性 | Uniqueness。共通性の残り。相関行列を分析する場合 (分散共分散行列なら ) |
| 単純構造 | Simple Structure。各変数が1つの因子にだけ大きな負荷を持つ状態 |
| バリマックス回転 | Varimax Rotation。直交を保ったまま単純構造に近づける回転 |
| プロマックス回転 | Promax Rotation。因子間の相関を許す(斜交)回転 |
| 因子得点 | Factor Score。個々の回答者について因子の値を推定したもの |
| 探索的因子分析 | EFA(Exploratory Factor Analysis)。構造を仮定せずデータから探す |
| 確認的因子分析 | CFA(Confirmatory Factor Analysis)。構造を先に指定して当てはまりを検定する |
| 偏相関係数 | Partial Correlation。他の変数の影響を除いた2変数の相関 |
| 条件付き独立 | Conditional Independence。第3の変数を与えると独立になること |
| 精度行列 | Precision Matrix。分散共分散行列(相関行列)の逆行列 |
| グラフィカルモデル | Graphical Model。条件付き独立の構造をグラフの辺で表す |
何に使うのか:測れないものを測りたい
数式の前に、この道具が生まれた事情から入ります。
アンケートでこんな10項目を聞いたとします。「人前で話すのが苦手」「初対面の人と話すと疲れる」「大人数の飲み会が苦手」「一人で過ごす時間が好き」……。
ここで本当に知りたいのは個々の項目への回答ではありません。その人がどれくらい内向的かです。ところが「内向性」という物差しは世の中に存在しないので、直接は測れません。体重なら体重計に乗れば済みますが、内向性を測る機械はありません。
そこで発想を変えます。内向性そのものは測れないが、内向性の影響を受けた項目なら測れる。 内向的な人は上の10項目すべてで「はい」寄りに答えるはずです。だから10項目の回答が互いに相関する。
この論理を逆向きに使うのが因子分析です。項目間に相関があるという事実から、その相関を生んでいる共通の原因を逆算する。 これが「観測できない共通要因を取り出す」の中身です。
使いどころを並べるとこうなります。心理尺度の構成(内向性・不安・自己効力感などを測る質問紙を作る)、顧客アンケートの構造把握(満足度の項目群が実は「価格」「接客」「品揃え」の3因子で動いていると分かる)、学力テストの分析(科目間の相関から文系能力・理系能力を取り出す)、そして経済指標のように多数の指標が少数の景気変動で動いていると考える場面です。
共通しているのは、相関が生まれる原因に興味があるという点です。ここが主成分分析との分かれ目になります。
まず図で:矢印の向きが逆とはどういうことか
私が最初につまずいたのはここなので、定義や数式より先に図を出します。
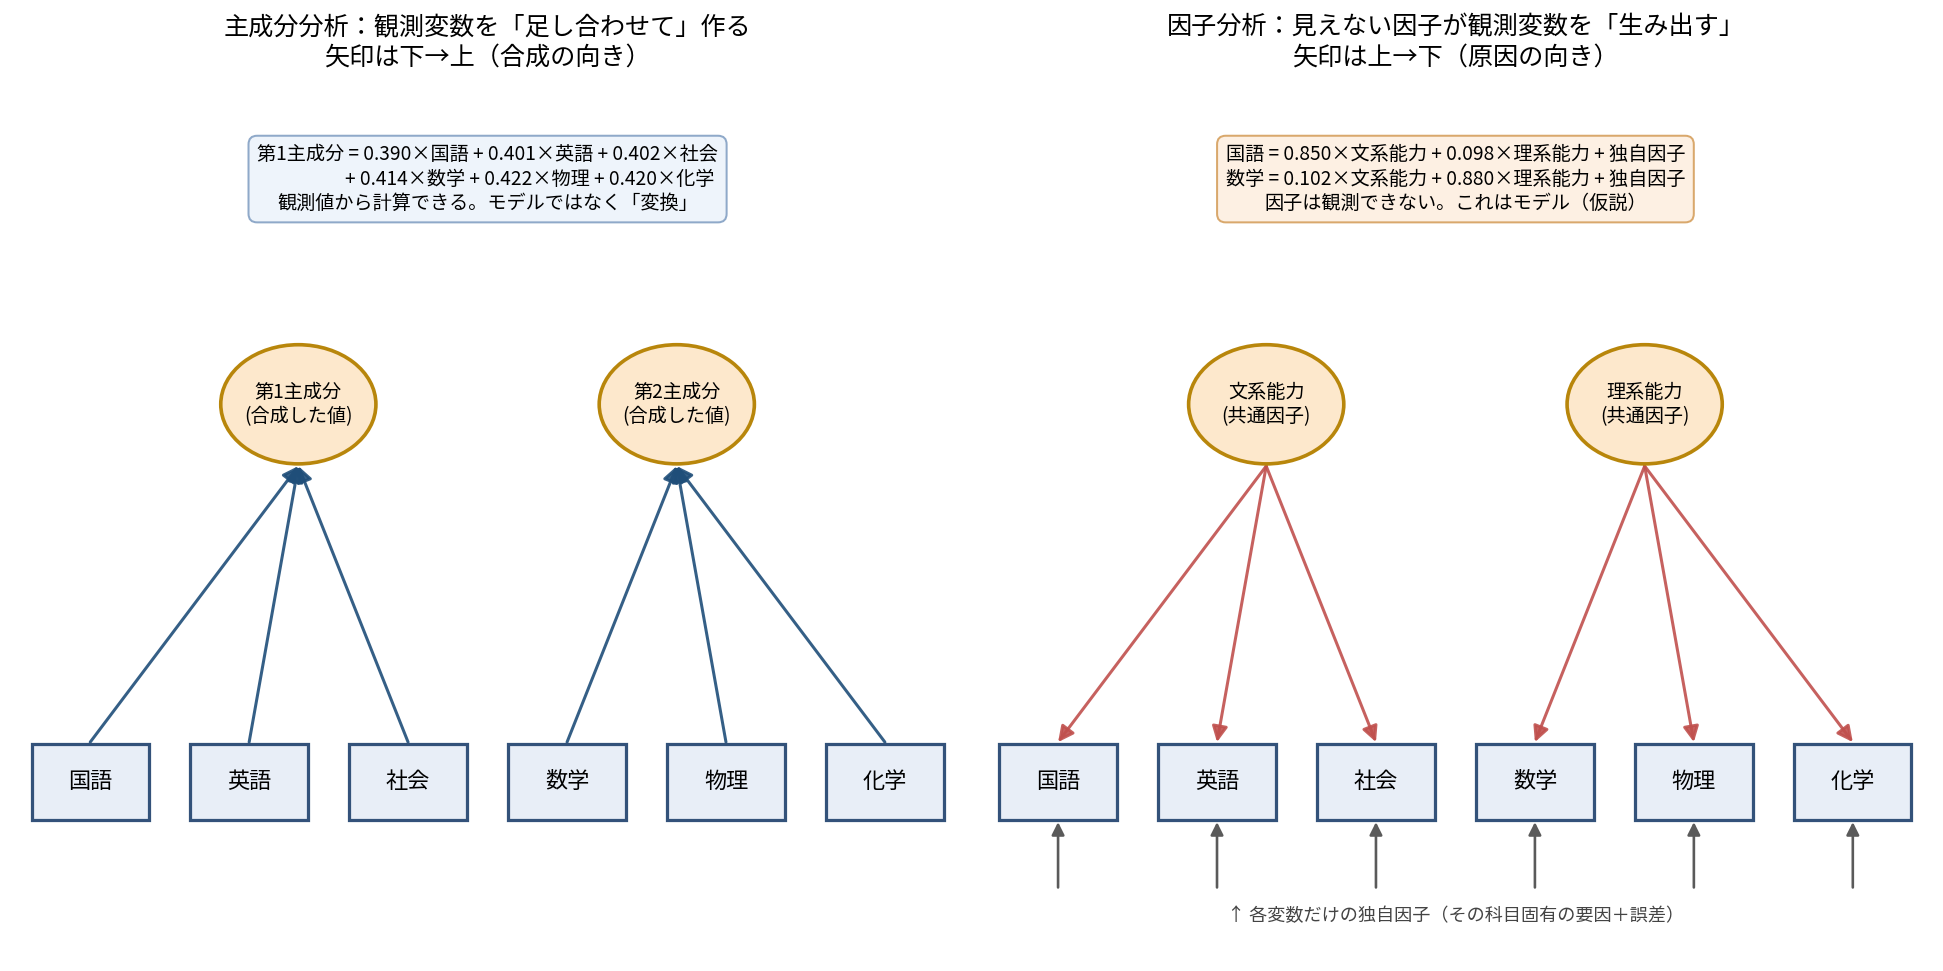
左が主成分分析、右が因子分析です。同じ6科目(国語・英語・社会・数学・物理・化学)を扱っています。
左では矢印が下から上に向かっています。 第1主成分は
という式です。6科目の点数が手元にあれば、この式に代入して電卓で計算できます。つまり第1主成分はデータの中にすでにある量で、それを見やすい形に組み替えただけです。
右では矢印が上から下に向かっています。 因子分析はこう書きます。
右辺の「文系能力」はどこにも記録されていません。成績表に載っているのは国語の点数だけで、文系能力という列は存在しません。それでも「そういう量があって、それが国語の点数を生んでいる」と主張している。
なお、この式のように「国語は文系能力でほぼ決まる」ときれいに分かれるのは、後で扱う回転を1回かけた後の姿です。推定した直後の負荷量は6科目すべてが似た値になり、こんなに素直には分かれません。しかもこの分離は因子分析に固有のものでもありません。詳しくは後半の「文系/理系に分けているのは「回転」だった」で扱います。
これが矢印の向きの意味です。言い換えるとこうなります。
- 主成分分析は変換である。 観測値から計算する手続きで、正しいか間違っているかを問う余地がない。座標軸を回すのと同じで、必ず実行できる。
- 因子分析はモデルである。 「背後に2つの因子がある」という仮説を立てているので、その仮説がデータと合わないことがありうる。
試験で「モデルの有無」が問われるのはこの違いです。そして「モデルだから間違っていることがありうる」という性質が、次の節の話につながります。私が抱いていた「胡散臭さ」への答えもここにあります。
決定的な違い:相関行列を再現できるか
矢印の向きの違いが、計算上どこに現れるのか。ここを数値で確かめたことで一気に腑に落ちました。
実験の設計
真の構造が分かっているデータを作ります。文系能力と理系能力という2つの因子があって、6科目がそこから生まれているとします。負荷量は次のように置きました。
| 科目 | 文系能力の負荷量 | 理系能力の負荷量 |
|---|---|---|
| 国語 | 0.85 | 0.10 |
| 英語 | 0.80 | 0.15 |
| 社会 | 0.70 | 0.20 |
| 数学 | 0.10 | 0.88 |
| 物理 | 0.15 | 0.82 |
| 化学 | 0.20 | 0.72 |
このモデルから相関行列を計算して、そこに主成分分析と因子分析の両方を当てます。真の答えが分かっているので、どちらが元の相関行列を復元できるかを測れます。
結果
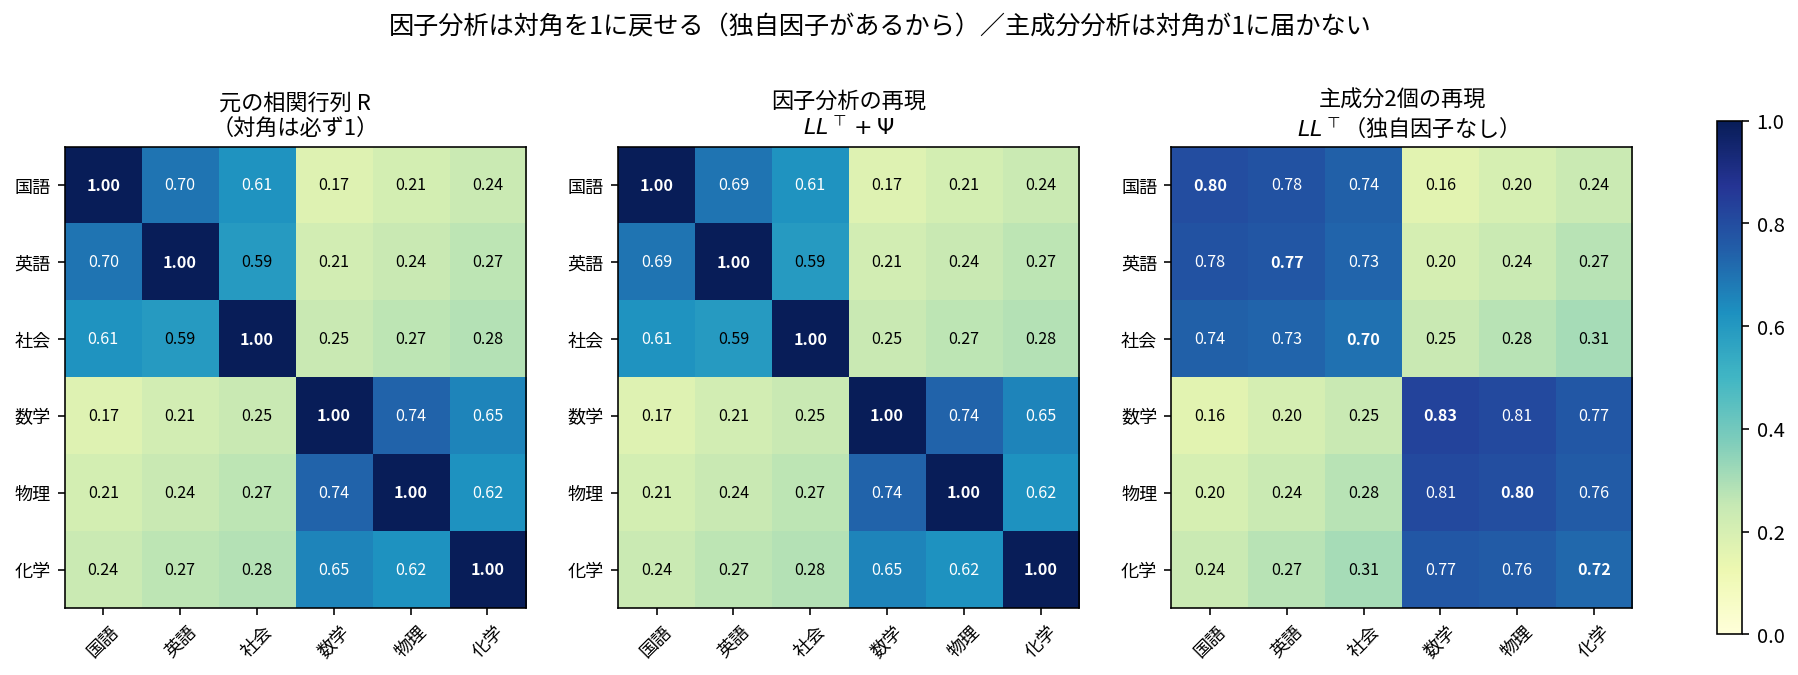
3枚のヒートマップを見比べます。左が元の相関行列、中央が因子分析の再現、右が主成分2個の再現です。
中央(因子分析)は左とほぼ見分けがつきません。対角は 1.00 に戻り、非対角も一致しています。非対角の最大誤差は 0.000000 でした(実際の誤差は で、表示の丸めによって国語と英語の間だけ 0.70 と 0.69 に割れて見えています)。
右(主成分2個)は明らかに違います。まず対角が 1 になりません(0.70〜0.83)。そして非対角も、文系3科目の間が 0.73〜0.78 と元の 0.59〜0.70 より大きく出ています。非対角の最大誤差は 0.144371、対角の最大誤差は 0.298764 です。
| 確認したこと | 因子分析 | 主成分2個 |
|---|---|---|
| 非対角(相関)の最大誤差 | 0.000000 | 0.144371 |
| 対角の最大誤差 | 0.000000 | 0.298764 |
| 対角の値 | すべて 1.00 | 0.70〜0.83 |
なぜこうなるのか
理由は式の形にあります。因子分析はこう書きます。
が因子負荷量の行列、 が独自性を並べた対角行列です。 が対角行列であることが決定的で、これは対角成分にだけ効いて非対角には一切効かないという意味です。
すると役割分担がこうなります。非対角(相関)は だけで説明しなければならない。対角は足りない分を で埋められる。 が自由に動けるおかげで対角のずれは常にゼロにでき、残る誤差は非対角にしか現れません。 だから因子分析は相関の再現に全力を使えるわけです。
主成分分析には がありません。 の形で、対角も非対角も同じ で説明しようとします。対角(各変数の分散=1)を説明することにも力を割かれるので、相関の再現が甘くなります。
ここで冒頭の「何に使うのか」に戻ります。因子分析が知りたかったのは相関が生まれる原因でした。だから相関だけを再現する形になっているのは当然です。逆に主成分分析が知りたいのはばらつきの大きい方向なので、分散(対角)を含めて扱うのが当然です。目的が違うから式が違う。
ひとつ断っておきます。この 0.000000 は、今回のデータがちょうど2因子モデルから作られているから達成された値です。 自由度が正のとき(6変数2因子なら4)、一般には残差が残ります。実際この後、同じ相関行列に1因子モデルを当てると残差 0.3440 が残ります。「因子分析なら必ず相関を完全再現できる」ではなく、誤差の置きどころが非対角に集まるのが構造的な違いです。逆に言えばこの比較は因子分析に有利な土俵(データを因子モデルから作った)でもあるので、有利なはずの土俵で主成分分析が対角を1にできないこと自体に意味があります。
要点:因子分析は独自性 を対角に足せるので、相関(非対角)の再現に専念できる。主成分分析は対角も非対角も同じ で背負うので、相関の再現が犠牲になる。この違いが「因子分析はモデル・主成分分析は変換」の計算上の正体。
「見えないもの」をどうやって推定するのか
ここが私のいちばんの疑問でした。存在が確認できないものを推定したと言われても信用できません。
答えは2つに分かれます。推定できる根拠と、それでも言えないことです。両方を明確にしておくのが大事だと思いました。
手で追える最小の例(3変数・1因子)
まず、なぜ推定が可能なのかを変数の数が少ない例で見ます。3つの変数()と1つの因子()だけの場合です。
モデルはこうです。
は共通因子で、観測できません。 は独自因子で、これも観測できません。観測できるのは の相関だけです。
ここで因子と独自因子が無相関で、独自因子同士も無相関だと仮定します(因子分析の標準的な仮定)。すると変数間の相関は
になります。相関が負荷量の積になるのがポイントです。ここで未知が3つ、式が3つなので解けます。
が約分されて だけが残ります。実際の数値でやってみます。 とすると
検算します。 で、 と一致しました。
| 変数 | 因子負荷量 | 共通性 | 独自性 |
|---|---|---|---|
| 0.800 | 0.640 | 0.360 | |
| 0.700 | 0.490 | 0.510 | |
| 0.600 | 0.360 | 0.640 |
観測できない の値を一度も使わずに、負荷量が求まりました。 これが「見えないものを推定する」の仕組みです。因子そのものを見に行くのではなく、因子があるとしたら相関はこうなるはず、という関係を逆に解くわけです。
ただし2点、正確に言っておくべきことがあります。
第一に、この式が決めるのは であって ではありません。 も同じ相関行列を完全に再現する正当な解です。因子の向きを反転させて負荷量の符号も全部反転させただけなので、 は変わりません。これは1因子の場合の「回転の不定性」にあたるもので、後の節で扱う話の最も単純な形がここにもう現れています。
第二に、解が常に存在するわけでもありません。 がゼロだと割り算ができず、 が負なら実数解がありません。1を超えることもあります。
| 結果 | ||
|---|---|---|
| 0.56, 0.48, 0.42 | 0.6400 | 0.800/0.700/0.600(正常) |
| 0.9, 0.8, 0.6 | 1.2000 | 、 が負(ヘイウッドケース) |
| 0.5, 0.5, −0.3 | −0.8333 | 実数解なし |
独自性が負になるのは「分散が負」という不可能な値です。これをヘイウッドケースと呼び、実データで因子分析が失敗する代表的なパターンです(0.9, 0.8, 0.6 は最小固有値 0.052 で相関行列としては正当なのに、1因子モデルの解が不適になります)。「解ける」ことと「意味のある解が出る」ことは別でした。
なぜ反証できるのか:自由度の話
もっと重要なのは、このモデルが間違っていたら分かるという点です。
上の例では未知3つ・式3つでちょうど解けました。では変数を増やすとどうなるか。 変数・ 因子で数えます。観測できる情報は相関行列の非対角の本数 。推定するパラメータは負荷量 個から回転の自由度 を引いた数です。
ここで「独自性 の 個を数えていないのでは」と気になりました。数え忘れではありません。相関行列の対角 本の式()が、 の 個をちょうど使い切っているので、対角も も両方勘定に入れないで辻褄が合います。
この数え方は教科書によくある式と一致します。
展開すればどちらも になります。
| 変数 | 因子 | 相関の本数 | パラメータ数 | 自由度 | 判定 |
|---|---|---|---|---|---|
| 6 | 1 | 15 | 6 | 9 | 検証可能 |
| 6 | 2 | 15 | 11 | 4 | 検証可能 |
| 6 | 3 | 15 | 15 | 0 | ちょうど(検証不可) |
| 6 | 4 | 15 | 18 | −3 | 識別不可 |
6変数2因子なら自由度が4残ります。この余りが決定的です。パラメータを自由に動かしても15本の相関すべてを合わせられるとは限らないので、モデルが間違っていれば当てはまらないことが露見します。
実際に確かめました。同じ相関行列に1因子モデルを当てると、非対角の最大残差が 0.3440 も残ります。2因子なら 0.000000。1因子では明確に足りないと数値が言っています。
| 因子数 | 非対角の最大残差 | 不適合度 |
|---|---|---|
| 1 | 0.3440 | 1.254075 |
| 2 | 0.0000 | 0.000000 |
ここまでの は母相関行列(真の構造から作った行列)に対する不適合度です。定義は最尤法の不一致度
で、 が当てはめた行列です。実際の検定は標本から行うので、あらためて の標本を生成し、標本相関行列から推定・検定しました。
| モデル | 自由度 | 値 | 判定 | |
|---|---|---|---|---|
| 1因子 | 347.698 | 9 | 0.00000 | 棄却(当てはまり不足) |
| 2因子 | 1.5952 | 4 | 0.80965 | 棄却されない |
これが「胡散臭さ」への答えでした。 因子分析は「見えない何かを置いた」だけの話ではなく、置いた結果が観測データと整合するかを検定できます。 自由度が正であるかぎり、モデルは反証可能です。
なお で自由度が 0 になり、 で負になることにも意味があります。因子を増やしすぎると、当てはまりの良さを検証する余地が消えます。 自由度が0だとモデルが合っていることを示す証拠が原理的に残らず、負なら識別すらできません。
ただし「自由度0なら必ず厳密に当てはまる」わけでもありません。(自由度0)でランダムな相関行列を試すと、非対角の残差が残る場合が多く、無理に合わせようとすると共通性が1を超える不適解(ヘイウッドケース)になりました。要点は「完璧に当てはまる」ことではなく、当てはまりの良さが良いモデルの証拠にならなくなる境界がここにあることです。
それでも言えないこと
一方で、データから言えないこともはっきりしています。ここを曖昧にすると因子分析は本当に怪しい道具になります。
因子に名前を付ける行為は、データの外側の話です。 上の計算が言っているのは「6科目の相関は2つの軸で説明できる」だけです。その軸を「文系能力・理系能力」と呼ぶ根拠はデータの中にありません。国語・英語・社会に大きな負荷が乗ったから文系と呼んだ、という分析者の解釈です。
そしてもう1つ、因子の向きと位置は一意に決まりません。これが次の節の回転の話です。
まとめると、因子分析について言えること・言えないことはこう分かれます。
| データから言えること | データから言えないこと |
|---|---|
| 何因子で相関を説明できるか(検定できる) | その因子が実在する心理的・物理的実体かどうか |
| 各変数の共通性・独自性の大きさ | 因子の名前・意味づけ |
| モデルが当てはまっていないこと(反証) | 因子の向き(回転で変わる) |
| どの変数がまとまって動くか | 因子が原因で観測変数が結果だという因果の向き |
最後の行は特に注意が必要でした。因子分析の図では因子から観測変数へ矢印が伸びますが、その矢印はモデルの仮定であって、データが証明したものではありません。 相関を説明する構造としては他の可能性もありえます。
共通性と独自性は、変数ごとの決定係数だった
ここは第16回の決定係数と同じ話かという疑問への答えです。結論から言うと同じ分解です。
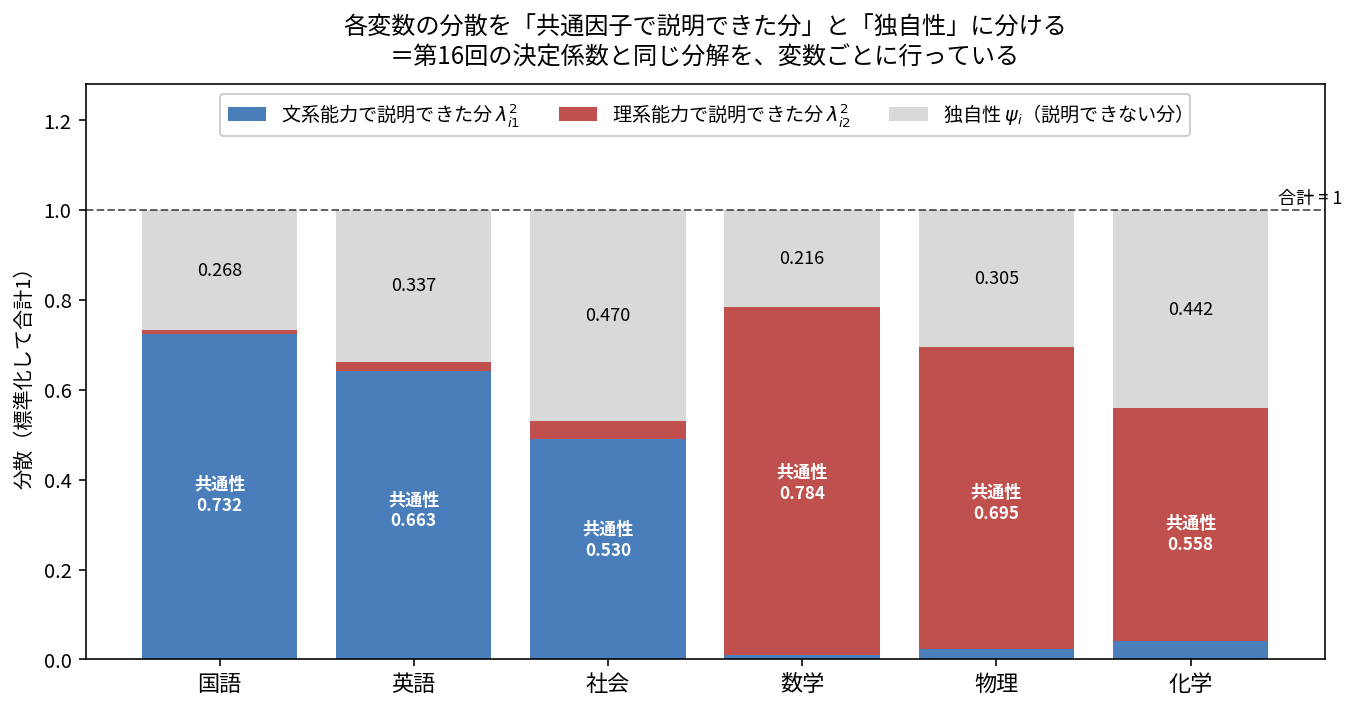
図の見方を説明します。各科目の分散を1(標準化しているので合計1)として、それを3つに分けています。青が文系能力で説明できた分、赤が理系能力で説明できた分、灰色が独自性です。
国語で計算してみます。負荷量は文系 0.850、理系 0.098 でした。
(表示用に丸めた負荷量で計算したので 0.7321 になりました。丸める前の値 0.850248 と 0.097873 で計算すると 0.7325 で、これが下の表の値です。)
共通性は負荷量の2乗の和です(ただし後で出てくる斜交回転の場合を除きます。因子間に相関があるときは計算式が変わるので、その節で扱います)。そして独自性は残り。全科目を並べるとこうなります。
| 科目 | 文系の負荷量 | 理系の負荷量 | 共通性 | 独自性 |
|---|---|---|---|---|
| 国語 | 0.850 | 0.098 | 0.7325 | 0.2675 |
| 英語 | 0.800 | 0.148 | 0.6625 | 0.3375 |
| 社会 | 0.700 | 0.198 | 0.5300 | 0.4700 |
| 数学 | 0.102 | 0.880 | 0.7844 | 0.2156 |
| 物理 | 0.152 | 0.820 | 0.6949 | 0.3051 |
| 化学 | 0.202 | 0.719 | 0.5584 | 0.4416 |
第16回の決定係数は「全体のばらつきのうち、説明できた分の割合」でした。共通性はまさにそれで、その変数の分散のうち共通因子で説明できた割合です。3本の縦線で説明したあの構造がそのまま出てきます。
対応を表にするとこうなります。
| 第16回(重回帰) | 今回(因子分析) |
|---|---|
| 全平方和(全体のばらつき) | 変数の分散(標準化して1) |
| 回帰平方和(説明できた分) | 共通性 |
| 残差平方和(説明できない分) | 独自性 |
| 決定係数 | 共通性 |
ただし違いが1つあります。 重回帰では説明変数()が観測されていて、係数だけを推定しました。因子分析では説明する側の因子も観測されていません。説明変数と係数を同時に推定していることになります。だから重回帰のような閉じた式()では解けず、反復計算が必要になります。
もう1つ用語の注意です。「独自性」はその変数固有の性質+測定誤差の両方を含みます。純粋な誤差ではありません。社会の独自性 0.470 は「社会の点数の47%が誤差」ではなく、「共通因子では説明できない社会固有の要素と誤差の合計が47%」です。
共通性の推定には循環がある
ここで少しだけ推定の話に触れます(深追いはしません)。
因子負荷量を求めるには相関行列の対角を共通性に置き換えます。ところが共通性は負荷量から計算される量です。負荷量を知るには共通性が必要で、共通性を知るには負荷量が必要という循環になります。
だから反復します。適当な初期値(重相関係数の2乗など)から始めて、負荷量を計算し、そこから共通性を更新し、また負荷量を計算する。3変数の例では 93回の反復で収束しました。最尤法(EMアルゴリズム)では 181回でしたが、どちらも同じ答え(0.800, 0.700, 0.600)に到達しました(6科目2因子の例では82回・156回でした)。
試験では反復の中身は問われないので、「閉じた式では解けず反復が必要」「共通性と負荷量が相互依存している」の2点を押さえておけば十分だと思います。
この反復が具体的にどう動くかは、後半の「計算の中身は主成分分析とほぼ同じだった」で図とともに扱います。
回転の不定性:結論は恣意的にならないのか
「回転しても当てはまりが同じ」なら結論を好きに動かせるのではないか。これも強い疑問でした。実際に軸を回して測ってみます。
なぜ回転しても当てはまりが変わらないのか
先に理屈を見ます。因子分析が再現するのは でした。ここで に直交行列 ()を掛けて とします。すると
で消えるので、 は完全に元のままです。 再現される相関行列が変わらないので、当てはまりも変わりません。これが回転の不定性の正体です。
数値で確認する
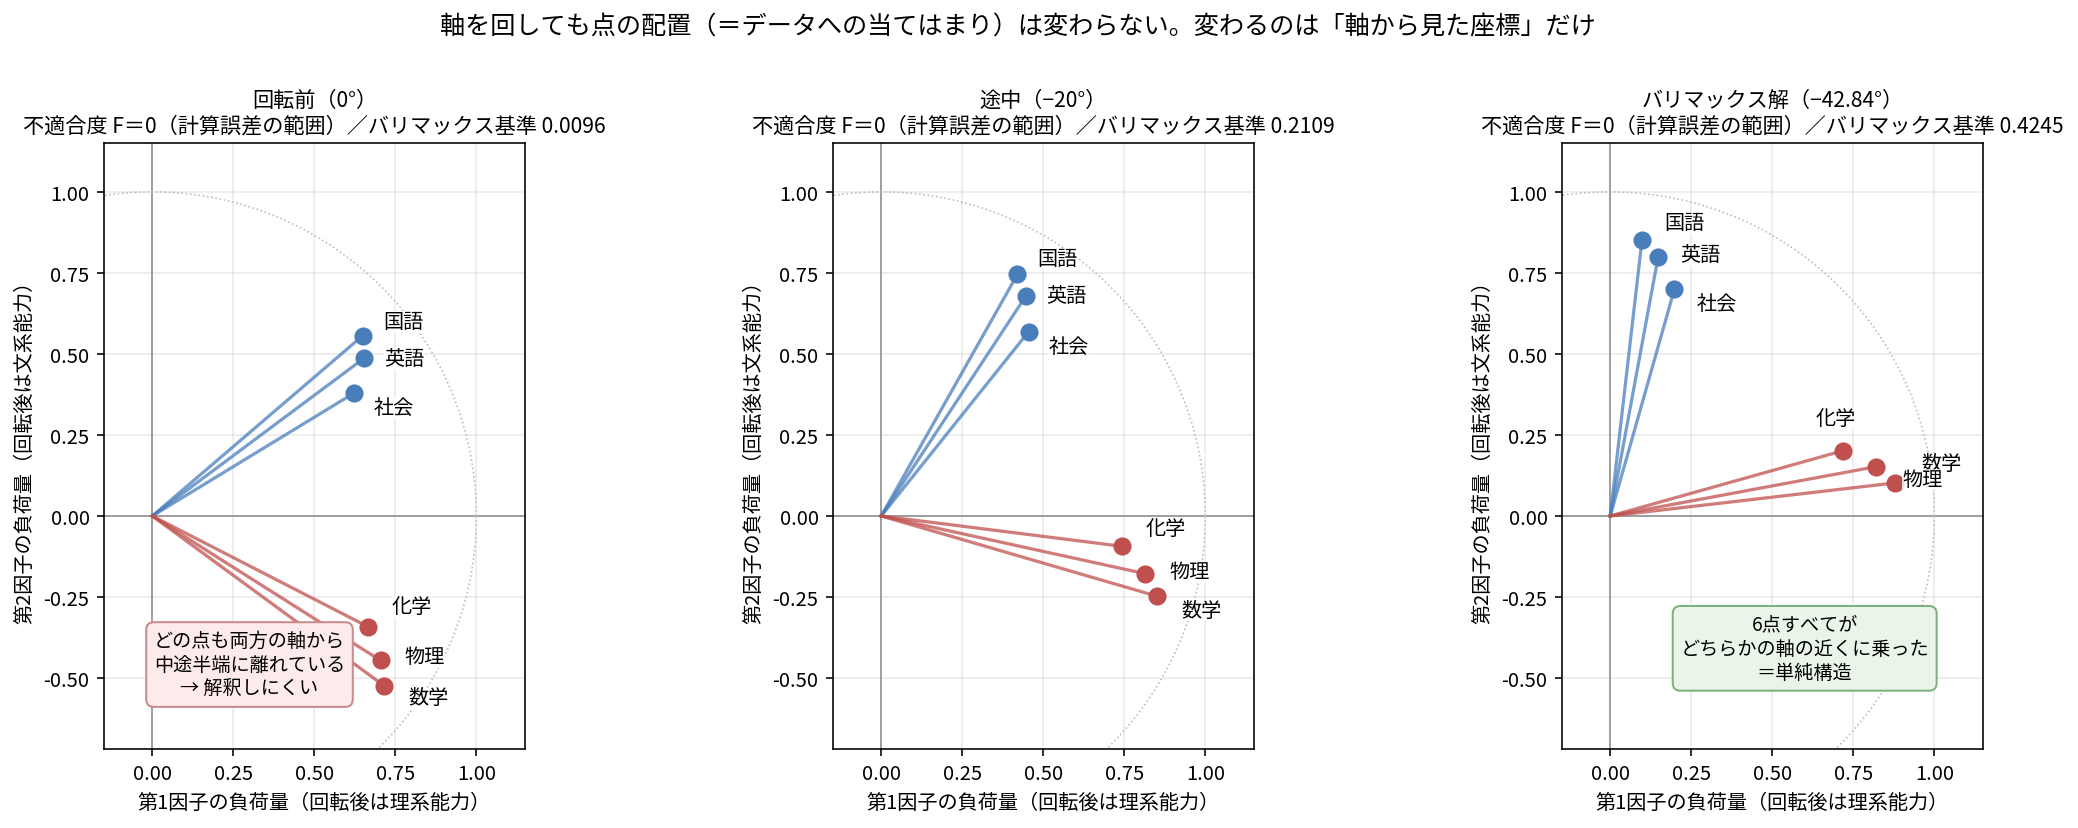
3枚の図はすべて同じ因子分析の解を、違う角度から見たものです。点の位置関係(点と点の距離、原点からの距離)はどの図でも同じです。変わっているのは軸から見た座標だけです。
なお図では回転後に理系能力が横軸(第1因子)、文系能力が縦軸(第2因子)に来ています。どちらを「第1因子」と呼ぶかは任意で、下の表とは列の呼び方が逆になっています。これも回転の不定性の一部です。
数値で見ます。
| 回転角 | 不適合度 | 共通性の和 | バリマックス基準 |
|---|---|---|---|
| 0° | 0 | 3.962700 | 0.009590 |
| 15° | 0 | 3.962700 | 0.085612 |
| 30° | 0 | 3.962700 | 0.291894 |
| 45° | 0 | 3.962700 | 0.422155 |
| 60° | 0 | 3.962700 | 0.346134 |
| 75° | 0 | 3.962700 | 0.139851 |
| 90° | 0 | 3.962700 | 0.009590 |
| 123.4° | 0 | 3.962700 | 0.335452 |
( の実測値は 程度で、これは浮動小数点の計算誤差です。)
当てはまりと共通性は角度によらず一定でした。 動いているのはバリマックス基準だけです。疑いは事実として正しかったことになります。
それでも恣意的にならない理由
では結論が好きに動かせるのか。ここが肝心で、答えは回転で変わるものと変わらないものが分かれていることです。
| 回転で変わらないもの | 回転で変わるもの |
|---|---|
| 各変数の共通性 (斜交では で計算) | 個々の因子負荷量 |
| 独自性 | 各因子の寄与(説明する分散の配分) |
| モデルの当てはまり(・) | 因子の解釈・名前 |
| 因子数という結論 | 因子軸の向き |
| 再現される相関行列 (斜交では ) | — |
つまり「2因子で説明できる」「国語の共通性は0.732」という結論は動きません。 動くのは「その2つの軸をどう名付けるか」だけです。
これは座標系の選び方と同じだと理解しました。地図で東西南北を使うか、道路に沿った斜めの座標を使うかは自由です。どちらを選んでも2点間の距離や街の形は変わりません。変わるのは各地点の座標の数字だけです。回転の不定性はこれと同じで、実質的な結論には触れていません。
だから因子分析の作法として「因子が2つあった」までは客観的な結論、「それを文系能力と理系能力と呼ぶ」は解釈、と切り分けて報告することになります。論文で回転方法を必ず明記するのはこのためです。
バリマックス回転は何を最大化しているのか
「解釈しやすくする」と説明されますが、解釈しやすさを数式にできるのか。できます。 ここが面白いところでした。
まず目標を言語化します。解釈しやすい負荷量とは、各変数がどれか1つの因子にだけ大きな値を持ち、他ではほぼ0という状態です。「国語は文系能力だけで動く」なら意味を言えますが、「国語は文系0.65・理系0.56」だと何と呼べばいいか分かりません。この理想を単純構造と呼びます。
これを数式にします。負荷量の2乗 を並べたとき、0に近い値と1に近い値に二極化していれば単純構造です。そして「二極化している」=「散らばりが大きい」なので、分散を測ればよいことになります。
バリマックス基準は各因子について負荷量の2乗の分散を計算し、その合計を最大化します。
角括弧の中が「2乗の平均」引く「平均の2乗」で、これは第3回でやった分散の公式そのものです。バリマックスは「負荷量の2乗の分散を最大化する回転」であり、「中途半端な値を減らす」を数式にしたものでした。名前の varimax も variance maximization の略です。
ただし実務のバリマックスは、この式をそのまま使う前にカイザー正規化をかけます。共通性の大きい変数が基準を独占しないよう、各行を で割って行の長さを1に揃えてから2乗の分散を計算し、最後に元の長さに戻します。
この記事に出てくるバリマックス基準の数値は、前に出した回転角の表と、負荷量プロットを3枚並べた図を含めてすべて、このカイザー正規化版で計算しています。 正規化しない場合、この例では最適角が 、基準の最大値が 0.197843 になり、値が変わります(回転後の負荷量もわずかに動き、絶対値が 0.7 を超える負荷量の個数が6個から5個に減ります)。ソフトウェアの既定値も正規化ありが一般的です。
実測すると効果がはっきり出ます。
| 指標 | 回転前 | バリマックス後 |
|---|---|---|
| バリマックス基準 | 0.009590 | 0.424519 |
| 負荷量の絶対値が 0.7 超の個数(12個中) | 2 | 6 |
| 負荷量の絶対値が 0.4 未満の個数(12個中) | 2 | 6 |
| ホフマンの複雑度(1に近いほど単純) | 1.7453 | 1.0843 |
負荷量そのものを比べると変化が見えます。
| 科目 | 回転前 第1 | 回転前 第2 | 回転後 第1 | 回転後 第2 |
|---|---|---|---|---|
| 国語 | 0.650 | 0.557 | 0.850 | 0.098 |
| 英語 | 0.653 | 0.486 | 0.800 | 0.148 |
| 社会 | 0.622 | 0.379 | 0.700 | 0.198 |
| 数学 | 0.715 | −0.523 | 0.102 | 0.880 |
| 物理 | 0.704 | −0.446 | 0.152 | 0.820 |
| 化学 | 0.665 | −0.341 | 0.202 | 0.719 |
回転前は6科目すべてが第1因子に 0.62〜0.72 という似た値を持っていて、これでは第1因子を何と呼べばいいか分かりません(強いて言えば「総合学力」)。回転後は文系3科目が第1因子に 0.70〜0.85、理系3科目が第2因子に 0.72〜0.88 と分離しました。中間の値が消えて両極に分かれたのが分かります。
なお最適角度は でした。全探索(0.001度刻み・18万点)で確かめた最大値と一致しています。この角度が閉じた式で一意に決まることは後半の「回転の角度はどうやって決まるのか」で扱います。( と90°違い)でも同じ基準値になりますが、これは2つの因子の列が入れ替わり、片方の符号が反転しただけで同じ解です。バリマックス基準は と しか使わないので、符号にも列の順番にも反応しません。
プロマックス回転:直交をやめる
バリマックスは直交(因子間の相関が0)を保ちます。しかし現実には文系能力と理系能力に相関があってもおかしくありません。地頭のいい人は両方できる、という話です。
因子間の相関を許す回転を斜交回転と呼び、代表がプロマックス回転です。バリマックス解を出発点に、負荷量を累乗して「小さい値をさらに小さく」した目標行列に近づけます。
今回のデータでやってみると、因子間相関は 0.3748 と推定されました(累乗の指数は 。 を変えると値も動き、 なら 0.2975、 なら 0.3568 でした)。そして斜交回転では2種類の行列を区別する必要が出てきます。
| 行列 | 意味 | 直交回転では |
|---|---|---|
| パターン行列 | 他の因子を固定したときの影響(回帰係数にあたる) | 構造行列と一致 |
| 構造行列 | 因子と観測変数の単純な相関 | パターン行列と一致 |
数値で比べます。
| 科目 | パターン 第1 | パターン 第2 | 構造 第1 | 構造 第2 |
|---|---|---|---|---|
| 国語 | 0.880 | −0.073 | 0.853 | 0.257 |
| 英語 | 0.817 | −0.009 | 0.814 | 0.297 |
| 社会 | 0.701 | 0.065 | 0.726 | 0.328 |
| 数学 | −0.072 | 0.910 | 0.269 | 0.883 |
| 物理 | −0.007 | 0.836 | 0.307 | 0.834 |
| 化学 | 0.066 | 0.720 | 0.336 | 0.745 |
国語を見ると、パターン行列では理系能力の値が −0.073 とほぼ0ですが、構造行列では 0.257 あります。これは「理系能力を固定すれば国語への直接の影響はないが、文系能力と理系能力に相関があるので、単純に相関を取れば 0.257 出る」という意味です。
この区別は第16回の偏回帰係数と単相関の違いと同じ構造です。 他を固定した効果と、素の相関は別物という話がここでも出てきます。斜交回転の結果を読むときはどちらの行列かを確認する必要があります。
なお構造行列はパターン行列に因子間相関を掛けたもの()で、直交回転では なので両者が一致します。
斜交回転では共通性の計算式が変わる
ここで注意が必要な点があります。斜交回転では共通性が「負荷量の2乗の和」になりません。 国語のパターン負荷量で計算すると
ですが、正しい共通性は 0.7325 です。因子間相関 を挟む必要があります。
つまり行ごとに「パターン負荷量 × 構造負荷量」の和を取ります。実際に計算して確かめました。
| 科目 | パターンの2乗和(誤り) | (正しい) | 直交回転のときの共通性 |
|---|---|---|---|
| 国語 | 0.7804 | 0.7325 | 0.7325 |
| 英語 | 0.6681 | 0.6625 | 0.6625 |
| 社会 | 0.4960 | 0.5300 | 0.5300 |
| 数学 | 0.8334 | 0.7844 | 0.7844 |
| 物理 | 0.6991 | 0.6949 | 0.6949 |
| 化学 | 0.5225 | 0.5584 | 0.5584 |
正しい式で計算すると、直交回転のときと完全に一致しました。 共通性が回転で変わらないこと自体は斜交回転でも成り立ちますが、計算式が変わるわけです。
再現される相関行列も同様で、斜交では ではなく になります。実測すると では元の相関行列から最大 0.3023 ずれ、 なら誤差 で一致しました。
もう1点、解釈上の注意です。真の理系負荷量は国語 0.10、英語 0.15 と正でしたが、プロマックスのパターン行列では国語 −0.073、英語 −0.009 と負に振れています。斜交回転が単純構造を強く追い求めた結果で、 を小さくすると絶対値が小さくなります( なら国語は −0.034)。小さな負の値は「効果が逆向き」ではなく「ほぼゼロ」と読むべき場合があります。
使い分けはこうなります。
| バリマックス(直交) | プロマックス(斜交) | |
|---|---|---|
| 因子間相関 | 0 に固定 | 推定する |
| パターンと構造 | 一致する | 別物になる |
| 解釈のしやすさ | 単純(1つの表で済む) | 表が2つ必要 |
| 現実性 | 因子が本当に無相関なら妥当 | 心理尺度では相関があるのが普通 |
| 使われる場面 | 因子を独立な指標として使いたいとき | 構造の理解が目的のとき |
追記:計算の中身は主成分分析とほぼ同じだった
ここまで「因子分析と主成分分析は考え方が逆」と書いてきました。ところがこの記事を書いたあとで疑問が湧きました。考え方が逆なら、パラメータを求める計算も違う手法を使うのだろうか。
調べたら逆でした。計算の機械はほぼ同一で、違うのは「その機械に何を入れるか」だけでした。ここが分かると、共通性・反復・回転という3つの話が1本につながります。この節はその記録です。
同じ機械に、対角だけ違う行列を入れている
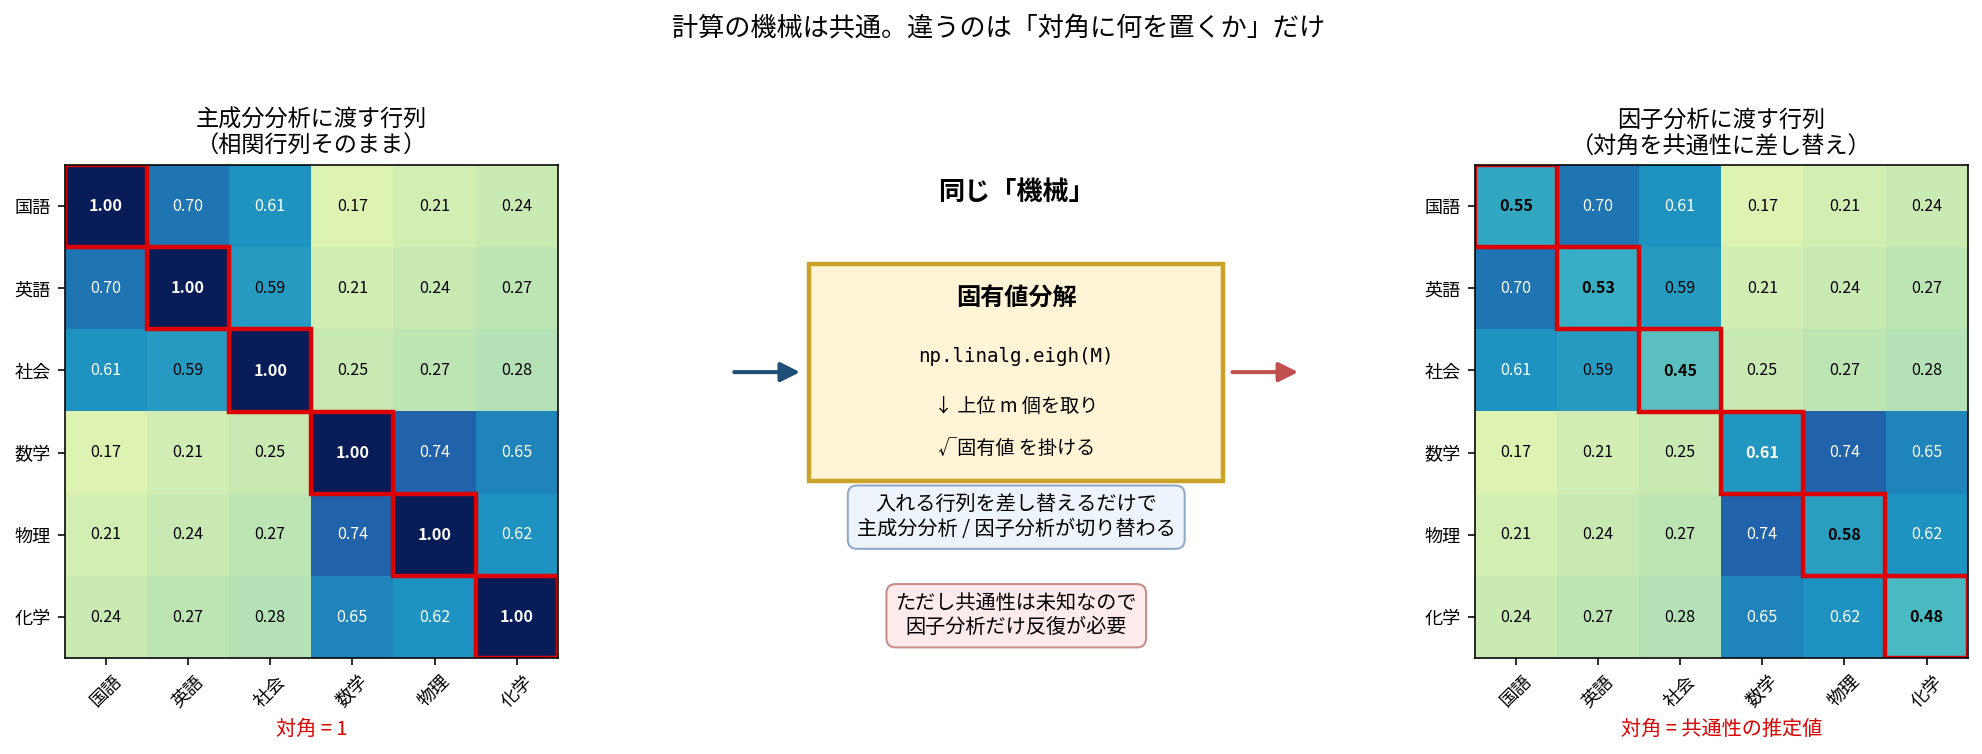
図の左右を見比べてください。非対角(相関の部分)は完全に同一です。赤枠で囲んだ対角だけが違います。
コードで書くとこうなります。
def extract(M, m):
    w, V = np.linalg.eigh(M)            # 固有値分解
    idx = np.argsort(w)[::-1][:m]       # 上位 m 個を取る
    w_m = np.clip(w[idx], 0, None)      # 負の固有値は0に丸める(後述)
    return V[:, idx] * np.sqrt(w_m)     # 固有ベクトル × √固有値

L_pca = extract(R, 2)          # ① 主成分分析:相関行列をそのまま

h2 = 1.0 - 1.0/np.diag(np.linalg.inv(R))   # 共通性の初期値(重相関係数の2乗)
Rs = R.copy()
np.fill_diagonal(Rs, h2)       # ← 違いはこの1行だけ
L_fa = extract(Rs, 2)          # ② 因子分析:対角を共通性に差し替え
np.clip を入れているのは、対角を共通性に差し替えると固有値に負の値が出ることがあるからです(理由は後の「因子数の決め方」で扱います)。
実際に因子分析のコードから対角の差し替えを外すと、主成分分析の負荷量と(固有ベクトルの符号を除いて)完全に一致することを確認しました。つまり主因子法は文字通り「対角を差し替えた主成分分析」です。
共通している部分を並べるとこうなります。
| 共通している部分 | 中身 |
|---|---|
| 入力 | どちらも相関行列だけ。生データは要らない |
| 核心の計算 | 対称行列の固有値分解 |
| 次元の選び方 | 固有値の大きい順に上位 個 |
| 負荷量の作り方 | 固有ベクトル × |
| 因子数・成分数の判断 | スクリープロットで固有値の並びを見る |
そして最尤法も、実は固有値問題として書けます。独自性で重み付けした行列 の固有値分解が最尤解を与えるという古典的な結果があります。今回のデータで計算すると固有値は 9.7124, 5.2969, 1, 1, 1, 1 で、1 を超えたのがちょうど2個(=指定した因子数)でした。ここから作った負荷量が EM アルゴリズムの解と一致することも確認しました。
残りが厳密に 1 になる理由は式で分かります。 を両側から で挟むと (ただし )になり、 の階数は なので固有値は「1より大きい値が 個、あとは全部1」です。
ただしこれを因子数の判定には使えません。 この性質が成り立つのは「因子数を正しく指定し、かつモデルが厳密に当てはまる」ときだけです。同じ母相関行列に1因子を当てると1超が3個になり、 の標本相関行列に2因子を当てると1超が4個になりました。1超の個数は指定した と当てはまりの結果であって、 を教えてくれる量ではありません。
| 推定法 | 何を固有値分解するか | 反復 |
|---|---|---|
| 主成分分析 | (対角は1のまま) | 不要 |
| 主成分法(因子分析) | をそのまま使い を後から辻褄合わせ | 不要 |
| 主因子法・反復主因子法 | の対角を に差し替えた行列 | 必要 |
| 最尤法 | (独自性で重み付け) | 必要 |
4つとも「何らかの行列の固有値分解」という同じ骨格を持っています。違うのは前処理と、その前処理に未知量が含まれるか(含まれるなら反復)だけでした。
そもそも共通性とは何か
上で「対角を共通性に差し替える」と書きましたが、共通性そのものをもう一度きちんと押さえます。前の節では負荷量の2乗の和として定義しましたが、意味から入ったほうが分かりやすいと気づきました。
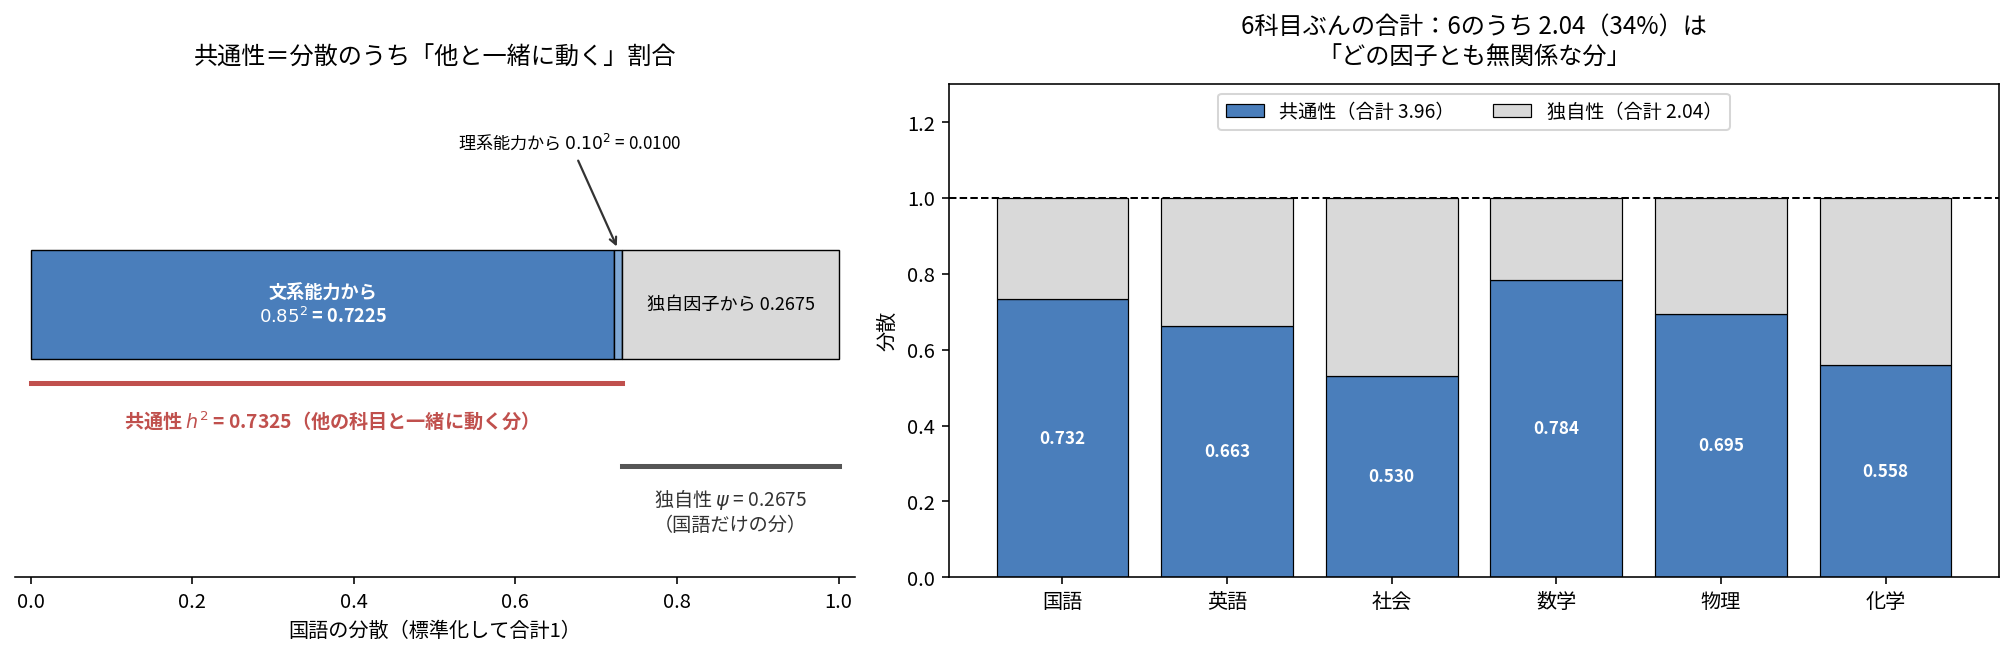
共通性とは、その変数の分散のうち「他の変数と一緒に動く」分です。
| 国語の分散 1.00 の内訳 | 値 | 相関に効くか |
|---|---|---|
| 文系能力から来た分 | 0.7225 | 効く |
| 理系能力から来た分 | 0.0100 | 効く |
| 合計=共通性 | 0.7325 | これが相関を作る |
| 独自因子から来た分=独自性 | 0.2675 | 一切効かない |
「一切効かない」を確かめます。国語と数学の相関を共通因子だけから計算すると
で、実際の とぴったり一致しました。独自因子同士が無相関という仮定を置いているので、独自因子は相関に1ミリも寄与しません。
だから「相関だけを説明したい」因子分析にとって、対角に入っている独自性は邪魔な混入物です。6科目ぶん合計すると、6 のうち 2.04(34%)が独自性でした。
では「固有値の top k を取るだけ」では駄目なのか
因子数を と決めているなら、主成分分析と同じように固有値の上位 個を取れば済むのではないか。これも自然な疑問です。
答えは「それも実在する方法」です。 主成分法(principal component method)という名前が付いていて、教科書にもソフトウェアの選択肢にもあります。やってみました。
| やり方 | 非対角の最大誤差 | 負荷量の最大誤差 | 名前 |
|---|---|---|---|
| 対角=1 のまま top2 | 0.144371 | 0.1164 | 主成分法 |
| 対角=共通性 で top2 | 0.000000 | 0.0022 | 主因子法 |
では何が起きているのか。鍵は固有値の性質です。
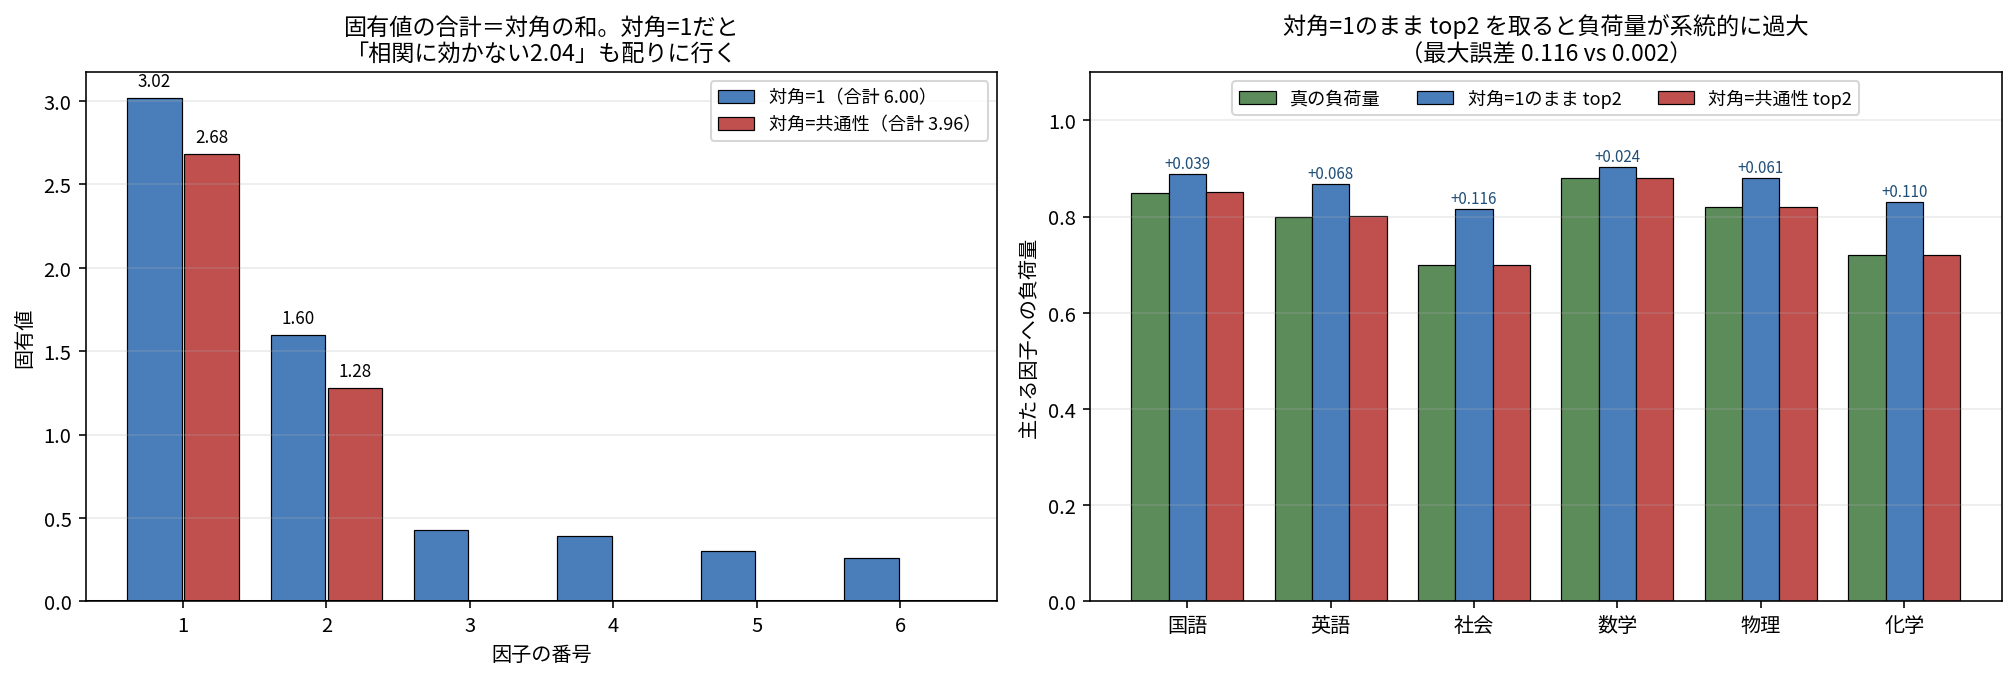
対角を 1 のままにすると固有値の合計は 6.00 になります。しかしこの 6 のうち 2.04 は独自性=相関に効かない分です。固有値分解は行列の全成分(対角を含む)の誤差を小さくしようとするので、top 2 の因子がこの 2.04 も背負おうとして負荷量が膨らみます。
| 科目 | 真の負荷量(主たる因子) | 対角=1のまま | ずれ | 対角=共通性 |
|---|---|---|---|---|
| 国語 | 0.850 | 0.889 | +0.039 | 0.850 |
| 英語 | 0.800 | 0.868 | +0.068 | 0.800 |
| 社会 | 0.700 | 0.816 | +0.116 | 0.700 |
| 数学 | 0.880 | 0.904 | +0.024 | 0.880 |
| 物理 | 0.820 | 0.881 | +0.061 | 0.820 |
| 化学 | 0.720 | 0.830 | +0.110 | 0.719 |
主たる因子への負荷量は6科目すべてで過大になりました。逆に小さいほうの負荷量は過小に出ます(国語の理系は真 0.100 に対して 0.089、社会の理系は 0.200 に対して 0.186)。つまり「全部大きくなる」のではなく、独自性の分を無理に背負わせた結果、負荷量のコントラストが実際より強く出るという歪みです。
対角を共通性に差し替えると固有値の合計は 3.96 になり、正の固有値2つ(2.6836 + 1.2791 = 3.9627)でちょうど使い切ります(ここでは反復が収束した後の共通性を使っています。粗い推定値を入れると負の固有値が出ますが、それは後の「因子数の決め方」で扱います)。「相関に効く分」だけを取り出したので、2因子でぴったり説明できるわけです。
この歪みは「独自性をどれだけ無視したか」に比例します。
| 独自性の平均 | 対角=1のままの負荷量誤差 | 対角=共通性の誤差 |
|---|---|---|
| 0.736(独自性が大きい) | 0.2247 | 0.0014 |
| 0.538 | 0.1604 | 0.0018 |
| 0.340(今回の設定) | 0.1164 | 0.0022 |
逆に言えば、共通性が高い変数ばかりなら主成分法でも実用上問題ありません。 両者の違いが際立つのは独自性が大きいときで、心理尺度のように1項目の信頼性が低い場面ほどこの区別が実質的な意味を持ちます。
なぜ因子分析だけ反復が必要なのか
ここで前の節の「共通性の推定には循環がある」がつながります。
対角を共通性に差し替えたい。ところが共通性は負荷量から計算される量なので、最初から分かっていません。
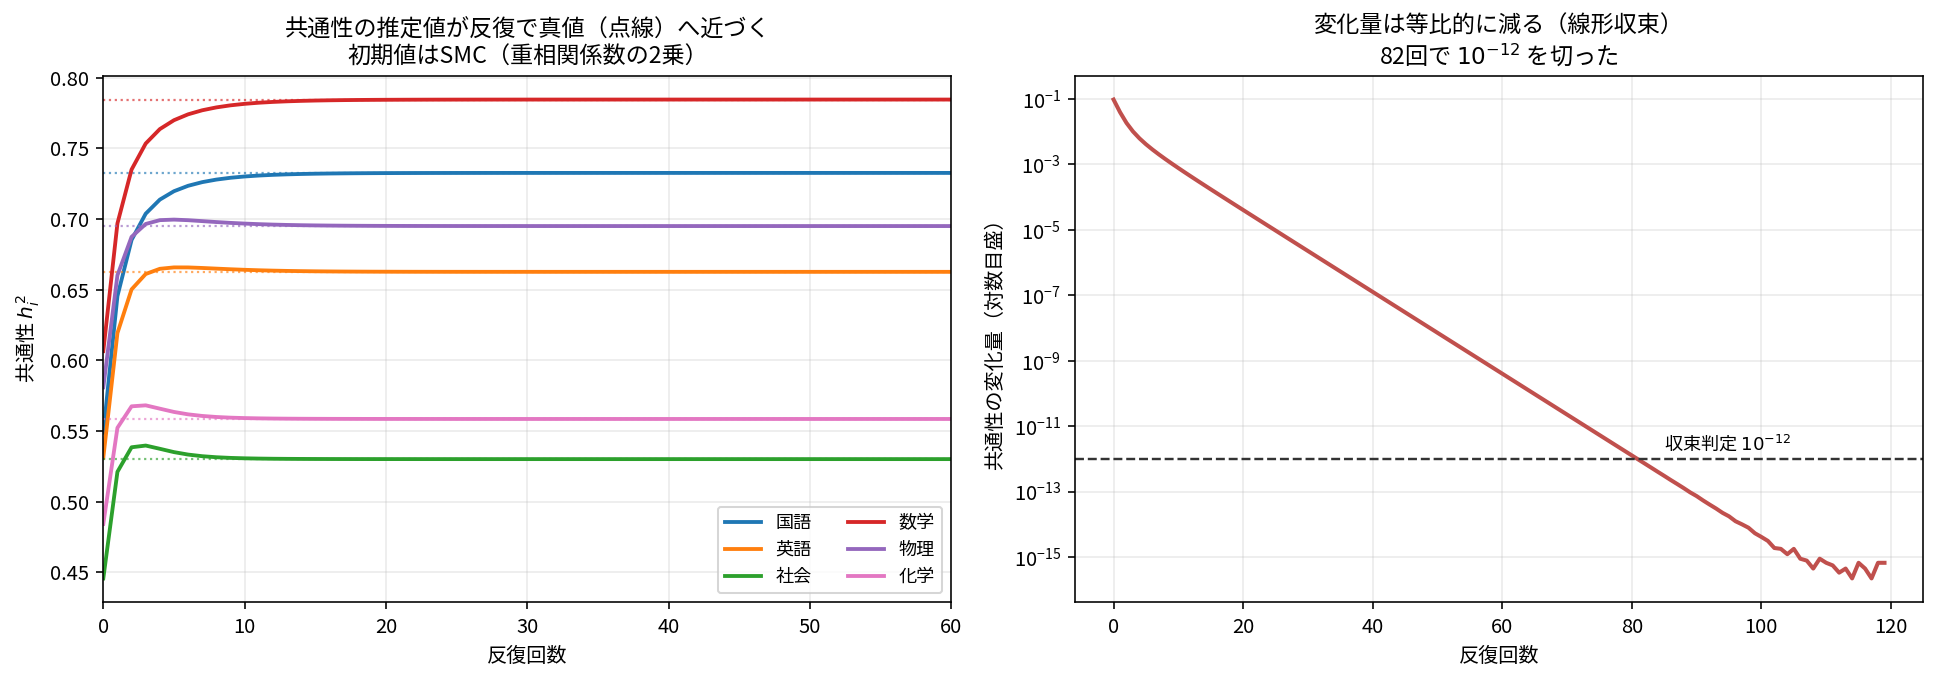
左の図が反復の様子です。重相関係数の2乗を初期値(0.45〜0.61)に置いて、負荷量を計算し、共通性を更新し、また負荷量を計算する。10回程度でほぼ真値に達し、社会と化学(幅は小さいが英語と物理も)は一度オーバーシュートしてから戻るのが見えます。右の図は変化量を対数目盛で見たもので、直線=等比的に減る線形収束です。82回で を切りました。
主成分分析にはこのグラフが存在しません。 渡す行列(対角=1)が最初から確定しているので、固有値分解1回で終わります。
要点:因子分析の反復は「固有値分解が難しいから」ではない。固有値分解に渡すべき行列そのものが未知だからである。主成分分析は渡す行列が最初から決まっているので1回で終わる。
文系/理系に分けているのは「回転」だった
もう1つ、この記事を書いたあとで気づいた重要な点があります。
冒頭の図で「国語 = 0.850×文系能力 + 0.098×理系能力 + 独自因子」という式を出しました。これはきれいに分かれすぎています。 主成分分析でこんなに都合よく分かれる気はしません。実際に主成分分析の中身を見ると、そのとおりでした。
| 国語 | 英語 | 社会 | 数学 | 物理 | 化学 | 正体 | |
|---|---|---|---|---|---|---|---|
| 第1主成分 | +0.390 | +0.401 | +0.401 | +0.414 | +0.422 | +0.420 | 総合学力 |
| 第2主成分 | +0.461 | +0.423 | +0.366 | −0.439 | −0.402 | −0.346 | 文系−理系の対比 |
第1主成分は6科目が全部プラスでほぼ均等なので「文系能力」とは呼べません。主成分分析は分散の大きい順に軸を取るので、いちばん分散が大きい「全科目できる人 vs できない人」の方向が第1主成分になります。だから第1主成分は総合力寄りになりがちです。
ところが因子分析も回転前は同じ形でした。
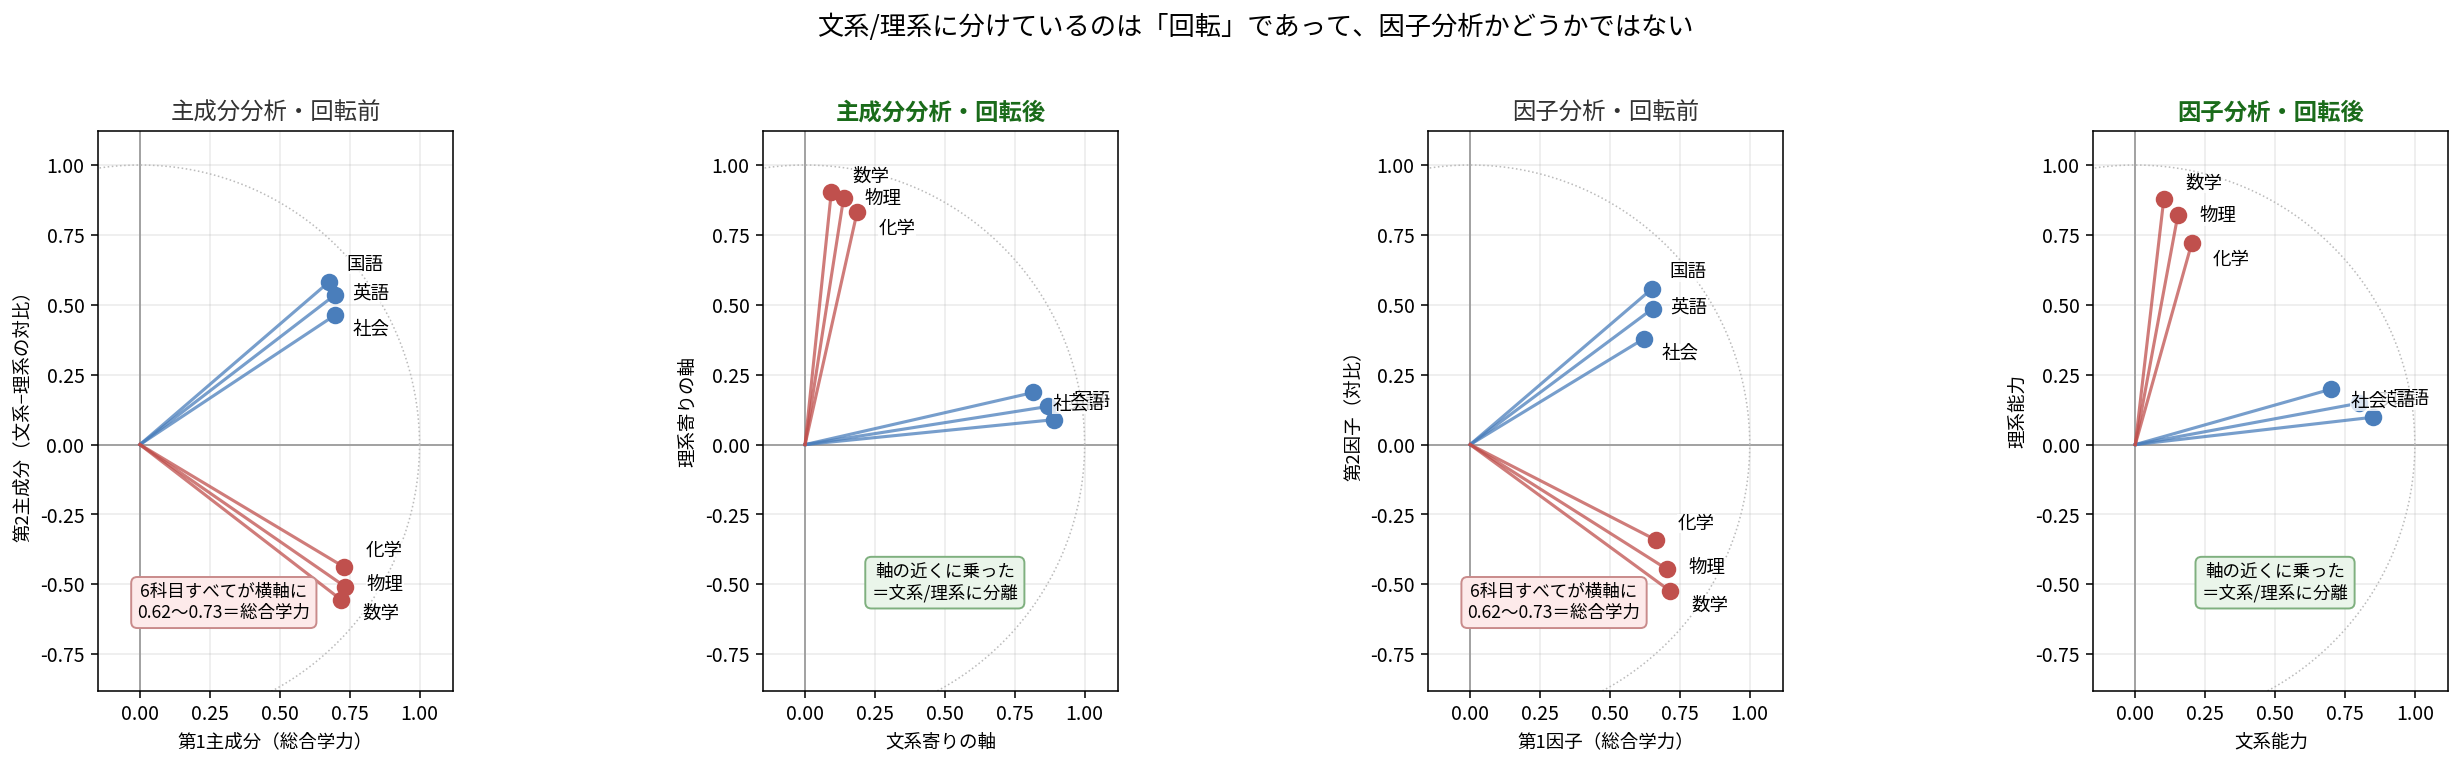
図の左2枚が主成分分析、右2枚が因子分析です。回転前(1枚目・3枚目)はどちらも同じ形で、6科目すべてが横軸方向に伸びています。因子分析の回転前の第1因子は 0.622〜0.715 で、これも「総合学力」です。
そして回転後(2枚目・4枚目)はどちらも文系/理系に分離しました。
逆向きの検証もしました。もし「分かれるのは因子分析だから」なら、主成分分析を回転しても分かれないはずです。
| 科目 | 主成分 回転前 PC1 | 回転前 PC2 | 回転後 軸1 | 回転後 軸2 |
|---|---|---|---|---|
| 国語 | 0.677 | +0.583 | 0.889 | 0.089 |
| 英語 | 0.697 | +0.535 | 0.868 | 0.136 |
| 社会 | 0.698 | +0.463 | 0.816 | 0.186 |
| 数学 | 0.720 | −0.555 | 0.094 | 0.904 |
| 物理 | 0.733 | −0.508 | 0.138 | 0.881 |
| 化学 | 0.730 | −0.438 | 0.186 | 0.830 |
分かれました。 これで「きれいに分かれるか」は主成分分析 vs 因子分析の違いではなく、回転したかどうかの違いだと確定します。(値が因子分析より大きめなのは、前述の「対角=1のまま」による過大推定です。構造の形は同じです。)
では、なぜ主成分分析では普通は回転しないのか。
| 軸1が説明する分散 | 軸2 | 合計 | |
|---|---|---|---|
| 回転前(=主成分) | 3.0203 | 1.5979 | 4.6182 |
| バリマックス回転後 | 2.2737 | 2.3446 | 4.6182 |
合計(4.6182)は変わりませんが、配分が平準化されます(ここでの「説明する分散」は負荷量の列の2乗和です。回転前ならこれは固有値そのもので、3.0203/1.5979 と一致することを確認しました)。しかも回転後は負荷量の列が直交しなくなるので、2.2737 と 2.3446 はもう互いに独立な取り分ではありません。主成分分析の売りは「第1主成分に最大の分散を集める」ことなので、回転するとその性質を失い、もはや主成分ではなくなります。次元圧縮が目的なら第1軸に情報を集めたいので、回転は目的に反します。
一方因子分析は分散を集めることが目的ではありません。 相関を再現できていれば十分で、どの向きでも当てはまりは同じ。失うものがないから、解釈しやすい向きを選べるわけです。
要点:「回転の不定性」は欠点のように見えて、実は自由に使える余地だった。主成分分析は回転すると売り(分散最大)を失うので回転しない。因子分析は失うものがないので回転できる。
なお「直交」という言葉は文脈で別のものを指すので、整理しておきます。
| 「直交」の意味 | 成り立つか | 実測値 |
|---|---|---|
| 主成分の係数ベクトルが互いに直交 | 成り立つ(固有ベクトルの性質) | |
| 主成分得点が無相関 | 成り立つ | |
| 因子分析の因子が無相関 | 仮定として置く | と置く |
| 推定した因子得点が無相関 | 成り立たない | 0.048 |
| 回転後の負荷量の列が直交 | 成り立たない | 内積 0.710(主成分分析。因子分析でも 0.700) |
重要なのは、主成分分析の直交性は固有ベクトルの性質として自動的に成り立つのに対し、因子分析の直交性は置いた仮定だという点です。だからプロマックス回転(斜交)を選べば因子間相関 0.3748 と推定されます。同じデータから「相関 0.37 がある」解と「相関 0」の解が、同じ当てはまりで出てくるわけです。
4番目も注意が必要です。因子が仮定として無相関でも、推定した因子得点は無相関になりません(実測 0.048)。前に述べた因子得点の不定性の帰結です。
回転の角度はどうやって決まるのか
「解釈しやすい向きを選ぶ」と書きましたが、人が目で見て選んでいるわけではありません。 バリマックス基準を最大化する角度を数値的に求めるだけです。
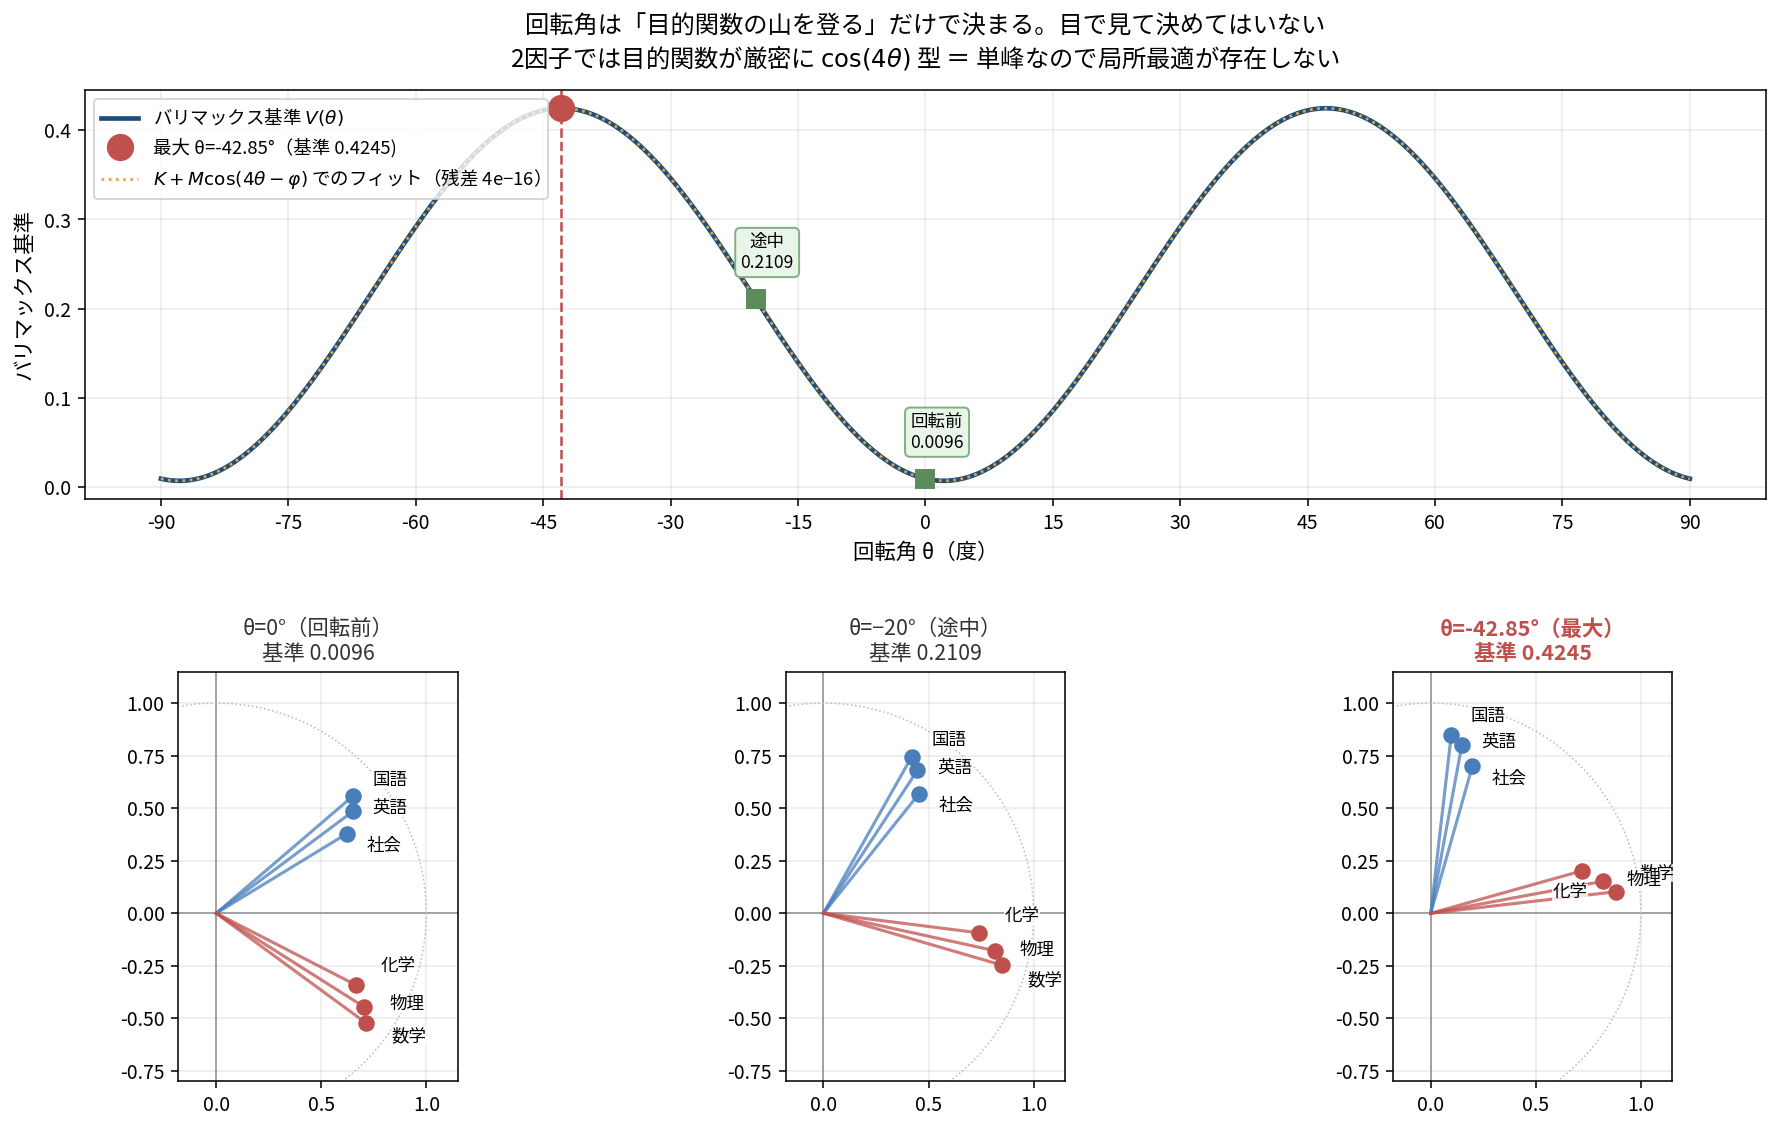
上段が目的関数です。きれいな余弦曲線になっていて、山の頂上()を探すだけの問題です。
そして2因子なら閉じた式で一発で求まります。 負荷量の2列(この記事の方針どおり、カイザー正規化して行の長さを1に揃えた後の列)を として 、 と置くと
今回の数値では 、、分子 、分母 で、 が出ます。
ひとつ注意があります。 を素朴に に入れると 、 になりますが、この角度の基準値は 0.0072 で最小のほうです。分子と分母の符号を別々に見て の象限を決める必要があります(今回は両方が負なので第3象限。プログラムでは arctan2(分子, 分母) を使います)。 の周期が 180° なので、 で 180° の差= で 45° の差が、最大と最小の取り違えになります。
| 求め方 | 答え | 計算量 |
|---|---|---|
| 総当たり(0.001度刻み・18万点) | 18万回の評価 | |
| 閉じた式() | 1回 | |
| 反復アルゴリズム(SVD法) | 349回の反復 |
3つの方法が小数第3位まで一致しました(総当たり 、閉じた式 、SVD法 )。回転角は連立方程式を解くのと同じくらい確定的な計算です。
なぜ余弦曲線になるのか。ここは「4次式だから倍角公式で」だけでは足りません。一般の三角4次式なら の項も出るはずなのに、実際にフィットすると の係数は厳密に0でした。
理由は行ごとの2乗和が回転で不変(共通性は回転で変わらない)だからです。、 と置くと、 は角度によらない定数で、 は について純粋な の波になります。バリマックス基準はこの と の2次式として
と書けます(数値で12桁の一致を確認しました)。 の波の2次式なので、出てくるのは と定数だけ。 や の項は原理的に現れません。
実際に の形で最小二乗フィットしたら 、、 で、最大残差 。厳密にこの形でした(振幅は 、位相は 。上の式の がこの振幅にあたります)。
ここから2つ分かります。周期が 90° なのは、 が 360° 回る間に は 90° しか進まないから。 そして90°の周期の中に山は1つだけ(=実質的に単峰)なので、どこから探し始めても同じ答えに着きます。2因子のバリマックス回転には「いい感じに調整する」余地が原理的にありません。
3因子以上では閉じた式がないので、因子を2本ずつペアにして上の公式を順に適用します。3因子なら (1,2), (1,3), (2,3) の3組を1周として、基準値が上がらなくなるまで繰り返します。今回の3因子の例では3周(=9回のペア回転)で収束しました(0.4227944349 → 0.4227944424 → 収束)。カイザーの原論文(1958年)の方法で、現在も標準的に使われています。
単峰性が保証されるのは2因子だけなので、局所最適も確認しました。ランダムな直交行列で初期値をかき混ぜて200回試すと、200回すべてが同じ値(0.422794442、標準偏差 )に到達しました。ただしこれは一般の保証ではないので、実データでは初期値を変えて再現性を見るのが作法です。
要点:分析者が選ぶのは「どの基準で回すか」だけ(バリマックスかプロマックスか、直交か斜交か)。基準を決めた後の角度は一意に計算される。 恣意性があるのは基準の選択までで、角度の決定は完全に機械的である。
この節で分かったことの整理
4つの疑問が1本につながりました。
| 疑問 | 答え |
|---|---|
| 推定は主成分分析と同じ手法か | ほぼ同じ。どちらも固有値分解で、違いは渡す行列の対角だけ |
| 共通性とは何か | その変数の分散のうち他の変数と一緒に動く分。独自性は相関に一切効かない |
| 固有値の top を取るだけでは駄目か | それも実在する方法(主成分法)。ただし対角に独自性が混ざるので負荷量が過大になる(最大 +0.116) |
| なぜ反復が必要か | 対角に置くべき共通性が未知だから。固有値分解自体は1回で済む |
| 文系/理系に分かれるのは因子分析だから? | 違う。回転のおかげ。主成分分析を回転しても同じように分かれる |
| 回転角はどう決めるか | バリマックス基準を最大化する角度。2因子なら の式で一意に確定 |
そして全部の根っこは同じでした。主成分分析は行列全体(対角を含む)を近似し、因子分析は非対角だけを近似して対角は に任せる。 「矢印の向きが逆」という考え方の違いは、計算上はこの対角の扱いにだけ現れるのでした。
因子数の決め方
因子数は分析者が決める必要があります。基準がいくつもあるので整理します。
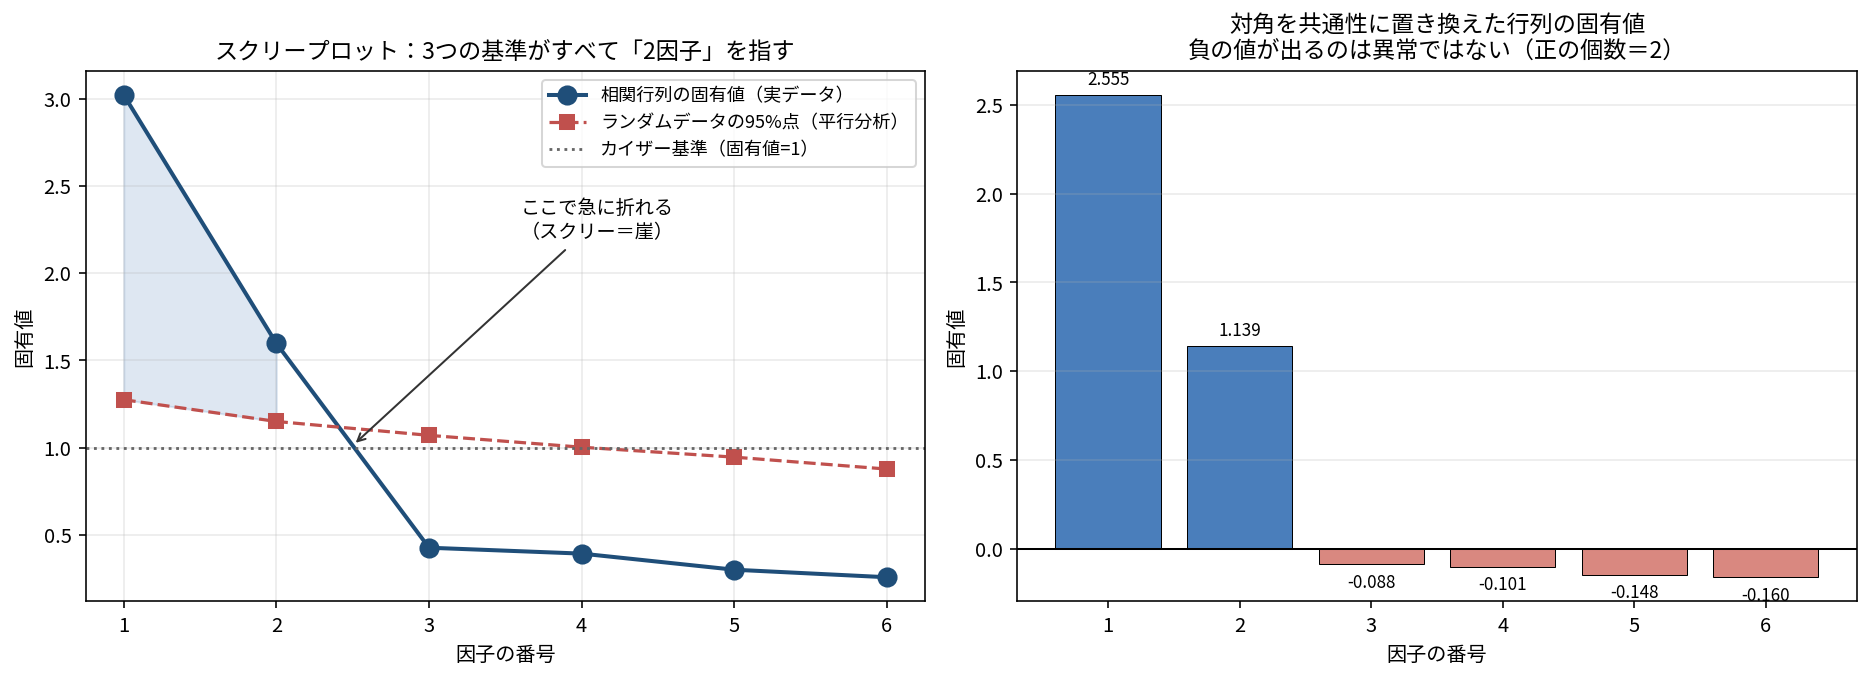
今回のデータで6つの基準を全部試したところ、すべてが2因子を指しました。図に描いたのはこのうち3つです。
| 基準 | 中身 | 今回の結果 |
|---|---|---|
| カイザー基準 | 相関行列の固有値が1を超える個数 | 2(3.0203, 1.5979 が1超) |
| スクリープロット | 固有値の折れ曲がり(崖)の位置 | 2(1.5979 → 0.4277 で急落) |
| 平行分析 | ランダムデータの固有値の95%点を超える個数 | 2 |
| 正の固有値の数 | 対角を共通性にした行列の正の固有値の個数 | 2(2.555, 1.139) |
| 累積寄与率 | 一定割合(例:70〜80%)に達する個数 | 2(76.97%) |
| 検定 | 当てはまりが棄却されない最小の因子数 | 2(=0.810、1因子は ) |
固有値の実測値を並べます。
| 番号 | 相関行列の固有値 | ランダムデータの95%点 | 対角を共通性にした固有値 |
|---|---|---|---|
| 1 | 3.0203 | 1.2754 | 2.5551 |
| 2 | 1.5979 | 1.1508 | 1.1394 |
| 3 | 0.4277 | 1.0712 | −0.0883 |
| 4 | 0.3939 | 1.0033 | −0.1012 |
| 5 | 0.3016 | 0.9464 | −0.1482 |
| 6 | 0.2586 | 0.8782 | −0.1601 |
いくつか注意点があります。
カイザー基準(固有値1以上)は使いすぎると危険です。 「固有値1」の根拠は「1変数分の情報量」なのですが、これは主成分分析の発想です。因子分析では対角を共通性に置き換えるので、基準がずれます。実務では因子数を多く見積もる傾向があると指摘されています。
平行分析のほうが信頼できるとされます。 考え方は明快で、まったく相関のないランダムデータでも、偶然これくらいの固有値は出るという線を引きます。表の第3列を見ると、無相関データでも第1固有値は 1.2754 まで出ています(この値は 、 での95%点です。 を増やせば1に近づき、 で なら約1.15、 なら約1.06。逆に なら約1.48まで膨らみます)。
カイザー基準の 1 はこの標本規模での偶然の水準より低いので、1を基準にすると偶然の変動を因子と誤認しうるわけです。閾値が標本サイズと変数の数に依存するのに、カイザー基準は固定値の1を使う——これが平行分析のほうが信頼できるとされる理由でした。
対角を共通性の推定値に置き換えると、固有値に負の値が出ます。 これは異常ではありません。実務では真の共通性が分からないので重相関係数の2乗などで代用しますが、この推定値は真の共通性を下回りがちで、対角を下げすぎた結果として行列が半正定値でなくなり、負の固有値が現れます。表の第4列で第3因子以降が負になっているのはこれで、正の個数(2個)が因子数の目安になります。
参考に、この例で真の共通性(0.7325, 0.6625, …)を対角に置くと固有値は 2.6836, 1.2791, 0, 0, 0, 0 となり、負は出ずにちょうど階数2の行列になります。負が出るのは「共通性が推定値だから」で、モデル自体の性質ではありませんでした。
最終的には解釈可能性も判断材料になります。 統計的基準で2因子と3因子のどちらもありえる場合、負荷量を見て意味を言える方を選ぶ、という判断が実務では行われます。ここは主観が入るところで、だから複数の基準を併記して報告します。
因子得点:個人の値は推定できるのか
因子負荷量は「どの変数がどの因子と結びつくか」の話でした。では個々の回答者について因子の値を知りたい場合はどうするか。これが因子得点です。
用途はあります。アンケートから「内向性スコア」を作って他の分析に使いたい、顧客を因子得点でセグメント分けしたい、といった場面です。
ここで主成分分析との違いがまた出ます。主成分得点は計算できます(観測値に係数を掛けて足すだけ)。因子得点は計算できず、推定するしかありません。 因子が観測されていないので当然です。
主な方法は2つです。
| 方法 | 考え方 | 性質 |
|---|---|---|
| 回帰法(トムソン法) | 因子を観測変数で回帰する形で推定 | 真の因子との相関が最大。ただし推定値の分散が1より小さくなる |
| バートレット法 | 独自性で重み付けした最小二乗 | 条件付き不偏()。代わりに推定値の分散が1より大きくなる |
数値で確かめました。 のデータで両方を計算し、真の因子得点(生成時に使った値)と比べます。
| 確認したこと | 値 |
|---|---|
| 回帰法とバートレット法の因子得点の相関 | 0.999155 |
| 文系能力の因子得点と真の因子の相関(回帰法/バートレット法) | 0.9204/0.9203 |
| 理系能力の因子得点と真の因子の相関(回帰法/バートレット法) | 0.9345/0.9344 |
2つの方法はほぼ同じ結果(相関 0.999)になりました。そして真の因子との相関は 0.92〜0.93 で、1ではありません。
この「1にならない」ことが因子得点の不定性です。 しかもこれは推定の失敗ではなく原理的な上限です。回帰法の因子得点が真の因子と持てる相関は で決まり、この設定では文系 0.9173、理系 0.9310 でした。 の実測値(0.9204/0.9345)はこれをわずかに上回っていますが、上限は母集団の量なので、有限標本で実現した因子の値との相関は標本誤差で上下にぶれます(40回試すと平均 0.9178/0.9311、標準偏差 0.003〜0.004 で、上限を超えるのは半分強)。実際、標本を に増やすと 0.917/0.931 に落ち着き、それ以上には改善しません。
ここが負荷量と因子得点の決定的な違いです。負荷量は多数のデータから推定するので を増やせば精度が上がりますが、個人の因子得点はその人の回答だけから推定するので、 をいくら増やしても独自因子の影響を分離しきれません。
2つの方法の性質の違いも数値で出ました()。
| 方法 | 因子得点の分散(実測・理系/文系) | 理論値 | の傾き |
|---|---|---|---|
| 回帰法 | 0.866/0.843 | = 0.866/0.843 | 約 0.85(1に縮む) |
| バートレット法 | 1.157/1.190 | = 1.157/1.190 | 約 1.00(不偏) |
回帰法は分散が1より小さく縮む代わりに真の因子との相関が最大、バートレット法は不偏の代償として分散が1より大きくなるというトレードオフです。どちらも真の因子得点そのものではありません。
実務上の含意はこうなります。因子得点は集団の傾向を見たり、大小を比較したりする用途には使えますが、個人の値を確定的な数値として扱ってはいけません。 「あなたの内向性スコアは 1.23 です」と1点で示すのは過剰な精度の主張になります。相関 0.93 は高いですが、個人単位では順位が入れ替わる程度の誤差が残ります。
探索的因子分析と確認的因子分析
ここまで扱ってきたのは探索的因子分析(EFA:Exploratory Factor Analysis)です。因子数も、どの変数がどの因子に結びつくかも決めずに、データから探しました。
これに対して確認的因子分析(CFA:Confirmatory Factor Analysis)は、構造を先に指定します。「国語・英語・社会は第1因子だけから影響を受け、第2因子の負荷量はゼロに固定する」といった制約を置いて、そのモデルがデータに当てはまるかを検定します。
| 探索的因子分析(EFA) | 確認的因子分析(CFA) | |
|---|---|---|
| 因子数 | データから決める | 事前に指定する |
| 負荷量の構造 | すべて自由に推定 | 一部をゼロに固定する |
| 回転 | 必要(不定性があるため) | 不要(制約で解が定まる) |
| 目的 | 構造の発見 | 仮説の検証 |
| 使う場面 | 新しい尺度を作るとき | 既存の尺度が別集団でも成り立つか確認するとき |
| 枠組み | 因子分析 | 構造方程式モデリング(SEM)の一部 |
回転が不要になるのがCFAの重要な性質です。 「この変数の負荷量はゼロ」という制約を十分に置くと、回転させると制約が壊れるので、解が一意に定まります。探索的分析で悩んだ回転の不定性が、制約によって解消されるわけです。
当てはまりの検定は先ほどの でやりました。1因子モデルは (自由度9、)で棄却され、2因子モデルは (自由度4、)で棄却されませんでした。
検定は他の検定と帰無仮説の向きが逆なので注意が必要です。ここでの帰無仮説は「モデルが正しい」です。したがって 値が大きいほどモデルが良いことになります。棄却されたら当てはまりが不足しているという読み方です。第14回の適合度検定と同じ構造で、第12回で扱った「棄却されないことは正しさの証明ではない」という注意もそのまま当てはまります。
なお は標本サイズに比例して大きくなる(。ここでの は標本相関行列に対する不適合度です)ので、 が大きいと些細なずれでも棄却されてしまいます。先に出した母集団の の表とこの は、別の行列(母相関行列と の標本相関行列)から、しかも別の推定法(前者は主因子法の解、後者は最尤法の解)で計算しているので、 を計算しても 347.698 にはなりません(最尤法で標本相関行列に1因子を当てると で、 です)。また の代わりにバートレット補正 を使う流儀もあり、教科書によって係数が違います。
そのため実務では RMSEA や CFI といった標本サイズの影響を補正した指標が併用されますが、準1級の範囲では 検定と自由度の数え方を押さえておけば十分だと思います。
グラフィカルモデル:なぜ同じ章にあるのか
因子分析の後にグラフィカルモデルが出てくるのは唐突に感じました。調べてみると、共通のテーマがありました。
どちらも「観測された相関を、背後の構造で説明する」道具です。 因子分析は「見えない共通因子があるから相関する」と説明し、グラフィカルモデルは「この変数を経由しているから相関する」と説明します。説明の道具が違うだけで、相関行列を構造に読み替えるという目的は同じです。
そして技術的にも共通点があります。どちらも多変量正規分布を前提に、相関行列(または分散共分散行列)だけを入力として構造を推定します。
偏相関係数と条件付き独立
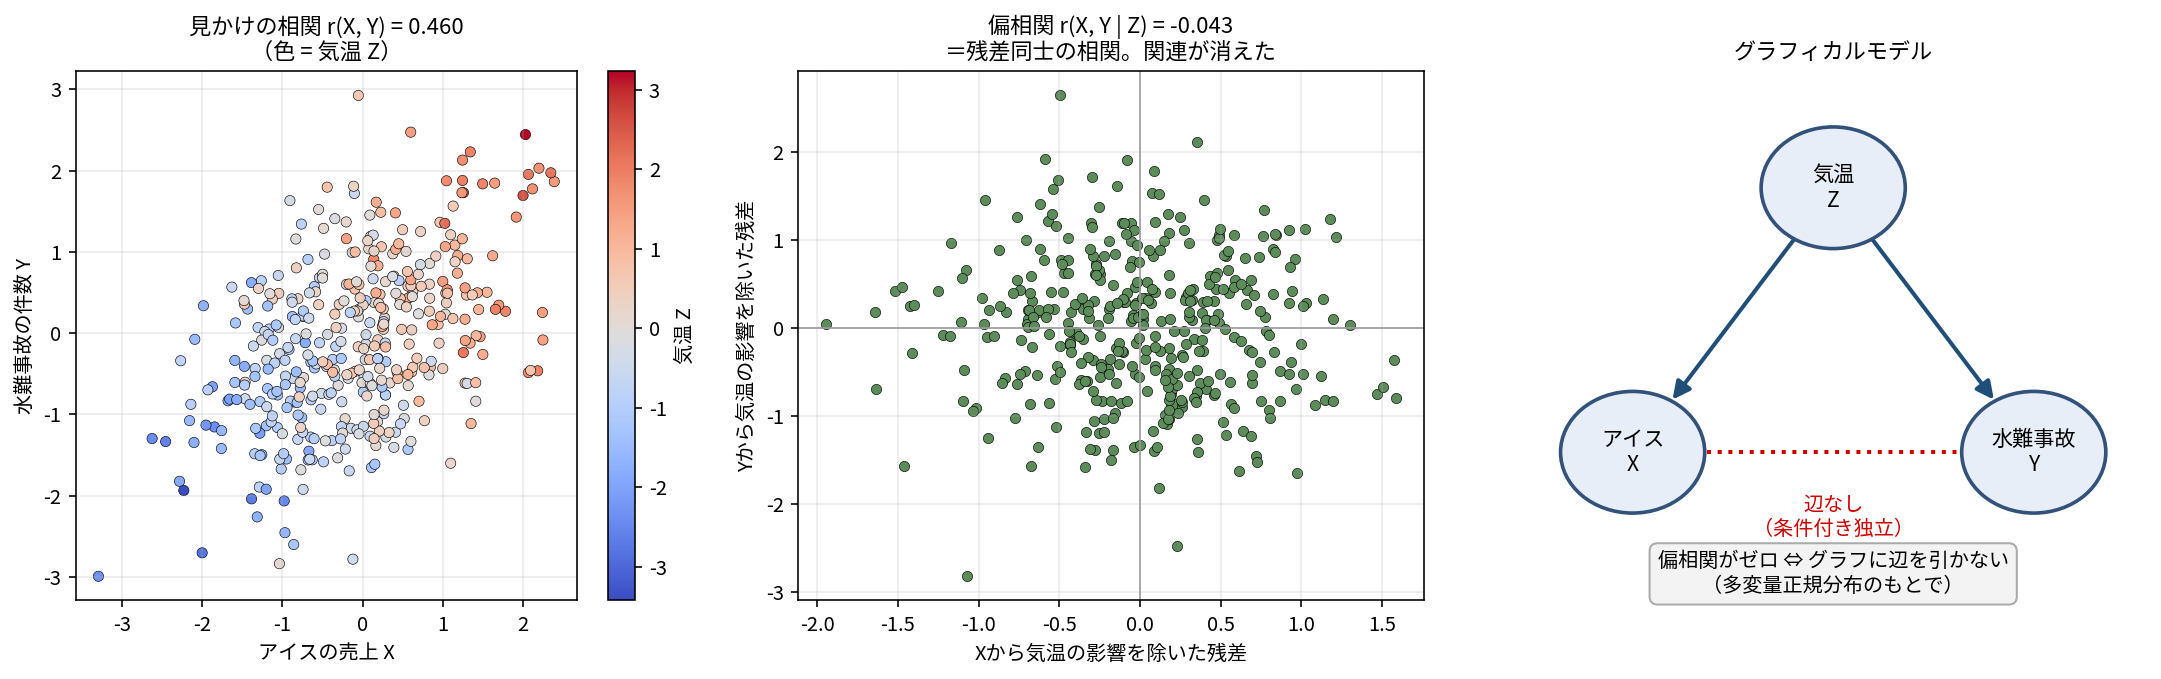
古典的な例で見ます。アイスクリームの売上と水難事故の件数には相関があります。だからといってアイスを規制しても事故は減りません。どちらも気温という共通の原因で動いているだけです。
数値を作って確かめます。気温 がアイス に 0.8、水難事故 に 0.6 の強さで影響し、 と の間には直接の関係がないとします。このとき相関行列はこうなります。
| 気温 | アイス | 水難事故 | |
|---|---|---|---|
| 気温 | 1.0000 | 0.8000 | 0.6000 |
| アイス | 0.8000 | 1.0000 | 0.4800 |
| 水難事故 | 0.6000 | 0.4800 | 1.0000 |
と の相関は 0.4800 で、ゼロではありません。直接の関係がないのに相関が出ています( という経路の積になっています)。
ここで気温を固定したらどうなるか。偏相関係数の式はこうです。
代入します。
ちょうどゼロになりました。 分子が厳密に 0 です。見かけの相関 0.48 は、すべて気温を経由した分だったことになります。
これを条件付き独立と呼びます。 を与えると と は独立、という意味です。記号では と書きます。
厳密に言うと、偏相関ゼロと条件付き独立は一般には別物です。 偏相関が除去するのは他の変数の線形の影響だけなので、どちらの向きも一般には成り立ちません。
反例を作って確かめました。 として 、( は独立な誤差)とします。作り方から は厳密に成立しています。ところが で計算すると
| 確認したこと | 値 |
|---|---|
| 0.6668 | |
| 偏相関 | 0.6668(ゼロにならない) |
| を に固定した条件付き相関 | 0.0034(≈0。条件付き独立は成立している) |
条件付き独立が厳密に成り立っているのに、偏相関は 0.667 も残りました。 理由は という非線形の部分が線形回帰の残差に残り、 と で共通の変動を作るからです。
成り立つのは「 と が の1次式であるとき、条件付き独立ならば偏相関ゼロ」という条件つきの主張です。多変量正規分布のもとでは条件付き期待値が線形になるので、両者が同値になります。 グラフィカルモデルで正規性を仮定するのはこのためです。ここは試験でも問われうる注意点だと思いました。
精度行列との対応
グラフィカルモデルの計算上の核心はここです。相関行列の逆行列(精度行列)を見ると、辺の有無が直接読めます。
先ほどの相関行列の逆行列を計算します。
| 気温 | アイス | 水難事故 | |
|---|---|---|---|
| 気温 | 3.3403 | −2.2222 | −0.9375 |
| アイス | −2.2222 | 2.7778 | 0.0000 |
| 水難事故 | −0.9375 | 0.0000 | 1.5625 |
と の成分がちょうど 0 になっています。 これが「グラフに – の辺を引かない」ことに対応します。
一般に、精度行列を とすると偏相関は
で求まります。マイナスが付くのが特徴です。精度行列の非対角成分がゼロ ⇔ 偏相関がゼロ ⇔ グラフに辺がないという三段の対応が成り立ちます。
だからグラフィカルモデルの実務は「精度行列を推定して、ゼロに近い成分の辺を落とす」作業になります。変数が多いと推定が不安定なので、第19回で扱った Lasso のような正則化を精度行列に掛ける手法(グラフィカル Lasso)が使われます。ここで正則化が再登場するのは伏線回収でした。
偏回帰係数と同じ発想か
同じ発想です。 これも確かめました。
偏相関の定義は「他の変数の影響を除いた相関」ですが、より具体的には他の変数で回帰した残差同士の相関です。 のシミュレーションで検証しました。
| 確認したこと | 値 |
|---|---|
| 実測の相関 | 0.4826(理論 0.4800) |
| 偏相関 を公式で計算 | 0.0002(理論 0) |
| で回帰した残差同士の相関 | 0.0002 |
公式で計算した偏相関と、残差同士の相関が一致しました。 第16回で偏回帰係数が「他の変数で回帰した残差に対する回帰」だと確かめたのと同じ構造です。
対応を並べるとこうなります。
| 第16回(偏回帰係数) | 今回(偏相関係数) |
|---|---|
| 他の説明変数の影響を除いた の効果 | 他の変数の影響を除いた と の関連 |
| と を他の変数で回帰した残差同士の回帰の傾き | 残差同士の相関 |
| の対角が分散を膨らませる(VIF) | 精度行列 の非対角が偏相関を与える |
図の中央パネルが「残差同士の散布図」で、これは構造のない雲になっています。左パネルでは点の色(気温)が右上と左下に偏っていて、相関が気温によって作られていることが目で見えます。色の偏りを取り除くと関連が消える、という順序で読むと分かりやすいと思いました。
コラム:変数を入れれば安全、ではない
ここまでは「共通原因を条件づけると見かけの相関が消える」話でした。逆向きの現象もあって、こちらのほうが実務では危険です。
と が本当に独立だとします。そして両方から影響を受ける第3の変数 があるとします()。このとき を条件づけると何が起きるか。
| 確認したこと | 理論値 | 実測値() |
|---|---|---|
| 0.0000 | 0.0018 | |
| −0.800000 | −0.800440 |
独立だった2変数に、強い負の相関(−0.80)が生まれました。
理屈は考えれば当たり前です。 の値が分かっているとき(たとえば )、 が大きければ は小さいはずです。合計が決まっているので片方が大きいと他方が小さくなる。だから負の相関が出ます。
このように2つの変数から矢印を受ける変数を合流点(コライダー)と呼び、合流点で条件づけると偽の関連が生まれます。「交絡を防ぐために変数はできるだけ入れておこう」という発想が裏目に出る典型例で、回帰分析でどの変数を入れるかを考えるときの落とし穴です。
3つのパターンを整理するとこうなります。
| 構造 | 図 | 条件づける前 | を条件づけた後 |
|---|---|---|---|
| 共通原因(交絡) | 相関あり(見かけ) | 相関が消える(正しくなる) | |
| 中間変数(媒介) | 相関あり(本物) | 相関が消える(効果を隠してしまう) | |
| 合流点(コライダー) | 相関なし | 偽の相関が生まれる(間違いになる) |
同じ「 で条件づける」操作が、構造によって正解にも間違いにもなります。 どの変数を条件づけるべきかは、データだけを見ても決まりません。背後の構造についての仮定が必要で、それをグラフで書いて議論するのがグラフィカルモデルの役割です。
準1級の範囲では「偏相関ゼロ=条件付き独立(正規分布のもとで)」が押さえどころですが、この非対称性は実務で判断を誤りやすいので記録しておきます。
実務ではどう使うのか
アンケート分析が代表例ですが、もう少し具体的に流れを書きます。
尺度を作る場面が最も多い用途です。たとえば従業員満足度調査で20項目を聞いたとします。20項目それぞれの平均を報告しても意味を読み取れません。因子分析をかけて「給与・人間関係・成長機会・経営への信頼」の4因子が出たら、20個の数字を4個の指標に圧縮して報告できます。しかも各因子に属する項目が分かるので、「人間関係の因子が低い」→「その因子に負荷が高い項目を見る」という掘り下げができます。
このとき因子分析でなければならない理由があります。項目の相関構造から「同じものを測っている項目群」を見つけたいからです。主成分分析でも似たグループは見えますが、「背後の構成概念を測っている」という主張をするなら因子分析の枠組みが必要になります。
既存の尺度を検証する場面では確認的因子分析を使います。他国で開発された心理尺度を日本語版にしたとき、「元の論文と同じ因子構造が再現されるか」を 検定と適合度指標で確認します。
実際の標本での挙動も確かめました。 のデータを生成して推定した結果です。
| 科目 | 推定した文系 | 推定した理系 | 真の文系 | 真の理系 |
|---|---|---|---|---|
| 国語 | 0.885 | 0.140 | 0.850 | 0.100 |
| 英語 | 0.807 | 0.141 | 0.800 | 0.150 |
| 社会 | 0.692 | 0.127 | 0.700 | 0.200 |
| 数学 | 0.066 | 0.848 | 0.100 | 0.880 |
| 物理 | 0.162 | 0.845 | 0.150 | 0.820 |
| 化学 | 0.185 | 0.686 | 0.200 | 0.720 |
負荷量の最大誤差は 0.0729 でした。 あれば構造はきちんと復元できています。固有値も 2.948, 1.646, 0.457, ... と第2因子までが1を超え、因子数を正しく2と判定しました。
実務上の目安として、標本サイズは変数の10倍以上、少なくとも200程度は必要とされます。相関行列を推定してからその構造を推定する二段構えなので、相関の推定が不安定だと全体が崩れます。
ブログのアクセス解析に使えるかも考えてみました。記事ごとに「PV・滞在時間・直帰率・スクロール率・回遊数」のような指標があるとき、これらの相関構造から「記事の質」のような潜在因子を取り出すことは原理的に可能です。ただし変数の数が5個程度では因子分析の旨味が薄く(自由度が足りない)、また指標間の関係が線形とは限りません。個人ブログの規模では第21回で見たようにサンプル数の壁があるので、素直に指標を個別に見るほうが実用的だと判断しました。
主成分分析との対比表(試験対策)
この回の主目的です。1枚にまとめます。
| 観点 | 主成分分析(第24回) | 因子分析(今回) |
|---|---|---|
| 矢印の向き | 観測変数 → 成分(合成) | 因子 → 観測変数(原因) |
| 正体 | 変換。計算手続き | モデル。検証できる仮説 |
| 何を再現するか | 分散を最大化 | 相関(非対角)を再現 |
| 独自因子 | 持たない | 変数ごとに持つ() |
| 対角の扱い | 1 のまま(全分散を使う) | 共通性に置き換える(主因子法。最尤法では の推定が同じ役割) |
| 式 | ||
| 成分・因子の値 | 計算できる(一意) | 計算できない(推定・不定性あり) |
| 解の一意性 | 一意(符号を除く。ただし固有値が重複しなければ) | 回転の不定性がある |
| 回転 | 普通はしない | する(解釈のため) |
| 次元を増やすと | 既存の成分は変わらない | すべての負荷量が変わりうる |
| 推定 | 固有値分解で一発 | 反復計算(共通性と負荷量が相互依存) |
| 当てはまりの検定 | 対象にならない(モデルではない) | できる( 検定) |
| 主な目的 | 次元圧縮・可視化・多重共線性回避 | 背後の構造の解釈・尺度の構成 |
「次元を増やすと」の行は試験で狙われそうなので補足します。主成分分析で第3主成分を追加しても、第1・第2主成分は変わりません(直交する順番に取っているだけなので)。因子分析で2因子から3因子に増やすと、共通性の推定値が変わるので全部の負荷量が変わります。この非対称性は両者の性格の違いをよく表しています。
自分が間違えていたこと
検証の過程で自分の理解が間違っていた点、および計算で踏んだ罠を記録します。
1. 図に書いた主成分の係数が間違っていた。 最初に図を作ったとき、第1主成分の式を「0.44×国語 + 0.43×英語 + …」と書きました。これは実際に計算せず、なんとなく置いた数字でした。固有ベクトルを計算したら 0.390, 0.401, 0.402, 0.414, 0.422, 0.420 で、書いた値と合っていません。図を作る前に数値を確定させるべきでした。
2. 特異な相関行列で偏相関の符号が壊れた。 コライダーの例を作るとき、最初に (誤差なし)としました。これは が の完全な線形結合なので相関行列が特異になり、行列式が になります。この状態で偏相関を計算したら、同じ計算が1回目は +1.0000、2回目は −1.0000 を返しました。理論値は −1 です。逆行列の計算が数値的に壊れて符号が不定になっていました。記事には誤差を入れた非特異版(、行列式 0.1104)を使い、理論値 −0.800000 と実測 −0.800440 の一致を確認しています。逆行列を使う計算では、行列式を確認する習慣が必要だと学びました。
3. 「回転しても当てはまりが同じなら結論も恣意的」という推論が間違っていた。 前提(当てはまりが同じ)は正しいのに、結論が誤っていました。回転で変わるのは負荷量と解釈だけで、共通性・独自性・因子数・当てはまりは不変です。「何が変わって何が変わらないか」を仕分けせずに「全部恣意的」と一括りにしていたのが誤りでした。
4. カイザー基準を素朴に信じていた。 「固有値1以上」は覚えやすいので基準として信頼していました。平行分析をやってみると、無相関のランダムデータでも第1固有値は 1.2754 まで出ます(、)。つまり1という閾値は偶然の変動より低く、因子を多く見積もりやすくなります(変数の数が少ない場合など、逆に過小になることもあると指摘されています)。基準の根拠(1変数分の情報量)が主成分分析の発想であることも理解していませんでした。
5. 偏相関ゼロと条件付き独立を無条件に同じものと考えていた。しかも修正の途中でもう一度間違えた。 最初は両者を同じものとして書き、査読で誤りを指摘されて「条件付き独立 ⇒ 偏相関ゼロ の向きだけは一般に成り立つ」と直しました。ところがこの修正自体が誤りでした。 、 という反例では、条件付き独立が厳密に成り立つのに偏相関が 0.667 残ります。正しくはどちらの向きも一般には成り立たず、多変量正規分布のもとでのみ同値です。条件を1つ緩めて直したつもりが、緩め方を間違えていました。
6. 独自性を「測定誤差」と理解していた。 独自性にはその変数固有の性質も含まれます。社会の独自性 0.470 は「47%が誤差」ではなく、「共通因子で説明できない社会固有の要素と誤差の合計」です。誤差だけだと思っていると、独自性が大きい変数を「測定が下手な項目」と誤って解釈します。
7. バリマックス基準の式と、記事に載せた数値が別物だった。 教科書どおりの式(負荷量の2乗の分散)を書いたのに、計算に使っていたのはカイザー正規化つきの版でした。式のとおりに計算すると最適角が 、基準の最大値が 0.197843 になり、記事の ・0.424519 とは一致しません。実装と説明が食い違っている典型的な事故で、式を書くときに自分の実装を確認していませんでした。
8. バートレット法の性質を逆に覚えていた。 「不偏だから分散も保たれる」と書きましたが、実測すると分散は 1.157/1.190 で1より大きいです。回帰法は逆に 0.866/0.843 と縮みます。不偏性と分散が1になることは別の性質で、バートレット法は不偏の代償として分散が膨らみます。
9. 斜交回転で共通性を2乗和で計算していた。 プロマックスの表を出した後、共通性が「負荷量の2乗の和」だという前の節の記述をそのまま適用できると思っていました。実際は国語で となり、正しい 0.732 と合いません。因子間相関を挟んだ が必要です。前の節で成り立った式が、条件が変わった後も成り立つと思い込んでいました。
10. 因子得点と真の因子の相関で、第1因子と第2因子のラベルを取り違えていた。 0.9345 を文系(第1因子)の値として書いていましたが、バリマックス後の列と真の因子の対応を照合すると 0.9345 は理系側で、文系側は 0.9204 でした。しかもこのとき「理論上限 0.9173 を超えているから別の因子だ」という判別を使ったのですが、これも誤りでした。 標本誤差で上限をわずかに上回ることは普通に起きます(40回試すと半分強で超える)。正しい判別は列の負荷量パターンを見ることです。バリマックス後の列の順序は一意でないのに、真の因子の番号と対応していると暗黙に仮定したのが原因です。列の順番を確かめずに番号で呼ぶと入れ替わります。
11. 「自由度0ならどんなデータでも完璧に当てはまる」と書いた。 自由度の数え上げが0になることと、厳密解が必ず存在することは別でした。 でランダムな相関行列を試すと残差が残る場合が多く、無理に合わせるとヘイウッドケースになります。正しくは「検証する余地が消える」です。
以下は追記の節(主成分分析との計算の比較)を書いたときに見つかった誤りです。
12. 「 の固有値が1を超えた個数=因子数」と書いた。 これは「因子数を正しく指定し、かつモデルが厳密に当てはまる」ときだけ成り立つ性質でした。同じ母相関行列に1因子を当てると1超が3個、 の標本相関行列に2因子を当てると1超が4個になります。1超の個数は指定した の結果であって、 を教えてくれる量ではありません。都合よく2個になったのを一般法則だと思い込んでいました。
13. 「負荷量が系統的に過大になる」と書いたが、過大になるのは主たる因子への負荷量だけだった。 小さいほうの負荷量は逆に過小になります(国語の理系は真 0.100 に対して 0.089)。正しくは「コントラストが強く出る」で、方向を揃えて語れる歪みではありませんでした。自分が作った表に主たる負荷量しか載せていなかったので、それだけを見て一般化していました。
14. 「4次式だから倍角公式で になる」という説明が不十分だった。 一般の三角4次式なら の項も出ます。実際にフィットすると の係数は厳密に0なのですが、その理由は「4次式だから」ではなく共通性が回転で不変だからでした。結論は合っていたのに、理由づけが間違っていました。
15. の公式を素朴に で解くと最小値に着く。 分子と分母がともに負なので は第3象限ですが、 としてしまうと基準値 0.0072(最小側)になります。記事に公式を載せた時点ではこの注意を書いておらず、読者が再現できない状態でした。 の周期 180° が では 45° にあたるので、最大と最小をちょうど取り違えます。
要点まとめ
| 問い | 答え |
|---|---|
| 主成分分析との最大の違い | 因子分析は相関(非対角)だけを再現する。実測で誤差 0.000000 vs 主成分2個は 0.144371 |
| 矢印の向きが逆とは | 主成分は観測値から計算できる(変換)。因子は計算できずモデル(仮説)である |
| 式の違い | 因子分析 /主成分 。 が対角にだけ効く |
| 見えない因子をどう推定するか | 因子の値は使わない。相関が負荷量の積になる関係を逆に解く(3変数なら )。決まるのは なので符号は不定。 ならヘイウッドケース |
| 反証できる根拠 | 自由度が正(6変数2因子で 、教科書の と一致)。1因子だと残差 0.3440 が残り で棄却() |
| データから言えないこと | 因子の名前・実在性・因果の向き・因子軸の向き |
| 共通性とは | 負荷量の2乗の和(直交回転のとき)。第16回の決定係数と同じ分解を変数ごとに行っている |
| 独自性とは | 。誤差だけでなくその変数固有の性質も含む |
| 回転で変わらないもの | 共通性・独自性・当てはまり・因子数・(斜交では ) |
| 回転で変わるもの | 個々の負荷量・因子の解釈・各因子の寄与 |
| なぜ恣意的でないか | 変わるのは軸の名付け方だけ。座標系の選択と同じで実質的結論に触れない |
| バリマックスは何を最大化するか | 負荷量の2乗の分散(カイザー正規化つき)。実測で基準 0.0096 → 0.4245、0.7超の負荷量が2個→6個 |
| 単純構造とは | 各変数が1因子にだけ大きな負荷を持つ状態。中間の値がないこと |
| プロマックス回転 | 斜交(因子間相関を許す)。実測の因子間相関 0.3748。パターン行列と構造行列が別物になり、共通性も2乗和では出せない |
| 因子数の決め方 | カイザー基準・スクリー・平行分析・正の固有値の数・累積寄与率・ 検定の6つ。今回は全部が2を指した |
| カイザー基準の注意 | 無相関データでも第1固有値は 1.2754 出る(・)。閾値が と に依存するので平行分析のほうが信頼できる |
| 共通性を対角にすると | 共通性の推定値を使うと固有値に負の値が出るのが正常(−0.088 〜 −0.160)。正の個数が因子数の目安 |
| 因子得点 | 計算できず推定。回帰法とバートレット法で相関 0.999、真の因子とは 0.92〜0.93 でこれが原理的な上限( を増やしても改善しない)。個人の値を確定値として扱わない |
| EFA と CFA の違い | CFAは構造を先に指定し負荷量をゼロに固定する。制約があるので回転が不要 |
| 検定の向き | 帰無仮説が「モデルは正しい」。 値が大きいほど当てはまりが良い |
| なぜグラフィカルモデルが同じ章か | どちらも見かけの相関を背後の構造で説明する道具 |
| 偏相関ゼロ=条件付き独立 | 多変量正規分布のもとで同値。一般にはどちらの向きも成り立たない(偏相関は線形の影響しか除かない。反例で偏相関 0.667 が残った) |
| 精度行列との対応 | の非対角がゼロ ⇔ 偏相関ゼロ ⇔ グラフに辺がない。実測で 0.000e+00 |
| 偏相関と偏回帰係数 | 同じ発想。他の変数で回帰した残差同士の相関(実測 0.0002 で一致) |
| 変数を入れれば安全か | 違う。 合流点で条件づけると独立な2変数に偽の相関(実測 −0.800)が生まれる |
| 実務の使いどころ | アンケートの尺度構成。標本は変数の10倍以上・200程度が目安 |
| 推定は主成分分析と同じ手法か | ほぼ同じ。どちらも固有値分解で、違いは渡す行列の対角だけ(1 か 共通性か) |
| 4つの推定法の共通点 | 主成分分析・主成分法・主因子法・最尤法すべて「何らかの行列の固有値分解」。最尤法は を分解し、厳密に当てはまるとき固有値は「1超が 個・残りは全部1」(ただし因子数の判定には使えない) |
| 固有値の top を取るだけでは | それも実在する方法(主成分法)。ただし主たる負荷量が過大・副の負荷量が過小になりコントラストが強く出る(最大 +0.116)。独自性が大きいほど歪む |
| なぜ反復が必要か | 固有値分解に渡すべき行列そのものが未知だから(対角の共通性)。分解自体は1回で済む |
| 文系/理系に分かれるのは | 回転のおかげ。因子分析も回転前は「総合学力」1本。主成分分析を回転しても同じように分かれる |
| 主成分分析が回転しない理由 | 回転すると分散の配分が平準化され(3.02/1.60 → 2.27/2.34)、分散最大という売りを失う。因子分析は失うものがない |
| 回転角の決め方 | バリマックス基準を最大化。目的関数は厳密に で単峰。2因子は の式で一発、3因子以上はペアごとに回す |
| 恣意性はどこにあるか | 基準の選択まで(バリマックスか/直交か斜交か)。基準を決めた後の角度は完全に機械的 |
次回
次回は第26章のその他の多変量解析手法で、多変量解析編の最後になります。多次元尺度構成法や正準相関分析といった、ここまでに出てこなかった手法を扱う回です。今回の「相関行列だけを入力として構造を推定する」という発想が、別の形で繰り返されます。
その先の発展編(第29回以降。最初は第27章の時系列解析)では、今回の道具が形を変えて再登場します。偏相関は偏自己相関になり、自己回帰モデルの次数を決める道具として使われます。「他の変数の影響を除いた関連」という発想がそのまま効いてくる場面です。
また第23回で扱ったランダムウォークが単位根過程として現れ、「見せかけの回帰」の原因になります。今回のコラムで見た「相関があっても直接の関係とは限らない」という話が、時系列では共和分という別の形で問題になります。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。