順位に直すと何が起きるのか:ノンパラメトリック検定の保険料【第15回】
はじめに
第13章はノンパラメトリック法です。前回(第14回・一般の分布に関する検定法)で「正規分布の前提が崩れたらどうするか」を扱いましたが、そこで出てきた道具はまだ「別の分布を当てはめる」「漸近的に近似する」という方向でした。今回はもっと過激な方針を取ります。
分布を当てにするのをやめる。
具体的には、データの値を捨てて順位だけを残します。この一言を最初に聞いたときの感想は「そんな乱暴なことをして大丈夫なのか」でした。滞在時間が310秒だったという情報を「9位」に置き換えてしまうのだから、明らかに情報が減っています。減った分だけ検定は鈍るはずです。
その「鈍り」の正体を数字で測れたのが、今回いちばんの収穫でした。正規分布のときの損失は約5%。 でやっていた検定を にすれば取り返せる程度です。そして前提が崩れると立場が逆転して、外れ値が10%混ざるだけで順位検定の検出力がt検定の約2倍になりました。5%の保険料で、崩れたときに2倍の見返りがある。この収支が見えてから、ノンパラメトリック法が「パラメトリックの下位互換」ではなく別の設計思想なのだと理解できました。
もうひとつ驚いたのは、この章の手法が全部同じ原理の変奏だったことです。符号検定、ウィルコクソンの符号付順位検定、順位和検定、クラスカル=ウォリス検定、スピアマン、ケンドール。名前が6つ並びますが、違うのは「何を並べ替えるか」だけでした。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 記号で迷ったら 統計の記号がややこしいのは軸が2本あるからだった を先に読んでください。
- 比較対象になるt検定は 第13回 で扱っています。
この記事で使う言葉
まず4つだけ。この記事はこの4語で回ります。
ノンパラメトリック(nonparametric):母集団の分布に「正規分布である」といった形を仮定しない方法。「パラメーター(母数)を持たない」という意味ではなく、分布の形をパラメーターで指定しないという意味です。母集団の中央値のようなパラメーターは普通に扱います。
分布によらない(distribution-free):帰無仮説のもとでの検定統計量の分布が、母集団がどんな分布であっても同じになる性質。ノンパラメトリックとほぼ同じ意味で使われますが、正確にはこちらが「なぜ分布を仮定しなくてよいか」の答えにあたります。
漸近相対効率(ARE, asymptotic relative efficiency):2つの検定が同じ検出力を出すために必要な標本数の比。「順位和検定のAREが 」なら、t検定の 個ぶんの仕事をするのに順位和は 個必要という意味です。
タイ(tie, 同順位):同じ値が複数あって順位が決まらない状態。5段階評価のアンケートのように値の種類が少ないデータでは大量に発生します。
TL;DR
- 順位に直すと分布を忘れる。 で は単調非減少だから、連続分布ならどんな分布でも順位のパターンは同じ。だから帰無分布が数え上げだけで確定する
- 検証:コーシー・対数正規を含む4分布で40万回ずつ回して、 通りの厳密分布と最大誤差 0.0012 で一致
- 正規分布での損は 4.5%(ARE )。 のt検定に追いつくには 〜 必要。ただし正規は最悪ケースではなく、あらゆる連続分布での ARE の下限は
- 前提が崩れると逆転する。 2群 で外れ値10%混入なら検出力 0.2263 対 0.4376、対数正規で 0.3460 対 0.6073。約2倍
- t検定は外れ値混入で が 0.030 に落ちる。これは安全マージンではなく検出力の漏れ
- t検定と結論が食い違ったら、食い違いの向きを見る。片方だけが有意になる非対称性が診断になる
- 順位和の が保証されるのは のときだけ。 形や分散が違う2群では保証が消える(ベーレンス=フィッシャー問題)
- 並べ替え検定は「帰無分布の作り方」で、頑健性は「統計量の選び方」。 この2つは直交している。ただし並べ替えにも交換可能性という前提が要る
- 対応ありは引き算して1標本問題に変換するだけ。対応を無視すると p が 0.0060 から 0.7929 へ飛ぶ
- クラスカル=ウォリス検定の正体は「順位に対する一元配置分散分析」。 にすると順位和検定の と完全一致
- スピアマンは「順位に対するピアソン」、ケンドールは「2点選んで順番が合う確率」。 母相関0.5のときケンドールはちょうど になるので、値をそのまま比べてはいけない
- 5段階評価は中間順位とタイ補正で対応できるが、2値データでは順位和検定はフィッシャーの正確検定と同一物になる(両方 0.0698)
なぜ順位に直すと分布を仮定しなくてよくなるのか
いちばん最初に潰したかったのがこれです。「順位にすれば分布を仮定しなくてよい」と教科書には書いてありますが、なぜそうなるのかが書かれていないことが多い。調べてみると、これは2つの別の主張の合わせ技でした。
主張1:順位は「元がどの分布だったか」を忘れる
第4回の変数変換で使った を思い出します。一様分布 を分位点関数 に通せば、任意の分布 に従う確率変数が作れる、というものです。
ここで重要なのは、 が単調非減少だということ。 なら で、順序が逆転することはありません。
ただし「非減少」であって「増加」ではない点が後で効いてきます。 が離散だと は階段状になって平坦な部分を持つので、 でも になりえます。これがタイ(同順位)です。 が連続なら確率1でタイが起きないので、狭義の順序が保たれます。この「連続分布・タイなし」が分布によらない性質の前提で、崩れたときの対処が後半のタイ補正になります。
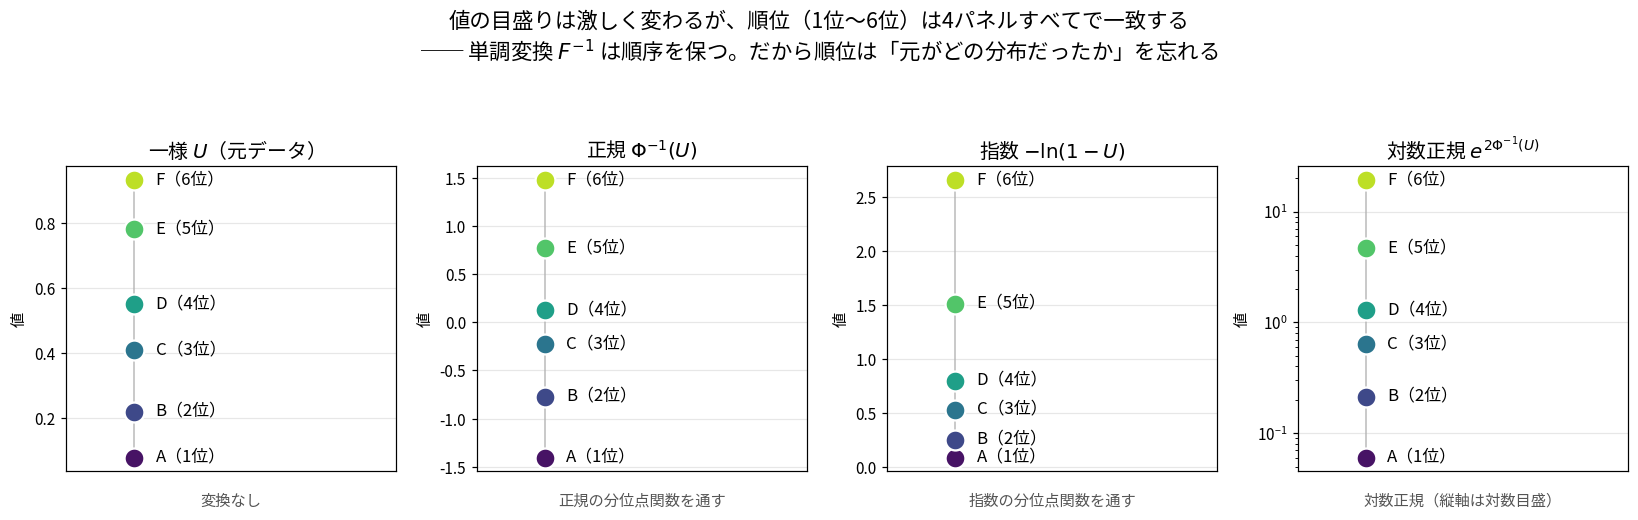
同じ6個の一様乱数を4種類の分布に変換した図です。縦軸の値は激しく変わるのに、1位から6位までの並びは4パネルすべてで一致しています。変数変換のときはヤコビアンを計算して密度の変化を追いかけましたが、順位だけを見るならヤコビアンが要らない。順序しか見ていないので、変換の「引き伸ばし方」は関係ないからです。
つまり、順位のパターンは元の分布の情報を一切持っていません。忘れているから、仮定する必要がない。
主張2:忘れた結果、数え上げで分布が確定する
ここが2段目です。忘れただけでは検定になりません。p値を計算するには帰無分布が必要です。
帰無仮説「2群は同じ分布から来ている」()が正しいとします。すると、全部を混ぜて順位をつけたとき、どの順位が群1に割り当てられるかは完全に偶然です。 個から群1の5個を選ぶ組合せは 通りで、タイがなければそのどれもが確率 になる。
この「」という強い帰無仮説が効いていることに注意してください。「平均だけが等しい」では足りません。分布がまったく同じでないと、割り当てが等確率になる根拠が消えます。
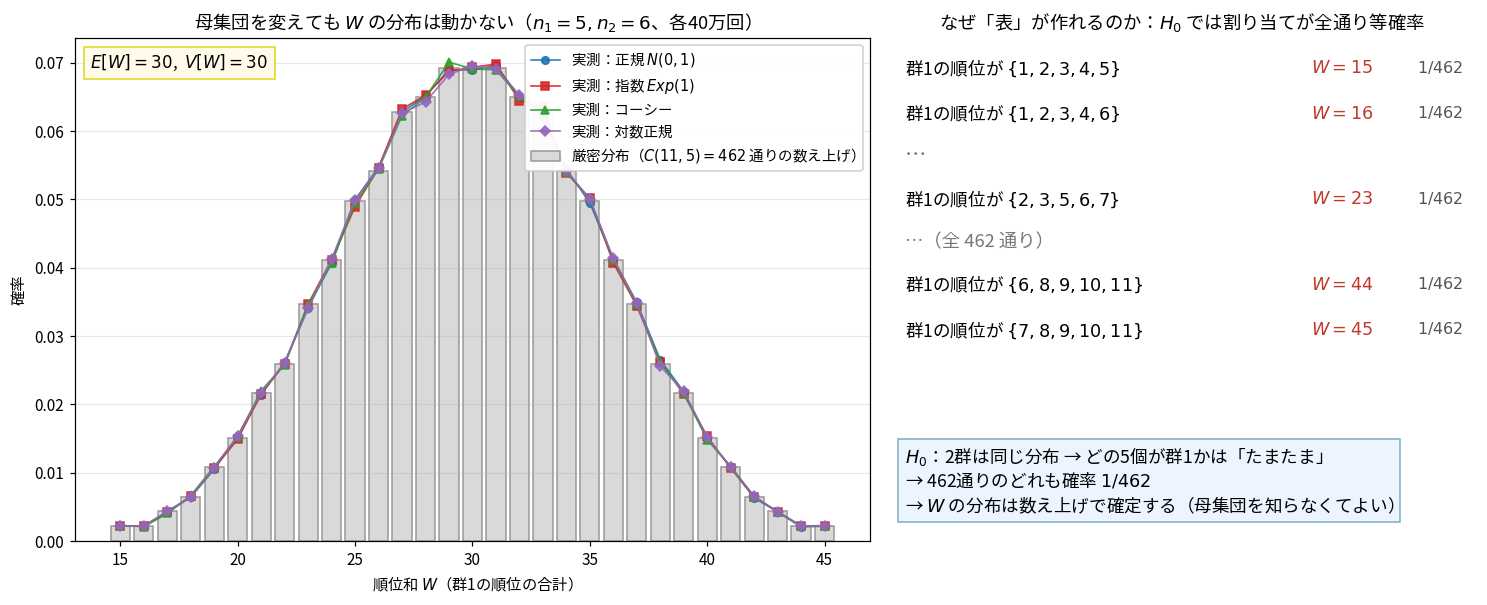
コーシー分布(平均が存在しない)と対数正規分布(極端に歪んでいる)を含む4分布で40万回ずつ回しましたが、462通りの数え上げから計算した厳密分布と最大誤差 0.0012 で一致しました。母集団を変えても の分布はまったく動かない。
これが「順位検定の表が作れる」理由です。パラメトリック検定は「母集団の分散を推定する」ために自由度を消費しますが、順位検定は数え上げで分散を確定させる。ここが設計思想の分かれ目でした。
手順を最後まで通してみる
原理が分かっても、実際に手を動かすまでは身につきませんでした。小さいデータで全手順をやります。
記事Aと記事Bの滞在時間(秒)を比べます。Aが5人、Bが4人。
| 群 | 滞在時間(秒) |
|---|---|
| 記事A | 182, 95, 240, 310, 145 |
| 記事B | 62, 118, 41, 88 |
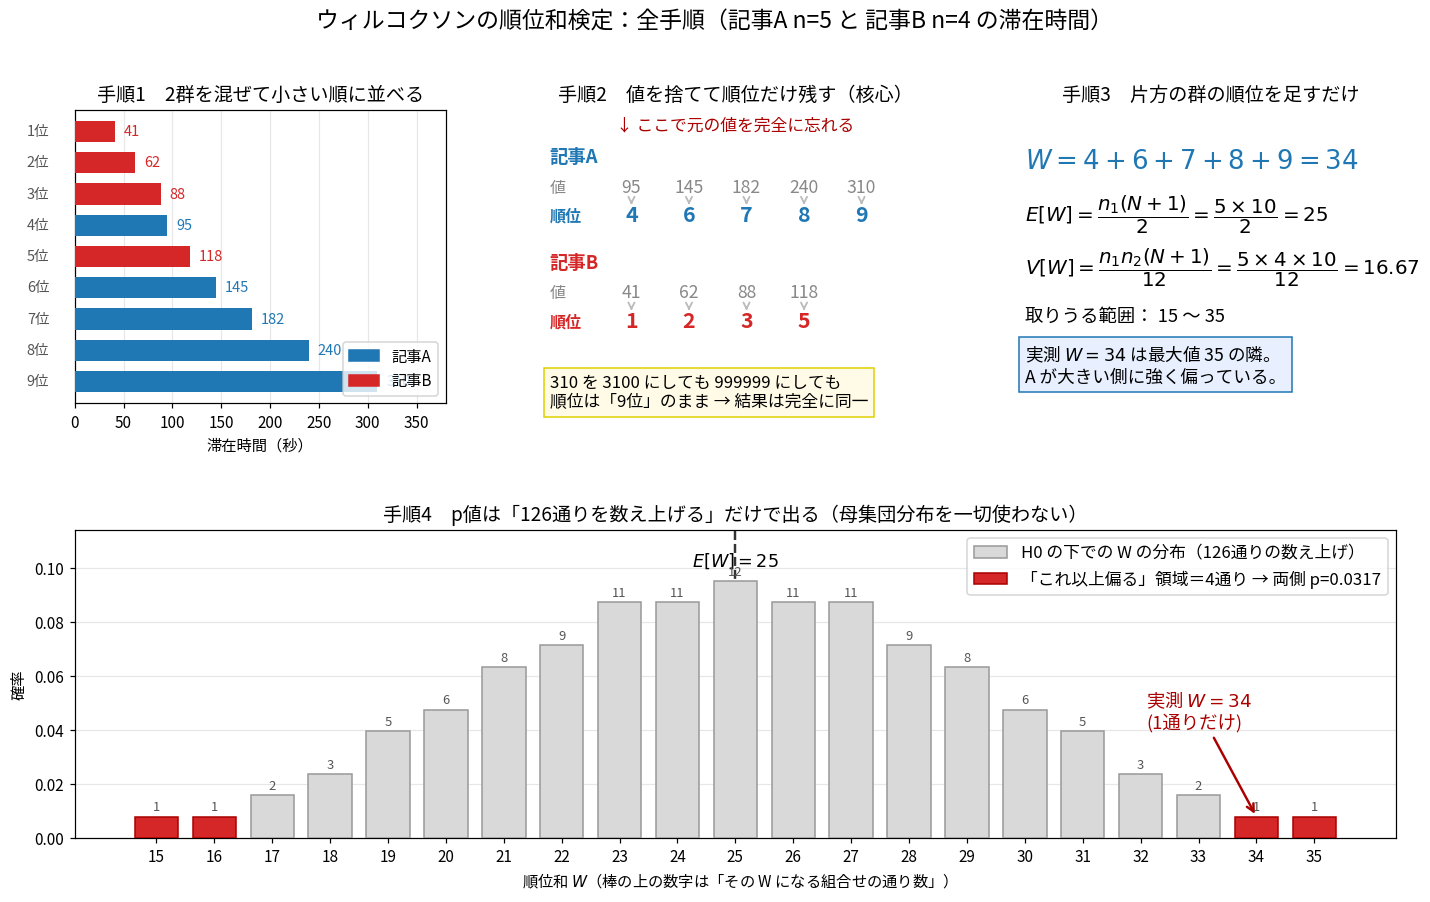
手順1:2群を混ぜて小さい順に並べる。 41(B)、62(B)、88(B)、95(A)、118(B)、145(A)、182(A)、240(A)、310(A)。
手順2:値を捨てて順位だけ残す。 これが核心です。Aの順位は 、Bは 。
ここで310を3100にしても999999にしても、順位は「9位」のままです。だから検定結果は完全に同一になります。「値を捨てる」というのがどういうことか、これで具体的に見えました。
手順3:片方の群の順位を足す。
期待値と分散は公式で出ます。
が取りうる範囲は (Aが最小の5個を独占)から (最大の5個を独占)まで。実測 34 は最大値 35 の隣なので、Aが大きい側に強く偏っています。
手順4:p値は126通りを数え上げるだけで出る。 通りのうち、 になるのは2通り( と )。片側 、両側 。
母集団の分布を一度も使っていません。 t検定なら「正規分布だと仮定して、標本分散から標準誤差を推定して」という段階が必要ですが、それが丸ごと消えています。
ここで自分が引っかかった罠を書いておきます。126通りは「観測されたデータ」ではありません。 帰無仮説が正しいとしたら起こりえた仮想のパターンで、実際に観測したのはそのうち1通りだけです。最初これを「126通りのデータを集めた」と読み違えて混乱しました。
公式の分母の 2 と 12 はどこから来たのか
この公式を暗記しようとして嫌になったので、由来を調べました。3つとも出自が違います。
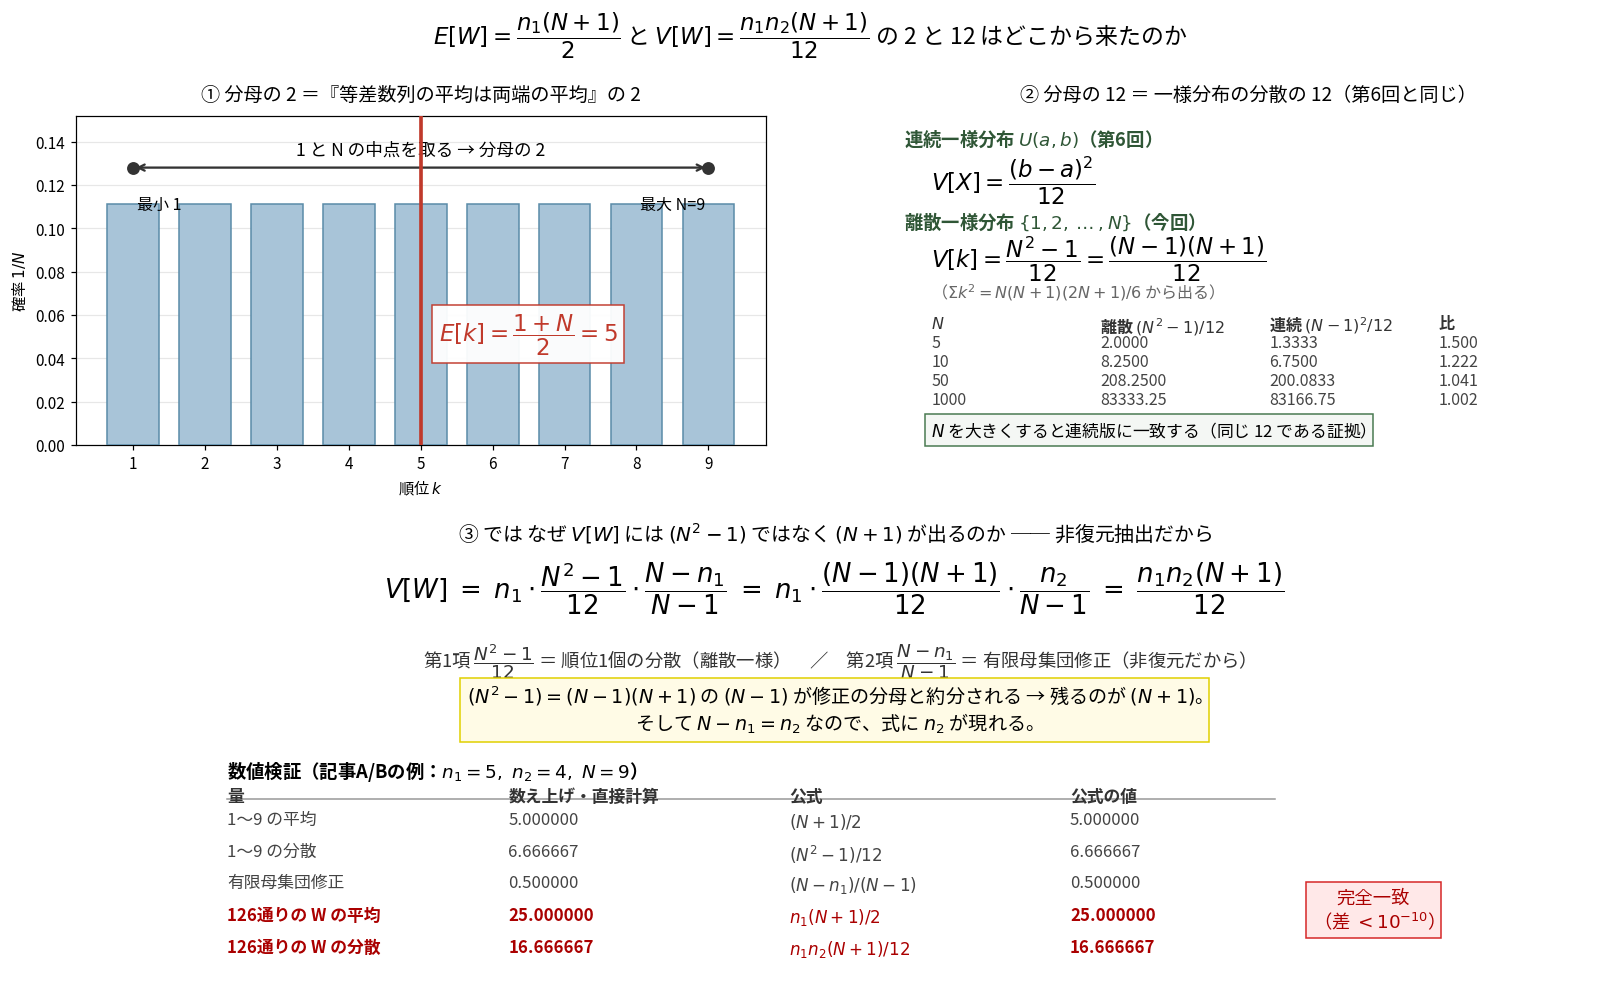
の 2 は等差数列の平均です。 順位は という等差数列なので、1個の期待値は両端の平均 。ガウス和 の 2 と同じものです。
の 12 は一様分布の分散の 12 です。第6回でやった と同根で、離散版は 。 を大きくすると連続版に一致していきます( で比 1.002)。
は約分の残りかすでした。 順位は非復元抽出なので有限母集団修正 が掛かります。
と分解して が約分され、 が現れる。12・・ は出自が3つとも違うと分かってから、この式が覚えやすくなりました。
の126通りを数え上げると平均 25.000000、分散 16.666667 で公式と完全一致しました。
「順位以外を捨てる」とは具体的に何を捨てているのか
では失っているものは何か。ここも数字で見ておきたかった部分です。
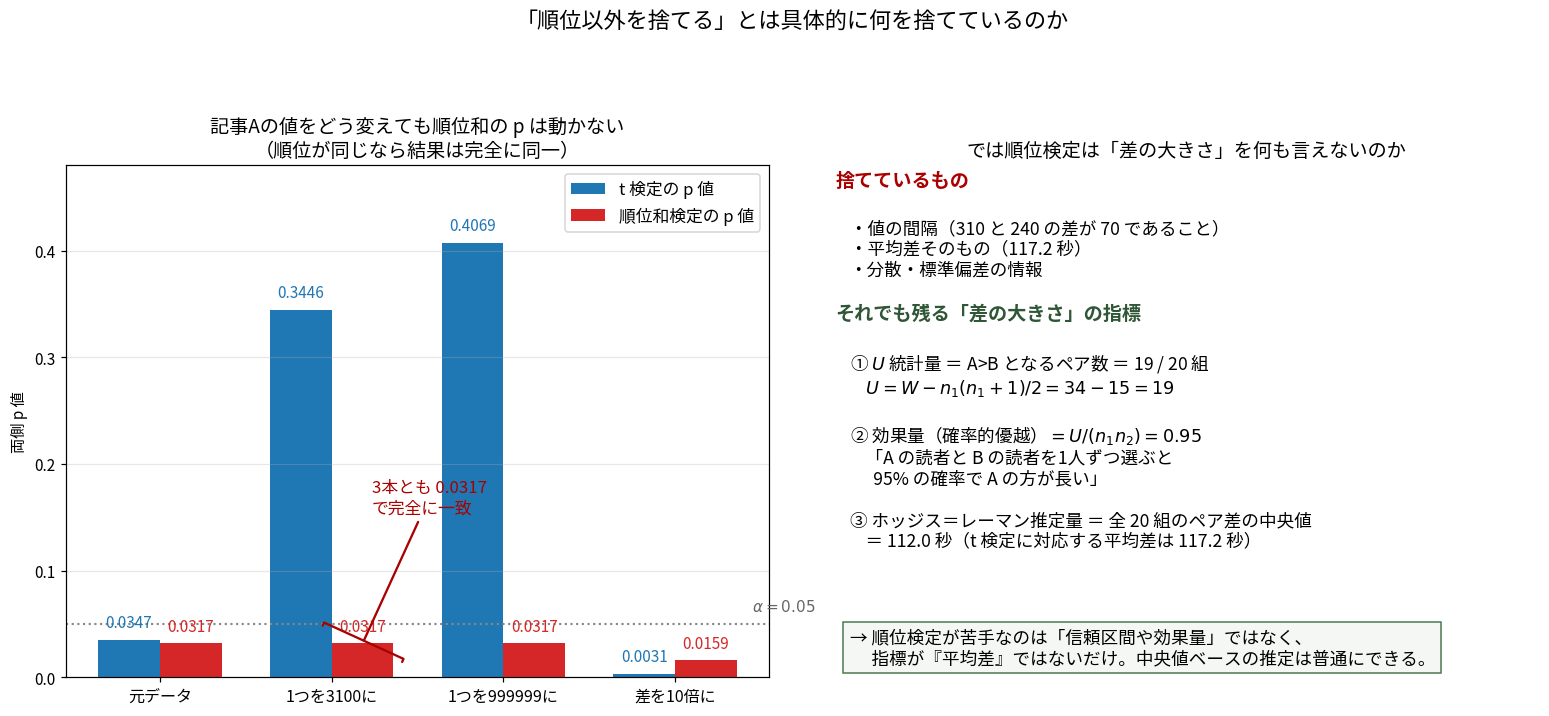
捨てているものは、値の間隔(310と240の差が70であること)、平均差そのもの(117.2秒)、分散の情報です。図の左を見ると、記事Aの値を3100にしても999999にしても順位和のp値は0.0317で微動もしません。t検定は 0.0347 から 0.4069 へ暴れています。
ここで自分が誤解していたことがあります。「順位検定は信頼区間や効果量が苦手」と思い込んでいましたが、これは誤りでした。 苦手なのではなく、指標が平均差ではないだけです。
U統計量:。これは「AとBを1つずつペアにしたとき、A > B になるペアの数」です。全20組のうち19組。
効果量(確率的優越):。「Aの読者とBの読者を1人ずつ選ぶと、95%くらいの確率でAの方が長い」と読めます。平均差より解釈しやすい場面すらある指標です。ただしこれは の推定値で、しかも20組だけから出しているので精度は極めて粗い(信頼区間は非常に広い)ことを忘れてはいけません。タイがあるときは半分数えて とします。
ホッジス=レーマン推定量:全20組のペア差の中央値 = 112.0秒(t検定に対応する平均差は117.2秒)。これが順位検定における「差の大きさ」の点推定で、ここから信頼区間も作れます。
何を失っているのか:保険料は5%だった
いよいよ「鈍り」の定量です。理論値は漸近相対効率という形で知られています。
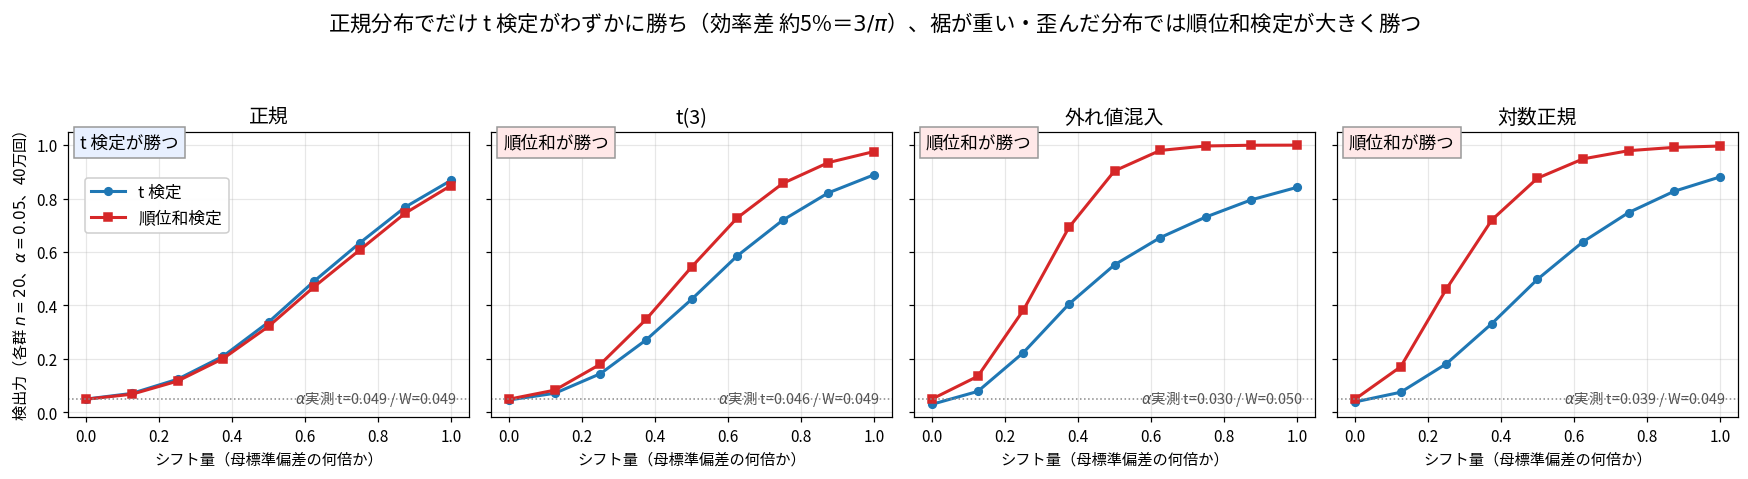
ARE は「t検定に必要な ÷ 順位和に必要な 」で定義します。1より小さければ順位和の負けです。
| 母集団の分布 | ARE(t検定の必要 ÷ 順位和の必要 ) | 意味 |
|---|---|---|
| 正規 | 4.5%の損 | |
| 一様 | 1.0000 | 損得なし |
| ロジスティック | 10%の得 | |
| 二重指数(ラプラス) | 1.5 | 50%の得 |
| 1.90 | 90%の得 | |
| コーシー | t検定は無力 |
正規分布での負け幅が 。これが有名な数字です。実測すると、t検定 の検出力 0.3382 に順位和が追いつくには 〜 が必要でした(0.3346 / 0.3490)。保険料は「サンプルを1〜2個足す」で払える。
ここで注意が必要でした。正規分布は最悪のケースではありません。 表に一様分布の 1.0 が並んでいるので「正規が底で、あとは得しかない」と読みたくなりますが、実際には裾の短い分布でもう少し損をしえます。ホッジス=レーマンの結果として、あらゆる連続分布にわたる ARE の下限は であることが知られています。つまり正しい保証は「正規で4.5%の損、どんな分布でも最大14%以内の損」です。「保険料は5%」は正規分布での話で、一般の保証は14%だと理解しておく必要がありました。
そして崩れたときの見返りが大きい。
| 分布 | ずれ | t検定 | 順位和検定 |
|---|---|---|---|
| 正規 | 1.0 | 0.87 | 0.85 |
| 1.0 | 0.89 | 0.98 | |
| 外れ値混入 | 0.5 | 0.41 | 0.90 |
| 対数正規 | 1.0 | 0.88 | 1.00 |
外れ値が10%混ざるだけで、シフト0.5のときの検出力が 0.41 対 0.90 になります。2倍以上。
図の下部に書いた の実測値も重要です。t検定は外れ値混入で が 0.030 に落ちています。名目5%より小さいので一見安全に見えますが、これは第13回でも確認したとおり安全マージンではなく検出力の漏れです。外れ値が分散を膨らませてt統計量の分母を吊り上げ、検定そのものを鈍らせている。順位和は全条件で 0.049〜0.050 を保っていました。
t検定と順位和検定で結論が食い違ったら
実務でいちばん困るのがこれです。3段階で考えることにしました。
(a) そもそも検定はデータを見る前に選ぶ
原則としてこれが答えです。両方やって都合のよい方を採るのは、 を水面下で2倍近くに引き上げる行為(多重比較の一種)です。第13回で「F検定で等分散を確かめてからt検定」が推奨されない理由と同じ構造です。
(b) 食い違いの「向き」が診断になる
とはいえ、すでに食い違いを見てしまうことはあります。そのとき有用なのが非対称性のチェックでした。
| 状況 | t検定のみ有意 | 順位和のみ有意 | 読み方 |
|---|---|---|---|
| 正規・差なし | 0.0103 | 0.0094 | ほぼ対称 → 偶然 |
| 外れ値混入 | 0.0002 | 0.2901 | 極端に非対称 → t検定が鈍っている |
正規分布で差がないときは、どちらか片方だけ有意になる確率がほぼ同じ(1%程度)です。これは偶然の産物。一方、外れ値が混ざると「順位和だけ有意」が29%も起きます。片方向にだけ偏った食い違いは、その検定の前提が壊れているサインでした。
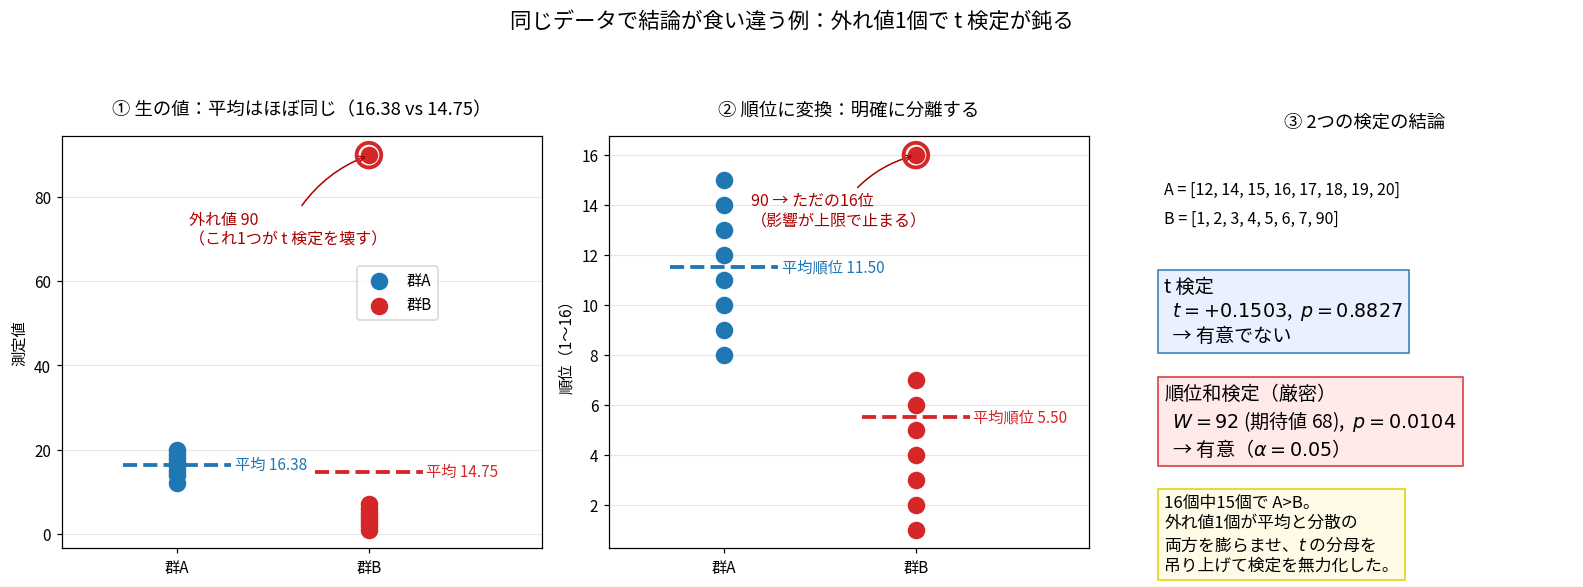
極端な例を作りました。、。Aの8個すべてがBの下位7個を上回り、外れ値90だけが例外という明白な差があるのに、t検定は で「有意でない」と答えます。外れ値90が平均を14.75まで持ち上げ、同時に分散を膨らませてt統計量の分母を吊り上げたからです。順位和では90が「ただの16位」に丸められて、 で有意になります。
(c) 「何を知りたいのか」に戻る
いちばん納得したのがこれでした。両方が正しく、別のことを検定しているケースが作れます。
、 とすると、平均は両方ちょうど0で、中央値は ()です。この2群を比べると、t検定は 6.4%、順位和は 21.2% で棄却しました。
t検定の 6.4% は「平均差がないので 付近であるべき」という予測どおりの挙動ですが、名目5%より少し膨らんでいます。強い歪みのぶんです。一方の順位和 21.2% は、 と確率的優越が崩れているので正しく検出しています。中央値が ずれているのはその一つの現れです。
t検定は平均を、順位和は「どちらが大きく出やすいか」を見ている。 食い違いは矛盾ではなく、質問が違うことの表れでした。
ここで正確に区別しておくべきことがあります。順位和検定の が保証されるのは のときだけです。この例のように分布の形自体が違う設定では、そもそも が成り立っていないので「 が正しい」という枠組みが当てはまりません。順位和が敏感な方向は平均差ではなく確率的優越 ですが、これを帰無仮説に置き換えて「 を検定している」と読むと危険で、形や分散が違う2群では 自体がずれます(マン=ホイットニーのベーレンス=フィッシャー問題。 かつ分散が違うと名目5%を大きく超えることが知られています)。厳密にやるならブルンナー=ムンツェル検定などが必要です。
「順位和は中央値の検定」と読むには、さらに位置ずれモデル を仮定する必要があります。この記事の前半で使った例のように「同じ形の分布が横にずれただけ」ならその読み方でよいのですが、形が違う場合は成り立ちません。
並べ替え検定こそ最強ではないのか
計算機があるのだから、順位に丸めずに生の値のまま全パターンを並べ替えて帰無分布を作ればいいのではないか。順位に直すのは手計算しかなかった時代の遺物ではないか。そう思っていました。
枠組みとしてはほぼ正しかったのですが、決定的に混同していたことがありました。
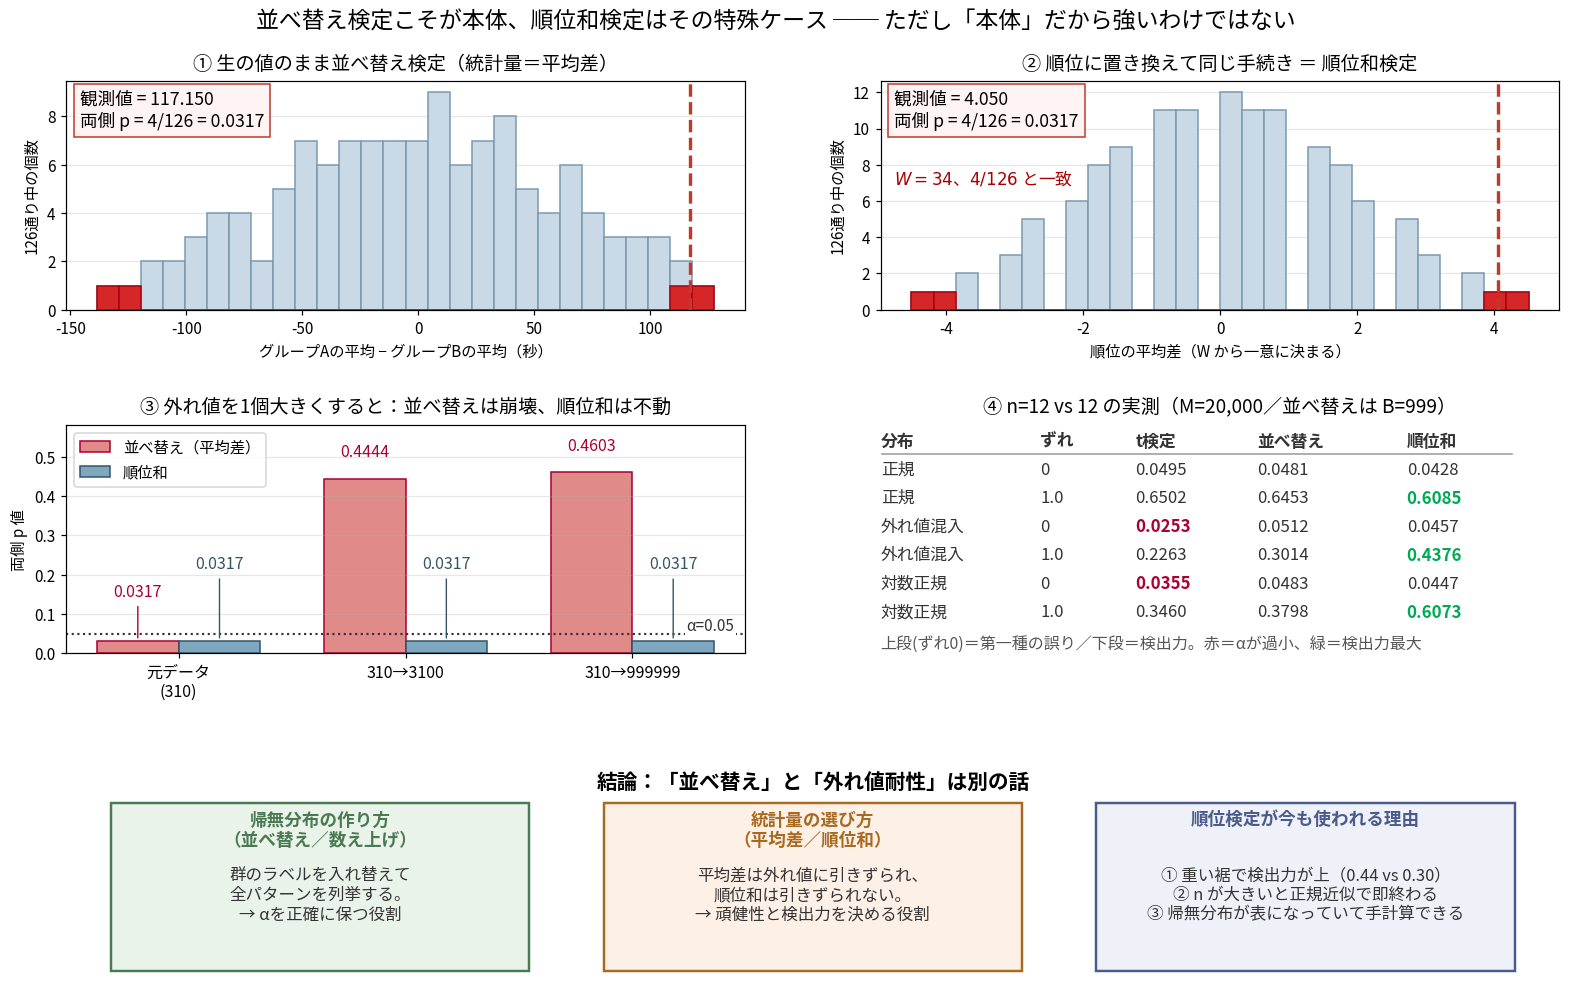
同じデータで2つの並べ替えをやりました。
| 方法 | 両側p |
|---|---|
| 生の値のまま、平均差を統計量にして並べ替え | 0.0317 |
| 順位に置換してから並べ替え(=順位和検定) | 0.0317 |
順位和検定は、並べ替え検定の統計量として順位和を選んだものです。これは定義上そうなっているので、証明が要る話ではありません。上の表で p が で一致したのはこのデータでの偶然で(次に見るように一般には別物になります)、「特殊ケースである」ことの証拠ではありません。ここを取り違えると次の話が分からなくなります。
そして外れ値を大きくしていくと、この2つが分かれます。
| データ | 並べ替え(平均差) | 順位和 |
|---|---|---|
| 元データ | 0.0317 | 0.0317 |
| 310 → 3100 | 0.4444 | 0.0317 |
| 310 → 999999 | 0.4603 | 0.0317 |
並べ替え検定なのに崩壊しています。 ここで自分の混同が判明しました。
「並べ替え」は帰無分布の作り方であって、頑健性は統計量の選び方から来る。 この2つは直交している。
並べ替えは「p値をどう計算するか」の話です。しかし統計量に平均差を選んだ以上、平均差そのものが外れ値に弱いという弱点はそのまま残ります。順位和検定が頑健なのは「並べ替えるから」ではなく「順位和を統計量に選んだから」でした。
そして並べ替えにも前提があります。厳密になるのは帰無仮説のもとでデータが交換可能(exchangeable)なとき、つまり2標本なら 、対応ありなら差が0のまわりに対称であるときだけです。「平均だけが等しく分散が違う」という弱い帰無仮説に対しては、並べ替えでも は保証されません。この記事のシミュレーションで並べ替えが を守れているのは、2群を同じ分布から生成している(=強い帰無仮説が成り立っている)からです。「並べ替えなら前提が不要」ではない。
では並べ替え検定の売りは何なのか。 ずつ・20000回で測りました。
| 分布 | ずれ | t検定 | 並べ替え(平均差) | 順位和 |
|---|---|---|---|---|
| 正規 | 0 | 0.0495 | 0.0481 | 0.0428 |
| 正規 | 1.0 | 0.6502 | 0.6453 | 0.6085 |
| 外れ値混入 | 0 | 0.0253 | 0.0512 | 0.0457 |
| 外れ値混入 | 1.0 | 0.2263 | 0.3014 | 0.4376 |
| 対数正規 | 0 | 0.0355 | 0.0483 | 0.0447 |
| 対数正規 | 1.0 | 0.3460 | 0.3798 | 0.6073 |
並べ替え検定の売りは検出力ではなく、第一種の誤りの正確さです。 の行(ずれ0)を見ると、並べ替えは全条件で 0.048〜0.051 を保っています。t検定は 0.0253 / 0.0355 に落ちています。しかし検出力では順位和に負けます(0.3014 対 0.4376、0.3798 対 0.6073)。なお上で書いたとおり、この の正確さは交換可能性が成り立っているおかげです。
そして順位検定が今も使われる理由が3つあると分かりました。
第1に、重い裾では検出力が上。上の表のとおりです。
第2に、 が大きいと正規近似が一瞬で済む。並べ替え検定は でも 億通りあるのでモンテカルロ近似が必要ですが、順位和には と の閉じた式があるので を計算して終わりです。
第3に、帰無分布が表になっていて手計算・査読できる。試験で出るのはこの性質のおかげです。
対応があるかないかの見分け方
ここは記法の問題ではなく、間違えると結論が壊れるところでした。
判定法は一行です。2列に並べて、横に並んだ2つの数字が同じ個体のものか。 行を入れ替えると意味が壊れるなら対応あり。Excelの1行が「1人の被験者のビフォー・アフター」なら対応あり、「無関係な2人」なら対応なしです。
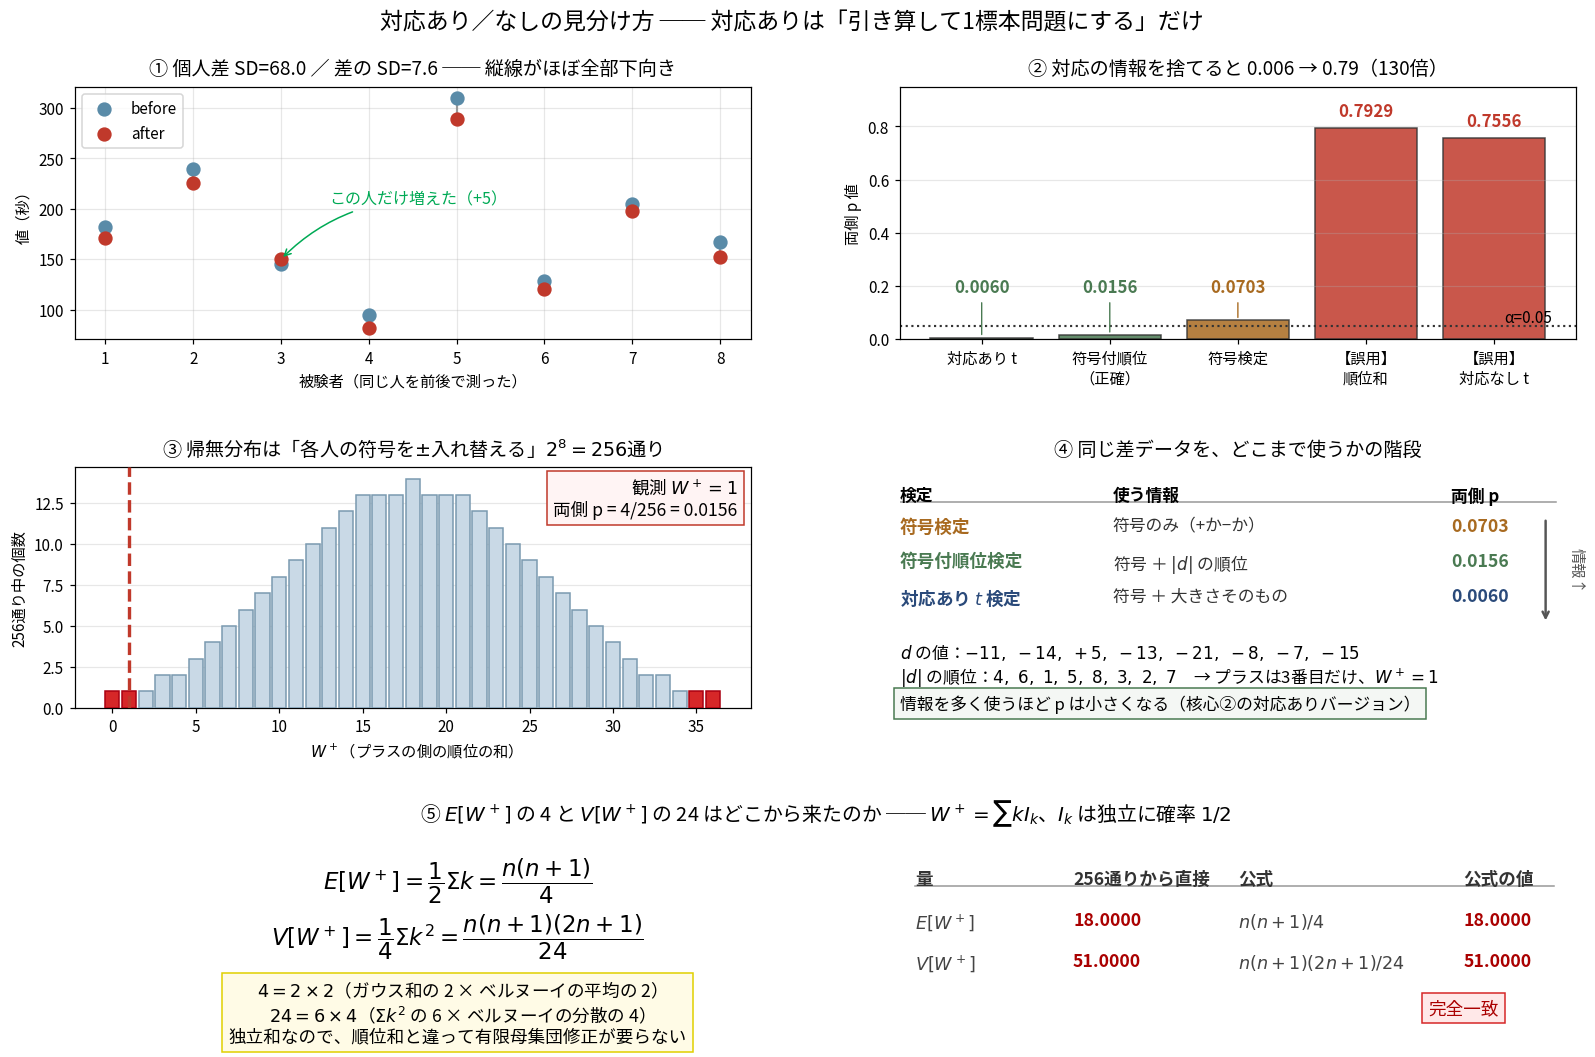
8人の被験者で、施策前後の指標を測ったとします。
| 被験者 | 前 | 後 | 差 |
|---|---|---|---|
| 1 | 182 | 171 | −11 |
| 2 | 240 | 226 | −14 |
| 3 | 145 | 150 | +5 |
| 4 | 95 | 82 | −13 |
| 5 | 310 | 289 | −21 |
| 6 | 128 | 120 | −8 |
| 7 | 205 | 198 | −7 |
| 8 | 167 | 152 | −15 |
対応ありのノンパラメトリック検定は「引き算して1標本問題に変換するだけ」でした。 新しい技術は出てきません。差を取ると8個の数字になり、あとは「これらは0のまわりに対称に散らばっているか」を調べるだけです。
符号付順位検定の帰無仮説は「差の分布が0を中心に対称(かつ連続)」です。この対称性は帰無仮説であると同時にモデル仮定でもある点に注意が必要でした。差の分布が歪んでいると、位置がずれていなくても対称性の破れだけで棄却されえます。順位和のところで「中央値の検定と単純化するのは危険」と書いたのと同じ話です。なお差がちょうど0になる個体は除いて を減らします。
帰無分布の作り方が変わります。群のラベルを入れ替えるのではなく、各人の符号を 入れ替える 通りを数えます。
ウィルコクソンの符号付順位検定の手順は、差の絶対値に順位をつけて(位、位、位、…)、正の差の順位だけを足す。ここでは の1位だけなので 。
256通りの数え上げで平均 18.0000、分散 51.0000。完全一致しました。
この 4 と 24 も由来があります。 と書けて、 は「 位の差が正か」を表す指示変数です。対称性の仮定のおかげで「絶対値の順位」と「符号」が独立になるので、 は独立に確率 のベルヌーイ試行になります。したがって 、。、 です。
ここに順位和検定との構造的な違いがあります。 は独立和なので有限母集団修正が要らない。だから のような「約分の残りかす」が出てこない。順位和の に が出るのは非復元抽出だからでした。この独立性の根拠が対称性の仮定にあるわけで、仮定と公式の形がつながっています。
対応を無視すると何が起きるか
| 手法 | 両側p |
|---|---|
| 対応のあるt検定 | 0.0060 |
| 符号付順位検定(正確) | 0.0156 |
| 符号検定 | 0.0703 |
| 【誤用】 対応を無視した順位和検定 | 0.7929 |
| 【誤用】 対応なしt検定 | 0.7556 |
0.0060 から 0.7929 へ飛びます。理由は数字を見れば明らかで、個人差のSDが68.0なのに対し差のSDは7.6です。対応を無視すると、個人差という巨大なばらつきを「ノイズ」として計算に入れてしまう。ノイズを9倍に増やすのと同じでした。
符号検定 → 符号付順位 → 対応ありt の「情報の階段」
上の表の上3行は、使う情報の量が階段状に増えていく構造になっています。
| 手法 | 使う情報 | p |
|---|---|---|
| 符号検定 | 増えたか減ったかだけ | 0.0703 |
| 符号付順位検定 | 増減 + 変化量の順位 | 0.0156 |
| 対応のあるt検定 | 増減 + 変化量の実数値 | 0.0060 |
このデータでは情報を足すほどp値が小さくなりました。ただしこれは一般法則ではありません。 差に外れ値があると順序が逆転して、対応ありt検定のほうが符号付順位検定より鈍ります(このあとの「食い違ったら」の話と同じ理由です)。一般に言えるのは、「符号検定は最も仮定が弱く、前提が満たされているときには最も鈍い」ということだけでした。
8人中7人が減少しても で有意にならないのは、符号検定が「7/8」という比率しか見ていないからです。
タイ(同順位):5段階評価アンケートの問題
ここまでは「同じ値が出ない」前提でした。5段階評価のアンケートでは同じ値が大量に出るので、 通りが等確率という前提が壊れます。
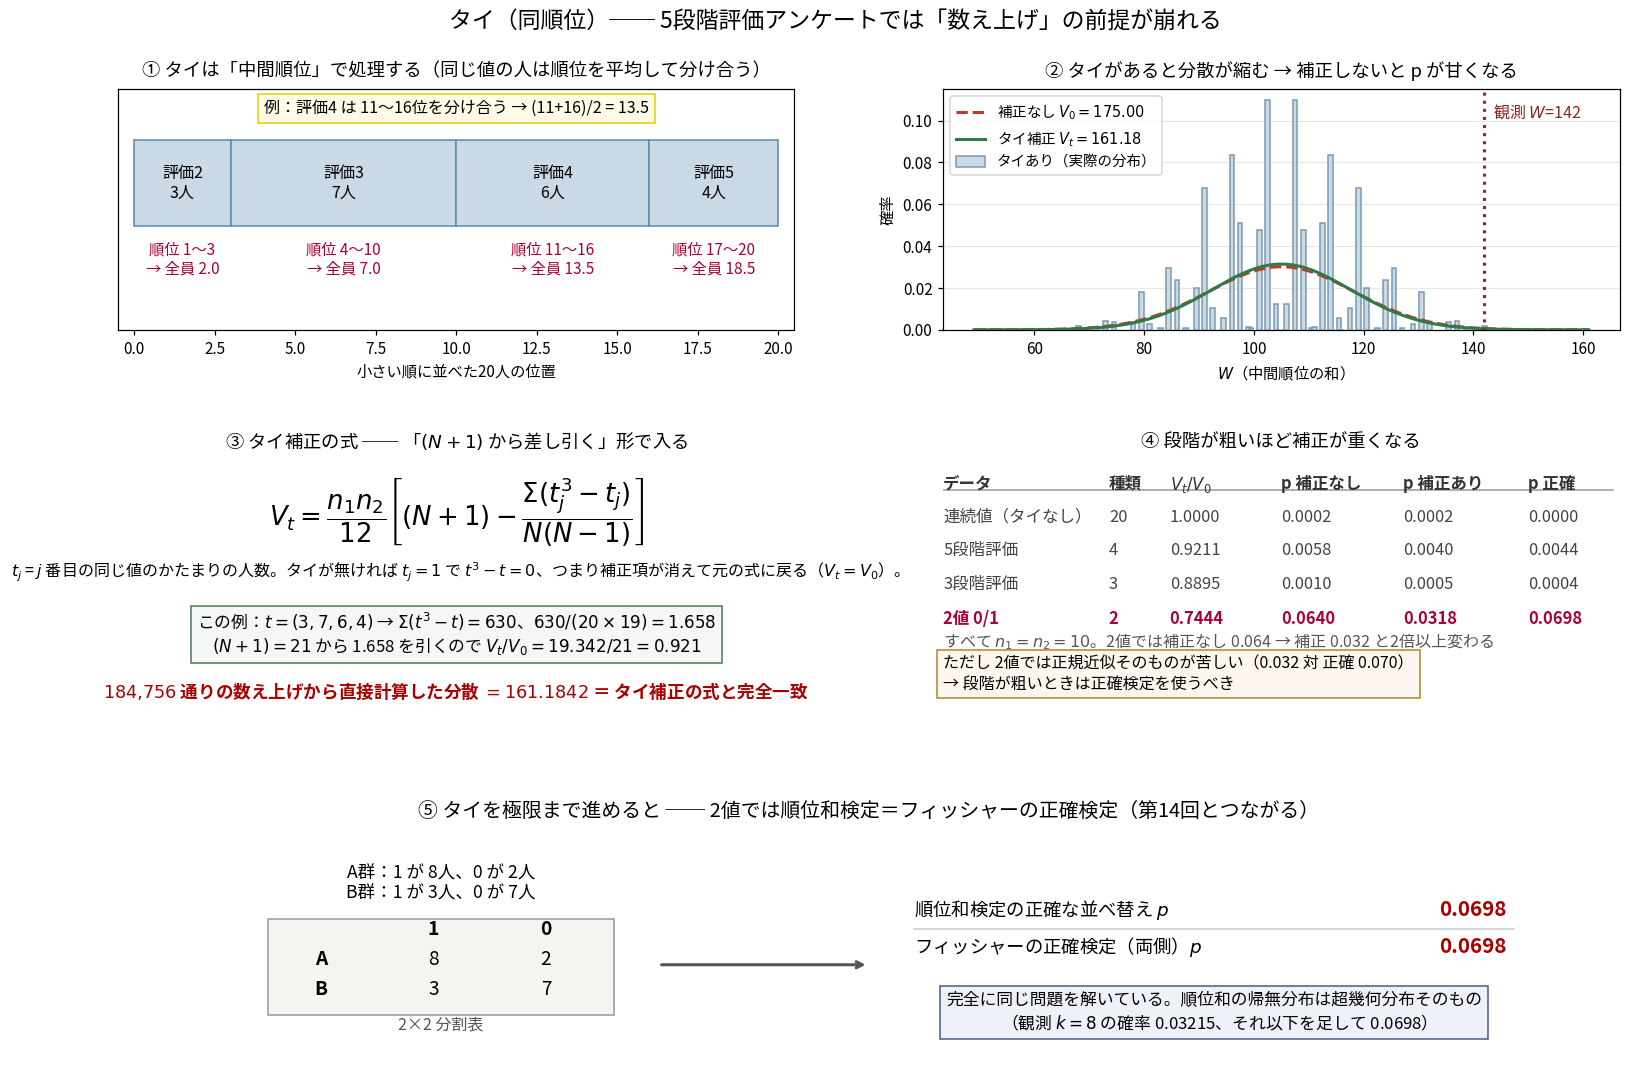
対処は3段構えでした。
第1に、処理法は「中間順位」。 同じ値の人は順位を平均して分け合います。評価4の6人は11位から16位を占めるので、全員 位。これで順位の総和は のまま保たれます。
第2に、分散が縮むので補正が必要。タイがあると が取れる値が減り、分布が細くなります。この例では取れる の値が101種類から56種類に減っていました。
は 番目の同じ値のかたまりの人数です。タイが無ければ で になり、補正項が自動的に消えて元の式に戻ります。 よくできた形です。
この例(A・B各10人、)では 、。 から引くので 。184,756通りの数え上げから直接計算した分散が 161.1842 で、補正式と完全一致しました。
段階が粗いほど補正が重くなります。
| データ | 値の種類 | p 補正なし | p 補正あり | p 正確 | |
|---|---|---|---|---|---|
| 連続値(タイなし) | 20 | 1.0000 | 0.0002 | 0.0002 | 0.0000 |
| 5段階評価 | 4 | 0.9211 | 0.0058 | 0.0040 | 0.0044 |
| 3段階評価 | 3 | 0.8895 | 0.0010 | 0.0005 | 0.0004 |
| 2値 0/1 | 2 | 0.7444 | 0.0640 | 0.0318 | 0.0698 |
最後の行が警告です。 補正すると 0.064 → 0.032 で有意になりますが、正確検定は 0.0698 で有意ではない。補正しても正規近似そのものが破綻しているケースです。段階が粗いときは補正だけで済ませず、正確検定を使うべきでした。
第3に、タイを極限まで進めると分割表の検定になります。 ここは自分でも驚きました。
| 手法 | 両側p |
|---|---|
| 順位和検定の正確な並べ替え | 0.0698 |
| フィッシャーの正確検定 | 0.0698 |
0/1の2値データでは、順位和検定の帰無分布は超幾何分布そのものです。 が2×2表のセル度数の1次関数になるので、片側の正確p は恒等的に一致します。 前回(第14回)でやったフィッシャーの正確検定と地下でつながっていました。「順位に直して数え上げる」という原理は、値の種類が2つに縮んだ瞬間に分割表の検定と同一物になる。
ただし両側 p が一致するかは p 値の定義に依存します。順位和側は片側を2倍する倍化法、フィッシャー側は「観測以下の確率を全部足す」方法を使うのが普通で、この2つは一般には別の値を出します。上の表で一致したのはこの例の表がほぼ対称だったからで、非対称な表では違う数字になります。
実務への含意はこうです。5段階アンケートは中間順位とタイ補正でよい。ただし、「はい/いいえ」の2値なら順位検定を持ち出す必要はなく、素直にフィッシャーの正確検定か比率の検定を使えばいい(同じ答えが出るので)。
3群以上:クラスカル=ウォリス検定
3群に拡張しても、やはり新技術は出てきませんでした。
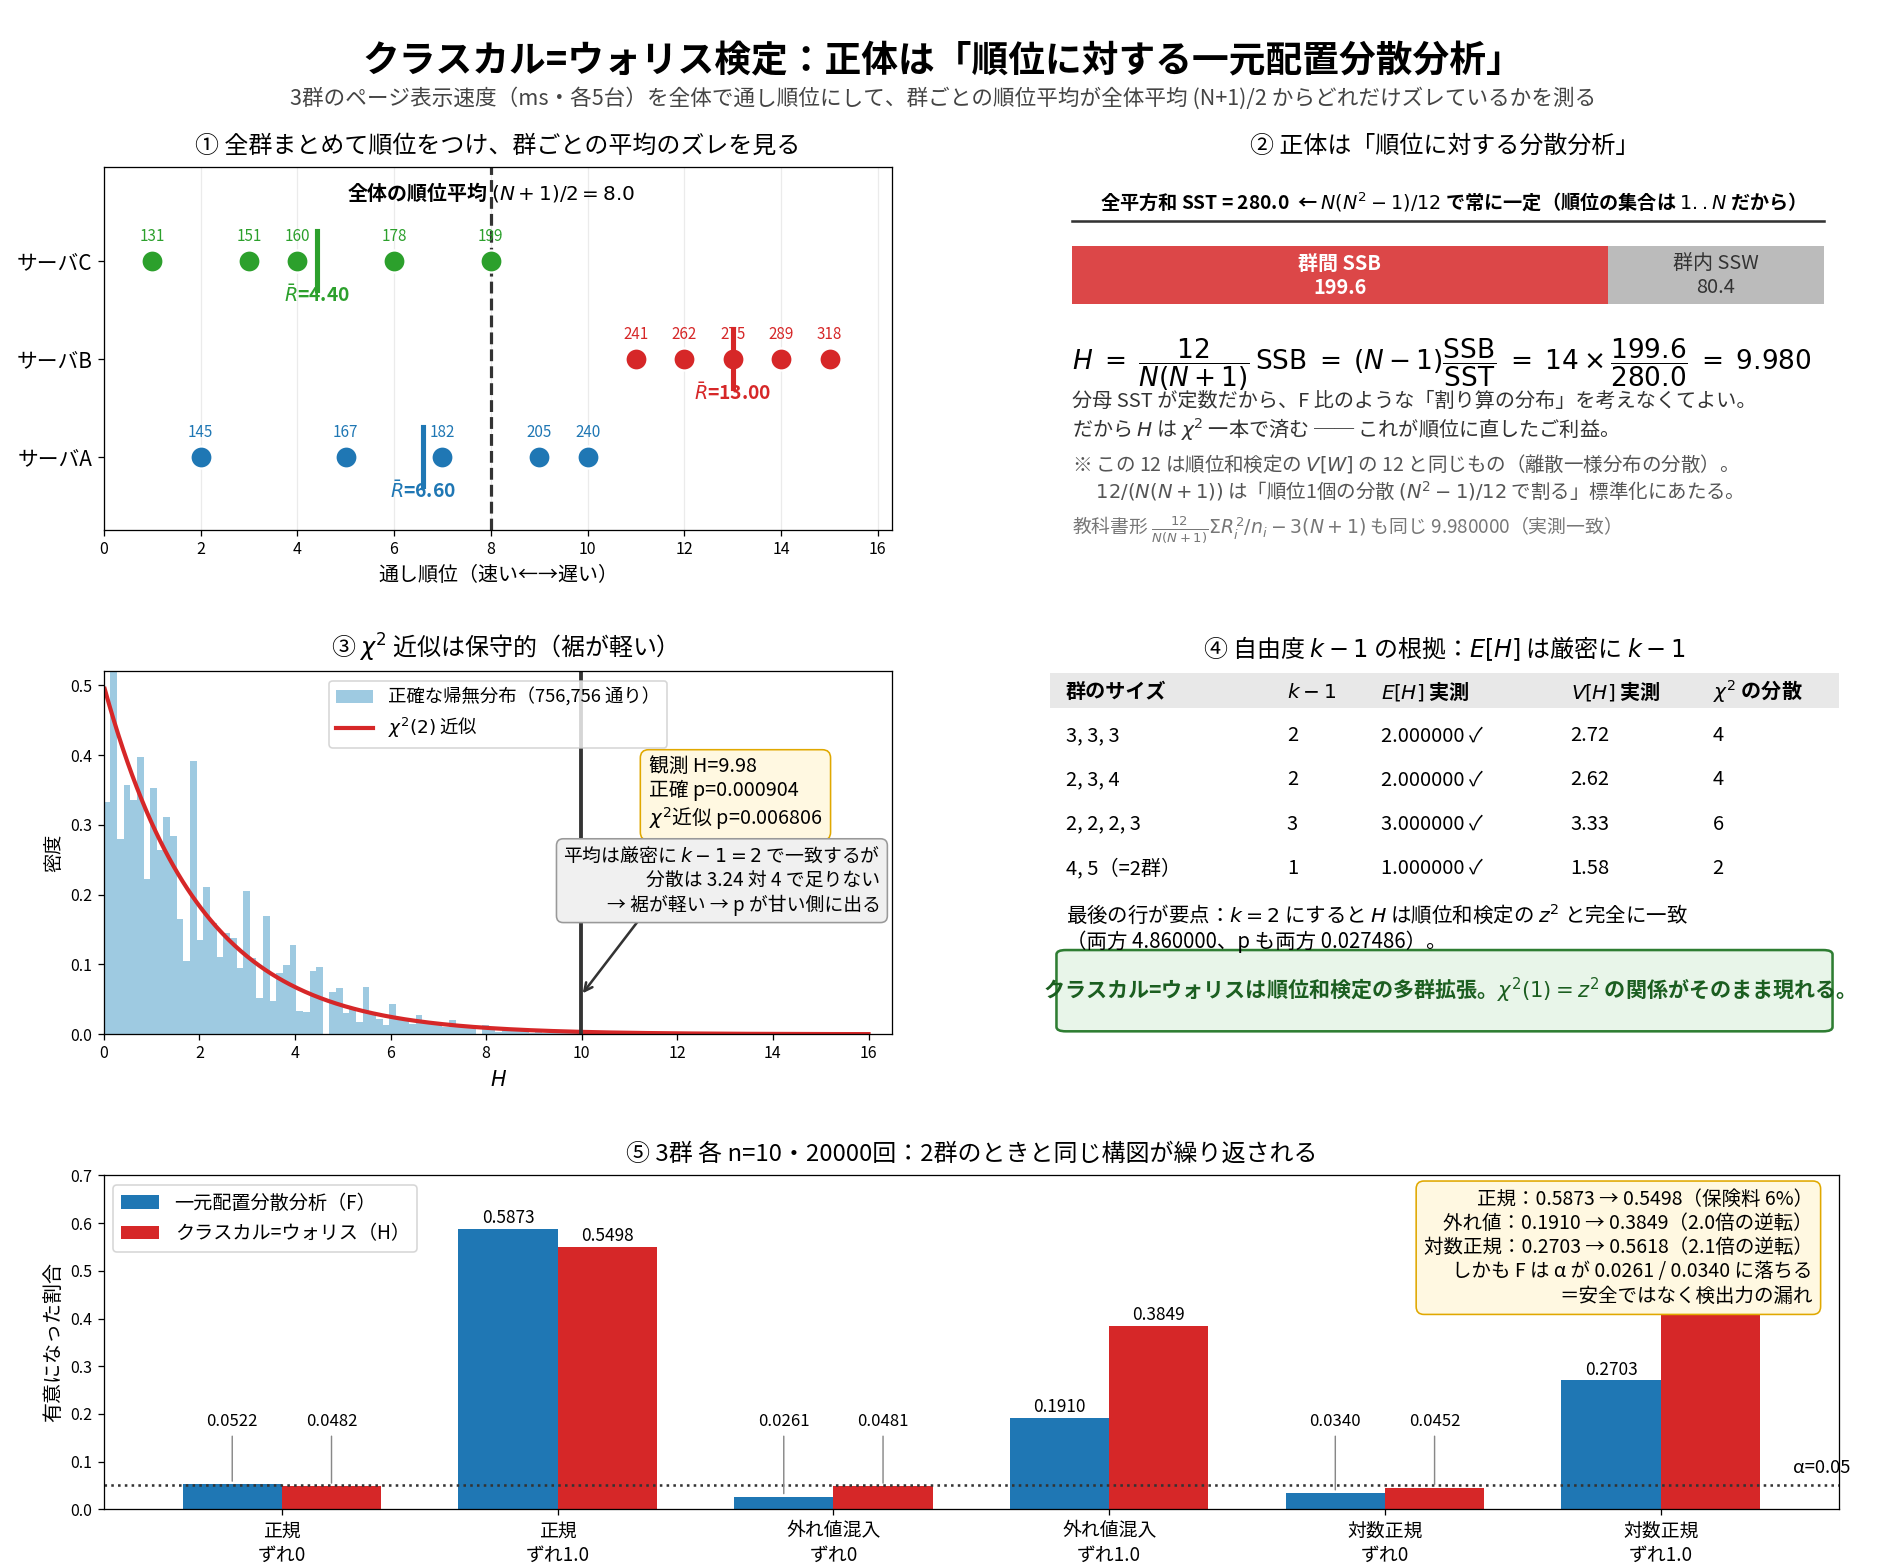
サーバA・B・Cのページ表示速度(ms、各5台)を比べます。全15個を通し順位に直すと、順位平均はA が 6.60、B が 13.00、C が 4.40。全体の順位平均は 。このズレの二乗和を測るのが です。
ここで 12 がまた出てきます。順位和検定の と同じ、離散一様分布の分散の 12 です。ただし正確には は「順位1個の分散 で割る」のではなく、 で割る標準化です( で割る標本分散のほう)。両者は 倍だけ違い、この が下の の と対応しています。いずれにせよ は単位のない量になります。教科書によく載っている は同じ式を展開しただけで、実測で両方 9.980000 でした。
正体は分散分析です。 順位に対して群間平方和 SSB と全平方和 SST を計算すると、
実測で SSB = 199.6、SST = 280.0、。しかも SST は とデータに依らず決まります(順位の集合は常に だから)。
分母が定数だから、 は SSB だけの関数になり、F 比のような「割り算の分布」を考えずにχ²で済む。 これが順位化のご利益でした。分散分析では分子と分母の両方が確率変数なのでF分布が必要になりますが、順位に直すと分母が消えるのです。
2群に戻すと順位和検定と同一物になります。 で 、順位和の 、pも両方 0.027486。 の関係そのままです(タイがない場合の恒等式)。クラスカル=ウォリスは順位和検定の多群拡張という位置づけが数値で確認できました。
自由度が になる根拠も数え上げで確認しました。タイがなければ が厳密に成り立ちます。
| 群のサイズ | 実測 | 実測 | の分散 | |
|---|---|---|---|---|
| 3, 3, 3 | 2 | 2.000000 | 2.72 | 4 |
| 2, 3, 4 | 2 | 2.000000 | 2.62 | 4 |
| 2, 2, 2, 3 | 3 | 3.000000 | 3.33 | 6 |
| 4, 5(=2群) | 1 | 1.000000 | 1.58 | 2 |
平均は厳密に一致するのに分散は足りません(2.72 対 4)。 が小さいと の裾がχ²より軽いので、χ²近似は保守的になります。今回のデータでは正確 に対しχ²近似 で、正確pの約7倍大きい(=棄却しにくい、厳しい側の)値でした。有意にはなるので実害はありませんが、境界付近では正確検定が必要です。
検出力は2群のときとまったく同じ構図でした(3群 各 、20000回)。
| 分布 | ずれ | 一元配置分散分析(F) | クラスカル=ウォリス(H) |
|---|---|---|---|
| 正規 | 0 | 0.0522 | 0.0482 |
| 正規 | 1.0 | 0.5873 | 0.5498 |
| 外れ値混入 | 0 | 0.0261 | 0.0481 |
| 外れ値混入 | 1.0 | 0.1910 | 0.3849 |
| 対数正規 | 0 | 0.0340 | 0.0452 |
| 対数正規 | 1.0 | 0.2703 | 0.5618 |
正規では検出力で3.8ポイント(相対6%)劣り、崩れると2倍前後の逆転。ここは「保険料」という言葉を使いたくなりますが、ARE は必要標本数の比なので検出力の差とは別の量です( 群でも正規での ARE は のままです)。F は が 0.0261 / 0.0340 に落ちていて、これも検出力の漏れです。
順位相関:スピアマンとケンドール
ピアソンの相関係数は直線関係の強さを測ります。順位に直すとこれが単調関係の強さに変わる。「文字数が増えればPVが増える」と言いたいだけなら、それが直線である必要はありません。
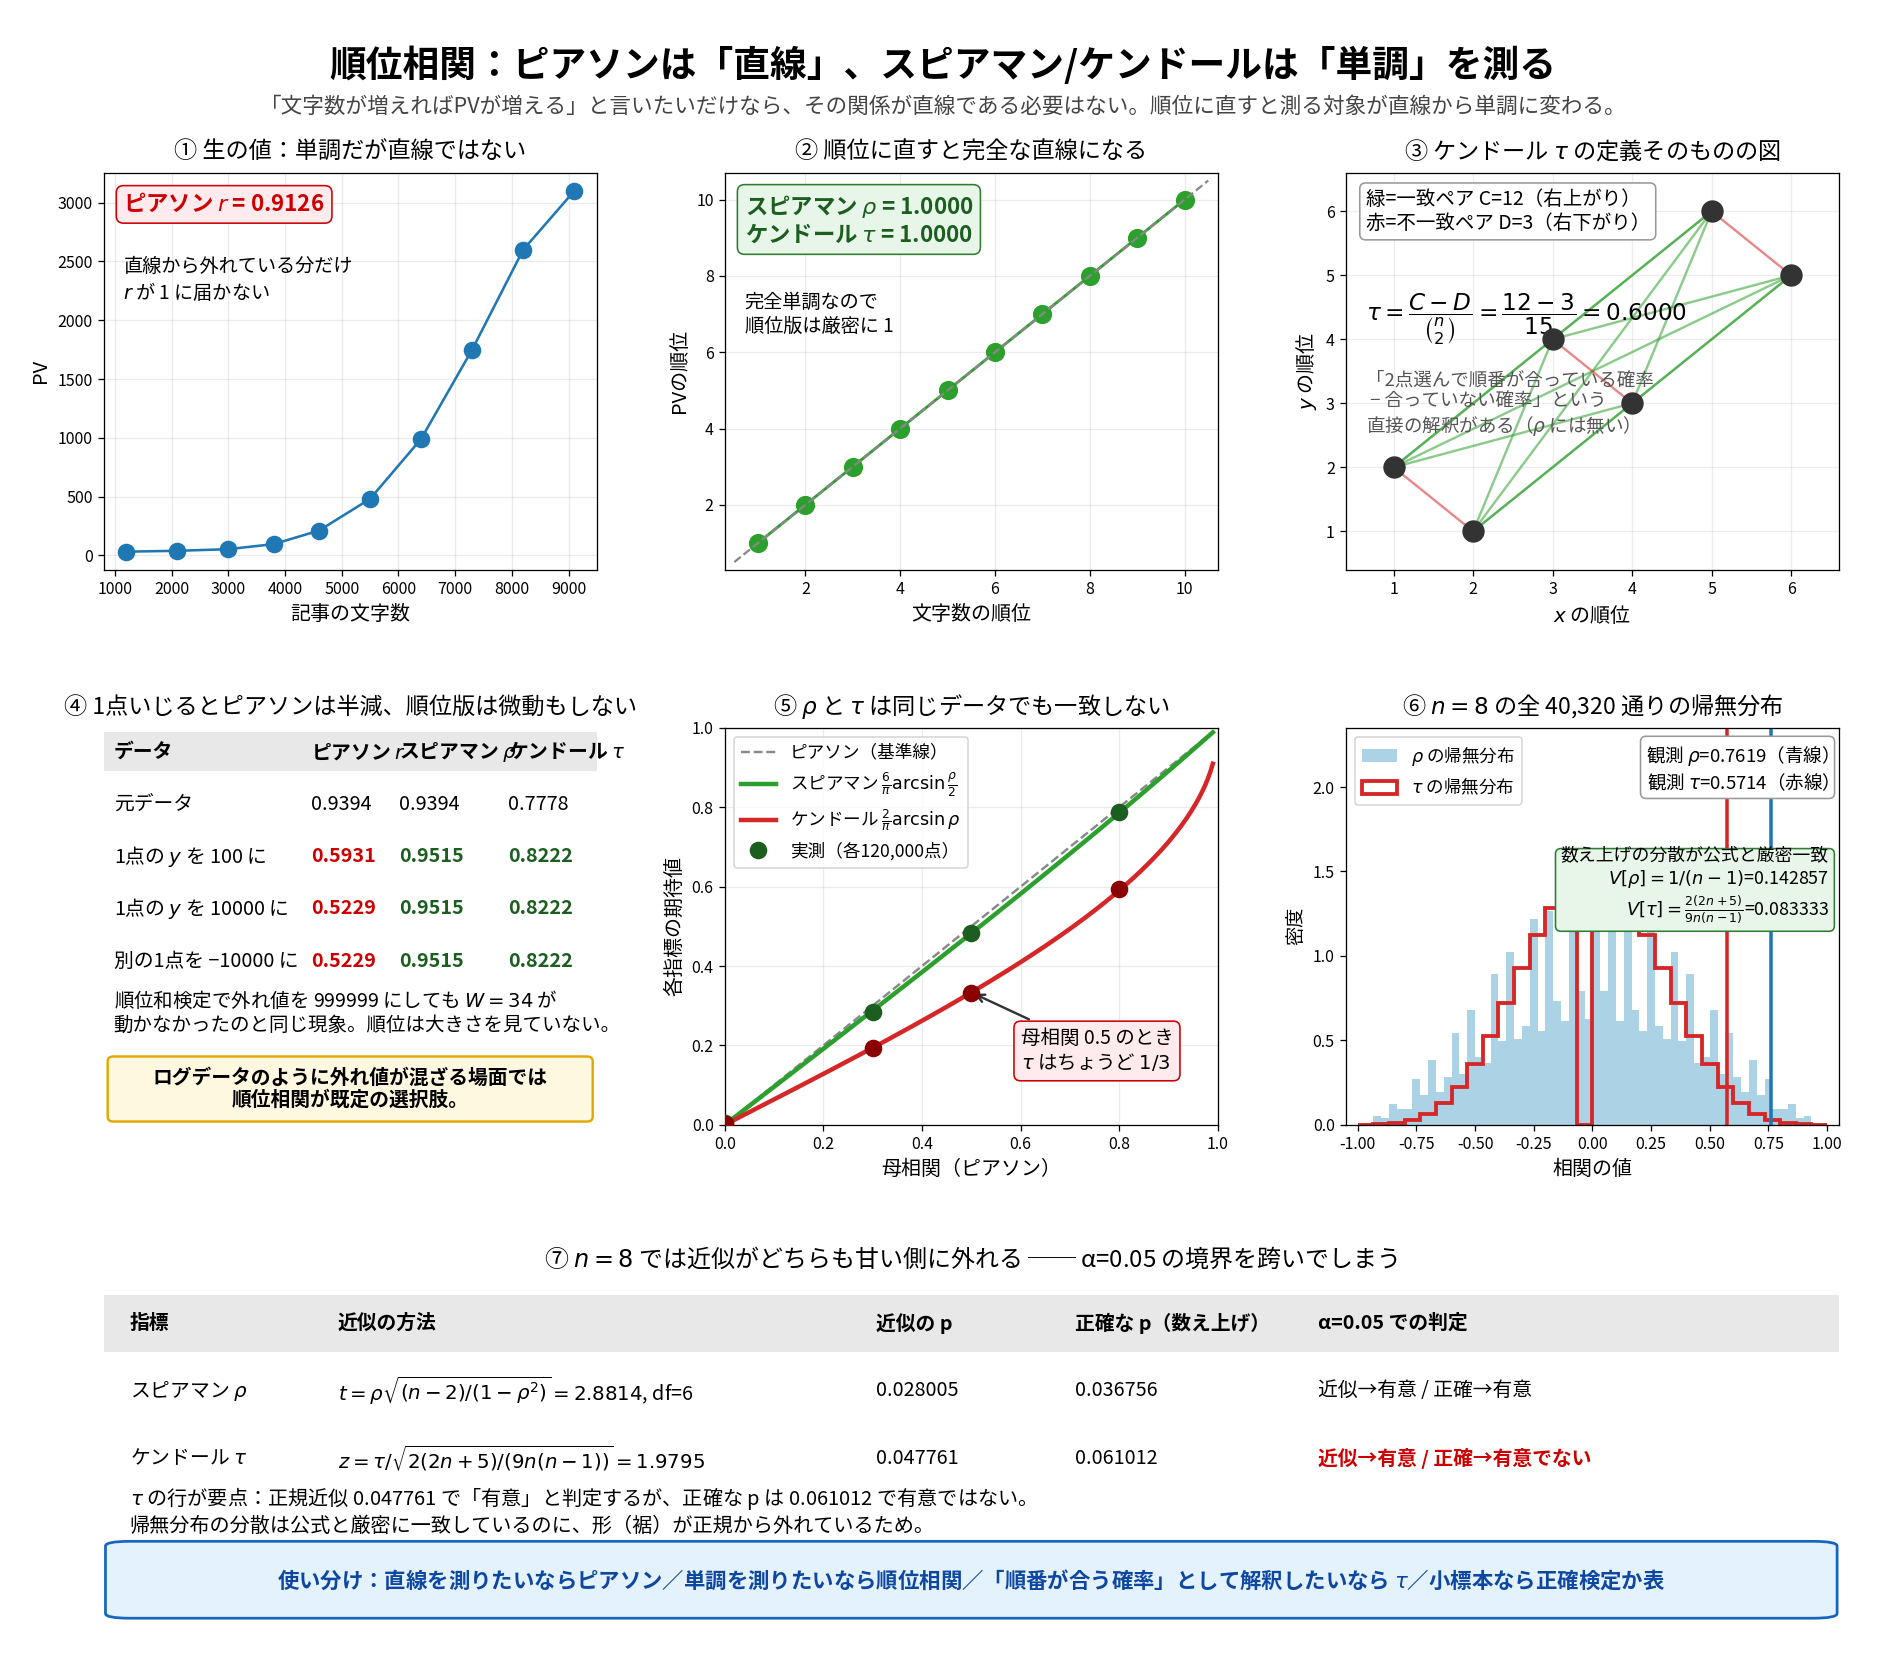
記事の文字数(1200〜9100字)とPV(31〜3100)で試しました。PVは指数的に伸びるので直線ではありません。
| 指標 | 値 |
|---|---|
| ピアソン | 0.9126 |
| スピアマン | 1.0000 |
| ケンドール | 1.0000 |
完全に単調なので順位版は厳密に1になり、ピアソンは0.9台にとどまります。
スピアマンの は「順位に対するピアソン」そのものです。 教科書によく載っている公式
( は同じ個体のxの順位とyの順位の差)は、タイが無いときだけ「順位に対するピアソン」と厳密に一致します。ここでも が出てきて、これはクラスカル=ウォリスの と同根です。順位の平方和が最初から決まっているから、 だけで相関が復元できる。
ケンドールの は考え方が違います。
は一致ペア数、 は不一致ペア数。 ペアすべてについて「xでもyでも同じ向きか」を判定して、その差の割合を取ります。「ランダムに2点選んだとき、順番が合っている確率 − 合っていない確率」という直接の解釈があるのが の強みです。
スピアマンにも確率的な表現はありますが、3点を使う形()になるので ほど直感的ではありません。「 には解釈がない」ではなく「2点では書けない」が正確でした。
なお上の式は で、タイがあるときは分母を に取り替えた が標準です( はそれぞれの変数のタイペア数)。
と の値を同じ物差しで比べてはいけない
ここが実務でいちばん危ない落とし穴でした。二変量正規のとき、母ピアソン相関 に対して、母集団のスピアマン値 と母集団のケンドール値 には別々の公式があります。
これは母集団の値( の極限)です。有限の ではスピアマンにわずかなバイアスがあり、厳密には で、 で上の式に収束します。ケンドールのほうは有限 でも が厳密です。以下は各120,000点なので極限値とみなして比較できます。
| 母ピアソン相関 | ピアソン | スピアマン | ケンドール | ||
|---|---|---|---|---|---|
| 0.0 | 0.0039 | 0.0044 | 0.0029 | 0.0000 | 0.0000 |
| 0.3 | 0.2980 | 0.2850 | 0.1923 | 0.2876 | 0.1940 |
| 0.5 | 0.5002 | 0.4822 | 0.3332 | 0.4826 | 0.3333 |
| 0.8 | 0.8022 | 0.7887 | 0.5932 | 0.7859 | 0.5903 |
理論式と実測がぴったり合いました。母相関0.5のとき、ケンドールはちょうど になります。だから「 だから相関が弱い」と読むのは誤りです。 は より系統的に小さい別スケールの量でした。
外れ値への強さ
| データ | ピアソン | スピアマン | ケンドール |
|---|---|---|---|
| 元データ | 0.9394 | 0.9394 | 0.7778 |
| 1点の を 100 に | 0.5931 | 0.9515 | 0.8222 |
| 1点の を 10000 に | 0.5229 | 0.9515 | 0.8222 |
| 別の1点を −10000 に | 0.5229 | 0.9515 | 0.8222 |
1点いじるだけでピアソンは 0.94 から 0.52 に半減し、順位版は微動もしません。 順位和検定で外れ値を999999にしても が動かなかったのと同じ現象です。
無相関の検定
で 通りを全数え上げしました。観測順位は で 、。
| 指標 | 近似の方法 | 近似のp | 正確なp | の判定 |
|---|---|---|---|---|
| スピアマン | , df=6 | 0.028005 | 0.036756 | 近似→有意 / 正確→有意 |
| ケンドール | 0.047761 | 0.061012 | 近似→有意 / 正確→有意でない |
帰無分布の分散は公式と厳密一致していました。、、どちらも数え上げの値と完全に同じ。
それでも は判定が逆転します。 分散が合っているのに が外れるのは、形(裾)が正規から外れているからです。分散が正しいことは分布が正しいことを意味しない。小標本では正確検定か数表を使うべきでした。
使い分けはこうなります。 直線を測りたいならピアソン、単調を測りたいなら順位相関、「順番が合う確率」として解釈したいなら 、小標本なら正確検定か表。ログデータのように外れ値が混ざる場面では、順位相関が既定の選択肢になります。
6手法は一本の原理の変奏だった
通して見ると、この章は独立した手法の羅列ではありませんでした。
| 手法 | 何を並べ替えるか | 統計量 | 平均 | 分散 |
|---|---|---|---|---|
| 符号検定 | 各個体の符号 | 正の個数 | ||
| 符号付順位検定 | 各個体の符号 | |||
| 順位和検定 / U | 群のラベル | |||
| クラスカル=ウォリス | 群のラベル(多群) | — | ||
| スピアマン | 片方の順位の並び | 順位のピアソン | 0 | |
| ケンドール | 片方の順位の並び | 0 | ||
| 並べ替え検定 | 何でも | 何でも | — | — |
「何を並べ替えるか」の列が設計そのものです。 対応ありは符号、対応なしは群ラベル、相関は片方の並び。ここを間違えると p が 0.0060 から 0.7929 に飛びます。
そして分散の列に 12・4・24・ が繰り返し現れる。全部、「順位の集合は必ず で、その平方和が最初から決まっている」という一点から来ています。
パラメトリック検定は母集団の分散を推定するために自由度を消費する。順位検定は分散を数え上げで確定させる。 この章の全体はこの一行でした。
実務での使い分け
学んだことを自分のブログ運営に落とすと、こうなりました。
5段階評価のアンケート(「この記事は役に立ちましたか」):中間順位とタイ補正で順位和検定を使う。平均を取って「3.8点でした」と報告するのは、順序尺度を間隔尺度として扱っている点で怪しい(「4と5の差」と「1と2の差」が同じ大きさだと仮定している)。
滞在時間やセッション長のログ:順位検定を既定にする。この種のデータは必ず極端な外れ値(タブを開いたまま寝た人)が混ざるので、平均が壊れます。中央値とホッジス=レーマン推定量で報告する。
「はい/いいえ」の2値:順位検定を持ち出さず、フィッシャーの正確検定か比率の検定。同じ答えが出るので、通りのよい名前を使ったほうがいい。
A/Bテストのコンバージョン率:これは2値なので上と同じ。ただし第13回でも書いたとおり、検定の選択より「途中で見て止めない」ことのほうが影響がずっと大きい。
サンプルが極端に少ないとき(各群5〜10):正確検定を使う。この記事で何度も出てきたとおり、正規近似は小標本で判定が逆転します。
つまずいたところ
「順位検定は信頼区間や効果量が苦手」と思い込んでいた。 苦手なのではなく、指標が平均差ではないだけでした。U統計量・効果量(確率的優越)・ホッジス=レーマン推定量があり、中央値ベースの区間推定は普通にできます。
並べ替え検定が万能だと思っていた。 これがこの章でいちばん大きな勘違いでした。「並べ替え」は帰無分布の作り方で、頑健性は統計量の選び方。 この2つを混同していたので、「並べ替えなら外れ値に強いはず」と考えていました。実際は平均差を統計量にした並べ替え検定は外れ値で 0.0317 から 0.4603 まで崩壊します。
126通りを「観測されたデータ」と読み違えた。 帰無仮説のもとで起こりえた仮想のパターンであって、実際に観測したのはそのうち1通りです。並べ替え検定の考え方の根っこにある部分なので、ここを誤解していると全体が分からなくなります。
が小さいのを「安全」だと思っていた。 t検定が外れ値混入で 0.030 に落ちるのを見て最初は「保守的でよいこと」と思いましたが、これは検出力の漏れでした。第13回で同じ間違いをしていたので、2回目です。
符号付順位検定の分散に有限母集団修正が必要だと考えた。 順位和検定に という「約分の残りかす」があったので同じだろうと思いましたが、 は独立和なので修正が要らない。非復元抽出かどうかという構造の違いを見落としていました。
の値を と同じ物差しで読んでいた。 母相関0.5でケンドールが 0.3333 になるのを見るまで、「 が小さいなら相関が弱い」と読んでいました。
分散が合っていれば近似が使えると思っていた。 ケンドールの で、 は公式と厳密に一致しているのに の判定が逆転しました(0.0478 対 0.0610)。分散が正しいことは分布が正しいことを意味しない。 モーメントの一致は分布の一致ではないという当たり前のことを、実例で叩き込まれました。
「正規分布が最悪ケース」だと思い込んでいた。 ARE の表に一様分布の 1.0 が並んでいるのを見て、「正規が底で、あとは得しかない」と読んでいました。実際には裾の短い分布でもう少し損をしえて、下限は です。表に載っている分布が全部ではないという当たり前のことを見落としていました。
「並べ替えなら前提が不要」だと思っていた。 並べ替え検定にも交換可能性という前提が必要です。この記事のシミュレーションで が守られていたのは2群を同じ分布から生成していたからで、「平均だけが等しく分散が違う」場合は並べ替えでも崩れます。前提から自由になる方法はなくて、どの前提と引き換えにするかを選んでいるだけだと分かりました。
この記事の要点
- 順位は元の分布を忘れる。 が単調非減少だから順序が保たれる(連続分布ならタイが起きないので狭義。ヤコビアン不要)
- 忘れた結果、 では全割り当てが等確率になり、帰無分布が数え上げで確定する。 4分布40万回で厳密分布と最大誤差 0.0012
- 正規分布での保険料は 4.5%(ARE )。ただし正規は最悪ケースではなく、下限は (最大14%の損)
- 崩れると2倍の見返り。 2群 で外れ値混入 0.2263 対 0.4376、対数正規 0.3460 対 0.6073(3群のF対Hでは 0.1910 対 0.3849、0.2703 対 0.5618)
- t検定は外れ値で が 0.030 に落ちる。安全ではなく検出力の漏れ
- 食い違ったら向きを見る。片方だけ有意が非対称に出るのは前提が壊れているサイン
- 順位和の の保証は が前提。 中央値の検定と読むには位置ずれモデルが要る
- 並べ替えは帰無分布の作り方、頑健性は統計量の選び方。 直交している。ただし交換可能性は並べ替えにも要る
- 並べ替え検定の売りは検出力ではなく の正確さ(全条件で 0.048〜0.051)
- 順位検定が残る理由は、重い裾で検出力が上・ 大で正規近似が一瞬・帰無分布が表になっている
- 対応ありは引き算して1標本問題に変換するだけ。無視すると 0.0060 → 0.7929
- 、。対称性の仮定から絶対値の順位と符号が独立になり、独立和なので有限母集団修正が要らない
- タイは中間順位。 の補正項は で自動的に消える。184,756通りの数え上げと厳密一致
- 2値データでは順位和 = フィッシャーの正確検定(片側は恒等的に一致、両側は p の定義次第)。順位和の帰無分布は超幾何分布
- クラスカル=ウォリスは「順位に対する一元配置分散分析」。 SST が定数なのでχ²で済む。 で順位和の と一致
- は(タイがなければ)厳密だが分散は足りない(2.72 対 4)→ χ²近似は保守的
- スピアマンは順位のピアソン、ケンドールは「順番が合う確率」。 母相関0.5で
- 分散が公式と一致しても近似が使えるとは限らない( の で判定が逆転)
- 12・4・24・ は全部「順位の平方和が最初から決まっている」から来ている
これで推測統計編が終わりました。第8章から第13章まで、推定と検定を一通り扱ったことになります。振り返ると、この6章はすべて「分母のばらつきをどう見積もるか」の変奏でした。第13回では母集団の分散を推定して自由度を消費し、今回は数え上げで分散を確定させた。同じ問いに対する2つの答え方だったわけです。
次回からは線形モデル編に入ります。ここまでは1つか2つの変数を扱ってきましたが、変数が3つ以上になると「どの変数がどの変数に効いているのか」という新しい問いが出てきます。第16章の重回帰分析がその入口です。