分割表:オッズ比とリスク比で結論が逆になる理由【第30回】
はじめに
第28章は分割表です。
前回は時間方向に並んだデータを扱いました。今回はカテゴリを2方向に並べたデータで、第14回のカイ二乗適合度検定が行と列の2方向に拡張されます。
この章に入る前の私の認識は「クロス集計表をカイ二乗検定にかける回」で、第14回の応用編くらいだと思っていました。実際その認識はおおむね合っていて、統計量の式は第14回とまったく同じです。違うのは期待度数の作り方だけでした。
ところが手を動かしてみると、想定していなかったところで足を取られました。いちばん驚いたのはこれです。
同じ2つの表を比べているのに、リスク比で測ると片方が勝ち、オッズ比で測るともう片方が勝ちます。
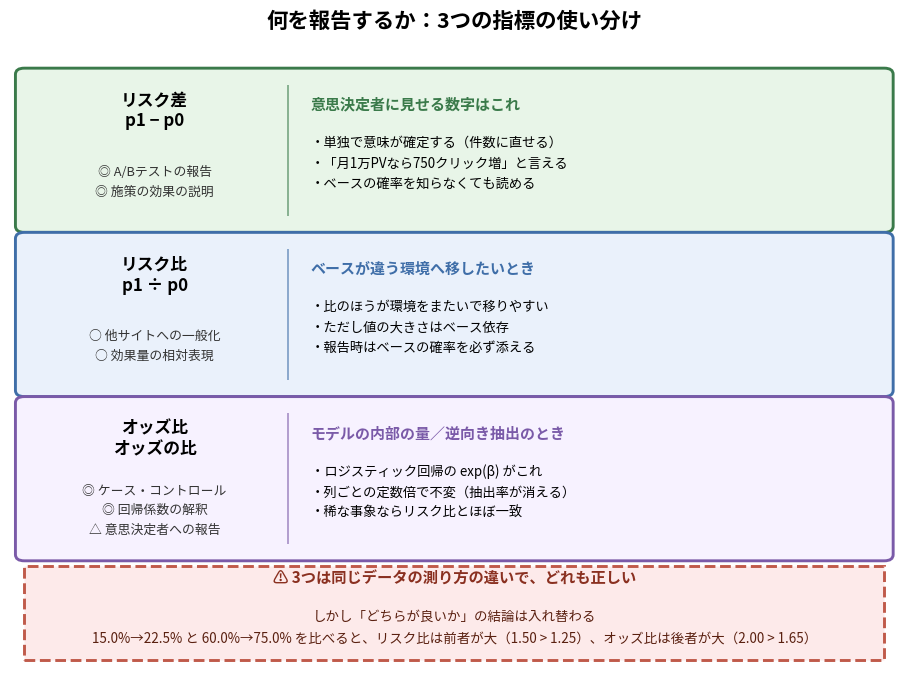
15.0%から22.5%へ上がった施策と、60.0%から75.0%へ上がった施策。リスク比は1.50対1.25で前者が大きい。オッズ比は1.65対2.00で後者が大きい。どちらの計算も正しくて、それでも結論が逆になる。「オッズ比とリスク比の違い」を用語の問題だと思っていたのですが、報告する指標を選ぶ時点で結論を選んでいるという話でした。
もうひとつ効いたのがシンプソンのパラドックスです。層別すると2つの層でどちらもAが勝っているのに、合計するとBが17ポイント差で圧勝する表を作りました。しかもその合計表を検定すると 、 値は の水準で「極めて有意にBが優れている」と出ます。有意性は交絡をまったく直してくれないという当たり前の事実を、数値で殴られる形で確認しました。
そして今回は、自分が出した3つの疑問がそのまま記事の柱になりました。残差の説明を読んでいて出てきた質問です。
- 寄与度はなぜ期待値で割るのか。感覚的には標準偏差で割りたい
- ピアソン残差は分かる。調整済み残差とは何なのか
- 補正後の とは何か。標準偏差をかけて範囲を広げているのか
答えを先に書くと、1つ目は「実際に標準偏差で割っている」、2つ目は「周辺合計を推定に使ったせいで縮んだ分散を割り戻したもの」、3つ目は「分布は動かさず切る位置だけをずらしている」です。3つとも「数え上げの標準偏差とは何か」という1点に収束していて、教科書だと式だけ書いてあって理由が書かれていない場所でした。
いつものように、出てくる数値はすべて自分で計算し、理論値やシミュレーションと突き合わせています。
この回で扱う用語
| 用語 | 読み・意味 |
|---|---|
| 分割表 | Contingency Table。2つ以上のカテゴリ変数を縦横に取って度数を数えた表。クロス集計表とも |
| 独立性の検定 | Test of Independence。行と列が独立かどうかを調べる検定 |
| 期待度数 | Expected Frequency。帰無仮説のもとで期待される人数 |
| リスク差 | Risk Difference。2つの確率の差 。単位はポイント |
| リスク比 | Risk Ratio(相対リスク)。2つの確率の比 |
| オッズ | Odds。「起きた:起きなかった」の比 |
| オッズ比 | Odds Ratio。2つのオッズの比。 のたすき掛けで計算できる |
| フィッシャーの正確検定 | Fisher's Exact Test。周辺合計を固定して全パターンを数え上げる検定 |
| 超幾何分布 | Hypergeometric Distribution。周辺合計を固定したときのセル度数が従う分布 |
| イエーツの連続性補正 | Yates' Continuity Correction。 から 0.5 を引く補正 |
| マクネマー検定 | McNemar Test。対応のある2×2表で、不一致ペアだけを使う検定 |
| シンプソンのパラドックス | Simpson's Paradox。層別と全体で結論が逆転する現象 |
| 交絡因子 | Confounder。群の割り付けと結果の両方に関係する変数 |
| マンテル・ヘンツェル法 | Mantel-Haenszel Method。層を通した共通オッズ比を推定する方法 |
| ピアソン残差 | Pearson Residual。。2乗すると への寄与になる |
| 調整済み残差 | Adjusted Residual(標準化残差)。分散を正しく補正した残差。近似的に標準正規分布に従う |
| 対数線形モデル | Log-Linear Model。セル度数の対数を行効果・列効果・交互作用の和で表すモデル |
| ケース・コントロール研究 | Case-Control Study。結果で群を分けてから原因を遡って調べる研究デザイン |
まず何に使うのか
数式の前に、この道具が必要になる場面から入ります。
このブログの記事末尾に置いているアフィリエイトリンクのデザインを、2種類試したとします。集計はこうなりました。
| クリックした | しなかった | 合計 | |
|---|---|---|---|
| デザインA | 30 | 170 | 200 |
| デザインB | 45 | 155 | 200 |
| 合計 | 75 | 325 | 400 |
知りたいのは「デザインとクリックには関係があるのか」です。A は15.0%、B は22.5%。差はありますが、400人程度だと偶然でもこれくらい動きそうな気がします。
この表が分割表です。行が2つ、列が2つなので 2×2 分割表と呼びます。行や列が増えれば 分割表になります。
やりたいことは第14回と同じ「観測された度数が、ある仮説から期待される度数とどれくらいズレているか」を測ることです。ただ、その期待される度数がどこから来るのかが、第14回とは違います。
第14回との違いは、期待度数の作り方だけ
第14回の適合度検定では、期待度数が外から与えられていました。サイコロなら「各面 」、ポアソン分布なら「 を推定して各カテゴリの確率」。帰無仮説が確率を直接指定してくれるので、あとは総数を掛ければ期待度数になります。
分割表の帰無仮説は「行と列が独立」です。これは確率を直接指定していません。だから期待度数を自分で作る必要があります。
使うのは第2回でやった独立の定義 です。
- クリックする確率は
- デザインAである確率は
- 独立なら両方が起きる確率は
- 400人中の期待人数は
約分すると有名な形になります。
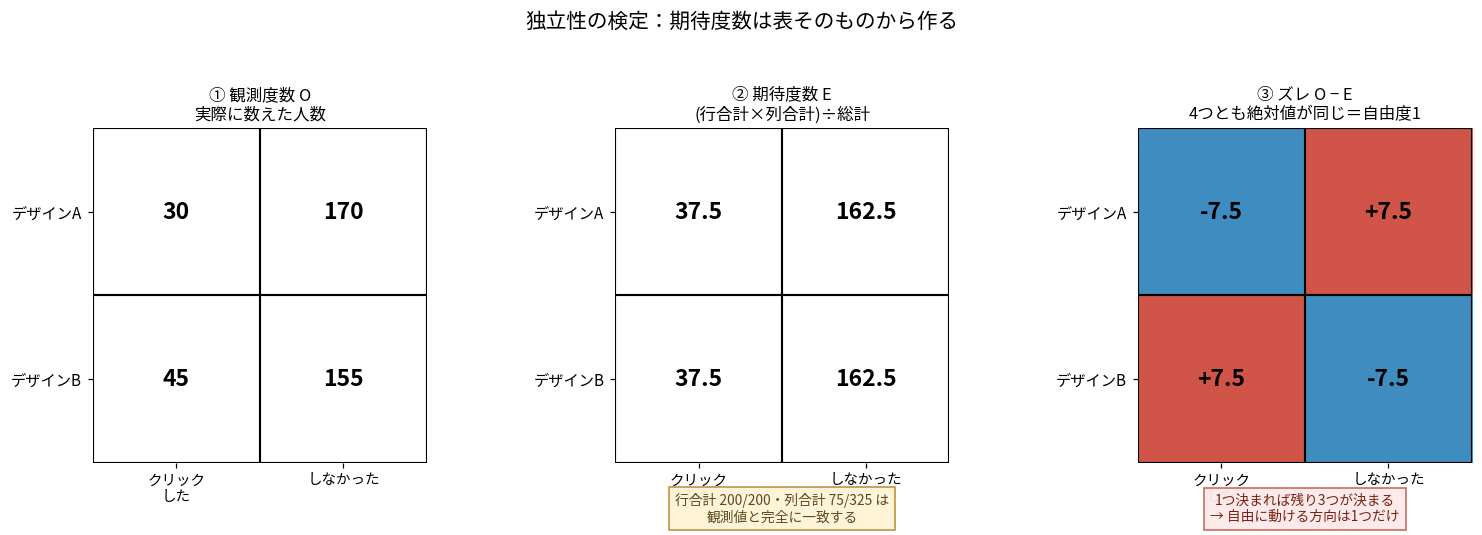
ここが今回の全部の土台です。期待度数を作るために、表の周辺合計(行の合計と列の合計)をデータから借りてきています。
図の中央パネルを見ると、期待度数の行合計は 200/200、列合計は 75/325 で、観測値と完全に一致します。当然です、そこから作ったので。つまり観測値と期待値がズレていいのは表の内側だけという構造になっています。
あとは第14回と同じ式です。
自由度1で 。5%をわずかに超えるので「有意差なし」です。15.0%対22.5%という見た目には大きい差でも、各200人では足りませんでした。
違いを整理しておきます。
| 適合度検定(第14回) | 独立性の検定(今回) | |
|---|---|---|
| 帰無仮説 | 「この分布に従う」(確率を直接指定) | 「行と列が独立」(確率は指定しない) |
| 期待度数の出どころ | 仮説が与える | 周辺合計から自分で作る |
| データから借りる量 | 0個(または推定した 個) | 個 |
| 自由度 | ||
| 統計量 | 同じ |
統計量の式は完全に同じで、違うのは期待度数の作り方と、その結果としての自由度だけです。
自由度 (r−1)(c−1) を実際に数える
第14回で「自由度=制約の本数を引く」と学んだので、その考え方で導けるはずです。実際に数えてみます。
先に、さっきの2×2表で自由度1が目に見える形で出ていたことを指摘しておきます。図の右パネルのズレを並べると で、4つとも絶対値が同じ、符号だけが市松模様に並んでいます。
これは偶然ではありません。周辺合計が観測値と一致しているので、ズレは行の中で足して0、列の中でも足して0でなければいけない。この制約を満たす4つの数は、1個決めたら残り3個が自動的に決まります。だから自由に動ける方向が1つしかない。これが自由度1の意味です。
もう少し大きい表で確かめます。読者の年代と流入元のクロス集計で、周辺合計だけを固定して、左上から埋めていきます。
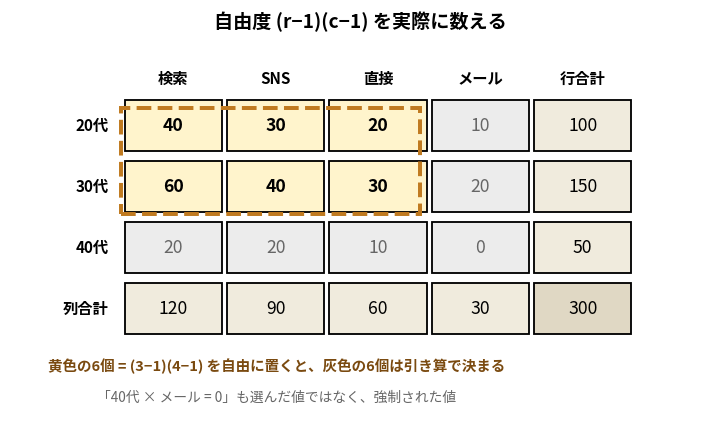
黄色の6セルを自由に置いた時点で、残りの6セルは全部引き算で決まります。右端の列は行合計から、最下行は列合計から出てくる。
これが自由度です。「」は「最後の行と最後の列は引き算で出るから数えない」という意味でした。
注目してほしいのは「40代 × メール = 0」です。これは私が選んだ値ではなく、周辺合計から強制された値です。自由度の話は「どのセルを自由に決められるか」の話なので、こういう強制されるセルは数に入りません。
第14回の「制約を引く」書き方でも同じ数が出ます。
| 数えるもの | 個数 |
|---|---|
| セル確率のうち自由なもの | (全部足して1なので1本減る) |
| 行の周辺確率を推定するのに使った本数 | |
| 列の周辺確率を推定するのに使った本数 | |
| 差 |
なので、展開すれば同じ式です。「実際に埋めてみる」やり方と「制約を引く」やり方が一致することが確認できました。
「周辺合計を固定する」には3つの意味がある
ここで先に注意しておきます。この「周辺合計は固定されている」という言い方は、実際のデータ収集では場面によって意味が変わります。
| データの取り方 | 固定されているもの | 確率モデル |
|---|---|---|
| 400人集めてから、デザインと結果の両方を記録 | 総計のみ | 1つの多項分布 |
| デザインAに200人、Bに200人と決めて割り振った | 行合計 | 独立な2つの二項分布 |
| フィッシャーの正確検定の立場 | 行と列の両方 | 超幾何分布 |
確率モデルとしては別物なのに、 の計算式は完全に同じになります。これは偶然ではなく、どのモデルでも最尤推定した期待度数が同じ形になるためです。ただし後で見るフィッシャーの正確検定は3番目の立場を取るので、そこだけ区別が必要になります。
3つの指標:どこを分母に置くかだけが違う
ここからが今回の本題のひとつです。実務でいちばん混乱するところでした。
同じ2×2表から、効果の大きさを表す指標が3つ出てきます。
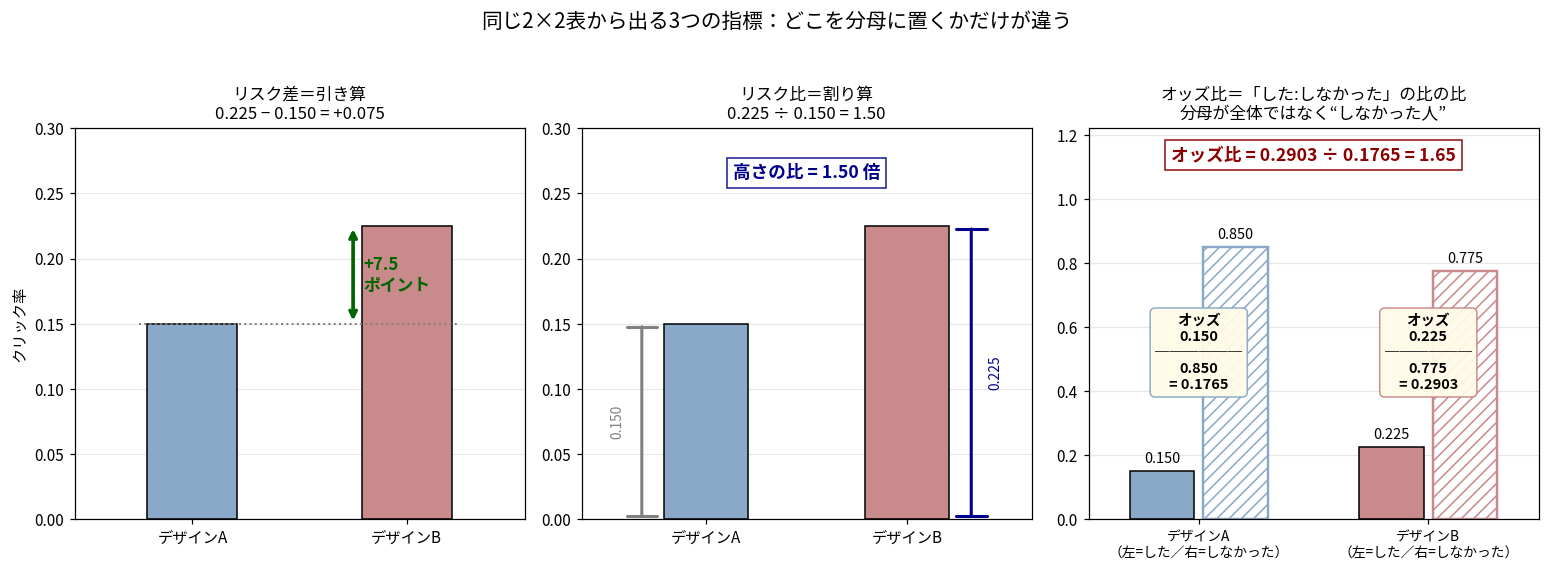
| 指標 | 定義 | 値 | 読み方 |
|---|---|---|---|
| リスク差 | 100人あたり7.5人増える | ||
| リスク比 | 1.5倍になる | ||
| オッズ比 | オッズが1.645倍 |
「リスク」という語は医学由来の慣習で、悪いことを指す必要はありません。クリック率でも計算は同じです。気になるなら「率の差」「率の比」と読み替えて構いません。
図の右パネルがオッズという量の正体です。棒が2本並んでいて、左が「クリックした」、右が「しなかった」。オッズはこの2本の高さの比です。分母が「全体」ではなく「していない人」なので、確率と違って1を超えられます。
第18回でロジスティック回帰をやったときに、係数 に対する がオッズ比になることを確認しました。あの量がここに戻ってきています。
オッズ比だけが特殊な振る舞いをする
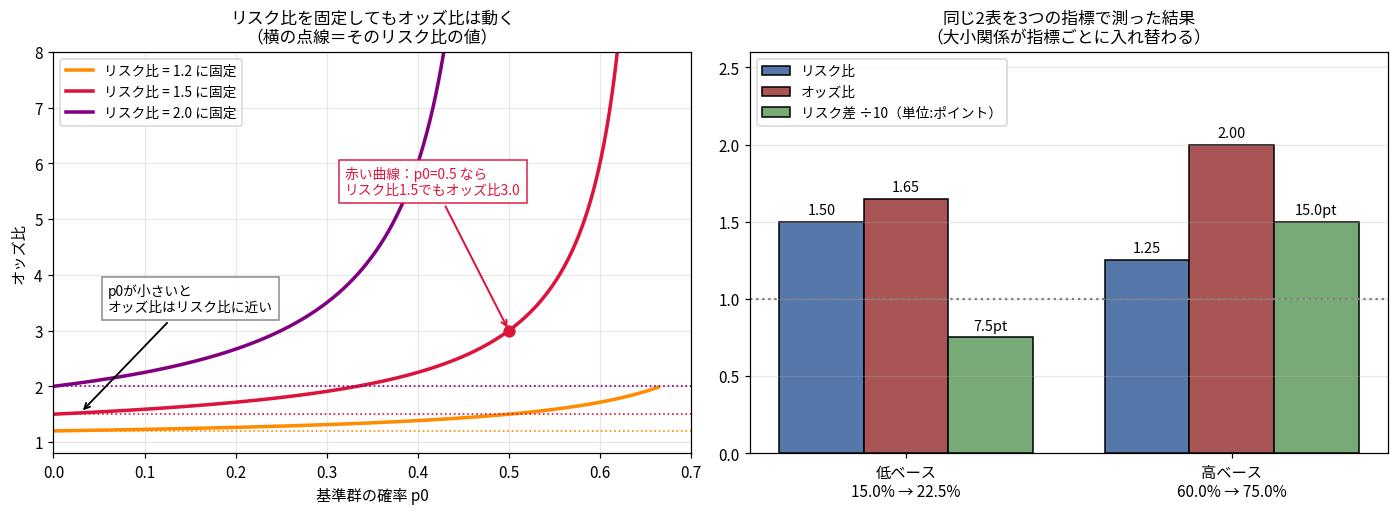
リスク比を1.5に固定したまま、基準確率 だけを動かしてみます。
| リスク比 | オッズ比 | オッズ比 ÷ リスク比 | ||
|---|---|---|---|---|
| 0.005 | 0.0075 | 1.50 | 1.5038 | 1.0025 |
| 0.01 | 0.015 | 1.50 | 1.5076 | 1.0051 |
| 0.05 | 0.075 | 1.50 | 1.5405 | 1.0270 |
| 0.10 | 0.150 | 1.50 | 1.5882 | 1.0588 |
| 0.20 | 0.300 | 1.50 | 1.7143 | 1.1429 |
| 0.40 | 0.600 | 1.50 | 2.2500 | 1.5000 |
| 0.50 | 0.750 | 1.50 | 3.0000 | 2.0000 |
| 0.60 | 0.900 | 1.50 | 6.0000 | 4.0000 |
| 0.66 | 0.990 | 1.50 | 51.0000 | 34.0000 |
リスク比はずっと1.50なのに、オッズ比は1.50から発散まで動きます。「オッズ比が3.0だった」と聞いても、元の確率が分からないとリスク比が1.5なのか3.0なのか判断できません。
理由は式を変形すると見えます。
という水増し係数が掛かっています。 が小さければこの係数は1に近いのでオッズ比とリスク比はほぼ一致し、大きくなると分母 が0に近づいて暴れます。第18回で「両群とも稀であることが条件」と書いた、その条件の正体がこれです。
目安を書くときに一度間違えました。上の表の の行(差 5.88%)を見て「どちらも0.10以下なら6%以内」と書こうとしたのですが、この行の は 0.15 で0.10を超えています。 条件と根拠が噛み合っていませんでした。
正しくは、水増し係数の上限は大きいほうの確率 だけで決まります。
なので なら差は 倍以内。 で11.1%、 で25.0%です(、 ならリスク比100に対してオッズ比111で、実際に11.0%ずれます)。
リスク比を1.5程度に限れば、(したがって )で差は5.88%以内。 が 0.154 を超えると1割、0.20 で14.3%です。効いているのは ではなく の側だという点が要点になります。
結論が逆転する
図の右パネルが実務でいちばん危ないところです。
| 低ベース 15.0%→22.5% | 高ベース 60.0%→75.0% | どちらが大きいか | |
|---|---|---|---|
| リスク差 | ポイント | ポイント | 高ベース |
| リスク比 | 低ベース | ||
| オッズ比 | 高ベース |
リスク比で見ると低ベースの勝ち、オッズ比で見ると高ベースの勝ちです。同じ2つの表なのに、指標を変えると結論がひっくり返ります。
誰かが計算を間違えているわけではありません。3つとも正しい計算です。測っている「差」の定義が違うだけで、第21回の標本調査法で「分散」が2つの別物を指していて混乱した、あれと同じ構造です。ここでは「効果」という言葉が3つの別物を指しています。
では何を報告するか
判断の基準はこうなります。
| 場面 | 報告すべき指標 | 理由 |
|---|---|---|
| 意思決定者に見せる(A/Bテスト・施策の効果) | リスク差 | 単独で意味が確定する。「月1万PVなら750クリック増」と件数に直せる |
| ベースが違う環境に一般化したい | リスク比 | 比のほうが環境をまたいで移りやすいという経験的な前提がある |
| ロジスティック回帰の係数(第18回) | オッズ比 | がそのままオッズ比になる。モデルの内部の量 |
| ケース・コントロール研究 | オッズ比 | リスク比が原理的に計算できない(次節) |
リスク差がいちばん強い理由は、単独で意味が確定することです。 「7.5ポイント上がった」は追加情報なしで件数に変換できます。「1.5倍」も「オッズ比1.645」も、元の確率を添えないと大きさが分かりません。
オッズ比だけが抽出率の影響を受けない
「では実務でオッズ比を使う理由はないのか」と思うところですが、オッズ比でなければならない場面があります。
「クリックした人100人」と「しなかった人100人」をあとから選んで集めて、その人たちがデザインAだったかBだったかを調べる。医学ではこれをケース・コントロール研究と呼びます。過去のデータから遡って調べるときの標準的なやり方です。
この場合、クリック率は計算できません。 「クリックした人を100人」と自分で決めてしまったので、表の中のクリック率50%は自分が作った数字です。
ところがオッズ比だけは、行から計算しても列から計算しても同じ値になります。
真ん中の (たすき掛け)が対称なので、行と列を入れ替えても不変です。
これを数値で確かめました。母集団を全部見える形にしておきます。デザインAは5万人に見せて1500クリック(3.0%)、Bは5万人に見せて3000クリック(6.0%)。真のリスク比は 2.000000、真のオッズ比は 2.0638297872 です。
ここから「クリック者1000人・非クリック者1000人」を抜きます。抽出率はクリック者が 、非クリック者が で、21.2倍も違う率で抜いています。かなり乱暴な操作です。
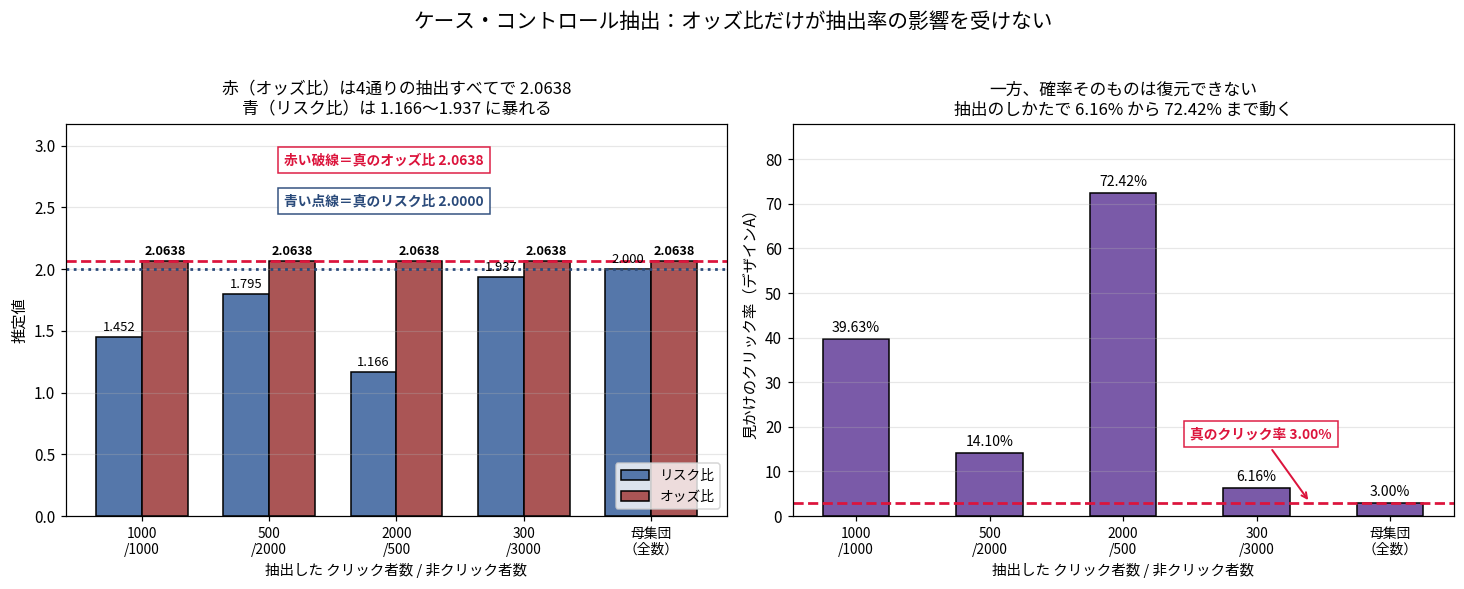
| 抽出した人数 | 見かけのクリック率A | リスク比 | オッズ比 |
|---|---|---|---|
| クリック者1000/非1000 | 0.396266 | 1.451807 | 2.0638297872 |
| クリック者500/非2000 | 0.140959 | 1.794702 | 2.0638297872 |
| クリック者2000/非500 | 0.724171 | 1.165746 | 2.0638297872 |
| クリック者300/非3000 | 0.061593 | 1.936914 | 2.0638297872 |
| 母集団(全数) | 0.030000 | 2.000000 | 2.0638297872 |
オッズ比だけが小数第10位まで一致します。 クリック率は 6.16% から 72.42% まで動き、リスク比は 1.166 から 1.937 まで暴れているのに。
理由は約分です。抽出後の表は という形をしています( がクリック者の抽出率、 が非クリック者の抽出率)。
掛け算と割り算しか使っていないので、列ごとに掛かった定数倍が約分で消えます。
リスク比はそうなりません。
分母に と の足し算が出てくるので、約分できずに残ります。
1行でまとめると「オッズは分母が同じ列の中の相手(しなかった人)なので、列に掛かった定数と一緒に消える」です。確率は分母が行の合計で、そこに と が混ざって入るので消えません。
なお今回の例では真のオッズ比 2.0638 と真のリスク比 2.0000 の差が3%しかありません。クリック率が3%と6%という低ベースだからで、水増し係数が とほぼ1になっています。逆向きにサンプリングしてもオッズ比が取れる → それを低ベースだからリスク比として解釈する、という2段構えで医学統計は回っています。
シンプソンのパラドックス:層別と全体で結論が逆転する
ここで指標の選び方ではどうにもならない問題が出てきます。
先に告白しておくと、この節の数値例を作るのに1回失敗しました。最初に作ったのは「層1ではBが勝ち、層2ではAが勝つ」という表でしたが、これはただのばらつきでパラドックスではありません。条件は厳しくて、すべての層でAが勝ち、なおかつ合計するとBが勝つでなければいけません。
設定
CTAデザインを2種類比較しますが、割り付けが偏っています。デザインAは主に解説記事に出し、Bは主にレビュー記事に出してしまった、という状況です。
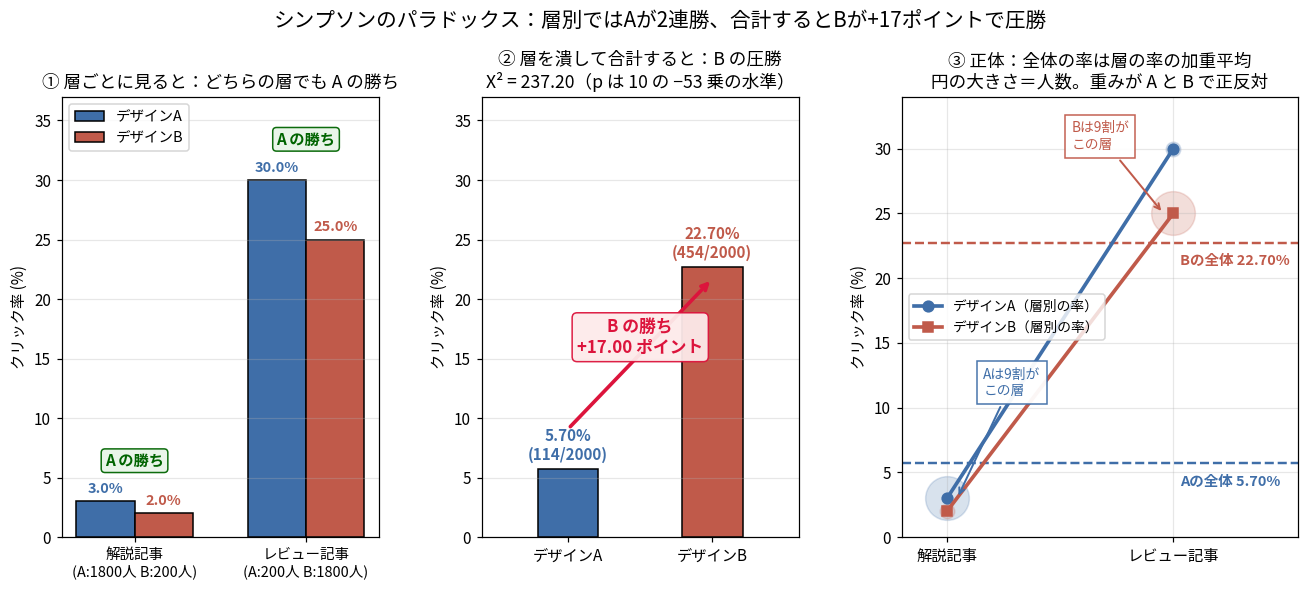
| 層 | Aの結果 | Bの結果 | Aの率 | Bの率 | 勝ち | オッズ比(B対A) | |
|---|---|---|---|---|---|---|---|
| 解説記事 | 54/1800 | 4/200 | 3.00% | 2.00% | A | 0.6599 | 0.6392 |
| レビュー記事 | 60/200 | 450/1800 | 30.00% | 25.00% | A | 0.7778 | 2.3687 |
| 【全体】 | 114/2000 | 454/2000 | 5.70% | 22.70% | B | 4.8583 | 237.2041 |
どちらの層でもAが勝っているのに、合計するとBが17ポイント差で勝ちます。 足し算しかしていないのに結論がひっくり返る。
しかも全体の表で検定すると 、 値は の水準です。極めて有意に「Bが優れている」と出ます。向きは逆なのに。
正体は加重平均
図の右パネルが種明かしです。全体の率は各層の率の加重平均で、その重みがAとBで正反対になっています。
Aは9割が「クリック率2.9%の層」、Bは9割が「25.5%の層」にいます。Aは各層で勝っているのに、負けやすい土俵に9割配置されている。 平均を取ると土俵の差が勝敗の差を上塗りします。
図の右パネルで見るべきは線の傾きではなく円の大きさです。線(層別の率)はAが常に上にあります。円(人数)が逆で、Aの大きい円が左下、Bの大きい円が右上。破線(全体の率)は大きい円のほうに引き寄せられています。
オッズ比でも逃げられない
前の節でオッズ比の不変性を確認したので、「オッズ比なら大丈夫では」と思うかもしれません。だめです。
層別のオッズ比は 0.6599 と 0.7778(どちらも1未満=Aが良い)、全体は 4.8583(1超=Bが良い)。方向が逆転しています。
前節で確認した不変性は「列ごとの定数倍に対する不変性」で、層を潰す操作はまったく別のことです。ここを混同すると危ないので明示しておきます。
直し方は2つ
(1)標準化。 重みを揃えて加重平均を取り直します。両層を50:50にすると、
Aの勝ちに戻ります。 第21回の層別抽出で「重みを設計する」話をしましたが、同じ道具です。
(2)マンテル・ヘンツェル法。 層を通した共通オッズ比を1つの数にまとめます。
層別の 0.6599 と 0.7778 の間にきちんと入ります。 全体の表から出した 4.8583 とは別物です。対応する検定がマンテル・ヘンツェル検定(コクラン・マンテル・ヘンツェル検定とも)で、「各層のズレを足し合わせてから1本のカイ二乗にする」という発想です。層ごとに検定して多重比較するのではなく、層を制御したうえで1本の検定にします。
交絡には2つの条件が同時に必要
「裏側の前提がズレていると駄目」という理解でおおむね合っていますが、条件は2つあって、両方が揃わないと逆転しません。
- 層が群の割り付けと関係している(Aは解説記事に9割)
- 層が結果とも関係している(解説記事はそもそもクリック率が低い)
片方だけなら結論は逆転しません。 記事タイプの構成比が9割対1割に偏っていても、記事タイプによってクリック率が変わらなければ(両層とも3%なら)全体の率は層別の率と一致します。逆に記事タイプでクリック率が大きく違っても、AとBが50:50で均等に割り付けられていれば重みが揃うので、リスク差は層別の値の加重平均になり、勝敗の向きも保たれます(率そのものは平均なので層別の値とは別の数になりますが、AとBで同じ重みを使うのでひっくり返りません)。
ただしオッズ比だけは、均等に割り付けても層別の値と一致しません。 共通の層別オッズ比が でも、層1が 、層2が というベースの違いがあると、50:50で割り付けた合計表のオッズ比は まで縮みます。これはオッズ比の非崩壊性(non-collapsibility)と呼ばれる性質です。率とリスク差は加重平均で保たれるのに、オッズ比は保たれない。
縮むだけで向きは変わりません(20万通りスキャンして は常に の範囲でした)。なので「層別と全体でオッズ比が違う」だけでは交絡があるとは言えません。
逆向きも成り立ちません。「逆転していなければ交絡なし」とも言えず、向きが同じまま値が大きくずれる交絡も作れます(共通オッズ比 2.000 で、層のベースを と 、割り付けを 600:400 と 400:600 にすると合計表は 2.62 になります)。結局、割り付けと結果の両方に矢印が刺さっているかどうかは、データの外側で確認するしかありません。
両方の矢印が刺さっている変数を交絡因子と呼びます。この「両方」という条件があるので、ランダム化すれば1本目の矢印が切れて安全になるという処方が効きます。
これは統計の問題なのか
大事な点なので書いておきます。シンプソンのパラドックスは計算の誤りではありません。 上の表の数字はすべて正しい。
問題はどちらを見るべきかがデータだけでは決まらないことです。「解説記事かレビュー記事か」は、CTAデザインを決める前から存在する読者側の性質です。だからこれで層別するのが正しい。
しかし仮に層別変数が「CTAを見てから起きたこと」(たとえば「ページを最後までスクロールしたか」)だったら、層別するほうが間違いになります。デザインの効果がスクロール率を経由して伝わっているなら、スクロール率で層別するとその経路を潰してしまいます。
「層別すべきか」は因果の順序の問題で、分割表を眺めているだけでは判断できません。 第27回のコラムで「変数を入れれば安全ではない」という話をしましたが、それと同じ問題がここにも出ています。
実務的な処方は単純です。A/Bテストではランダムに割り付ける。 ランダム化すれば期待値として層の構成比が揃うので、この問題が起きません。記事タイプごとに手で振り分けるのではなく、同じ記事内でランダムに出し分けるのが正解です。
マクネマー検定:同じ人を2回測ったとき
ここまでは「1人が表のどこか1箇所に入る」表を扱ってきました。同じ人を2回測る場合は、表の意味が変わります。
同じ100人に旧デザインと新デザインの両方を見せて、それぞれクリックしたかを記録します。
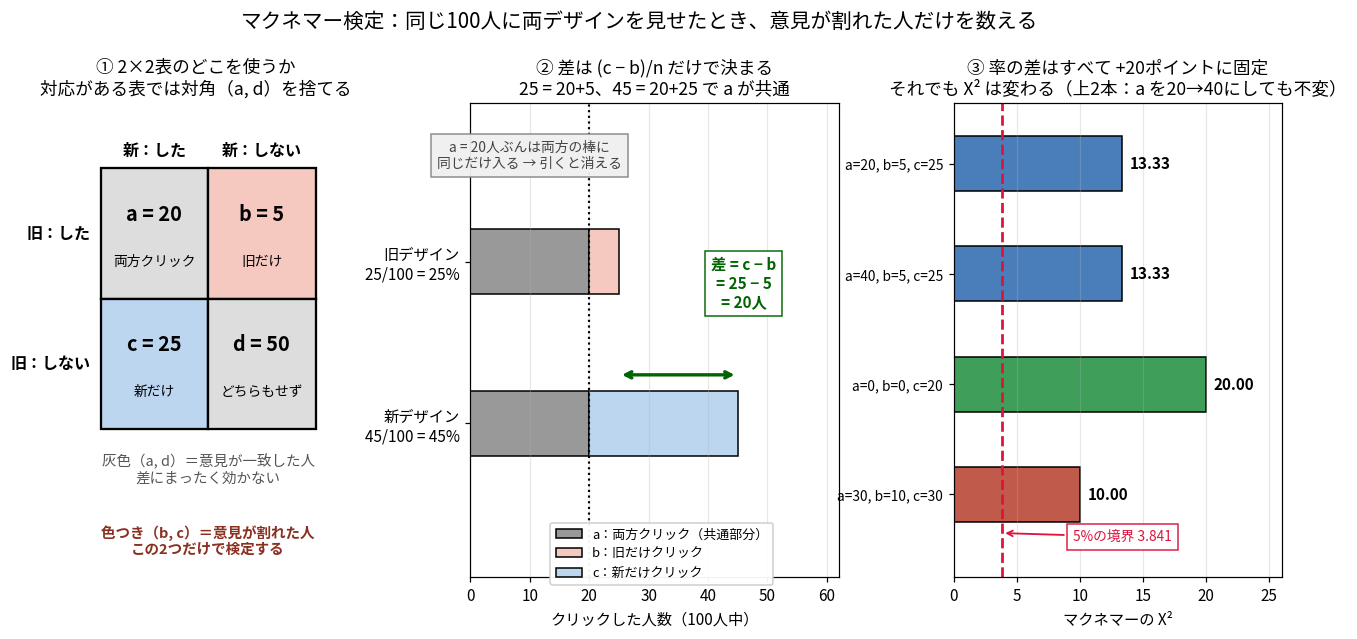
| 新:した | 新:しない | 計 | |
|---|---|---|---|
| 旧:した | 25 | ||
| 旧:しない | 75 | ||
| 計 | 45 | 55 | 100 |
この表は見た目が同じですが、意味がまったく違います。 今までは行が「A群の人/B群の人」で、1人は1つのセルに入りました。今回は行と列が同じ人の2回の回答です。だから合計は200ではなく100になります。
見分け方のルール:1人が表に何回登場するかを数える。1回ならふつうの分割表、2回(同じ人の2つの回答が1つのセルを決める)ならマクネマー。 言い換えると、測定回数が表の合計の2倍ならマクネマー、一致するならふつうの分割表です。上の表は100人×2回=200測定に対して合計100、最初のCTA表は400人×1回=400測定に対して合計400でした。
差はどこから来るのか
旧のクリック率は 、新は 。引き算してみます。
が消えました。 図の中央パネルがこれです。旧の棒は 、新の棒は で、灰色の が共通部分。引き算すると共通部分が消えて、色のついた部分の差だけが残ります。(どちらもクリックしなかった50人)は最初から入っていません。
率の差に効いているのは と だけ。意見が一致した人(両方クリックした20人、両方しなかった50人)は、差について何の情報も持っていません。
だから検定も b と c だけで行う
自由度1で 。
この式の意味はもっと単純です。 意見が割れた人が30人いて、そのうち25人が「新のほうでクリックした」向き。もし2つのデザインに差がないなら、割れた人がどちらに割れるかはコイン投げのはずです。30回投げて25回表が出たら偏っていると言える。
実際に厳密な二項検定(, , , 両側)をやると でした。カイ二乗近似の とよく合っています。
マクネマー検定は「不一致ペアに対する符号検定」で、第15回でやった符号検定と同じ道具です。
対応のあるt検定との比較
| 対応のあるt検定(第13回) | マクネマー検定(今回) | |
|---|---|---|
| データ | 各人の差 | 各人の組(0/0, 0/1, 1/0, 1/1) |
| 捨てるもの | 個人の水準(平均が高い人・低い人) | 一致ペア |
| 効く量 | で標準誤差が縮む | 不一致ペアの数 |
| 元になる検定 | 1標本t検定 | 符号検定(二項検定) |
共通しているのは「個人差を引き算で消す」という発想です。 第13回で「対応のあるt検定の正体は 」という話をしました。相関が高いほど個人差が大きく消えて得をする、という構造です。
違うのは、消え方が離散的なことです。 t検定では差 が連続値なので全員が情報を持ちます。マクネマーでは差が の3値しかなく、 の人(一致ペア)は完全に無情報になって捨てられる。連続の場合の「相関が高いと得」が、離散では「一致ペアが増える」という形で現れます。
数値で確認します。率の差を +20ポイントに固定したまま中身を変えます。
| 旧 | 新 | 差 | 値 | |||||
|---|---|---|---|---|---|---|---|---|
| 20 | 5 | 25 | 50 | 25% | 45% | +20pt | 13.3333 | 0.00026 |
| 40 | 5 | 25 | 30 | 45% | 65% | +20pt | 13.3333 | 0.00026 |
| 0 | 0 | 20 | 80 | 0% | 20% | +20pt | 20.0000 | 0.00001 |
| 30 | 10 | 30 | 30 | 40% | 60% | +20pt | 10.0000 | 0.00157 |
1行目と2行目は を20から40に変えただけで、 が小数第4位まで同一です。一致ペアは検定に一切寄与しません。3行目は不一致が20件しかないのに全部同じ向き()なので と最も強い証拠になります。「20人中20人が新を選んだ」ですから、確かに強い。
誤用するとどうなるか
同じデータを4通りに検定しました。
| 方法 | 値 | 何に答えているか | |
|---|---|---|---|
| マクネマー検定 | 13.3333 | 0.000261 | 率が上がったか(正しい問い) |
| 厳密二項検定 | — | 0.000325 | 同じ問いを厳密に |
| マクネマー+連続性補正 | 12.0333 | 0.000523 | 同じ問い(やや保守的) |
| 独立性の検定(誤用) | 16.4983 | 0.000049 | 別の問い |
| 比率の差の検定(対応を無視) | 8.7912 | 0.003027 | 正しい問いだが検出力を捨てる |
独立性の検定をこの表にかけると 値がもっと小さくなります。 でもこれは良い結果ではありません。答えている問いが違うからです。独立性の検定が聞いているのは「旧でクリックした人は新でもクリックしやすいか」で、これは対角の が大きいかどうかの話。個人の一貫性を測っているだけで、率が上がったかは何も言っていません。
逆に対応を無視して第13回の比率の差の検定をすると が 13.33 から 8.79 に落ちます。結論は変わりませんが、個人差を消す利得を捨てています。
実務での使いどころ
A/Bテストは、ほぼ確実にマクネマーではありません。 訪問者を2群にランダムに分けるので、1人は片方のデザインしか見ません。これは対応のないデータです。
マクネマーが必要になるのは同じ人を2回測るときで、医学では標準的な使いどころが3つあります。
| 場面 | 内容 |
|---|---|
| 診断法の比較 | 同じ患者100人に検査Aと検査Bの両方を実施して、どちらが陽性を拾えるか |
| クロスオーバー試験 | 同じ患者に薬Aを投与し、期間を置いてから薬Bを投与する |
| マッチドペアのケース・コントロール | 患者1人ごとに年齢・性別が同じ健常者を1人選んでペアにする |
3つ目が示しているのは、マクネマーの本質が「同一人物」ではなく「ペアになっていること」だという点です。 ペアを作った理由は問いません。第13回の対応のあるt検定が双子のデータや左右の目のデータに使えるのと同じ構造です。
Web の文脈で言えば、同じ読者にメールの件名AとBを別々の週に送って開封率を比べる、サイト改修の前後で同じ登録ユーザーの行動を比べる、といった場面が該当します。
残差分析:どのセルが原因か
表で有意になったあと、必ず出てくる問題があります。
読者の年代(4段階)× 流入元(4種類)のクロス集計、 で検定すると 、自由度9、。
| 検索 | SNS | 直接 | メール | 計 | |
|---|---|---|---|---|---|
| 20代 | 320 | 210 | 60 | 10 | 600 |
| 30代 | 540 | 150 | 180 | 30 | 900 |
| 40代 | 430 | 60 | 210 | 100 | 800 |
| 50代以上 | 210 | 20 | 100 | 110 | 440 |
| 計 | 1500 | 440 | 550 | 250 | 2740 |
「年代と流入元は独立ではない」。これで終わりでは何の役にも立ちません。 16個の数字のどこが変なのかを知りたい。第20回で分散分析のあとに多重比較をした、あの流れと同じ構造です。
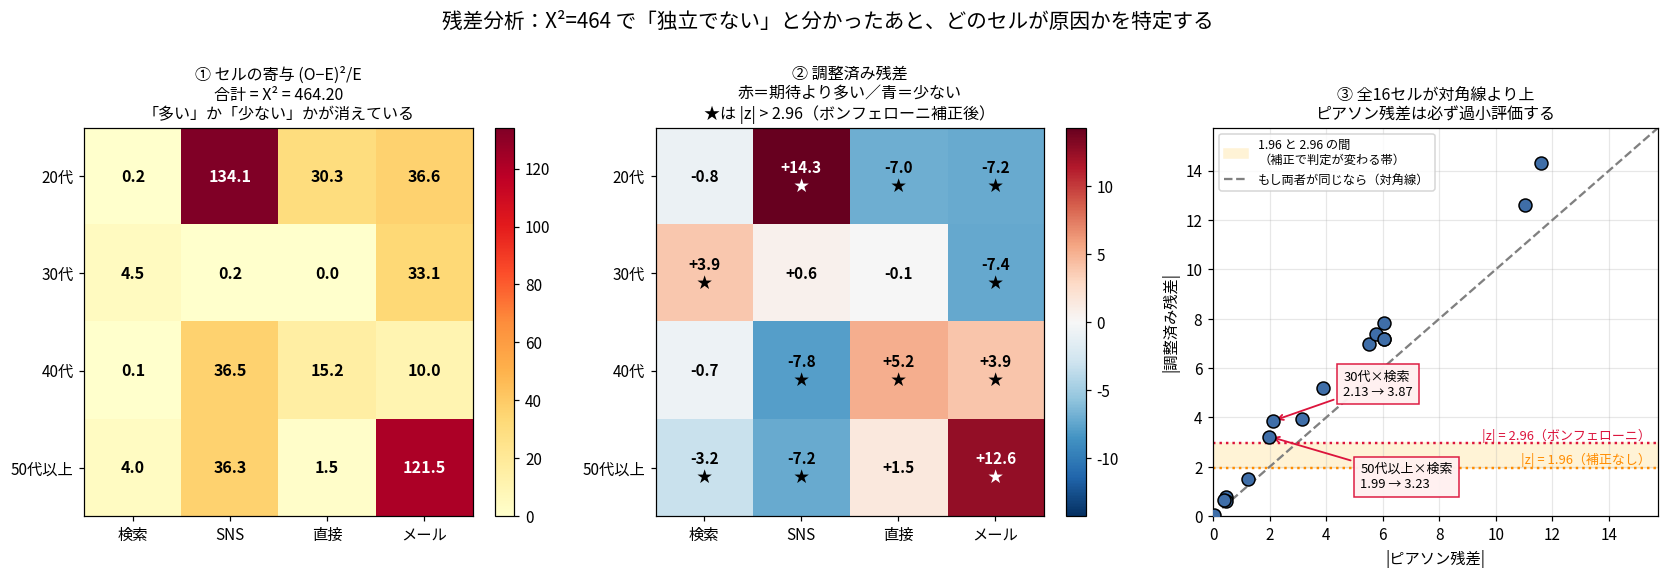
素朴な方法:セルの寄与を見る
は16個の項の和なので、各項を見れば大きいところが分かります。
| 検索 | SNS | 直接 | メール | |
|---|---|---|---|---|
| 20代 | 0.2 | 134.1 | 30.3 | 36.6 |
| 30代 | 4.5 | 0.2 | 0.0 | 33.1 |
| 40代 | 0.1 | 36.5 | 15.2 | 10.0 |
| 50代以上 | 4.0 | 36.3 | 1.5 | 121.5 |
丸めずに足すと 464.2004 で に一致します(表示は小数第1位に丸めているので、見えている数字を足すと 464.1 になります)。20代×SNS と 50代以上×メールが突出しています。
しかしこれには欠陥があります。2乗しているので全部正の値になり、「期待より多い」のか「少ない」のかが消えています。
ピアソン残差:符号を残す
2乗する前の形を見ます。
これをピアソン残差と呼びます。2乗すると寄与になるので が成り立ちます(実測 464.2004 で一致)。符号が残るので、20代×SNS は で「期待より多い」と読めます。
調整済み残差:これが正しい道具
正しい標準化はこうなります。
が行の周辺確率、 が列の周辺確率。これを調整済み残差(または標準化残差)と呼び、帰無仮説のもとで近似的に標準正規分布に従います。なぜこの形なのかは次の節でシミュレーションで確かめます。
分母に という1未満の数が入っているので、この平方根で割ると必ず絶対値が大きくなります。図の右パネルで全16点が対角線より上にあるのがこれです。
倍率は で、実測では 1.145〜1.814 の範囲でした。
| セル | ピアソン残差 | 調整済み残差 | 倍率 | |
|---|---|---|---|---|
| 30代 × 検索 | 0.3039 | 1.814 | ||
| 40代 × 検索 | 0.3204 | 1.767 | ||
| 50代以上 × 検索 | 0.3799 | 1.622 | ||
| 20代 × SNS | 0.6556 | 1.235 | ||
| 50代以上 × メール | 0.7628 | 1.145 |
検索の列で倍率が最大です。 検索は周辺確率が と大きいので が小さく、補正が強く効きます。メールの列は なので でほぼ補正なし。
「よく使われる行・列に属するセルほど強く割り戻す」ということです。第17回のてこ比と同じ発想で、周辺で大きな影響力を持っている場所はそのぶん割り引いて評価します。
判定が変わるセルが実際にありました。50代以上×検索はピアソン残差 で をぎりぎり超えるかどうかという値ですが、調整済み残差では で明確に有意です。ピアソン残差で判断すると「微妙」で済ませてしまう場所が、正しくは明確に有意でした。
全16セルの結果
| セル | O | E | 寄与 | ピアソン残差 | 調整済み残差 |
|---|---|---|---|---|---|
| 20代 × SNS | 210 | 96.35 | 134.06 | ||
| 50代以上 × メール | 110 | 40.15 | 121.55 | ||
| 40代 × SNS | 60 | 128.47 | 36.49 | ||
| 30代 × メール | 30 | 82.12 | 33.08 | ||
| 50代以上 × SNS | 20 | 70.66 | 36.32 | ||
| 20代 × メール | 10 | 54.74 | 36.57 | ||
| 20代 × 直接 | 60 | 120.44 | 30.33 | ||
| 40代 × 直接 | 210 | 160.58 | 15.21 | ||
| 40代 × メール | 100 | 72.99 | 9.99 | ||
| 30代 × 検索 | 540 | 492.70 | 4.54 | ||
| 50代以上 × 検索 | 210 | 240.88 | 3.96 | ||
| 50代以上 × 直接 | 100 | 88.32 | 1.54 | ||
| 20代 × 検索 | 320 | 328.47 | 0.22 | ||
| 40代 × 検索 | 430 | 437.96 | 0.14 | ||
| 30代 × SNS | 150 | 144.53 | 0.21 | ||
| 30代 × 直接 | 180 | 180.66 | 0.00 |
太字が (後述のボンフェローニ補正後)で有意なセルです。読み取れることを並べます。
| 発見 | 根拠 |
|---|---|
| 20代はSNSから来る | 調整済み残差 (期待96人に対し210人)。表全体で最も強い |
| 50代以上はメールから来る | (期待40人に対し110人) |
| SNSは年代とともに単調に減る | 行内シェアが |
| メールは年代とともに単調に増える | 行内シェアが |
| 検索は表全体への貢献は小さいが、無関係ではない | 寄与の合計は8.9(全体464のうち1.9%)。ただし調整済み残差では 30代 ・50代以上 が有意 |
で独立でない、というだけの情報から、ここまで具体的な話に落ちました。 実務ではこの表を見て「20代向けの記事はSNSでの拡散を意識する、50代以上向けはメルマガに載せる」という判断になります。
この表を作るときに1つ間違えました。最初は単調性の根拠として調整済み残差を並べていました(SNSなら )。ところがこれは単調ではありません。最後の段で と増えています。メールも最初の段が で減っている。
残差は行の にも依存するので、単調性を見る量ではありませんでした。 50代以上は と小さいので残差が伸びません。単調性を見たいなら行内シェア(その年代の中で何%がその流入元か)を使うのが正しく、そちらは実際に単調です。
もうひとつ注意しておくと、「単調に減る/増える」というパターンはカイ二乗検定自体はまったく見ていません。 カイ二乗検定は行と列の順序を無視するので、行を入れ替えても同じ値になります。順序に意味があるカテゴリなら、傾向を直接検定する方法のほうが検出力が高くなります( 表ならコクラン・アーミテージ傾向検定、この例のような 表なら後で触れる線形連関モデルによる自由度1の検定)。ただし得をするのは割り当てたスコアの方向に実際の傾向があるときだけで、傾向がU字型なら自由度1に絞ったぶん損をします。
つまずいた3つの疑問
ここまでの説明を読んでいて、自分の中から3つの疑問が出てきました。3つとも「数え上げの標準偏差とは何か」という同じ場所に収束していて、教科書だと式だけ書いてあって理由が書かれていない箇所です。順に潰していきます。
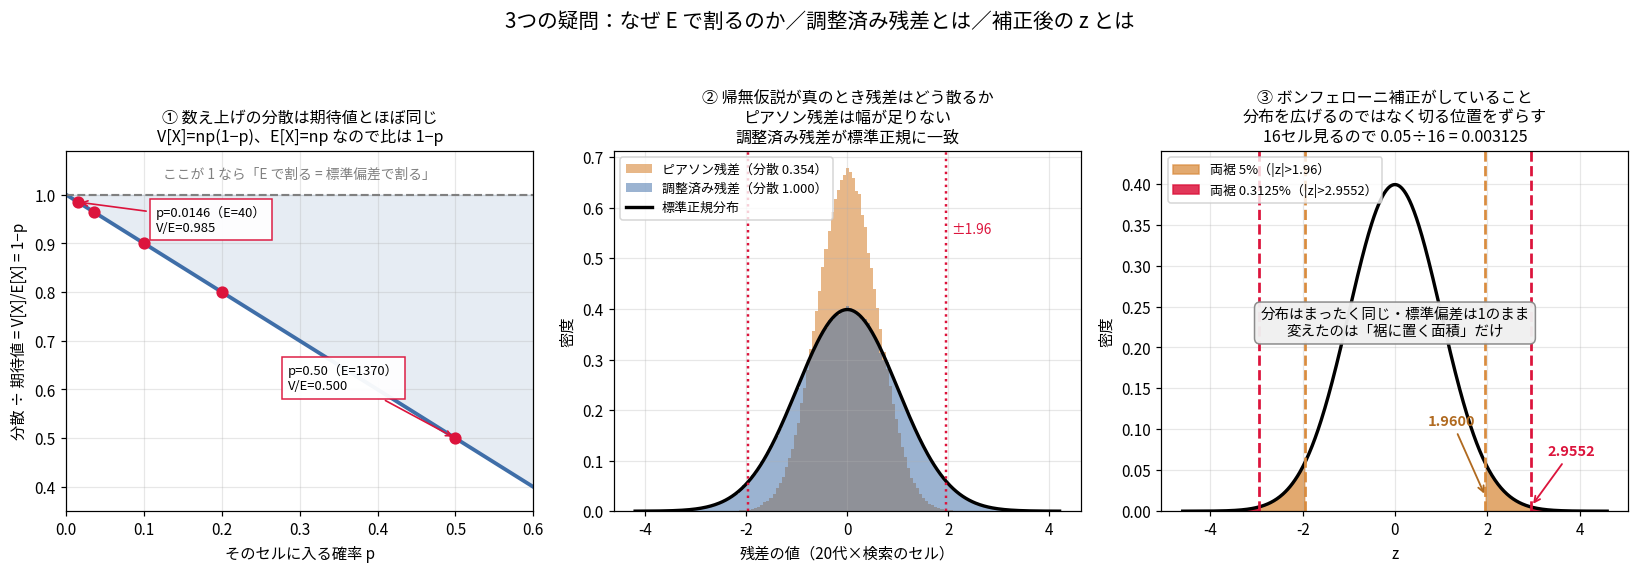
疑問1:なぜ期待値で割るのか。標準偏差で割りたくなる
という式を見ると、分母が標準偏差ではないので落ち着きません。 スコアなら標準偏差で割るはずです。
答え:実際に標準偏差で割っています。 が標準偏差です。
セルに入る人数を考えます。 人それぞれが確率 でそのセルに入るので、人数は二項分布に従います。
が小さければ なので、。分散と期待値が一致します。
だから標準偏差は で、 はズレを標準偏差で割った形そのものです。
「数え上げでは分散が期待値と等しい」は第5回でポアソン分布の性質として出てきました。二項分布で が小さいときポアソン分布に近づくので、同じ話です。
実測で確かめます。
| 実測(40万回) | |||||
|---|---|---|---|---|---|
| 2740 | 0.0146 | 40.00 | 39.42 | 39.42 | 0.9855 |
| 2740 | 0.0352 | 96.45 | 93.05 | 92.96 | 0.9638 |
| 2740 | 0.10 | 274.00 | 246.60 | 246.61 | 0.9000 |
| 2740 | 0.20 | 548.00 | 438.40 | 438.58 | 0.8003 |
| 2740 | 0.50 | 1370.00 | 685.00 | 684.67 | 0.4998 |
図の左パネルがこの表を絵にしたもので、比はちょうど の直線になります。
ただし では で、まったく一致していません。 で割るのは過大な標準偏差で割っていることになり、残差が小さめに出ます。この「 のずれ」が、次の疑問の答えの一部になります。
疑問2:調整済み残差とは何なのか
ピアソン残差は「寄与のルートを取って符号を付けたもの」で理解できます。では調整済み残差の はどこから来たのか。
答え:周辺合計を推定に使ったせいで縮んだ分散を、正しく割り戻したものです。
問題はピアソン残差の分散が1になっていないことです。「標準正規に従うから で切る」と言いたいのに、実際の分散が1未満なんです。
理由が2段階あります。帰無仮説(独立)が真の4×4表を12万個生成して、 の分散を実測しました。
(1段目) が0でないぶん縮む。 疑問1で見た です。期待度数を真の値で固定した場合、分散は になります。
| セル | の実測分散 | 実測 ÷ | |
|---|---|---|---|
| 20代 × 検索 | 289.34 | 328.47 | 0.8809 |
| 20代 × SNS | 93.46 | 96.35 | 0.9700 |
| 50代以上 × メール | 39.41 | 40.15 | 0.9816 |
20代×検索なら に対して実測 289.34 で一致します。
(2段目)周辺合計を推定に使ったぶん、さらに縮む。 ここが本題です。
実際にやっているのは「期待度数をその表の周辺合計から作る」ことでした。すでに見たように、期待度数の行合計・列合計は観測値と完全に一致します。ということは は「行ごとに足して0、列ごとに足して0」という制約に縛られている。自由に動けないので散らばりが小さくなります。
| セル | の実測分散 | 実測 ÷ | 実測 ÷ その値 | ||
|---|---|---|---|---|---|
| 20代 × 検索 | 116.13 | 328.47 | 0.3536 | 116.10 | 1.0003 |
| 20代 × SNS | 63.54 | 96.35 | 0.6594 | 63.17 | 1.0059 |
| 20代 × メール | 38.95 | 54.74 | 0.7115 | 38.86 | 1.0024 |
| 30代 × 検索 | 149.19 | 492.70 | 0.3028 | 149.73 | 0.9963 |
| 40代 × 直接 | 90.75 | 160.58 | 0.5652 | 90.88 | 0.9987 |
| 50代以上 × メール | 30.54 | 40.15 | 0.7607 | 30.62 | 0.9973 |
でぴったり一致します。 だからこれで割るのが正しい標準化です。
厳密さについて補足しておくと、この式は行合計を固定した場合には厳密で、総計だけを固定した場合は 倍になります( から まで小さい表を完全列挙して確認しました。 で比がちょうど )。今回は なので で、シミュレーションでは見えない差です。「漸近的に正しい」が正確な言い方になります。
もう1つ面白い点があります。この分母は期待度数と周辺確率の両方を「その表から推定した値」にして初めて標準正規になります。
| 分子と分母の作り方 | 残差の分散 | の割合 |
|---|---|---|
| 真の期待度数と真の周辺確率を使う | 1.7840 | 0.1407 |
| その表から推定した値を使う(正しい方法) | 1.0019 | 0.0502 |
真の値を使うと分散が1.78まで膨らみ、5%のはずの判定が14%になります。「周辺合計を推定に使ったから縮む」という説明が、この対比でそのまま実証できます。 推定した期待度数を使うと 自体が小さくなり、それに合わせて分母も小さくしているので、両方が釣り合って1になる、という構造です。
標準化した結果を確認します。
| ピアソン残差の分散 | 調整済み残差の分散 | |
|---|---|---|
| 20代 × 検索 | 0.3536 | 1.0003 |
| 30代 × 検索 | 0.3040 | 1.0004 |
| 50代以上 × メール | 0.7628 | 0.9999 |
| 16セルの平均 | 0.5625 | 1.0000 |
| 16セルの最小/最大 | 0.304 / 0.763 | 0.997 / 1.002 |
図の中央パネルがこれを絵にしたものです。オレンジ(ピアソン残差)は幅が足りず、青(調整済み残差)が黒い標準正規曲線に重なっています。
なぜ自由度の話と似ているのか。 第14回で「パラメータを推定すると自由度が減る」と学びました。あれと同じ現象を、表全体ではなくセル1個ずつで見ているのが調整済み残差です。 推定に使ったぶん動ける範囲が減る、という同じ理屈が、片方では自由度の減少、もう片方では分散の縮小として現れます。
疑問3:補正後の z とは何か
という閾値が出てきたとき、「標準正規分布に標準偏差をかけて範囲を広げているのか」と考えました。
答え:違います。分布はまったく動かしていません。標準正規分布のまま、切る位置だけを外側にずらしています。
図の右パネルがそれです。黒い曲線は1本だけ。オレンジの塗りが「両裾に5%」、赤の塗りが「両裾に0.3125%」。同じ分布の、どこで切るかを変えただけで、標準偏差は1のままです。
| 両側の水準 | 閾値 | 意味 |
|---|---|---|
| 0.050000 | 1.9600 | 1個だけ見るとき |
| 0.025000 | 2.2414 | 2個見るとき |
| 0.006250 | 2.7344 | 8個見るとき |
| 0.003125 | 2.9552 | 16個見るとき(今回) |
| 0.000500 | 3.4808 | 100個見るとき |
なぜずらすか。16回検定すると、どれか1つが偶然5%を切る確率が上がります。
| やること | 誤検出する割合(実測200万回) | 狙い |
|---|---|---|
| 1個だけ見て | 0.0500 | 5%(正しい) |
| 16個見てどれかが | 0.4741 | 5%のつもりが47% |
| 16個見てどれかが | 0.0449 | 5%以下(補正が効いている) |
ここで一度間違えました。 最初に「独立な16個なら だから実測もそうなるはず」と考え、実際に独立な標準正規16個でシミュレーションして 0.5610 という数字を出しました。しかし調整済み残差はセル間で独立ではありません。 周辺合計を共有しているので、あるセルが期待より多ければ同じ行の別のセルは少なくなります。実測した16セルの相関は平均 、最小 、 の組が120組中28組ありました。
負の相関があるぶん「どれか1つでも超える」確率は独立の場合より小さくなります(0.4741 < 0.5599)。ボンフェローニ補正は独立性を仮定しない不等式なので、この相関があっても水準を超えない側に働きます(実測 0.0449 で5%以下)。5%を使い切れていないのは、補正が保守的であることの実演です。
やっていることは単純で、 を で割って各セルに配分する。全部足して に収まるので、「どこか1つでも誤検出する確率」が5%以下に抑えられます(ボンフェローニの不等式)。第12回・第20回で多重比較としてやったのと同じ道具です。
今回のデータでは補正しても結論が変わりませんでした( で有意な11セルが でも全部有意)。効果が大きいデータなので余裕があったためです。
3つの疑問の関係
| 疑問 | 答え | 効いている量 |
|---|---|---|
| なぜ で割る | 標準偏差で割っている( だから) | |
| 調整済み残差とは | 周辺推定で縮んだ分散を割り戻す | |
| 補正後の とは | 分布は同じ、切る位置をずらす | 水準を で割る |
疑問1と疑問2は「正しい標準偏差は何か」という同じ問いで、答えが2段階になっているだけでした。疑問3だけが別問題(何回見るか)です。
フィッシャーの正確検定
小さい表では、カイ二乗近似が使えません。ここで登場するのがフィッシャーの正確検定です。
CTAデザインを各12人に見せて、A は2人、B は7人がクリックしたとします。期待度数の最小は 4.5 で、よく言われる「5未満」の目安に引っかかります。
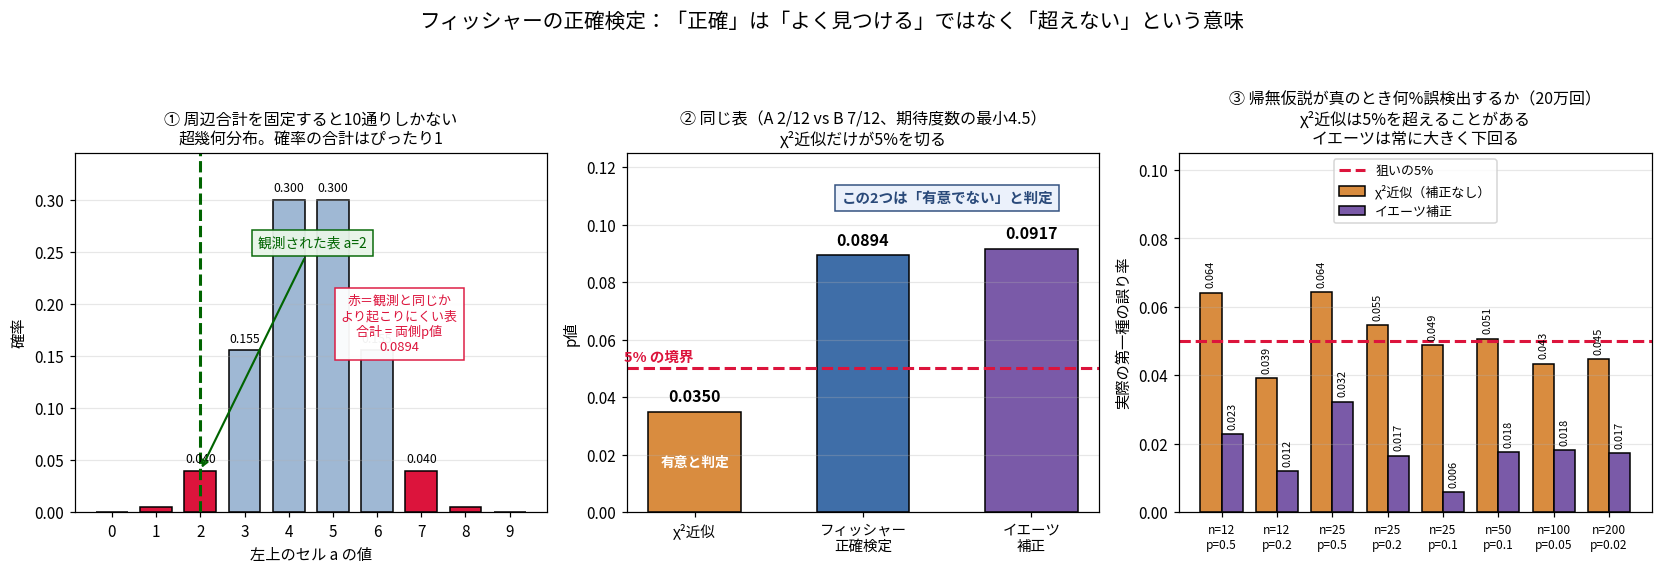
周辺合計を両方固定すると、表は数えられる
行合計が (12, 12)、列合計が (9, 15) で固定されているので、左上のセル を決めれば残り3つが引き算で決まります(自由度1がここでも効いています)。 は 0〜9 の10通りしかありません。
| 表の中身 | 確率 | 観測以下か | |
|---|---|---|---|
| 0 | [0, 12 / 9, 3] | 0.000168 | ○ |
| 1 | [1, 11 / 8, 4] | 0.004543 | ○ |
| 2(観測) | [2, 10 / 7, 5] | 0.039978 | ○ |
| 3 | [3, 9 / 6, 6] | 0.155472 | — |
| 4 | [4, 8 / 5, 7] | 0.299838 | — |
| 5 | [5, 7 / 4, 8] | 0.299838 | — |
| 6 | [6, 6 / 3, 9] | 0.155472 | — |
| 7 | [7, 5 / 2, 10] | 0.039978 | ○ |
| 8 | [8, 4 / 1, 11] | 0.004543 | ○ |
| 9 | [9, 3 / 0, 12] | 0.000168 | ○ |
| 合計 | 1.000000 | 両側 = 0.089379 |
確率がぴったり1になります。全パターンを尽くしたので近似がどこにもありません。これが「正確」の意味です。
この確率分布は超幾何分布です。第5回でやった「壺から玉を取り出す」構造で、「24人のうちクリックした9人を選ぶとき、A群の12人から何人選ばれるか」に対応します。
両側 値は「観測と同じか、より起こりにくい表」の確率を全部足して 。片側( が2以下)なら です。
なお両側 値の作り方には流儀があります。上のやり方は点確率法(観測の確率以下の確率を持つ表を全部足す)で、R の fisher.test の既定です。ほかに「片側を2倍する」「中央法」があり、この例は分布が対称なので3つとも一致しますが、非対称な表では値が変わります。
ここで前に保留した「周辺合計を固定する3つの意味」が効いてきます。 フィッシャーの正確検定は両方固定の立場を取ります。総計しか固定していないデータに対しても両方固定して計算するので、条件付きにすると情報を捨てているという批判があります。試験対策としては「両方固定して超幾何分布で数える」で十分です。
3つの方法を比べる
| 方法 | 値 | 5%で判定 | |
|---|---|---|---|
| χ²近似(補正なし) | 4.4444 | 0.035015 | 有意 |
| フィッシャーの正確検定 | — | 0.089379 | 有意でない |
| イエーツ補正 | 2.8444 | 0.091690 | 有意でない |
χ²近似だけが5%を切ります。 本当は有意でないものを有意と判定している。 では近似が甘い方向に外れました。
「期待度数5以上」は近似の質を保証していない
第14回で「期待度数5以上という目安は思うより緩い」と学んだので、「5未満ならフィッシャー」という目安と矛盾しないか気になりました。実際の第一種の誤り率を8つの設定で測りました。
| 各群の | 期待度数の最小 | χ²近似の実サイズ | イエーツの実サイズ | |
|---|---|---|---|---|
| 12 | 0.50 | 6.0 | 0.0641 | 0.0228 |
| 12 | 0.20 | 2.4 | 0.0391 | 0.0120 |
| 25 | 0.50 | 12.5 | 0.0643 | 0.0323 |
| 25 | 0.20 | 5.0 | 0.0547 | 0.0165 |
| 25 | 0.10 | 2.5 | 0.0488 | 0.0059 |
| 50 | 0.10 | 5.0 | 0.0506 | 0.0176 |
| 100 | 0.05 | 5.0 | 0.0434 | 0.0181 |
| 200 | 0.02 | 4.0 | 0.0447 | 0.0172 |
この表でいちばん面白いのは、期待度数が12.5もあるのにχ²近似の実サイズが 0.0643 になっている行(, )です。 逆に期待度数が2.4しかない行(, )は 0.0391 で5%を下回っています。
順番がむしろ逆になっています。「期待度数5以上」は近似の質をまったく保証していません。
効いているのは期待度数ではなく離散性です。第14回で「 が26個の値しか取れないので階段が5%をまたげない」という話をしました。 付近では の取れる値が粗くなり、階段が5%を上側にまたぎます。 が小さいと下側にまたぐ。
つまり第14回の結論と今回の目安は矛盾していません。どちらも「5」という粗い代理指標を使っているだけで、本当の問題は が取れる値の粗さです。 「5未満ならフィッシャー」は実務のルールとしては安全側に倒れるので機能しますが、「5以上なら安全」は成り立ちません。
イエーツの連続性補正とは何か
上の表でイエーツ補正が一貫して保守的なことが見えたので、この補正が何をしているのかを確かめました。先に既習の話から入ります。
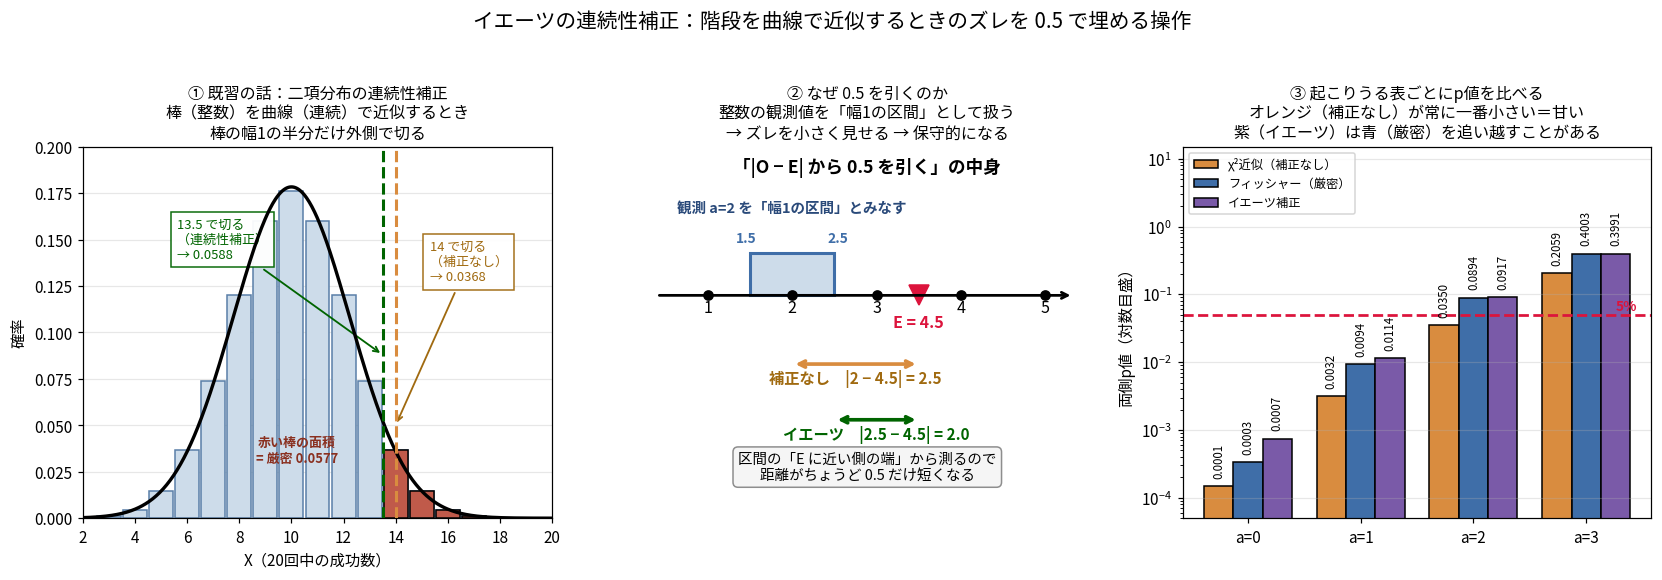
二項分布を正規分布で近似するとき
二項分布 で を求めたいとします。平均 、標準偏差 で正規近似します。
| 方法 | 値 | 厳密との誤差 |
|---|---|---|
| 厳密(二項分布で直接計算) | 0.057659 | — |
| 正規近似( で切る) | 0.036819 | 0.020840 |
| 正規近似( で切る) | 0.058762 | 0.001103 |
で切ると誤差が約19分の1になります。
図の左パネルがその理由です。二項分布は棒(整数の値だけ)、正規分布は曲線(連続)。棒には幅があって、 の棒は「 から 」の範囲を占めています。だから の面積を曲線で測るなら から積分するべきです。
これが連続性補正です。「離散を連続で近似するとき半個ぶんずらす」という一般的な技法で、第8回の中心極限定理でも出てくる話です。
イエーツ補正は同じことを2×2表でやっている
統計量も同じ問題を抱えています。セルの人数は整数しか取れない(さっきの例では が10通り)のに、カイ二乗分布は連続です。
図の中央パネルがイエーツ補正の中身です。観測値 を「 から の区間」とみなします。期待値は 。
- 補正なし:
- イエーツ:区間の に近い側の端 から測って
距離がちょうど 短くなります。 これが「 から を引く」の意味です。
実際の計算を見ます。
| クリック | しない | |
|---|---|---|
| 観測 O(A行) | 2 | 10 |
| 観測 O(B行) | 7 | 5 |
| 期待 E(A行) | 4.5 | 7.5 |
| 期待 E(B行) | 4.5 | 7.5 |
| 2.0 | 2.0 |
4セルすべて で同じです(自由度1の市松模様。最初の図で見たものと同じ構造)。全部から を引くので、統計量は 倍になります。実測 で一致します。
のとき、方向は必ず「小さくする」です。 ズレを小さく見せるので が下がり、 値が上がるので保守的になります。
( が 未満だと引き算の中身が負になり、さらに 未満だと補正後の が補正前より大きくなります(差はちょうど )。 の2×2表(周辺合計が0でないもの)を総当たりすると、前者は4090通り、後者は1878通りありました。実装では 0 で打ち切るのが普通です。)
なぜ2×2表だとうまくいかないのか
二項分布では が見事に効いたのに、2×2表では行き過ぎます。理由が2つあります。
(1)相手が正規分布ではない。 2×2表で周辺合計を固定したときの厳密な分布は超幾何分布で、正規分布より裾が短い。 という値は正規近似に合わせて導かれたもので、超幾何分布には最適化されていません。
(2)階段の幅が一定でない。 の値は で となります。つまり階段1段ぶんの増分が とどんどん広がる。一律に 引くのは、狭いところでは足りず、広いところでは行き過ぎます。
起こりうる表ごとに比べるとこうなります。
| χ²近似 | フィッシャー(厳密) | イエーツ | イエーツは厳密より | |
|---|---|---|---|---|
| 0 | 0.000148 | 0.000337 | 0.000743 | 大きい(保守的) |
| 1 | 0.003163 | 0.009423 | 0.011412 | 大きい(保守的) |
| 2 | 0.035015 | 0.089379 | 0.091690 | 大きい(保守的) |
| 3 | 0.205903 | 0.400323 | 0.399075 | わずかに小さい |
χ²近似はすべての行で厳密より小さい(甘い)。イエーツはそれを直そうとして、 では厳密を追い越してしまっています。
結論:使わない
| 項目 | 内容 |
|---|---|
| 何をする操作か | から を引く |
| どこに使うか | 2×2表(自由度1)のみ |
| 元になった発想 | 離散を連続で近似するときの連続性補正 |
| の由来 | 整数の観測値を「幅1の区間」とみなし、その半分 |
| 効果の方向 | なら必ず が下がる=保守的になる(0.5未満は0で打ち切る) |
| 現代の評価 | 推奨されない。 小標本ならフィッシャーの正確検定を使う |
| 試験対策 | 定義と「保守的になる」「2×2のみ」を覚える |
実サイズの表を見れば分かります。イエーツの実サイズは 0.006〜0.032 で、常に5%を大きく下回っています。 5%使えるところを1〜3%しか使っておらず、そのぶん検出力を捨てています。
イエーツ補正が教科書に載っているのは歴史的な理由(計算機がない時代の工夫)です。 離散性による損失を減らしたいなら mid-p値(境界の確率を半分だけ数える方法)という処方があり、第14回で触れています。
対数線形モデル:分割表を回帰として書き直す
この章の最後の話題です。深追いはしませんが、位置づけを押さえておきます。
セル度数の対数を、足し算に分解するモデルです。
最初のCTA表(A 30/200 vs B 45/200)で実際に分解しました。参照セル方式(行1・列1を基準)で計算します。
| 項 | 計算 | 値 |
|---|---|---|
| 切片 | 3.401197 | |
| 行効果 | 0.405465 | |
| 列効果 | 1.734601 | |
| 交互作用 |
復元すると元の表に完全に一致します(飽和モデルなので当然)。そして 、オッズ比の逆数が 。
交互作用項はオッズ比の対数そのものでした(符号は基準の取り方によります)。
さらに、 と置いたモデルの最尤推定が になります。 つまり、
独立性の検定が「交互作用の有無の検定」に読み替わりました。第20回で分散分析の交互作用を扱いましたが、あれと同じ言葉で分割表を扱えるようになるのがこのモデルの値打ちです。
なぜ対数を取るかというと、度数は掛け算の構造()を持っているので、対数を取ると足し算になるからです。第18回の一般化線形モデルの枠組みで言えば、ポアソン回帰でリンク関数が対数という位置づけになり、実際そうやって推定します。
検定統計量は G²
対数線形モデルでは ではなく (尤度比統計量)を使うのが標準です。
| 表 | 差 | 最小の期待度数 | ||
|---|---|---|---|---|
| CTA 2×2 | 3.6923 | 3.7129 | 37.50 | |
| 年代×流入元 4×4 | 464.2004 | 448.3334 | 40.15 | |
| 小さい表 2×2 | 4.4444 | 4.6409 | 4.50 |
期待度数が十分あればほぼ一致します。どちらも同じ自由度のカイ二乗分布に漸近する(第14回のウィルクスの定理)。 を使う理由はモデル同士の比較ができることで、入れ子になったモデルの の差がそのまま尤度比検定になります。
3元以上ではモデル選択になる
ここが対数線形モデルの本領です。3元表では「独立」の言い方が何通りもあります。
変数の番号は 1 = 層(記事タイプ)、2 = デザイン、3 = クリック です。
| 記法 | 意味 | 解釈 |
|---|---|---|
| (1, 2, 3) | 3つとも独立 | すべて無関係 |
| (12, 3) | クリックが他の2つと独立 | デザインを変えても動かない |
| (12, 13) | デザインとクリックが層のもとで独立 | シンプソンの節で検定したかった仮説 |
| (12, 13, 23) | 2元交互作用のみ・3元交互作用なし | 層によらず共通のオッズ比 |
| (123) | 飽和モデル | 層ごとにオッズ比が違ってよい |
シンプソンの例で確認しました。層ごとのオッズ比は 0.6599( で 、標準誤差 0.5236)と 0.7778( で 、標準誤差 0.1636)。差の検定は 、 で均一性を棄却しません。だから (12, 13, 23) で足ります。
このモデルの共通オッズ比を実際に推定してみると、マンテル・ヘンツェルとは別の推定量ですが、ほぼ同じ値になります。
| 推定量 | 値 |
|---|---|
| マンテル・ヘンツェル | 0.7642 |
| (12, 13, 23) モデルの最尤推定 | 0.7659 |
| ウルフ( オッズ比の逆分散加重) | 0.7665 |
3つとも層別の 0.6599 と 0.7778 の間に入り、全体の表から出した 4.8583 とはまったく別の水準です。
いつ使うのか
独立性の検定で足りる場面では使いません。 使うのは次の3つです。
| 場面 | 理由 |
|---|---|
| 3元以上で「どういう独立か」を選び分けたい | カイ二乗検定には5通りを言い分ける言葉がない。変数が4つ5つになると手に負えない |
| 順序や構造を係数に埋め込みたい | カイ二乗検定は行と列の順序を無視する。 とすれば自由度9の検定が自由度1になり検出力が上がる(線形連関モデル) |
| 度数そのものを予測したい | カイ二乗検定は「独立か否か」のyes/noしか返さない |
ただし実務では同じことをロジスティック回帰でやるほうが普通です。 これは偶然ではなく、分割表に対する対数線形モデルと、それをロジスティック回帰で書いたものは数学的に等価です。クリックを0/1の目的変数、年代と流入元を説明変数にしてロジスティック回帰を回せば、対数線形モデルの交互作用項と同じ情報が係数として出てきます。
ただし条件があります。等価になるのは、説明変数どうしの交互作用項をすべて含めたときだけです。説明変数どうしの項(残差分析の例なら 年代×流入元、上の3元表なら 層×デザイン に当たる項)を含む階層モデルが、ロジスティック回帰に対応します。これを入れないモデルは「年代と流入元が独立」という余分な仮定を置いた別のモデルになります。
| 対数線形モデル | ロジスティック回帰 | |
|---|---|---|
| 見ているもの | セルの度数 | 特定の変数が起きる確率 |
| 変数の役割 | 全部対等 | 目的変数と説明変数を区別 |
| 向く場面 | 「どの変数同士に関係があるか」を探索 | 「これを予測したい」が決まっている |
「結果変数が1つに決まっているならロジスティック回帰、変数間の関係構造そのものを調べたいなら対数線形モデル」が判断基準です。
準1級では用語と位置づけだけで十分です。計算問題として出るのはまれで、出ても「(交互作用) がオッズ比」程度でしょう。
実務:A/Bテストで何を使うか
道具が増えたので、選ぶ順序を整理します。
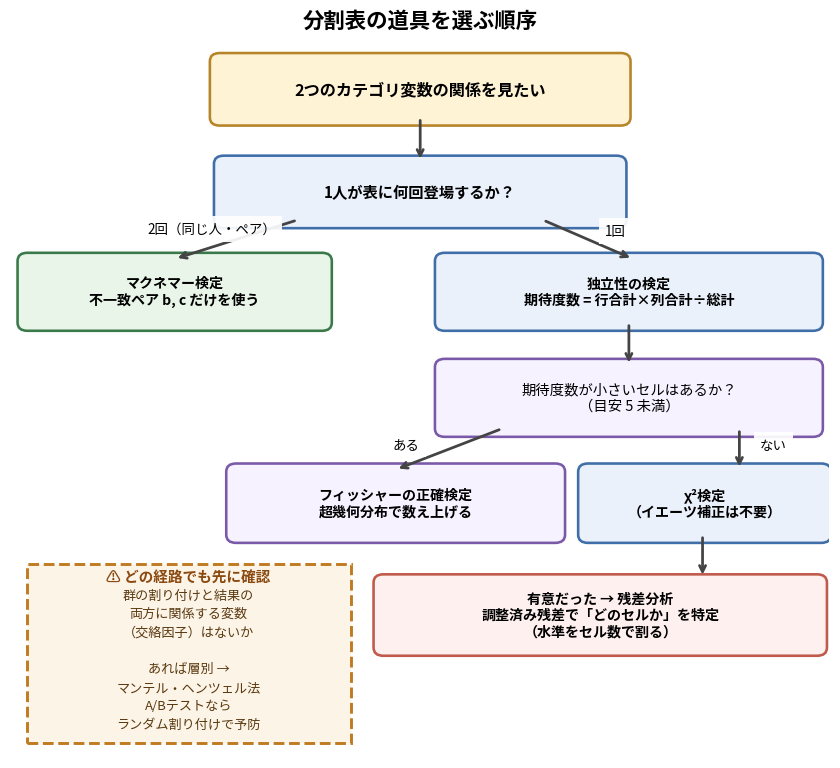
最初の分岐が「1人が表に何回登場するか」であることが大事です。ここを間違えると、そもそも別の問いに答えてしまいます。
左下の注意は経路に関係なく常に確認すべきことで、これを外すとシンプソンのパラドックスを踏みます。
このブログのCTA比較なら、手順はこうなります。
(1)訪問者をランダムに2群へ割り付ける。 これが最重要です。手で「この記事はA、あの記事はB」と振ると交絡が入ります。
(2)検定はカイ二乗検定。 第13回の母比率の差の検定と数学的に同じものです。2×2表のカイ二乗検定は、プールした比率を使う 検定の と厳密に一致します。「どちらを使うべきか」という問いには「同じなのでどちらでもよい」が答えになります。
(3)報告はリスク差。 「クリック率が7.5ポイント上がった。月1万PVなら750クリック増」と言えるのはリスク差だけです。
(4)有意でも即断しない。 第11回で「月31PVではA/Bテストに5.8年かかる」と計算しました。このブログの規模だとそもそも検出力が足りないことが多い。今回のCTA例(各200人)でも 15.0% 対 22.5% という大きい差が で有意になりませんでした。
やってはいけないこと
| やりがちなこと | なぜ問題か |
|---|---|
| 有意になるまで毎日確認する | 第12回の多重比較。停止規則を決めずに覗くと偽陽性が激増する |
| 記事タイプごとに手でデザインを割り振る | 交絡。シンプソンのパラドックスを踏む |
| 期待度数が小さいのにカイ二乗検定 | 近似が甘い方向に外れる。フィッシャーを使う |
| イエーツ補正をかける | 保守的すぎて検出力を捨てる |
| オッズ比を「◯倍になった」と報告 | ベースが高いと確率の変化を過大に見せる |
| 3群以上を2群ずつ比較 | 多重比較。まず 表で全体を検定し、残差分析で特定する |
最後の項目が今回学んだことの実務での使いどころです。 CTAデザインを3種類試したら、 表でカイ二乗検定 → 有意なら調整済み残差でどのデザインが効いているかを特定、という流れになります。
自分が間違えていたこと
今回、書きながら間違いに気づいた点を残しておきます。
1. シンプソンのパラドックスの数値例を作り損ねた。 最初に作ったのは「層1ではBが勝ち、層2ではAが勝つ」という表で、これを「逆転が起きた」と書こうとしました。しかしこれはただのばらつきで、パラドックスではありません。条件は「すべての層でAが勝ち、なおかつ合計するとBが勝つ」で、層ごとに勝敗が割れている表を作っても意味がない。「逆転」という言葉に引きずられて、何と何が逆転するのかを確定しないまま数値を作っていました。
2. 大きな の 値を数値積分で出して桁を間違えた。 、自由度9の上側確率を数値積分で求めたら と出ました。これは浮動小数点の精度限界にぶつかった嘘の値で、正しくは です。「1から累積確率を引く」形で計算すると、累積確率が1に近すぎて差が取れません。連分数(Lentz法)で対数スケールのまま計算し直して修正しました。極端に小さい確率を扱うときは、引き算を経由しない計算式を選ぶ必要があります。
3. オッズ比の不変性を、層を潰す操作にも成り立つと錯覚しかけた。 ケース・コントロールでオッズ比が不変だと確認した直後にシンプソンのパラドックスを扱ったので、「オッズ比なら層別と全体で一致するのでは」と考えました。まったく別の操作です。 不変なのは「列ごとに定数を掛ける」操作に対してで、層を足し合わせる操作では方向すら逆転します(0.6599 と 0.7778 に対して全体は 4.8583)。
4. 「期待度数5以上」の意味を取り違えていた。 「5以上なら近似は安全、5未満なら危険」という理解でしたが、実測すると期待度数12.5でカイ二乗近似の実サイズが 0.0643、期待度数2.4で 0.0391 でした。順序が逆です。効いているのは期待度数の大きさではなく が取れる値の粗さ(離散性)で、 が 0.5 付近だと期待度数が大きくても近似が甘くなります。
5. イエーツ補正を式だけ覚えていて、 の由来を説明できなかった。 「 から を引く」は書けるのに、なぜ なのかを聞かれて答えられませんでした。二項分布の連続性補正と同じ発想(整数の観測値を幅1の区間とみなす)だと分かれば、あとは覚える必要がありません。式を覚えていることと理解していることの差が、いちばんはっきり出た箇所でした。
6. 多重比較のシミュレーションで、分割表ではなく独立な正規乱数を回していた。 「16セルのどれかが になる確率」を測るつもりで、実際には独立な標準正規16個を生成していました。出た値 0.5610 が理論値 とよく一致したので、「理論値との照合も合います」と書いて満足してしまった。独立を仮定した理論値と一致したことが、独立を仮定した乱数を回した証拠だったのに、それを検証の成功と読み違えていました。 実際の分割表で回すと 0.4741 で、調整済み残差はセル間で負に相関しています(平均 、最小 )。理論値と一致したときこそ、何を仮定した理論値なのかを確認する必要があります。
7. 単調性の根拠に、単調でない数列を並べていた。 「SNSは年代とともに単調に減る」の根拠として調整済み残差 を挙げていましたが、最後で増えています。残差は行の にも依存するので、単調性を測る量ではありませんでした。 主張自体は正しく(行内シェアは単調)、引いてきた数字が違っていた。自分が載せた数列を読み直せば気づけた誤りです。
8. オッズ比が「均等割り付けなら層別値と一致する」と思っていた。 交絡の2条件を整理したとき、「片方だけならズレない」と書きました。率とリスク差については正しいのですが、オッズ比は50:50で完全に均等割り付けしても層別値と一致しません(非崩壊性)。共通オッズ比 2.000 でも、層のベースが と なら合計表は 1.451 まで縮みます。向きは変わらないので交絡とは別問題ですが、「層別と全体でオッズ比が違う=交絡」とは言えません。
9. の「増分」として の値そのものを並べていた。 「 が1増えるごとの増分は 」と書きましたが、これは における の値です。増分は 。結論(幅が広がる)は正しいのに、量を取り違えていました。
10. 目安の条件と根拠が噛み合っていなかった。 「 と がどちらも0.10以下なら差は6%以内」と書こうとして、根拠にした表の行は でした。条件を満たしていない行から目安を作っていたことになります。正しくは上限は だけで決まり、 なら11.1%以内です。
要点まとめ
| 項目 | 要点 |
|---|---|
| 適合度検定との違い | 統計量の式は同じ。 違いは期待度数を「仮説が与える」か「周辺合計から作る」かだけ |
| 期待度数 | 。行合計・列合計は観測値と完全に一致するので、ズレていいのは表の内側だけ |
| 自由度 | 。 は「最後の行と列は引き算で出るから数えない」の意味。3×4表なら6セルだけ自由 |
| 2×2表のズレ | 4セルすべて が同じ値になる(市松模様)。自由度1が目に見える形 |
| リスク差 | 。単独で意味が確定する唯一の指標。 件数に直せるので報告に向く |
| リスク比 | 。ベースを添えないと大きさが分からない |
| オッズ比 | オッズの比。 で行と列の入れ替えに対して対称 |
| オッズ比とリスク比の関係 | 。ずれの上限は大きいほうの確率 だけで決まり ( で11.1%以内)。リスク比1.5なら で5.88%以内、 で14.3% |
| 指標で結論が逆転する | 15.0%→22.5% と 60.0%→75.0% で、リスク比は前者が大(1.50>1.25)、オッズ比は後者が大(2.00>1.65) |
| ケース・コントロール | 結果で群を分けるので確率が計算できない。 オッズ比だけが抽出率 の約分で不変(4通りの抽出すべてで 2.0638297872) |
| なぜオッズ比だけ不変か | 掛け算と割り算だけなので定数倍が消える。リスク比は分母が という足し算なので消えない |
| シンプソンのパラドックス | 層別で全部Aが勝ち、合計でBが+17ポイント勝つ。正体は加重平均で、重みがAとBで正反対 |
| 有意性は交絡を直さない | 逆向きの結論が 、 で出る。 を増やすと間違いに自信がつくだけ |
| 交絡の2条件 | ①群の割り付けと関係する ②結果とも関係する。両方揃わないと結論は逆転しない。ランダム化で①を切る |
| オッズ比の非崩壊性 | 均等割り付けでもオッズ比は層別値と一致しない(共通2.000 → 合計1.451)。率とリスク差は加重平均で保たれるのに、オッズ比は保たれない。向きは変わらないので交絡とは別問題 |
| 層別すべきかは因果の問題 | 割り付け前から存在する性質なら層別する。割り付け後に起きたことで層別すると経路を潰す |
| 直し方 | 標準化(重みを揃える)→ 16.50% vs 13.50% でAの勝ちに戻る/マンテル・ヘンツェル法 |
| マクネマー検定 | 対応のある2×2表。。一致ペア は完全に無情報 |
| 見分け方 | 1人が表に何回登場するかを数える。 2回登場(測定回数が表の合計の2倍)→マクネマー、1回(測定回数=合計)→ふつうの分割表 |
| マクネマーの中身 | 不一致ペアに対する符号検定。「30人が割れて25人が新に有利」をコイン投げと比べる |
| 一致ペアは効かない実測 | を20→40に変えても は 13.3333 のまま |
| 独立性の検定を誤用すると | 値は小さくなるが(0.000049)別の問いに答えている(個人の一貫性を測っている) |
| 対応のあるt検定との関係 | 発想は同じ(個人差を消す)。違いは差が3値しかなく、0の人が捨てられること |
| セルの寄与 | 。合計が になるが、2乗なので多い/少ないが消える |
| ピアソン残差 | 。符号は残るが分散が1に届かない(16セル平均 0.5625・範囲 0.304〜0.763) |
| 調整済み残差 | 。分散が 1.0000 で標準正規に一致。これを で判定に使う |
| なぜ E で割るのか | 数え上げでは 、 なので 。 が小さければ が標準偏差 |
| なぜさらに補正が必要か | 周辺合計を推定に使うと分散が まで縮む(実測で1.00に一致)。行合計固定なら厳密・総計だけ固定なら 倍。第14回の「推定すると自由度が減る」をセル単位で見たもの |
| 補正の倍率 | 。周辺確率が大きい行・列ほど強く効く(検索列1.814、メール列1.145)。第17回のてこ比と同じ発想 |
| ボンフェローニ補正 | 分布は動かさず切る位置をずらす。 16セルなら → 。補正なしだと誤検出率が0.4741(独立な16個なら0.5599。調整済み残差は負に相関するので独立より低い)。補正後は0.0449 |
| フィッシャーの正確検定 | 周辺合計を両方固定して超幾何分布で全列挙。24人の例では10通りしかなく確率の合計が1.000000 |
| 「正確」の意味 | 「よく見つける」ではなく「5%を超えないことが保証される」。検出力は近似より低い(第14回で約10ポイント) |
| 期待度数5以上の目安 | 近似の質を保証しない。 期待度数12.5で実サイズ0.0643、期待度数2.4で0.0391。効いているのは離散性 |
| イエーツ補正 | から を引く。 は「整数を幅1の区間とみなした半分」。二項分布の連続性補正と同じ発想 |
| イエーツの評価 | 推奨されない。 実サイズ 0.006〜0.032 で5%を使い切れず、厳密値を追い越すこともある( で 0.0917 > 0.0894) |
| なぜ2×2で が効かないか | ①相手が超幾何分布(裾が短い)② の階段の幅が一定でない(1段ぶんの増分が と広がる) |
| 対数線形モデル | セル度数の対数を行効果・列効果・交互作用の和に分解。交互作用ゼロ=独立 |
| 交互作用項の正体 | がオッズ比(0.607843 = 1/1.645161)。 の最尤推定が |
| と | 。期待度数が十分ならほぼ一致。モデル比較ができるので対数線形では |
| いつ対数線形モデルを使うか | 3元以上でモデル選択したいとき/順序を係数に埋めたいとき(線形連関モデル)/度数を予測したいとき |
| ロジスティック回帰との関係 | 数学的に等価(ただし説明変数どうしの交互作用項をすべて含めたときに限る)。結果変数が1つに決まっているならロジスティック回帰を使う |
| A/Bテストでの手順 | ランダム割り付け → カイ二乗検定(=比率の差の検定と同一)→ リスク差で報告 → 検出力を疑う |
| 3群以上の比較 | 2群ずつ比較しない。 表で全体を検定 → 調整済み残差で特定 |
次回
次回は第29章の欠測データの処理です。今回は「表に入っている人数」を数えてきましたが、次回扱うのはそもそも記録が欠けている場合の話になります。
今回の交絡の議論と似た構造が形を変えて出てきます。欠測のメカニズムは MCAR・MAR・MNAR の3つに分類されますが、これは要するに「何が欠測の有無を決めているか」の分類です。今回「群の割り付けと結果の両方に矢印が刺さっている変数が交絡因子」と整理しましたが、欠測でも「欠けたかどうか」と「知りたい値」の関係で話が決まります。
そして重みがずれると平均が動くという今回の構造も効いてきます。シンプソンのパラドックスでは層の構成比がAとBで正反対だったせいで結論が逆転しました。欠測では「答えてくれた人」の構成比が母集団と違うことが同じ問題を起こします。第21回の無回答バイアスがここに合流します。
推定にはEMアルゴリズムが出てきます。第27回の因子分析で「渡すべき行列そのものが未知だから反復する」という構造がありましたが、あれと同じ形の反復です。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。