t検定の使い分けとウェルチ:等分散仮定で誤り率が35%に暴走【第13回】
はじめに
第11章は正規分布に関する検定です。前回(第12回・検定の論理)で有意水準や棄却域といった検定の骨組みを作ったので、今回はそこに具体的な道具を並べていきます。
ただ、この章はどの教科書でも検定の名前が10個くらい並ぶ構成になっていて、最初に読んだときの印象は「暗記する表が増えた」でした。1標本のt検定、2標本のt検定、対応のあるt検定、ウェルチの検定、母分散のχ²検定、分散比のF検定、母比率のz検定、相関係数の検定。名前が似ているうえに、自由度が だったり だったり だったりします。
この章の本題は「10個の検定を覚えること」ではなく、「10個が同じ形をしていると気づくこと」でした。
全部これです。分子は「知りたい差」、分母は「その差が偶然でも出るかどうかの基準になるばらつき」。違うのは分母のばらつきをどう見積もるかだけで、その見積もり方が自由度を決めています。この一本の筋が見えてからは、表を覚える作業がほとんど要らなくなりました。
そして今回いちばん驚いたのが、前提が崩れたときの壊れ方です。等分散を仮定するt検定を、分散が違うデータに使うと、名目5%のはずの誤り率が35.08%まで上がりました。20回に1回の間違いを許すつもりだったものが、3回に1回になっている。しかも条件をひっくり返すと0.04%まで落ちて、今度は差を見つけられなくなります。この非対称な壊れ方を実測できたのが、今回の学習の収穫でした。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 記号で迷ったら 統計の記号がややこしいのは軸が2本あるからだった を先に読んでください。
- t分布・χ²分布・F分布そのものの成り立ちは 第7回 で扱っています。
この記事で使う言葉
まず3つだけ。この記事はこの3語で回ります。
プールした分散(pooled variance):2つの群の分散を「共通の値」だと思って、両方のデータをまとめてひとつの分散を推定したもの。「プール」は共有する・合算するという意味です。
ウェルチの検定(Welch's t-test):2群の分散が違ってもよいことにしたt検定。サタスウェイト近似(Satterthwaite approximation)という方法で自由度を計算します。
頑健性(robustness / ロバストネス):前提(正規性や等分散性)が少し崩れても、結論が大きく狂わない性質。「頑健である」=「前提違反に強い」です。
TL;DR
- すべての検定は 「差 ÷ ばらつき」。違うのは分母の見積もり方だけで、それが自由度を決める
- 自由度 = n −(先に推定したパラメータの個数)。1標本・2標本・対応あり・相関はこの1行で出る(F検定は2つ組、ウェルチは近似で小数になるので例外)
- t検定の使い分けは統計の判断ではなく「データの取り方」で決まる。迷ったら「データの1行は何を表しているか」を見る
- 等分散を仮定したt検定は、分散が違うと 5% → 35.08% まで暴走する。しかも条件が逆だと 0.04% に潰れる
- ウェルチを常用してよい。 等分散が真のときの損は ずつで −0.07pt しかない
- 「F検定で等分散を確かめてからt検定」は推奨されない。手順の問題もあるが、F検定そのものが正規性に弱く、指数分布では n を増やすと 30.85% まで悪化する
- 平均の検定は中心極限定理に守られていて n を増やせば直る。分散の検定は守られておらず n を増やすほど悪化する
- 対応のあるt検定の正体は 標準誤差が 倍になること。ただし では逆に不利
- 母比率で を使って標準誤差を作ると 66.8% まで壊れる。帰無仮説の で作るのが正解
すべての検定は「差 ÷ ばらつき」だった
最初に、この章の全体を貫く形を確認します。
「新しい教材で平均点が3点上がった」と言われたとき、それが意味のある変化かどうかは3点という数字だけでは判断できません。生徒の点数が毎回±2点しか動かない世界なら3点は大事件ですが、±20点動く世界なら3点は誤差です。
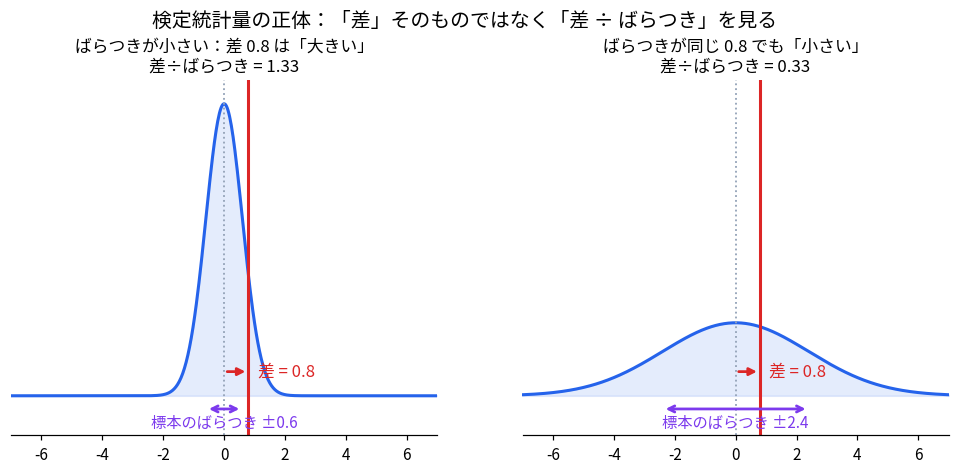
左右の図で赤い線の位置(差 = 0.8)はまったく同じです。違うのは分布の幅だけ。左では 0.8 ÷ 0.6 = 1.33 で、右では 0.8 ÷ 2.4 = 0.33 になります。同じ差が、ばらつきの大小で意味を変える。 だから差を単独で見ずに、必ずばらつきで割ります。
この「割る」という操作を数式にすると、こうなります。
分子は「推定した値」と「帰無仮説の値」の差。分母は第10回で出てきた標準誤差(SE)です。今回登場する検定は、この形に何を入れるかが違うだけです。
| 場面 | 分子(差) | 分母(ばらつき) |
|---|---|---|
| 1標本の平均 | ||
| 2標本の平均差 | ||
| 対応あり | ||
| 母比率 | ||
| 相関係数 |
分子の列を見ると、どれも「引き算」です。 そして分母の列だけが場面ごとに違う。この表の右側だけを覚えれば済むというのが、この章の実質的な内容でした。
σ を知っているかどうかで z と t が分かれる
分母のばらつきには2通りあります。母集団のばらつき σ を知っている場合と、標本から推定する場合です。
σ が既知なら、分母は定数です。分子の標本平均だけが揺れるので、比は素直に標準正規分布に従います。これがz検定です。σ を推定すると分母も揺れるようになり、その分だけ分布の裾が広がってt分布になります。第7回で「母分散を知らないことへの罰金」と書いたのがこれです。
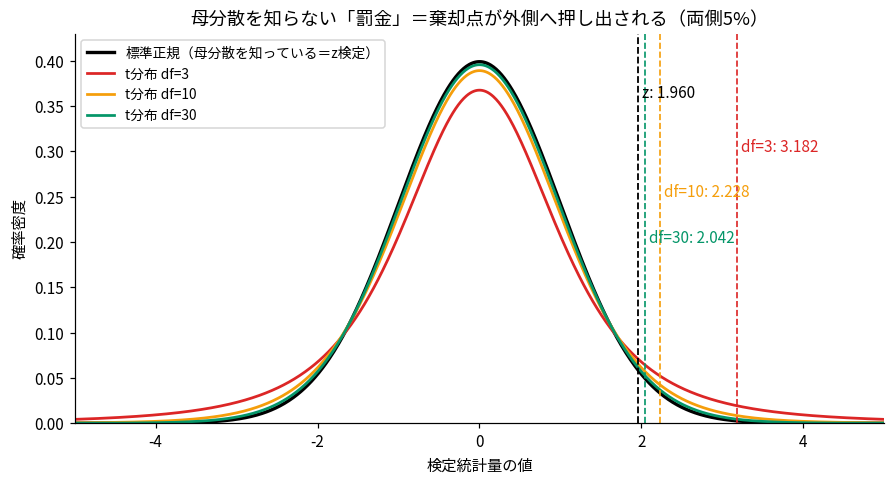
罰金は棄却点の位置に現れます。 自由度3では 3.182 まで待たないと棄却できません。標準正規の 1.960 と比べると 1.6 倍です。データが少ないと「分母の見積もりが外れているかもしれない」ので、その分だけ判定を厳しくしている、と読めます。
そして自由度が大きくなると罰金は消えます。 自由度30で 2.042、自由度120では 1.980 で、標準正規の 1.960 とほとんど区別がつきません。大標本のときに「z検定」と書かれているのは、この意味です。
なお「σ を知っているなら平均も知っているだろう」という感覚は正しくて、1標本の平均のz検定は現実にはほぼ使いません。教科書に載っているのは、σ が既知なら分布が厳密に標準正規と決まるので、有意水準や棄却域という概念を説明するときに余計な要素が混ざらないからです。
ただし比率の検定では、σ を推定して t にする必要がありません。 0/1のデータでは分散が で、平均 の関数になっているからです。「 である」という帰無仮説を立てた瞬間、分散も と自動的に確定してしまう。帰無仮説が平均と分散を同時に指定するので、σ が本当に既知になるわけです。ただしこれは「σ を別に推定しなくてよい」という意味だけで、0/1データそのものは二項分布なので、正規分布への近似は依然として必要です。後半の母比率の節で、これが実務上の違いを生むところまで見ます。
t検定の使い分けは、統計の判断ではなかった
ここが今回いちばん認識が変わったところです。
t検定の種類を選ぶとき、私は「どれが適切か統計的に判断する」ものだと思っていました。実際には違いました。どのt検定を使うかは、データを取った時点でほぼ決まっています。
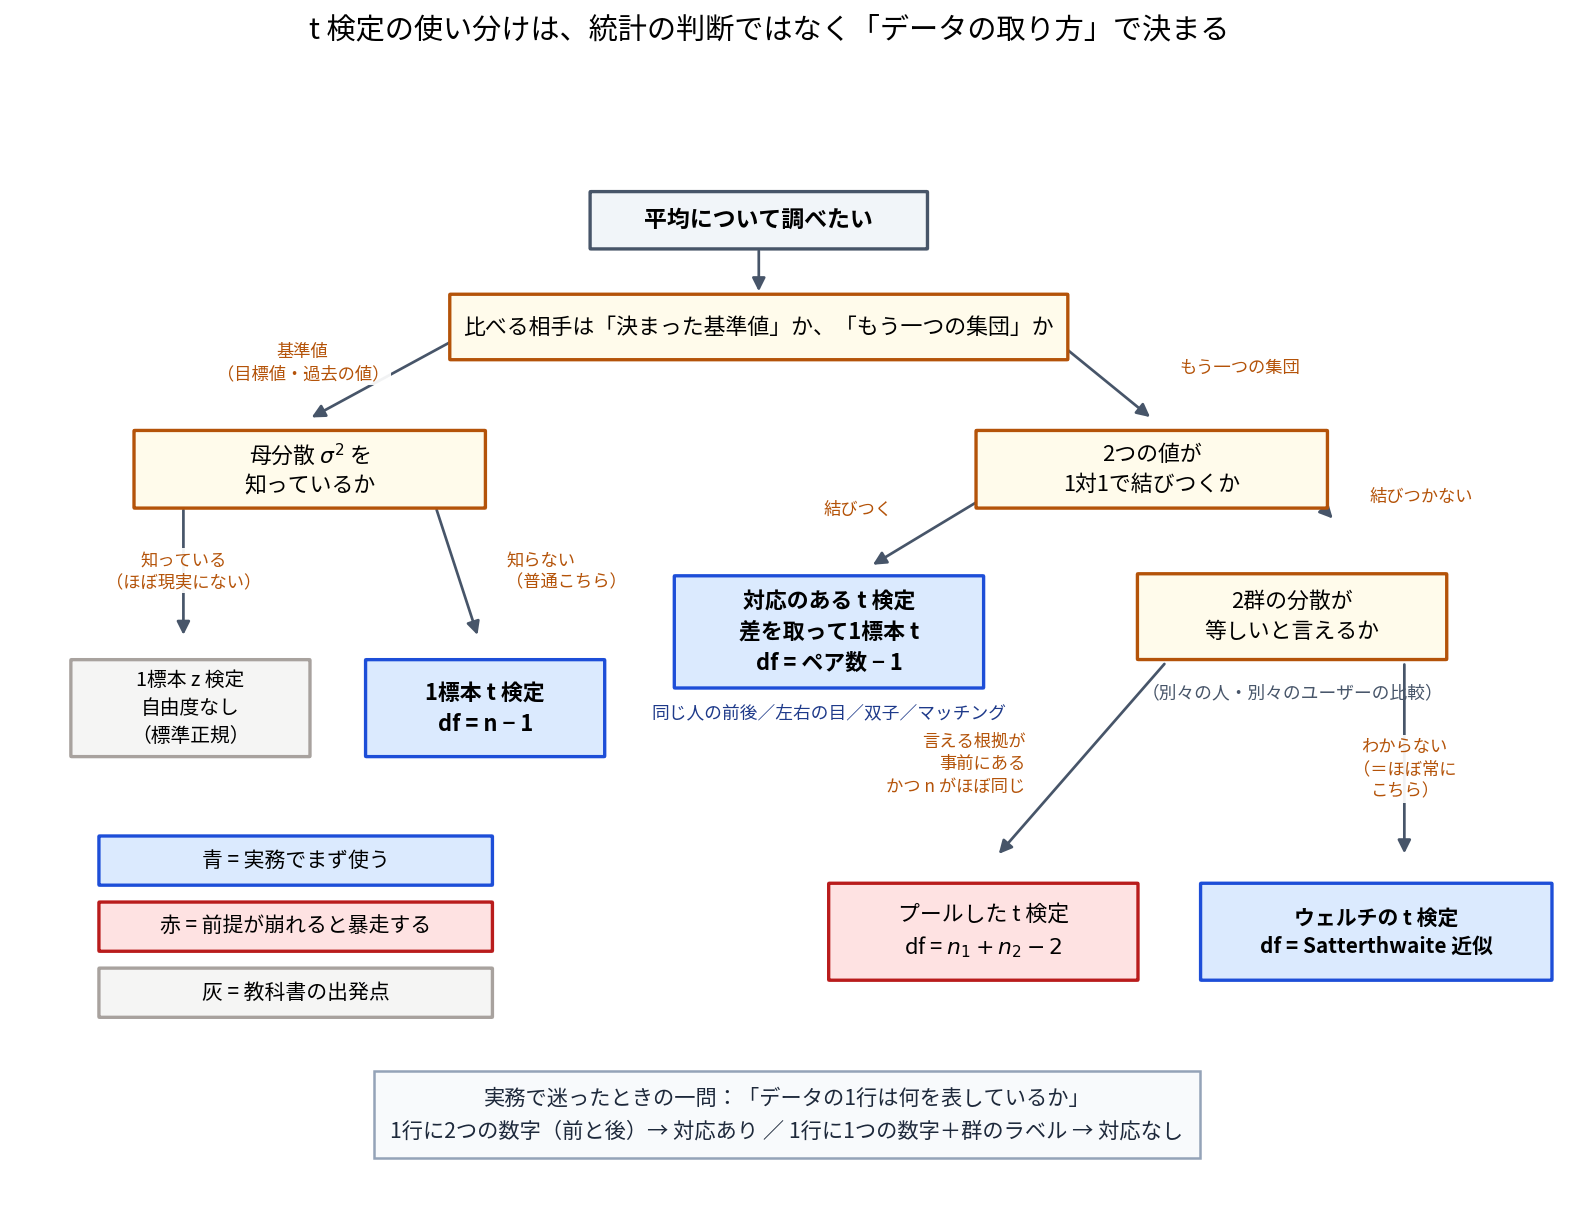
分岐を上から見ていくと、聞かれていることは3つだけです。
分岐1:比べる相手は何か。 「目標値の80点を超えたか」なら1標本。「A群とB群のどちらが高いか」なら2標本。これは調べたいことそのものなので迷いません。
分岐2:2つの値が1対1で結びつくか。 同じ人の投薬前後なら結びつきます。別々の人をランダムに2群に分けたなら結びつきません。これはデータの取り方で決まっていて、後から選べません。
分岐3:分散が等しいと言えるか。 ここだけが判断の余地があるように見えますが、後で見るように実務ではほぼ「言えない」側に倒してよいという結論になります。
実務で迷ったときの一問
分岐2の判定で迷ったら、統計を考えずにExcelの形を見てください。
「データの1行は何を表しているか?」
1行が「1人の前と後」のように2つの数字を持っているなら対応あり。1行が「1人の1つの数字+どちらの群か」なら対応なし。これで決まります。
もうひとつ確実な手がかりがあります。2群の が違っていたら、それは必ず対応なしです。対応があるならペアなので個数が一致するはずで、一致しないなら対応が取れていません。
間違えやすい例
対応ありになるのは、同じ人の投薬前後、同じユーザーのUI変更前後、同じ被験者の左右の目、双子の兄と弟、年齢と性別でマッチングさせたペア、同じ工場の去年と今年です。
対応なしになるのは、治療群と対照群にランダムに割り振った別々の人、A/Bテストで別々のユーザーに振り分けた2群です。
紛らわしいのがマッチングです。「年齢と性別が同じ人をペアにして、片方に新薬、片方に偽薬」という設計は、別々の人なのに対応ありとして扱います。設計の段階で人為的にペアを作っているからです。逆に「同じ人を2回測った」ように見えても、2回の測定が無関係な別々の対象についてなら対応なしです。血が通っているかではなく、ペアとして紐づけたかどうかが基準です。
自由度はひとつの規則で全部出る
次の疑問は自由度の決め方でした。これは1行にまとまりました。
なぜ引くのかというと、推定した値を使った時点で、残差の間に制約が生まれるからです。標本平均 を計算してから残差 を作ると、残差の合計は必ず 0 になります。つまり 個のうち 個が決まれば最後の1個は自動的に決まる。自由に動けるのは 個だけなので、自由度は です。
この規則を各検定に当てはめると、こうなります。
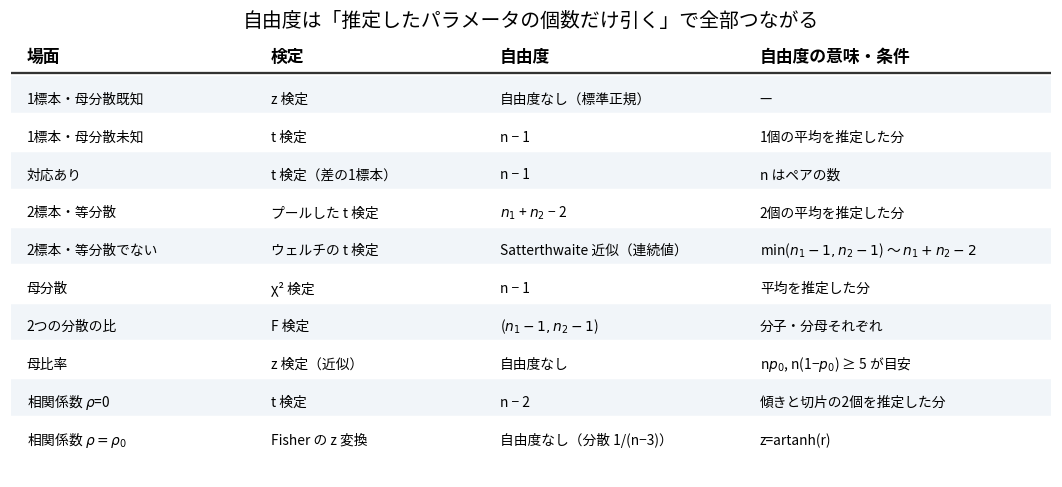
表のなかで一度は引っかかるのが相関係数の です。なぜ2個引くのかというと、相関係数の検定は実質的に「回帰直線の傾きがゼロか」を調べていて、傾きと切片の2個を推定しているからです。2個推定したので2個引きます。 だと自由度1しかなく、実際 ではよほど強い相関でないと有意になりません。
2標本の も同じ読み方です。2つの群の平均をそれぞれ推定したので、2個引きます。
母比率に自由度がないのは、さきほど書いたとおり帰無仮説が分散まで指定してしまうので、分散を推定する必要がないからです。推定していないので引くものがない。
ウェルチの自由度だけが小数になる
ウェルチの検定の自由度は、サタスウェイト近似で次のように計算されます。
見た目は複雑ですが、分子は「合計のばらつきの2乗」、分母は「それぞれのばらつきの2乗を自由度で割ったものの和」という形です。統計ソフトが「df = 15.83」のような小数を出すのはこれが理由です。データから計算するので、実行するたびに値が変わります。
この自由度がどこまで動けるのかを調べてみました。
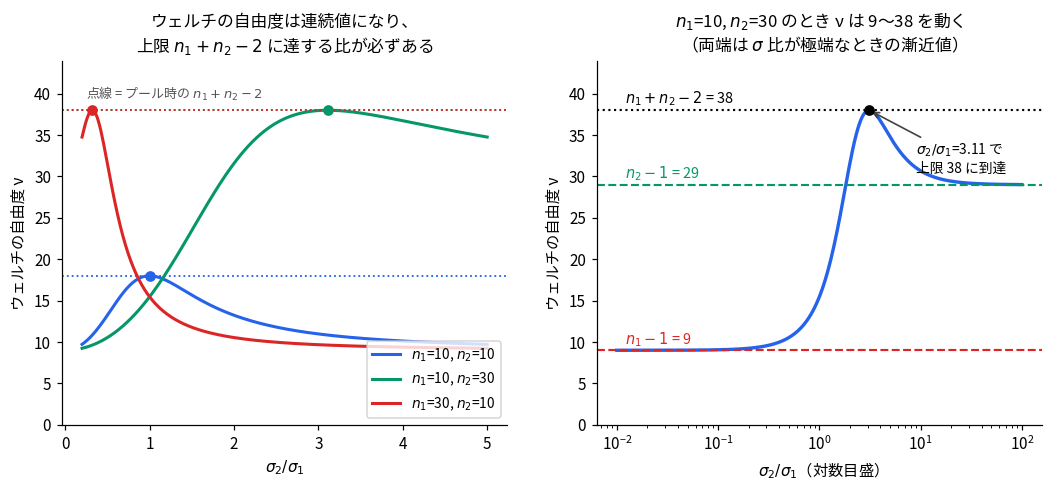
範囲は です。上限に達するのは と の比が になったときで、 ならそれは等分散のときです。 が不均衡でも上限には届きます。 なら 付近でぴったり 38 になります。逆に の比が極端になると、 か に漸近して落ちていきます。
この「落ちる分」がウェルチの代金です。 自由度が小さいほど棄却点が外側に行くので、検定は保守的になります。ではその代金はいくらなのか、というのが後半の「ウェルチを常用する代金」につながります。
ここは最初、私が「 なら 9〜29 しか動かず 38 には届かない」と誤解していた箇所です。極限値だけを検算して「両端が下限と上限」と早合点していました。実際には は山型で、両端が最小・途中が最大です。極限だけ調べて範囲を決めるのは危ない、という教訓になりました。
等分散の仮定が崩れると、誤り率が35%まで暴走する
まず、プールしたt検定の分母を確認します。
は2つの分散を自由度で重みづけした平均です。ここが問題の起点でした。サンプル数が多い群の分散のほうが、重く扱われます。
真の平均差がゼロのデータを20万回生成して、名目5%の検定が実際に何%棄却するかを測りました。
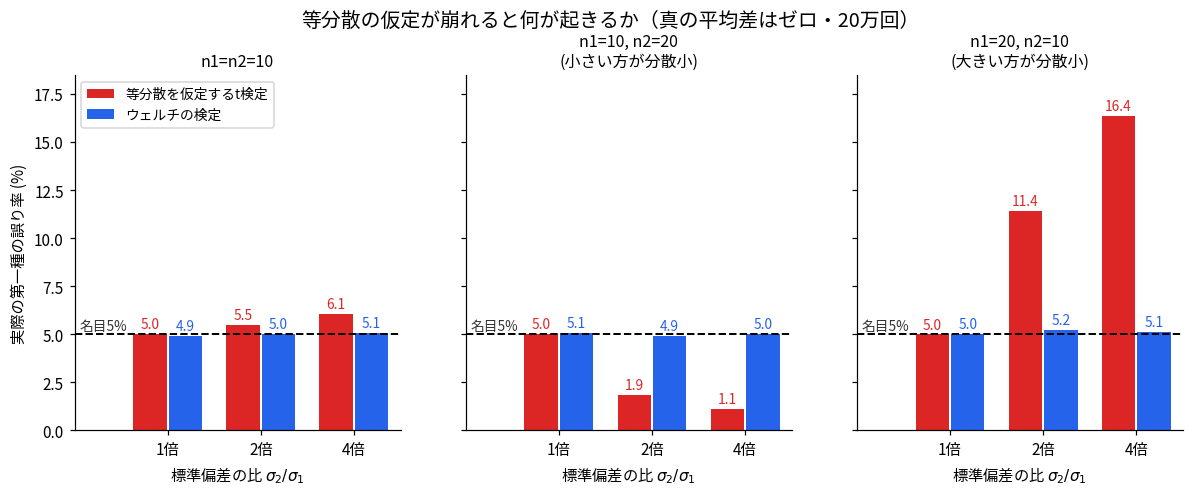
左のパネル( が等しい)を見ると、標準偏差が4倍違っても 6.06% で済んでいます。等分散の仮定は「 が等しければそこそこ頑健」なのです。教科書がプールしたt検定を安心して載せられるのは、この事実が背景にあります。
問題は真ん中と右です。同じ「」なのに、 の割り振りを入れ替えるだけで 1.11% と 16.37% に分かれました。 符号が逆転しています。
もっと極端な条件でどこまで行くか試しました。
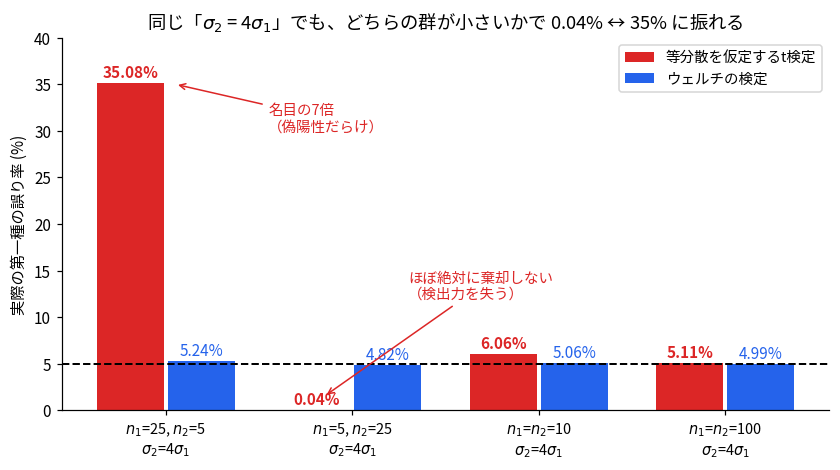
で 35.08%。名目の7倍です。 そして にひっくり返すと 0.04%。1万回に4回しか棄却しません。
なぜ向きで逆転するのか
が自由度で重みづけした平均だったことを思い出します。
(分散小)、(分散大)のとき、 はサンプルの多い「分散が小さい群」に引っ張られて小さくなります。分母が小さくなるので の値は大きくなり、棄却しすぎます。
逆に (分散小)、(分散大)なら、 は分散の大きい群に引っ張られて大きくなる。分母が大きくなるので が小さくなり、棄却しなくなります。
「サンプルが多いほうの分散が小さい」ときに偽陽性が出る、と覚えられます。ただし実務では覚える必要はなくて、ウェルチを使えばこの分岐そのものが消えます。ウェルチはどの条件でも 4.8〜5.2% を保っていました。
F検定で等分散を確かめてからt検定、は推奨されない
多くの入門書に「まずF検定で等分散性を確認し、等分散ならプールしたt検定、そうでなければウェルチ」と書かれています。この手順が妥当かを調べました。
理由1:データを見てから検定を選ぶと水準が守れない
同じデータで「どの検定を使うか」を決めてから「その検定を実行する」と、2つの判断が独立でなくなります。実測しました。
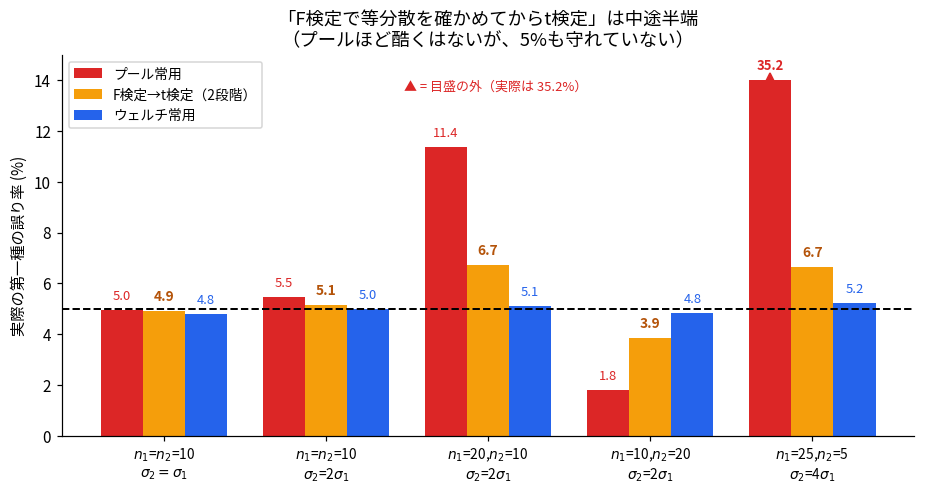
2段階手順はプール常用よりはずっとましです。35.2% だったところを 6.7% に抑えています(さきほどの 35.08% とわずかに違うのは、別の乱数系列で測り直しているためです)。しかし5% を守れていません。 で 6.73%、 で 6.66%。逆向きの では 3.86% と今度は保守的すぎます。
この現象は、第12回で扱った多重性の問題の一種です。ひとつのデータに2回判断させると、名目の水準からずれます。
理由2:もっと深刻な話。F検定そのものが信用できない
ここが今回の発見でした。2段階手順の問題は「手順が2段になっていること」だと思っていましたが、もっと根本的な問題がありました。
等分散を確かめるために使うF検定そのものが、正規性に極端に弱いのです。
真に等分散のデータでF検定をやって、名目5%が実際に何%になるかを測りました。
| 分布 | |||
|---|---|---|---|
| 正規 | 5.13% | 5.06% | 5.01% |
| 一様(尖度小) | 1.06% | 0.38% | 0.24% |
| (裾が重い) | 12.59% | 17.69% | 22.05% |
| 指数(歪度2) | 22.88% | 28.29% | 30.85% |
指数分布では で既に 22.88%、しかも を増やすと 30.85% まで悪化しています。
これは「前提を確かめるための道具が、確かめたい前提と同じくらい壊れやすい」という状況です。壊れた体温計で熱を測って、体温計が正しいかを判断しているようなものです。だからF検定を前段に置く手順は、そもそも土台が怪しい。
結論:ウェルチを常用してください。 データを見て選ぶ必要がなく、選ぶための道具も要りません。
なお、F検定を「分散そのものが知りたい」目的で使うのは正当です。品質管理でばらつきの均一性を評価する場合など、分散の比が本題ならF検定が正しい道具です。ダメなのは「t検定の前提チェックに使う」用途です。
ウェルチを常用する代金は、ほとんどゼロだった
「ウェルチが常に安全なら、なぜ教科書は等分散版を載せるのか」という問いに答えます。
まず代金を測りました。等分散が本当に成り立っているとき、ウェルチはどれだけ検出力を損するでしょうか。
| 標本サイズ | 真の差 | プールt | ウェルチ | 差 |
|---|---|---|---|---|
| ずつ | 54.88% | 52.02% | −2.85pt | |
| ずつ | 56.38% | 55.78% | −0.59pt | |
| ずつ | 86.88% | 86.81% | −0.07pt | |
| 75.79% | 72.36% | −3.43pt |
ずつなら −0.07pt。 検出力 86.88% が 86.81% になるだけです。損が目立つのは ずつ(−2.85pt)と標本サイズが偏った場合(−3.43pt)ですが、それでも数ポイントです。
得るものは、5% が 35% に暴走する事故を回避できること。 数ポイントの検出力と引き換えなら、迷う理由がありません。実務ではウェルチを既定値にしてよいという結論になります。R の t.test() が var.equal = FALSE を初期値にしているのは、この判断と同じ理由だと思われます。
では、なぜ教科書に等分散版があるのか
ウェルチが実務の既定値なら、等分散版は不要に見えます。でも4つの理由がありました。
理由1:試験で手計算で出る。 サタスウェイト近似の自由度を電卓で計算して、しかも小数の自由度でt分布表を引くのは現実的ではありません。準1級の試験ではプールした版が問われるので、そこは割り切って計算できるようにしておく必要があります。
理由2:正規性と等分散のもとで、厳密にt分布に従う。 ここが理論的にいちばん重要です。プールしたt検定は近似ではありません。 正規母集団で分散が等しければ、統計量は正確に自由度 のt分布に従います。一方ウェルチは近似で、自由度も近似値です。前回扱った尤度比検定を2標本正規モデルに適用すると、プールしたt検定が自然に導かれます。理論の骨格として、こちらが本体なのです。
理由3:分散分析と実験計画法の土台。 3群以上を比べる分散分析は、すべての群の分散が等しいという仮定のうえに作られています。プールした分散の考え方が分からないと、次章以降の分散分析が読めません。ウェルチだけ知っていても先に進めない構造になっています。
理由4:等分散が事前知識から言えるなら、そのほうが効率的。 同じ測定装置で同じ条件で測ったなら、測定誤差の分散が等しいと考える物理的な根拠があります。この場合はプールしたほうが情報を有効に使えます。
ただし理由4には強い注意があります。 その根拠は事前知識から来なければならず、同じデータのF検定から来てはいけません。データを見て決めた瞬間、さきほどの2段階手順の問題に落ちます。
正規性が崩れたとき:平均は守られ、分散は守られない
最後の疑問です。ここで今回いちばん大きな発見がありました。
「正規性の前提が崩れたときどうなるか」への答えは、検定によって正反対でした。
分散についての検定は、n を増やすと悪化する
さきほどF検定の表で見た現象を、母分散のχ²検定も含めてグラフにしました。真の分散は帰無仮説どおりなので、正しく動けば5%になるはずの状況です。
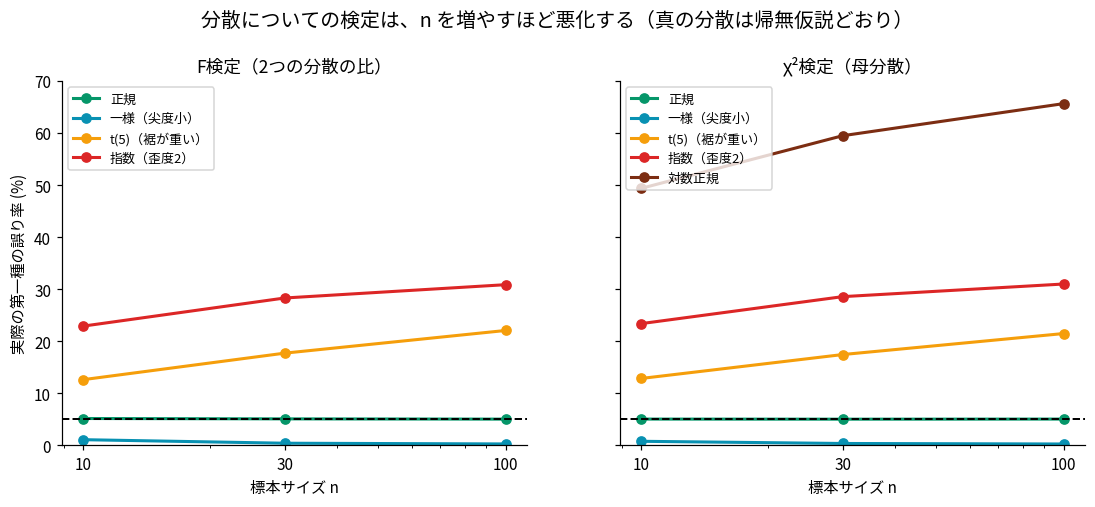
線が右上がりです。 を増やすほど悪くなっています。対数正規分布に対するχ²検定は で 65.65%。3回に2回、ありもしない差を見つけてしまいます。
一様分布では逆に潰れて 0.23% になっています。方向すら予測できないというのが厄介な点です。
平均についての検定は、n を増やせば直る
同じ指数分布で、平均の検定をやってみます。
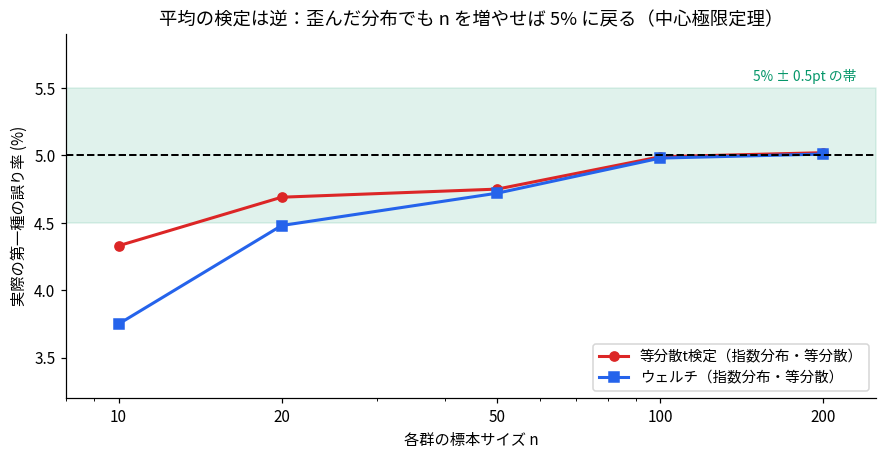
今度は右上がりで5%に収束しています。 で 4.33%、 で 4.99%、 で 5.02%。
この違いはどこから来るのでしょうか。
平均の検定を守っているのは中心極限定理です。 第8回で見たとおり、元の分布が何であっても標本平均は を増やすと正規分布に近づきます。だから分子の は、 が大きければ元の分布の歪みを忘れます。
分散の検定にはそれがありません。 χ²検定やF検定は、標本分散の分布が「正規母集団のときのχ²分布」であることに直接依存しています。標本分散の分布は を増やしても正規母集団のχ²分布には近づかず、元の分布の尖度(4次モーメント)が効き続けます。守ってくれる定理が存在しません。
仕組みを式で追うと、なぜ「 を増やしても直らない」のかがはっきりします。標本分散のばらつきは ( は尖度)です。一方、検定が基準に使うχ²分布は正規母集団を前提にしているので 、つまり を想定しています。実際の相対的な幅は 、基準の幅は 。この比 から が消えます。 だから をどれだけ増やしても比率は縮まりません。
指数分布は なので比は 。基準の棄却点が本当の分布の 1.96/2 ≒ 0.98 標準偏差のところに来てしまい、棄却率は に落ち着きます。実測が n=10 で 22.88%、n=30 で 28.29%、n=100 で 30.85% と上がっていったのは、発散していたのではなく 32.7% という誤った水準に収束していたのでした。一様分布()だと比は 0.63 で、逆に 0.2% 程度へ潰れていきます。 を増やすと「間違った答えに、より確実に到達する」わけです。
この対比は、第7回で標本分散とχ²分布を結びつけたことへの重要な補足です。 あの関係は正規性に完全に依存していました。
どこまで許されるのか
実測から得られた目安をまとめます。
| やろうとしていること | 正規性が崩れたときの扱い |
|---|---|
| 平均の検定( が各群30以上) | ほぼ問題ない。 歪んでいてもCLTが効く |
| 平均の検定( が10前後) | 数ポイントずれる。極端な歪みなら要注意 |
| 平均の検定(歪み+ が不均衡) | 要注意。 実測で 6.6% |
| 分散・分散比の検定 | 正規性が疑わしいなら使わない。 を増やしても直らない |
最も危険な組み合わせは「歪んだ分布+標本サイズの不均衡」でした。 の指数分布でウェルチが 6.63%、対数正規で 6.64% になっています。等しい なら 4〜5% に収まるところが、偏らせると5%を超える。「 を揃える」という実験計画の基本が、ここで効いています。
分散の検定を正規性なしで行いたい場合は、ルビーン検定(Levene's test)やブラウン・フォーサイス検定(Brown–Forsythe test)といった頑健な代替があります。平均の検定なら次々回で扱うノンパラメトリック法が選択肢になります。
対応のあるt検定の正体は √(1−ρ)
対応のあるt検定は、名前のとおり「2標本の検定の一種」に見えますが、中身は違います。
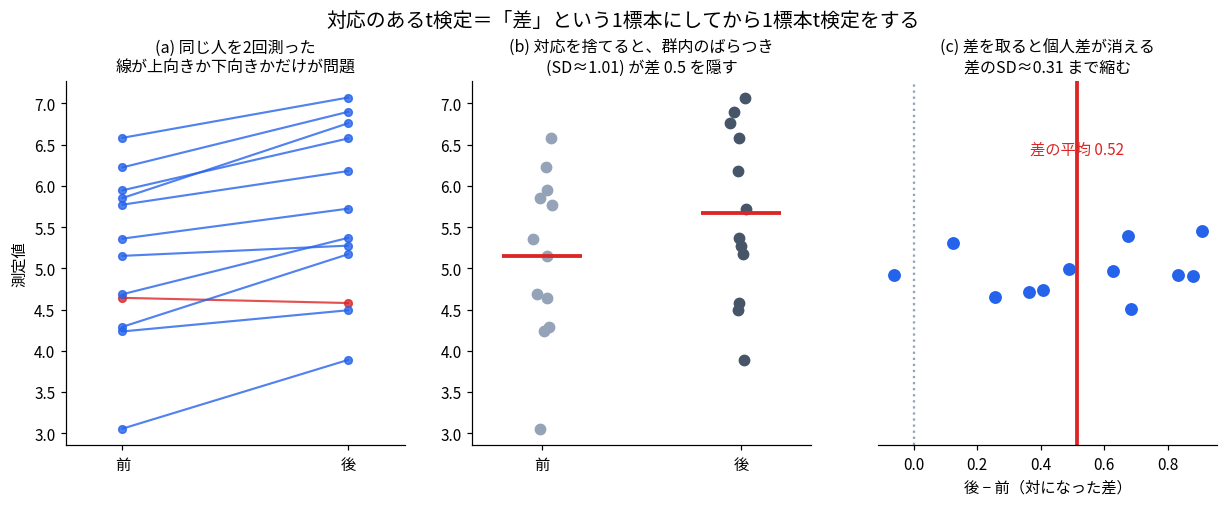
左の図で見るべきは、線が上向きか下向きかだけです。「もともと3.0点の人」と「もともと6.5点の人」の絶対値の違いは、上がったか下がったかとは関係ありません。
中央の図が問題を示しています。対応を捨てて2群として比べると、群内のばらつき(SD ≈ 1.01)が、知りたい差 0.5 を飲み込んでしまいます。
右の図が解決です。差を取ると個人差が消えて、ばらつきが 0.31 まで縮みました。 そして差というひとつの数列になったので、あとは1標本のt検定をするだけです。自由度は ( はペア数)。新しい検定を覚えたのではなく、1標本t検定に変形しただけでした。
効果は理論値と一致した
ペア内の相関 を振って検出力を測りました。
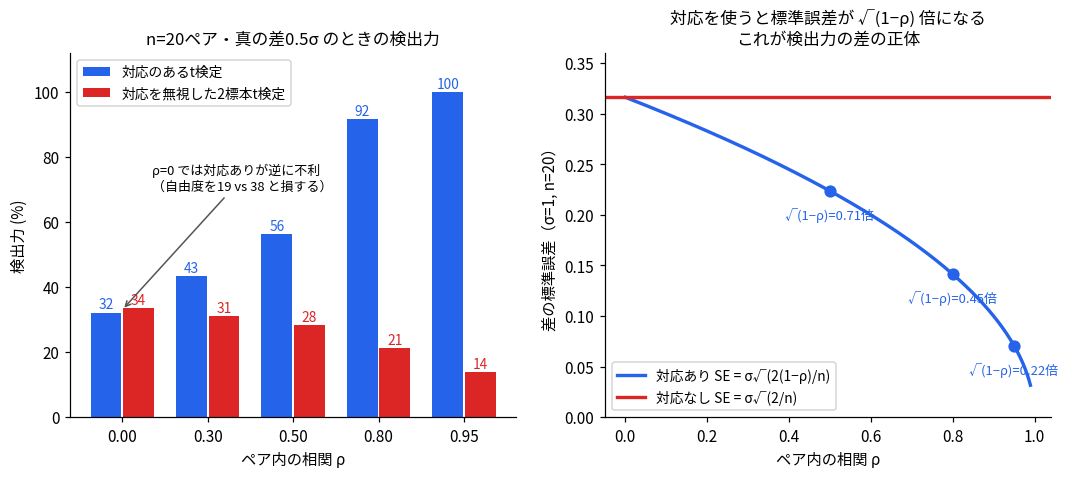
で 91.74% 対 21.30%。対応を無視すると、見つかるはずの差の8割を見逃します。
この差の正体は右のグラフです。 標準誤差を並べると、
比は です。 なら 0.707 倍、 なら 0.224 倍。実測でも のとき差の平均のSDが で 0.1409(理論 0.1414)、 で 0.0709(理論 0.0707)と、小数第3位まで一致しました。
なぜ になるのかは分散の公式から出ます。
第3回で出てきた共分散の項が、ここで効きます。相関が高いほど が大きく引き算されて、差の分散が縮む。 これが対応のある設計の利益の正体です。
私の予測が外れたところ
グラフの左端を見てください。 では対応ありのほうが不利です。 32.18% 対 33.70%。
私はここを「対応ありは常に有利」だと予測していて、外しました。理由は自由度です。 ペアなら対応ありの自由度は 19、対応なしなら 38。 だと で標準誤差が縮まないので、自由度を半分にした損だけが残ります。
つまり対応のある設計は「ペアにすることで相関が生まれる」ことが前提です。ペアの取り方に意味がなければ、自由度を捨てただけになります。
逆に、対応を無視すると何が起きるか
対応があるのに2標本t検定をしてしまった場合、真の差がゼロのときの誤り率が で 0.00% になりました。 でも 0.75% です。
これは「安全側に間違えた」ように見えて、実は深刻です。 検定は棄却しなくなりますが、それは差がないからではなく検定の感度を失っているからです。「有意差なし」という結論が、正しい理由で出ていない。保守的な間違いは、間違いだと気づきにくいぶん危ないという例だと思いました。
母比率の検定:どちらの分散を使うかで壊れる
母比率の検定は という形ですが、SE の作り方に2通りあります。
スコア型は帰無仮説の を使い、Wald型は推定値 を使います。 どちらでもよさそうに見えますが、実測すると大きく違いました。
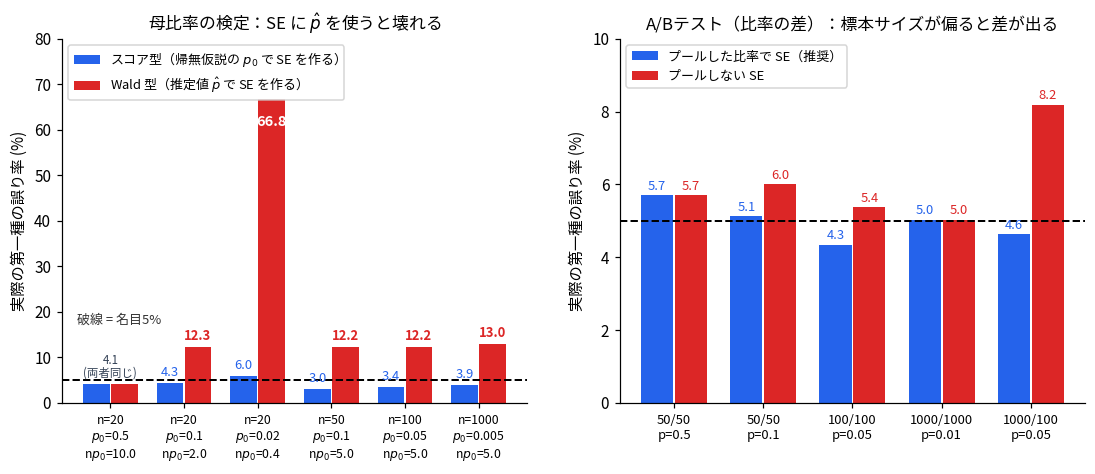
Wald型が で 66.82%。 そして でも 12.96% です。 という目安を満たしていても壊れています。スコア型は 2.99〜6.55% の範囲に収まりました(離散性による上下はありますが、桁で壊れることはありません)。
理由は、さきほどz検定の節で書いたことです。 帰無仮説 を立てた瞬間、分散も と確定しています。σ が既知なのに、わざわざ から推定し直すのは、既知の情報を捨てて余分な誤差を持ち込む行為です。しかも が偶然0に近い値を取ると SE がほぼ0になり、 が発散します。これが 66.8% の中身です。
教科書がスコア型を標準にしているのは、単なる慣習ではなく理由がありました。
A/Bテストでは「プールする」
2標本の比率の差でも同じ構図です。帰無仮説は「」なので、共通の比率をひとつ推定するのが自然です。
右のグラフで、 が等しければプールしてもしなくてもほぼ同じです。差が出るのは、 のケースで 4.64% 対 8.19%。ここでも標本サイズの不均衡が引き金になっています。
平均のときの と同じ話が、比率でも起きていると読めます。
相関係数の検定:n が小さいと r は驚くほど大きく出る
相関係数の検定は、 を調べる場合だけ簡単な形になります。
この式を逆に解くと「有意になる の下限」が出ます。
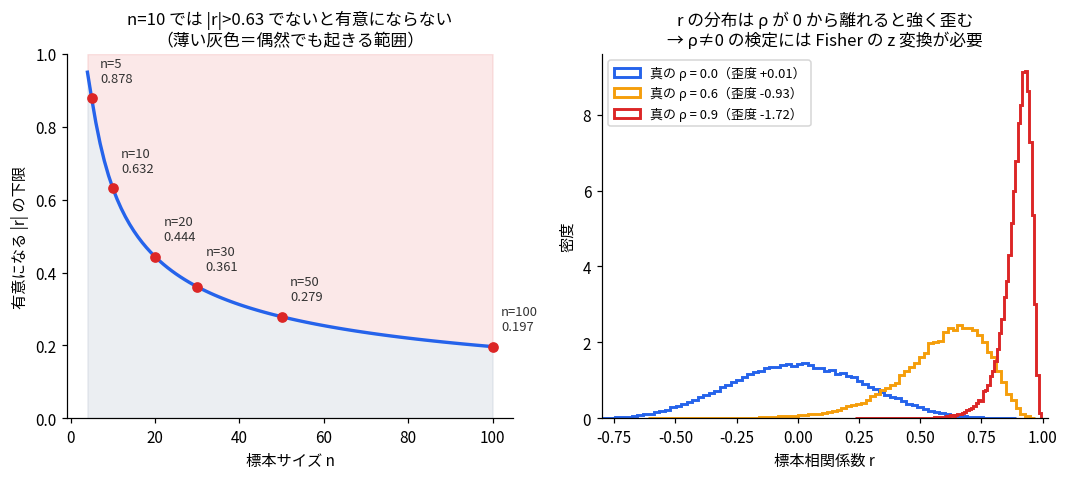
では でないと有意になりません。 なら 0.878 です。理論値と実測の95パーセンタイルは小数第3位まで一致しました( で理論 0.6319、実測 0.6331)。
これは実務で重要だと思いました。 データが10点しかない散布図で が出たとき、それは「相関がある」証拠になりません。偶然でも普通に起きる範囲です。逆に なら で有意になるので、今度は実質的にどうでもいい弱い相関が有意になります。有意性と重要性は別、という前回の話がそのまま出てきます。
ρ ≠ 0 を調べたいときは Fisher の z 変換
「相関が 0.5 より大きいか」を調べたい場合、上の の式は使えません。右のグラフが理由です。 が0から離れると の分布が強く歪みます( で歪度 −1.72)。 には という壁があるので、 が1に近いと分布が壁に押しつけられて歪むわけです。
そこでFisher の z 変換(Fisher's z transformation)を使います。
は を に引き伸ばす関数なので、壁を取り払って歪みを直します。実測でも のとき t検定は 83.70% 棄却してしまう(帰無仮説が なら5%であるべき)のに対し、Fisher の z は 4.99% を保ちました。
これは第4回でやった変数変換が、実務で効く例です。変換の目的が「正規分布に近づける」ことだと分かる、いい具体例でした。
A/Bテストではどれを使うべきか
ここまでの内容を、実務で測る指標の種類ごとに整理しました。
| 測る指標 | 使う検定 | 注意点 |
|---|---|---|
| コンバージョン率・クリック率 | 2標本の比率の差(z検定・プール型) | 割り当てが偏ったらプール必須 |
| 平均購入額・滞在時間 | ウェルチのt検定 | 強く歪むので を各群30以上に |
| 同じユーザーの前後 | 対応のあるt検定 | 期間効果と混ざる危険がある |
| 分散(体験の安定性) | F検定は避ける | 正規性が崩れると使えない |
平均購入額は特に注意が必要です。 購入額の分布は「ほとんど0円、まれに10万円」のような形をしていて、対数正規や指数分布に近い強い歪みがあります。この場合ウェルチでも が小さいと 6.6% 程度ずれます。 を揃えて各群十分に取ることが前提になります。
ただし、検定の選び方より大事なことがある
ここが最後に気づいた点です。ウェルチを既定値にしておけば、検定の選択で生じる誤りは 5% → 6% 程度で止まります。それを怠ると 35% まで行き、運用(覗き見・多重比較)の誤りはさらに上乗せされます。
毎日p値を見て「有意になったら止める」という運用(peeking) をすると、それは何度も検定していることになるので、第一種の誤り率が名目を大きく超えます(何倍になるかは覗く回数と間隔に依存します)。第2回で扱った多重比較の問題そのものです。
つまり優先順位はこうなります。
- 事前にサンプルサイズを決めて、途中で見て止めない(効果:数十%の改善)
- 複数指標を見るなら多重比較の補正をする(効果:数十%の改善)
- ウェルチを使う(効果:数%の改善)
3番目を完璧にやっても、1番目を破っていたら無意味です。今回ウェルチの優位性を細かく測ってきましたが、実務のインパクトの大きさで言えば、そちらのほうがずっと大事だと分かりました。
つまずいたところ
t検定の種類を「統計的に選ぶもの」だと思っていた。 実際にはデータの取り方で決まっています。「対応があるかどうか」は実験設計の時点で確定しているので、解析の段階で選ぶ余地はありません。Excelの1行が何を表しているかを見るという判定法に行き着いてから、迷わなくなりました。
「F検定で等分散を確認」を正しい手順だと信じていた。 多くの入門書に書かれているので疑っていませんでした。実測すると水準が守れないうえ、F検定そのものが正規性に極端に弱い(指数分布で 30.85%)ことが分かりました。前提を確かめる道具が、確かめたい前提より壊れやすい。
対応ありは常に有利だと予測して、外した。 では 32.18% 対 33.70% で対応ありが負けます。自由度を半分にした損が、 で得がゼロのときに残るからです。ペアの取り方に意味があることが前提でした。
「正規性が崩れたらどうなるか」に単一の答えを期待していた。 検定によって正反対でした。平均は で直り、分散は で悪化する。 中心極限定理が守ってくれるかどうかで分かれます。第7回で標本分散とχ²分布を結びつけたときは、それが正規性に完全に依存していることを意識していませんでした。
母比率のSEに を使ってよいと思っていた。 66.82% という数字を見て考えを変えました。帰無仮説が分散まで指定しているので、 で推定し直すのは既知の情報を捨てる行為でした。
この記事の要点
- すべての検定は 「差 ÷ ばらつき」。違うのは分母の見積もり方で、それが自由度を決める
- 自由度 = n −(先に推定したパラメータの個数)。 残差に制約が入るので自由に動ける数が減る
- t検定の使い分けはデータの取り方で決まっている。「1行に2つの数字があるか」で対応の有無が判定できる
- 等分散を仮定したt検定は で 35.08%、逆向きで 0.04%。 が自由度で重みづけされるため向きで逆転する
- ウェルチ常用の代金は ずつで −0.07pt。 実務では既定値にしてよい
- 教科書に等分散版があるのは、手計算で出題される・厳密にt分布に従う・分散分析の土台・事前知識があれば効率的、の4つの理由
- 「F検定で確認してからt検定」は F検定自体が指数分布で 30.85% まで壊れるので土台が怪しい
- 平均の検定はCLTに守られて n で直る。分散の検定は守られておらず n で悪化する(対数正規のχ²検定で 65.65%)
- 対応のあるt検定の利益は SE が 倍になること。 では自由度を損するだけ
- 母比率は帰無仮説の で SE を作る。 を使うと 66.82% まで壊れる。2標本ならプールする
- では でないと有意にならない。 の検定には Fisher の z 変換
- A/Bテストでは検定の選択より「途中で見て止めない」ことのほうが影響が大きい
次回は第12章の一般の分布に関する検定法です。今回は「正規分布を前提とした検定」を並べましたが、その前提が崩れたときにどうするかを正面から扱う章になります。今回「分散の検定は正規性に守られていない」と分かったので、正規性そのものを検定する適合度検定が出てくるはずです。