分散分析と実験計画法:ダミー変数の重回帰とF値が一致した【第20回】
はじめに
第20章は分散分析と実験計画法です。
この回を書く前、私は分散分析を「3群以上の平均を比べる検定」くらいの理解で止まっていました。ところが今回いちばん驚いたのは、分散分析が重回帰分析とまったく同じ計算だったことです。「似ている」という話ではありません。同じデータで両方を計算したら、F値が小数第6位まで一致しました。
もうひとつ引っかかっていたのが名前です。やりたいことは平均の比較なのに、なぜ「分散分析」なのか。ここも計算してみると納得できました。
そして直交表。これは正直、最初に読んだときまったく意味がわかりませんでした。「1と2しか書いていない表なのに、なぜ内積が0という話になるのか」。この記事では、そこも4行の小さな表から順に解きほぐしていきます。
いつものように、出てくる数値はすべて自分で計算して検算しています。特に前半は9個のデータだけで全部の式を追えるようにしたので、電卓なしで確かめられます。
この回で扱う用語
先に略語と用語を整理しておきます。
| 用語 | 読み・意味 |
|---|---|
| ANOVA | Analysis of Variance=分散分析。「分散の分析」 |
| Sum of Squares=平方和。ばらつきの大きさ | |
| Mean Square=平均平方。平方和を自由度で割ったもの | |
| / / | 全体平方和 / 群間平方和 / 群内平方和 |
| FWER | Family-Wise Error Rate=真の帰無仮説を1つでも棄却する確率 |
| FDR | False Discovery Rate=有意と言った中の誤りの割合の期待値 |
| イータ2乗。効果の大きさの指標。一元配置なら回帰の と同じ量 | |
| 水準 | 要因の取りうる値(「図あり」「図なし」など) |
| 処理 | 実験で割り付ける条件のこと |
| 交絡 | こうらく。2つの効果が同じ場所に乗って区別できない状態 |
なぜ3群以上でt検定を繰り返してはいけないのか
まず動機から
3つの案を比べたいとき、素直に思いつくのは「A対B、A対C、B対Cをそれぞれt検定する」という手順です。これが壊れます。
確かめ方は単純で、本当は3群まったく同じデータを作り、「1つでも有意なら差がある」と判定したときの誤り率を数えます。各群6個、40,000回のシミュレーションです。
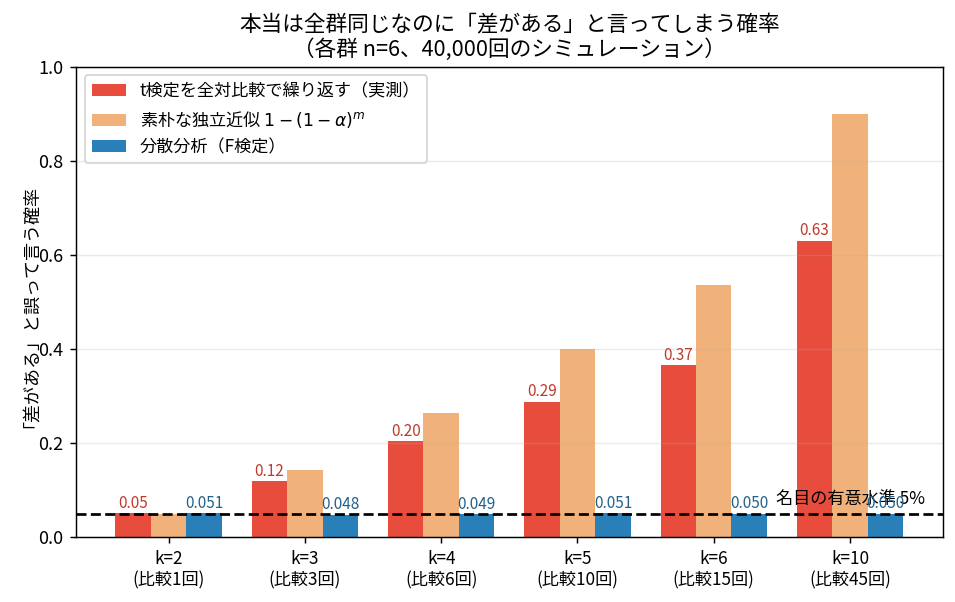
| 群数 | 比較数 | t検定を繰り返す | 素朴な | 分散分析 F |
|---|---|---|---|---|
| 2 | 1 | 0.0508 | 0.0500 | 0.0508 |
| 3 | 3 | 0.1192 | 0.1426 | 0.0483 |
| 4 | 6 | 0.2042 | 0.2649 | 0.0487 |
| 5 | 10 | 0.2879 | 0.4013 | 0.0508 |
| 6 | 15 | 0.3661 | 0.5367 | 0.0499 |
| 10 | 45 | 0.6298 | 0.9006 | 0.0497 |
10群なら「本当は全部同じなのに、6割以上の確率でどこかに差を見つけてしまう」ことになります。第12回で扱った多重比較の問題と同じものです。
この表で私が面白いと思ったのは の行です。t検定と分散分析の値が 0.0508 で完全に一致しています。 これは偶然ではなく だからで、分散分析は2群のときt検定そのものになります。
「積み重なる」のはリスクではなくセーフ確率
ここは私が最初に誤解していた点です。「毎回5%のリスクを取るから、リスクが掛け算で積み重なる」と考えていました。正確には、掛け算になるのは「全部セーフ」のほうです。
20面ダイスを振って1が出たら誤りと考えます。 なら比較は3回。
もし3つの比較が独立なら、名目5%が約14%、3倍近くに膨らむ計算になります。ただし実際の対比較は独立ではないので、これは過大評価です(あとで実測 0.1090 と比べます)。
なぜセーフ側を掛け算するかというと、セーフはANDの関係だからです。「1回目もセーフ、かつ2回目もセーフ、かつ3回目もセーフ」なので掛け算になる。一方「1つでも誤る」はORなので素直な掛け算にならず、ANDに裏返してから1から引きます。
もし誤りを直接足すと で、正しい値 0.142625 より大きくなります。「2つ同時に誤る場合」を二重に数えるからです。 が45まで増えると足し算は 2.25 という確率としてありえない値になります。
| 計算 | での値 | 性質 |
|---|---|---|
| 足し算 | 0.1500 | 最も粗い上限。ボンフェローニ法の根拠 |
| 積 | 0.1426 | 検定が独立なら正確 |
| 実測(相関あり) | 0.1090 | 真の値(この行は各群 ・誤差自由度6) |
| 分散分析 | 0.0491 | 問いを1つに束ねるので5%を保つ |
実測の行だけ設定を添えたのは、この値が群サイズで動くからです。あとで手計算に使う各群3個の設定では 0.109 ですが、冒頭の表(各群6個)では 0.119 でした。自分で確かめると 0.108(=3)→ 0.116(=6)→ 0.122(=100)と、誤差自由度が増えるにつれて上がります。上限側の2つ(0.1500 と 0.1426)が実測を上回るという関係は、どの設定でも変わりません。
ボンフェローニ法が という素朴な割り算で済むのは、この足し算のほうを使っているからです。足し算は上振れの近似なので、ボンフェローニは常に安全側に外れます。
3つの比較は独立ではない
上の表で、積の計算 0.1426 より実測 0.1090 が小さいのが気になります。理由は3つの比較が独立でないからです。
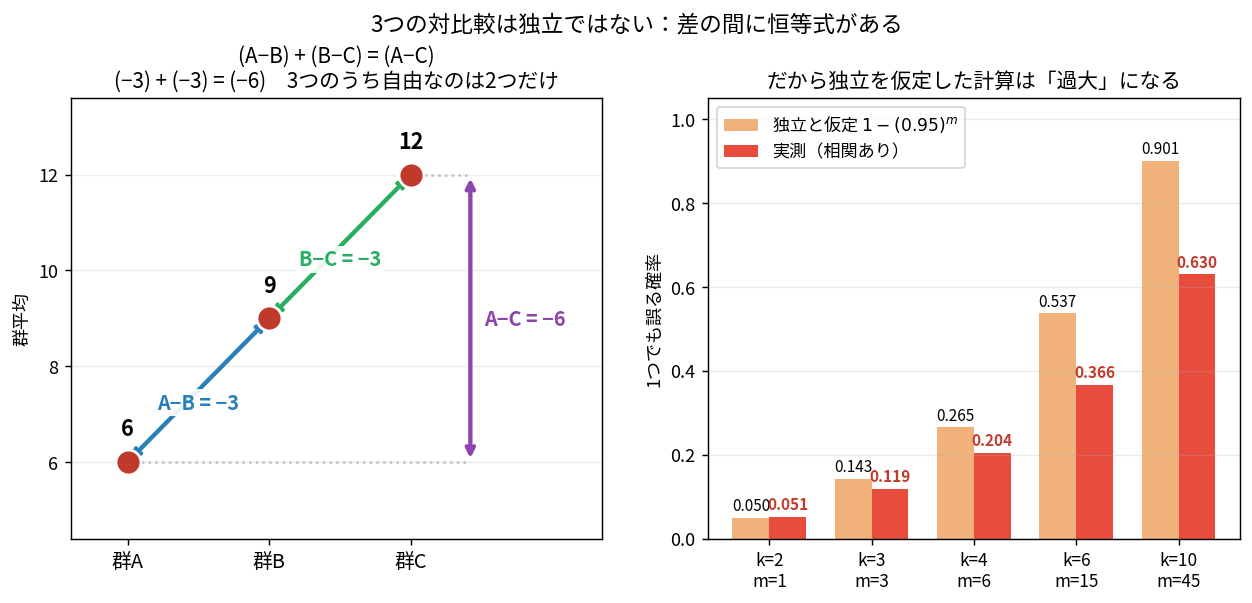
3つの差の間には恒等式があります。
実際に群平均 6, 9, 12 で計算すると 。2つ決まれば3つ目は自動的に決まるので、線形独立なのは2本だけです。
そしてこの 2 は群間平方和の自由度 とぴったり同じです。ここが分散分析の設計思想につながります。3つの比較を別々に検定するのは、2次元の情報を3回に分けて聞いているので無駄がある。それなら 自由度をまとめて1回で検定すればいい。それが F の分子の自由度が になっている理由です。「検定回数を1回に減らす」のは恣意的な工夫ではなく、情報の次元に合わせた自然な設計だったわけです。
ただし混同しやすい点があるので分けて書きます。線形独立と統計的独立は別の話です。 線形独立に選んだ2本( と )も、統計的には独立ではありません。実測すると相関は (理論値 )でした。 と なら です。
だから「独立な検定が2本」と考えて としても、実測 0.1090 には合いません。3つの 統計量は共通の を分母に持つので、そもそも完全に独立にはなりません。
ではなぜ積の計算が上振れの上限になるのか。これはシダックの不等式という非自明な事実によります。平均0の多変量正規分布では、相関があっても(負の相関が混じっていても)「全部が閾値以内に収まる確率」が各確率の積以上になる、という性質です。だから積で計算した「全部セーフ」は実際より小さめに出て、その補集合である誤り率は大きめに出ます。
9個のデータで分散分析を手計算する
数字が大きいと「なんとなく」で終わってしまうので、3群 × 各3個 = 9個に縮めて全部の式に数値を入れていきます。
データ
群A:  4,  6,  8   → 合計 18, 平均 18/3 = 6
群B:  7,  9, 11   → 合計 27, 平均 27/3 = 9
群C: 10, 12, 14   → 合計 36, 平均 36/3 = 12

全体: 合計 81, 個数 9, 全体平均 81/9 = 9
群の中のばらつきは3群とも完全に同じ(どれも平均から )にしてあります。違うのは群平均が3ずつずれている点だけです。
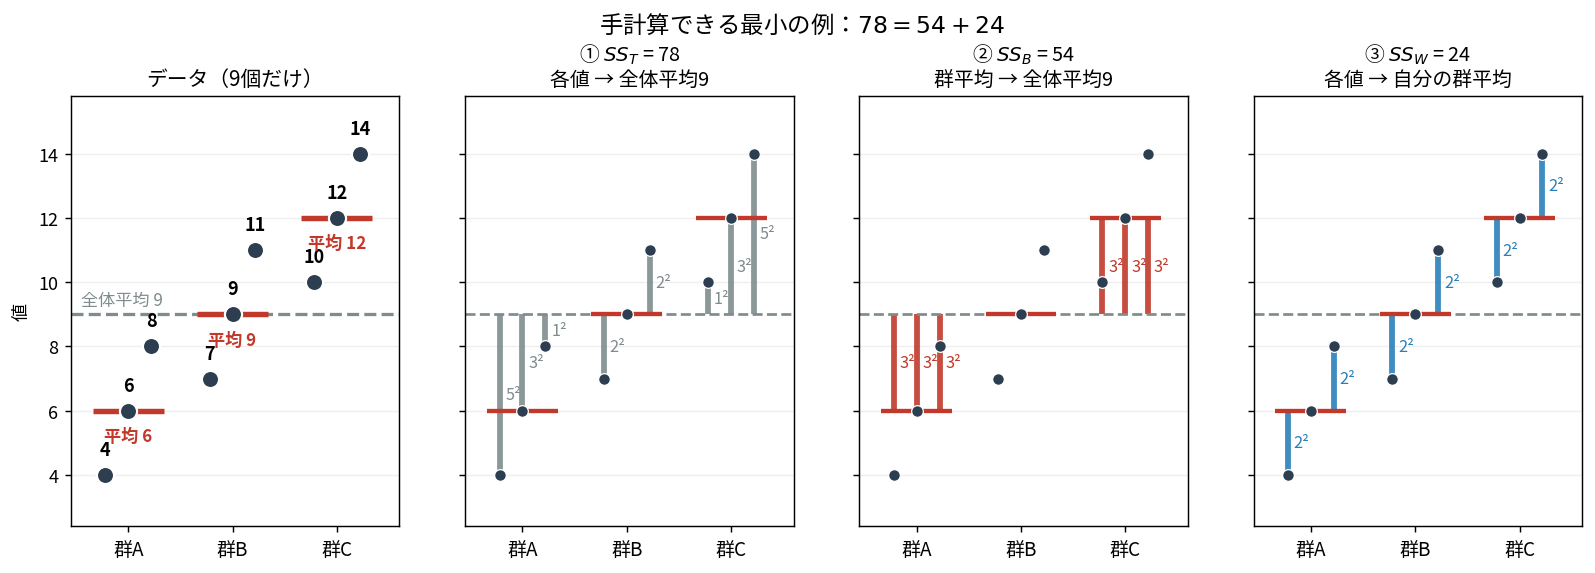
全体平方和:各値から全体平均9までのずれ
 (4−9)² = (−5)² = 25
 (6−9)² = (−3)² =  9
 (8−9)² = (−1)² =  1
 (7−9)² = (−2)² =  4
 (9−9)² = ( 0)² =  0
(11−9)² = (+2)² =  4
(10−9)² = (+1)² =  1
(12−9)² = (+3)² =  9
(14−9)² = (+5)² = 25
                 ────
                   78
群間平方和:群平均から全体平均までのずれ(× 各群の個数)
 群A: (6 − 9)² = (−3)² = 9
 群B: (9 − 9)² = ( 0)² = 0
 群C: (12− 9)² = (+3)² = 9
                        ──
                        18

SS_B = n × 18 = 3 × 18 = 54
ここでなぜ を掛けるのかが最初のつまずきどころでした。群平均は3つしかないのに、分解しているのは9個のデータのばらつきだからです。群Aの3個はどれも「群平均が全体平均から ずれている」分を共有しているので、 を3回数える必要があります。
群内平方和:各値から自分の群平均までのずれ
 群A: (4−6)²  + (6−6)²  + (8−6)²   = 4 + 0 + 4 = 8
 群B: (7−9)²  + (9−9)²  + (11−9)²  = 4 + 0 + 4 = 8
 群C: (10−12)²+ (12−12)²+ (14−12)² = 4 + 0 + 4 = 8
                                              ──
                                              24
検算すると で合います。
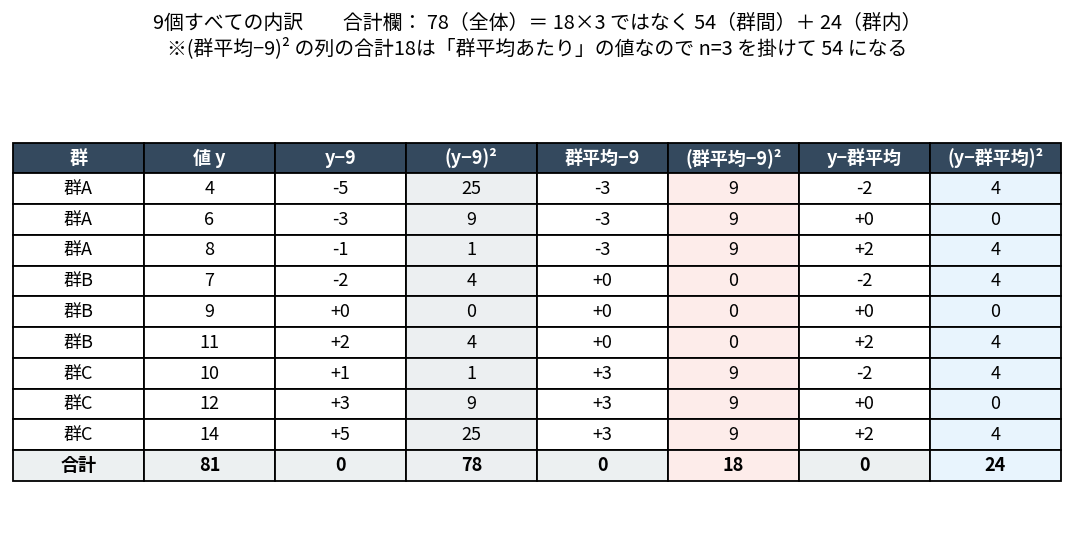
この表で注目したいのは、ずれそのものの列(3列目・5列目・7列目)の合計がどれも 0 になっていることです。ずれは打ち消し合うので、そのままでは「ばらつきの大きさ」になりません。2乗した列を足すと 78 と 24 になります。
そして各行で が成り立っています。1行目は 、9行目は 。ずれのレベルでは単なる足し算です。
1点だけ取り出すと恒等式の正体が見える
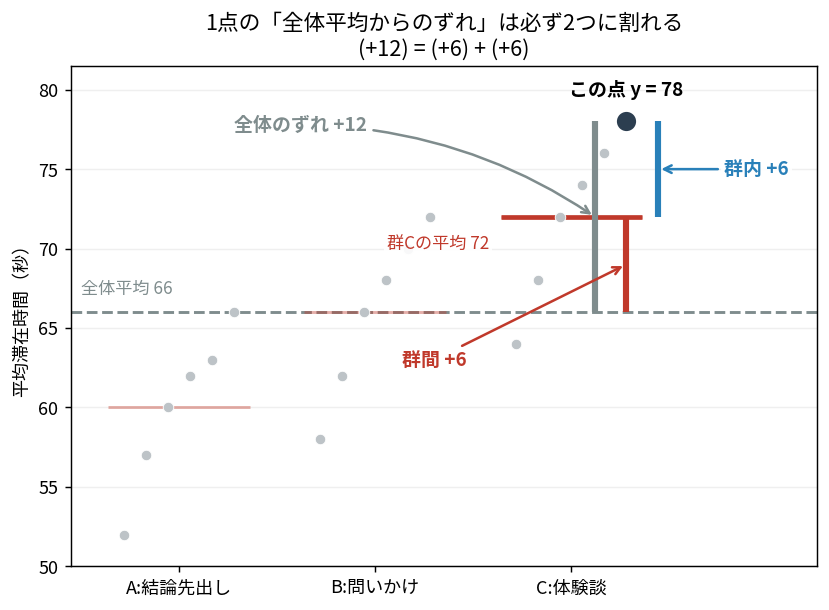
別のデータでの図ですが、構造は同じです。ある点の「全体平均からのずれ」は必ず「群平均が全体平均からどれだけ離れているか」と「その点が群平均からどれだけ離れているか」に分かれます。
これを全点でやって2乗して足すと平方和の分解になります。
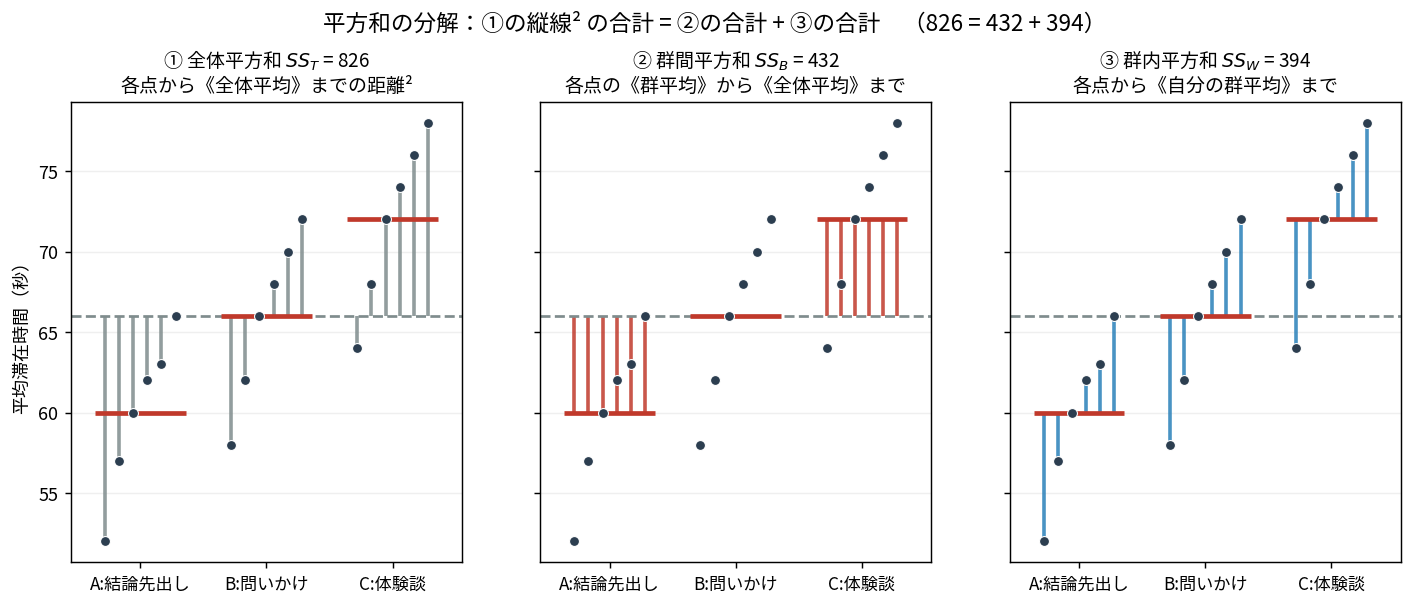
2乗する前は打ち消し合うのに、2乗して足すとぴったり合うのが面白いところです。理由は交差項が厳密に0になるからで、
各群の中で になるので、群ごとに括り出すと必ず消えます。手計算例だと群Aで ですね。
分散分析表を埋める
変動要因   平方和 SS   自由度 df        平均平方 MS      F値
─────────────────────────────────────────────────────
群間          54     k−1 = 3−1 = 2   54/2 = 27      27/4 = 6.75
群内          24     N−k = 9−3 = 6   24/6 =  4
─────────────────────────────────────────────────────
全体          78     N−1 = 9−1 = 8
自由度も数えて確認します。
群間 df = 2:群平均は3つあるが全体平均9が決まっているので、
            2つ決まれば残りは自動的に決まる
群内 df = 6:各群で3個のうち2個が自由(群平均が決まっているため)
            2 × 3群 = 6
全体 df = 8:9個のうち8個が自由
検算:2 + 6 = 8
の上側5%点は 5.1433 なので、 で有意()です。
という数字の意味も確かめておきます。各群の不偏分散はどれも
3群とも4なので平均も4。つまり は各群の分散を(自由度で重みづけて)平均したものです。一方 は群平均 6, 9, 12 の不偏分散 に を掛けた値です。
なぜ「平均の比較」なのに「分散」分析なのか
名前が噛み合わない感じは正しくて、答えは「やりたいことは平均の比較だが、道具として使うのは分散」です。より正確に言うと、 を2通りに推定して、その2つが食い違うかを見る検定です。
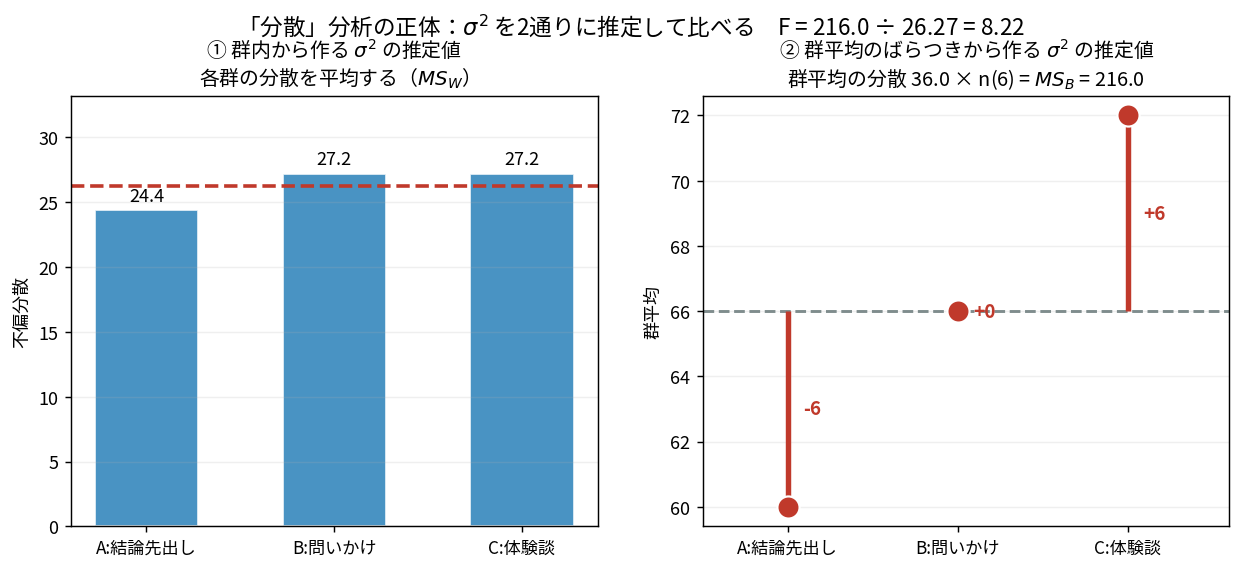
の推定値が2通り作れます。
群内から作る():各群の中のばらつきから推定します。群平均がどこにあろうと関係なく測れるので、これはいつでも の正しい推定値です。
群平均のばらつきから作る():群平均が3つあるので、その散らばりからも推定できます。 が真なら の分散は なので、 を掛ければ の推定になります。
この2つが本当に同じものを測っているのか、シミュレーションで確かめました。
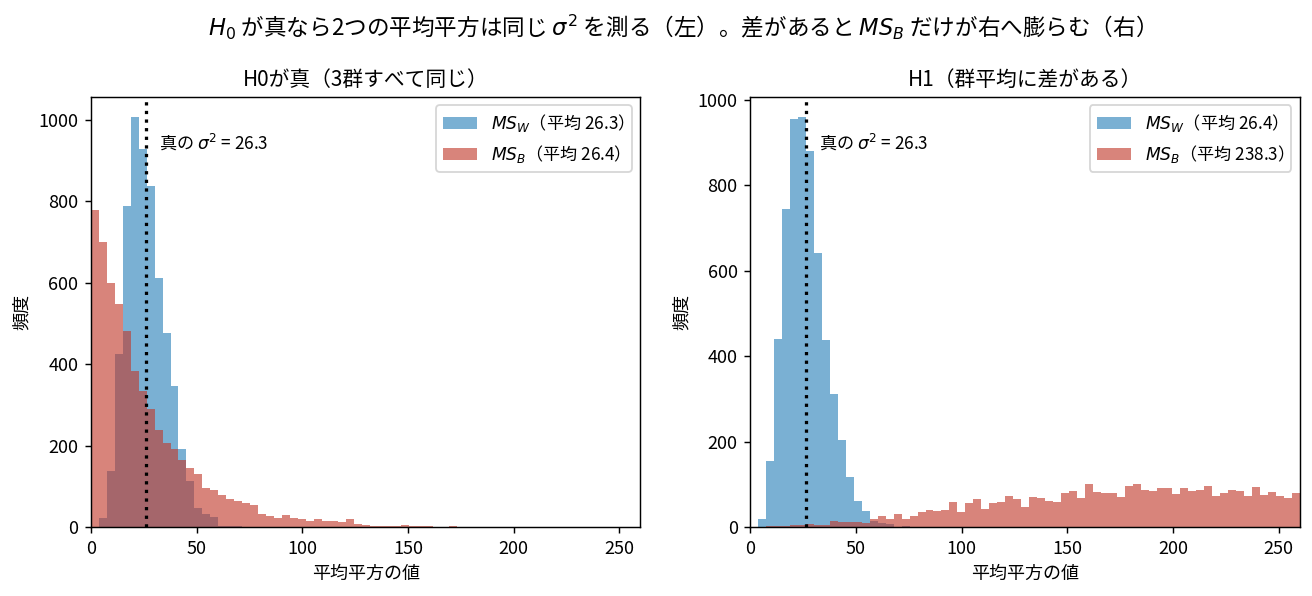
が真のとき の平均は 26.43、 の平均は 26.33 で、真の をどちらも当てています。ただし の分布のほうが横に広いのが目につきます。自由度が2しかないので推定が粗いわけです。
群平均に差があると は 26.44 のまま動かないのに だけ 238 に膨らみます。理論的には、群 の効果を (定義から )と書くと
平均の差は にだけ現れるので、比を取れば平均の差が検出できます。
なおこの式と先の は、どちらも各群のサイズが等しい場合の形です。一般には が群ごとの になって和の中に入り、、 となります。
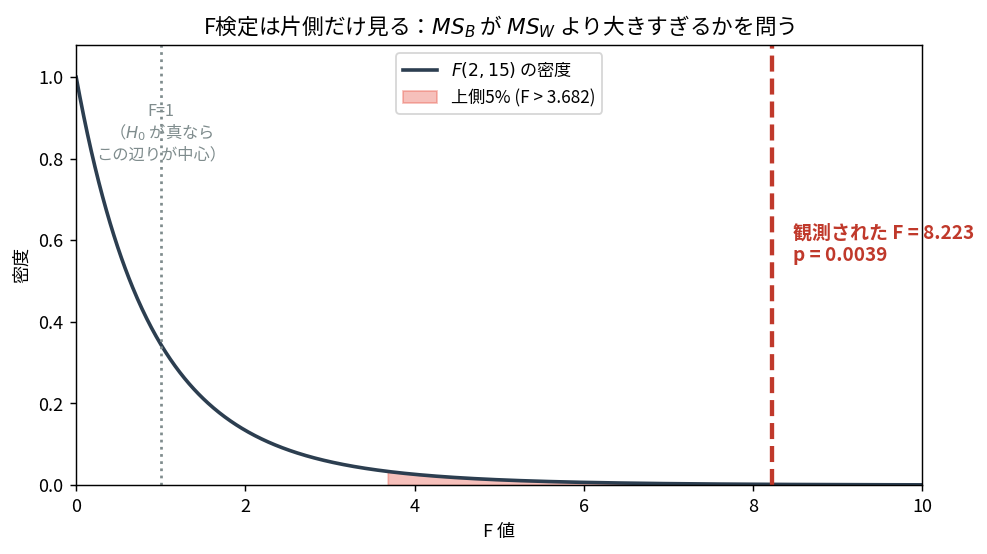
だから検定統計量は で、 が真なら1のあたりが中心になります。片側だけ見るのは、平均に差があると だけが大きくなる方向にしか動かないからです。第7回で見た「F分布は分散の比の分布」がそのまま使えます。
名前の由来をまとめると、「分散を分析する」というより「ばらつき(平方和)を要因ごとに分解する」ことにあります。英語の analysis of variance も、variance を分解するという意味で読むと納得しやすいです。
群平均が同じでも結論は変わる
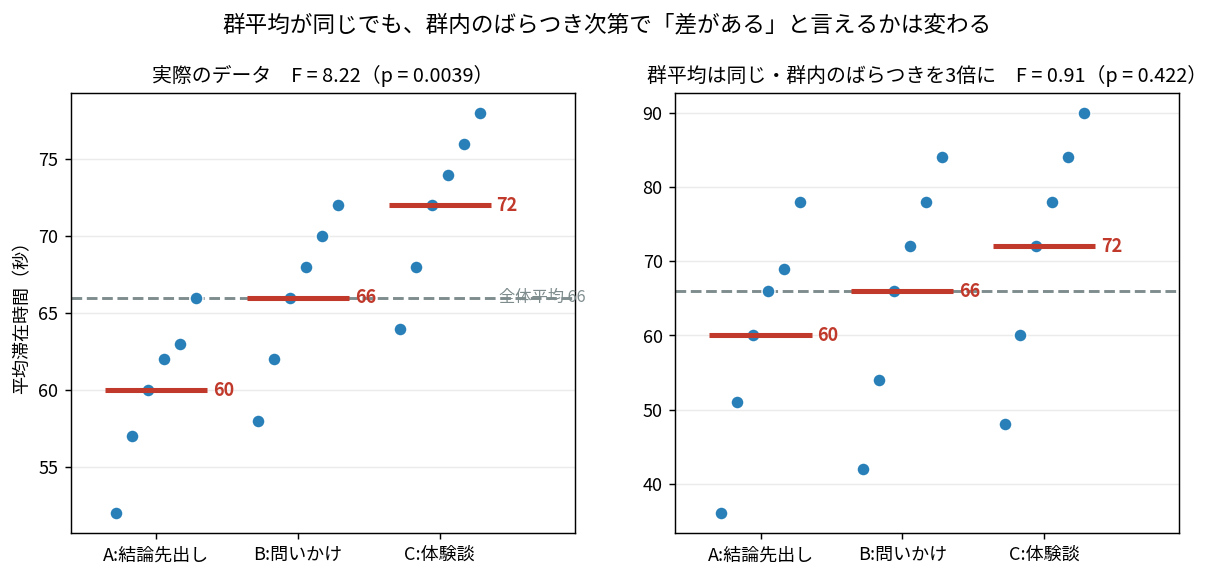
左右で群平均(赤い横線)は 60/66/72 とまったく同じです。違うのは群内のばらつきだけ。左は ()で有意ですが、右はばらつきを3倍にしただけで ()になり有意でなくなります。
「平均の差」だけ見ても結論は決まらず、差をばらつきで割った比が必要だということです。
分散分析はダミー変数の重回帰と同じ計算だった
ここが今回いちばんの発見でした。「同じだと聞いた」を確かめるために、同じデータで両方を計算しました。
使うデータは滞在時間の例(3群 × 各6個、群平均 60/66/72)です。
対応表
| 量 | 分散分析での呼び名 | 重回帰での呼び名 | 値 |
|---|---|---|---|
| 全体のばらつき | (全体平方和) | (全変動) | 826.0000 |
| 説明できた分 | (群間平方和) | (回帰変動) | 432.0000 |
| 説明できない分 | (群内平方和) | (残差平方和) | 394.0000 |
| 比率 | (イータ2乗) | (決定係数) | 0.5230 |
| 検定統計量 | F(群間MS ÷ 群内MS) | F(モデル全体の有意性) | 8.223350 |
| 自由度 | (2, 15) | ||
| p値 | 同一 | 同一 | 0.00388035 |
F値が小数第6位まで一致しました。 「似ている」ではなく文字どおり同じ計算です。
設計行列を見る
     切片  D_B  D_C     y        推定された係数 β
群A [  1    0    0 ]   52..66     β0 = 60 ← 基準群Aの平均そのもの
群B [  1    1    0 ]   58..72     β1 =  6 ← B平均 − A平均
群C [  1    0    1 ]   64..78     β2 = 12 ← C平均 − A平均
「Aを基準にして、Bならこの列が1、Cならこの列が1」というダミー変数を2本作るだけです。係数の意味もきれいに出ます。切片は基準群の平均、ダミーの係数は基準群との差。第16回のダミー変数の話がそのまま効いています。
コーディングを変えても F は変わらない
ダミーの作り方は何通りかあります。試したのは3つです。
| コーディング | 係数の意味 | F値 |
|---|---|---|
| 基準セル方式(treatment) | 切片=A平均60、係数=Aとの差(6, 12) | 8.223350 |
| 効果コーディング(sum-to-zero) | 切片=総平均66、係数=各群の効果(−6, 0) | 8.223350 |
| 切片なし・ダミー3本 | 係数=群平均そのもの(60, 66, 72) | 8.223350 |
どれも当てはめ値 が「その点の属する群の平均」になる点は共通なので、 が一致します。係数の解釈は変わるがモデルは同じということです。
ただし3つ目には注意が必要でした。切片なしモデルで統計ソフトが自動で出す「モデル全体のF」は (3群の平均がすべて0)を検定する別物で、このデータだと 1000.5 という値になります。滞在時間が60秒台なので「平均が0ではない」ことを検定しているだけです。 を得るには (群平均が等しい)を明示して検定する必要があります。
なお切片とダミー3本を全部入れると列が線形従属になりランク落ちします(ランク3、列数4)。いわゆるダミー変数の罠です。 群なら 本にするか切片を外します。
この見方が手に入ると、分散分析表は「ダミー変数だけの重回帰の出力を並べ替えたもの」として読めます。新しい理論ではなく、第16回でやったことの特殊ケースです。
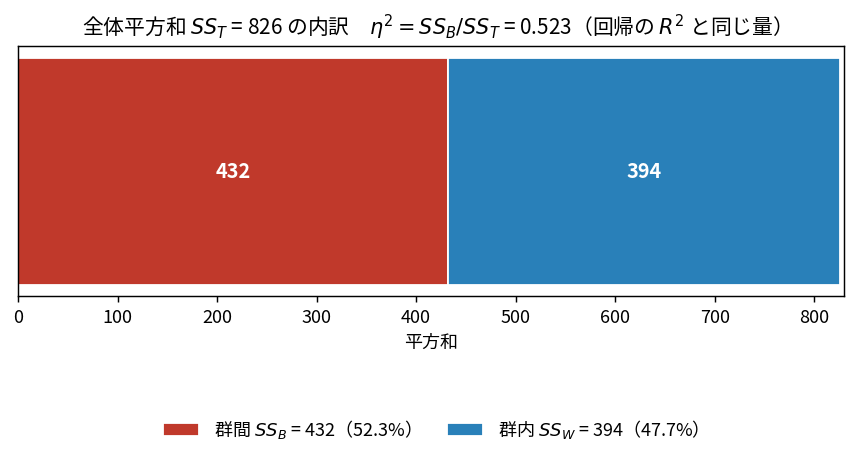
比率にすると 。これは重回帰の決定係数 とまったく同じ量です。分野によって呼び名が違うだけでした。
二元配置分散分析と交互作用
交互作用は「線の平行さ」で見る
要因が2つあるときは二元配置になります。ここで出てくる交互作用が、私は長らくピンときていませんでした。「Aの効果がBの水準によって変わる」という説明だけでは像が結ばなかったのですが、図を並べたら一気に分かりました。
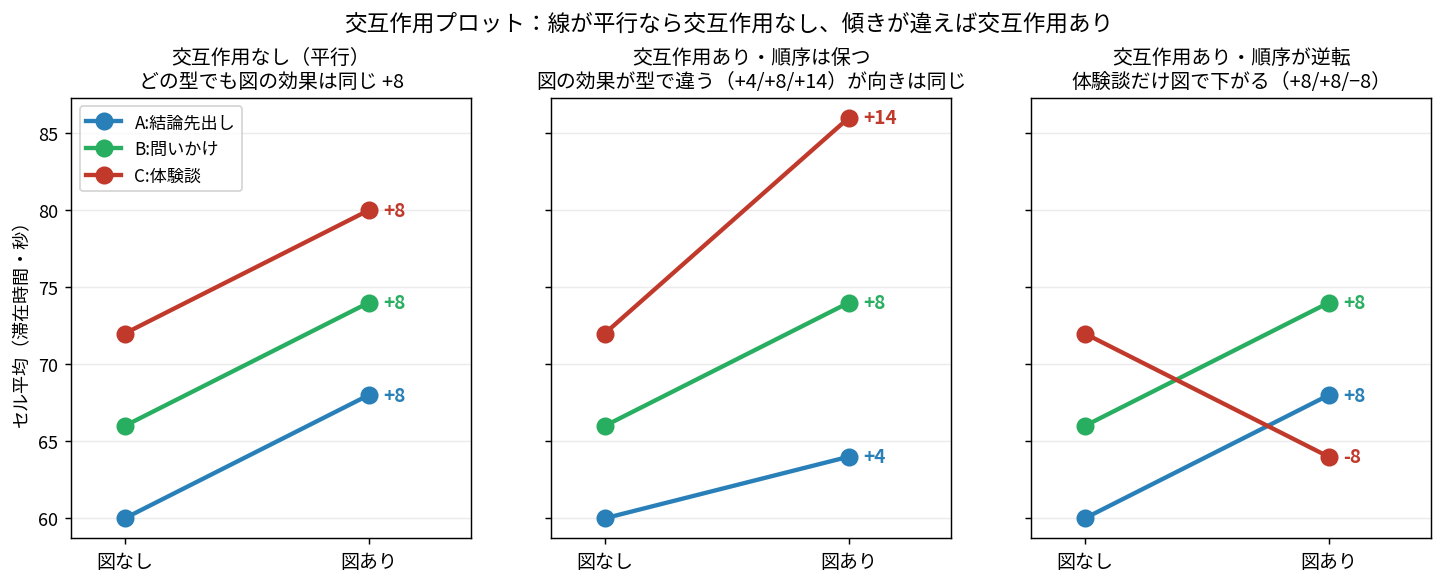
横軸に一方の要因、線の色で他方の要因を取ったプロット(交互作用プロット)です。
左:どの型でも「図あり」の効果は 。3本が平行なので交互作用なし。 中央:効果が と型によって違うので交互作用あり。ただし全部プラスなので順序は保たれています(相乗効果型)。 右:体験談だけ図で下がる()。線が交差する順序逆転型で、これがいちばん厄介なパターンです。
交互作用の定義は「セル平均から、行の効果と列の効果と総平均で説明できる分を引いた残り」です。
ここで記号の中身を明示しておきます。 や は平均そのものではなく効果(総平均からの偏差)です。
制約は 、、そして については行和・列和がどちらも0()です。 を「行平均」と読むと式が壊れるので、ここは注意が必要でした。
右のケースで数値を出すと が と残り、左のケースでは全部0になります。 に行和・列和の制約が入るので、自由度は になります。
なお図で「図ありの効果は 」と書いたのは2水準の差(単純効果)で、効果 の定義に沿えば です(総平均からの偏差なので差の半分)。「効果」という言葉が2つの意味で使われやすいところです。
交互作用があると主効果が消える
実務でいちばん怖いのがこれでした。
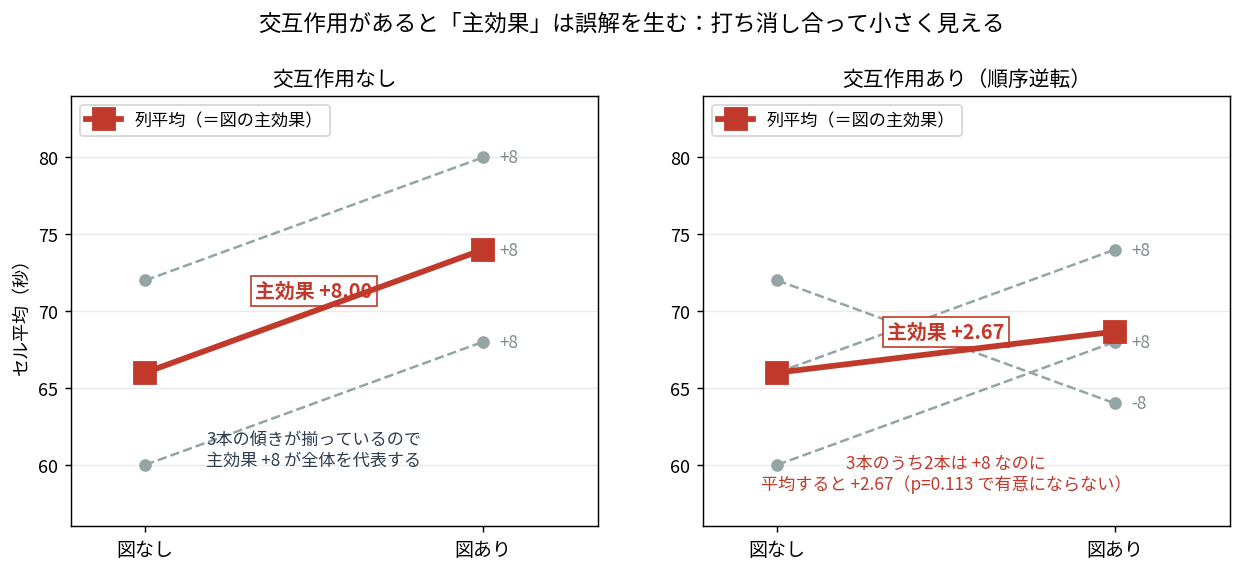
右パネルを見てください。3つの型のうち2つで図は の効果があるのに、平均すると になり、主効果の検定は で有意になりません。
ここで「図には効果がない」と結論すると完全な誤読です。交互作用が有意なら、主効果は単独で解釈してはいけないという原則の実演になっています。
| 変動要因 | 交互作用なしデータ | 交互作用ありデータ |
|---|---|---|
| 導入文の型(主効果A) | F=18.78, p=0.00004 有意 | F=4.87, p=0.0204 有意 |
| 図の有無(主効果B) | F=25.04, p=0.00009 有意 | F=2.78, p=0.1126 有意でない |
| 型 × 図(交互作用) | F=0.00, p=1.0000 | F=11.13, p=0.00071 有意 |
| 誤差 | SS=276.0, df=18 | SS=276.0, df=18 |
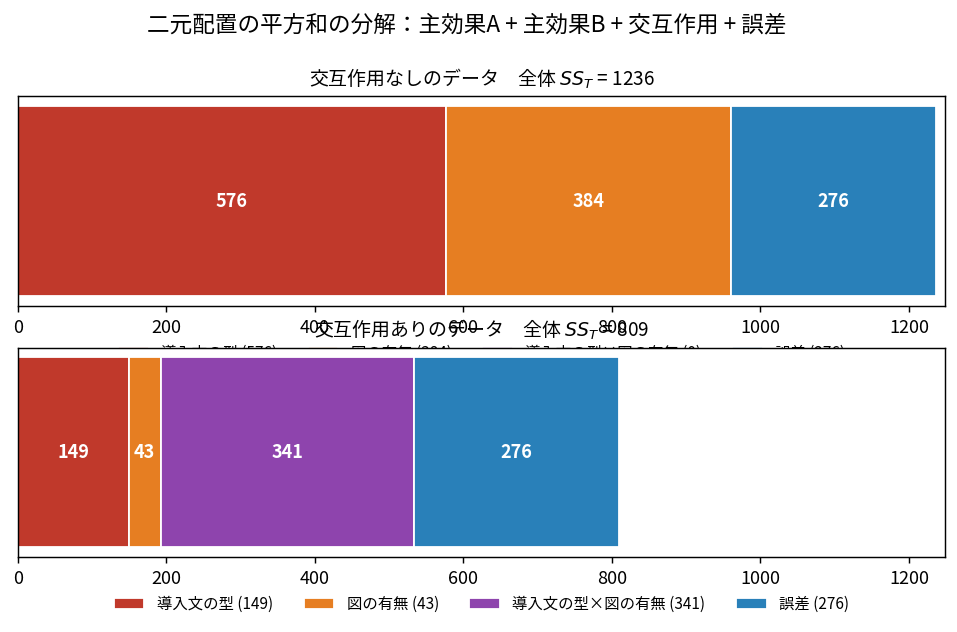
二元配置でも平方和は足し算で分解します。上(交互作用なし)は交互作用の帯が幅0で消えていて、下(交互作用あり)は交互作用が 341.3 と最大の成分になっています。
この例では が上のケースの と一致しますが、これは単純効果の2乗和が と で等しくなるように作ったデータ固有の事情です。一般に「交互作用が増えた分だけ主効果が減る」わけではなく、 と は独立に動きます。
交互作用の検定はモデル比較そのもの
ここでも重回帰との一致が成立します。ダミーの積の項(、)を足したモデルと足さないモデルの残差平方和を比べると、
分散分析表の交互作用の F と小数第6位まで一致しました。交互作用の検定=積の項を入れるか否かのモデル比較です。
係数の読み方も確認しておきます。
切片(A・図なし)   +60.000
型B               +6.000
型C              +12.000
図あり            +8.000
型B×図あり        +0.000
型C×図あり       −16.000

→ 図の効果は A で +8.0、B で +8.0、C で −8.0
「図あり」の係数 は基準の型Aでの効果でしかありません。交互作用があると主効果を単独で読めないことが、係数の形からも見えます。
繰り返しのない二元配置
各セルに1個しかデータがないと交互作用が推定できません。理由は自由度の勘定です。
a=3, b=2 のとき
 r=1: 全体df=5   A=2  B=1  A×B=2  誤差=0  ← 分母が作れない
 r=2: 全体df=11  A=2  B=1  A×B=2  誤差=6
 r=4: 全体df=23  A=2  B=1  A×B=2  誤差=18
セルに1個だと「セル平均=観測値そのもの」なので、セル内のばらつき(純粋な誤差)が測れません。だから交互作用を誤差の代わりに使う(=交互作用は無いと仮定する)ことになります。交互作用が実在すると分母が膨らんで主効果の検出力が落ちる、という代償つきです。
多重比較法の使い分け
全部を1つの尺度で並べる
テューキー・ダネット・シェッフェと、第12回で扱ったボンフェローニ・ホルム・BH法。全部を比べるために、それぞれの臨界値を「 がこの値を超えたら有意」の形に換算しました。、各群 、誤差自由度15、 の設定です。
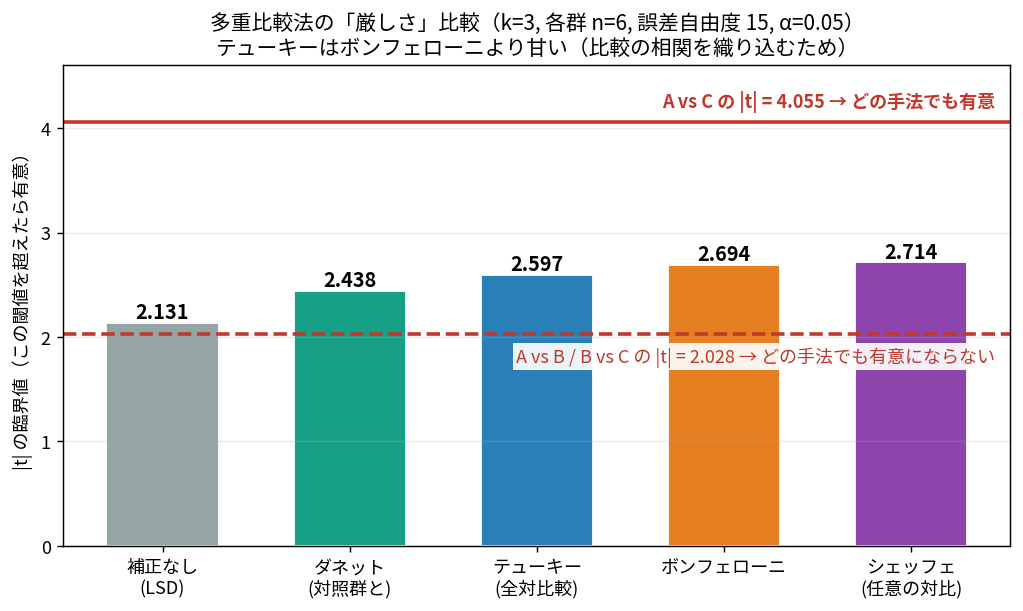
補正なし(LSD)      : t_0.975(15)                        = 2.1314
ダネット(対照群と)  : 等相関(ρ=0.5)多変量tの上側5%点      = 2.4377
テューキー(全対比較): q_0.95(3,15)/√2 = 3.6734/1.41421   = 2.5975
ボンフェローニ       : t_(1−0.05/6)(15)                    = 2.6937
シェッフェ(任意の対比): √(2 × F_0.95(2,15)) = √(2×3.6823) = 2.7138
ここで意外だったのが、テューキーがボンフェローニより甘い(2.597 < 2.694)ことです。理由は前半で見た「対比較には相関がある」を正しく織り込んでいるから。
ボンフェローニは逆に相関を一切使いません。どんな依存構造でも成り立つ最も粗い上限()を採るので、相関を織り込むテューキーには必ず損をします。前半で出てきた「足し算 」がまさにこれです。なお「独立を仮定した式」は のほうで、これを使う補正はシダック補正と呼ばれ、ボンフェローニとは別物です。
6手法の対比表
| 手法 | 何を守るか | 比較の対象 | 臨界値の作り方 | 使いどき |
|---|---|---|---|---|
| テューキー(Tukey HSD) | FWER | 全対比較 本 | スチューデント化範囲分布 | 全対比較の第一候補。等分散・各群同数が前提(不等なら Tukey-Kramer) |
| ダネット(Dunnett) | FWER | 対照群との比較 本のみ | 等相関多変量tの分布。対照群と各処理群が同数なら (配分比で変わる) | 対照群があるとき。比較本数が減るので検出力が上がる |
| シェッフェ(Scheffé) | FWER | 任意の対比(無限個) | データを見てから対比を思いつくとき。対比較だけなら不利 | |
| ボンフェローニ | FWER | 任意の 個(事前に決める) | 汎用。相関を無視するので保守的 | |
| ホルム | FWER | 任意の 個 | p値を小さい順に と比較 | ボンフェローニの上位互換(必ず同等以上の検出力) |
| BH法(Benjamini-Hochberg) | FDR(別の基準) | 任意の 個 | p値を小さい順に と比較 | 探索的に大量の比較をするとき。FWERは守らない |
第12回で扱った3手法との違いは「分散分析の構造を使うかどうか」です。テューキー・ダネット・シェッフェは群構造と共通の を前提に、比較同士の相関まで織り込んだ専用の分布を使います。だから鋭い。一方ボンフェローニ・ホルム・BHはp値の列だけを見る汎用の道具で、検定の中身を問いません(だから分散分析以外でも使える)。
手計算例での判定
9個のデータ(、、誤差自由度6)で全手法を計算しました。
補正なし     : t_0.975(6)                          = 2.4469
テューキー   : q_0.95(3,6)/√2 = 4.3392/1.41421     = 3.0683
シェッフェ   : √(2 × F_0.95(2,6)) = √(2×5.1433)    = 3.2073
ボンフェローニ: t_0.991667(6)                       = 3.2875
| 比較 | 差 | 補正なし | テューキー | シェッフェ | ボンフェローニ | |
|---|---|---|---|---|---|---|
| A vs B | −3 | 1.8371 | なし | なし | なし | なし |
| A vs C | −6 | 3.6742 | あり | あり | あり | あり |
| B vs C | −3 | 1.8371 | なし | なし | なし | なし |
分散分析は で有意なのに、特定できるのは A vs C だけです。隣り合う群(差が3)は検出できません。「全体としては差があるが、どのペアかは言い切れない」という状態は普通に起こります。矛盾ではなく、問いが違うから答えも違うだけです。
臨界値の順序は状況で入れ替わる
ここは自分で計算して初めて気づいた点です。上の手計算例ではボンフェローニ(3.2875)がシェッフェ(3.2073)より厳しくなっています。 の例とは順序が逆です。
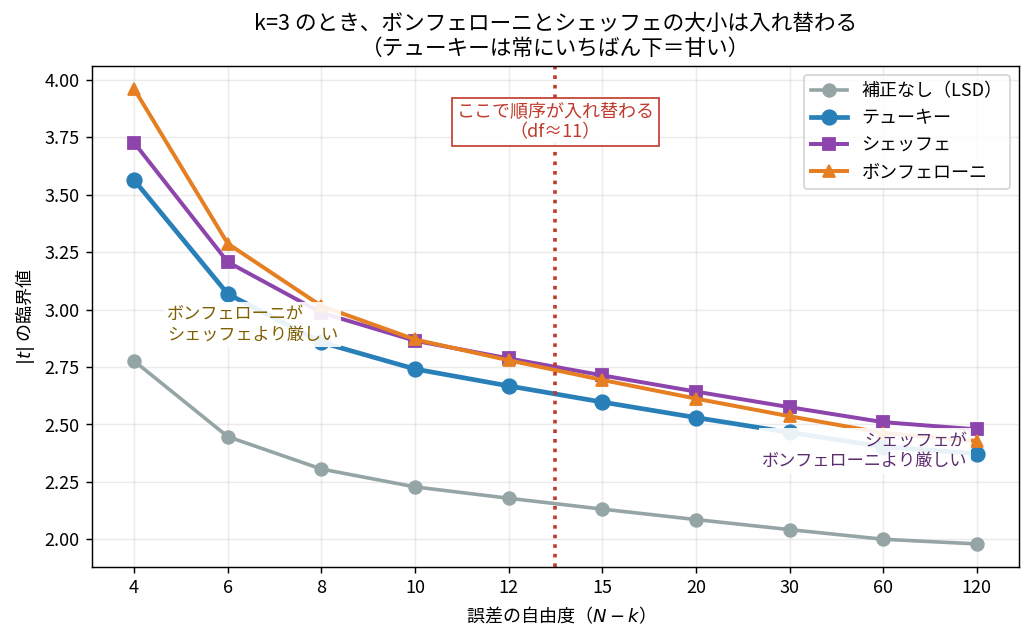
| 誤差自由度 | テューキー | シェッフェ | ボンフェローニ | 大小関係 |
|---|---|---|---|---|
| 4 | 3.5640 | 3.7267 | 3.9608 | シェッフェ < ボンフェローニ |
| 6 | 3.0683 | 3.2073 | 3.2875 | シェッフェ < ボンフェローニ |
| 10 | 2.7413 | 2.8645 | 2.8701 | シェッフェ < ボンフェローニ |
| 12 | 2.6679 | 2.7876 | 2.7795 | ボンフェローニ < シェッフェ |
| 15 | 2.5975 | 2.7138 | 2.6937 | ボンフェローニ < シェッフェ |
| 30 | 2.4653 | 2.5752 | 2.5357 | ボンフェローニ < シェッフェ |
| 120 | 2.3731 | 2.4786 | 2.4280 | ボンフェローニ < シェッフェ |
で交差します。理由は自由度が小さいときに の極端な分位点が急激に大きくなるからです。ボンフェローニが使うのは の上側 点という裾のかなり外側で、ここは自由度が小さいと一気に大きくなります。シェッフェが使う の 95% 点はそこまで急に伸びません。だから自由度が小さい側でボンフェローニが不利になります。
なお群数 を動かした場合は別の傾向になります( 固定)。
| 群数 | 比較数 | テューキー | シェッフェ | ボンフェローニ |
|---|---|---|---|---|
| 3 | 3 | 2.5975 | 2.7138 | 2.6937 |
| 4 | 6 | 2.8821 | 3.1404 | 3.0363 |
| 6 | 15 | 3.2490 | 3.8087 | 3.4837 |
| 8 | 28 | 3.4930 | 4.3527 | 3.7882 |
| 10 | 45 | 3.6755 | 4.8258 | 4.0209 |
こちらではシェッフェが一貫して最も厳しいまま、その差が広がっていきます。シェッフェは「任意の対比」という無限に広い範囲を守るので、群数が増えて対比の空間が広がるほど不利になるわけです。テューキーとの差も 0.12 から 1.15 に開きます。
つまり自由度が小さいとボンフェローニが不利、群数が多いとシェッフェが不利という、方向によって逆の傾向でした。
一方、全対比較を対象とする単一ステップ手法の中では、テューキーが常に最も甘い(=有利)です。 を3〜10、 を5〜120の54通りスキャンして、テューキー < min(ボンフェローニ, シェッフェ) に反例0件で確認しました。
ただしこの主張には範囲の限定が必要でした。2つ例外方向があります。
比較を絞ればダネットがさらに甘い(上の図で 2.4377 < 2.5975)。対照群との比較だけでよいなら、そちらが有利です。
段階的手法には負けることがあります。 ホルム法は 換算で という3段階の閾値を持つので、たとえば のとき(この3値は恒等式 を満たすので実際に起こりえます)ホルムは3本すべて棄却しますが、テューキーは2.5975 を下回る3本目を棄却できません。単一ステップのテューキーは、多段階の手法(ホルムや多段テューキー)に一律には勝てないわけです。
つまり正確には「全対比較を単一ステップで扱うならテューキーが最有利」という指針になります。
テューキーの同時信頼区間
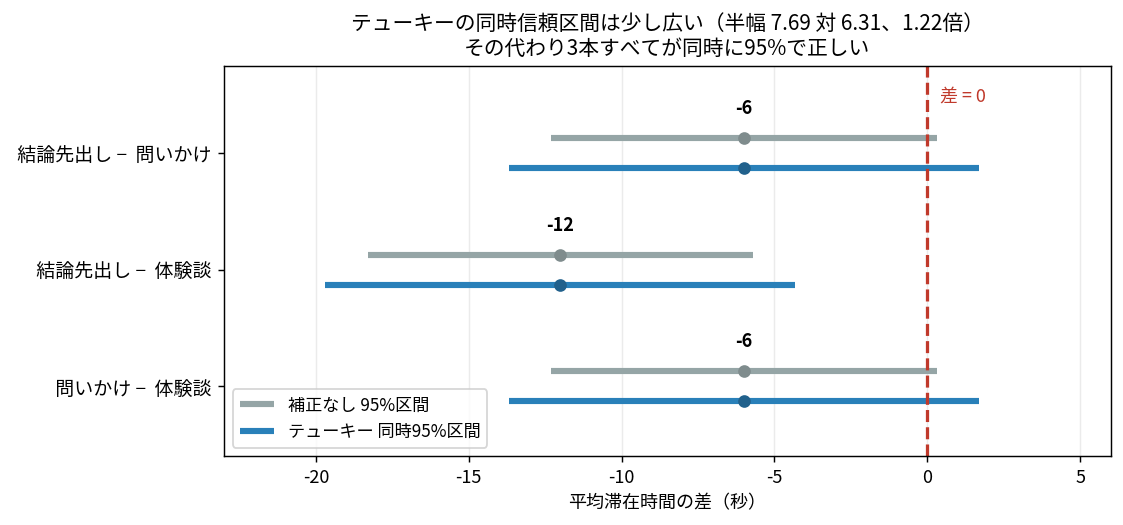
テューキーは信頼区間の形でも出せます。半幅は 7.69 で、補正なし 6.31 の 1.22 倍。広くなる代わりに「3本すべてが同時に95%で正しい」という強い保証がつきます。補正なしの区間は1本ずつなら95%ですが、3本同時では95%を割ります。
シェッフェと分散分析の美しい一貫性
シェッフェが厳しい理由は、守っている範囲が無限に広いからです。たとえば「AとBの平均 対 C」という対比
を検定すると で、シェッフェの臨界値 2.714 を超えて有意になります。データを見てから思いついた対比でも守れるのがシェッフェの価値です。その代わり対比較だけに使うならテューキーに必ず負けます。
そして検算して感心したのがこれです。最大の を与える対比は で、それで計算すると
完全に一致します。 つまり「シェッフェで作れる最大の 」がちょうど に等しい。だから閾値を に取れば、「F が有意でないなら、どのシェッフェ対比も有意にならない」が保証されます。
手計算例(9個のデータ)でも確認できます。 で、。こちらは最大の対比がたまたま A vs C の対比較になっているケースです。
なおこの最大化の話も各群同数が前提で、群のサイズが違うと最大化する対比は になります。
標準的な多重比較法の中で、F検定と論理的に一致するのはシェッフェだけです。テューキーやダネットはこの同値性を持たないので、Fが有意でなくてもテューキーが有意になることや、その逆も起こりえます。
分散分析は多重性を回避しているのか
私がずっと引っかかっていた疑問です。「分散分析で多重性を避けられるなら、なぜその後に多重比較をするのか。矛盾していないか」。3段階に分けて答えます。
(1) 回避ではなく、問いを束ねている
分散分析は多重性を回避しているのではなく、そもそも多重性が発生していないというのが正確な言い方です。
「A対B、A対C、B対C」という3つの問いを「どこかに差があるか」という1つの問いに置き換えています。だから検定は1回で済み、 がそのまま守られる。回避というより問題の立て方を変えているわけです。
前半で見たように、3つの差のうち自由に動けるのは 個だけでした。分散分析はその2自由度をまとめて1回で検定しています。
(2) 後から多重比較をするのは矛盾ではない
問いが違うからです。F検定は「差があるか」、多重比較は「どこに差があるか」。前者に答えても後者は未解決なので、続けて聞くのは自然な手順です。
(3) ただし「F有意なら補正不要」は誤り
これを Fisher's LSD(最小有意差法)と言います。シミュレーションで検証しました。
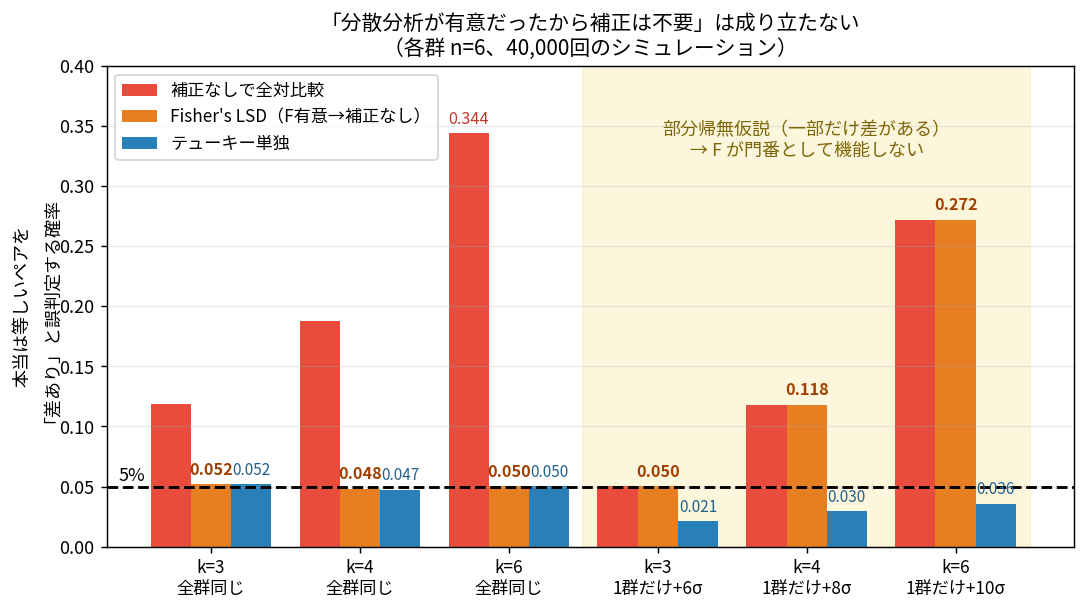
| 状況 | 分散分析F | 補正なし全対比較 | Fisher's LSD | テューキー |
|---|---|---|---|---|
| k=3 全群等しい | 0.0520 | 0.1190 | 0.0520 | 0.0519 |
| k=4 全群等しい | 0.0480 | 0.1880 | 0.0480 | 0.0473 |
| k=6 全群等しい | 0.0503 | 0.3441 | 0.0503 | 0.0500 |
| k=3 1群だけ+6σ | 1.0000 | 0.0504 | 0.0504 | 0.0213 |
| k=4 1群だけ+8σ | 1.0000 | 0.1180 | 0.1180 | 0.0295 |
| k=6 1群だけ+10σ | 1.0000 | 0.2719 | 0.2719 | 0.0355 |
上半分(全群が本当に等しい)では Fisher's LSD がきれいに5%を守っています。Fが門番として機能しているからです。
問題は下半分(1群だけ大きく離れている=部分帰無仮説)です。F はほぼ100%有意になるので門番として何も止めません。すると残りの「本当は等しい」群同士が素のまま比較され、 で 0.118、 で 0.272 まで膨張します。
Fisher's LSD が正当化されるのは のときだけです( では等しいペアが最大1組しかないので、そこで多重性が生じない)。実務では「Fが有意 → テューキー等で多重比較」とし、F を通した後も補正は必要と覚えるのが安全です。
なおテューキーは(正規性と等分散のもとでなら)どの真の平均の配置でもFWERを守るので(表の右列がどの状況でも5%以下)、Fを見ずに直接使っても構いません。
実験計画法の3原則
3原則(局所管理・反復・無作為化)は、言葉で覚えると「良い実験の心得」みたいに聞こえてしまいます。それぞれが分散分析表のどこに効くかで見ると腑に落ちました。
| 原則 | やること | 分散分析表のどこに効くか | 効果 |
|---|---|---|---|
| 局所管理(local control) | 邪魔なばらつきをブロックとして取り出す | 誤差平方和が減る(分母が小さくなる) | 検出力が上がる |
| 反復(replication) | 同じ条件を複数回試す | 誤差の自由度が生まれる(分母が作れる) | 誤差を推定できる/精度が で上がる |
| 無作為化(randomization) | 割り付けをランダムにする | 系統的な偏りが誤差に変わる | 推定が偏らなくなる |
ひとことで言うと、反復が分母を作り、局所管理が分母を小さくし、無作為化が分子の偏りを消す。3つで役割が完全に分かれています。
局所管理=乱塊法:分母を小さくする
3つの導入文(A/B/C)を比べたいが、記事のテーマによって滞在時間の水準がそもそも大きく違う、という状況を考えます。このテーマの違いが邪魔なばらつきです。
完全無作為化:テーマを気にせずランダムに割り付ける
乱塊法      :各テーマの中で3つの導入文を必ず1回ずつ試す
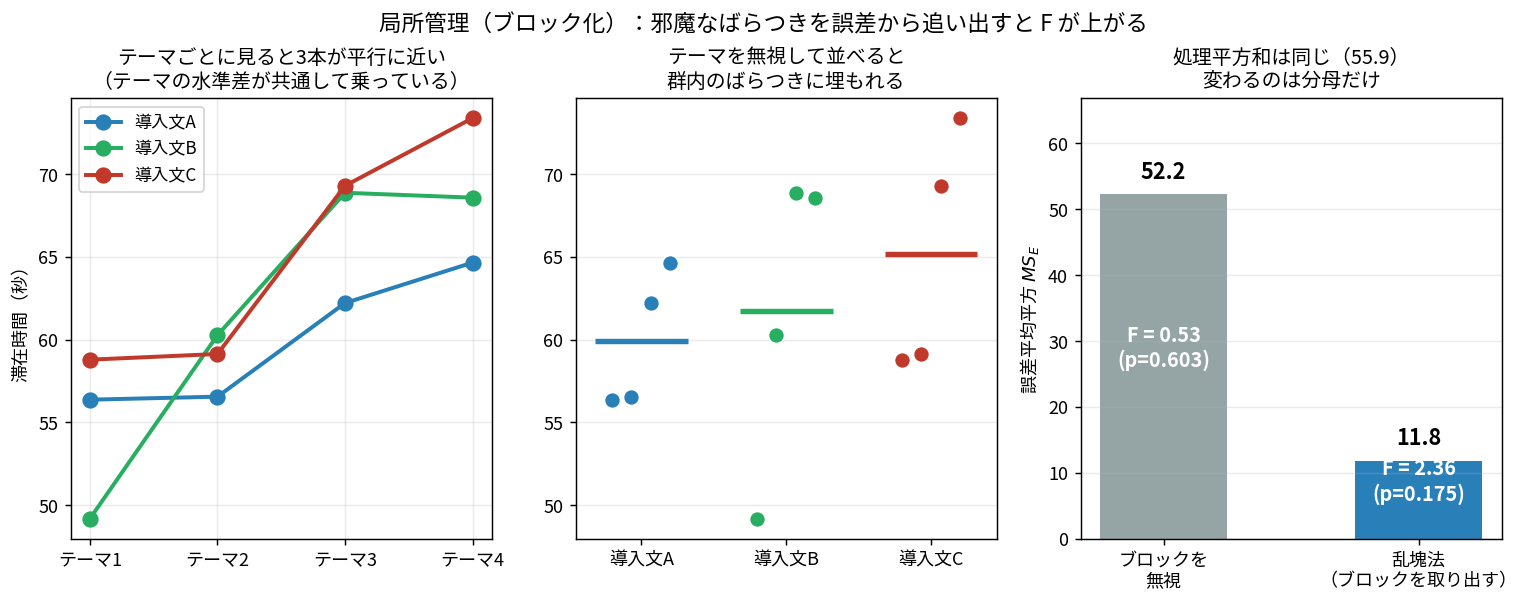
| 変動要因 | ブロック無視(SS / df / MS) | 乱塊法(SS / df / MS) |
|---|---|---|
| 処理(導入文) | 55.860 / 2 / 27.930 | 55.860 / 2 / 27.930 |
| ブロック(テーマ) | —(誤差に混入) | 399.061 / 3 / 133.020 |
| 誤差 | 469.984 / 9 / 52.220 | 70.924 / 6 / 11.821 |
| F値 | 0.5348(p=0.603) | 2.3628(p=0.175) |
注目すべきは処理平方和が 55.860 のまま変わっていないことです。変わったのは分母だけ。誤差平方和 469.984 のうち 399.061 がテーマ由来だったので、それを取り出したら残りが 70.924 になりました。誤差の自由度は 9 → 6 に減りますが、分母が5分の1近くになる効果が勝ちます。
真の に対し、乱塊法の は妥当な推定です。ブロックを無視した 52.220 は を大幅に過大評価していたことになります。
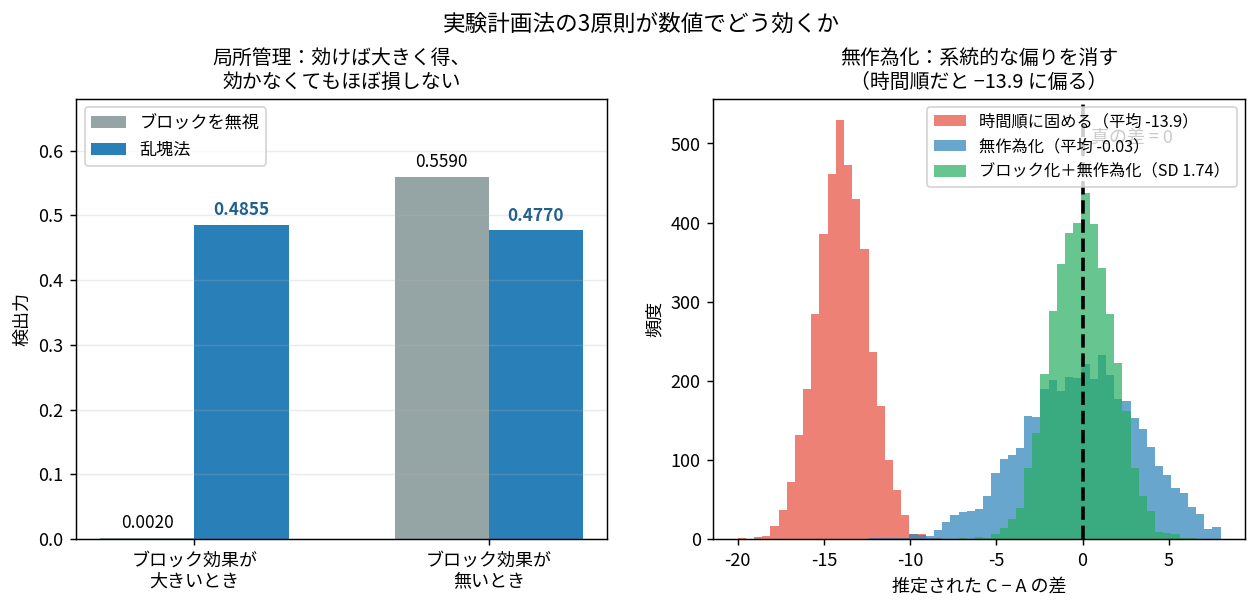
左のパネルが実務的にいちばん有益でした。ブロック効果が大きいときは検出力が 0.0020 → 0.4855 に劇的に改善する一方、ブロック効果が実際には無いときも 0.5590 対 0.4770 でほぼ同じ(自由度を少し失う分だけわずかに不利)。
つまり誤差自由度に余裕があれば、ブロック化は効けば大きく得、効かなくても損は小さい。失うのは 個の誤差自由度ぶんで、この例では 0.559 → 0.477 でした。だから迷ったらブロック化する、という判断になります。
ただし総観測数が少なくブロック数が多いと、この自由度の損が効いてきます。後で出てくる 3×3 のラテン方格が極端な例で、誤差自由度が2しか残らず実用に耐えなくなります。「ほぼ損しない」と言えるのは誤差自由度が十分あるときの話です。
ブロックは「実験前」に決めなければならない
ここは私が誤解しかけた点です。「データを見てグルーピングすれば検出力が上がる」と理解しそうになったのですが、それは順番が逆でした。正しくは「実験する前にグループを決めておく」です。
処理にまったく差がないデータで、ブロックの決め方だけを変えて誤り率を測りました。
| ブロックの決め方 | 第一種の誤り率 | 判定 |
|---|---|---|
| ブロックを使わない(一元配置) | 0.0555 | OK |
| 実験前に決めたブロックで乱塊法 | 0.0515 | OK |
| 結果と無関係な共変量で後から層別 | 0.0553 | OK |
| 結果 y の値を見てブロックを作る | 0.3897 | 破綻(5%の7.8倍) |
最後の行が危険です。 が近いもの同士を同じブロックにすると、「ブロック内では が近い」という状況を人工的に作ってしまい、誤差平方和が不当に小さくなって F が過大になります。差がまったくないデータで4割の確率で「差がある」と言ってしまう。
そもそも実験計画法は「データを取る前にプランを立てる」方法論なので、データを見て決める余地がありません。「実験計画」という名前がそのまま条件を表しています。
似た概念と区別しておくと整理できます。
| 邪魔な変数の状態 | 対処 | |
|---|---|---|
| ブロック化 | 知っている | 実験の設計時に組み込む |
| 共変量調整(ANCOVA) | 測ってある | 解析時に回帰で調整(第16回の重回帰と同じ) |
| 交絡変数の探索 | 分からない | 観察データの因果推論の話(別問題) |
実験計画法の強さは、知っている変数はブロック化で除去し、知らない変数は無作為化で無害化するという2段構えにあります。
無作為化:バイアスを分散に変換する
無作為化の役割は「公平にする」という漠然としたものではなく、系統的な偏り(バイアス)を、扱える形のばらつき(分散)に変換することです。
A/Bテストで「時間とともに読者の質が変わる」(午前は熱心、夜は流し読み)という状況を作り、処理の効果は全部0(本当は差がない)にして検証しました。
| 割り付け | 有意になる割合(本当は差がないのに) | C−A の推定値の平均(真値は0) | 推定値の標準偏差 |
|---|---|---|---|
| 時間順に固める(Aを全部→Bを全部→Cを全部) | 1.0000 | −13.93 | 1.50 |
| 無作為化 | 0.0530 | −0.03 | 3.42 |
| ブロック化+無作為化 | 0.0522 | −0.02 | 1.74 |
時間順に固めると100%の確率で「差がある」と誤判定します。しかも推定値が −13.93 に偏る。これがバイアスです。真値0なのに一貫して同じ方向にずれるので、サンプルを増やしても直りません。
無作為化すると偏りが −0.03 とほぼ0に消え、誤り率も5.3%に戻ります。ただし代わりに標準偏差が 1.50 から 3.42 に増えている点に注目してください。トレンド由来のばらつきは消えず、誤差の中に移動しただけです。これが「バイアスを分散に変換する」の意味です。
正確に言うと、無作為化が保証するのは偏りの期待値が0になることで、1回1回の実験では偏りは残ります(上の表の −0.03 は4000回の平均値です)。「無作為化すれば1回の実験でも偏りが消える」わけではありません。
そして3原則が組み合わさります。時間を4ブロックに区切ってブロック化し、各ブロック内で無作為化すると、誤り率5%を保ったまま標準偏差が 3.42 → 1.74 に縮みます。無作為化で偏りを消し、局所管理で精度を取り戻すという分業です。
反復:分母を作る/精度は√nでしか上がらない
反復の役割は2つあります。ひとつは誤差の自由度を作ること。繰り返しのない二元配置がまさにこれで、各セルに1個だと誤差の自由度が0になりFの分母が作れません。
もうひとつは精度を上げることですが、 なので効率は悪いです。
| 各群の | (σ=3) | 差の95%区間の半幅 |
|---|---|---|
| 2 | 2.1213 | 9.5473 |
| 4 | 1.5000 | 4.7988 |
| 8 | 1.0607 | 3.1194 |
| 16 | 0.7500 | 2.1363 |
| 32 | 0.5303 | 1.4894 |
半幅を半分にするには を4倍にする必要がある。第10回・第11回で見た「精度はルートでしか改善しない」がここでも効いています。
なお混同しやすいのが真の反復と擬似反復(pseudo-replication)の区別です。真の反復は独立に実験をやり直すこと(別の記事で導入文Aを試す)。擬似反復は同じ実験を測り直すだけ(同じ記事のPVを2回数える)。
擬似反復の害は名目上の自由度だけが水増しされることです。従属な測定を独立な反復として数えるので、実質的な情報は増えていないのに と誤差自由度が大きくなり、 が小さくなります。結果として F や t が過大に、p値が不当に小さくなります。A/Bテストで「同じユーザーの複数回訪問」を独立な観測として数えるのも同じ誤りです。
直交表:4行の表で全部わかる
さて直交表です。私は最初、これがまったく理解できませんでした。「1と2しか書いていない表なのに、なぜ内積が0という話が出てくるのか」。ここは4行の だけを使って順に積み上げます。
そもそも何のために作るのか
ブログ記事で3つの工夫を試したいとします。
A: タイトルに数字を入れる  (あり / なし)
B: 図を入れる              (あり / なし)
C: 内部リンクを増やす      (あり / なし)
全組合せは 通りで記事8本。要因が7個になると 本で現実的ではありません。
そこで「4本だけ書いて、3つの工夫の効果を全部知りたい」と考えます。これが直交表の動機です。ただしどの4本を選ぶかで成功と失敗が分かれる。ここが直交表の存在理由でした。
一言でいうと、直交表は「少ない実験回数で、複数の要因の効果を混ざらずに取り出すための、組合せの選び方カタログ」です。表そのものに深い意味があるのではなく、実験の指示書だと思うと分かりやすいです。
まず失敗例を見る
答え合わせできるように真の効果を先に決めます。
滞在時間 = 50 + 8×(Aあり) + 4×(Bあり) + 0×(Cあり)

つまり  A は +8秒、B は +4秒、C は効果なし(0秒)
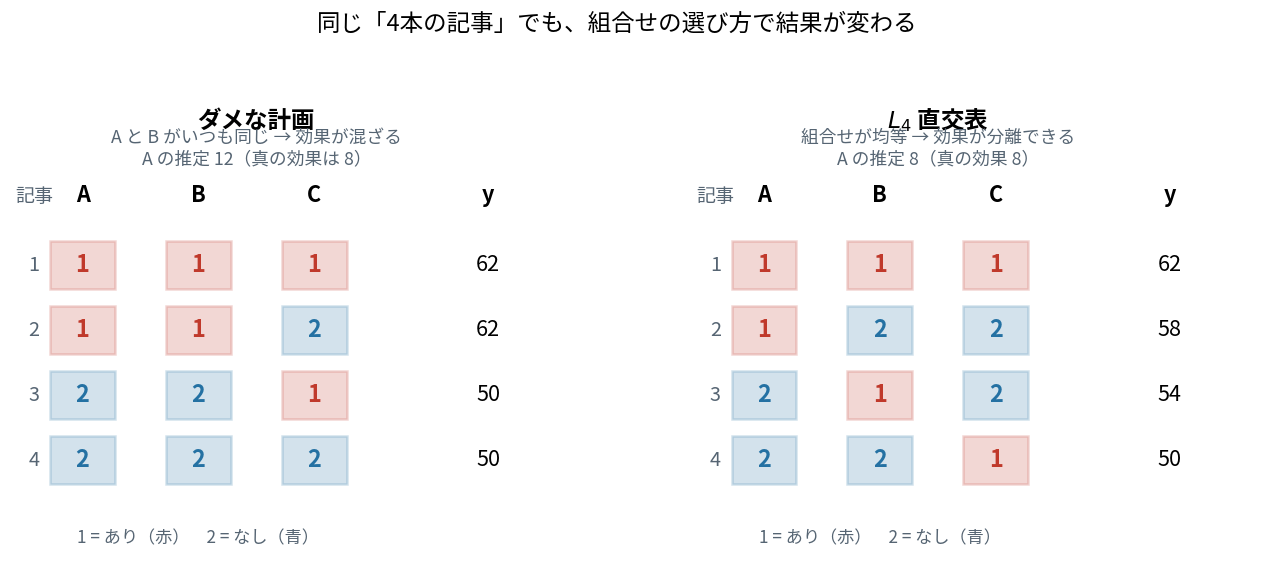
ダメな計画:A と B をいつも同時に変えてしまった場合。
記事 | A    B    C   | 滞在時間
  1  | あり  あり  あり  |   62
  2  | あり  あり  なし  |   62
  3  | なし  なし  あり  |   50
  4  | なし  なし  なし  |   50

A の効果を「Aありの平均 − Aなしの平均」で測る:
  A あり(記事1,2)の平均 = (62+62)/2 = 62
  A なし(記事3,4)の平均 = (50+50)/2 = 50
  差 = 62 − 50 = 12
12 と出ましたが、A の真の効果は 8 です。 A ありの記事は B もありだから、B の効果 が紛れ込んで になりました。A と B の効果が分離できていないわけです。
ちなみにこの計画でも C の効果は正しく測れます(C あり平均56、C なし平均56、差0=真の効果0)。C だけは A・B とバランスよく組み合わさっていたからです。つまり「バランスよく組み合わさっているか」が分離できるかの分かれ目です。
L4 の読み方
は4行3列の表です。
記事 | 列1  列2  列3
  1  |  1    1    1
  2  |  1    2    2
  3  |  2    1    2
  4  |  2    2    1
| 表の要素 | 意味 |
|---|---|
| 行 | 1回の実験(=記事1本)。4行なので実験4回 |
| 列 | 要因を割り当てる場所。3列なので要因を3つまで置ける |
| 中身の 1 / 2 | その要因のどちらの水準を使うかの指示 |
| ラテン方格(Latin square)由来 | |
| 添字の 4 | 行数=実験の回数 |
列1にA、列2にB、列3にC を割り当てると、「こういう4本を書け」という指示書になります。
記事 | A(数字)  B(図)   C(リンク) | 滞在時間
  1  |  あり     あり     あり     |   62
  2  |  あり     なし     なし     |   58
  3  |  なし     あり     なし     |   54
  4  |  なし     なし     あり     |   50

各要因の効果を「あり平均 − なし平均」で測る:
  A: あり(記事1,2)の平均 60 − なし(記事3,4)の平均 52 =  8   真の効果 8
  B: あり(記事1,3)の平均 58 − なし(記事2,4)の平均 54 =  4   真の効果 4
  C: あり(記事1,4)の平均 56 − なし(記事2,3)の平均 56 =  0   真の効果 0
3つとも真の効果とぴったり一致しました。 記事4本で3要因の効果が分離でき、しかも計算は平均の引き算だけです。
なぜ混ざらないのか(ここが直交の本質)
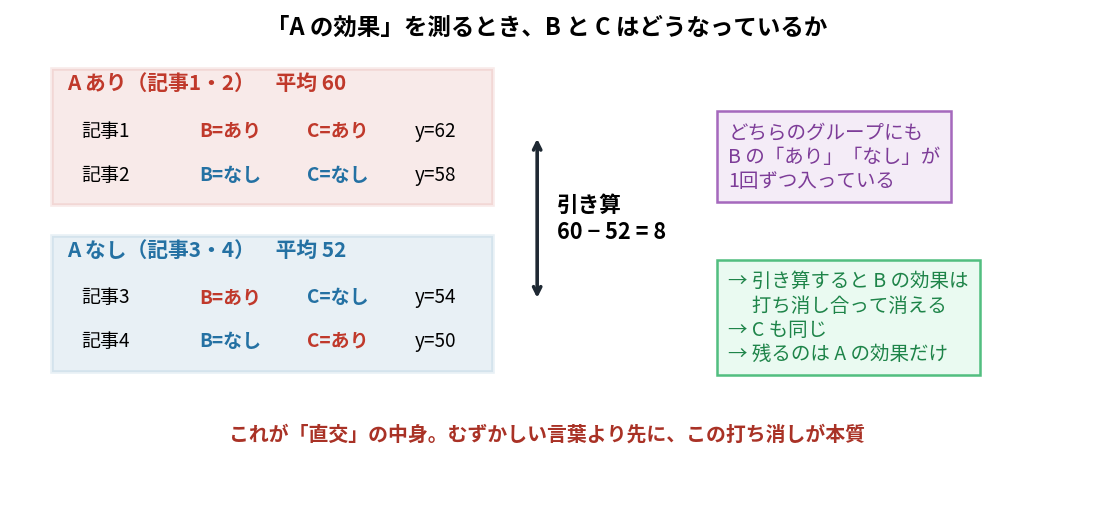
A の効果を測るとき、2つのグループの中で B がどうなっているかを見ます。
A ありのグループ(記事1・2)には B のあり/なしが1回ずつ。A なしのグループ(記事3・4)にも B のあり/なしが1回ずつ。 だから引き算すると B の効果は打ち消し合って消えます。C も同様。残るのは A の効果だけ。
これが「直交」の中身です。 難しい言葉より先に、この打ち消しの仕組みを押さえるのが大事でした。逆に失敗例では、A ありのグループに B のありしか入っていなかったので打ち消しが起きず、B の効果が漏れ込んだわけです。
「1と2しかないのに内積が0」の謎
私がいちばん引っかかったのがここです。答えは「1 と 2 は名札にすぎず、計算するときは +1 と −1 に置き換えている」でした。
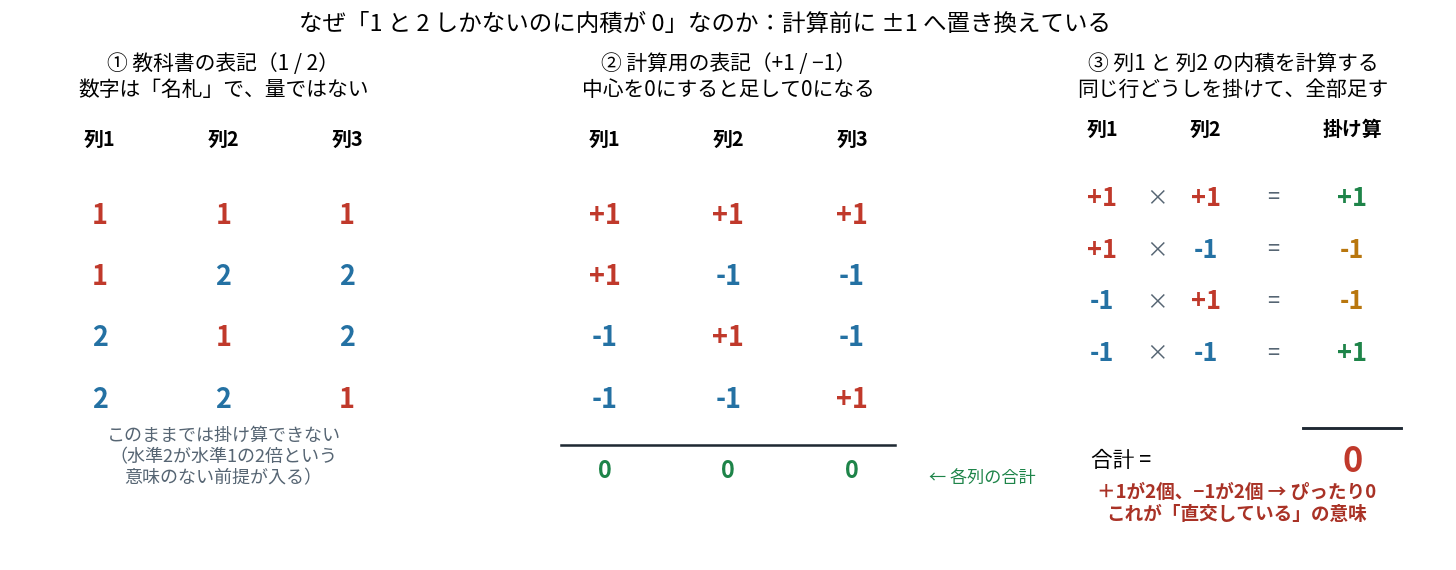
なぜ 1/2 のままでは計算できないのか。 水準の名前は「あり/なし」でも「1/2」でも「赤/青」でも構いません。ただの名札です。もし 1 と 2 をそのまま数値として掛け算すると、「水準2は水準1の2倍」という意味のない前提が入ってしまいます。色に赤=1、青=2 と番号を振って「青は赤の2倍」と言うのが無意味なのと同じです。
そこで中心を0にする置き換えをします。
水準1 → +1
水準2 → −1

こうすると2つの水準が0を挟んで対称になり、  (+1) + (−1) = 0
これは第16回のダミー変数と同じ発想(効果コーディング)で、「どちらでもない状態(0)から見たプラス側とマイナス側」を表しています。
内積を計算します。 内積とは同じ位置どうしを掛けて全部足すこと。
        列1     列2    掛け算
記事1:  (+1) × (+1)  =  +1
記事2:  (+1) × (−1)  =  −1
記事3:  (−1) × (+1)  =  −1
記事4:  (−1) × (−1)  =  +1
                        ────
                合計 =    0
+1 が2個、−1 が2個。だからぴったり0になります。 そしてこの 0 が意味しているのは、
「列1が +1 の行では、列2は +1 と −1 が同数」
「列1が −1 の行でも、列2は +1 と −1 が同数」
つまり2つの列がバランスよく組み合わさっているということ。ひとつ前で見た「引き算すると打ち消し合って消える」を数式1本で表しただけです。新しい概念ではなく、同じことの言い換えでした。
全ペアで確認すると 列1・列2 = 0、列1・列3 = 0、列2・列3 = 0。だから「直交表」と呼びます。
なお自分自身との内積は0になりません。 で、±1 はどちらも2乗すれば1なので必ず行数になります。 なら8です。
なぜ 0/1 ではなく 1/2 なのか
プログラミングに慣れていると「あり/なしなら 0/1 で表すのが普通では」と思うところです。私もそう思ったので確かめました。理由は3つありました。
1つめ。0/1 では内積が0になりません。 これが決定的です。
0/1 で列1×列2 を計算すると
  1 × 1 = 1
  1 × 0 = 0      ← 0を掛けると情報が消える
  0 × 1 = 0
  0 × 0 = 0
       合計 = 1   ← 正の値。絶対に0にならない
0/1 は「片方だけを数える」表記なので、掛け算するとマイナスの項が出ません。直交表なら両方が水準1になる行が必ずあるので、合計は正の値になります。±1 なら打ち消せる。3つの表記を並べると違いが明確です。
| 表記 | 列1の中身 | 列1・列2 の内積 | 直交する? |
|---|---|---|---|
| 1/2(教科書の表記) | [1, 1, 2, 2] | 9 | しない |
| 0/1(ダミー変数) | [1, 1, 0, 0] | 1 | しない |
| +1/−1(計算用) | [1, 1, −1, −1] | 0 | する |
1/2 のままでも0にならないので、1/2 は「表示用」、±1 は「計算用」と役割が分かれているわけです。
ただし誤解しないよう補足します。0/1 では効果が分離できない、という話ではありません。 が便利なのは「全体平均を差し引いた座標になっている」からで、0/1 のままでも切片(全体平均)を取り除いてから内積を取れば0になります。実際 0/1 を中心化すると になり、 の半分=同じ方向です。
本質は表記ではなく「各水準の組合せが同数現れる=バランスしている」ことで、 はそれを一発で確認できる書き方だということです。だから後で見るように、どの表記でもF値は変わりません。
2つめ。水準が3つ以上あるとき 1 始まりが自然です。 直交表は2水準だけでなく、 のような3水準系もあります。中身は 1/2/3 で、最大の数字がそのまま水準数になります。0 始まりだと 0/1/2 で最大値が2、水準数は3とずれて読みづらい。プログラミングの0始まりとは逆の発想です。
3つめ。0/1 は「ない/ある」を含意してしまいます。 実験計画の水準は「温度180℃/200℃」「タイトル数字入り/疑問形」のような対等な2択が多いので、「0 = 何もしない状態」という意味が紛れ込むと不自然です。1/2 なら単なる通し番号なので中立に使えます。
まとめると、こう使い分けています。
| 場面 | 表記 | 理由 |
|---|---|---|
| 表を読む・実験を指示する | 1/2(水準の通し番号) | 3水準以上でも同じ規則。対等な2択に中立 |
| 直交性を確認・効果を計算する | +1/−1(効果コーディング) | 内積が0になる |
| 回帰モデルに入れる | 0/1(ダミー変数) | 「基準からの差」として係数を読みたいとき |
面白いのは、3つとも同じモデルを表していてF値は変わらないことです。前半で確認したとおり、基準セル方式(0/1)でも効果コーディング(±1)でも で一致しました。変わるのは係数の意味だけ。表記は「何を読みたいか」で選んでいるだけでした。
なぜ「直交」という言葉なのか
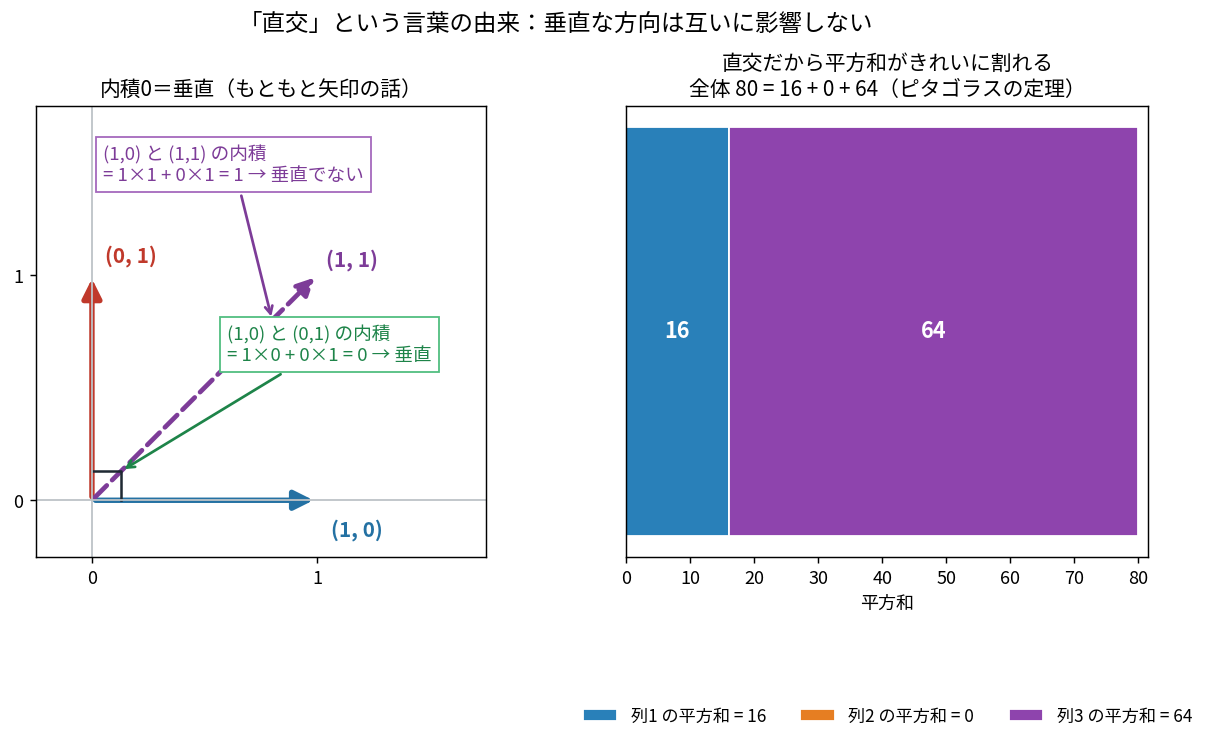
内積が0=直交(垂直)というのは、もともと矢印(ベクトル)の話です。 と の内積は で垂直。 と の内積は1なので垂直でない(45度)。
直交表の各列は「4個の数字の並び」なので、4次元空間の矢印だと思えます。その矢印同士が垂直に立っている、というのが「直交表」の意味です。
垂直だと何が嬉しいのか。垂直な方向は互いに影響しません。 東に3歩進んでも北の位置は変わらない。だから「A の効果」を測るときに「B の効果」が漏れてこないわけです。
数値で確かめると、データが4つの方向にきれいに分解できます。
データ y = [50, 58, 54, 46]

  全体平均の方向 : (y·u)/(u·u) = 208/4 = 52.0
  列1 の方向     : (y·u)/(u·u) =   8/4 =  2.0
  列2 の方向     : (y·u)/(u·u) =   0/4 =  0.0
  列3 の方向     : (y·u)/(u·u) = −16/4 = −4.0

4方向の成分を足し戻すと [50, 58, 54, 46] → 元のデータに完全復元

平方和も分解できる(ピタゴラスの定理):
  全体平方和 = 80
  列1 = 16、列2 = 0、列3 = 64  →  16 + 0 + 64 = 80
ここで今回の前半とつながります。「平方和が要因ごとにきれいに割れる」のは、まさに一元配置分散分析で見た と同じ構造(直交分解)です。内積が0でないとこの分解ができません(同じばらつきを重複して数えてしまう)。分散分析表がいつも足し算で閉じるのは、背後で直交分解が成立しているからでした。
L4 の作り方と交絡
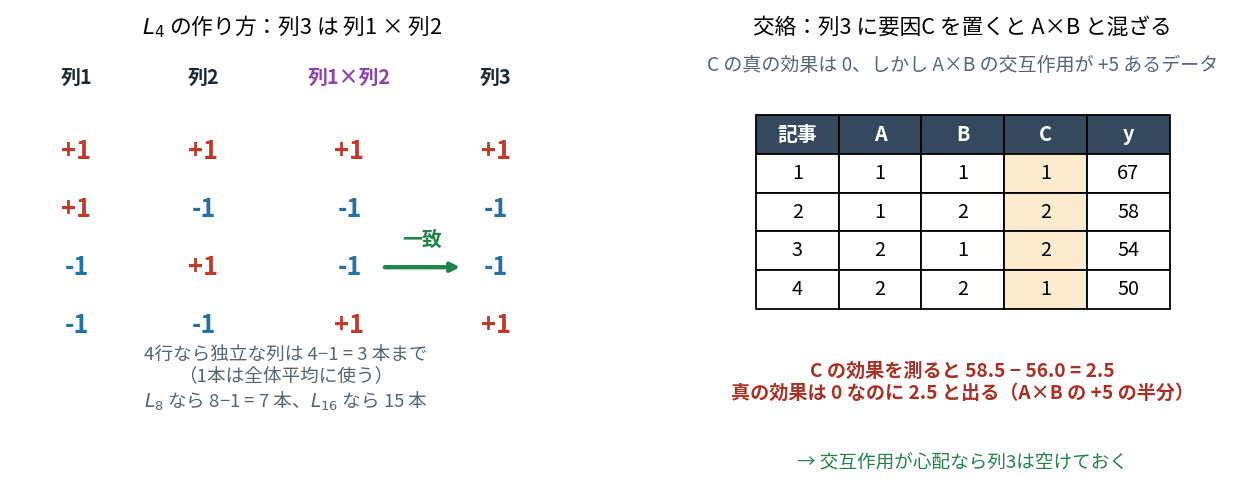
の3列は、実は基本列(生成元)が2本だけ。3列目は1列目と2列目の要素ごとの掛け算で作れます。
記事 | 列1  列2  列1×列2  列3
  1  | +1   +1    +1      +1
  2  | +1   −1    −1      −1
  3  | −1   +1    −1      −1
  4  | −1   −1    +1      +1
                 ↑ 一致 ↑

作り方:
  1. 列1: +1 +1 −1 −1  (前半プラス、後半マイナス)
  2. 列2: +1 −1 +1 −1  (交互)
  3. 列3: 列1 × 列2 を計算する
「基本列が2本」と「直交する列が3本」は別の話なので、混同しないよう補足します。積で作れる列3 も、ベクトルとしては列1・列2 と直交していて線形独立です(だから平方和が とピタゴラスで割れる)。積で作れることと、互いに直交していることは両立します。
行数と列数の関係もこれで分かります。正しい規則は「列が消費する自由度の合計が行数−1 以下」です。1を引くのは全体平均に1本使うから(すべて の列が暗黙に入っている)。
2水準の列は1本で1自由度なので、 は3列、 は 列、 は15列になります。ただし3水準の列は1本で2自由度を使うので、(9行)は 列が上限です。「行数−1が列数」は2水準系に限った話でした。
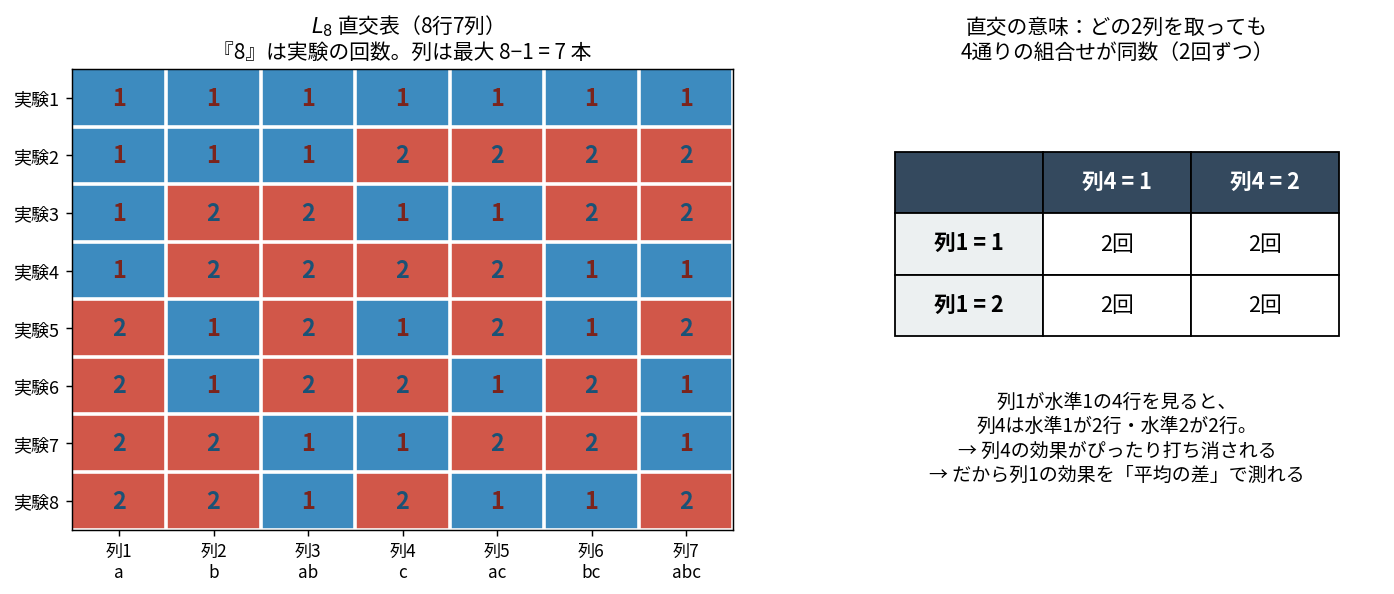
も同じ規則で、基本列3本(a, b, c)とその積4本で7列になります(列1=a、列2=b、列3=a×b、列4=c、列5=a×c、列6=b×c、列7=a×b×c)。 の「8」は実験の回数で、 の 3 が基本列の本数に対応しています。
交絡:列3 に要因を置くと何が起きるか
列3 は 列1×列2 でした。ところで「A×B の交互作用」も、まさに 列1×列2 の形で現れる量です。つまり列3 には2つのものが同じ場所に乗ります。
列3 に乗るもの:
  ・要因C の主効果
  ・A×B の交互作用
→ 区別できない。これが「交絡(こうらく)」
実演します。C の効果は0、しかし A×B の交互作用が あるデータを作ります。
記事 | A    B    C  | 滞在時間
  1  | 1    1    1  |   67   ← A,B 両方ありなので +5 が乗る
  2  | 1    2    2  |   58
  3  | 2    1    2  |   54
  4  | 2    2    1  |   50

C の効果を測ると:
  C あり(記事1,4)の平均 = (67+50)/2 = 58.5
  C なし(記事2,3)の平均 = (58+54)/2 = 56.0
  差 = 58.5 − 56.0 = 2.5
C の真の効果は0なのに 2.5 と出ました。 これは A×B の交互作用 の半分です。どちらが原因なのかは、このデータからは原理的に分かりません。 実験の回数を増やしても、この計画のままでは永久に分離できません。
対策は交互作用が心配な列を空けておくことです。 で要因を2つ(列1・列2)だけ使えば、列3 の値が A×B の交互作用の推定値として読めます。
では入れる要因の数によって話が変わります。ここは自分で計算して初めて理解できたところなので、2つに分けて書きます。
3要因を列1・2・4 に置く場合(完全実施計画)。 このとき列3・5・6 は本当に空き列で、すべての2因子交互作用が推定できます。
| 列 | その列に乗る効果 | 割り付け |
|---|---|---|
| 1 | a | 要因A |
| 2 | b | 要因B |
| 3 | a×b | 空き列 → A×B を推定できる |
| 4 | c | 要因C |
| 5 | a×c | 空き列 → A×C を推定できる |
| 6 | b×c | 空き列 → B×C を推定できる |
| 7 | a×b×c | 空き列 → A×B×C を推定できる |
4要因を列1・2・4・7 に置く場合。 要因Dを列7 に入れた瞬間、 という関係が生まれます(実際に計算して確認しました)。すると2因子交互作用同士が交絡します。
| 列 | その列に乗るもの | 割り付け |
|---|---|---|
| 1 | A | 要因A |
| 2 | B | 要因B |
| 3 | A×B と C×D(交絡) | — |
| 4 | C | 要因C |
| 5 | A×C と B×D(交絡) | — |
| 6 | A×D と B×C(交絡) | — |
| 7 | D | 要因D |
に対し で同じ列に乗る、という仕組みです。同様に 、。
つまり4要因を入れた時点で列3・5・6 は「空き列」ではなくなり、2つの交互作用の和が乗ります。 「A×B を推定できる」とは言えません。ただし主効果はどれも2因子交互作用と交絡しない(これを解像度IVと呼びます)ので、主効果の評価は安全です。
この違いを知ると、「 だから7要因入れられる」と考えるのがいかに危険かが分かります。実際には「何個の要因を入れ、どの交互作用を見たいか」で割り付けを決める必要があり、要因を増やすほど交互作用の情報が失われていきます。
直交していないと何が壊れるか
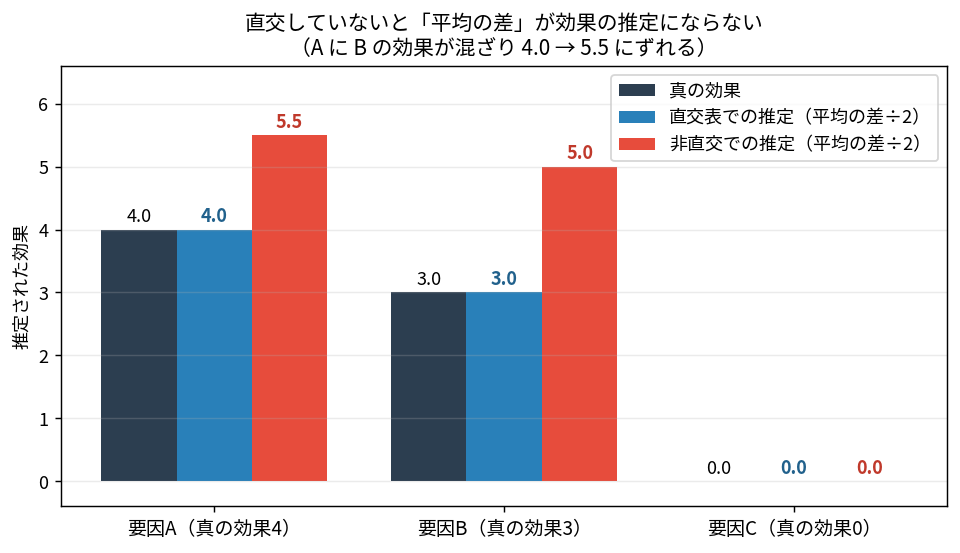
直交表なら「平均の差」がそのまま真の効果に一致します。非直交だと A の推定が 4.0 ではなく 5.5 になり、B の効果が混ざり込みます。
直交の実利は3つありました。
(1) 電卓レベルの計算(平均の差)で効果が推定できる。 行列演算が要りません。
(2) 列を1本削っても他の係数が変わらない。 これは実務上とても大きい利点です。 が対角行列になるので、逆行列も対角になり、各係数が完全に独立に決まります。非直交だとモデルを変えるたびに全係数が動きます。
(3) 係数の分散が最小になる。 上の非直交の例では A の係数の分散が 1.33倍に膨らみました( の対角が 0.125 → 0.1667)。直交表は「同じ実験回数で最も精度が高い割り付け」でもあるわけです。
実験計画法は「実験回数を減らす技術」なのか
半分正しいですが、正確には「主効果だけに絞れば、少ない回数で全要因を同時に評価できる技術」です。
7要因を2水準で全部試すと 回。 なら8回で16分の1。ただし代償として交互作用が主効果と交絡します。「回数を減らす」ではなく「交互作用の情報を捨てる代わりに回数を減らす」という交換でした。
だから実務での使い方は2段階になります。まず直交表で多数の要因をスクリーニングし(大きく効く要因を絞る)、次に絞った少数の要因について交互作用まで含めて詳しく調べる。
ラテン方格法と分割実験
ラテン方格法:邪魔なばらつきが2方向あるとき
テーマも曜日も滞在時間に影響する、という状況です。両方をブロック化したい。
        曜日1  曜日2  曜日3
テーマ1    A     B     C
テーマ2    B     C     A
テーマ3    C     A     B

各行に A,B,C が1回ずつ/各列にも1回ずつ → 行と列の両方でバランス
全組合せ 3×3×3 = 27 回のところ、9 回で済む
| 変動要因 | 自由度 |
|---|---|
| 処理(導入文) | |
| 行(テーマ) | |
| 列(曜日) | |
| 誤差 | |
| 全体 |
ただし3×3 のラテン方格は誤差の自由度が2しかありません。 の5%点は 19.0 という極端な値になり、検出力が実用に耐えません。実務では 4×4 以上(誤差 df = 6)、5×5(df = 12)、または同じ方格を繰り返す必要があります。「9回で済む」の代償がここに出ます。
分割実験:変えにくい要因があるとき
サーバー設定は1日1回しか変えられない(変えにくい)。記事の書き方は記事ごとに変えられる。この非対称性を扱うのが分割実験(split-plot design)です。
1次因子(whole plot)… 変えにくい要因(サーバー設定)。日単位で割り付け
2次因子(split plot)… 変えやすい要因(記事の書き方)。日の中で割り付け
以下の表は具体的に「サーバー設定S が2水準、各設定で2日ずつ(=全体プロット4個)、各日に書き方W の3水準を1回ずつ」という設計です。総観測数は になります。
| 変動要因 | df | 検定に使う分母 |
|---|---|---|
| S(1次因子) | 1 | 1次誤差 |
| 1次誤差(日による違い) | 2 | — |
| W(2次因子) | 2 | 2次誤差 |
| S×W | 2 | 2次誤差 |
| 2次誤差(記事による違い) | 4 | — |
| 全体 | 11 |
ここが試験で狙われる急所です。誤差が2種類でき、分母を使い分けます。 1次因子は自由度の小さい1次誤差で割るので検出力が低い。2次因子と交互作用は自由度の大きい2次誤差で割るので精度が高い。全部を2次誤差で割ると、1次因子の検定が不当に甘くなります。
一般式も整理しておきます。1次因子の水準数を 、各水準あたりの全体プロット数(反復)を 、2次因子の水準数を とすると、
上の例なら1次誤差が 、2次誤差が 。いくつかの設計で検算すると、 なら 4 と 8、 なら 3 と 9 で、いずれも全体の自由度と辻褄が合います。2次誤差のほうが必ず 倍大きいので、2次因子の検定が有利になる構造が式から読めます。
実務的な含意としては、「変えにくい要因」は検出力が低くなるのを覚悟する。逆に「変えやすい要因」とその交互作用は精度よく見られます。
実務:A/B/Cテストで本当に使えるのか
まず「何回の観測が必要か」を計算する
検定をやる前に設計を確認します。検出力80%、 で必要な総観測数です。Cohen's f は効果量で、0.10=小、0.25=中、0.40=大が目安です。
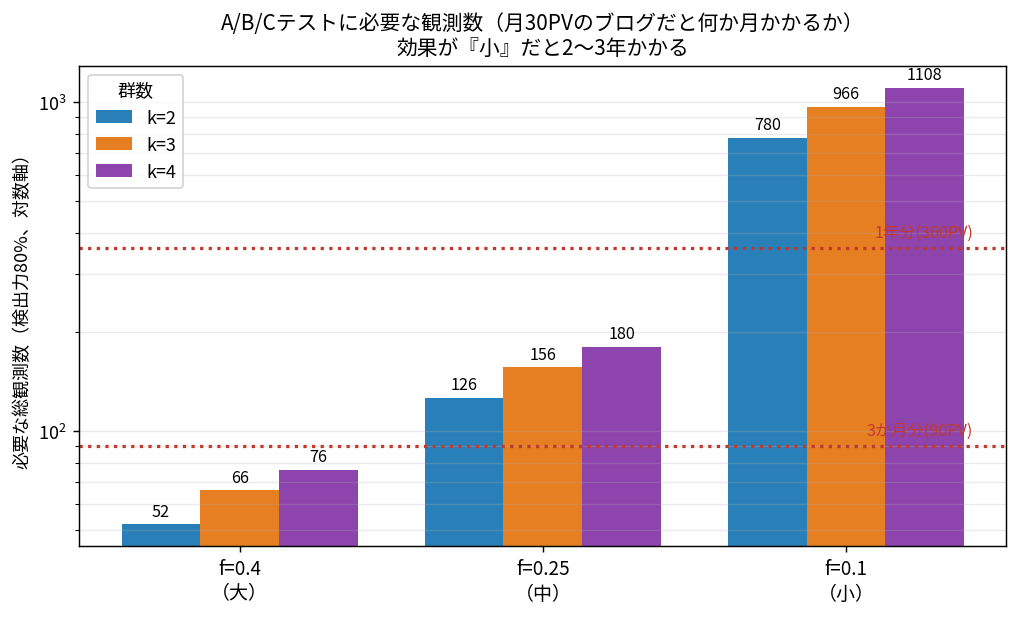
| 群数 | 効果量 f | 各群 n | 総数 N | 実測検出力 | 月31PVだと |
|---|---|---|---|---|---|
| 2 | 0.40(大) | 26 | 52 | 0.804 | 1.7か月 |
| 2 | 0.25(中) | 63 | 126 | 0.793 | 4.1か月 |
| 2 | 0.10(小) | 390 | 780 | 0.795 | 2.1年 |
| 3 | 0.40(大) | 22 | 66 | 0.815 | 2.1か月 |
| 3 | 0.25(中) | 52 | 156 | 0.794 | 5.0か月 |
| 3 | 0.10(小) | 322 | 966 | 0.797 | 2.6年 |
| 4 | 0.40(大) | 19 | 76 | 0.826 | 2.5か月 |
| 4 | 0.25(中) | 45 | 180 | 0.804 | 5.8か月 |
| 4 | 0.10(小) | 277 | 1108 | 0.806 | 3.0年 |
面白い点として、群数を増やしても必要な「各群の 」は減ります(3群 f=0.25 なら各群52、4群なら各群45)。総数は増えますが1群あたりの負担は軽くなります。
理由は非心度です。Cohen's f は
と定義されるので、検出力を決める非心度は になります。 を固定するというのは「各群あたりの平均的な効果の大きさを保ったまま群を足す」ことなので、 をそのままにしても が に比例して増えます。分子自由度 が増える不利を差し引いても、この増加が勝つわけです。
このブログは月間PVが31(GA4 の実測 29PV/28日を月換算した値。第11回と同じ数字)なので、当てはめると次のようになります。3群なら効果が「大」で2.1か月、「中」で5.0か月。「小」は2.6年かかるので事実上不可能。
つまり小さな改善の検出は諦め、大きく効く変更に絞るなら成立するという線が引けます。ただし数か月かかる間にサイト自体が変わってしまうので、現実には検定より流入を増やす打ち手を優先するのが妥当という結論になりました(第11回と同じ結論です)。
PVが少ないうちの4つの使い道
| 使い道 | 中身 |
|---|---|
| (A) 検定ではなく設計に使う | 上の表がまさにこれ。「1年かかる」と分かればやらない判断ができる。これだけでも十分な価値がある |
| (B) 単位を PV から「記事」に変える | PVは足りないが記事は数十本書ける。「記事1本」を実験単位にして応答変数を「その記事の平均滞在時間」にすれば を稼げる |
| (C) 直交表で少ない記事数で多要因を試す | 7要因を全部試すと128記事だが なら8記事。PVが少なくても実行可能 |
| (D) ブロック化で既存のばらつきを除く | 記事のテーマは滞在時間に強く影響する。テーマをブロックにすればそのばらつきを誤差から追い出せる |
L8 でブログ記事の7要因を8本で試す設計
A: タイトルの型   水準1=数字入り    水準2=疑問形
B: 導入文         水準1=結論先出し  水準2=問いかけ
C: 見出しの数     水準1=5個以上     水準2=4個以下
D: 図表           水準1=あり        水準2=なし
E: 文字数         水準1=3000字以上  水準2=3000字未満
F: 内部リンク     水準1=3本以上     水準2=2本以下
G: CTAの位置      水準1=冒頭と末尾  水準2=末尾のみ

記事 | A  B  C  D  E  F  G
  1  | 1  1  1  1  1  1  1
  2  | 1  1  1  2  2  2  2
  3  | 1  2  2  1  1  2  2
  4  | 1  2  2  2  2  1  1
  5  | 2  1  2  1  2  1  2
  6  | 2  1  2  2  1  2  1
  7  | 2  2  1  1  2  2  1
  8  | 2  2  1  2  1  1  2

各要因の効果 =(水準1の4記事の平均)−(水準2の4記事の平均)
検出できる効果の大きさも先に見積もれます。推定は「4本の平均 − 4本の平均」なので です。
| 記事間のばらつき σ | 効果のSE | 検出可能な効果の目安 |
|---|---|---|
| 5秒 | 3.54 | 約7秒以上 |
| 10秒 | 7.07 | 約14秒以上 |
| 20秒 | 14.14 | 約28秒以上 |
| 30秒 | 21.21 | 約42秒以上 |
記事間のばらつきが大きいと8本では小さな効果は見えません。「大きく効く要因があるかのスクリーニング」として使うのが正しい用途です。
多重比較の実務での使い分け
| 状況 | 使う手法 | 理由 |
|---|---|---|
| 現行 vs 新案1 vs 新案2 | ダネット | 現行が対照群。比較が2本に減るので有利(df=15 でテューキーより6.1%甘い) |
| 全案を横並びで比較 | テューキー | 対比較では常に最も有利 |
| 「案1と案2の平均 vs 案3」 | シェッフェ | 合成した対比を検定できる |
| 指標が複数(CTR・滞在時間・CVR) | ボンフェローニ / BH | 指標をまたぐ比較には分散分析の枠組みが使えない |
実務で最も多い失敗:覗き見
今回のテーマ(検定の繰り返し)の総まとめとして、いちばん実害の大きいパターンです。毎日結果を見て、有意になったところで止める。 これは検定を何十回も繰り返すのと同じです。
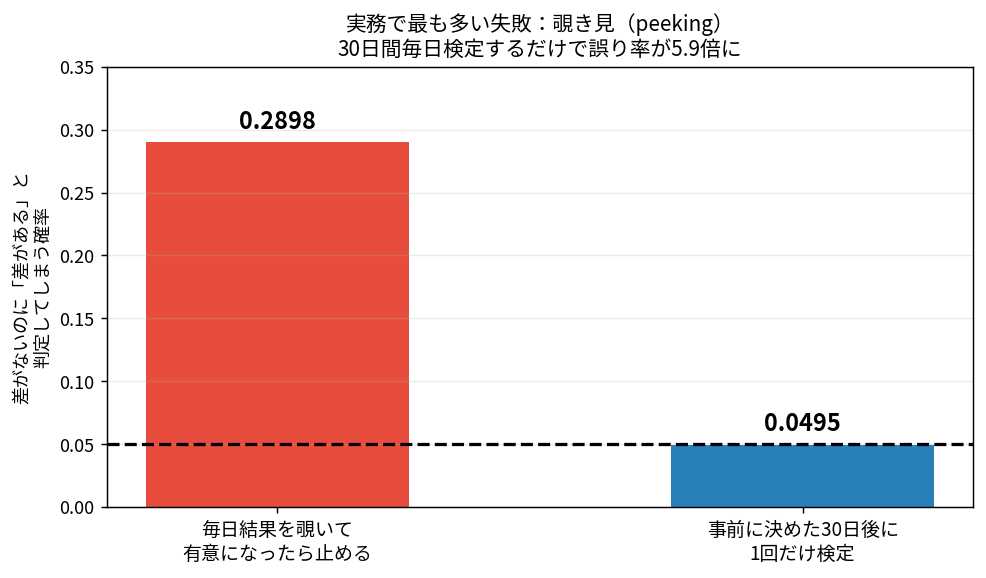
真の差が0のデータで30日間毎日検定すると、名目5%のはずが 0.2898(約29%)まで膨張します。30日後に1回だけ検定すれば 0.0495 で5%を保つ。覗き見だけで誤り率が5.9倍です。
しかも覗き見が厄介なのは、「有意になったら止める」という止め方自体が選択バイアスを生む点です。偶然大きく振れた瞬間を狙って切り取っているので、効果量も過大に推定されます。
対策は2つあります。ひとつは固定標本サイズで、事前に必要数を計算してそこまで結果を見ない。最もシンプルで確実です。もうひとつは逐次検定の手法で、どうしても途中で見たいなら群逐次デザインやα消費関数(O'Brien-Fleming 型など)を使い、覗く回数の分だけ各回の閾値を厳しくします。準1級の範囲では前者を理解していれば十分です。
自分が間違えていたこと
今回の学習で自分の誤解が修正された点を並べます。
「分散分析は3群以上専用の検定」だと思っていた。 2群でも使えて、そのときt検定と完全に一致します()。シミュレーションでも で誤り率が 0.0508 対 0.0508 と一致しました。
「分散分析と重回帰は別の手法」だと思っていた。 同じ計算です。F値が 8.223350 まで一致し、 が 、 が に対応します。
「複数の検定で誤りのリスクが積の形で積み重なる」と考えていた。 積になるのは「全部セーフ」の確率です。誤りはその補集合で、 という形で出します。
「素朴な が正しい膨張率」だと思っていた。 これは過大評価です。対比較は独立でなく、 という恒等式があるので自由に動けるのは 個だけ。実測 0.1090 に対し計算値 0.1426 でした。
「守る範囲が広いほど臨界値が厳しくなる」と一般化しかけた。 ボンフェローニとシェッフェの大小は状況で入れ替わります( で交差)。しかも交差の理由を「比較数 が増えるとボンフェローニが不利」と書きかけたのですが、 で を動かして検算するとシェッフェが一貫して厳しいままで、私の説明が誤りでした。正しくは「自由度が小さいと の極端な分位点が急に伸びる」ためです。
「ボンフェローニは独立を仮定した上限」と書いてしまった。 逆でした。ボンフェローニは依存構造を一切仮定しません(だから最も粗い)。独立を仮定するのは を使うシダック補正のほうです。
「テューキーが対比較で常に最も甘い」と断定しかけた。 単一ステップ手法の中では正しいのですが、段階的手法には負けることがあります。ホルム法は のケースで3本すべて棄却できるのに、テューキーは2本しか棄却できません。
「線形独立なのは2本」を「独立な検定が2本」と読み替えかけた。 線形独立と統計的独立は別物です。 と の相関は で、独立2本と考えると になり実測 0.1090 と合いません。
に4要因を置いたときの交絡を誤解していた。 「列3・5・6 を空ければ2因子交互作用が全部見られる」と書いたのですが、要因Dを列7 に置くと になり、、、 で2因子交互作用同士が交絡します。空き列として使えるのは要因が3つまでのときでした。
「切片なしダミー3本でもF値が一致する」と書いた。 残差平方和は一致しますが、統計ソフトが出す「モデル全体のF」は を検定する別物で、このデータでは 1000.5 になります。8.223350 を得るには検定する仮説を揃える必要がありました。
「 は7列だから行数−1が列数」と一般化しかけた。 2水準系に限った話です。3水準の列は1本で2自由度使うので、(9行)は4列が上限になります。
「Fが有意なら後の比較で補正は不要」と考えかけた。 でしか成立しません。 で部分帰無仮説だと誤検出率が 0.118〜0.272 に膨張します。
「局所管理はデータを見てグルーピングすること」だと理解しかけた。 順番が逆で、実験前に決める必要があります。結果を見てブロックを作ると誤り率が 0.3897(5%の7.8倍)に破綻しました。
「実験計画法は実験回数を減らす技術」だと思っていた。 正確には「交互作用の情報を捨てる代わりに回数を減らす」技術です。 で7要因を扱うと主効果と交互作用が交絡します。
直交表の 1/2 を「そのまま計算に使う数値」だと思っていた。 ただの名札で、計算時は ±1 に置き換えます。0/1 では内積が0にならないので代替できません。
要点まとめ
| 問い | 答え |
|---|---|
| なぜ3群以上でt検定を繰り返せないか | 誤り率が膨張する(k=6 で0.366、k=10 で0.630) |
| なぜ「分散」分析なのか | を群内と群間の2通りに推定して比べる検定だから |
| 分散分析=ダミー変数の重回帰か | 文字どおり同一。F値が小数第6位まで一致 |
| 分散分析は多重性を回避しているか | 回避ではなく問いを1つに束ねているので発生しない |
| F有意の後の多重比較は矛盾か | 矛盾ではない(問いが違う)。ただし補正は依然必要 |
| 交互作用とは | セル平均から行・列・総平均で説明できる分を引いた残り。あると主効果を単独で解釈できない |
| 多重比較の使い分け | 全対比較を単一ステップで→テューキー、対照群と→ダネット、任意の対比→シェッフェ |
| 直交表は何のために直交するか | を対角にするため。平均の差だけで効果が推定でき、列を削っても他の係数が動かない |
| の8は何か | 実験の回数(行数)。 で基本列3本。2水準列なら最大 本 |
| に7要因入れられるか | 入れられるが交互作用と交絡する。4要因でも2因子交互作用同士が交絡( 等) |
| 3原則の役割分担 | 反復が分母を作り、局所管理が分母を小さくし、無作為化が分子の偏りを消す |
次回
次回は第21章、標本調査法です。今回の「ブロック化で邪魔なばらつきを取り除く」という発想が、標本調査では層別抽出として現れます。母集団をあらかじめ層に分けておくと推定の精度が上がる、という同じ構造です。今回の局所管理が「実験する側」の話だったのに対し、次回は「すでにある母集団から抜き出す側」の話になります。
なお今回の「平方和を直交する方向に分解する」という発想は、後の第22章・主成分分析でもう一度出てきます。直交表で見た「垂直な方向に分けると互いに影響しない」という性質を、今度はデータの側から探しに行く回です。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。