「線形」はグラフの形ではない:ロジスティック回帰とオッズ比【第18回】
はじめに
第18章は質的回帰です。前回(第17回・回帰診断法)まで、目的変数 は売上や滞在時間のような連続した数値でした。今回はそこが変わります。 が「コンバージョンしたか、しなかったか」の0か1になる。
この章で一番の収穫は、正直に言うと章の内容そのものではありませんでした。「線形モデル」という言葉の意味を、私はずっと誤解していたという発見です。
ロジスティック回帰のグラフはS字カーブで、どう見ても直線ではありません。それなのに線形モデルの仲間として扱われる。ここが昔から引っかかっていました。調べる過程で分かったのは、「線形」が と の関係の話ではなく、パラメータ の入り方の話だったということです。 について1次式なら、グラフがどれだけ曲がっていても線形モデル。この一行を理解した瞬間に、第16回からの見え方がまとめて変わりました。
もうひとつ、この章は深層学習との接続点でもあります。ロジスティック回帰は「隠れ層のないニューラルネットワーク」そのもので、交差エントロピー損失は対数尤度の符号を反転しただけ。分類モデルの最終層でシグモイドを使う理由が、統計の側から説明できるようになります。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 記号で迷ったら 統計の記号がややこしいのは軸が2本あるからだった を先に読んでください。
- 前提になる重回帰分析は 第16回 で扱っています。
- オッズという言葉は 第2回・ベイズの定理 にも出てきました。今回それが同じものだと分かります。
この記事で使う言葉
3つだけ先に決めておきます。残りは出てきたところで説明します。
オッズ(odds):「成功する確率 ÷ 失敗する確率」つまり 。確率が「全体との比」なのに対し、オッズは負け組との比です。20人中4人が成功したなら確率は 、オッズは 。競馬やブックメーカーの「4対1」がこれです。
ロジット(logit):オッズの対数 。ロジスティック回帰が直線を引いているのはこの尺度の上です。 と に分かれるのではなく、プロビット(probit=probability unit)に倣った logistic unit の略です。「対数オッズ」とも呼びます。
GLM(Generalized Linear Model=一般化線形モデル):線形回帰を「正規分布以外の分布」と「リンク関数を挟む」の2方向に拡張した枠組み。ロジスティック回帰もポアソン回帰もこの中に入ります。今は「線形回帰の親戚をまとめた箱」くらいの理解で十分で、記事の後半で正体を見ます。
なお略語がいくつか出てきますが、初出のたびにスペルアウトを添えます。この記事で使うのは GLM、IRLS(Iteratively Reweighted Least Squares=反復重み付き最小二乗法)、MLE(Maximum Likelihood Estimation=最尤推定)、OLS(Ordinary Least Squares=通常の最小二乗法)の4つです。
困りごと:コンバージョン率を予測したい
具体的な設定から始めます。ウェブサイトのアクセスログがあって、訪問者ごとに次の2つが記録されているとします。
- 滞在時間 (分)
- コンバージョンしたか (購入・申込などをしたら1、しなければ0)
やりたいことは「滞在時間からコンバージョン確率を予測する」です。滞在が長い人は買いやすいはずなので、関係はありそうです。
データは400件、真のモデルを として生成しました(滞在時間は平均4分・右に裾を持つガンマ分布)。以降の数値はすべてこのデータから出しています。
第16回でやった最小二乗法をそのまま使えばよさそうに思えます。 が0と1しか取らないだけで、あとは同じではないか。やってみると4通りに壊れました。
失敗①:確率が[0,1]を飛び出す
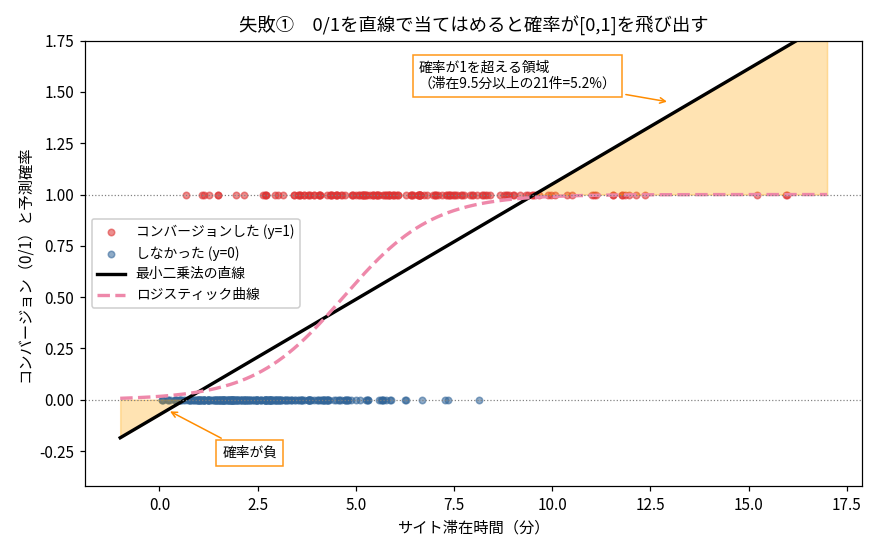
最小二乗法で当てはめた直線は でした。予測値の範囲を見ると −0.0665 から 1.7221 まで散らばっています。
- 1を超えたのが 21件(5.2%)
- 負になったのが 16件(4.0%)
滞在16分の訪問者には「コンバージョン確率 1.72」という予測が出ます。確率としてありえません。
ただし、これは4つの問題のうち一番軽いものです。予測値を0と1でクリップしてしまえば実用上は動いてしまうからです。「確率が1を超えるのが問題」という説明で止まると、なぜロジスティック回帰が必要なのかは伝わりません。残りの3つが本題です。
失敗②:等分散が原理的に成立しない
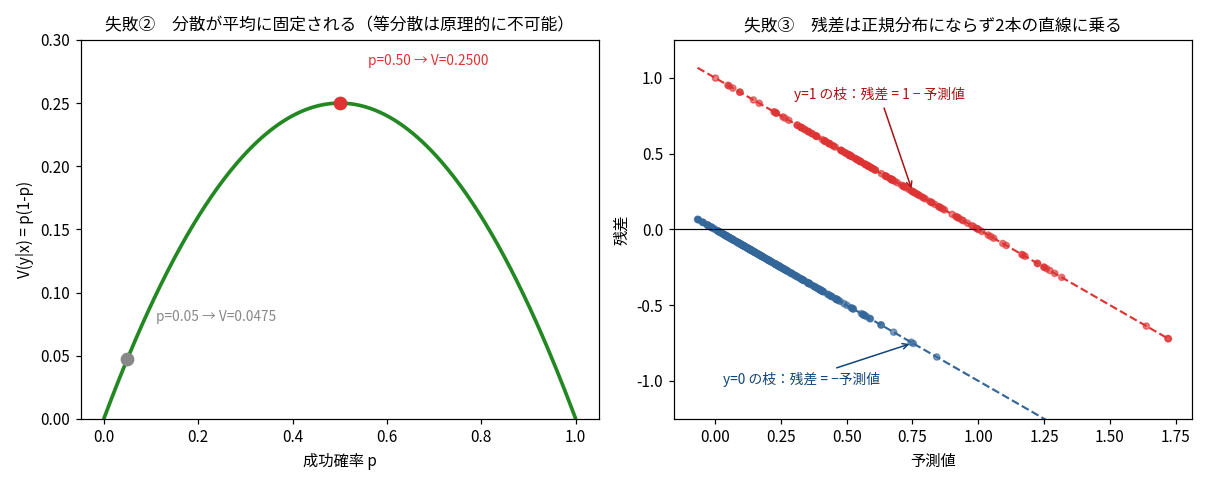
第17回で回帰の4つの仮定を扱いました。そのうち等分散性が、ここでは崩れるどころか定義から成立しえないことになります。
がベルヌーイ分布に従うなら、その分散は平均で決まります。
平均 が とともに動くのですから、分散も一緒に動きます。 を動かすと分散はこうなります。
| 0.05 | 0.0475 |
| 0.20 | 0.1600 |
| 0.50 | 0.2500 |
| 0.80 | 0.1600 |
| 0.95 | 0.0475 |
のときが最大で、両端に行くほど小さくなります。表の範囲(〜)でも 5.3倍 の開きがあり、 がさらに0や1に近づけば比はいくらでも大きくなります。実データの残差を予測値の順に4分割して分散を測ると 0.0595 / 0.1025 / 0.2389 / 0.1207 で、理論通りの山型になりました。
第17回では不均一分散を「データの性質によって起きたり起きなかったりする問題」として扱いました。ここが違います。0/1のデータでは、不均一分散を避ける方法がない。 加重最小二乗法で対処するという発想は正しい方向ですが、そもそもモデルの形から作り直したほうが素直です。
そしてこれは推定の効率の問題でもあります。頑健な標準誤差を使えば検定は救えますが、分散の構造が分かっているのにそれを無視して等重みで当てはめる以上、推定量のばらつきは大きくなります。 が0や1に近い観測ほど情報が多い(分散が小さい)のに、最小二乗法はすべてを同じ重みで扱ってしまう。
失敗③:残差が正規分布になりえない
同じ図の右側です。残差 を予測値に対してプロットすると、点が2本の直線に完全に乗ります。
の観測は残差が 、 の観測は 。この2通りしかないので当然です。滞在時間4分付近の残差を並べるとこうなりました。
-0.383 -0.379 -0.376 -0.370 0.613 0.615 0.617 0.617 0.631 0.631
−0.38付近と+0.62付近に分かれて、中間がありません。正規分布のような釣鐘型にはなりようがない。
これが効いてくるのは検定です。第16回で係数の 検定、第13回で 分布を扱いましたが、それらは誤差の正規性を前提にしていました。ここでは前提が完全に外れるので、有限標本で厳密な 検定は使えなくなります。
ただしこの問題だけならロジスティック回帰は必要ありません。 不均一分散に頑健な標準誤差(ホワイトの標準誤差)を使えば、 が大きいとき中心極限定理(第8回)によって漸近的な推論は成立します。実際、経済学では0/1を線形回帰する線形確率モデルが「平均的な変化量を素直に読める」という理由で今も使われています。
つまり失敗①と失敗③は比較的軽い側で、本当に効くのは失敗②の効率の悪さと、次に見る失敗④の「効果が一定という強制」でした。
失敗④:効果が一定だと強制してしまう
実務ではこれが一番痛い問題だと思います。
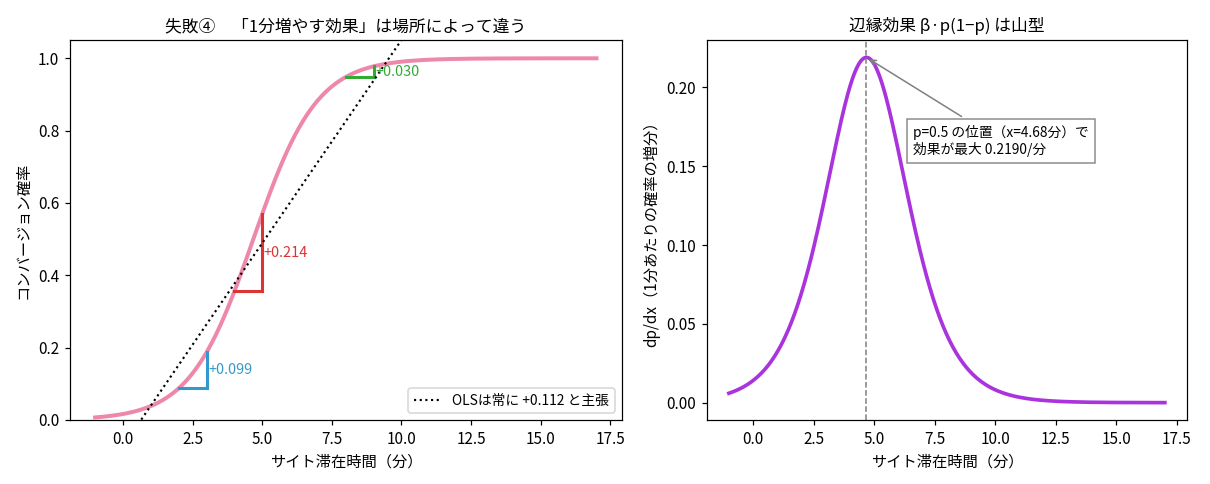
直線 は「 が1増えたら は必ず 増える」と主張します。 がどこにあっても同じだけ増える。しかし現実のコンバージョンはそうなっていません。
ロジスティック回帰で当てはめた結果から、滞在時間を1分増やしたときの確率の変化を計算しました。
| 滞在時間 | 確率の変化 |
|---|---|
| 2分 | 0.087 → 0.187(+0.099) |
| 4分 | 0.355 → 0.570(+0.214) |
| 6分 | 0.761 → 0.884(+0.123) |
| 8分 | 0.948 → 0.978(+0.030) |
| 14分 | 1.000 → 1.000(+0.0002) |
効果は場所によって大きく違います。2分から8分のあいだでも7.3倍、14分まで含めれば1291倍の開きです。最小二乗法はどこでも「+0.112」と主張しますが、これはおおむね平均的な傾きを表しているにすぎません。
この違いは施策の判断そのものです。「滞在時間を1分伸ばす」という施策を打つとき、4分の人を5分にするのが最も効き(+0.214)、8分の人を9分にしてもほとんど無駄(+0.030)。この非線形性を直線で潰してしまうと、限られた予算をどこに配分するかの判断を誤ります。
図の右側は、この「1単位あたりの変化」を微分で表したものです。
これを限界効果(marginal effect)と呼びます。なお同じ marginal でも、分布の話では「周辺・辺縁」と訳し、微分の話では「限界」と訳します。後で「周辺分散」という語も出てくるので、訳し分けに注意してください。 が掛かっているので で最大、両端でゼロに近づく山型になります。今回のデータでは になる滞在時間が 4.68分 で、そこでの効果が最大の 0.219/分 でした。
分散が 、限界効果も 。 失敗②と失敗④に同じ形が出てくるのは偶然ではなく、後で見る指数型分布族の構造から来ています。
解決の方針:尺度を張り替える
4つの失敗の根っこは共通しています。確率は0から1という狭い器に閉じ込められているのに、直線 は を自由に動く。 器の大きさが違うものを等号で結ぼうとしているのが無理の原因です。
やるべきことは2つのうちどちらかです。
- 直線の側を に押し込める
- 確率の側を に引き伸ばす
採用されたのは2番です。しかも2段構えで引き伸ばします。
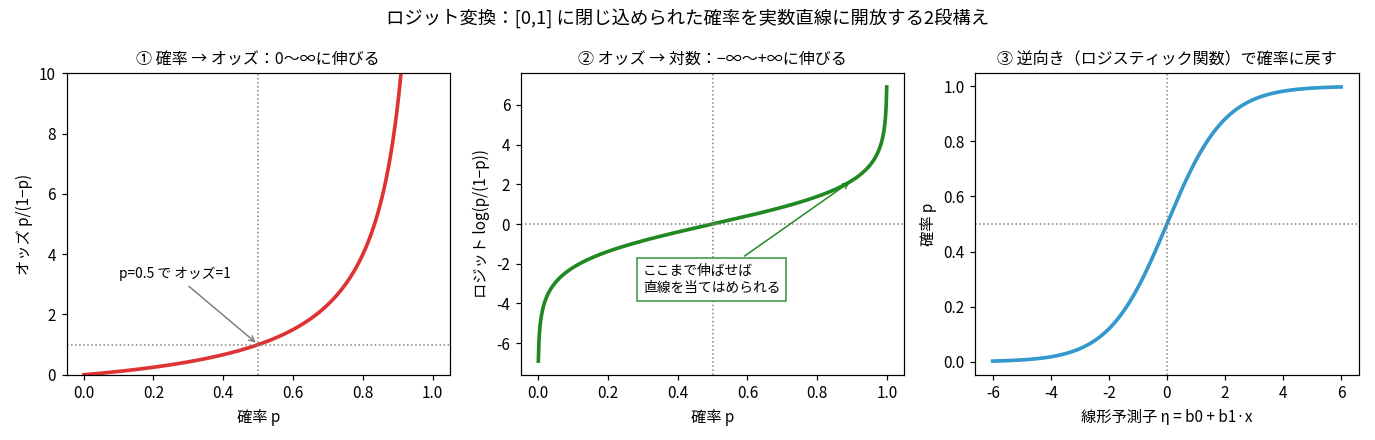
端点を含まない開区間で書いたのは、 や ではロジットが に飛んで定義できないからです。この「端では定義できない」という性質が、後で完全分離の話につながります。
1段目で天井が外れ、2段目で床が外れます。ここまで伸ばして初めて、直線を当てはめる資格が生まれます。
これがロジスティック回帰です。逆向きに解くと確率が戻ってきます。
この関数をロジスティック関数、機械学習の文脈ではシグモイド関数と呼びます。同じものです。
オッズがピンとこない問題
ここで一度立ち止まります。ロジット変換の1段目に出てきたオッズが、私にはずっと馴染めませんでした。確率で足りているのに、なぜわざわざ別の指標を持ち出すのか。
まず定義そのものを絵にします。
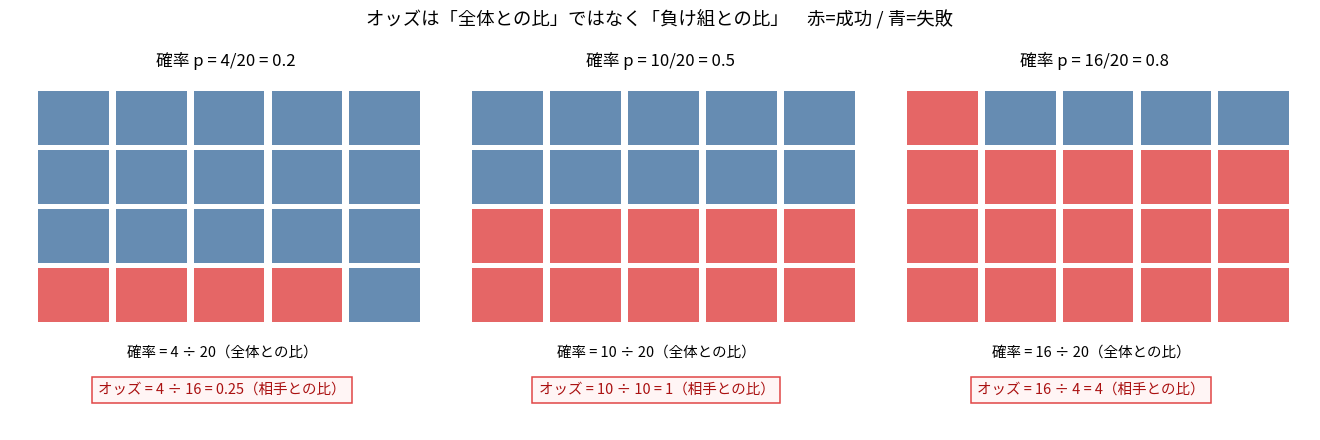
違いは分母だけです。
- 確率
- オッズ
20人中4人が成功したなら、確率は 、オッズは 。16人成功なら確率 、オッズ 。
この絵を見て納得できたのは、オッズが確率よりも「変化に敏感」だという点です。確率が と4倍になるあいだに、オッズは と16倍になっています。確率は上限0.8で頭打ちに近づいていますが、オッズにはまだ余裕がある。この余裕が、上限を外すという役割につながっています。
対応表を作ると感覚がつかめます。
| 確率 | オッズ | ロジット | 言い方 |
|---|---|---|---|
| 0.01 | 0.0101 | −4.595 | 1対99 |
| 0.10 | 0.1111 | −2.197 | 1対9 |
| 0.20 | 0.2500 | −1.386 | 1対4 |
| 1/3 | 0.5000 | −0.693 | 1対2 |
| 0.50 | 1.0000 | 0.000 | 1対1 |
| 2/3 | 2.0000 | +0.693 | 2対1 |
| 0.80 | 4.0000 | +1.386 | 4対1 |
| 0.90 | 9.0000 | +2.197 | 9対1 |
| 0.99 | 99.000 | +4.595 | 99対1 |
でオッズ1・ロジット0。ロジットが0を中心に対称なのが気持ちいいところです。 と を入れ替えるとロジットの符号が反転するだけになります。
第2回のオッズと同じものか
この疑問には、はっきり答えがあります。まったく同じものです。しかも偶然の一致ではありません。
第2回 でベイズの定理を扱ったとき、こういう形が出てきました。
第2回の検査の例(有病率0.1%、感度99%、特異度99%)で検算します。
- 事前オッズ
- 尤度比
- 事後オッズ
- 事後確率
ベイズの式から直接計算しても 0.0902 で一致します。ここで両辺の対数をとってみます。
掛け算が足し算になりました。そしてこの右辺の形を、ロジスティック回帰の式と並べてみます。
構造が同じです。 各係数は「その変数がもたらす証拠の重み」として読めます。
ただしこの読み替えには条件があります。条件なしで成り立つのは、説明変数をベクトルごとひとまとめにした形だけです。
右の項を変数ごとの和に割るには、 を与えたときに説明変数が条件付き独立であること(=ナイーブベイズ)が必要で、さらに各項が の1次式になるには類条件付き分布に制約(等分散の正規分布、ベルヌーイなど)が要ります。
そしてロジスティック回帰そのものは条件付き独立を仮定していません。事後確率を直接モデル化する判別的なモデルなので、生成側の仮定を置かずに係数を推定します。切片についても注意が必要で、 は「事前のロジット」ではなくすべての説明変数が0のときのロジットです。
それでも構造の一致は示唆的です。「なぜ確率ではなくオッズなのか」の答えがここにあります。掛け算で更新される量だから、対数をとると足し算になる。 確率そのままでは、この分解ができません。第2回でオッズに触れたのが伏線として効いた形です。
オッズ比の解釈が実務で混乱する
係数の意味に進みます。ロジスティック回帰の係数 は、こう解釈するのが定番です。
が1増えると、オッズが 倍になる
導出は一行です。 を1増やすとロジットが 増えるので、オッズは 倍になります。この をオッズ比(odds ratio)と呼びます。今回のデータでは なので 。「滞在時間が1分増えるとコンバージョンのオッズが2.40倍」です。
問題は、これを「確率が2.40倍」と読んではいけないという点です。ここが実務で最も事故が起きるところだと思います。
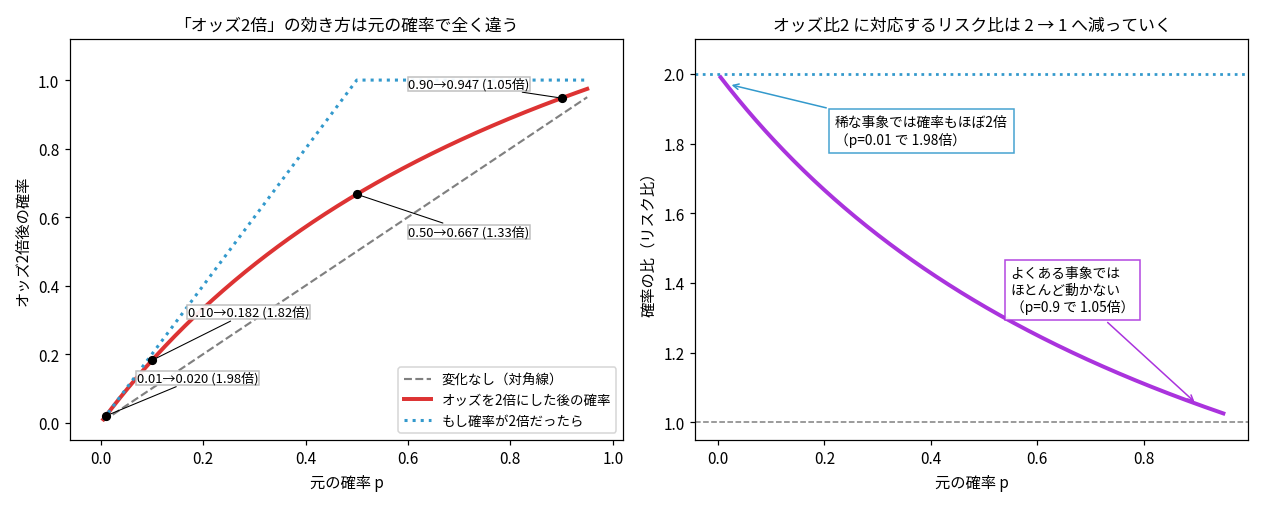
分かりやすいようにオッズ比2で計算します。
| 元の確率 | オッズ2倍後の確率 | 確率の比 | 確率の差 |
|---|---|---|---|
| 0.01 | 0.0198 | 1.98倍 | +0.010 |
| 0.05 | 0.0952 | 1.90倍 | +0.045 |
| 0.10 | 0.1818 | 1.82倍 | +0.082 |
| 0.20 | 0.3333 | 1.67倍 | +0.133 |
| 0.50 | 0.6667 | 1.33倍 | +0.167 |
| 0.70 | 0.8235 | 1.18倍 | +0.124 |
| 0.90 | 0.9474 | 1.05倍 | +0.047 |
元の確率が小さいときはオッズ比 ≒ 確率比、大きいときは全く別物になります。 ならオッズを2倍にしても確率は5%しか増えません。
逆向きにも見ておきます。「確率を2倍にする」ためにはオッズ比がいくら必要か。
| リスク比 | オッズ比 | ||
|---|---|---|---|
| 0.01 | 0.02 | 2.0 | 2.02 |
| 0.05 | 0.10 | 2.0 | 2.11 |
| 0.10 | 0.20 | 2.0 | 2.25 |
| 0.20 | 0.40 | 2.0 | 2.67 |
| 0.30 | 0.60 | 2.0 | 3.50 |
| 0.45 | 0.90 | 2.0 | 11.0 |
同じ「確率2倍」なのに、オッズ比は2.02から11.0まで変わります。オッズ比は大きく出やすい指標だということです。論文やレポートで「オッズ比11」と書いてあっても、元の確率が高ければ確率は2倍にすぎない場合があります。
両者の関係は恒等式で書けます。
この形を見ると、近似が成り立つ条件は、両群とも事象が稀であることだと分かります。基準群の確率 が小さいだけでは足りません。 でもリスク比が10なら になり、オッズ比は でリスク比の1.9倍にずれます。
実務での指針
まとめるとこうなります。
- コンバージョン率が数%で、効果も極端でない世界( も も小さい)では、オッズ比をリスク比のように読んでもほぼ問題ない
- メール開封率60%のような高い水準を扱うときは、オッズ比を確率に戻して報告する
- 報告時は「基準となる確率」を必ず添える。オッズ比だけでは意味が定まらない
実際の報告では、代表的な値での予測確率を並べるのが安全です。「滞在4分の人のコンバージョン確率は35.5%、5分なら57.0%」と書けば誤解の余地がありません。オッズ比はモデルの内部で係数を解釈するための量で、意思決定者に見せる量としては確率のほうが適しています。
なぜ解析的に解けないのか
ここから推定の話に移ります。第10回 で最尤法を扱ったとき、正規分布のケースでは推定値が式で書けました。ロジスティック回帰では書けません。この違いはどこから来るのか。
スコア方程式(対数尤度の微分をゼロにする式)を並べると一目で分かります。
線形回帰:
について1次式なので、移項するだけで正規方程式になります。あとは連立方程式を解けば終わりです。
ロジスティック回帰:
が の指数の中に埋まっています。外に取り出す操作がありません。これは多項式でも有理式でもない超越方程式で、四則演算と初等関数だけでは一般に解の表示が知られていません。
ここは正確に言う必要があります。超越方程式であること自体は「閉じた式で書けない」ことを意味しません。 も超越方程式ですが と書けます。「書ける/書けない」は、どの関数を既知とみなすかに依存する相対的な話です。次の節でその感覚を掘ります。
念のため数式処理システム(sympy)に の最小例を渡してみましたが、答えを返さずタイムアウトしました。もちろんこれは非存在の証明ではありません(解けなかっただけです)。ただ、汎用の記号処理でも歯が立たない種類の式だという体感は得られました。
単調だから解けるのでは、という疑問
ロジスティック関数は単調増加で素性がよいので、解析的に解けそうな気がしていました。この直感は半分正しく、半分は別の話です。
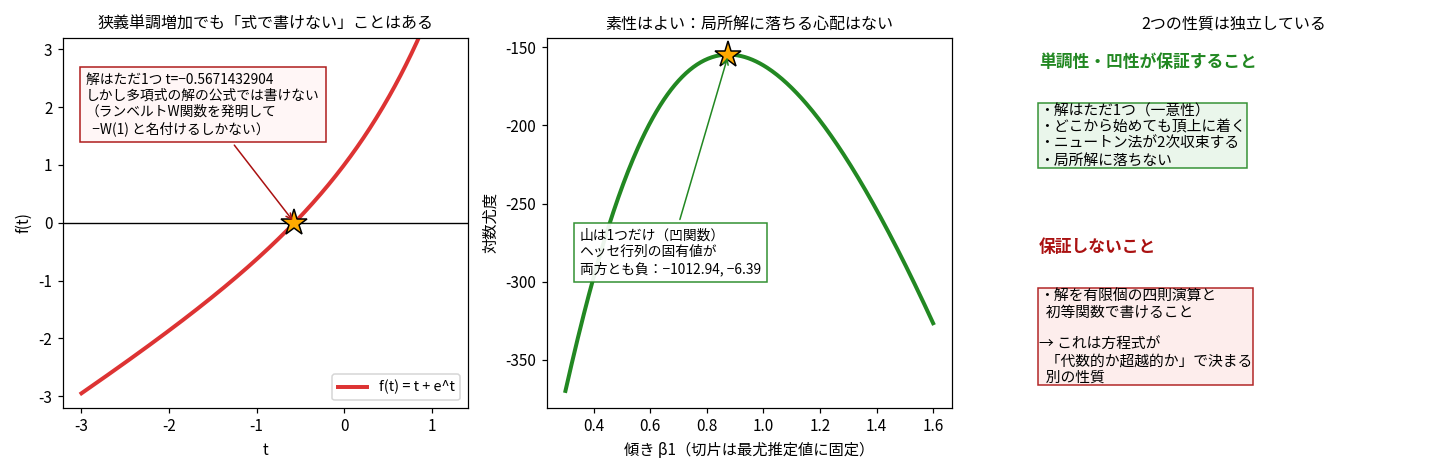
素性がよいという部分は本当です。ロジスティック回帰の対数尤度は凹関数で、ヘッセ行列 の固有値を計算すると −1012.94 と −6.39 でどちらも負でした。狭義の凹関数なので山は1つだけ。局所解に落ちる心配がなく、どこから始めても同じ頂上に着きます。
しかしそれは「式で書けること」を保証しません。この2つは独立した性質です。
一番簡単な反例を挙げます。 は なので狭義単調増加、 の解はただ1つです。では式で書けるか。sympy に解かせるとこう返ってきました。
解: [-LambertW(1)]
数値解: -0.5671432904
ランベルトW関数という「新しい関数を発明して名前を付ける」以外に書き方がありません。 単調で解が一意なのに、初等関数の範囲では書けない例です。
身近な例では、惑星の位置を求めるケプラー方程式 も単調ですが について解析的に解けず、数百年ずっと数値解法が使われています。
整理するとこうなります。
| 問い | 答え | 根拠 |
|---|---|---|
| 解は一意に決まるか | 決まる | 対数尤度が凹(固有値が全て負) |
| 数値計算は安定か | 安定 | 局所解なし・7回で収束 |
| 初等関数で書けるか | 書けない | 表示が知られていない(超越方程式) |
ただし1行目には条件が2つ付きます。狭義の凹(=最大点が一意)には設計行列がフルランクであることが必要で、完全な多重共線性があると平坦な方向が残ります。そして最大点が有限の で存在するには、データが完全分離していないことが必要です。この2つ目の条件が破れたときに何が起きるかは、後の Hauck-Donner効果の節で扱います。
「解ける」という言葉が二重の意味を持っているのが混乱の元でした。「解が存在して一意か」なら解ける。「紙の上で と初等関数で書けるか」なら解けない。
反復計算の中身は「重み付き最小二乗の繰り返し」
閉じた式がないので数値的に解きます。使うのはニュートン・ラフソン法ですが、この文脈では別の名前で呼ばれます。
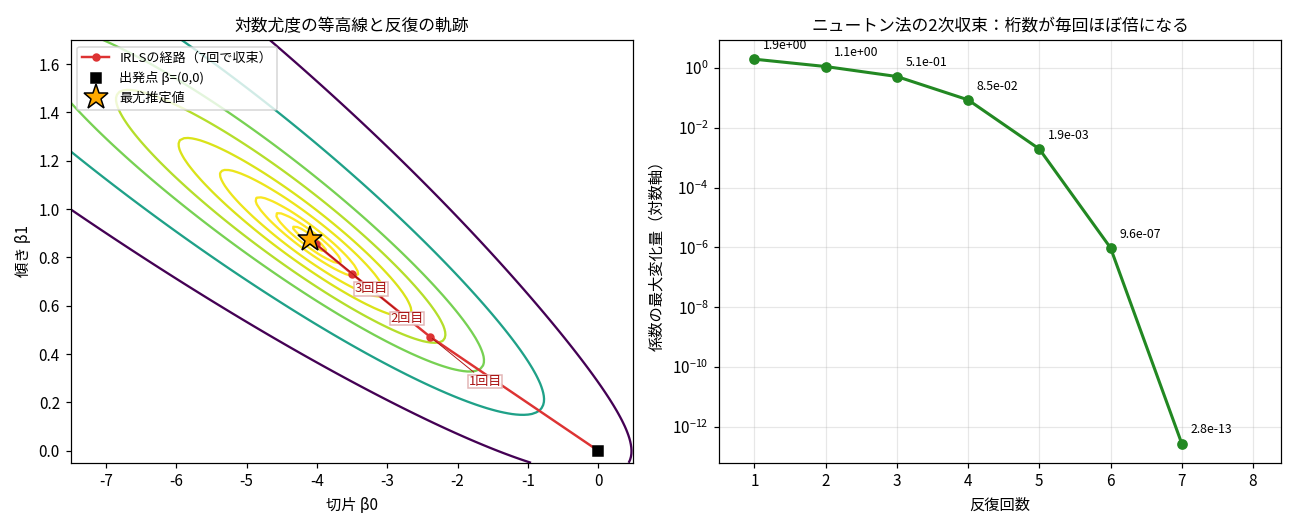
実際に回すと7回で収束しました。
| 反復 | 最大変化量 | ||
|---|---|---|---|
| 1 | −2.3938 | 0.4724 | 1.9e+00 |
| 2 | −3.5001 | 0.7321 | 1.1e+00 |
| 3 | −4.0135 | 0.8553 | 5.1e−01 |
| 4 | −4.0987 | 0.8756 | 8.5e−02 |
| 5 | −4.1006 | 0.8761 | 1.9e−03 |
| 6 | −4.1006 | 0.8761 | 9.6e−07 |
| 7 | −4.1006 | 0.8761 | 2.8e−13 |
変化量が と、後半で桁数がほぼ倍々に縮んでいます。これがニュートン法の2次収束です。最初の3回が倍々になっていないのは、2次収束が解の近傍でだけ現れる局所的な性質だからです。1階微分だけを使う勾配降下法だと最後まで一定の割合でしか縮まないので、この差が出ます。
面白いのは、この1ステップの中身がただの重み付き最小二乗法だという点です。手で書くとこうなります。
- 現在の から 、 を計算
- 作業重み を作る
- 作業応答 を作る
- を解く(=重み付き最小二乗)
- 収束するまで1に戻る
実際に手で回すと、収束値がニュートン法の実装と一致しました(初期値の置き方が違うので途中の値はずれます)。
1回目 WLS の解: [-2.29228282  0.44953095]
4回目 WLS の解: [-4.09778673  0.87542737]
7回目 WLS の解: [-4.10061220  0.87609608]  ← 収束(上の表と一致)
この手続きを IRLS(Iteratively Reweighted Least Squares=反復重み付き最小二乗法) と呼びます。読み方はそのまま「重みを付け替えながら最小二乗を繰り返す」です。
なお上に書いた 、 はロジットリンクだから成り立つ簡略形です。一般形は
で、正準リンクのときだけ となって分母と分子が約されます。この点は後のGLMの節で確認します。
もう一つ、正準リンクには期待情報行列と観測情報行列が一致するという性質があり、そのおかげでニュートン・ラフソン法とフィッシャースコアリング法が完全に同じ計算になります。非正準リンク(プロビットなど)では両者は別物で、IRLSはフィッシャースコアリングの側に対応します。
線形回帰は「1回で終わるIRLS」という位置づけになります。恒等リンクだと作業重みが で一定なので、重みを付け替える必要がなく1回で収束する。ここで第16回とつながります。
作業重みが何をしているか
という重みの意味を確認しました。予測確率ごとに平均の重みを出すとこうなります。
| 予測確率の範囲 | 件数 | 平均の重み |
|---|---|---|
| 0.0〜0.1 | 121 | 0.0520 |
| 0.1〜0.3 | 90 | 0.1457 |
| 0.3〜0.7 | 87 | 0.2358 |
| 0.7〜0.9 | 44 | 0.1609 |
| 0.9〜1.0 | 58 | 0.0329 |
予測が0か1に振り切れている観測は、ほとんど重みを持ちません。 「絶対に買わない人」「絶対に買う人」からは情報が取れず、 付近の「どちらに転ぶか分からない人」が推定を支えている。
ここは第10回のフィッシャー情報量とつながりますが、条件を付けないと逆のことも言えてしまうので注意が必要でした。
対数オッズ を推定する上での情報量は で、 で最大です。一方で確率 そのものを推定する情報量は で、 が最小・両端が最大になります。
| の情報量 | の情報量 | |
|---|---|---|
| 0.1 | 0.0900 | 11.1111 |
| 0.5 | 0.2500 | 4.0000 |
| 0.9 | 0.0900 | 11.1111 |
同じ観測なのに、何を推定したいかで「情報が多い場所」が反転します。この記事で何度も出てくる「同じ語が2つの別物を指す」罠の一例です。
なお実験計画の話に広げるのは危険でした。2パラメータのロジスティック回帰のD最適計画は の1点ではなく、( と )の2点です。情報行列は で の広がりも効くため、作業重みだけを見て「微妙な条件がよい」と結論するのは早すぎます。
「線形モデル」の線形はどこにかかっているのか
ここが今回いちばんの発見でした。節を割いて書きます。
ロジスティック回帰のグラフはS字で、直線にはまったく見えません。それなのに線形モデルの一族として扱われる。この違和感の正体は、「線形」という言葉を私が誤読していたことでした。
「線形」は と の関係が直線という意味ではありません。パラメータ について1次式という意味です。
同じモデルを3つの尺度で見る
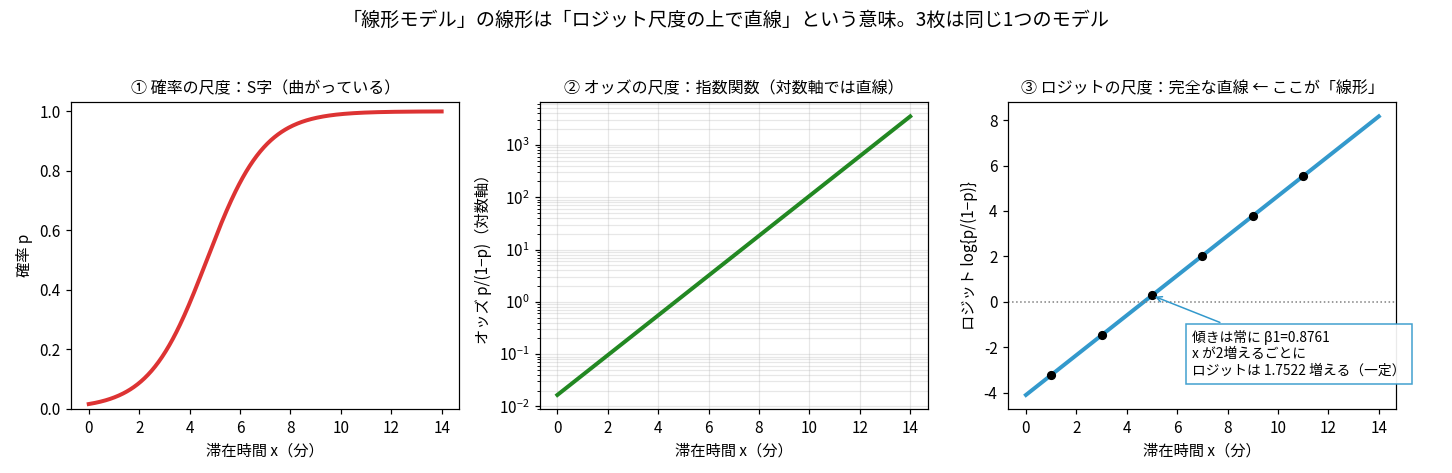
3枚の図はすべて同じ1つのモデルです。見ている尺度だけが違います。
| 尺度 | 見た目 |
|---|---|
| 確率 | S字カーブ(曲がっている) |
| オッズ | 指数関数(対数軸なら直線) |
| ロジット | 完全な直線 |
実データで検算しました。当てはめた確率をロジットに戻すと、 と小数点以下6桁まで一致します。
| 1.0 | 0.038253 | −3.224516 | −3.224516 |
| 5.0 | 0.569514 | +0.279868 | +0.279868 |
| 11.0 | 0.996075 | +5.536445 | +5.536445 |
が2増えるごとのロジットの増分を並べると 1.7521922 が5回連続 で、小数点以下10桁まで一定でした。完全な直線です。
つまりロジスティック回帰は、曲がった関係が直線に見える尺度を探してきたモデルです。曲がっているのは確率という尺度のせいで、モデルの骨格はまっすぐ。だから線形を名乗る資格があります。
線形モデルと非線形モデルの境界
判定基準は一つだけです。リンク関数で変換した尺度の上で、 が1次式になっているか。
| 式 | 判定 | 理由 |
|---|---|---|
| 線形 | が1次 | |
| 線形 | は曲がるが は1次 | |
| 線形 | 変数をどう加工しても が1次なら線形 | |
| 非線形 | が指数の位置にいる | |
| 非線形 | 上限 自体を推定する(成長曲線モデル) |
第16回で「 も線形モデル」という話が出ましたが、まったく同じ理屈でした。あのとき「 は曲線なのに線形と呼ぶのか」と思ったのを覚えています。答えは「 の姿は関係ない」でした。
について1次だと何が嬉しいのか
これが単なる言葉の約束ではなく、解き方そのものを決めているという点が本題です。
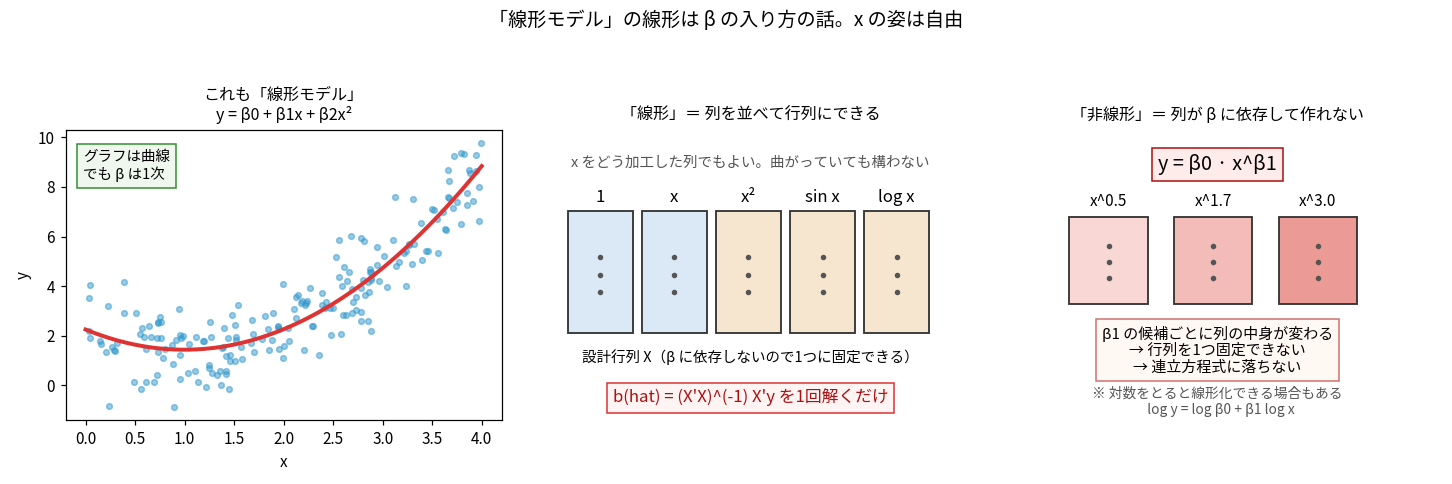
が1次でしか現れないと、設計行列 を1つに固定できます。列の中身が に依存しないからです。
こう並べてしまえば、あとは を1回解けば終わりです。実際にかなり無茶な形で試しました。
真値 に対して推定は 。 も も7乗も混ざっているのに、直線のときと解き方が1文字も変わりません。
一方 では、 が0.5なのか1.7なのか3.0なのかで列の中身自体が変わってしまうので、行列を1つに固定できません。連立方程式に落ちない、というのが「非線形」の実体です。
ただしこの例は救えます。両辺の対数をとると で線形になり、真値 を と推定できました。リンク関数も対数変換も、狙いは同じで、非線形に見えるものを線形の枠に持ち込むことなのだと分かります。
GLMで何が失われたのか
この定義を押さえると、GLMの限界を正確に言えるようになります。
| 恩恵 | 線形回帰 | GLM(ロジスティック等) |
|---|---|---|
| 設計行列 を固定できる | できる | できる(維持される) |
| が の線形結合 | と厳密に書ける | 書けない(反復が必要) |
| の分布 | 正規誤差なら厳密に正規 | 漸近的にだけ正規 |
| 分散 | (厳密) | (近似・ が推定値依存) |
①は生き残り、②③が「厳密」から「漸近的」に格下げされています。
これで前から気になっていたことが解けました。第11回・第13回では 分布を丁寧に扱ったのに、ロジスティック回帰では急に (正規近似)が出てくる。理由は、厳密分布が手に入らないからでした。 が の線形結合で書けないので、正規分布から 分布を導く筋道が使えません。
もう一つ直接的な理由があります。 分布は「正規の を、推定した分散で割る」構造から生まれるのですが、二項分布とポアソン分布では散布パラメータ が既知なので、割る対象がありません。逆に言うと、後で出てくる準ポアソンやガンマ回帰では を推定するため、慣習的に を使います。 一択なのは が既知の場合だけです。
そして格下げの代償が、次の節で見る現象です。
Hauck-Donner効果:データが綺麗すぎると検定が壊れる
第12回 で尤度比検定・ワルド検定・スコア検定の3つを扱い、そこで Hauck-Donner効果(ハウク・ドナー効果)という名前だけ出しました。ロジスティック回帰で起きる現象なので、ここで実物を見ます。
用意するのは、完全に分離したデータです。
x = [-3, -2, -1, -0.5,  0.5,  1,  2,  3]
y = [ 0,  0,  0,  0,     1,   1,  1,  1]
を境に綺麗に分かれています。誰が見ても は効いています。ところが検定にかけると異常が起きます。
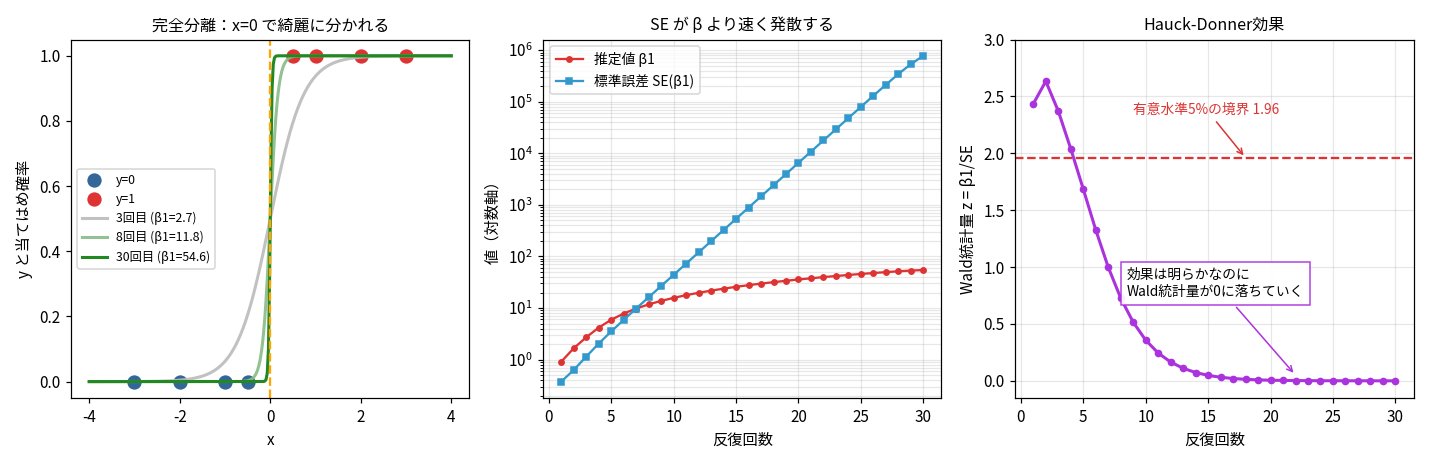
| 反復 | Wald | 値 | ||
|---|---|---|---|---|
| 2 | 1.66 | 0.63 | 2.633 | 0.0085 |
| 3 | 2.71 | 1.14 | 2.371 | 0.0178 |
| 5 | 5.92 | 3.52 | 1.685 | 0.0919 |
| 8 | 11.77 | 16.19 | 0.727 | 0.4673 |
| 12 | 19.76 | 119.79 | 0.165 | 0.8690 |
| 20 | 35.76 | 6540.44 | 0.006 | 0.9956 |
| 30 | 54.57 | 777292 | 0.0001 | 0.9999 |
係数は発散し続けるのに、ワルド統計量 は0に向かって落ちていきます。 有意水準5%で判定すると「効果なし」という結論が出ます。効果は目で見て明らかなのに。
なぜ標準誤差のほうが速く膨らむのか。標準誤差は次の形をしています。
分離データでは当てはめ確率が0と1に張り付くので、 が について指数的に0へ落ちます。すると標準誤差は 程度で膨らみ、線形にしか増えない を必ず追い越します。IRLSの作業重みがゼロに潰れていく話(作業重みの節)と同じ現象を、別の角度から見たことになります。
なぜ発散するかというと、完全分離では尤度の最大値が有限の で達成されないからです。傾きを急にすればするほど当てはまりがよくなり、 で対数尤度が0(=完璧な予測)に近づく。最尤推定値が存在しないという状態です。
尤度比検定は壊れない
同じデータで尤度比検定をやると、少なくとも0に落ちるという壊れ方はしません。
- 切片のみのモデルの対数尤度:
- 完全分離時の対数尤度の上限:( で近づくが達成されない)
- 尤度比統計量の上限:
- 自由度1の で
「上限」と書いたのは大事なところです。数行前に「最尤推定値が存在しない」と書いたのだから、最大値が達成されるとは言えません。どの有限の でも対数尤度は厳密に負で、0はあくまで近づく先です。
そしてこの という数値自体は信用してはいけません。 で、しかも最尤推定値が境界にある状況なので、漸近 近似の前提が最も崩れる場面です。同じデータをフィッシャーの正確検定(第14回)で評価すると、片側 、両側 です。 の は両側に相当するので と比べると、33倍もずれています。なお が連続値なので、厳密には を0で二値化した2×2表の話(一般には並べ替え検定や正確ロジスティック回帰)です。
正しい言い方はこうなります。ワルド検定は「効果なし」側に振り切れるが、尤度比検定は有意側に留まる。 の値そのものは小標本では当てにならないので、正確検定や罰則つき尤度(後述のFirthの補正)を使うのが筋です。
第12回で「3つの検定は漸近的に同じ」と書きましたが、その但し書きが効いてくる場面がここでした。同じ曲線を違う場所で測っているので、条件が悪いと結果が食い違う。
もう一段踏み込むと、この現象の本質はワルド検定がパラメータの取り方に依存することです。同じ帰無仮説「オッズ比 」を で検定するか で検定するかで、ワルド統計量は別の値になります。尤度比検定とスコア検定はこの取り替えに対して不変ですが、ワルド検定は不変ではない。Hauck-Donner効果はその非不変性が極端に出た姿だと読めます。
完全分離は特殊事情ではなかった
ここで一歩踏み込んで確かめてよかったと思います。「完全分離という極端な場合の話」だと片付けそうになったのですが、乖離は連続的に起きていました。
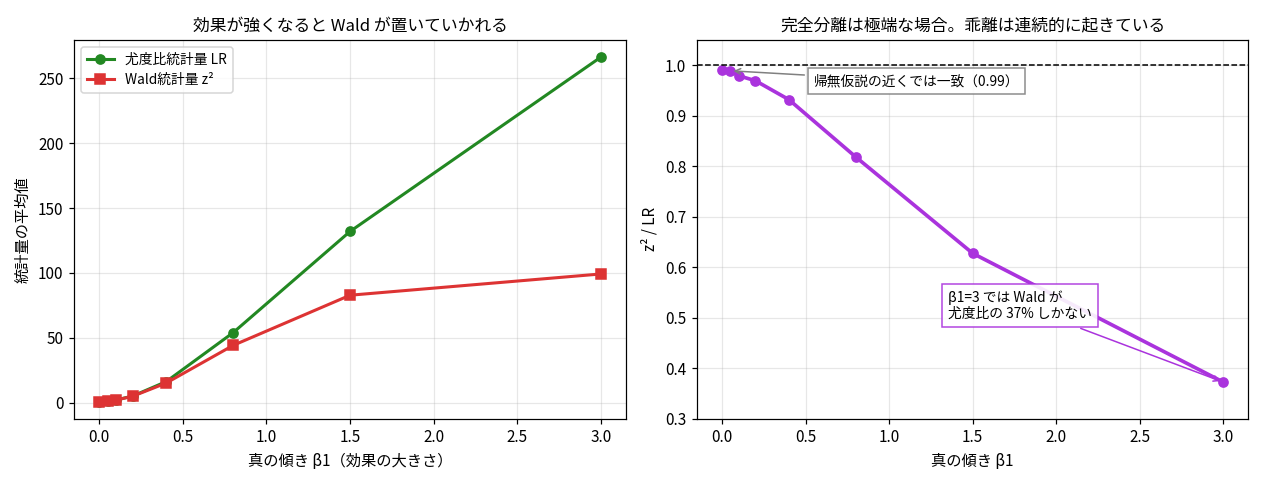
真の傾きを変えて、両者の平均を比べます(、各200回)。
| 真の | Wald | 尤度比 | |
|---|---|---|---|
| 0.00 | 0.853 | 0.862 | 0.989 |
| 0.05 | 1.075 | 1.087 | 0.989 |
| 0.10 | 2.017 | 2.060 | 0.979 |
| 0.20 | 4.988 | 5.146 | 0.969 |
| 0.40 | 15.14 | 16.25 | 0.932 |
| 0.80 | 44.14 | 53.94 | 0.818 |
| 1.50 | 82.83 | 132.0 | 0.628 |
| 3.00 | 99.21 | 266.3 | 0.373 |
帰無仮説の近くでは一致しますが、効果が強くなるほどワルドが置いていかれます。 では尤度比の37%しかありません。完全分離はこの曲線の極限にあるだけで、境界事例ではなかった。
ただし表の右下を過剰に読まないよう注意が必要です。 の水準では両方の統計量が巨大なのでどちらでも棄却されます。実害が出るのは「効果が強く、かつ標準誤差が暴走し始める境界のあたり」で、・ の反復には分離に近いデータも混じるため平均値は外れ値に引かれています。
ただし帰無仮説のもとでのサイズは両方とも守られています(、3000回)。
- 尤度比検定:0.0447
- ワルド検定:0.0430
- 名目:0.05
の平均は 0.9853( の期待値1)、上側5%点は 3.6976(理論値3.8415)でした。やや保守的ですが問題ない範囲です。
実務での指針
- 効果が大きいのに 値が微妙なとき、ワルド検定を疑う。 尤度比検定で確認する
- 係数が20とか50といった異常な値になったら、完全分離を疑ってクロス集計を見る
- 完全分離への処方は罰則つき最尤法(Firthの補正、リッジ)。有限の推定値に落ち着く
このリッジという処方は、深層学習でいう重み減衰(weight decay)と同じものです。統計と機械学習が別々に見つけた同じ薬だと考えると納得しやすい。
一般化線形モデル:3つの部品に分解する
ここまでロジスティック回帰を個別に見てきましたが、同じ骨格が広い範囲で使い回せます。それが GLM(Generalized Linear Model=一般化線形モデル)です。
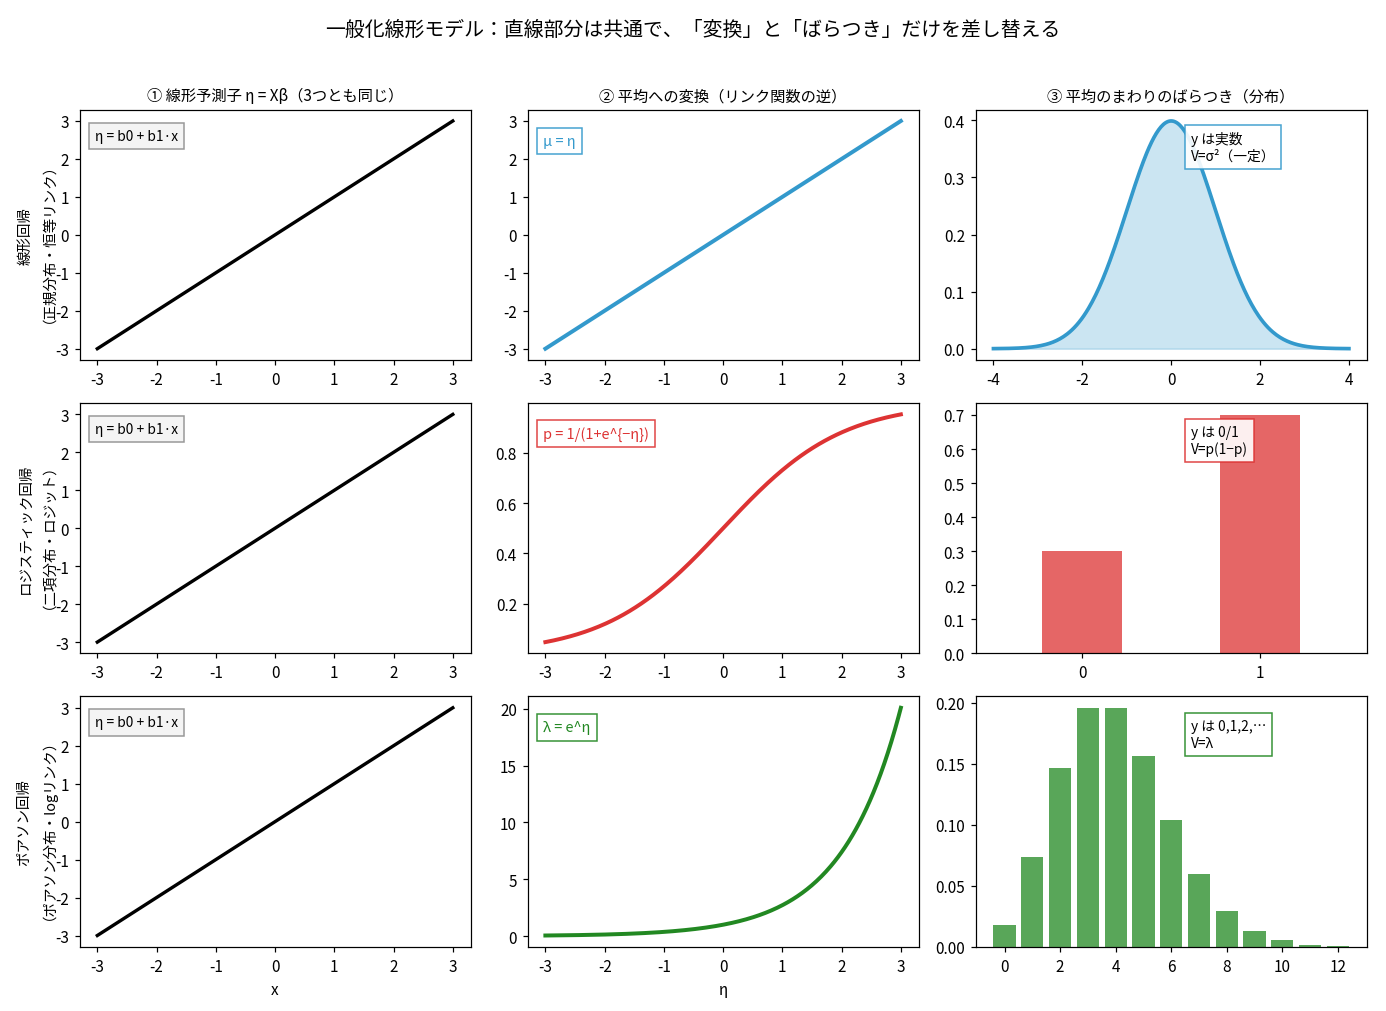
図の3行を見比べてください。左端の直線部分(線形予測子 )は3つとも完全に同じです。違うのは次の2つだけです。
- リンク関数: をどう平均 に変換するか
- 分布:平均のまわりでどうばらつくか
この2つを差し替えるだけで、別のモデルになります。
1つの表に収める
| モデル | の種類 | 分布 | リンク | 分散 | の意味 | 使う場面 |
|---|---|---|---|---|---|---|
| 線形回帰 | 実数 | 正規 | (恒等) | がそのまま増加量 | 売上・時間・スコア | |
| ロジスティック回帰 | 0/1 | ベルヌーイ | オッズが 倍 | コンバージョン・解約 | ||
| プロビット回帰 | 0/1 | ベルヌーイ | 解釈しにくい | 経済学の選択モデル | ||
| ポアソン回帰 | 0,1,2,… | ポアソン | 件数が 倍 | クリック数・故障件数 | ||
| 負の二項回帰 | 0,1,2,… | 負の二項 | (下の脚注参照) | 件数が 倍 | 過分散のあるカウント | |
| ガンマ回帰 | 正の実数 | ガンマ | 平均が 倍 | 保険金額・待ち時間 |
表の見方で2つ補足します。分散の列は散布パラメータ と分散関数 の積に分けて書きました。線形回帰の は 側ではなく 側にいます。また試行回数 の二項分布なら になるので、ここでは のベルヌーイとして書いています。負の二項回帰は を固定したときだけGLMの枠に収まり、 も推定する実務の標準的な使い方は厳密には枠外です。
用語の整理もしておきます。「一般化線形モデル」の「一般化」が何を一般化したのか。 答えは①リンク関数を挟むこと、②正規分布以外を許すこと、の2点です。「線形」の部分は最後まで温存されています。 そこが崩れると非線形回帰という別の道具箱に移ります。
なお名前の似た一般線形モデル(General Linear Model)は別物で、こちらは正規誤差の線形モデル全般(回帰・分散分析・共分散分析を統一した枠組み)を指します。試験でも紛らわしいので、「一般化(generalized)」が付くほうがリンク関数と分布の話だと覚えておくとよさそうです。
指数型分布族との接続
第9回 で母関数を扱ったとき、指数型分布族と自然パラメータという言葉が出ました。あれがここで効いてきます。
指数型分布族の形はこうです。
この形に揃えると、平均と分散が自動的に出てきます。
3つの分布で確認しました( と は sympy で計算)。
| 分布 | 自然パラメータ | |||
|---|---|---|---|---|
| 正規 | ||||
| 二項 | ||||
| ポアソン |
二項分布の は sympy が という形で返してきましたが、 で 0.235004、 も 0.235004 で一致を確認しました。
そして自然パラメータ をそのまま と等号で結ぶのが正準リンク(canonical link)です。
- 正規: なので恒等リンク
- 二項: なのでロジットリンク
- ポアソン: なのでlogリンク
表の「リンク関数」の列は、正準リンクを選んだ場合には自然パラメータの列そのものでした。第9回で「自然パラメータ」と呼んだものが、ここで正準リンクとして戻ってきたわけです。逆に、プロビットや complementary log-log は立派なリンク関数ですが自然パラメータではありません。リンク関数=自然パラメータではなく、正準リンクのときだけ一致するという関係です。
さらに、正準リンクのときは が成り立つので、IRLSの作業重みが に簡約されます。二項とポアソンは なので、単に です。
| リンク | 作業重み | ||
|---|---|---|---|
| ロジット | |||
| log | |||
| 恒等 |
恒等リンクだと で一定。だから線形回帰は重みを付け替える必要がなく1回で終わる。 第16回の正規方程式が、GLMの中でどこに位置するかがこれで確定します。
そしてもう一つ、失敗②(分散が )と失敗④(限界効果が )に同じ形が出た理由もここにありました。どちらも から来ているのです。分散関数と限界効果が同じ形になるのは、正準リンクを使っている限り必然でした。
カウントデータ:ポアソン回帰とオフセット項
が0/1ではなく「件数」のときはポアソン回帰を使います。クリック数、故障件数、問い合わせ件数などです。
対数リンクを使う理由は2つあります。件数は負にならないので を保証したい。そして効果が掛け算で効くほうが自然だからです。「広告を打つと問い合わせが1.5倍になる」は、元が10件でも1000件でも通じます。
オフセット項が必要になる場面
実務でよく出るのがこれです。露出数の違うキャンペーンを比べたいとき。
真のクリック率が旧クリエイティブ0.004、新クリエイティブ0.006(率比1.5)で、露出数が500〜20000とばらつくデータを作りました。
| 方法 | |
|---|---|
| をオフセットに入れる | 1.4707 |
| オフセットなし | 1.4047 |
| 単純集計での率比 | 1.4707 |
オフセットを入れると単純集計の率比と一致し、入れないと露出数の差に汚染されます。切片も となり、1露出あたりのクリック率として読めるようになりました。
オフセット項は、係数を1に固定した説明変数です。式で書くと違いが見えます。
左辺が「率の対数」になりました。係数の意味が「件数の比」から「率の比」に変わるのが効果です。露出が2倍なら期待クリック数も2倍、という制約を入れていることになります。
なぜ係数を1に固定するのか。「率」として解釈したいなら1でなければ困るからです。推定して1.8になったら、それは「露出が2倍でもクリックは1.8倍」という規模の効果があるモデルであって、単純な率の比較ではなくなります。
とはいえ「固定すべき」と決め打ちする必要はありません。係数=1 は検証できる仮定です。 をあえて普通の説明変数として入れ、係数が1から有意にずれるか見れば診断になります。ずれなければオフセットに格下げしてよく、ずれるなら規模の効果を明示的に扱うべきだという判断ができます。
過分散:ポアソンの前提が壊れる
ポアソン分布には強い制約があります。分散が平均に等しい()。第5回 で扱った性質です。現実のカウントデータではこれが破れることが多く、過分散(overdispersion)と呼びます。
自分が引っかかった罠
過分散を判定しようとして、まず素の「分散÷平均」を計算して間違えました。
| データ | 分散÷平均(素) |
|---|---|
| 純粋なポアソン | 2.54 |
| 負の二項() | 4.72 |
ポアソンから生成したデータなのに2.54が出ています。原因は平均 が とともに動いていることでした。周辺分布の分散は2つの成分に分解されます。
実測の分散が 12.955 だったので、理論と整合しています。「条件付き分散」と「周辺分散」を混同していたわけです。この2語の区別は第16回の「分散」という語の多義性(データのばらつき/推定値のばらつき)と同じ種類の罠でした。
正しい診断はモデルを当てはめた後のピアソン残差で行います。
| データ | ピアソン | 逸脱度/自由度 |
|---|---|---|
| 純粋なポアソン | 0.964 | 1.026 |
| 負の二項() | 3.476 | 3.374 |
これなら綺麗に判別できます。 が1付近ならポアソンでよく、1を大きく超えたら過分散です。
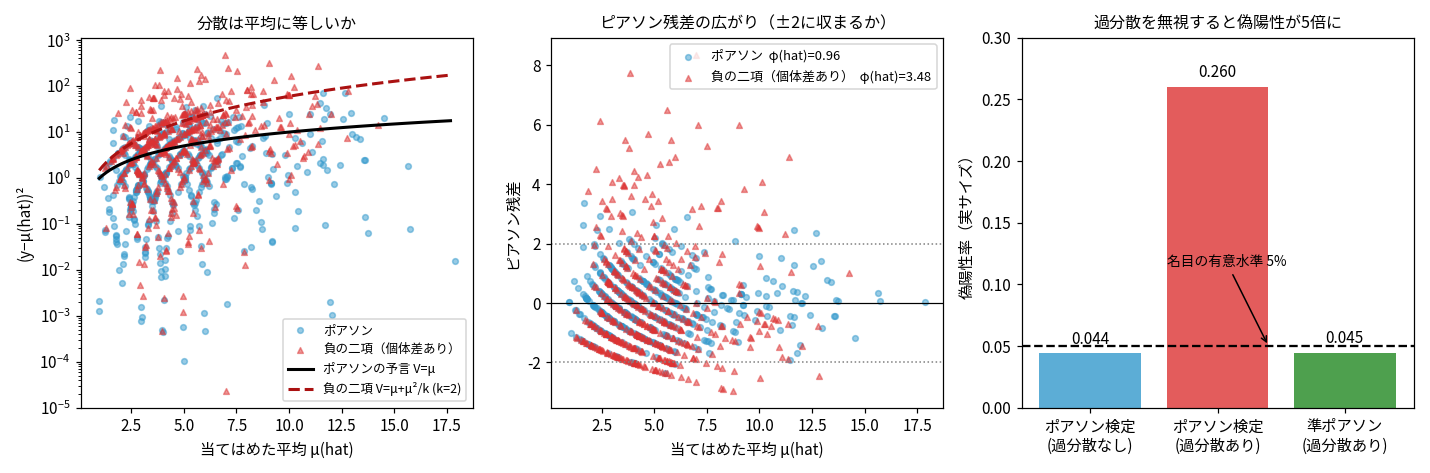
無視すると偽陽性が5倍になる
効果ゼロのデータで検定を回し、偽陽性率を測りました(、各1500回)。
| 設定 | ポアソン回帰の検定 | 準ポアソン補正後 |
|---|---|---|
| 過分散なし | 0.0440 | 0.0473 |
| 過分散あり | 0.2600 | 0.0447 |
名目5%が26%に膨らみました。 効果がないのに4回に1回は「有意」と判定してしまう。A/Bテストでこれをやると、存在しない改善を報告し続けることになります。
補正は簡単で、標準誤差に を掛けるだけです。これを準ポアソン(quasi-Poisson)と呼びます。実データでの効果を見ると、係数はほぼ変わらず標準誤差だけが動いています。
| データ | SE | 補正後SE | ||
|---|---|---|---|---|
| ポアソン | [1.4918, 0.5072] | [0.0224, 0.0193] | 0.964 | [0.0220, 0.0189] |
| 負の二項 | [1.5094, 0.4180] | [0.0219, 0.0194] | 3.476 | [0.0408, 0.0361] |
過分散が壊すのは点推定ではなく標準誤差だという点が重要です。係数の値自体は使えるので、報告する数字が「効果の大きさ」だけなら影響は小さい。 値や信頼区間を出すときに補正が必要になります。
負の二項回帰との使い分け
第5回で負の二項分布を扱いました。あれがここで戻ってきます。負の二項分布は、ポアソンの 自体がガンマ分布でばらつく混合分布です。
顧客ごとの熱心さ、機械ごとの当たり外れ、地域ごとの需要差といった個体差があると自然にこの形になります。分散は と2次式に膨らみます。
使い分けの指針はこうなります。
- 標準誤差だけ直したい → 準ポアソン( を掛ける)。分布を仮定し直さないので手軽。 を推定しているので、参照分布は ではなく を使うのが慣例
- 分散の形すら仮定したくない → サンドウィッチ(頑健)標準誤差。第17回のロバスト標準誤差と同じ考え方
- 予測分布や区間予測が必要 → 負の二項回帰。分散の形を と明示的にモデル化する
- ゼロが異常に多い → ゼロ過剰モデル(zero-inflated)。「そもそも対象外の人」と「対象だが0回だった人」を分ける
過分散の逆、過小分散()もありえます。これは「件数の上限が決まっている」ような場合に起きますが、実務で遭遇する頻度は低いようです。
プロビットモデルとの違い
0/1のモデルにはロジット以外の選択肢もあります。プロビットモデルです。リンク関数に正規分布の累積分布関数の逆関数 を使います。
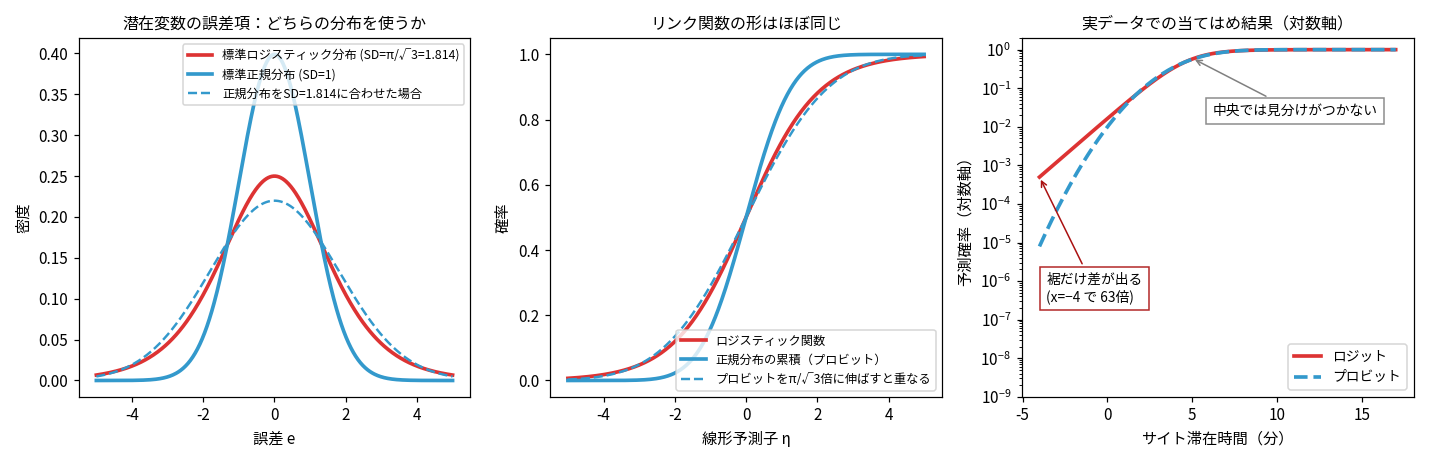
同じデータに両方を当てはめました。
| モデル | 切片 | 傾き |
|---|---|---|
| ロジット | −4.1006 | 0.8761 |
| プロビット | −2.3297 | 0.4967 |
| 比 | 1.760 | 1.764 |
係数が約1.76倍ずれています。 目安になるのが で、これは標準ロジスティック分布の標準偏差(分散 )です。
ただし「1.76の正体が1.8138」と言い切るのは正確ではありませんでした。ロジスティック分布と正規分布はスケールを変えれば重なる同型の分布ではなく、形の違う2つの分布です。そのため係数比は理論定数にぴったり一致せず、データが集まっている確率の範囲に依存します。曲線全体を最もよく近似するスケール定数は約1.6(アメミヤの経験則)で、実務では1.6〜1.8の幅で語られます。今回のデータではたまたま1.76でした。
理由は潜在変数の解釈から出てきます。どちらのモデルも、次のように書けます。
は「買いたい気持ち」のような目に見えない量です。この誤差 に何を仮定するかだけが違います。
- 標準ロジスティック分布(SD )→ ロジット
- 標準正規分布(SD )→ プロビット
誤差のスケールが1.81倍違うので、係数も約1.81倍ずれる。 中身は同じことを言っています。
予測確率の差もほとんどありません。
| ロジット | プロビット | 差 | |
|---|---|---|---|
| 2 | 0.0872 | 0.0907 | −0.0035 |
| 4 | 0.3552 | 0.3659 | −0.0107 |
| 6 | 0.7606 | 0.7424 | +0.0182 |
| 8 | 0.9482 | 0.9499 | −0.0017 |
差が出るのは裾だけです。 ではロジットが 、プロビットが で 63倍の差。ロジスティック分布のほうが裾が厚いためです。
どちらを使うべきか
実務ではロジットを選んで問題ありません。 理由はオッズ比という解釈可能な量が手に入ることです。プロビットの係数は「潜在変数の標準偏差を単位とした変化」でしかなく、意思決定者に説明できません。
プロビットが使われるのは、経済学の選択モデルのように潜在変数に正規分布を仮定する理論的な理由がある場合や、複数の選択が相関する多変量プロビットに拡張したい場合です。
そして極端な裾の確率を推定したいときは選択が結果を変えるので注意が必要です。63倍の差はモデル選択が生んだ差で、データが語っている差ではありません。
深層学習との接続:分類の最終層と同じもの
ロジスティック回帰を見て「機械学習で見たことがある」と感じる方は多いと思います。その感覚は正確で、しかも偶然ではありません。
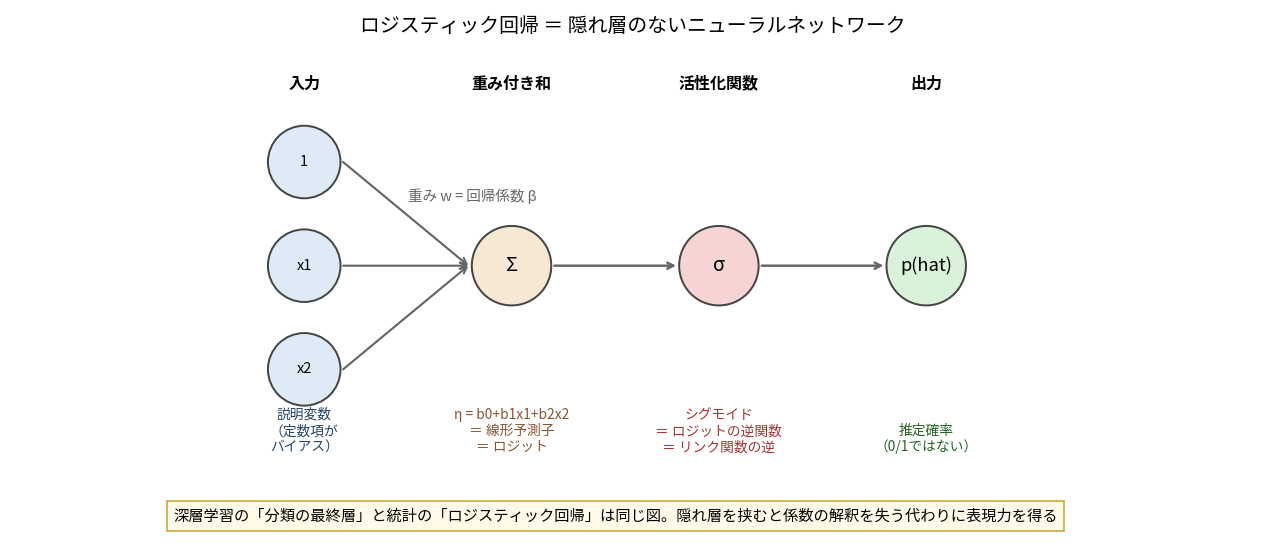
「入力 → 重み付き和 → 活性化関数 → 出力」という分類ネットワークの最終層の図と、ロジスティック回帰は完全に同じものです。歴史の順序は統計が先で、ニューラルネットワークがこの構造を出力層として取り込みました。
| 統計の言葉 | 深層学習の言葉 | 備考 |
|---|---|---|
| 回帰係数 | 重み (定数項はバイアス) | 同じもの |
| 線形予測子 | ロジット、スコア | 「ロジット」は深層学習でも同じ語 |
| リンク関数の逆 | シグモイド関数 | 同じ関数 |
| 負の対数尤度 | 交差エントロピー損失 | 符号を反転して で割っただけ |
| 最尤法(IRLS・ニュートン法) | 勾配降下法・Adam | 2階微分を使うか1階だけか |
| 多項ロジット | ソフトマックス回帰 | 同じモデル |
| 罰則つき最尤(リッジ) | 重み減衰(weight decay) | 同じ処方 |
つまりロジスティック回帰は隠れ層のないニューラルネットワークです。隠れ層を挟むと表現力を得る代わりに、係数の解釈を失います。
損失関数まで同じ
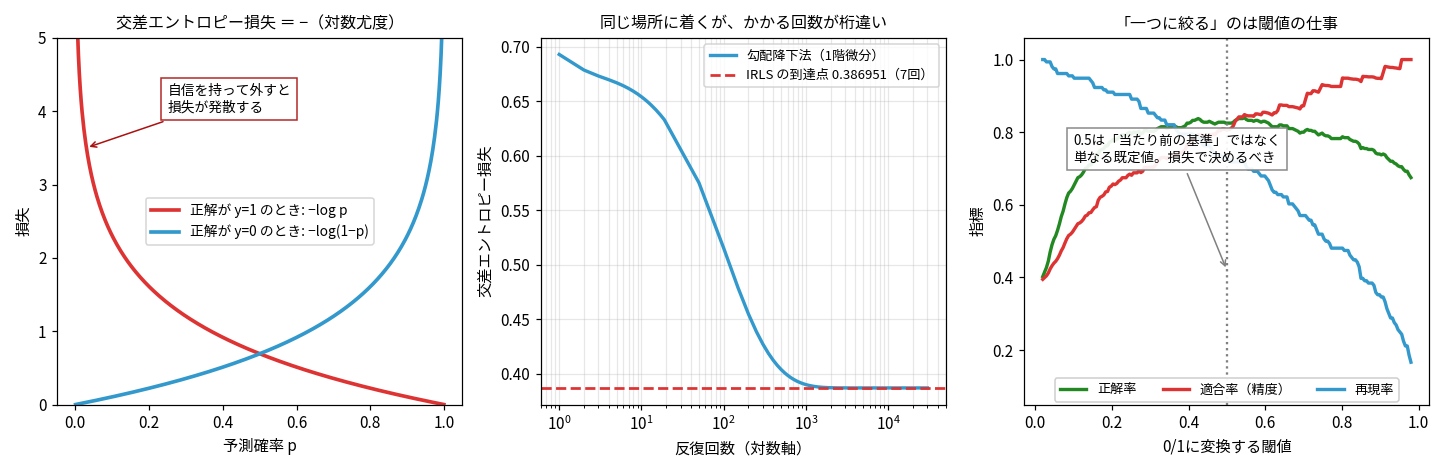
交差エントロピー損失はこう書かれます。
これは対数尤度に を掛けただけです。実際に勾配降下法(学習率0.08)を回すと、IRLSと同じ場所に着きました。
| 方法 | 到達した係数 | 損失 |
|---|---|---|
| 勾配降下 1000回 | [−3.524673, 0.755554] | 0.38999822 |
| 勾配降下 10000回 | [−4.100607, 0.876095] | 0.38695101 |
| IRLS 7回 | [−4.100612, 0.876096] | 0.38695101 |
「損失を最小化する」と「尤度を最大化する」は同じ操作の言い換えでした。第10回で最尤法を理解した時点で、深層学習の学習原理も実は手の内にあったことになります。回数の差(7回対1万回)は2階微分を使うかどうかの差です。
「一つに絞る」のは活性化関数の仕事ではない
ここは区別しておく価値があります。シグモイドが出すのは確率で、0/1に絞る仕事はしていません。
閾値を動かすと結果が大きく変わります。
| 閾値 | 正解率 | 適合率 | 再現率 | 見逃し | 空振り |
|---|---|---|---|---|---|
| 0.2 | 0.777 | 0.654 | 0.910 | 14件 | 75件 |
| 0.3 | 0.802 | 0.704 | 0.853 | 23件 | 56件 |
| 0.5 | 0.825 | 0.807 | 0.724 | 43件 | 27件 |
| 0.7 | 0.800 | 0.873 | 0.571 | 67件 | 13件 |
閾値0.5は「当たり前の基準」ではなく単なる既定値です。解約予測なら見逃し(離れる顧客を見落とす)のコストが高いので閾値を下げる、審査なら空振りのコストが高いので上げる。これは統計の問題ではなくビジネスの損失計算の問題で、モデルの外側にあります。
深層学習で argmax を取ると自動的に絞られるので混同しやすいのですが、argmax は「等コスト」を暗黙に仮定しているだけです。
シグモイドとソフトマックスの関係
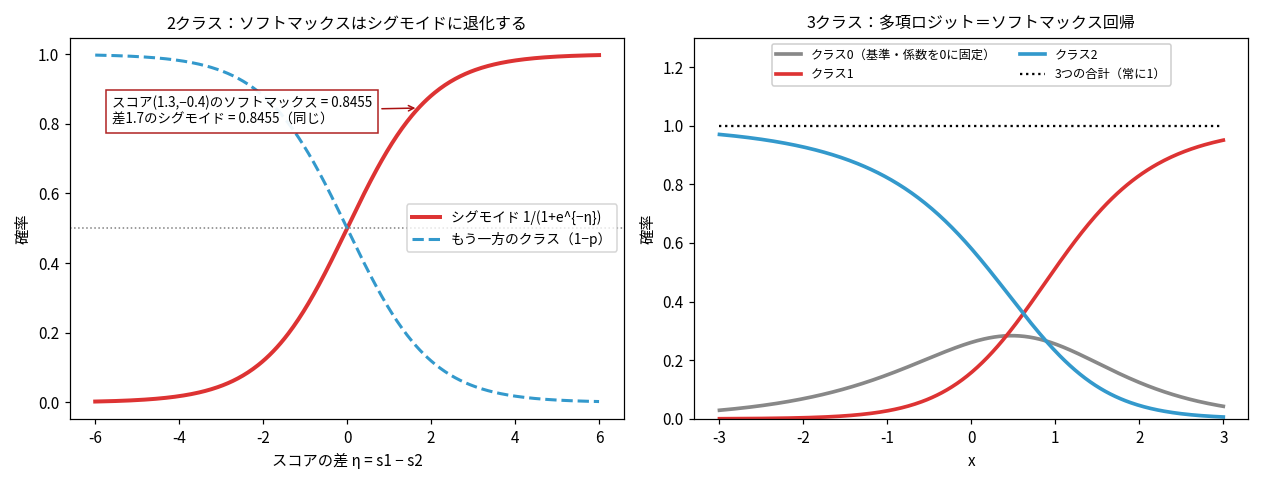
多クラス分類で使うソフトマックス関数との関係も、一本につながります。
2クラスのソフトマックスはシグモイドに退化します。 スコア のソフトマックスは 。一方、差 のシグモイドは で一致しました。
スコアの絶対値ではなく差しか効かないので、パラメータが1組余ります。全部に同じ定数を足しても結果が変わらないからです。統計ではこれを識別不能と呼び、基準カテゴリの係数を0に固定して解消します。
これが多項ロジットで「基準カテゴリを決める」理由でした。深層学習は予測しか使わないので冗長なまま学習して構いません。同じ数式に対する態度の違いが、係数を解釈するかどうかから来ているわけです。
3クラスで確認しました。真の係数 と (クラス0を基準に0固定)から のデータを生成し、勾配降下で推定したところ と を復元できました。確率の和は常に1です。
多項ロジットと順序ロジット
選択肢が3つ以上になるケースを、用語レベルで整理します。
多項ロジット(multinomial logit)
順序のない3択以上(どのプランを選ぶか、どの店舗を使うか)に使います。基準カテゴリを1つ決めて、残りとのオッズ比を 組推定します。
係数が 倍に増えるので、変数が多いとパラメータが膨らみます。IIA(Independence of Irrelevant Alternatives=無関係な選択肢からの独立)という仮定を置いていて、「選択肢を1つ追加しても他の選択肢間の比が変わらない」ことを要求します。この仮定が現実に合わない例(有名な「赤バス・青バス問題」)があり、その場合は入れ子ロジットや多項プロビットに移ります。
順序ロジット(ordered logit)
順序のある選択肢(不満・普通・満足、松竹梅のプラン)に使います。累積確率をロジット変換します。
特徴は傾き を全カテゴリで共通にして、切片 だけをずらすことです。これを比例オッズモデル(proportional odds model)と呼びます。「満足度を1段上げる効果は、どの段階でも同じオッズ比」という仮定になります。
右辺が とマイナスなのは慣例です。こう書くと が「 が増えるほど上位カテゴリに行きやすい」と読めて直感的になります。教科書やソフトによって符号が逆なので、係数の符号を報告するときは規約を確認する必要があります。
多項ロジットに比べてパラメータがずっと少なく済むのが利点で、比例オッズ仮定が妥当なら順序情報を捨てないので検出力も高くなります。仮定が破れていればバイアスが入るので、Brant検定などで確認します。
準1級では順序があるかないかでモデルを選べること、そして順序ロジットの係数が1つだけ(比例オッズ)という点を押さえておけば足りそうです。
実務:コンバージョン率の分析でどう使うか
最後に実務の話をまとめます。今回の設定がそのままA/Bテストやコンバージョン分析に対応します。
モデルの選び方
| やりたいこと | 使うモデル |
|---|---|
| 訪問者ごとにコンバージョンするか | ロジスティック回帰 |
| 期間あたりのクリック数・購入回数 | ポアソン回帰(露出数をオフセット) |
| 上のカウントがばらつきすぎる | 準ポアソン or 負の二項回帰 |
| 購入金額(正の連続値・右に歪む) | ガンマ回帰 or 対数変換した線形回帰 |
| どのプランを選んだか | 多項ロジット |
| 満足度(5段階) | 順序ロジット |
A/Bテストとの関係
2群のA/Bテストなら、群を表すダミー変数1つのロジスティック回帰になります。このとき係数はそのまま オッズ比です。実際に確かめました。
群A:30/100成功、群B:60/100成功のデータでロジスティック回帰を当てはめると、
- 切片 (群Aのログオッズ)
- 傾き (ログオッズ比)
- 傾きのSE
3つとも閉じた式と完全に一致しました。2群だけならロジスティック回帰は分割表の分析と同じものです。
ではなぜ回帰を使うのか。共変量を入れられるからです。流入元・デバイス・新規/リピートを説明変数に加えると、群間のアンバランスを調整した効果が出せます。第16回でやった「他を固定して」の話が、そのままここでも使えます。
報告のときの注意
- オッズ比だけを報告しない。 基準となる確率と、代表的な値での予測確率を添える
- 閾値は損失から決める。 0.5を既定値として受け入れない
- 係数が異常に大きいときは完全分離を疑う。 クロス集計で確認する
- カウントデータでは を必ず見る。 過分散を放置すると偽陽性が5倍になる
試験対策として
出題されやすい形を整理します。
必ず押さえる
- オッズ比の計算と解釈(、「オッズが何倍」であって確率ではない)
- 2×2表からのオッズ比と、その標準誤差
- リンク関数と分布の対応(線形=恒等・正規、ロジスティック=ロジット・二項、ポアソン=log・ポアソン)
- 逸脱度の差による尤度比検定(モデル選択)
- ポアソン回帰でのオフセット項の意味
- 過分散の判定( が1を超えるか)と対処
用語レベルで足りる
- プロビットとの違い(誤差分布の仮定、係数が1.6〜1.8倍程度ずれる)
- 多項ロジット・順序ロジット(順序の有無で選ぶ、比例オッズ)
- Hauck-Donner効果(名前と「完全分離でワルドが壊れる」まで)
計算パターン
逸脱度の差でモデルを比較する問題が出ます。変数の少ないモデルの逸脱度から、多いモデルの逸脱度を引く()と、自由度の差の に従う、という形です。第14回の適合度検定と同じ構造なので、そこと合わせて覚えると楽になります。
前回との接続
第16回で最小二乗法の を、第17回で残差診断を扱いました。今回はその両方が形を変えて出てきました。
正規方程式は「1回で終わるIRLS」だった。 恒等リンクでは作業重みが1で一定なので反復が要らない。ロジスティック回帰では重みが と推定値に依存するので、重みを付け替えながら繰り返すことになります。
第17回の等分散性の診断は、ここでは診断する意味がなかった。 0/1のデータでは不均一分散が定義から確定しているので、診断して対処するのではなく、モデルの形から作り直します。
そして第12回のワルド検定・尤度比検定の違いが、ここで初めて実害として見えました。「漸近的に同じ」の但し書きが効く場面がロジスティック回帰だった、ということです。
つまずいたところ
「線形モデル」の線形をグラフの形だと思っていた。 これがこの章で最大の発見でした。 について1次という意味で、 の姿は自由。 でも でも でも、 が1次なら線形モデルです。第16回で多項式回帰を「線形モデル」と呼んでいた理由がずっと分かっていませんでした。
単調なら解析的に解けると思っていた。 単調性・凹性が保証するのは解の一意性と数値計算の安定性で、閉じた式の存在とは無関係でした。 が反例で、単調なのにランベルトW関数を発明しないと書けません。
「オッズが2倍」を「確率が2倍」と読んでいた。 ならオッズ2倍で確率は1.05倍にしかなりません。逆に (確率2倍)はオッズ比11.0です。稀な事象でしか近似が成り立ちません。
過分散の判定で素の「分散÷平均」を見て間違えた。 純粋なポアソンデータでも2.54という値が出ました。平均が で動くと周辺分散が の2成分になるからで、 が実測 12.955 と整合しました。条件付き分散と周辺分散は別物で、診断はモデル当てはめ後のピアソン残差で行う必要があります。
Hauck-Donner効果を「完全分離だけの特殊事情」だと思っていた。 乖離は連続的で、 では既にワルドが尤度比の37%しかありません。完全分離はその極限にあるだけでした。境界事例だと思って片付けそうになったところを、数値を並べて確かめてよかったところです。ただし の水準では両方の統計量が巨大でどちらでも棄却されるので、実害が出るのは標準誤差が暴走し始める境界のあたりだけです。
ワルドと尤度比を「近い」と書きかけた。 実データで 、 を並べて「漸近的に同じだから近い」と書こうとしましたが、2倍以上違います。効果が非常に強い場所で比べていたのが原因でした。「漸近的に同じ」は帰無仮説の近くでの話で、どこでも成り立つ性質ではありません。
プロビットの係数比1.8を、根拠のない経験則だと思っていた。 誤差分布の標準偏差の違い( 対 1)という理由がありました。ただし逆に「だから比は必ず1.814」でもありません。2つの分布は形が違うので比はデータ依存で、目安として1.6〜1.8に収まるという理解が正確でした。
オフセット項を「ただの説明変数」だと思っていた。 係数を1に固定するのが本質で、それによって係数の意味が「件数の比」から「率の比」に変わります。ただし「固定しなければならない」わけでもなく、係数=1 は普通の説明変数として入れて検証できる仮定でした。
この記事の要点
- 0/1を最小二乗法で当てはめると4通りに壊れる(軽い順に①③、重いのが②④)。 ①予測が範囲外(1超が5.2%、負が4.0%)②等分散が定義から不成立(、〜 でも5.3倍差)③残差が2本の直線に乗り正規分布になりえない ④効果が一定だと強制(2分+0.099/4分+0.214/8分+0.030/14分+0.0002 と最大1291倍違う)
- ロジット変換は2段構え。 確率→オッズで天井が外れ、オッズ→対数で床が外れる。ここまで伸ばして初めて直線を当てはめられる
- オッズは「負け組との比」。 確率が0.2→0.8と4倍のあいだにオッズは0.25→4と16倍。この余裕が上限を外す
- 第2回のオッズと同じもの。 事後オッズ=事前オッズ×尤度比の対数をとると で、ロジスティック回帰の右辺と同じ構造
- オッズ比は確率比ではない。 なら1.98倍だが なら1.05倍。逆に確率2倍は でオッズ比11.0
- 解析解が出ないのは が指数の中に埋まって外に出せないから。 ただし「超越方程式だから閉形式がない」とは言えない( は超越方程式だが )。初等関数の範囲で表示が知られていないという意味
- 単調性・凹性は解の一意性と計算の安定性を保証するが、初等関数での表示は保証しない。 は単調で解が一意だが と書くしかない。なお一意性には設計行列のフルランク性と「完全分離でないこと」も必要
- IRLS は重み付き最小二乗の繰り返し。 作業重み 、作業応答 。7回で収束し変化量は と2次収束
- 線形回帰は「1回で終わるIRLS」。 恒等リンクでは で一定だから重みの付け替えが不要
- 「線形モデル」の線形は について1次という意味。 でも でも線形。 が指数にいたら非線形
- 設計行列 を1つに固定できるかが分かれ目。 を混ぜても1回で解けた(真値との一致を確認)
- GLMでは「 が の線形結合」と「分散の厳密性」が失われ、漸近的な話に格下げされる。 分布が使えず になる理由でもある( が既知なので割る対象がない)
- Hauck-Donner効果:完全分離で SE が より速く発散し、Wald が0に落ちる。 30回目で 、SE 、。尤度比検定は0に落ちる壊れ方をしない(ただし という値自体は では当てにならず、正確検定では両側0.0286)
- 乖離は連続的。 は で0.989、 で0.373。完全分離はその極限
- GLMは「直線部分は共通、変換とばらつきだけ差し替える」枠組み。 一般化したのはリンク関数と分布で、「線形」は温存されている
- 正準リンクを選ぶと、リンク関数は自然パラメータそのものになる(リンク関数一般ではない。プロビットは自然パラメータでない)。 →恒等、→ロジット、→log。平均は 、分散は
- 分散関数と限界効果が同じ になるのは から来ているから(正準リンクを使う限り必然)
- オフセット項は「係数を1に固定した説明変数」。 入れると率比1.4707(単純集計と一致)、入れないと1.4047にずれる
- 過分散の判定に素の分散÷平均を使ってはいけない。 ポアソンでも2.54が出る(周辺分散 )。ピアソン で見ると0.964対3.476で明確
- 過分散を無視すると偽陽性が5%→26%。 で補正すると4.47%に戻る。壊れるのは点推定ではなく標準誤差
- 負の二項は「 がガンマでばらつく混合分布」。 個体差があるとこの形になり分散が
- ロジットとプロビットの違いは誤差のスケールだけ。 係数比は1.760/1.764。目安は (誤差分布のSD)だが2分布は形が違うので比はデータ依存で1.6〜1.8。裾では63倍の差が出る
- ロジスティック回帰は隠れ層のないニューラルネット。 交差エントロピー損失=−対数尤度/(ともに0.38695101)。勾配降下1万回とIRLS7回が同じ場所に着く
- 2クラスのソフトマックスはシグモイドに退化する(スコアの差だけが効く)。余ったパラメータを消すのが「基準カテゴリの固定」
- 0/1に絞るのは閾値の仕事で、活性化関数の仕事ではない。 0.5は既定値にすぎず、見逃しと空振りのコストで決める
- 2群のA/Bテストならロジスティック回帰=分割表の分析。 切片 、傾き オッズ比、SE が完全一致。回帰を使う理由は共変量を入れられること
線形モデル編もいよいよ後半です。次回は第19章の生存時間解析。「イベントが起きるまでの時間」を扱う分野で、まだ起きていない観測(打ち切り)をどう扱うかが焦点になります。今回のポアソン回帰で扱った「率」の考え方が、ハザード関数という形で戻ってきます。