適合度検定は「分布を証明する道具」ではなかった【第14回】
はじめに
第12章は一般の分布に関する検定法です。前回(第13回・t検定の使い分け)の最後に「分散の検定は正規性に守られていない」と分かったので、じゃあその正規性そのものを検定すればいいのでは、という流れでこの章に来ました。
ところが学び終えてみると、その期待はほぼ裏切られました。
この章の主役である適合度検定は、「このデータは正規分布に従うか」を確かめる道具として紹介されることが多いのですが、実際に測ってみると、確かめたい場面では気づけず、気づける場面ではもう確かめる必要がないという噛み合わなさがありました。正規性が崩れて分散の検定が5%から38.6%まで暴走している状況で、適合度検定が「非正規だ」と気づける確率は23.5%しかない(より強いアンダーソン–ダーリング検定でも43%です)。逆にn=500まで増やせば99.9%気づけるのですが、そのときは中心極限定理が効いていて、そもそも正規性が要らなくなっています。
じゃあこの章は何のためにあるのか。本題は適合度検定ではなく、「正規分布のような都合の良さがない一般の場合、どうやって検定を作るか」という漸近論の話でした。 という一本の定理があって、これがロジスティック回帰の逸脱度やモデル選択で使い続ける道具になる。適合度検定はその一番単純な実例として置かれている、という構造です。
そしてもう一つ、今回いちばん収穫だったのが自由度が になる理由です。第7回で「偏差の合計が0だから自由度が1減る」を理解したので同じ話だと思っていたら、別の原理でした。図で描いてみたら一発で分かったので、それを共有します。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 記号で迷ったら 統計の記号がややこしいのは軸が2本あるからだった を先に読んでください。
- χ²分布そのものの成り立ちは 第7回、尤度比検定の考え方は 第12回 で扱っています。
この記事で使う言葉
先に4つだけ整理します。この記事はこの4語で回ります。
適合度検定(goodness-of-fit test):観測されたデータの度数が、想定した分布から計算される度数と合っているかを調べる検定。「適合度」は当てはまりの良さという意味です。
期待度数(expected frequency):想定した分布が正しいとしたら、そのセルに何個入るはずかという理論値。記号は 。観測された実際の個数は 観測度数(observed frequency) で 。
漸近分布(asymptotic distribution):標本サイズ を大きくしていったときに、検定統計量の分布が近づいていく先の分布。「漸近」はだんだん近づくという意味で、 が有限のうちは近似にすぎません。
ノンパラメトリック検定(nonparametric test):母集団がどの分布族に属するかを仮定しない検定。「パラメトリック」=分布族を仮定してそのパラメータを扱う、の否定形です。
TL;DR
- 「一般の分布に関する検定」=適合度検定ではない。 主流は尤度比・ワルド・スコア検定で、適合度検定はその中の特別な一員
- 本題は Wilksの定理 。 は制約の本数で、適合度検定の (推定した個数)とは別物()
- ①②③を分ける基準は「どの分布か」ではなく、①厳密な分布が書けるか ②漸近近似に頼るか ③分布族を仮定しないか
- 適合度検定の帰無仮説は「点」ではなく 「曲線(分布族)に乗っているか」 。だから自由度が 本減る
- パラメータ推定は目的ではなく手段。 曲線までの距離を測るための足場で、 は結論に登場しない
- 自由度が減る理由は第7回とは別の原理。厳密な制約ではなく「平均して1だけ削られる」。差が負になることが10.4%ある
- 最尤推定 ≠ 最小カイ二乗推定。 「推定すればX²は必ず小さくなる」は誤り
- 生データから推定すると自由度は と の間に来る(Chernoff–Lehmann)。ずれの大きさはセルの粗さで決まる
- 「期待度数5以上」は思うより緩い。崩れても保守的になる方向で、k=5・期待度数1でも 0.0335
- 危ないのは最小期待度数が小さいとき(偏った表ではここが真っ先に小さくなる)とスパースなセルが大量にあるときのG²(0.1624)
- X²とG²の優劣は状況で逆転する。 一様な多セルではX²が頑健、偏った表では によって入れ替わる
- は が小さくても厳密に成立。壊れるのは分布の形と裾だけ
- 正確検定は構造的に保守的(p値が階段状にしか動かない)。フィッシャーは10対10で実サイズ 0.0128、代金は検出力10ポイント。イェーツ補正はさらに行き過ぎる
- 最小期待度数11.4で目安を満たしていても p≈4e-06 で棄却される。 目安は近似の話で、当てはまりの話ではない
- 「正規性を検定してからt検定」は機能しない。2標本ならサイズは壊れないので検出力の問題。ただし1標本では歪度でサイズが壊れる(対数正規で0.0862)
- 平均は中心極限定理に守られるが、分位点は守られない。 正規仮定の99%点の区間は被覆率 1.6% まで崩壊する
- 適合度検定は判定装置ではなく診断装置。p値ではなくセルごとの寄与を読む
まず地図:検定の3分類は「どの分布か」で分かれていない
この章に入る前に引っかかったのが、そもそも第11章(正規分布に関する検定)、第12章(一般の分布に関する検定)、第13章(ノンパラメトリック法)という並びが何で分かれているのかでした。
「正規分布用」「それ以外の分布用」「分布を仮定しない用」だと思って読み始めたのですが、それだと第12章に出てくる話がうまく収まりません。整理したのがこの図です。
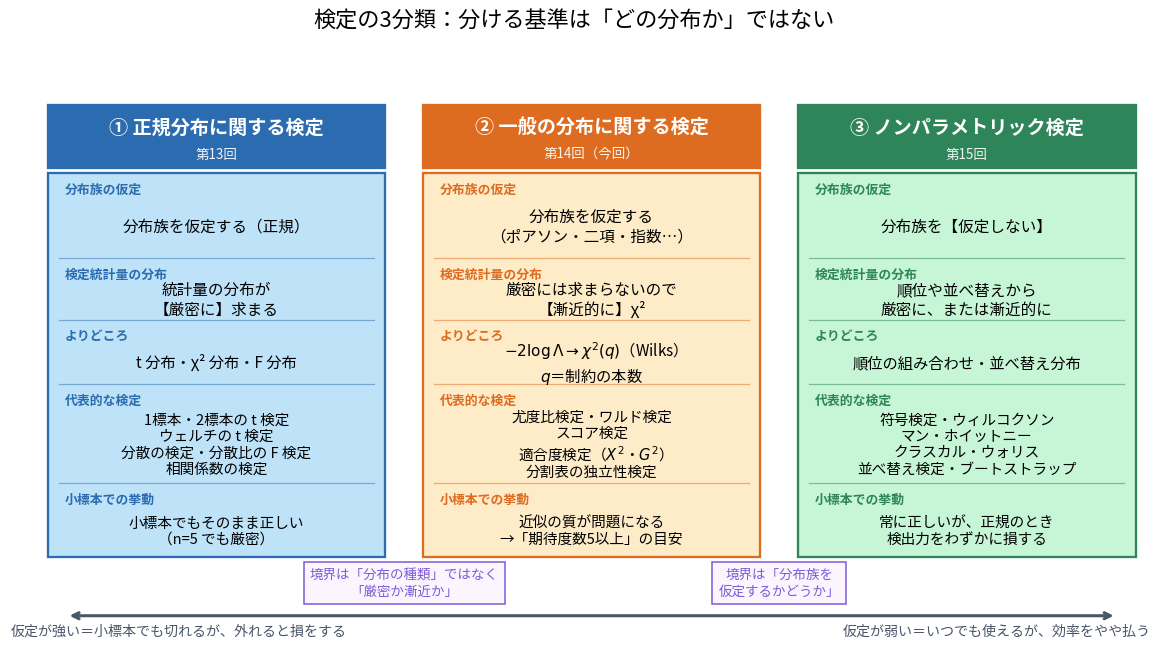
①と②を分けているのは分布の種類ではなく、厳密な分布が書けるかどうかでした。
正規分布は特別に恵まれています。標本平均と標本分散が独立になり、その比を取るとちょうどt分布になる。だから でも厳密に正しい検定ができます。ところがポアソン分布や指数分布ではこの奇跡が起きません。そこで という漸近論に乗り換えるしかない。第12章のタイトルが言う「一般の分布」は「正規以外」という意味ではなく、「正規のような都合の良さがない一般の場合、どう検定を作るか」という意味です。
これが分かってから、章の位置づけが腑に落ちました。「期待度数5以上」のような近似の質の話がこの章に集中しているのも、漸近近似に頼っているからです。
②と③を分けているのは素直に「分布族を仮定するかどうか」です。
「一般の分布に関する検定=適合度検定」ではない
ここも最初に誤解していました。②はもっと広い枠で、中身は帰無仮説の型で2つに分かれます。
| 帰無仮説の型 | 例 | 分布族は |
|---|---|---|
| パラメータについて | 、、2群の が等しい | 前提として置き、疑わない |
| モデルそのものについて | : そもそもポアソン分布である( は何でもよい) | これ自体を疑う |
第12回でやった尤度比検定・ワルド検定・スコア検定は全部上の行です。「ポアソンであることは認めた上で、 が3かどうか」を問う。②が漸近論を必要とするのはこの型でも同じで、適合度検定に固有の話ではありません。
適合度検定は下の行にいる特別な一員です。同じχ²近似という機構を使いながら、問う向きが逆になっています。
適合度検定はノンパラメトリックなのか
もう一つ整理しておきたいのが、適合度検定と③の関係です。「分布を仮定しない検定」と聞くとウィルコクソンなどを思い浮かべますが、実は適合度検定も distribution-free(分布によらない) な側面を持ちます。
ここは言い方に注意が必要でした。正確には「帰無仮説の中でどのパラメータ を取っても、漸近的な帰無分布が のまま変わらない」という意味です(漸近的にピボットである、ということ)。ポアソンでも指数分布でも同じ 表を引けるのがその現れです。ただし後述する Chernoff–Lehmann の状況では極限分布が分布族とセルの切り方に依存するので、この性質も無条件ではありません。
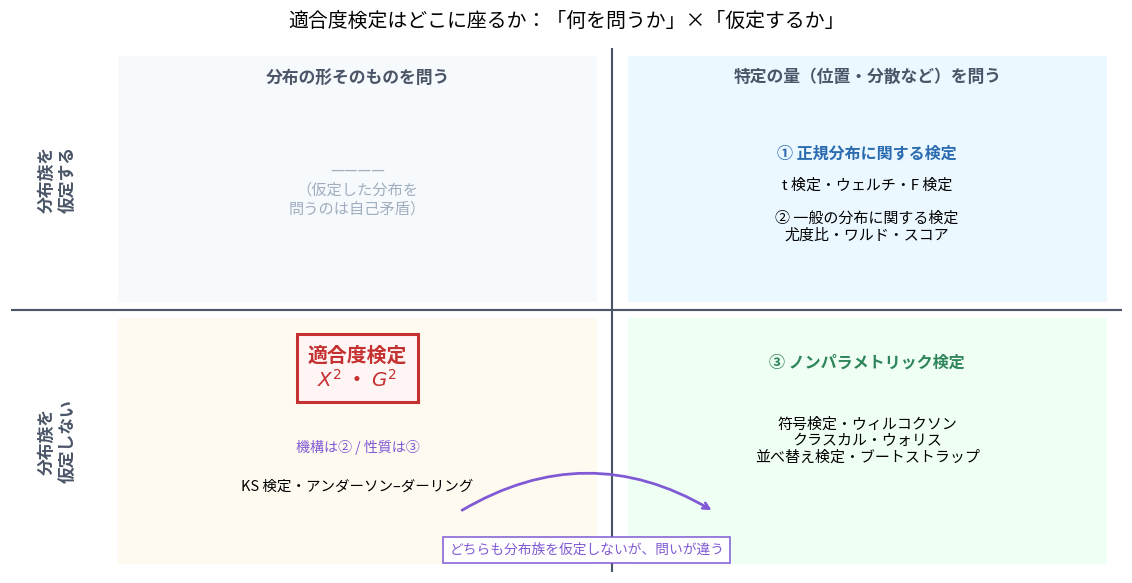
正確には機構としては②、性質としては③です。ウィルコクソンと同じ「仮定しない」行にいますが、問いが「分布の形」か「位置」かで列が違う。
左上が空欄なのがポイントで、仮定した分布そのものを問うのは自己矛盾だからです。この2軸に置いてみて、自分がずっと「適合度検定 vs ノンパラメトリック」という成立しない対比で考えていたことに気づきました。
適合度検定の定義:6個のズレを1個の数に押し込む
ここから中身に入ります。定義そのものの図から始めます。
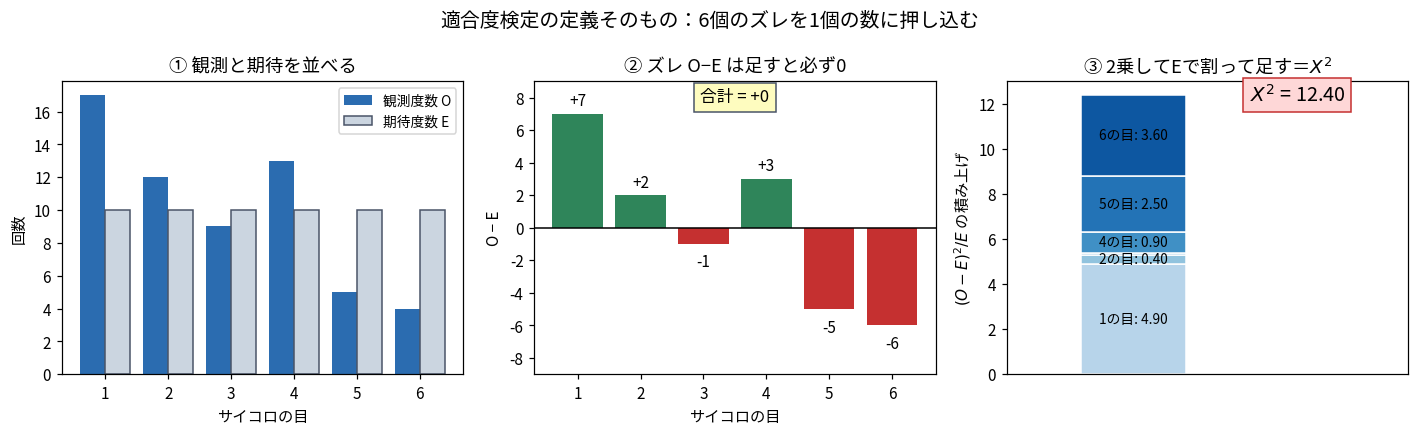
サイコロを60回振って、1の目が17回、6の目が4回出たとします。それぞれの目は10回ずつ出るはずなので、ズレを見ます。
ここでズレの合計は必ず0になります(中央のパネル)。合計が60であることは決まっているので、どこかが多ければどこかが少ない。これが後で自由度の話につながる伏線です。
そのズレを2乗して期待度数で割って足したのが
で、この例では です。
なぜ で割るのか
2乗するのは符号を消すためなので分かりますが、なぜ で割るのかが最初は分かりませんでした。
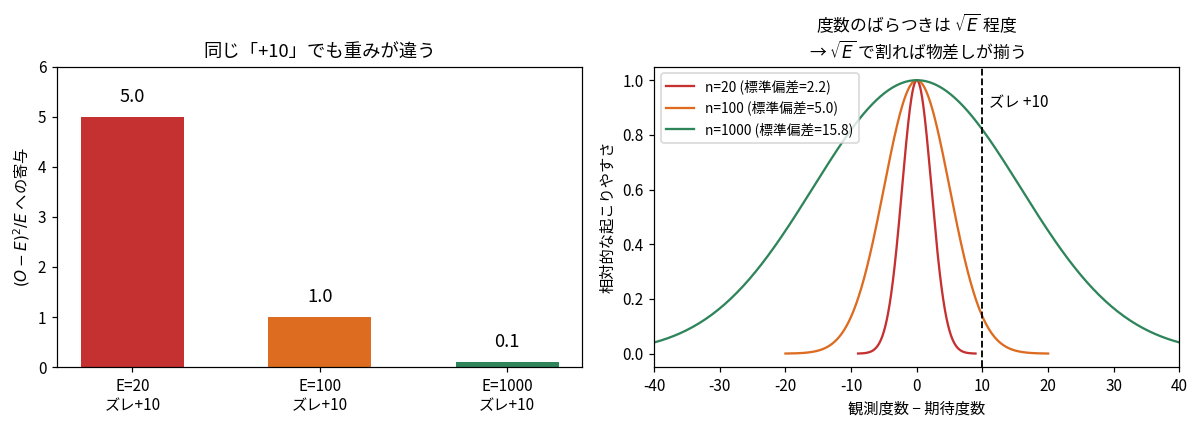
理由は物差しを揃えるためでした。期待度数20のセルで「+10のズレ」は大事件ですが、期待度数1000のセルなら誤差です。度数のばらつきは 程度なので、 で割れば「何σぶんのズレか」に揃います。2乗した後に で割るのは、2乗する前に で割ったのと同じことです。
つまり は「標準化したズレの2乗和」で、これが 分布になるのは 第7回 でやった「標準正規の2乗和がχ²」の話とつながっています。
自由度が になる理由:帰無仮説は「点」ではなく「曲線」
ここが今回いちばん面白かったところです。
教科書には自由度が ( はセル数、 は推定したパラメータの個数)と書いてあります。 は「合計を に合わせたから」で、これは第7回の「偏差の合計が0だから1減る」と同じ話です。
では は何なのか。同じ原理だと思っていたら、違いました。
まず「点」と「曲線」の違いを見る
ハーディ・ワインベルグ平衡を例にします。3つの遺伝子型の確率が という形になるという仮説です(、)。
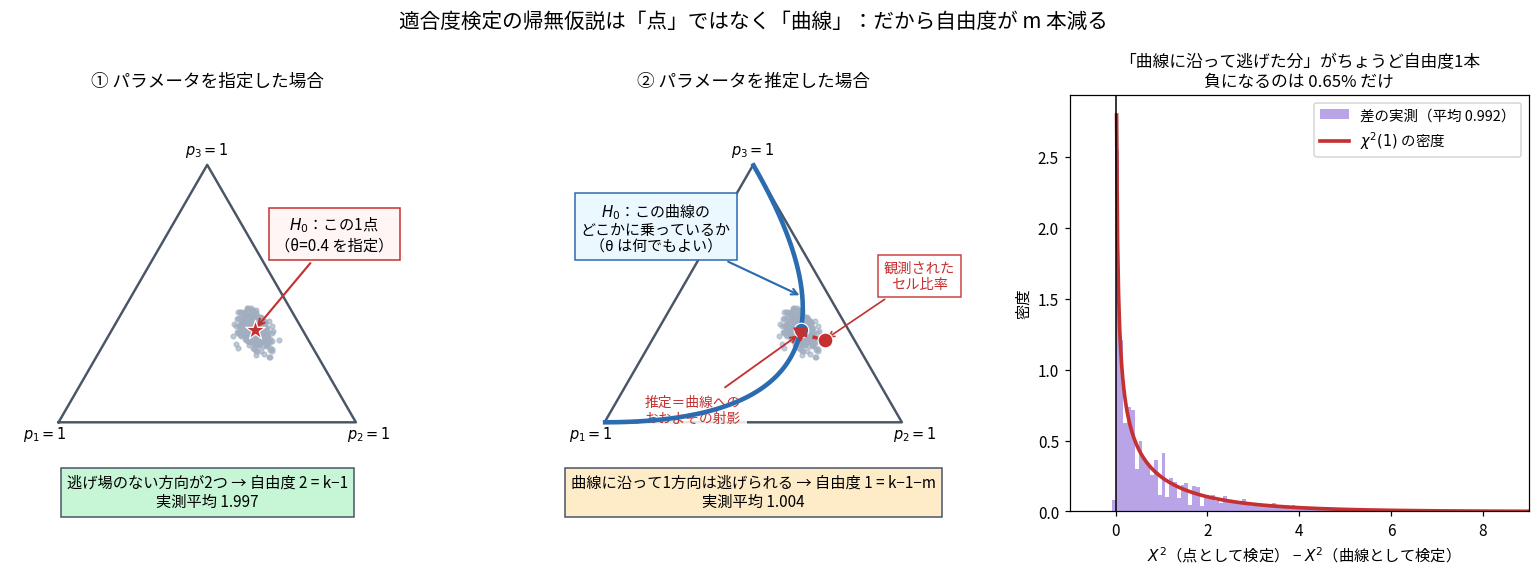
三角形は3つのセル確率が取り得る範囲全体(単体と呼ばれます)で、内部の1点が「セル確率の組」ひとつに対応します。
左のパネル。 と指定した場合、帰無仮説は星印の1点だけです。観測がここからどれだけ離れているかを測る。動ける方向が2つあるので自由度2です(実測平均1.9969)。
中央のパネル。 を推定する場合、帰無仮説は青い曲線全体になります。 を動かすと描かれる曲線で、問うているのは「観測がこの曲線のどこかに乗っているか」です。 がどこかは問うていません。曲線に沿って1方向は逃げられるので自由度1(実測平均1.0044)。
| 帰無仮説 | 自由度 | の平均(実測) | 棄却率(公称5%) |
|---|---|---|---|
| を指定(点) | 1.9969 | 0.0487 | |
| を推定(曲線) | 1.0044 | 0.0491 | |
| 差=曲線に沿って逃げた分 | 0.9925 | 負になるのは0.65% |
この「曲線に沿って逃げられる方向の数」が です。 分布族のパラメータが2個あれば曲面になって2方向逃げられる。だから になる。
パラメータ推定は目的ではなく手段
ここで大事な気づきがありました。中央のパネルの赤い破線が示しているのは、観測から曲線までの距離を測るために、曲線上のいちばん近い点を代表として選んでいるという操作です。
つまりパラメータを推定しているのは「答えを知るため」ではありません。 曲線までの距離を測るための足場です。
証拠として、 は検定の結論のどこにも登場しません。「、自由度1、」と報告して、 だったことは検定の主張に関係ない。適合度検定を「既知の分布のパラメータを計算する手続き」だと思っていると、この非対称さが見えなくなります。
第7回とは別の原理だった
さて、 と が同じ原理かどうかです。
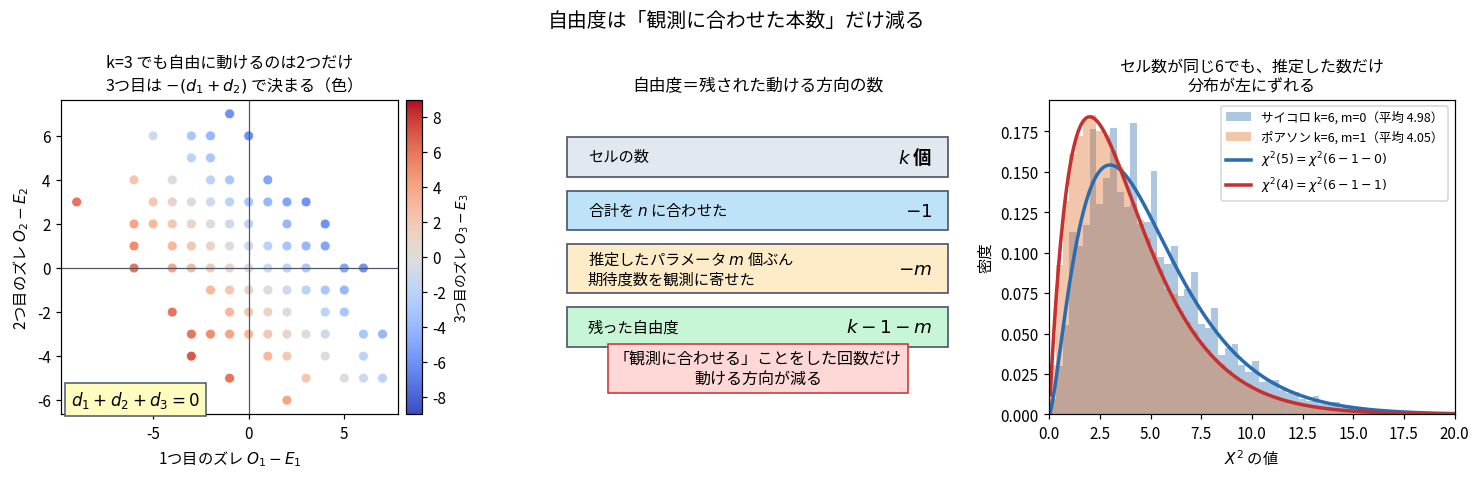
左のパネルが第7回の型です。 と を決めると3つ目は で完全に決まる。逃げ場がない厳密な制約です。合計を に合わせたぶんの はこの型です。
ところが は違います。私は最初「推定は を最小にする を選ぶから、真の値を使うより は必ず小さくなる」と考えていました。これは誤りでした。
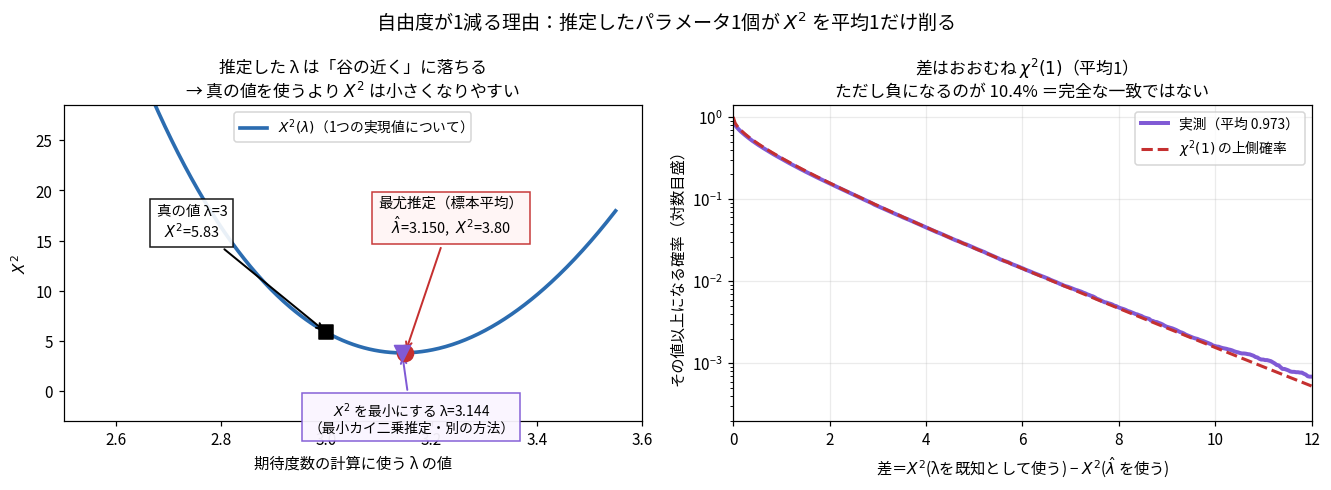
左のパネルを見てください。 を動かすと は谷を描きますが、最尤推定(標本平均3.150)と を最小にする点(3.144)は別の場所にあります。最尤推定と最小カイ二乗推定は違う方法だからです。
結果として、 既知の から 推定の を引いた差は、10.4%のケースで負になります。真の値を使ったほうが が小さいことがある。
つまり は「毎回きっちり1本削られる」のではなく「平均して1だけ削られる」。右のパネルで差の分布が におおむね乗り、平均0.973になっているのがそれです。厳密な幾何的制約ではなく漸近的な性質でした。
先ほどのハーディ・ワインベルグでは負になるのが0.65%でした。この差には理由があって、後の節で扱います(ここは生データから推定、あちらは度数から推定という違いです)。最尤推定と 最小点の距離を100例で測ると平均0.000449・最大0.004035で、ごく近いが一致しないという関係でした。だから「おおよその射影」と書いています。
実際に自由度で分布がずれることを確認する
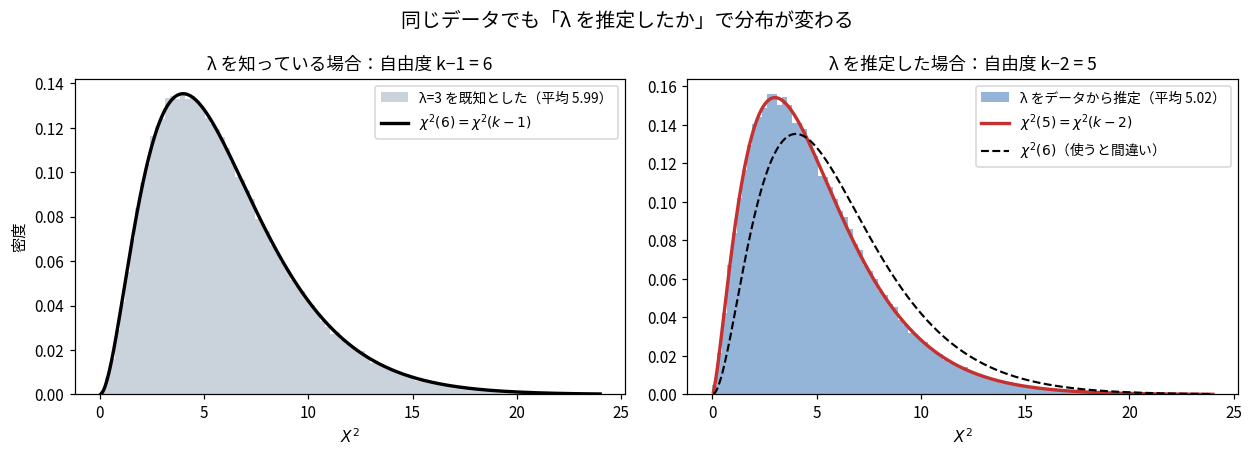
同じ観測度数でも、 を既知として使えば自由度6(実測平均5.9971)、推定すれば自由度5(実測平均5.0239)。推定したのに を使うと、右のパネルの破線のようにずれて、棄却しにくくなる方向に間違えます。
教科書の すら近似だった
もう一つ発見がありました。同じ「 と を推定した」でも、推定の仕方で自由度が変わります。
| 推定の仕方 | 理論値 | 実測平均 | 棄却率 |
|---|---|---|---|
| 度数だけから最尤推定() | 5() | 4.9458 | 0.0478 |
| 生データから最尤推定() | 5〜7の間 | 5.1955 | — |
度数だけから推定するとぴったり になります。ところが実務でやるのはたいてい後者、つまり生データの平均・標準偏差をそのまま使う方法で、こちらは と の間に来ます。Chernoff–Lehmann の現象と呼ばれるものです。
教科書が「」と言い切るのは、後者を前者で近似しているからでした。試験では を使えばよいのですが、「なぜぴったりではないのか」を知っていると納得の質が違います。
ずれの大きさはセルの粗さで決まる
ここで気づいたことがあります。さきほどのポアソンの例(実測5.0239)では、同じ「生データからの推定」なのにほぼぴったり でした。 矛盾しているように見えますが、理由があります。
生データからの推定でずれが生じるのは、度数に丸めた時点で失われる情報があるからです。ポアソンで「0件・1件・2件・…・6件以上」のように細かく切ると、度数がほぼ元データの情報を全部持っているので、失われる分がなく、ずれが見えません。一方で連続分布を8個の区間に粗く区切ると情報の損失が大きく、ずれがはっきり出ます。
つまり 「セルが元データの情報をどれだけ保持しているか」でずれの大きさが決まる 。ハーディ・ワインベルグの例で を使ったのは、これは度数だけから計算される最尤推定なので、そもそも情報の損失がゼロ。だから先ほどぴったり に乗り、差が負になるのも0.65%で済んでいました。
「差が負になるのが10.4%」だったポアソン例と、「0.65%」だったハーディ・ワインベルグの違いはここでした。 前者は生データからの推定、後者は度数からの推定です。「状況次第」と片付けるべきではありませんでした。
「期待度数5以上」の根拠を実測する
適合度検定には「各セルの期待度数が5以上」という目安がついてきます。これがどこから来た数字なのか気になったので測りました。
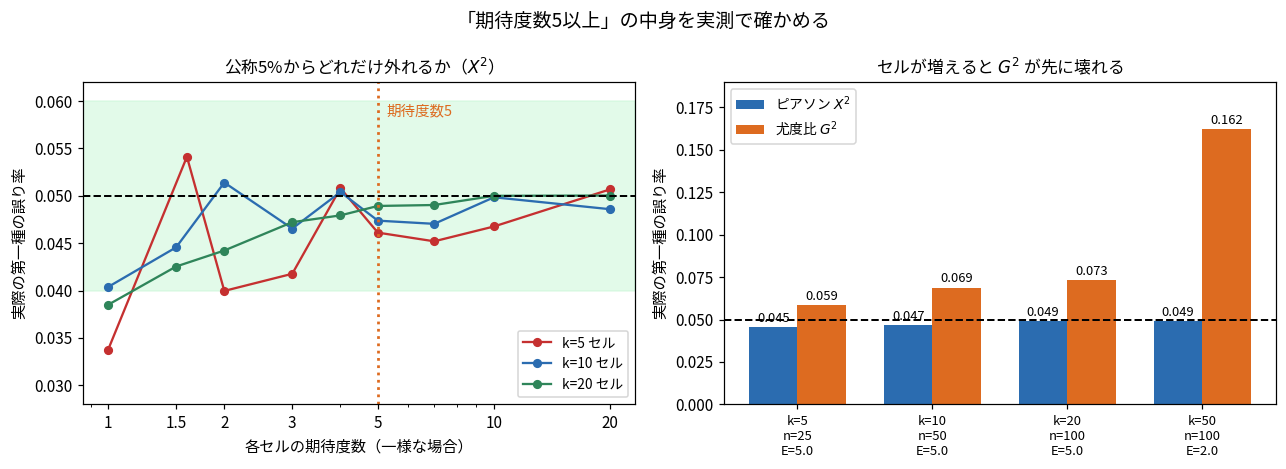
結果は予想と逆でした。この目安は思っているよりずっと緩く、崩れ方も多くの場合「危険側」ではなく「保守的側」でした。
一様な なら期待度数2まで下げても0.0521で5%とほぼ一致します。 では期待度数1で0.0335と、5%を下回る方向に外れます。つまり「近似が壊れる=偽陽性が増えて危険」という直感は外れていて、多くの場合は棄却しにくくなるだけでした。
ただし単調ではありません。左のパネルをよく見ると は途中の期待度数1.6付近で0.054とわずかに5%を超えています。単一の小さいセルの影響も、 で1つだけ のセルを作ると0.0537で、これも5%を少し上回ります。「大きく崩れることは少なく、方向は保守的側が多いが、途中で5%をわずかに超える領域もある」 が正確な言い方でした。
なお、多くの教科書が引くコクランの基準は「期待度数5以上」を一枚岩で要求するのではなく、期待度数5未満のセルが全体の20%未満で、かつ最小期待度数が1以上という形です。上の実測結果( なら でも大丈夫、 の で0.0335と保守側)は、まさにこの基準の妥当性を裏づけています。
本当に危ないのは2つ
ひとつはスパースなセルが大量にあるときで、しかも尤度比 のほうが先に壊れます。
()で は0.0499なのに は0.1624。3倍以上に膨らみます。「 のほうが尤度比検定として理論的に筋が通っている」印象がありますが、小標本での近似の質は が上でした。
もうひとつは確率が偏っている表です。 のような確率ベクトルで にすると、 の実サイズは0.0710に膨らみます。
ただしここは当初、私は誤った解釈をしていました。「偏り自体が原因」だと思ったのですが、この設定の最小期待度数は で、そもそも目安を満たしていません。 を増やして最小期待度数を5にすると0.0514まで戻ります。
| 最小期待度数 | の実サイズ | の実サイズ | |
|---|---|---|---|
| 50 | 0.5 | 0.0710 | 0.0290 |
| 100 | 1.0 | 0.0622 | 0.0565 |
| 200 | 2.0 | 0.0548 | 0.0657 |
| 500 | 5.0 | 0.0514 | 0.0589 |
つまり膨張の原因は偏りそのものではなく最小期待度数の違反でした。ではなぜ偏りが問題になるかというと、確率が偏っている表では最小期待度数が真っ先に小さくなるからです。上の例では先頭が0.9なら残り5セルの合計が0.1しかないので、最小セルは必ず0.02以下になります。偏った表を見たら、まず最小期待度数を丁寧に確認するというのが正しい教訓でした。
そしてこの表のもう一つの読みどころが、 と の優劣が入れ替わっていることです。 では 0.0710 対 0.0290 で が保守的、ところが では 0.0548 対 0.0657 で逆転します。一様な多セル()では が0.1624まで膨らみました。
私は事前に「 が頑健、 が危険」と一括りにしようとして、測定に否定されました。どちらが安全かは状況で変わります。
は小標本でも厳密に成立する
「小標本だと が信頼できない」の意味を確かめるために、多項分布を全列挙して期待値を厳密計算しました。
で 。 がどれだけ小さくても、確率がどれだけ偏っていても、平均は厳密に です。
これは2行で証明できます。多項分布では なので
も も途中で消えます。だから小標本でも偏っていても厳密に成り立つ。ただし条件があって、 に真の確率を使っている場合の話です( も必要)。パラメータを推定した場合は成立せず、実際に先ほどの正規分布の例では4.9458で5からずれていました。
壊れるのは平均ではなく分布の形と裾だけでした。「小標本で近似が悪い」という言葉が具体化された瞬間で、これは自分にとって大きい発見でした。
正確検定を常に使えばいいのでは
「 が小さくて近似が怪しいなら、厳密に計算すればいいのでは」と考えました。多項分布の確率は原理的に全列挙できるので、正確な 値が出せます。
ところが正確検定を常用しない理由があります。計算量もありますが、本質的なのは離散性でした。
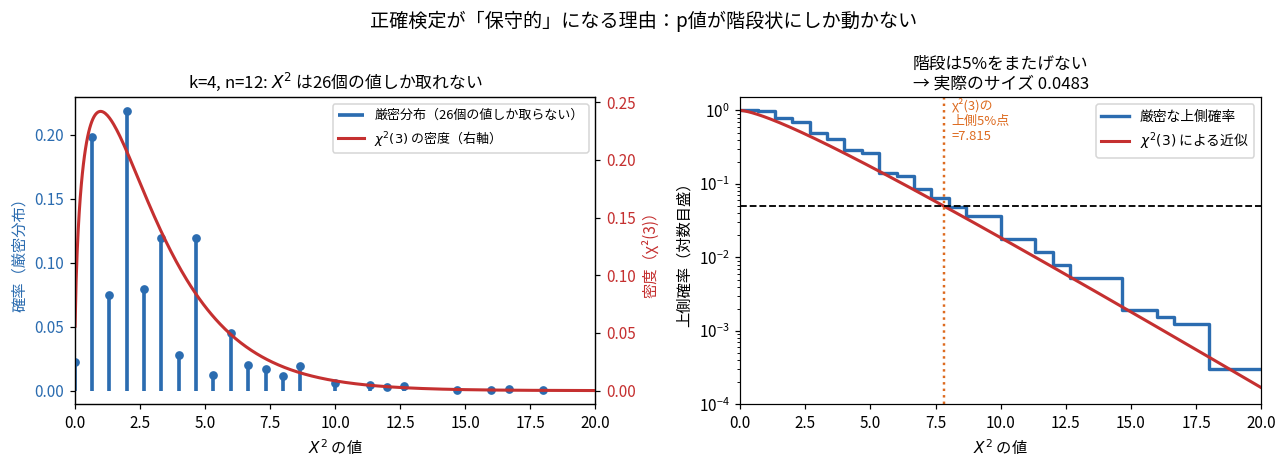
では は26個の値しか取れません。右のパネルの階段が厳密な上側確率で、これは5%の水平線をまたげない。5%以下の階段のうち一番大きいものを選ぶしかないので、実際のサイズは0.04828にしかならず、5%を使い切れません。
フィッシャーの正確検定でこれが顕著に出ます。
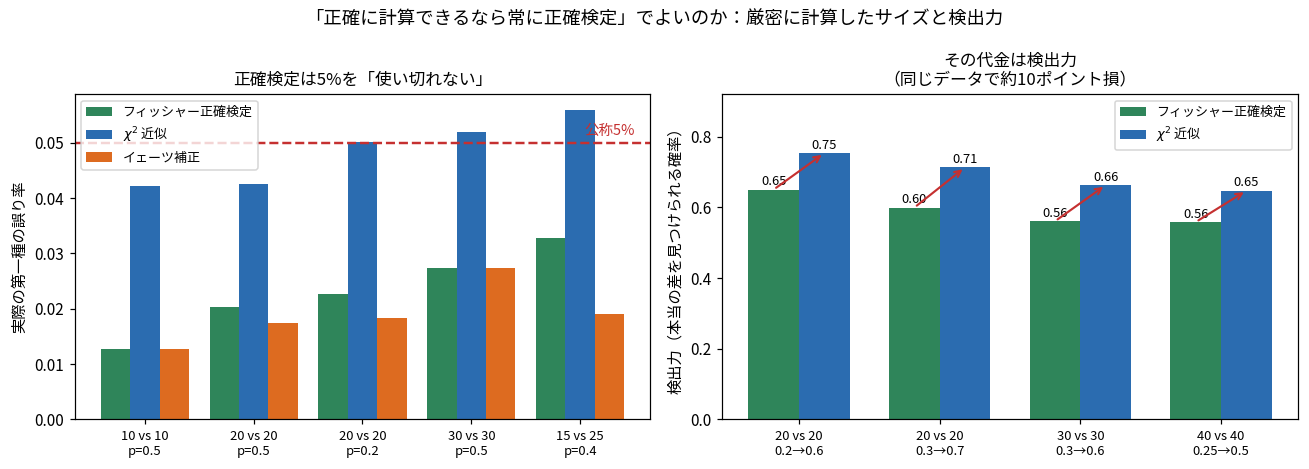
実サイズは10対10でわずか0.0128、どのケースでも常に5%未満です。そして右のパネルがその代金で、検出力が 近似より約10ポイント低い(20対20で0.2→0.6を見つける確率が0.6502 対 0.7535)。
つまり 「正確」は「一番よく見つけられる」ではなく「5%を超えないことが保証される」という意味 でした。厳密に守りたい場面では正確検定、検出力が惜しい場面では近似、という使い分けになります。
なお左のパネルでは 近似のサイズが5%をやや超えているケース(15対25で0.0560)もあるので、検出力を比べるならサイズが揃っている組で見る必要があります。20対20( 側0.0425)の比較が公平で、そこでの差が約10ポイントです。
イェーツの連続性補正についても測りました。「正確検定に寄せるぶん保守的になる」と書こうとしたのですが、実際はフィッシャーよりさらに保守的になることがありました(20対20でイェーツ0.0175 対 フィッシャー0.0204、15対25でイェーツ0.0191 対 フィッシャー0.0328)。寄せるどころか行き過ぎている。イェーツ補正が現在あまり推奨されないのはこれが理由です。
離散性による損失を減らす標準的な処方としては mid-p値(境界の確率を半分だけ数える方法)があり、保守性と水準の維持のバランスを取れます。「正確か近似か」の二択ではありません。
計算量のほうは、 の多項分布を全列挙すると パターンで、そもそも不可能です。ここでモンテカルロによる 値が実用解になります。
なお分割表の独立性検定もこの章の範囲ですが、連載では第30回でまとめて扱うので、ここではフィッシャーの正確検定の性質だけに触れています。
実務例:エラー件数はポアソン分布に従うか
ここまでの道具を実際に使ってみます。サーバーの1分あたりのエラー件数が200分ぶんあるとして、ポアソン分布に従うかを調べます。
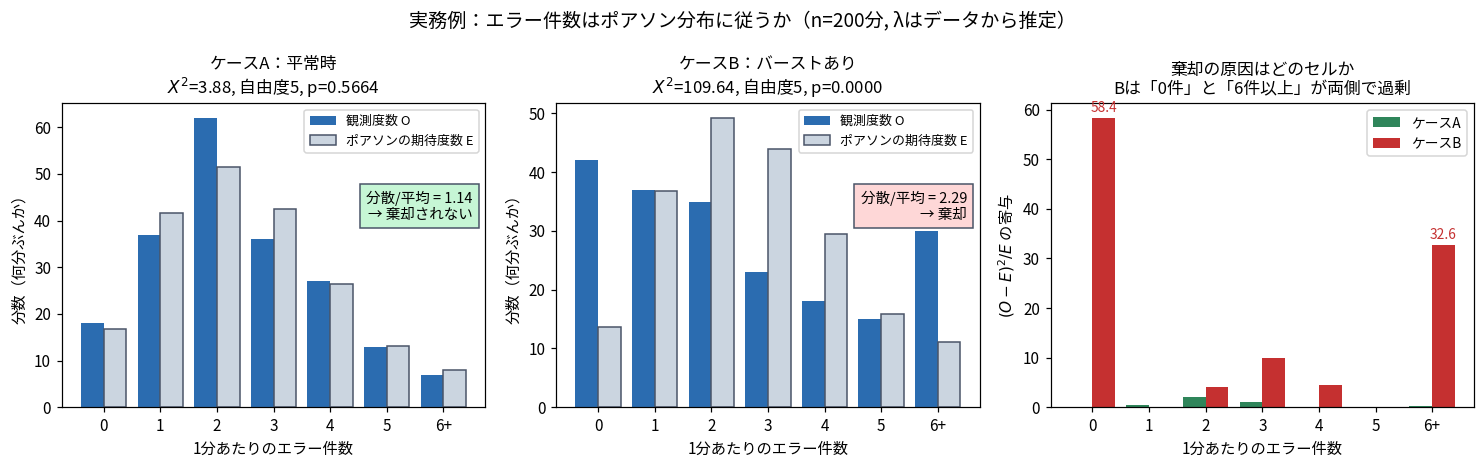
ケースA(平常時)は 、 で棄却されません。ケースB(バーストあり)は で棄却されます。
ここで価値があるのは 値ではなく右のパネルです。 ケースBは「0件」の寄与が58.4、「6件以上」が32.6で両端が過剰。これは「静かな時間と大量発生が混在する」というバーストの形で、どう外れているかを教えてくれます。次の候補が負の二項分布(ガンマ混合ポアソン)だと分かる。
は 個のズレを1個の数に押し込む装置なので、押し込む前のセルごとの寄与を見ないと情報を捨てることになります。
そもそも分散平均比を見るほうが早い
ポアソン分布は平均と分散が等しいので、分散/平均比を見るのが手っ取り早いです。ケースAは1.1408、ケースBは2.2867。1から離れていれば怪しい。
という過分散(overdispersion)の検定があり、こちらは「過分散」という特定の方向に絞っているぶん検出力が高くなります。 と書いたのは、これが厳密ではなく近似だからです(独立同分布で帰無仮説がポアソンという前提つき)。 が小さいと近似が悪化し、 では実サイズが0.0382と保守側にずれました。
この統計量の自由度が になる理由も、さきほどの で説明できます。 は「 個のセル・期待度数 のピアソン 」そのものの形なので、セル数 に対して自由度が になる。実際に平均を測ると で29.0、 で199.0とぴったりでした。
適合度検定の強みは方向を指定しないぶん何にでも使えること、弱みは同じ理由で弱いことでした。疑う方向が決まっているなら専用の検定のほうがいい。
期待度数5以上を満たしても棄却される例
正規性の例がいちばん教育的だったので載せます。日次リターン500日ぶんを10セルに分けて正規分布への適合を見ます。
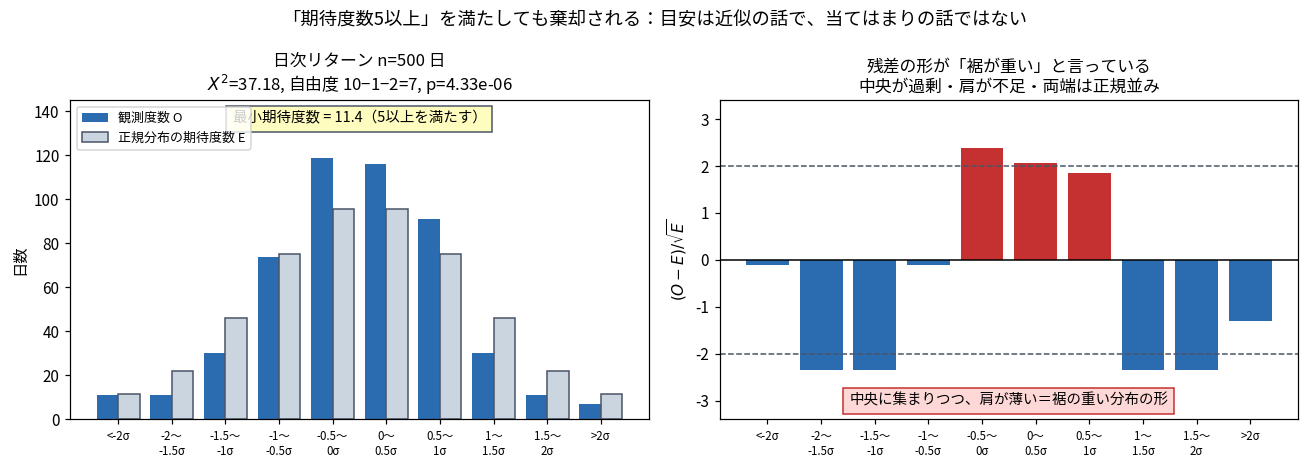
最小期待度数11.375で目安を余裕で満たしているのに、、 で棄却されます。
これで「期待度数5以上」の意味がはっきりしました。あの目安は「χ²近似が使えるか」の話であって、「当てはまりが良いか」とは無関係です。私はこの2つを混同していました。
右の残差を見ると、中央3セルが過剰・肩の4セルが不足という形で、裾の重い分布の特徴が出ています。
この検定、実務でどのくらい使うのか
ここまで書いてきて、正直に思ったことがあります。「この分布に従うか」を単体で検定する場面は、実務ではそう多くないのではないか。
理論的に度数が決まっているケース(メンデルの遺伝比、サイコロやルーレットの一様性)、乱数生成器やシミュレーションの検証、品質管理の受入検査くらいで、圧倒的に多いのは「分布を仮定して、その上で推定や検定をする」場面です。
じゃあ仮定した分布を検定すればいいのでは、となります。前回の第13回で「分散の検定は正規性に守られていない」と分かったので、なおさらそう考えました。ここに罠がありました。
検定が鳴るのは、鳴ってほしくないときだけ
同じデータに「正規性の適合度検定」と「正規性を仮定した手続き」を同時にかけて測りました()。
| 真の分布 | 平均のt検定 (公称5%) | 分散の検定 (公称5%) | 正規で作った99%点の 実際の超過率(公称1%) | 正規性検定が 気づく確率 |
|---|---|---|---|---|
| 正規 | 0.0502 | 0.0493 | 1.44% | 0.0517(サイズ) |
| 一様 | 0.0513 | 0.0033 | 0.08% | 0.1128 |
| t(3) | 0.0449 | 0.3857 | 2.33% | 0.2352 |
| 対数正規 | 0.0856 | 0.4241 | 4.77% | 0.7732 |
t(3) の行を見てください。分散の検定は公称5%が実際38.6%まで暴走しています。7倍以上。ところが正規性の適合度検定が気づける確率は23.5%しかない。壊れている場面で警報が鳴りません。
を動かすとこの構造がさらにはっきりします(データは t(3) 固定)。
| 正規性検定の検出力 | t検定の実サイズ | 99%点の超過率 | |
|---|---|---|---|
| 20 | 0.1932 | 0.0434 | 2.73% |
| 30 | 0.2359 | 0.0441 | 2.45% |
| 50 | 0.3733 | 0.0452 | 2.09% |
| 100 | 0.6196 | 0.0466 | 1.91% |
| 200 | 0.8943 | 0.0483 | 1.75% |
| 500 | 0.9993 | 0.0479 | 1.53% |
平均については完全に噛み合っていません。 では t 検定は0.0434で問題ないのに正規性検定は19%しか気づけない。 では99.9%の確率で「非正規だ」と警報を出すのに、中心極限定理が効いていて t 検定は0.0479で何の問題もない。
ただしこの数字は「適合度検定でやった場合」
ここで一つ注意が必要です。上の検出力はχ²適合度検定で正規性を調べた場合の数字で、正規性検定一般の性能ではありません。適合度検定は連続データをセルに丸める時点で情報を捨てるので、正規性検定としてはかなり弱いほうです。
同じ t(3) を、正規分布で臨界値を較正して公平に比べるとこうなります。
| χ²適合度 | アンダーソン–ダーリング検定 | ジャック–ベラ検定 | |
|---|---|---|---|
| 20 | 0.193 | 0.327 | 0.391 |
| 30 | 0.236 | 0.430 | 0.517 |
| 50 | 0.373 | 0.610 | 0.699 |
検出力がおよそ2倍違います。実務や試験でシャピロ–ウィルク検定やアンダーソン–ダーリング検定が使われるのはこのためで、連続分布への適合を見るならセルに区切らない検定のほうが強い(コルモゴロフ–スミルノフ検定も同じ理由でこちら側です)。
ただし結論は変わりません。検出力が2倍になっても で0.43、つまり半分以上見逃すからです。事前検定という手順自体の問題は残ります。
「事前検定してから本検定」という手順が統計学で批判されるのは、この噛み合わなさが理由でした(第一種の誤りが二段構えで制御できなくなるという問題も別にあります)。前回F検定について同じ結論に達したので、これは一般的な性質のようです。
3つの戦略を比べる
では何を選ぶべきか。3つの道を同じ条件で測りました。
- 戦略A:分布を仮定して進む(t検定)
- 戦略B:適合度検定で正規性を確かめてから選ぶ
- 戦略C:最初から仮定しない(ウィルコクソン)
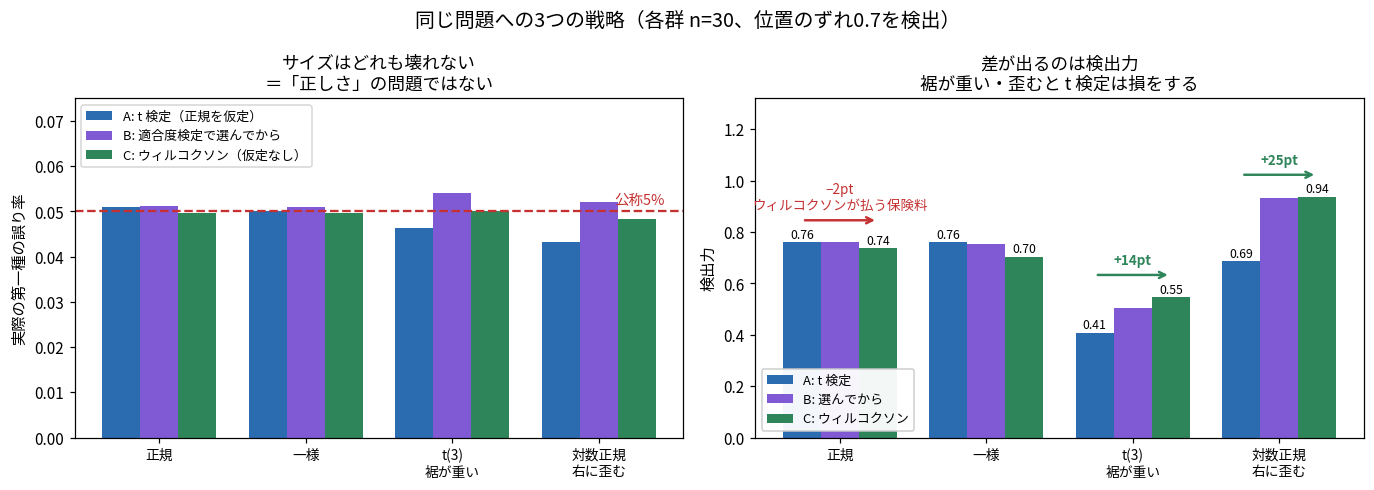
左のパネルが重要です。サイズはどの戦略でもほぼ0.05に収まっています。 ここでは2標本の比較をしているので、正規性が崩れても t 検定は壊れない。だからこの設定では「正しさ」の問題ではありませんでした。
ただしこれは無条件ではありません。2標本だから成り立っているのがポイントで、先ほどの表(1標本の検定)で対数正規のとき0.0856だったことと矛盾していません。同じ対数正規で測り直すとこうなります。
| 検定の設計 | 実サイズ(公称5%) |
|---|---|
| 1標本 t検定 | 0.0862 |
| 2標本 t検定(30対30) | 0.0460 |
| 2標本 t検定(50対10) | 0.0483 |
2標本では2つの群の歪みが引き算で打ち消し合うので、サイズが保たれます。1標本では歪度がそのまま残るため、中心極限定理の収束の遅れが直接効いて5%を超えます。「平均の検定なら歪んでいても安全」と丸暗記すると危ないところでした。
差が出るのは検出力です。t(3) で t 検定0.4089 対 ウィルコクソン0.5480、対数正規で0.6860 対 0.9380。裾が重いと t 検定は損をします。外れ値が標準偏差を膨らませて自分の分母を大きくしてしまうからで、順位に変換するウィルコクソンはその影響を受けません。
逆に正規のときウィルコクソンが払う代金は0.7608 → 0.7379、わずか2ポイントです。安い保険料です。
戦略Bは中途半端でした。ここでは両群それぞれに正規性検定をかけて、両方通ったら t 検定という手順にしています。t(3) だと片方が通る確率が なので、両方通るのは 、つまり59.4%を「正規」と誤判定してしまい、検出力0.5050とウィルコクソン単体(0.5480)に届かない。対数正規では で6.1%しか通さないので実質ウィルコクソンと同じ。わざわざ2段階にした甲斐がありません。
ただし平均以外では「正しさ」が崩壊する
ここまでは平均の話でした。分位点になると話が変わります。
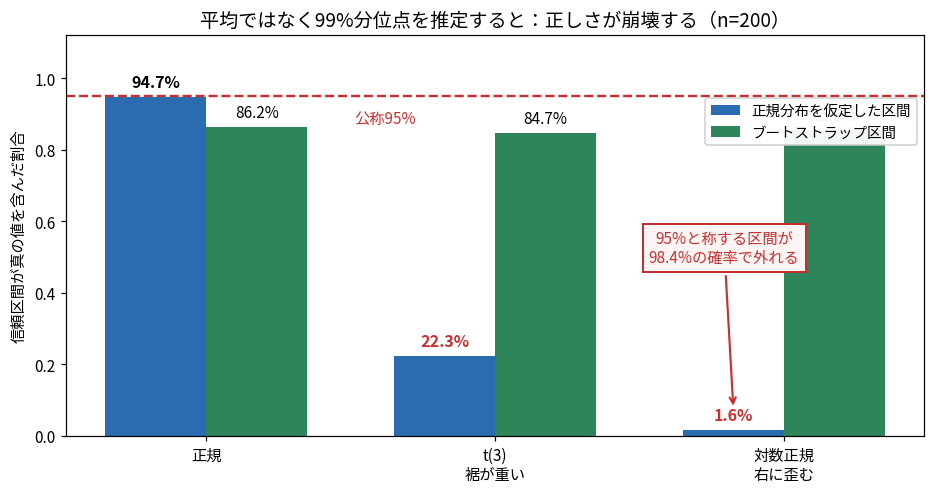
で99%分位点の95%信頼区間を作り、実際の被覆率を測りました。
| 真の分布 | 正規仮定 | ブートストラップ |
|---|---|---|
| 正規 | 0.9473 | 0.8622 |
| t(3) | 0.2228 | 0.8470 |
| 対数正規 | 0.0158 | 0.8550 |
対数正規で正規仮定の区間は被覆率1.6%。95%と称している区間が98.4%の確率で真の値を外します。もはや区間推定として機能していません。
中心極限定理は平均を守りますが、分位点は守りません。 リスク管理のVaR(Value at Risk、想定最大損失額)、在庫の安全在庫、SLA(Service Level Agreement、サービス品質保証)の99パーセンタイルはすべてこちら側にあります。
ただしブートストラップも0.85前後で公称95%には届いていません。分位点のブートストラップは裾に依存するので難しく、無料の解決策ではないということです。それでも1.6%と85%なら比べる余地はありません。
整理すると
| 何を推論するか | 正規性が崩れたとき | 適合度検定は役に立つか |
|---|---|---|
| 平均・回帰係数 | サイズは保たれ、検出力が落ちる | 意味が薄い。 が小さいと検出力なし、大きいと中心極限定理で仮定が不要 |
| 分散・分位点・裾 | 正しさが崩壊する(被覆率1.6%) | 一番頼りたいのに検出力が足りない |
そしてどちらの場合も、適合度検定を通してから決めるより、最初からロバストな手続きを選んだほうが良い。
ノンパラメトリック法の本当の役割は「仮定の検査官」ではなく「仮定を要らなくする代替経路」でした。 次回の第13章がまさにそこなので、繋がりが見えてきました。
使い分けの地図
最後に、適合度検定を使うときの判断をまとめます。
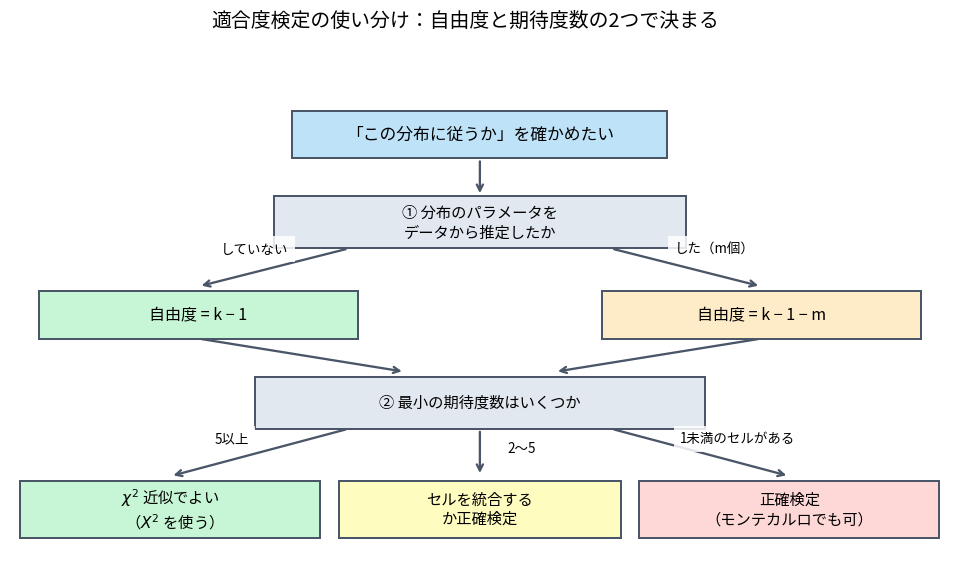
判断は2つだけです。①パラメータを推定したか(自由度が か か)、②最小期待度数はいくつか(χ²近似でよいか、セルを統合するか、正確検定にするか)。
ただし前述のとおり、確率が偏っている表では最小期待度数が真っ先に小さくなるので、偏りのある表では②を特に丁寧に確認する必要があります。コクランの基準(期待度数5未満のセルが20%未満・最小1以上)のほうが実態に近い目安です。
そして棄却されたときは 値で終わらせず、セルごとの寄与を読んでどう外れているかを診断する。ここまで来て、適合度検定は判定装置ではなく診断装置だという理解に落ち着きました。
この章の本題は適合度検定ではなかった
適合度検定を細かく測ってきましたが、第12章の本題は別にあります。尤度比検定と漸近論です。
これはWilksの定理と呼ばれるもので、「帰無仮説が課す制約の本数 だけ自由度を持つχ²に収束する」という主張です。成立には入れ子のモデルであること、正則条件、そして真の値が母数空間の内部にあること(境界上では成立しません)が必要です。
ここで記号に注意が必要でした。適合度検定の (推定したパラメータの個数)と、Wilksの (制約の本数)は別物です。適合度検定をWilksの枠で見ると、セル確率 個の自由なパラメータのうち 個分だけを分布族の形に縛るので
となり、これが自由度 の別の導き方になります。 と を混同しないよう、記号を分けておきます。適合度検定の はこの定理の一番単純な実例にすぎません。
この定理が効く場所は非常に広く、ロジスティック回帰の逸脱度、モデル選択、一般化線形モデルの検定、階層モデルの比較などで使い続けます。そして今回測った「 と が漸近的に同じで、小標本では のほうが近似が良い」という性質は、逸脱度を扱うときにそのまま効いてきます。
と が漸近的に同じになる理由も書いておくと、 を のまわりでテイラー展開すると2次の項がちょうど になります。つまり は の2次近似。だから と が近いところ(= が大きい)では一致し、離れると挙動が分かれるわけです。
この章で触れなかったこと
- 分割表の独立性検定:自由度が になりますが、これも今回の考え方そのままです。 個の自由なセル確率のうち、行と列の周辺確率 個を推定するので 。連載では第30回で扱います。
- コルモゴロフ–スミルノフ検定:累積分布関数の最大のズレを見る検定で、セルに区切らないので情報を捨てません。連続分布への適合を見るならこちらのほうが強く、先ほどの正規性の検出力比較がその証拠です。
- 非心カイ二乗分布:適合度検定の検出力を理論的に計算する道具で、非心度は です。今回は検出力をすべてシミュレーションで測りましたが、本来はこれで計算できます。
適合度検定が第12章に置かれているのは、「分布族という曲線からの距離を測る」という漸近論の考え方を、一番目に見える形で体験させるためだったと理解しました。
つまずいたところ
「一般の分布に関する検定=適合度検定」だと思っていた。 ②の主流は「分布族を認めた上でパラメータを問う」尤度比・ワルド・スコア検定で、適合度検定は逆向きに「分布族自体を問う」特別な一員でした。ここを混同していると、章の本題である漸近論が視野から落ちます。
①②③が「どの分布か」で分かれていると思っていた。 ①と②の境界は厳密な分布が書けるかどうかでした。「一般の分布」は「正規以外」ではなく「正規のような都合の良さがない場合」という意味です。
適合度検定を「パラメータを計算する手続き」だと思っていた。 計算はしていますが目的ではありません。曲線までの距離を測るための足場で、 は検定の結論に登場しません。単体の上に描いてみて初めて腑に落ちました。
自由度が減る理由を第7回と同じだと思っていた。 は厳密な制約ですが、 は平均して1だけ削られるという漸近的な性質です。差が負になることが10.4%あります。
「推定すれば は必ず小さくなる」と書いて、間違えた。 最尤推定と最小カイ二乗推定は別物です。 を動かして の谷を描いた図のとき、当初は「推定は谷の最小点を選ぶ」と説明するつもりで、シミュレーションに否定されました。
期待度数を下げると「甘くなって危険」だと予測して、外した。 多くの場合は保守的になる方向でした(・期待度数1で0.0335)。ただし単調ではなく、途中で5%をわずかに超える領域もあります。
「 が頑健、 が危険」と一括りにしようとして、否定された。 一様な多セルではその通りですが、偏った表では で 0.0710 対 0.0290、 で0.0548 対 0.0657と入れ替わります。どちらが安全かは状況依存でした。
「期待度数5以上」を「当てはまりの目安」と混同していた。 最小期待度数11.4で満たしているのに で棄却される例を見て、あれは近似の質の話だと分かりました。
「正規性が怪しいから検定しよう」という発想そのものが間違いだった。 測ってみると、2標本の平均についてはサイズが壊れないので検出力の問題、分位点については正しさが崩壊するが検定の検出力が足りない。どちらも事前検定は機能せず、最初からロバストな手続きを選ぶべきでした。
この記事の要点
- 「一般の分布に関する検定」は適合度検定より広い枠。 本題は で、。適合度検定の と混同しない
- ①②③の境界は「どの分布か」ではなく ①厳密に書けるか ②漸近近似か ③分布族を仮定しないか
- 適合度検定は機構は②・性質は③。ウィルコクソンと同じ行だが「分布の形」を問う点で列が違う
- 帰無仮説は「点」ではなく 「曲線(分布族)に乗っているか」 。曲線に沿って逃げられる方向の数が
- パラメータ推定は目的ではなく手段。 は検定の結論に登場しない
- は厳密な制約、 は平均して1だけ削られる漸近的な性質(差が負になるのが10.4%)
- 最尤推定 ≠ 最小カイ二乗推定。 生データから推定すると自由度は と の間(Chernoff–Lehmann)
- は が小さくても厳密( で も も消える)。ただし真の を使う場合のみ
- 「期待度数5以上」は緩い。崩れても多くは保守的(・E=1で0.0335)。教科書の基準はコクランの形(5未満が20%未満・最小1以上)
- X²とG²の優劣は逆転する。 一様多セルは が危険(0.1624)、偏った表は で入れ替わる
- 正確検定は離散性ゆえ構造的に保守的(フィッシャー10対10で0.0128)。代金は検出力10ポイント。イェーツはさらに行き過ぎ、緩和策はmid-p値
- 最小期待度数11.4でも で棄却される。 目安は近似の話で当てはまりの話ではない
- 「正規性を検定してからt検定」は機能しない。 が小さいと気づけず、大きいと気づく必要がない
- 2標本の平均はサイズが壊れず検出力が落ちるだけ(t(3)で14pt、対数正規で25ptの損)。1標本は歪度でサイズが壊れる(0.0862)
- 分位点は正しさが崩壊する。正規仮定の99%点の区間は被覆率 1.6%
- 適合度検定は判定装置ではなく診断装置。セルごとの寄与で「どう外れているか」を読む
次回は第13章のノンパラメトリック法です。今回「仮定を検査するより、仮定を要らなくする経路を選ぶべき」という結論に至ったので、その経路そのものを扱う章になります。ウィルコクソンが正規のときに払う代金が2ポイントしかないという数字を見てしまったので、なぜそんなに安いのかを知りたくなっています。