離散型分布の使い分け:分布は「選ぶ」のではなく「渡される」【第5回】
はじめに
第4回では変数変換とヤコビアンを扱いました。今回は第5章「離散型分布」です。
この章は、正直なところ「知っているつもり」でした。二項分布、ポアソン分布、幾何分布、超幾何分布——全部名前は聞いたことがあるし、公式もどこかで見た覚えがあります。過去に挫折したときも、ここは飛ばさずに読んだはずです。
にもかかわらず、実務で困っていました。「このデータ、どの分布で考えればいいですか」と聞かれたときに答えられないのです。それぞれの定義は言えるのに、目の前のアクセスログや障害チケットの件数を見て「これは二項です」「これはポアソンです」と決める手順が自分の中にありませんでした。
今回いちばんの発見は、そもそも、「分布を選ぶ」という発想自体がずれていたという点です。実務でやっているのは選択ではなく、「いちばん単純な分布から始めて、その前提が崩れていないか確かめて、崩れていたら次の分布に渡す」という一方向の流れでした。この軸で章全体を読み直すと、6つの分布がきれいに並びました。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
TL;DR
- 実務での使い分けは「分布を選ぶ」ではなく、単純な分布の前提が崩れたら次に渡すという流れだった
- 出発点は二項分布。試行回数nが決まっているかで最初の分岐が起きる
- ポアソン分布は「めったに起きないこと専用」ではない。 はいくらでも大きくできる
- ポアソン分布の前提が崩れると分散が平均を超える(過分散)。実測では分散が平均の17倍になった
- 過分散を受け止めるのが負の二項分布。ポアソン分布を含む、より広いモデルだった
- 幾何分布の無記憶性は「50回外した人のその後も最初と同じ」という、直感に反するのに実務で使える性質
用語集
この記事の鍵になる2語だけ挙げておきます。後で具体例つきで説明するので、いま覚える必要はありません。
| 用語 | 意味 |
|---|---|
| 過分散 | データの分散が、モデルが想定する分散より大きいこと。ポアソン分布は平均=分散なので、分散が平均を超えたら過分散 |
| 無記憶性 | これまで何回失敗したかが、この先の見通しに影響しないという性質。 |
「どの分布を使うか」で詰まっていた
第5章の冒頭を読んだとき、まず思ったのは「また分布のカタログか」でした。二項分布の定義、期待値、分散、モーメント母関数。次にポアソン分布の定義、期待値、分散、モーメント母関数。以下同様——という構成で、分布ごとに公式が並んでいます。
これを覚えても実務では使えなかった、というのが過去の経験でした。カタログを暗記しても、目の前のデータをどの棚に入れるかが分からないからです。
そこでAIに、教科書の順番ではなく「実務で最初に判断すべきこと」から整理してもらいました。出てきたのがこの図です。
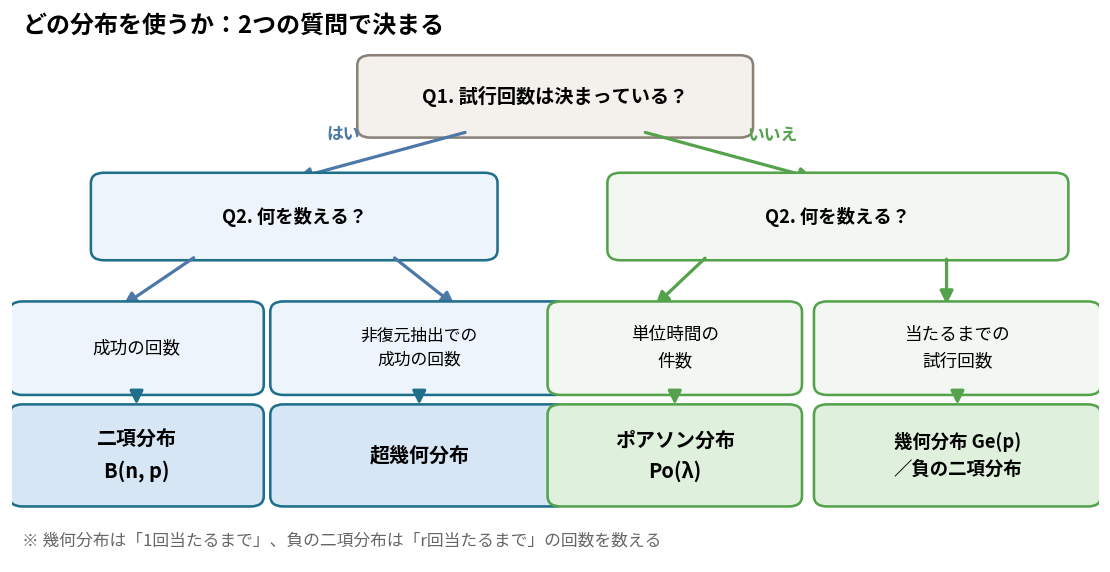
最初の分岐は「試行回数nが決まっているか」でした。
10打席立つ、100人にメールを送る、50個を検査する——このように分母があるなら二項分布の系統です。一方、1分間のアクセス数、1日の障害件数のように「何回試したか」が数えられず件数だけが観測されるならポアソン分布の系統になります。
そして「当たるまで何回かかるか」を知りたい場合は、回数そのものが確率変数になるので幾何分布・負の二項分布に移ります。
3つを並べると、形がはっきり違います。
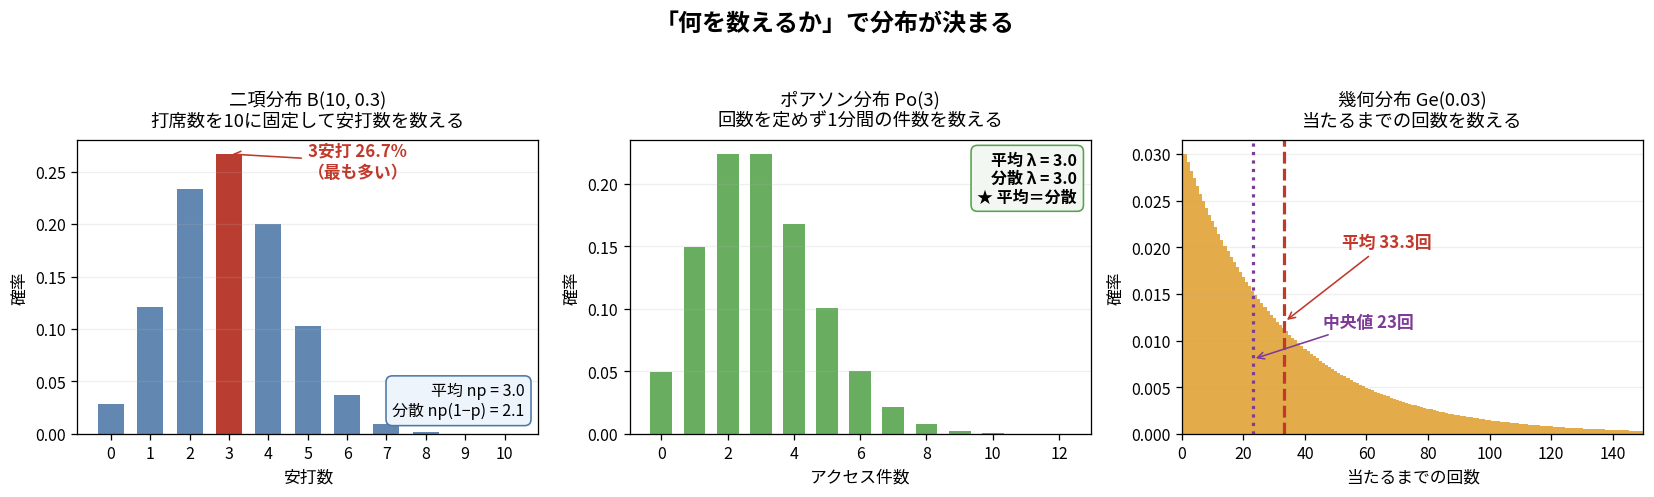
二項分布は10で打ち切られる有限の分布、ポアソン分布は右に無限に続く分布、幾何分布は1回目がいちばん高くて単調に減っていく分布です。同じ「数を数える」でも、何を数えているかで形が変わるわけです。
出発点:二項分布
いちばん単純な出発点が二項分布です。打率3割の選手が10打席立ったときの安打数を考えます。
、 で計算するとこうなります。
| 安打数 | 確率 |
|---|---|
| 0本 | 2.82% |
| 1本 | 12.11% |
| 2本 | 23.35% |
| 3本 | 26.68% |
| 4本 | 20.01% |
| 5本 | 10.29% |
平均は 、分散は です。平均が3本で、実際に3本がもっとも起こりやすい。ここは直感どおりです。
注目したいのは分散が平均より小さいという点です。 を掛けるので必ずそうなります。この「分散 < 平均」という性質が、後でポアソン分布と比べるときの目印になります。
二項分布が成り立つ条件は、試行回数nが固定されていて、各試行が独立で、成功確率pが毎回同じであること。Web系の実務ではA/Bテストのコンバージョン、メールの開封率、品質検査の不良品数などがそのまま当てはまります。
nが数えられないとき:ポアソン分布
さて実務で困るのは、nが数えられない場合です。
「このサイトに1分間に何件アクセスが来るか」を二項分布で書こうとすると、分母が要ります。世界の全人口を分母にすればいいのか。日本のインターネット利用者か。決められません。しかも各人がこの1分にアクセスする確率pも分かりません。
ここでポアソン分布が出てきます。
nとpを個別に知る必要がなく、(単位時間あたりの平均件数)だけで書けるのが利点です。平均3件/分のアクセスなら を入れるだけです。
| 件数 | 確率 |
|---|---|
| 0件 | 4.98% |
| 1件 | 14.94% |
| 2件 | 22.40% |
| 3件 | 22.40% |
| 4件 | 16.80% |
| 5件 | 10.08% |
200万回のシミュレーションで平均2.998、分散3.004でした。平均=分散がポアソン分布の決定的な特徴です。
実際にnを増やすと二項分布はポアソン分布になる
「nとpを知らなくていい」という主張が本当か、確かめました。 に固定したまま、nを増やしてpを小さくしていきます。
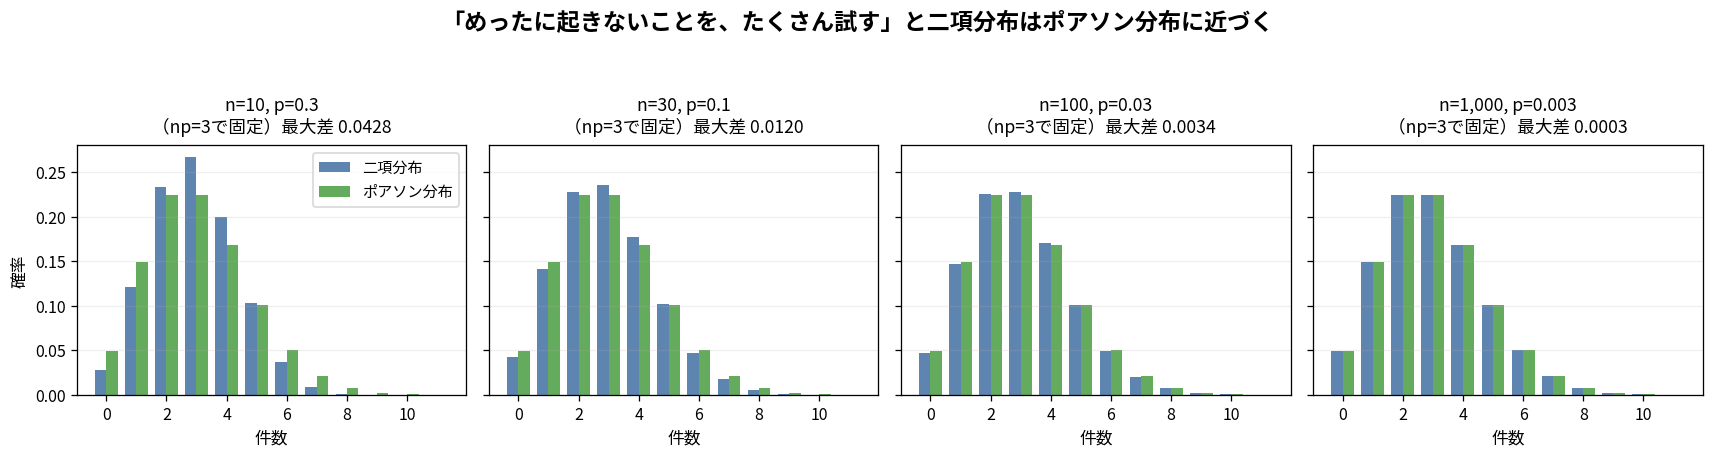
| n | p | 二項分布とポアソン分布の最大差 |
|---|---|---|
| 10 | 0.3 | 0.0428 |
| 30 | 0.1 | 0.0120 |
| 100 | 0.03 | 0.0034 |
| 1000 | 0.003 | 0.0003 |
ではもう見分けがつきません。nをどんどん大きくしても が同じなら形は変わらない——だからnを知らなくても済むのです。「分母が数えられない」という困りごとへの回答が、この収束でした。
私が誤解していたこと:ポアソン分布は「レアな現象」専用ではない
ここで、自分がずっと勘違いしていた点が判明しました。
上の収束が「、」という条件で成り立つので、私は「ポアソン分布はめったに起きないことに使う分布」だと理解していました。地震の回数、システム障害の件数、事故の件数——たしかに教科書の例はどれも珍しい事象です。だから「1分に1200件くるアクセス」のような頻繁な現象には使えないと思っていました。
これが間違いでした。 は二項分布から導出するときの条件であって、適用するときの条件ではないのです。
1日100万PVのサイトを考えます。1分あたり平均1200件なら で、これはまったく「レア」ではありません。しかし個々の利用者に目を向けると、ある特定の1人がこの特定の1分にアクセスする確率は で、極めて小さい。pが小さいのは「1人あたり」の話で、 はいくらでも大きくできるわけです。
を変えると形はこう変わります。
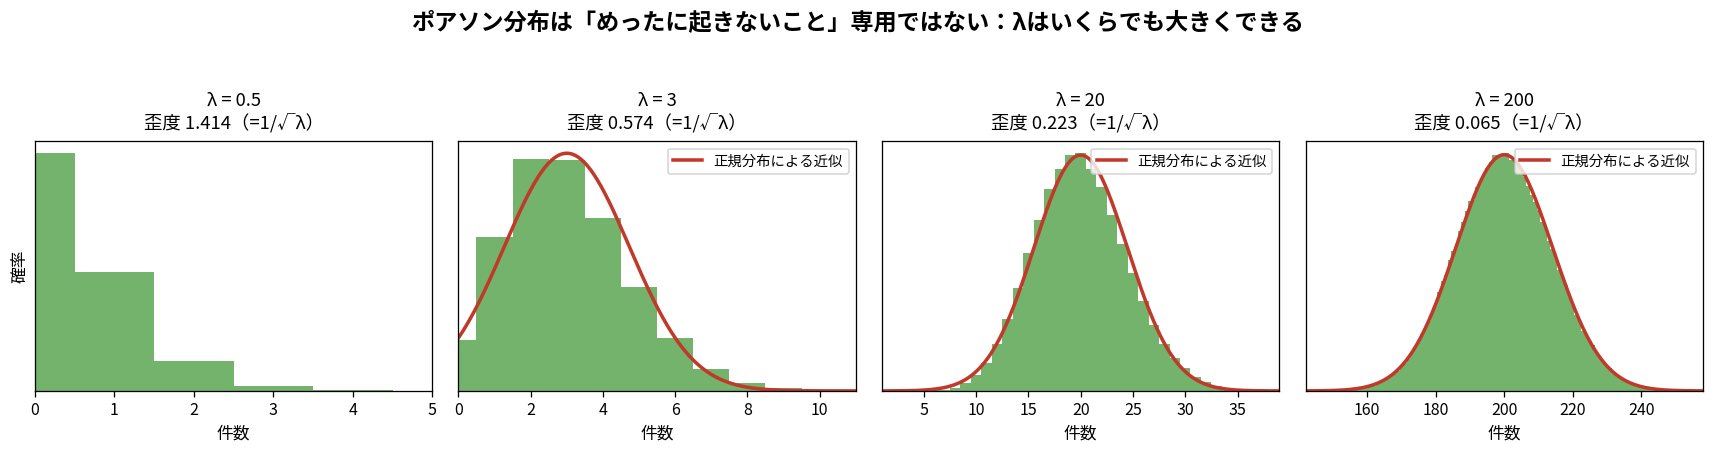
| 歪度 | 形 | |
|---|---|---|
| 0.5 | 1.414 | 右に強く歪む |
| 3 | 0.574 | 右に歪む |
| 20 | 0.223 | やや歪む |
| 200 | 0.065 | ほぼ左右対称 |
歪度は です。 が大きいほど左右対称に近づき、 あたりから正規近似が実用的になります。
これは実務で効きます。1分1200件のアクセスを扱うとき、いちいちポアソン分布の式を使わなくても正規分布で近似してよい。逆に「1日あたり0.5件の障害」のような小さい では歪みが強いので、平均±2σのような感覚で扱うと外します。
ポアソン分布の本当の前提
では適用条件は何なのか。ポアソン過程の3条件でした。
独立性は、ある区間の件数が他の区間に影響しないこと。崩れる例は、障害が起きてクライアントが一斉にリトライするケースです。1件のエラーが次のエラーを呼ぶので独立ではありません。
定常性は、単位時間あたりの発生率 が一定であること。昼と夜でアクセス数が違うサイトを1日まとめて1つの で扱うと、この前提が崩れます。
希少性は、極めて短い時間に2件以上が同時に起きないこと。これも私は誤読していて、「稀な現象に限る」という意味だと思っていました。実際は「瞬間的に同時発生しない」という意味です。崩れる例は、バッチの一括登録で同じ瞬間に大量のレコードが作られるケースです。
前提が崩れたときに何が起きるか:過分散
3条件が崩れたら何が起きるのか。分散が平均を超えます。
3つの状況をシミュレーションで比べました。
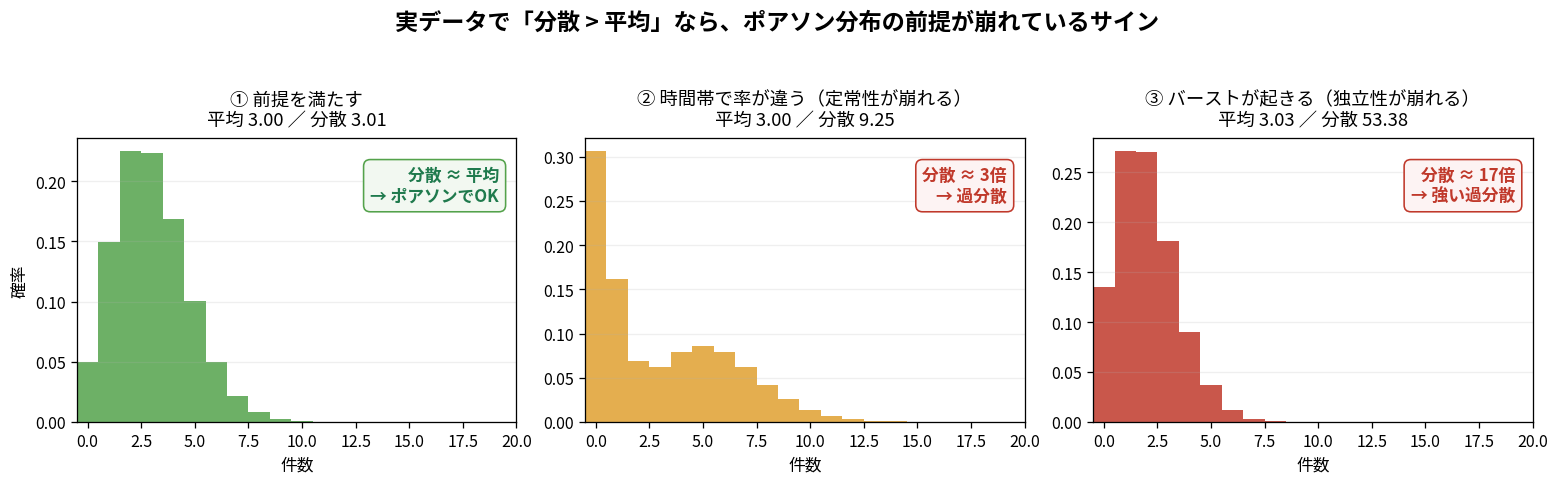
| 状況 | 平均 | 分散 |
|---|---|---|
| 前提を満たす | 3.00 | 3.01 |
| 時間帯で率が違う(定常性が崩れる) | 3.00 | 9.25(約3倍) |
| バーストがある(独立性が崩れる) | 3.03 | 53.38(約17倍) |
平均はどれも3.00前後で変わりません。平均を見ているだけでは前提の崩れに気づけないわけです。しかし分散は3.01、9.25、53.38と大きく違います。
ここが実務でいちばん役に立った知見でした。手元の件数データについて平均と分散を計算して、分散が平均より明らかに大きければポアソン分布を仮定した分析は信用できない。逆に言えば、その2つを計算するだけで前提のチェックができます。
信頼区間を例にすると影響が分かります。ポアソン分布を仮定すると標準偏差は ですが、実際の分散が53.38なら標準偏差は7.31です。4倍以上ずれているので、「この件数は異常です」というアラートが誤検知だらけになります。ポアソン分布を仮定した異常検知が現場でうるさくなりがちなのは、たいていこれが原因です。
なぜ率が混ざると過分散になるのか
定常性が崩れると分散が増える理屈が最初ぴんと来ませんでした。個々の時間帯ではちゃんと平均=分散なのに、なぜ合わせると壊れるのか。
実際にやってみました。
import numpy as np

rng = np.random.default_rng(0)

# 3つの時間帯でアクセス率が違うサイトを想定
for lam, name in [(0.5, "閑散期"), (3.0, "通常"), (9.0, "繁忙期")]:
    x = rng.poisson(lam, 200000)
    print(f"{name}: 平均 {x.mean():.2f} / 分散 {x.var():.2f}")
    # → どれも平均 ≈ 分散(ポアソン分布の性質)

# 3つを混ぜると…
mixed = np.concatenate([rng.poisson(lam, 200000) for lam in (0.5, 3.0, 9.0)])
print(f"混合: 平均 {mixed.mean():.2f} / 分散 {mixed.var():.2f}")
# → 平均 4.17 / 分散 16.88(分散が平均の4倍=過分散)
| グループ | 平均 | 分散 | |
|---|---|---|---|
| 閑散期 | 0.5 | 0.50 | 0.50 |
| 通常 | 3.0 | 3.01 | 3.00 |
| 繁忙期 | 9.0 | 9.00 | 8.99 |
| 混ぜた結果 | — | 4.17 | 16.88 |
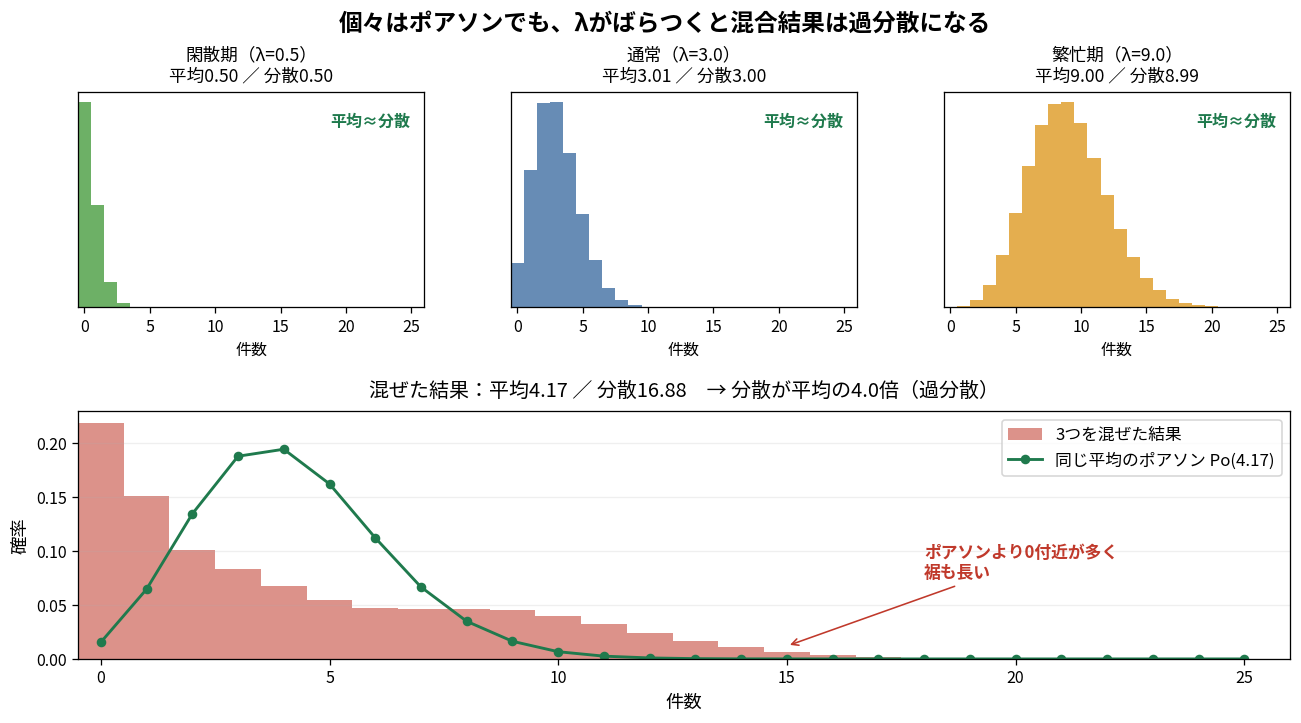
個々のグループは律儀に平均=分散を守っています。それでも混ぜると分散が平均の4倍になりました。
理由は、ばらつきの原因が2階建てになるからです。ポアソン分布のばらつき(同じ でも件数が揺れる)に加えて、 そのものが0.5なのか9.0なのかというばらつきが乗ります。後者が上乗せされるので、合計の分散が膨らみます。
実務のデータはほぼ必ずこの状態です。曜日で違う、時間帯で違う、ユーザーセグメントで違う。「本当に は1つか」を疑う癖が、この節でついた収穫でした。
過分散を受け止める:負の二項分布
過分散が見つかったとき、次に渡す先が負の二項分布です。
正直に書くと、この分布は今回いちばん理解が浅かったものでした。教科書には「r回成功するまでの試行回数の分布」と書いてあって、それは覚えていました。しかし実務でどう使うのかを知らず、幾何分布のおまけのような扱いで通り過ぎていました。
実際には、実務での主用途は過分散な件数データのモデル化です。そして驚いたのは、その用途が教科書の定義とはまったく違う導き方から出てくることでした。
先ほど を混ぜたら過分散になりました。あの混ぜ方をきちんと定式化して、 自身がガンマ分布に従ってばらつくとしたときに得られる分布が、負の二項分布なのです。
2つの作り方が同じ分布になることを確かめました(、)。
| 作り方 | 平均 | 分散 |
|---|---|---|
| A:r回成功するまでの失敗回数(, ) | 4.499 | 11.254 |
| B: がガンマ分布に従うポアソン混合 | 4.499 | 11.261 |
| 理論値 | 4.5 | 11.25 |
ここで数え方に注意が必要でした。 負の二項分布には流儀が2つあり、どちらを使うかで平均が変わります。
| 何を数えるか | 平均 | この記事での出番 |
|---|---|---|
| 失敗回数(成功を含めない) | 件数データのモデル化(上の表) | |
| 試行回数(成功を含める) | 「当たるまで何回か」(後述の無記憶性の節) |
上の表と、この後に出てくる は失敗回数のほうの流儀です。一方、後の「幾何分布と負の二項分布」の節で平均100.1回と書いているのは試行回数のほうです。件数を数えたいのか回数を数えたいのかで使い分けている、と読んでください。教科書や関数のドキュメントを読むときも、まずどちらの流儀かを確認するのが安全です(scipy.stats.nbinom は失敗回数、Rの rnbinom も失敗回数です)。
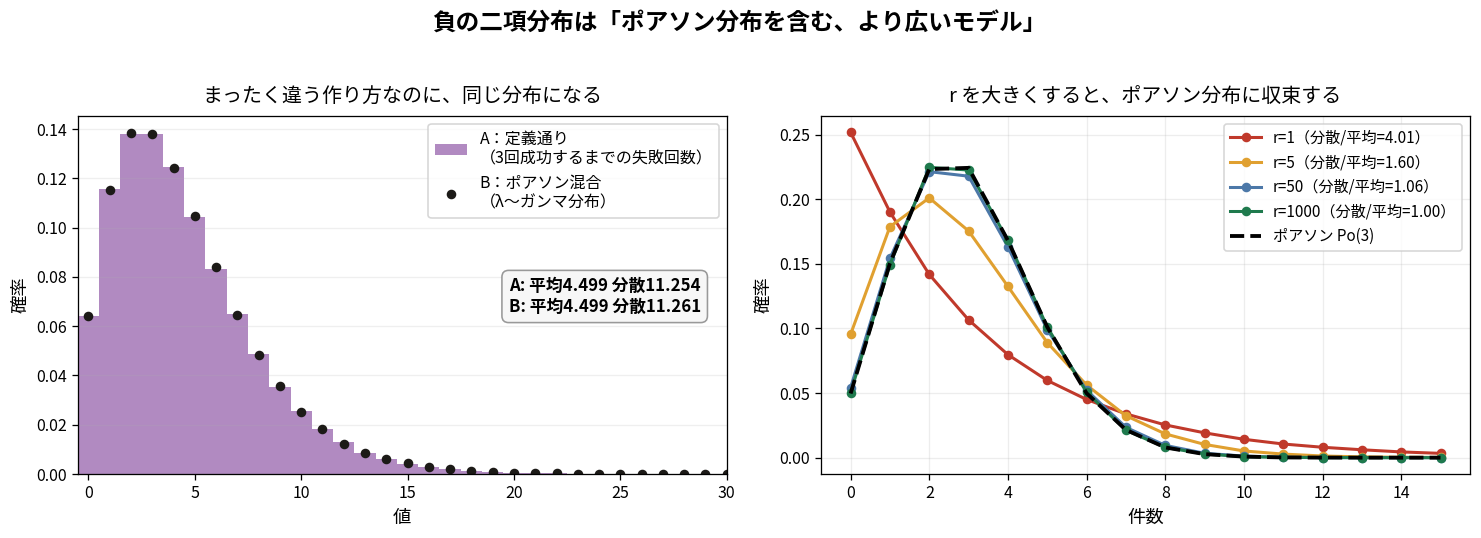
一致しました。「何回で成功するか」という話と「率がばらつく件数」という話が同じ式に着地するのは、今回いちばん意外な点でした。
そして分散と平均の関係がきれいです。
平均を3に固定してrを動かすとこうなります。
| 分散 | 分散/平均 | |
|---|---|---|
| 0.5 | 21.0 | 7.00 |
| 1.0 | 12.0 | 4.00 |
| 10 | 3.9 | 1.30 |
| 100 | 3.09 | 1.03 |
| 1000 | 3.01 | 1.00 |
でポアソン分布に一致します。つまり負の二項分布はポアソン分布を含む、より広いモデルでした。rが「どれくらい過分散か」を表すダイヤルになっていて、回し切るとポアソン分布に戻る。
この関係を知ってから、実務での手順が明確になりました。件数データを見たら、まず平均と分散を比べる。ほぼ等しければポアソン分布で済ませる。分散が大きければ負の二項分布に移る。RでもPythonでも、ポアソン回帰を負の二項回帰に差し替えるのは1行の変更です。モデルが入れ替わるのではなく、ダイヤルが1本増えるだけだと分かると、心理的なハードルが下がりました。
待ち時間を数える:幾何分布
ここまでは「決まった枠のなかで何件起きたか」の話でした。もう一方の系統が「当たるまで何回かかるか」です。
当選確率3%のガチャで考えます。 なので平均は 回です。
ここに、実務でも生活でも効く落とし穴がありました。
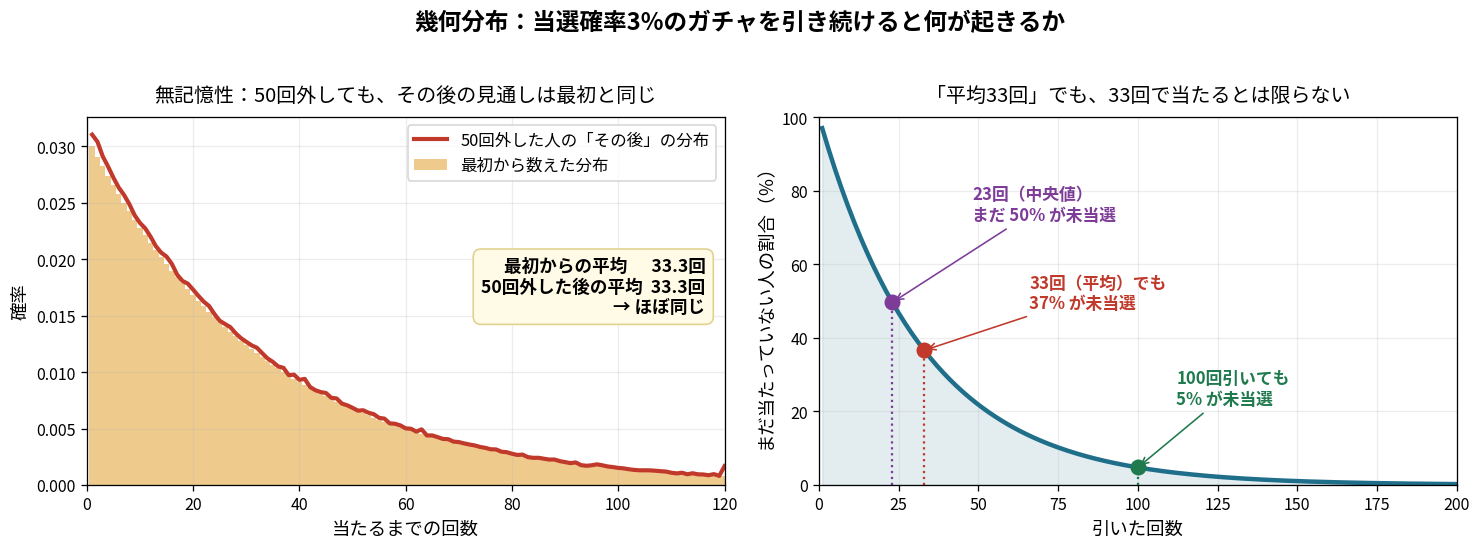
図の右側です。平均は33.3回ですが、33回引いた時点でまだ36.6%の人が当たっていません。 「平均33回」を「33回引けばだいたい当たる」と読むと外します。中央値は23回で、平均よりだいぶ小さい。右に長く裾を引く分布なので、平均が代表値として使いにくいのです。
| 引いた回数 | まだ当たっていない割合 |
|---|---|
| 23回(中央値) | 49.6% |
| 33回(平均) | 36.6% |
| 100回 | 4.8% |
この36.6%が のすぐ近くにいるのが面白いところです。未達成率は なので、 を入れると となり、 でちょうど に収束します。 での厳密な値は、33回時点で36.6%、平均ちょうど(33.33回)なら36.2%。「平均回数を引いても = 約37%の人が未達成」は、pが小さいときの近似として覚えておくと使えます。
無記憶性:50回外しても状況は変わらない
図の左側が無記憶性です。
50回引いて外した人の「その後の必要回数」の分布が、1回も引いていない人の分布とぴったり重なります。 平均も33.3回のまま、最初と同じです。
50回も外したのだから、そろそろ当たりが近い——という感覚は間違っています。各試行が独立なら、過去の失敗は何の情報にもなりません。「天井」や「確定」の仕組みがないガチャは、文字どおり過去を覚えていません。
実務では離脱までの回数などに当てはめます。「5回使ってまだ課金していないユーザーは、次に課金する確率が下がっているのか」を確認したいとき、無記憶なら下がっていないことになります。そして実データが無記憶ではなかったとき、それ自体が発見です。 回数を重ねるほど当たりにくくなる(あるいは当たりやすくなる)なら、独立性が成り立っていない、つまりユーザーの行動に学習や疲労が入っている証拠になります。
幾何分布と負の二項分布:無記憶なのは幾何だけ
負の二項分布は「r回当たるまでの回数」なので、幾何分布(r=1の場合)の一般化です。両方とも独立な試行の繰り返しなので、どちらも無記憶だと私は思っていました。違いました。
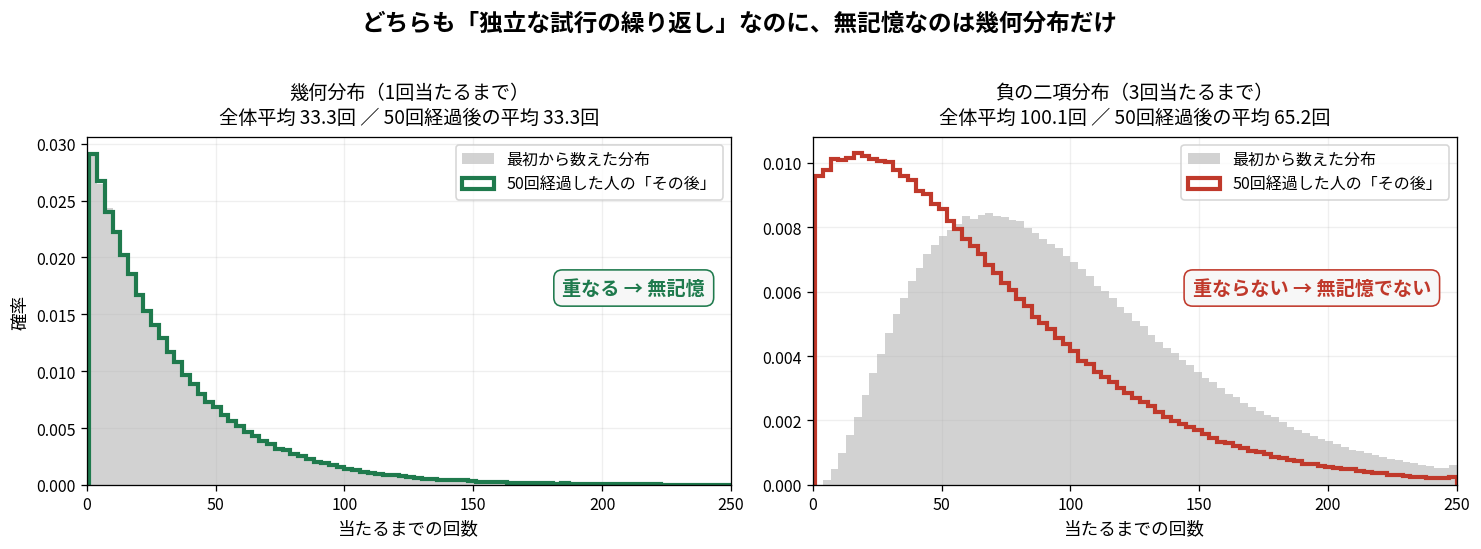
| 分布 | 全体の平均 | 50回経過後の残り平均 | 無記憶か |
|---|---|---|---|
| 幾何分布(1回当たるまで) | 33.3回 | 33.3回 | ○ |
| 負の二項分布(3回当たるまで) | 100.1回 | 65.2回 | ✕ |
負の二項分布では、50回経過すると残りの平均が100.1回から65.2回に縮みます。理由は、50回のあいだに何回当たったかという情報が蓄積されているからです。
| 50回時点の当たり数 | 残りの平均 |
|---|---|
| 0回 | 100.0回 |
| 1回 | 66.6回 |
| 2回 | 33.3回 |
すでに2回当たっているなら、あと1回でいいので残りは33.3回(=幾何分布と同じ)です。つまり負の二項分布は「あと何回必要か」を覚えている。無記憶性が成り立つのは、覚えるべきものが何もない のときだけでした。
離散分布で無記憶なのは幾何分布だけ、連続分布では指数分布だけ——ここは試験でも問われる点だと思います。
分母が有限で、しかも減っていくとき:超幾何分布
最後に、二項分布から別方向に外れるケースです。
二項分布は成功確率pが毎回同じであることを前提にしています。しかし箱から取り出して戻さない(非復元抽出)場合、1回取るごとに残りの構成が変わるのでpが動きます。ここで超幾何分布が必要になります。
とはいえ、母集団が十分に大きければ1個抜いても構成はほぼ変わりません。どこから二項分布で代用してよいのか、実際に測りました。
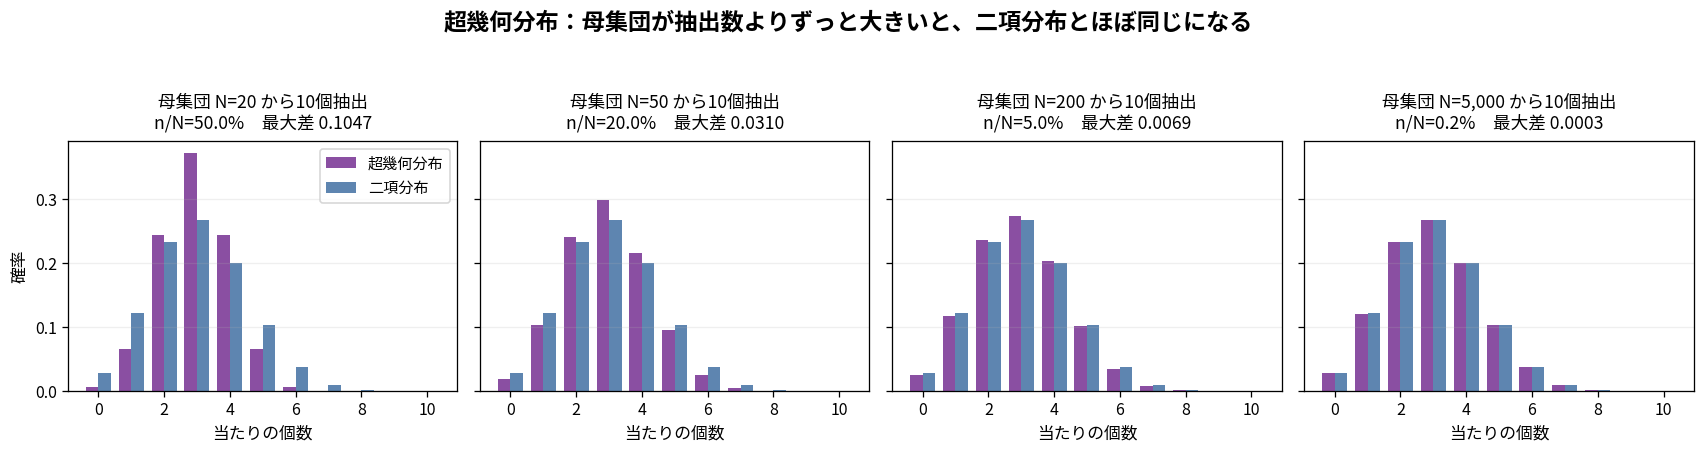
| 母集団N | 抽出n | n/N | 二項分布との最大差 |
|---|---|---|---|
| 20 | 10 | 50% | 0.1047 |
| 50 | 10 | 20% | 0.0310 |
| 200 | 10 | 5% | 0.0069 |
| 5000 | 10 | 0.2% | 0.0003 |
目安として n/Nが5〜10%以下なら二項分布で代用してよいという感覚が得られました。逆にN=20から10個抜くような状況では差が0.10もあるので、超幾何分布を使う必要があります。
実務で該当するのは、監査サンプリングや小さい母集団のアンケートです。数万人のユーザーから1000人抽出するようなWeb系の場面では、ほぼ二項分布で足ります。だから普段あまり出会わないわけで、試験で問われるのに実務で使わない理由も納得できました。
使い分けの正体は「前の分布が使えるか確かめる」流れだった
ここまで整理して、冒頭の困りごとに戻ります。
私は「6つの分布から正しいものを選ぶ」ものだと思っていました。だから選べなかったのです。実際にやることは選択ではなく、単純な仮定から始めて、崩れたところで次に渡すという一方向の流れでした。
- 二項分布で始める。ただし試行回数nが数えられない → ポアソン分布へ
- ポアソン分布を仮定する。ただし分散が平均を大きく超えている → 負の二項分布へ
- 二項分布を仮定する。ただし非復元抽出でn/Nが大きい → 超幾何分布へ
- 件数ではなく「当たるまでの回数」を知りたい → 幾何分布、r回なら負の二項分布へ
この見方だと、覚えるのは公式ではなくチェック項目になります。nは数えられるか。 は本当に1つか。分散は平均と等しいか。抽出は復元か。取り出す割合は小さいか。
そして各分布の期待値・分散の公式は、このチェックを実行するための道具として位置づけられます。「ポアソン分布の分散は 」という事実は、暗記項目ではなく前提が崩れていないか診断するための基準値でした。ここが腹に落ちたのが今回いちばんの成果です。
名前が理解を邪魔していた話
もうひとつ、今回すっきりしたことがあります。この章の分布名は、内容を表していません。
幾何分布が最悪でした。図形の話だと思っていたので、なぜ「当たるまでの回数」に幾何が付くのか意味が分からず、名前を見るたびに引っかかっていました。
答えは、「幾何数列」が「等比数列」の別名だからです(英語の geometric sequence)。
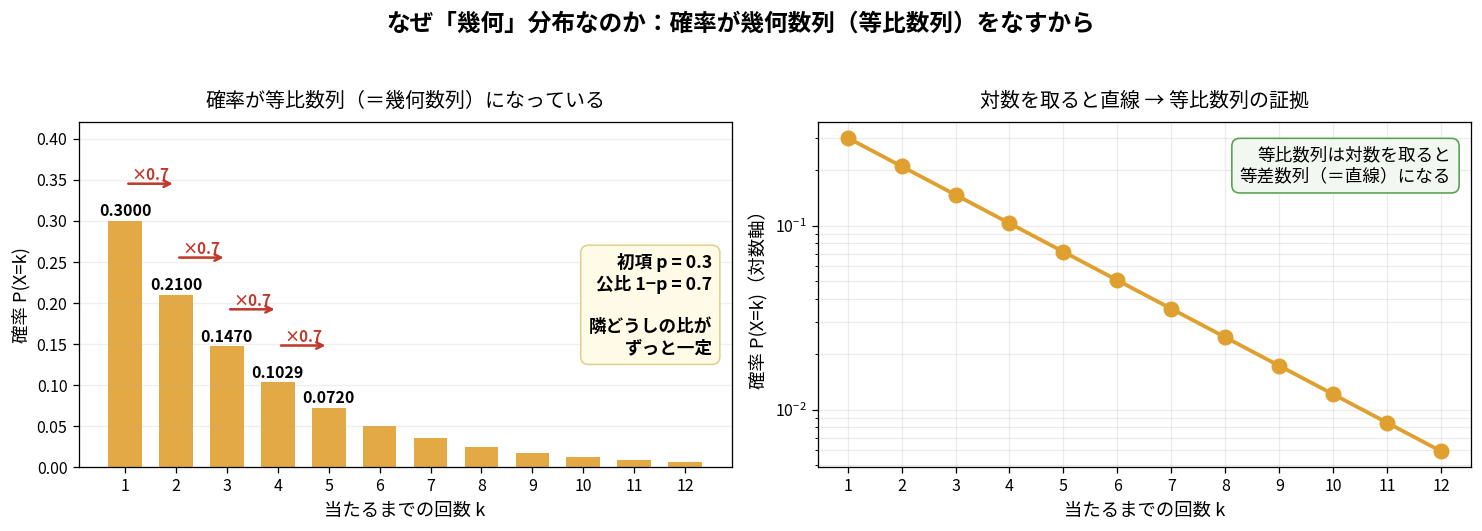
の幾何分布の確率を並べると、0.3000 → 0.2100 → 0.1470 → … と毎回0.7倍になっています。等比数列です。対数を取ると直線になります。図形とはまったく関係がなく、「等比分布」と訳されていれば一発で分かった話でした。ちなみに中国語でも「几何分布」だそうで、同じ誤解が起きていそうです。
なぜ等比数列が geometric なのかは古代ギリシャに遡ります。等差数列(arithmetic)が数を足していく算術的な操作に対応し、等比数列は「正方形の辺を2倍にすると面積が4倍」のような図形的な操作に対応していたから、という経緯でした。
他の名前も内容とずれています。
| 分布 | 名前の由来 | 内容から名づけるなら |
|---|---|---|
| 二項分布 | 式に二項係数が現れるから(「2つの結果」ではない) | 成功回数分布 |
| ポアソン分布 | 人名 | 件数分布 |
| 幾何分布 | 確率が等比(幾何)数列をなすから | 初回成功待ち分布 |
| 負の二項分布 | 展開すると負の指数の二項係数が現れるから(値が負になるのではない) | r回成功待ち分布 |
| 超幾何分布 | 超幾何級数という特殊関数の名前から(内容と無関係) | 非復元抽出分布 |
ポアソン分布は人名です。Siméon Denis Poisson(1781-1840、フランスの数学者)が1837年の著書で発表しました。面白いのは、その研究のテーマが裁判で誤った有罪判決が出る件数だったという点です。アクセス数や障害件数の話ではなく、司法の誤判から生まれた分布でした。poisson はフランス語で「魚」を意味します。
なお1711年にド・モアブルが先に同様の結果を得ていて、「ド・モアブル分布と呼ぶべきだ」と主張する人もいます。発見者の名前が付かない現象はスティグラーの法則と呼ばれていて、その法則自体が先行研究のある名前だというオチまで付いています。
教科書の定番例になっている「馬に蹴られて死亡したプロイセン軍兵士の数」は、1898年にボルトキーヴィチが示したものです。この例が有名になりすぎたせいで、「ポアソン分布=珍しい死亡事故」という印象を持ってしまったのかもしれません。
AIを使ってみた感想
今回AIがいちばん役に立ったのは、「教科書と違う順番で説明してほしい」と頼めたことでした。
第5章は分布ごとに定義・期待値・分散が並ぶカタログ構成です。この順番で読むと、分布どうしの関係が見えません。「実務で最初に判断することから逆算して並べ直してほしい」と頼んだら、冒頭のフローチャートが出てきました。本には載っていない切り口です。
一方で、間違いも見つかりました。自分の誤解が2つ判明しています。
ひとつはポアソン分布を「レアな現象専用」だと思っていたこと。「 が条件なら、1分1200件のアクセスには使えないのでは」と質問したところ、 は導出条件であって適用条件ではない、 は自由に大きくできる、という説明が返ってきました。1人あたりの確率と全体の件数を混同していたわけです。この誤解のせいで、高トラフィックのデータにポアソン分布を使うのを避けていました。
もうひとつは負の二項分布です。教科書の「r回成功するまでの回数」という定義しか知らず、実務での使い道が分かっていませんでした。「過分散な件数データに使う」と言われても最初は繋がらず、 を混ぜるシミュレーションを自分で回して平均4.17・分散16.88という数字を見るまで納得できませんでした。定義から用途は導けない——この章はそれを痛感する回でした。
ただ気をつけている点もあります。AIの説明は流暢なので、聞いた時点で分かった気になりやすい。今回は過分散も無記憶性も自分でコードを書いて数字を出しましたが、それをやらずに読み流していたら、また「知っているつもり」の在庫が増えていたと思います。数字が手元に出てくるまでは理解したことにしない、というのが今回決めたルールです。
この章で押さえること
| 問い | 答え |
|---|---|
| 使い分けの手順 | 単純な分布から始め、前提が崩れたら次に渡す |
| 最初の分岐 | 試行回数nが決まっているか(分母があるか) |
| 二項分布 | 平均 、分散 。分散 < 平均 |
| ポアソン分布 | 平均=分散=。 は大きくてもよい |
| ポアソンの前提 | 独立性・定常性・希少性(希少性は「同時発生しない」の意味) |
| 前提が崩れた兆候 | 分散が平均を超える(過分散)。平均だけ見ても気づけない |
| 負の二項分布 | 。 でポアソンに一致する広いモデル |
| 幾何分布 | 平均 。平均回数でも が未達成 |
| 無記憶性 | 幾何分布だけが持つ(負の二項分布は持たない) |
| 超幾何分布 | n/Nが5〜10%以下なら二項分布で代用可 |
試験と実務での重要度も整理しておきます。
| 分布 | 試験 | 実務 | 主な用途 |
|---|---|---|---|
| 二項分布 | ★★★ | ★★★ | A/Bテスト、CVR、品質検査 |
| ポアソン分布 | ★★★ | ★★★ | アクセス数、障害件数、待ち行列 |
| 幾何分布 | ★★☆ | ★★☆ | ガチャ、離脱までの回数 |
| 負の二項分布 | ★★☆ | ★★☆ | 過分散な件数データ(実務では重要) |
| 多項分布 | ★★☆ | ★★☆ | 多カテゴリの分類、分割表の背景 |
| 超幾何分布 | ★★☆ | ★☆☆ | 小さい母集団からの抽出、監査サンプリング |
負の二項分布は試験での配点はそこまで大きくない印象ですが、実務では頻繁に出番があります。逆に超幾何分布は試験に出るのに実務ではほぼ二項分布で足りる。この非対称性を知っておくと、勉強の力の入れどころが決めやすくなります。
次回
第6回は第6章の前半、連続型分布を予定しています。
指数・ガンマ・正規・対数正規・ベータを扱います。指数分布は今回の幾何分布の連続版なので無記憶性がそのまま出てきますし、ポアソン分布とは「同じ現象を件数で見るか間隔で見るか」の関係になります。今回の分布が別の姿で戻ってくる回です。t分布やカイ二乗分布といった標本分布は、その次の回でまとめて扱います。
この連載は、うまくいった記録だけでなく詰まった箇所も含めて書いています。同じく準1級を目指している方、一度挫折した方の参考になれば嬉しいです。