時系列解析:無関係な2本で77%が「有意」になる見せかけの回帰【第29回】
はじめに
第27章は時系列解析です。発展編の1本目にあたります。
この章に入る前、私が時系列に持っていた認識は「データが時間順に並んでいるだけ」という程度のものでした。並んでいる順番に意味があるなら、それを説明変数にして回帰すればいいのではないか。第16回の重回帰分析の道具がそのまま使えるはずだ、と。
その認識は、最初の実験で崩れました。
互いに一切参照せずに乱数から作った2本の系列を回帰したところ、決定係数 0.891、 値 が出ました。教科書の棄却限界 の14倍です。5000回繰り返すと、5%であるべき棄却率が 76.9% になりました。
さらに気持ち悪いことに、標本サイズを増やすと悪化しました。 で 66.6%、 で 91.2%。第8回の大数の法則は「 を増やせば真実に近づく」と保証していたはずですが、ここではデータを集めるほど強く間違えます。
この現象は見せかけの回帰(spurious regression)と呼ばれるもので、時系列を扱う人が最初に叩き込まれる話でした。
そして私はここで最初の誤解をします。「無関係な2本に相関が生まれてしまう現象」だと思ったのです。しかし違いました。5000回のうち傾きが正だったのは 50.6%、負が 49.4%。傾きの平均は で、正しくゼロを示しています。
まず壊れているのは「その推定値がどれくらい信用できるか」という自己申告でした。標準誤差が 6.22倍 過小に出ていたのです。
ただし後で見るように、推定値の側も無傷ではありません。傾きが正しいのは「平均としては」だけで、1本1本は の幅でブレます。しかもこの幅は を増やしても縮みません。
この記事は、その一点を掘り下げた記録です。回帰の話から入ると分かりにくかったので、いったん標本平均という中学レベルの計算まで降りて、 のデータを手で追うところからやり直しました。そこで見えたのは、 の が「 個ぶんの独立な情報がある」という主張だったという事実でした。
定常性が必要な理由も、そこから逆算できます。そして ACF と PACF が AR と MA を見分けられる理由、差分を取るべきなのが のときだけである理由も、同じ筋で繋がりました。
いつものように、出てくる数値はすべて自分で計算し、理論値と突き合わせています。そして最後に自己診断を8問やって、2問間違えました。 その内容も含めて書いています。
この回で扱う用語
| 用語 | 読み・意味 |
|---|---|
| 定常性 | Stationarity。平均・分散・自己共分散が時刻によらないこと |
| 弱定常 | Weak Stationarity。2次モーメントまでが時刻によらない(本記事の「定常」はこれ) |
| ホワイトノイズ | White Noise。平均0・分散一定・無相関な系列。時系列の「何も起きていない」状態 |
| 自己相関 | Autocorrelation。同じ系列の 期前との相関 |
| ACF | AutoCorrelation Function=自己相関関数。ラグ に対する自己相関を並べた関数 |
| PACF | Partial AutoCorrelation Function=偏自己相関関数。間の期の影響を除いた自己相関 |
| コレログラム | Correlogram。ACF・PACF を棒グラフにした図 |
| AR モデル | AutoRegressive=自己回帰モデル。過去の自分の値で現在を説明する |
| MA モデル | Moving Average=移動平均モデル。過去のノイズの加重和で現在を表す |
| ARMA モデル | AR と MA を両方持つモデル |
| ARIMA モデル | AutoRegressive Integrated Moving Average。差分を取ってから ARMA を当てる |
| 単位根 | Unit Root。 の状態。差分を取らないと定常にならない |
| 反転可能性 | Invertibility。MA を AR() に書き換えられる条件()。AR の定常条件と対になる |
| ランダムウォーク | Random Walk。。単位根過程の代表 |
| 見せかけの回帰 | Spurious Regression。無関係な非定常系列間で有意な回帰が出る現象 |
| ラグ演算子 | Lag Operator。 と書く記号 |
| DF 検定 | Dickey-Fuller 検定。単位根の有無を検定する |
| ADF 検定 | Augmented Dickey-Fuller 検定。DF にラグ項を加えたもの |
| 過剰差分 | Over-differencing。必要でないのに差分を取ること |
| 共和分 | Cointegration。個々は単位根だが線形結合が定常になる関係 |
| Ljung-Box 検定 | 残差の自己相関をまとめて検定する(モデルの十分性の確認) |
| SARIMA | Seasonal ARIMA。季節成分を持つ ARIMA |
用語が多いですが、核になるのは「定常性」の1つだけです。他は全部その周りに配置されています。
1. まず壊れるところを見る
1-1. 完全に無関係な2本から が出る
やったことは単純です。標準正規乱数を100個作って累積和を取る。これを2回、互いに一切参照せずに行います。
import numpy as np
rng = np.random.default_rng()

x = np.cumsum(rng.normal(size=100))   # ランダムウォーク1
y = np.cumsum(rng.normal(size=100))   # ランダムウォーク2
# x と y は定義上まったく無関係
以下の図は、この操作を何度か試して が大きく出た組を選んで描いています。ただし節1-2 で見るように、これは特殊な例ではありません。
累積和なので、これは第23回で扱ったランダムウォークそのものです。 を展開すると 、つまりホワイトノイズの累積和になります。
この2本を単回帰にかけます。
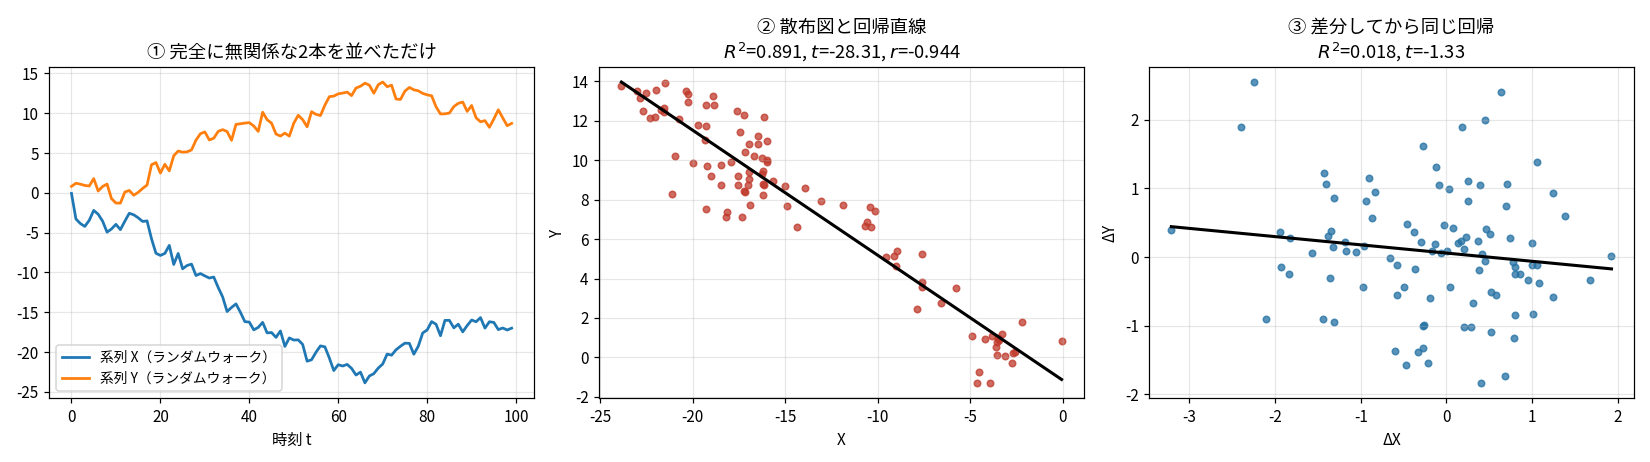
決定係数 0.891、 値 、相関係数 。
左のパネルを見ると、青が下に流れ、橙が上に流れています。ランダムウォークは「一度ずれたら戻る力がない」ので、各系列がそれぞれ勝手にどこかへ漂います。すると2本の間に「一方が上がる期間に他方が下がった」という長い区間が生まれ、回帰はそれを「関係」として拾います。
右のパネルは、同じデータを1階差分してから同じ回帰をかけたものです。 が 0.018 に落ち、 値も に収まります。
1-2. たまたまではない。分布そのものが違う
上の1組は「たまたま強く出た例を選んだ」のではないか、と疑うのが自然です。5000回繰り返しました。
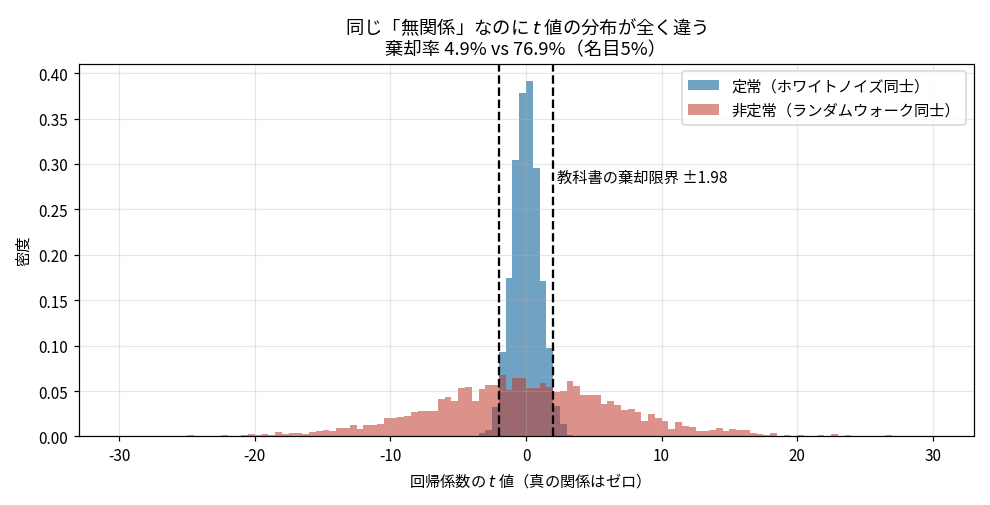
| 状況 | 5%有意で棄却した割合 (正しければ5%) | 平均 | の95%点 |
|---|---|---|---|
| 定常(ホワイトノイズ同士) | 5.2% | 0.010 | 1.99 |
| 非定常(ランダムウォーク同士) | 76.9% | 0.241 | 14.80 |
| 非定常だが差分してから回帰 | 5.4% | — | — |
非定常な場合、 が 0.5 を超えたケースが 16.4% ありました。「決定係数が高いから良いモデル」がまったく通用しません。
青(定常)は棄却限界 の内側にきちんと収まりますが、赤(非定常)は まで平然と出ます。 分布に従っていないので、 分布の表を引いた判定が意味を持ちません。
1-3. データを増やすと悪化する
ここが一番気持ち悪いところです。
| 標本サイズ | 棄却率(名目5%) | の中央値 |
|---|---|---|
| 50 | 66.6% | 3.12 |
| 100 | 76.9% | 4.50 |
| 250 | 84.9% | 7.03 |
| 500 | 88.6% | 10.51 |
| 1000 | 91.2% | 14.87 |
の中央値が 3.12 → 4.50 → 7.03 → 10.51 → 14.87 と育っています。おおよそ のペースです。
通常の統計では、データを増やせば真実に近づくのが救いでした。第8回の大数の法則がそれを保証し、第10回では精度が で改善すると確認しました。
ところが非定常データでは、無関係であるという事実は変わらないまま、確信度だけが無限に上がっていきます。 「10年分のデータで検証しました」と言う人が一番強く間違えます。
1-4. 正規分布は関係ない
私が最初に立てた仮説はこうでした。「ホワイトノイズは正規分布に従うから平均すると真ん中に寄る。ランダムウォークはどちらかに発散するから、長い目で見た相関が出やすい」。
前半は的を射ていましたが、正規分布という部分は完全に無関係でした。ノイズの分布を4通りに変えて確かめます。
| ノイズ の分布 | 定常(そのまま) | 非定常(累積和) |
|---|---|---|
| 正規分布 | 4.7% | 76.9% |
| コイン投げ( の2値だけ) | 5.9% | 75.8% |
| (裾がとても重い) | 5.1% | 75.2% |
| 一様分布(山がなく平ら) | 5.7% | 76.2% |
4つとも同じ結果です。 コイン投げのように しか出ないノイズでも、山のない一様分布でも、累積和にした瞬間に 76% 壊れます。
効いているのは分布の形ではなく「累積和にした」という構造だけでした。
1-5. 「線形に見えるから」でもない
次に私が考えたのは「 なら だから、系列が線形に近い見え方になる。だからそれ同士の散布図も線形っぽくなるのではないか」という説明でした。
これも違いました。散布図を8組並べます。
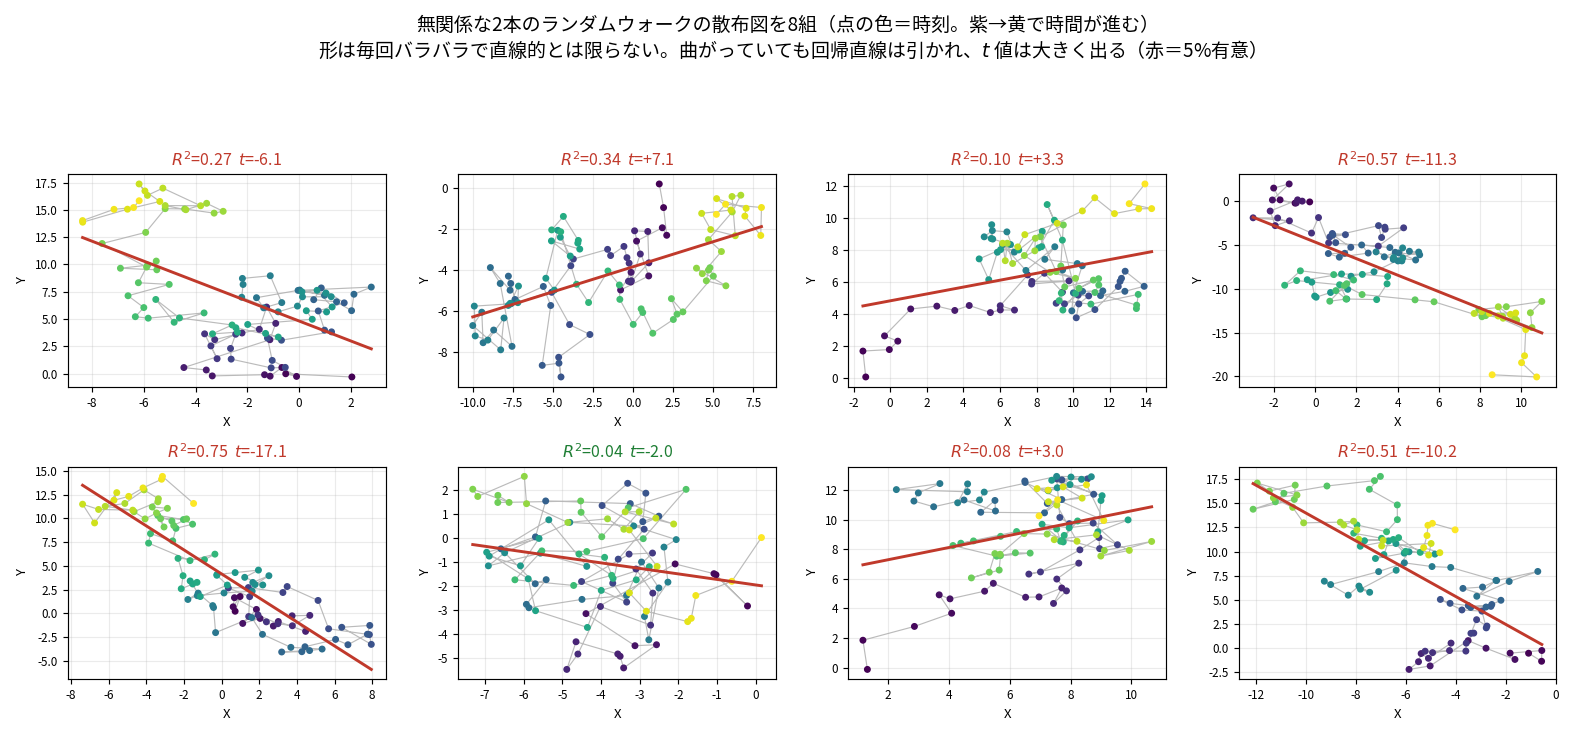
直線的なのは一部だけです。L字型、塊が2つに分かれた形、折れ曲がった形が混じります。それでも8枚中7枚が5%有意。上段左は明らかに直線から外れているのに です。
そして決定的な数字があります。5000回集計すると、傾きが正だったのが 50.6%、負が 49.4%。有意になったケースだけを見ても正 50.6% / 負 49.4%。
符号は毎回コイン投げです。 「両方が線形なトレンドを持つから一緒に動いて見える」という説明だと「同じ向きに動きやすい」はずですが、向きは完全にランダムでした。
つまり累積和は直線にはなりません。 の符号がランダムなので折れ曲がります。
2. 原因は標準誤差の過小申告
2-1. 分子は無事で、分母が壊れている
ここから本題です。 値は「推定値 ÷ 標準誤差」です。そして先に見たように、傾きの平均は でゼロ、つまり傾きは平均としては正しく「関係なし」を示しています。
まず壊れているのは分母でした。(推定値の側も「平均は正しいが1本1本はブレる」という別の問題を抱えています。それは節2-7で扱います。)
回帰の話は変数が2つあって追いにくいので、いったん標本平均という最も単純な設定まで降ります。
やることは中学レベルです。データを10個取って平均を出し、95%信頼区間を作る。真の平均は0だと分かっているので、区間が0を含めば成功です。
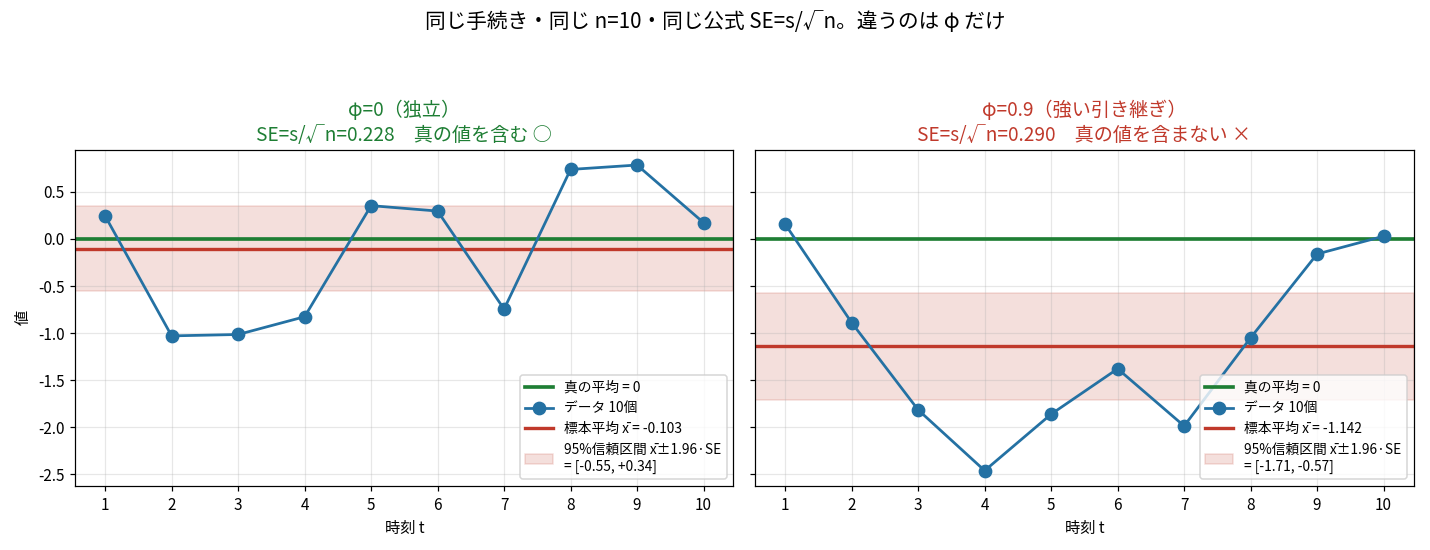
右側(、つまり前の値を0.9倍引き継ぐ系列)の計算を追ってください。
データ: +0.16 -0.89 -1.82 -2.46 -1.86 -1.38 -1.99 -1.05 -0.16 +0.03
標本平均 x̄ = -1.142
標本SD    s  = 0.917
標準誤差 SE = s/√n = 0.917 / 3.162 = 0.290
95%信頼区間 = -1.142 ± 1.96 × 0.290 = [-1.710, -0.573]
→ 真の値 0 を含まない(外れた)
左側(、独立なデータ)は同じ手続きで 、ちゃんと0を含みます。
使った公式は左右まったく同じ です。 式の計算にも間違いはありません。
つまり、公式そのものがこの状況では成り立っていないのです。
2-2. は「隣同士が似ているか」を見ていない
なぜ成り立たないのか。 が何を測っているかを図にします。
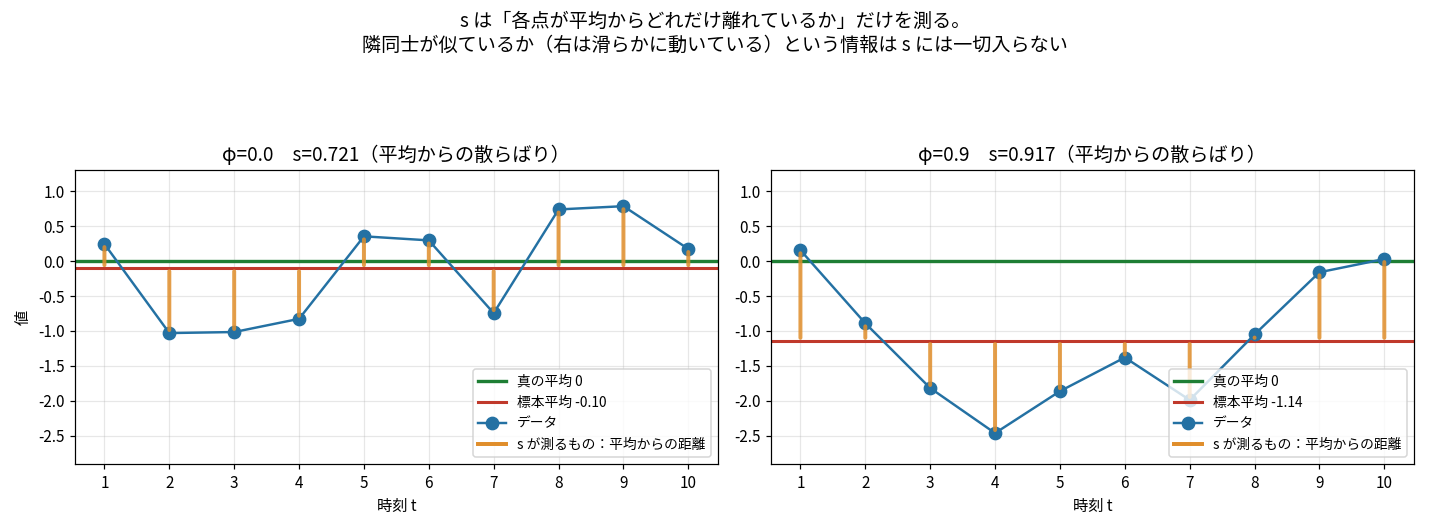
橙の縦線が が測っているもの、つまり各点から標本平均までの距離です。
ここで気づいてほしいのは、右の (0.917)は左の (0.721)より大きいということ。それでも右は的を外しました。
図の右を見ると、データが滑らかに繋がって動いています。 の次が 、その次が 。隣同士が似ている。ところが は「点が平均からどれだけ散らばっているか」しか計算しないので、この滑らかさは に一切入りません。
は10個をシャッフルしても同じ値になります。並び順の情報を捨てているのです。
2-3. は「 個ぶんの独立な情報がある」という主張だった
ここが核心です。第8回で を導いたとき、何が起きていたか。
共分散の項がゼロになるから で割れました。
時系列では隣同士に共分散があるので、この項が残ります。 なら隣の相関が0.9、2つ隣が0.81、3つ隣が0.729と、正の共分散がずらりと並びます。合計は よりずっと大きくなります。
つまり で割るのは「 個ぶんの独立な情報がある」という主張なのです。
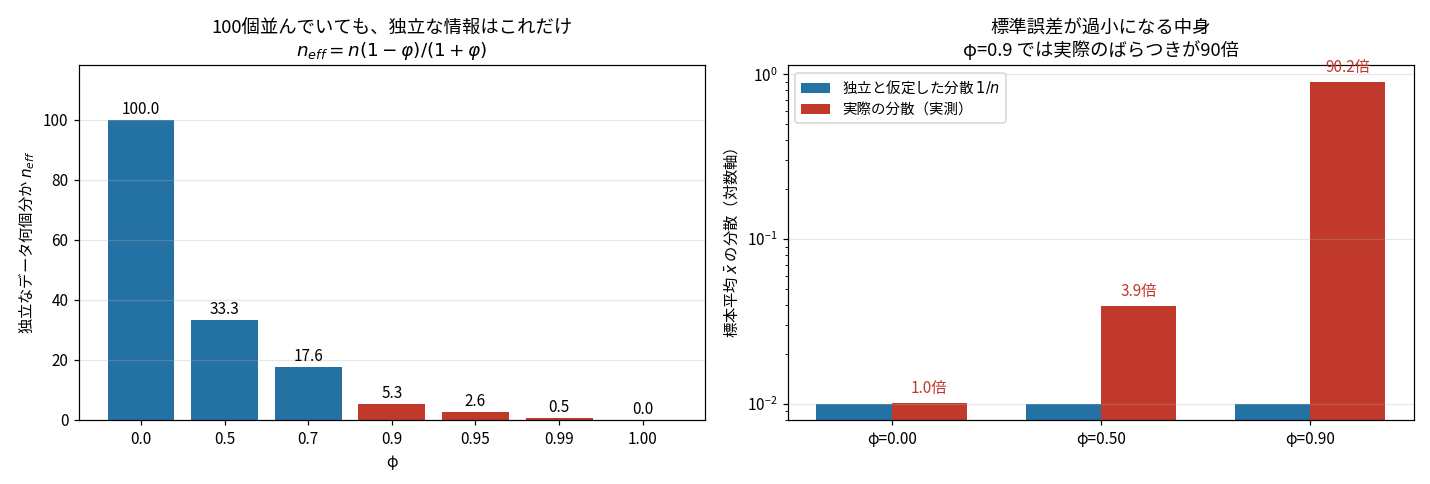
有効標本サイズ で測ると、 のとき100個が実質 5.3個分。 ではこの式は 0 になります(厳密には の式は定常性を前提に導かれているので は適用域外です。実際には が に比例して増えるので、集めるほど悪くなります。節1-3 で「 を増やすと棄却率が上がる」と見たのは、この現象の回帰版です)。
そして右の図がその帰結です。標本平均の分散を実測すると、 で 。ホワイトノイズ()の と比べて 90.2倍でした( の厳密値 0.905 とぴったり一致。漸近値 には ではまだ届いていません)。
ただし「何と比べるか」に注意が必要です。90.2倍はホワイトノイズとの比で、公式が実際に使う分母は です。 自体も大きくなる( では )ので、公式の過小度は分散で約21倍、標準誤差で 4.59倍になります。この 4.59倍が後の表に出てくる数字です。
2-4. 「1本しか観測できない」という宿命
なぜ標本平均がずれるのか、20本の系列を重ねて見ます。
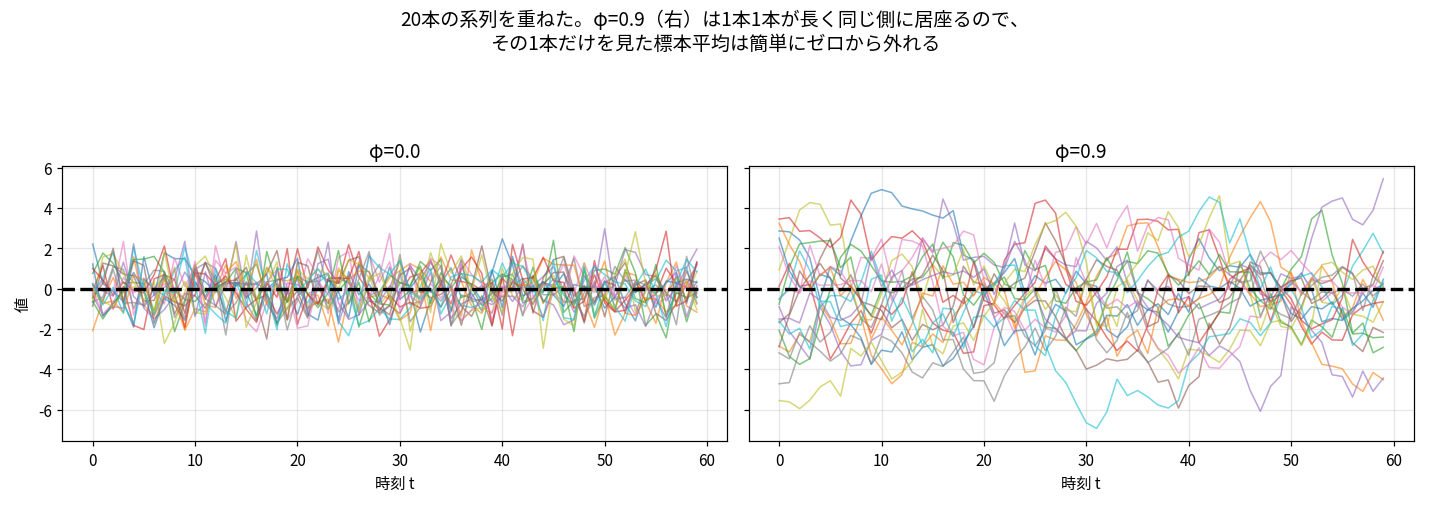
左()は20本がほぼ の帯に収まるので、どの1本を取っても平均はほぼ0になります。
右()は1本1本が長く同じ側に居座ります。たまたま下側に居た系列を観測すれば、標本平均は簡単に や になる。
そして時系列では観測できるのは1本だけです。その1本が偏っていても、 からは気づけません。
2-5. 「95%」が実際に何%なのか数える
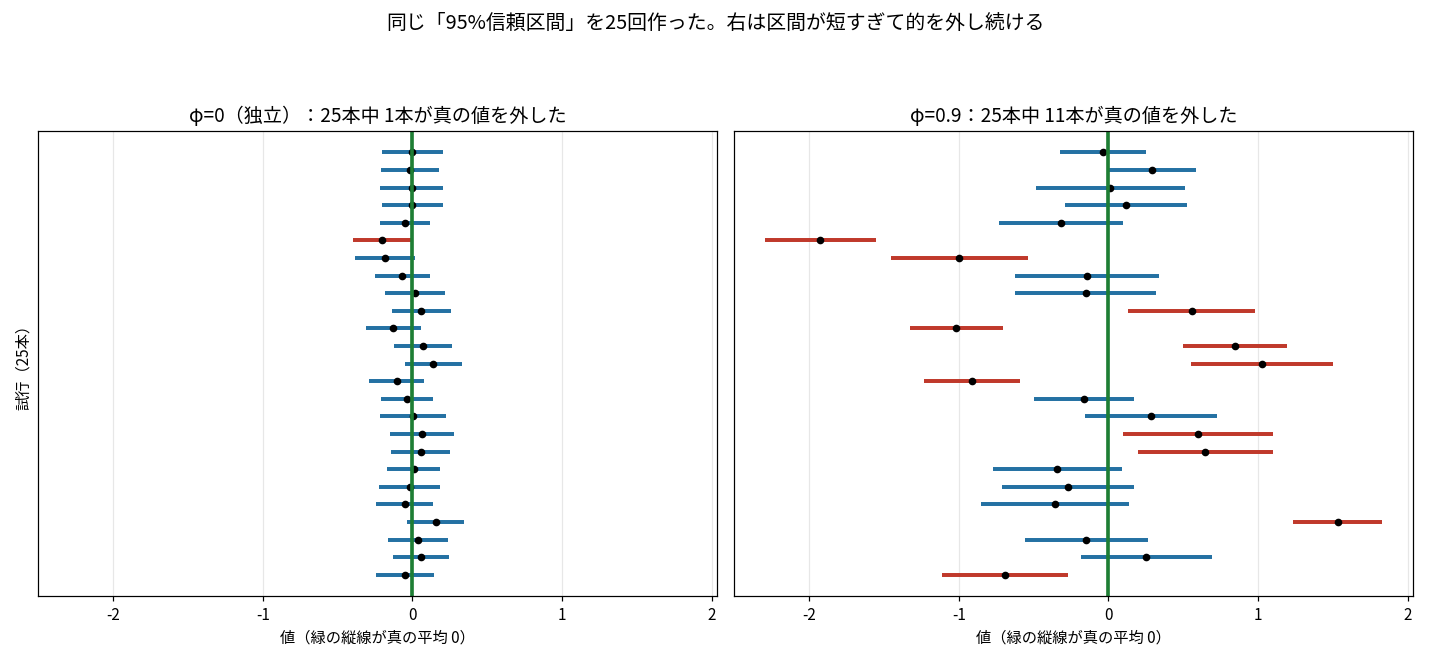
同じ手続きで95%信頼区間を25回作りました()。緑の縦線が真の値0。左は25本中1本だけ外れ(ほぼ理論通り)、右は 11本が外れています。
右の区間は左の2倍ほどしか長くなっていないのに、中心(黒丸)の散らばりは 9.5倍です(0.0998 → 0.9453)。区間の長さが中心の散らばりに追いついていない、これが「標準誤差が過小」の見た目です。
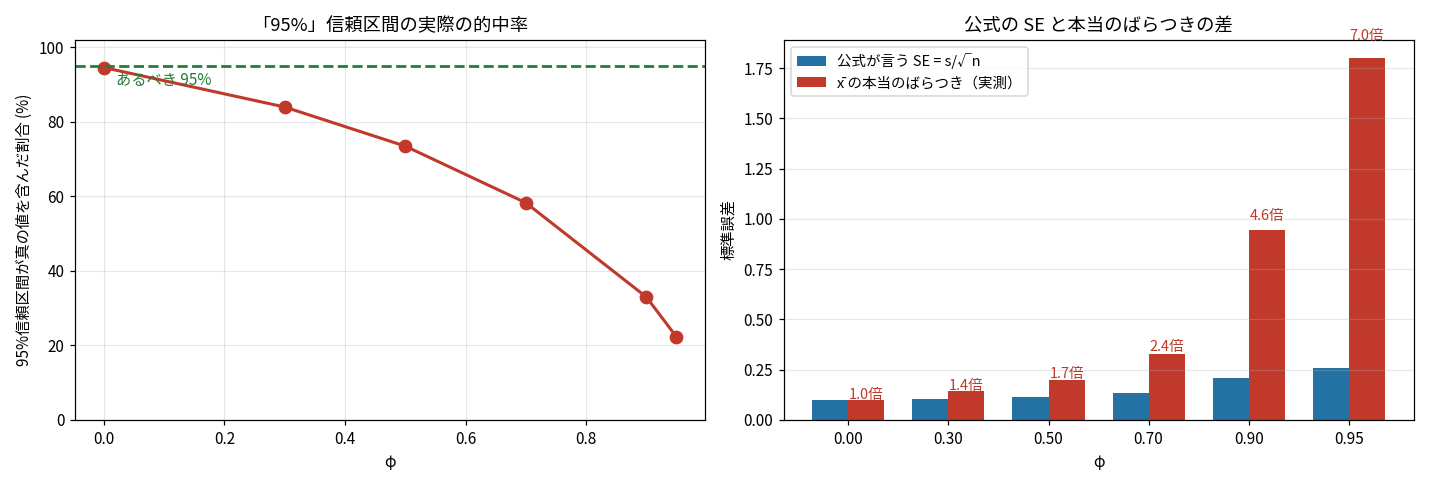
| 被覆率 (あるべき95%) | 公式の | の本当のばらつき (20000回の実測SD) | 公式は何倍 過小か | |
|---|---|---|---|---|
| 0.00 | 94.6% | 0.0998 | 0.1008 | 1.01 倍 |
| 0.30 | 84.0% | 0.1041 | 0.1439 | 1.38 倍 |
| 0.50 | 73.5% | 0.1138 | 0.1985 | 1.74 倍 |
| 0.70 | 58.3% | 0.1361 | 0.3285 | 2.41 倍 |
| 0.90 | 33.0% | 0.2061 | 0.9453 | 4.59 倍 |
| 0.95 | 22.3% | 0.2576 | 1.7996 | 6.99 倍 |
では「95%信頼区間」が3回に1回しか当たりません。
2-6. 橋渡し:回帰の傾きも同じ構造
ここで回帰に戻ります。平均と回帰は別物に見えますが、標準誤差の公式が同じ仮定に乗っています。
| 標本平均 | 回帰の傾き | |
|---|---|---|
| 推定値の中身 | データの加重和(重みは全部 ) | データの加重和(重みは ) |
| ばらつきの計算 | ||
| 公式が使う仮定 | 共分散の項=0(独立) | 共分散の項=0(誤差が独立) |
| 時系列で起きること | 隣同士が似ていて共分散が残る | 同じ。残差が滑らかに繋がって共分散が残る |
第17回で学んだ最小二乗法の4つの仮定のうち、独立性がこの共分散の項をゼロにするために置かれていました。平均のときの と、回帰のときの は、同じ仮定から出てきた同じ性質の数字です。
目で見える証拠が残差です。
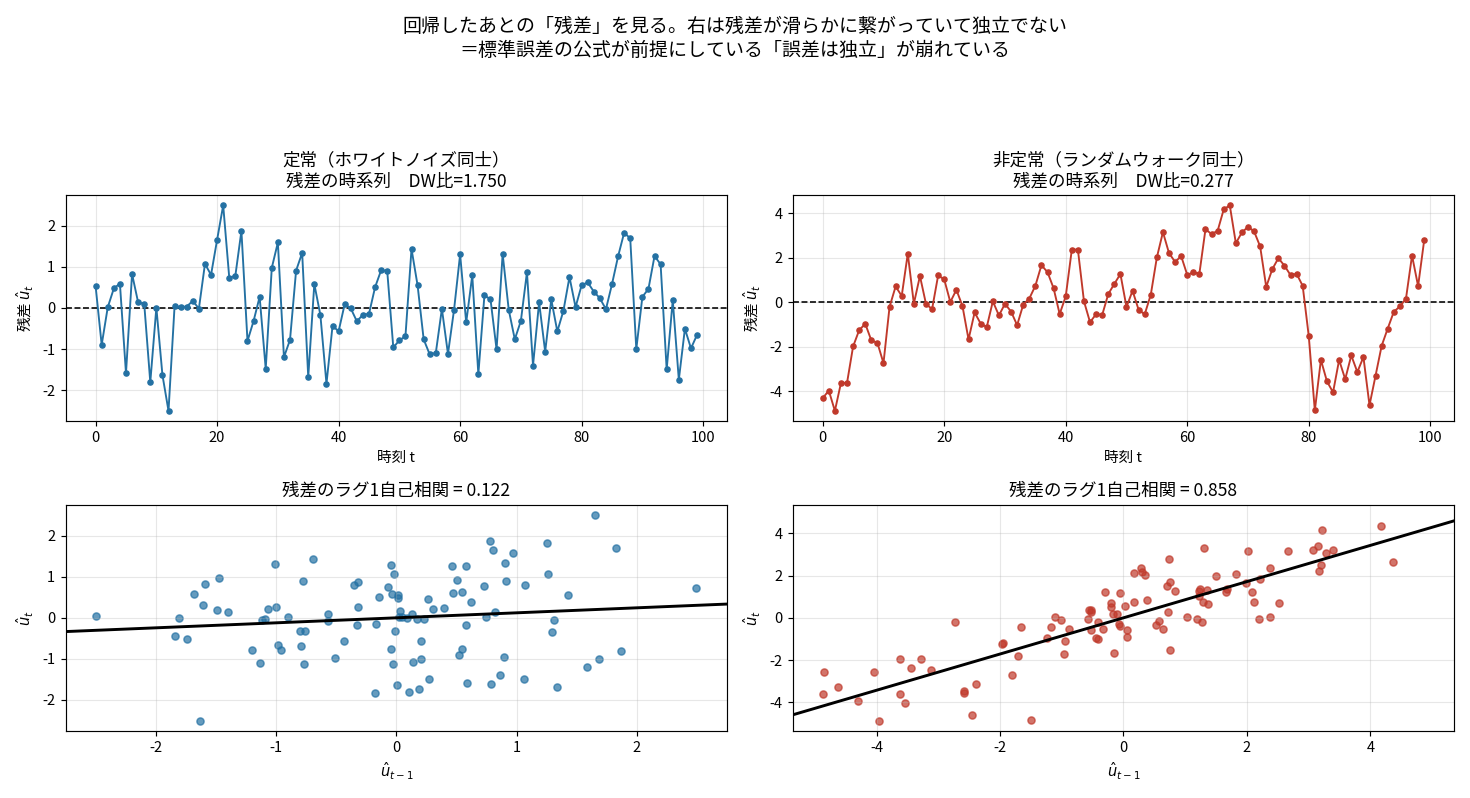
| 残差の自己相関 ラグ1 / 2 / 3 / 4 / 5 | ダービン・ワトソン比 (独立なら約2.0) | |
|---|---|---|
| 定常(この1組) | 0.122 / 0.075 / 0.161 / 0.044 / 0.026 | 1.750 |
| 非定常(この1組) | 0.858 / 0.765 / 0.663 / 0.571 / 0.516 | 0.277 |
| 非定常(5000回の平均) | — | 0.171 |
平均のときに「データの隣同士が似ている」と言ったのと同じことが、回帰では「残差の隣同士が似ている」として現れます。
そして第17回のダービン・ワトソン比への答えがここにあります。DW比の平均が 0.171。あのとき「2から離れたら誤差の自己相関を疑え」と学んだ、その最も極端な症例が単位根でした。同じ話の程度が違う版であって、別の話ではありません。
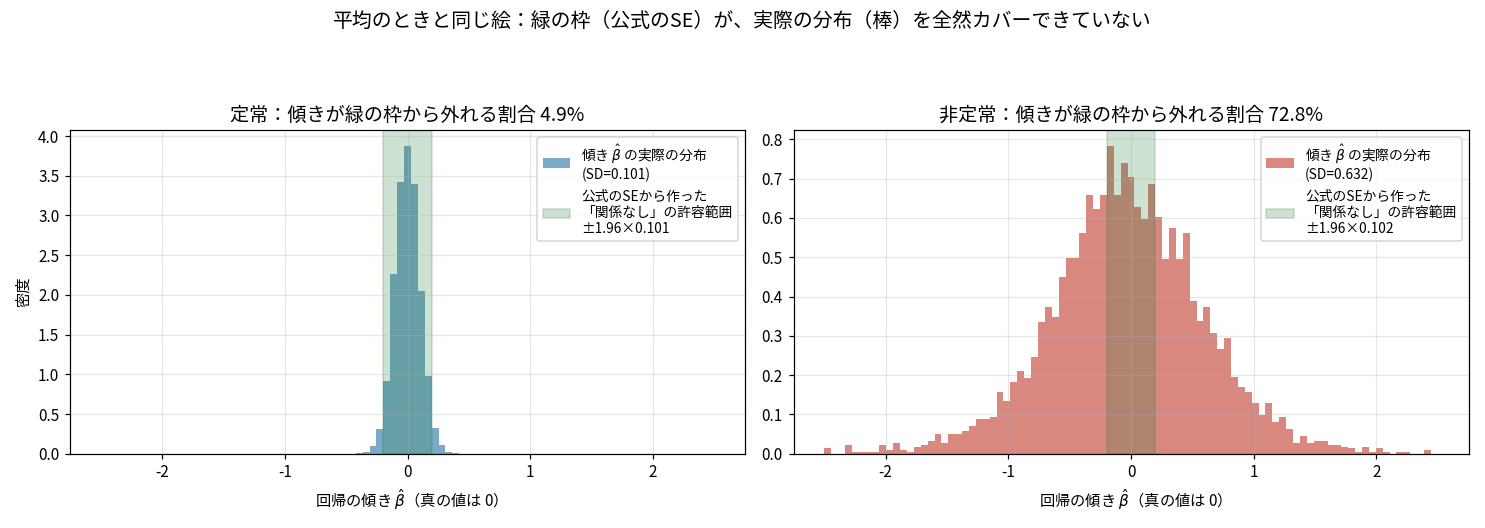
| 傾きの平均 (真の値0) | 公式が言う | 傾きの本当のばらつき (実測SD) | 公式は何倍 過小か | 残差のDW比 | |
|---|---|---|---|---|---|
| 定常 | 0.1010 | 0.1017 | 1.01 倍 | 2.001 | |
| 非定常 | 0.1028 | 0.6398 | 6.22 倍 | 0.171 |
棒が傾きの実際の分布、緑の帯が公式の から作った許容範囲 です。緑の帯の幅は左右でほぼ同じ(0.101 と 0.103)なのに、右の分布は6倍以上広い。だから 72.8% がはみ出します。
傾きは実際 の幅でブレるのに、公式は「 しかブレないはず」と言う。だから 0.3 という平凡なブレが「、有意」に化けます。
2-7. 標準誤差を直せば済む話ではない
「では自己相関に対応した標準誤差を使えばいいのでは」と考えるのが自然です。Newey-West(HAC=Heteroskedasticity and Autocorrelation Consistent、不均一分散・自己相関に頑健な標準誤差)を自作して試しました。
| 標準誤差の計算方法 | 棄却率(名目5%) | 平均 | 傾きの実測SD |
|---|---|---|---|
| 通常の最小二乗法の | 75.0%(別の乱数列で再実行したもの) | 0.103 | 0.607 |
| Newey-West | 58.7% | 0.171 | 0.607 |
| 差分してから通常の回帰 | 5.4% | — | — |
の直し方では足りません。 75.0% → 58.7% と改善はしますが、まだ全然ダメです。
理由は、単位根がある場合傾きの分布そのものが「 を増やすと縮む」という性質を失っているためです。実測しました。
| 標本サイズ | 傾き の実測SD | 独立なら で |
|---|---|---|
| 100 | 0.627 | 0.100 |
| 250 | 0.640 | 0.063 |
| 500 | 0.633 | 0.045 |
| 1000 | 0.616 | 0.032 |
| 2000 | 0.610 | 0.022 |
を20倍にしても 0.63 のままです。 通常の回帰なら のペースで縮むはずのものが、まったく縮みません。
つまり は一致推定量ですらありません。「傾きは正しい」と書きましたが、正確には平均としては正しいだけで、1本の系列しか観測できない立場からすると でブレる無意味な数字です。だから をどう直しても 分布には戻りません。
だからモデルを直すしかない。 それが差分であり、ARIMA の I(Integrated=和分)が存在する理由です。
3. AR(1) と「戻る力」
3-1. ホワイトノイズとランダムウォークは同じ式の両端
ここまで「定常」と「非定常」を対比してきましたが、この2つは別種の生き物ではありません。同じ式の両端です。
これが AR(1) モデルです。AR は AutoRegressive(自己回帰)の略で、括弧の1は「何期前まで参照するか」。自分の過去で自分を回帰するという意味です。 はホワイトノイズです。
なら 、つまりホワイトノイズ。 なら 、つまりランダムウォーク。
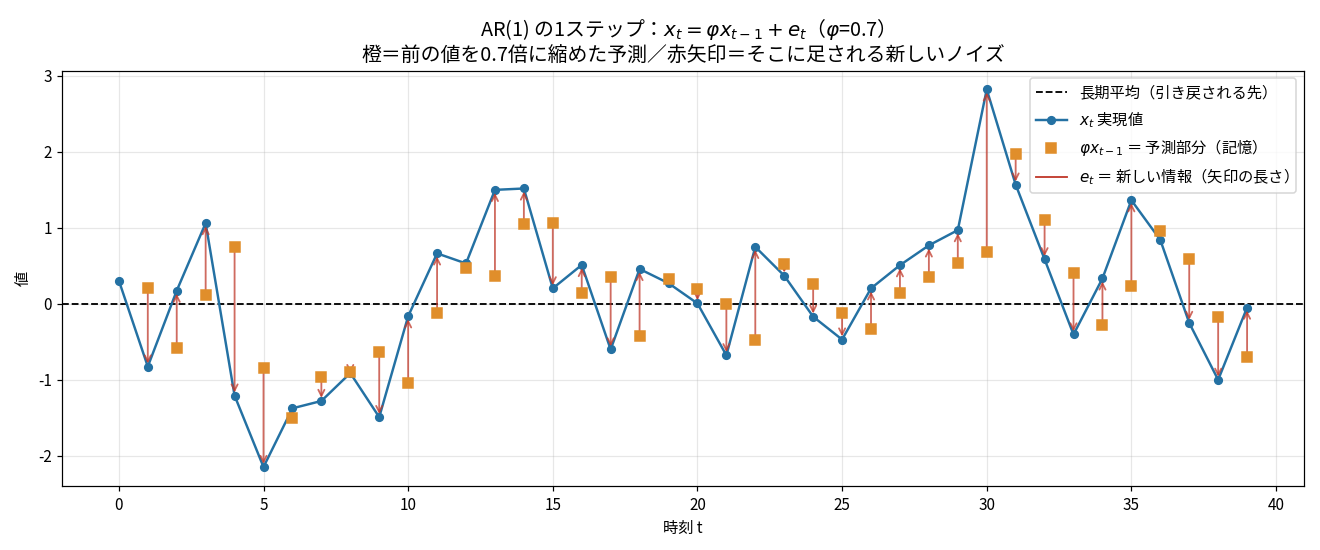
1ステップを2つに分けた図です。
- 橙の四角 = … 前の値を0.7倍に縮めた「予測できる部分」。過去から分かっている
- 赤い矢印 = … その時刻に初めて入る「新しい情報」
青い実現値は必ず「橙 + 赤矢印」です。橙が常にゼロの破線側に寄っている(前の値より原点に近い)のが「引き戻し」の実体です。
なお AR(2) なら で2期前まで見ます。
3-2. を動かすと何が変わるか
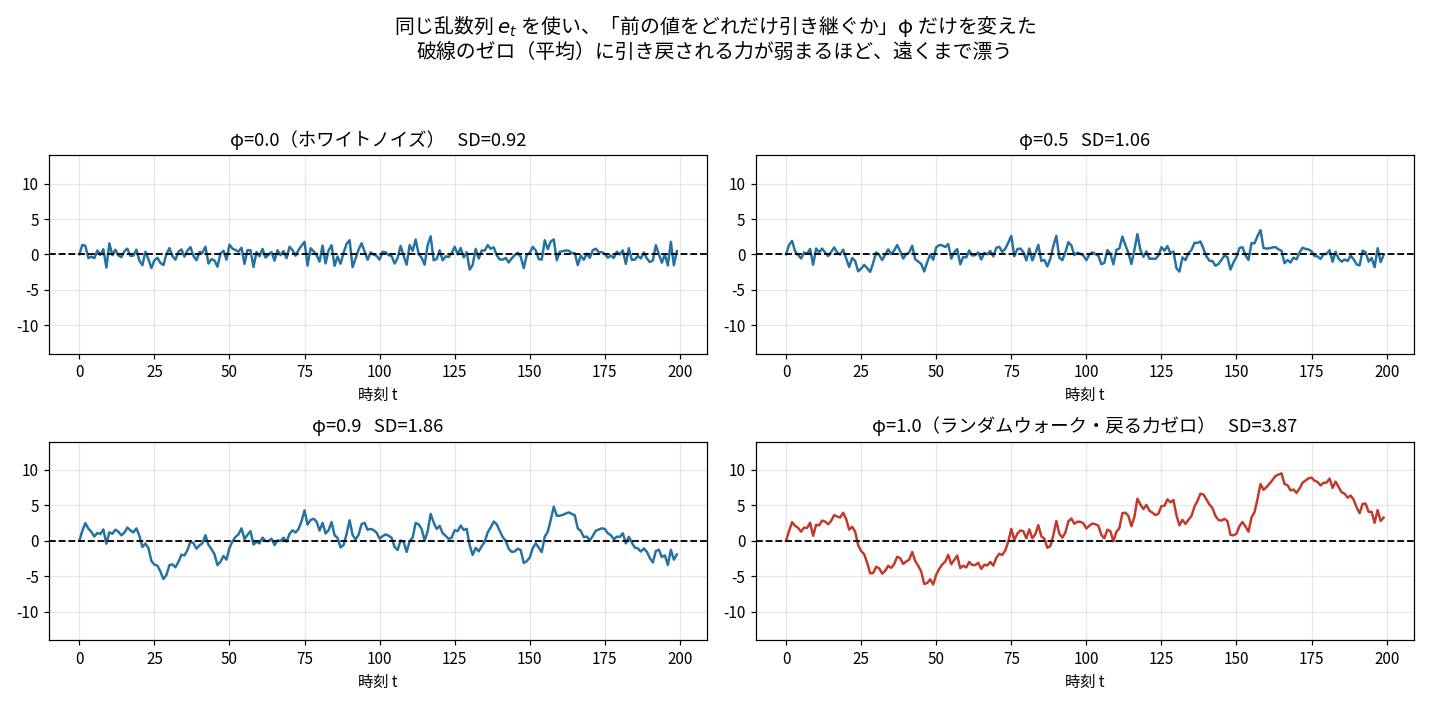
4枚すべて同じ乱数列 を使っています。 違うのは だけ。(左上)はゼロの破線に毎回引き戻され、(右下)は一度離れると戻ってこない。標準偏差が 0.92 → 1.06 → 1.86 → 3.87 と育っていきます。
「戻る力」の正体を見ます。
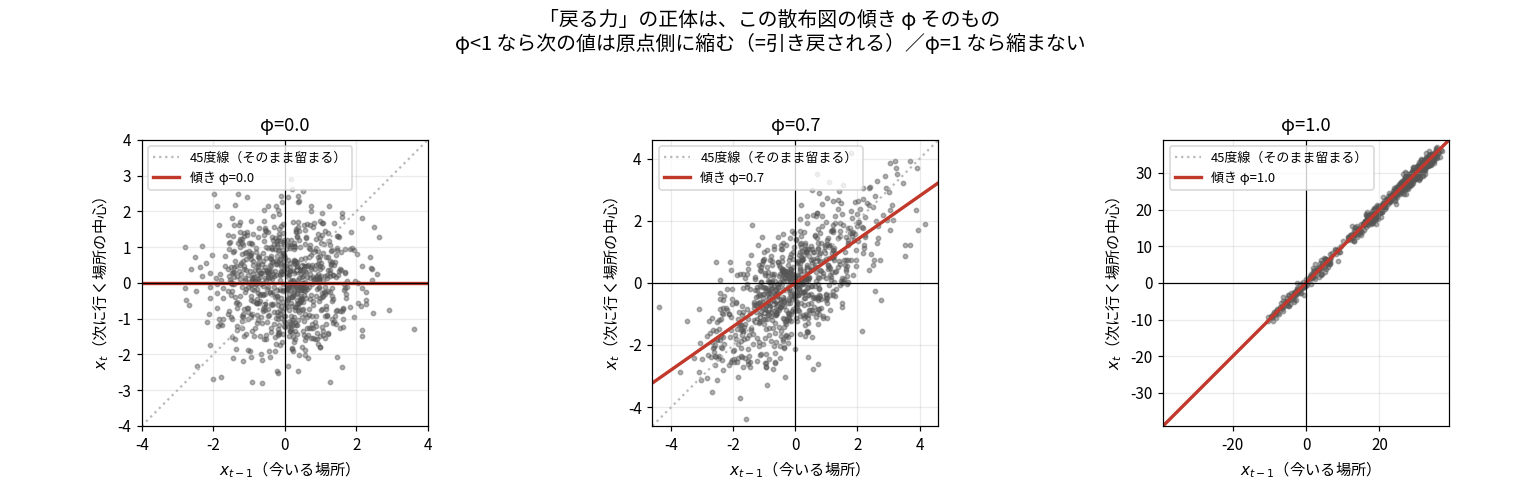
灰色の点線が45度線、つまり「今いる場所にそのまま留まる」線です。
- :赤い線が45度線より寝ている。今 にいると、次の中心は 。原点側に0.7倍縮む。これが引き戻し
- :赤線が45度線とぴったり重なる。縮みがゼロ。今いる場所がそのまま新しい中心になる
ランダムウォークが漂うのは正規分布のせいではなく、この45度線と重なっていることのせいでした。
3-3. 崖ではなく坂
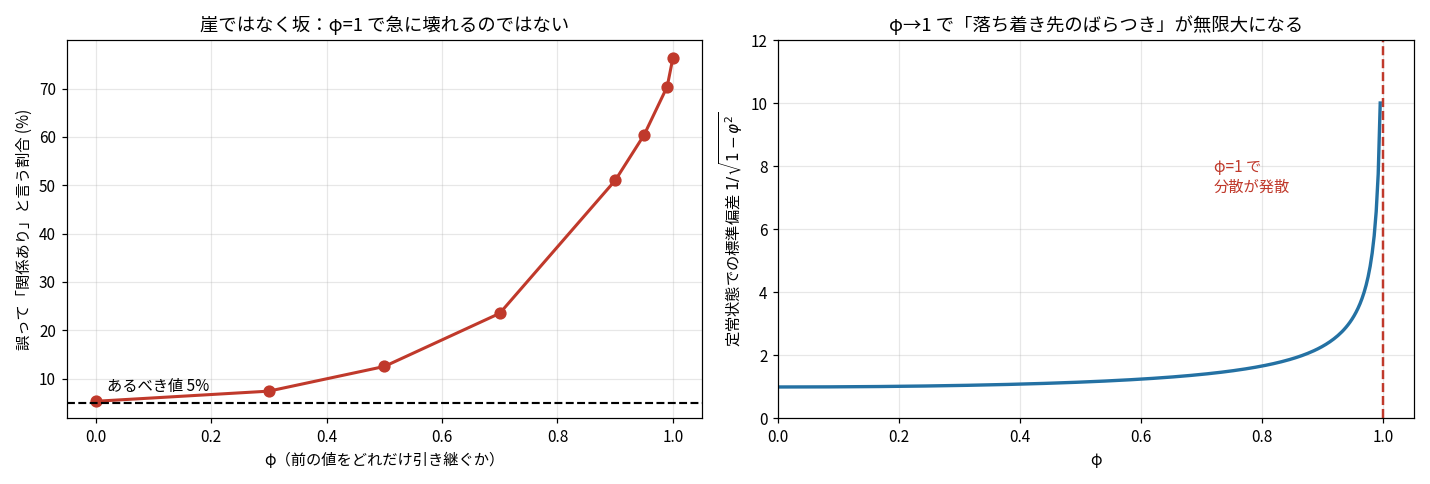
| 棄却率(名目5%) | の中央値 | 実測SD | 理論SD | |
|---|---|---|---|---|
| 0.00 | 5.3% | 0.68 | 0.99 | 1.00 |
| 0.30 | 7.4% | 0.75 | 1.04 | 1.05 |
| 0.50 | 12.5% | 0.89 | 1.13 | 1.15 |
| 0.70 | 23.5% | 1.12 | 1.35 | 1.40 |
| 0.90 | 51.0% | 2.03 | 2.01 | 2.29 |
| 0.95 | 60.4% | 2.57 | 2.46 | 3.20 |
| 0.99 | 70.4% | 3.57 | 3.26 | 7.09 |
| 1.00 | 76.4% | 4.41 | 3.78 | ∞(存在しない) |
で突然壊れるのではありません。 で既に 12.5%、 で 51% と、坂を上るように悪化します。
理由は右の図です。 のとき、この系列が落ち着く先の標準偏差は になります。実測と理論が で 1.13 vs 1.15、 で 1.35 vs 1.40 と一致しています。そして でこの値が無限大に発散します。
は「落ち着き先が存在しなくなる点」です。 これが単位根と呼ばれるものの正体です。
なお で実測SDが理論SDを下回っています(2.01 vs 2.29、3.26 vs 7.09)。私は最初これを「 では落ち着き先まで到達していないから」と説明したのですが、間違いでした。
バーンイン期間を3000ステップ入れて完全に定常状態から始めても、 の窓内で測った は で 2.06、 で 3.45 にしかなりません(理論値 2.29 / 7.09)。過渡期の寄与はごく一部でした。
本当の理由は、 の窓の中では、系列がゆっくり上下する長周期のうねりが標本平均に吸収されてしまい、 がそれを「ばらつき」として数えないことです。厳密に計算すると は で 4.40(真の の84%)、 では 13.5(真の 50.3 の27%)まで縮みます。 で言えば 2.10 と 3.67 で、真の 2.29 と 7.09 に届いていません(上に書いた 2.06 / 3.45 は で、 とは一致しません)。
これは節2-2で見た「 は並び順の情報を捨てている」の裏返しです。節2-2 では「 のときより が大きい」ことを見ましたが、それでも自分自身の真の には届いていない、という関係です。 が1に近いほど「窓に収まらない長さのうねり」が増えるので、 の下方バイアスが大きくなります。
3-4. 「単位根」という名前の由来
ここでラグ演算子 を導入します。 と定義するだけの記号です。これを使うと AR(1) は次のように書けます。
括弧の中を の多項式と見て、 を解くと 。この を特性方程式の根と呼びます。
- なら … 根が単位円の外側にある → 定常
- なら … 根がちょうど1(単位)になる → 単位根
「単位根」は「特性方程式の根が1である」という意味でした。AR(2) 以上でも同じ判定で、すべての根が単位円の外にあれば定常です。これは試験で問われる形です。
4. 弱定常性の定義
4-1. 3つが「時刻によらない」こと
もう実質見えているので、名前を付けるだけです。時系列 が弱定常とは、次の3つがすべて時刻 によらないことです。
| 条件 | 意味 | 破れるとどうなるか |
|---|---|---|
| ① (定数) | 平均が時刻によらない | トレンドがある |
| ② (定数) | ばらつきが時刻によらない | だんだん振れ幅が広がる |
| ③ | ラグ だけで決まり を含まない | 「5期前との関係」が時期によって違う |
「弱」と付くのは、平均・分散・共分散という2次までのモーメントだけを要求しているからです。分布の形そのものが時刻によらないことまで要求するのが強定常ですが、準1級では弱定常だけで十分です(以下、単に「定常」と書きます)。
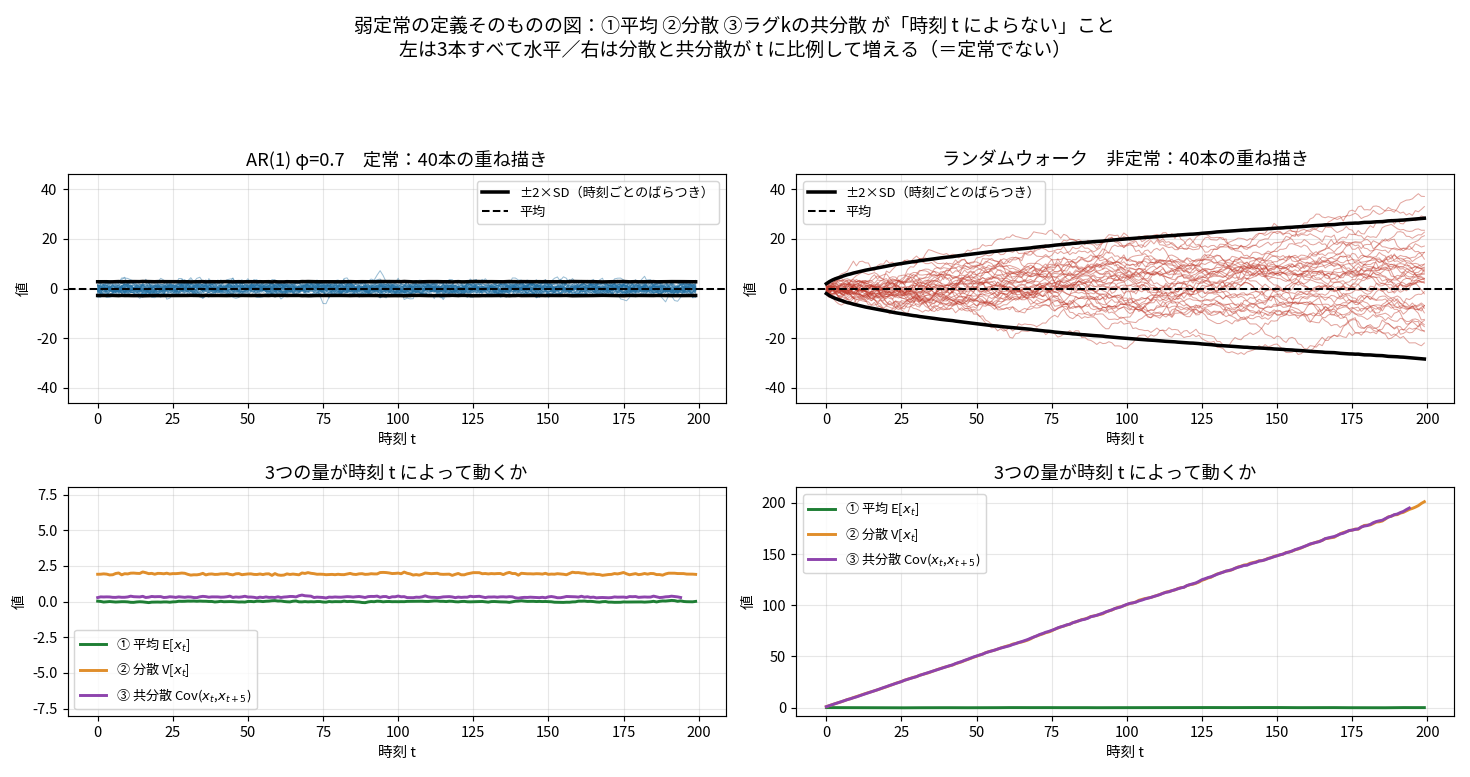
上段は40本の重ね描き。黒線が各時刻ごとのばらつき で、左は水平な帯、右は の放物線状に開いていきます(第23回のブラウン運動の図と同じ形)。
下段が定義そのもので、①平均・②分散・③ラグ5の共分散を時刻 の関数として描いたものです。左は3本すべて水平、右は②③が に比例して直線的に増えています。
4-2. ランダムウォークの平均はゼロ
20000本の系列を生成して、各時刻の値を集めて計算しました。
AR(1) (理論値:、、)
| 時刻 | |||
|---|---|---|---|
| 6 | 1.9656 | 0.3191 | |
| 21 | 1.9688 | 0.3208 | |
| 51 | 1.9545 | 0.3423 | |
| 101 | 1.9607 | 0.3373 | |
| 191 | 1.9574 | 0.3417 |
ランダムウォーク(理論値:、)
| 時刻 | 理論値 | |||
|---|---|---|---|---|
| 6 | 6.02 | 6 | 6.00 | |
| 21 | 20.69 | 21 | 20.70 | |
| 51 | 51.35 | 51 | 51.24 | |
| 101 | 101.29 | 101 | 101.37 | |
| 191 | 190.96 | 191 | 191.37 |
平均だけは両方ゼロで、条件①は満たしています。
ランダムウォークが非定常なのは②と③のせいです。「非定常=トレンドがある」ではありません。 ドリフトのないランダムウォークは平均ゼロのまま、ばらつきだけが無限に育ちます。ここは試験で狙われるところです。
4-3. 条件③の「ラグだけで決まる」を確かめる
AR(1) の自己共分散を3つの時刻で比べます。
| ラグ | 理論 | |||
|---|---|---|---|---|
| 0 | 1.9689 | 1.9546 | 1.9608 | 1.9608 |
| 1 | 1.3887 | 1.3573 | 1.3751 | 1.3725 |
| 2 | 0.9692 | 0.9526 | 0.9559 | 0.9608 |
| 3 | 0.6789 | 0.6801 | 0.6529 | 0.6725 |
| 5 | 0.3208 | 0.3423 | 0.3373 | 0.3295 |
横に読むと一定(どの時刻でも同じ)、縦に読むと で減衰。 これが「ラグだけで決まる」ということです。
ランダムウォークで同じ表を作ると:
| ラグ | |||
|---|---|---|---|
| 0 | 20.70 | 51.35 | 101.29 |
| 1 | 20.71 | 51.37 | 101.30 |
| 2 | 20.73 | 51.31 | 101.19 |
| 3 | 20.76 | 51.35 | 101.27 |
| 5 | 20.70 | 51.24 | 101.37 |
横に読むと全く違い、縦に読むと減衰しません。 ラグを5に増やしても値が下がらない(20.70 → 20.70)。つまり5期離れても関係が全く薄れない。「記憶が永久に残る」のが単位根の特徴で、これが見せかけの回帰の源でした。
4-4. なぜ定常性が必要なのか
これで一言で言えます。
定常なら、条件③のおかげで「1本の系列を時間方向にずらして眺めること」が「繰り返し観測」の代わりになります。 どの時刻でも同じルールが動いているからです。だから を増やせば精度が上がり、標準誤差の公式が意味を持ちます。
定常でなければ時刻ごとに別のルールが動いているので、何期集めても「同じものの繰り返し」になりません。
(厳密には、時間平均が期待値に収束することをエルゴード性と呼び、定常性とは別の条件です。ただし準1級のレベルでは「定常なら時間方向の平均が使える」と理解しておけば足ります。)
5. 差分は 専用の薬
5-1. トレンド定常と単位根で、正しい処理が逆になる
ここで私は次の誤解をしました。「時間の一次式なら直線からの残差にすれば独立になる。AR(1) なら前の値との差分を取れば自己相関が消える」。
前半は正しいのですが、後半は のときだけです。 の AR(1) はすでに定常なので、差分してはいけません。
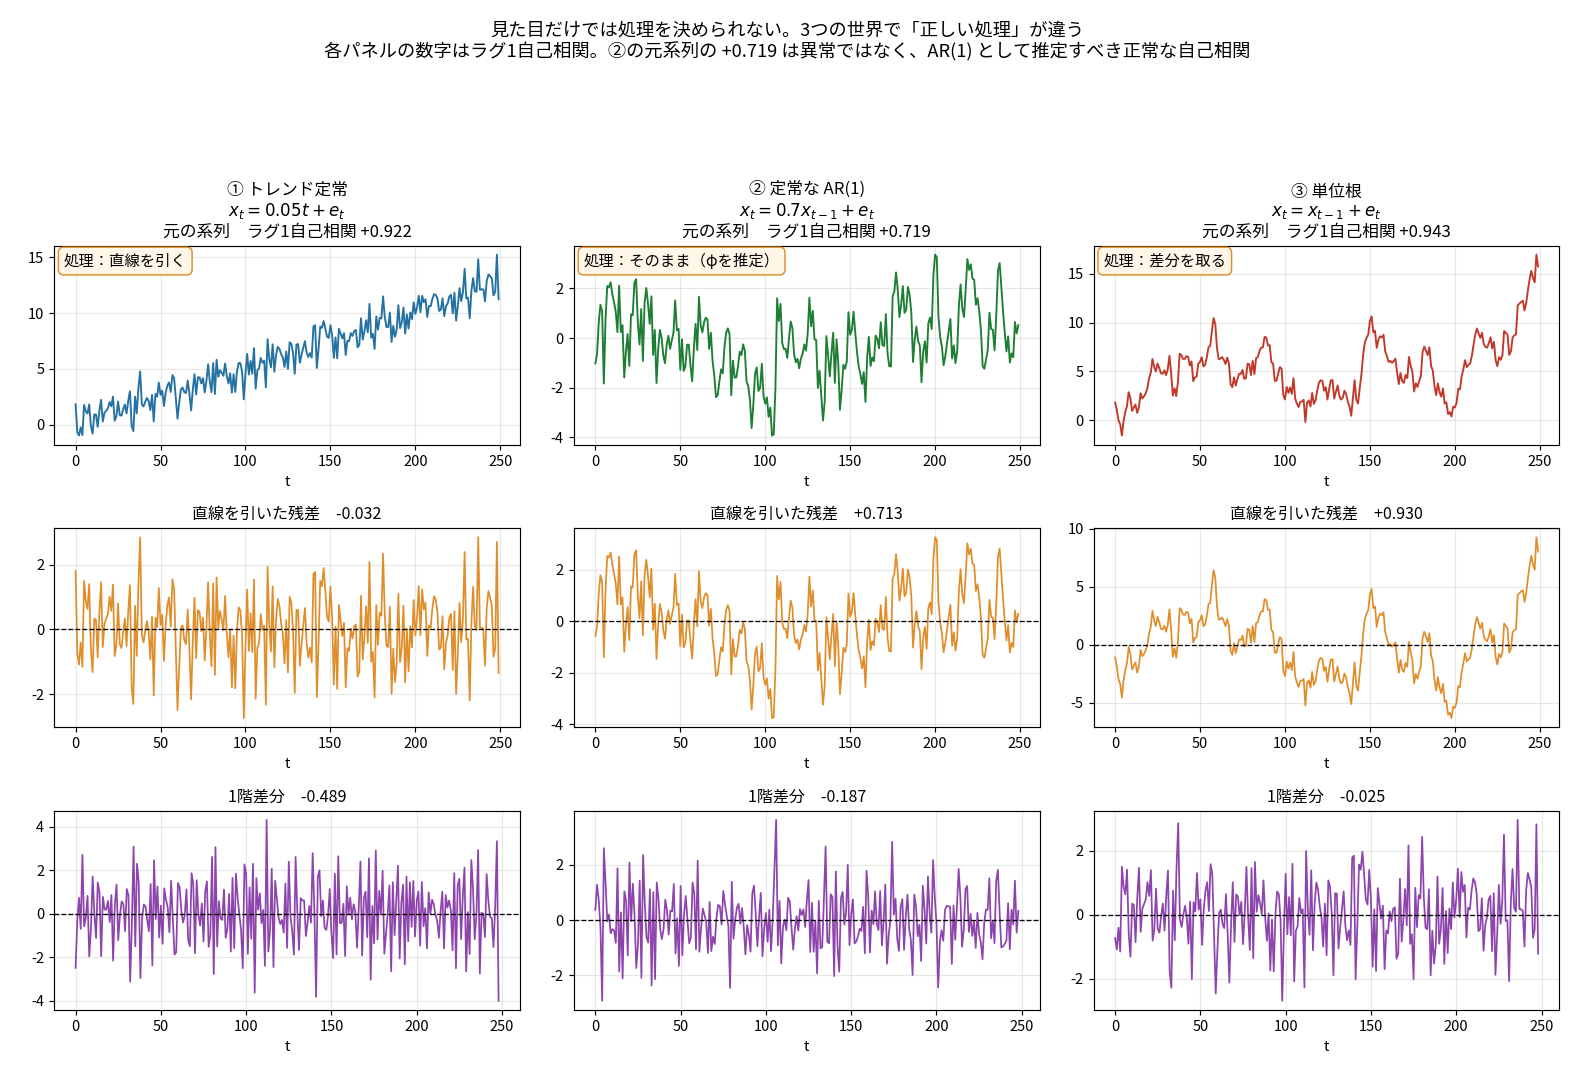
| ① トレンド定常 | ② 定常な AR(1) | ③ 単位根 | |
|---|---|---|---|
| 元の系列のラグ1自己相関 | |||
| 直線を引いた残差 | ○ | × | |
| 1階差分 | × | × | ○ |
| 正しい処理 | 直線を引く | そのまま( を推定) | 差分を取る |
元の系列の自己相関は / / 。3つとも強い自己相関で、見た目では区別できません。 それでも正しい処理は全部違います。
そして大事なのは、②の は「消すべき問題」ではないということです。これは AR(1) の そのもの、つまり推定して予測に使う情報です。
問題だったのは「自己相関があるのに無いふりをして標準誤差を計算すること」でした。 をモデルに入れて明示的に扱えば、標準誤差も正しく出せます。
5-2. なぜ で差分すると負の自己相関が出るのか
代数で1行です。
- なら なので 。完全にホワイトノイズ
- なら の項が残る。符号が負なので「前が大きかったら次は引き下げる」という人工的な反動が生まれる
この反動の大きさは理論的に になります。
| そのまま ラグ1自己相関 | 差分後 ラグ1自己相関 | 差分後の理論値 | |
|---|---|---|---|
| 0.00 | |||
| 0.30 | |||
| 0.50 | |||
| 0.70 | |||
| 0.90 | |||
| 0.95 | |||
| 1.00 | 0.000 |
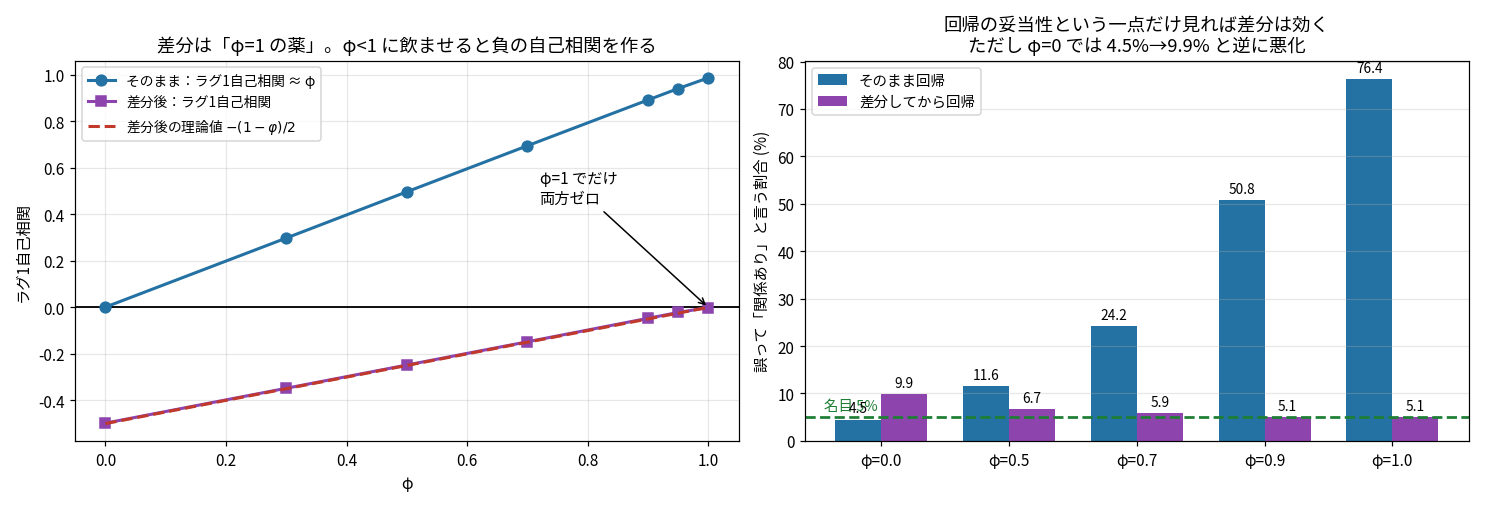
紫(実測)と赤破線(理論値)が完全に重なっています。 で初めて両方ゼロになる。差分は「 のための薬」です。
右の図では、回帰の妥当性という一点だけを見れば差分は広い範囲で効きますが、(元々ホワイトノイズ)では 4.5% → 9.9% と逆に悪化します。
5-3. 用語の整理
| 用語 | 意味 | 正しい処理 |
|---|---|---|
| 階差定常/単位根過程/I(1) | 1階差分で定常になる。「確率的トレンド」を持つ | 差分を取る |
| トレンド定常 | 時間の関数(直線など)を引けば定常になる。「確定的トレンド」 | トレンド除去 |
| 過剰差分 | 必要でないのに差分すること | 差分を取り消す |
「差分は何回取ってよいのか」への答えは必要な回数だけです。1階差分で自己相関が消えたらそこで止めます。実務では1階、季節性があれば加えて季節差分、2階以上はほぼ不要です。
そして という式は、後で出てくる Dickey-Fuller 検定そのものです。係数 がゼロかどうかを検定すれば、差分すべきかが決まります。
6. MA モデルと ARMA
6-1. MA は「過去のノイズ」を足す
AR の対になるのが MA(Moving Average=移動平均)モデルです。足しているものが違うだけです。
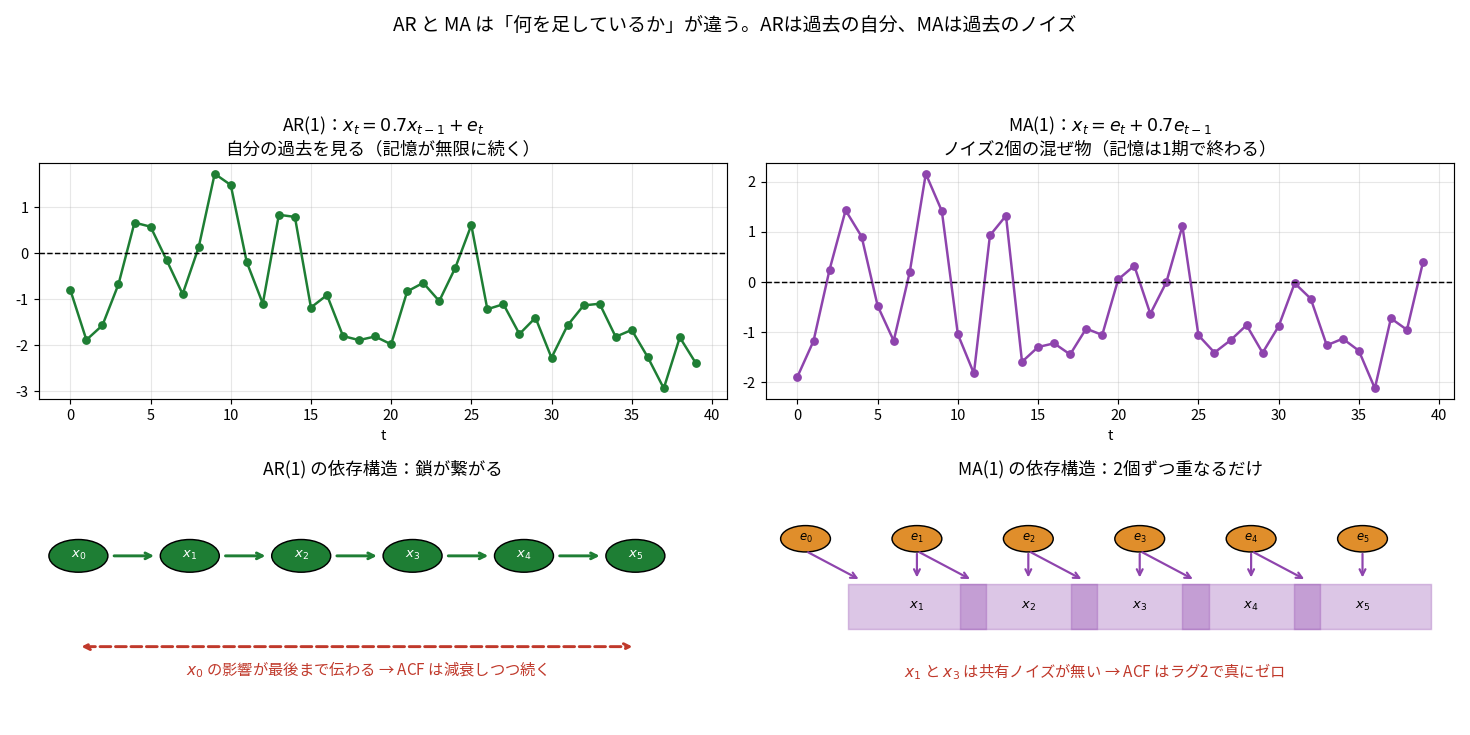
下段の依存構造が肝です。
AR は鎖で、 の影響が といつまでも伝わります(0.7、0.49、0.343…と薄れつつ消えない)。
MA は2個ずつの重なりです。 と は を共有しますが、 と は共有するノイズが1つもありません。だから2期以上離れると関係が真にゼロになります。
ひとつ注意で、「移動平均」という名前は誤解を招きます。データを平滑化する移動平均(3期移動平均など)とは別物で、こちらは「ノイズの加重和」というモデルです。同じ言葉が2つの別物を指しています。
使いどころの違いはこうです。MA は一時的なショックが数期だけ影響して完全に消える現象(テレビで紹介されてアクセスが2日跳ねて元に戻る)。AR は効果が薄れながら長く残る現象(口コミが徐々に広がる)。
そして ARMA(p, q) は両方を持つモデルです。
6-2. ARIMA(p, d, q) の記号
| 記号 | 名前 | 意味 |
|---|---|---|
| p | AR(自己回帰) | 過去の自分を何期分使うか |
| d | I(Integrated=和分) | 差分を何回取るか |
| q | MA(移動平均) | 過去のノイズを何期分使うか |
ARIMA(1,1,1) とは、①まず1階差分を取り()、②その に ARMA(1,1) を当てる、という2段階です。
「Integrated=和分」という名前の由来は、差分(difference)の逆操作が和(integrate)だからです。「差分すれば定常になる=定常なものを足し上げて出来ている」という意味で、I(1) は第23回のランダムウォークの一般化にあたります。
季節性が入ると SARIMA(p,d,q)(P,D,Q) になります。後半の括弧は「 期前」に対する同じ3つで、 は周期(日次データの週次周期なら )。
7. ACF と PACF:なぜ AR と MA を見分けられるのか
7-1. 定義の違いは「間の期を固定するか」
私が一番つまずいたのがここです。ACF も PACF も「過去との相関」に見えて、区別がつきませんでした。
| ACF (自己相関) | PACF(偏自己相関) | |
|---|---|---|
| 測るもの | と のただの相関 | 同じ相関から間の期(1〜)の影響を取り除いた分 |
| 定義 | と重回帰したときの の係数 | |
| 回帰でいうと | 単回帰の傾き | 重回帰の偏回帰係数 |
違いは「間の期を固定するかしないか」だけです。 第16回で「他の変数を固定したとき」の正体が残差だったのと同じ構造で、第27回の偏相関と同じ道具です。
7-2. AR(1) で「2期前は効いているのか」
AR(1) のデータで、2期前の効果を2通りに測ります。
【単回帰】x_t ~ x_{t-2}
   x_{t-2} の係数 = +0.4910 (SE 0.0019)   強く効いて見える

【重回帰】x_t ~ x_{t-1} + x_{t-2}
   x_{t-1} の係数 = +0.6984 (SE 0.0022)   真の φ=0.7
   x_{t-2} の係数 = +0.0022 (SE 0.0022)   ★ゼロ
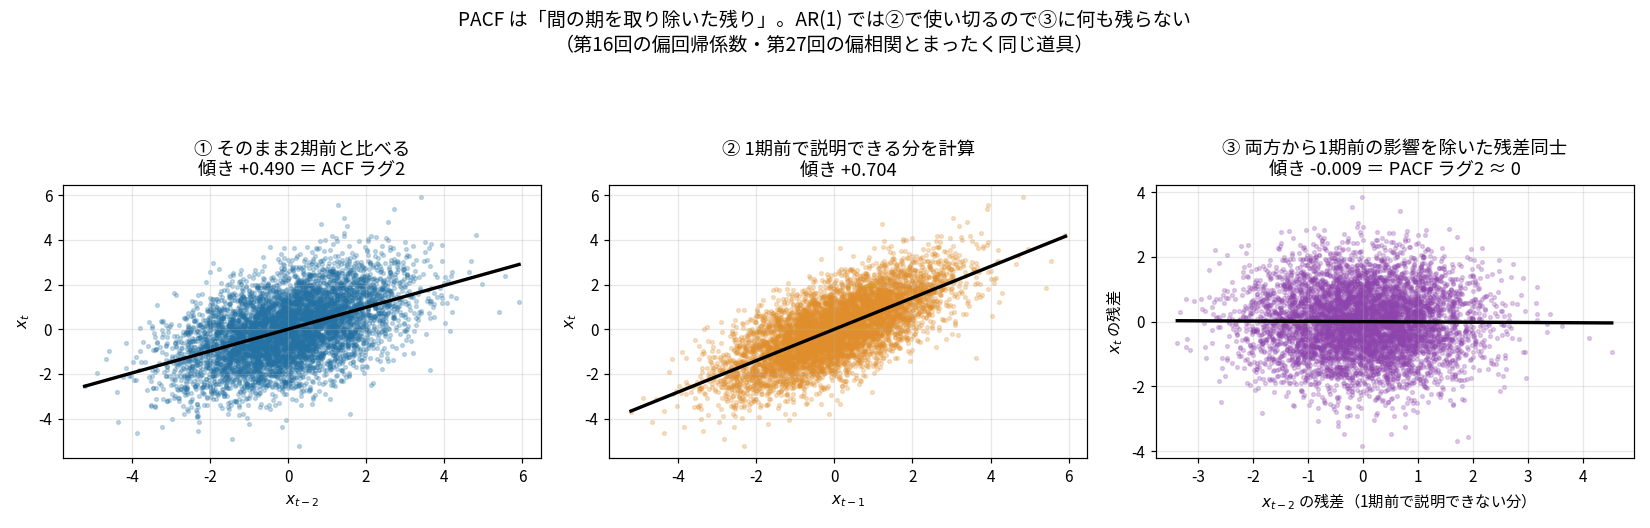
③で両方から1期前の影響を除いた残差同士を見ると、傾きが でほぼ完全に水平になります。これが PACF ラグ2 です(この散布図は で描いているので 。上のコードは なので 。どちらも「ゼロと区別できない」という同じ結論です)。
なお③の傾きと、上の重回帰の の係数は理論上まったく同じものです。第16回で「他の変数を固定した係数=残差同士の回帰」と確かめたのと同じ関係で、同じデータなら数値も一致します。
7-3. なぜこんなに違うのか:経路の分解
私はここで「単回帰と重回帰でなぜそんなに結果が変わるのか」が分からなくなりました。答えは、 と 自身が相関していることです。実測 。隣同士なので当然0.7です。
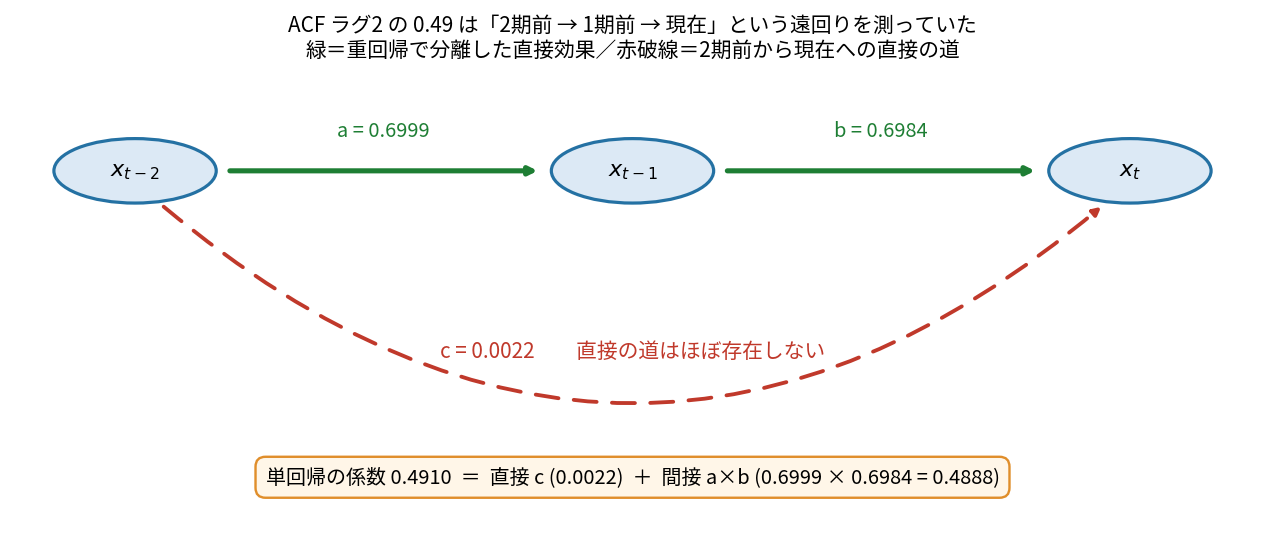
ぴったり一致します。
という数字は「2期前が直接効いている」のではなく、「2期前 → 1期前 → 現在」という遠回りの経路を測っていただけでした。単回帰は間の を見ていないので、遠回りと直接の道を区別できません。
考えてみれば当然です。AR(1) の定義 に はそもそも登場しません。 を知ってしまえば は追加情報を持たない。第22回のマルコフ性そのものです。
2つは違う問いを聞いています。
| 問いの形 | 答え | |
|---|---|---|
| 単回帰(ACF) | 「2期前が1大きいと、現在はどれだけ大きい?」 | 0.491 |
| 重回帰(PACF) | 「1期前が同じ値の2つを比べたとき、2期前の違いは効く?」 | 0.002 |
7-4. 層別で見ると一目瞭然
これが一番直感的でした。
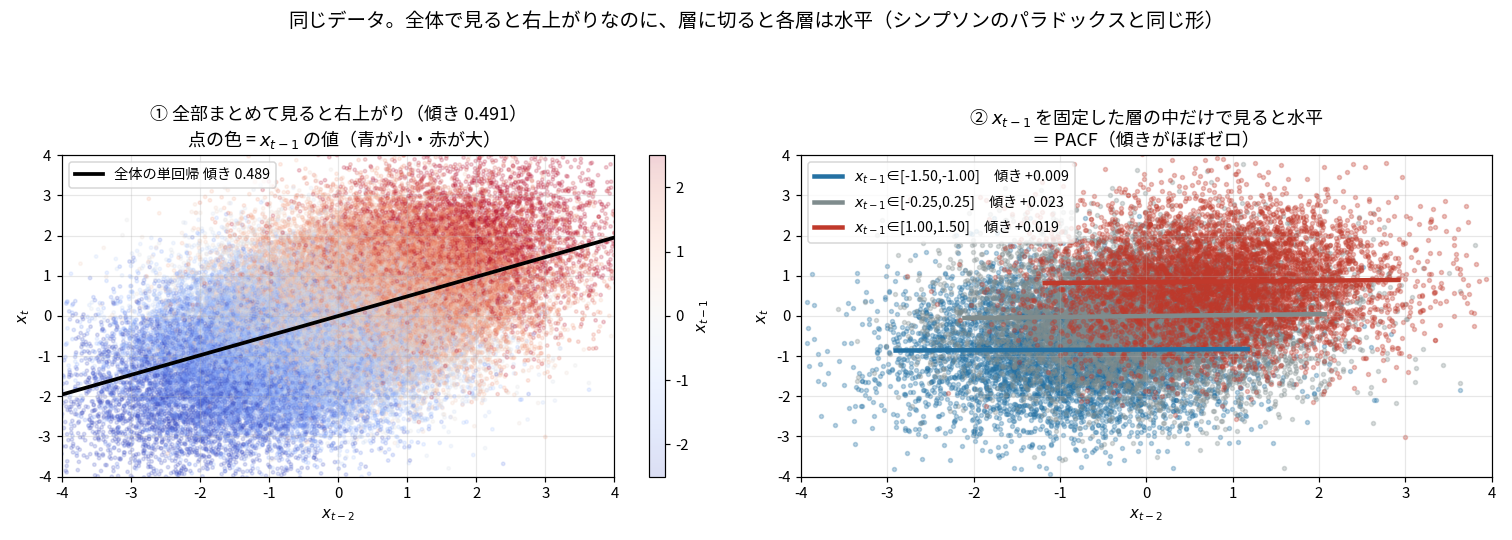
同じデータです。 左は全部まとめた散布図で右上がり(傾き 0.489)。点の色が の値で、青(小)が左下、赤(大)が右上に固まっているのが見えます。
右は を3つの狭い帯に限定して、その中だけで直線を引いたもの。3本すべてほぼ水平(、、)です。
左の右上がりは、層が斜めに並んでいるだけで作られていました。構造としてはシンプソンのパラドックスと同じ形です。
実データの数字でも確かめます。 に限定した4374件の中で:
| 条件( を1.00付近に固定) | の平均 | の平均 |
|---|---|---|
| のグループ(1843件) | ||
| のグループ(919件) |
が 2.28 も違うのに、 の平均はほぼ同じです。逆に を固定して を変えると → と大きく動きます。
7-5. MA では逆になる
MA(1) を「過去の自分」で表そうとすると、無限に続きます。
MA(1) は AR() に等しい(係数が符号を交替しながら減衰する)。実測でも重回帰の係数が / / / と出ました。理論値 / / / より小さめなのはラグ4で打ち切っているためで、無限に続くことの裏返しです。
この書き換えが成り立つのは のときで、この条件を反転可能性(invertibility)と呼びます。 だと級数が発散して AR() に書けません。さらに と は同じ ACF を与えるので、どちらか一方に決めるためにこの条件を課します。ラグ演算子で書くと の根が単位円の外、つまり AR の定常条件と対になる概念です。
一方、MA の共分散は簡単に計算できます。 は互いに独立なので、添字が一致する項だけが残るのがポイントです。
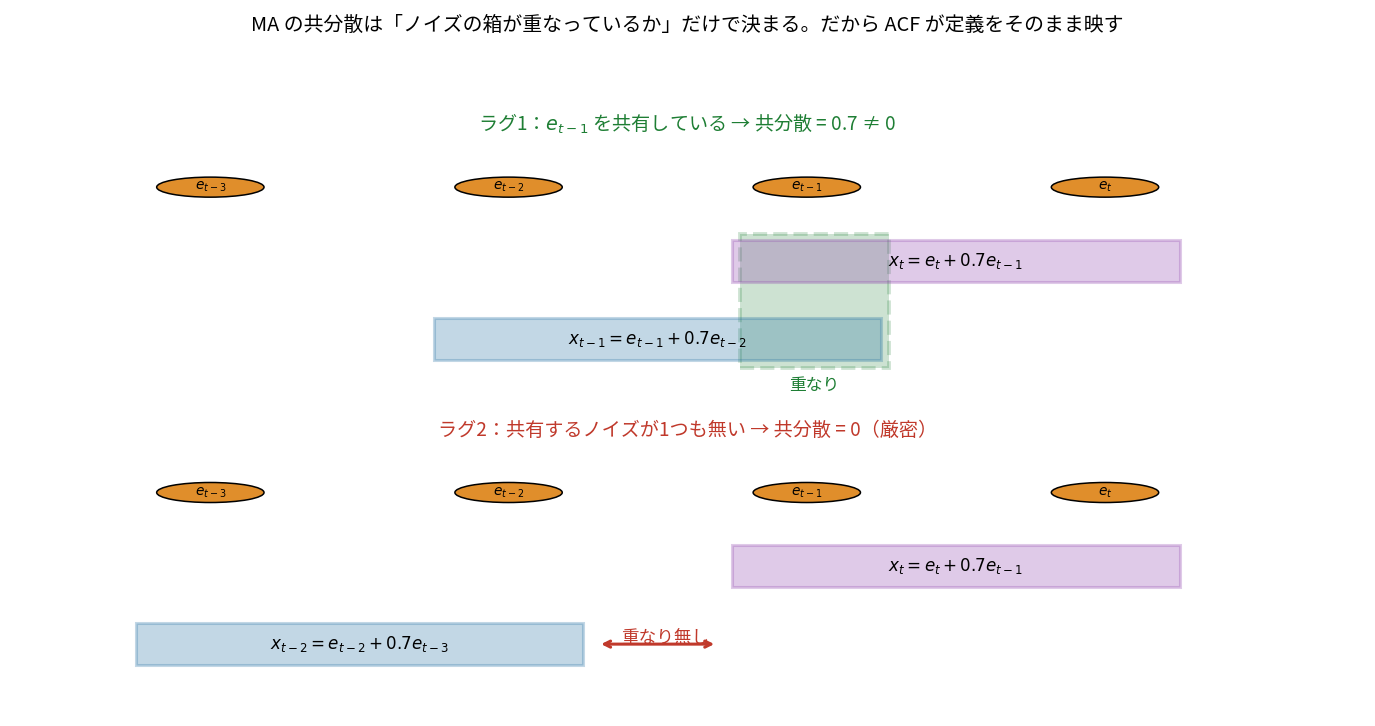
ラグ1: 展開すると4項。独立なので添字が一致するものだけ残る → を共有しているので
ラグ2: 添字は と 。一致するものが1つも無い → 厳密にゼロ(近似ではない)
MA の共分散は「ノイズの箱が重なっているか」だけで決まります。 共分散は共有ノイズを数えるだけの計算なので、MA の定義がそのまま共分散に写ります。
7-6. コレログラム:4モデルを並べる
ACF と PACF を棒グラフにしたものをコレログラムと呼びます。
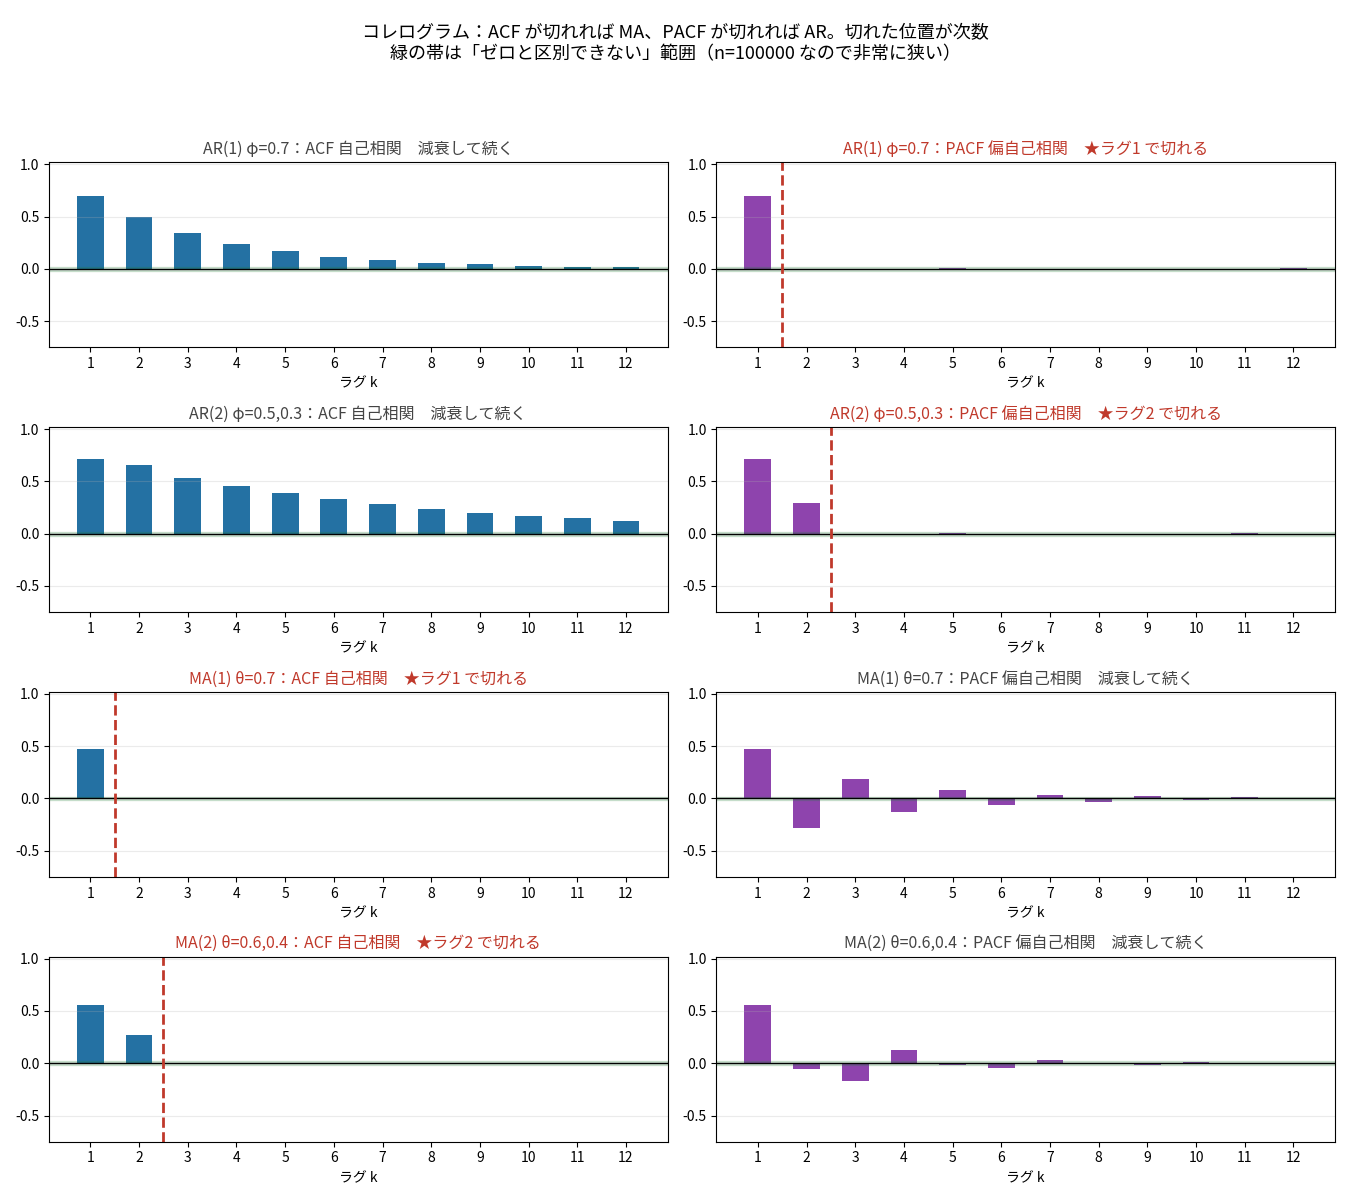
| モデル | ACF | PACF |
|---|---|---|
| AR(p) | 減衰して続く | ラグ で切れる |
| MA(q) | ラグ で切れる | 減衰して続く |
| ARMA(p,q) | 減衰して続く | 減衰して続く(どちらも切れない) |
| 単位根 I(1) | ほぼ1のまま減衰しない | ラグ1がほぼ1で以降ゼロ |
実測値():
| モデル | ACF ラグ1 / 2 / 3 | PACF ラグ1 / 2 / 3 |
|---|---|---|
| AR(1) | 0.7005 / 0.4915 / 0.3442 | 0.7005 / 0.0017 / |
| AR(2) | 0.7111 / 0.6525 / 0.5361 | 0.7111 / 0.2971 / |
| MA(1) | 0.4709 / 0.0031 / 0.0017 | 0.4709 / / |
| MA(2) | 0.5562 / 0.2692 / 0.0062 | 0.5562 / / |
理論値との一致も確認しました。AR(1) の ACF は (0.7000 / 0.4900 / 0.3430)、MA(1) の ACF ラグ1は 、MA(2) の ACF は 0.5526 / 0.2632、AR(2) の PACF ラグ2は 。
7-7. なぜ見分けられるのか:道具とモデルの「言語」
これが今回一番の収穫でした。ACF と PACF はどちらが優れているという話ではなく、読み取れるモデルが違うだけです。
| AR(1): | MA(1): | |
|---|---|---|
| 定義が使っている言葉 | 過去の自分 | 過去のノイズ |
| ACF(共分散)で見ると | 鎖を伝う間接効果が混ざり尾を引く | 共有ノイズの有無がそのまま出る → 切れる |
| PACF(過去の自分で回帰)で見ると | 定義をそのまま読み取る → 切れる | AR() に書き換えが必要で無限に続く |
PACF は「過去の自分で回帰する」道具なので、過去の自分で書かれた AR の次数を読み取れる。 ACF は「共有ノイズを数える」道具なので、ノイズで書かれた MA の次数を読み取れる。
道具とモデルの言語が一致したときだけ、ぴたりと切れます。一致していない側は「書き換え」が必要になり、その書き換えが無限級数になるので尾を引きます。
だから両方見ないと、どちらの言語で書かれているか分かりません。 これがコレログラムを2つ並べる理由でした。
7-8. 覚え方
ACF が切れたら MA、PACF が切れたら AR。切れた位置が次数。
頭文字だと逆になるので注意です。PACF と AR が組(PACF → p の決定、と結びつけると混乱しません)。
実務上の注意もひとつ。上の表がこれだけきれいに切れたのは だからです。実データの 程度では、切れた後のラグでも 程度ばらつくため、「切れた」の判定に主観が入ります。だから AIC を併用します。
8. 単位根検定(Dickey-Fuller)
8-1. 検定するのは前に出した式そのもの
第5節で出した式をもう一度書きます。
- 帰無仮説 :(、単位根あり、差分が必要)
- 対立仮説 :(、定常)… 片側検定
やることは「 を に回帰して、係数の 値を見る」だけです。
ところが落とし穴があります。
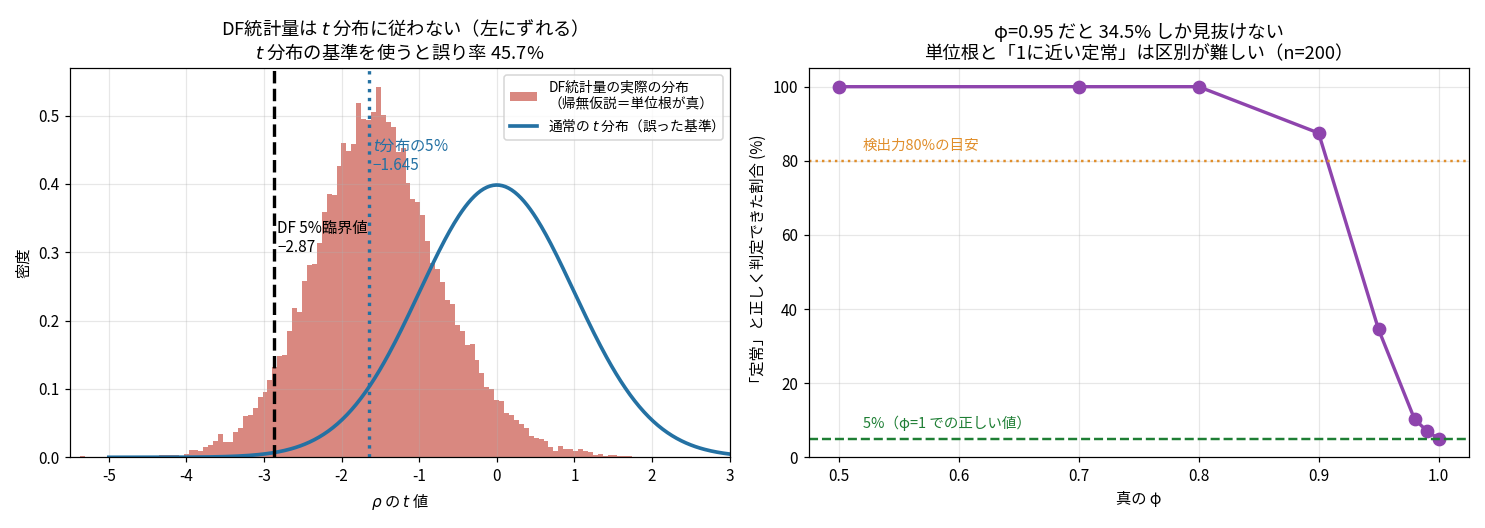
この 値は 分布に従いません。 通常の 分布の5%点()を使うと第一種の誤りが 45.7% になり、正しい DF 臨界値 を使うと 5.2% に収まります。
| モデルの型 | 1% 臨界値 | 5% 臨界値 | 10% 臨界値 |
|---|---|---|---|
| 定数項なし | |||
| 定数項あり(標準) | |||
| 定数項+トレンド | |||
| (参考)通常の 分布 |
、20000回のシミュレーションで自作した値です。教科書の値( / / )とほぼ一致しました(1%点は裾なので誤差が大きく、再実行すると 〜 の範囲で動きます)。
なぜ 分布に従わないのか。 帰無仮説()のもとでは説明変数 自体が非定常なので、 の推定量が通常の漸近正規性を持ちません。単位根の検定が単位根の影響を受けるという自己言及的な構造です。だから専用の臨界値表が必要になります。
トレンド項を入れると臨界値がさらに左に動く点にも注意が必要です。同じデータでもモデルの型で結論が変わります。
8-2. 検出力の弱さ
DF 検定の最大の弱点です。真の が1に近いとき、「定常である」と正しく判定できる割合を測りました()。
| 真の | 「定常」と正しく判定できた割合 |
|---|---|
| 0.50 / 0.70 / 0.80 | 100.0% |
| 0.90 | 87.5% |
| 0.95 | 34.5% |
| 0.98 | 10.3% |
| 0.99 | 7.2% |
| 1.00(帰無仮説が真) | 5.0%(これは正しい値) |
は定常なのに、3回に2回は「単位根あり」と判定してしまいます。
標本を増やせば改善します。 のとき で 6.8%、 で 13.3%、 で 34.5%(上の表と同じ条件)、 で 97.4%、 で 100%。
単位根検定は「長い系列」を要求する検定です。日次データなら1年半、月次データなら40年分。第12回の「棄却できないことは帰無仮説が正しいことを意味しない」が、ここでは特に重く効きます。
8-3. ADF 検定:なぜ「拡張」が必要か
DF 検定は「差分がホワイトノイズ」を前提にしています。差分に自己相関が残っていると崩れます。ラグ項 を加えたものが ADF(Augmented Dickey-Fuller)検定です。
どの場合に必要か調べました(すべて帰無仮説が真なので5%になるべき)。
| の構造 | DF(ラグ0) | ADF ラグ1 | ADF ラグ4 | ADF ラグ8 |
|---|---|---|---|---|
| ホワイトノイズ | 4.8% | 4.7% | 4.8% | 4.5% |
| AR(1) | 4.7% | 5.6% | 5.3% | 4.7% |
| AR(1) | 14.9% | 5.7% | 5.8% | 6.1% |
| MA(1) | 61.0% | 24.1% | 6.0% | 5.1% |
| MA(1) | 99.8% | 92.0% | 36.0% | 11.3% |
負の MA 成分があると DF 検定は壊滅的に壊れます。 では 99.8% の確率で「単位根なし」と誤判定します。ラグを足すと 92.0% → 36.0% → 11.3% と改善しますが、それでも足りません。
そして面白いのは、負の MA 成分は過剰差分で生まれるものだということです(第5節の )。つまり「差分しすぎた系列に単位根検定をかけると誤った答えが返る」という循環があります。ラグ数の選択は AIC で決めるのが標準です。
9. ブログのアクセス数に使えるのか
9-1. データと前処理
自分のブログのアクセス数に応用できるか、これが個人的な動機でした。1年分(365日)の日次PVを現実的な構造で生成しました。週次季節性(週末に3割落ちる)+ゆるい成長+AR(1)の粘り+バズ1回。平均 40.8 PV、最大 421 PV。
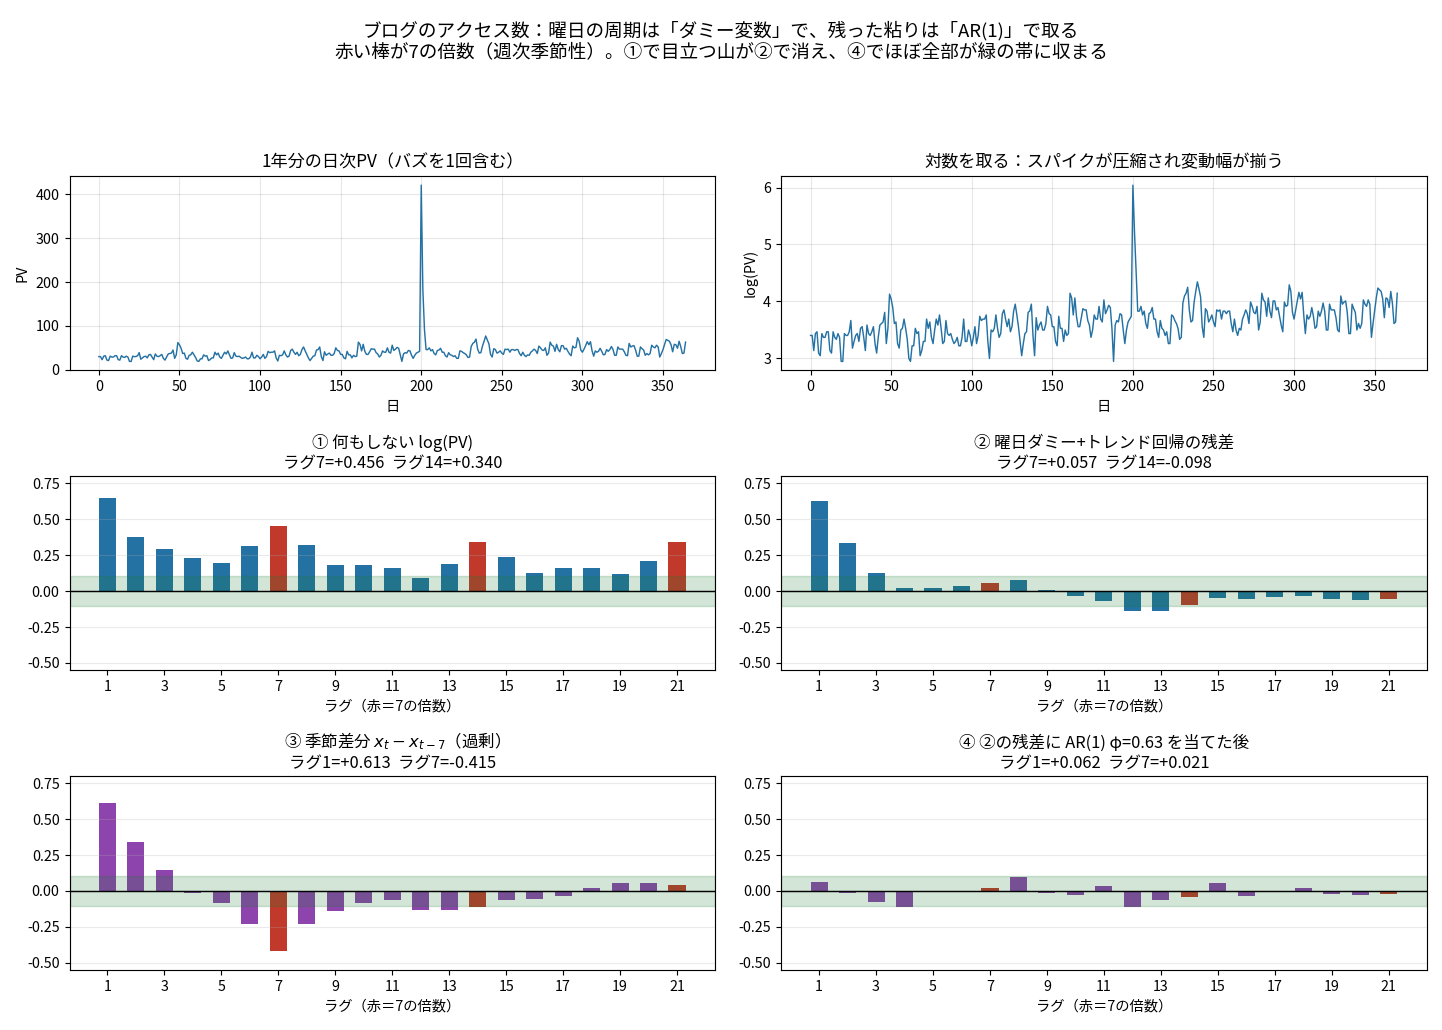
まず対数を取ります。 バズのスパイクが圧縮され、変動幅が期間を通じて揃います。PV は「何%増えた」で動くので対数が自然です。変動幅が水準に比例するときは対数を取る、という第17回の不均一分散への対処と同じ発想です。
9-2. 週次季節性の扱い:4つの方法
赤い棒が7の倍数(週次季節性)です。
| 処理 | ラグ1 | ラグ7 | ラグ14 | SD |
|---|---|---|---|---|
| ① 何もしない | 0.3185 | |||
| ② 曜日ダミー+トレンド回帰 | 0.2364 | |||
| ③ 季節差分 | 0.3269 | |||
| ④ 1階差分 | 0.2651 | |||
| ⑤ ②+残差に AR(1) | — |
①はラグ7に の山。②の曜日ダミーで に消えます。③の季節差分は に反転(過剰差分)。④の1階差分ではラグ7が と残ります。
そして⑤、②の残差に AR(1) を当てるとほぼすべてがゼロと区別できない範囲に収まりました。
結論:曜日は「ダミー変数」、残った粘りは「AR(1)」。
なぜ SARIMA の季節差分ではなくダミー変数なのか。 「月曜は高い」は確定的な構造です(曜日は永久に7日周期で確実に来る)。差分は確率的なトレンドを消す道具なので、ここでは道具が合っていません。第5節で見た「トレンド定常 vs 単位根」の区別が、そのまま季節性にも当てはまります。
9-3. 予測させてみる
最後の28日を隠して当てさせました。
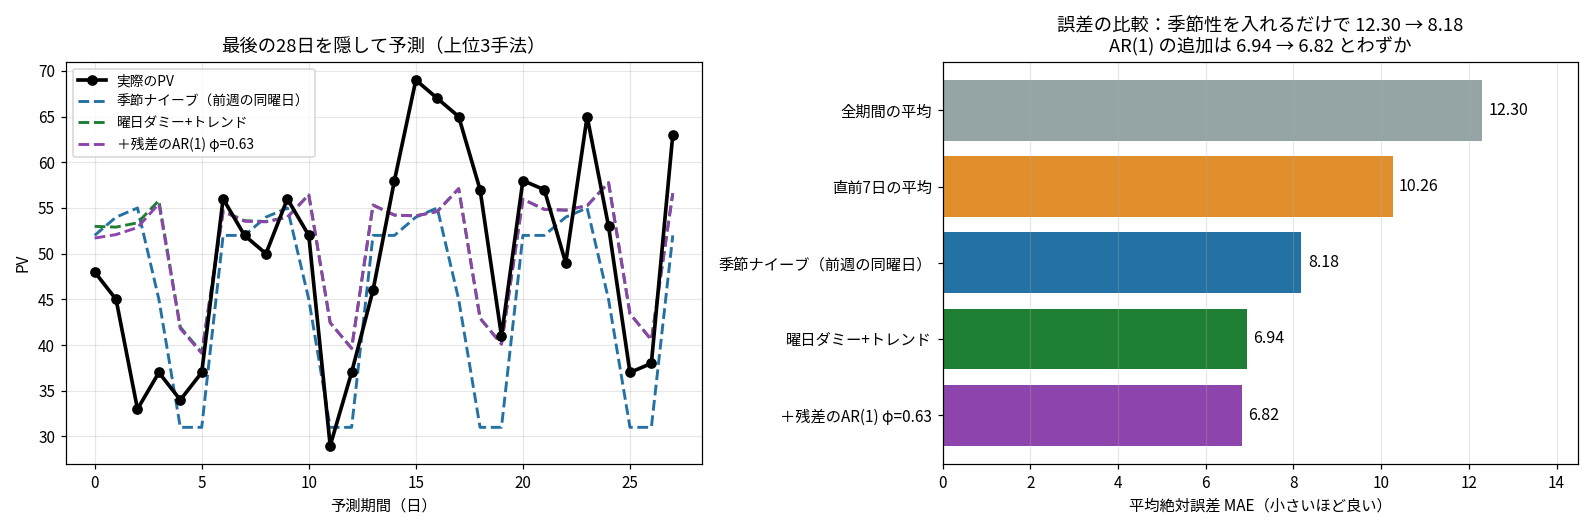
| 予測方法 | MAE | MAPE | コメント |
|---|---|---|---|
| 全期間の平均 | 12.30 | 22.9% | ベースライン |
| 直前7日の平均 | 10.26 | 21.0% | トレンドは拾うが曜日を潰す |
| 季節ナイーブ(前週の同じ曜日) | 8.18 | 16.8% | 季節性を入れるだけで大きく改善 |
| 曜日ダミー+トレンド回帰 | 6.94 | 15.4% | 全期間の情報を使うので更に良い |
| +残差の AR(1) | 6.82 | 15.1% | 改善はわずか(1.7%) |
MAE は Mean Absolute Error(平均絶対誤差)、MAPE は Mean Absolute Percentage Error(平均絶対パーセント誤差)です。
効果の大きさの順番が実務的に重要です。 「季節性を入れる」で 、「回帰にする」で 、「AR(1) を足す」で 。
凝った時系列モデルより、曜日と対数変換の方がはるかに効きます。
AR 部分が効かない理由は、1期先の予測でしか AR の記憶が使えないためです。 なら28日先には で消えます。AR / ARIMA は短期予測の道具で、長期予測にはトレンドと季節性しか効きません。
9-4. 正直な結論
この規模のブログでは、予測モデルを作る意味は薄いです(上のデータは日次40PV前後、月1200PV程度の想定。私の実際のブログはもっと少なく月31PVです)。MAPE 15% は「40PVが34〜46PVの間」という程度の精度で、その情報で何かを決められるとは思えません。
時系列解析が効くのは介入の効果測定です。「7月に内部リンクを整えたら、曜日変動と成長トレンドを差し引いた上で有意に増えたか」という問いの形なら、この道具立てがそのまま使えます。第11回で「月31PVではA/Bテストに5.8年かかる」と計算したのと同じ話で、まず流入を増やすのが先という結論はここでも変わりませんでした。
10. 残りの用語(用語と使いどころだけ)
準1級では用語レベルで足りる部分をまとめます。
10-1. Ljung-Box 検定
コレログラムは目で見る道具ですが、ラグ1〜 の自己相関をまとめて1つの検定にするのが Ljung-Box 検定です。
は「ラグ1〜 の自己相関がすべてゼロ」なので、 値が大きいほどモデルが良い(第14回の適合度検定と同じ向き)。
| 検定する系列 | 自由度 | 値 | 判定 | |
|---|---|---|---|---|
| ホワイトノイズ | 10.75 | 10 | 0.3770 | OK |
| AR(1) | 31.90 | 10 | 0.0004 | 自己相関あり |
| AR(1) | 229.60 | 10 | 0.0000 | 自己相関あり |
| AR(1) に AR(1) を当てた残差 | 8.24 | 9 | 0.5100 | OK=モデル十分 |
という弱い自己相関でも検出できています。使いどころはモデルを当てた後の残差にかけて取り残しを確認する、第17回の残差診断の時系列版です。自由度が から推定パラメータ数だけ減る(10 → 9)のは第14回と同じ理屈です。
10-2. AIC と BIC による次数決定
コレログラムの「切れた」判定には主観が入るので、情報量規準を併用します(詳細は第32回)。真の次数を当てられるか測りました。
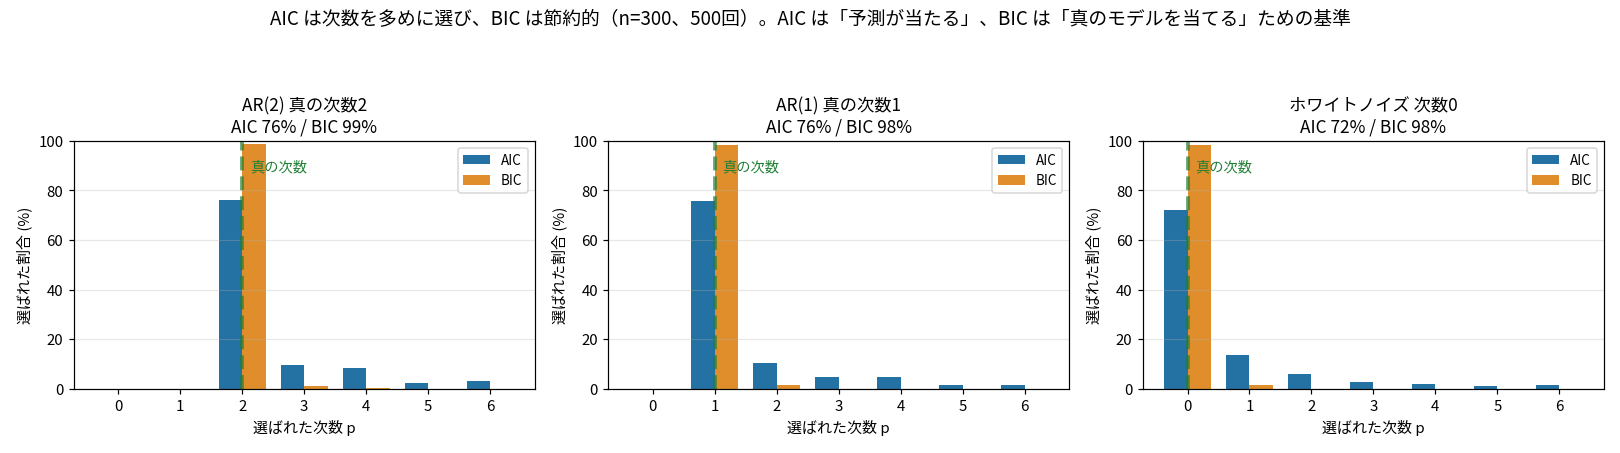
| 罰則項 | 思想 | 真の次数を当てた割合 | |
|---|---|---|---|
| AIC | 予測が当たるモデルを選ぶ(真のモデルの存在を仮定しない) | 72〜76% | |
| BIC | 真のモデルを当てる(一貫性がある) | 98〜99% |
なら なので、BIC の罰則は AIC の約2.9倍厳しい。だから BIC は節約的なモデルを選び、AIC は大きめの次数に流れます。
AIC が「間違っている」のではなく目的が違います。時系列の次数決定では「少し多めに取っても予測は悪化しにくい」ため AIC が慣例的に使われますが、真の構造を知りたいなら BIC です。
10-3. 共和分
ここまで「単位根同士の回帰は見せかけ」と言ってきましたが、例外があります。
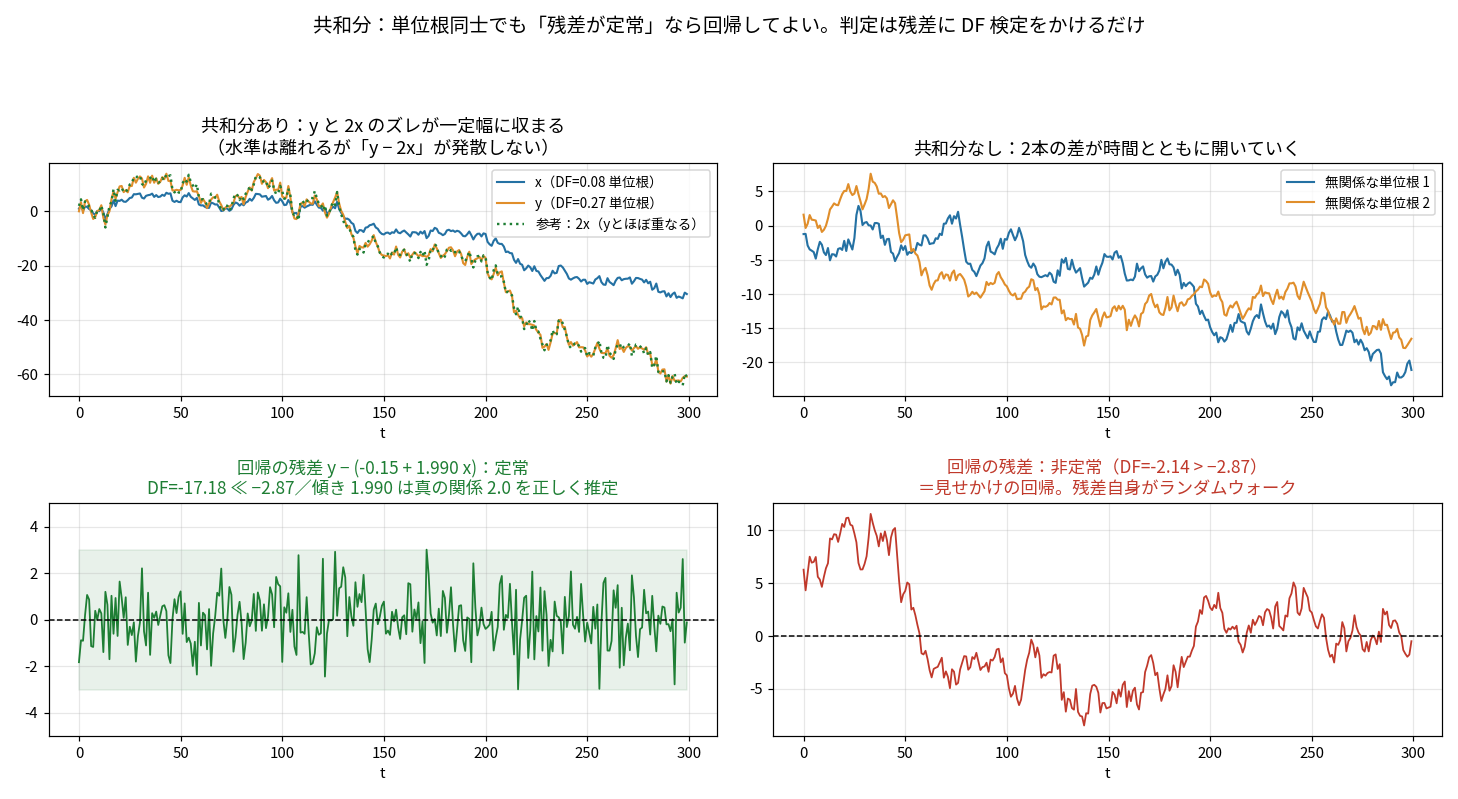
左の と はどちらも単位根(DF 、)ですが、緑の点線 が にぴったり重なっています。水準はどんどん動くのに のズレは一定幅(SD )に収まります。
だから回帰の残差が定常(DF )で、傾き 1.990 は真の関係 2.0 を正しく推定できています。無関係な2本だと差が開き続け(SD )、残差自身がランダムウォークになります(DF )。
共和分(cointegration)=それぞれは単位根だが、ある線形結合が定常になる関係。
直感的には2本が鎖で繋がれている状態です。各自ふらふら歩くが、離れすぎると引き戻される。判定は回帰の残差に DF 検定をかけるだけ(Engle-Granger 法)で、残差が定常なら共和分あり=その回帰は意味があります。
ただし臨界値は通常の DF とは別のものを使います。残差は回帰で最小化された量なので、臨界値がさらに左にずれるのです。・定数項ありでシミュレーションすると5%点は でした( を使うとサイズが 14.1% に膨らみます)。上の例は と なのでどちらの基準でも結論は変わりませんが、境界付近では効いてきます。
これが「差分すれば安全」の落とし穴です。 共和分がある場合に両方を差分してしまうと、 という長期の関係が消えます。差分は短期の変化だけを残すので。正しい扱いは誤差修正モデル(ECM)で、短期の差分の動きと長期のズレを両方入れます。例は金利の長短スプレッド、同業2社の株価、為替と物価。
10-4. スペクトル解析
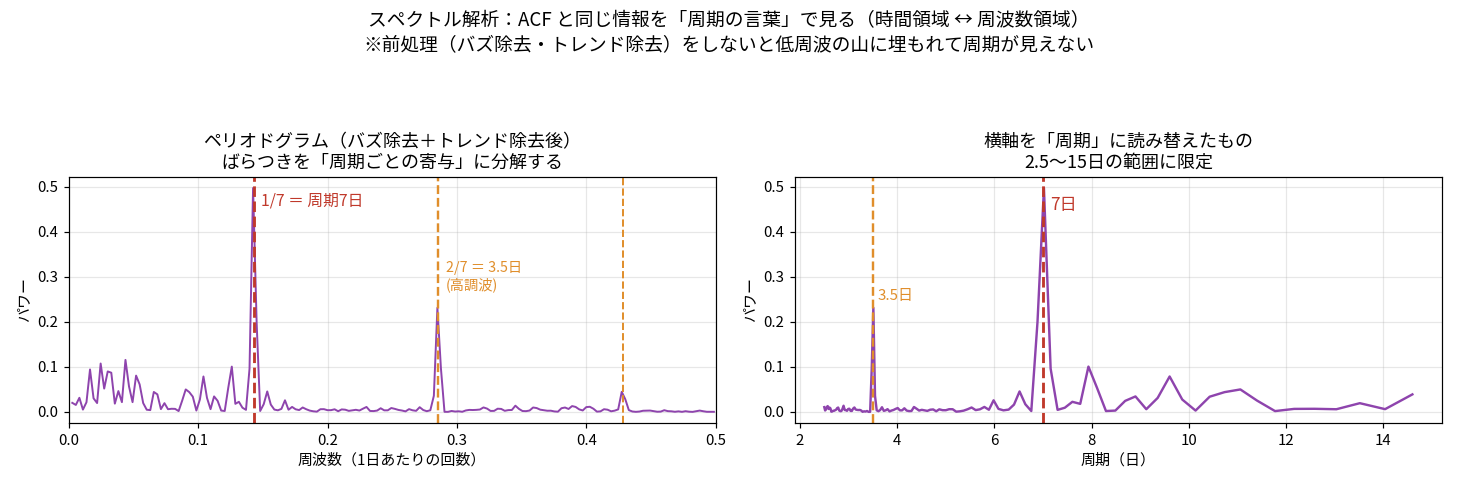
先ほどのブログPVのデータ(バズ除去・トレンド除去後)のペリオドグラムです。周波数 に鋭いピーク=周期7日が一目で分かります(全ピーク中1位)。 にあるのは高調波で、3.5日周期の成分が別にあるのではなく「7日周期の波形が正弦波ではない」ことの現れです。
| 時間領域(ACF/PACF) | 周波数領域(スペクトル) | |
|---|---|---|
| 横軸 | ラグ(何期前か) | 周波数(または周期) |
| 得意なこと | 次数の決定、モデルの構築 | 周期の発見 |
互いにフーリエ変換で移り合うので情報量は同じです(ウィナー・ヒンチンの定理)。ACF を変換したものがスペクトル密度。
使いどころは周期が未知のとき。曜日周期のように「7日だ」と分かっているならダミー変数で済みますが、機械の振動や脳波のように「何周期あるか自体を探したい」ときに効きます。なお前処理(トレンド除去)をしないと低周波の山に埋もれて見えません。実際1回失敗しました。
10-5. 状態空間モデル
| 項目 | 内容 |
|---|---|
| 解き方 | カルマンフィルタ(逐次的に状態を更新する=第2回のベイズ更新の連続版) |
| ARIMA との関係 | ARIMA は状態空間モデルの特殊ケースとして書ける(状態空間の方が広い枠組み) |
| 強い場面 | 欠測値がある(そのまま扱える)/係数が時間変化する/複数系列を同時に/トレンド・季節を明示的に分解したい |
| 既習との接続 | 第22回の HMM(隠れマルコフモデル)は状態空間モデルの離散版 |
HMM を使った経験があるなら、あの隠れ状態が連続値になったものと考えれば構造は同じです。前向き・後ろ向きアルゴリズムに対応するのがカルマンフィルタ・スムーザです。準1級ではこの対応関係と用語までで、計算は問われません。
11. 自己診断で2問間違えた
この回の最後に、自分で理解度を確かめる8問を解きました。結果は 6.5/8(完全正解5問、部分正解3問を 0.5 点ずつで計算)。記録として残します。
「読めば理解できる」状態には達していたのですが、白紙から出すと落ちる箇所がありました。しかも落ちた場所には共通点があって、すべて「対応関係の向き」でした。
間違えた問題1:ACF と PACF の対応を逆にした
問:ACF がゆっくり減衰して続き、PACF がラグ2で切れました。どんなモデルですか。
私の答えは MA(1)。正解は AR(2) です。
実測で並べると一目瞭然でした。
| ACF ラグ1〜5 | PACF ラグ1〜5 | |
|---|---|---|
| AR(2) | (続く) | (ラグ2で切れる) |
| MA(1) | (ラグ1で切れる) | (続く) |
MA(1) だとACF がラグ1で切れてしまい、問題文の「ゆっくり減衰して続く」に反します。
第7節で「道具とモデルの言語」の話まで理解したつもりでいたのに、いざ問われると対応が逆に出ました。頭文字が PACF ↔ AR で交差しているのが原因だと思います。「PACF が切れたら p が決まる」と結びつけるのが確実です。
間違えた問題2:過剰差分という名前が出なかった
問:差分を取ったら、ラグ1自己相関が になりました。何が起きましたか。
私の答えは「これだけだとなんとも言えないが、線形+ノイズの式に対して差分を取っている」。方向は合っていますが、「過剰差分」という診断が出ませんでした。
という負の自己相関は、差分という操作が作り出したものである可能性が高いです。元が定常 AR(1) だと仮定すれば から 、つまり元データはほぼホワイトノイズだったと逆算できます。
ただし節5-1で見たようにトレンド定常でも差分すると が出るので、 という値だけから「AR(1) でほぼ白色」と「トレンド定常」を区別することはできません。どちらにしても差分は不要だったという診断は同じです。
対処は差分を取り消して元に戻し、必要ならトレンド除去に切り替えることです。
惜しかった問題:DF 検定が専用表を要る理由
問:Dickey-Fuller 検定で、通常の 分布表を使ってはいけないのはなぜですか。
私の答えは「求める対象の変数が自分自身に依存しているため、正しく検出できない」。これは AR 一般の説明で、DF 検定に固有の理由になっていません。
正確には「帰無仮説()のもとでは説明変数 自体が非定常なので、 の推定量が漸近正規性を持たず 分布に従わない」。単位根の検定が単位根の影響を受ける自己言及構造です。
正解できた問題
- 非定常な回帰で壊れるのは分子か分母か → 分母(標準誤差)
- MA(1) の ACF ラグ2 は「ほぼゼロ」か「厳密にゼロ」か → 厳密にゼロ
- AR(1) で ACF ラグ2 が 0.49 になる理由 →
- DF 検定で棄却できなかったとき「単位根がある」と結論してよいか → 「単位根がないとは言えない」が正しい
最後の問題は表現まで含めて正解でした。DF 検定は で検出力 34.5% しかないので、棄却できないのは「単位根がある証拠」ではなく「区別できるほどのデータがない」ことの方が多いのです。
ラグ1自己相関 0.9 の系列は差分すべきか
もう1問、部分正解だったものを挙げます。「差分と直線それぞれの自己相関を計算して比べる」という方針は正しかったのですが、選択肢を2つしか挙げられませんでした。
正しくは3通りあります。
- 単位根 → 差分を取る
- トレンド定常 → 直線を引く
- 定常な AR(1) で → 何もしない( を推定する)
3番目が抜けていました。そして判定手順としては ADF 検定があります。
12. 試験対策:出題されやすい順
| 優先度 | 項目 | 問われ方 |
|---|---|---|
| 最優先 | ACF / PACF の読み取り | コレログラムの図から次数を答える/どちらが切れるかの対応 |
| 最優先 | 定常性・単位根 | 定常性の定義(3条件)/ランダムウォークが非定常な理由/差分の必要性 |
| 高 | AR / MA / ARMA の理論 ACF | AR(1) の ACF が /MA(1) の ACF ラグ1が |
| 高 | DF / ADF 検定 | 帰無仮説の向き( が単位根)/片側検定/通常の 表を使えない |
| 中 | AR の定常条件 | AR(1) は 、AR(2) 以上は特性方程式の根が単位円の外 |
| 中 | ラグ演算子・ARIMA の表記 | の形/ の意味 |
| 低 | Ljung-Box・AIC | 使いどころと向き( 値が大きいと OK) |
| 低 | 共和分・スペクトル・状態空間 | 用語の意味と使いどころのみ |
13. まとめ
この回で確かめたこと
| 問い | 答え |
|---|---|
| なぜ定常性が必要か | 定常なら「時間方向にずらす」ことが繰り返し観測の代わりになる。非定常だと時刻ごとに別のルールなので何期集めても同じものの繰り返しにならない |
| 見せかけの回帰の正体 | 「相関が生まれる」のではない(符号は正 50.6% / 負 49.4% のコイン投げで、平均は )。まず 標準誤差が 6.22倍 過小。ただし が正しいのは平均だけで、 を20倍にしてもSDは 0.63 のまま縮まない(一致性がない)。だから を直すだけでは足りず差分が必要になる |
| なぜ を増やすと悪化するか | が で育つ。定常なら で情報の増え方が測れるが、 は式の適用域外で、実際は が に比例して増える。集めるほど悪くなる |
| 正規分布は関係あるか | まったく無関係。 ノイズをコイン投げ・・一様に変えても棄却率は 75〜77% で同じ。効くのは「累積和にした」構造だけ |
| の正体 | 「 個ぶんの独立な情報がある」という主張。 の共分散項がゼロだから で割れた |
| が見落とすもの | 並び順。 は各点から平均までの距離しか測らない(実測で が大きい方が区間を外した) |
| 平均と回帰の共通点 | どちらも加重和で、どちらも共分散項=0 の仮定から を出している。だから同じ理由で壊れる |
| 目に見える形 | 残差の自己相関。非定常の回帰で 0.858、DW比 0.171。第17回のダービン・ワトソン比の極端版 |
| 弱定常の定義 | ①平均 ②分散 ③ラグ の共分散が時刻によらない。ランダムウォークは①を満たす(非定常=トレンドありではない) |
| 条件③の読み方 | 自己共分散の表を横に読むと一定、縦に読むと で減衰。単位根では横が違い縦が減衰しない |
| の意味 | 落ち着き先の標準偏差 が発散する点。崖ではなく坂( で既に 12.5% 棄却) |
| 「単位根」の由来 | ラグ演算子で と書いたときの特性方程式の根が 1。定常条件は根が単位円の外 |
| 差分はいつ取るか | のときだけ。 に使うと の負の自己相関を作る(過剰差分) |
| トレンド定常との区別 | 確定的トレンドは直線を引く、確率的トレンド(単位根)は差分。見た目では区別できない(自己相関 0.922 vs 0.943) |
| AR と MA の違い | AR は過去の自分(鎖なので影響が無限に伝わる)、MA は過去のノイズ(箱が2個ずつ重なるだけ) |
| ACF と PACF の違い | ACF は単回帰の傾き、PACF は重回帰の偏回帰係数(間の期を固定する) |
| なぜ AR で PACF が切れるか | ACF ラグ2 の 0.49 は =遠回りの経路。直接効果はゼロ |
| 層別で見ると | 全体では傾き 0.489 だが、 を固定した各層は水平(、、)。シンプソンのパラドックスと同型 |
| なぜ MA で ACF が切れるか | 共分散は共有ノイズを数える計算なので、箱が重ならないラグで厳密にゼロになる |
| 見分け方の本質 | 道具とモデルの「言語」の一致。 PACF は過去の自分の言葉、ACF はノイズの言葉。一致した側だけ切れる |
| 覚え方 | ACF が切れたら MA、PACF が切れたら AR。頭文字が逆(PACF ↔ p) |
| DF 検定の中身 | の を片側検定するだけ |
| DF が専用表を要る理由 | 帰無仮説のもとで が非定常なので 分布に従わない。 表を使うと誤り率 45.7% |
| DF の弱点 | 検出力。 で 34.5% しか見抜けない( なら 97.4%) |
| ADF が必要な場面 | 差分に負の MA 成分があるとき。 で DF は 99.8% 誤判定 |
| 共和分 | 個々は単位根だが線形結合が定常。差分すると長期の関係が消えるので ECM を使う |
| ブログPVのモデル | 曜日はダミー変数、粘りは AR(1)。 季節差分は過剰(ラグ7が に反転) |
| 予測で効く順 | 季節性 > 回帰化 > AR(1) 。凝ったモデルより曜日と対数変換 |
| AR が長期予測に効かない理由 | で消える()。AR は短期予測の道具 |
自分が間違えていたこと
この回で誤解していた点を残します。
- 「見せかけの回帰は無関係な2本に相関が生まれる現象」だと思っていた。 違う。符号は正負50%ずつのコイン投げで、傾きは平均としてはゼロ。まず標準誤差の申告が 6.22倍甘い(推定値の側にも別の問題があり、それは項目8)。
- 「ホワイトノイズは正規分布だから真ん中に寄る」と考えた。 正規分布は無関係。コイン投げでも一様分布でも同じ結果で、効くのは「累積和」という構造だけ。
- 「 なら だから系列が線形に近くなる」と考えた。 累積和は直線ではない( の符号がランダムなので折れる)。散布図8組を並べると L字型や2塊など多様で、直線的なのは一部だけ。
- 「AR(1) なら前の値との差分を取れば自己相関が消える」と考えた。 差分が必要なのは のときだけ。 は既に定常で、差分すると の負の自己相関を作る。定常な系列の自己相関は消すべき問題ではなく、推定して使う情報。
- ACF と PACF の対応を逆にした(自己診断で発覚)。PACF ↔ AR が組。
- 負の自己相関を見て「過剰差分」と診断できなかった(自己診断で発覚)。
- DF 検定が専用表を要る理由を一般論で答えた(自己診断で発覚)。「帰無仮説のもとで説明変数が非定常」が核心。
以下は記事を書き上げた後の査読で見つかった誤りです。
- 「壊れているのは標準誤差だけで推定値は正しい」と書いていた。 平均としては正しいが、 の標準偏差は を20倍にしても 0.63 のまま縮まず、一致推定量ですらない。「 を直せば済まない」という節2-7の結論と、まとめの「 が過小なだけ」が矛盾していた。
- で が理論値に届かない理由を「過渡期だから」と説明していた。 バーンインを3000ステップ入れても届かない。真の理由は「窓に収まらない長周期のうねりが標本平均に吸収される」で、これは節2-2の「 は並び順を見ない」と同じ現象だった。自分の記事の一番いい筋を取り逃していた。
- 「90.2倍」と「4.59倍」を同じことの2表現のように書いていた。 前者はホワイトノイズとの比、後者は公式の分母 に対する比で、分母が違う。
- MA(1) = AR() に反転可能性()の条件を書いていなかった。 と が同じ ACF を与えるという重要な事実も落ちていた。
- Engle-Granger の残差 DF 検定に通常の DF 臨界値を当てていた。 残差は回帰で最小化された量なので臨界値がさらに左にずれる( を使うとサイズが 14.1%)。
- ランダムウォークの分散の表で、時刻ラベルが1つずれていた(配列の添字を時刻として書いたため、理論値 に対して表は の値)。
- PV の対数変換を第19回の参照としていたが、正しくは第17回(不均一分散への対処)。
検証に使ったコード
scipy が使えない環境だったので、以下は自作しました。
- 自己相関関数・偏自己相関関数(Levinson-Durbin の再帰式)
- Dickey-Fuller 検定・ADF 検定と、その臨界値(20000回のシミュレーションから)
- Newey-West(HAC)標準誤差
- Ljung-Box 検定( の上側確率は正則化不完全ガンマ関数を級数と連分数で評価)
- AIC / BIC による次数選択
分布の上側確率と 分布の分位点は、第17回で作った自作モジュールを再利用しました。
なお PACF の実装では、素朴に「次数ごとに重回帰を解く」方法だと標本数が次数によって変わってしまいます。Levinson-Durbin を使うとこの問題が起きません。AIC の計算でも同じ罠を踏んで、最初は AIC の正解率が 0% になりました(次数ごとに標本数が変わって対数尤度が比較できていなかった)。最大次数に合わせて標本を固定したら 72〜76% という妥当な値になりました。
次回
次回は第28章の分割表です。
今回「時間方向に並んだデータ」を扱いましたが、次はカテゴリを2方向に並べたデータが対象になります。第14回で扱った 適合度検定が、行と列の2方向に拡張されます。
そして今回の「見かけの関係と直接の関係を分ける」という発想も再登場します。今回は を固定して の効果を測りましたが、分割表では第3の変数で層別すると関係が逆転する(シンプソンのパラドックス)という形で現れます。今回の層別の散布図がその予告編になっていました。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。