打ち切りを捨てると寿命が77%短く見える:生存時間解析【第19回】
はじめに
第19章は回帰分析その他です。教科書ではこの章に生存時間解析・正則化・非線形回帰が同居していて、一見すると寄せ集めに見えます。ただ実際に手を動かしてみると、ここに並んでいる手法はどれも「普通の最小二乗法では扱えないもの」への対処でした。生存時間解析は「値が分からない行」への対処、正則化は「変数が多すぎる」への対処、平滑化は「直線では足りない」への対処です。
今回いちばん驚いたのは最初の実験でした。サブスクの平均継続月数を推定するとき、「まだ解約していない人」を分析から外すと、真の12ヶ月が2.75ヶ月に見えます。77%の過小評価です。 月次のマージンが一定ならLTV(顧客生涯価値)の見積もりが4分の1以下になるということで、これは投資判断が変わる規模の誤りです。
そしてその誤りを避ける仕組みが、驚くほど素直でした。「6ヶ月以上続いた」という不等式の情報を、そのまま確率として尤度に書く。 それだけです。欠測データのように「何も分からない」のではなく、不等式という使える情報が残っている——この見方に切り替わった瞬間に、章全体が繋がりました。
もうひとつ引っかかったのがハザード関数でした。「その時点まで生きていた人が次の瞬間に死ぬ率」という説明は読んでいたのですが、密度関数と何が違うのかがピンと来ていませんでした。結論としては分母が違うだけです。これも図にすると一瞬で片付きました。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
- 連載全体の目次は 統計検定準1級 独学記事インデックス にあります。
- 記号で迷ったら 統計の記号がややこしいのは軸が2本あるからだった を先に読んでください。
- 指数分布と無記憶性は 第5回 で扱っています。今回のハザードの話はそこと直結します。
- オッズ比は 第18回 で扱いました。今回はハザード比との違いを整理します。
この記事で使う言葉
先に5語だけ固めます。この記事はこの5語で回ります。
生存時間(survival time):ある時点から「イベント」が起きるまでの時間。医学では死亡までの時間ですが、工学では故障までの時間、Webサービスでは解約までの時間です。時間そのものが分析対象になるのが特徴です。
打ち切り(censoring):イベントがまだ起きていないために、正確な時間が分からない状態。「少なくとも6ヶ月は続いた」という不等式の情報だけを持っています。以下、断りなく「打ち切り」と書いたときは右打ち切り(right censoring)を指します。
生存関数(survival function):、つまり時刻 を過ぎてもイベントが起きていない確率。サブスクなら「 ヶ月後の継続率」です。
ハザード関数(hazard function):「 まで生き残った人が、次の瞬間にイベントを起こす率」。確率ではなく率なので1を超えることがあります。
比例ハザードモデル(proportional hazards model):Cox(コックス)が提案した回帰モデル。共変量がハザードを何倍にするかで効果を表します。HR(Hazard Ratio=ハザード比)がその倍率です。
TL;DR
- 打ち切りを捨てると平均寿命が2.75ヶ月に見える(真値12ヶ月、−77%)。イベント扱いすると4.72ヶ月(−61%)。どちらの誤りも「短い」側に出る
- 正しい扱いは尤度に として入れること。5人のデータなら手で追える。打ち切りは「総観測時間には入るがイベント数には入らない」
- ハザードと密度の違いは分母だけ。密度は「最初にいた全員」、ハザードは「その時点まで生き残った人」が分母
- ハザードが一定 ⟺ 指数分布 ⟺ 無記憶性(第5回と同値)。現実にはほぼ成り立たないのでワイブル分布が要る
- カプラン・マイヤーが階段になるのは情報が入る時刻が離散的だから。自作実装が教科書値7点と完全一致
- ログランク検定は 、 で教科書値と一致。「観測−期待」で測る
- Cox回帰の部分尤度は「いつ」を諦めて「誰に」だけを使う。 が分子と分母で約分されて消える
- 3つの違うベースラインから同じハザード比2.0を回収できることを実測(1.982 / 2.007 / 1.942)
- リスク比2.00・オッズ比3.50(発生率60%対30%)。オッズ比は常に1から遠い側に出る
- Lassoが0にするのは 制約の角が軸上にあるから。同じ設定でLasso 、リッジ
- 多項式の次数を上げると訓練誤差は単調に下がるがテスト誤差は6次で底を打つ(15次で1.098に暴走)。訓練誤差が を下回っても過学習の証拠にはならない(バイアスが消えれば まで下がる)
なぜ普通の回帰では扱えないのか
まず何に使うのかから入ります。このブログのようなサブスクサービスで「顧客は平均で何ヶ月続くのか」を知りたいとします。LTVの計算に必要な数字です。
ところがサービスを始めて6ヶ月しか経っていないとき、困ったことが起きます。まだ解約していない人が大勢いる。 この人たちの解約月は分かりません。分かっているのは「少なくとも6ヶ月は続いた」ということだけです。
普通の重回帰(第16回)が使えないのは、目的変数の値が数値として手元にない行があるからです。 に何を入れればいいのか決まらない。
ここで大事なのは、これは欠測(missing)とは違うという点です。欠測は「何も分からない」ですが、打ち切りは という不等式の情報を持っています。この違いが分かってから、章の見通しが一気に良くなりました。
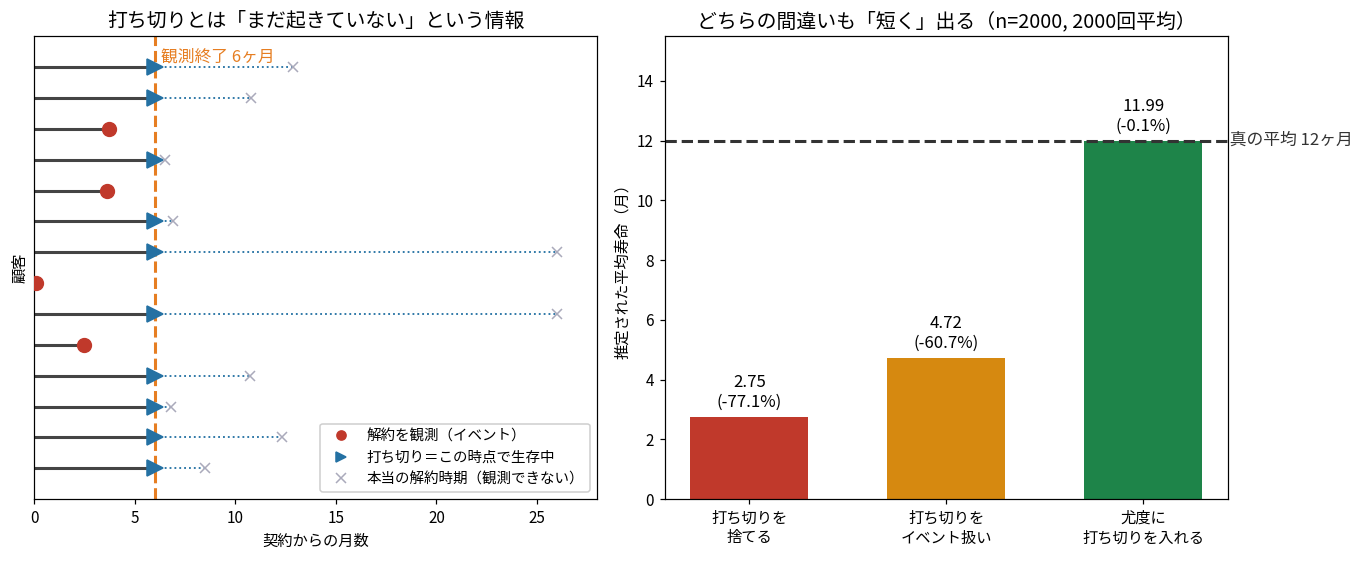
左の図で、青い三角のところで観測が終わっています。灰色の×は神様だけが知っている本当の解約時期です。右の図が結果で、真の平均は12ヶ月(指数分布、 を2000回反復)。
| 打ち切りの扱い | 推定された平均寿命 | バイアス | 理論値との照合 |
|---|---|---|---|
| 捨てる(解約した人だけで平均) | 2.7504 ヶ月 | −77.1% | |
| 打ち切り時刻をイベント扱い | 4.7192 ヶ月 | −60.7% | |
| 尤度に打ち切りを入れる | 11.9858 ヶ月 | −0.1% | 真値 12 |
注目すべきは、2つの誤りがどちらも「短い」側に出ることです。 バイアスの向きが一方向に決まっているので、気づかないまま使うと必ず寿命を過小評価します。
理由は別々です。捨てる場合は、6ヶ月以内に解約した人だけが残ります。つまり「早く辞めた人」を選んで集めていることになる。長く続く人ほど「観測できない」側に回るので、標本が体系的に短命側に偏ります。これは選択バイアスです。
イベント扱いする場合は、6ヶ月時点で継続中の人を「6ヶ月で解約した」と記録します。本当は12ヶ月、30ヶ月続く人を全員6ヶ月に切り詰めているので、 の平均になります。打ち切り率が高いほど傷が深くなる性質があり、今回は打ち切り率が60.7%でした。
尤度に「不等式」を書く
正しい扱い方は尤度の書き方にあります。イベントを観測した人は密度 を、打ち切られた人は生存関数 を掛けます。
は「イベントを観測したか」の指示変数です。打ち切りの行は として尤度に参加している——捨てられていません。
と と の関係
ここで記号を整理しておきます。筆者はこの3つの関係が曖昧だったので、いちど明示的に確認しました。
が累積分布関数(CDF: Cumulative Distribution Function)、 が生存関数です。 は統計学一般では上側確率、相補累積分布関数とも呼ばれます。
生存時間解析でわざわざ ではなく を主役にするのは、「まだ起きていない確率」の方が直接使いたい量だからです。打ち切りの尤度がまさにそれですし、実務的にも を「 ヶ月後の継続率」として読む方が自然です。
指数分布(平均 )での形はこうなります。
次の節で使う 、 で数値を確認すると、(6ヶ月後の継続率42.4%)、、足すと 1.000000。モンテカルロで を400万件試すと 0.424050 でした。
なお は確率ではありません。 密度に幅を掛けて初めて確率になります(番外編・期待値の定義で扱った話と同じ)。実測すると で、 とほぼ一致しました。厳密には尤度で掛けているのは ですが、 は に依存しない定数なので最大化の答えは変わりません。だから省略できます。
尤度関数の形は「決まっていない」
ここは筆者が誤解していた点です。尤度関数の形は最初から決まっているわけではなく、分布を仮定して初めて決まります。
式の中で が出てきたのは「解約までの時間は指数分布に従う」と仮定したからです。ワイブル分布を仮定すれば別の形になります。つまり尤度は枠で、分布が中身です。
そしてこれが、次に出てくるカプラン・マイヤー推定量との違いになります。KMはこの枠を使いますが、 と に特定の分布の形を入れず、分布そのものを自由に動かして最大化します。その結果が階段関数になります。
5人のデータで実際に数値を入れる
式だけでは掴みにくいので、5人に減らして手で追えるようにします。観測は6ヶ月で終了とします。
| 分かっていること | 尤度に掛けるもの | |
|---|---|---|
| Aさん | (解約を観測) | 密度 |
| Bさん | (解約を観測) | 密度 |
| Cさん | しか分からない | 生存確率 |
| Dさん | しか分からない | 生存確率 |
| Eさん | (解約を観測) | 密度 |
尤度の考え方はこれだけです。 尤度とは「そのパラメータのもとで手元のデータが起きる確率(っぽさ)」なので、各人について「その人について分かっていることが起きる確率」を書いて掛ければいい。Aさんは「2ヶ月で解約した」の確率っぽさ、つまり 。Cさんは「6ヶ月以上続いた」の確率、つまり です。
不等式の情報しかないなら、不等式の確率をそのまま書く。 は普通に計算できる量なので何も困りません。これが「まだ起きていない」の組み込み方です。
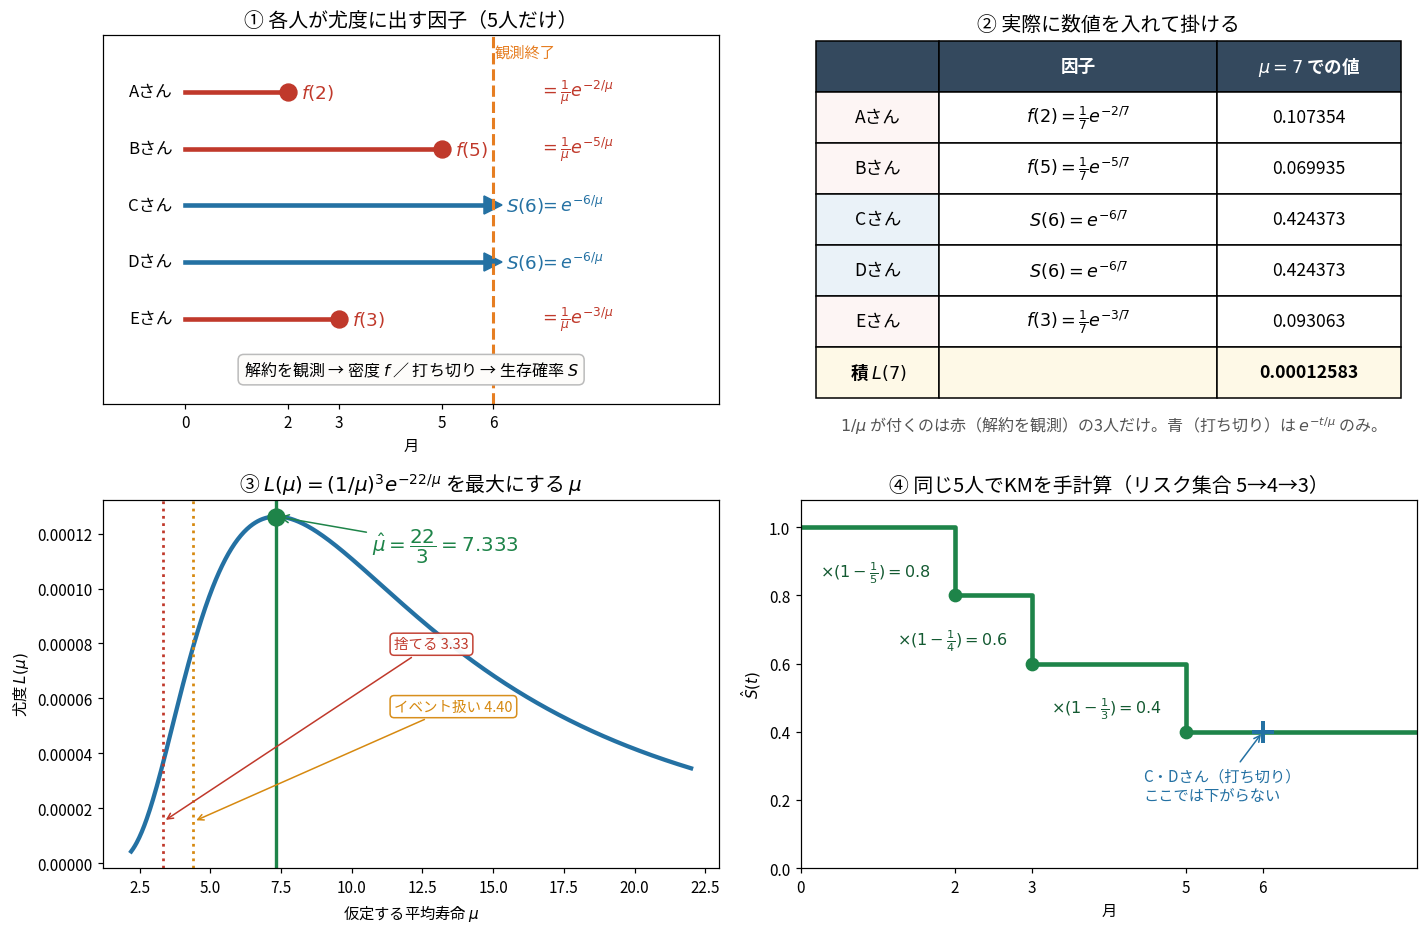
平均 と仮定して数値を入れます。
全部掛けると です。
ここできれいなことが起きます。 が付くのは密度の3人だけで、指数部分は全員が なので、指数法則でまとめられます。
打ち切りの人は指数の中(総観測時間22)には入るが、 の肩(イベント数3)には入らない。 これが打ち切りの正体です。打ち切りデータは「時間を提供するが、イベントは提供しない」という形で貢献します。
を微分して0にすると 。数値探索でも 7.333341 で一致しました。
図の左下がこの尤度曲線です。誤った2つの推定値(3.33 と 4.40)が、どちらも頂点より左側に並んでいるのが見て取れます。
これで分母が ではなくイベント数だった理由も見えます。同じ5人から3つの推定値を出すとこうなります。
| 方法 | 計算 | 値 | 何が起きているか |
|---|---|---|---|
| 打ち切りを捨てる | 3.333 | 分子から ヶ月が消える | |
| 打ち切りをイベント扱い | 4.400 | 分母が に増える | |
| 正しい最尤推定 | 7.333 | 時間は全員分、イベントは3件 |
分子を削るか、分母を膨らませるか。 どちらも小さくする方向で、これが先ほどの −77% / −61% の縮小版です。一般に指数分布なら になります。
打ち切りが許される条件
この仕組みには前提があります。打ち切りの理由がイベントと無関係であること(独立打ち切り、independent censoring)です。
「観測期間が終わった」は無関係なので問題ありません。しかし「解約しそうな人が先に調査から抜ける」なら、打ち切り自体が情報を持ってしまい、以下のすべての手法が偏ります。実務ではここが一番危ない前提です。Webサービスなら「アカウント削除で追跡不能になった人」は解約と相関しているので、この前提が崩れます。
補足を2つ。ひとつは条件付きでよいということです。Cox回帰では「共変量 を与えたもとで打ち切りと生存時間が独立」であれば十分で、無条件の独立は要りません。「プランによって観測期間が違う」ようなケースは、そのプランを共変量に入れておけば救われます。実務では効く緩和です。
もうひとつは、打ち切り分布を無視して だけを最大化してよい根拠が「生存時間分布のパラメータと打ち切り分布のパラメータが共通でない」ことにある点です。この条件があるので、打ち切りの発生の仕方を尤度に書かなくても の推定に影響しません。上で を省略できたのと同じ論法です。
ハザード関数は分母が違うだけ
ハザードは筆者が最もつまずいた概念でした。「その時点まで生きていた人が次の瞬間に死ぬ率」という理解自体は正しかったのですが、密度関数と何が違うのかが分かっていませんでした。
答えは分母です。密度 は「最初にいた全員」を分母にした割合。ハザード は「 まで生き残った人」を分母にした率です。
条件付き確率になっているのがポイントで、 で割ることが「生き残った人だけを分母にする」操作にあたります。
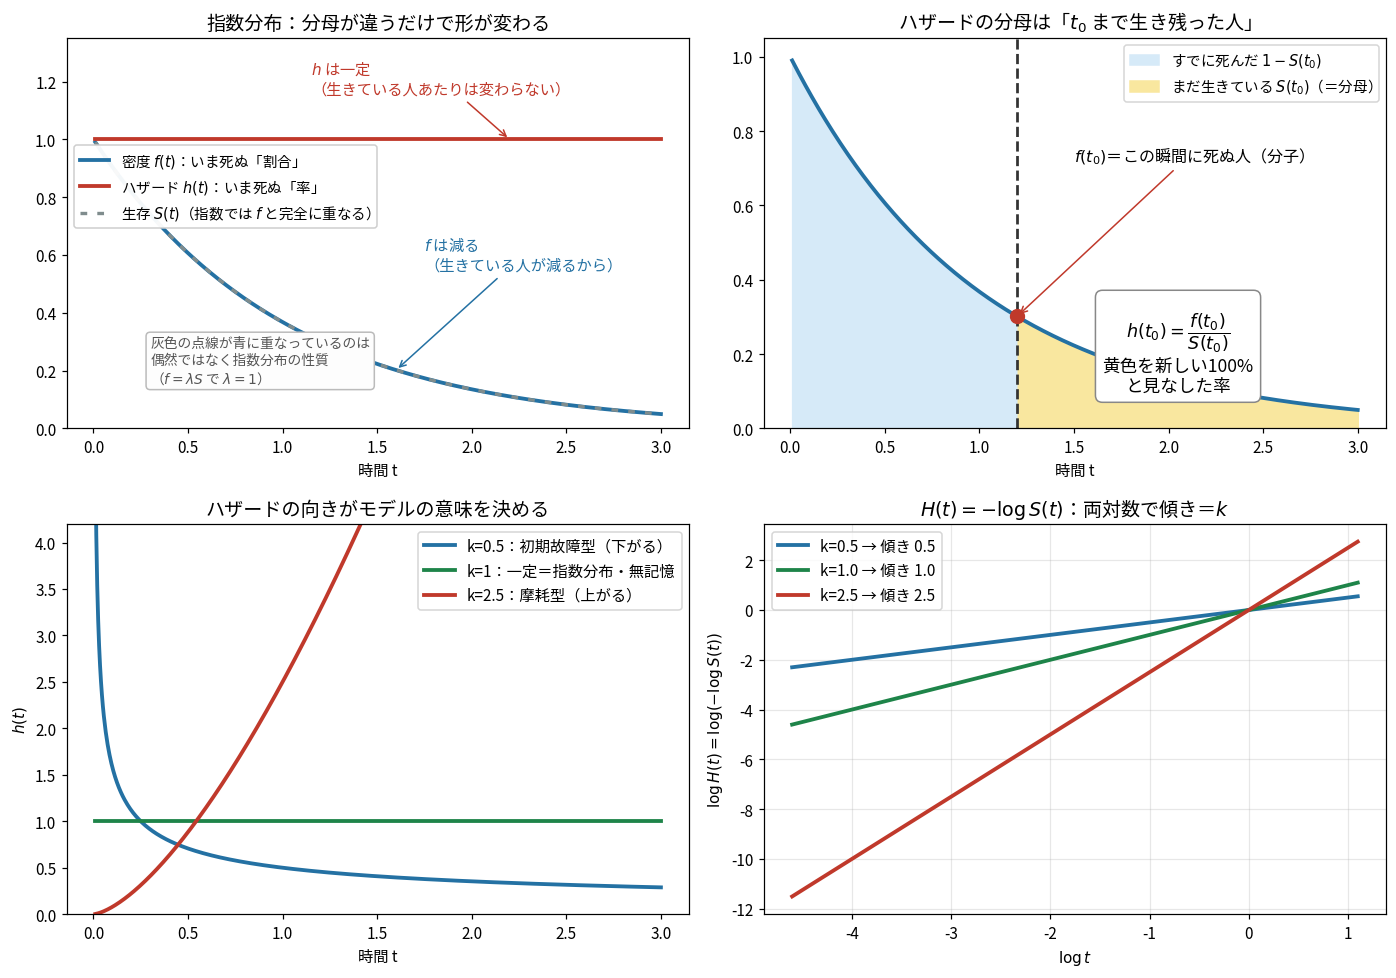
右上のパネルが定義そのものの図です。 黄色い部分(まだ生きている人)を「新しい100%」と見なして、その中でいま死ぬ人の割合を測る。だから分母が時間とともに小さくなり、 と の形が食い違います。
左上のパネルが一番分かりやすい例です。指数分布では が減っているのに は一定です。生きている人が減っているから死亡数()は減りますが、1人あたりの危険度()は変わらない。同じ現象を違う分母で見ているだけです。
なお左上で灰色の点線()が青()に完全に重なっていますが、これは作図のミスではなく指数分布の性質です。 なので、 のときは一致します。
ハザードは確率ではありません。 で割っているので単位時間あたりの率であり、1を超えます(図の左下で の赤い曲線が で4を超えてグラフの上端に消えていきます)。「確率」と読むと1を超えた瞬間に破綻します。速度メーターだと思うのが正しい理解で、時速120kmが「120個の何か」でないのと同じです。
第5回の無記憶性とつながる
第5回で扱った無記憶性と、ハザード一定は同じことの言い換えです。3行で往復できます。
(定数)とすると、 という関係から積分して 。ここで (時刻0では全員生きている)なので 、よって 。これは指数分布そのものです。逆も辿れるので同値になります。
| 言い方 | 意味 | 第5回との対応 |
|---|---|---|
| ハザードが一定 | いつでも危険度が同じ | — |
| 無記憶性 | 幾何分布(離散)/指数分布(連続) | |
| 累積ハザードが直線 | が に比例 |
実務的な意味は「これまで3年続いた顧客は、これから続く期間の分布が新規顧客と同じ」です。そしてこれは現実にはほぼ成り立ちません。 だから のワイブル分布が必要になります。
図の左下がその比較です。 なら使うほど壊れる(摩耗型)、 なら初期に脱落しやすく生き残るほど安定する(初期故障型)。サブスクの解約は 型が多いはずで、最初の数ヶ月で辞める人が多く、1年続いた人は続きやすい、という実感と合います。
4つの関数は全部同じ情報
、、、 のどれか1つが分かれば残り3つが決まります。言い換えの体系にすぎません。
累積ハザード が便利なのは、両対数プロットで直線になり傾きが を教えてくれるからです(図の右下)。推定した曲線がどのモデルに合うかを目で判定できます。この性質は後で比例ハザードの確認にも使います。
なお と が使えるのは が連続分布で の範囲です。離散の場合(あるいは次に出てくるKM推定量のような離散的な推定値)では であって とは一致しません。試験で関係式の変換を問われるのは連続分布の文脈なので実害は少ないのですが、KM曲線から を作る場面では意識しておくと安全です。
カプラン・マイヤーはなぜ階段なのか
分布を仮定せずに を推定したい。そのための方法がカプラン・マイヤー推定量(KM)です。
はその時刻の死亡数、 はリスク集合(その時点でまだ観測下にある人数)です。
階段になる理由は、情報が入ってくる時刻が離散的だからです。 死亡が起きていない時刻では なので掛ける数が1になり、曲線は動きません。だから死亡時刻だけで下がる階段になります。
滑らかにできないのは、データが「イベントの間に何が起きたか」を一切語らないからです。滑らかに繋ぐには分布の形を仮定するしかなく、それをやらないのがKMの売り(ノンパラメトリック)です。第15回で扱った「分布を当てにするのをやめる」という思想がここにも出てきます。
なお「尤度を使わないから階段になる」わけではありません。KM推定量もれっきとした最尤推定量です。 ただし特定の分布族の中で のようなパラメータを動かすのではなく、あらゆる分布を候補にして尤度を最大化します(各時刻の離散ハザード を自由に動かして を最大化すると 、すなわちKMが出てきます)。その解が「観測された時刻に確率が集まった離散分布」になるので階段が現れる、というのが正確な順序です。
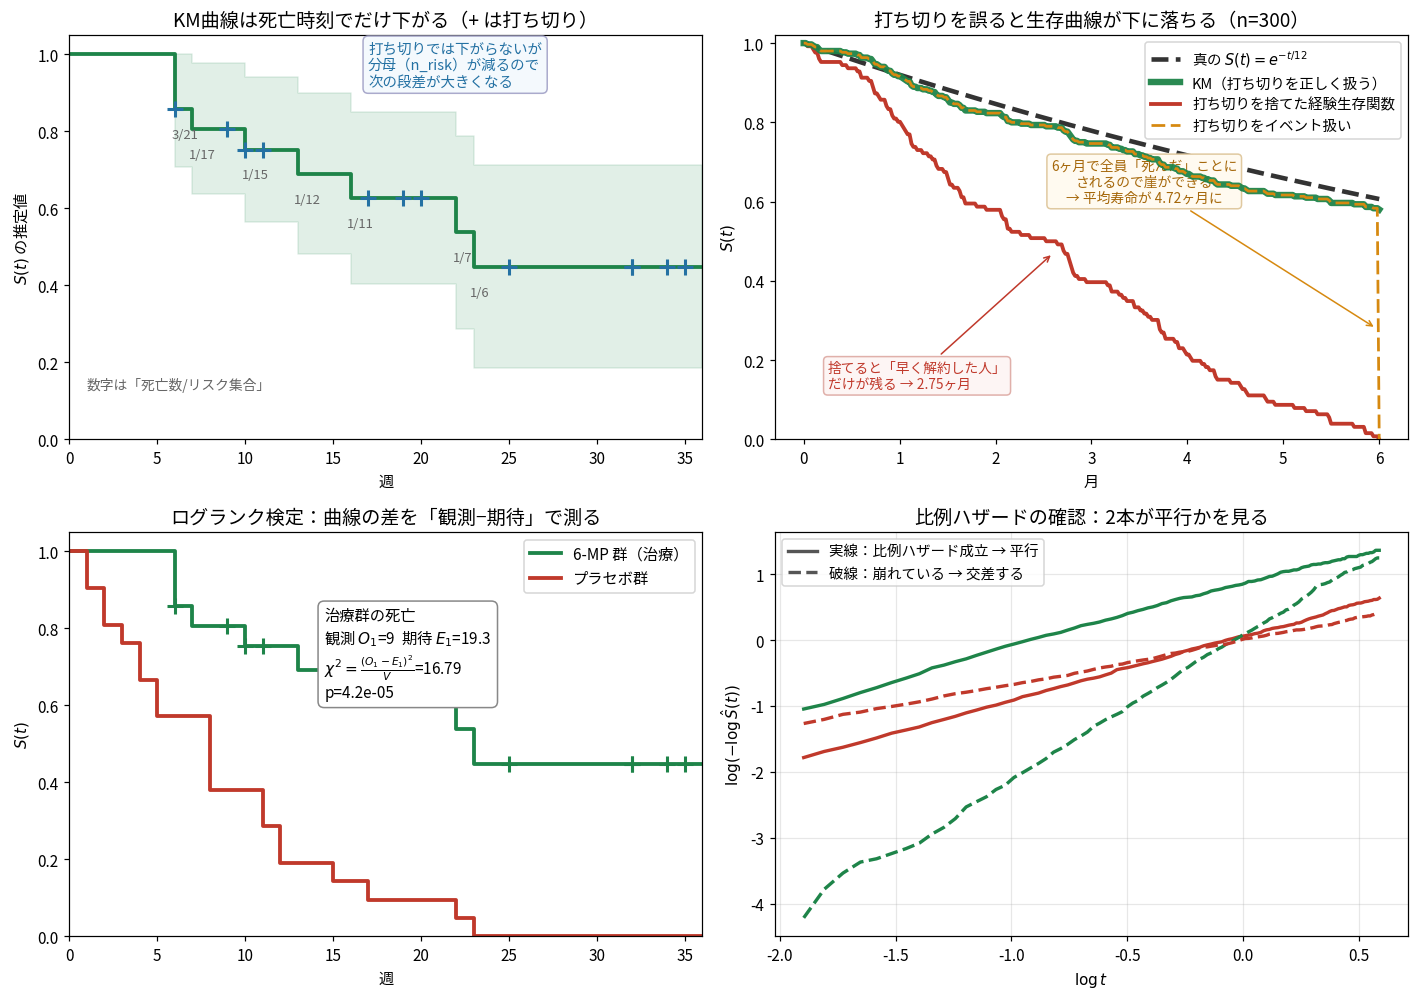
掛け算にする理由は条件付き確率の連鎖です。「23週生きる」は「6週を生き延び、かつその後7週を生き延び、かつ…」と分解できます。各段階でリスク集合が違うので、それぞれの条件付き生存率を掛けます。
この形なら途中で人が抜けても(打ち切り)分母を調整するだけで対応できる——ここがKMの発明です。
教科書の定番データ(Gehanの白血病データ、6-MP群)で自作実装を検算しました。
| 週 | リスク集合 | 死亡 | 自作実装の | 教科書値 |
|---|---|---|---|---|
| 6 | 21 | 3 | 0.8571 | 0.8571 |
| 7 | 17 | 1 | 0.8067 | 0.8067 |
| 10 | 15 | 1 | 0.7529 | 0.7529 |
| 13 | 12 | 1 | 0.6902 | 0.6902 |
| 16 | 11 | 1 | 0.6275 | 0.6275 |
| 22 | 7 | 1 | 0.5378 | 0.5378 |
| 23 | 6 | 1 | 0.4482 | 0.4482 |
7点すべて一致しました。ここで注目したいのが6週で と4人減っているのに死亡は3人という点です。差の1人が打ち切りです。
図の左上で、青い +(打ち切り)のところでは曲線は下がりませんが分母が減っています。だから次の段差が大きくなります。これが打ち切りの情報の使われ方で、先ほどの尤度で を掛けたことと同じ役割です。尤度では因子として、KMではリスク集合の頭数として、同じ情報が別の形で使われています。
さきほどの5人のデータでもKMは手計算できます。
リスク集合が と減るのは解約した人が抜けているだけです。打ち切りのCさん・Dさんは の時点でもまだ分母に残っています(6ヶ月まで生きているので)。
図の右上が、打ち切りを誤ったときのKM曲線です。橙(オレンジ)の破線が6ヶ月で崖のように0へ落ちているのが「イベント扱い」の誤りの正体で、赤い線が大きく下に外れているのが「捨てる」の誤りです。太い緑のKM曲線が真の (黒い破線)にきれいに乗っていることも確認できます。なお6ヶ月までは橙の破線が緑と重なっています。「イベント扱い」の誤りは打ち切り時点までは正しく、その先で崖を作るという性質だからです。
信頼区間はグリーンウッドの公式
KM曲線の信頼区間にはグリーンウッド(Greenwood)の公式を使います。図の緑の帯がそれです。
右に行くほど帯が広がるのは、リスク集合が小さくなって推定が不安定になるからです。「曲線の右端は当てにならない」という実務的な教訓がここから出ます。
なお という素朴な区間は をはみ出すことがあります( が0や1に近いとき)。実務では に変換してから区間を作り、それを戻すことで範囲内に収めます。
ログランク検定
2群のKM曲線に差があるかを検定します。考え方は各イベント時刻で分割表を作ることです。
「もし2群に差がないなら、この死亡はリスク集合の人数比で振り分けられるはず」という期待値 を作り、観測 とのズレを積み上げます。
これを自由度1の 分布で判定します(2群比較なので1、 群なら ですが、その場合は上の1自由度の形ではなくベクトル形の統計量になります)。第14回のカイ二乗の発想と同じで、時刻ごとの 表を全時刻で足し合わせたもの(Mantel-Haenszel型)です。なお の時刻では分母の が0になるので、その項は分散0として飛ばします。
自作実装での結果は 、、、、。教科書値(、)と一致しました。
読み方は「治療群では19.3人death するはずが9人しか死んでいない」です。図の左下がその2群の曲線です。
ログランク検定の性質として押さえておきたいのは、比例ハザードが成り立つとき、順位に基づく検定のなかで漸近的に最も検出力が高いという点です(Cox部分尤度のスコア検定と一致します)。無条件に最強という意味ではなく、分布を正しく仮定できるならパラメトリック検定の方が強いこともあります。
逆に言えば、2本の曲線が交差するような状況(ハザード比が時間で反転する)では検出力が落ちます。前半の差と後半の差が打ち消し合うからです。
Cox回帰の部分尤度は何を諦めているのか
共変量(プラン、流入経路、年齢など)の効果を測りたい。そこで登場するのが比例ハザードモデルです。
がベースラインハザードで、これはまったく形を仮定しません(任意の関数でよい)。だからこのモデルは「セミパラメトリック」と呼ばれます。時間の効果は に押し込め、共変量の効果は に押し込む——この分離が肝です。
という形にしてある理由は2つあります。指数関数は常に正なのでハザードが負にならないこと、そして共変量が1増えたときの効果が掛け算(何倍)になることです。第18回のロジスティック回帰でオッズが掛け算になったのと同じ構造です。
何を諦めているのか
結論から言うと、「いつ起きたか」の絶対的な時間情報を諦めて、「誰に起きたか」の順序情報だけを使っています。
各イベント時刻で、リスク集合の中から「この人が選ばれる確率」を計算し、それを掛け合わせます。
この式は同じ時刻に複数のイベントが起きないことを前提にしています。連続時間なら理屈上そうなりますが、実データは「6週」「3ヶ月」のように丸められているのでタイ(同順位)が普通に発生します。上で使ったGehanのデータも6週に3件のタイがあります。
タイがあると上の式が定義できないので近似を使います。Breslow法(分母を共通に使う簡便法。この記事の自作実装もこれ)、Efron法(タイが多いときより正確)、厳密法(離散時間として全ての順序を数え上げる)の3つが主要な選択肢です。統計ソフトによって既定値が違うので、タイの多いデータを扱うときは自分の使うソフトの既定値を確認する必要があります。タイが少なければどれを選んでもほぼ同じ結果になります。
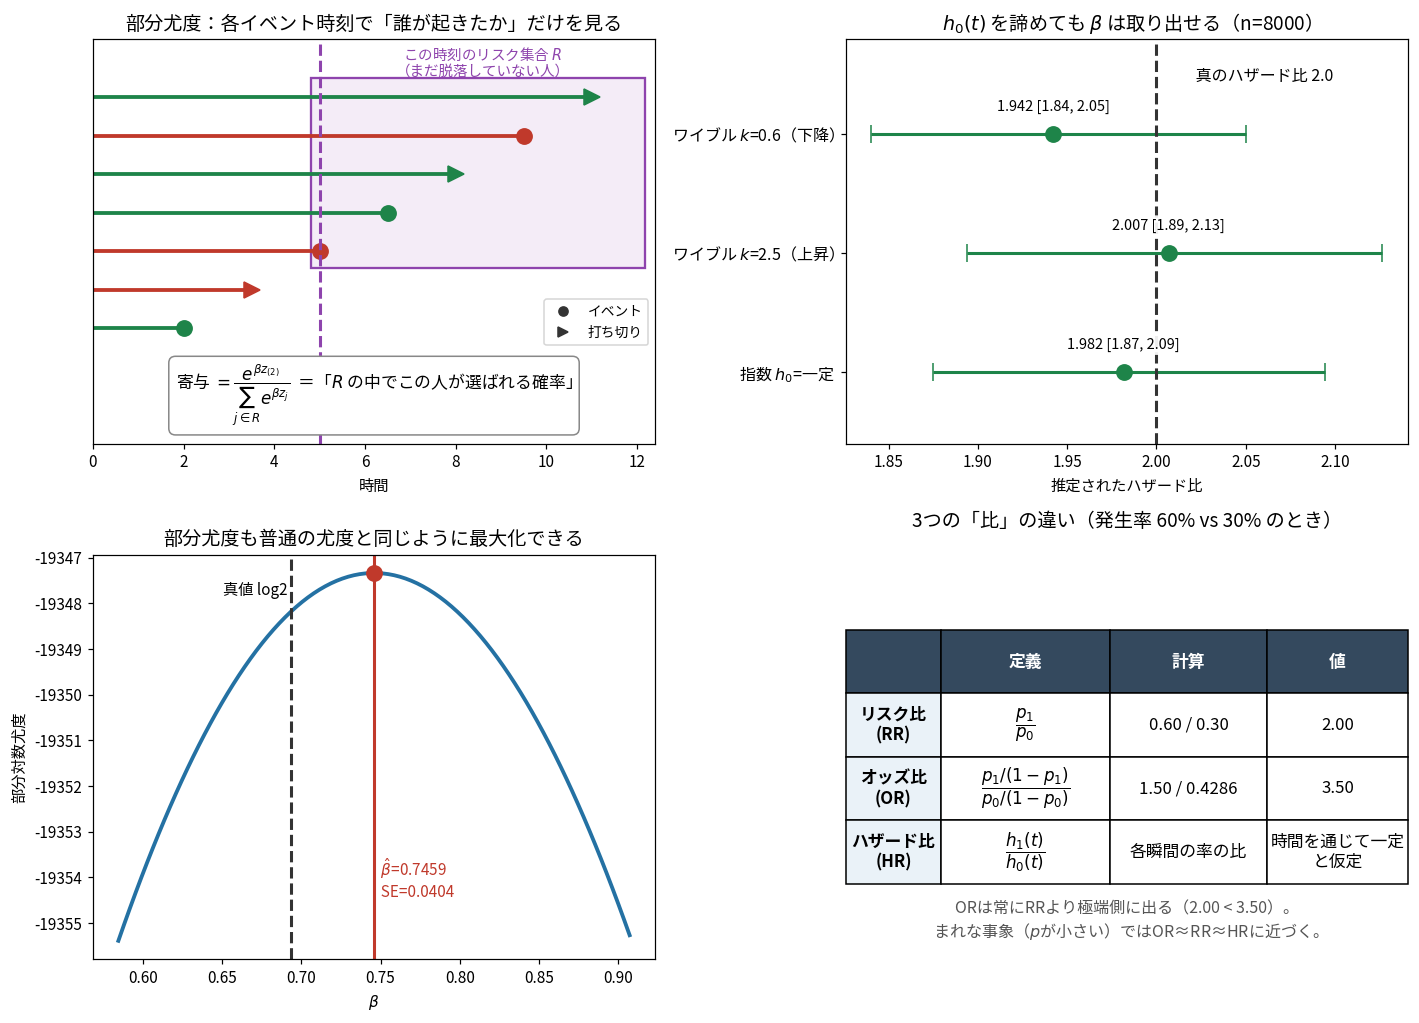
なぜそれで係数が推定できるのか。 分子と分母の両方に が掛かっているので、比を取ると完全に消えます。
つまり「 が何であっても、この確率は だけで決まる」。だから を推定せずに が推定できます。
捨てているのは絶対的な時刻の情報で、実際 を単調増加変換しても(順序が変わらなければ)推定値は1ミリも変わりません。「3ヶ月と4ヶ月」でも「3年と40年」でも、順序が同じなら同じ答えになります。
これが第15回のノンパラメトリック法と同じ発想であることに気づいたときは少し感動しました。値を捨てて順位だけを使う——同じ思想がここにも現れています。
図の右上が確認実験です。まったく違う3つのベースライン(指数、ワイブル の上昇型、ワイブル の下降型)からデータを生成して、いずれも真のハザード比2.0を回収できました(1.982 / 2.007 / 1.942、、独立な乱数)。
代償は効率の若干の低下ですが、モデル誤特定のリスクを大きく減らせる交換として優れています。
図の左下は、この部分尤度を の関数として描いたものです(別のデータセット、 での例なので と真値 が少しずれています。1回の推定にはこの程度のばらつきが乗ります)。上に凸の滑らかな曲線になっていて、普通の尤度と同じようにニュートン法で最大化できることが分かります。「部分」尤度という名前ですが、扱い方は通常の尤度と変わりません。
推定量の性質を確認する
真値既知のシミュレーションで確認しました(真値 、HR = 2)。
| の平均 | バイアス | 実測SD | 平均SE | 95%CI 被覆率 | |
|---|---|---|---|---|---|
| 100 | 0.71114 | +0.01799 | 0.26805 | 0.25918 | 0.9320 |
| 200 | 0.70258 | +0.00943 | 0.17565 | 0.18067 | 0.9610 |
| 1000 | 0.69066 | −0.00249 | 0.08099 | 0.07976 | 0.9460 |
| 5000 | 0.69285 | −0.00030 | 0.03449 | 0.03558 | 0.9590 |
各1000回反復です。 では小標本バイアスが上方に出て被覆率も93.2%とやや低くなっています。これは最尤推定量一般の性質(第10回)と同じで、部分尤度でも同様に現れます。 を増やすとバイアスが と縮み、被覆率は名目95%に落ち着きます。
比例ハザードの仮定はどう確認するか
このモデルの前提は「ハザード比が時間を通じて一定」です。確認方法は3つあります。
| 方法 | やること | 崩れているサイン |
|---|---|---|
| プロット | 群別のKMを 対 で描く | 2本が平行でない・交差する |
| Schoenfeld残差 | 残差を時間に対して回帰し、傾きが0かを検定 | 傾きが有意(HRが時間依存) |
| 時間依存の交互作用 | を入れる | が有意 |
1つめが手軽で、図(19-04)の右下がそれです。実線(比例ハザード成立)は平行、破線(崩れている)は交差します。 なぜ平行になるかは累積ハザードの式から出ます。 なら なので、両辺の対数を取ると 。定数 の差だけの平行移動になります。
崩れていたらどうするか
層別Cox(stratified Cox)が第一選択です。問題の変数を層別因子にすると、層ごとに別の を許すので比例性を要求しなくなります。代償としてその変数のHRは推定できません(消えてしまうので)。
他には時間依存係数にする(期間を分割して前期・後期で別のHRを推定する)、加速故障時間モデル(AFT: Accelerated Failure Time)に乗り換える、RMST(Restricted Mean Survival Time=制限平均生存時間)のように比例性を要らない指標で比較する、という手があります。
ただ実務では「HRが一定でない」こと自体が発見になる場合も多いはずです。治療が最初だけ効くなら、それは臨床的に重要な情報ですし、サブスクなら「あるキャンペーン経由の顧客は最初の3ヶ月だけ解約しやすい」といった知見になります。
ハザード比・オッズ比・リスク比を1つの表で
3つの「比」が混同しやすいので整理します。第18回のオッズ比との違いがここで片付きます。
| 指標 | 定義 | 分母にあるもの | 出てくる場面 | 時間を扱うか |
|---|---|---|---|---|
| リスク比(RR: Risk Ratio) | 全員(最初にいた人) | コホート研究、A/Bテストの CVR 比 | 期間を固定して1つの数字 | |
| オッズ比(OR: Odds Ratio) | 起きなかった人 | ロジスティック回帰、ケースコントロール研究 | 扱わない | |
| ハザード比(HR: Hazard Ratio) | その時点まで生存していた人 | Cox回帰、ログランク検定 | 各瞬間の率の比 |
発生率が60%対30%のときの実際の値はRR = 2.00、OR = 3.50です。オッズ比は常にリスク比より1から遠い側に出ます( が大きいほど乖離が激しい)。
が小さいとき(まれな事象)は なので3つとも近づきます。これがケースコントロール研究でORをRRの代用にできる根拠です。
HRの解釈でよくある誤りを2つ挙げます。
ひとつめは「HR = 2 だから寿命が半分」という読み方です。HRは各瞬間の率の比であって、生存時間の比ではありません。指数分布では なので、この場合だけは「平均寿命が半分」が成り立ちます。ただしこれは指数分布の特殊事情です。ワイブル分布で計算すると、ハザードを2倍にしたときの平均寿命は 倍になるので、 なら0.315倍(半分より大きく減る)、 なら0.758倍(半分ほど減らない)です。同じHR = 2でも寿命への影響は分布の形で変わります。
ふたつめは条件付きであることの見落としです。HRは「その時点まで生存していた人」という条件付きの量なので、比較している集団が時間とともに変わっていきます。だから「HRが一定」という仮定は、思っているより強い主張です。
リッジとLasso:なぜLassoは0になるのか
ここから話題が変わります。何に使うのかから入ると、第16回の最小二乗法は説明変数が多いと破綻するという問題があります。
変数が観測数に近づく、あるいは変数同士が強く相関する(多重共線性)と、 が不安定になって係数が暴れます。正則化は「係数の大きさに罰金を科す」ことでこれを抑えます。わざとバイアスを入れて分散を大きく減らす取引です。
罰則の形が2乗()か絶対値()かだけの違いです。ところがこの違いが決定的な差を生みます。
なお係数の や は本質ではなく、後で出てくるソフト閾値の式をきれいにするための流儀です。教科書では と分母なしで書くことも多く、その場合は同じ解を得る の値が変わります。 の絶対値を文献やライブラリ間で比べるときは、この正規化の違いに注意が必要です(この記事の は「1観測あたり」のスケールになっています)。
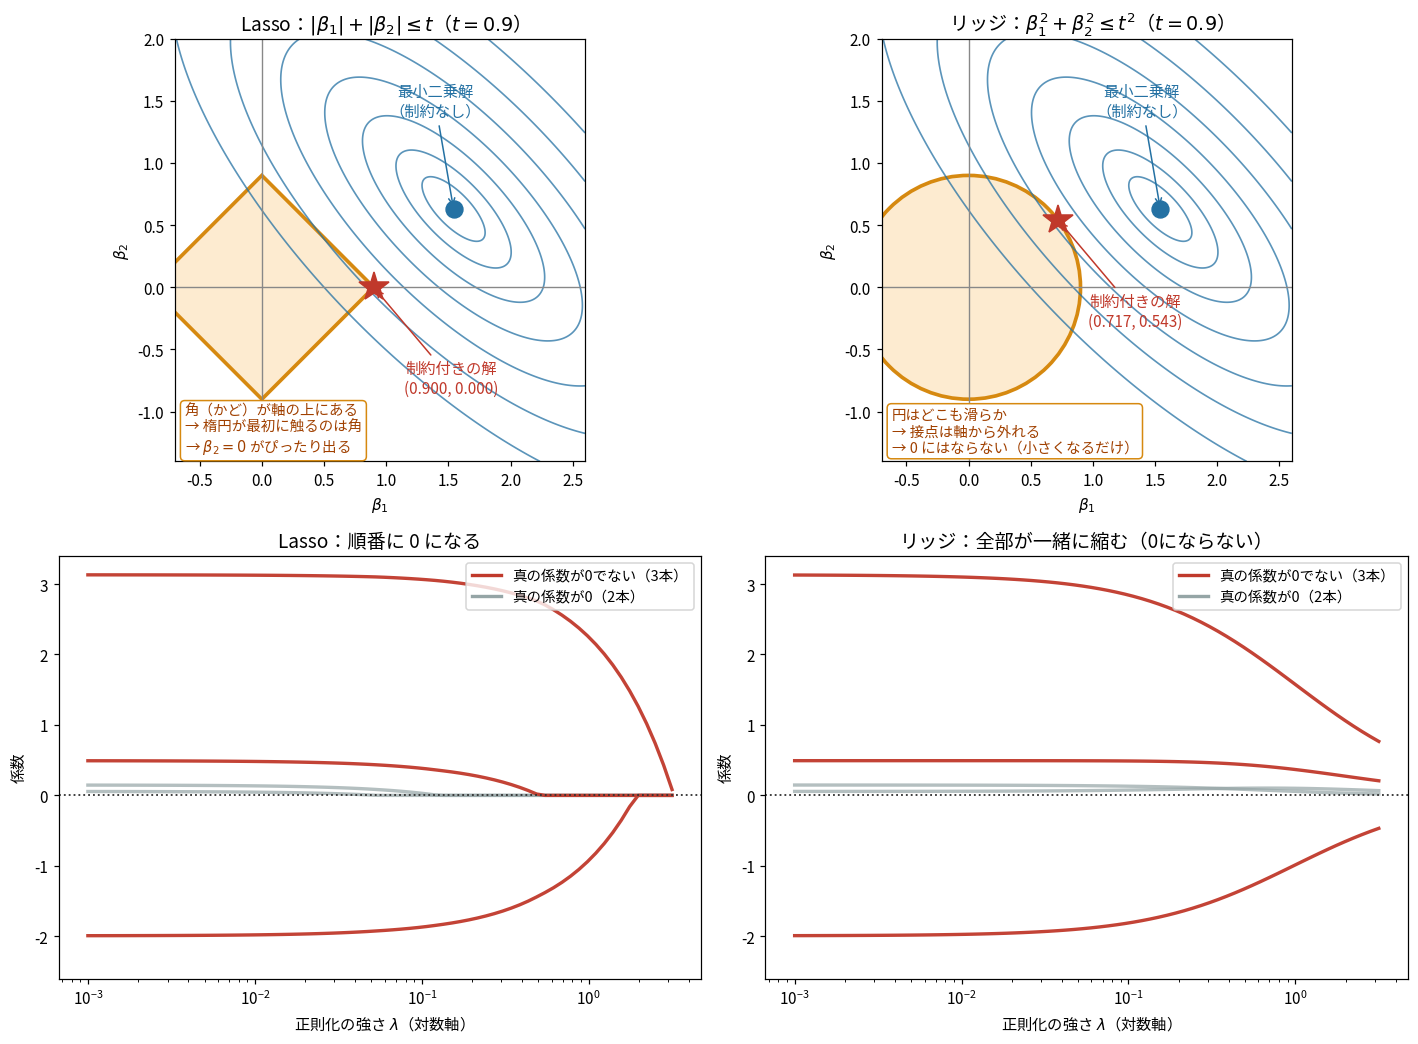
これが定義そのものの図です。 どちらも「制約領域の中で最小二乗の等高線に一番近い点」を選んでいます。違いは制約領域の形だけです。 は菱形で角が軸の上にある、 は円でどこも滑らかです。
楕円を膨らませていくと、菱形には角で当たります(片方の係数がぴったり0)。円には接線で当たるので軸から外れます。
実際の数値では、同じデータ・同じ制約の大きさ()でLassoが 、リッジが 。Lassoだけが をぴったり0にしました。
角が「当たりやすい」理由
角は尖っているので、そこで接する等高線の傾きに幅(許容範囲)があります。円周上の1点で接するには傾きがぴったり一致しないといけませんが、角では「かなり広い範囲の傾き」が角で最小になる。だから角が選ばれる確率が正の値を持ち、次元が増えるほど(軸・辺・面という低次元の縁が増えるほど)スパースな解が出やすくなります。
代数的にはソフト閾値作用素が対応します。説明変数が直交している場合()、(第 列と の内積)と置くと、解はこの1行で書けます。
なら厳密に0です。直交デザインで座標降下法とこの式が最大差 で一致することを確認しました。
この閉じた形が使えるのは直交デザインのときだけという点は押さえておきたいところです。一般の では変数間の相関があるため、この式は「座標降下法の1ステップの更新式」としてのみ現れます( を他の変数の効果を引いた部分残差で置き換える)。だからLassoには閉じた解がありません。
が原点で微分できないことが、この「0で止まる」性質の源です。 2乗なら原点で微分が0になって滑らかに通過してしまいますが、絶対値は原点で折れているので、そこに解が引っかかります。
係数パスで見る
を動かしたときの係数の動きが図の下段です。真の係数は の5変数で、赤が真の係数が0でない3本、灰色が真の係数が0の2本です。
| Lasso の係数 | 0の個数 | リッジで0になった数 | |
|---|---|---|---|
| 0.00 | 3.131, −1.993, 0.147, 0.056, 0.493 | 0 | 0 |
| 0.05 | 3.103, −1.929, 0.088, 0.004, 0.438 | 0 | 0 |
| 0.20 | 2.988, −1.758, 0, 0, 0.288 | 2 | 0 |
| 1.00 | 2.250, −0.925, 0, 0, 0 | 3 | 0 |
Lassoが最初に0にした2つは、真の係数が0だった変数です。 変数選択が機能しています。一方リッジはどんな でも1つも0にしませんでした。 で3つめ(真の係数 0.5)も0になっていますが、これは罰則を強くしすぎると本当に効いている変数まで切ってしまうことを示しています。だから は交差検証で選びます。
使い分け
| リッジ | Lasso | |
|---|---|---|
| 罰則 | () | () |
| 解 | 閉じた形がある( の対角に定数を足して逆行列を取る) | 閉じた形なし(座標降下法など) |
| 係数が0になるか | ならない(縮むだけ) | なる(変数選択を兼ねる) |
| 相関の強い変数群 | 仲良く分け合う | 1つだけ選んで他を切る(不安定) |
| 向いている場面 | 多重共線性の緩和、全変数に弱い効果がある | 変数が多く、効くのは少数と思われる |
相関の強い変数群での不安定さを補うのがElastic Net( と の混合)です。
実務上の注意として、正則化はスケールに依存するので変数を標準化してから適用します。また切片は通常罰則の対象にしません(切片を縮めると予測が原点方向に引っ張られるだけで意味がない)。 は交差検証で決めます。
リッジの解は、上の目的関数を微分して整理すると になります(分母なしの流儀なら )。この形から分かる通り、リッジは の対角成分を持ち上げて逆行列を安定させるという直接的な効果を持ちます。多重共線性でランク落ちしかけている行列を救う操作です。 で が正則でない場合でも解が一意に決まる、という利点もここから来ます。
非線形回帰・多項式回帰・平滑化
最後の話題です。共通する発想は「柔らかさ」をパラメータで調整することです。多項式なら次数、平滑化ならバンド幅。柔らかくすればデータに寄り添えますが、ノイズまで拾ってしまいます。
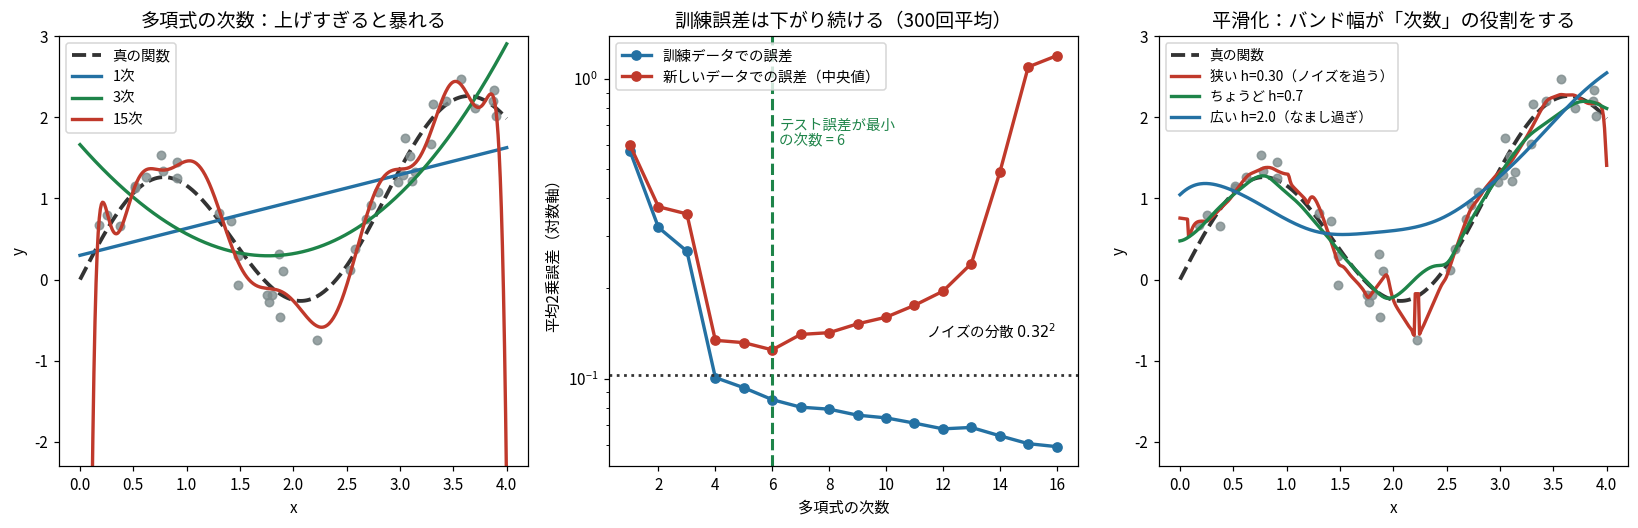
中央のパネルが本質です。 訓練誤差は次数を上げると単調に下がっていきますが(15次で0.0606、16次で0.0592)、新しいデータでの誤差は6次で底を打ち、そこから急増します。
| 次数 | 訓練データでの誤差 | 新しいデータでの誤差 | 判定 |
|---|---|---|---|
| 1 | 0.57489 | 0.60147 | 硬すぎる(未学習) |
| 3 | 0.26611 | 0.35455 | まだ足りない |
| 6 | — | 最小 | ちょうどよい |
| 15 | 0.0606 | 1.09771 | 過学習(訓練は最良・実力は最悪) |
、真の関数 、ノイズ 、300回反復。テスト誤差は中央値です(高次で外れ値が出るため)。
ここで筆者が最初に誤解した点を書いておきます。訓練誤差がノイズ分散 の点線を下回っているのを見て「ノイズを説明してしまっている証拠だ」と書きかけたのですが、これは判定基準になりません。 モデルが真の関数をほぼ表現できているとき、訓練誤差の期待値は次の形になります。
つまり過学習していなくても を下回ります。 パラメータ数 の分だけ自由度を使ってノイズを吸収するからです。15次()で計算すると で、実測値 0.0606 と一致しました(差はモンテカルロ誤差 の範囲)。
一方、次数が低くて真の関数を表現しきれていないときは、バイアスの分だけ を上回ります。 上の表の1次(0.575)と3次(0.266)がそれで、 よりずっと大きい。実測すると6次あたりで を下回り始めます。
結局、訓練誤差では次数を選べません。 バイアスが残っている段階では下がるのが正しく、バイアスが消えた後も の分だけ下がり続け、 に達すれば0になります(データ点を完全に通る曲線が引ける)。「下がった」という事実だけでは、良くなったのかノイズを吸ったのか区別できない——これが正しい理解です。テスト誤差を見るしかありません。
平滑化(右のパネル)は「各点の近くだけを見て局所的に回帰する」方法です。局所線形回帰(LOESS)は、注目点 を原点に取り直して( を説明変数にして)近傍に重みを付けた直線を当てはめ、その切片、つまり での当てはめ値を予測値にします。これを を動かしながら繰り返すと曲線になります。
バンド幅 が次数の役割を果たし、狭いと分散が大きく、広いとバイアスが大きい。同じトレードオフです。
スプラインは「区分多項式を滑らかに繋ぐ」方法で、平滑化スプラインでは曲率 に罰金を科します。これは正則化そのもので、罰則パラメータが柔らかさを決めます。リッジと同じ構造がここに現れるわけで、この章の3つの話題が実は繋がっていることが分かります。
用語の注意を1つ。「非線形回帰」はパラメータについて非線形なモデル( など)を指します。多項式回帰は を説明変数と見ればパラメータについては線形なので、実は通常の最小二乗法で解けます(線形回帰の一種)。
真の非線形回帰は閉じた解がなく反復計算が必要で、初期値によって局所解に落ちる危険があります(第18回のロジスティック回帰と同じ構図ですが、あちらは対数尤度が凹なので大域解が保証されるという違いがあります)。
生存時間解析はIT系の実務で使えるのか
使えます。むしろ解約予測は生存時間解析の教科書的な適用先です。医学用語で書かれているので気づきにくいだけで、対応は素直です。
| 医学の言葉 | サブスク・Webの言葉 |
|---|---|
| 死亡(イベント) | 解約、離脱、初回購入、障害の発生 |
| 生存関数 | 継続率カーブ( ヶ月後にまだ契約している割合) |
| ハザード | 契約 ヶ月目の人が今月解約する率 |
| 打ち切り | まだ契約中の人(観測期間が終わっただけ) |
| ハザード比 | プラン・流入経路・利用頻度が解約率を何倍にするか |
実務で効く点を2つ挙げます。
ひとつめは指標の切り分けです。「今月の解約率 = 解約数 ÷ 契約者数」だけを見ていると、契約期間の構成に引きずられます。新規が多い月は(初期の解約が多いので)解約率が悪化して見える。ハザードを契約月齢ごとに見れば、「悪化したのは商品ではなく流入構成」と切り分けられます。
ふたつめはデータを捨てないことです。この記事の最初の実験では、打ち切りを捨てると平均寿命を77%も過小評価しました。月次マージンが一定ならLTVの見積もりが4分の1以下になるということで、投資判断が変わります。
注意点として、Webのデータでは打ち切りが無情報とは限りません。「アカウント削除で追跡不能になった人」は解約と相関しているので前提が崩れます。
また離散時間(月次)のデータが多いので、離散時間ロジスティックハザードモデル(各月を0/1のロジスティック回帰にする)の方が扱いやすい場面もあります。これは第18回のロジスティック回帰の応用で、実装が簡単なうえ時間依存の共変量も入れやすいという利点があります。
つまずいたところ
ハザードを確率だと思っていた。 「率」と「確率」の区別が曖昧なまま読んでいたので、 が1を超える例を見て混乱しました。 で割っているので単位時間あたりの量であり、速度メーターだと思えば片付きます。時速120kmが「120個の何か」ではないのと同じです。
尤度関数の形が最初から決まっていると思っていた。 という式が出てきたとき「尤度関数ってこれだっけ」と混乱したのですが、これは指数分布の密度関数で、指数分布を仮定したからこの形になっただけでした。尤度は枠で、分布が中身。カプラン・マイヤーも同じ枠を使いますが、 と に特定の分布の形を入れず、分布そのものを自由に動かして最大化します。
累積分布関数を「累積密度関数」と呼びかけていた。 正しくは累積分布関数(CDF)です。そして は そのものではなく で、反対側を見ています。、 を数値で確認して初めて安心しました。
部分尤度の「部分」が何を指すのか分かっていなかった。 「一部のデータしか使わない」のかと思っていたのですが、そうではなく尤度の一部分(時刻の情報)を諦めているという意味でした。データは全部使います。 が約分で消える計算を自分で追って、ようやく納得しました。
Lassoの図で自分の主張を検証せずに書きかけた。 制約の大きさを に設定した図で「角に当たる」と説明しようとしたのですが、実際の解は で角に当たっていませんでした。 でしか厳密に角に乗らないことを数値で確認して に直しました。図で主張するときは、その主張が成り立つ範囲を確認しないと嘘になります。
訓練誤差がノイズ分散を下回るのを「過学習の証拠」だと思った。 これが今回いちばん大きな勘違いでした。バイアスが無視できるなら なので、過学習していなくても を下回ります。「 を下回ったら怪しい」という直感的に正しそうな判定基準が、実は何も判定していなかったわけです。しかも表の1次(0.575)や3次(0.266)は逆に を大きく上回っていて、自分が載せた表が自分の主張を反証していました。書いた数値を自分の主張と突き合わせる作業を飛ばすとこうなります。
KMを「尤度を使わない方法」だと思っていた。 ノンパラメトリックという言葉から「尤度の枠組みの外にある」と受け取っていたのですが、KMは分布族を限定せずに尤度を最大化した結果でした。「階段になるのは尤度を使わないから」ではなく「非パラメトリック最尤解が観測時刻に確率を集める離散分布になるから」が正しい因果です。ノンパラメトリックは「尤度を捨てる」ことではなく「分布族を狭めない」ことだと分かりました。
ソフト閾値の式が万能だと思った。 という美しい式を見て「Lassoにも閉じた解があるのか」と思ったのですが、これは説明変数が直交している場合だけです。一般には変数間の相関があるので、この式は座標降下法の1ステップとしてしか使えません。「閉じた解がない」という表と、この式が両立する理由がここで繋がりました。
試験対策としての要点
この章は試験での比重が小さいので、用語と考え方を押さえて細かい計算は捨てる方針で臨みます。押さえるべきは6点です。
- 、、、 の関係式の変換(、、)。ここは計算問題になりやすい
- ハザード一定 ⟺ 指数分布 ⟺ 無記憶性の同値関係
- KM推定量の手計算。リスク集合の数え方(打ち切りは分子に入らないが分母には残る)
- ワイブルの とハザードの向き( 増加、 減少、 一定)
- Cox回帰はベースラインを推定しない。ハザード比は
- リッジは0にしない、Lassoは0にする。 の角が理由
この記事の要点
- 打ち切りを捨てると平均寿命が−77%、イベント扱いで−61%。 どちらも「短い」側に出る(真値12ヶ月に対し2.7504/4.7192、理論値2.7510/4.7216と一致)
- 打ち切りは欠測ではない。 という不等式の情報を持っているので、 として尤度に書ける
- 尤度は枠で分布が中身。 はどの分布でも共通で、 と の形は仮定した分布で決まる
- 指数分布なら 。打ち切りは総観測時間には入るがイベント数には入らない
- 5人の例で 。捨てると 、イベント扱いで 。分子を削るか分母を膨らませるかの違い
- 。 は累積分布関数(CDF)で「累積密度関数」という語は存在しない。
- 密度とハザードの違いは分母だけ。 密度は最初の全員、ハザードは生き残った人が分母
- ハザードは確率でなく率なので1を超える。速度メーターと同じ
- ハザード一定 ⟺ 指数分布 ⟺ 無記憶性。 「3年続いた顧客も新規と同じ」は現実には成り立たないのでワイブルが要る
- KMが階段なのはイベントのない時刻では で掛ける数が1になるから。教科書値7点と完全一致
- KMも最尤推定量。 分布族を狭めずに尤度を最大化した解が「観測時刻に確率が集まる離散分布」になるから階段が出る(尤度を使わないわけではない)
- と は連続分布で の範囲の関係。離散では で と一致しない
- 打ち切りは曲線を下げないが分母を減らす(次の段差が大きくなる)。尤度の と同じ役割
- ログランクは 対 で 、(教科書値と一致)。自由度1で判定
- ログランクが最強なのは「順位に基づく検定のなかで漸近的に」という限定つき(Coxのスコア検定と一致)
- 部分尤度は「いつ」を諦めて「誰に」だけを使う。 が分子と分母で約分されて消える
- 部分尤度の式はタイ(同時刻イベント)がない前提。実データは丸められているのでBreslow法・Efron法・厳密法のどれかを使う
- 3つの違うベースラインから同じHR 2.0を回収(1.982/2.007/1.942)。 を単調変換しても推定値は変わらない
- Coxの小標本バイアスは で 、 で 。被覆率は93.2%〜96.1%
- 比例ハザードの確認は が平行かどうか。 の対数を取ると定数差になるから
- RR = 2.00、OR = 3.50(60%対30%)。ORは常に1から遠い側。まれな事象では3つが近づく
- HR = 2 は「寿命が半分」ではない。各瞬間の率の比であり、条件付き集団が時間で変わる。ワイブルなら平均寿命は 倍( で0.315倍、 で0.758倍)
- 打ち切りの独立性は共変量で条件付けたものでよい。「プランで観測期間が違う」はプランを共変量に入れれば救われる
- Lassoが0にするのは の角が軸上にあるから。 同設定でLasso 、リッジ
- ソフト閾値 と座標降下が で一致。 が原点で微分できないことが源。ただしこの閉じた形は直交デザイン限定(一般の では座標降下の更新式としてのみ現れる)
- Lassoが最初に0にした2変数は真の係数が0だった変数。リッジはどんな でも0にしない
- 多項式は訓練誤差が単調に下がってもテスト誤差は6次で底(15次で1.098に暴走)
- 訓練誤差がノイズ分散を下回るのは過学習の証拠にならない(筆者の誤解)。バイアスが消えれば まで下がる(15次で理論0.0614・実測0.0606)。逆に低次はバイアスの分だけ を上回る(1次で0.575)
- 平滑化スプラインの曲率罰則は正則化そのもの。 この章の3つの話題は同じ構造で繋がっている
- 解約予測は生存時間解析の教科書的な適用先。ハザードを契約月齢で見れば「商品の悪化」と「流入構成の変化」を切り分けられる
次回は第20章の分散分析と実験計画法です。今回まで「与えられたデータをどう分析するか」を扱ってきましたが、次章ではデータの取り方そのものを設計する話に入ります。A/Bテストで複数の要因を同時に試したいとき、何回の実験で足りるのか——という問いに答える章です。