欠測データ:平均で埋めると信頼区間が嘘をつく【第31回】
はじめに
第29章は不完全データの統計処理です。要するに、データに空白があるときどうするかという話です。
この章に入る前、私はここを軽く見ていました。空白があるなら、その行を捨てるか、平均で埋めるか、どちらかでいいだろうと思っていたのです。特に平均で埋めるのは無害に見えました。全体の平均を動かさないのだから、大きな害はないはずだ、と。
手を動かしてみたら、この予想は半分当たっていて、半分は完全に外れていました。
平均代入で平均は当たります。真の平均 452.0 万円に対して、推定値 451.67。ここは予想通りでした。
外れていたのはその先です。同じ推定に付ける95%信頼区間の被覆率が 81.5% まで落ちました。95%と名乗る区間が、5回に1回近く外すということです。しかもこれは、欠測行を捨てた場合(94.1%)より悪い。埋めたことで、データを捨てるより悪い状態になっていました。
原因を追いかけて分かったのは、ひとつの単純な事実でした。
表に数字を1つ書き込むという行為が、その人の分散をゼロにしてしまう。
この一文がこの章の背骨で、平均代入がダメな理由も、EM アルゴリズムが何をしているのかも、多重代入法で「なぜ複数回埋めるのか」も、全部ここから出てきます。
もうひとつ収穫がありました。MCAR・MAR・MNAR という3つの略語です。名前が似ていて区別がつかず、この章の最初の関門だと思っていたのですが、同じデータで欠測の仕組みだけを変えた3枚の散布図を並べたら一気に整理できました。しかも「MAR かどうかは検定できない」という事実が、なぜできないのかまで含めて数値で示せました。
いつものように、出てくる数値はすべて自分で計算し、理論値と突き合わせています。
この回で扱う用語
| 用語 | 読み・意味 |
|---|---|
| 欠測データ | Missing Data。観測されるべき値が得られていないデータ。不完全データとも |
| MCAR | Missing Completely At Random=完全にランダムな欠測。欠測確率が何にも依存しない |
| MAR | Missing At Random=ランダムな欠測。欠測確率が観測されている変数で決まる |
| MNAR | Missing Not At Random=ランダムでない欠測。欠測確率が欠測している値そのもので決まる |
| リストワイズ削除 | Listwise Deletion。欠測がある行を丸ごと捨てる。完全ケース分析(Complete Case Analysis)とも |
| ペアワイズ削除 | Pairwise Deletion。相関などを計算するとき、その2変数が揃っている行だけを使う |
| 平均代入 | Mean Imputation。欠測を観測値の平均で埋める |
| 回帰代入 | Regression Imputation。欠測を他の変数からの回帰予測値で埋める |
| 確率的回帰代入 | Stochastic Regression Imputation。回帰予測値に乱数の誤差を足して埋める |
| EM アルゴリズム | Expectation-Maximization Algorithm。E ステップと M ステップを繰り返して最尤推定値を求める反復法 |
| 多重代入法 | MI(Multiple Imputation=多重代入法)。欠測を 通りに埋めて結果を統合する |
| ルービンの公式 | Rubin's Rules。多重代入の結果を統合する式。分散を代入内分散と代入間分散に分ける |
| 代入内分散 | Within-imputation Variance 。各回のデータセット内での分散の平均 |
| 代入間分散 | Between-imputation Variance 。 個の推定値どうしのばらつき |
| FIML | Full Information Maximum Likelihood=完全情報最尤法。欠測を埋めず、観測された情報だけで尤度を書く |
| 感度分析 | Sensitivity Analysis。仮定を振ってみて結論がどこまで動くかを調べる |
| 被覆率 | Coverage Probability。95%信頼区間が本当に真の値を含む割合 |
| 欠測に起因する分散の割合 | 。全分散のうち欠測由来の分。FMI(欠測情報割合)の大標本近似 |
何に使うのか:空白のある表を前にして
数式の前に、この章が生まれた事情から入ります。
アンケートを 2000 人に配ったとします。聞いたのは年齢と年収です。年齢は名簿から分かるので全員埋まりました。年収は 600 人分が空白でした。
平均年収を出したい。素朴な手は2つです。
- 空白の行を捨てて 1400 人で平均を出す(リストワイズ削除)
- 空白を「答えてくれた人の平均」で埋める(平均代入)
どちらも、初めて聞くと十分まともに思えます。この章の全体は「この2つがいつどう壊れるのか」を明らかにして、壊れない道具を用意する話です。
そして壊れ方は、欠測がどういう仕組みで起きたかによって変わります。だから最初に欠測の分類が来ます。分類が先に来るのは、この章の構成として自然なのです。
欠測の仕組みは3種類ある
同じ 2000 人のデータで、回答率をどれも約70%にそろえて、「誰が答えなかったか」の決まり方だけを変えました。データの中身はまったく同じです。
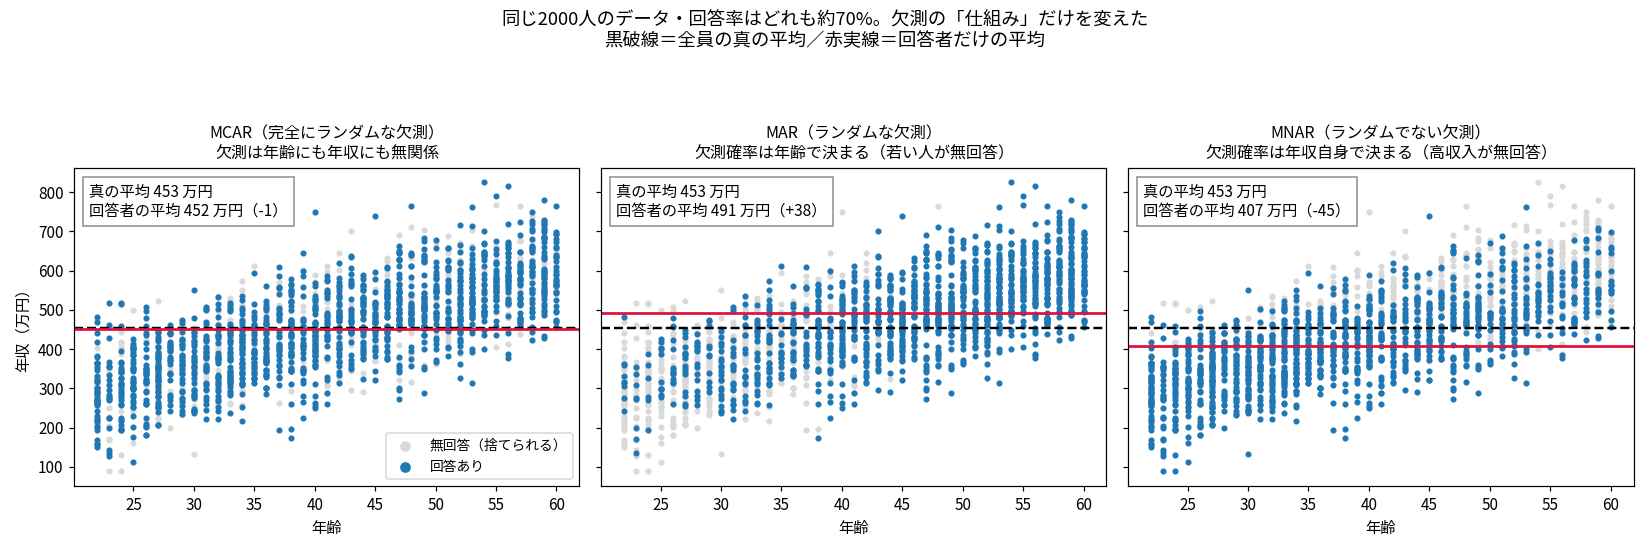
灰色が無回答、青が回答ありです。黒破線が全員の真の平均、赤実線が回答者だけの平均。左のパネルだけ赤線と黒線が重なっています。
3つの略語はこう整理できます。
| 略語 | スペルアウト | 日本語訳 | 欠測確率が何で決まるか |
|---|---|---|---|
| MCAR | Missing Completely At Random | 完全にランダムな欠測 | 何にも依存しない(コイン投げ) |
| MAR | Missing At Random | ランダムな欠測 | 観測されている他の変数(年齢) |
| MNAR | Missing Not At Random | ランダムでない欠測 | 欠測している値そのもの(年収) |
実測値です。真の平均年収は 452.8 万円でした。
| 仕組み | 回答率 | 回答者の年収平均 | 真値との差 | 回答者の年収SD | 回答者の年齢平均 |
|---|---|---|---|---|---|
| 真の値(全員) | 100% | 452.8 | — | 118.3 | 41.4 |
| MCAR | 71.2% | 451.7 | −1.1 | 119.2 | 41.3 |
| MAR | 67.1% | 491.1 | +38.3 | 108.2 | 46.1 |
| MNAR | 67.7% | 407.3 | −45.5 | 105.5 | 38.0 |
MCAR はほぼ当たります。MAR は若い人が抜けたので +38.3 万円高く出て、MNAR は高収入が抜けたので −45.5 万円低く出ました。
MAR と MNAR の分かれ目は「偏りの原因が手元にあるか」
MCAR とそれ以外の差はすぐ分かります。難しいのは MAR と MNAR の区別で、ここが一番間違えられるところです。
MAR の行をもう一度見てください。回答者の年齢平均が 46.1 歳です(全体は 41.4 歳)。あからさまに高齢に偏っています。
そしてこの偏りは、データを見れば分かります。年齢は全員について観測できているからです。だから「年齢で重み付けし直す」「年齢を説明変数に入れる」という対処ができます。
MNAR はどうでしょうか。回答者の年齢平均は 38.0 歳で、これも偏ってはいます。しかし偏りの本当の原因は「年収が高い人が答えなかった」ことで、その年収は欠測しています。手元のデータをどう眺めても「高収入層が何人抜けたか」は分かりません。直す手がかりがデータの中に存在しないのです。
言い換えるとこうなります。
| 回答した人は全体の縮小版か? | |
|---|---|
| MCAR | Yes。ただ数が減っただけ |
| MAR | No。でも年齢を揃えて比べれば縮小版になる |
| MNAR | No。しかも何を揃えればよいのかがデータからは分からない |
定義を式で書くと
を「回答したか」を表す 0/1 の変数、 を観測できた値、 を欠測した値とします。
| 条件 | 意味 | |
|---|---|---|
| MCAR | 欠測確率がデータ全体と無関係 | |
| MAR | 観測値で条件付けたら無関係 | |
| MNAR | 上のどちらも成り立たない | 欠測した値そのものが効いている |
MAR の式が言っているのは「(年齢)を知っている状態なら、(年収)を追加で知っても欠測確率の予想は変わらない」ということです。これは第2回でやった条件付き独立と同じ形です。
判定基準は変数の名前ではなく「何を測ったか」
MAR の原因は「年齢である」に限りません。観測できている変数なら何でもよいのです。性別でも居住地でも、それらの組み合わせでも。「見えている情報のどれかで説明がつく」なら MAR です。
そして MNAR も「原因が年収そのもの」に限りません。知りたい変数と関係している未観測の何かが原因なら、すべて MNAR になります。たとえば「慎重な性格の人は答えない」で、性格が年収と相関しており、性格を測っていないなら MNAR です。
ここで注意すべき点があります。未観測の原因があること自体は MNAR の条件ではありません。 その原因が知りたい変数とつながっているかどうかが分かれ目です。
具体例で確かめます。健康診断のデータで、体重は全員測り、血圧は一部が欠測しました。欠測の原因は「その日の血圧計の故障」で、検査室の記録は持っていません。
これは MCAR です。故障は、その人の血圧の値とも、年齢や体重とも無関係に起きています。だから欠測した人たちは全体からランダムに抜き取られた集団になります。検査室の記録を持っていなくても MCAR のままで、MCAR は他の変数の助けを必要としない唯一のケースだからです。機器の故障・記録用紙の紛失・データ入力の取りこぼしは、教科書が MCAR の例として挙げる定番です。
ではこの例を MNAR にひねってみます。
混んでいる時間帯は昼休みに来る現役の会社員が多く、空いている時間帯は平日昼間に来られる高齢者が多い。そして血圧は年齢と強く相関する。
こうすると、故障の起きた時間帯が「若くて血圧が低い人」を選択的に落とすことになり、MCAR が崩れます。このとき年齢を測っていれば MAR、年齢も測っていなければ MNAR です。
同じ「血圧計の故障」でも、故障のタイミングが患者の種類と相関しているかどうかで分類が変わる。 そしてこれは少し不思議な性質を含んでいます。
MAR か MNAR かは、データの性質ではなく「何を一緒に集めたか」で決まる。
同じ現象でも、年齢を聞いていれば MAR、聞いていなければ MNAR です。これは後で実務の話をするときに効いてきます。
名前についての警告
MAR(ランダムな欠測)は、ランダムではありません。 上の図の真ん中は、若い人が明らかに狙って抜けています。
「他の観測変数で条件付けたあとはランダム」という意味なのですが、この命名は統計学で最も分かりにくいものの一つと言われています。私は MAR = 条件付きランダム と読み替えることにしました。
MCAR は検定できる。MAR と MNAR は原理的に区別できない
分類が分かったところで、当然の疑問が来ます。実際のデータで、どれなのか判定できるのでしょうか。
答えは「MCAR は判定できる。MAR と MNAR は判定できない」です。しかも後半は「まだ良い方法が発明されていない」のではなく、原理的に不可能でした。
MCAR の検定
やることは単純です。回答した人としなかった人に分けて、両方について観測できている変数(年齢)を比べる。MCAR なら無回答は完全にランダムなので、2群の年齢は一致するはずです。第13回のウェルチのt検定で比べました。
| 仕組み | 回答者の年齢 | 無回答者の年齢 | t値 | 判定 |
|---|---|---|---|---|
| MCAR | 41.31 | 41.61 | −0.570 | 棄却できない(MCAR と矛盾しない) |
| MAR | 46.13 | 31.74 | +39.576 | MCAR を棄却 |
| MNAR | 38.00 | 48.52 | −23.937 | MCAR を棄却 |
MCAR かどうかは判定できました。ただしMAR と MNAR はどちらも同じ「棄却」に落ちます。この検定は両者を区別しません。
なお、複数の変数をまとめて検定する方法としてリトルの MCAR 検定(Little's MCAR test)があり、実務ではこちらが使われます。ただし区別できるのは MCAR かどうかまでで、上の限界は変わりません。
区別できないことの実演
手元のデータを1つ固定します。1400 人は年齢と年収の両方、600 人は年齢だけ。
| 手元にあるデータ(これしかない) | |
|---|---|
| 回答者 1400 人 | 年齢平均 40.60 / 年収平均 451.5 万円 / 年収SD 118.0 |
| 無回答者 600 人 | 年齢平均 41.74 / 年収は不明 |
| 回答者で推定した回帰式 | 年収 = 142.2 + 7.62 × 年齢 |
この同じデータを生む、2つの世界を考えます。
| 世界 | 無回答者の中身 | 無回答者の真の年収平均 | 全2000人の真の平均 |
|---|---|---|---|
| A(MAR) | 同じ年齢の回答者と同じ年収分布 | 461.1 | 454.4 |
| B(MNAR) | 同じ年齢の回答者より120万円高い(だから答えなかった) | 580.8 | 490.3 |
答えは 35.9 万円も違うのに、手元のデータ(上の表の3行)はAとBで完全に同一です。
検定とは、観測データを入力にして判定を出す関数です。入力が同じなら出力も同じになります。
だから MAR と MNAR を見分ける検定は作れない。
これは検定の設計が下手だからではなく、情報が存在しないからです。判別に必要な情報が、まさに欠測している部分に入っています。
実務では、MAR か MNAR かは分野の知識で仮定するしかありません。「この調査で年収を答えなかった人は、年齢と職種を揃えれば答えた人と同じと考えて差し支えないか」を、統計ではなく調査設計の知識で判断することになります。
リストワイズ削除はいつ許されるのか
「欠測がある行を丸ごと捨てる」という最も単純な方法が、どこまで許されるのかを測ります。4000 回のシミュレーションで、真の平均年収 452.0 万円、真の傾き 8.0 です。
| 方法 | 平均の推定値 | 偏り | 傾きの推定値 | 偏り |
|---|---|---|---|---|
| 欠測なし(2000人) | 452.04 | — | 8.0012 | — |
| MCAR+削除 | 452.03 | +0.03 | 8.0008 | +0.0008 |
| MAR+削除 | 491.68 | +39.68 | 7.9996 | −0.0004 |
| MNAR+削除 | 405.55 | −46.45 | 7.0867 | −0.9133 |
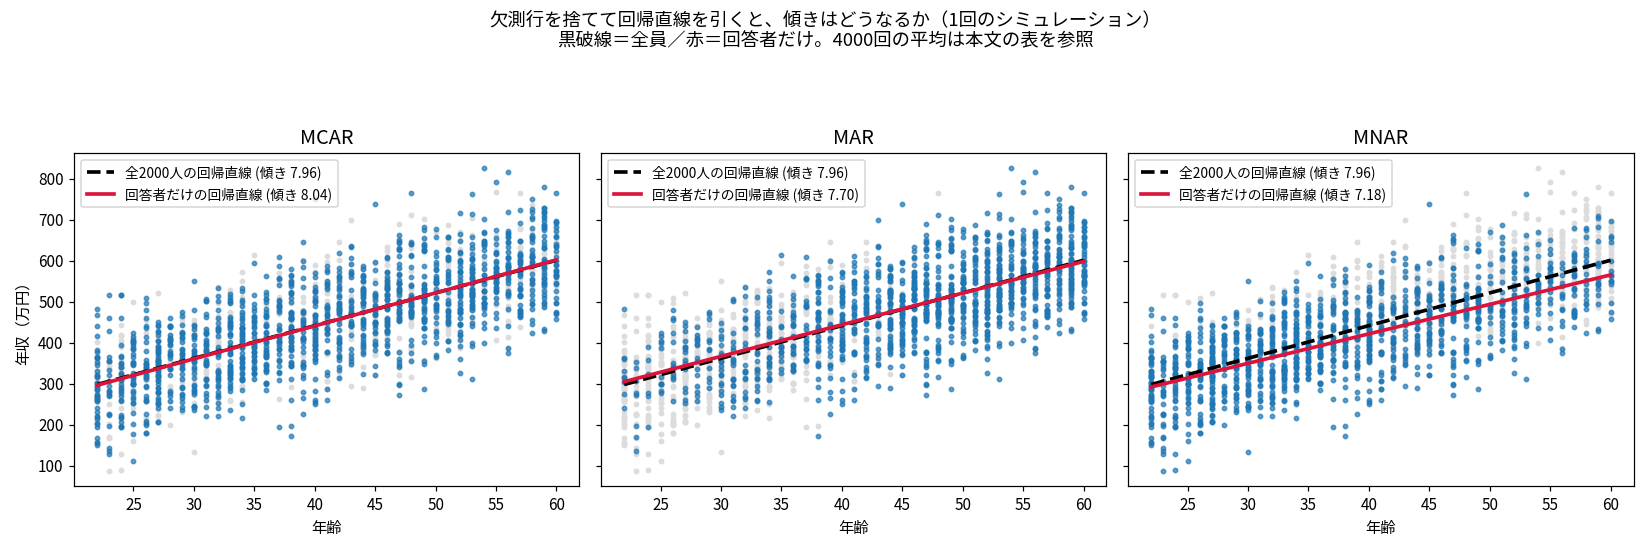
図は1回のシミュレーションで、表の値は 4000 回の平均です。MAR のパネルで赤と黒がほぼ重なっているのが要点です。
図に出ている傾きは1標本の値なので、表の 4000 回平均とは少しずれます。MAR は図で 7.70、4000 回平均は 7.9996(この 7.70 は真値 8.00 から −1.34 標準偏差の位置にある通常のばらつきの範囲内です)。MNAR は図で 7.18、4000 回平均は 7.0867。MNAR のずれは何度繰り返しても消えませんが、MAR のずれは繰り返せば消えます。この違いが偏りとばらつきの区別です。
MAR で平均は壊れるのに傾きは壊れない
MAR の行を見てください。平均は +39.68 も外すのに、傾きは −0.0004 しか外していません。
同じデータ、同じ削除操作なのに、壊れ方が違います。つまり
「MAR なら削除はダメ」は、推定したい量とモデルの正しさを指定しないと判定できない。
理由はこうです。削除によって年齢の分布は歪みます(若い人が減る)。しかし各年齢での年収の条件付き分布は歪んでいません。欠測確率が年齢だけで決まっているので、同じ年齢の中では回答者と無回答者が同じ分布を持つからです。
そして回帰の傾きは、この条件付き分布だけで決まる量です。だから無傷。一方、平均は「年齢の分布」の重みで加重平均する量なので、そこが歪めば直撃を受けます。
ただしこれは MAR 一般の性質ではない
ここは危ないので、条件を崩した反例を自分で測りました。真の傾きを 2.0 にした別のデータで、4000回のシミュレーションです。
| 条件 | 崩したときの完全ケース分析の傾き |
|---|---|
| (3条件そろっている=記事の設定) | 2.0000 |
| ① だけが欠測 → が欠測し、欠測確率が に依存 | 1.8450 |
| ②欠測確率が回帰モデルに入っている だけで決まる → と相関する別の観測変数 に依存 | 1.8471 |
| ③回帰モデルが正しい → 真が なのに直線を当てる | 3.4487 |
③が一番怖いところです。真の関係が曲線なのに直線を当てると、その傾きは「 の分布のどこを重く見るか」で変わってしまいます。全データに直線を当てたときの傾きは 1.9957 なのに、削除すると 3.4487。 の分布が歪むことが、ここで直撃します。
②については前提をひとつ書き添えておきます。上の 1.8471 は とした設定で、この は とも相関しています。 を と完全に無相関にする( の誤差項にだけ相関させる)と、傾きは 2.0000 に戻り、ずれるのは切片だけになりました。「 と相関する観測変数に依存すれば必ず傾きが偏る」わけではないという点は、私も試して初めて分かりました。
逆に、誤差が不等分散でも傾きは無傷でした(実測 1.9983)。効率は落ちますが偏りは出ません。
用語についても正確に書いておきます。「欠測確率が、回帰モデルに入っている共変量だけで決まる」は MAR の特殊ケースで、共変量依存の欠測(covariate-dependent missingness)と呼ばれます。だから正しい言い方は「MAR だから傾きは大丈夫」ではなく、
共変量依存の欠測で、かつモデルが正しく特定されているから大丈夫。
になります。私は当初これを「MAR の定義そのもの」と書いていて、そこが誤りでした。
この区別は実務で意味を持ちます。「平均を知りたい」のか「関係を知りたい」のかで、許される手抜きが違うのです。①②を確認でき、モデルの形にも根拠があるなら、回帰係数だけが目的なら完全ケース分析が使える場面があります(③のモデルの正しさはデータから確認できる性質ではないので、ここは分野の知識に頼ることになります)。
MCAR でも代償はある
偏りが消えても、無料ではありません。
| 方法 | 平均の標準誤差 | 傾きの標準誤差 |
|---|---|---|
| 欠測なし(n=2000) | 2.682 | 0.1610 |
| MCAR+削除(平均1400人) | 3.195 | 0.1904 |
比は 1.1912 で、理論値 とよく合います。精度はルートで悪化するわけです。第10回の「精度はルートでしか改善しない」の裏返しです。
そして多変量ではこれが深刻になります。10 変数がそれぞれ独立に 10% 欠測すると、全部揃っている行は しか残りません。1変数あたりの欠測が少なくても、変数が増えると全滅に近づくのがリストワイズ削除の第2の問題です。
なお、この問題を避けるためにペアワイズ削除(相関を計算するときはその2変数が揃っている行だけ使う)という方法もありますが、こちらは組み合わせごとに使う人が違うため、分散共分散行列が正定値でなくなるという別の困りごとを生みます。第24回で扱った固有値分解が使えなくなる場合があり、多変量解析の前処理としては危険です。
平均代入がダメな理由
ここが今回いちばん学びのあった部分です。設定は MCAR で 30% 欠測、つまり最も条件の良いケースにしました。偏りの心配がない状況で試して、それでも壊れるかを見ます。n=200、4000 回のシミュレーションです。
| 方法 | 平均 | 年収のSD | 報告される標準誤差 | 本当の標準誤差 | 95%区間の被覆率 | 相関 r | 傾き |
|---|---|---|---|---|---|---|---|
| 真値 | 452.0 | 120.50 | — | — | 95% | 0.7479 | 8.00 |
| ①欠測なし(n=200) | 451.77 | 120.26 | 8.504 | 8.590 | 94.8% | 0.7477 | 7.99 |
| ②リストワイズ削除 | 451.67 | 120.14 | 10.163 | 10.399 | 94.1% | 0.7479 | 8.00 |
| ③平均代入 | 451.67 | 100.38 | 7.098 | 10.399 | 81.5% | 0.6250 | 5.59 |
| ④回帰代入 | 451.73 | 111.91 | 7.913 | 9.387 | 90.1% | 0.8030 | 7.99 |
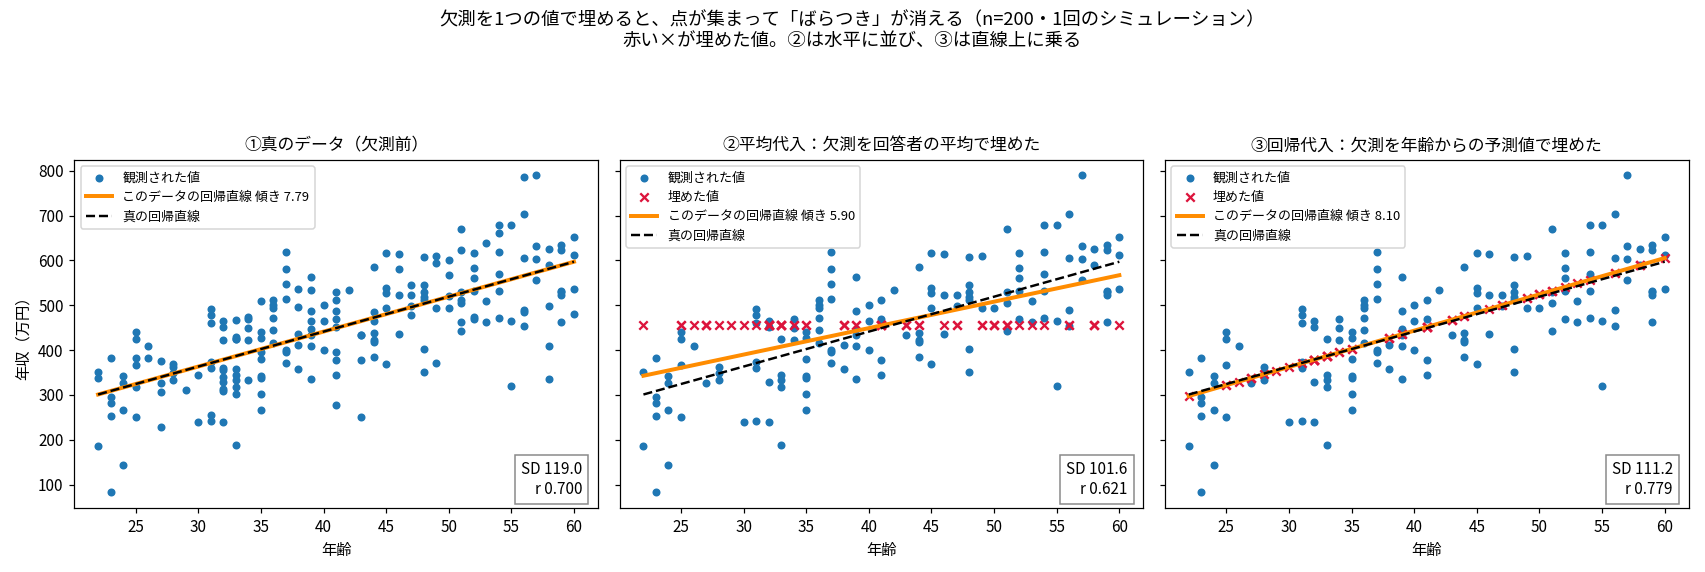
赤い×が埋めた値です。図の中央(平均代入)では1本の水平線に並び、右(回帰代入)では1本の斜め線に並びます(図のパネル番号①②③は上の表の行番号とは対応していません。図は真のデータ・平均代入・回帰代入の3枚です)。どちらも「そこにばらつきがない」ことが問題です(図は1回のシミュレーションなので、値は上の表の4000回平均とは少しずれます)。
まず、平均は当たっている
③の平均は 451.67。当たっています。
これは当然で、 個の平均に、その平均自身を何個足しても平均は変わりません。だから「平均代入は無害に見える」という直感は錯覚ではなく、平均だけを見るなら本当に無害です。
壊れるのはそれ以外の全部でした。
壊れたもの1:ばらつきが16.7%過小
SD 100.38 は真値 120.50 の 83.3% です。理論値がぴったり出ます。欠測割合を 30%(残り 70%)とすると、
で、実測 100.38 と合います。
理由は図②の赤い×が全部同じ高さに並んでいることです。平方和 を作るとき、埋めた60人の寄与はちょうど 0 になります(埋めた値が平均そのものなので差がゼロ)。分子は観測された 140 人分のまま、分母だけ 200 になる。だから 倍です。
壊れたもの2:信頼区間が嘘をつく
ここが最も深刻でした。
平均代入が報告する標準誤差は 7.098 です。ところが推定値の本当のばらつきは 10.399(リストワイズ削除と同じ値になります。情報量は増えていないので当然です)。1.47 倍も自分を過大評価しているわけです。
その結果、95%信頼区間の被覆率が 81.5% に落ちます。
そして表を縦に見てください。欠測なし(94.8%)より悪い。削除(94.1%)より悪い。 つまり
平均代入は、データを捨てるより悪い。
捨てれば少なくとも嘘はつきません。埋めると 200 人分のデータがあるかのように振る舞ってしまう。実際には 140 人分の情報しかないのに、そう見えなくなるのです。
第11回で信頼区間を扱ったとき「信頼区間は作り方に付いている数字」という話をしましたが、これはその作り方が壊れている例です。推定値が正しくても、精度の申告が嘘なら結論は信用できません。
壊れたもの3:相関と回帰係数が逆方向に壊れる
| 相関 r(真値 0.7479) | 傾き(真値 8.00) | 何が起きたか | |
|---|---|---|---|
| ③平均代入 | 0.6250(83.6%) | 5.59(−30%) | 関係を薄める。理論値 |
| ④回帰代入 | 0.8030(+7%) | 7.99 | 関係を強めすぎる(傾きは当たる) |
2つの代入法が逆方向に壊れているのが面白いところです。
数字の関係を先に確認しておきます。平均代入では共分散が 0.70 倍になります(埋めた60人の がゼロなので への寄与が消え、分子は140人分のまま分母が200になる)。 は不変、 は 倍。だから
同じ現象なのに傾きと相関で係数が違うのは、相関だけが の縮小に助けられて半分だけ戻るからです。
平均代入では、埋めた点が水平に並びます。つまり年齢と年収の関係がない点を60個追加したことになる。だから相関も傾きも薄まります。
回帰代入では、埋めた点が回帰直線上にぴったり乗ります。つまり誤差ゼロの完璧な点を60個追加したことになる。だから相関が真値より高く出ます。
なお回帰代入で傾きだけが当たるのは、追加した点が既存の回帰直線の上に乗っているので直線の向きを変えないからです。当てはまりの良さ(相関)は水増しされますが、直線そのものは動きません。
回帰代入も不十分だが、惜しいところまで来ている
④の行を見ると、平均 451.73 も傾き 7.99 も合っており、平均代入より明らかにましです。しかし SD 111.91(真値 120.50)と標準誤差 7.913(本当は 9.387)はまだ過小で、被覆率も 90.1%。
足りないものは1つだけでした。
埋めた値に「予測の誤差」が入っていない。
48 歳の人の年収は「たぶん 510 万円」ですが、本当は くらいのはずです。回帰代入は予測の中心だけを置いて、 を捨てている。だから点が直線に張り付き、ばらつきが足りなくなります。
ここから解決策が2方向に分かれます。
- 誤差を足して埋める。 ただし1回では乱数任せなので、乱数を変えて何回も埋める → 多重代入法
- そもそも埋めるのをやめる。 埋めずに、欠測を持ったまま尤度を最大化する → EM アルゴリズム / 完全情報最尤法
MCAR でも代入した方が得だという話
ここでひとつ、私が誤解していた点を書いておきます。
「MCAR なら削除しても偏らないのだから、それで十分」と思っていました。偏りについては正しいのですが、精度については損をしています。
MCAR・欠測30%で、平均年収を推定した結果(6000回、n=2000)です。
| 方法 | 平均 | 標準誤差 |
|---|---|---|
| 欠測なし(2000人) | 451.96 | 2.638 |
| リストワイズ削除(約1400人) | 451.99 | 3.170 |
| 年齢を使った回帰代入(2000人分) | 451.96 | 2.861 |
どちらも偏りはゼロですが、分散が18.5%減っています。標準誤差は「欠測なし」比で 1.20 倍から 1.08 倍まで戻りました。
なぜかというと、捨てた600人にも情報が残っているからです。年収は分かりませんが、年齢は分かっている。そして年齢と年収の相関は です。「48歳の人の年収は不明だが、たぶん510万円くらい」という予測は、まったくの無情報より確実にましです。捨てるとこの情報を自分から放棄することになります。
つまり MCAR での正しい理解は、こうです。
削除しても答えは合う。ただしデータを無駄にしている。
そして無駄にした分を追加調査で買い戻すには費用がかかります。この章の道具は、追加調査なしで精度を回収する技術でもあるわけです。
そして MAR なら、偏りそのものが消える
もうひとつ大事な点です。ここからは平均の話です(傾きについては前節のとおり、条件がそろえば削除でも無傷でした)。3000 回のシミュレーションで、削除と「年齢を使った回帰代入」を比べました(真の平均 452.0 万円)。
| 仕組み | 削除の偏り | 年齢で回帰代入した偏り |
|---|---|---|
| MCAR | +0.01 | −0.01 |
| MAR | +39.60 | +0.02 |
| MNAR | −46.48 | −22.63 |
MAR の行を見てください。削除だと +39.60 外すのに、年齢で埋めると +0.02。ほぼ完全に直りました。
これは当然のことで、MAR の定義は「欠測の原因が観測されている変数で説明できる」でした。原因が手元にあるなら、それを使って埋めればよい。 削除が MAR で壊れるのは、MAR が直せないからではなく、削除という手段がその情報を使っていないからです。
MNAR でも −46.48 が −22.63 に半減しています。完全には直らないが、何もしないよりはましという位置づけです。
ここで用語を1つ区別しておきます。「代入すると良くなる」の「良くなる」が2つの別物を指しています。
| 何が良くなるのか | |
|---|---|
| MCAR で代入が効く | 精度が上がる(答えはもともと合っていた) |
| MAR で代入が効く | 偏りが消える(答えがそもそも間違っていた) |
前者はおまけ、後者は必須です。MAR が「正しい結果を出せる境界線」になります。
EM アルゴリズム
「E ステップと M ステップを繰り返す」という説明を何度も読んだのですが、それでは何も見えませんでした。そこで n=10 の例で反復を1行ずつ数値で追いました。
使うデータ
| i | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| x(年齢/10) | 2.4 | 2.8 | 3.2 | 3.6 | 4.0 | 4.4 | 4.8 | 5.2 | 5.6 | 6.0 |
| y(年収/100万円) | 3.1 | 3.6 | 3.5 | 4.4 | 4.2 | 5.1 | 欠測 | 欠測 | 欠測 | 欠測 |
x は全員わかっていて、y は後半4人が欠測です。しかも欠測しているのは x が大きい側だけという、いかにも危なそうな配置にしました。
2変量正規分布を仮定して、(y の平均)・(y の分散)・(x と y の共分散)を推定します。x 側は全員観測なので 、 で確定です。
2つのステップが何をしているか
| ステップ | やること | 入口 → 出口 |
|---|---|---|
| E ステップ(Expectation=期待値) | 今のパラメータを使って、欠測している4人の y の条件付き期待値 を計算し、表を埋める | パラメータ → 埋まった表 |
| M ステップ(Maximization=最大化) | 埋まった表を完全なデータとして扱い、いつもの最尤推定の式(平均・分散・共分散)を当てる | 埋まった表 → パラメータ |
この2つは互いの出口が互いの入口になっています。 パラメータが分かれば埋められる、埋まればパラメータが出る。しかし最初はどちらも手元にありません。
だから適当な値から始めて往復させる。
これが EM の全体像です。「鶏と卵」の状況を、片方を仮に置くことで回し始める、という発想です。
反復を数値で追う
初期値をわざと外して、、、(x と y は無関係だと思い込んでいる状態)から始めます。
| 反復 | 傾き b | E ステップが置いた4人の値 | ||||
|---|---|---|---|---|---|---|
| 初期 | 3.0000 | 2.0000 | 0.0000 | — | — | — |
| 1 | 3.5900 | 1.2949 | −0.2180 | 0.0000 | 2.0000 | 3.00, 3.00, 3.00, 3.00 |
| 2 | 3.7467 | 0.8525 | −0.0431 | −0.1652 | 1.2589 | 3.491, 3.425, 3.359, 3.293 |
| 3 | 3.8730 | 0.6216 | 0.1190 | −0.0327 | 0.8511 | 3.727, 3.714, 3.701, 3.688 |
| 4 | 3.9825 | 0.5078 | 0.2602 | 0.0901 | 0.6109 | 3.927, 3.963, 3.999, 4.035 |
| 5 | 4.0776 | 0.4619 | 0.3829 | 0.1971 | 0.4566 | 4.101, 4.180, 4.258, 4.337 |
| 6 | 4.1603 | 0.4569 | 0.4895 | 0.2901 | 0.3508 | 4.252, 4.368, 4.484, 4.600 |
| 8 | 4.2946 | 0.5117 | 0.6628 | 0.4411 | 0.2200 | 4.497, 4.673, 4.850, 5.026 |
| 12 | 4.4726 | 0.6979 | 0.8924 | 0.6413 | 0.1077 | 4.822, 5.078, 5.335, 5.591 |
| 20 | 4.6321 | 0.9719 | 1.0982 | 0.8206 | 0.0597 | 5.113, 5.441, 5.769, 6.098 |
| 40 | 4.7044 | 1.1294 | 1.1914 | 0.9019 | 0.0541 | 5.245, 5.606, 5.966, 6.327 |
| 80 | 4.7090 | 1.1402 | 1.1974 | 0.9071 | 0.0540 | 5.253, 5.616, 5.979, 6.342 |
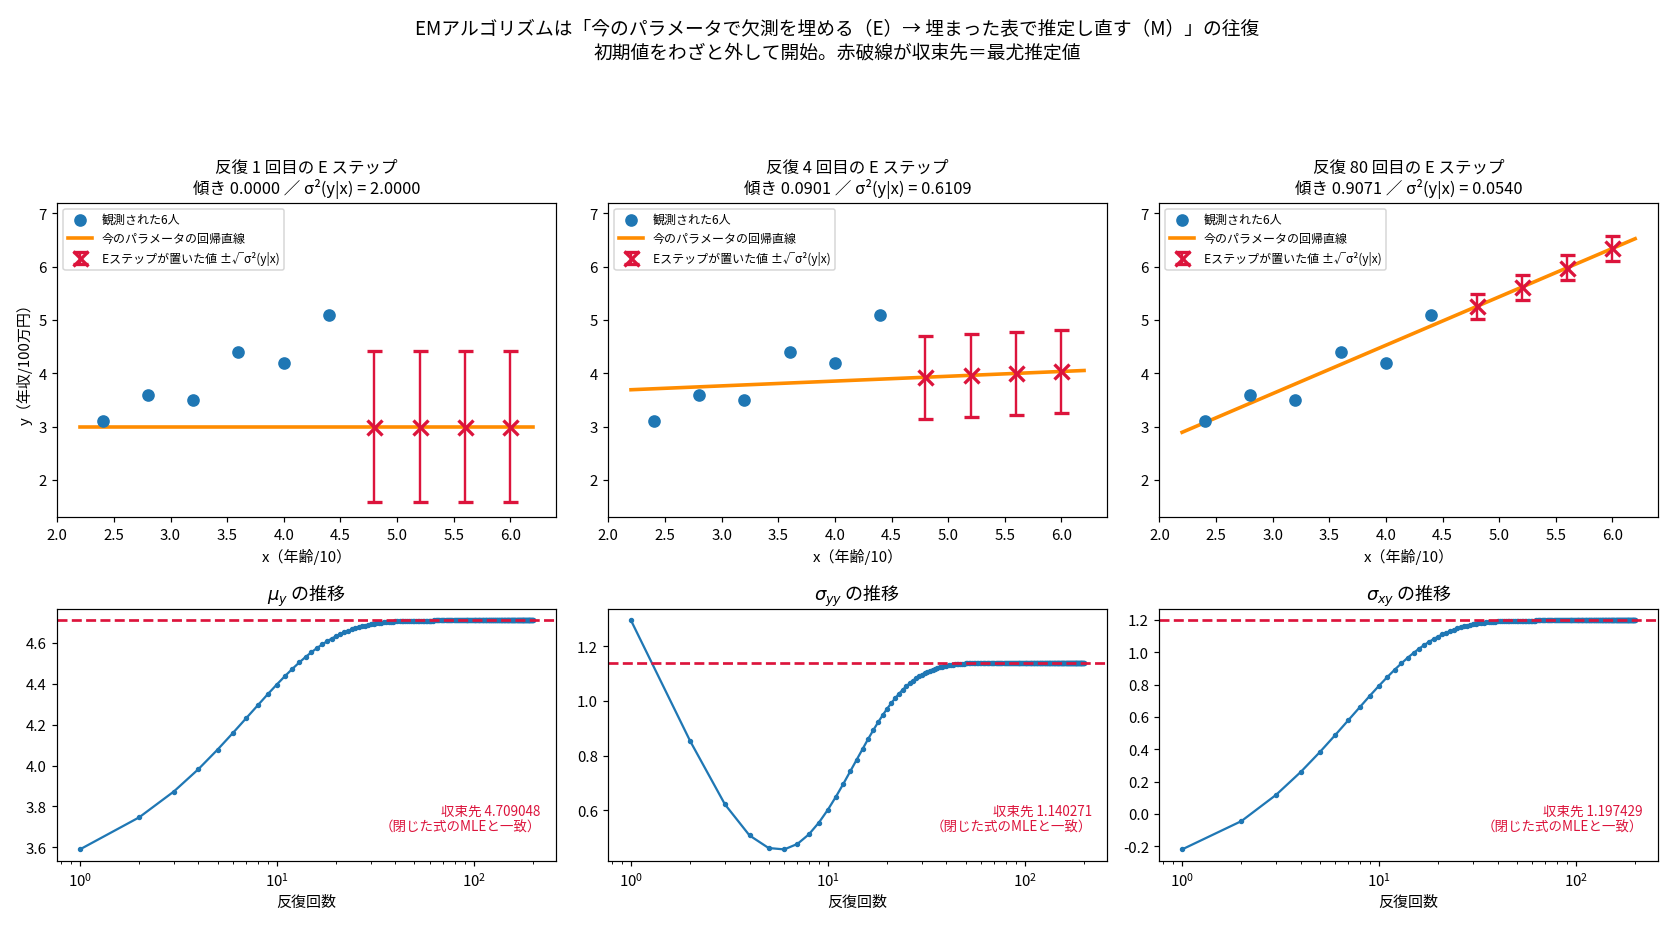
上段で動きが見えます。反復1では傾きが 0 なので、4人を全部 3.0 という同じ高さに置いています。これは平均代入と同じ状態です。反復4で少し斜めになり、反復80では直線に沿って階段状に並びます。
そして赤いひげが縮んでいくのも見てください。ひげの長さは なので、条件付き分散が と小さくなるのに対応して、ひげは と短くなります(パネルのタイトルに出ている 2.0000 や 0.0540 は分散の値で、ひげの長さはその平方根です)。EM は「埋める値」と「その値に対する自信」を同時に育てています。
下段では、 が一度 1.29 から 0.46 付近まで下がってから 1.14 まで戻る非単調な動きをしています(表に載せていない反復7が谷底で、最小値は反復6の 0.4569 と反復7の 0.4768 のあいだ、図では約 0.45 に見える位置です)。単調に改善するわけではないのが面白いところです(後述しますが、単調非減少が保証されているのは尤度であってパラメータではありません)。
収束先は最尤推定値そのもの
この欠測パターン(x が全観測で y が単調に欠測)では、運良く最尤推定値が閉じた式で書けます。完全ケース6人で回帰を推定すると 、切片 、残差分散 で、ここから直接計算できます。
| EM の収束値 | 4.709048 | 1.140271 | 1.197429 |
| 閉じた式の最尤推定値 | 4.709048 | 1.140271 | 1.197429 |
| 一致誤差 |
12桁一致しました。 ここが私の最大の疑問への答えでした。
EM は新しい推定量ではない。第10回でやった最尤推定値を求めるための計算手順である。
答えは最尤法と同じもので、そこに至る道が反復になっているだけです。「EM 推定量」という別の推定量があるわけではありません。
他の方法と並べると差が見えます。
| 方法 | の推定値 | の推定値 |
|---|---|---|
| リストワイズ削除(6人) | 3.983333 | 0.438056 |
| 平均代入 | 3.983333 | 0.262833 |
| EM(=最尤法) | 4.709048 | 1.140271 |
削除だと が 3.98、EM は 4.71 で、0.73=73万円分の差です。欠測しているのは x が大きい(年齢が高い)側で、x と y には強い正の関係がある。だから「捨てた4人は高い側にいたはずだ」という情報を、x を通じて回収しているわけです。
肝は E ステップの「+ 条件付き分散」
ここが平均代入・回帰代入と決定的に違う点です。M ステップで分散を計算するには が必要ですが、
と、右辺に第2項が付きます。これは新しい式ではなく、第3回の分散の定義を移項しただけです。
に、全部「」を付けただけ。 は の別名です。
数値で確かめます。7人目()は、収束時には「5.253 を中心に、分散 0.054 でばらつく」という分布だと見なされています。仮にこの人の年収が等確率で2通り、()だとしましょう。つまり 5.0206 か 5.4854 です。
一方、中心の値を2乗しただけなら です。差は で、ぴったり条件付き分散になります。
y の平均は 5.253 だが、 の平均は ではない。 第10回で扱った の話です。そして は凸関数なので、イェンセンの不等式から と必ず上に外れる。その外れ幅がちょうど分散です。
表に数字を書くと分散がゼロになる
M ステップで分散を計算するとき、平方和が必要で、そこに が入ります。
7人目に何を足すか。
- 回帰代入:表に 5.253 と書いたので、 を足す
- EM: を足す()
回帰代入は1人あたり 0.054 ずつ足し忘れている。 これが積み上がって分散が過小になっていました。前節の「SD 111.91 vs 真値 120.50」の正体はこれです。
言い方を変えると、これが今回の核心になります。
表に1つの数字を書き込むという行為が、そもそも「その人の分散はゼロ」を意味してしまう。
だから EM は表に数字を書かず、「この人は 5.253 ± 0.2324 の分布」という幅ごと持ち回ります。E ステップの正式な説明が「値を代入するのではなく対数尤度の期待値を計算する」なのは、 と の両方の期待値を扱っているという意味でした。
第18回の IRLS と似ているのか
どちらも「解析的に解けないから反復する」のは同じですが、解けない理由が違います。
| 第18回のニュートン法/IRLS | 今回の EM | |
|---|---|---|
| データは | 揃っている | 欠けている |
| 何が難しいか | 尤度の式は完全に書けるが、微分して0にした式が代数的に解けない | 尤度の式そのものが書けない(欠測値が中に入っている) |
| 反復で何をするか | 曲面の頂上へ登る(接線・2次近似を使う) | 「欠測を埋める」と「パラメータを直す」を交互に |
| 1回の更新で使うもの | 1階微分と2階微分(ヘッセ行列) | 条件付き期待値(微分不要) |
| 尤度は毎回上がるか | 保証なし(行き過ぎて下がることがある) | 下がらない(単調非減少が証明されている) |
| 収束の速さ | 速い(2次収束・数回) | 遅い(1次収束。今回は80回) |
表の「保証なし」については補足が必要でした。実際に測ってみると、失敗の仕方が2種類ありました。
| 状況 | 対数尤度の推移 |
|---|---|
| 通常のデータ・初期値 | −41.59 → −34.54 → −34.34 → −34.34(単調増加・3回で収束) |
| 初期値を大きく外す | −768 → → (発散) |
| 完全分離データ( なら必ず ) | 尤度は と単調に 0 へ上がるが、 が と止まらない |
ロジスティック回帰の対数尤度は正準リンクなので凹であり、普通のデータを普通の初期値で回せばまず単調に増加します。「保証なし」が効いてくるのは、初期値を大きく外してフルステップで行き過ぎる場合で、実務ではステップ幅を縮めるだけで防げます。
もうひとつの完全分離は性質が違って、尤度は下がらないのに推定値が発散するという失敗です。初期値の問題ではなく最尤推定値が有限の値として存在しないためで、これは EM に替えても解決しません(第18回で扱った Hauck-Donner 効果の背景です)。
ロジスティック回帰の場合、尤度は と完全に書けます。データは全部揃っている。困るのは微分して0にした連立方程式が について解けないという、純粋に代数の問題です。
欠測の場合はもっと手前で困ります。尤度を書こうとすると 7 人目の が式の中に必要なのに、その値がない。式が書けないので微分もできない。
そこで EM は を1つの数字ではなく分布として持ち、その分布で尤度の期待値を取ります。「 が 5.02 なら尤度はこう、5.49 ならこう、それを重み付けして平均」という形にすれば、 が式から消えてパラメータだけの関数になる。そうなればいつもの最尤推定が使える。 M ステップが「いつもの平均・分散の式を当てるだけ」で済んだ理由です。
遅いが頑丈というトレードオフ
今回 80 回かかりました。ニュートン法なら5回程度で済む場面です。ではなぜ EM を使うのでしょうか。
- 微分がいらない。 2階微分(ヘッセ行列)を導出・実装するのは面倒で、欠測パターンが複雑だと現実的でありません
- 絶対に下がらない。 ニュートン法は初期値が悪いとステップが行き過ぎて発散します(上の実測で対数尤度が )。EM は初期値をどれだけ外しても(今回は から始めました)尤度が単調非減少で、必ずどこかに着きます
- 1回の更新が「いつもの推定式」で書ける。 実装が驚くほど簡単です
安定性を速度で買っているわけです。
ただし2に関して弱点もあります。尤度が単調非減少であることは保証されますが、たどり着くのが最大値だとは保証されていません。 一般に保証されるのは停留点に着くことまでで、局所最大だけでなく鞍点に捕まることもあります。混合正規分布のあてはめでは実際に起きます。第24回で扱った「停留点と最大値は別物」という話と同じ構図です。対策は初期値を複数試すことです。
なお EM の反復は と、現在の値だけから次の値が決まる写像の繰り返しです。第22回のマルコフ連鎖で扱った「 を満たす定常分布に収束する」のと同じ構図で、EM の収束先も という不動点です。 が非単調に動いたのは、この写像が不動点に向かう途中の挙動でした。
EM は欠測専用の道具ではない
応用範囲はこの章より広いです。「観測できない何かがある」という形をしていれば全部 EM に乗ります。
| 場面 | 「欠測している」ものは何か |
|---|---|
| 今回の欠測データ | 答えてもらえなかった年収 |
| 混合正規分布のあてはめ | 各点がどのクラスターに属するかというラベル |
| 隠れマルコフモデル | 各時刻の隠れ状態 |
| 第19回の打ち切りデータ | 打ち切られた後の本当の生存時間(区間としてだけ分かる) |
| 第27回の因子分析 | 観測できない共通因子の値 |
私は研究で隠れマルコフモデルを使ったことがあるのですが、そのライブラリの中身のパラメータ推定は EM でした(この文脈ではバウム・ウェルチ法と呼ばれます)。「各時刻の隠れ状態」が欠測データで、E ステップで「時刻 に状態 にいた確率」を計算し、M ステップで推移確率と出力確率を更新する。今日追った反復と構造が同じです。
第26回のクラスター分析で扱った k-means 法も、EM の親戚です。「各点がどのクラスターに属するか」を割り当てる段階と、「クラスターの中心を計算し直す」段階の往復になっており、E と M の構造そのものです。違いは、k-means が所属を 0/1 で断定する(ハード割り当て)のに対し、混合正規分布の EM は「70% はクラスター1、30% はクラスター2」という確率で持つ(ソフト割り当て)点です。ここでも「1つに決めてしまうか、分布として持つか」という今回の主題が顔を出します。
打ち切りは欠測なのか
第19回で扱った打ち切りデータとの関係です。答えは「欠測に見えるが、実際には欠測していない(区間として観測されている)」でした。この違いが、打ち切りだけが直せる理由になります。
契約期間(解約までの月数)が平均24ヶ月の指数分布で、観測期間は12ヶ月とします。12ヶ月時点でまだ解約していない人は打ち切りです(このケースでは 60.6% が打ち切りになります)。4000 回、n=500 のシミュレーションです。
| 方法 | 推定値 | 偏り |
|---|---|---|
| ①打ち切り値をそのまま平均(12を入れる) | 9.44 | −14.56 |
| ②打ち切られた人を捨てる | 5.50 | −18.50 |
| ③打ち切りを正しく扱う最尤推定 | 24.09 | +0.09 |
②が第19回で見た「打ち切り捨てで77%短くなる」現象です()。打ち切りが 60.6% なので、リストワイズ削除すると6割を捨てることになります。しかも捨てられるのは長く続いた人ばかりなので、残った4割は短命な人の集まりです。
一見 MNAR に見えるのに直せる理由
「解約月」という変数だけを見ると、長く続いた人が欠測している。つまり欠測が値そのものに依存しているので、これは MNAR の形です。前半でやった「年収が高い人が答えない」と同じ構造です。
ところが打ち切りには、通常の欠測にない情報が2つあります。
| 通常の欠測(年収) | 打ち切り(生存時間) | |
|---|---|---|
| 分かること | 何も分からない | 区間が分かる(12以上) |
| 欠測の仕組み | 不明(MAR か MNAR か判別不能) | 既知(観測終了日というルール) |
| 尤度への書き方 | 積分して周辺化するしかない | 生存関数 をそのまま掛ける |
| 直せるか | MAR を仮定すれば直る | 仮定が少なくて済む(ゼロではない。後述) |
打ち切られた人の尤度への貢献を、密度 ではなく にする。「値は知らないが12以上だ」という情報を、そのまま尤度に書けるわけです。
つまり打ち切りは欠測に見える状況の中で最も恵まれたケースです。第19回で打ち切りをちゃんと扱えたのは、欠測の仕組みが既知だったからでした。
用語の整理(ここは私が混同していました)
当初、私はこれを「値そのものが欠測を決めるが仕組みが既知なので、無視できる(ignorable)欠測に分類される」と理解していました。これは誤りでした。
ルービンの枠組みでの ignorability の定義は「MAR + パラメータの分離性」です。つまり MNAR かつ ignorable という組み合わせは存在しません。では打ち切りは何なのでしょうか。
答えは「打ち切りは欠測ではなく粗視化(coarsened)データ」です。値が消えているのではなく、「 という区間」に粗くなっているだけ。この枠組みは CAR(Coarsening At Random=ランダムな粗視化) と呼ばれます。条件は「粗視化の仕組みが値に依存しない」ではありません(12ヶ月打ち切りは かどうかという値に依存して起きています)。正しくは粗視化の確率が、観測された粗いデータ(「」という情報)だけで決まり、その区間内のどこに真値があるかには依存しないことです。MAR の粗視化版に当たる条件で、これが成り立つと尤度が分離して を掛ける形が正当化されます。
「値そのものが欠測を決めるのに直せる」の正体は、そもそも欠測していないことでした。 区間として観測されているのです。
「仮定なしで直る」も言い過ぎでした
必要な仮定が2つあります。
ひとつは無情報打ち切り(non-informative / independent censoring)で、これが欠測データ論の MAR に対応します。全員が12ヶ月で観測終了する管理打ち切りなら自動的に満たされますが、「早く解約しそうな不満のある人が、先に連絡が取れなくなって脱落する」ような打ち切りだと崩れます。実際に試すと 24ヶ月が 46.01ヶ月になりました。
もうひとつは分布の特定です。上の 24.09 は「指数分布」を正しく仮定できたから出た数字でした。
| 真の分布(どれも平均24ヶ月) | 指数分布として推定した値 |
|---|---|
| 指数分布 | 24.09 |
| 対数正規分布 | 33.31 |
| ワイブル分布() | 63.88 |
ワイブルで 63.88 は 2.7 倍の過大です。60.6% が打ち切られている状況では、観測できているのは分布の左端だけで、右側の形はほぼ全部を仮定が決めている。カプラン・マイヤー法に逃げても、最後の観測点より先の平均は識別できません。
正しい言い方はこうなります。
打ち切りは、区間情報が残るので仮定の量が少なくて済む。ただしゼロではない。
逆向きの応用
第19回では打ち切りを生存時間解析の道具として扱いましたが、通常の欠測を打ち切り風に扱うという発想もあります。
アンケートで年収を数値で聞く代わりに「400万円未満/400〜600万/600万以上」と区間で聞けば、答えてもらいやすくなり、しかも打ち切りと同じ形の情報が手に入ります。値は不明でも区間が分かるので、尤度に正しく書ける。
「答えてくれない」を「区間だけ答えてくれる」に設計変更すると、欠測問題が打ち切り問題に格下げされる。 判別不能な MAR / MNAR の問いを、検証しやすい仮定に置き換えられるわけです。実務ではかなり有効な手だと思います。
多重代入法:なぜ複数回埋めるのか
私の疑問は「1回でよいのではないか」でした。乱数で誤差を足すなら、1回埋めれば十分な気がします。
結論から書くと、推定値については1回で十分でした。複数回必要なのは別の理由です。
まず確率的回帰代入
回帰代入に足りないのは「予測の誤差」でした。そこで埋める値を
埋める値 = 予測の中心 + 乱数
にします。これが確率的回帰代入です。点が直線に張り付かず、本物のデータと同じように散らばります。
これを 回繰り返して結果をまとめるのが多重代入法です。 を変えて測りました(3000回、n=200、MCAR 30%欠測、真の平均 452.0)。
| 方法 | 推定値 | 報告するSE | 本当のSE | 95%被覆率 |
|---|---|---|---|---|
| 確率的回帰代入 1回のみ | 452.04 | 8.502 | 9.957 | 90.9% |
| 多重代入 m=2 | 452.04 | 9.278 | 9.420 | 94.2% |
| 多重代入 m=5 | 451.99 | 9.154 | 9.429 | 94.1% |
| 多重代入 m=20 | 451.73 | 9.070 | 9.338 | 94.4% |
| 多重代入 m=100 | 451.86 | 9.047 | 9.360 | 93.8% |
推定値の列を見てください。1回でも m=100 でも 452 前後で変わりません。
変わるのは報告するSEです。1回だけだと 8.502 と報告するのに本当は 9.957。過小評価なので被覆率が 90.9% に落ちます。m=2 にした瞬間 9.278 になり、被覆率が 94.2% に回復します。
複数回埋める理由は、標準誤差を正しく報告するためである。
そして m=2 でほぼ効果が出て、m=5 で十分でした。m=100 にしてもほとんど改善しません。教科書に「 程度でよい」と書かれている理由が、この表で納得できました。
1回だと足りない理由
1回で埋めると、埋めた表は「本物のデータ」に見えます。そこから普通に標準誤差を計算すると、200人分のデータがある前提の値が出ます。しかし 57 人分の値は自分が乱数で作ったものなので、そこに情報はありません。
欠測の不確実性には2種類あります。
| 不確実性の中身 | 1回の代入で見えるか | |
|---|---|---|
| ①標本のばらつき | 200人という有限のサンプルから平均を推定することの誤差 | 見える(いつもの ) |
| ②欠測のばらつき | 埋めた57人の値が「本当は何だったか分からない」ことによる誤差 | 見えない(答えが1つしかない) |
②を見るには、答えを複数持つ必要があります。だから乱数を変えて何通りも埋めて、答えがどれくらいばらけるかを実測する。第11回のブートストラップと同じ「ばらつきを知りたければ何回もやってみる」という発想です。
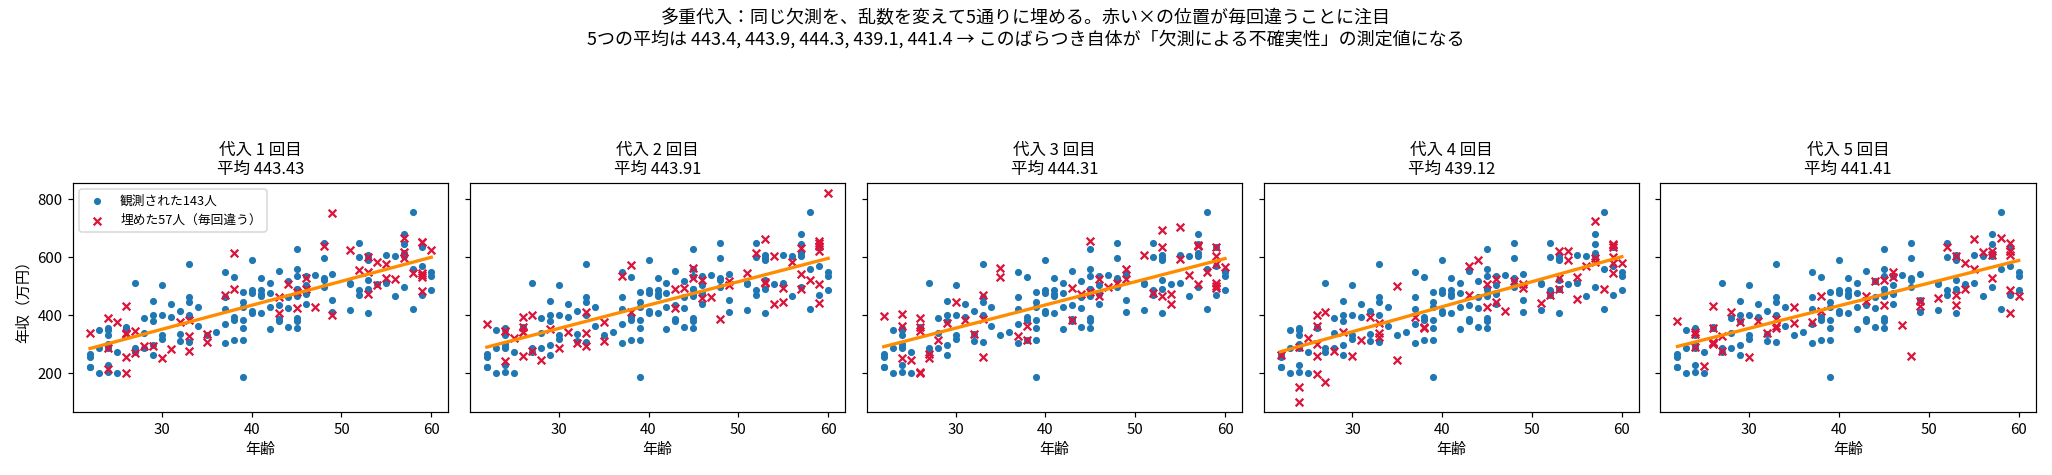
観測 143 人(青)は5枚とも同一で、赤い×だけが毎回違います。その結果、5枚の平均が 443.43 / 443.91 / 444.31 / 439.12 / 441.41 とばらけます。このばらつきそのものが②の測定値です。
ルービンの公式は何を足しているのか
上の5枚から出た数値です(この標本では観測143人・欠測57人・残差SD 74.81)。
| 代入 | 平均 | 分散 | 埋めた最初の3人 |
|---|---|---|---|
| 1 | 443.4336 | 72.4744 | 526.83, 479.15, 334.20 |
| 2 | 443.9057 | 69.5275 | 494.57, 561.65, 376.02 |
| 3 | 444.3114 | 70.2965 | 702.61, 477.89, 530.94 |
| 4 | 439.1153 | 75.6578 | 454.38, 427.56, 245.68 |
| 5 | 441.4071 | 66.6160 | 557.76, 433.76, 374.36 |
推定値は単純平均です。
分散は2つを足します。これがルービンの公式です。
| 記号 | 読み方 | 何を測っているか | 値 | |
|---|---|---|---|---|
| 代入内分散(within) | 各回の表の中で普通に計算した分散の平均。①標本のばらつき | 70.9144 | 8.4211 | |
| 代入間分散(between) | 5つの どうしのばらつき。②欠測のばらつき | 4.6895 | 2.1655 | |
| 全分散(total) | 76.5418 | 8.7488 |
ルービンの公式が足しているのは、①と②である。
「もしデータが揃っていたら残っていた誤差」+「揃っていないことによる追加の誤差」です。
1回の代入では しか計算できません。 は複数の答えがないと定義できない量です。これが「複数回埋める」の答えでした。
という補正がついているのは、 回という有限回で を推定していること自体の誤差を織り込むためです。 が小さいほど大きくなり( なら1.2倍)、 で1に近づきます。
情報の損失割合
と の比が、欠測でどれだけ損したかを教えてくれます。
57人分(28.5%)が欠測しているのに、全分散のうち欠測に由来する分は 7.35%(同じ設定を繰り返したときの平均は 13.0%)でした。欠測割合の 28.5% よりずっと小さく収まるのは、年齢という強い予測変数(相関 0.75)があるおかげで、欠測した人についてもかなりのことが分かるからです。
ただし数字の読み方に注意が2つ必要でした。
ひとつは用語です。 は正確には「全分散のうち欠測に起因する割合」で、ルービンの FMI(Fraction of Missing Information=欠測情報割合)は自由度補正を含む (ただし )という別の式です。 は が大きいときの近似で、この標本では に対し FMI は 7.60% でした。近いのですが同じものではありません。
もうひとつはこの 7.35% が1標本の値だという点です。 で を推定しているので、 自体が激しくばらつきます。同じ設定を800回繰り返すと の平均は 13.0%、5〜95パーセンタイルは 3.0%〜28.1% でした。7.35% は下振れした1回の引きです。 が小さいときの は方向性の目安であって、報告する数字として信用しすぎない方がよさそうです。
この標本でのSEを並べると、こうなります。
| 方法 | 標準誤差 |
|---|---|
| 完全データ(欠測がなかったら) | 8.5235 |
| 多重代入 m=5 | 8.7488 |
| リストワイズ削除 | 9.5840 |
多重代入は完全データにかなり近いところまで戻せています。そして削除より良い数字を出すのに、削除より正直です。平均代入は「削除より良い数字を報告するが嘘」でしたから、そこが決定的に違います。
3段階の手順
| 段階 | 英語 | やること |
|---|---|---|
| 1. 代入 | Imputation | 欠測を 通りに埋めて、 個の完全なデータセットを作る |
| 2. 分析 | Analysis | 個それぞれに、いつもの分析をそのまま適用する(平均でも回帰でも検定でも) |
| 3. 統合 | Pooling | 個の結果をルービンの公式でまとめる |
段階2が「いつもの分析をそのまま」でよいのが、多重代入の実務上の強みです。欠測用に特別な分析手法を覚え直す必要がありません。
EM だと分析ごとに欠測を組み込んだ尤度を書き直す必要がありますが、多重代入は「データを作る」段階で問題を解決してしまうので、後段は普通のツールが使えます。
なお実際の多重代入では、埋める値の生成にベイズ的な手続きを使います。回帰係数 自身にも推定誤差があるので、その事後分布からも を引き直してから予測値を作る、という二段構えです。今回のシミュレーションは を固定した簡易版なので、正式な多重代入よりわずかに を小さく見積もっています。多変量の欠測に対しては連鎖方程式による多重代入(MICE)が標準的で、変数ごとに順番に回帰して埋めるループを回します。
完全情報最尤法(FIML)
FIML(Full Information Maximum Likelihood=完全情報最尤法)は、欠測を埋めず、各人が持っている情報だけで尤度を書いて足し上げる方法です。
| その人が持っている情報 | 尤度への貢献 |
|---|---|
| x と y の両方(143人) | 2変量正規の密度 |
| x だけ(57人) | y について積分して消した周辺密度 |
( は両方ある人、 は x だけの人)
「観測されていない変数は、尤度から積分して消す」だけです。 欠測している人を捨てるのでもなく、値を作るのでもなく、その人が知らせてくれた分だけを使う。
FIML は EM とまったく同じ最尤推定値を返します。違いは解き方だけで、EM は反復(E→M→E→M)で解き、FIML はこの を数値最適化で直接最大化します。今回の n=10 の例で EM が出した 4.709048 は、FIML の答えでもあります。
| EM | FIML | 多重代入 | |
|---|---|---|---|
| 欠測を埋めるか | 内部で埋める(期待値として) | 埋めない | 埋める(m通り) |
| 解き方 | 反復(E↔M) | 数値最適化で直接 | 乱数で生成→統合 |
| 推定値 | 最尤推定値 | 最尤推定値(EMと同じ) | ほぼ同じ |
| 標準誤差 | 別途計算が必要(弱点) | 最適化の副産物で出る | ルービンの公式 |
| 後段の分析 | 分析ごとに尤度を書き直す | 分析ごとに尤度を書き直す | いつもの分析がそのまま使える |
| 正しく効く条件 | MAR | MAR | MAR |
EM の弱点として挙げた「標準誤差が出ない」は実務では重要です。EM は点推定値を返しますが、その精度は教えてくれません(尤度の2階微分を別に計算するか、ブートストラップを回す必要があります)。
FIML と多重代入は標準誤差まで面倒を見てくれるので、実務ではこの2つが主流です。EM は「何が起きているか」を理解するのに最適な形をしていますが、道具としては裏方に回っている印象です。
感度分析:MNAR に対する唯一の誠実な対応
MAR か MNAR かは検定できませんでした。だからと言って諦めるのでもなく、MAR だと決めつけるのでもない第三の道が感度分析です。
やり方は単純で、MNAR の度合いをパラメータ にして振ってみます。
無回答者の年収 = (同じ年齢の回答者からの予測値) + +
が MAR の仮定です(無回答者は同じ年齢の回答者と同じ)。 なら「無回答者は隠れて年収が高い」という MNAR を表します。
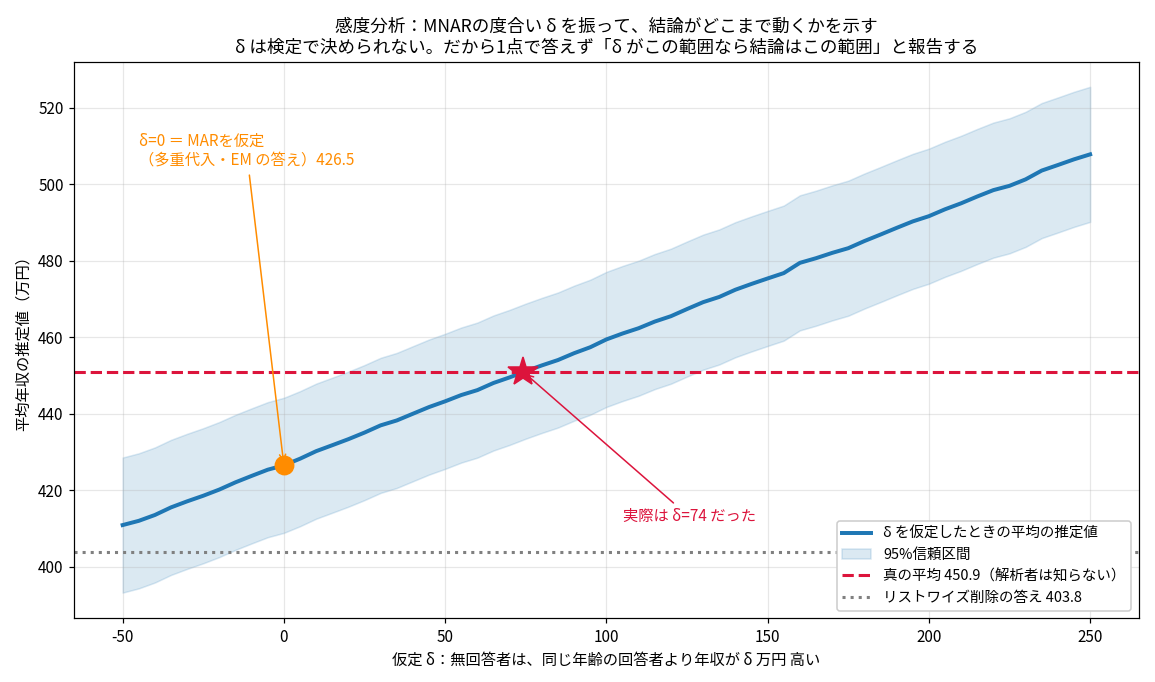
での推定値は 426.5(オレンジの点)です。ところがこのデータの真の は 74 で、真の平均は 450.9(赤破線)でした。
つまり MAR を仮定した多重代入・EM も、実際が MNAR なら外します。ただし灰色の点線(リストワイズ削除の 403.8)はさらに下にあり、描いた範囲のどの でも点推定の線より下にあります(信頼区間の帯まで含めると、 が負の側では帯が 403.8 に届きます)。MAR を仮定した推定は、少なくとも削除よりは真値に近い位置から出発しています。
そしてグラフのどの点が正しいかはデータから決められません。だから報告の仕方が変わります。
「無回答者が回答者と同程度()なら平均は 426 万円。無回答者が 100 万円高いなら 459 万円。 を超えないと『平均は 475 万円以上』という結論にはならないので、そこまで極端な無回答バイアスが考えにくいなら、平均は 427〜476 万円の範囲と考えられる。」
1つの数字ではなく、条件つきの幅で答える。 この形にすると、読み手が自分の分野の知識で を選べます。
MNAR を検定で解決できない代わりに、判断を「 の妥当な範囲はどこか」という答えられる問いに置き換えるのが感度分析の狙いです。
グラフの傾き自体も情報です。緩やかなら「 が多少ずれても結論は変わらない=頑健」、急なら「結論が仮定に大きく依存する=慎重に扱う」と読みます。
なお MNAR に正面から取り組むモデルとして、ヘックマンの2段階推定(選択モデル)やパターン混合モデルがあります。前者は「回答するかどうか」を決める式と「年収の値」を決める式を同時に推定する方法で、経済学でよく使われます。ただし識別のために「回答するかどうかには影響するが年収には影響しない変数」を見つける必要があり、その仮定が満たされているかは検証できません。MNAR ではどこかに検証不能な仮定が必ず残るという構造は変わりません。
実務:アンケートの無回答をどう扱うか
優先順位をつけると、解析より前の設計段階でできることが圧倒的に効きます。
| 順位 | やること | なぜ効くか |
|---|---|---|
| 1 | そもそも欠測を出さない設計。 答えにくい質問(年収・年齢)は選択肢の区間にする、必須にする、質問数を削る | 欠測がなければ全部の問題が消える。年収を区間で聞けば打ち切りと同じ扱いができて、「MAR か MNAR か」という判別不能な問いを避けられる |
| 2 | 欠測を予測できる変数を一緒に集める。 属性・行動ログ・回答にかかった時間・回答日時など | MAR か MNAR かは「何を一緒に集めたか」で決まる。予測変数が増えるほど MAR に近づき、直せる欠測になる |
| 3 | 無回答者を追跡して一部だけでも回収する(再依頼・電話で一部の項目だけ聞く) | 回収した一部から を推定できる。感度分析の仮定を実測値に置き換えられる。MNAR を検定不能から脱出させる唯一の道 |
| 4 | 欠測の状況を必ず報告する。 項目ごとの欠測率、無回答者と回答者の属性比較 | 読み手が判断できる。報告しないのが最も悪い |
| 5 | 解析は多重代入か FIML。 予測変数を惜しみなく入れる | MAR なら偏りが消え、標準誤差も正しく出る |
| 6 | MNAR の感度分析を添える | MAR が疑わしいときに結論の頑健性を示せる |
5について補足すると、代入モデルに入れる変数は最終的な分析に使わないものでも入れてよい(むしろ入れるべき)です。欠測を予測できる変数が多いほど MAR の仮定が現実に近づくからで、これは「モデルは単純な方がよい」という第32回のモデル選択の原則とは逆向きに働きます。代入は予測の問題であって、説明の問題ではないという区別です。
そして、やってはいけないことが1つあります。
平均代入。 これだけは明確に避けます。分散を縮め、相関を薄め、信頼区間で嘘をつく(被覆率 81.5%)。リストワイズ削除の方がまだ正直です。
第21回で扱った標本調査法の無回答バイアスとの関係も整理しておきます。あちらでは重み付け(無回答が多い層の回答者に重みを増やす)という対処を扱いました。これは今回の枠組みで言えば「層という観測変数で条件付ける」ことなので、MAR を仮定した対処です。同じ仮定の上に立っている2つの技術で、重み付けは層単位・多重代入は個人単位という粒度の違いになります。
自分が間違えていたこと
この章で自分の理解が間違っていた点を残しておきます。
1. 平均代入を「無害」だと思っていた
平均が動かないから大きな害はないだろうと考えていました。実際には平均だけが無事で、分散・標準誤差・相関・回帰係数がすべて壊れます。しかも被覆率が 81.5% で、データを捨てた場合(94.1%)より悪い。「何もしないより悪い処置」がありうるという点が、いちばんの発見でした。
2. MCAR を「誰が答えないか分からない状態」と表現した
これは MNAR の説明になってしまいます。MCAR は「どういう人が答えないという偏りが、そもそも存在しない」状態です。「分からない」のは MNAR の困りごとで、MCAR は偏りの有無という一段前の話で脱落しています。
| 偏りがあるか | 偏りの原因は手元にあるか | |
|---|---|---|
| MCAR | ない | (偏りがないので不要) |
| MAR | ある | ある |
| MNAR | ある | ない |
3. 「未観測の原因があれば MNAR」と考えた
血圧計の故障のように、知りたい変数と無関係な未観測の原因なら、記録がなくても MCAR のままです。分かれ目は「未観測かどうか」ではなく「その原因が知りたい変数とつながっているか」でした。
4. 「MAR か MNAR か区別できないから正しい結果は出せない」と考えた
区別できないのは事実ですが、結論は間違いでした。MAR なら削除は偏るが、正しく埋めれば偏らない(+39.60 → +0.02)。そして実務では「MAR を仮定して推定し、MNAR だったらどれだけずれるかを感度分析で示す」という2段構えを取ります。
5. 「MCAR なら削除で十分」と考えた
偏りについては正しいのですが、精度で損をしています。捨てた人にも他の変数(年齢)が残っており、それを使えば分散を 18.5% 減らせました。追加調査なしで精度を回収できる分を、自分から放棄していることになります。
6. 「代入すると良くなる」の中身を区別していなかった
「良くなる」が2つの別物を指していました。MCAR で代入が効くのは精度が上がるからで、MAR で代入が効くのは偏りが消えるからです。前者はおまけ、後者は必須です。同じ「良くなる」で括ると、どちらが致命的かの判断を誤ります。
7. EM を「最尤法とは別の推定法」だと思っていた
EM の収束値は閉じた式の最尤推定値と12桁一致しました。EM は推定量ではなく、最尤推定値に到達するための計算手順です。「EM 推定量」という別物はありません。
8. 多重代入を「複数回埋めれば推定値が良くなる」と誤解した
推定値は 1 回でも m=100 でもほぼ同じ(452 前後)でした。複数回必要なのは標準誤差を正しく報告するためで、(代入間分散)が複数の答えがないと定義できないからです。目的は推定値ではなく精度の申告でした。
9. 「 は大きいほどよい」と思っていた
m=2 でほぼ効果が出て、m=5 で十分でした。m=100 にしても被覆率は改善しません(94.1% → 93.8%)。 の補正が有限回の誤差を織り込んでいるので、 を増やす見返りが早く飽和します。
10. 「MAR なら削除は必ず偏る」と思っていた
推定したい量によります。 MAR+削除で平均は +39.68 も外しますが、回帰の傾きは −0.0004 しか外しません。削除で歪むのは説明変数の分布で、条件付き分布は歪まないからです。
ただし査読で分かったのは、この性質が MAR 一般のものではないことでした。成立するのは「 だけが欠測」「欠測確率が、回帰モデルに入っている共変量だけで決まる(=共変量依存の欠測)」「モデルが正しく特定されている」の3条件がそろったときだけです。モデルを誤特定すると傾きも 2.00 → 3.45 と壊れます。 私は当初これを「MAR の定義そのもの」と書いていて、そこが誤りでした。
11. 打ち切りを普通の欠測と同じ枠組みで考えていた
打ち切りは最も恵まれたケースでした。ただし当初の理解には2つ誤りがありました。
第一に、これを「MNAR かつ無視できる(ignorable)欠測」と分類したのが誤りです。ignorability の定義は「MAR + パラメータの分離性」なので、MNAR かつ ignorable は存在しません。打ち切りは欠測ではなく粗視化(coarsened)データで、「 という区間」として観測されています。直せる理由は「そもそも欠測していない」ことでした。
第二に「仮定なしで直る」も言い過ぎでした。無情報打ち切りと分布の特定という2つの仮定が必要で、真の分布がワイブルなら 24ヶ月を 63.88ヶ月と答えます。正しくは「仮定の量が少なくて済む。ただしゼロではない」です。
要点まとめ
| 問い | 答え |
|---|---|
| MCAR / MAR / MNAR の分かれ目 | 欠測確率が何で決まるか。何にも依存しない/観測変数で決まる/欠測値そのもので決まる |
| MAR と MNAR の実質的な違い | 偏りの原因が手元にあるか。MARは年齢で直せる、MNARは直す手がかりがデータに無い |
| MAR は「ランダム」か | ランダムではない。 条件付きランダムの意味。統計学で最も紛らわしい命名 |
| MAR か MNAR かはデータの性質か | 違う。「何を一緒に集めたか」で決まる。 原因の変数を測っていれば MAR になる |
| MCAR は検定できるか | できる。 回答群と無回答群で他の変数を比べる(実測 t=−0.570 / +39.576 / −23.937) |
| MAR と MNAR は検定できるか | 原理的に不可能。 同じ観測データが両方の世界から出る(35.9万円違うのにデータは同一) |
| リストワイズ削除が許されるのは | MCARのとき(偏りなし・効率のみ損)。共変量依存の欠測でモデルが正しければ回帰係数は無傷(偏り −0.0004) |
| 回帰係数が無傷になる3条件 | ① だけが欠測 ②欠測確率が回帰モデルに入っている共変量だけで決まる ③モデルが正しく特定されている。③を崩すと傾き 2.00 → 3.45。MAR 一般の性質ではない |
| MCARでの削除の代償 | 標準誤差が 倍(実測 1.191)。10変数×10%欠測で残るのは 35% |
| 平均代入で当たるもの | 平均だけ(451.67、真値452.0) |
| 平均代入で壊れるもの | SD( 倍)・標準誤差(7.098 vs 本当は10.399)・被覆率(81.5%)・相関( 倍)・傾き(−30%) |
| 傾きと相関で係数が違う理由 | 共分散が 0.70 倍・ 不変・ が 倍。傾き は 0.70 倍、相関 は 倍 |
| 平均代入と削除どちらが悪いか | 平均代入。 被覆率 81.5% < 94.1%。捨てれば嘘はつかない |
| 回帰代入の壊れ方 | 平均代入とは逆方向。相関を過大にする(0.803 vs 真値0.748)。傾きは当たる |
| 回帰代入に足りないもの | 埋めた値の予測誤差。 を捨てて中心だけ置いている |
| この章の核心の一文 | 表に1つの数字を書き込むと、その人の分散がゼロになる |
| EMのEステップ | 今のパラメータで欠測の条件付き期待値を計算( と の両方) |
| EMのMステップ | 埋まった表を完全データとして扱い、いつもの推定式を当てる |
| EMの収束先 | 最尤推定値そのもの(閉じた式と12桁一致・誤差 ) |
| EMの肝 | の第2項。回帰代入はこれを落としたEM |
| EM と IRLS の違い | IRLSは尤度が書けるが解けない、EMは尤度そのものが書けない。EMは微分不要で尤度が単調非減少、ただし遅い(1次収束) |
| IRLSが壊れるのは | 初期値を大きく外したとき(実測 )。普通のデータなら単調増加する。完全分離は別種で、尤度は下がらないのに推定値が発散 |
| EMは最大値に着くか | 保証なし。 保証されるのは停留点まで(局所最大・鞍点もあり)。初期値を複数試す |
| EMの応用範囲 | 混合正規・隠れマルコフモデル(バウム・ウェルチ法)・打ち切り・因子分析・k-means。「見えない何か」があれば乗る |
| 打ち切りは欠測か | 欠測ではなく粗視化(coarsened)データ。 「12以上」の区間として観測されている。MNAR かつ ignorable は存在しない(ignorability の定義は MAR+分離性) |
| 打ち切りは仮定なしで直るか | 違う。 無情報打ち切り(違反で 46.01ヶ月)と分布の特定(ワイブルを指数と誤ると 63.88ヶ月)が必要。仮定は少ないがゼロではない |
| 打ち切りを捨てると | 24.0ヶ月 → 5.50ヶ月(−77%)。捨てられるのは長命な6割 |
| 多重代入で複数回埋める理由 | 標準誤差のため。 推定値は1回でも同じ(452前後) |
| はいくつ必要か | m=2で効果、m=5で十分。 m=100でも改善しない |
| ルービンの公式が足すもの | 代入内分散 (標本のばらつき)+ 代入間分散 (欠測のばらつき) |
| の意味 | 回という有限回で を推定していること自体の誤差。 で1 |
| 全分散のうち欠測由来の割合。FMI(欠測情報割合)の大標本近似で別物(この標本で 7.35% vs 7.60%)。 ではばらつきが大きく(800回の5〜95%点で 3.0%〜28.1%)1標本の 7.35% は信用しすぎない | |
| 多重代入の実務上の強み | 段階2で「いつもの分析」がそのまま使える。 欠測用の手法を覚え直さなくてよい |
| FIMLは何をするか | 欠測を埋めず、観測されていない変数を尤度から積分して消す |
| FIMLとEMの関係 | 同じ推定値。 反復で解くか数値最適化で直接解くかの違いだけ |
| EMの実務上の弱点 | 標準誤差が出ない(別途2階微分かブートストラップ)。FIML・多重代入が主流な理由 |
| MNARにどう対処するか | 感度分析。 を振って「 がこの範囲なら結論はこの範囲」と幅で報告する |
| 感度分析のグラフの傾き | 緩やか=結論が頑健、急=仮定に強く依存。傾き自体が情報 |
| MNARを検定可能にする唯一の道 | 無回答者の一部を追跡して回収する。 を実測値に置き換えられる |
| 実務で最も効くこと | 解析より設計。 区間で聞く/予測変数を一緒に集める/追跡調査 |
| 絶対にやってはいけないこと | 平均代入。 削除の方がまだ正直 |
| 第21回の重み付けとの関係 | どちらもMARを仮定した対処。重み付けは層単位、多重代入は個人単位 |
次回
次回は第30章のモデル選択です。今回の話とは逆方向の問題を扱います。
今回は「情報が足りない」ときにどうするかでした。次回は「使える変数がたくさんある」ときに、どれを使うかを決める話です。第16回で「変数を増やすと決定係数は必ず上がる」という現象を見ましたが、その先にある赤池情報量規準(AIC)やベイズ情報量規準(BIC)、交差検証法を扱います。
そして意外な接続があります。今回の代入モデルでは「予測変数を惜しみなく入れるべき」でしたが、次回のモデル選択では「変数は少ない方がよい」という逆の原則が出てきます。同じデータ、同じ変数でも、予測が目的か説明が目的かで正反対の判断になるという話で、今回の最後に触れた区別がそこで正面から扱われます。
また今回の対数尤度が、次回は AIC の計算式の中に として現れます。EM で最大化していたものが、そのままモデル比較の材料になるわけです。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。