分散は「2乗の平均−平均の2乗」:順番を逆にすると別物になる【第3回】
はじめに
第2回ではベイズの定理を扱いました。今回は第3章「分布の特性値」から、分散を中心に見ていきます。
分散の公式は と書かれますが、この形がどこから来たのか、なぜこの順番なのかを説明できるでしょうか。公式として覚えているだけだと、いざ使うときに順番が怪しくなります。今回はそこを手を動かして確かめます。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
TL;DR
- 分散は 。「2乗の平均」から「平均の2乗」を引く。順番が逆だと別物になる
- そもそもの定義は「平均からのズレを2乗して平均したもの」で、展開するとこの形になる
- 独立なら分散は足せる(標準偏差は足せない)。ここから標本平均の分散 が2行で出る
- で割るのは、標本平均を使ったぶん、ズレが小さく出てしまうのを埋め合わせるため
- 平均と分散が同じでも分布の形は違う。それを測るのが歪度(歪み)と尖度(裾の重さ)
- A/BテストのCVRに出てくる も、この公式から2行で導ける
統計の用語が出てくるので、先に用語集を置いておきます。用語を知っている方は「平均だけでは何がわからないのか」まで飛ばしてください。
用語集
定義式も載せますが、すべて後で具体例つきで説明するので、いま覚える必要はありません。 読んでいて「これ何だっけ」となったらここに戻ってください。
散らばりを表す言葉
| 用語 | 定義式 | 意味 |
|---|---|---|
| 期待値/平均 | 値の平均。分布の中心 | |
| 偏差 | 個々の値が平均からどれだけズレたか | |
| 分散 | 偏差を2乗して平均したもの。散らばりの大きさ | |
| 標準偏差 | 分散の平方根。単位が元に戻る |
分散の単位は元の値の2乗(年収なら「万円の2乗」)で意味が取りづらいので、平方根を取って単位を戻したものが標準偏差です。「平均±100万円くらいに散らばっている」と読めるようになります。
なお期待値の定義式は、連続的な値を取る場合は積分になります。
分布の形を表す言葉
| 用語 | 定義式 | 意味 |
|---|---|---|
| 歪度(わいど) | 分布の左右の歪み。0なら左右対称、正なら右に裾が長い | |
| 尖度(せんど) | 分布の裾の重さ。正規分布を0として、正なら裾が重い |
や で割っているのは、単位をなくして分布の形だけを取り出すためです。これがないと「cmで測るか mで測るか」で値が変わってしまいます。尖度で3を引くのは、正規分布のときにちょうど0になるよう基準を合わせているためです。
標本と母集団に関する言葉
| 用語 | 定義式 | 意味 |
|---|---|---|
| 母集団 | — | 本当に知りたい全体(例:全ユーザー) |
| 標本 | 実際に手元にあるデータ(例:調査した100人) | |
| 標本平均 | 手元のデータの平均 | |
| 母分散 | 母集団の分散。本当に知りたい値 | |
| 標本分散 | 手元のデータの分散。 で割る | |
| 不偏分散 | で割る。母分散の推定に使う |
標本分散と不偏分散の違いは、割る数が か かだけです。「不偏」というのは、何度も繰り返せば平均的に正しい値(母分散)になるという意味で、この記事の後半で実際に確かめます。
記号について注意です。 この記事では区別をはっきりさせるため を で割る版、 を で割る版に割り当てました。ただし公式ワークブックや『統計学入門』を含む多くのテキストは、 を不偏分散( で割るほう)に使います。本や問題文が変わったら、まず「その はどちらか」を確認してください。呼び名より割る数のほうが本質です。
平均だけでは何がわからないのか
第2回と同じように、まず困りごとから始めます。
3つの会社が「平均年収500万円」と言っている。この3社は同じだろうか?
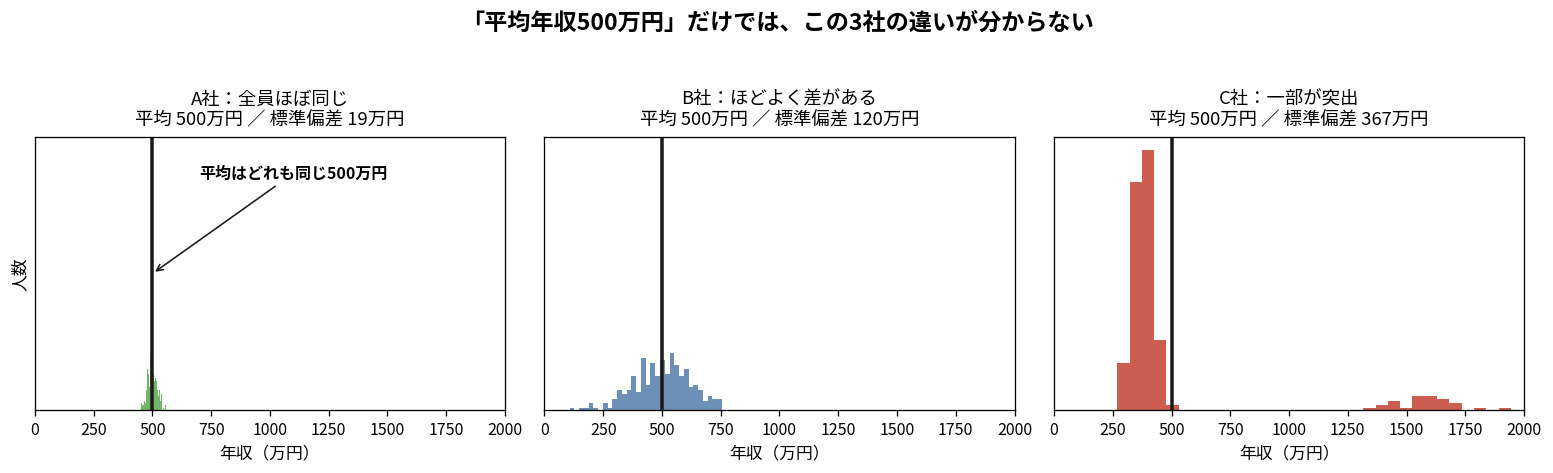
平均はどれも500万円ですが、中身はまったく違います。A社は全員が横並び、B社はほどよく差があり、C社は少数の高給者が平均を引き上げている。
平均という1つの数字では、分布の「散らばり」が表現できない。 だから散らばりを測る量が必要になります。それが分散です。
分散の定義:ズレを2乗して平均する
散らばりを測りたいなら、「平均からどれだけズレているか」を集計すればよさそうです。しかし単純に足すとうまくいきません。
データ: 2, 4, 4, 4, 5, 5, 7, 9  (平均 5)
偏差:  -3, -1, -1, -1, 0, 0, +2, +4
偏差の合計: 0
偏差の合計は必ず0になります。 プラスとマイナスが打ち消し合うためで、これは平均の定義からの必然です。
そこで2乗してから平均します。2乗すればマイナスが消えて、打ち消し合いが起きません。
これが分散の定義です。「平均からのズレを2乗して、その平均を取る」だけのことでした。
なぜ絶対値ではなく2乗なのか。理由はいくつかありますが、実用的には2乗のほうが数学的に扱いやすい(微分できる、後述の展開ができる、正規分布と相性がいい)という点が大きいです。絶対値を使う指標も存在します(平均絶対偏差)が、統計理論の主流にはなりませんでした。
「2乗の平均 − 平均の2乗」の正体
さて、本題の公式です。定義を展開すると、こうなります。
つまり、
ここが私が曖昧だった部分です。 正確には「2乗の期待値 から 期待値の2乗 を引く」。この2つは順番が違うだけで、まったく別の量です。
| 記号 | 読み方 | 計算の順番 |
|---|---|---|
| 2乗の期待値 | 各値を2乗してから、平均を取る | |
| 期待値の2乗 | 平均を取ってから、2乗する |
なお のほうは、平均を取った時点でただの定数になっています。だから「平均の2乗の期待値」と言っても同じ値で、期待値を取る意味がありません。私が混乱していたのはここでした。
実際の数字で確かめます。
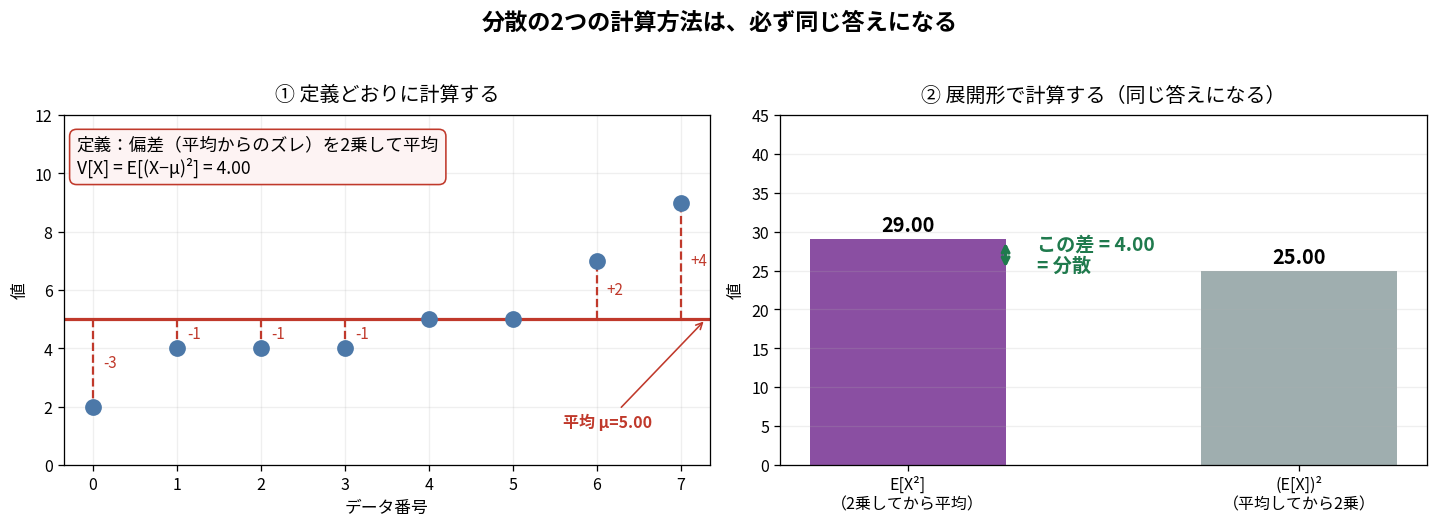
先ほどのデータで計算すると、、 で、差は 4。定義どおりに偏差の2乗を平均しても 4 になり、一致しました。
10万件の乱数でも確かめました。
import numpy as np

rng = np.random.default_rng(0)
x = rng.normal(50, 12, 100000)

by_definition = ((x - x.mean())**2).mean()   # 定義:偏差の2乗の平均
by_formula    = (x**2).mean() - x.mean()**2  # 展開形:2乗の平均 − 平均の2乗

print(by_definition)  # → 144.037012
print(by_formula)     # → 144.037012
小数6桁まで一致します。
この公式が便利な理由
わざわざ展開形を覚える意味は、平均を先に計算しなくても分散が出せる点にあります。定義のままだと「平均を求める→各データの偏差を求める→2乗して平均」と2回データを走査しますが、展開形なら と を一度に集計するだけで済みます。
さらに、理論的な導出でも威力を発揮します。前回出てきた がその例です。
応用:p(1−p) を導いてみる
第2回ではA/Bテストを扱いました。あそこで出てくるCVRのような0/1データの分散は になるのですが、これは今回の公式から2行で出ます。
購入したら1、しなかったら0という変数 を考えます。購入確率は です。
ポイントは になることです。0と1しか取らない変数は、2乗しても値が変わりません(、)。だから2乗の期待値が期待値と一致してしまう。
シミュレーションでも確認しました。
| 分散(実測) | ||||
|---|---|---|---|---|
| 0.1 | 0.0996 | 0.0996 | 0.0897 | 0.0900 |
| 0.3 | 0.3005 | 0.3005 | 0.2102 | 0.2100 |
| 0.5 | 0.5004 | 0.5004 | 0.2500 | 0.2500 |
| 0.9 | 0.8998 | 0.8998 | 0.0902 | 0.0900 |
と が完全に同じ値になっているのが見えます。
A/Bテストで「CVRが50%に近い指標ほど多くのサンプルが必要」と言われる理由も、これで説明できます。 が最大になるのは のときだからです。
もう一つの性質:独立なら分散は足せる
分散には、この先ずっと使うことになる性質がもう一つあります。独立な確率変数を足すと、分散も足せるというものです。
足せるのは分散だけで、標準偏差は足せません。 ここは間違えやすいところです。標準偏差が3と4のものを足すと、標準偏差は7ではなく になります。三平方の定理と同じ形です。
なぜ分散なら足せるのか。今回の展開形を使うと理由が見えます。
最後に残った が共分散です。独立なら なのでこの項が0になって消えます。「独立なら足せる」の正体は「共分散が消えること」でした。逆に言えば、独立でなければ足せません。
サイコロ2個で確かめます。1個の分散は なので、2個の合計の分散は になるはずです。
import numpy as np

rng = np.random.default_rng(0)
a = rng.integers(1, 7, 1_000_000)
b = rng.integers(1, 7, 1_000_000)

print((a + b).var())        # → 5.8340
print(a.var() + b.var())    # → 5.8341
一致しました。
これが標本平均の精度につながる
この性質がいちばん効くのは、 個のデータの平均を取ったときです。同じ分布から独立に取った 個を足すと分散は になるので、それを で割った標本平均の分散は
になります。標準偏差にすると です。データを増やすと推定の精度が で上がるという、この先の推定・検定のほぼ全部を支える式が、「分散は足せる」から2行で出てきました。ここではその出どころだけ押さえておきます。
なぜ n−1 で割るのか
もう一つ、公式を暗記しただけで意味を考えていなかった箇所です。手元のデータから分散を計算するとき、 で割るか で割るかという話があります。
結論から言うと、母集団の分散を推定したいなら で割るのが正しい。理由を実験で確かめました。
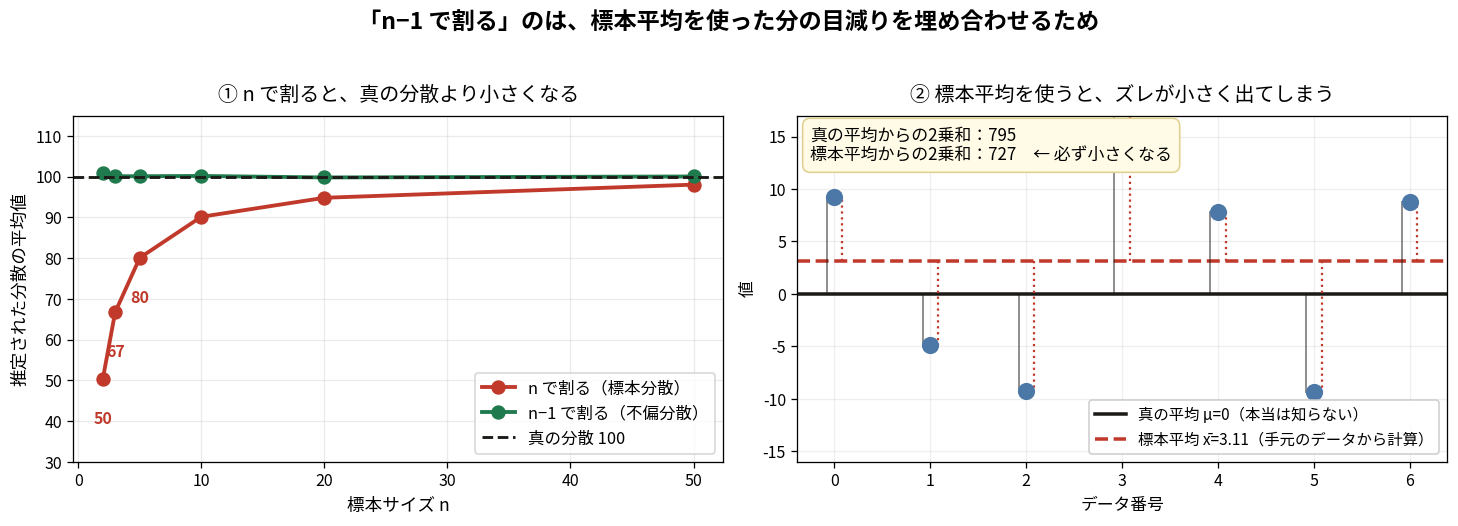
真の分散が100の母集団から 個を取り出して、分散を6万回計算した平均値です。
| 標本サイズ | で割る | で割る |
|---|---|---|
| 2 | 50.0 | 100.0 |
| 3 | 66.4 | 99.6 |
| 5 | 80.0 | 100.0 |
| 10 | 90.0 | 100.0 |
| 30 | 96.9 | 100.2 |
で割ると系統的に小さく出ます。 なら真値の半分、 なら3分の2。一方 で割ると、どの でもぴったり100になります。
小さく出る理由
原因は、真の平均を知らないので標本平均で代用していることにあります。
上の図の右側を見てください。真の平均(黒い実線)からのズレの2乗和は795ですが、標本平均(赤い破線)からのズレの2乗和は727で、必ず小さくなります。
これは偶然ではなく、標本平均は「そのデータからのズレの2乗和を最小にする点」だからです。手元のデータに最もフィットする位置に線を引いているので、真の平均より必ずズレが小さく出る。その目減りを埋め合わせるために、割る数を から に減らして値を持ち上げます。
が小さいほど影響が大きいのも納得できます。データが2個しかなければ標本平均はその真ん中にぴったり来るので、ズレが極端に小さく見積もられるからです。
なお は「自由度」と呼ばれる量で、標本平均を1つ推定したぶん、自由に動ける次元が1つ減ったと解釈します。この考え方は第11章のt検定などで繰り返し出てくるので、ここで押さえておく価値があります。
平均と分散だけでは、まだ足りない
分散があれば散らばりは表現できます。しかし平均と分散が同じでも、分布の形は全然違うことがあります。
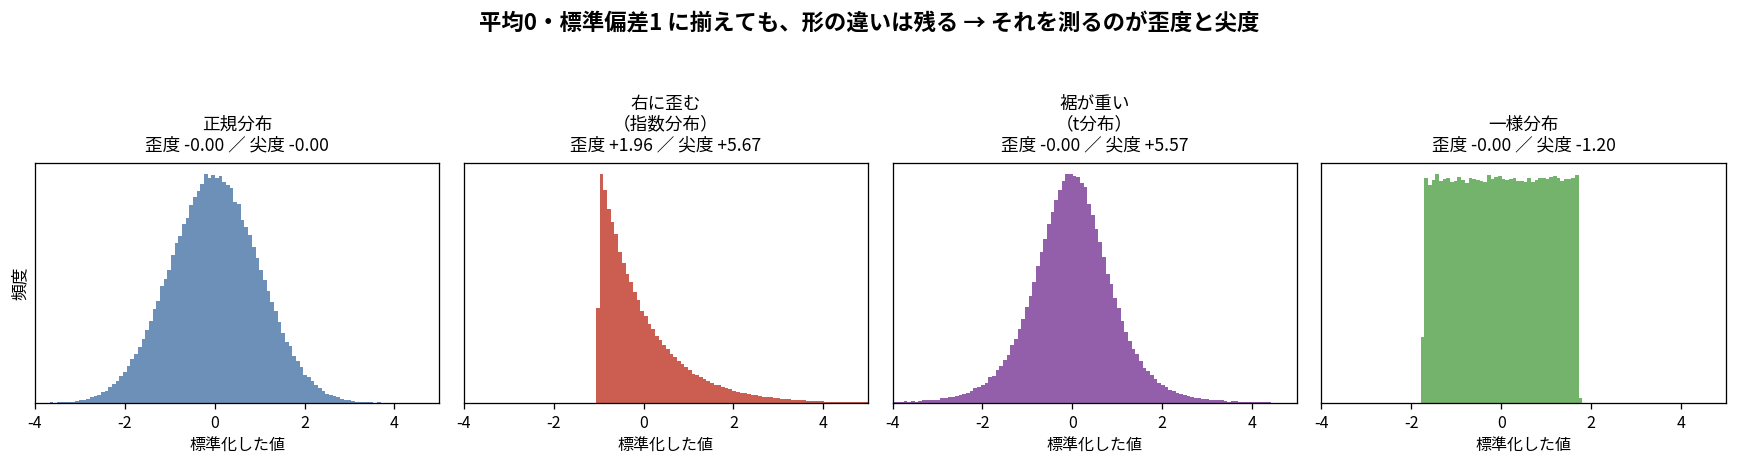
4つとも平均0・標準偏差1に揃えてありますが、形は明らかに違います。この違いを数値化するのが歪度と尖度です。
以下は10万件の乱数から計算した実測値で、括弧内が理論値です。
| 分布 | 歪度(実測 / 理論) | 尖度(実測 / 理論) | 特徴 |
|---|---|---|---|
| 正規分布 | 0.00 / 0 | 0.00 / 0 | 基準。左右対称 |
| 指数分布 | +1.96 / +2 | +5.67 / +6 | 右に長い裾 |
| t分布(自由度5) | 0.00 / 0 | +5.57 / +6 | 左右対称だが裾が重い |
| 一様分布 | 0.00 / 0 | −1.20 / −1.2 | 裾がない(範囲が有限) |
実測値が理論値より小さめに出ているのは偶然ではありません。 尖度は偏差の4乗を使うので、値の大半を決めるのは滅多に出ない極端な値です。裾の重い分布では、その極端な値が標本にたまたま入らないことが多く、標本尖度は系統的に下振れします。指数分布の +5.67 も t分布の +5.57 も、10万件あっても理論値6には届きませんでした。
裾が重い分布ほど「実測の尖度」は信用できない、という点はそれ自体が実務の教訓でした。手元のデータの尖度が小さく出ても、裾が軽いことの証明にはなりません。
用語集に定義式を載せましたが、歪度は「偏差の3乗」、尖度は「偏差の4乗」から計算します。分散が2乗だったので、その延長にある量です。
| 何乗か | 名前 | 定義式 | 何を測るか |
|---|---|---|---|
| 1乗 | 平均 | 中心の位置 | |
| 2乗 | 分散 | 散らばりの大きさ | |
| 3乗 | 歪度 | 左右の歪み | |
| 4乗 | 尖度 | 裾の重さ |
このように「偏差を何乗して平均するか」で順番に定義されていく量をモーメントと呼びます。第2章の母関数は、このモーメントをまとめて取り出す道具です。
なぜ3乗で歪みが測れるのか。 2乗だとマイナスの偏差もプラスになって左右の区別が消えますが、3乗なら符号が残ります。だから右に大きく外れる値があれば正、左に外れれば負になる。
t分布と正規分布の比較が興味深いところです。歪度はどちらも0(左右対称)ですが、尖度が大きく違います。t分布は極端な値が出やすく、これが「裾が重い」という性質です。金融のリスク評価などで正規分布を仮定すると危険だと言われるのは、現実のデータの尖度が正規分布より高いことが多いためです。
実務ではどう効くか
この回の内容がIT寄りの仕事でどう使えるかを考えてみました。
標準偏差を見ないと判断を誤る
APIのレスポンスタイムを「平均200ms」と報告したとして、標準偏差が10msなのか300msなのかで話がまったく変わります。前者は安定していますが、後者は一部のユーザーが1秒以上待たされている可能性がある。
平均だけの監視ダッシュボードは危険という話は、この章の内容そのものです。だからパーセンタイル(p95、p99)を見る文化が生まれました。
歪度が高いデータで平均を使わない
レスポンスタイムや購入金額のような指標は、たいてい右に強く歪んでいます。歪度が高い分布では平均が少数の外れ値に引っ張られるので、中央値のほうが実態を表すことが多い。
年収の「平均」と「中央値」が乖離するのも同じ理由です。
サンプル数が少ないときの分散に注意
で割った分散を使うと過小評価になる、という話は実務でも起きます。少数のサンプルで「ばらつきが小さいから安定している」と判断すると、実際より楽観的な見積もりになります。
AIを使ってみた感想
今回は、自分の記憶が怪しい状態から始まったのが良かったと思います。「2乗の期待値と期待値の2乗、どっちが先だっけ」という曖昧さは、AIに聞いて答えをもらうだけでは直りません。実際に数字を入れて 、 と計算して、差が分散に一致するのを見たことで、ようやく順番が体に入りました。
の話も同じです。「不偏推定量だから」という説明は前も読んだ記憶がありますが、6万回シミュレートして なら真値の半分になると見るまで、なぜ必要なのかは腹に落ちていませんでした。
公式を覚えるより、公式が成り立つところを一度自分で確かめるほうが記憶に残ります。連載の方針としてこれは続けます。
次回
第4回は第4章「変数変換」を予定しています。
「身長の分布はわかる。ではBMI(身長を2乗して割る)の分布はどうなるか」という話です。ヤコビアンが出てくるあたりで、過去に一度つまずいた記憶があります。
この連載は、うまくいった記録だけでなく詰まった箇所も含めて書いています。同じく準1級を目指している方、一度挫折した方の参考になれば嬉しいです。