連続型分布は「足したか掛けたか」で決まる【第6回】
はじめに
前回(第5回)は離散型分布を扱いました。今回は連続型分布として、指数・ガンマ・正規・対数正規・ベータの5つを見ていきます。
正直に言うと、この章はいちばん警戒していました。分布の名前が5つも6つも並び、それぞれに確率密度関数と平均と分散の表がついてくる。第1回で書いたとおり、私の過去のつまずきは「読んだけれど何に使うのかが頭に入っていない」ことでした。分布の一覧表はその典型で、覚えた気になって数日後に何も残らない箇所です。
そこで今回は方針を変えて、式を先に見ないことにしました。代わりに1つの問いだけを立てます。
そのデータは、どう作られたのか。足したのか、掛けたのか、混ざったのか。
この問いに答えると分布が決まります。逆に言えば、分布の名前と式を覚える必要はありませんでした。
なお筆者は統計の専門家ではありません。理解の誤りが含まれる可能性があるため、試験対策として読む場合は必ず公式テキストで確認してください。
TL;DR
- 連続分布では点の確率が0になる。だから確率を点ではなく区間に割り当てる。その「単位幅あたりの確率」が密度
- 分布は作られ方で決まる。指数=ポアソンの裏返し、ガンマ=指数を足す、正規=たくさん足す、対数正規=たくさん掛ける、ベータ=成功数と失敗数を足す(一様事前分布のとき)
- 「平均間隔30分」でも30分以内に来る確率は63.2%。右に歪んだ分布では平均は真ん中ではない
- 中心極限定理は「たくさん混ぜる」ではなく「1つの値がたくさんの寄与の合計」。平均が離れた分布を混ぜると、むしろ正規から遠ざかる
- A/Bテストで検定は「有意差なし(p=0.82)」しか返さないが、ベータ分布は「Aが勝つ確率78%」と答える。問いが違う
統計の用語が出てくるので、先に用語集を置いておきます。用語を知っている方は「点の確率が0になってしまう」まで飛ばしてください。
用語集
この記事の鍵になる3つだけ挙げておきます。すべて後で具体例つきで説明するので、いま覚える必要はありません。
| 用語 | 記号 | 意味 |
|---|---|---|
| 確率密度 | 単位幅あたりの確率。確率そのものではない | |
| 生存関数 | 「まだ起きていない」確率。 | |
| 事後分布 | データを見た後の、真の値の居場所の分布 |
事後分布の は「〜という条件のもとで」を表します。第2回のベイズの定理に出てきた記号と同じものです。
点の確率が0になってしまう
まず、そもそもなぜ連続分布という別枠が必要なのかから始めます。
前回の離散分布は「何件起きるか」を数えられました。0件、1件、2件と並べて、それぞれに確率を割り当てればよかった。ところが身長や処理時間は数えられません。
身長がちょうど170cmである確率は?
答えは0です。170.000…cm と無限に桁が続くので、それにぴったり一致する人はいません。0.1cm単位で測れば「170.0cm付近」の人はいますが、それは「ちょうど170cm」ではない。
つまり離散分布のやり方は使えません。そこで、点に確率を割り当てるのをやめて、区間に割り当てることにします。
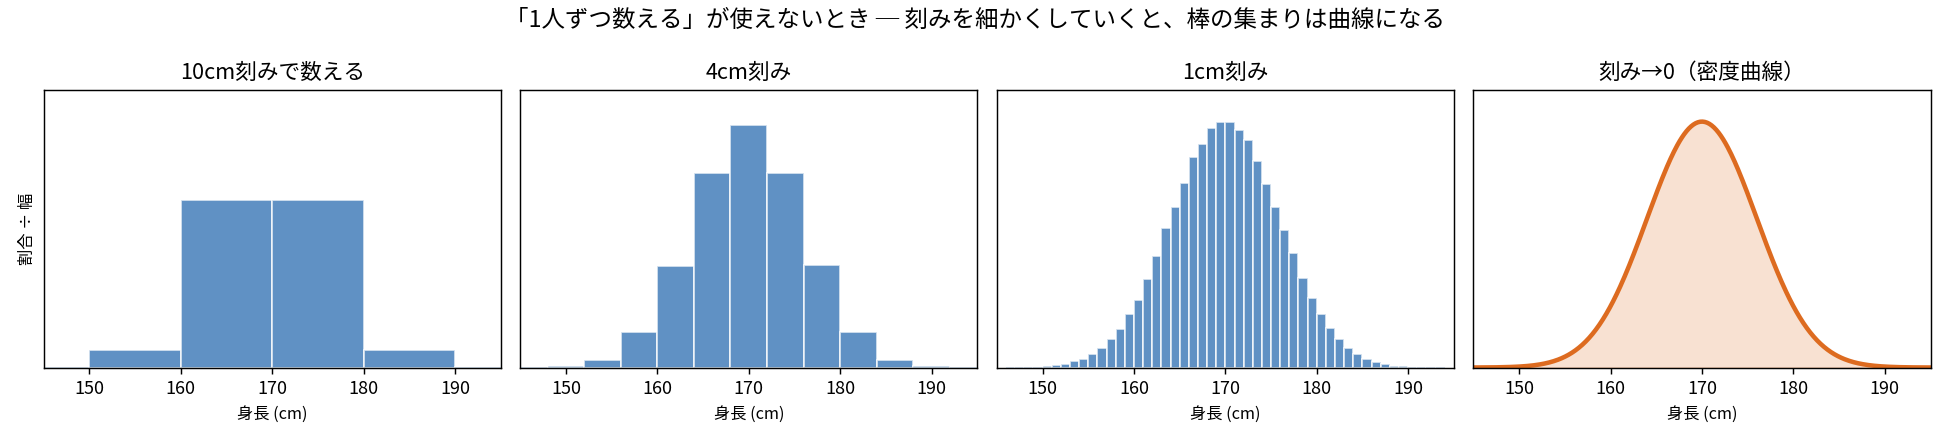
図はヒストグラムの刻みを 10cm → 4cm → 1cm → 0 と細かくしていったものです。最後に滑らかな曲線が現れます。これが密度曲線でした。
ここで肝になるのが縦軸です。縦軸は「割合」ではなく「割合 ÷ 幅」になっています。もし幅で割らずに割合をそのまま取ると、刻みを細かくするほど各棒に入る人数が減って、棒はどんどん低くなり最後には消えてしまいます。幅で割っておけば、刻みを細かくしても高さが安定して曲線に収束する。
「点の確率が0になる」問題を、「幅で割る」ことで回避したわけです。
最初のつまずき:密度は確率ではない
そして早々に引っかかりました。密度曲線の値を確率だと思ってしまうのです。
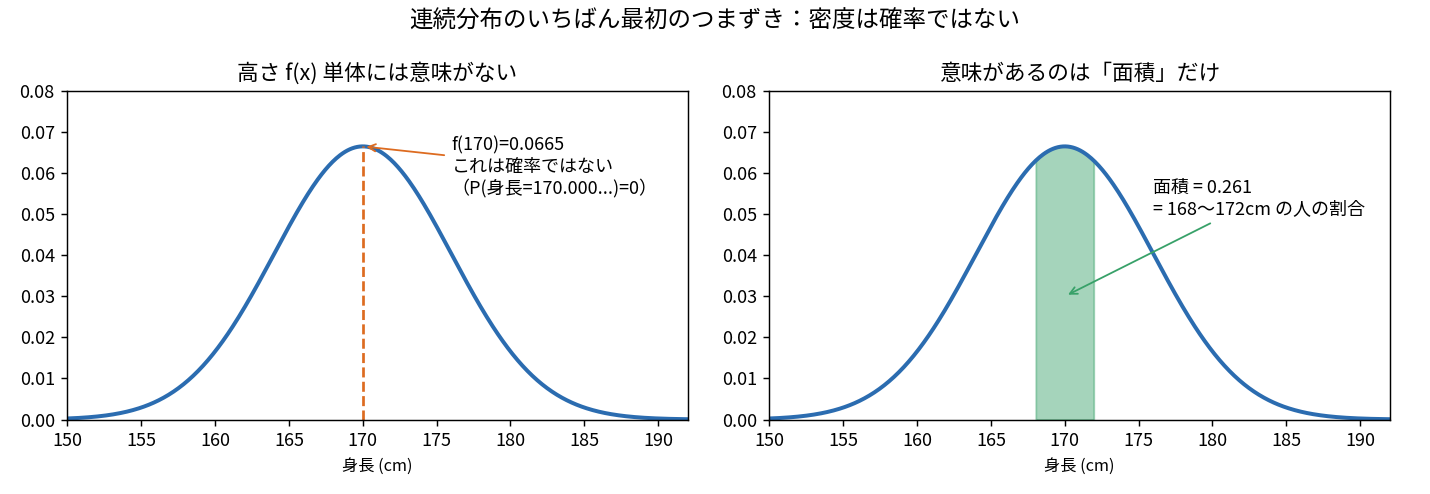
左の図で という値が出ています。これは「170cmの人が6.65%いる」ではありません。単位幅(1cm)あたりの密集度です。
確率が知りたければ面積を見ます。右の図で 168〜172cm を塗ると面積は 0.261 で、これが「この区間に入る確率26.1%」でした。
この区別が腹に落ちたのは、人口密度の比喩でした。
| 人口密度 | 確率密度 | |
|---|---|---|
| 単位 | 1km²あたり何人 | 単位幅あたりどれだけの確率 |
| これ自体は | 人数ではない | 確率ではない |
| 実体を出すには | 面積を掛ける | 幅を掛ける(=面積を取る) |
「東京都の人口密度は6000人/km²」と言われて「東京都には6000人しかいない」とは思いません。同じことです。
この比喩のおかげで、もう一つの疑問も解けました。密度は1を超えてよいのです。幅0.1の範囲に確率1が全部詰まっていれば、密度は10になります。確率は1を超えられませんが、密度は「割り算の結果」なので上限がない。第4回でヤコビアンを扱ったとき、密度が2.50になる例が出てきましたが、あれも同じ理屈でした。
使いどころマップ:4つの問いと4つの分布
ここから本題です。分布を式で覚えるのをやめて、どんな困りごとに答えるものなのかで並べます。
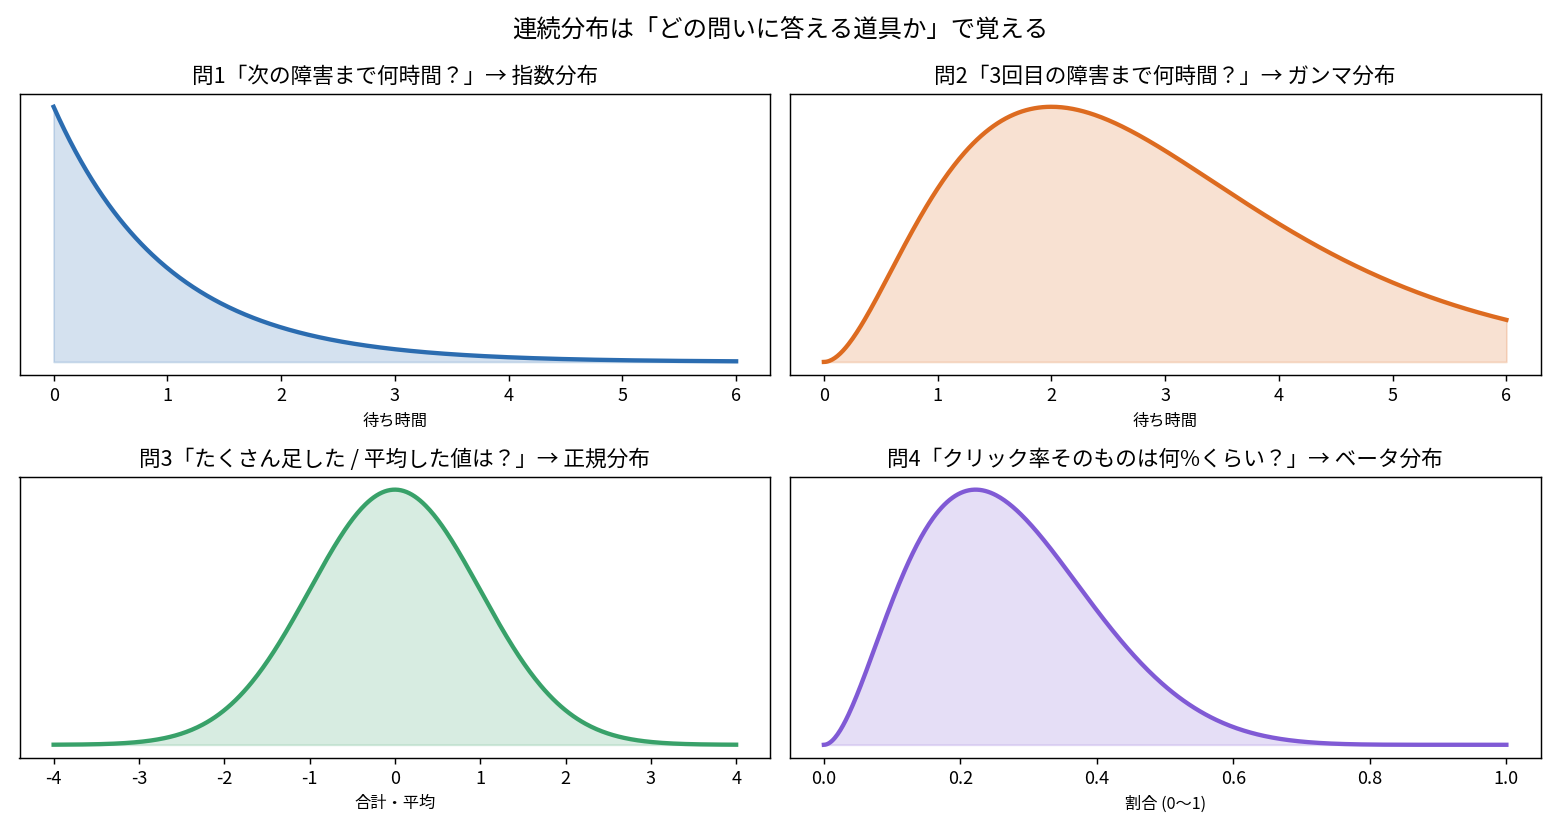
| 問い | 分布 | どう作られたか |
|---|---|---|
| 次のイベントまでの時間 | 指数分布 | ポアソンの裏返し |
| 回目のイベントまでの時間 | ガンマ分布 | 指数を 本足す( が整数のとき。この場合はアーラン分布とも呼ぶ) |
| 合計・平均はどこに来るか | 正規分布 | たくさん足す |
| 年収・レイテンシ | 対数正規分布 | たくさん掛ける |
| 率そのものはどこにあるか | ベータ分布 | 成功数・失敗数を足す |
そしてもう一つ、前回の離散分布ときれいに対応していることに気づきました。
| 離散 | 連続 | 関係 |
|---|---|---|
| ポアソン分布 | 指数分布 | 同じ現象を件数で見るか間隔で見るか |
| 負の二項分布 | ガンマ分布 | 同じく、 回目までを件数か時間で見るか |
| 二項分布 | 正規分布 | を大きくすると近似できる |
| 二項分布の「逆問題」 | ベータ分布 | 二項のパラメータ 自体の分布 |
上の2行は同じ現象を件数で見るか間隔で見るかの違いです。下の2行は少し性質が違って、正規分布は二項分布の近似、ベータ分布は二項分布のパラメータそのものの分布という関係になります。いずれにせよ、離散と連続を別々の暗記表として扱う必要はないと分かりました。
指数分布:式を自力で導いてみる
具体例で進めます。あるシステムで1時間に平均2件の障害が起きるとします( 件/時間)。
では、次の障害までの平均待ち時間は?
これは考える前に「30分」と答えが浮かびました。1時間に2件なら間隔は30分。直感で分かります。
問題は、この直感を式にするところです。ここで役に立ったのが言い換えでした。
「次の障害までが より長い」 = 「0から までに1件も起きていない」
同じ出来事の言い換えです。そして右側は件数の問題なので、前回のポアソン分布が使えます。待ち時間という新しい問題を、既に解いた問題にすり替えたわけです。
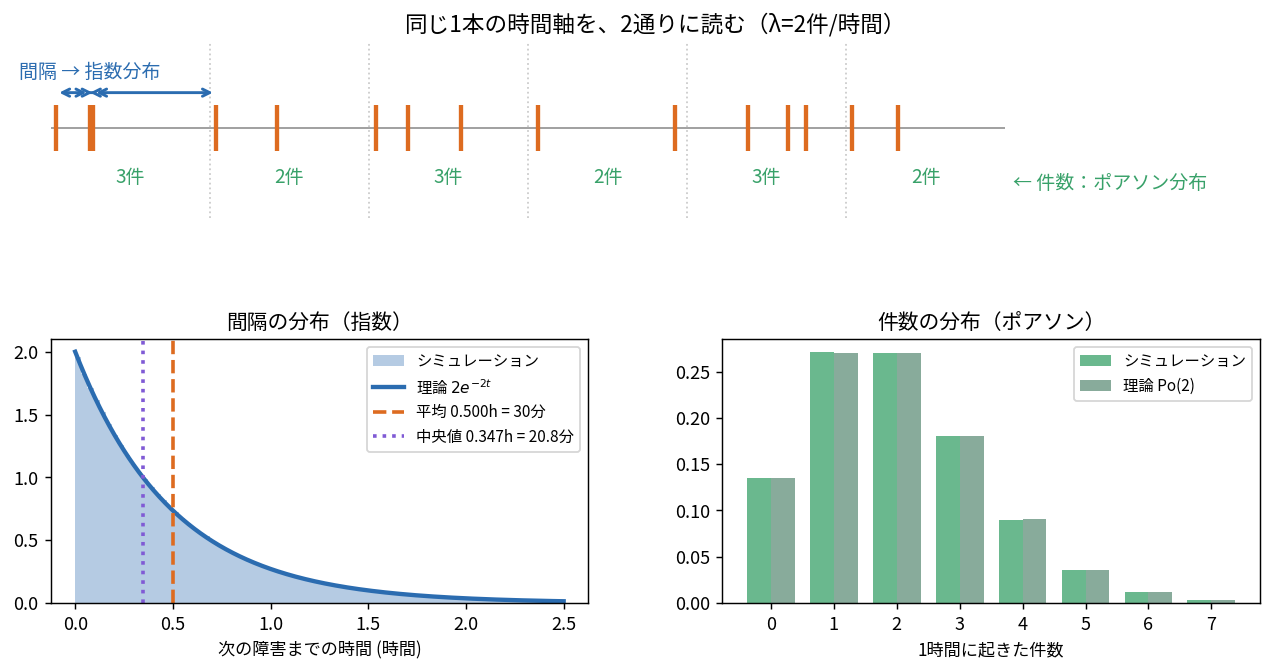
あとは機械的に進みます。
- 時間の件数はポアソン分布で、平均は 件
- 「0件」の確率は
- これがそのまま生存関数:
- 累積分布は裏返して
- 微分すると密度:
覚えるのは の1個だけで、残りは引き算と微分で出てきます。平均は 時間 = 30分で、最初の直感どおりでした。
200万件のシミュレーションで確かめました。
| 見方 | 実測 | 理論 |
|---|---|---|
| 間隔の平均 | 30.02分 | 30分 |
| 1時間区間の件数の平均 | 1.9988 | 2 |
| 1時間区間の件数の分散 | 1.9965 | 2 |
| 0.1349 | 0.1353 | |
| 0.2707 | 0.2707 |
件数の平均と分散がどちらも2になっているのは、前回のポアソン分布の性質そのものです。同じ乱数列を件数で集計すればポアソン、間隔で集計すれば指数になる。2つの分布が別物ではなく、同じものの2つの見方だと分かった時点で、覚える量が半分になりました。
引っかかりポイント:平均30分は「半々」ではない
さて、ここで実務でよく誤解される話が出てきます。
「障害の平均間隔は30分」と聞いたとき、30分経った時点で障害が来ている確率は50%か?
答えは63.2%です。
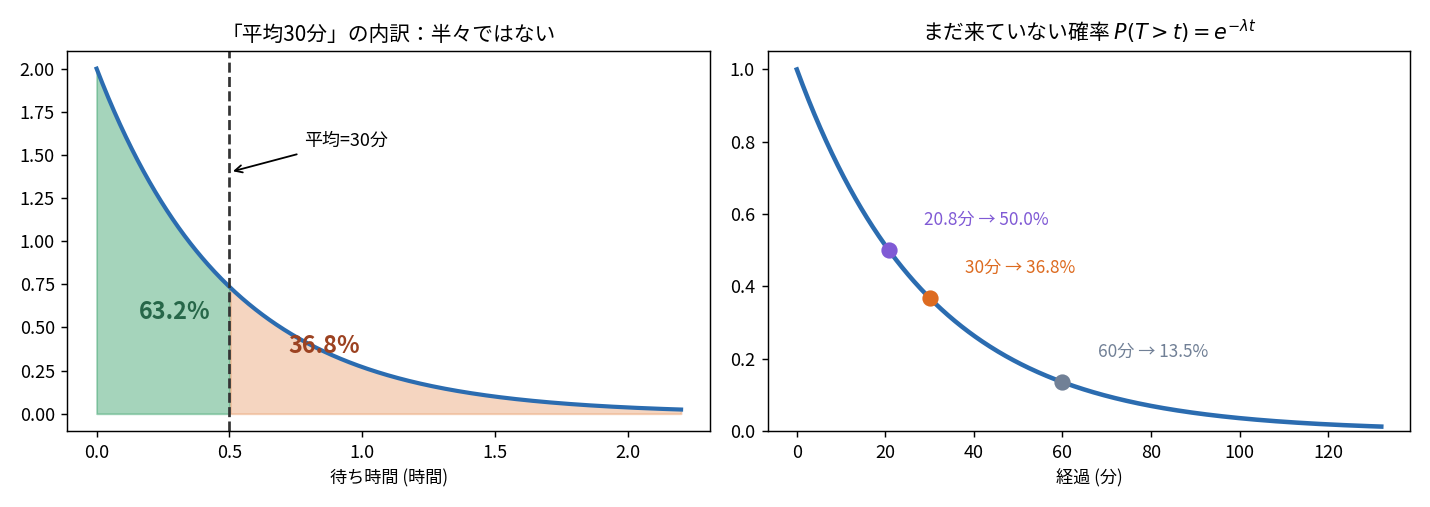
| 経過 | まだ来ていない | すでに来た |
|---|---|---|
| 20.8分(中央値) | 50.0% | 50.0% |
| 30分(平均) | 36.8% | 63.2% |
| 60分 | 13.5% | 86.5% |
半々になるのは中央値の20.8分のほうです。中央値は で計算できます。
平均は真ん中ではない。これが右に歪んだ分布の共通の性質で、この記事では以降も何度も出てきます。
実務への影響は分かりやすいところです。「障害の平均間隔は30分」という報告を受けて、30分おきに等間隔で障害が起きる絵を思い浮かべると誤ります。実際には5分後に来ることもあり、2時間空くこともある。SLAを平均で語ると外すので、パーセンタイル(p95など)で語るべきという話につながります。
無記憶性は欠陥ではなく「適用範囲の宣言」
指数分布には有名な性質があります。無記憶性です。
すでに3時間待っている。あと何分で来る? → まだ平均30分。3時間待った事実は何の情報にもならない。
これを最初は「非現実的な仮定」と受け取りました。3時間も無事なら壊れにくい機械だと思いたくなるし、逆に古い機械なら壊れやすいと思いたくなる。
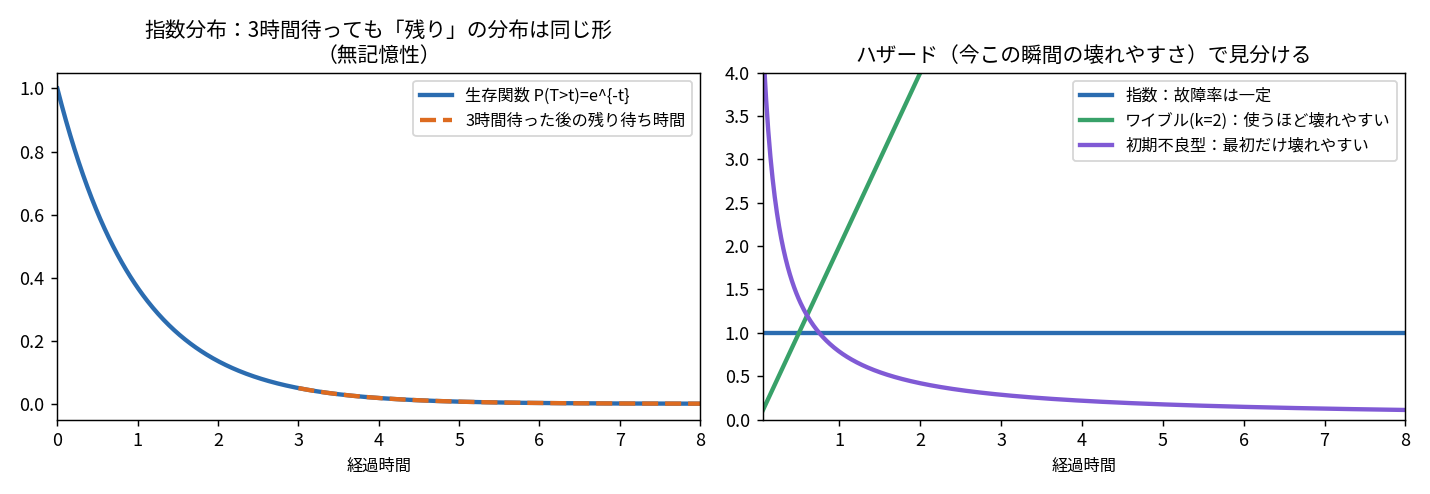
考え方が変わったのは、右のハザードの図を見たときです。ハザードは「いま生き残っているものが、次の瞬間に壊れる率」です。
| ハザード | 意味する故障 | 分布 |
|---|---|---|
| 一定 | ランダムな外的要因(落雷、他プロセスの暴走) | 指数分布 |
| 増加 | 摩耗・劣化 | ワイブル分布() |
| 減少 | 初期不良(初期を越えれば安定) | ワイブル分布() |
つまり無記憶性は欠陥ではなく、適用範囲の宣言でした。「この分布はランダムな外的要因による故障を扱います」と言っているだけで、摩耗故障にはワイブルを使えばよい。
そして実務の順序も見えました。分布を先に決めるのではなく、実データのハザードを描いてから分布を選ぶ。ハザードが一定なら指数、右上がりなら摩耗を疑う。
ガンマ分布:ピークは平均より手前にある
次は「3件目の障害までの時間」です。指数を3本足すだけなので、ガンマ分布になります。
、 で300万回シミュレーションしました。
| 量 | 実測 | 理論 |
|---|---|---|
| 平均 | 1.5006 | |
| 分散 | 0.7502 | |
| 歪度 | 1.156 |
平均と分散は覚える必要がありません。指数分布1本の平均が 、分散が で、それを3本足すだけです(独立なら分散も足せる、という第3回の性質を使います)。
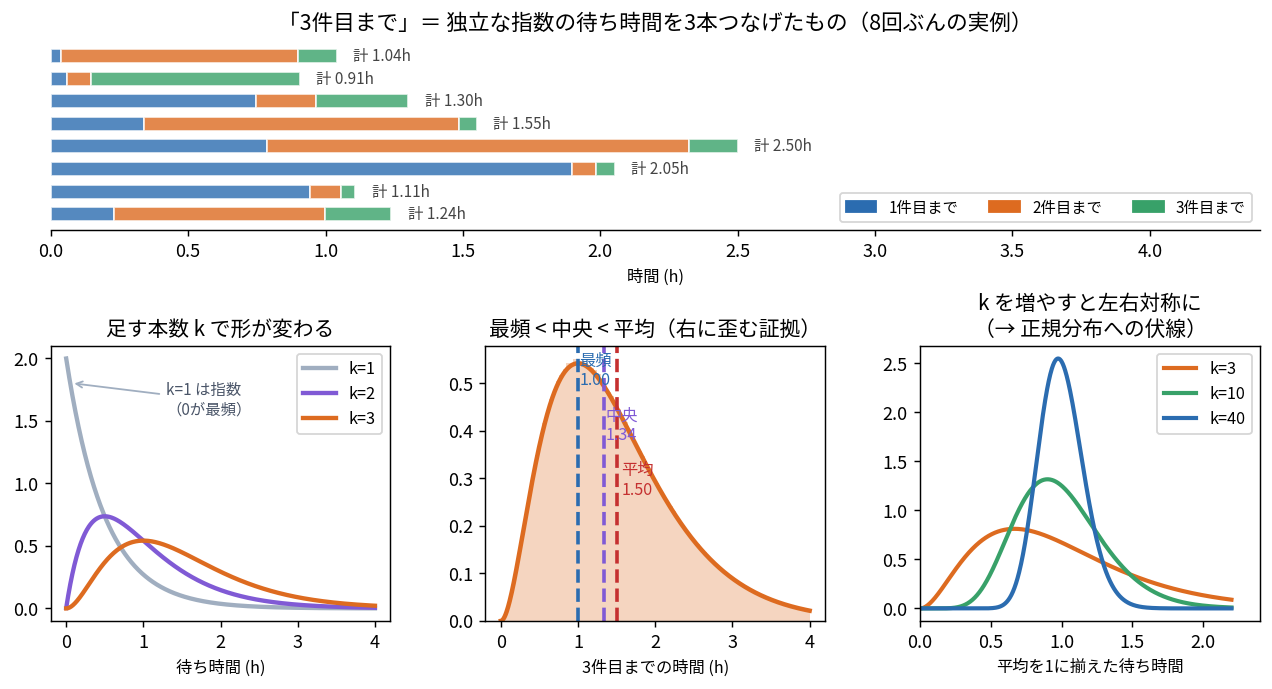
歪度 も味わい深いところです。 を増やすと0に近づく。図の右下で と増やすと形が対称に近づいていくのは、足す本数を増やすと正規分布に近づくという中心極限定理の実例でした。
ここで自分が間違えた
そして私はここで間違えました。3つの代表値を聞かれて、こう答えたのです。
平均が1.5hだから、ピーク(最頻値)も1.5hのあたりだろう。
実測は違いました。
| 代表値 | 値 |
|---|---|
| 最頻値 | 1.00h |
| 中央値 | 1.34h |
| 平均 | 1.50h |
しかも間違いに気づく材料は自分で出していました。歪度が正(右に歪む)と言った時点で矛盾しているのです。右に歪むとは「右に長い裾がある」こと。裾は平均を右に引っ張るので、平均がピークと一致するはずがない。
暗記しなくても導けます。平均は、しっぽに引っ張られる側にいる。これだけ覚えておけば、右歪みなら平均がいちばん右、左歪みならいちばん左だと分かります。
ただしこれは経験則で、例外があります。この記事を書いたあとに検算したところ、ワイブル分布(形状 、尺度1)は歪度が で右に歪んでいるのに、最頻値0.8964 > 中央値0.8949 となって順序が崩れていました。 では最頻値0.9083 > 中央値0.9006 > 平均0.8997 と完全に逆転します。歪度が0に近い分布では順序が保証されないので、「たいていはこうなる」目安として使うのが安全です。
なぜピークが手前に来るのか
最頻値が になる理由も、図で腹に落ちました。
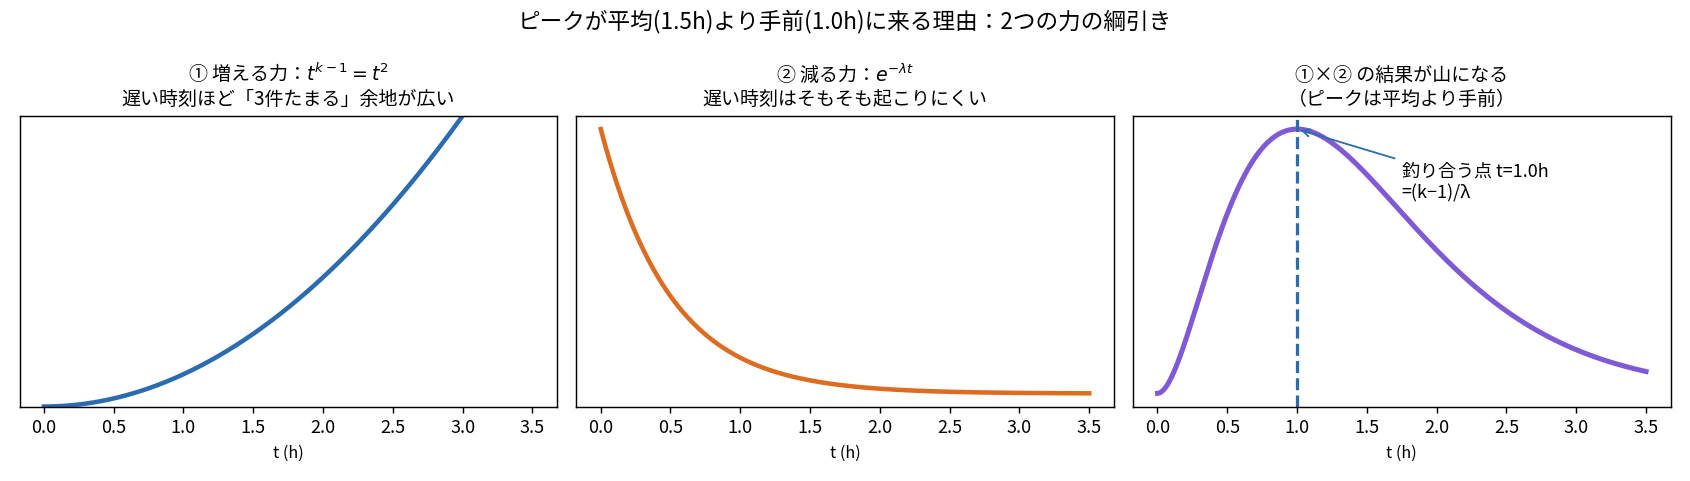
密度は2つの因子の掛け算です。
- ① 押し上げ :遅い時刻ほど、そこまでに3件がたまる並べ方の余地が広い → 押し上げる
- ② 押し下げ :遅い時刻はそもそも到達しにくい → 押し下げる
2つの力が釣り合った点がピークです。実際に対数を取って微分すると確かめられます。
なおこの は のときの話です。 だと が で発散するので、密度は0のすぐ右で無限に高くなり、内部にピークを持ちません。
という一見不自然な形も、「押し上げの強さ」と「押し下げの強さ」の釣り合いから出てきた数だと分かれば覚える必要がありません。
混ぜる vs 足す:中心極限定理のもう一つの誤解
正規分布に進みます。ここでも間違えました。
身長が正規分布になるのは、年齢や性別ごとに違う分布が組み合わさって平均化されるからだろう。
方向が逆でした。混合はむしろ正規分布から遠ざけます。
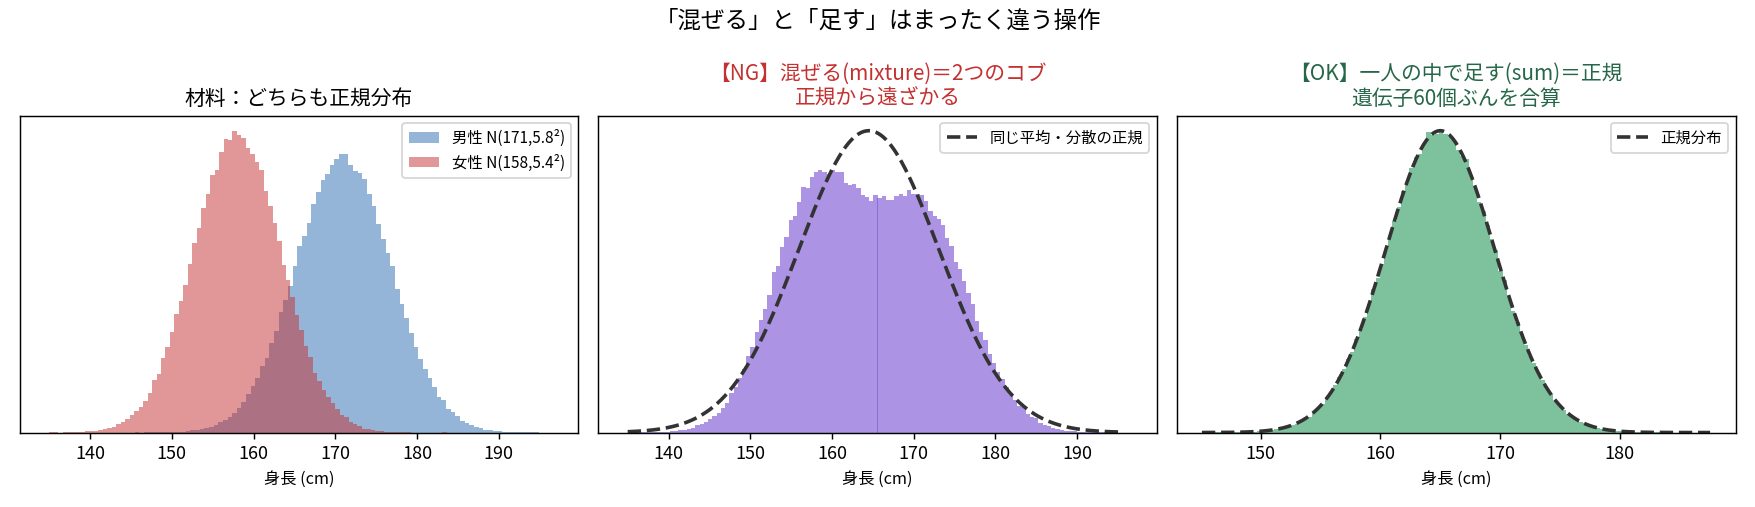
40万人で試しました。男性 と女性 を混ぜると、歪度0.076・尖度 で、二峰性の平べったい分布になります(図の中央)。
ここで一つ注意が必要でした。「混ぜると正規から遠ざかる」は成分の平均が標準偏差に比べて十分離れているときの話です。検算してみると、 と を50:50で混ぜた場合は歪度0.0006・尖度 とほぼ完全な正規分布(単峰)になりました。今回の男女の例は平均差13cmに対し標準偏差が約5.6なので離れており、二峰になったわけです。
尖度についても言い過ぎないようにしておきます。負の尖度は二峰性の証拠ではありません。一様分布は完全に単峰なのに尖度 ですし、逆に は明確に二峰なのに尖度 です。今回のケースでたまたま負になった、と読むのが正確でした。
一方、一人の身長を60個の小さな要因の合計として作ると、歪度 ・尖度 できれいな正規分布になりました。
| 混ぜる(mixture) | 足す(sum) | |
|---|---|---|
| 操作 | 男性から1人または女性から1人 | 1人の中で要因1 + 要因2 + … + 要因60 |
| 結果 | コブが増える | 正規分布に近づく |
| 身長で言うと | 男女込みの全国データ(実際に二峰性) | 男性だけ/女性だけ |
つまり中心極限定理は「たくさんのものを混ぜると正規になる」ではなく、「1つの観測値が、たくさんの小さな寄与の合計になっている」という主張でした。「または」ではなく「+」です。
これは実務でそのまま使える診断になります。
正規分布に見えないときは、隠れたグループの混在を疑う。
ヒストグラムが二峰だったり不自然に平たいとき、外れ値処理や変換をする前に「何かで層別できないか」を考える。デバイス別、新規/既存別、地域別で分けたら各群はきれいな正規だった、というのはよくある話です。異常検知でもA/Bテストでも効く見方でした。
対数正規分布:年収が歪む理由
「足す」の次は「掛ける」です。
年収の上がり方を思い出すと、昇給は「+10万円」ではなく「×1.03」という形で来ます。掛け算が積み重なる。
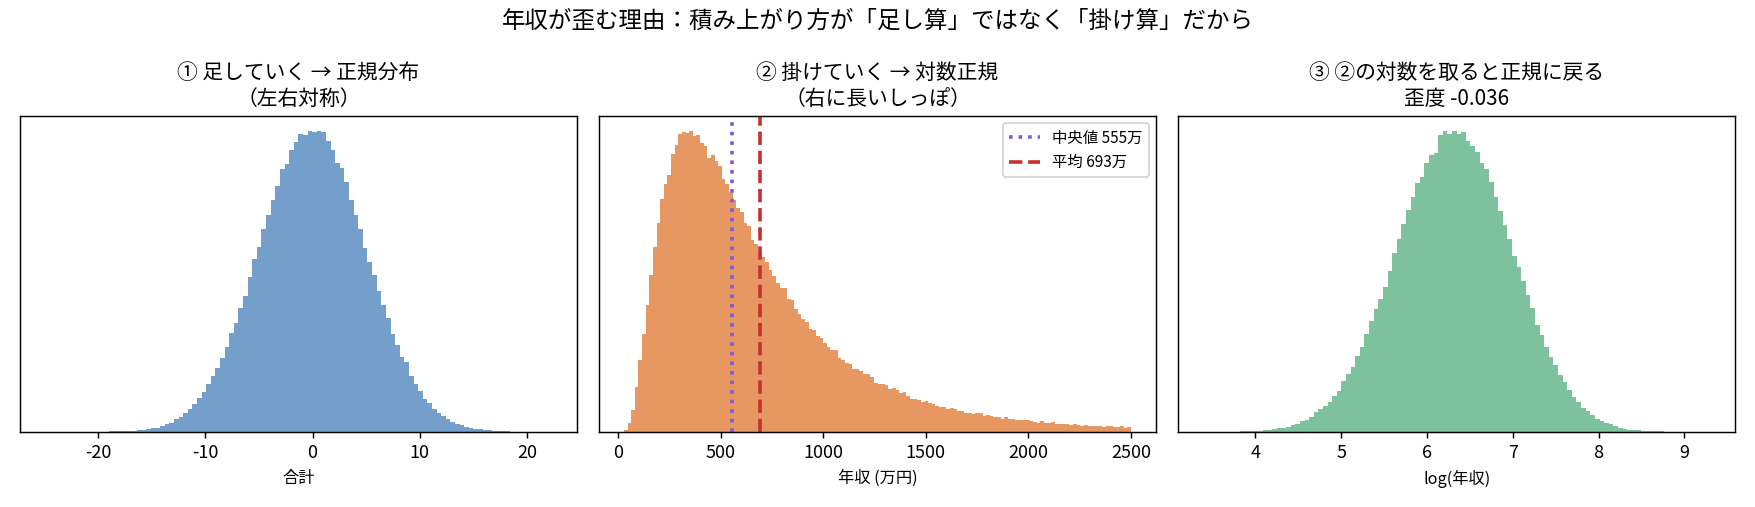
25個を足したもの(左)は正規分布ですが、25回の倍率(0.80〜1.28倍)を掛けたもの(中央)は歪度2.41で右に強く歪みます。そして平均693万円に対して中央値555万円という乖離が生まれる。
理屈は単純でした。 なので、対数を取れば掛け算が足し算に変わり、中心極限定理が使えます。だから対数を取ると正規分布に戻る(右の図、歪度 )。「対数正規分布」という名前はそのまま「対数を取ると正規」という意味でした。
なお「変換すると分布の形が変わる」のは第4回でやった話で、対数正規分布の密度関数もヤコビアンを使って正規分布から導けます。個別に暗記する式ではありませんでした。
そして指数分布のときと同じ教訓が出てきます。
右に歪んだ分布では、平均は代表値として機能しない。
「平均間隔30分でも63%が30分以内に来る」と「平均年収693万円でも中央値は555万円」は、同じことを違う場面で言っているだけです。所得の議論で中央値が使われるのは、この性質があるためでした。
掛け算で積み上がるものを挙げてみると、身のまわりに多くあります。
- 年収・株価・都市人口
- サイト滞在時間・ファイルサイズ
- APIのレスポンスタイム
レスポンスタイムがここに入るのは重要でした。ただし機構の説明は雑にできません。DNS解決・キュー待ち・DB処理といった各段の所要時間は足し算で積み上がるので、そこだけ見れば正規分布に近づくはずです。実際のレイテンシが右に強く歪むのは、遅延要因が倍率で効くからでした。負荷が上がるとキュー待ちが加速的に伸び、リトライが1回入れば所要時間はまるごと2倍になり、それが多段構成の各層で掛け合わさる。「各段の時間の合計」ではなく「各段の遅延倍率の積」が支配的になる領域で、対数正規に近い形が出てきます。厳密に対数正規だと言い切れるものではありませんが、平均から離れた裾が長いという点は共通です。だからレイテンシ監視を平均でやるのは筋が悪く、p95/p99を見るべきという話になる。第3回で「平均だけの監視ダッシュボードは危険」と書きましたが、その理由が分布の作られ方から説明できるようになりました。
見分け方も1行です。対数軸でヒストグラムを描いて左右対称なら対数正規。生の軸で「歪んでいるな」と唸る前に、軸を対数にしてみる。
ベータ分布:A/Bテストの「母数が少なすぎる」を数字にする
最後はベータ分布です。ここがいちばん実務に直結しました。
題材はこうです。
バナーのA案は10人に見せて1人がクリック(10%)。B案は1000人に見せて80人がクリック(8%)。 数字ではA案の勝ちだが、A案を採用してよいか?
誰でも「A案は母数が少なすぎる」と思います。問題は、その感覚を数字にできるかでした。
前回の二項分布は「 が与えられたとき、何人がクリックするか」を答える道具です。しかし今知りたいのは逆で、「80/1000 という結果が出たとき、真の はどこにあるか」。この逆問題に答えるのがベータ分布でした。
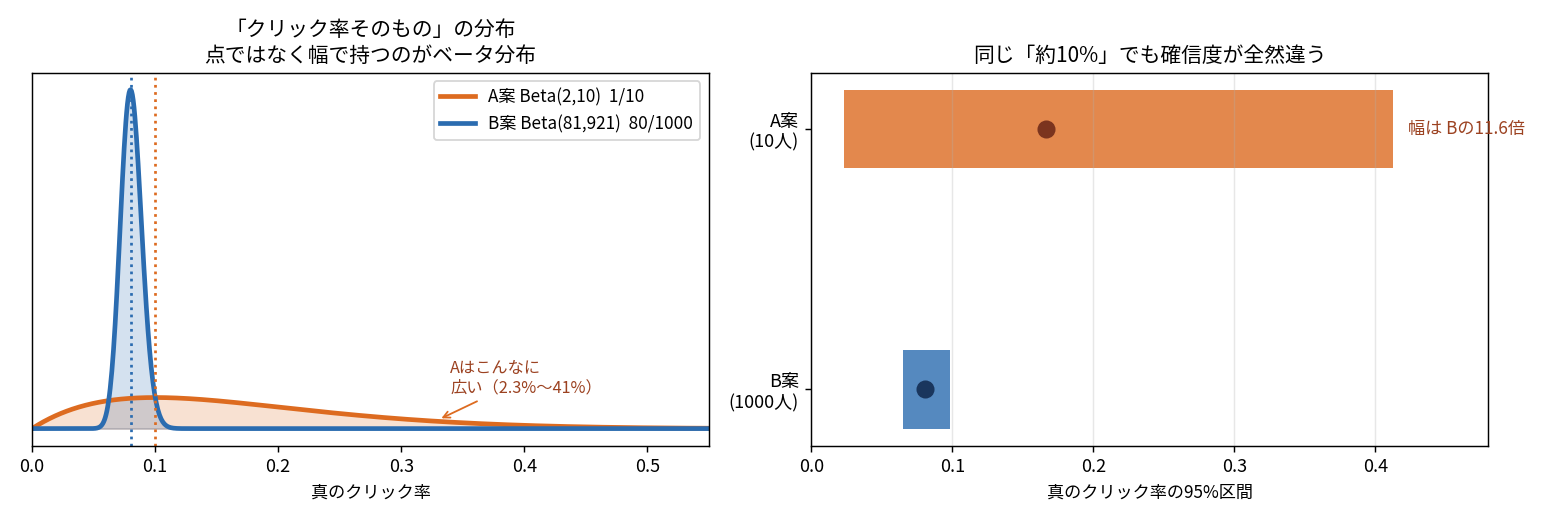
しかも計算が驚くほど簡単です。一様な事前分布 から始めると、
成功と失敗を数えて足すだけ。事後分布の形を得るまでに積分は出てきません(このあと95%区間や を計算する段では積分が必要になりますが、そこは数値計算に任せられます)。
| A案(10人中1人) | B案(1000人中80人) | |
|---|---|---|
| 見かけの率 | 10.0% | 8.0% |
| 事後分布 | ||
| 真の率の95%区間 | 2.3% 〜 41.3% | 6.5% 〜 9.8% |
A案の区間幅はB案の11.6倍です。「本当はBの半分以下かもしれないし、5倍かもしれない」という状態が、区間の幅として目に見えました。
なぜこんなに簡単に済むのか。第2回でベイズの定理をやったとき、分母に出てくる規格化のための積分が厄介だという話がありました。二項分布の尤度とベータ分布の事前分布を組み合わせると、その積分を解かずに答えがベータ分布の形で閉じます。これを共役性と呼び、ベータ分布が実務で重宝される理由でした。
検定との違い:問いが違う
同じデータで比率の差の検定もやってみました。
結論は「有意差なし」。ここで手が止まりました。この結果から何をすべきか分からないのです。
検定の答えの限界は、「差があるとは言えない」という文が2つの状況を区別しないことでした。
- A案とB案は本当に同じくらい
- データが足りなくて何も言えない
今回は明らかに2番ですが、 という数字からはそれが読めません。しかもA案の区間が 2.3%〜41.3% だったことを思い出すと、「差がない」どころか「5倍差があるかもしれない」状態です。
もう一点、この 自体も鵜呑みにはできませんでした。A案は10人中1件なので、比率の差の 検定が前提とする正規近似(期待度数5以上)を満たしていません。参考にフィッシャーの正確確率検定を計算すると両側 で、 検定の0.82とかなり離れます。検定の答えが信用できないほどデータが少ないわけで、これは「データが足りない」という結論をむしろ補強する材料でした。
さらに実務上の制約もあります。検定は途中で何度も覗くと第一種の過誤が膨らむ(覗き見問題)ので、ダッシュボードを毎日眺めるWeb運用と相性が悪い。「今日は有意になったから止めよう」をやると、有意水準は名目の5%より大きく崩れます。
一方ベータ分布の答えはこうでした。
解釈が要りません。「A案が勝つ見込みは78%、採用ラインを95%に置いているのでまだ決められない」とそのまま意思決定の言葉になります。
| 検定(頻度論) | ベータ(ベイズ) | |
|---|---|---|
| 問い | 「差がない」と仮定すると、この結果と同じかもっと極端な結果が出る確率はどれくらいか | データを見た後、真の率はどこにありそうか |
| 答え | 値 0.82 → 有意差なし | |
| 途中で覗く | 過誤が増える | 事後分布そのものは壊れない |
| 「情報不足」の表現 | できない | 区間の幅として見える |
どちらが正しいかという話ではなく、問いが違うのでした。論文で「効果があると主張してよいか」を審査するなら検定、Webで「今日どちらを出すか」を決め続けるならベイズ。使い分けの基準がようやく持てました。
覗き見については、正確に書いておきます。事後分布そのものはいつデータを止めたかに依存しない(尤度原理)ので、途中で何度見ても分布の解釈は壊れません。ただし「 が95%を超えたら採用する」という決定ルールを毎日評価すれば、誤って採用してしまう率は名目より上がります。ベイズなら覗き見が完全に無害、というわけではないのでした。ここは調べていて自分の理解が甘かったと気づいた点です。
あと何人集めればいいのか
ベイズのやり方だと、もう一つ実用的な問いに答えられます。
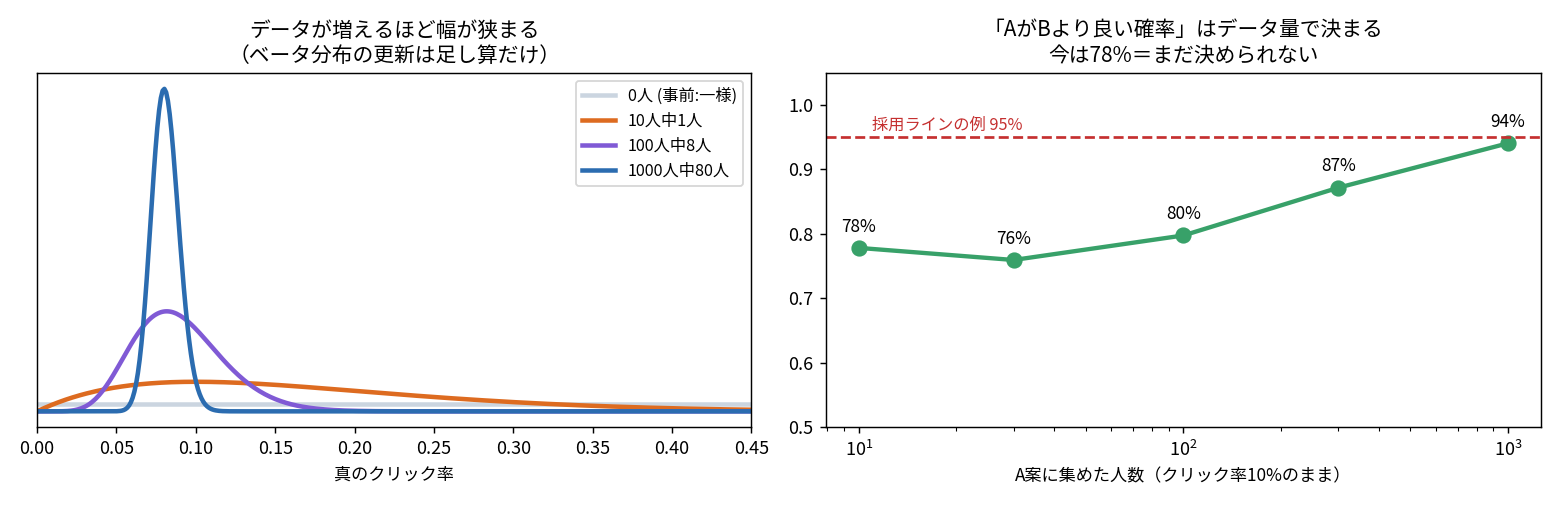
左の図は、データを足すほど分布が尖っていく様子です。データ0人なら一様分布、1000人なら鋭いピーク。情報が増えることと分布が細くなることが同じだと視覚的に分かります(なお一様事前分布は「何も知らない」状態を表すわけではありません。後述します)。
右の図が実用的でした。A案の観測クリック率がちょうど10%で推移した場合、人数を増やしていくとどうなるか。
| A案の人数 | |
|---|---|
| 10人 | 78% |
| 30人 | 76% |
| 100人 | 80% |
| 300人 | 87% |
| 1000人 | 94% |
1000人まで集めれば94%で、採用ライン95%にほぼ届きます。
30人のところで一度下がっているのが不思議だったので調べました。最初は「少数だと偶然の揺れが残るため」と考えたのですが、この折れ線は乱数ではなく厳密な計算値なので偶然は入っていません。本当の理由は事前分布の が小標本ほど効くことでした。事後平均は10人で 、30人で 、100人で と真の値0.1へ下がっていきます。つまり10人時点の78%は、A案を実際より高く見積もっていたぶんの水増しだったわけです。30人でその水増しが減った結果、いったん下がる。
もう一つ、この表の読み方に注意が必要でした。これは「観測値がちょうど10%で推移した場合」の1本の筋です。A案の真の率が本当に10%だとしても、二項変動を考えると1000人時点で が95%を超える確率は43%程度しかありません。「1000人集めれば決着する」と読むと楽観的すぎます。
それでも、「サンプルサイズが足りない」という曖昧な感覚を人数という数字で語れるようになったのは、今回いちばん実務に持ち帰れる収穫でした。
事前分布の選び方で答えが変わる
ここまで一様事前分布 を「何も知らない状態」として使ってきましたが、これは正確ではありません。一様分布は「率が0.5である」ことと「率が0.01である」ことを同じ重みで扱うという、それ自体が一つの主張です。クリック率のように0に近い値が普通の場面では、けっこう強い主張になります。
どれくらい影響するのか、事前分布を変えて を計算し直しました。
| 事前分布 | |
|---|---|
| 一様 | 0.778 |
| ジェフリーズ | 0.652 |
| ホールデン | 0.474 |
78%と47%では結論が真逆です。ホールデン事前分布(成功も失敗も0件を足す、つまり観測値そのまま)だと、A案が勝つ確率は五分五分を割ります。
なぜここまで動くかというと、A案のデータが10人しかないからです。 を足すか を足すか を足すかが、10という数字に対しては大きい。B案は1000人なので事前分布の違いはほとんど効きません。
つまり 「データが足りない」の正体は「事前分布の選択が結論を左右してしまう」状態でもありました。ここは学習中に見落としていて、あとから検算して気づいた点です。実務でベイズA/Bテストを使うなら、事前分布を1つ決めて満足せず、別の事前分布でも同じ結論になるかを確認する(感度分析)べきだと分かりました。逆に事前分布を変えても結論が動かないなら、それはデータが十分に集まった証拠になります。
P(A>B) を3通りで検算する
最後に、この連載の中心にある「AIの答えを自分で検算する」の実例として、 を3つの方法で計算しました。
方法1:モンテカルロ
実際に使った方法です。Aの分布から1本、Bの分布から1本くじを引いて、Aが大きかった回数を数えるだけ。実質3行でした。
rng = np.random.default_rng()
sA = rng.beta(1+1,  1+9,   3_000_000)   # A: 10人中1人
sB = rng.beta(1+80, 1+920, 3_000_000)   # B: 1000人中80人
print((sA > sB).mean())                  # → 0.7783
この方法の強みは、問いを変えても手続きが変わらないことです。
| 知りたいこと | 書き方 |
|---|---|
| Aが勝つ確率 | (sA > sB).mean() |
| Aが1.2倍以上になる確率 | (sA > 1.2*sB).mean() |
| 差の95%区間 | np.percentile(sA-sB, [2.5, 97.5]) |
式を導き直す必要がありません。これがベイズが実務で使いやすい最大の理由で、MCMC が主役になった背景もここにあると理解しました。分布を数式で解く代わりに、サンプルを取って数える。
弱点は精度です。誤差は でしか縮まりません。実測の収束を見ると分かります。
| 試行回数 | |
|---|---|
| 1,000 | 0.775 |
| 10,000 | 0.7764 |
| 100,000 | 0.77841 |
| 1,000,000 | 0.77785 |
| 10,000,000 | 0.77805 |
精度を10倍にするには回数を100倍にする必要があります。
方法2:厳密な級数
パラメータが整数なら、有限項の足し算で厳密に書けます(Evan Miller が紹介した式)。
はベータ関数です。ここで注意したいのは、この式が返すのは のほうだという点。代入すると 0.22197945 が出るので、1から引いて となります(添字を入れ替えて直接計算しても同じ値になることを確認しました)。項数は までの和なので、この向きだと81項です。
実装のコツは、ベータ関数の値が巨大になって桁が溢れるので math.lgamma で対数を経由することでした。素直に math.gamma で書くと OverflowError で落ちます(実際に落ちました)。
方法3:定義通りの二重積分
いちばん素直な方法です。
「Aが だったとして、Bがそれ以下である確率」を、すべての について足し上げる。条件付き確率で場合分けして足すという基本操作だけで書けます。4万分割で 0.77807。
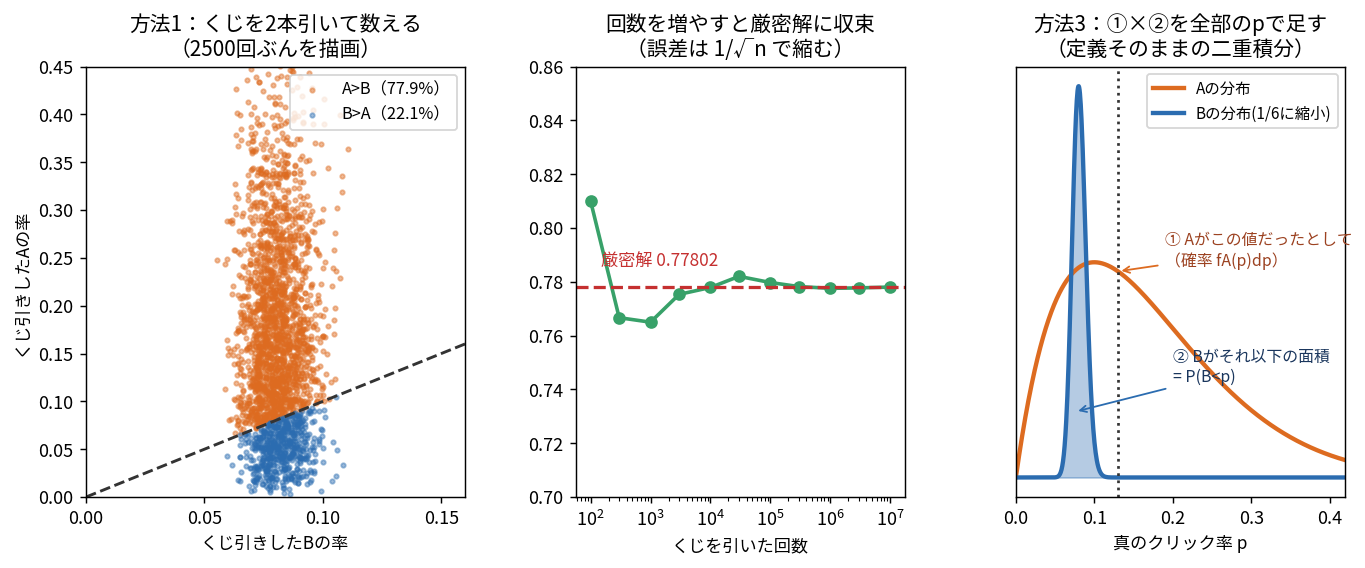
左の散布図が一目で分かる形でした。対角線より上がAの勝ちで77.9%。そしてAの点が縦方向に大きく散っているのが、A案の不確実性そのものです。
3つを並べます。
| 方法 | 性質 | |
|---|---|---|
| モンテカルロ(1000万) | 0.77805 | 実装3行・どんな問いにも使える・誤差あり |
| 厳密な級数 | 0.77802055 | 誤差ゼロ・整数パラメータ限定・導出が必要 |
| 数値積分(4万分割) | 0.77807 | 定義に忠実・分割数で精度向上 |
小数4桁目まで一致しました。
なぜ3通りやるのか
これは今回の学習で一番大事にした点です。統計はAIが誤りやすい分野でした。式の形は正しいのに添字が入れ替わっていたり、 と の役割が途中で逆になったりする。もっともらしい数字が返ってくるので、間違っていても気づけません。
だから1つの答えを別の方法でも出して突き合わせるのを習慣にしました。食い違えば、実装か理解のどこかが間違っているサインです。今回も級数の実装で桁溢れに気づいたのは、モンテカルロの値と合わなかったからでした。
実務でも同じで、モンテカルロを使うときは「試行回数を1桁増やしても答えが動かないか」を必ず確認します。動くならまだ収束していない。
この回で押さえること
| 問い | 答え |
|---|---|
| 密度とは | 単位幅あたりの確率。確率ではない。1を超えてよい |
| 次のイベントまでの時間 | 指数分布。 から微分で全部出る |
| 回目までの時間 | ガンマ分布。指数を 本足す( が整数のとき)。ピークは平均より手前 |
| 合計・平均 | 正規分布。混ぜるのではなく足す |
| 掛け算で積み上がるもの | 対数正規分布。対数を取れば正規に戻る |
| 率そのものの居場所 | ベータ分布。一様事前分布なら成功数と失敗数を足すだけ。ただし小標本では事前分布の選択が結論を動かす |
| 右に歪んだ分布で平均は | 代表値として機能しない。中央値かパーセンタイルを使う |
そして冒頭に置いた一本の筋に戻ります。
分布の名前と式を覚える必要はない。「そのデータがどう作られたか(足したのか・掛けたのか・混ざったのか)」を問えば分布は決まる。
5つの分布を別々の暗記項目として扱っていたら、たぶん今回も数日で忘れていました。「足す」「掛ける」「混ぜる」の3語に整理し直したことで、式を思い出せなくても導き直せる状態になりました。
前回・前々回とのつながり
今回は過去の回の内容が何度も戻ってきました。
| つながった先 | どこで |
|---|---|
| 第2回 ベイズの定理 | ベータの共役性(分母の積分を回避)、 値の限界 |
| 第3回 分散 | ガンマの分散を足す、歪度・尖度で形を測る |
| 第4回 変数変換 | 対数正規を正規から導く、密度が1を超える話 |
前回の離散分布との対応(ポアソン↔指数、負の二項↔ガンマ、二項↔ベータ)も含めると、章が独立していないことがはっきりしました。前の章を飛ばして先に進むと後で必ず戻ってくる構造になっている。
次回
次回は標本分布を扱います。
正規分布から取ったデータの2乗和はどんな分布になるのか、分散を知らないまま平均を検定するとどうなるのか——カイ二乗分布・t分布・F分布が出てくる回です。今回の「足す」の話がそのまま効いてくるはずで、第4回の変数変換も本格的に使うことになります。
この連載は、うまくいった記録だけでなく詰まった箇所も含めて書いています。同じく準1級を目指している方、一度挫折した方の参考になれば嬉しいです。