「その他」ではなかった:多変量解析編の地図を1枚にまとめる【第28回】
はじめに
第26章はその他の多変量解析手法です。多変量解析編の最後にあたります。
章のタイトルを見た時点で、正直あまり気乗りしませんでした。「その他」というのは、どこにも入らなかったものを集めた引き出しに見えます。多次元尺度構成法、正準相関分析、数量化法、対応分析。名前も互いに似ていないので、無関係な手法を4つ暗記させられる回だと思っていました。
結論から言うと、これは読み方を間違えていました。この4手法は無関係ではなく、ここまでの4手法(主成分分析・因子分析・クラスター分析・判別分析)が埋めていなかったマスを埋めています。 2軸のマトリクスに並べると、それがはっきり見えます。
そしてもうひとつ、この回でいちばん驚いたことがあります。
多次元尺度構成法(MDS)をユークリッド距離で計算すると、(分散共分散行列を使う)主成分分析とまったく同じ座標が出てくる。 「似ている」ではなく、小数第15位まで一致します。
だとすると「別の手法として2つ覚える意味は何なのか」という話になります。この記事ではそこを実際に計算して確かめました。答えは「計算は同じで、受け取れる入力が違う」でした。
もう1点。数量化法I〜IV類は、ほぼ既習の手法に別の名前が付いているだけでした。数量化I類はダミー変数の重回帰分析、II類は判別分析、III類は対応分析とまったく同じ計算です。I類・II類・III類については、実際に数値が一致することを自分で計算して確かめました。 IV類だけはMDSと同じ問題(親近性のデータから配置を作る)を扱うものの、定式化が違うので「同じ計算」とは書けません。ただし新しい発想が増えるわけではないので、「新しい仕組みは3つ」の数え方は変えていません。
つまり、この章で本当に新しく学ぶ仕組みは3つだけです。「その他」という名前の割に、学習コストはこの編でいちばん軽い回でした。
なお今回はワークブックの深さに合わせて、用語と位置づけの整理を主目的にしています。個々の手法の導出は追わず、そのぶん「どれをいつ使うか」の地図づくりに紙面を割きました。出てくる数値はいつもどおり全部自分で計算し、記事に載せる直前に再実行して照合しています。
1. まず結論:多変量解析編の地図
細かい話に入る前に、この編の全体像を1枚にします。この記事でいちばん残したかったのはこの図です。
軸の取り方には試行錯誤がありました。最終的に採ったのは、横軸が正解ラベルの有無(教師なしか教師ありか)、縦軸が何を相手にするのか(データ表の列=変数の関係を相手にするのか、行=個体を相手にするのか)です。データが量的か質的かは3番目の区別なので、軸ではなく各カードのラベルに落としました。
なぜ「データの型」を横軸にしなかったのか、そこが最初の失敗でした。判別分析は説明変数が量的なのに目的変数が質的で、数量化I類はその逆(説明変数が質的で目的変数が量的)です。データの型を1本の軸にすると、この2つを置く場所が決まりません。「量的か質的か」は手法の性格を分ける第一の軸ではなかったわけです。
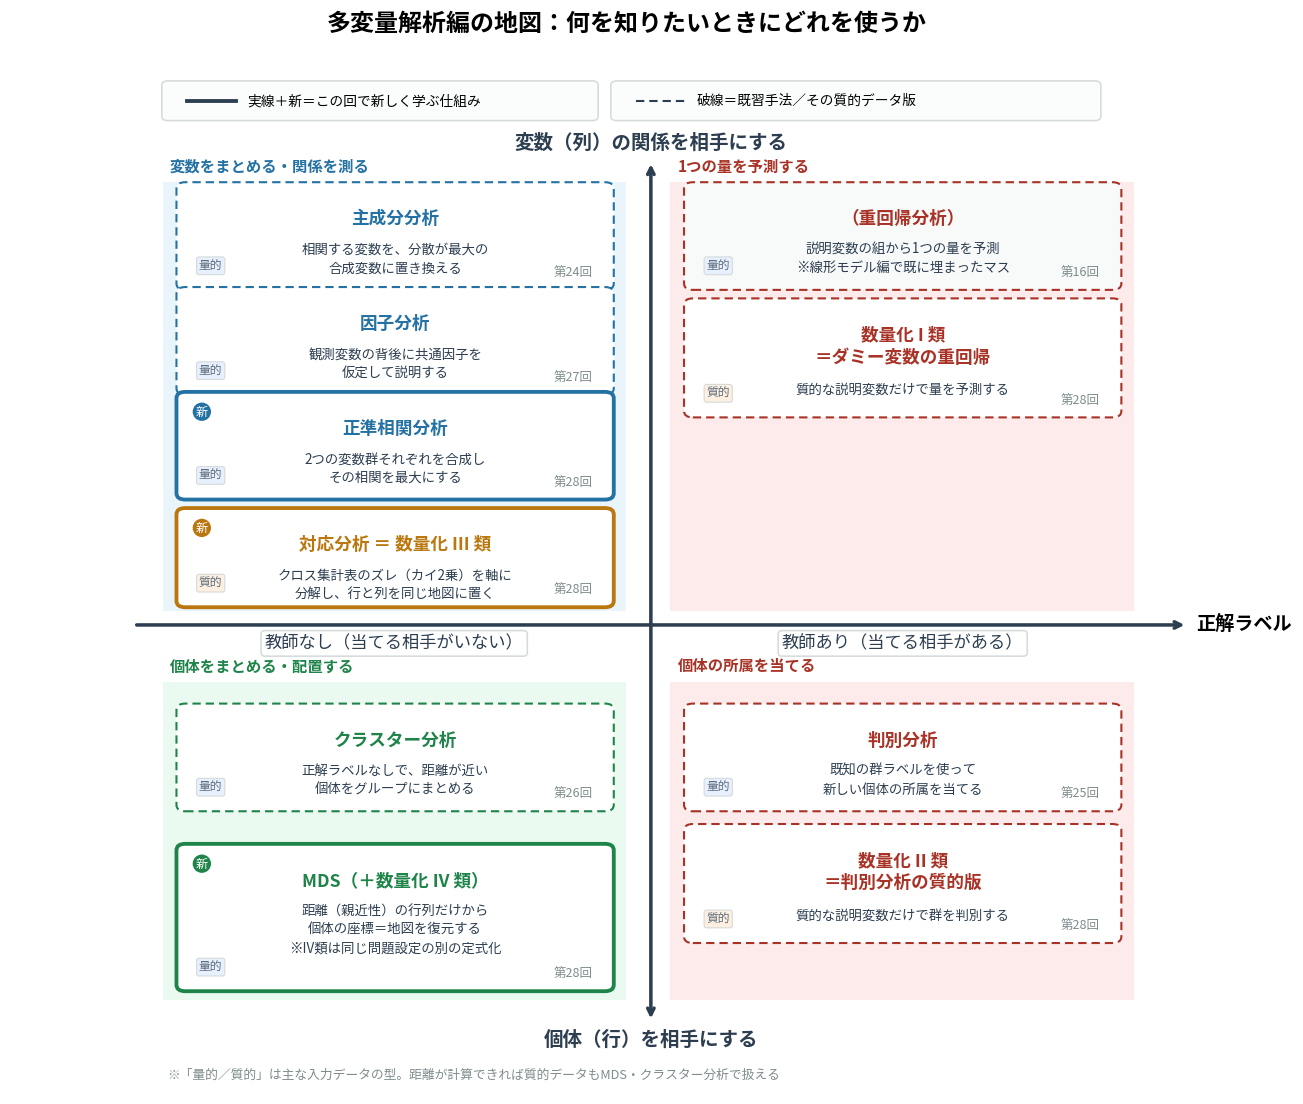
この図の読み方を補足します。
枠線が実線で「新」が付いているのが、この回で本当に新しい3つです。正準相関分析、対応分析、MDS。破線のカードは既習手法か、その質的データ版にすぎません。だから26章は、見た目ほど重くありません。
対応分析と数量化III類は、計算がまったく同じなので1枚のカードにまとめました。 教科書では別の節に出てくるので別物のように見えますが、同じものです。実はこの記事を書く過程で、私は最初これを別カードとして並べた図を作ってしまい、後から統合しました。分けて描くと「覚えることが2つある」という誤解をそのまま図にしてしまいます。
一方MDSと数量化IV類は「+」でつないで、等号にはしませんでした。 両者は「親近性・非類似度のデータから個体の配置を求める」という同じ問題を扱いますが、定式化は同じではありません(後の節で書きます)。III類のように等号で結ぶのは踏み込みすぎだと判断しました。
そして地図にすると、26章が寄せ集めではないことが見えます。第24回から第27回までで埋まっていたのは左上の量的なマスと左下、それに右下の判別分析だけでした。質的データを相手にするカードが1枚も無かったのです。26章の4手法は、そこを埋めに来ています。
「何を知りたいときにどれを使うか」の逆引き
地図を実務向きに引き直すと、こうなります。手法名から入るのではなく、困っていることから引く形です。
| 知りたいこと・困っていること | 使う手法 | 回 |
|---|---|---|
| 変数が多すぎる。少ない軸にまとめて散布図で見たい | 主成分分析 | 第24回 |
| 観測できない「学力」「満足度」のような原因を想定したい | 因子分析 | 第27回 |
| 正解ラベルは無いが、似た顧客をグループに分けたい | クラスター分析 | 第26回 |
| 既知の群(購入/非購入)があり、新しい人がどちらか当てたい | 判別分析 | 第25回 |
| 距離や類似度しか手元にない(元の変数の値が無い) | MDS | 第28回 |
| 変数群が2つある(適性検査の点数群と業績の指標群)。その関係を1つの数字で | 正準相関分析 | 第28回 |
| 説明変数がカテゴリだけ。それで売上を予測したい | 数量化I類 | 第28回 |
| クロス集計表が大きすぎて、どこがどう偏っているか読めない | 対応分析 | 第28回 |
共通の枠組みはあるのか
「その他」の4手法に共通の枠があるのか、というのが私がこの章に対して最初に持った疑問でした。あります。ほぼ全部が固有値分解か特異値分解です(因子分析は最尤法だと反復計算になるので、ここでは主因子法の話として書いています)。
| 手法 | どんな行列を作って分解するか |
|---|---|
| 主成分分析 | 分散共分散行列(変数を標準化する場合は相関行列)の固有値分解 |
| 因子分析(主因子法) | 相関行列の対角を共通性に差し替えて固有値分解 |
| 古典的MDS | 距離行列を二重中心化した行列の固有値分解 |
| 正準相関分析 | 両方の分散を白色化した相関行列の特異値分解 |
| 対応分析 | 度数を で割った表について「観測 − 期待」を で割った行列の特異値分解 |
「行列を1つ作って分解し、大きい固有値の軸から順に使う」という同じ型を、入力の作り方だけ変えて使い回しています。第24回で主成分分析の道具立てを理解していれば、残りは入力の作り方を覚えるだけです。
なお特異値分解(Singular Value Decomposition、SVD)は、対称でない長方形の行列にも使える固有値分解の一般化だと考えてください。分割表は行と列で項目数が違う長方形なので、固有値分解ではなくSVDを使います。
2. 名前と正式名称の交通整理
この章は用語の暗記が実質的な中身なので、先に名前を整理します。試験では略語や別名で問われることがあります。
| 日本語名 | 英語(正式名称) | 略語 | 入力 → 出力 |
|---|---|---|---|
| 主成分分析 | Principal Component Analysis | PCA | 数値の表 → 分散が最大になる新しい軸 |
| 因子分析 | Factor Analysis | FA | 数値の表 → 背後の共通因子と負荷量 |
| 正準相関分析 | Canonical Correlation Analysis | CCA | 変数群2つ → 合成変数の組とその相関 |
| クラスター分析 | Cluster Analysis | — | 個体間の距離 → グループ分け |
| 判別分析 | (Linear)Discriminant Analysis | LDA | 群ラベル付きデータ → 群を分ける境界 |
| 多次元尺度構成法 | Multidimensional Scaling | MDS | 距離の行列だけ → 個体の座標 |
| 対応分析 | Correspondence Analysis | CA | クロス集計表 → 行と列を同じ平面に置いた地図 |
| 数量化I〜IV類 | Hayashi's Quantification Methods | — | カテゴリのデータ → カテゴリに割り当てた数値 |
MDS は何の略なのか
MDS = Multidimensional Scaling、日本語の正式名称は多次元尺度構成法です。「多次元尺度法」と書かれることもありますが、同じものです。
名前を分解すると、やっていることがそのまま出てきます。Scaling(尺度構成)は「対象に数値=目盛りを割り当てる」という心理学由来の用語です。もともとは「AとBは似ている、AとCは似ていない」という主観的な回答から、対象を1本の直線上に並べる研究がありました。それをMultidimensional(多次元)に拡張し、直線ではなく平面や空間に配置するのがMDSです。
つまり「似ている・似ていないという情報だけから、対象を置く座標系を作る手法」という名前です。ここが分かると、次の節の「距離だけから地図を作る」という話がそのまま名前と結びつきます。
MDS には2つの流派がある
ここは試験で狙われるところなので分けておきます。
| 呼び名 | 英語 | 中身 |
|---|---|---|
| 古典的MDS | Classical MDS Torgerson Scaling | 距離の値そのものを使う。二重中心化して固有値分解する、閉じた式で一発で解ける方法。主座標分析(Principal Coordinates Analysis, PCoA)という別名もある |
| 非計量MDS | Nonmetric MDS Kruskal's MDS | 距離の大小の順序だけを使う。「ストレス」という食い違いの指標を反復計算で最小化する。順序尺度のデータに使えるのが利点 |
ここで用語をもう1段だけ整理します。距離の値そのものを使うMDSを総称して計量MDSといいますが、計量MDS = 古典的MDS ではありません。 計量MDSには、古典的MDS(閉じた式)のほかに、実際の距離とのズレを反復計算で詰める最小二乗MDS(Sammonマッピングなど)も含まれます。つまり「閉じた式で解ける/反復で解く」の区別と、「距離の値を使う/順序だけ使う」の区別は別の軸です。私は最初この2つを重ねて「計量MDS=一発で解ける方法」と覚えかけました。
この記事で扱うのは古典的MDSです。 試験で問われるのは主に「非計量MDSは順序情報しか使わない」「ストレスを最小化する」の2点でした。
なお非計量MDSが「順序だけを使う」仕組みの中身は、単調回帰です。元の距離の順序を保つように補正した値(disparity)を当てはめ、実際の配置との残差を規準化した平方和がストレスです。この2つが1本につながると、暗記が理屈になります。
略語の罠
ここで1つ注意です。LDAは線形判別分析(Linear Discriminant Analysis)の略ですが、機械学習の文献では潜在ディリクレ配分法(Latent Dirichlet Allocation)というまったく別の手法(文書のトピック抽出)の略語としても使われます。
そしてCAは対応分析(Correspondence Analysis)、CCAは正準相関分析(Canonical Correlation Analysis)です。1文字違いで別物なので、文脈で判断するしかありません。
さらに厄介なのは、CCA 自体が2つの手法の略語だということです。生態学の文献では CCA は正準対応分析(Canonical Correspondence Analysis)を指すのが標準で、これは名前のとおり対応分析(CA)の拡張であって、正準相関分析とは別物です。正準相関分析を CanCorr と書き分ける文献もあります。
手元のデータの形から引く
用語を覚えるより、手元にあるデータの形から引くほうが実務でも試験でも速いです。
| 手元にあるデータ | 候補になる手法 |
|---|---|
| 数値の変数×個体の表(1枚) | 主成分分析/因子分析/クラスター分析 |
| 数値の表 + 群ラベル | 判別分析 |
| 数値の表が2枚(変数群が2つ) | 正準相関分析(片方が1変数なら重回帰と一致) |
| 距離・類似度の行列しかない | MDS(数量化IV類も同じ問題設定)/クラスター分析 |
| クロス集計表(度数) | 対応分析(=数量化III類)/カイ2乗検定 |
| カテゴリの説明変数 + 数値の目的変数 | 数量化I類(=ダミー変数の重回帰) |
| カテゴリの説明変数 + 群ラベル | 数量化II類(=判別分析) |
3. 多次元尺度構成法:距離だけから地図を作る
定義から入ります。MDSは、個体どうしの距離(または非類似度)の行列だけを入力として、その距離関係を再現する座標を出力する手法です。
いちばんわかりやすい例が地図です。都市間の距離表だけを渡して、緯度・経度は一切教えない。それでも日本地図が出てくるのか、をやってみます。
8都市の距離表から日本地図を復元する
入力は8都市の距離(km)だけです。座標の情報はどこにも入れていません。
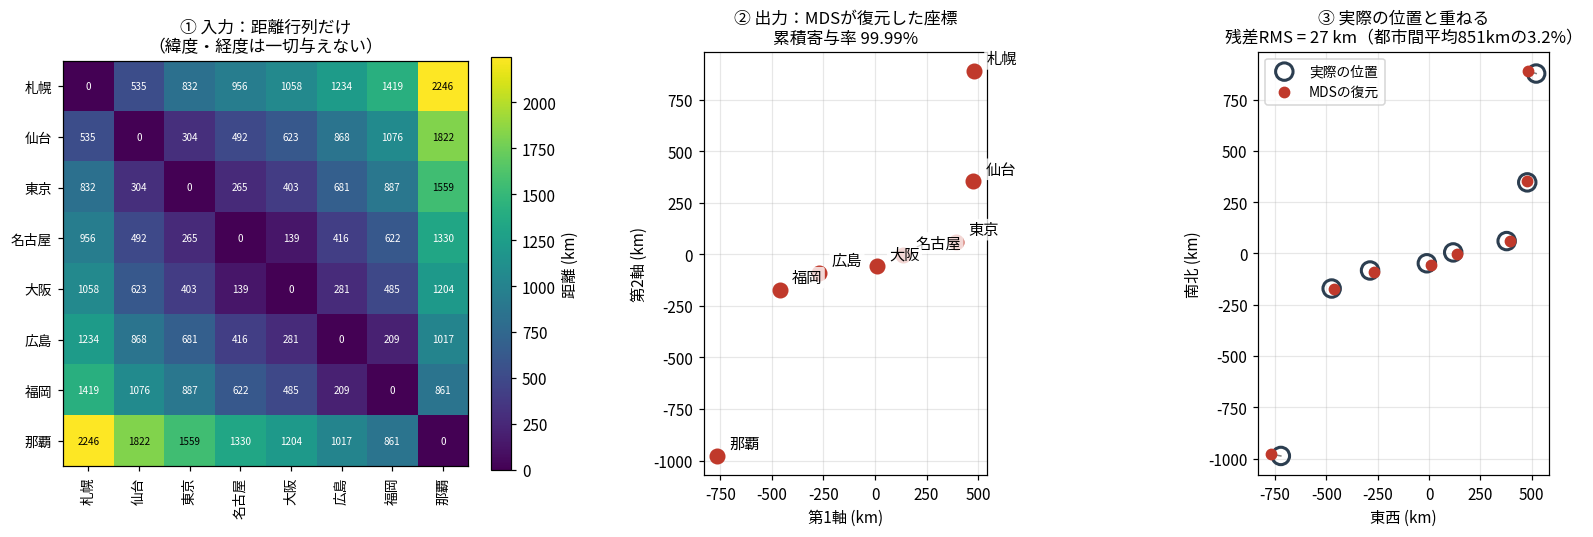
出てきました。距離だけを渡して、日本列島の形が復元されています。
数値で確認します。
| 項目 | 値 |
|---|---|
| 第1軸の固有値 | 3200520.8(寄与率 93.44%) |
| 第2軸の固有値 | 224301.9(寄与率 6.55%) |
| 上位2軸の累積寄与率 | 99.99% |
| 正の固有値の個数 | 4個(点が8個なので最大7次元) |
| 負の固有値の個数 | 3個(最小 −776.1、第1固有値の 0.02%) |
| 実際の平面座標との残差RMS | 27 km(都市間平均851kmの3.2%) |
| 2軸で再現した距離と元の距離の相関 | 1.000000(最大のずれ 1 km) |
累積寄与率99.99%というのは、8都市の距離関係が実質2次元で説明しきれているという意味です。当然です。都市は地球という球面の上にありますが、日本列島の範囲なら平面で十分近いということです。
なお負の固有値が3個出ていますが、最大のものでも第1固有値の 0.02% しかありません。球面上の大円距離は厳密にはユークリッド距離ではないので、この程度のごく小さい負の値は出るのが普通です。実務ではこの大きさなら無視して上位の正の軸だけ使います。負の固有値そのものの意味は後の節で書きます。
「軸に意味はない」はどういう意味か
図では「北が上」になるように描きましたが、これは私が後から回転させて合わせたものです。 MDSの出力そのものに「北」は入っていません。
距離を再現するという目的からすると、配置は回転・反転・平行移動が自由です。 全体をぐるっと回しても、鏡に映しても、点どうしの距離は変わらないので、どれも等しく正解です。だから「第1軸が東西を表す」といった外的な意味づけは、MDS自身がしてくれるものではありません。
ここは私が一度雑に理解して、この記事の中で自己矛盾を起こしかけたところです。「軸に意味がない」を強く言いすぎると、次の節で書く「古典的MDS=主成分分析」と衝突します。正確にはこうです。
- 古典的MDSが返す配置は主軸に揃っているので、第1軸は分散が最大の方向、つまり主成分分析の第1主成分と一致します。この意味では軸に順序と意味があります(そうでなければ上の表の寄与率が定義できません)
- しかし「その軸が東西である」「その軸が価格の高低である」といった実質的な解釈は付いてきません。 回転しても距離は同じなので、目的関数からは向きが決まらないからです
試験で問われる「MDSの軸に意味はない」は後者の話です。「分散最大という内的な意味」と「東西や価格といった外的な意味」を分けて考えると、混乱しません。
なお図の右パネルで実際の座標と重ねるには、回転と反転のほかに拡大縮小も合わせています。この「2つの配置を回転・反転・拡大縮小で最もよく重ねる」操作をプロクラステス分析といいます(回転・反転だけなら直交プロクラステス)。残差27kmはそれを施した後の値です。ただし拡大縮小はMDSの不定性ではありません。 古典的MDSは距離の絶対値を再現しているので、勝手に拡大すると距離が変わってしまいます。ここで縮尺を合わせたのは、緯度経度由来のkm座標と重ねるための処理です。
計算の中身:二重中心化
軽くだけ触れます。距離行列 から座標を作る手順はこうです。
- 各要素を2乗した行列 を作る
- 二重中心化する。中心化行列 を使って
- を固有値分解し、固有値の平方根で固有ベクトルをスケールする
なぜこれで座標が出るのか、直感だけ書きます。距離の2乗を展開すると
です。ここで欲しいのは内積 の部分(内積が分かれば座標が復元できる)ですが、邪魔な と が付いています。二重中心化は、この行ごと・列ごとに乗っている邪魔な項を引き算で消す操作です。消した結果が内積の行列 になり、あとは固有値分解すれば座標が出ます。
負の固有値が出たら何を意味するか
日本地図の例では、負の固有値はごく小さいものが3個でした。では大きい負の固有値が出たら何を意味するのか。ここが試験で問われるところです。
負の固有値は「その距離行列を、何次元のユークリッド空間にも等長に埋め込めない」というサインです。ここは正確に言う必要があります。「平面(2次元)に収まらない」という話ではありません。それは正の固有値が3個以上あるだけで起きる、次元数が足りないという別の問題です。負の固有値は次元をいくら増やしても解決しません。
実験してみました。次節で使う12個体・5変数のデータ(都市の例とは別のデータです)について、個体間の距離を直線距離(ユークリッド距離)ではなくマンハッタン距離(碁盤の目に沿った距離)で測り直し、MDSに入れます。結果は負の固有値が4個、最小は −10.2704。無理に座標を作ろうとして虚数方向の軸が出てきた、という状態です。
第1固有値が 181.04 なので、最小の負はその5.7%にあたります。都市の例の負が第1固有値の0.02%だったのと比べると、桁が2つ以上違います。「小さい負は丸め誤差のようなもの、大きい負は距離そのものがユークリッド的でないサイン」という区別は、絶対値ではなく第1固有値との比で見る必要があります(都市の例は距離がkm単位なので、負の値そのものは −776.1 と大きく見えます)。
ただしここで「マンハッタン距離だから必ず負が出る」と一般化するのは間違いでした。書きながら気になって確かめたところ、反例がすぐ出ました。
| 配置 | マンハッタン距離のMDSの固有値 |
|---|---|
| 5点を1直線上に並べた場合 | 30.2 と 0 のみ。負は0個(1次元ではL1とL2が一致する) |
| 3点の場合(5変数からL1を計算) | 60.43、3.23、0。負は0個 |
| 8点の場合(4変数からL1を計算) | 上位5個が正、負が2個(−1.02、−1.28) |
三角不等式を満たす3点なら必ず平面に埋め込めますし、1次元上の配置ならL1距離はユークリッド距離そのものです(マンハッタン距離は距離の公理を満たすので、上の3点の例はこれに該当します)。正しくは「マンハッタン距離は一般にユークリッド距離として実現できるとは限らず、今回の配置では負の固有値が出た」です。「距離の種類」ではなく「距離行列そのもの」が埋め込めるかどうかを決めています。
負の原因はメトリックの選び方だけではありません。三角不等式を破っている非類似度(人が主観で付けた類似度など)や、測定誤差・欠測でも起きます。三角不等式が破れていれば3点でも負が出ます。()で試すと固有値は 12.5、0、−3.5 でした。「点が少なければ大丈夫」ではなく「距離として成立していれば点が少ないうちは大丈夫」です。
対処は3つです。負が小さければ無視して上位の正の軸だけ使う。距離を変換する(今回のデータでは にすると負の固有値が消えました)。あるいは非計量MDSに切り替える。大きい負の固有値が出るなら、そもそもユークリッド的な配置で距離の値を再現するのが無理なので、順序だけを使う方針に変えるのが筋です。
4. MDSと主成分分析は何が違うのか
ここが今回いちばんおもしろかった論点です。
両方とも「次元を減らして散布図にする」手法です。だとすると、どう使い分けるのか。私は当初「アルゴリズムが違う別の手法」だと思っていました。違いました。
同じデータで両方を計算して座標を比べる
12個体・5変数のデータを用意して、2つの経路で計算しました。
条件を先に書いておきます。この一致には前提があります。 主成分分析は分散共分散行列ベース(変数を標準化しない)で、距離はその同じ標準化していない変数で測ったユークリッド距離です。相関行列ベースの主成分分析(=変数を標準化する場合)に対応するのは「標準化したあとのユークリッド距離」なので、入力の作り方を揃えないと一致しません。
- 経路A(主成分分析):12×5のデータ行列から分散共分散行列を作り、固有値分解する
- 経路B(古典的MDS):同じデータから12×12のユークリッド距離行列を作る。このとき元の変数の値は捨てる。 その距離行列を二重中心化して固有値分解する
経路Bでは、途中で元のデータを捨てています。それでも同じ答えが出るのか。
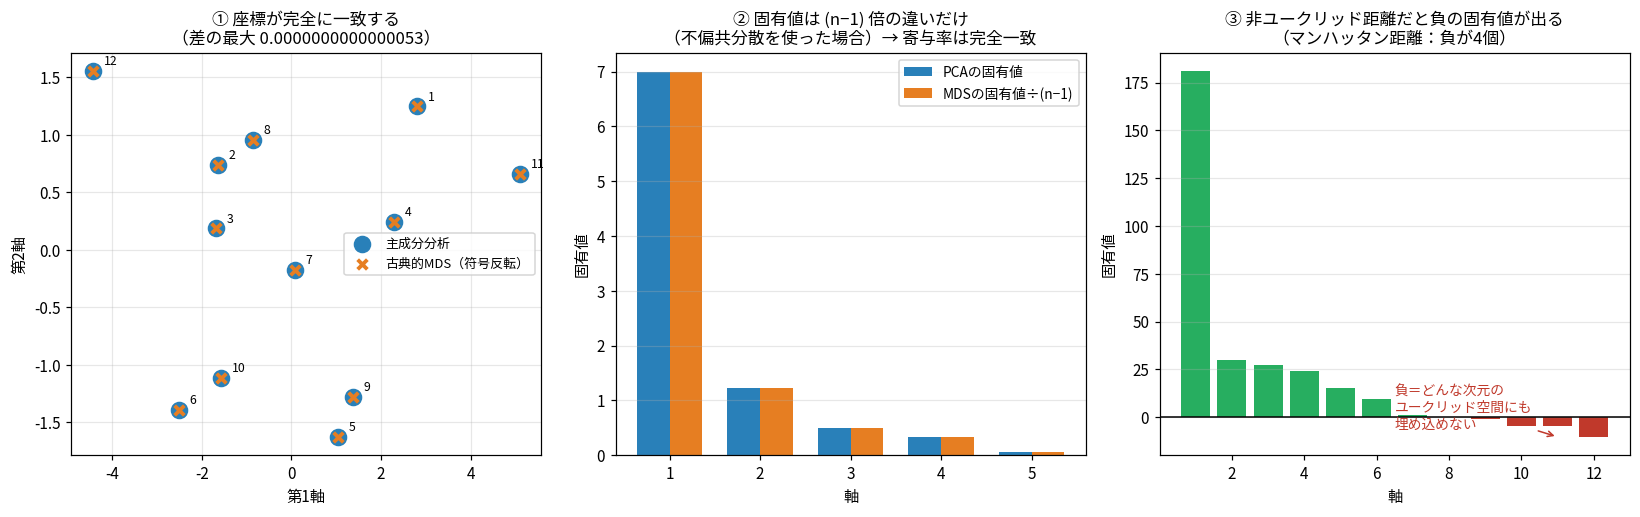
完全に一致しました。座標の差の最大は 5.33e-15、つまり浮動小数点の計算誤差の範囲です。なおこれは各軸の符号を揃えたあとの値です。固有ベクトルの符号は数学的に決まらないので、左右反転した図が出てくることがあります(図の凡例に「符号反転」と書いてあるのがそれです)。距離を再現するという意味ではどちらも同じ配置です。
固有値の関係も見ておきます。
| 軸 | PCAの固有値 | MDSの固有値 | MDSの固有値÷ |
|---|---|---|---|
| 1 | 6.993904 | 76.932940 | 6.993904 |
| 2 | 1.220205 | 13.422251 | 1.220205 |
| 3 | 0.505097 | 5.556062 | 0.505097 |
| 4 | 0.324374 | 3.568110 | 0.324374 |
| 5 | 0.057479 | 0.632269 | 0.057479 |
| 合計 | 9.101057 | 100.111631 | 9.101057 |
MDSの固有値は、PCAの固有値のちょうど 倍でした( なので11倍)。
この の出どころは中心化ではありません。共分散行列を作るときに で割っている(不偏共分散)ことの裏返しです。MDSの は中心化した座標の内積そのもの(平方和のスケール)なので、 で割る前の量になっています。もし標本共分散を で割る流儀にすれば、倍率は 倍になります。
どちらにしても全軸が同じ定数倍なので、寄与率は完全に一致します(第1軸の寄与率はどちらも 76.8472%)。
では違いはどこにあるのか
計算が同じなら、2つ覚える意味は何なのか。答えは受け取れる入力が違う、これだけです。
| 主成分分析 | 古典的MDS | |
|---|---|---|
| 入力 | 個体×変数のデータ行列(生データが必要) | 距離行列だけでよい |
| ユークリッド距離のとき | — | 主成分分析と完全に同一 |
| 非ユークリッド距離 | 受け取れない | 受け取れる(負の固有値が出ることを許す) |
| 軸の意味(内部) | 分散最大の方向 | 同じ(主軸で返るので第1軸は分散最大) |
| 軸の意味(外部) | 主成分負荷量で「何の軸か」を読める | 読めない(東西・価格などの外的な意味は付かない) |
| 変数の寄与 | 主成分負荷量で読める | 読めない(元の変数の情報が無い) |
つまりユークリッド距離を使う限り、MDSは「生データが手に入らない場合の主成分分析」です。逆に言えば、生データがあってユークリッド距離を使うなら、わざわざMDSを持ち出す理由はありません。
ただしこの言い方はMDSを狭く見せすぎます。MDSの入力はユークリッド距離である必要がありません。 生態学で群集の類似度に使うブレイ・カーティス非類似度、集合の重なりを測るジャッカード距離、生物の遺伝的距離。これらは「変数を引き算して2乗する」形をしていないので、主成分分析には渡せません。MDS(主座標分析)が生態学や系統解析で標準的に使われるのは、この非ユークリッドな非類似度を受け取れるからです。主成分分析の代役という以上の役割がここにあります。
MDSが本当に効くのは、最初から距離しか存在しない場合です。たとえばアンケートで「この2つの商品はどのくらい似ていますか」と直接聞いた回答、生物の種の遺伝的距離、ブランドの主観的な類似度。こういうデータには「変数の値」がそもそも存在しません。元の変数が無いところから座標を作れるのがMDSの立ち位置です。
まとめ:この関係を一言で
古典的MDS with ユークリッド距離 = (分散共分散行列による)主成分分析。 違いは計算ではなく、入力に何を受け取れるかだけ。
なお古典的MDSの別名が主座標分析(Principal Coordinates Analysis, PCoA)であることも、この一致を知ると納得できます。名前の時点で主成分の親戚だと言っているわけです。
5. 正準相関分析:変数群が2つあるとき
次は正準相関分析です。定義はこうです。
変数群 ( 個)と変数群 ( 個)があるとき、それぞれを合成した変数 、 を作り、 と の相関が最大になるように係数 を決める。 そのときの相関を正準相関、合成した変数を正準変量という。
使う場面のイメージは、たとえば採用の場面です。適性検査の点数が5種類あり、入社後の業績指標が3種類ある。「適性検査全体と業績全体は、どのくらい関係しているのか」を1つの数字で言いたい。こういうときに使います。
「yが複数ある重回帰」という理解は正しいか
私はこの手法を最初に読んだとき、「重回帰は説明変数が複数で目的変数が1つ。正準相関は目的変数も複数になったもの」と理解しました。この理解は正しかったのですが、確かめてみると、もう少し強い主張ができます。
3つの手法が入れ子になっているのです。
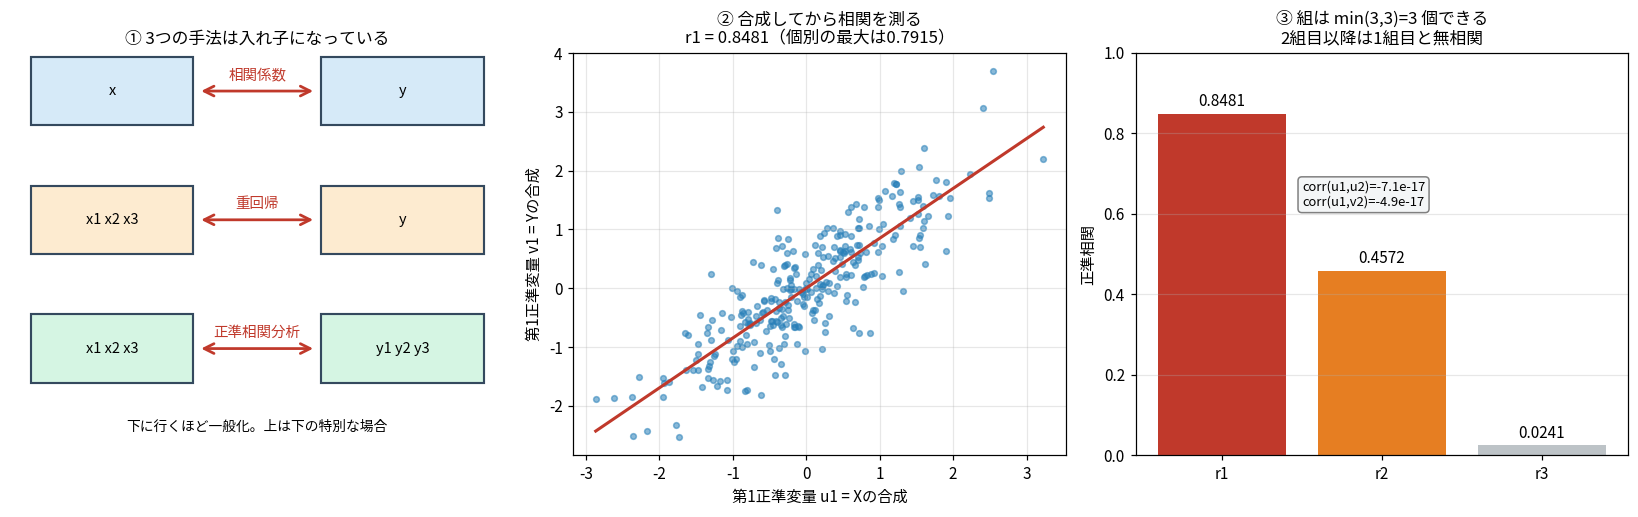
数値で確かめます。 3変数・ 3変数、 のデータで計算しました。
特殊ケース1: を1変数にすると重回帰と一致するか
| 計算経路 | 値 |
|---|---|
| 正準相関 | 0.81946950 |
| 重回帰の重相関係数 | 0.81946950 |
一致しました(差 1.11e-16)。 が1変数のときの正準相関は、重回帰の重相関係数そのものです。
特殊ケース2: も も1変数にすると
正準相関 0.79154871、ピアソン相関の絶対値 0.79154871。これも一致します。
つまり入れ子はこうなっています。
| 変数の数 | 手法 | 測るもの |
|---|---|---|
| :1、:1 | 相関係数 | |
| :多、:1 | 重回帰分析 | 重相関係数 |
| :多、:多 | 正準相関分析 | 正準相関 |
相関係数 ⊂ 重回帰 ⊂ 正準相関分析。下に行くほど一般的で、上は下の特別な場合です。だから正準相関分析を新しく覚えるというより、重回帰の目的変数側を複数に開いたものと捉えるのが正確です。
ただしこの入れ子の説明には、1つ大事な注意があります。「重回帰の目的変数側を開いたもの」という言い方は、 が説明する側・ が説明される側という向きを含んでしまいます。正準相関分析にその向きはありません。 と を入れ替えても正準相関の値も正準変量も変わりません(完全に対称です)。重回帰は「 を で説明する」という非対称な問題ですが、正準相関分析は「2つの変数群がどれだけ共通の何かを持っているか」を測る対称な問題です。
説明変数群・目的変数群と呼びたくなるのは、実務でそういう文脈に使うことが多いからで、手法の構造には向きが入っていません。入れ子は「特別な場合として一致する」という意味での入れ子で、「一般化したから向きも引き継ぐ」わけではない、と分けて理解しておくのが安全でした。
「1対1の相関の最大値」ではない
ここは私が誤解しかけたところです。「 と の相関が最大になる組」と聞くと、、 …と総当たりして最大のものを選ぶ、というイメージを持ちがちです。違います。
上のデータで確認しました。
- 個別の相関で最大なのは
- 正準相関
合成することで 0.0565 上がっています。 正準相関は「1対1の相関の最大値」ではなく、両側で変数を混ぜてから測った相関です。だから個別の相関のどれよりも大きくなり得ます。
そして下回ることもありません。理由は、個別の相関そのものが「片方の係数を1、他を0」という特別な合成にあたるからです。 はあらゆる合成の中の最大値なので、その特別な合成の値以上になります。
ただしこの不等式には条件が2つあります。比べる相手は個別の相関の「絶対値」の最大であること(正準相関は定義上つねに0以上なので、 の相関があるデータで「」と言っても情報がありません)。そして保証されるのは だけだということ。今回は で個別の最大 0.7915 を下回りましたが、これは「 は必ず下回る」という法則ではありません。共通因子が2本あるようなデータを作ると、 が個別の相関の最大を上回る例も作れます(実際に作ってみたところ、、 に対して個別の相関の絶対値の最大は 0.9831 でした)。「 以降は小さくなる」ではなく「 以降には保証がない」が正確な言い方です。
実際に第1正準変量の中身を見るとこうでした。
この と の相関を素朴に計算すると 0.848082 で、正準相関 と一致します。定義どおりです。
組はいくつできるか:min(p, q)
試験で狙われるのはここです。 正準相関の組は何個できるか。
答えは 個です。上の例は なので3組でした。多い方ではなく、少ない方です。 が5変数、 が2変数なら、組は2つしかできません。
理由は素朴に考えれば分かります。 側が2変数しかないなら、 から作れる互いに無相関な合成変数は2つまでです。相手がいないので3組目は作れません。
正確には組の個数は です。両側の変数がフルランク(多重共線性がなく、 も足りている)なら 個になります。ランクが を下回るほど変数が重複している場合だけ、組の数が減ります( でもランクが2しかなければ2組。 でランク2、 でランク2なら、 のままで減りません)。試験では素直に と答えて問題ありませんが、「なぜ少ない方なのか」はランクの話だと押さえておくと迷いません。
そして2組目以降は1組目と無相関になります。実測した直交性はこうでした。
主成分分析で第2主成分が第1主成分と直交していたのと同じ構造です。「大きい順に、互いに無相関な軸を取り出していく」という第24回の型が、ここでも繰り返されています。
第3の正準相関は 0.0241 でした。ほぼ0なので、3組目は実質的に意味がありません。主成分分析と同じように、上位の組だけ見て解釈するのが実務での使い方です。
なお「どこまでの組が意味を持つか」は目分量ではなく検定で決める枠組みがあります。ウィルクスのラムダ()を使い、バートレットの近似でカイ2乗検定にかけて「 組目以降はすべて0か」を順に調べていく方法です。ここは深追いしませんでしたが、用語として「正準相関の有意性はウィルクスのラムダ」だけは覚えておくことにしました。第25回の判別分析で「群の平均ベクトルが全部等しいか」を検定するのに使った と同じ統計量なので、無関係な暗記ではありません(第12回のウィルクスの定理とは名前が似ているだけの別物です。あちらは尤度比の漸近分布の話)。
6. 数量化法:既習手法の言い換え
林知己夫が提案した数量化法I〜IV類です。ここは正直に言うと、新しい手法を覚える場所ではありません。
「カテゴリのデータに数値(スコア)を割り当てる」という発想を共通の柱に、既習の手法をカテゴリデータ向けに整理し直したものです。名前が I・II・III・IV と番号で付いているせいで、4つの独立した手法のように見えてしまいます。
対応表を作りました。この記事で数量化法について覚えるべきことは、この表だけです。
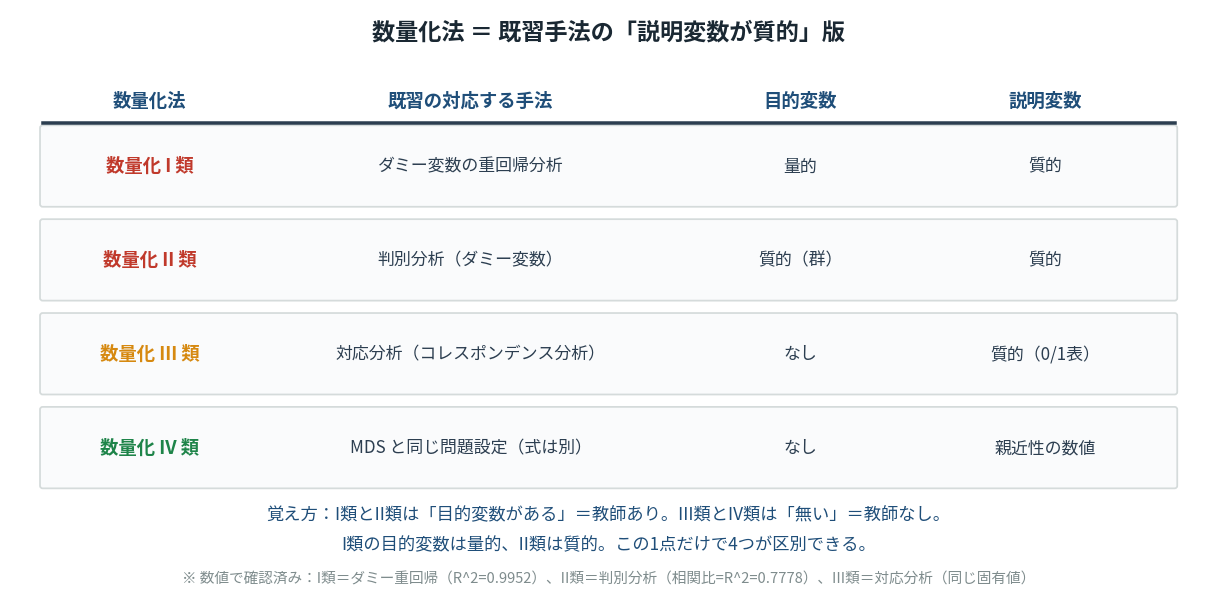
区別の仕方は機械的です。目的変数があるか(教師ありか)、それが量的か質的か、この2点だけです。
| 目的変数 | 説明変数 | 対応する既習手法 | |
|---|---|---|---|
| I類 | 量的 | 質的 | ダミー変数の重回帰分析(第16・20回) |
| II類 | 質的(群) | 質的 | 判別分析(第25回) |
| III類 | なし | 質的(0/1表) | 対応分析と同一の計算 |
| IV類 | なし | 親近性の数値 | MDSと同じ問題設定(式は別) |
I類とII類が教師あり、III類とIV類が教師なしです。
IV類だけ「同一の計算」と書けない理由を補足します。数量化IV類は、親近性 が与えられたとき を(スケールを固定した上で)最小化するようスコア を決める、という2次形式の最小化として定式化されます。グラフのラプラシアン行列の固有値問題に近い形です。一方の古典的MDSは距離行列を二重中心化してから固有値分解します。「親近性データから個体の配置を作る」という狙いは同じでも、解く式が違うわけです。試験対策としては「IV類=親近性データの布置=MDS的な手法」と覚えれば足りますが、等号で結んで暗記すると、式を見せられたときに戸惑うと思います。
数量化I類=ダミー変数の重回帰を数値で確認する
言葉だけだと納得しにくいので計算しました。家賃の例です()。説明変数は立地(都心・近郊・郊外)と築年数(新築・中古・築古)で、どちらもカテゴリしかありません。目的変数は家賃(万円)という量的な値です。
これをダミー変数の重回帰として解いた結果です(基準は郊外×築古)。
| 項目 | 値 |
|---|---|
| 定数項(郊外×築古) | 6.7262 |
| 立地:都心 | +7.1548 |
| 立地:近郊 | +2.6667 |
| 立地:郊外 | 0(基準) |
| 築年数:新築 | +3.6548 |
| 築年数:中古 | +1.6667 |
| 築年数:築古 | 0(基準) |
| 決定係数 | 0.995248 |
数量化I類では、この結果を別の用語で呼びます。ここが暗記のポイントです。
| 数量化法の用語 | 重回帰での正体 | この例での値 |
|---|---|---|
| カテゴリースコア | 偏回帰係数(に相当する量) | 都心 +7.1548 など |
| アイテム | 説明変数 | 立地、築年数 |
| カテゴリー | 水準 | 都心、近郊、郊外 |
| 決定係数 | 決定係数 (そのまま) | 0.995248 |
| 重相関係数 | 0.997621 | |
| レンジ | そのアイテムの係数の最大−最小 | 立地 7.1548、築年数 3.6548 |
ここは私が一度取り違えたところなので、はっきり書いておきます。私は最初、この表に「相関比」という用語を「 のこと」として書いていました。二重に間違っていました。
まず相関比 は2乗された量(群間変動 ÷ 全変動)で、平方根の側ではありません。そしてより重要なのは、相関比は数量化I類の指標ではないことです。相関比は「量的な変数が、質的な群によってどれだけ説明されるか」を測る量なので、群が必要です。目的変数が量的な数量化I類には群がないので、あてはまりは素直に決定係数 / 重相関係数 と呼びます。相関比が出てくるのは、目的変数が群である数量化II類の方です(次項で確認します)。
「相関比」という語が両方に出てくると思い込んだ結果、 と を混ぜた記述になっていました。同じ語が複数の手法に出てくるように見えたときは、その語が要求する前提(ここでは「群が必要」)に立ち返ると切り分けられます。
カテゴリースコアも、偏回帰係数と完全に同じ数値とは限りません。上の表は「郊外×築古を基準(0)に置く」流儀で解いたものですが、数量化法では各アイテムの中で加重平均が0になるように中心化する流儀が一般的です。その場合、各アイテムのスコアは上の値から定数を引いた形になり、定数項も一緒に動きます。アイテム内での差(つまりレンジ)は流儀によらず同じなので、比較に使う分には影響しません。
レンジは「そのアイテムがどれだけ効いているか」を測る指標として使います。この例では立地のレンジ7.1548が築年数の3.6548より大きいので、家賃への影響は立地の方が大きいと読みます。重回帰の言葉で言えば「そのカテゴリ変数を動かしたときの予測値の振れ幅」です。
ただしレンジは標準化されていない量です。カテゴリ数が多いアイテムは、それだけで最大−最小が広がりやすい。度数の偏りが大きいアイテムでは、ごく少数しか該当しないカテゴリの極端なスコアがレンジを押し上げます。アイテム間でレンジを比べていいのは、カテゴリ数と度数の分布が似ている場合です。実務では偏相関比(他のアイテムの影響を除いたうえで、そのアイテム固有の説明力を測る指標)を併記して判断します。今回の例は両アイテムとも3カテゴリで度数も近いので、レンジの比較が素直に効いています。
数量化II類も確認する
こちらは購入するかしないか(2群)を、チャネル(A・B・C)とデバイス(PC・スマホ)から当てる例です()。
| 項目 | 値 |
|---|---|
| 定数項(C×スマホ) | +0.3333 |
| チャネルA | +0.5000 |
| チャネルB | −0.5000 |
| デバイスPC | +0.3333 |
| 決定係数 (=相関比 ) | 0.777778 |
| 判別得点0.5を境にした正解率 | 12/12 |
| 購入群の平均得点 | 0.8889 |
| 非購入群の平均得点 | 0.1111 |
ここが相関比の出てくる場所です。判別得点(上の係数から計算されるスコア)を実際の2群で分けて、群間変動 ÷ 全変動を計算すると 0.777778。つまり
2群の場合、相関比は決定係数と厳密に一致します(自分で両方計算して6桁一致を確認しました)。目的変数が群なので相関比を定義でき、しかもそれが と同じ値になる。数量化II類のあてはまりの指標として相関比が出てくるのは、この構造があるからです。
そして念のため正準相関も計算してみたところ、0.88191710 で の 0.88191710 と一致しました。つまり2群の判別分析は、正準相関分析の特別な場合でもあるわけです。前節の入れ子構造がここでも顔を出します。なお3群以上のII類では は第1正準相関の2乗 に対応します。2群のときだけ、 と と の3つが同じ数字になります。
覚え方
数量化法についてやるべきことは、この対応表を1回書き写すことだけだと考えています。導出や計算の練習は不要です。試験でも「数量化III類に対応する手法はどれか」といった対応の知識で答えられます。
7. 対応分析:カイ2乗を地図にする
最後は対応分析です。地図の左上(教師なし・変数の関係を相手にする)で、質的データを扱うカードがずっと無かった、そこを埋めるのがこの手法です。
何をする手法か
入力はクロス集計表(分割表)です。年代×関心ジャンル、都道府県×購入商品、といった度数の表です。
第14回でカイ2乗適合度検定をやりましたし、第30回では分割表の独立性の検定を扱います。カイ2乗検定は「行と列は独立か」を判定します。しかし独立でないと分かったとして、どこがどうズレているのかは教えてくれません。
対応分析はその「どこが」を地図にする手法です。カイ2乗が「ズレがある」で終わるところを、そのズレを軸に分解して可視化します。
数値で見る
年代(4区分)× 関心ジャンル(4区分)、 の表を使いました。
| ゲーム | 音楽 | 料理 | 健康 | 計 | |
|---|---|---|---|---|---|
| 10代 | 45 | 20 | 10 | 5 | 80 |
| 20代 | 30 | 35 | 20 | 10 | 95 |
| 30代 | 15 | 25 | 40 | 25 | 105 |
| 40代以上 | 5 | 10 | 30 | 50 | 95 |
| 計 | 95 | 90 | 100 | 90 | 375 |
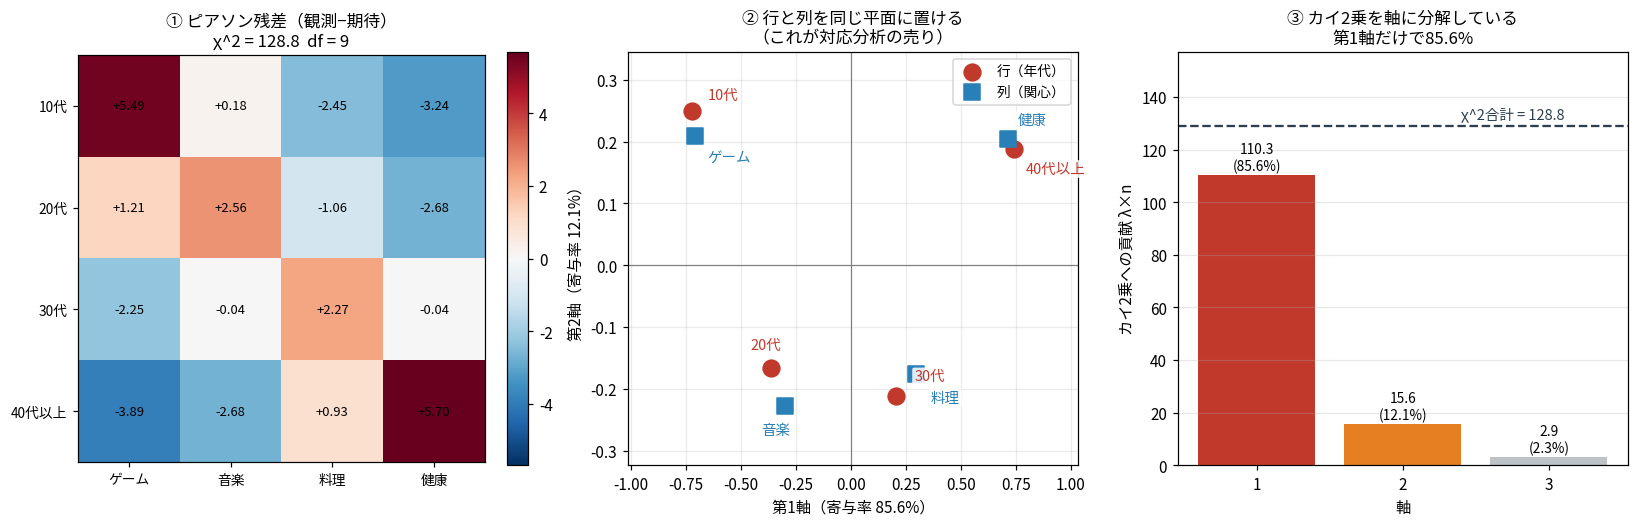
計算結果です。
| 項目 | 値 |
|---|---|
| ピアソンのカイ2乗 | 128.8452 |
| 自由度 | |
| 総イナーシャ | 0.343587 |
総イナーシャ = カイ2乗 ÷ n
ここがこの節の核心で、試験で最も狙われるところです。
イナーシャ(inertia、慣性)は、カイ2乗をサンプルサイズで割った量です。カイ2乗は に比例して大きくなってしまうので、 で割って「1人あたりのズレの量」にしたものだと考えると分かりやすいです。
「慣性」という物理の言葉が付いているのは、これが重み付きの散らばりの形をしているからです。対応分析では、各行を行プロファイル(その行を行合計で割った、足すと1になる比率のベクトル)として扱い、行合計の割合をマス(mass、質量)という重みにします。そして各行プロファイルが全体の平均プロファイルからどれだけ離れているかをカイ2乗距離で測り、マスで重み付けして足す。カイ2乗距離とは、成分ごとのズレをその列の割合の平方根で割ってからユークリッド距離を測る量です。
分母が なのは、カイ2乗統計量が「ズレの2乗 ÷ 期待値」だったのと同じ重み付けです。割合の小さい列でのズレを重く見るわけです。これが総イナーシャです。物理で言えば「質量×重心からの距離の2乗の和」=慣性モーメントと同じ形をしているので、この名前になっています。
列側から同じことをしても同じ値になります。行から見ても列から見ても同じ量になるのが、対応分析が行と列を対等に扱える理由です。
そして対応分析は、この総イナーシャを軸ごとに分解します。
| 軸 | 固有値 | 寄与率 | (カイ2乗への貢献) | 累積寄与率 |
|---|---|---|---|---|
| 1 | 0.294025 | 85.58% | 110.2593 | 85.58% |
| 2 | 0.041730 | 12.15% | 15.6486 | 97.72% |
| 3 | 0.007833 | 2.28% | 2.9373 | 100.00% |
| 合計 | 0.343587 | 100% | 128.8452 = |
軸ごとの貢献を足すとカイ2乗そのものになります。 110.2593 + 15.6486 + 2.9373 = 128.8452。ぴったり一致しました。
つまり対応分析は、カイ2乗という1つの数字を軸ごとに分解して「ズレの内訳」を見せる手法です。この表の第1軸だけで全体のズレの85.6%を説明できているので、この分割表のズレはほぼ1次元的だと分かります。
なお軸の本数は最大で 本です。この例は4×4なので3本。
1を引く理由は、分解する行列の作り方にあります。出発点は「観測された比率 独立なら期待される比率」という差の行列です。差なので、各行の合計も各列の合計も必ず0になります。合計が0という制約が入った の行列のランクは、最大でも です。「引かれる1本」は、全体の比率そのものを表す自明な方向(独立モデルの部分)にあたり、そこは差を取った時点で消えています。
実際に特異値分解にかけるのは、この差を で割った行列です。割り算は行と列に正の重みを掛けているだけなのでランクは変わりません。今回の4×4の表で確認すると、どちらの行列もランク3で、軸は3本でした。
なおこれも上限です。表の中に他の行の重み付き和で書ける行があるなど、行列のランクが落ちる場合は軸の本数も減ります。
行と列を同じ平面に置ける
対応分析のいちばんの売りがこれです。第1軸のスコアを並べます。
| 行(年代) | 第1軸のスコア |
|---|---|
| 10代 | −0.720 |
| 20代 | −0.360 |
| 30代 | +0.205 |
| 40代以上 | +0.740 |
| 列(関心) | 第1軸のスコア |
|---|---|
| ゲーム | −0.707 |
| 音楽 | −0.297 |
| 料理 | +0.295 |
| 健康 | +0.716 |
年代の順序と関心の順序が、同じ軸の上に同じ並びで乗りました。 若い←→年上 が、ゲーム←→健康 に対応しています。これが「行と列を同じ地図に置く」の意味です。
主成分分析のバイプロットでも個体と変数を同じ図に置きましたが、対応分析では行のカテゴリと列のカテゴリという、まったく別の種類のものを同じ平面に置けるのが特徴です。
注意:行と列の距離を直接比べてはいけない
ただし落とし穴があります。「10代とゲームが近いから関係が強い」と読むのは、厳密には正しくありません。
理由はスケーリングの流儀にあります。対応分析のスコアには「主座標」と「標準座標」があり、主座標はカイ2乗距離を再現するように特異値 を掛けた座標、標準座標は掛けない座標です。行も列も主座標で描けば、行同士の距離・列同士の距離はそれぞれカイ2乗距離として解釈できます(全軸を使えば厳密に一致します。今回の表で10代と40代以上の距離を計算すると、3軸すべてを使った主座標間の距離 1.465034 とカイ2乗距離 1.465034 が6桁一致しました。上位2軸だけの図では、落とした第3軸の2.28%分だけ近似になります)。上の図で使った対称正規化(両方を主座標にする流儀)もこれです。
問題は、行と列をまたいだ距離が、どちらのカイ2乗距離にもならないことです。行の主座標は「行プロファイル空間での距離」を、列の主座標は「列プロファイル空間での距離」を表していて、別々の空間の座標を同じ紙に重ねて描いているにすぎません。だから行同士の距離(10代と40代以上がどれだけ違うか)は解釈できて、列同士も解釈できるのに、行と列をまたいだ距離だけは意味を持たないのです。
行と列の関係を数値として読める流儀もあります。片方を主座標、もう片方を標準座標にする非対称正規化(バイプロット)にすると、行と列の内積が「観測された比率 ÷ 期待される比率 」(独立モデルから何倍ズレているか)に一致します。この記事の表で計算して確かめたところ、差は 7.8e-16 でした。だから「原点から見て同じ方向にあるほど関連が強い」と読めるようになります。ただしその場合、標準座標にした側の点どうしの距離はカイ2乗距離ではなくなります。どちらの流儀でも、行と列の間の「近さ」を距離で読むことはできないわけです。
実務では「原点から見て同じ方向にあるものは関連が強い傾向」という方向(角度)の一致として読むのが安全です。試験でも、ここを引っかける形の出題があり得ます。
ガットマン効果(馬蹄形)
上の図の中央パネルをよく見ると、4つの年代がきれいな直線ではなく緩やかな弧を描いています。これは偶然ではありません。
行と列に自然な順序があり、その順序に沿って度数が集中しているとき、対応分析の第1軸と第2軸のプロットは弧(馬蹄形)になります。 これをガットマン効果(または馬蹄形効果、horseshoe effect)といいます。
原因は、第2軸が第1軸の2次関数のような形になってしまうことです。実質1次元の構造を2次元に描くと、2本目の軸が「1本目の端と真ん中の違い」を拾ってしまい、結果として曲がります。
大事なのは「馬蹄形が出たら、それは実質1次元の順序構造がある証拠」と読むことです。第2軸に無理に別の解釈を与えてはいけません。今回の例で第1軸の寄与率が85.6%と圧倒的だったことも、実質1次元であることと整合しています。
もう少し正確に言うと、馬蹄形が出るのは「順序がある」だけでは足りません。各行が、その順序軸上の自分の位置の近くにピークを持つ形で列に反応している(一峰性の反応)ときに出ます。10代がゲームに集中し、40代以上が健康に集中し、中間の年代が中間に集中する、という今回の表がまさにそれです。生態学では、環境の勾配に沿って種の分布が一峰性になるため馬蹄形が出やすく、それを補正するためにデトレンド対応分析(DCA)という手法まで用意されています。「弧が出たら1次元の勾配を疑う」という読み方は、この分野で確立したものです。
数量化III類は同じ計算
冒頭の表で述べたとおりです。念のため数値で確認しました。8人×5項目の0/1の反応表(誰がどの項目に「はい」と答えたか)に対応分析を実行します。
| 軸 | 固有値 | 寄与率 |
|---|---|---|
| 1 | 0.836352 | 68.43% |
| 2 | 0.295982 | 24.22% |
| 3 | 0.066426 | 5.43% |
| 4 | 0.023462 | 1.92% |
総イナーシャは 1.222222。ここでの は表の総度数、つまり1の個数で 18(回答者数の8でも項目数の5でもありません)。 で、直接計算したカイ2乗 22.0 と一致します。前の例では が回答者数と総度数の両方だったので気づきにくいのですが、イナーシャの は一貫して表の度数の合計です。
そして第1軸のスコアで行と列を並べ替えると、こうなりました。
| 項1 | 項2 | 項3 | 項4 | 項5 | |
|---|---|---|---|---|---|
| 人1 | 1 | 1 | 0 | 0 | 0 |
| 人7 | 1 | 1 | 0 | 0 | 0 |
| 人2 | 1 | 1 | 1 | 0 | 0 |
| 人3 | 0 | 1 | 1 | 0 | 0 |
| 人4 | 0 | 0 | 1 | 1 | 0 |
| 人5 | 0 | 0 | 1 | 1 | 1 |
| 人6 | 0 | 0 | 0 | 1 | 1 |
| 人8 | 0 | 0 | 0 | 1 | 1 |
1が対角線上に階段状に並びました。 これが数量化III類の目的、「似た者どうし・似た項目どうしを隣に置くように並べ替える」そのものです。計算は対応分析、目的の言い方が違うだけだとよく分かります。
3変数以上のとき:多重対応分析
ここまでの対応分析は、2つの変数のクロス集計表が入力でした。年代×関心のように2元です。では質的変数が3つ以上あるときはどうするのか。
そのための拡張が多重対応分析(Multiple Correspondence Analysis, MCA)です。各個体について「該当するカテゴリに1が立つ」形の指示行列(各質的変数のカテゴリを全部横に並べ、該当箇所だけ1を立てた表)を作り、それに対応分析をかけます。
上でやった8人×5項目の0/1表は、各行の1の個数が2〜3とばらついているので厳密な指示行列ではありません(指示行列なら「変数ごとに必ず1つ」なので行和は変数の個数で一定になります)。多重回答型の表に対応分析をかけた例だと見てください。アイテムが3つ以上ある場合の数量化III類が、多重対応分析に対応します。
主成分分析に対する位置づけで言えば、「量的変数がたくさんあるときの主成分分析」に対応する「質的変数がたくさんあるときの手法」がこれです。アンケートの選択式回答をまとめて可視化する場面でよく使われます。試験対策としては名前と位置づけまでで十分だと判断しました(固有値の解釈に補正が必要になるなど、細かい注意点がある手法です)。
第30回への橋
対応分析の話は、実は26章の中では回収しきれません。カイ2乗の関係は第30回(分割表と独立性の検定)で本題になります。
- カイ2乗検定:「行と列は独立か」を判定する(イエス/ノー)
- 対応分析:そのカイ2乗を軸に分解して「どこがどうズレているか」を見せる
つまり検定が出した1つの数字の内訳を開いて見せるのが対応分析です。第30回は出題頻度が高い単元なので、イナーシャとカイ2乗の関係だけは、この回の知識としてではなく第30回の準備として押さえておくと効率がいいと思います。
8. 試験対策:どこに時間を使うか
正直なところ、26章は投入した時間に対する得点の戻りがこの編でいちばん低い章だと判断しました。出るとしても選択肢問題1問か、記述の小問の一部です。しかも問われ方が「その手法は何をするものか」「その用語はどの手法のものか」という識別レベルで、計算は要求されません。
その前提で、優先順位をつけました。
| 優先 | 項目 | 押さえること |
|---|---|---|
| 高 | 正準相関分析 | 組の個数はフルランクなら 。重回帰は が1変数の特別な場合。組は互いに無相関。 と に向きは無い |
| 高 | 対応分析 | 総イナーシャ = 。軸はカイ2乗を分解している。行と列を同じ平面に置ける。ガットマン効果 |
| 中 | MDS | 入力は距離行列。ユークリッド距離なら(共分散行列による)主成分分析と同一。非計量MDSは順序だけ使いストレスを最小化 |
| 低 | 数量化法 | I〜IV類と既習手法の対応(暗記のみ)。IV類だけは「同じ問題設定」止まり |
落としやすい点
自分が引っかかった、あるいは引っかかりそうだと感じた箇所をまとめます。
| 誤解しやすい点 | 正しくは |
|---|---|
| 正準相関の組は 個 | 個。少ない方(フルランクのときの上限) |
| 正準相関分析は で を説明する手法 | 向きは無い。 と を入れ替えても結果は同じ |
| 正準相関は個別の相関の最大値 | 違う。合成してから測るので個別の最大(0.7915)より大きくなる(0.8481)。ただし保証されるのは だけで、 は上回ることも下回ることもある |
| MDSの第1軸には意味がない | 内部的にはある(主軸で返るので第1軸は分散最大=寄与率が定義できる)。無いのは東西・価格などの外的な意味 |
| MDSの負の固有値は計算ミス | どんな次元のユークリッド空間にも埋め込めないというサイン。 この例のマンハッタン距離では4個出た(最小 −10.2704) |
| マンハッタン距離なら必ず負が出る | 出ないこともある。 一直線に並んだ点なら負は0個 |
| 点が3つなら負は出ない | 三角不等式を満たしていれば出ない。破っていれば3点でも出る( で −3.5) |
| 相関比は | 相関比 は2乗された量。 は重相関係数 |
| 相関比は数量化I類の指標 | II類の指標。 相関比は群を必要とするので、目的変数が量的なI類では定義できない |
| 数量化IV類はMDSと同じ計算 | 問題設定が同じだけ。 IV類は2次形式の最小化で、二重中心化ではない |
| 対応分析で行と列の距離を直接比べる | 比べられない。 行と列は別の空間の座標。方向(角度)の一致として読む |
| 総イナーシャはカイ2乗そのもの | 。 は表の度数の合計(回答者数とは限らない) |
| カイ2乗距離は割合で割る | 割るのは割合そのもの(2乗のズレを で割る=ズレを で割ってから距離) |
| 数量化III類と対応分析は別の手法 | 同じ計算。 呼び名が違うだけ |
深追いしなくてよいところ
逆に、手を動かして覚える価値が薄いと判断した部分も書いておきます。二重中心化の式の導出、正準相関を求める固有値問題の立て方、ウィルクスのラムダによる正準相関の検定手順、対応分析の行スコアと列スコアのスケーリングの流儀(対称正規化・非対称正規化の使い分け)、多重対応分析の固有値の補正。ここは試験で問われる形になりにくいので、深入りしませんでした。
9. 要点まとめ
| 項目 | 結論 |
|---|---|
| この章の正体 | 「その他」ではなく、2×2の地図の空きマスを埋める4手法 |
| 本当に新しい仕組み | 3つだけ(MDS・正準相関分析・対応分析)。数量化法は既習手法の別名 |
| 共通の枠組み | ほぼ全部が固有値分解か特異値分解。入力の作り方だけが違う |
| MDSの正式名称 | Multidimensional Scaling = 多次元尺度構成法。古典的MDSの別名は主座標分析(PCoA) |
| MDSと主成分分析 | 分散共分散行列による主成分分析と、同じ変数のユークリッド距離を使ったMDSは完全に同一(座標の差 5.33e-15、寄与率も76.8472%で一致) |
| MDSの固有値 | 主成分分析の固有値の 倍。共分散を で割っているからで、全軸が同じ倍率なので寄与率は一致 |
| MDSの立ち位置 | 「生データが無い場合の主成分分析」。さらに非ユークリッドな非類似度(ブレイ・カーティスなど)も受け取れる |
| MDSの軸 | 第1軸は分散最大(内部的な意味はある)。無いのは外的な意味で、回転・反転が自由(日本地図の「北が上」は後から合わせたもの) |
| 負の固有値 | どんな次元のユークリッド空間にも埋め込めないサイン(12個体のマンハッタン距離で4個・最小 −10.2704=第1固有値の5.7%)。距離の種類だけでは決まらず、大きさは第1固有値との比で見る |
| 非計量MDS | 距離の順序だけを使い、単調回帰で当てはめてストレスを反復計算で最小化する |
| 計量MDSとの関係 | 計量MDS ⊋ 古典的MDS(最小二乗MDSも計量MDSに含まれる) |
| 正準相関の入れ子 | 相関係数 ⊂ 重回帰 ⊂ 正準相関分析( と一致:0.81946950)。ただし正準相関分析に説明・被説明の向きは無い |
| 正準相関の組の個数 | 個(フルランクなら )。2組目以降は1組目と無相関(実測 ) |
| の大きさ | 個別の相関の絶対値の最大以上(0.7915 → 0.8481)。保証されるのは だけで、 以降は上回ることもある |
| 正準相関の検定 | ウィルクスのラムダ 。第25回の判別分析の検定と同じ統計量 |
| 数量化I類 | ダミー変数の重回帰()。当てはまりは決定係数 と重相関係数 で見る。カテゴリースコアは偏回帰係数と定数分だけずれる(レンジは同じ) |
| 数量化II類 | 判別分析。正準相関 0.88191710 = 。相関比 (群が必要な量なので、I類では定義できない) |
| 数量化IV類 | MDSと同じ問題設定・違う定式化( の最小化) |
| 対応分析の総イナーシャ | (128.8452 ÷ 375 = 0.343587)。 は表の度数の合計。マス(行の重み)で重み付けしたカイ2乗距離の和で、行から見ても列から見ても同じ |
| カイ2乗距離 | 行プロファイルのズレを と、列の割合 で割って測る |
| バイプロットの読み | 非対称正規化なら行と列の内積が「観測の割合 ÷ 期待の割合 」(ピアソン残差ではない) |
| 軸への分解 | 110.2593 + 15.6486 + 2.9373 = 128.8452 = 。軸の本数は最大 |
| ガットマン効果 | 順序構造+一峰性の反応があると弧(馬蹄形)になる。実質1次元のサイン。第2軸に別の解釈を与えない |
| 行と列の距離 | 直接比べてはいけない。 行と列は別の空間の座標。方向(角度)の一致として読む |
| 多重対応分析 | 質的変数が3つ以上のときの拡張。指示行列に対応分析をかける |
| 第30回への接続 | カイ2乗検定が「ズレがある」と言うだけのところを、対応分析が「どこが」に開く |
おわりに
今回いちばん収穫だったのは、地図を1枚描いたことでした。
私はこの連載を書きながら、多変量解析編の各手法を「1回ずつ理解した」つもりでいました。しかし2軸のマトリクスに並べようとした時点で、自分が手法どうしの位置関係をまったく把握していなかったことが分かりました。実際、最初に描いた図では軸として宣言した基準と、カードを置いた位置が食い違っていました。 「量的か質的か」を軸にしたつもりで、実際には教師ありかどうかで並べていた。図にして眺めるまで気づきませんでした。
そして「その他の多変量解析手法」という章が、地図の空きマスを埋める役だと分かってからは、暗記する対象が急に減りました。新しい仕組みは3つ、あとは名前の対応表1枚。 章のタイトルに引きずられて「4つの無関係な手法」と構えていたのが、いちばんの無駄でした。
もう1つ書き残しておきたいのは、MDSと主成分分析の関係です。別の手法だと思っていた2つが、条件を揃えると同じ計算だった。 違いは「何を入力に取れるか」だけでした。第27回でも主成分分析と因子分析が「同じ機械に何を渡すか」の違いだと分かりましたし、今回の正準相関と重回帰も入れ子でした。
ただしこの記事を書く過程でいちばん学んだのは、「同じです」と言うときには前提を書かないといけないということでした。MDSと主成分分析が一致するのは共分散行列を使う主成分分析と比べたときで、相関行列を使うなら距離の側も標準化してから測る必要があります。数量化IV類とMDSは目的が同じでも式は違います。マンハッタン距離で負の固有値が出るのはデータによります。どれも最初は「=」で書いてしまい、あとで自分で反例を作って気づいたものです。手法の対応関係を覚えるときこそ、等号の下に小さく条件を書き添える癖をつけないと危ないと感じました。
この編を通じて繰り返し出てきたのは、手法の数より少ない道具で全部が回っているという構造です。固有値分解という1つの機械があって、そこに何を渡すかで名前が変わる。地図を描いてよかったと思うのは、それが一望できたからです。
次回
次回からは発展編に入ります。最初は第27章の時系列解析です。
ここまでの多変量解析編では、データの行(個体)に順序がありませんでした。誰が1行目でも結果は同じです。時系列ではこれが崩れます。 行に時間の順序が入り、隣同士のデータが相関する。第16回以降の回帰分析が前提にしていた「誤差が互いに独立」という仮定が、真正面から壊れる世界です。
そこで第27回の偏相関が偏自己相関として再登場します。「他の時点の影響を除いた、 期前との関連」を測る道具として、自己回帰モデルの次数を決めるのに使われます。
そして第23回のランダムウォークが単位根過程という名前で戻ってきます。無関係な2つの系列を回帰すると有意な関係が出てしまう「見せかけの回帰」の原因がこれです。第27回のコラムで見た「相関があっても直接の関係とは限らない」という話が、時系列では共和分という形で問題になります。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。