クラスター分析:「正解がない」手法をどう信じるか【第26回】
はじめに
第24章はクラスター分析です。前回の判別分析と並べて「グループ分けの手法」として紹介されることが多い章です。
この章に入る前、私の理解はこうでした。「判別分析は正解ラベルがある場合、クラスター分析は正解ラベルがない場合。違いはそれだけ」。教科書の説明もだいたいそう書いてあります。
手を動かしてみて、この理解が入力の話としては正しいが、いちばん大事なことを取り落としているとわかりました。ラベルが無くなると失われるのは入力の1列ではなく、採点する能力そのものです。そしてそこから、この章のすべての落とし穴が派生していました。
いちばん驚いたのは標準化の実験です。年齢と年収でクラスター分析をして、距離への寄与を分解したら年収 99.9999999987%、年齢 0.0000000013%(約770億分の1)でした。それだけなら「まあそうだろう」で済む話ですが、確認のために「年収1変数だけ」でクラスタリングした結果と突き合わせたら、120人全員が完全に同じクラスターに入りました。 年齢という列は計算に渡されていたのに、結果に1人も影響していなかったのです。
さらに、年収を「円」で持つか「十万円」で持つか「億円」で持つかという記録上の都合だけで、結果の純度が 0.75 → 1.00 → 0.82 と動きました。
もうひとつ引っかかっていたのが「手法が多すぎて選べない」という問題です。最短距離法・最長距離法・群平均法・ウォード法・k-means。同じデータに5つ全部を適用してみたら、最短距離法が三日月データで純度1.00(唯一の勝者)なのに、橋渡しの点が7個混じっただけで0.47に転落しました。どの手法も全勝しませんでした。
そして「それだと正解がないことになる」という当然の疑問に、この記事では正面から答えます。結論を先に言うと、その通りで、正解はありません。 クラスター分析は仮説を作る道具であって、仮説を検証する道具ではない。この整理に辿り着いたのが今回のいちばんの収穫でした。
最後に、自分のブログで使えるかも検証しました。答えは「今のデータ量では使えない」で、しかもその理由が怖いものでした。構造がまったく無いデータでも、 が小さいと「綺麗に3つに分かれた」ように見えてしまいます。
いつものように、出てくる数値はすべて自分で計算し、複数の経路で検算しています。この章は scipy.cluster も scikit-learn も使わず、距離行列から階層的クラスタリングまで自分で実装しました(手続きが見えるようにするためです)。
この回で扱う用語
| 用語 | 読み・意味 |
|---|---|
| クラスター分析 | Cluster Analysis。データを似たもの同士のグループに分ける手法の総称 |
| クラスター | Cluster。分けた結果の1つ1つのグループ(「房」「かたまり」の意) |
| 教師なし学習 | Unsupervised Learning。正解ラベルを与えずにデータの構造を見つける枠組み |
| 教師あり学習 | Supervised Learning。正解ラベルを与えて予測ルールを学ばせる枠組み。判別分析や回帰がこちら |
| 階層的クラスタリング | Hierarchical Clustering。近いものから順に融合していき、木構造を作る方法 |
| デンドログラム | Dendrogram。階層的クラスタリングの結果を表す樹形図(dendro=樹) |
| 連結法 | Linkage Method。クラスター間の距離をどう定義するかの規則 |
| 非階層的クラスタリング | Non-hierarchical Clustering。木を作らず、指定した数に直接分ける方法。k-means がこちら |
| Within-cluster Sum of Squares=クラスター内平方和。各点と自分のクラスターの重心との距離の2乗の合計 | |
| Error Sum of Squares=誤差平方和。この章では WSS と同じものを指す | |
| 重心 | Centroid。クラスターに属する点の平均。「中心」 |
| 鎖効果 | Chaining Effect。最短距離法で、点が数珠つなぎになって細長いクラスターができる現象 |
| シルエット係数 | Silhouette Coefficient。各点が「正しいクラスターにいるか」を から で測る指標 |
| 純度 | Purity。この記事で手法の性能を比べるために使う指標。各クラスターで最も多い真ラベルの割合 |
純度について先に注意書きをしておきます。 これは説明のために私がこの記事で使う簡易的な指標で、標準的な指標ではありません。 純度には「クラスター数を増やすほど上がる」という欠点があり( にすれば必ず 1.00 になる)、この記事ではクラスター数を真の値に固定して手法だけを比べる用途に限って使っています。
2つの分割の一致度を測る標準的な指標はランド指数とその偶然一致を補正した調整ランド指数(ARI: Adjusted Rand Index)です。実務でクラスタリング結果を比べるならこちらを使ってください。
WSS と ESS のように同じものを指す略語が2つあるのは混乱の元なので、この記事では原則 WSS で通します(ウォード法の文脈だけ、慣習に合わせて と書きます)。
1. 何に使うのか:かたまりを「見つける」
前回の判別分析はこういう場面で使いました。「優良顧客と離脱顧客のデータがある。両者を分ける境界を引いて、新しい顧客がどちらかを判定したい」。
今回は違います。そもそもどんな層があるのか分かっていない場面です。
- ブログに来る読者を分類したいが、どんなタイプがいるのか自分でも言えない
- 商品の購買データがある。似た買い方をする客をまとめて、それぞれに違う施策を打ちたい
- 遺伝子の発現データから、似た振る舞いをする遺伝子群を見つけたい
共通しているのは、答えを知らないまま「グループがあるとしたらどう分かれるか」を探していることです。だから最初にやることは決まっています。似ているものを近くに、似ていないものを遠くに置いて、近いもの同士を集める。
ここで「似ている」を数値にする必要が出てきます。それが距離です。この章は結局のところ、
- 距離をどう定義するか
- 近いものをどうまとめていくか
- いくつのグループに分けるか
の3つを決める話に尽きます。手法の名前がたくさん出てきますが、すべて2番目の「まとめ方」のバリエーションです。
2. 判別分析との違いは「正解ラベルの有無」だけか
これが今回いちばん確かめたかったことです。入力の違いとしては、それで合っています。 ただし「だけ」ではありません。
まず同じデータで両方をやってみます。80人の顧客データで、優良顧客40人と離脱顧客40人がきれいに分かれている場合です。
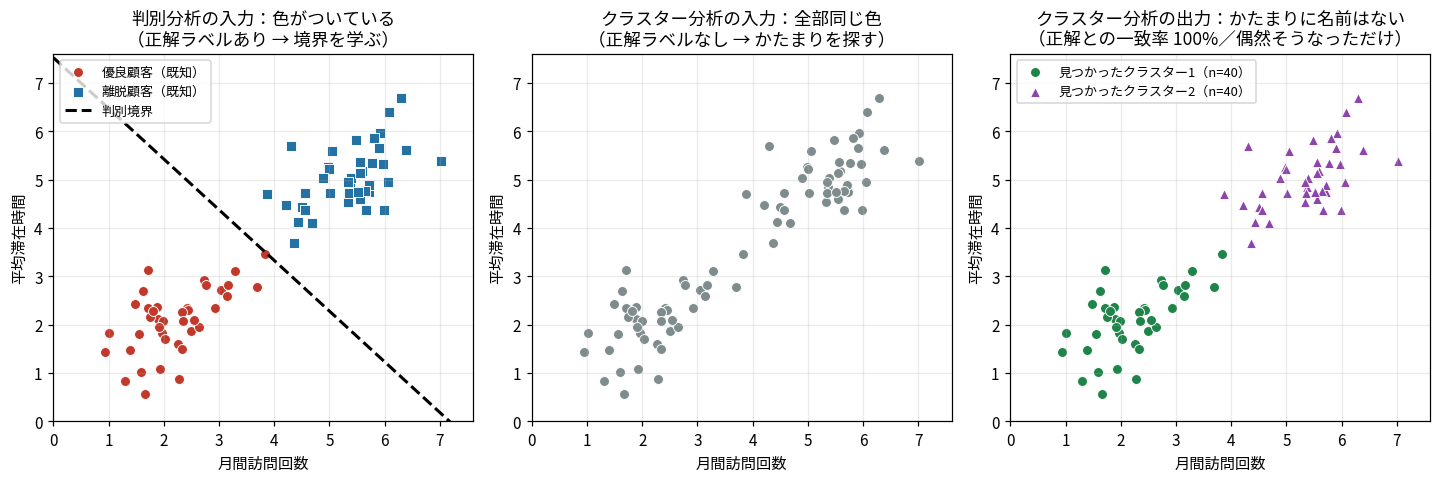
左が判別分析の入力です。色がついていて、その色を分ける境界(破線)を引くのが仕事です。中央がクラスター分析の入力で、同じ点なのに色の情報が抜けています。 右がクラスター分析の出力です。
この例では正解と100%一致しました。ただしこれは2群がきれいに離れていたから偶然そうなっただけです。そして出てきたかたまりに「優良顧客」という名前は付いていません。番号が振られているだけで、意味は人間が後から与えます。
決定的な違いは「採点できるか」
表にすると、下2行が本質です。
| 判別分析(第25回) | クラスター分析(今回) | |
|---|---|---|
| 入力 | データ+正解ラベル | データのみ |
| 仕事 | 既知のグループを分ける境界を引く | グループそのものを作る |
| 出力 | 判別関数(新しい人を分類できる) | 各点への番号(意味は人間が付ける) |
| 正しさの測り方 | 誤判別率で測れる | 測る相手がいない |
| 答える問い | 「この人はA群かB群か」 | 「そもそも何群あるのか」 |
判別分析には答案があるので採点できます。交差確認法で誤判別率を出し、手法Aと手法Bを比べて良い方を選べます。
クラスター分析には答案がありません。 だから「この分け方が正しい」と統計的に決めることが原理的にできません。この一点から、以降に出てくる落とし穴のほとんどが導かれます。
ラベルが無いと何が失われるか
「ラベルの有無だけ」という理解が危ういことを示す例を作りました。真のグループは左右に分かれているのに、データ全体が上下方向に大きく散らばっているデータです。
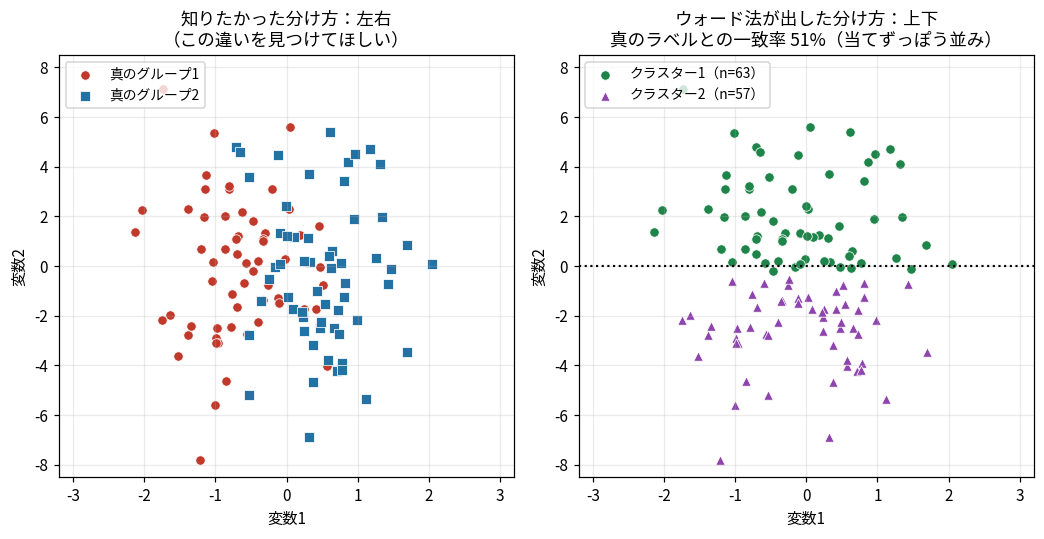
左が真の構造で、左右に2群あります。ウォード法をかけた結果が右で、上下に切られました。 真のラベルとの一致率は 50.8%。コイン投げと変わりません。
ここで重要なのは、同じデータにラベルを与えて判別分析をすると正答率 85.0% で当てられることです。つまり左右を分ける情報はデータの中に確かにあるのに、クラスター分析はそれを取り出せませんでした。
なぜかというと、クラスター分析は距離が近いものを集めるだけだからです。このデータでは上下方向の散らばりの方が大きいので、距離的に目立つのは上下の違いです。左右の違い(グループの中心が 1.1 しか離れていない)は、上下の散らばり(標準偏差 3.0)に埋もれます。
ここが試験と実務の両方で問われる勘所です。 クラスター分析は「隠れた正解を発掘する装置」ではありません。与えた距離のものさしで見て目立つ構造を返すだけの装置です。 だから 正解ラベルが無い → 採点できない → 結果は距離の定義と手法に依存する という連鎖が起きます。
この連鎖を意識しながら、以下で距離と手法を見ていきます。
3. 距離の定義:「同じ距離になる点」を描くと性格が見える
「近いものを集める」手法なので、近いの定義を変えれば結果が変わります。 4種類の距離を、式ではなく「原点から等距離にある点の集合」の形で見てみます。この集合の形が、そのものさしの性格そのものです。
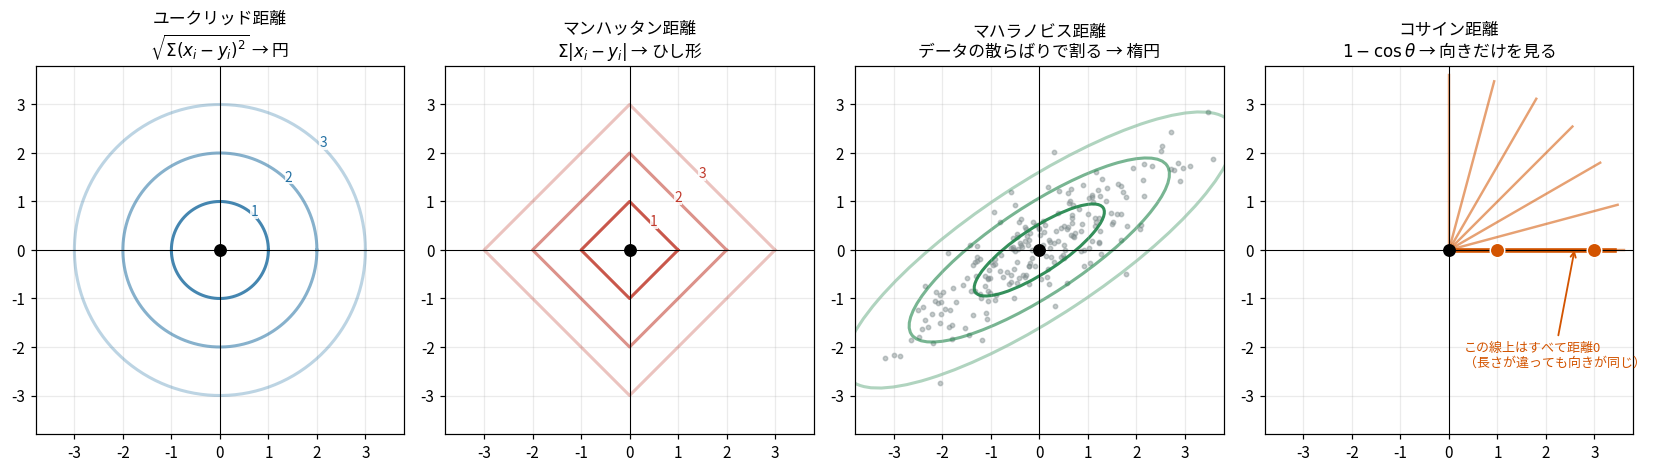
- ユークリッド距離は円になります。全方向を平等に扱う、いちばん素直なものさしです
- マンハッタン距離はひし形です。碁盤の目を歩く距離なので、斜め方向が相対的に遠くなります
- マハラノビス距離はデータの散らばりに沿った楕円です。散らばりが大きい方向は割り引かれます
- コサイン距離は原点から出る半直線の上がすべて距離 0 になります。長さを完全に無視し、向きだけを見ます
式も並べておきます。 を2つの点( 次元のベクトル)とします。
は共分散行列です。マハラノビス距離で が単位行列なら、ユークリッド距離に一致します。
コサイン距離の値域には注意が必要です。 が から なので、距離は から をとります(真逆を向いていれば )。ただし閲覧回数や出現頻度のように成分がすべて非負のデータでは なので、実質的に から の範囲に収まります。
同じ2点でも値は変わる
点 と点 で4通り計算しました。
| 距離 | 値 | 由来 |
|---|---|---|
| ユークリッド | 5.0000 | 。3-4-5 の直角三角形の斜辺 |
| マンハッタン | 7.0000 | |
| マハラノビス | 1.4142 | 方向の標準偏差 3・ 方向 4 で割ると 相当なので |
| コサイン | 1.0000 | 直交しているので 、距離は |
ここでマハラノビス距離だけ「データがないと計算できない」ことに注目してください。他の3つは2点だけで決まりますが、マハラノビス距離は共分散行列=周りのデータの散らばりを必要とします。第25回で出てきた通りです。
これは後で重要になります。マハラノビス距離は実質的に「標準化を距離の定義に組み込んだもの」だからです。
使い分けの目安
| 距離 | 向いている場面 | 注意点 |
|---|---|---|
| ユークリッド | 既定の選択。変数が同じ単位か標準化済みのとき | 単位に弱い(後述) |
| マンハッタン | 外れ値の影響を抑えたいとき(2乗しないため) | 座標軸の取り方に依存する |
| マハラノビス | 変数間に強い相関があるとき | 共分散行列の推定が必要。変数の数に対しデータが少ないと不安定 |
| コサイン | 大きさを無視したいとき。 文章のベクトル、閲覧傾向 | 大きさの情報が完全に消える |
コサイン距離の使いどころが直感的に分かりにくいので補足します。ブログの読者分析で「Aさんは月100PV、Bさんは月10PV、ただし2人ともお金カテゴリを7割・技術カテゴリを3割読む」という場合、ユークリッド距離では活動量の差で遠くなりますが、コサイン距離では距離ゼロになります。「熱心さは問わず、興味の傾向だけで分けたい」ならコサインです。
4. 階層的クラスタリング:点の距離からクラスターの距離へ
距離が決まったら、次は「近いものをまとめる」段階です。階層的クラスタリングの手続きは単純です。
- 最初は全員が1人1クラスター( 個のクラスター)
- いちばん近い2つのクラスターを融合する
- 1つになるまで 2 を繰り返す( 回で終わる)
問題は 2 の「いちばん近い2つ」です。点と点の距離は定義しましたが、クラスターとクラスターの距離はまだ定義していません。3人のクラスターと5人のクラスターの距離とは何でしょうか。
ここに複数の答えがあり、それが手法の名前になっています。
| 手法 | クラスター間距離の定義 |
|---|---|
| 最短距離法(単連結法・最近隣法) | 2群の最も近い1組の距離 |
| 最長距離法(完全連結法・最遠隣法) | 2群の最も遠い1組の距離 |
| 群平均法 | 全ペアの距離の平均 |
| 重心法 | 2群の重心間の距離 |
| ウォード法 | 融合によって増えるクラスター内平方和 |
上4つは「距離」なので直感的です。ウォード法だけ毛色が違い、これが後で重要になります。
5つの手法は「係数の違い」しかない
実装するときに気づいたことですが、この5手法はLance-Williams の漸化式という共通の形にまとめられます。クラスター と を融合したとき、残った との距離を次で更新します。
手法ごとに変わるのは係数 だけです。
| 手法 | ||||
|---|---|---|---|---|
| 最短距離法 | ||||
| 最長距離法 | ||||
| 群平均法 | ||||
| 重心法 | ||||
| ウォード法 |
最短距離法と最長距離法が の符号だけの違いであることが見えます。、 という恒等式そのものです。
試験でこの表を暗記する必要はありません。ただし「手法の違いはクラスター間距離の定義の違いだけ」という構造を掴んでおくと、手法名を見たときに性格が推測できます。
なお重心法とウォード法は平方ユークリッド距離を入力にする約束です(式が平方距離の分解に基づいているため)。実装のときここを間違えると結果が狂います。
「距離を二乗して渡すかどうか」がどれだけ効くかは手法によって違うので、整理しておきます。
| 手法 | 距離を二乗して渡すと |
|---|---|
| 最短距離法・最長距離法 | 融合順序は変わらない( と は単調変換で不変なので) |
| 群平均法 | 変わる。 10点の乱数300セットで 21% が不一致だった(平均は単調変換で保たれない) |
| 重心法・ウォード法 | 平方距離を渡すのが正しい定義。 素の距離を渡すと別の手法になる |
つまり二乗するかを気にしなくてよいのは最短距離法と最長距離法だけです。
5. デンドログラムとは何か
前節の融合の履歴を図にしたものがデンドログラム(樹形図)です。語源はギリシャ語の dendro(樹)+ gram(図)。
作り方は単純で、融合するたびに、その2つを横棒でつなぐだけです。横棒を引く高さが、その融合のコストになります。
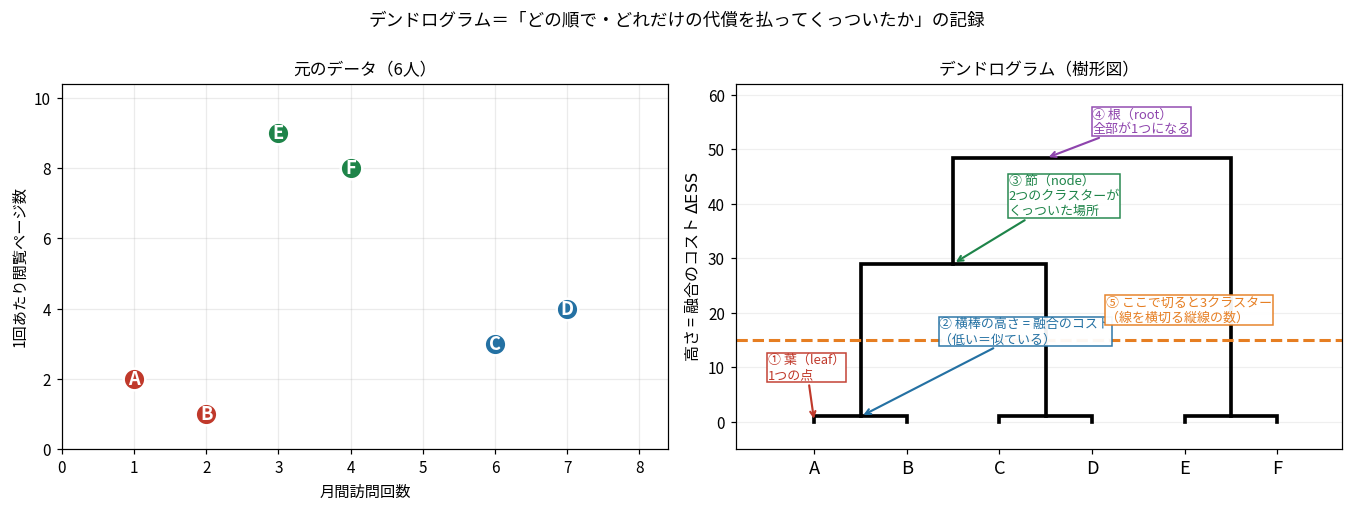
読み方は5つの部品を押さえれば足ります。
| 部品 | 何か |
|---|---|
| 葉(leaf) | いちばん下の1本1本。1つのデータ点 |
| 横棒の高さ | その融合のコスト。低い=似ている(安く融合できた) |
| 節(node) | 横棒と縦線が出会う点。2つのクラスターがくっついた場所 |
| 根(root) | いちばん上。全部が1つのクラスターになる |
| 切断線 | 横に線を引くと、線を横切る縦線の本数がクラスター数 |
上の図では A-B、C-D、E-F が高さ 1.0 で安くくっついたあと、次の融合がいきなり 29.0 に跳ねています。この段差が「3つのかたまりがある」というサインです。
デンドログラムの最大の利点は「 を先に決めなくてよい」ことです。 1回計算すれば、 でも でもその場で読み取れます。k-means は を変えるたびに計算し直しですが、デンドログラムは切る高さを変えるだけです。 逆に欠点は が大きいと葉が潰れて読めなくなること( なら横軸に1000本の縦線が並びます)。
⚠️ 1つ注意すべきことがあります。横軸の順序に意味はありません。 デンドログラムは枝を左右に入れ替えても同じ木を表します(節のところで回転させられる)。だから「A と F が横軸で離れているから遠い」とは読めません。2点の近さは「どの高さで初めて同じ枝に入るか」で読みます。 この高さをコーフェネティック距離と呼び、後で手法の比較にも使います。
縦軸は何を表しているのか
私がずっと分からなかったのが縦軸です。「高さ」と書いてあるが、何の高さなのか。
答え:そこで2つをくっつけたときに払う代償の大きさです。 そして代償の測り方が手法ごとに違うので、「縦軸は何か」の答えは使った手法によって変わります。
| 手法 | 縦軸(高さ)の意味 |
|---|---|
| 最短距離法 | 2つのクラスターのいちばん近い点同士の距離 |
| 最長距離法 | 2つのクラスターのいちばん遠い点同士の距離 |
| 群平均法 | クラスター間の全ペアの距離の平均 |
| ウォード法 | 融合によって増えるクラスター内平方和(=失う情報量) |
ここがすっきりしなかったので、ウォード法について で全ステップを手で追いました。
使うデータ(6人の読者)
| A | B | C | D | E | F | |
|---|---|---|---|---|---|---|
| 月間訪問回数 | 1 | 2 | 6 | 7 | 3 | 4 |
| 1回あたり閲覧ページ数 | 2 | 1 | 3 | 4 | 9 | 8 |
見ての通り「ライト層 (A,B)・中間層 (C,D)・回遊層 (E,F)」の3つのかたまりです。
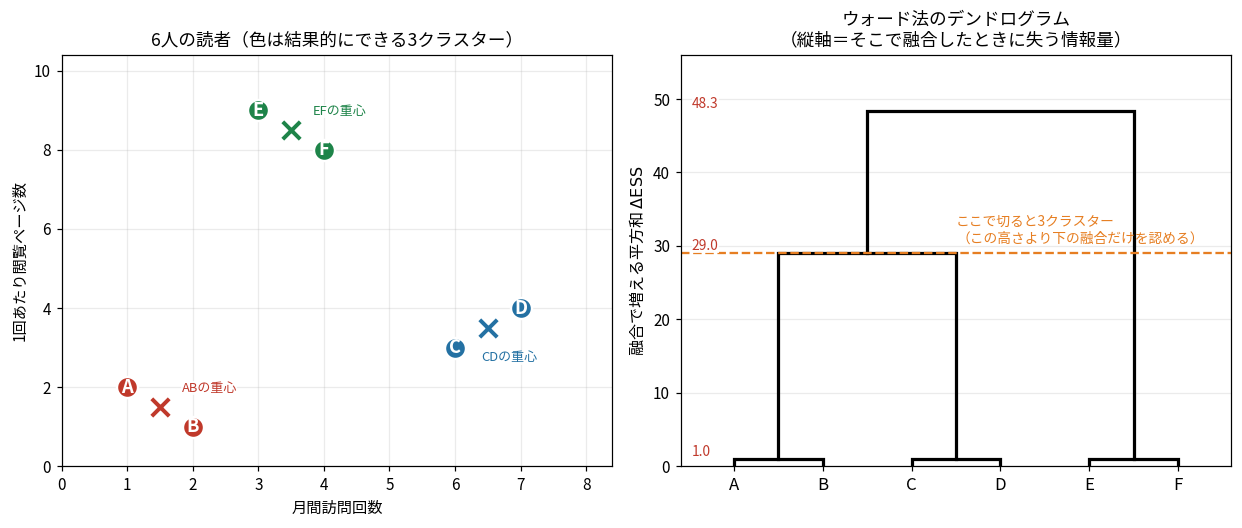
右のデンドログラムで、高さが 1.0 → 29.0 → 48.3 と飛んでいることに注目してください。最初の3回の融合は代償 1.0 で済むのに、4回目は一気に 29.0 かかります。この段差がクラスター数の手がかりになります。
ウォード法の縦軸を定義から確かめる
ウォード法の縦軸は WSS(クラスター内平方和)の増加分です。WSS とは「各クラスターの中で、点が重心からどれだけ散らばっているか」を平方和で測ったものです。
第16回の残差平方和と同じ発想で、「重心1点で代表させたときに説明しきれない量」です。1人1クラスターなら重心は自分自身なので WSS はゼロ。全員1クラスターなら全体の平方和になります。
融合するたびに WSS は必ず増えます(クラスターが粗くなるので代表しきれない量が増える)。ウォード法はその増加が最小になるペアを選ぶ手法です。
これを3つの独立な経路で計算して、全部一致することを確認しました。
| 経路 | やり方 |
|---|---|
| A(定義) | 融合後の分け方について WSS を定義通り計算し直し、融合前との差を取る |
| B(公式) | に代入する |
| C(漸化式) | Lance-Williams の更新式で距離行列を逐次更新する |
ステップ0:平方ユークリッド距離を並べる
| A | B | C | D | E | F | |
|---|---|---|---|---|---|---|
| A | — | 2 | 26 | 40 | 53 | 45 |
| B | 2 | — | 20 | 34 | 65 | 53 |
| C | 26 | 20 | — | 2 | 45 | 29 |
| D | 40 | 34 | 2 | — | 41 | 25 |
| E | 53 | 65 | 45 | 41 | — | 2 |
| F | 45 | 53 | 29 | 25 | 2 | — |
1点と1点を融合するときは なので、公式は
つまり上の表を2で割るだけが融合コストです。最小は A-B, C-D, E-F がすべて で同点になります。
ステップ1〜5:全ステップの融合コスト
| step | 融合したもの | 融合後の WSS | その時点の分け方 | 次点の候補 | |
|---|---|---|---|---|---|
| 1 | A + B | 1.0000 | 1.0000 | AB | C | D | E | F | C+D も E+F も同じ 1.0 |
| 2 | C + D | 1.0000 | 2.0000 | AB | CD | E | F | E+F が同じ 1.0 |
| 3 | E + F | 1.0000 | 3.0000 | AB | CD | EF | F+CD が 17.67 |
| 4 | AB + CD | 29.0000 | 32.0000 | ABCD | EF | CD+EF が 34.0 |
| 5 | EF + ABCD | 48.3333 | 80.3333 | ABCDEF | — |
経路A(定義通りの再計算)と経路B(公式)は、すべてのステップ・すべての候補ペアで一致しました。
各ステップで実際に何を比べているのか
上の表は「選ばれたペア」だけを並べたものですが、各ステップでは全候補についてコストを計算し、いちばん小さいものを1つ選んでいます。 その候補を見ると、コストが「重心間の平方距離 × サイズの係数」に分解できることがはっきりします(以下はコストの小さい順に上位数件)。
ステップ1(A|B|C|D|E|F)
| 候補 | サイズ | 重心間の平方距離 | 係数 | コスト |
|---|---|---|---|---|
| A+B | 1×1 | 2.0000 | 0.5000 | 1.0000 ← 採用 |
| C+D | 1×1 | 2.0000 | 0.5000 | 1.0000(同点) |
| E+F | 1×1 | 2.0000 | 0.5000 | 1.0000(同点) |
| B+C | 1×1 | 20.0000 | 0.5000 | 10.0000 |
| D+F | 1×1 | 25.0000 | 0.5000 | 12.5000 |
この段階は全部が1点なので係数はすべて 0.5 で同じ。つまり単純に近いペアが選ばれます。
ステップ3(E|F|AB|CD)— 係数が結果を左右し始めます(ステップ2はステップ1と同じ結論なので省きます)
| 候補 | サイズ | 重心間の平方距離 | 係数 | コスト |
|---|---|---|---|---|
| E+F | 1×1 | 2.0000 | 0.5000 | 1.0000 ← 採用 |
| F+CD | 1×2 | 26.5000 | 0.6667 | 17.6667 |
| E+CD | 1×2 | 42.5000 | 0.6667 | 28.3333 |
| AB+CD | 2×2 | 29.0000 | 1.0000 | 29.0000 |
AB+CD と E+CD を比べてください。 重心間の平方距離は AB+CD の方が近い(29.0 < 42.5)のに、コストはほぼ同じ(29.0 vs 28.3)になっています。AB+CD は 2個×2個 なので係数が 1.0 と大きく、その分だけ割高になったからです。
ステップ4(AB|CD|EF)
| 候補 | サイズ | 重心間の平方距離 | 係数 | コスト |
|---|---|---|---|---|
| AB+CD | 2×2 | 29.0000 | 1.0000 | 29.0000 ← 採用 |
| CD+EF | 2×2 | 34.0000 | 1.0000 | 34.0000 |
| AB+EF | 2×2 | 53.0000 | 1.0000 | 53.0000 |
ここは全部 2×2 なので係数が同じで、また単純に近い順になります。なお AB+CD (29.0) と CD+EF (34.0) の差はわずか 5.0 で、ここが「一度くっつけたら離せない」貪欲法の分岐点です。もし別のデータで大小が逆転すれば、以降の木の形が変わります。
ステップ4を手で検算する
いちばん大事なステップ4(AB と CD の融合、)を公式で追います。
- AB の重心:
- CD の重心:
- 重心間の平方距離:
- 係数:
- よって ✓
この係数 がウォード法の性格を決めています。 重心間の距離が同じでも、サイズが大きいクラスター同士の融合ほど係数が大きくなります。
| 係数 | ||
|---|---|---|
| 1 | 1 | 0.5 |
| 2 | 2 | 1.0 |
| 5 | 5 | 2.5 |
| 10 | 10 | 5.0 |
| 1 | 20 | 0.95 |
いちばん下の行が示唆的です。1個の孤立点を20個の大クラスターにくっつけるコスト(0.95)は、5個と5個をくっつけるコスト(2.5)より安い。 だから小さいものは早めに吸収され、大きいもの同士の合体は渋られます。結果としてサイズが揃いやすくなります。
いちばんきれいな性質:高さの総和=全体の平方和
3経路の突き合わせ結果です。
| step | (定義) | (公式) | scipy 流の高さ | 高さ | 一致 |
|---|---|---|---|---|---|
| 1 | 1.0000 | 1.0000 | 1.4142 | 1.0000 | ○ |
| 2 | 1.0000 | 1.0000 | 1.4142 | 1.0000 | ○ |
| 3 | 1.0000 | 1.0000 | 1.4142 | 1.0000 | ○ |
| 4 | 29.0000 | 29.0000 | 7.6158 | 29.0000 | ○ |
| 5 | 48.3333 | 48.3333 | 9.8319 | 48.3333 | ○ |
| 合計 | 80.3333 | 80.3333 | — | 80.3333 | ○ |
合計 80.3333 は、6人全員を1つのクラスターとしたときの平方和とぴったり一致します。
つまりデンドログラムは「全体のばらつき 80.33 を、どの順番でどれだけずつ諦めていくかの記録」として読めます。
ただしこれはウォード法固有の性質ではありません。 は WSS の増分なので、どんな順番で融合しても総和は
になります(途中の項が打ち消し合う、いわゆる望遠鏡和です)。実際に融合順序をでたらめにしても総和は 80.3333 になることを確認しました。
ウォード法に固有なのは、この総額 80.33 の支払いをできるだけ後半に回すことです。各段階でいちばん安い融合を選ぶので、序盤は 1.0 ずつしか払わず、終盤に 29.0・48.3 とまとめて払う形になります。この「支払いが後ろに寄る」ことが、デンドログラムの下部が平らで上部に大きな段差ができる理由です。
なお第20回の分散分析で平方和を群間と群内に分解しましたが、あれと同じ量を扱っています。ウォード法は平方和の分解を階層的に繰り返しているわけです。
⚠️ 縦軸の目盛りには流儀が3つある
上の表に「scipy 流の高さ」という列があったことに気づいたでしょうか。ソフトによって縦軸の目盛りが違います。 教科書と手元の出力が合わなくて悩む定番の場所です。
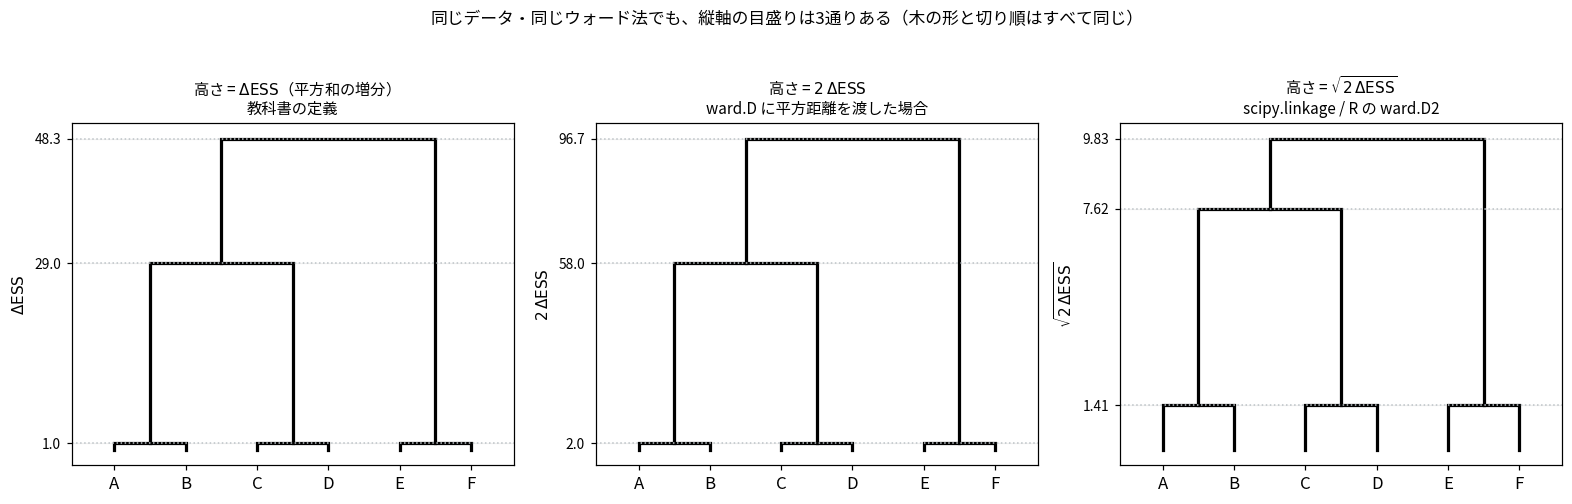
| 目盛り | この例の高さ | どこで見るか |
|---|---|---|
| 1.0 / 29.0 / 48.3 | 教科書の定義。「平方和の増分」と書かれていたらこれ | |
| 2.0 / 58.0 / 96.7 | R の hclust(method="ward.D") に平方距離を渡した場合 | |
| 1.41 / 7.62 / 9.83 | Python の scipy.linkage、R の ward.D2。距離の次元に戻してある |
これら3つの間では木の形(どの順でくっつくか、どこで切ると何個になるか)は完全に同じです。 同じ を単調変換しているだけなので大小関係が変わらないためです。
⚠️ ただし ward.D には注意が必要です。この関数は渡された値にウォード法の係数をそのまま適用するだけなので、上の が得られるのは dist(X)^2 を渡した場合に限ります。素の dist(X) を渡すと(こちらの方が自然な書き方に見えるので危険です)高さは何の量でもなくなり、融合順序そのものが変わります。 8〜10点の乱数データ300セットで確認したところ、42% で融合順序が一致しませんでした。 ウォード法をやりたいなら ward.D2 を使うのが安全です(ward.D は歴史的な実装として残されているものです)。
試験対策としては「高さ=融合のコスト(大きいほど無理な融合)」と読めれば十分でしょう。ただし絶対値そのものに意味はなく、比較可能なのは同じデンドログラム内の高さの大小だけという点は押さえておくべきです。異なるデータで作ったデンドログラムの高さを比べても意味がありません。
どこで切るとクラスター数が決まるか
デンドログラムの読み方は「横線を引き、その線より下で起きた融合だけを認める」です。線を横切る縦線の本数がクラスター数になります。
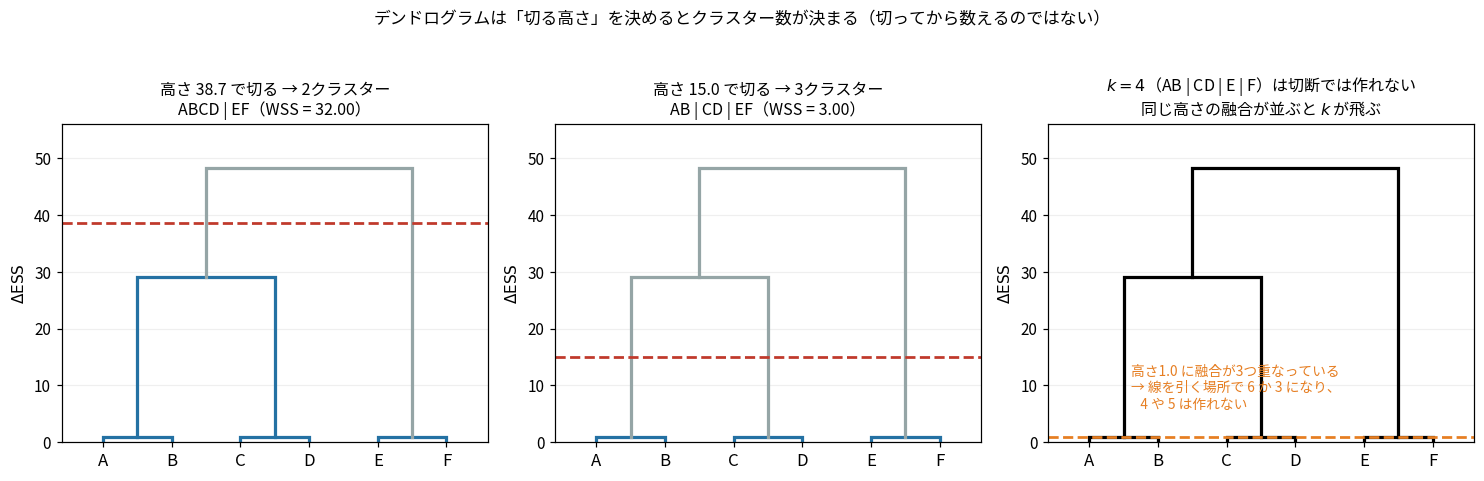
3枚目が落とし穴です。この例では高さ 1.0 に融合が3つ重なっているため、切断では や を作れません。線を少し動かすと6個から一気に3個に飛びます。
実データで完全に同じ高さになることは稀ですが、「切断で任意の が作れるわけではない」ことは知っておくと安全です。 を指定して切る関数(fcluster など)は、切断線ではなく融合を上から 回だけ実行しないという実装になっているので、こちらは任意の が作れます。
6. ウォード法がよく使われる理由
「ウォード法が実務の既定値」とよく書かれていますが、何が優れているのか気になっていました。3つありました。
理由1:最小化している量が明確
最短距離法の「いちばん近い点同士の距離」は手続きの説明であって、「全体として何が良くなるのか」を言っていません。
一方ウォード法は各段階で WSS の増加を最小にするという目的をはっきり持っています。しかもこれは k-means が最小化する量と同一です。
ただし測るタイミングが違います。 ここを押さえると2つの性格の差が見えます。
| 測るもの | いつ測るか | |
|---|---|---|
| k-means | 各点 → 自分の中心への平方距離 | 現在の状態を評価する(この分け方は何点か) |
| ウォード法 | 2つのクラスターの重心間の平方距離 | くっつけた後の変化を予測する(くっつけたら何点悪くなるか) |
同じ WSS を見ていますが、k-means は「いまの点数」、ウォード法は「この手を打ったときの失点」を計算しています。そしてウォード法の方には というサイズの係数が掛かるのが決定的な違いで、これが理由2につながります。
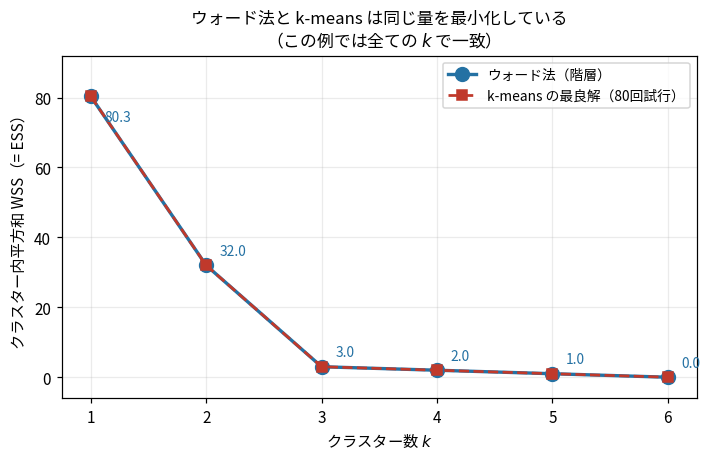
この例ではすべての で完全に一致しました。ウォード法は階層的、k-means は非階層的で見た目は別手法ですが、目指している山は同じです。
ただし正確に言うと、ウォード法は貪欲法(各段階で目先の最善を選ぶ)なので、一般には k-means の最適解に一致する保証はありません。上の例が一致したのは、小さくきれいなデータだったからです。実務ではウォード法の結果を k-means の初期値に使うという併用がよく行われます。
理由2:サイズの揃ったコンパクトなクラスターができる
先に見た係数 が効きます。重心間の平方距離を 100 に固定して、サイズだけ変えるとこうなります。
| 係数 | コスト | 解釈 | ||
|---|---|---|---|---|
| 1 | 1 | 0.50 | 50 | 点と点 |
| 1 | 20 | 0.95 | 95 | 孤立点を大集団に吸収:安い |
| 2 | 2 | 1.00 | 100 | |
| 5 | 5 | 2.50 | 250 | 中規模同士:孤立点の吸収(95)より2.6倍高い |
| 10 | 10 | 5.00 | 500 | |
| 20 | 20 | 10.00 | 1,000 | 大集団同士:非常に高い |
「1個と20個」(95) が「5個と5個」(250) より安いのが要点です。距離が同じなら、ウォード法は小さいものを大きいものに吸収する方を選びます。
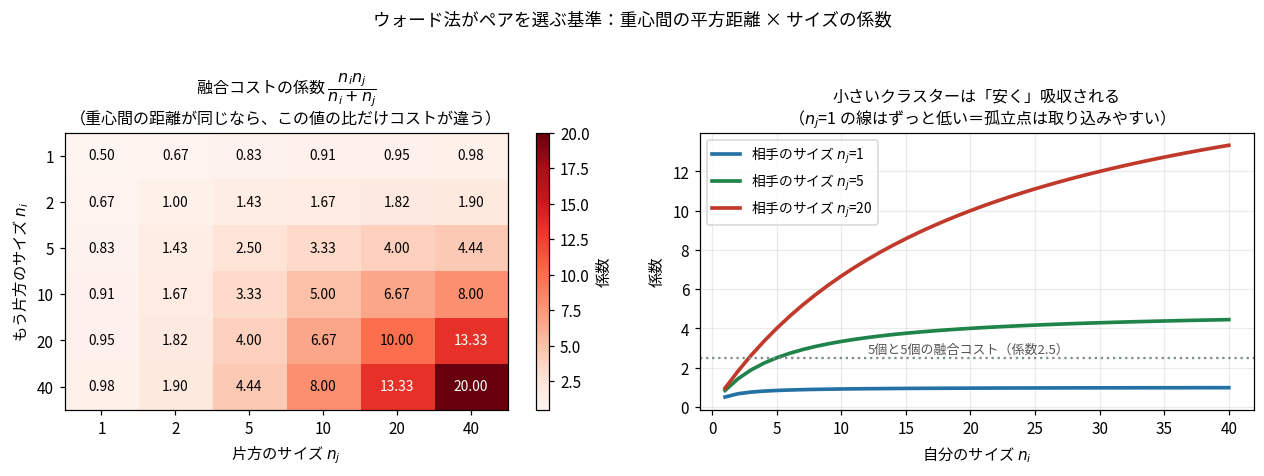
結果として、ぽつんと1つだけ残る点は早めに吸収され、大きなクラスター同士は最後まで合体しないという動きになります。「1つの巨大クラスターと多数の孤立点」という使いにくい結果になりにくいわけです。
どれくらい揃うのか実測した
「揃いやすい」と書きましたが、程度が気になったので測りました。構造がまったく無いデータ(一様分布・)を に分けます。真の構造がないので、手法の「好み」がそのまま出ます。完全に均等なら 30/30/30/30 です。
| 手法 | 平均サイズ(大→小) | 最大÷最小 | 最小が5未満だった割合 |
|---|---|---|---|
| 最短距離法 | 104 / 11 / 3 / 1 | 108.0 | 99.5% |
| 最長距離法 | 44 / 33 / 25 / 18 | 2.4 | 0.0% |
| 群平均法 | 45 / 33 / 25 / 17 | 2.7 | 2.0% |
| ウォード法 | 43 / 32 / 26 / 19 | 2.2 | 0.0% |
| k-means | 37 / 32 / 28 / 24 | 1.5 | 0.0% |
(200回試行。サイズは平均、比は各試行の比の中央値)
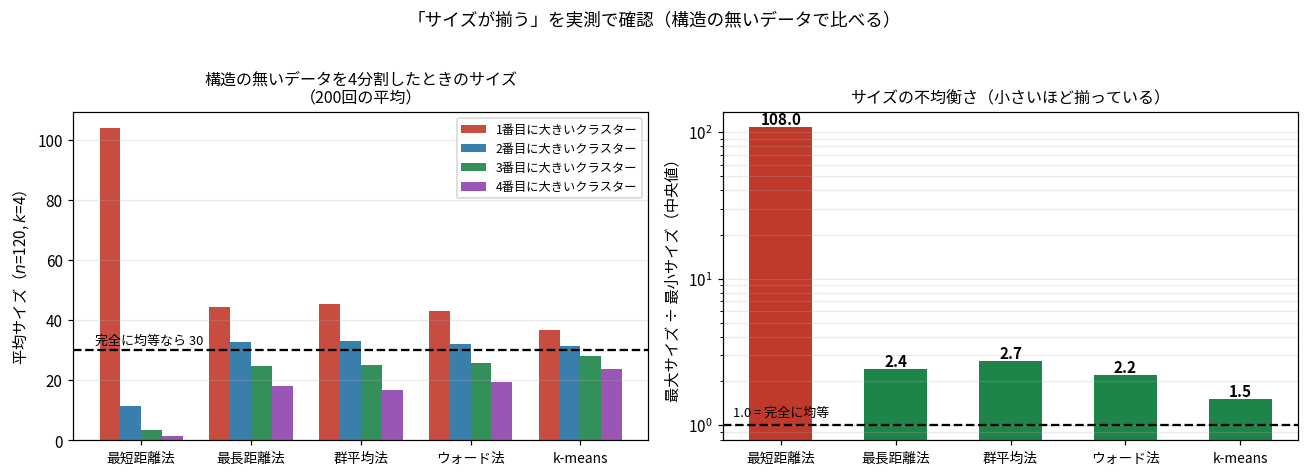
読み取れることが3つあります。
- 最短距離法は 99.5% の試行で「5個未満のクラスター」を作りました。 実質的に使えない分割です(鎖効果でほぼ全部が1つにつながり、外れ値だけが分離する)
- ウォード法(2.2倍)は最長距離法(2.4倍)や群平均法(2.7倍)より揃っていますが、劇的な差ではありません
- いちばん揃うのは k-means(1.5倍)でした。 これは予想外でした。ウォード法は貪欲に融合するので序盤の偏りが残りますが、k-means は点を何度でも移動できるためです。実際、ウォード法の結果を初期値にして k-means を回すだけで比が 2.20 → 1.55 に下がり、k-means 単独(1.51)とほぼ同じになります(構造がないデータでは均等な分割の方が WSS が小さいので、移動できる手法はそちらへ流れます)。ちなみにこの200回の試行では、ウォード法の WSS が k-means の最良解より大きかった割合が100%でした。つまりウォード法の解は k-means の局所最適にすら達しておらず、「1手ずつ最善を選ぶ」ことの限界がはっきり出ています
⚠️ 「サイズが揃う」は構造が無いときの傾向です。強制ではありません。 100人・10人・10人の3群(極端な不均衡)を作ってウォード法にかけたら、結果は 100 / 10 / 10 で純度 1.0000 でした。40/40/40 に無理やり均等化はしません。 つまり「揃いやすい」は迷ったときに均等側を選ぶ好みであって、はっきりした不均衡があればそれに従います。ここを「常に均等になる」と誤解すると、実データで不均衡な結果が出たときに「手法を間違えたのか」と悩むことになります。
実務で「だいたい同じ規模のセグメントに分けたい」というニーズには合います。読者を分けたときに「9割が1つのセグメント」では施策に使えません。
理由3:高さの逆転が起きない
重心法には、後の融合の高さが前より低くなる「逆転」が起きることがあります。デンドログラムが変な形になり、読めなくなります。実際に乱数データで逆転例を検出できました(8点・2変数、seed=9)。
最短距離法・最長距離法・群平均法・ウォード法では逆転が起きません(単調性が保証されます)。
ただし「万能だから常用されている」わけではありません。ウォード法は球状で同程度のサイズのクラスターを前提にした手法なので、細長い形や鎖状のクラスターは苦手です。次の節で実演します。 「よく使われる」は「安全な既定値」という意味であって「常に正しい」ではありません。
7. 手法の対比表と、結果が変わる問題
ここが今回いちばん知りたかったところです。まず一覧表を置きます。
| 手法 | クラスター間距離 | できやすいクラスター | 弱点 |
|---|---|---|---|
| 最短距離法 (単連結法) | 2群の最も近い1組 | 細長い・鎖状・曲がった形。 非球状の構造を追える | 鎖効果。 橋渡しの点があると全部つながり「巨大な1個+孤立点」になる |
| 最長距離法 (完全連結法) | 2群の最も遠い1組 | 直径の小さい密な球状。 サイズは揃いやすい | 大きく広がったクラスターを割る。 外れ値1個に距離が引っ張られる |
| 群平均法 | 全ペアの平均 | 最短と最長の中間。 バランス型 | 特徴が薄い。外れ値には中程度に弱い |
| 重心法 | 2群の重心間 | 球状。ウォード法に近い | 高さの逆転が起きる |
| ウォード法 | 融合で増える平方和 | 球状かつサイズが揃う。 実務の既定値 | 鎖状・細長い形は苦手。外れ値を無理に取り込む |
| k-means (非階層) | (距離の定義ではなく) WSS を直接最小化 | 球状・同程度の広がり | 初期値依存。 を先に決める必要がある |
覚え方のコツは両端を押さえることだと思います。
- 最短距離法は「1組でも近ければつなぐ」→ つながりやすい → 伸びる
- 最長距離法は「全組が近くないとつながない」→ つながりにくい → 丸くなる
群平均法はその中間、ウォード法は「丸くなる」側でサイズ均等の性格が追加、と整理できます。
同じデータで手法を変えると本当に変わるのか
3種類のデータ形状 × 5手法で実際に走らせました。クラスター数は真の値に固定してあるので、違いは純粋に手法によるものです。評価は純度(各クラスターの中で最も多い真ラベルの割合。1.00 なら完全一致)で測ります。
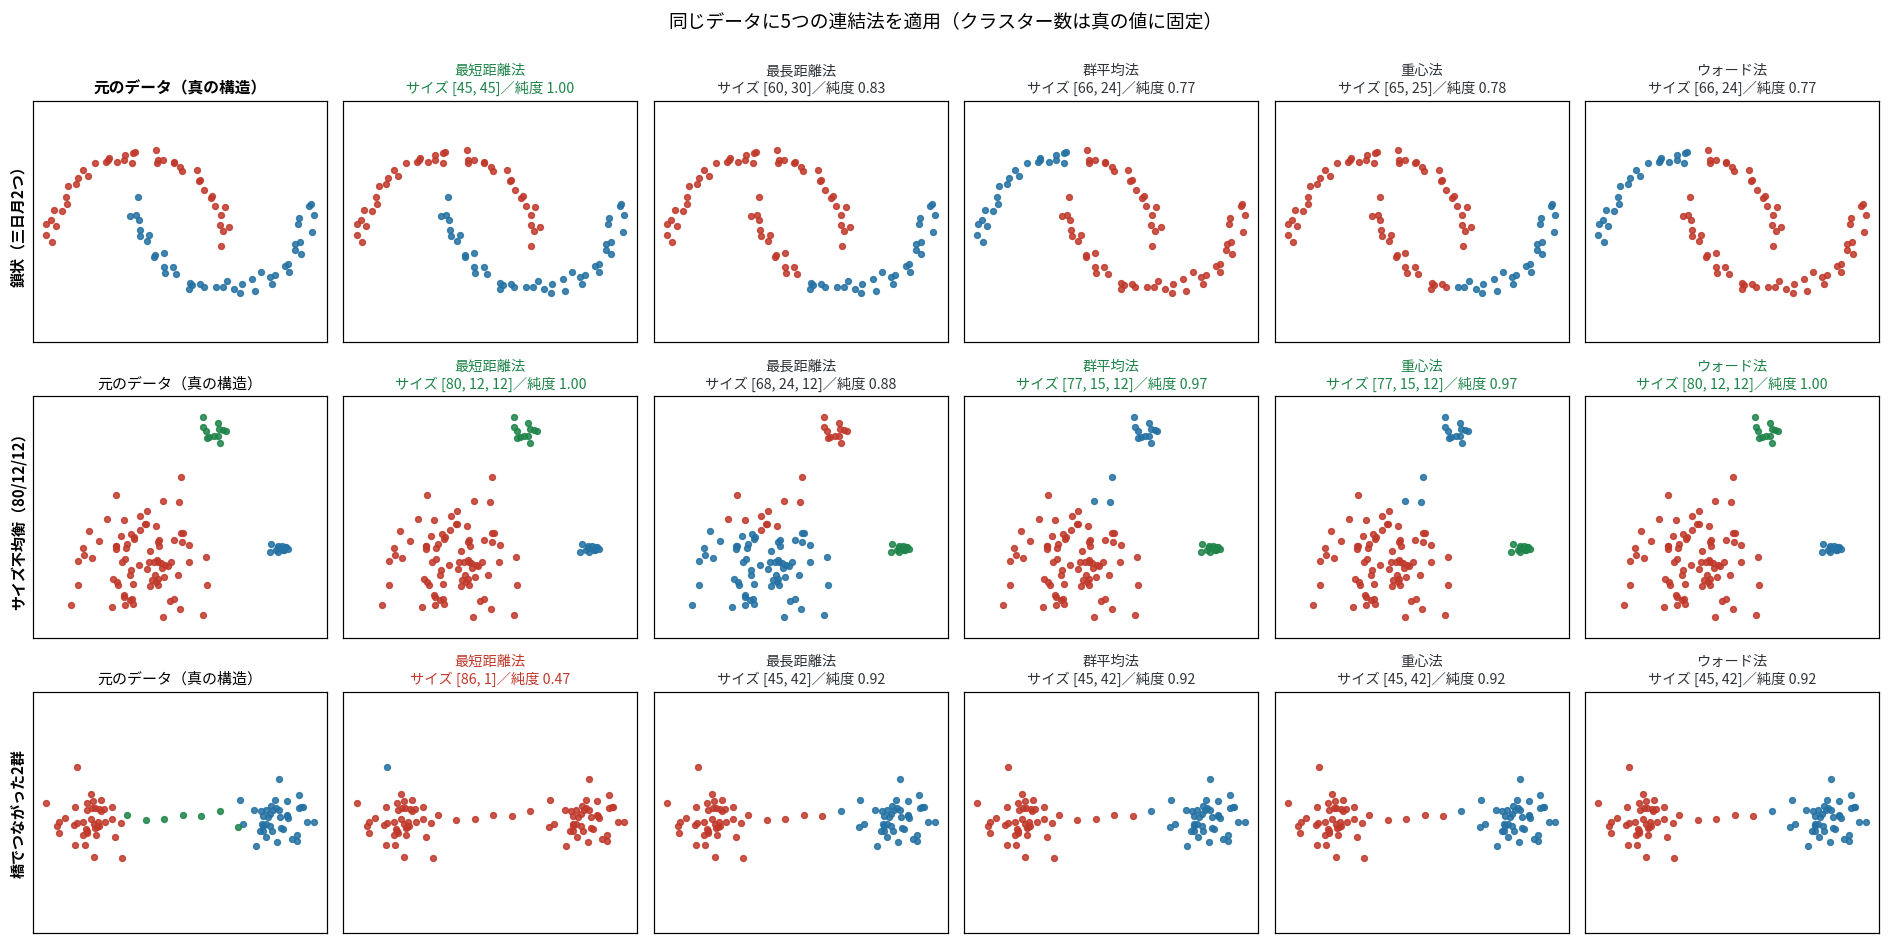
数値で並べます。上段が純度、下段がクラスターサイズです。
| データ | 最短距離法 | 最長距離法 | 群平均法 | 重心法 | ウォード法 |
|---|---|---|---|---|---|
| 鎖状(三日月2つ) | 1.0000 [45, 45] | 0.8333 [60, 30] | 0.7667 [66, 24] | 0.7778 [65, 25] | 0.7667 [66, 24] |
| サイズ不均衡(80/12/12) | 1.0000 [80, 12, 12] | 0.8846 [68, 24, 12] | 0.9712 [77, 15, 12] | 0.9712 [77, 15, 12] | 1.0000 [80, 12, 12] |
| 橋でつながった2群 | 0.4713 [86, 1] | 0.9195 [45, 42] | 0.9195 [45, 42] | 0.9195 [45, 42] | 0.9195 [45, 42] |
行ごとに勝者が入れ替わっています。 そしてどの手法も全勝していません。
- 最短距離法は2勝1敗。ただし負け方が壊滅的(0.47、サイズ [86, 1])
- ウォード法は負けたのは1行目だけ(3行目の 0.92 は4手法同点の首位)。しかもその負けが 0.77 で崩れ方が小さい
- 最長距離法は2行目で 0.88。広く散らばったクラスターを割っている(80個の群を 68 と 12 に分断した)
鎖効果は欠点であり長所でもある
教科書では最短距離法の鎖効果は欠点として書かれます。しかし「近いものを次々つないでいく」という同じ性質が、状況によって長所にも欠点にもなります。
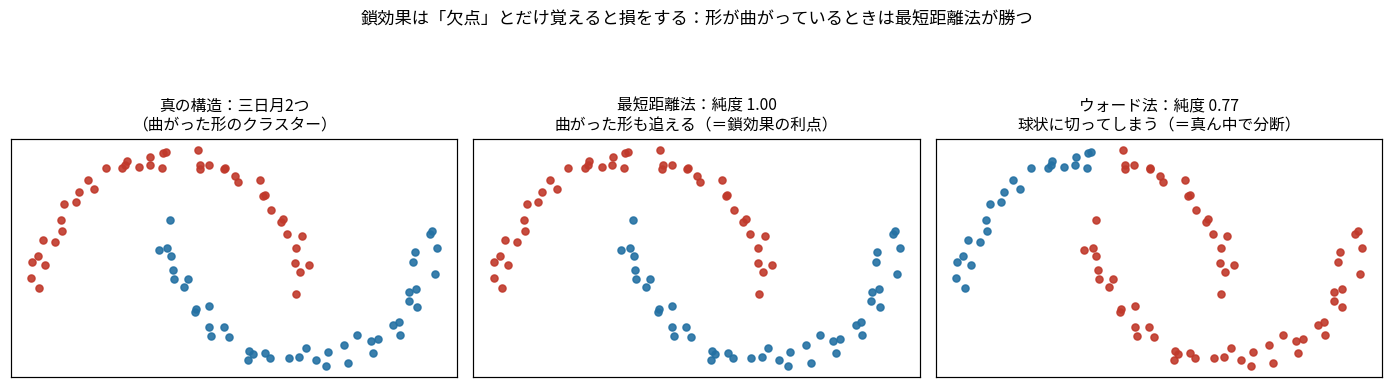
三日月2つのデータでは、最短距離法が純度1.00で完璧に三日月をなぞります。ウォード法は 0.77 で、三日月の真ん中を横切って「丸い2つ」に切ってしまいます。
ウォード法は平方和を最小にするので、そもそも「丸くないクラスター」を作れない設計なのです。重心から遠い点が多いクラスターは平方和が大きくなるので選ばれません。
ところが同じ最短距離法が、次のデータでは崩壊します。
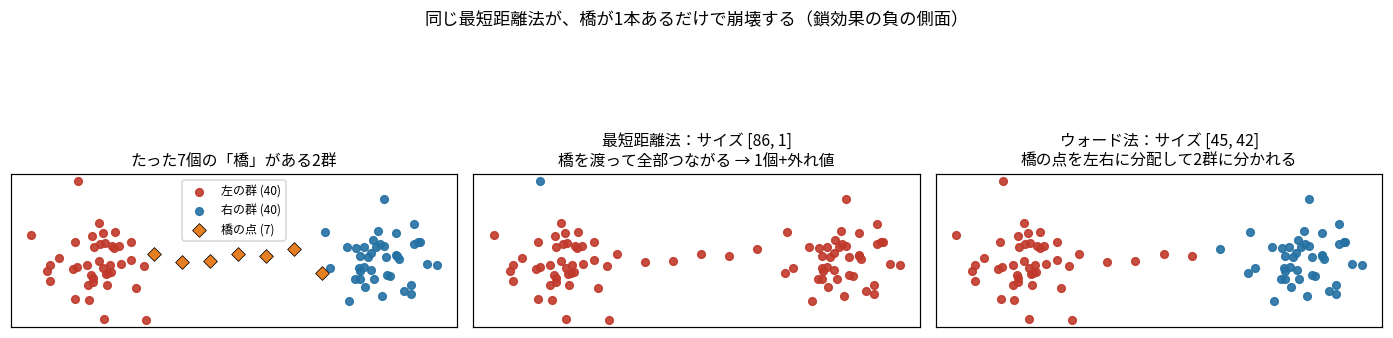
2つの群の間に橋渡しの点がわずか7個(全体の8%)あるだけです。最短距離法は橋を渡って全部つながり、サイズ [86, 1] になりました。純度 0.47。ウォード法は橋の点を左右に分配して [45, 42] と正しく2群に分けます。
同じ性質が、データの形によって正反対の結果を生むというのがこの章の要点だと思います。
デンドログラムの形にも手法の性格が出る
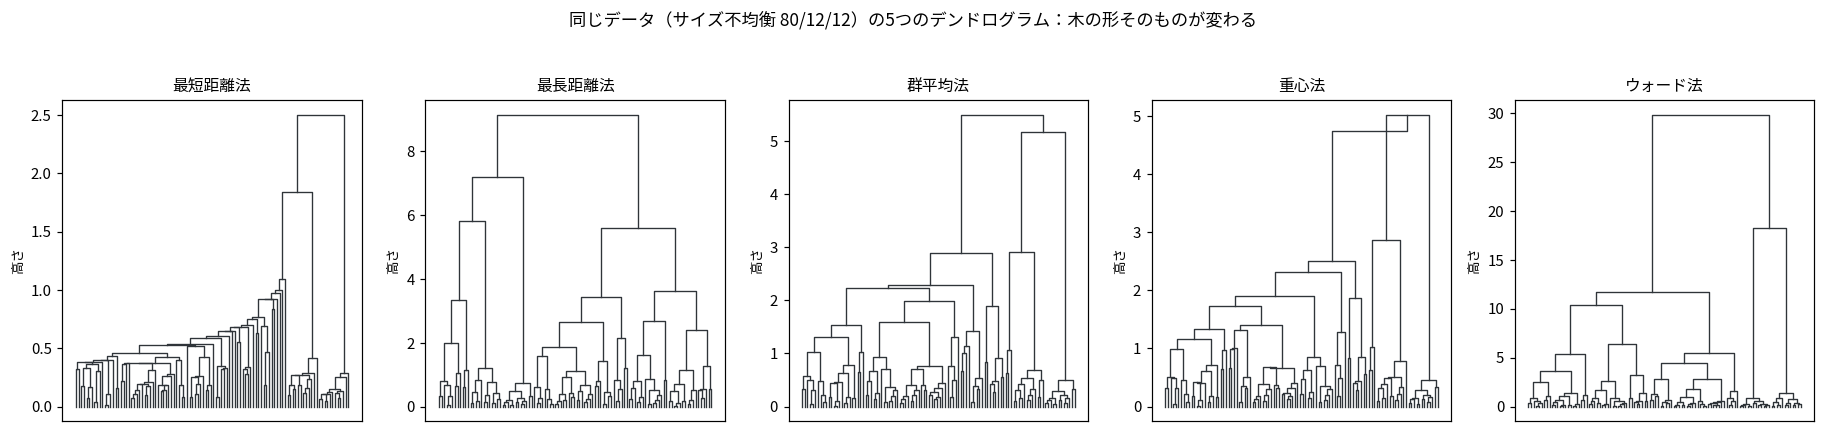
サイズ不均衡データ(80/12/12)の5つのデンドログラムです。木の形自体が変わります。
最短距離法は階段状に少しずつ伸びる形になります。これが鎖効果の視覚的なサインで、どこで切っても大きな段差がなく、クラスター数を読み取りにくい。
ウォード法は上の方に大きな段差があり、切る場所が見つけやすい。これも実務でウォード法が好まれる理由の1つです。
8. 「正解がない」のに、どう判断すればいいのか
ここが今回のいちばん大事な話です。
「手法で結果が変わるなら、正解がないことになる。それでどう判断すればいいのか」。この疑問は本質を突いていて、前半は完全に正しいのです。統計的な検定で「この分け方が正しい」と決めることはできません。
できるのは以下の4つです。
判断材料1:解釈可能性(実務ではこれが主役)
出たクラスターに意味のある名前が付くか。 「訪問頻度が高くて滞在時間が短い層」のように説明でき、それに対して打つ手が変わるならその分け方は有用です。
名前が付かないクラスターは、統計的にどれだけ綺麗でも使えません。逆に統計指標が中程度でも、施策が変わる分け方なら価値があります。
クラスター分析は「仮説を作る道具」であって「仮説を検証する道具」ではありません。 出てきた分け方は仮説として扱い、検証は別の手段(その分け方でA/Bテストをする、判別分析で新データに適用できるか見る)で行う。 この分業を意識すると、「正解がないのにどう使うのか」の居心地の悪さが解消します。
判断材料2:安定性(同じ結論が繰り返し出るか)
データを半分に分けて別々にクラスタリングして同じ構造が出るか、点を少し抜いても結果が変わらないか(ブートストラップ)を見ます。
手法を変えても同じ結論が出るなら、それは頑健な構造だと言えます。 逆に手法ごとにバラバラなら「そもそも明確なかたまりが無い」というのが結論です。
上の実測でも、橋つきデータでは最短距離法以外の4手法がすべて [45, 42] で一致していました。この「複数の手法が同じ答えを出す」ことは、弱いですが有用な証拠です。
判断材料3:内部指標(数値で測る)
正解ラベルなしで計算できる指標を使います。後で扱うシルエット係数がこれです。ただし指標も「球状のクラスターが良い」といった前提を持っているので、指標が高い=正しいではありません。
もう1つ、デンドログラムの忠実さを測るコーフェネティック相関係数もあります。「元の点間距離」と「デンドログラム上で2点が初めて同じ枝になる高さ」の相関です。実測すると次のようになりました。
| データ | 最短距離法 | 最長距離法 | 群平均法 | 重心法 | ウォード法 |
|---|---|---|---|---|---|
| 鎖状(三日月2つ) | 0.5357 | 0.7085 | 0.7056 | 0.7130 | 0.6957 |
| サイズ不均衡(80/12/12) | 0.8393 | 0.7129 | 0.8663 | 0.8651 | 0.8681 |
| 橋でつながった2群 | 0.8071 | 0.9251 | 0.9378 | 0.9376 | 0.9295 |
群平均法が高くなりやすいのは当然です。距離の平均を保つように設計されているからです。注意すべきは、この指標が高い手法が「良い」わけではないことです。1行目では最短距離法がこの指標で最下位(0.54)なのに、純度では唯一の満点(1.00)でした。指標が測っているものと、やりたいことが一致していない例です。
判断材料4:そもそもデータの性質から手法を先に選ぶ
結果を見て選ぶと後付けになるので、分析前に決めるのが筋です。
| 状況 | 選ぶ手法 |
|---|---|
| とくに事前情報がない(最初の一手) | ウォード法。 サイズが揃い解釈しやすい |
| クラスターが細長い・曲がっていそう | 最短距離法(ただし外れ値を先に除く) |
| 外れ値が混じっている可能性が高い | 群平均法か最長距離法。最短距離法は避ける |
| データが大きい( が数万以上) | k-means(階層的手法は の距離行列が必要) |
| クラスター数の手がかりが欲しい | まず階層的手法でデンドログラムを見る |
試験対策としてはこの表が答えです。「鎖状のクラスターを検出できるのはどれか」「サイズの揃ったクラスターができやすいのはどれか」という形で問われるので、最短距離法=伸びる/最長距離法・ウォード法=丸くなるを軸に思い出せれば足ります。
9. k-means:非階層的クラスタリング
階層的手法は の距離行列を作るので、 が数万を超えるとメモリに乗りません。そこで使われるのが k-means です。
計算量の違いは「距離を何回計算するか」を数えれば見えます。
| 何と何の距離を測るか | 1回の作業で | メモリ | |
|---|---|---|---|
| k-means | 点 と 中心 | 回( は自分で決める定数) | (データ本体だけ) |
| 階層的手法 | 点 と 点(全ペア) | 回 | (距離行列を保持) |
核心は相手の数です。 は3とか5という小さな定数ですが、「全ペア」の相手の数は そのもの。 人のパーティで、k-means は「 人の班長にだけ挨拶に行く」、階層的手法は「全員が全員と握手する」に相当します。10人なら握手45回と班長方式30回(=3)で大差ありませんが、1000人だと 499,500回 vs 3,000回になります。
そして実務で先に効くのは時間よりメモリです。
| 距離行列 | データ本体(3変数) | |
|---|---|---|
| 10,000 | 0.8 GB | 0.24 MB |
| 44,721 | 16 GB(ノートPCの限界) | 1.1 MB |
| 1,000,000 | 8,000 GB | 24 MB |
=100万のときデータ本体は24MBで余裕なのに、距離行列は8TB必要です(対称行列をそのまま持つ場合。半分だけ持てば4TB)。一方 k-means は距離を計算してすぐ捨てるので、メモリはデータ本体だけです。
⚠️ ただし「 のメモリが必須」ではありません。 距離を毎回計算し直す実装なら のメモリで済みます(最短距離法の SLINK 法、最長距離法の CLINK 法、fastcluster が使う最近傍連鎖の方式など)。避けられないのはメモリではなく計算回数の方です。ただし scipy.linkage に距離行列を渡す普通の使い方では上の表の通りになるので、実務上の壁として意識しておく価値はあります。
なお k-means の計算量は正確には ( は反復回数)で、 は とともに緩やかに増えます(実測で 〜 程度。理論上の最悪ケースは指数的になりうることが知られていますが、実データでは起きません)。ただし実務では
max_iterで打ち切るので、その場合は厳密に に比例します。 素朴に実装した階層的手法は各段階で最小ペアを全探索するため になりますが、最近傍連鎖アルゴリズムなどで まで落とせます。一般の非類似度行列を入力とする限り、 より速くはできません(全ペアを一度は見る必要があるため)。ただし低次元のユークリッド空間なら例外があります。最短距離法のデンドログラムは最小全域木と等価なので、2次元ならドロネー三角形分割を経由して で厳密に求まります。
やっていることは2行で書けます。
- 割り当て: 各点を、いま最も近い中心に割り当てる
- 更新: 各中心を、担当した点の平均(=重心)に動かす
これを中心が動かなくなるまで繰り返すだけです(ロイドのアルゴリズム)。名前の means(平均) は手順2の「平均に動かす」から来ています。
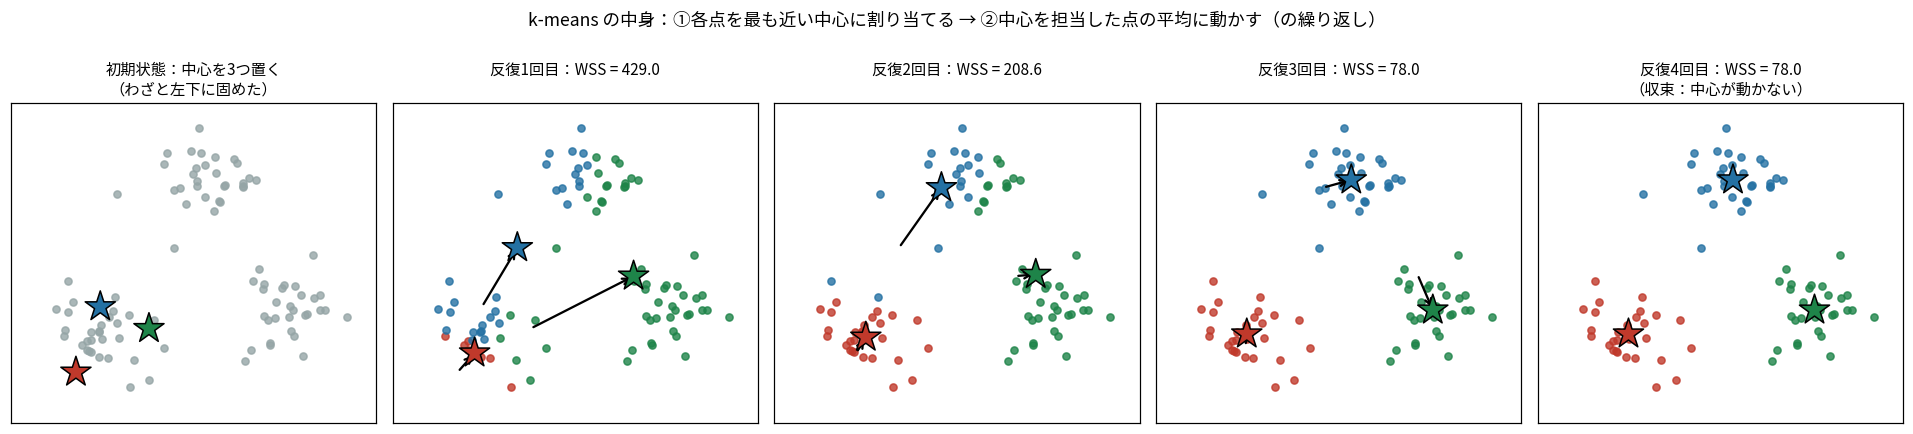
わざと中心3つを左下に固めた状態から出発させました。WSS が 429.0 → 208.6 → 78.0 と下がり、4回目で中心が動かなくなって停止します。
目的関数は絶対に増えません。 ここは正確に書く必要があります。目的関数を「割り当て と中心の位置 の両方の関数」として
と書くと、手順1は を固定して について最小化し、手順2は を固定して について最小化しています。手順2 が を減らすのは、「平方和を最小にする点は平均である」という第3回で見た性質そのものです。どちらも を増やさないので、 は単調に減っていきます。
有限回で止まる根拠は、これに加えてもう1つ必要です。 単調に減るだけでは無限に続く可能性があるので(減少列は無限に続けます)、次を使います。割り当てが実際に変わるときは が狭義に減るので、同じ割り当てが二度現れることはありません。そして分割の総数は有限( 通り以下)です。だから必ず有限回で止まります。
ただし止まるのは「中心が動かなくなる点」であって、大域的な最小とは限りません。 ここが次の話につながります。
ここに初期値依存の原因が全部あります。 このアルゴリズムは WSS が減る方向にしか動けません。坂を下ることしかできないので、いったん谷(局所最適)に落ちると出られない。 どの谷に落ちるかはどこから出発したかで決まる。それが初期値依存です。
実行するたびに結果が変わるのか
答え:はい、変わります。 ただし「毎回でたらめ」ではなく、いくつかの決まった解のどれかに落ちるという形で変わります。
同じデータ・同じ で、初期値だけを変えて 300回走らせました。
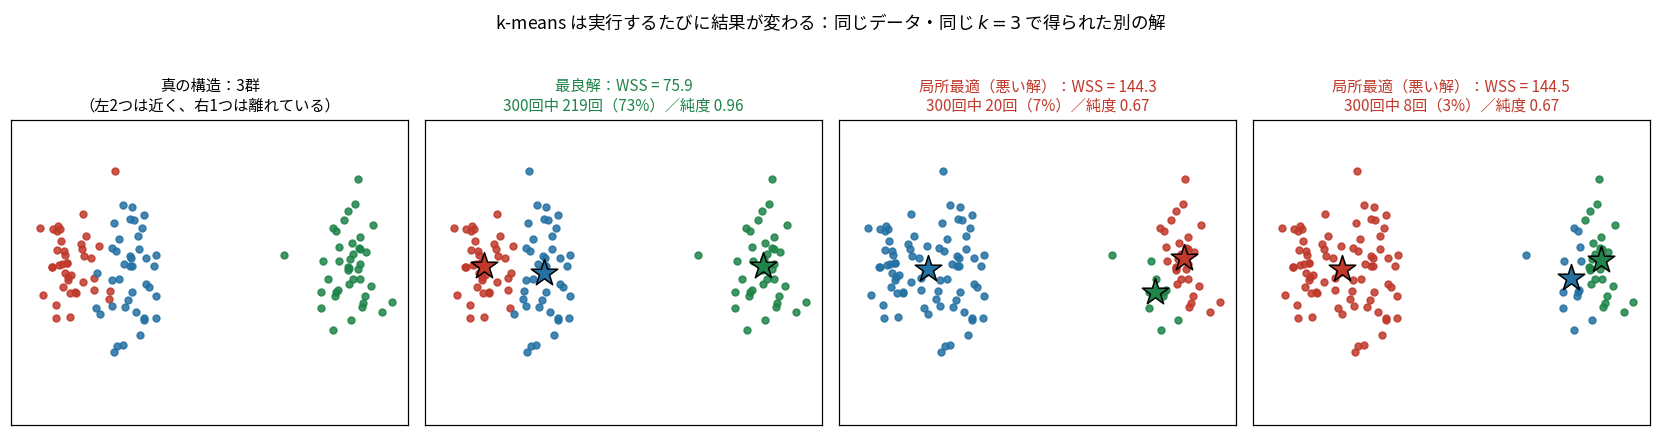
| WSS | 出現回数 | 割合 | サイズ | 解の性質 |
|---|---|---|---|---|
| 75.87 | 219 | 73.0% | [41, 40, 39] | 最良解(真の構造に対応) |
| 144.31 | 20 | 6.7% | [80, 30, 10] | 左2群を合体・右を分割 |
| 144.48 | 8 | 2.7% | [80, 26, 14] | 同上(割り方が違う) |
| … | … | … | [80, …, …] | 同上のバリエーション |
| 149.07 | 3 | 1.0% | [80, 39, 1] | 最悪解(1個だけのクラスター) |
異なる解が全部で22通り出ました。 ただし WSS で見ると実質2グループ(75.9 か 144以上)で、悪い解はすべて「左の近接した2群を合体させ、代わりに右の離れた1群を割った」形です。純度は 0.96 → 0.67 に落ちます。
ここが実務上の重要点です。 悪い解 [80, 30, 10] を1回だけ実行して受け取ったら、「大きな層が1つと小さな層が2つある」という誤った結論を出してしまいます。しかも数値は綺麗に出るので、間違っていることに気づけません。
対策:これは解決済みの問題です
| 対策 | 最良解に到達した割合 | コメント |
|---|---|---|
| ランダム初期化を1回 | 73.0% | これが「毎回変わる」の正体 |
| k-means++ で初期化 | 86.0% | 1点目はランダム、以降は既存の中心から遠い点を選びやすくする |
| 2回試して WSS 最小を採用 | 95.0% | |
| 3回試して WSS 最小を採用 | 100.0% | この例では3回で十分だった |
| 10回試して WSS 最小を採用 | 100.0% | ライブラリの既定値はこのあたり |
ポイントは「WSS を見れば良い解かどうか判定できる」ことです。 正解ラベルは無くても WSS は計算できます。だから「複数回走らせて WSS が最小のものを採る」だけで解決します。
k-means++ は、初期の中心を選ぶときに既存の中心からの距離の2乗に比例する確率で次の点を選ぶ方法です。遠い点が選ばれやすくなるので、初期の中心が固まりにくくなります。
scikit-learn の KMeans には n_init(既定10)と init="k-means++"(既定)があるので、普通に使えばこの対策は自動で入っています。 「毎回変わって困る」となるのは n_init=1 にしたか、自前実装した場合です。なお再現性が必要なら random_state を固定します。
k-means の弱点
初期値依存以外に3つあります。
- を先に決めなければならない(デンドログラムのように全体を眺められない)
- 球状で同程度の広がりのクラスターを前提にしている。細長い形や、大きさが極端に違うクラスターは苦手
- 平均を使うので外れ値に弱い。代表点を平均ではなくクラスター内の実データ点(メドイド)にする k-medoids(PAM 法)という変種があります。代表点が必ず実在の観測値になるので外れ値に引っ張られず、任意の非類似度行列に使えます(中央値を使う k-medians とは別物です)
2番目については、上の実測がまさにその例です。悪い解が「小さく近い2群」を合体させたのは、k-means がサイズの揃った分割を暗黙に好むためです(§6 で実測した通りで、真のサイズが不均衡だとこれが裏目に出ます)。この点ではウォード法の方が頑健でした。
10. クラスター数をどう決めるか
「エルボー法は主観的に見える」というのは、まったく正しい指摘です。より客観的な方法があります。真のクラスター数が4のデータで3つの方法を比べました。
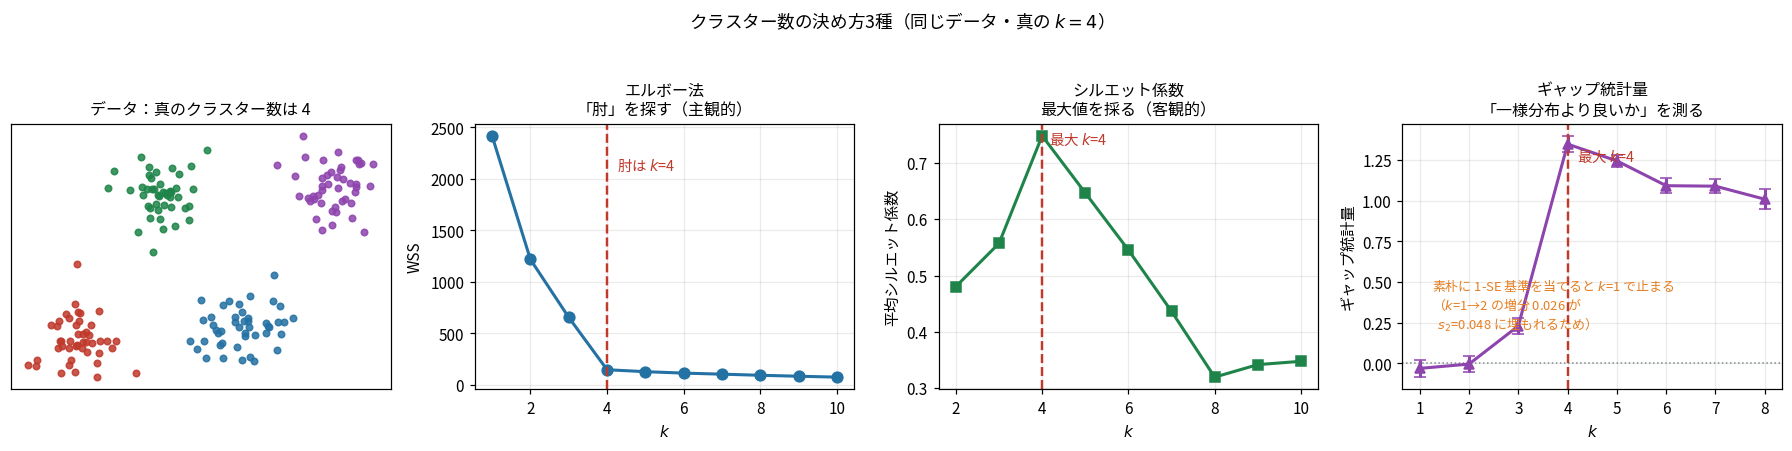
| WSS | 前の からの減少率 | 平均シルエット係数 | ギャップ統計量 | |
|---|---|---|---|---|
| 1 | 2418.37 | — | — | |
| 2 | 1218.16 | 49.6% | 0.4805 | |
| 3 | 655.38 | 46.2% | 0.5573 | 0.230 |
| 4 | 147.40 | 77.5% | 0.7483 | 1.348 |
| 5 | 128.59 | 12.8% | 0.6468 | 1.245 |
| 6 | 114.59 | 10.9% | 0.5453 | 1.092 |
| 7 | 104.35 | 8.9% | 0.4364 | 1.089 |
| 8 | 93.58 | 10.3% | 0.3196 | 1.009 |
3指標すべてが を指しました。
エルボー法:肘を数値にする
減少率の列を見ると「肘」が数値になります。 までは 46〜78% 減るのに、 以降は 9〜13% しか減りません。この段差が肘の正体で、「 を1つ増やして得られる改善が急に小さくなる点」です。
なぜ WSS が単調に減るのかというと、 を増やせば必ず細かく分けられるからです。極端な話 なら WSS はゼロになります。だからWSS が小さいこと自体には意味がなく、減り方の変化を見るしかありません。第16回の「変数を増やせば決定係数は必ず上がる」と同型の問題です。
シルエット係数:定義から
各点 について2つの平均距離を測ります。
- = 自分と同じクラスターの他の点への平均距離(=居心地の悪さ)
- = 最も近い他のクラスターの点への平均距離(=隣の魅力)
そして
と定義します。分母は に収めるためのものです。
| 意味 | |
|---|---|
| 1 に近い | 。自分の仲間は近く、他は遠い=正しい場所にいる |
| 0 に近い | 。境界上にいる。どちらでもよい点 |
| 負 | 。他のクラスターの方が近い=置き場所を間違えている |
小さな例で確かめます。1次元で 0, 1, 10, 11 を と に分けた場合、点0 は
実装値と手計算が一致しました。なおクラスターのサイズが1のときは が定義できないので、慣習で とします。
シルエット図:平均だけ見ると損をする
平均値を1つ見るより、点ごとの値を並べたシルエット図の方が情報量が多いです。
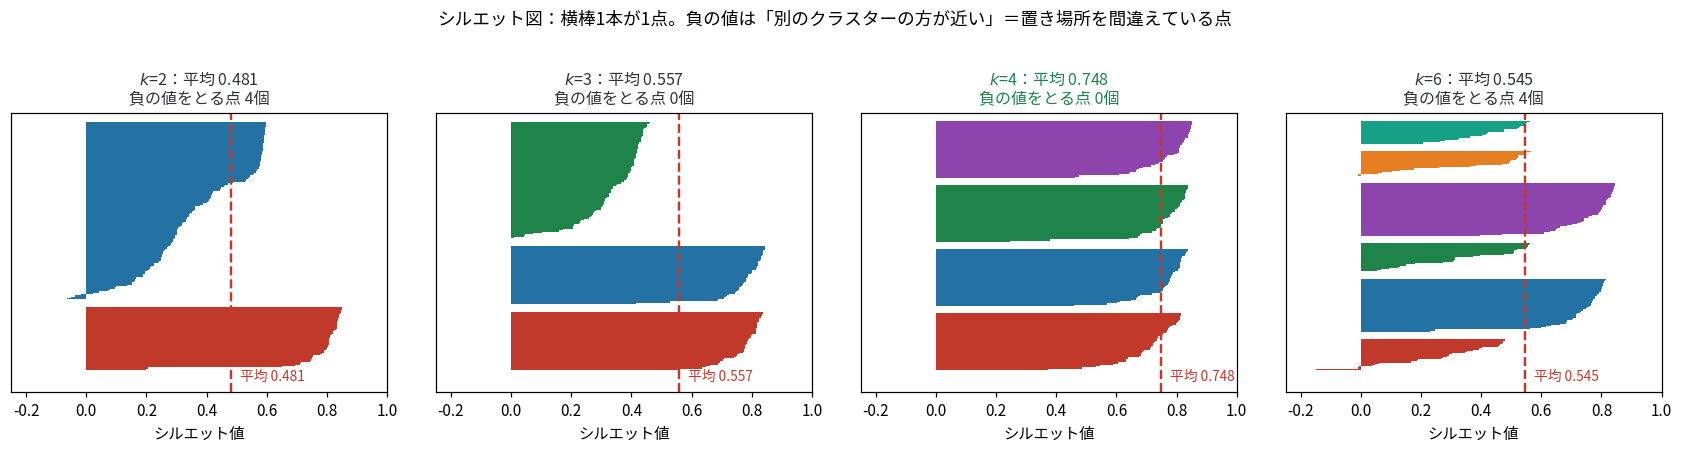
横棒1本が1点で、クラスターごとにまとめて降順に並べたものです。
| 平均シルエット係数 | 負の値をとる点 | |
|---|---|---|
| 2 | 0.4805 | 4個 |
| 3 | 0.5573 | 0個 |
| 4 | 0.7483 | 0個 |
| 6 | 0.5453 | 4個 |
で4つのブロックの幅(点数)と長さ(値)が揃い、負の点がゼロになります。 では上に細く削られたブロックが2つ現れ、負の値をとる点も4個出ます。
平均値だけでなくこの形を見ると、「無理に割った」ことが視覚的にわかります。 実務ではこちらの方が説明に使いやすいです。
⚠️ エルボー法が機能しない場合
「主観的」より深刻な問題があります。そもそも肘が存在しない場合です。
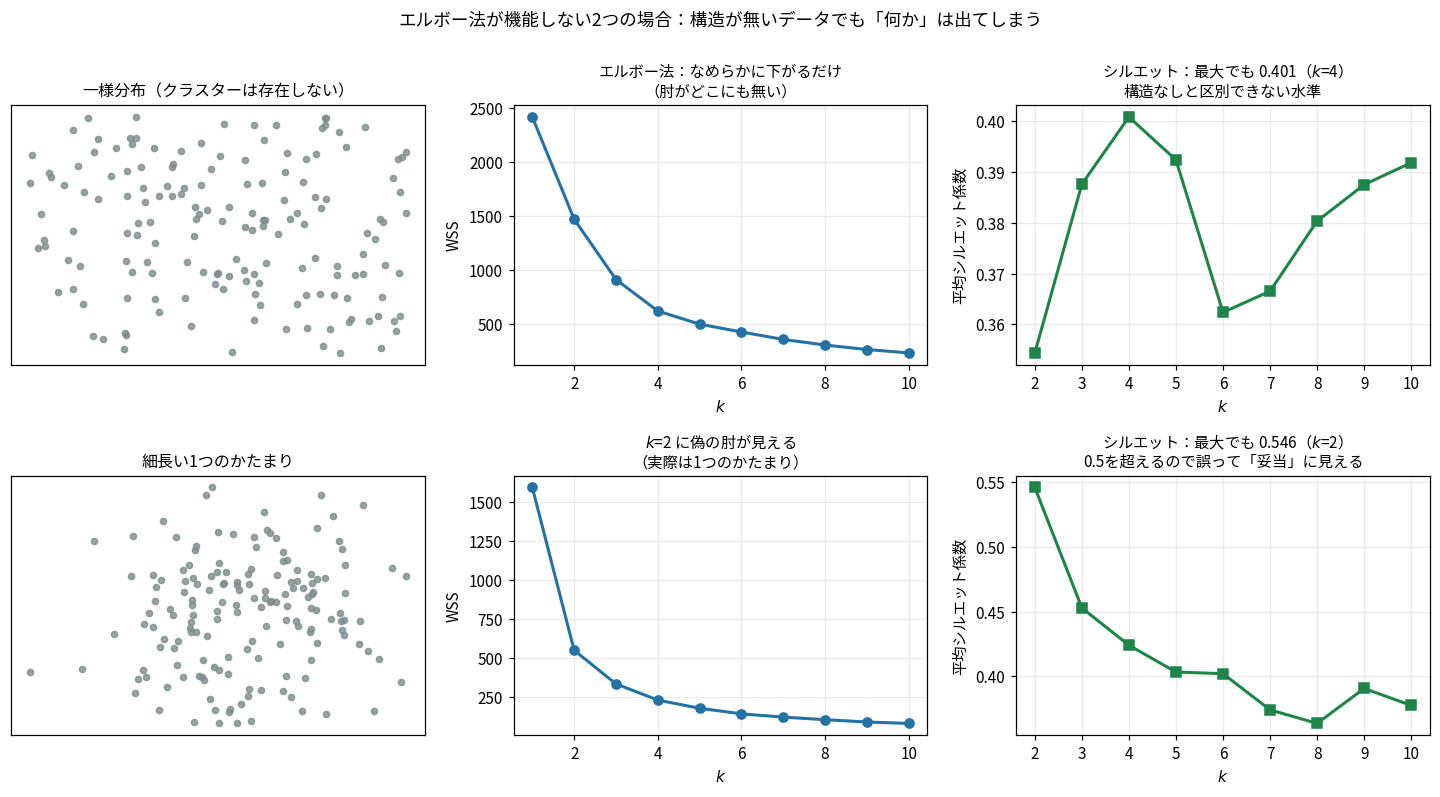
上段が完全な一様分布(クラスターは存在しない)、下段が細長い1つのかたまりです。
上段は WSS がなめらかに下がり続け、肘がどこにもありません。 下段はもっと厄介で、 で 1590 → 547 と急落するので肘があるように見えます。 しかし実際には1つのかたまりしかないので、これは偽の肘です。細長い分布を真ん中で半分に割れば平方和が大きく減るのは当然で、それが「2群ある」ことを意味しません。
それでも k-means は を指定すれば必ず「何か」を返します。
一方シルエット係数は最大でも 0.401 / 0.546 にとどまります。慣習的な目安として、平均シルエット係数が
- 0.7 以上:はっきりした構造
- 0.5〜0.7:妥当な構造
- 0.25〜0.5:弱い構造(人工的な分割の疑い)
- 0.25 未満:構造なし
とされます(Kaufman と Rousseeuw の経験則)。一様分布の 0.401 はこの表で「弱い構造」に落ちるので、エルボー法よりは判断材料になります。
⚠️ ただし「構造なし」を判定できると言うと言い過ぎです。 構造がまったく無いデータでも、平均シルエット係数は0になりません。2次元の標準正規分布を k-means で に切ったとき、 で 0.355、 でも 0.330 で、 を増やしても 0.33 付近から下がりません。 一様分布ならもう少し高く 0.38〜0.43 程度です。
つまり0.4 前後は「構造なしと区別できない領域」であって、上の表は判定基準ではなく経験則です。細長い1つのかたまりの 0.546 が「妥当な構造」に分類されてしまうのも、この目安の限界を示しています(実際には1つのかたまりなので構造はありません)。
正しい使い方は「絶対水準で判定する」ではなく「構造がないときのベースラインと比べて明確に高いかを見る」です。そのベースラインを実際に計算してくれるのが、次のギャップ統計量です。
ギャップ統計量
もう1つ、(=クラスターが存在しない)も候補に入れられる方法があります。ギャップ統計量(Tibshirani ら, 2001)です。
が実データの WSS、 が構造のない参照データ(各変数の範囲に一様分布)で同じことをやったときの WSS です。つまり「デタラメなデータに比べてどれだけ良く分かれたか」を測ります。
参照データより明確に良く分かれていれば Gap が大きくなり、構造がなければ Gap はゼロ付近に留まります。だから が最適という結論も出せるわけです。
自分が踏んだ落とし穴
この指標には「1標準誤差基準」があり、 を満たす最小の を選ぶとされています。ここで は参照データの の標準偏差に を掛けたものです。
これを素朴に実装したら を選んでしまいました。
最初は「ギャップが負だから基準が壊れたのだろう」と考えたのですが、これは誤りでした。符号は式のどこにも関与していません。 不等式を移項すると正体が見えます。
つまりこの基準は「1つ先に進んだときの増分が1標準誤差に埋もれたら、そこで止まる」という、最初の平坦点で打ち切る規則なのです。実測では の増分が しかなく、 に埋もれていました(表の値は丸めてあるので、引き算すると 0.027 に見えます)。だから で止まった。この基準の設計どおりの挙動で、偶然でもバグでもありません。
参照回数 を 30 から 150 に増やしても直らなかったのも当然でした。 は参照データの標準偏差に を掛けたものなので、 を増やしても係数が に変わるだけで、 はほとんど縮まないのです。
対処としては、大域的な最大値から1標準誤差以内に入る最小の を採る変種を使うのが標準的です(R の cluster パッケージの maxSE に globalSEmax として実装されています)。この例ではそれで正しく になります。
教訓: 「うまく動かない → 手近な原因(符号)に飛びつく」をやってしまいました。式を移項して何を判定している規則なのかを読めば、符号が無関係なことはすぐ分かったはずです。
まとめ
| 方法 | 何を見るか | 長所 | 短所 |
|---|---|---|---|
| エルボー法 | WSS の減少が緩やかになる点 | 計算が軽い・直感的 | 主観的。肘が無い場合に何も言えず、偽の肘に騙される |
| シルエット係数 | 平均 が最大の | 判定が自動( ごとに計算して最大を採るだけ) | 絶対水準では「構造の有無」を判定できない(構造なしでも 0.33〜0.43 が出る)。球状のクラスターを好む。計算が に比例 |
| ギャップ統計量 | 構造のない参照データと比べた改善量 | (構造なし)を候補に入れられる(§13 の混合正規分布+BIC でも可能) | 参照データの生成が必要で計算が重い |
| デンドログラムの切断 | 高さが大きく飛ぶところ | を先に決めずに全体を見渡せる | 階層的手法にしか使えない。 が大きいと読めない |
| 実務的な制約 | 運用できるセグメント数 | 実際にはこれが最強 | 統計的な裏付けはない |
実務での順序としてはこうなります。まずデンドログラムで全体を眺めて候補を絞り、シルエット係数で数値を確認し、最後に「そのクラスター数で運用できるか」で決める。セグメント別のメール文面を8種類は書けない、というのは統計指標よりも強い制約です。
試験対策としては、エルボー法とシルエット係数の定義が言えれば十分でしょう。特にシルエット係数は と のどちらがどちらかを問う形で出ます。 で、大きいほど良いと覚えてください。
11. 標準化しないとどうなるか
ここが今回いちばん驚いた実験です。
年齢(20〜50歳)と年収(300〜1000万円)で3つの層を作りました。年齢だけでも年収だけでも分けられないように設計してあります。
| 群 | 年齢の平均 | 年収の平均 |
|---|---|---|
| 若手・低収入(40人) | 27.4 歳 | 402万円 |
| 中年・低収入(40人) | 44.2 歳 | 445万円 |
| 中間年齢・高収入(40人) | 36.2 歳 | 841万円 |
下2つは年収がほぼ同じで年齢が違うので、年齢を無視すると絶対に分けられません。
まず数字を見る:距離への寄与
問題の本質は「距離」がどの変数から作られているかです。全ペアの平方距離を年齢由来と年収由来に分解しました。
| 年齢の寄与 | 年収の寄与 | |
|---|---|---|
| 標準化なし | 0.0000000013% | 99.9999999987% |
| 標準化あり | 50.00% | 50.00% |
年齢の寄与は約770億分の1です。
なぜこうなるかは計算すればすぐわかります。標準偏差が年齢 7.49歳・年収 206万円なので、単位の比が約27万倍。距離は2乗するので、その2乗=約760億倍の差になります。
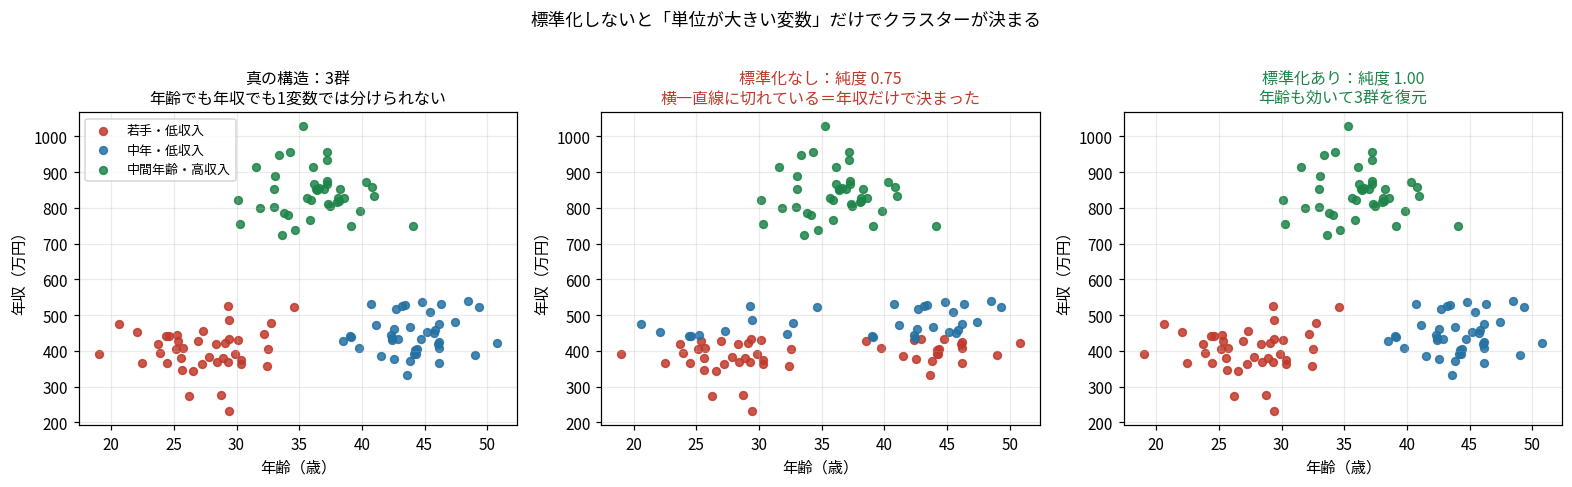
中央のパネルが横一直線に切れているのがわかります。下の2群(若手と中年)が年収の高さだけで混ぜられ、年齢の違いが完全に無視されています。純度 0.75。右が標準化した場合で、純度 1.00 で3群を完全復元しました。
決定的な確認:本当に「年収だけ」で決まっている
「年齢の寄与が小さい」ではなく「効いていない」ことを確かめました。
- 2変数(年齢+年収)を標準化せずにウォード法 → 分割 A
- 年収1変数だけを使ってウォード法 → 分割 B
A と B は完全に同一の分割でした(120人全員が同じクラスターに入った)。
年齢の列は計算に渡されていたのに、結果に1人も影響していません。つまり「標準化を忘れる」の実質的な意味は「単位が小さい変数を分析から削除する」ことです。
さらに悪いこと:単位を変えるだけで結果が変わる
年収を「円」で持つか「万円」で持つかは、データの中身とは無関係な、記録上の都合です。それだけで結果が変わります。
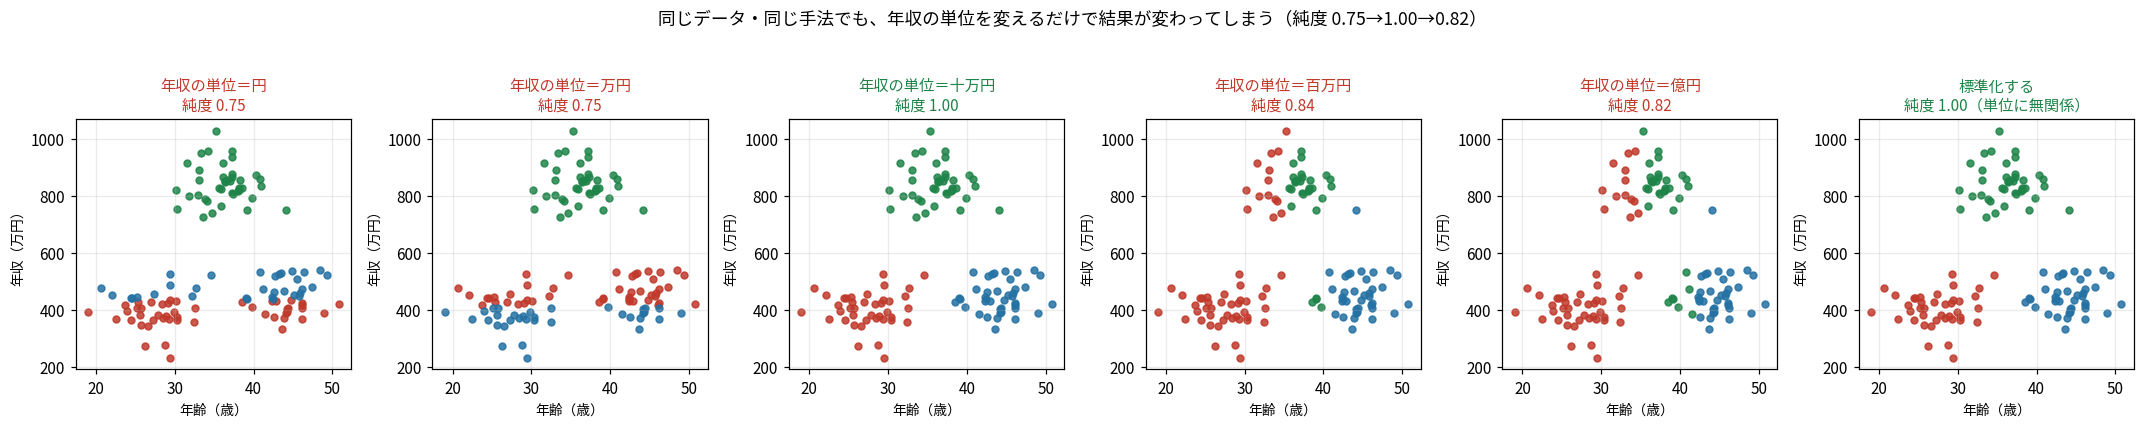
| 年収の単位 | 年齢と年収の標準偏差の比 | 純度 | クラスターサイズ |
|---|---|---|---|
| 円 | 0.0000 | 0.7500 | [48, 40, 32] |
| 万円 | 0.0363 | 0.7500 | [46, 40, 34] |
| 十万円 | 0.3630 | 1.0000 | [40, 40, 40] |
| 百万円 | 3.6299 | 0.8417 | [54, 37, 29] |
| 億円 | 362.9884 | 0.8250 | [53, 34, 33] |
「十万円」のときだけ偶然うまくいくのは、そのとき年齢と年収の標準偏差の比が 0.36 でたまたま釣り合ったからです。
これが「標準化が必要」の本当の理由です。 「精度が上がるから」ではありません。標準化しないと、分析結果が「データをどの単位で記録したか」という恣意的な選択に左右されてしまうから。標準化はその恣意性を取り除く操作です。
標準化 は各変数の標準偏差を1に揃えるので、どの変数も距離に等しく寄与するようになります。
ここで第16回の回帰と比べておくと違いがはっきりします。回帰では標準化しても係数のスケールが変わるだけで、当てはまり(決定係数)は変わりません。 ところがクラスター分析は距離が主役なので、標準化すると分割そのものが変わります。 同じ「標準化」という操作でも、手法によって意味の重さが違います。
マハラノビス距離という別解
面白いことに、標準化していない生データにマハラノビス距離を使うと純度 1.00 になります。
マハラノビス距離は共分散行列の逆行列を挟むので、単位の違いを自動的に吸収するのです。第25回で学んだマハラノビス距離は、「標準化+変数間の相関の補正」を距離の定義に組み込んだものと理解できます。変数が無相関なら、マハラノビス距離は「標準化してユークリッド距離を取る」ことと一致します。
⚠️ ただし標準化は「常に正しい」わけではない
教科書があまり書かない話です。標準化はすべての変数の標準偏差を1に揃えるので、情報を持っていない変数のノイズも同じ大きさまで持ち上げてしまいます。
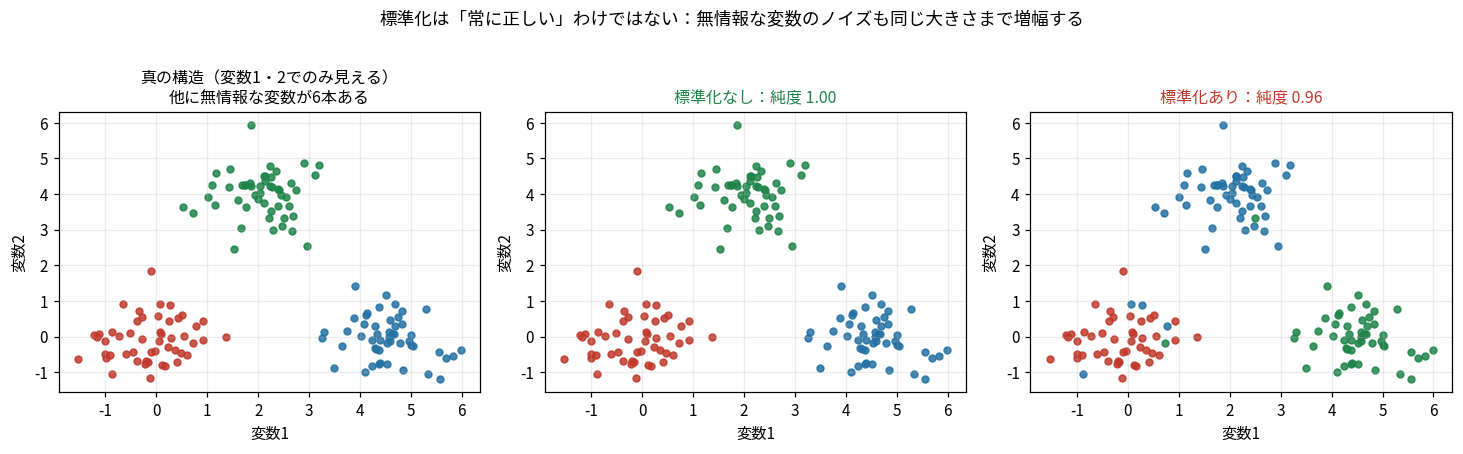
変数1・2に本物の3群構造があり、他にまったく無情報な変数が6本混ざったデータです(ノイズ変数の標準偏差は約 0.05 で、本物の変数の約 2.0 に比べて40分の1)。
標準化なしなら純度 1.00、標準化すると 0.96 に落ちました。 標準化がノイズ6本を本物の変数と同じ大きさに増幅し、6対2で数の力で押し負けたためです。
標準化の判断基準
| 状況 | どうするか |
|---|---|
| 単位が違う変数が混ざっている(年齢と年収、身長と体重) | 標準化する。 これが基本 |
| すべて同じ単位・同じ意味(各科目の点数、各月の売上) | 標準化しない方がよい場合がある。 ばらつきの違い自体が情報 |
| 無情報な変数が混ざっている可能性が高い | 標準化の前に変数選択をする。主成分分析(第24回)で次元を落としてからでもよい |
| 変数間に強い相関がある | マハラノビス距離か、主成分分析を先に通す |
| 外れ値が大きい | 標準偏差ではなく中央値と四分位範囲で正規化する(ロバスト標準化) |
試験対策としては「単位が違う変数を混ぜるときは標準化が必要」で十分です。理由も「距離が単位の大きい変数に支配されるから」と言えれば満点でしょう。ただし「標準化すれば常に良くなる」ではないことは実務では知っておく価値があります。
12. 自分のブログで使えるか
この連載は自分のブログでやっているので、読者のセグメント分けに使えるか検証しました。結論を2つに分けます。手法としては使えます。ただし今のデータ量では使えません。 後者の方が重要なので先に書きます。
先に悪い知らせ: が小さいと「存在しないクラスター」が見える
GA4 の直近28日は PV 29・ユーザー 14 でした。この でクラスター分析をやると何が起きるかを実験しました。
完全に構造の無いデータ(1つの正規分布)から 個を取り出して、ウォード法で3つに切ります。真のクラスターは存在しないので、「何も出ない」のが正解です。
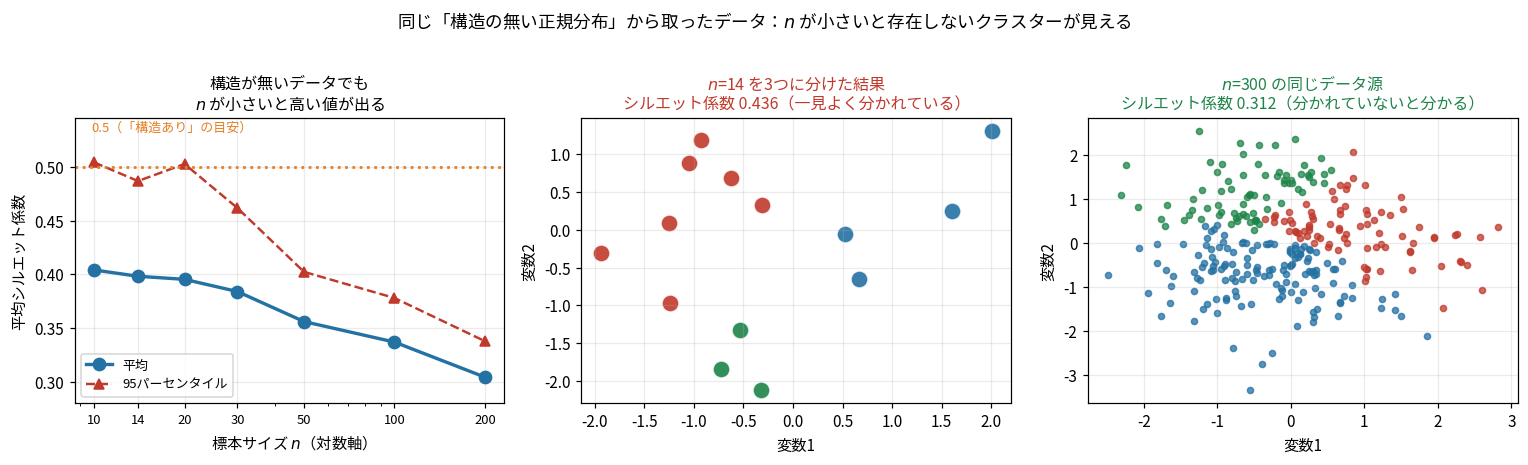
| シルエット係数の平均 | 最大 | 0.5 を超えた割合 | |
|---|---|---|---|
| 10 | 0.4040 | 0.6038 | 5.0% |
| 14 | 0.3981 | 0.5320 | 2.5% |
| 20 | 0.3953 | 0.5312 | 7.5% |
| 30 | 0.3839 | 0.5097 | 2.5% |
| 50 | 0.3560 | 0.4285 | 0.0% |
| 100 | 0.3369 | 0.4004 | 0.0% |
| 200 | 0.3043 | 0.3473 | 0.0% |
(各 で40回試行した平均)
中央のパネルを見てください。14個の点が3つに綺麗に分かれて見えます。シルエット係数は 0.436。しかし元は1つの正規分布です。同じデータ源から300個取ると、切っても分かれていないことが一目でわかり、シルエット係数は 0.312 に落ちます(この300個は1回の実現値で、上の表の 40回試行の平均とは別の数字です。 の平均 0.3043 と同じ水準です)。
が小さいほどシルエット係数が高く出て、〜20 では「構造あり」の目安 0.5 を超えることさえあります。
クラスター分析には「有意差なし」に相当する出力がありません。 検定なら「差があるとは言えない」と答えてくれます。しかしクラスター分析は を指定すれば必ず 個のクラスターを返します。 構造が無くても、それを教えてくれません。 だから が小さいときは「何か出た」を信用しないことが唯一の防御になります。 で3セグメントに分けて施策を打つのは、乱数を読んで意思決定するのと変わりません。
目安として、1セグメントあたり最低30〜50人は欲しいところです。3〜4セグメントに分けたいなら 〜200 が実質的な下限。月間ユーザー数がそこに届いてから着手するのが順序で、いま優先すべきは流入を増やすことです。
なお が少ないうちは、クラスター分析よりも「よく読まれている記事はどれか」を素直に見る方が情報量が多いです。実際、このブログの読者がお金・節税ジャンルに集中していることは、記事別のPVを見るだけで分かりました。
良い知らせ:データが揃えば有効な手法です
の架空データで、実際にやる手順を通してみます。変数は GA4 から取れるものを想定しました。
| セグメント(設計値) | n | 訪問回数 | 閲覧ページ数 | 滞在秒 | 検索流入比率 |
|---|---|---|---|---|---|
| 直帰の検索流入 | 160 | 1.15 | 1.11 | 25.8 | 0.93 |
| 1記事を熟読 | 120 | 1.32 | 2.52 | 240.4 | 0.89 |
| 回遊するリピーター | 80 | 5.22 | 3.53 | 299.9 | 0.57 |
| 常連(直接流入) | 40 | 12.18 | 1.59 | 70.8 | 0.10 |
単位が違う変数(回数・秒・比率)が混ざっているので、標準化は必須です。そのうえでウォード法を適用しました。
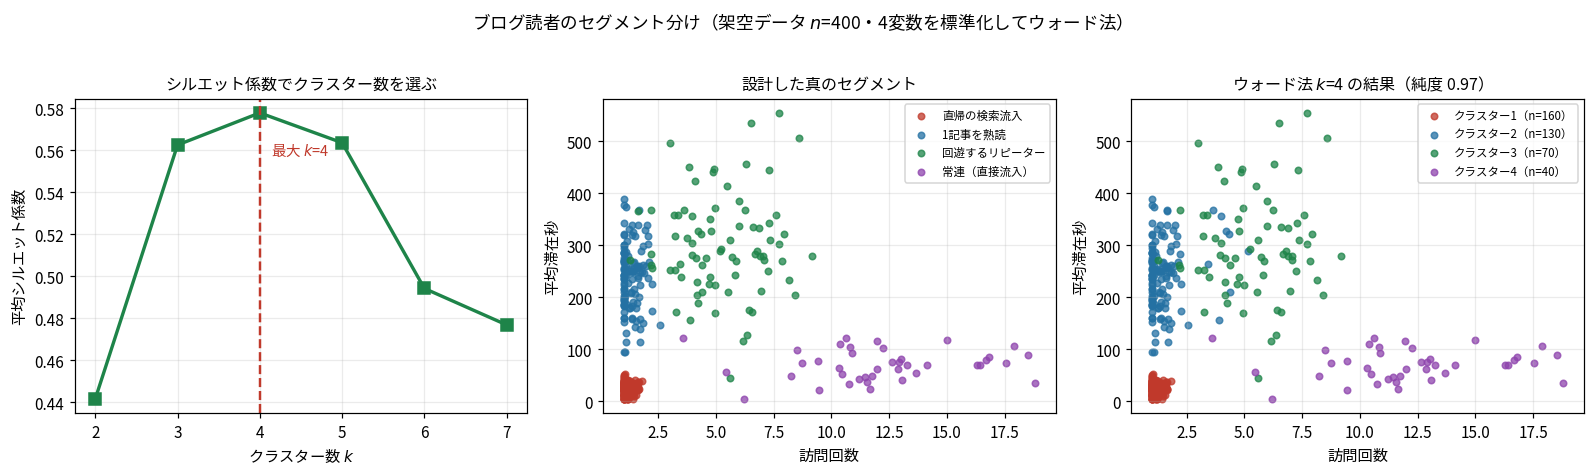
シルエット係数は で最大(0.578)になり、設計した通りの数を正しく当てました。純度 0.97、サイズも [160, 130, 70, 40] と真の [160, 120, 80, 40] にほぼ一致しています。
実務での読み方:クラスターに名前を付ける
出てきたクラスターは番号でしかないので、各変数の平均を並べて特徴を読み、名前を付けるのが次の作業です。標準化した値の平均を色で見ると一目でわかります。
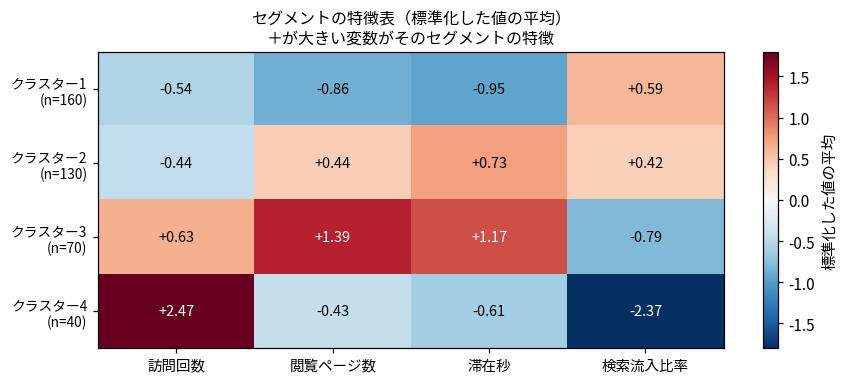
| クラスター | n | 特徴(標準化値) | 付ける名前 | 打つ手 |
|---|---|---|---|---|
| 1 | 160 | 訪問 /ページ /滞在 /検索 | 検索から来てすぐ帰る層 | 導入文と見出しの改善、内部リンクの追加 |
| 2 | 130 | 訪問 /ページ /滞在 /検索 | 1記事をじっくり読む層 | 記事末に関連記事、購読の導線 |
| 3 | 70 | 訪問 /ページ /滞在 /検索 | 回遊するリピーター | 連載のインデックス、シリーズ構成を活かす |
| 4 | 40 | 訪問 /ページ /滞在 /検索 | 更新チェックの常連 | 更新頻度の維持、RSS・購読の案内 |
標準化した値なので、 なら全体の標準偏差1個分だけ高いという読み方をします。
ここで注目してほしいのは、クラスター1と2が「同じ検索流入なのに分かれた」ことです。 訪問回数はどちらも低く、検索流入比率も同じくらい高い。違うのは滞在時間とページ数だけです。
流入元だけで分けていたら同じ扱いになっていた2つの層に、別の施策が必要だと分かる。これがクラスター分析の実務的な価値だと思いました。単一の指標で切るのでは見えない組み合わせを拾ってくれます。
この連載の内容との接続
| やりたいこと | 使う手法 | 回 |
|---|---|---|
| セグメントを見つける | クラスター分析 | 今回 |
| 見つけたセグメントに新しい読者を割り振る | 判別分析(境界を学習させる) | 第25回 |
| 変数が多すぎるので先に整理する | 主成分分析 | 第24回 |
| セグメント間で滞在時間に差があるか検定する | 分散分析 | 第20回 |
| 施策の効果を確かめる | A/Bテスト(2標本の検定) | 第13回 |
ただし最後の「検定」には注意が必要です。 クラスター分析で作ったセグメント間で「滞在時間に差があるか」を検定すると、ほぼ確実に有意になります。 なぜなら滞在時間の差が大きくなるようにクラスターを作ったからです。 同じデータで分けて同じデータで検定するのは循環論法で、第12回の多重比較や第17回の「データを見てからモデルを決める」問題と同じ罠です。 これは選択的推測(selective inference)/モデル選択後の推測と呼ばれる問題の一種で、通称 double dipping(二度漬け)と言われます。近年は「その分割を選んだこと」を条件づけて正しい 値を出す方法も提案されていますが(Gao, Bien, Witten 2022 が階層的クラスタリング版)、別データで検証するのが原則です。
13. この記事で扱わなかった手法
紙幅の都合で深入りしませんでしたが、押さえておくべきものを整理しておきます。特に最初の1つはこの章の内容を確率モデルとして書き直したものなので、重要度が高いです。
| 手法・概念 | どういうものか | なぜ重要か |
|---|---|---|
| 混合正規分布モデル (モデルベースクラスタリング) | 「データは 個の正規分布の混ぜ合わせから出てきた」と仮定し、最尤法(EM アルゴリズム)で推定する | クラスター分析を確率モデルにしたもの。 所属確率で「7割こっち」というソフトな割り当てができ、共分散構造を指定すれば球状以外も扱える。何よりBIC でクラスター数を選べる(エルボー・シルエット・ギャップとは別系統の、尤度にもとづく答え)。k-means は「全成分の共分散を共通の (等方かつ同じ大きさ)に固定し、混合比も等しいとした混合正規モデルのハード割り当て版」という対応関係がある(ここでの「同じ大きさ」は共分散の話で、クラスターの点数のことではありません) |
| DBSCAN(密度ベース) | 密度の高い点を連結していく。到達可能性で定義 | 「三日月は最短距離法しか追えない」への現代的な答え。非凸形状に強く、しかも外れ値を「どのクラスターでもない」と判定できる(本記事の「クラスター分析には有意差なしに相当する出力がない」という嘆きへの部分的な回答) |
| Calinski-Harabasz 指数 (分散比規準) | 群間平方和 ÷ 群内平方和 を自由度で調整した比 | 分散分析の 比と同じ形。 第20回の平方和の分解がそのまま内部指標になる |
| Davies-Bouldin 指数 | 各クラスターについて「内部のばらつき ÷ 他クラスターとの距離」の最悪値を求め、それを平均したもの | シルエット係数と並ぶ内部指標。小さいほど良い(向きが逆) |
| ジャッカード係数・ゴワー距離 | 2値データや混合型データの非類似度 | この記事は量的変数の距離4種で閉じているが、実データはカテゴリ変数を含む。類似度 から距離を作るには とする |
| 超距離(ultrametric) | デンドログラムの高さが満たす不等式 | 「デンドログラムが描ける条件」の正体。高さの逆転(重心法)とコーフェネティック相関を同じ枠組みで整理できる |
| メディアン法・McQuitty 法 | Lance-Williams の係数が違うだけの別手法 | メディアン法()は重心法と同様に逆転が起きる |
このうち混合正規分布モデルは第33回(第31章・ベイズ法)や、EM アルゴリズムを扱う第31回(第29章・不完全データの統計処理)で再登場するはずなので、そこで改めて扱う予定です。
14. 自分が間違えていたこと
この章を学ぶ前に持っていた誤解を記録しておきます。
① 判別分析との違いは「正解ラベルの有無」だけだと思っていた。 入力の違いとしては合っていましたが、失われるのは入力の1列ではなく採点する能力でした。そこから「結果が手法に依存する」「正しさを検定できない」がすべて派生します。ラベルがあるデータで判別分析なら 85% 当てられるのに、クラスター分析だと 50.8% しか当たらない例を作って、ようやく違いの重さが分かりました。
② 標準化は「精度を上げるための前処理」だと思っていた。 違いました。分析結果が「データをどの単位で記録したか」に左右されないようにする操作です。年収を円で持つか十万円で持つかで純度が 0.75 と 1.00 に変わる、というのは前処理の問題ではなく結論の恣意性の問題です。
③ 標準化は常にやるべきだと思っていた。 無情報な変数のノイズも増幅されるので、そうとは言えません。純度 1.00 が 0.96 に落ちる例で確認しました。
④ 鎖効果は単なる欠点だと思っていた。 同じ性質が、三日月データでは唯一の勝者(純度 1.00)にし、橋のあるデータでは唯一の敗者(0.47)にします。手法の性質に良い悪いはなく、データの形との相性しかないという理解に変わりました。
⑤ デンドログラムの縦軸は「距離」だと思っていた。 手法によって違いました。ウォード法の縦軸は距離ではなく平方和の増分で、しかもソフトによって ・・ の3通りの目盛りがあります。
⑥ 「k-means は初期値依存」を知識としては知っていたが、軽く見ていた。 300回試したら27%の確率で「大きな層1つと小さな層2つ」という誤った構造を出しました。しかも見た目には綺麗な結果です。ただし WSS で判定できるので、複数回試すだけで解決する問題でもありました。
⑦ ギャップ統計量の1標準誤差基準を素朴に実装して を選んでしまった。しかも原因の見立ても間違えた。 最初は「ギャップが負だから基準が壊れた」と考えたのですが、符号は式に関与していませんでした。移項すれば 、つまり最初の平坦点で打ち切る規則だと分かります。増分 0.0265 が に埋もれていただけで、設計どおりの挙動でした。動かない理由を、式を読まずに手近な特徴(符号)に結びつけたのが失敗でした。
⑧ 「ウォード法はサイズが揃う」を「均等なサイズになる」と理解していた。 最初はそう書きそうになりました。実測すると、構造の無いデータでは確かに揃いますが(最大÷最小が 2.2倍)、100/10/10 という不均衡な構造があればそのまま再現します。 「揃いやすい」は迷ったときに均等側を選ぶ好みであって強制ではありません。さらに測ってみたら、いちばん揃うのはウォード法ではなく k-means(1.5倍)でした。「階層的手法の方が揃う」という思い込みも外れていました。
⑨ 計算量の下限について2つ言い過ぎた。 最初は「階層的手法は より速くできない」「 のメモリは回避できない」と書いていました。どちらも入力の条件を落としていました。 前者は一般の非類似度行列を入力とする場合の話で、低次元のユークリッド空間なら最短距離法は最小全域木と等価なので で解けます。後者は SLINK 法などで メモリにできます。「必須」と書く前に、どの前提の下での必須かを確認すべきでした。
⑩ が小さいと「クラスターが見つからない」だけだと思っていた。 逆でした。 が小さいと存在しないクラスターが見つかります。 しかもシルエット係数まで高く出ます。これがいちばん怖い発見でした。
15. 要点まとめ
| 論点 | 要点 |
|---|---|
| クラスター分析の位置づけ | 教師なし学習。グループを見つける(判別分析は既知のグループを分ける) |
| 判別分析との本質的な違い | 正解ラベルが無い → 採点できない → 結果が距離と手法に依存する |
| 何を返す装置か | 隠れた正解の発掘装置ではなく、与えた距離で見て目立つ構造を返す装置 |
| 4つの距離 | ユークリッド=円/マンハッタン=ひし形/マハラノビス=データに沿った楕円/コサイン=向きだけ |
| マハラノビス距離の正体 | 標準化+相関の補正を距離に組み込んだもの。単位の違いを自動で吸収する |
| 連結法の覚え方 | 最短距離法=1組でも近ければつなぐ=伸びる/最長距離法=全組が近くないとつながない=丸くなる |
| 5手法の関係 | Lance-Williams の漸化式の係数の違いだけ。最短と最長は の符号だけ違う |
| ウォード法と k-means の違い | 同じ WSS を見るが測るタイミングが違う。 k-means は「現在の状態」、ウォード法は「融合したときの増分」 |
| ウォード法の縦軸 | 。高さの総和=全体の平方和(実測 80.3333)だがこれは融合順序に依らない恒等式でウォード法固有ではない |
| ウォード法でサイズが揃う理由 | 係数 が大クラスター同士の融合を渋る(1と20で0.95、5と5で2.5)。「小さいものを大きいものに吸収」が安い |
| サイズはどれくらい揃うか | 構造なしデータで最大÷最小が 最短距離法108倍/ウォード法2.2倍/k-means 1.5倍。最も揃うのは k-means |
| 「揃う」は「等しくなる」ではない | 100/10/10 の不均衡な構造はそのまま再現する。均等化は強制ではなく「迷ったときの好み」 |
| 縦軸の目盛り | / / の3流儀。木の形は同じ。ただし ward.D に素の距離を渡すと融合順序まで変わる |
| デンドログラムとは | 融合の履歴の樹形図。葉・横棒の高さ・節・根・切断線の5部品。 を先に決めなくてよいのが最大の利点 |
| デンドログラムの読み方 | 横線より下の融合だけを認める。同じ高さが並ぶと作れない がある |
| ⚠️ 横軸の順序 | 意味がない(枝は左右に入れ替えても同じ木)。近さは「どの高さで同じ枝に入るか」=コーフェネティック距離で読む |
| 手法で結果が変わる | 実測で純度が 1.00〜0.47 まで動く。どの手法も全勝しない |
| 鎖効果 | 三日月では最強(1.00)、橋が7個あると最弱(0.47)。性質に良い悪いはなく相性だけ |
| 正解がない中での判断 | ①解釈可能性 ②安定性 ③内部指標 ④事前の手法選択。結果は仮説として扱う |
| コーフェネティック相関の罠 | 群平均法が高く出るが、この指標が高い手法が良いわけではない(三日月で最短距離法は最下位だが純度満点) |
| 計算量の違い | k-means は点と個の中心=に比例/階層的手法は全ペア=。実務の壁はメモリで、=100万なら距離行列 8TB |
| k-means の中身 | ①最も近い中心に割り当て ②中心を重心に動かす。割り当てが変わるとき目的関数が狭義に減る+割り当ての総数が有限なので必ず有限回で停止 |
| 初期値依存の原因 | 坂を下ることしかできない → 谷に落ちると出られない。300回で22通りの解、最良解73% |
| 初期値依存の対策 | WSS で良否が判定できるので複数回試す。k-means++ で86%、3回試行で100% |
| エルボー法 | WSS の減少率の段差を見る(実測 77.5% → 12.8%)。 を増やせば WSS は必ず減る |
| エルボー法の限界 | 一様分布では肘が無く、細長い1つのかたまりでは偽の肘が出る。 主観性より深刻 |
| シルエット係数 | 。=同クラスター内、=最近隣クラスター。大きいほど良い |
| シルエット係数の限界 | 構造なしでも 0.33〜0.43 のベースラインが残る( を増やしても消えない)。絶対水準では判定できない |
| ギャップ統計量 | 構造のない参照データとの比較。(構造なし)を候補に入れられる |
| 標準化が必要な本当の理由 | 精度ではなく恣意性の除去。 単位を変えると純度が 0.75→1.00→0.82 と動く |
| 標準化を忘れると | 年齢の寄与が約770億分の1(標準偏差比 27.6万倍の2乗)。結果は「年収1変数だけ」の場合と完全に同一になった |
| 回帰との違い | 回帰は標準化しても当てはまりが変わらないが、クラスター分析は分割そのものが変わる |
| 標準化の副作用 | 無情報な変数のノイズも同じ大きさに増幅する(純度 1.00 → 0.96) |
| 手法比較の指標 | この記事の純度は簡易指標( で必ず1.00)。標準は調整ランド指数(ARI) |
| が小さいときの罠 | 構造が無くても必ず何か返る。 シルエット係数の平均は =14 で 0.398、=200 で 0.304 |
| セグメント分けの下限 | 1セグメント30〜50人。3〜4分割なら =100〜200 が実質的な下限 |
| 作ったセグメントの検定 | 循環論法(double dipping)になる。 選択的推測の問題。検証は別データで |
次回
次回は第25章の因子分析とグラフィカルモデルです。
今回のクラスター分析は「個体を似たもの同士にまとめる」手法でしたが、因子分析は「変数の背後にある共通の要因を探す」手法です。似ているようで方向が90度違います。データの行をまとめるのがクラスター分析、列の背後を探るのが因子分析、と整理できます。
そして第24回の主成分分析との違いが焦点になるはずです。主成分分析は「ばらつきを最大にする合成変数を作る」、因子分析は「観測変数を説明する潜在変数を仮定する」。前者はデータの要約、後者はモデルの当てはめという違いがあり、ここを混同しやすいと聞いています。
この連載の全体像とこれまでの回は統計検定準1級・独学連載のまとめにあります。